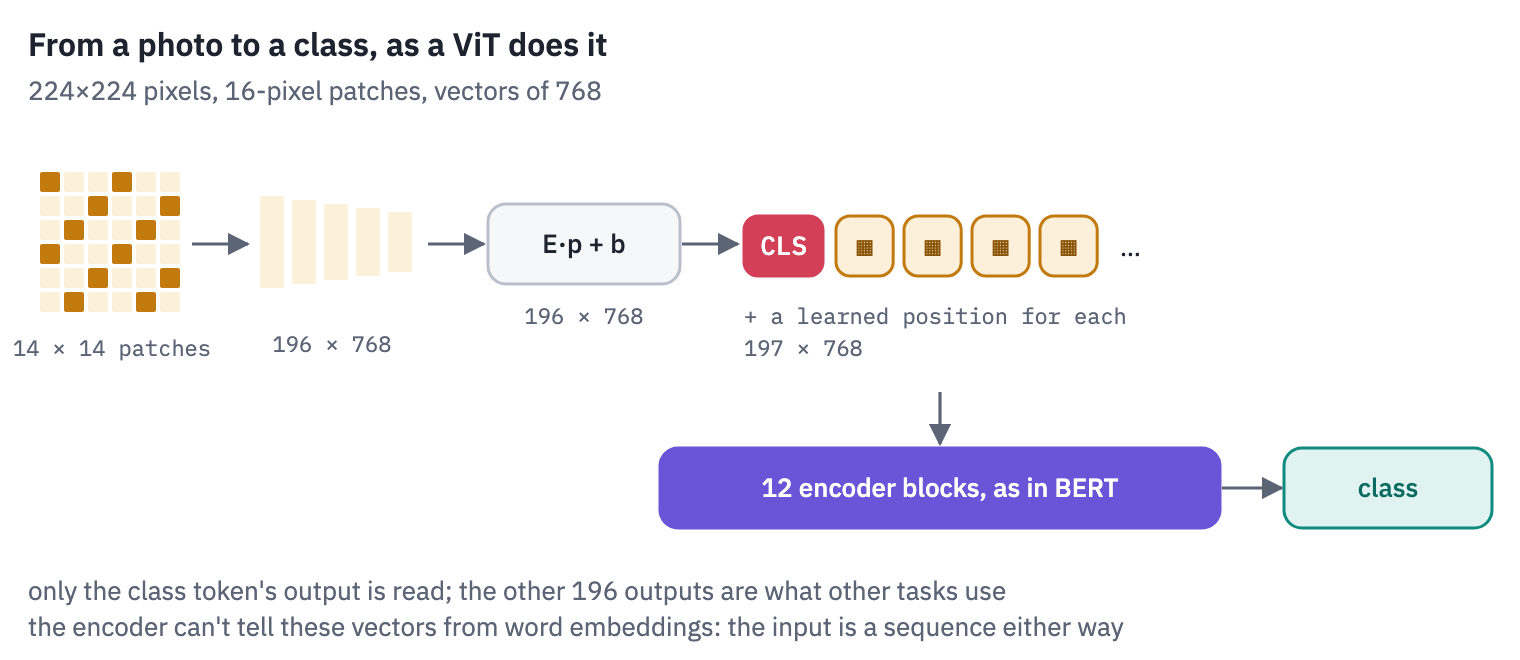
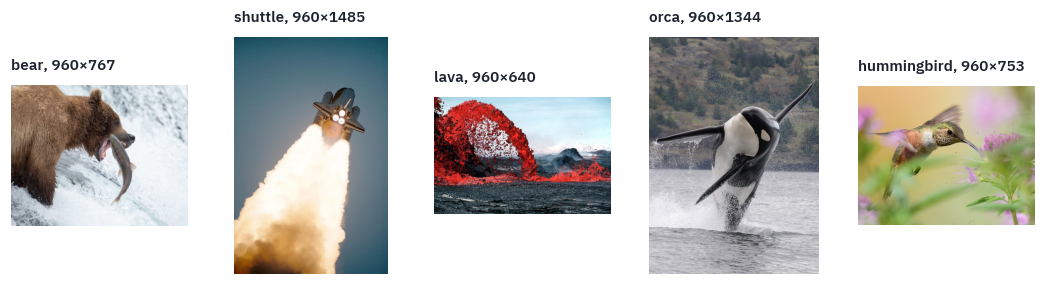
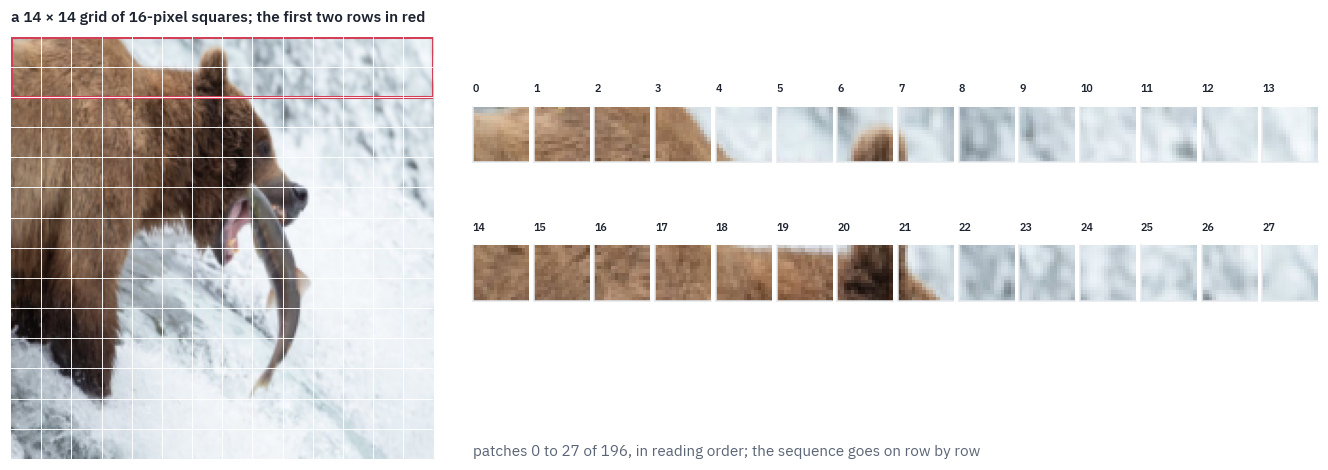
<?xml version="1.0" encoding="utf-8"?> <feed xmlns="http://www.w3.org/2005/Atom" xmlns:media="http://search.yahoo.com/mrss/" xml:lang="en"> <generator uri="https://jekyllrb.com/" version="4.3.4">Jekyll</generator> <link href="https://blog.korolevalab.com/feed.xml" rel="self" type="application/atom+xml"/> <link href="https://blog.korolevalab.com/" rel="alternate" type="text/html" hreflang="en"/> <updated>2026-11-11T10:59:38+00:00</updated> <id>https://blog.korolevalab.com/feed.xml</id> <title type="html">Eva Koroleva</title> <subtitle>Eva Koroleva, ML engineer and researcher in NLP, computer vision and generative models: projects, a Transformers course, and posts on ML and cognitive science.</subtitle> <author> <name>Eva Koroleva</name> <uri>https://blog.korolevalab.com/</uri> </author> <entry> <title type="html">The Vision Transformer reads images as sequences of patches</title> <link href="https://blog.korolevalab.com/blog/2026/transformer-architectures-11-vit/" rel="alternate" type="text/html" title="The Vision Transformer reads images as sequences of patches"/> <published>2026-11-09T20:00:00+00:00</published> <updated>2026-11-10T00:00:00+00:00</updated> <id>https://blog.korolevalab.com/blog/2026/transformer-architectures-11-vit</id> <content type="html" xml:base="https://blog.korolevalab.com/blog/2026/transformer-architectures-11-vit/"><![CDATA[<p class="tfs-links"><strong>Transformer architectures: from BERT to diffusion</strong> · lesson 11 of 15 · <a href="/teaching/">all lessons</a> · <a href="https://www.kaggle.com/code/qmarva/transformer-architectures-11-vision-transformer">run on Kaggle</a> · <a href="https://colab.research.google.com/github/xmarva/transformers-from-scratch/blob/main/notebooks/colab/a11_vit.ipynb">open in Colab</a> · <a href="https://github.com/xmarva/transformers-from-scratch">code on GitHub</a></p> <p>For eight years, from AlexNet in 2012 to 2020, every serious image classifier was a convolutional network. A convolution has two beliefs about images built into it: that nearby pixels belong together, and that a pattern means the same thing wherever it appears. Those beliefs are true, and they are why a CNN learns from a few thousand photos.</p> <p>In October 2020 a team at Google Brain dropped both. They took the Transformer encoder of <a href="/blog/2026/transformer-architectures-01-bert/">lesson 1</a>, BERT’s encoder almost unchanged, cut an image into a grid of 16×16-pixel squares, and fed the squares to it as if they were words.</p> <p>The paper’s title was the whole idea: <em>An image is worth 16x16 words</em>. It worked, with a condition: the model needed to see far more images than a CNN, 303 million of them in Google’s internal JFT-300M collection, before it caught up and then overtook.</p> <p>Today that same encoder, the <em>Vision Transformer</em> or ViT, is the eye of every model that reads images, from DINOv2 to the vision-language models of lesson 13.</p> <p>One thing to settle before we start, because the phrase “images as words” invites it: the ViT doesn’t turn an image into <em>text</em>. It turns an image into a <em>sequence of vectors</em>, the same kind of object an embedding layer makes from text, and the Transformer reads that sequence with exactly the machinery it uses for words.</p> <p>A vision-language model (lesson 13) goes one step further and places these vectors next to the vectors of text tokens in a language model’s input. Generating images from text is the opposite direction and has its own architecture, lesson 15’s diffusion Transformer.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/11/hero-light.png" width="760" alt="The Vision Transformer in one line. A 224 by 224 photo is cut into a 14 by 14 grid of 16-pixel squares; each square is flattened into 768 numbers and projected to a vector of 768; a learned class token is put in front and a learned position vector is added to each of the 197 vectors; the sequence goes through twelve encoder blocks, and the class token's output vector goes to a linear classifier that names the picture" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/11/hero-dark.png" width="760" alt="The Vision Transformer in one line. A 224 by 224 photo is cut into a 14 by 14 grid of 16-pixel squares; each square is flattened into 768 numbers and projected to a vector of 768; a learned class token is put in front and a learned position vector is added to each of the 197 vectors; the sequence goes through twelve encoder blocks, and the class token's output vector goes to a linear classifier that names the picture" loading="lazy"></p> <p><strong>What you’ll do</strong></p> <ol> <li>Walk one photo from pixels to the sequence of 197 vectors the encoder reads, one step at a time, with every tensor’s shape printed and every step drawn.</li> <li>Write the ViT in PyTorch, load Google’s ViT-B/16 into it and match Hugging Face.</li> <li>Open the trained model: what its first layer looks for in a patch, what its positions learned, how far its heads look at each depth, which parts of a photo decide the answer.</li> <li>Run it at a higher resolution by stretching its position embeddings, <a href="/blog/2026/transformer-architectures-09-long/">lesson 9</a>’s trick in two dimensions.</li> <li>Watch DINO, a ViT trained without a single label, find the objects in photos with its attention.</li> <li>On satellite images of Europe, race a pretrained ViT, a ViT and a CNN trained from scratch, and a probe on DINOv2’s features, from a hundred labelled images to sixteen thousand.</li> </ol> <p><strong>What you need</strong>: a GPU for the last section. On Kaggle, <em>Settings → Accelerator → GPU</em>; on Colab, <em>Runtime → Change runtime type → T4 GPU</em>. The notebook downloads ViT-B/16 (346 MB) twice, in two versions, two small self-supervised ViTs (90 MB each), five public-domain photos and the EuroSAT dataset (90 MB).</p> <h2 id="setup">Setup</h2> <p>One small helper package, <code class="language-plaintext highlighter-rouge">tfs</code>, draws the course’s plots and token chips and knows where the notebook runs (Kaggle, Colab or your own machine). Everything the lesson teaches is written out in the notebook itself.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">importlib.util</span>
<span class="kn">import</span> <span class="n">subprocess</span>
<span class="kn">import</span> <span class="n">sys</span>

<span class="n">TFS</span> <span class="o">=</span> <span class="sh">"</span><span class="s">git+https://github.com/xmarva/transformers-from-scratch@main</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">importlib</span><span class="p">.</span><span class="n">util</span><span class="p">.</span><span class="nf">find_spec</span><span class="p">(</span><span class="sh">"</span><span class="s">tfs</span><span class="sh">"</span><span class="p">)</span> <span class="ow">is</span> <span class="bp">None</span><span class="p">:</span>
    <span class="n">subprocess</span><span class="p">.</span><span class="nf">check_call</span><span class="p">([</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">-m</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">pip</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">install</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-q</span><span class="sh">"</span><span class="p">,</span> <span class="n">TFS</span><span class="p">])</span>

<span class="kn">from</span> <span class="n">tfs</span> <span class="kn">import</span> <span class="n">env</span>
<span class="kn">from</span> <span class="n">tfs.viz</span> <span class="kn">import</span> <span class="n">table</span><span class="p">,</span> <span class="n">token_chips</span><span class="p">,</span> <span class="n">use_course_style</span>

<span class="n">env</span><span class="p">.</span><span class="nf">quiet</span><span class="p">()</span>  <span class="c1"># no progress bars or environment warnings in the outputs
</span><span class="n">SEED</span> <span class="o">=</span> <span class="mi">42</span>
<span class="n">env</span><span class="p">.</span><span class="nf">seed_everything</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">COLORS</span> <span class="o">=</span> <span class="nf">use_course_style</span><span class="p">()</span>
<span class="n">WORK_DIR</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">work_dir</span><span class="p">()</span>
</code></pre></div></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">io</span>
<span class="kn">import</span> <span class="n">json</span>
<span class="kn">import</span> <span class="n">math</span>
<span class="kn">import</span> <span class="n">random</span>
<span class="kn">import</span> <span class="n">time</span>
<span class="kn">import</span> <span class="n">urllib.request</span>

<span class="kn">import</span> <span class="n">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>
<span class="kn">from</span> <span class="n">matplotlib.colors</span> <span class="kn">import</span> <span class="n">LinearSegmentedColormap</span><span class="p">,</span> <span class="n">to_rgb</span>
<span class="kn">import</span> <span class="n">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="n">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">import</span> <span class="n">torch</span>
<span class="kn">import</span> <span class="n">torch.nn</span> <span class="k">as</span> <span class="n">nn</span>
<span class="kn">import</span> <span class="n">torch.nn.functional</span> <span class="k">as</span> <span class="n">F</span>
<span class="kn">from</span> <span class="n">huggingface_hub</span> <span class="kn">import</span> <span class="n">hf_hub_download</span>
<span class="kn">from</span> <span class="n">PIL</span> <span class="kn">import</span> <span class="n">Image</span>
<span class="kn">from</span> <span class="n">safetensors.torch</span> <span class="kn">import</span> <span class="n">load_file</span>

<span class="n">SMOKE</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">smoke</span><span class="p">()</span>  <span class="c1"># CI runs the lesson on a small slice; you run it in full
</span><span class="n">device</span> <span class="o">=</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">if</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">is_available</span><span class="p">()</span> <span class="k">else</span> <span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">GPU:</span><span class="sh">"</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">get_device_name</span><span class="p">(</span><span class="mi">0</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>GPU: Tesla T4</code></pre> <h2 id="1-five-photographs">1. Five photographs</h2> <p>Five photographs from the collections of the US National Park Service, NASA, the US Geological Survey, NOAA and the US Fish and Wildlife Service: works of the US federal government, in the public domain.</p> <p>A brown bear catching a salmon at Brooks Falls in Alaska, the space shuttle Discovery lifting off, a fountain of lava on Kīlauea, an orca breaching off the coast of Washington, a rufous hummingbird in Wyoming.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">PHOTOS</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">bear</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">shuttle</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">lava</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">orca</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">hummingbird</span><span class="sh">"</span><span class="p">]</span>
<span class="c1"># 960-pixel copies of the Wikimedia Commons files listed in the References, kept in
# the course's repository because Commons limits how often one address may download
</span><span class="n">BASE</span> <span class="o">=</span> <span class="p">(</span>
    <span class="sh">"</span><span class="s">https://raw.githubusercontent.com/</span><span class="sh">"</span>
    <span class="sh">"</span><span class="s">xmarva/transformers-from-scratch/main/assets/photos/a11</span><span class="sh">"</span>
<span class="p">)</span>


<span class="k">def</span> <span class="nf">fetch_photo</span><span class="p">(</span><span class="n">name</span><span class="p">):</span>
    <span class="n">data</span> <span class="o">=</span> <span class="n">urllib</span><span class="p">.</span><span class="n">request</span><span class="p">.</span><span class="nf">urlopen</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">BASE</span><span class="si">}</span><span class="s">/</span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="s">.jpg</span><span class="sh">"</span><span class="p">).</span><span class="nf">read</span><span class="p">()</span>
    <span class="k">return</span> <span class="n">Image</span><span class="p">.</span><span class="nf">open</span><span class="p">(</span><span class="n">io</span><span class="p">.</span><span class="nc">BytesIO</span><span class="p">(</span><span class="n">data</span><span class="p">)).</span><span class="nf">convert</span><span class="p">(</span><span class="sh">"</span><span class="s">RGB</span><span class="sh">"</span><span class="p">)</span>


<span class="n">photos</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">PHOTOS</span><span class="p">:</span>
    <span class="n">photos</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="o">=</span> <span class="nf">fetch_photo</span><span class="p">(</span><span class="n">name</span><span class="p">)</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">photos</span><span class="p">),</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">12</span><span class="p">,</span> <span class="mf">2.8</span><span class="p">))</span>
<span class="k">for</span> <span class="n">ax</span><span class="p">,</span> <span class="p">(</span><span class="n">key</span><span class="p">,</span> <span class="n">photo</span><span class="p">)</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">axes</span><span class="p">,</span> <span class="n">photos</span><span class="p">.</span><span class="nf">items</span><span class="p">()):</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">imshow</span><span class="p">(</span><span class="n">photo</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">key</span><span class="si">}</span><span class="s">, </span><span class="si">{</span><span class="n">photo</span><span class="p">.</span><span class="n">width</span><span class="si">}</span><span class="s">×</span><span class="si">{</span><span class="n">photo</span><span class="p">.</span><span class="n">height</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">10</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">axis</span><span class="p">(</span><span class="sh">"</span><span class="s">off</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/11/output-01.png" alt="Output of the code above" loading="lazy"></p> <h2 id="2-from-pixels-to-a-sequence-step-by-step">2. From pixels to a sequence, step by step</h2> <p>This is the section the rest of the lesson stands on. We take the bear and follow it to the exact tensor the encoder reads, printing the shape at every step. The numbers come from the model we load in section 3, Google’s ViT-B/16: patches of 16 pixels, vectors of 768 numbers.</p> <p><strong>Step 1: a fixed size and a fixed scale.</strong> The model was trained on 224×224 images, so every photo is resized to that, aspect ratio or not.</p> <p>Each pixel’s three channels, red, green and blue, arrive as integers from 0 to 255; they are divided by 255 and then <em>normalised</em>, shifted and scaled so that each channel sits roughly between −1 and 1. This checkpoint uses a mean of 0.5 and a standard deviation of 0.5 for every channel:</p> \[x_{c,i,j} = \frac{\text{pixel}_{c,i,j} / 255 - 0.5}{0.5}.\] <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">SIZE</span><span class="p">,</span> <span class="n">PATCH</span><span class="p">,</span> <span class="n">MEAN</span><span class="p">,</span> <span class="n">STD</span> <span class="o">=</span> <span class="mi">224</span><span class="p">,</span> <span class="mi">16</span><span class="p">,</span> <span class="mf">0.5</span><span class="p">,</span> <span class="mf">0.5</span>


<span class="k">def</span> <span class="nf">to_tensor</span><span class="p">(</span><span class="n">photo</span><span class="p">,</span> <span class="n">size</span><span class="o">=</span><span class="n">SIZE</span><span class="p">,</span> <span class="n">mean</span><span class="o">=</span><span class="n">MEAN</span><span class="p">,</span> <span class="n">std</span><span class="o">=</span><span class="n">STD</span><span class="p">):</span>
    <span class="n">small</span> <span class="o">=</span> <span class="n">photo</span><span class="p">.</span><span class="nf">resize</span><span class="p">((</span><span class="n">size</span><span class="p">,</span> <span class="n">size</span><span class="p">),</span> <span class="n">Image</span><span class="p">.</span><span class="n">BILINEAR</span><span class="p">)</span>
    <span class="n">pixels</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">asarray</span><span class="p">(</span><span class="n">small</span><span class="p">),</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float32</span><span class="p">)</span>  <span class="c1"># (height, width, 3)
</span>    <span class="n">pixels</span> <span class="o">=</span> <span class="p">(</span>
        <span class="n">pixels</span><span class="p">.</span><span class="nf">permute</span><span class="p">(</span><span class="mi">2</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="mi">255</span>
    <span class="p">)</span>  <span class="c1"># channels first: (3, height, width), from 0 to 1
</span>    <span class="n">mean</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">mean</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
    <span class="n">std</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">std</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
    <span class="nf">return </span><span class="p">(</span><span class="n">pixels</span> <span class="o">-</span> <span class="n">mean</span><span class="p">)</span> <span class="o">/</span> <span class="n">std</span>


<span class="n">x</span> <span class="o">=</span> <span class="nf">to_tensor</span><span class="p">(</span><span class="n">photos</span><span class="p">[</span><span class="sh">"</span><span class="s">bear</span><span class="sh">"</span><span class="p">])</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">one photo as a tensor:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">values from </span><span class="si">{</span><span class="n">x</span><span class="p">.</span><span class="nf">min</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="s"> to </span><span class="si">{</span><span class="n">x</span><span class="p">.</span><span class="nf">max</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">11</span><span class="p">,</span> <span class="mf">3.2</span><span class="p">),</span> <span class="n">gridspec_kw</span><span class="o">=</span><span class="p">{</span><span class="sh">"</span><span class="s">width_ratios</span><span class="sh">"</span><span class="p">:</span> <span class="p">[</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mf">1.4</span><span class="p">]})</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">imshow</span><span class="p">(</span><span class="n">photos</span><span class="p">[</span><span class="sh">"</span><span class="s">bear</span><span class="sh">"</span><span class="p">])</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">set_title</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">original, </span><span class="si">{</span><span class="n">photos</span><span class="p">[</span><span class="sh">'</span><span class="s">bear</span><span class="sh">'</span><span class="p">].</span><span class="n">width</span><span class="si">}</span><span class="s">×</span><span class="si">{</span><span class="n">photos</span><span class="p">[</span><span class="sh">'</span><span class="s">bear</span><span class="sh">'</span><span class="p">].</span><span class="n">height</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">10</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="nf">imshow</span><span class="p">((</span><span class="n">x</span><span class="p">.</span><span class="nf">permute</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">0</span><span class="p">)</span> <span class="o">*</span> <span class="n">STD</span> <span class="o">+</span> <span class="n">MEAN</span><span class="p">).</span><span class="nf">clamp</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">))</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">resized to 224×224</span><span class="sh">"</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">10</span><span class="p">)</span>
<span class="k">for</span> <span class="n">channel</span><span class="p">,</span> <span class="n">color</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="mi">3</span><span class="p">),</span> <span class="p">[</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">]]):</span>
    <span class="n">axes</span><span class="p">[</span><span class="mi">2</span><span class="p">].</span><span class="nf">hist</span><span class="p">(</span>
        <span class="n">x</span><span class="p">[</span><span class="n">channel</span><span class="p">].</span><span class="nf">flatten</span><span class="p">(),</span> <span class="n">bins</span><span class="o">=</span><span class="mi">60</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.6</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">RGB</span><span class="sh">"</span><span class="p">[</span><span class="n">channel</span><span class="p">]</span>
    <span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">2</span><span class="p">].</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">the 3 × 224 × 224 numbers after normalising</span><span class="sh">"</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">10</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">2</span><span class="p">].</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">axis</span><span class="p">(</span><span class="sh">"</span><span class="s">off</span><span class="sh">"</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="nf">axis</span><span class="p">(</span><span class="sh">"</span><span class="s">off</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
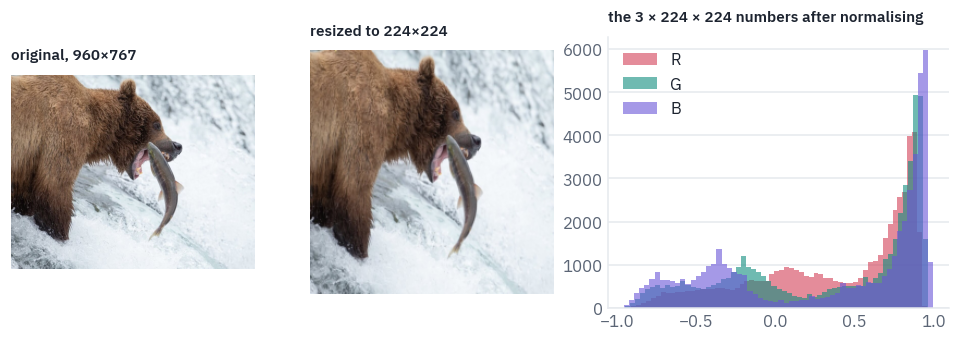
</code></pre></div></div> <pre class="tfs-printed"><code>one photo as a tensor: (3, 224, 224)
values from -0.96 to 1.00</code></pre> <p><img class="tfs-output" src="/assets/posts/arch/11/output-02.png" alt="resized to 224×224" loading="lazy"></p> <p>The bear became a little wider, because the photo wasn’t square; the model was trained on such squashed squares and doesn’t mind. The histogram shows what the model actually receives: 150,528 numbers, mostly in the bright end, because the photo is mostly white water.</p> <p><strong>Step 2: cut into patches.</strong> A 224×224 image holds 14 × 14 = 196 squares of 16×16 pixels. Cutting is pure reindexing, no arithmetic: split the height into 14 rows of 16 and the width into 14 columns of 16, move the row and column indices to the front, and flatten each square.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">patchify</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">p</span><span class="o">=</span><span class="n">PATCH</span><span class="p">):</span>
    <span class="n">channels</span><span class="p">,</span> <span class="n">height</span><span class="p">,</span> <span class="n">width</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span>
    <span class="n">x</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="nf">reshape</span><span class="p">(</span><span class="n">channels</span><span class="p">,</span> <span class="n">height</span> <span class="o">//</span> <span class="n">p</span><span class="p">,</span> <span class="n">p</span><span class="p">,</span> <span class="n">width</span> <span class="o">//</span> <span class="n">p</span><span class="p">,</span> <span class="n">p</span><span class="p">)</span>  <span class="c1"># (3, 14, 16, 14, 16)
</span>    <span class="n">x</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="nf">permute</span><span class="p">(</span>
        <span class="mi">1</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">4</span>
    <span class="p">)</span>  <span class="c1"># (14, 14, 3, 16, 16): grid row, grid column, then the patch
</span>    <span class="k">return</span> <span class="n">x</span><span class="p">.</span><span class="nf">reshape</span><span class="p">((</span><span class="n">height</span> <span class="o">//</span> <span class="n">p</span><span class="p">)</span> <span class="o">*</span> <span class="p">(</span><span class="n">width</span> <span class="o">//</span> <span class="n">p</span><span class="p">),</span> <span class="n">channels</span> <span class="o">*</span> <span class="n">p</span> <span class="o">*</span> <span class="n">p</span><span class="p">)</span>  <span class="c1"># (196, 768)
</span>

<span class="n">patches</span> <span class="o">=</span> <span class="nf">patchify</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">patches:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">patches</span><span class="p">.</span><span class="n">shape</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">numbers in one patch: 3 × 16 × 16 =</span><span class="sh">"</span><span class="p">,</span> <span class="mi">3</span> <span class="o">*</span> <span class="n">PATCH</span> <span class="o">*</span> <span class="n">PATCH</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>patches: (196, 768)
numbers in one patch: 3 × 16 × 16 = 768</code></pre> <p>The order of the squares is the order of reading a page: left to right along the top row, then the next row. Here is the grid on the photo, and the first two rows of squares laid out as the sequence the model will see:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">grid</span> <span class="o">=</span> <span class="n">SIZE</span> <span class="o">//</span> <span class="n">PATCH</span>
<span class="n">shown</span> <span class="o">=</span> <span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="nf">permute</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">0</span><span class="p">)</span> <span class="o">*</span> <span class="n">STD</span> <span class="o">+</span> <span class="n">MEAN</span><span class="p">).</span><span class="nf">clamp</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
<span class="n">fig</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">figure</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">12</span><span class="p">,</span> <span class="mf">4.2</span><span class="p">))</span>
<span class="n">ax</span> <span class="o">=</span> <span class="n">fig</span><span class="p">.</span><span class="nf">add_axes</span><span class="p">([</span><span class="mf">0.0</span><span class="p">,</span> <span class="mf">0.0</span><span class="p">,</span> <span class="mf">0.32</span><span class="p">,</span> <span class="mf">1.0</span><span class="p">])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">imshow</span><span class="p">(</span><span class="n">shown</span><span class="p">)</span>
<span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">grid</span><span class="p">):</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">axhline</span><span class="p">(</span><span class="n">k</span> <span class="o">*</span> <span class="n">PATCH</span> <span class="o">-</span> <span class="mf">0.5</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="sh">"</span><span class="s">white</span><span class="sh">"</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mf">0.6</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">axvline</span><span class="p">(</span><span class="n">k</span> <span class="o">*</span> <span class="n">PATCH</span> <span class="o">-</span> <span class="mf">0.5</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="sh">"</span><span class="s">white</span><span class="sh">"</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mf">0.6</span><span class="p">)</span>
<span class="n">red</span> <span class="o">=</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">]</span>
<span class="n">first_rows</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nc">Rectangle</span><span class="p">((</span><span class="o">-</span><span class="mf">0.5</span><span class="p">,</span> <span class="o">-</span><span class="mf">0.5</span><span class="p">),</span> <span class="n">SIZE</span><span class="p">,</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">PATCH</span><span class="p">,</span> <span class="n">fill</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">red</span><span class="p">,</span> <span class="n">lw</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">add_patch</span><span class="p">(</span><span class="n">first_rows</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">a 14 × 14 grid of 16-pixel squares; the first two rows in red</span><span class="sh">"</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">10</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">axis</span><span class="p">(</span><span class="sh">"</span><span class="s">off</span><span class="sh">"</span><span class="p">)</span>
<span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">2</span> <span class="o">*</span> <span class="n">grid</span><span class="p">):</span>
    <span class="n">row</span><span class="p">,</span> <span class="n">col</span> <span class="o">=</span> <span class="nf">divmod</span><span class="p">(</span><span class="n">k</span><span class="p">,</span> <span class="n">grid</span><span class="p">)</span>
    <span class="n">tile</span> <span class="o">=</span> <span class="n">shown</span><span class="p">[</span><span class="n">row</span> <span class="o">*</span> <span class="n">PATCH</span> <span class="p">:</span> <span class="p">(</span><span class="n">row</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">*</span> <span class="n">PATCH</span><span class="p">,</span> <span class="n">col</span> <span class="o">*</span> <span class="n">PATCH</span> <span class="p">:</span> <span class="p">(</span><span class="n">col</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">*</span> <span class="n">PATCH</span><span class="p">]</span>
    <span class="n">tile_ax</span> <span class="o">=</span> <span class="n">fig</span><span class="p">.</span><span class="nf">add_axes</span><span class="p">(</span>
        <span class="p">[</span><span class="mf">0.35</span> <span class="o">+</span> <span class="p">(</span><span class="n">k</span> <span class="o">%</span> <span class="n">grid</span><span class="p">)</span> <span class="o">*</span> <span class="mf">0.046</span><span class="p">,</span> <span class="mf">0.62</span> <span class="o">-</span> <span class="p">(</span><span class="n">k</span> <span class="o">//</span> <span class="n">grid</span><span class="p">)</span> <span class="o">*</span> <span class="mf">0.3</span><span class="p">,</span> <span class="mf">0.042</span><span class="p">,</span> <span class="mf">0.25</span><span class="p">]</span>
    <span class="p">)</span>
    <span class="n">tile_ax</span><span class="p">.</span><span class="nf">imshow</span><span class="p">(</span><span class="n">tile</span><span class="p">)</span>
    <span class="n">tile_ax</span><span class="p">.</span><span class="nf">set_xticks</span><span class="p">([])</span>
    <span class="n">tile_ax</span><span class="p">.</span><span class="nf">set_yticks</span><span class="p">([])</span>
    <span class="n">tile_ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="nf">str</span><span class="p">(</span><span class="n">k</span><span class="p">),</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">7</span><span class="p">)</span>
<span class="n">caption</span> <span class="o">=</span> <span class="sh">"</span><span class="s">patches 0 to 27 of 196, in reading order; the sequence goes on row by row</span><span class="sh">"</span>
<span class="n">fig</span><span class="p">.</span><span class="nf">text</span><span class="p">(</span><span class="mf">0.35</span><span class="p">,</span> <span class="mf">0.05</span><span class="p">,</span> <span class="n">caption</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">10</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">])</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/11/output-03.png" alt="a 14 × 14 grid of 16-pixel squares; the first two rows in red" loading="lazy"></p> <p>PyTorch has the same cut built in as <code class="language-plaintext highlighter-rouge">unfold</code>, which slides a window over an image and stacks what it sees. With a stride equal to the window, the windows don’t overlap and it returns our patches, in our order:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">unfolded</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">unfold</span><span class="p">(</span><span class="n">x</span><span class="p">[</span><span class="bp">None</span><span class="p">],</span> <span class="n">kernel_size</span><span class="o">=</span><span class="n">PATCH</span><span class="p">,</span> <span class="n">stride</span><span class="o">=</span><span class="n">PATCH</span><span class="p">)[</span><span class="mi">0</span><span class="p">].</span><span class="n">T</span>  <span class="c1"># (196, 768)
</span><span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">unfold against reshape, max difference:</span><span class="sh">"</span><span class="p">,</span> <span class="p">(</span><span class="n">unfolded</span> <span class="o">-</span> <span class="n">patches</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">())</span>
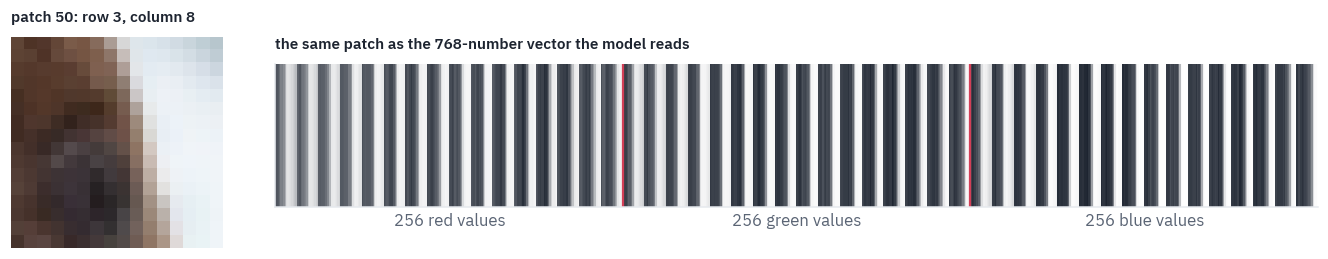
</code></pre></div></div> <pre class="tfs-printed"><code>unfold against reshape, max difference: 0.0</code></pre> <p><strong>Step 3: one patch is 768 numbers.</strong> A patch is a small picture, 16×16 pixels in three channels, and the model sees it as one long vector: the 256 red values, then the 256 green, then the 256 blue.</p> <p>Here is patch 50, the one with the bear’s eye, and its vector drawn as a strip, every number one thin bar.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">k</span> <span class="o">=</span> <span class="mi">50</span>  <span class="c1"># row 3, column 8: the bear's eye
</span><span class="n">row</span><span class="p">,</span> <span class="n">col</span> <span class="o">=</span> <span class="nf">divmod</span><span class="p">(</span><span class="n">k</span><span class="p">,</span> <span class="n">grid</span><span class="p">)</span>
<span class="n">tile</span> <span class="o">=</span> <span class="n">shown</span><span class="p">[</span><span class="n">row</span> <span class="o">*</span> <span class="n">PATCH</span> <span class="p">:</span> <span class="p">(</span><span class="n">row</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">*</span> <span class="n">PATCH</span><span class="p">,</span> <span class="n">col</span> <span class="o">*</span> <span class="n">PATCH</span> <span class="p">:</span> <span class="p">(</span><span class="n">col</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">*</span> <span class="n">PATCH</span><span class="p">]</span>
<span class="n">fig</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">figure</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">12</span><span class="p">,</span> <span class="mf">2.6</span><span class="p">))</span>
<span class="n">ax</span> <span class="o">=</span> <span class="n">fig</span><span class="p">.</span><span class="nf">add_axes</span><span class="p">([</span><span class="mf">0.0</span><span class="p">,</span> <span class="mf">0.05</span><span class="p">,</span> <span class="mf">0.16</span><span class="p">,</span> <span class="mf">0.85</span><span class="p">])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">imshow</span><span class="p">(</span><span class="n">tile</span><span class="p">,</span> <span class="n">interpolation</span><span class="o">=</span><span class="sh">"</span><span class="s">nearest</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">patch </span><span class="si">{</span><span class="n">k</span><span class="si">}</span><span class="s">: row </span><span class="si">{</span><span class="n">row</span><span class="si">}</span><span class="s">, column </span><span class="si">{</span><span class="n">col</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">10</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">axis</span><span class="p">(</span><span class="sh">"</span><span class="s">off</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span> <span class="o">=</span> <span class="n">fig</span><span class="p">.</span><span class="nf">add_axes</span><span class="p">([</span><span class="mf">0.2</span><span class="p">,</span> <span class="mf">0.25</span><span class="p">,</span> <span class="mf">0.79</span><span class="p">,</span> <span class="mf">0.5</span><span class="p">])</span>
<span class="n">greys</span> <span class="o">=</span> <span class="n">LinearSegmentedColormap</span><span class="p">.</span><span class="nf">from_list</span><span class="p">(</span><span class="sh">"</span><span class="s">greys</span><span class="sh">"</span><span class="p">,</span> <span class="p">[</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">ink</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">card</span><span class="sh">"</span><span class="p">]])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">imshow</span><span class="p">(</span><span class="n">patches</span><span class="p">[</span><span class="n">k</span><span class="p">][</span><span class="bp">None</span><span class="p">],</span> <span class="n">aspect</span><span class="o">=</span><span class="sh">"</span><span class="s">auto</span><span class="sh">"</span><span class="p">,</span> <span class="n">cmap</span><span class="o">=</span><span class="n">greys</span><span class="p">,</span> <span class="n">interpolation</span><span class="o">=</span><span class="sh">"</span><span class="s">nearest</span><span class="sh">"</span><span class="p">)</span>
<span class="k">for</span> <span class="n">edge</span> <span class="ow">in</span> <span class="p">[</span><span class="mi">256</span><span class="p">,</span> <span class="mi">512</span><span class="p">]:</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">axvline</span><span class="p">(</span><span class="n">edge</span> <span class="o">-</span> <span class="mf">0.5</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">],</span> <span class="n">linewidth</span><span class="o">=</span><span class="mf">1.5</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_yticks</span><span class="p">([])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xticks</span><span class="p">([</span><span class="mi">128</span><span class="p">,</span> <span class="mi">384</span><span class="p">,</span> <span class="mi">640</span><span class="p">],</span> <span class="p">[</span><span class="sh">"</span><span class="s">256 red values</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">256 green values</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">256 blue values</span><span class="sh">"</span><span class="p">])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">the same patch as the 768-number vector the model reads</span><span class="sh">"</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">10</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
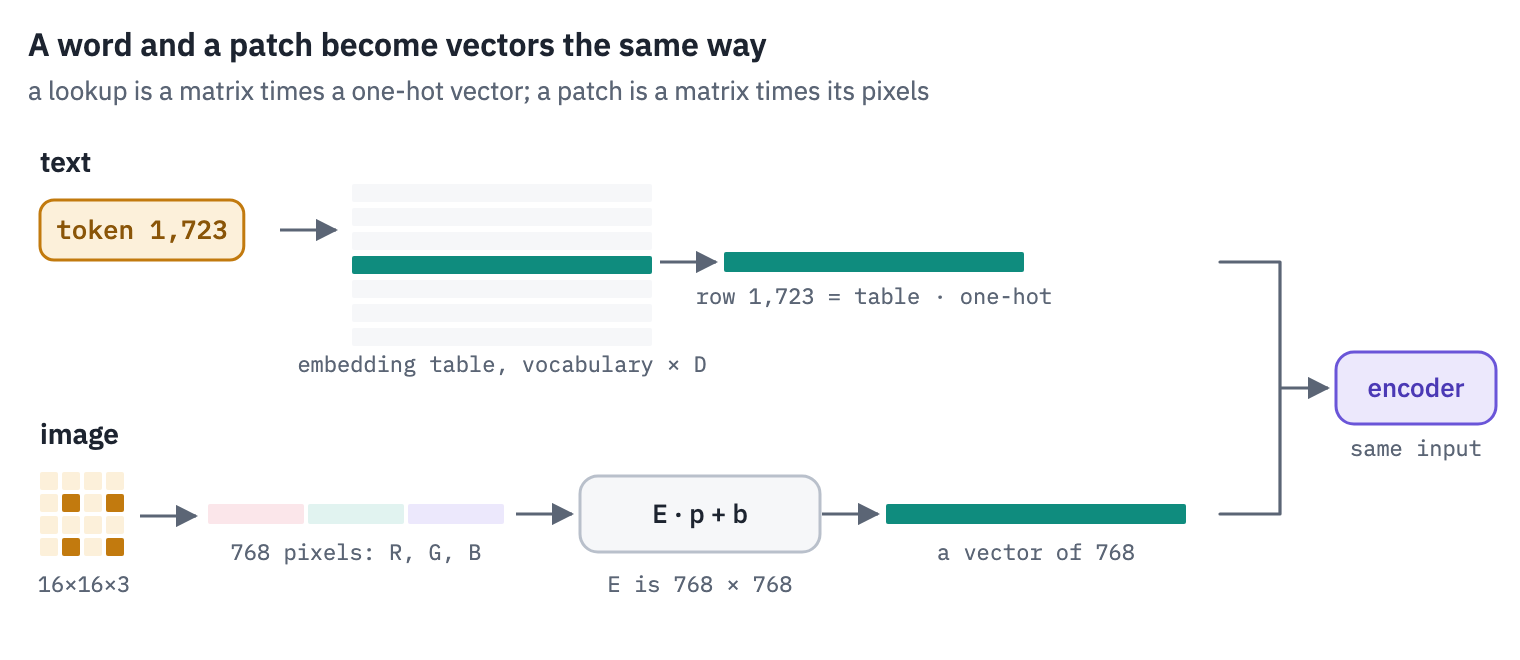
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/11/output-04.png" alt="the same patch as the 768-number vector the model reads" loading="lazy"></p> <p><strong>Step 4: the patch embedding.</strong> Text enters a Transformer through an embedding table: token number 1,723 picks row 1,723 of a matrix.</p> <p>A patch has no number; it <em>is</em> a vector of 768 pixels. So the ViT multiplies it by a learned matrix \(E\) and adds a bias:</p> \[z_i = E\,p_i + b, \qquad E \in \mathbb{R}^{D \times 768}.\] <p>The two are closer than they look. Looking up row \(t\) of a table is multiplying the table by a one-hot vector, a vector of zeros with a single 1 in place \(t\); the ViT multiplies the same kind of matrix by a vector of pixels instead of a one-hot one.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/11/embedding-light.png" width="760" alt="How text and images become vectors, side by side. On the left, a token id picks one row of an embedding table, which is the same as multiplying the table by a one-hot vector. On the right, a patch of 16 by 16 pixels in three channels is flattened into 768 numbers and multiplied by a learned matrix, plus a bias, giving a vector of the same width as a word's embedding. Both produce one vector per token; after that the Transformer can't tell where the vectors came from" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/11/embedding-dark.png" width="760" alt="How text and images become vectors, side by side. On the left, a token id picks one row of an embedding table, which is the same as multiplying the table by a one-hot vector. On the right, a patch of 16 by 16 pixels in three channels is flattened into 768 numbers and multiplied by a learned matrix, plus a bias, giving a vector of the same width as a word's embedding. Both produce one vector per token; after that the Transformer can't tell where the vectors came from" loading="lazy"></p> <p>In the released code the matrix is stored as a convolution with 768 filters of size 16×16 and a stride of 16: sliding a 16×16 filter in steps of 16 is the same as multiplying each patch by the filter, flattened. We check it with the real weights.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">ViTConfig</span><span class="p">,</span> <span class="n">ViTForImageClassification</span>

<span class="n">REPO</span> <span class="o">=</span> <span class="sh">"</span><span class="s">google/vit-base-patch16-224</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">SMOKE</span><span class="p">:</span>  <span class="c1"># a small model with random weights stands in for Google's
</span>    <span class="n">small</span> <span class="o">=</span> <span class="nc">ViTConfig</span><span class="p">(</span><span class="n">hidden_size</span><span class="o">=</span><span class="mi">64</span><span class="p">,</span> <span class="n">num_hidden_layers</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span> <span class="n">num_attention_heads</span><span class="o">=</span><span class="mi">4</span><span class="p">)</span>
    <span class="n">small</span><span class="p">.</span><span class="n">intermediate_size</span><span class="p">,</span> <span class="n">small</span><span class="p">.</span><span class="n">num_labels</span> <span class="o">=</span> <span class="mi">128</span><span class="p">,</span> <span class="mi">1000</span>
    <span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="mi">0</span><span class="p">)</span>
    <span class="n">reference</span> <span class="o">=</span> <span class="nc">ViTForImageClassification</span><span class="p">(</span><span class="n">small</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
    <span class="n">vit_config</span> <span class="o">=</span> <span class="n">small</span><span class="p">.</span><span class="nf">to_dict</span><span class="p">()</span>
    <span class="n">reference</span><span class="p">.</span><span class="nf">save_pretrained</span><span class="p">(</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">vit-small</span><span class="sh">"</span><span class="p">)</span>  <span class="c1"># saved under the checkpoints' names
</span>    <span class="n">hf_weights</span> <span class="o">=</span> <span class="nf">load_file</span><span class="p">(</span><span class="nf">str</span><span class="p">(</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">vit-small</span><span class="sh">"</span> <span class="o">/</span> <span class="sh">"</span><span class="s">model.safetensors</span><span class="sh">"</span><span class="p">))</span>
<span class="k">else</span><span class="p">:</span>
    <span class="n">reference</span> <span class="o">=</span> <span class="n">ViTForImageClassification</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">REPO</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
    <span class="n">vit_config</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">REPO</span><span class="p">,</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">)))</span>
    <span class="n">hf_weights</span> <span class="o">=</span> <span class="nf">load_file</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">REPO</span><span class="p">,</span> <span class="sh">"</span><span class="s">model.safetensors</span><span class="sh">"</span><span class="p">))</span>
<span class="n">conv_weight</span> <span class="o">=</span> <span class="n">hf_weights</span><span class="p">[</span>
    <span class="sh">"</span><span class="s">vit.embeddings.patch_embeddings.projection.weight</span><span class="sh">"</span>
<span class="p">]</span>  <span class="c1"># (768, 3, 16, 16)
</span><span class="n">conv_bias</span> <span class="o">=</span> <span class="n">hf_weights</span><span class="p">[</span><span class="sh">"</span><span class="s">vit.embeddings.patch_embeddings.projection.bias</span><span class="sh">"</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">the convolution</span><span class="sh">'</span><span class="s">s weight:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">conv_weight</span><span class="p">.</span><span class="n">shape</span><span class="p">))</span>

<span class="n">E</span> <span class="o">=</span> <span class="n">conv_weight</span><span class="p">.</span><span class="nf">reshape</span><span class="p">(</span>
    <span class="n">conv_weight</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="o">-</span><span class="mi">1</span>
<span class="p">)</span>  <span class="c1"># (768, 768): one flattened filter per row
</span><span class="n">as_matrix</span> <span class="o">=</span> <span class="n">patches</span> <span class="o">@</span> <span class="n">E</span><span class="p">.</span><span class="n">T</span> <span class="o">+</span> <span class="n">conv_bias</span>  <span class="c1"># (196, 768)
</span><span class="n">as_conv</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">conv2d</span><span class="p">(</span><span class="n">x</span><span class="p">[</span><span class="bp">None</span><span class="p">],</span> <span class="n">conv_weight</span><span class="p">,</span> <span class="n">conv_bias</span><span class="p">,</span> <span class="n">stride</span><span class="o">=</span><span class="n">PATCH</span><span class="p">)</span>  <span class="c1"># (1, 768, 14, 14)
</span><span class="n">as_conv</span> <span class="o">=</span> <span class="n">as_conv</span><span class="p">.</span><span class="nf">flatten</span><span class="p">(</span><span class="mi">2</span><span class="p">)[</span><span class="mi">0</span><span class="p">].</span><span class="n">T</span>  <span class="c1"># (196, 768)
</span><span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">patch vectors:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">as_matrix</span><span class="p">.</span><span class="n">shape</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span>
    <span class="sh">"</span><span class="s">matrix against convolution, max difference:</span><span class="sh">"</span><span class="p">,</span>
    <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="n">as_matrix</span> <span class="o">-</span> <span class="n">as_conv</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span>
<span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>the convolution's weight: (768, 3, 16, 16)
patch vectors: (196, 768)
matrix against convolution, max difference: 9.5e-06</code></pre> <p>The convolution is only a fast way to write the matrix product: the ViT has no convolutional layers in the sense of a CNN, because the filters never overlap and never slide past what they’ve already seen.</p> <p><strong>Step 5: the class token and the positions.</strong> Two learned additions turn the 196 vectors into the sequence the encoder reads.</p> <p>In front goes a <em>class token</em>, one vector the model learned, the same for every image: it carries no pixels and gathers the whole image through attention, layer by layer, like BERT’s [CLS] in lesson 1.</p> <p>Its output is what the classifier reads. Then, to every one of the 197 vectors, a learned <em>position embedding</em> is added, one per place in the grid, because attention by itself has no idea of order.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">cls_token</span> <span class="o">=</span> <span class="n">hf_weights</span><span class="p">[</span><span class="sh">"</span><span class="s">vit.embeddings.cls_token</span><span class="sh">"</span><span class="p">]</span>  <span class="c1"># (1, 1, 768)
</span><span class="n">positions</span> <span class="o">=</span> <span class="n">hf_weights</span><span class="p">[</span><span class="sh">"</span><span class="s">vit.embeddings.position_embeddings</span><span class="sh">"</span><span class="p">]</span>  <span class="c1"># (1, 197, 768)
</span><span class="n">sequence</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">cls_token</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="n">as_matrix</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>  <span class="c1"># (197, 768)
</span><span class="n">sequence</span> <span class="o">=</span> <span class="n">sequence</span> <span class="o">+</span> <span class="n">positions</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">class token:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">cls_token</span><span class="p">.</span><span class="n">shape</span><span class="p">),</span> <span class="sh">"</span><span class="s"> positions:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">positions</span><span class="p">.</span><span class="n">shape</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">the sequence the encoder reads:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">sequence</span><span class="p">.</span><span class="n">shape</span><span class="p">))</span>

<span class="c1"># negative numbers in teal, positive in rose, zero white
</span><span class="n">ends</span> <span class="o">=</span> <span class="p">[</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">card</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">]]</span>
<span class="n">signed</span> <span class="o">=</span> <span class="n">LinearSegmentedColormap</span><span class="p">.</span><span class="nf">from_list</span><span class="p">(</span><span class="sh">"</span><span class="s">signed</span><span class="sh">"</span><span class="p">,</span> <span class="n">ends</span><span class="p">)</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">11</span><span class="p">,</span> <span class="mf">2.6</span><span class="p">))</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">imshow</span><span class="p">(</span>
    <span class="n">sequence</span><span class="p">.</span><span class="n">T</span><span class="p">[:</span><span class="mi">96</span><span class="p">],</span> <span class="n">aspect</span><span class="o">=</span><span class="sh">"</span><span class="s">auto</span><span class="sh">"</span><span class="p">,</span> <span class="n">cmap</span><span class="o">=</span><span class="n">signed</span><span class="p">,</span> <span class="n">vmin</span><span class="o">=-</span><span class="mi">3</span><span class="p">,</span> <span class="n">vmax</span><span class="o">=</span><span class="mi">3</span><span class="p">,</span> <span class="n">interpolation</span><span class="o">=</span><span class="sh">"</span><span class="s">nearest</span><span class="sh">"</span>
<span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">position in the sequence: 0 is the class token, 1 to 196 the patches</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">first 96 of 768</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">The bear, as the encoder sees it: 197 columns of 768 numbers</span><span class="sh">"</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">10</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
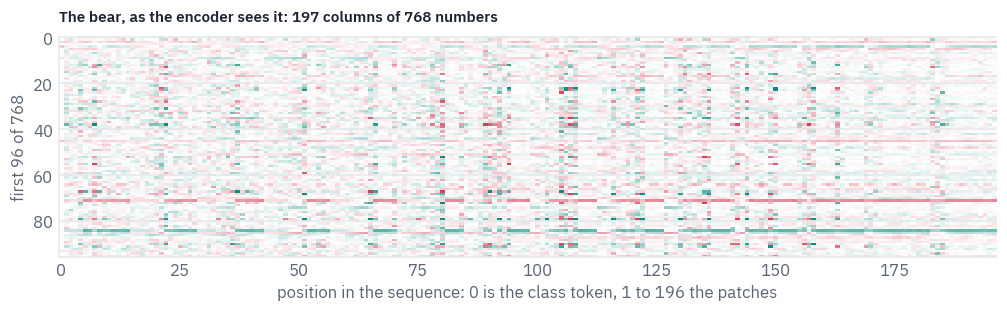
</code></pre></div></div> <pre class="tfs-printed"><code>class token: (1, 1, 768)  positions: (1, 197, 768)
the sequence the encoder reads: (197, 768)</code></pre> <p><img class="tfs-output" src="/assets/posts/arch/11/output-05.png" alt="The bear, as the encoder sees it: 197 columns of 768 numbers" loading="lazy"></p> <p>That is the whole conversion. From here on, a ViT is a Transformer encoder, the one from lesson 1: twelve blocks of attention and an MLP, then a final layer norm, and a linear layer on the class token’s output vector.</p> <p>Are the positions really needed? Attention compares every vector with every other one and sums the results, so without positions the encoder can’t tell a patch in the corner from the same patch in the centre.</p> <p>A test makes it concrete: shuffle the 196 patches, as if the photo were cut up and the pieces thrown in a bag. We do it twice, with the positions the model learned and with the positions removed. The <code class="language-plaintext highlighter-rouge">encode</code> function used here is the encoder of the next section.</p> <h2 id="3-the-vit-in-pytorch">3. The ViT in PyTorch</h2> <p>The encoder block puts the layer norm <em>before</em> attention and before the MLP, as GPT-2 and every model since do, not after them as BERT did; the MLP widens to 3,072 with a GELU, as in BERT. The attention keeps its weights on demand, for the pictures of section 4.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">Attention</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">heads</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span> <span class="o">=</span> <span class="n">heads</span><span class="p">,</span> <span class="n">d</span> <span class="o">//</span> <span class="n">heads</span>
        <span class="n">self</span><span class="p">.</span><span class="n">query</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">key</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">value</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">out</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="bp">False</span>
        <span class="n">self</span><span class="p">.</span><span class="n">weights</span> <span class="o">=</span> <span class="bp">None</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">b</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">d</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span>
        <span class="n">q</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">query</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">view</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
        <span class="n">k</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">key</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">view</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
        <span class="n">v</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">value</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">view</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">self</span><span class="p">.</span><span class="n">keep</span><span class="p">:</span>  <span class="c1"># the slow way, to see the weights
</span>            <span class="n">weights</span> <span class="o">=</span> <span class="p">(</span><span class="n">q</span> <span class="o">@</span> <span class="n">k</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">2</span><span class="p">)</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">)).</span><span class="nf">softmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
            <span class="n">self</span><span class="p">.</span><span class="n">weights</span> <span class="o">=</span> <span class="n">weights</span><span class="p">.</span><span class="nf">detach</span><span class="p">()</span>
            <span class="n">out</span> <span class="o">=</span> <span class="n">weights</span> <span class="o">@</span> <span class="n">v</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="n">out</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">scaled_dot_product_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">out</span><span class="p">(</span><span class="n">out</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">d</span><span class="p">))</span>


<span class="k">class</span> <span class="nc">Block</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">heads</span><span class="p">,</span> <span class="n">hidden</span><span class="p">,</span> <span class="n">eps</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm1</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">eps</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">attn</span> <span class="o">=</span> <span class="nc">Attention</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">heads</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm2</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">eps</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">fc1</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">hidden</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">fc2</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">hidden</span><span class="p">,</span> <span class="n">d</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">attn</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">norm1</span><span class="p">(</span><span class="n">x</span><span class="p">))</span>
        <span class="k">return</span> <span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">fc2</span><span class="p">(</span><span class="n">F</span><span class="p">.</span><span class="nf">gelu</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">fc1</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">norm2</span><span class="p">(</span><span class="n">x</span><span class="p">))))</span>
</code></pre></div></div> <p>The model is the five steps of section 2 followed by the blocks. <code class="language-plaintext highlighter-rouge">tokens</code> builds the sequence; <code class="language-plaintext highlighter-rouge">encode</code> runs the blocks on any sequence, which is what the shuffling test needs.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">ViT</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">,</span> <span class="n">classes</span><span class="p">,</span> <span class="n">image_size</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span><span class="p">,</span> <span class="n">p</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">patch_size</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">grid</span> <span class="o">=</span> <span class="p">(</span><span class="n">image_size</span> <span class="ow">or</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">image_size</span><span class="sh">"</span><span class="p">])</span> <span class="o">//</span> <span class="n">p</span>
        <span class="n">eps</span> <span class="o">=</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">layer_norm_eps</span><span class="sh">"</span><span class="p">,</span> <span class="mf">1e-6</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">patch_embed</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Conv2d</span><span class="p">(</span><span class="mi">3</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">kernel_size</span><span class="o">=</span><span class="n">p</span><span class="p">,</span> <span class="n">stride</span><span class="o">=</span><span class="n">p</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">cls</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">d</span><span class="p">))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">pos</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">grid</span> <span class="o">*</span> <span class="n">grid</span> <span class="o">+</span> <span class="mi">1</span><span class="p">,</span> <span class="n">d</span><span class="p">))</span>
        <span class="n">heads</span><span class="p">,</span> <span class="n">hidden</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">blocks</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">ModuleList</span><span class="p">(</span>
            <span class="p">[</span><span class="nc">Block</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">heads</span><span class="p">,</span> <span class="n">hidden</span><span class="p">,</span> <span class="n">eps</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">])]</span>
        <span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">eps</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">head</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">classes</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">tokens</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">pixels</span><span class="p">):</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">patch_embed</span><span class="p">(</span><span class="n">pixels</span><span class="p">).</span><span class="nf">flatten</span><span class="p">(</span><span class="mi">2</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>  <span class="c1"># (batch, 196, d)
</span>        <span class="n">x</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">self</span><span class="p">.</span><span class="n">cls</span><span class="p">.</span><span class="nf">expand</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">),</span> <span class="n">x</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>  <span class="c1"># (batch, 197, d)
</span>        <span class="k">return</span> <span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">pos</span>

    <span class="k">def</span> <span class="nf">encode</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="k">for</span> <span class="n">block</span> <span class="ow">in</span> <span class="n">self</span><span class="p">.</span><span class="n">blocks</span><span class="p">:</span>
            <span class="n">x</span> <span class="o">=</span> <span class="nf">block</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">pixels</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">head</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">encode</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">tokens</span><span class="p">(</span><span class="n">pixels</span><span class="p">))[:,</span> <span class="mi">0</span><span class="p">])</span>
</code></pre></div></div> <p>Google’s names differ from ours; one function renames them. The same function serves every ViT checkpoint in this lesson.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">rename</span><span class="p">(</span><span class="n">state</span><span class="p">):</span>
    <span class="n">short</span> <span class="o">=</span> <span class="p">{</span>
        <span class="sh">"</span><span class="s">embeddings.patch_embeddings.projection</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">patch_embed</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">embeddings.cls_token</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">cls</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">embeddings.position_embeddings</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">pos</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">layernorm</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">norm</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">classifier</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">head</span><span class="sh">"</span><span class="p">,</span>
    <span class="p">}</span>
    <span class="n">inside</span> <span class="o">=</span> <span class="p">{</span>
        <span class="sh">"</span><span class="s">attention.attention.</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attn.</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">attention.output.dense</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attn.out</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">layernorm_before</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">norm1</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">layernorm_after</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">norm2</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">intermediate.dense</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">fc1</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">output.dense</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">fc2</span><span class="sh">"</span><span class="p">,</span>
    <span class="p">}</span>
    <span class="n">out</span> <span class="o">=</span> <span class="p">{}</span>
    <span class="k">for</span> <span class="n">key</span><span class="p">,</span> <span class="n">value</span> <span class="ow">in</span> <span class="n">state</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
        <span class="n">key</span> <span class="o">=</span> <span class="n">key</span><span class="p">.</span><span class="nf">removeprefix</span><span class="p">(</span><span class="sh">"</span><span class="s">vit.</span><span class="sh">"</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">key</span><span class="p">.</span><span class="nf">startswith</span><span class="p">(</span><span class="sh">"</span><span class="s">pooler.</span><span class="sh">"</span><span class="p">):</span>
            <span class="k">continue</span>  <span class="c1"># a layer this checkpoint's classifier never used
</span>        <span class="k">if</span> <span class="n">key</span><span class="p">.</span><span class="nf">startswith</span><span class="p">(</span><span class="sh">"</span><span class="s">encoder.layer.</span><span class="sh">"</span><span class="p">):</span>
            <span class="n">number</span><span class="p">,</span> <span class="n">rest</span> <span class="o">=</span> <span class="n">key</span><span class="p">.</span><span class="nf">removeprefix</span><span class="p">(</span><span class="sh">"</span><span class="s">encoder.layer.</span><span class="sh">"</span><span class="p">).</span><span class="nf">split</span><span class="p">(</span><span class="sh">"</span><span class="s">.</span><span class="sh">"</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
            <span class="k">for</span> <span class="n">theirs</span><span class="p">,</span> <span class="n">ours</span> <span class="ow">in</span> <span class="n">inside</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
                <span class="n">rest</span> <span class="o">=</span> <span class="n">rest</span><span class="p">.</span><span class="nf">replace</span><span class="p">(</span><span class="n">theirs</span><span class="p">,</span> <span class="n">ours</span><span class="p">)</span>
            <span class="n">out</span><span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="s">blocks.</span><span class="si">{</span><span class="n">number</span><span class="si">}</span><span class="s">.</span><span class="si">{</span><span class="n">rest</span><span class="si">}</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">value</span>
            <span class="k">continue</span>
        <span class="k">for</span> <span class="n">theirs</span><span class="p">,</span> <span class="n">ours</span> <span class="ow">in</span> <span class="n">short</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
            <span class="k">if</span> <span class="n">key</span><span class="p">.</span><span class="nf">startswith</span><span class="p">(</span><span class="n">theirs</span><span class="p">):</span>
                <span class="n">key</span> <span class="o">=</span> <span class="n">ours</span> <span class="o">+</span> <span class="n">key</span><span class="p">[</span><span class="nf">len</span><span class="p">(</span><span class="n">theirs</span><span class="p">)</span> <span class="p">:]</span>
        <span class="n">out</span><span class="p">[</span><span class="n">key</span><span class="p">]</span> <span class="o">=</span> <span class="n">value</span>
    <span class="k">return</span> <span class="n">out</span>
</code></pre></div></div> <p>The check against Hugging Face, whose model was loaded in section 2, on all five photos at once.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">labels</span> <span class="o">=</span> <span class="p">{</span><span class="nf">int</span><span class="p">(</span><span class="n">k</span><span class="p">):</span> <span class="n">v</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="sh">"</span><span class="s">,</span><span class="sh">"</span><span class="p">)[</span><span class="mi">0</span><span class="p">]</span> <span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="ow">in</span> <span class="n">vit_config</span><span class="p">[</span><span class="sh">"</span><span class="s">id2label</span><span class="sh">"</span><span class="p">].</span><span class="nf">items</span><span class="p">()}</span>
<span class="n">vit</span> <span class="o">=</span> <span class="nc">ViT</span><span class="p">(</span><span class="n">vit_config</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">labels</span><span class="p">))</span>
<span class="n">vit</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">(</span><span class="nf">rename</span><span class="p">(</span><span class="n">hf_weights</span><span class="p">),</span> <span class="n">strict</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">vit</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>

<span class="n">batch</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">([</span><span class="nf">to_tensor</span><span class="p">(</span><span class="n">photo</span><span class="p">)</span> <span class="k">for</span> <span class="n">photo</span> <span class="ow">in</span> <span class="n">photos</span><span class="p">.</span><span class="nf">values</span><span class="p">()])</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">ours</span> <span class="o">=</span> <span class="nf">vit</span><span class="p">(</span><span class="n">batch</span><span class="p">)</span>
    <span class="n">theirs</span> <span class="o">=</span> <span class="nf">reference</span><span class="p">(</span><span class="n">pixel_values</span><span class="o">=</span><span class="n">batch</span><span class="p">).</span><span class="n">logits</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">batch:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">batch</span><span class="p">.</span><span class="n">shape</span><span class="p">),</span> <span class="sh">"</span><span class="s"> logits:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">ours</span><span class="p">.</span><span class="n">shape</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">max difference from Hugging Face:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="n">ours</span> <span class="o">-</span> <span class="n">theirs</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>batch: (5, 3, 224, 224)  logits: (5, 1000)
max difference from Hugging Face: 0.0e+00</code></pre> <p>Exact to the last bit: same operations, same order. Now the shuffling test from section 2, on the five photos.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">order</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randperm</span><span class="p">(</span><span class="n">grid</span> <span class="o">*</span> <span class="n">grid</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">predict</span><span class="p">(</span><span class="n">with_positions</span><span class="p">,</span> <span class="n">shuffled</span><span class="p">):</span>
    <span class="n">x</span> <span class="o">=</span> <span class="n">vit</span><span class="p">.</span><span class="nf">patch_embed</span><span class="p">(</span><span class="n">batch</span><span class="p">).</span><span class="nf">flatten</span><span class="p">(</span><span class="mi">2</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
    <span class="k">if</span> <span class="n">shuffled</span><span class="p">:</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">x</span><span class="p">[:,</span> <span class="n">order</span><span class="p">]</span>
    <span class="n">x</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">vit</span><span class="p">.</span><span class="n">cls</span><span class="p">.</span><span class="nf">expand</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">batch</span><span class="p">),</span> <span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">),</span> <span class="n">x</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
    <span class="k">if</span> <span class="n">with_positions</span><span class="p">:</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">x</span> <span class="o">+</span> <span class="n">vit</span><span class="p">.</span><span class="n">pos</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="n">probs</span> <span class="o">=</span> <span class="n">vit</span><span class="p">.</span><span class="nf">head</span><span class="p">(</span><span class="n">vit</span><span class="p">.</span><span class="nf">encode</span><span class="p">(</span><span class="n">x</span><span class="p">)[:,</span> <span class="mi">0</span><span class="p">]).</span><span class="nf">softmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">probs</span>


<span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">with_positions</span> <span class="ow">in</span> <span class="p">[</span><span class="bp">True</span><span class="p">,</span> <span class="bp">False</span><span class="p">]:</span>
    <span class="k">for</span> <span class="n">shuffled</span> <span class="ow">in</span> <span class="p">[</span><span class="bp">False</span><span class="p">,</span> <span class="bp">True</span><span class="p">]:</span>
        <span class="n">probs</span> <span class="o">=</span> <span class="nf">predict</span><span class="p">(</span><span class="n">with_positions</span><span class="p">,</span> <span class="n">shuffled</span><span class="p">)</span>
        <span class="n">row</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">positions</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">learned</span><span class="sh">"</span> <span class="k">if</span> <span class="n">with_positions</span> <span class="k">else</span> <span class="sh">"</span><span class="s">removed</span><span class="sh">"</span><span class="p">}</span>
        <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">patches</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="sh">"</span><span class="s">shuffled</span><span class="sh">"</span> <span class="k">if</span> <span class="n">shuffled</span> <span class="k">else</span> <span class="sh">"</span><span class="s">in order</span><span class="sh">"</span>
        <span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">p</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">photos</span><span class="p">,</span> <span class="n">probs</span><span class="p">):</span>
            <span class="n">row</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">labels</span><span class="p">[</span><span class="n">p</span><span class="p">.</span><span class="nf">argmax</span><span class="p">().</span><span class="nf">item</span><span class="p">()]</span><span class="si">}</span><span class="s"> </span><span class="si">{</span><span class="n">p</span><span class="p">.</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span>
        <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">row</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">positions</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">patches</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">bear</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">shuttle</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">lava</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">orca</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">hummingbird</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">learned</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">in order</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">brown bear 100%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">space shuttle 100%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">volcano 100%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">killer whale 100%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">hummingbird 100%</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">learned</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">shuffled</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">brown bear 83%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">projectile 58%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">volcano 100%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">kite 26%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">hummingbird 28%</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">removed</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">in order</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">golden retriever 50%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">honeycomb 65%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">volcano 43%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">black stork 14%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">bulbul 18%</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">removed</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">shuffled</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">golden retriever 50%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">honeycomb 65%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">volcano 43%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">black stork 14%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">bulbul 18%</td></tr></tbody></table></div> <p>Two things to read. Without positions, shuffled and ordered patches give <em>identical</em> answers, to the last digit: with nothing to say where a patch sits, the encoder treats the image as a bag of squares, and a bag has no order. That model also gets most photos wrong, because it was trained to rely on positions it no longer has.</p> <p>With positions, shuffling hurts some photos and not others: the bear’s fur and the lava’s red are recognisable in any order, while a shuttle cut into pieces looks like any projectile, and a shuffled orca becomes a kite, the bird of prey.</p> <p>ViTs are surprisingly robust to such shuffling, a finding Naseer and colleagues reported in 2021, and the reason is in the table: much of what identifies an object lives inside the patches themselves.</p> <p>The model’s own answers on the five photos, top five each:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">probs</span> <span class="o">=</span> <span class="n">ours</span><span class="p">.</span><span class="nf">softmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span>
    <span class="mi">2</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">photos</span><span class="p">),</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">13</span><span class="p">,</span> <span class="mf">4.8</span><span class="p">),</span> <span class="n">gridspec_kw</span><span class="o">=</span><span class="p">{</span><span class="sh">"</span><span class="s">height_ratios</span><span class="sh">"</span><span class="p">:</span> <span class="p">[</span><span class="mf">1.2</span><span class="p">,</span> <span class="mi">1</span><span class="p">]}</span>
<span class="p">)</span>
<span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">photo</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">photos</span><span class="p">.</span><span class="nf">values</span><span class="p">()):</span>
    <span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="n">k</span><span class="p">].</span><span class="nf">imshow</span><span class="p">(</span><span class="n">photo</span><span class="p">.</span><span class="nf">resize</span><span class="p">((</span><span class="n">SIZE</span><span class="p">,</span> <span class="n">SIZE</span><span class="p">)))</span>
    <span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="n">k</span><span class="p">].</span><span class="nf">axis</span><span class="p">(</span><span class="sh">"</span><span class="s">off</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">top</span> <span class="o">=</span> <span class="n">probs</span><span class="p">[</span><span class="n">k</span><span class="p">].</span><span class="nf">topk</span><span class="p">(</span><span class="mi">5</span><span class="p">)</span>
    <span class="n">names</span> <span class="o">=</span> <span class="p">[</span><span class="n">labels</span><span class="p">[</span><span class="n">i</span><span class="p">.</span><span class="nf">item</span><span class="p">()][:</span><span class="mi">18</span><span class="p">]</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">top</span><span class="p">.</span><span class="n">indices</span><span class="p">][::</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
    <span class="n">axes</span><span class="p">[</span><span class="mi">1</span><span class="p">,</span> <span class="n">k</span><span class="p">].</span><span class="nf">barh</span><span class="p">(</span><span class="n">names</span><span class="p">,</span> <span class="n">top</span><span class="p">.</span><span class="n">values</span><span class="p">.</span><span class="nf">flip</span><span class="p">(</span><span class="mi">0</span><span class="p">).</span><span class="nf">numpy</span><span class="p">(),</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">])</span>
    <span class="n">axes</span><span class="p">[</span><span class="mi">1</span><span class="p">,</span> <span class="n">k</span><span class="p">].</span><span class="nf">set_xlim</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
    <span class="n">axes</span><span class="p">[</span><span class="mi">1</span><span class="p">,</span> <span class="n">k</span><span class="p">].</span><span class="nf">tick_params</span><span class="p">(</span><span class="n">labelsize</span><span class="o">=</span><span class="mi">8</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">tight_layout</span><span class="p">()</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/11/output-06.png" alt="Output of the code above" loading="lazy"></p> <h2 id="4-what-the-model-learned">4. What the model learned</h2> <p><strong>The first layer.</strong> The patch embedding’s 768 filters are 768 small pictures, each a pattern the model compares a patch against.</p> <p>Their principal components, the directions along which the filters vary most, show what kind of patterns those are. The ViT paper drew the same picture for its large model.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">filters</span> <span class="o">=</span> <span class="n">vit</span><span class="p">.</span><span class="n">patch_embed</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="nf">detach</span><span class="p">().</span><span class="nf">reshape</span><span class="p">(</span><span class="n">vit</span><span class="p">.</span><span class="n">patch_embed</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="o">-</span><span class="mi">1</span><span class="p">)</span>
<span class="n">centered</span> <span class="o">=</span> <span class="n">filters</span> <span class="o">-</span> <span class="n">filters</span><span class="p">.</span><span class="nf">mean</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>
<span class="n">_</span><span class="p">,</span> <span class="n">_</span><span class="p">,</span> <span class="n">directions</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="nf">svd</span><span class="p">(</span><span class="n">centered</span><span class="p">,</span> <span class="n">full_matrices</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">n_show</span> <span class="o">=</span> <span class="nf">min</span><span class="p">(</span><span class="mi">28</span><span class="p">,</span> <span class="n">directions</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">])</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="mi">4</span><span class="p">,</span> <span class="mi">7</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">8.4</span><span class="p">,</span> <span class="mf">4.8</span><span class="p">))</span>
<span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">ax</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">axes</span><span class="p">.</span><span class="n">flat</span><span class="p">):</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">axis</span><span class="p">(</span><span class="sh">"</span><span class="s">off</span><span class="sh">"</span><span class="p">)</span>
    <span class="k">if</span> <span class="n">k</span> <span class="o">&gt;=</span> <span class="n">n_show</span><span class="p">:</span>
        <span class="k">continue</span>
    <span class="n">picture</span> <span class="o">=</span> <span class="n">directions</span><span class="p">[</span><span class="n">k</span><span class="p">].</span><span class="nf">reshape</span><span class="p">(</span><span class="mi">3</span><span class="p">,</span> <span class="n">PATCH</span><span class="p">,</span> <span class="n">PATCH</span><span class="p">).</span><span class="nf">permute</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">0</span><span class="p">)</span>
    <span class="n">picture</span> <span class="o">=</span> <span class="p">(</span><span class="n">picture</span> <span class="o">-</span> <span class="n">picture</span><span class="p">.</span><span class="nf">min</span><span class="p">())</span> <span class="o">/</span> <span class="p">(</span><span class="n">picture</span><span class="p">.</span><span class="nf">max</span><span class="p">()</span> <span class="o">-</span> <span class="n">picture</span><span class="p">.</span><span class="nf">min</span><span class="p">())</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">imshow</span><span class="p">(</span><span class="n">picture</span><span class="p">,</span> <span class="n">interpolation</span><span class="o">=</span><span class="sh">"</span><span class="s">nearest</span><span class="sh">"</span><span class="p">)</span>
<span class="n">fig</span><span class="p">.</span><span class="nf">suptitle</span><span class="p">(</span><span class="sh">"</span><span class="s">The 28 main directions of ViT-B/16</span><span class="sh">'</span><span class="s">s patch filters</span><span class="sh">"</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">11</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/11/output-07.png" alt="Output of the code above" loading="lazy"></p> <p>Blobs of colour, colour-opponent pairs, then edges and spots at every orientation, then finer and finer textures: much the same basis as the first layer of a CNN, which also learns edge and colour detectors. Nobody built them in; they are what is useful for describing a 16×16 square of a natural image.</p> <p><strong>The positions.</strong> Each of the 196 position embeddings is a vector of 768 numbers that the model learned with no hint that the patches form a grid. Compare each position with every other one by cosine similarity, and draw the result for each place in the grid as a small map:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">pos</span> <span class="o">=</span> <span class="n">vit</span><span class="p">.</span><span class="n">pos</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">:].</span><span class="nf">detach</span><span class="p">()</span>
<span class="n">similarity</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">cosine_similarity</span><span class="p">(</span><span class="n">pos</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">],</span> <span class="n">pos</span><span class="p">[</span><span class="bp">None</span><span class="p">],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
<span class="n">similarity</span> <span class="o">=</span> <span class="n">similarity</span><span class="p">.</span><span class="nf">reshape</span><span class="p">(</span><span class="n">grid</span><span class="p">,</span> <span class="n">grid</span><span class="p">,</span> <span class="n">grid</span><span class="p">,</span> <span class="n">grid</span><span class="p">)</span>
<span class="n">step</span> <span class="o">=</span> <span class="mi">2</span>  <span class="c1"># every second row and column, so that the maps stay readable
</span><span class="n">picked</span> <span class="o">=</span> <span class="nf">list</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">grid</span><span class="p">,</span> <span class="n">step</span><span class="p">))</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">picked</span><span class="p">),</span> <span class="nf">len</span><span class="p">(</span><span class="n">picked</span><span class="p">),</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">7.6</span><span class="p">,</span> <span class="mf">7.6</span><span class="p">))</span>
<span class="k">for</span> <span class="n">a</span><span class="p">,</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">picked</span><span class="p">):</span>
    <span class="k">for</span> <span class="n">b</span><span class="p">,</span> <span class="n">j</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">picked</span><span class="p">):</span>
        <span class="n">axes</span><span class="p">[</span><span class="n">a</span><span class="p">,</span> <span class="n">b</span><span class="p">].</span><span class="nf">imshow</span><span class="p">(</span>
            <span class="n">similarity</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="n">j</span><span class="p">],</span> <span class="n">cmap</span><span class="o">=</span><span class="n">signed</span><span class="p">,</span> <span class="n">vmin</span><span class="o">=-</span><span class="mi">1</span><span class="p">,</span> <span class="n">vmax</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">interpolation</span><span class="o">=</span><span class="sh">"</span><span class="s">nearest</span><span class="sh">"</span>
        <span class="p">)</span>
        <span class="n">axes</span><span class="p">[</span><span class="n">a</span><span class="p">,</span> <span class="n">b</span><span class="p">].</span><span class="nf">set_xticks</span><span class="p">([])</span>
        <span class="n">axes</span><span class="p">[</span><span class="n">a</span><span class="p">,</span> <span class="n">b</span><span class="p">].</span><span class="nf">set_yticks</span><span class="p">([])</span>
<span class="n">fig</span><span class="p">.</span><span class="nf">suptitle</span><span class="p">(</span>
    <span class="sh">"</span><span class="s">Each map: one grid position against all 196, by cosine similarity</span><span class="sh">"</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">11</span>
<span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/11/output-08.png" alt="Output of the code above" loading="lazy"></p> <p>Every map is strongest exactly where its position is, with a halo around it and bands of rose along its own row and column.</p> <p>The model rediscovered the two-dimensional grid from a one-dimensional list of 196 slots, simply because knowing which patches are neighbours, and which share a row or a column, helps it classify. The ViT paper tried position embeddings designed for two dimensions and found no gain; this picture is why.</p> <p><strong>How far the heads look.</strong> For each head, the <em>mean attention distance</em> is the distance in pixels between a patch and the patches it attends to, averaged with the attention weights. A head that looks at its neighbours has a small distance, one that looks across the whole image a large one.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">for</span> <span class="n">block</span> <span class="ow">in</span> <span class="n">vit</span><span class="p">.</span><span class="n">blocks</span><span class="p">:</span>
    <span class="n">block</span><span class="p">.</span><span class="n">attn</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="bp">True</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="nf">vit</span><span class="p">(</span><span class="n">batch</span><span class="p">)</span>
<span class="n">centres</span> <span class="o">=</span> <span class="p">(</span>
    <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">(</span>
        <span class="n">torch</span><span class="p">.</span><span class="nf">meshgrid</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">grid</span><span class="p">),</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">grid</span><span class="p">),</span> <span class="n">indexing</span><span class="o">=</span><span class="sh">"</span><span class="s">ij</span><span class="sh">"</span><span class="p">),</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span>
    <span class="p">)</span>
    <span class="p">.</span><span class="nf">reshape</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
    <span class="p">.</span><span class="nf">float</span><span class="p">()</span>
    <span class="o">*</span> <span class="n">PATCH</span>
<span class="p">)</span>
<span class="n">pixels_apart</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cdist</span><span class="p">(</span><span class="n">centres</span><span class="p">,</span> <span class="n">centres</span><span class="p">)</span>  <span class="c1"># (196, 196)
</span><span class="n">distance</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">block</span> <span class="ow">in</span> <span class="n">vit</span><span class="p">.</span><span class="n">blocks</span><span class="p">:</span>
    <span class="n">w</span> <span class="o">=</span> <span class="n">block</span><span class="p">.</span><span class="n">attn</span><span class="p">.</span><span class="n">weights</span><span class="p">[:,</span> <span class="p">:,</span> <span class="mi">1</span><span class="p">:,</span> <span class="mi">1</span><span class="p">:]</span>  <span class="c1"># patches to patches, without the class token
</span>    <span class="n">w</span> <span class="o">=</span> <span class="n">w</span> <span class="o">/</span> <span class="n">w</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">distance</span><span class="p">.</span><span class="nf">append</span><span class="p">((</span><span class="n">w</span> <span class="o">*</span> <span class="n">pixels_apart</span><span class="p">).</span><span class="nf">sum</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">).</span><span class="nf">mean</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">2</span><span class="p">)))</span>  <span class="c1"># one number per head
</span><span class="n">distance</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">(</span><span class="n">distance</span><span class="p">)</span>  <span class="c1"># (layers, heads)
</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">7</span><span class="p">,</span> <span class="mf">3.6</span><span class="p">))</span>
<span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">distance</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]):</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">scatter</span><span class="p">(</span>
        <span class="p">[</span><span class="n">layer</span><span class="p">]</span> <span class="o">*</span> <span class="n">distance</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="n">distance</span><span class="p">[</span><span class="n">layer</span><span class="p">],</span> <span class="n">s</span><span class="o">=</span><span class="mi">18</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">],</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.8</span>
    <span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">layer</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">mean attention distance, pixels</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">Every dot is one head, averaged over the five photos</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/11/output-09.png" alt="Every dot is one head, averaged over the five photos" loading="lazy"></p> <p>In the first layers the heads split: some look mostly at their neighbourhood, a patch or two away, like a convolution; others already look across the whole image, something a CNN can only do after many layers.</p> <p>By the last layers every head looks far. The ViT paper reported the same spread; it is the clearest sign that the model learned a locality that a CNN has built in, and learned to drop it where it doesn’t help.</p> <p><strong>What decides the answer.</strong> The class token’s attention to the patches shows what it gathered, but a single layer tells little, because the token mixes with everything at every layer.</p> <p><em>Attention rollout</em> (Abnar and Zuidema, 2020) multiplies the attention matrices of all layers, each averaged over heads and mixed half and half with the identity for the residual connection, and reads the class token’s row of the product.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">n</span> <span class="o">=</span> <span class="n">batch</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
<span class="n">rollout</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">eye</span><span class="p">(</span><span class="n">grid</span> <span class="o">*</span> <span class="n">grid</span> <span class="o">+</span> <span class="mi">1</span><span class="p">).</span><span class="nf">repeat</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
<span class="k">for</span> <span class="n">block</span> <span class="ow">in</span> <span class="n">vit</span><span class="p">.</span><span class="n">blocks</span><span class="p">:</span>
    <span class="n">a</span> <span class="o">=</span> <span class="n">block</span><span class="p">.</span><span class="n">attn</span><span class="p">.</span><span class="n">weights</span><span class="p">.</span><span class="nf">mean</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>  <span class="c1"># (photos, 197, 197), averaged over heads
</span>    <span class="n">a</span> <span class="o">=</span> <span class="mf">0.5</span> <span class="o">*</span> <span class="n">a</span> <span class="o">+</span> <span class="mf">0.5</span> <span class="o">*</span> <span class="n">torch</span><span class="p">.</span><span class="nf">eye</span><span class="p">(</span><span class="n">grid</span> <span class="o">*</span> <span class="n">grid</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span>  <span class="c1"># the residual path
</span>    <span class="n">a</span> <span class="o">=</span> <span class="n">a</span> <span class="o">/</span> <span class="n">a</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">rollout</span> <span class="o">=</span> <span class="n">a</span> <span class="o">@</span> <span class="n">rollout</span>
    <span class="n">block</span><span class="p">.</span><span class="n">attn</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="bp">False</span>
<span class="n">maps</span> <span class="o">=</span> <span class="n">rollout</span><span class="p">[:,</span> <span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">:].</span><span class="nf">reshape</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="n">grid</span><span class="p">,</span> <span class="n">grid</span><span class="p">)</span>

<span class="n">violet</span> <span class="o">=</span> <span class="nf">to_rgb</span><span class="p">(</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">])</span>
<span class="c1"># from clear to violet, laid over the photo
</span><span class="n">glow</span> <span class="o">=</span> <span class="n">LinearSegmentedColormap</span><span class="p">.</span><span class="nf">from_list</span><span class="p">(</span><span class="sh">"</span><span class="s">glow</span><span class="sh">"</span><span class="p">,</span> <span class="p">[(</span><span class="o">*</span><span class="n">violet</span><span class="p">,</span> <span class="mf">0.0</span><span class="p">),</span> <span class="p">(</span><span class="o">*</span><span class="n">violet</span><span class="p">,</span> <span class="mf">0.9</span><span class="p">)])</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">13</span><span class="p">,</span> <span class="mf">2.9</span><span class="p">))</span>
<span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">photo</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">photos</span><span class="p">.</span><span class="nf">values</span><span class="p">()):</span>
    <span class="n">heat</span> <span class="o">=</span> <span class="p">(</span><span class="n">maps</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="o">/</span> <span class="n">maps</span><span class="p">[</span><span class="n">k</span><span class="p">].</span><span class="nf">max</span><span class="p">()).</span><span class="nf">numpy</span><span class="p">()</span>
    <span class="n">axes</span><span class="p">[</span><span class="n">k</span><span class="p">].</span><span class="nf">imshow</span><span class="p">(</span><span class="n">photo</span><span class="p">.</span><span class="nf">resize</span><span class="p">((</span><span class="n">SIZE</span><span class="p">,</span> <span class="n">SIZE</span><span class="p">)).</span><span class="nf">convert</span><span class="p">(</span><span class="sh">"</span><span class="s">L</span><span class="sh">"</span><span class="p">),</span> <span class="n">cmap</span><span class="o">=</span><span class="n">greys</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.75</span><span class="p">)</span>
    <span class="n">axes</span><span class="p">[</span><span class="n">k</span><span class="p">].</span><span class="nf">imshow</span><span class="p">(</span>
        <span class="n">heat</span><span class="p">,</span> <span class="n">cmap</span><span class="o">=</span><span class="n">glow</span><span class="p">,</span> <span class="n">extent</span><span class="o">=</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">SIZE</span><span class="p">,</span> <span class="n">SIZE</span><span class="p">,</span> <span class="mi">0</span><span class="p">),</span> <span class="n">interpolation</span><span class="o">=</span><span class="sh">"</span><span class="s">bilinear</span><span class="sh">"</span>
    <span class="p">)</span>
    <span class="n">axes</span><span class="p">[</span><span class="n">k</span><span class="p">].</span><span class="nf">set_title</span><span class="p">(</span><span class="n">labels</span><span class="p">[</span><span class="n">ours</span><span class="p">[</span><span class="n">k</span><span class="p">].</span><span class="nf">argmax</span><span class="p">().</span><span class="nf">item</span><span class="p">()],</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">10</span><span class="p">)</span>
    <span class="n">axes</span><span class="p">[</span><span class="n">k</span><span class="p">].</span><span class="nf">axis</span><span class="p">(</span><span class="sh">"</span><span class="s">off</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/11/output-10.png" alt="Output of the code above" loading="lazy"></p> <p>The violet regions are the bear’s head and the fish, the shuttle’s nose rather than its plume, the orca’s body, the hummingbird. The model was never told where the objects are; its answer simply rests on them.</p> <p>Rollout is a rough tool, a product of averages that ignores the MLPs, but it is cheap and often right about where to look.</p> <h2 id="5-a-bigger-image-and-stretched-positions">5. A bigger image, and stretched positions</h2> <p>More pixels per object help, and the ViT paper <a href="/blog/2025/adapters/">fine-tuned</a> its models at 384×384. With the same 16-pixel patches the grid becomes 24 × 24 and the sequence 577 tokens long.</p> <p>The patch embedding and the encoder don’t care, they work on any number of tokens; only the position embeddings, learned for a 14 × 14 grid, have to change.</p> <p>The paper’s answer is lesson 9’s answer in two dimensions: <em>interpolate</em> them, treating the 196 vectors as a 14 × 14 image with 768 channels and resizing it.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">stretch_positions</span><span class="p">(</span><span class="n">pos</span><span class="p">,</span> <span class="n">new_grid</span><span class="p">):</span>
    <span class="n">cls_pos</span><span class="p">,</span> <span class="n">grid_pos</span> <span class="o">=</span> <span class="n">pos</span><span class="p">[:,</span> <span class="p">:</span><span class="mi">1</span><span class="p">],</span> <span class="n">pos</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">:]</span>
    <span class="n">old_grid</span> <span class="o">=</span> <span class="nf">int</span><span class="p">(</span><span class="n">grid_pos</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span> <span class="o">**</span> <span class="mf">0.5</span><span class="p">)</span>
    <span class="n">d</span> <span class="o">=</span> <span class="n">grid_pos</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
    <span class="n">grid_pos</span> <span class="o">=</span> <span class="n">grid_pos</span><span class="p">.</span><span class="nf">reshape</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">old_grid</span><span class="p">,</span> <span class="n">old_grid</span><span class="p">,</span> <span class="n">d</span><span class="p">).</span><span class="nf">permute</span><span class="p">(</span>
        <span class="mi">0</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">2</span>
    <span class="p">)</span>  <span class="c1"># (1, d, 14, 14)
</span>    <span class="n">grid_pos</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">interpolate</span><span class="p">(</span>
        <span class="n">grid_pos</span><span class="p">,</span> <span class="n">size</span><span class="o">=</span><span class="p">(</span><span class="n">new_grid</span><span class="p">,</span> <span class="n">new_grid</span><span class="p">),</span> <span class="n">mode</span><span class="o">=</span><span class="sh">"</span><span class="s">bicubic</span><span class="sh">"</span><span class="p">,</span> <span class="n">align_corners</span><span class="o">=</span><span class="bp">False</span>
    <span class="p">)</span>
    <span class="n">grid_pos</span> <span class="o">=</span> <span class="n">grid_pos</span><span class="p">.</span><span class="nf">permute</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">1</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">new_grid</span> <span class="o">*</span> <span class="n">new_grid</span><span class="p">,</span> <span class="n">d</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">cls_pos</span><span class="p">,</span> <span class="n">grid_pos</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>


<span class="n">BIG</span> <span class="o">=</span> <span class="mi">384</span>
<span class="n">big</span> <span class="o">=</span> <span class="nc">ViT</span><span class="p">(</span><span class="n">vit_config</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">labels</span><span class="p">),</span> <span class="n">image_size</span><span class="o">=</span><span class="n">BIG</span><span class="p">)</span>
<span class="n">weights</span> <span class="o">=</span> <span class="nf">rename</span><span class="p">(</span><span class="n">hf_weights</span><span class="p">)</span>
<span class="n">weights</span><span class="p">[</span><span class="sh">"</span><span class="s">pos</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="nf">stretch_positions</span><span class="p">(</span><span class="n">weights</span><span class="p">[</span><span class="sh">"</span><span class="s">pos</span><span class="sh">"</span><span class="p">],</span> <span class="n">BIG</span> <span class="o">//</span> <span class="n">PATCH</span><span class="p">)</span>
<span class="n">big</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">(</span><span class="n">weights</span><span class="p">,</span> <span class="n">strict</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">big</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>
<span class="n">big_batch</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">([</span><span class="nf">to_tensor</span><span class="p">(</span><span class="n">photo</span><span class="p">,</span> <span class="n">size</span><span class="o">=</span><span class="n">BIG</span><span class="p">)</span> <span class="k">for</span> <span class="n">photo</span> <span class="ow">in</span> <span class="n">photos</span><span class="p">.</span><span class="nf">values</span><span class="p">()])</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">big_probs</span> <span class="o">=</span> <span class="nf">big</span><span class="p">(</span><span class="n">big_batch</span><span class="p">).</span><span class="nf">softmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">tokens at 224:</span><span class="sh">"</span><span class="p">,</span> <span class="n">grid</span> <span class="o">*</span> <span class="n">grid</span> <span class="o">+</span> <span class="mi">1</span><span class="p">,</span> <span class="sh">"</span><span class="s"> at 384:</span><span class="sh">"</span><span class="p">,</span> <span class="p">(</span><span class="n">BIG</span> <span class="o">//</span> <span class="n">PATCH</span><span class="p">)</span> <span class="o">**</span> <span class="mi">2</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span>
<span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">name</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">photos</span><span class="p">):</span>
    <span class="n">small_answer</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">labels</span><span class="p">[</span><span class="n">probs</span><span class="p">[</span><span class="n">k</span><span class="p">].</span><span class="nf">argmax</span><span class="p">().</span><span class="nf">item</span><span class="p">()]</span><span class="si">}</span><span class="s"> </span><span class="si">{</span><span class="n">probs</span><span class="p">[</span><span class="n">k</span><span class="p">].</span><span class="nf">max</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span>
    <span class="n">big_answer</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">labels</span><span class="p">[</span><span class="n">big_probs</span><span class="p">[</span><span class="n">k</span><span class="p">].</span><span class="nf">argmax</span><span class="p">().</span><span class="nf">item</span><span class="p">()]</span><span class="si">}</span><span class="s"> </span><span class="si">{</span><span class="n">big_probs</span><span class="p">[</span><span class="n">k</span><span class="p">].</span><span class="nf">max</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">name</span><span class="si">:</span><span class="mi">12</span><span class="si">}</span><span class="s"> 224: </span><span class="si">{</span><span class="n">small_answer</span><span class="si">:</span><span class="mi">28</span><span class="si">}</span><span class="s"> 384: </span><span class="si">{</span><span class="n">big_answer</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>tokens at 224: 197  at 384: 577
bear         224: brown bear 100%              384: brown bear 100%
shuttle      224: space shuttle 100%           384: space shuttle 100%
lava         224: volcano 100%                 384: volcano 100%
orca         224: killer whale 100%            384: killer whale 100%
hummingbird  224: hummingbird 100%             384: hummingbird 100%</code></pre> <p>Without a single step of training, the model reads three times as many patches and still names every photo, as sure of itself as before.</p> <p>These photos are easy; on harder images the stretched positions, close to but not the same as anything the model saw, are worth a short fine-tuning at the new size, which is what the ViT paper did.</p> <p>The price of resolution is the length of the sequence, and attention’s cost grows with its square. The patch size sets the trade-off:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">cost</span> <span class="o">=</span> <span class="p">[]</span>
<span class="n">d</span><span class="p">,</span> <span class="n">layers</span> <span class="o">=</span> <span class="n">vit_config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">vit_config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">]</span>
<span class="k">for</span> <span class="n">size</span> <span class="ow">in</span> <span class="p">[</span><span class="mi">224</span><span class="p">,</span> <span class="mi">384</span><span class="p">,</span> <span class="mi">512</span><span class="p">]:</span>
    <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="p">[</span><span class="mi">32</span><span class="p">,</span> <span class="mi">16</span><span class="p">,</span> <span class="mi">14</span><span class="p">,</span> <span class="mi">8</span><span class="p">]:</span>
        <span class="n">n_tokens</span> <span class="o">=</span> <span class="p">(</span><span class="n">size</span> <span class="o">//</span> <span class="n">p</span><span class="p">)</span> <span class="o">**</span> <span class="mi">2</span> <span class="o">+</span> <span class="mi">1</span>
        <span class="n">linear</span> <span class="o">=</span> <span class="p">(</span>
            <span class="n">layers</span> <span class="o">*</span> <span class="n">n_tokens</span> <span class="o">*</span> <span class="mi">12</span> <span class="o">*</span> <span class="n">d</span> <span class="o">*</span> <span class="n">d</span> <span class="o">*</span> <span class="mi">2</span>
        <span class="p">)</span>  <span class="c1"># projections and the MLP, two flops a weight
</span>        <span class="n">attention</span> <span class="o">=</span> <span class="n">layers</span> <span class="o">*</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">n_tokens</span> <span class="o">*</span> <span class="n">n_tokens</span> <span class="o">*</span> <span class="n">d</span> <span class="o">*</span> <span class="mi">2</span>  <span class="c1"># scores and the weighted sum
</span>        <span class="n">cost</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
            <span class="p">{</span>
                <span class="sh">"</span><span class="s">image</span><span class="sh">"</span><span class="p">:</span> <span class="n">size</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">patch</span><span class="sh">"</span><span class="p">:</span> <span class="n">p</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">tokens</span><span class="sh">"</span><span class="p">:</span> <span class="n">n_tokens</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">GFLOPs</span><span class="sh">"</span><span class="p">:</span> <span class="p">(</span><span class="n">linear</span> <span class="o">+</span> <span class="n">attention</span><span class="p">)</span> <span class="o">/</span> <span class="mf">1e9</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">attention</span><span class="sh">'</span><span class="s">s share</span><span class="sh">"</span><span class="p">:</span> <span class="n">attention</span> <span class="o">/</span> <span class="p">(</span><span class="n">linear</span> <span class="o">+</span> <span class="n">attention</span><span class="p">),</span>
            <span class="p">}</span>
        <span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">cost</span><span class="p">),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">image</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">patch</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">tokens</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">GFLOPs</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">attention's share</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">224</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">50</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8.59</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.01</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">224</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">16</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">197</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">34.89</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.04</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">224</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">14</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">257</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">46.09</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.05</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">224</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">785</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">156.06</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.15</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">384</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">145</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">25.41</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.03</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">384</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">16</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">577</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">110.29</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.11</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">384</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">14</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">730</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">143.65</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.14</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">384</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,305</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">587.41</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.33</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">512</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">257</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">46.09</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.05</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">512</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">16</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,025</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">212.85</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.18</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">512</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">14</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,297</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">282.33</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.22</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">512</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4,097</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,314.73</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.47</td></tr></tbody></table></div> <p>At 224 pixels with 16-pixel patches attention is a small part of the work; at 512 pixels with 8-pixel patches it approaches half of it, and the share keeps growing with every step up.</p> <p>This is why the vision encoders of today’s chat models cut images into tiles and why their patch sizes are 14 or 16 and not smaller: every halving of the patch quadruples the sequence.</p> <h2 id="6-attention-that-finds-objects-without-labels">6. Attention that finds objects without labels</h2> <p>Everything so far was learned from labels, a thousand ImageNet classes. In 2021 Mathilde Caron and colleagues at Facebook AI trained ViTs with <em>no</em> labels at all, by self-distillation: a student network learns to give the same output for a small crop of a photo that a slowly updated copy of itself, the teacher, gives for a large crop.</p> <p>They called the method DINO, and noticed something nobody had asked for: the attention of the class token in the last layer outlined the objects in a photo, a segmentation learned from no segmentation at all.</p> <p>DINO’s small ViT with 8-pixel patches is the same architecture as ours with other numbers, so it loads into our class. It was trained with the usual ImageNet normalisation, a different mean and deviation per channel.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">DINO</span> <span class="o">=</span> <span class="sh">"</span><span class="s">facebook/dino-vits8</span><span class="sh">"</span>
<span class="n">IMAGENET_MEAN</span><span class="p">,</span> <span class="n">IMAGENET_STD</span> <span class="o">=</span> <span class="p">[</span><span class="mf">0.485</span><span class="p">,</span> <span class="mf">0.456</span><span class="p">,</span> <span class="mf">0.406</span><span class="p">],</span> <span class="p">[</span><span class="mf">0.229</span><span class="p">,</span> <span class="mf">0.224</span><span class="p">,</span> <span class="mf">0.225</span><span class="p">]</span>
<span class="k">if</span> <span class="n">SMOKE</span><span class="p">:</span>
    <span class="n">dino_config</span> <span class="o">=</span> <span class="p">{</span><span class="o">**</span><span class="n">vit_config</span><span class="p">,</span> <span class="sh">"</span><span class="s">patch_size</span><span class="sh">"</span><span class="p">:</span> <span class="mi">8</span><span class="p">,</span> <span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">:</span> <span class="mi">4</span><span class="p">}</span>
    <span class="n">dino</span> <span class="o">=</span> <span class="nc">ViT</span><span class="p">(</span><span class="n">dino_config</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
<span class="k">else</span><span class="p">:</span>
    <span class="n">dino_config</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">DINO</span><span class="p">,</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">)))</span>
    <span class="n">dino</span> <span class="o">=</span> <span class="nc">ViT</span><span class="p">(</span><span class="n">dino_config</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
    <span class="n">dino_state</span> <span class="o">=</span> <span class="nf">rename</span><span class="p">(</span><span class="nf">load_file</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">DINO</span><span class="p">,</span> <span class="sh">"</span><span class="s">model.safetensors</span><span class="sh">"</span><span class="p">)))</span>
    <span class="n">missing</span> <span class="o">=</span> <span class="n">dino</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">(</span><span class="n">dino_state</span><span class="p">,</span> <span class="n">strict</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">only the classifier is missing:</span><span class="sh">"</span><span class="p">,</span> <span class="n">missing</span><span class="p">.</span><span class="n">missing_keys</span><span class="p">)</span>
<span class="n">dino</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>

<span class="n">dino_batch</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">photo</span> <span class="ow">in</span> <span class="n">photos</span><span class="p">.</span><span class="nf">values</span><span class="p">():</span>
    <span class="n">dino_batch</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="nf">to_tensor</span><span class="p">(</span><span class="n">photo</span><span class="p">,</span> <span class="n">mean</span><span class="o">=</span><span class="n">IMAGENET_MEAN</span><span class="p">,</span> <span class="n">std</span><span class="o">=</span><span class="n">IMAGENET_STD</span><span class="p">))</span>
<span class="n">dino_batch</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">(</span><span class="n">dino_batch</span><span class="p">)</span>
<span class="n">last</span> <span class="o">=</span> <span class="n">dino</span><span class="p">.</span><span class="n">blocks</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">].</span><span class="n">attn</span>
<span class="n">last</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="bp">True</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">dino</span><span class="p">.</span><span class="nf">encode</span><span class="p">(</span><span class="n">dino</span><span class="p">.</span><span class="nf">tokens</span><span class="p">(</span><span class="n">dino_batch</span><span class="p">))</span>
<span class="n">last</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="bp">False</span>
<span class="n">side</span> <span class="o">=</span> <span class="n">SIZE</span> <span class="o">//</span> <span class="n">dino_config</span><span class="p">[</span><span class="sh">"</span><span class="s">patch_size</span><span class="sh">"</span><span class="p">]</span>
<span class="n">heads</span> <span class="o">=</span> <span class="n">last</span><span class="p">.</span><span class="n">weights</span><span class="p">[:,</span> <span class="p">:,</span> <span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">:].</span><span class="nf">reshape</span><span class="p">(</span>
    <span class="nf">len</span><span class="p">(</span><span class="n">photos</span><span class="p">),</span> <span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="n">side</span><span class="p">,</span> <span class="n">side</span>
<span class="p">)</span>  <span class="c1"># (photos, heads, 28, 28)
</span><span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">one map per head:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">heads</span><span class="p">.</span><span class="n">shape</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>only the classifier is missing: ['head.weight', 'head.bias']
one map per head: (5, 6, 28, 28)</code></pre> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">shades</span> <span class="o">=</span> <span class="n">LinearSegmentedColormap</span><span class="p">.</span><span class="nf">from_list</span><span class="p">(</span><span class="sh">"</span><span class="s">shades</span><span class="sh">"</span><span class="p">,</span> <span class="p">[</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">card</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">]])</span>
<span class="n">show</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">bear</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">shuttle</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">orca</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">hummingbird</span><span class="sh">"</span><span class="p">]</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">show</span><span class="p">),</span> <span class="n">heads</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span> <span class="o">+</span> <span class="mi">1</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">13</span><span class="p">,</span> <span class="mf">2.1</span> <span class="o">*</span> <span class="nf">len</span><span class="p">(</span><span class="n">show</span><span class="p">)))</span>
<span class="k">for</span> <span class="n">r</span><span class="p">,</span> <span class="n">name</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">show</span><span class="p">):</span>
    <span class="n">k</span> <span class="o">=</span> <span class="nf">list</span><span class="p">(</span><span class="n">photos</span><span class="p">).</span><span class="nf">index</span><span class="p">(</span><span class="n">name</span><span class="p">)</span>
    <span class="n">axes</span><span class="p">[</span><span class="n">r</span><span class="p">,</span> <span class="mi">0</span><span class="p">].</span><span class="nf">imshow</span><span class="p">(</span><span class="n">photos</span><span class="p">[</span><span class="n">name</span><span class="p">].</span><span class="nf">resize</span><span class="p">((</span><span class="n">SIZE</span><span class="p">,</span> <span class="n">SIZE</span><span class="p">)))</span>
    <span class="k">for</span> <span class="n">h</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">heads</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]):</span>
        <span class="n">axes</span><span class="p">[</span><span class="n">r</span><span class="p">,</span> <span class="n">h</span> <span class="o">+</span> <span class="mi">1</span><span class="p">].</span><span class="nf">imshow</span><span class="p">(</span><span class="n">heads</span><span class="p">[</span><span class="n">k</span><span class="p">,</span> <span class="n">h</span><span class="p">],</span> <span class="n">cmap</span><span class="o">=</span><span class="n">shades</span><span class="p">,</span> <span class="n">interpolation</span><span class="o">=</span><span class="sh">"</span><span class="s">nearest</span><span class="sh">"</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">r</span> <span class="o">==</span> <span class="mi">0</span><span class="p">:</span>
            <span class="n">axes</span><span class="p">[</span><span class="n">r</span><span class="p">,</span> <span class="n">h</span> <span class="o">+</span> <span class="mi">1</span><span class="p">].</span><span class="nf">set_title</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">head </span><span class="si">{</span><span class="n">h</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">10</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">ax</span> <span class="ow">in</span> <span class="n">axes</span><span class="p">[</span><span class="n">r</span><span class="p">]:</span>
        <span class="n">ax</span><span class="p">.</span><span class="nf">axis</span><span class="p">(</span><span class="sh">"</span><span class="s">off</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/11/output-11.png" alt="Output of the code above" loading="lazy"></p> <p>Most heads of the last layer have found an object and outlined it on a grid of 8-pixel cells: the orca’s body and fins against the sea, the shuttle and the edge of its plume, the bear’s head and the fish.</p> <p>Different heads take different parts, and one or two look at the background instead. The model was never shown a label, a box or a mask; separating a thing from its background turned out to be useful for matching crops of the same photo, and the attention learned to do it.</p> <p>DINOv2, which Meta trained on 142 million curated images in 2023, is the same idea at scale, and its features are what many vision systems now start from. The last section puts them to work.</p> <h2 id="7-land-use-from-orbit-with-few-labels">7. Land use from orbit, with few labels</h2> <p>EuroSAT is 27,000 images from the Sentinel-2 satellites of the European Space Agency’s Copernicus programme, 64×64 pixels, each 640 metres across, in ten classes of land use: crops, forest, pasture, highway, industry, housing, rivers, lakes and two more.</p> <p>Helber and colleagues released it in 2019 under the MIT license. It is a good test of the ViT’s weak spot: images that look nothing like ImageNet, and a budget of labels we can shrink at will.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">EUROSAT</span> <span class="o">=</span> <span class="sh">"</span><span class="s">hf://datasets/timm/eurosat-rgb/data/{}-00000-of-00001.parquet</span><span class="sh">"</span>


<span class="k">def</span> <span class="nf">load_split</span><span class="p">(</span><span class="n">split</span><span class="p">,</span> <span class="n">limit</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
    <span class="n">frame</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nf">read_parquet</span><span class="p">(</span><span class="n">EUROSAT</span><span class="p">.</span><span class="nf">format</span><span class="p">(</span><span class="n">split</span><span class="p">))</span>
    <span class="k">if</span> <span class="n">limit</span><span class="p">:</span>
        <span class="n">frame</span> <span class="o">=</span> <span class="n">frame</span><span class="p">.</span><span class="nf">groupby</span><span class="p">(</span><span class="sh">"</span><span class="s">label</span><span class="sh">"</span><span class="p">).</span><span class="nf">head</span><span class="p">(</span><span class="n">limit</span><span class="p">)</span>
    <span class="n">images</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">record</span> <span class="ow">in</span> <span class="n">frame</span><span class="p">[</span><span class="sh">"</span><span class="s">image</span><span class="sh">"</span><span class="p">]:</span>
        <span class="n">images</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">asarray</span><span class="p">(</span><span class="n">Image</span><span class="p">.</span><span class="nf">open</span><span class="p">(</span><span class="n">io</span><span class="p">.</span><span class="nc">BytesIO</span><span class="p">(</span><span class="n">record</span><span class="p">[</span><span class="sh">"</span><span class="s">bytes</span><span class="sh">"</span><span class="p">])).</span><span class="nf">convert</span><span class="p">(</span><span class="sh">"</span><span class="s">RGB</span><span class="sh">"</span><span class="p">)))</span>
    <span class="n">images</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">stack</span><span class="p">(</span><span class="n">images</span><span class="p">)).</span><span class="nf">permute</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>  <span class="c1"># (n, 3, 64, 64), uint8
</span>    <span class="n">names</span> <span class="o">=</span> <span class="p">[</span><span class="n">i</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="sh">"</span><span class="s">_</span><span class="sh">"</span><span class="p">)[</span><span class="mi">0</span><span class="p">]</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">frame</span><span class="p">[</span><span class="sh">"</span><span class="s">image_id</span><span class="sh">"</span><span class="p">]]</span>
    <span class="k">return</span> <span class="n">images</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">frame</span><span class="p">[</span><span class="sh">"</span><span class="s">label</span><span class="sh">"</span><span class="p">].</span><span class="n">values</span><span class="p">),</span> <span class="n">names</span>


<span class="n">train_images</span><span class="p">,</span> <span class="n">train_labels</span><span class="p">,</span> <span class="n">train_names</span> <span class="o">=</span> <span class="nf">load_split</span><span class="p">(</span><span class="sh">"</span><span class="s">train</span><span class="sh">"</span><span class="p">,</span> <span class="mi">30</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="bp">None</span><span class="p">)</span>
<span class="n">test_images</span><span class="p">,</span> <span class="n">test_labels</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="nf">load_split</span><span class="p">(</span><span class="sh">"</span><span class="s">test</span><span class="sh">"</span><span class="p">,</span> <span class="mi">10</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="bp">None</span><span class="p">)</span>
<span class="n">classes</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">label</span><span class="p">,</span> <span class="n">name</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">train_labels</span><span class="p">.</span><span class="nf">tolist</span><span class="p">(),</span> <span class="n">train_names</span><span class="p">):</span>
    <span class="n">classes</span><span class="p">[</span><span class="n">label</span><span class="p">]</span> <span class="o">=</span> <span class="n">name</span>
<span class="n">classes</span> <span class="o">=</span> <span class="p">[</span><span class="n">classes</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nf">sorted</span><span class="p">(</span><span class="n">classes</span><span class="p">)]</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">train:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">train_images</span><span class="p">.</span><span class="n">shape</span><span class="p">),</span> <span class="sh">"</span><span class="s"> test:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">test_images</span><span class="p">.</span><span class="n">shape</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">classes:</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">, </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">classes</span><span class="p">))</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="mi">2</span><span class="p">,</span> <span class="mi">10</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">13</span><span class="p">,</span> <span class="mi">3</span><span class="p">))</span>
<span class="k">for</span> <span class="n">c</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">10</span><span class="p">):</span>
    <span class="n">picks</span> <span class="o">=</span> <span class="p">(</span><span class="n">train_labels</span> <span class="o">==</span> <span class="n">c</span><span class="p">).</span><span class="nf">nonzero</span><span class="p">()[:</span><span class="mi">2</span><span class="p">,</span> <span class="mi">0</span><span class="p">]</span>
    <span class="k">for</span> <span class="n">r</span><span class="p">,</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">picks</span><span class="p">.</span><span class="nf">tolist</span><span class="p">()):</span>
        <span class="n">axes</span><span class="p">[</span><span class="n">r</span><span class="p">,</span> <span class="n">c</span><span class="p">].</span><span class="nf">imshow</span><span class="p">(</span><span class="n">train_images</span><span class="p">[</span><span class="n">i</span><span class="p">].</span><span class="nf">permute</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">0</span><span class="p">))</span>
        <span class="n">axes</span><span class="p">[</span><span class="n">r</span><span class="p">,</span> <span class="n">c</span><span class="p">].</span><span class="nf">axis</span><span class="p">(</span><span class="sh">"</span><span class="s">off</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="n">c</span><span class="p">].</span><span class="nf">set_title</span><span class="p">(</span><span class="n">classes</span><span class="p">[</span><span class="n">c</span><span class="p">],</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">8</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <pre class="tfs-printed"><code>train: (16200, 3, 64, 64)  test: (5400, 3, 64, 64)
classes: AnnualCrop, Forest, HerbaceousVegetation, Highway, Industrial, Pasture, PermanentCrop, Residential, River, SeaLake</code></pre> <p><img class="tfs-output" src="/assets/posts/arch/11/output-12.png" alt="Output of the code above" loading="lazy"></p> <p>Four learners, each trained on 10, 100 and all 1,620 labelled images per class:</p> <ol> <li><strong>ViT-B/16 pretrained</strong> on ImageNet-21k’s 14 million images, the checkpoint <em>before</em> it learned ImageNet’s 1,000 classes, fine-tuned whole. The 64-pixel tiles are enlarged to 224.</li> <li><strong>A small ViT from scratch</strong>: six blocks of width 192, 8-pixel patches on the 64-pixel tiles, so 64 patches.</li> <li><strong>A small CNN from scratch</strong> with about as many parameters, four blocks of convolutions: the inductive bias the ViT gave up.</li> <li><strong>A linear probe on DINOv2</strong>: the small DINOv2, frozen, turns each tile into a vector, and only a linear classifier on top is trained. No pixel-level training at all.</li> </ol> <p>All four see the same augmentation: random flips and quarter turns, which change nothing about what a satellite tile shows.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">augment</span><span class="p">(</span><span class="n">images</span><span class="p">):</span>
    <span class="n">flip</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">rand</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">images</span><span class="p">),</span> <span class="n">device</span><span class="o">=</span><span class="n">images</span><span class="p">.</span><span class="n">device</span><span class="p">)</span> <span class="o">&lt;</span> <span class="mf">0.5</span>
    <span class="n">images</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">where</span><span class="p">(</span><span class="n">flip</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">],</span> <span class="n">images</span><span class="p">.</span><span class="nf">flip</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">),</span> <span class="n">images</span><span class="p">)</span>
    <span class="n">turns</span> <span class="o">=</span> <span class="n">random</span><span class="p">.</span><span class="nf">randint</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">3</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">rot90</span><span class="p">(</span><span class="n">images</span><span class="p">,</span> <span class="n">turns</span><span class="p">,</span> <span class="n">dims</span><span class="o">=</span><span class="p">(</span><span class="o">-</span><span class="mi">2</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">))</span>


<span class="k">def</span> <span class="nf">normalise</span><span class="p">(</span><span class="n">images</span><span class="p">,</span> <span class="n">size</span><span class="p">,</span> <span class="n">mean</span><span class="p">,</span> <span class="n">std</span><span class="p">):</span>
    <span class="n">x</span> <span class="o">=</span> <span class="n">images</span><span class="p">.</span><span class="nf">float</span><span class="p">()</span> <span class="o">/</span> <span class="mi">255</span>
    <span class="k">if</span> <span class="n">size</span> <span class="o">!=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]:</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">interpolate</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">size</span><span class="o">=</span><span class="p">(</span><span class="n">size</span><span class="p">,</span> <span class="n">size</span><span class="p">),</span> <span class="n">mode</span><span class="o">=</span><span class="sh">"</span><span class="s">bilinear</span><span class="sh">"</span><span class="p">,</span> <span class="n">align_corners</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
    <span class="n">mean</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">mean</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">x</span><span class="p">.</span><span class="n">device</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
    <span class="n">std</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">std</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">x</span><span class="p">.</span><span class="n">device</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
    <span class="nf">return </span><span class="p">(</span><span class="n">x</span> <span class="o">-</span> <span class="n">mean</span><span class="p">)</span> <span class="o">/</span> <span class="n">std</span>


<span class="k">class</span> <span class="nc">SmallCNN</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">classes</span><span class="p">,</span> <span class="n">width</span><span class="o">=</span><span class="mi">64</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">layers</span> <span class="o">=</span> <span class="p">[]</span>
        <span class="n">channels</span> <span class="o">=</span> <span class="mi">3</span>
        <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">4</span><span class="p">):</span>
            <span class="n">out</span> <span class="o">=</span> <span class="n">width</span> <span class="o">*</span> <span class="mi">2</span> <span class="o">**</span> <span class="nf">min</span><span class="p">(</span><span class="n">k</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
            <span class="n">layers</span> <span class="o">+=</span> <span class="p">[</span>
                <span class="n">nn</span><span class="p">.</span><span class="nc">Conv2d</span><span class="p">(</span><span class="n">channels</span><span class="p">,</span> <span class="n">out</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="n">padding</span><span class="o">=</span><span class="mi">1</span><span class="p">),</span>
                <span class="n">nn</span><span class="p">.</span><span class="nc">BatchNorm2d</span><span class="p">(</span><span class="n">out</span><span class="p">),</span>
                <span class="n">nn</span><span class="p">.</span><span class="nc">GELU</span><span class="p">(),</span>
            <span class="p">]</span>
            <span class="n">layers</span> <span class="o">+=</span> <span class="p">[</span><span class="n">nn</span><span class="p">.</span><span class="nc">Conv2d</span><span class="p">(</span><span class="n">out</span><span class="p">,</span> <span class="n">out</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="n">padding</span><span class="o">=</span><span class="mi">1</span><span class="p">),</span> <span class="n">nn</span><span class="p">.</span><span class="nc">BatchNorm2d</span><span class="p">(</span><span class="n">out</span><span class="p">),</span> <span class="n">nn</span><span class="p">.</span><span class="nc">GELU</span><span class="p">()]</span>
            <span class="n">layers</span> <span class="o">+=</span> <span class="p">[</span><span class="n">nn</span><span class="p">.</span><span class="nc">MaxPool2d</span><span class="p">(</span><span class="mi">2</span><span class="p">)]</span>
            <span class="n">channels</span> <span class="o">=</span> <span class="n">out</span>
        <span class="n">self</span><span class="p">.</span><span class="n">features</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Sequential</span><span class="p">(</span><span class="o">*</span><span class="n">layers</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">head</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">channels</span><span class="p">,</span> <span class="n">classes</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">head</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">features</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">mean</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="p">(</span><span class="o">-</span><span class="mi">2</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">)))</span>


<span class="n">SMALL_VIT</span> <span class="o">=</span> <span class="p">{</span>
    <span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">:</span> <span class="mi">192</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">:</span> <span class="mi">6</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">:</span> <span class="mi">3</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">:</span> <span class="mi">768</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">patch_size</span><span class="sh">"</span><span class="p">:</span> <span class="mi">8</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">image_size</span><span class="sh">"</span><span class="p">:</span> <span class="mi">64</span><span class="p">,</span>
<span class="p">}</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">net</span> <span class="ow">in</span> <span class="p">[(</span><span class="sh">"</span><span class="s">small ViT</span><span class="sh">"</span><span class="p">,</span> <span class="nc">ViT</span><span class="p">(</span><span class="n">SMALL_VIT</span><span class="p">,</span> <span class="mi">10</span><span class="p">)),</span> <span class="p">(</span><span class="sh">"</span><span class="s">small CNN</span><span class="sh">"</span><span class="p">,</span> <span class="nc">SmallCNN</span><span class="p">(</span><span class="mi">10</span><span class="p">))]:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="s">: </span><span class="si">{</span><span class="nf">sum</span><span class="p">(</span><span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span> <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">net</span><span class="p">.</span><span class="nf">parameters</span><span class="p">())</span> <span class="o">/</span> <span class="mf">1e6</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s">M parameters</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>small ViT: 2.7M parameters
small CNN: 2.3M parameters</code></pre> <p>One training loop serves the first three learners. It counts steps rather than epochs, so that the smallest dataset is seen many times and the largest a few, and uses 16-bit floats with a loss scaler on the GPU.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">train</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">images</span><span class="p">,</span> <span class="n">labels</span><span class="p">,</span> <span class="n">size</span><span class="p">,</span> <span class="n">mean</span><span class="p">,</span> <span class="n">std</span><span class="p">,</span> <span class="n">steps</span><span class="p">,</span> <span class="n">lr</span><span class="p">,</span> <span class="n">batch_size</span><span class="o">=</span><span class="mi">64</span><span class="p">):</span>
    <span class="n">model</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">train</span><span class="p">()</span>
    <span class="n">optimizer</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">optim</span><span class="p">.</span><span class="nc">AdamW</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="nf">parameters</span><span class="p">(),</span> <span class="n">lr</span><span class="o">=</span><span class="n">lr</span><span class="p">,</span> <span class="n">weight_decay</span><span class="o">=</span><span class="mf">0.05</span><span class="p">)</span>
    <span class="n">schedule</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">optim</span><span class="p">.</span><span class="n">lr_scheduler</span><span class="p">.</span><span class="nc">OneCycleLR</span><span class="p">(</span>
        <span class="n">optimizer</span><span class="p">,</span> <span class="n">lr</span><span class="p">,</span> <span class="n">total_steps</span><span class="o">=</span><span class="n">steps</span><span class="p">,</span> <span class="n">pct_start</span><span class="o">=</span><span class="mf">0.1</span>
    <span class="p">)</span>
    <span class="n">scaler</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">amp</span><span class="p">.</span><span class="nc">GradScaler</span><span class="p">(</span><span class="n">device</span><span class="p">,</span> <span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">images</span><span class="p">,</span> <span class="n">labels</span> <span class="o">=</span> <span class="n">images</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">),</span> <span class="n">labels</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">steps</span><span class="p">):</span>
        <span class="n">pick</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randint</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">images</span><span class="p">),</span> <span class="p">(</span><span class="n">batch_size</span><span class="p">,),</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
        <span class="n">x</span> <span class="o">=</span> <span class="nf">normalise</span><span class="p">(</span><span class="nf">augment</span><span class="p">(</span><span class="n">images</span><span class="p">[</span><span class="n">pick</span><span class="p">]),</span> <span class="n">size</span><span class="p">,</span> <span class="n">mean</span><span class="p">,</span> <span class="n">std</span><span class="p">)</span>
        <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">autocast</span><span class="p">(</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float16</span><span class="p">,</span> <span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">):</span>
            <span class="n">loss</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span><span class="nf">model</span><span class="p">(</span><span class="n">x</span><span class="p">),</span> <span class="n">labels</span><span class="p">[</span><span class="n">pick</span><span class="p">])</span>
        <span class="n">optimizer</span><span class="p">.</span><span class="nf">zero_grad</span><span class="p">()</span>
        <span class="n">scaler</span><span class="p">.</span><span class="nf">scale</span><span class="p">(</span><span class="n">loss</span><span class="p">).</span><span class="nf">backward</span><span class="p">()</span>
        <span class="n">scaler</span><span class="p">.</span><span class="nf">step</span><span class="p">(</span><span class="n">optimizer</span><span class="p">)</span>
        <span class="n">scaler</span><span class="p">.</span><span class="nf">update</span><span class="p">()</span>
        <span class="n">schedule</span><span class="p">.</span><span class="nf">step</span><span class="p">()</span>
    <span class="k">return</span> <span class="n">model</span>


<span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">predict_all</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">images</span><span class="p">,</span> <span class="n">size</span><span class="p">,</span> <span class="n">mean</span><span class="p">,</span> <span class="n">std</span><span class="p">,</span> <span class="n">batch_size</span><span class="o">=</span><span class="mi">256</span><span class="p">):</span>
    <span class="n">model</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>
    <span class="n">out</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">a</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">images</span><span class="p">),</span> <span class="n">batch_size</span><span class="p">):</span>
        <span class="n">x</span> <span class="o">=</span> <span class="nf">normalise</span><span class="p">(</span><span class="n">images</span><span class="p">[</span><span class="n">a</span> <span class="p">:</span> <span class="n">a</span> <span class="o">+</span> <span class="n">batch_size</span><span class="p">].</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">),</span> <span class="n">size</span><span class="p">,</span> <span class="n">mean</span><span class="p">,</span> <span class="n">std</span><span class="p">)</span>
        <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">autocast</span><span class="p">(</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float16</span><span class="p">,</span> <span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">):</span>
            <span class="n">out</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="nf">model</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">float</span><span class="p">().</span><span class="nf">argmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">).</span><span class="nf">cpu</span><span class="p">())</span>
    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">(</span><span class="n">out</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">subset</span><span class="p">(</span><span class="n">per_class</span><span class="p">):</span>
    <span class="n">keep</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">c</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">10</span><span class="p">):</span>
        <span class="n">keep</span> <span class="o">+=</span> <span class="p">(</span><span class="n">train_labels</span> <span class="o">==</span> <span class="n">c</span><span class="p">).</span><span class="nf">nonzero</span><span class="p">()[:</span><span class="n">per_class</span><span class="p">,</span> <span class="mi">0</span><span class="p">].</span><span class="nf">tolist</span><span class="p">()</span>
    <span class="k">return</span> <span class="n">train_images</span><span class="p">[</span><span class="n">keep</span><span class="p">],</span> <span class="n">train_labels</span><span class="p">[</span><span class="n">keep</span><span class="p">]</span>
</code></pre></div></div> <p>DINOv2 comes from the transformers library: it adds a few details to the ViT recipe, such as layer scale and 14-pixel patches, and here it only serves as a frozen feature extractor. Its class token plus the average of its patch tokens is the image’s vector, and a linear layer on top is trained with plain gradient descent.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">AutoModel</span><span class="p">,</span> <span class="n">Dinov2Config</span><span class="p">,</span> <span class="n">Dinov2Model</span>

<span class="k">if</span> <span class="n">SMOKE</span><span class="p">:</span>
    <span class="n">dinov2</span> <span class="o">=</span> <span class="nc">Dinov2Model</span><span class="p">(</span>
        <span class="nc">Dinov2Config</span><span class="p">(</span>
            <span class="n">hidden_size</span><span class="o">=</span><span class="mi">32</span><span class="p">,</span>
            <span class="n">num_hidden_layers</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span>
            <span class="n">num_attention_heads</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span>
            <span class="n">intermediate_size</span><span class="o">=</span><span class="mi">64</span><span class="p">,</span>
            <span class="n">patch_size</span><span class="o">=</span><span class="mi">14</span><span class="p">,</span>
            <span class="n">image_size</span><span class="o">=</span><span class="mi">56</span><span class="p">,</span>
        <span class="p">)</span>
    <span class="p">)</span>
    <span class="n">dinov2_size</span> <span class="o">=</span> <span class="mi">56</span>
<span class="k">else</span><span class="p">:</span>
    <span class="n">dinov2</span> <span class="o">=</span> <span class="n">AutoModel</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="sh">"</span><span class="s">facebook/dinov2-small</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">dinov2_size</span> <span class="o">=</span> <span class="mi">224</span>
<span class="n">dinov2</span> <span class="o">=</span> <span class="n">dinov2</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>


<span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">dinov2_features</span><span class="p">(</span><span class="n">images</span><span class="p">,</span> <span class="n">batch_size</span><span class="o">=</span><span class="mi">256</span><span class="p">):</span>
    <span class="n">out</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">a</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">images</span><span class="p">),</span> <span class="n">batch_size</span><span class="p">):</span>
        <span class="n">x</span> <span class="o">=</span> <span class="nf">normalise</span><span class="p">(</span>
            <span class="n">images</span><span class="p">[</span><span class="n">a</span> <span class="p">:</span> <span class="n">a</span> <span class="o">+</span> <span class="n">batch_size</span><span class="p">].</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">),</span> <span class="n">dinov2_size</span><span class="p">,</span> <span class="n">IMAGENET_MEAN</span><span class="p">,</span> <span class="n">IMAGENET_STD</span>
        <span class="p">)</span>
        <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">autocast</span><span class="p">(</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float16</span><span class="p">,</span> <span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">):</span>
            <span class="n">hidden</span> <span class="o">=</span> <span class="nf">dinov2</span><span class="p">(</span><span class="n">pixel_values</span><span class="o">=</span><span class="n">x</span><span class="p">).</span><span class="n">last_hidden_state</span><span class="p">.</span><span class="nf">float</span><span class="p">()</span>
        <span class="n">out</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">hidden</span><span class="p">[:,</span> <span class="mi">0</span><span class="p">],</span> <span class="n">hidden</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">:].</span><span class="nf">mean</span><span class="p">(</span><span class="mi">1</span><span class="p">)],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">).</span><span class="nf">cpu</span><span class="p">())</span>
    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">(</span><span class="n">out</span><span class="p">)</span>


<span class="n">train_features</span> <span class="o">=</span> <span class="nf">dinov2_features</span><span class="p">(</span><span class="n">train_images</span><span class="p">)</span>
<span class="n">test_features</span> <span class="o">=</span> <span class="nf">dinov2_features</span><span class="p">(</span><span class="n">test_images</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">one tile as a DINOv2 vector:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">train_features</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">:]))</span>


<span class="k">def</span> <span class="nf">linear_probe</span><span class="p">(</span><span class="n">features</span><span class="p">,</span> <span class="n">labels</span><span class="p">,</span> <span class="n">steps</span><span class="o">=</span><span class="mi">500</span><span class="p">):</span>
    <span class="n">mean</span><span class="p">,</span> <span class="n">std</span> <span class="o">=</span> <span class="n">features</span><span class="p">.</span><span class="nf">mean</span><span class="p">(</span><span class="mi">0</span><span class="p">),</span> <span class="n">features</span><span class="p">.</span><span class="nf">std</span><span class="p">(</span><span class="mi">0</span><span class="p">)</span> <span class="o">+</span> <span class="mf">1e-6</span>
    <span class="n">probe</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">features</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="mi">10</span><span class="p">)</span>
    <span class="n">optimizer</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">optim</span><span class="p">.</span><span class="nc">AdamW</span><span class="p">(</span><span class="n">probe</span><span class="p">.</span><span class="nf">parameters</span><span class="p">(),</span> <span class="n">lr</span><span class="o">=</span><span class="mf">1e-2</span><span class="p">,</span> <span class="n">weight_decay</span><span class="o">=</span><span class="mf">1e-3</span><span class="p">)</span>
    <span class="n">x</span> <span class="o">=</span> <span class="p">(</span><span class="n">features</span> <span class="o">-</span> <span class="n">mean</span><span class="p">)</span> <span class="o">/</span> <span class="n">std</span>
    <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">steps</span><span class="p">):</span>
        <span class="n">loss</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span><span class="nf">probe</span><span class="p">(</span><span class="n">x</span><span class="p">),</span> <span class="n">labels</span><span class="p">)</span>
        <span class="n">optimizer</span><span class="p">.</span><span class="nf">zero_grad</span><span class="p">()</span>
        <span class="n">loss</span><span class="p">.</span><span class="nf">backward</span><span class="p">()</span>
        <span class="n">optimizer</span><span class="p">.</span><span class="nf">step</span><span class="p">()</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="k">return</span> <span class="nf">probe</span><span class="p">((</span><span class="n">test_features</span> <span class="o">-</span> <span class="n">mean</span><span class="p">)</span> <span class="o">/</span> <span class="n">std</span><span class="p">).</span><span class="nf">argmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>one tile as a DINOv2 vector: (768,)</code></pre> <p>The race. Every learner gets the same subsets of labelled tiles and is scored on the same 5,400 test tiles.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">IN21K</span> <span class="o">=</span> <span class="sh">"</span><span class="s">google/vit-base-patch16-224-in21k</span><span class="sh">"</span>
<span class="n">budgets</span> <span class="o">=</span> <span class="p">[</span><span class="mi">3</span><span class="p">,</span> <span class="mi">10</span><span class="p">]</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="p">[</span><span class="mi">10</span><span class="p">,</span> <span class="mi">100</span><span class="p">,</span> <span class="mi">1620</span><span class="p">]</span>
<span class="n">results</span> <span class="o">=</span> <span class="p">[]</span>
<span class="n">predictions</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">per_class</span> <span class="ow">in</span> <span class="n">budgets</span><span class="p">:</span>
    <span class="n">images</span><span class="p">,</span> <span class="n">labels_</span> <span class="o">=</span> <span class="nf">subset</span><span class="p">(</span><span class="n">per_class</span><span class="p">)</span>
    <span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
    <span class="n">chosen</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([(</span><span class="n">train_labels</span> <span class="o">==</span> <span class="n">c</span><span class="p">).</span><span class="nf">nonzero</span><span class="p">()[:</span><span class="n">per_class</span><span class="p">,</span> <span class="mi">0</span><span class="p">]</span> <span class="k">for</span> <span class="n">c</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">10</span><span class="p">)])</span>
    <span class="n">guess</span> <span class="o">=</span> <span class="nf">linear_probe</span><span class="p">(</span><span class="n">train_features</span><span class="p">[</span><span class="n">chosen</span><span class="p">],</span> <span class="n">train_labels</span><span class="p">[</span><span class="n">chosen</span><span class="p">])</span>
    <span class="n">results</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
        <span class="p">{</span>
            <span class="sh">"</span><span class="s">labels per class</span><span class="sh">"</span><span class="p">:</span> <span class="n">per_class</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">learner</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">DINOv2 + linear probe</span><span class="sh">"</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">accuracy</span><span class="sh">"</span><span class="p">:</span> <span class="p">(</span><span class="n">guess</span> <span class="o">==</span> <span class="n">test_labels</span><span class="p">).</span><span class="nf">float</span><span class="p">().</span><span class="nf">mean</span><span class="p">().</span><span class="nf">item</span><span class="p">(),</span>
            <span class="sh">"</span><span class="s">seconds</span><span class="sh">"</span><span class="p">:</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="p">,</span>
        <span class="p">}</span>
    <span class="p">)</span>
    <span class="n">predictions</span><span class="p">[(</span><span class="sh">"</span><span class="s">DINOv2 + linear probe</span><span class="sh">"</span><span class="p">,</span> <span class="n">per_class</span><span class="p">)]</span> <span class="o">=</span> <span class="n">guess</span>

    <span class="n">learners</span> <span class="o">=</span> <span class="p">[</span>
        <span class="p">(</span><span class="sh">"</span><span class="s">small CNN</span><span class="sh">"</span><span class="p">,</span> <span class="k">lambda</span><span class="p">:</span> <span class="nc">SmallCNN</span><span class="p">(</span><span class="mi">10</span><span class="p">),</span> <span class="mi">64</span><span class="p">,</span> <span class="n">IMAGENET_MEAN</span><span class="p">,</span> <span class="n">IMAGENET_STD</span><span class="p">,</span> <span class="mf">3e-3</span><span class="p">),</span>
        <span class="p">(</span><span class="sh">"</span><span class="s">small ViT</span><span class="sh">"</span><span class="p">,</span> <span class="k">lambda</span><span class="p">:</span> <span class="nc">ViT</span><span class="p">(</span><span class="n">SMALL_VIT</span><span class="p">,</span> <span class="mi">10</span><span class="p">),</span> <span class="mi">64</span><span class="p">,</span> <span class="n">IMAGENET_MEAN</span><span class="p">,</span> <span class="n">IMAGENET_STD</span><span class="p">,</span> <span class="mf">1e-3</span><span class="p">),</span>
        <span class="p">(</span><span class="sh">"</span><span class="s">ViT-B/16 pretrained</span><span class="sh">"</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="mi">224</span><span class="p">,</span> <span class="p">[</span><span class="n">MEAN</span><span class="p">]</span> <span class="o">*</span> <span class="mi">3</span><span class="p">,</span> <span class="p">[</span><span class="n">STD</span><span class="p">]</span> <span class="o">*</span> <span class="mi">3</span><span class="p">,</span> <span class="mf">5e-5</span><span class="p">),</span>
    <span class="p">]</span>
    <span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">make</span><span class="p">,</span> <span class="n">size</span><span class="p">,</span> <span class="n">mean</span><span class="p">,</span> <span class="n">std</span><span class="p">,</span> <span class="n">lr</span> <span class="ow">in</span> <span class="n">learners</span><span class="p">:</span>
        <span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
        <span class="k">if</span> <span class="n">name</span> <span class="o">==</span> <span class="sh">"</span><span class="s">ViT-B/16 pretrained</span><span class="sh">"</span><span class="p">:</span>
            <span class="n">model</span> <span class="o">=</span> <span class="nc">ViT</span><span class="p">(</span><span class="n">vit_config</span><span class="p">,</span> <span class="mi">10</span><span class="p">)</span>
            <span class="k">if</span> <span class="ow">not</span> <span class="n">SMOKE</span><span class="p">:</span>
                <span class="n">pretrained</span> <span class="o">=</span> <span class="nf">rename</span><span class="p">(</span><span class="nf">load_file</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">IN21K</span><span class="p">,</span> <span class="sh">"</span><span class="s">model.safetensors</span><span class="sh">"</span><span class="p">)))</span>
                <span class="n">model</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">(</span><span class="n">pretrained</span><span class="p">,</span> <span class="n">strict</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>  <span class="c1"># a new head for 10 classes
</span>            <span class="n">steps</span> <span class="o">=</span> <span class="mi">30</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="nf">max</span><span class="p">(</span><span class="mi">300</span><span class="p">,</span> <span class="mi">3</span> <span class="o">*</span> <span class="nf">len</span><span class="p">(</span><span class="n">images</span><span class="p">)</span> <span class="o">//</span> <span class="mi">32</span><span class="p">)</span>
            <span class="n">model</span> <span class="o">=</span> <span class="nf">train</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">images</span><span class="p">,</span> <span class="n">labels_</span><span class="p">,</span> <span class="n">size</span><span class="p">,</span> <span class="n">mean</span><span class="p">,</span> <span class="n">std</span><span class="p">,</span> <span class="n">steps</span><span class="p">,</span> <span class="n">lr</span><span class="p">,</span> <span class="n">batch_size</span><span class="o">=</span><span class="mi">32</span><span class="p">)</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="n">steps</span> <span class="o">=</span> <span class="mi">30</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="nf">max</span><span class="p">(</span><span class="mi">1500</span><span class="p">,</span> <span class="mi">30</span> <span class="o">*</span> <span class="nf">len</span><span class="p">(</span><span class="n">images</span><span class="p">)</span> <span class="o">//</span> <span class="mi">64</span><span class="p">)</span>
            <span class="n">model</span> <span class="o">=</span> <span class="nf">train</span><span class="p">(</span><span class="nf">make</span><span class="p">(),</span> <span class="n">images</span><span class="p">,</span> <span class="n">labels_</span><span class="p">,</span> <span class="n">size</span><span class="p">,</span> <span class="n">mean</span><span class="p">,</span> <span class="n">std</span><span class="p">,</span> <span class="n">steps</span><span class="p">,</span> <span class="n">lr</span><span class="p">)</span>
        <span class="n">guess</span> <span class="o">=</span> <span class="nf">predict_all</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">test_images</span><span class="p">,</span> <span class="n">size</span><span class="p">,</span> <span class="n">mean</span><span class="p">,</span> <span class="n">std</span><span class="p">)</span>
        <span class="n">results</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
            <span class="p">{</span>
                <span class="sh">"</span><span class="s">labels per class</span><span class="sh">"</span><span class="p">:</span> <span class="n">per_class</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">learner</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">accuracy</span><span class="sh">"</span><span class="p">:</span> <span class="p">(</span><span class="n">guess</span> <span class="o">==</span> <span class="n">test_labels</span><span class="p">).</span><span class="nf">float</span><span class="p">().</span><span class="nf">mean</span><span class="p">().</span><span class="nf">item</span><span class="p">(),</span>
                <span class="sh">"</span><span class="s">seconds</span><span class="sh">"</span><span class="p">:</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="p">,</span>
            <span class="p">}</span>
        <span class="p">)</span>
        <span class="n">predictions</span><span class="p">[(</span><span class="n">name</span><span class="p">,</span> <span class="n">per_class</span><span class="p">)]</span> <span class="o">=</span> <span class="n">guess</span>
        <span class="k">del</span> <span class="n">model</span>
        <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
            <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">empty_cache</span><span class="p">()</span>
<span class="n">results</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">results</span><span class="p">)</span>
<span class="n">order</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">ViT-B/16 pretrained</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">small ViT</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">small CNN</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">DINOv2 + linear probe</span><span class="sh">"</span><span class="p">]</span>
<span class="n">accuracy</span> <span class="o">=</span> <span class="n">results</span><span class="p">.</span><span class="nf">pivot</span><span class="p">(</span><span class="n">index</span><span class="o">=</span><span class="sh">"</span><span class="s">learner</span><span class="sh">"</span><span class="p">,</span> <span class="n">columns</span><span class="o">=</span><span class="sh">"</span><span class="s">labels per class</span><span class="sh">"</span><span class="p">,</span> <span class="n">values</span><span class="o">=</span><span class="sh">"</span><span class="s">accuracy</span><span class="sh">"</span><span class="p">)</span>
<span class="n">accuracy</span> <span class="o">=</span> <span class="n">accuracy</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">order</span><span class="p">]</span>
<span class="n">accuracy</span><span class="p">.</span><span class="n">columns</span> <span class="o">=</span> <span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">n</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> labels per class</span><span class="sh">"</span> <span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="n">accuracy</span><span class="p">.</span><span class="n">columns</span><span class="p">]</span>
<span class="nf">table</span><span class="p">(</span><span class="n">accuracy</span><span class="p">.</span><span class="nf">reset_index</span><span class="p">(),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">3</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">learner</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">10 labels per class</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">100 labels per class</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">1,620 labels per class</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">ViT-B/16 pretrained</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.916</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.970</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.988</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">small ViT</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.586</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.815</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.932</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">small CNN</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.740</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.920</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.979</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">DINOv2 + linear probe</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.845</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.926</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.966</td></tr></tbody></table></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">7.2</span><span class="p">,</span> <span class="mf">3.8</span><span class="p">))</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">color</span> <span class="ow">in</span> <span class="p">[</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">ViT-B/16 pretrained</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">]),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">DINOv2 + linear probe</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">]),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">small CNN</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">data</span><span class="sh">"</span><span class="p">]),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">small ViT</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">]),</span>
<span class="p">]:</span>
    <span class="n">part</span> <span class="o">=</span> <span class="n">results</span><span class="p">[</span><span class="n">results</span><span class="p">.</span><span class="n">learner</span> <span class="o">==</span> <span class="n">name</span><span class="p">]</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span>
        <span class="n">part</span><span class="p">[</span><span class="sh">"</span><span class="s">labels per class</span><span class="sh">"</span><span class="p">]</span> <span class="o">*</span> <span class="mi">10</span><span class="p">,</span>
        <span class="n">part</span><span class="p">.</span><span class="n">accuracy</span><span class="p">,</span>
        <span class="n">marker</span><span class="o">=</span><span class="sh">"</span><span class="s">o</span><span class="sh">"</span><span class="p">,</span>
        <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span>
        <span class="n">label</span><span class="o">=</span><span class="n">name</span><span class="p">,</span>
        <span class="n">linewidth</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span>
    <span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xscale</span><span class="p">(</span><span class="sh">"</span><span class="s">log</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">labelled training tiles</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">test accuracy</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">EuroSAT, ten classes: accuracy against the number of labels</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">9</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/11/output-13.png" alt="EuroSAT, ten classes: accuracy against the number of labels" loading="lazy"></p> <p>The two from-scratch lines tell the story of 2020. With few labels the CNN is far ahead of the ViT of the same size: its built-in belief in local, repeated patterns is worth thousands of examples.</p> <p>As labels grow, the ViT closes much of the gap, but on 16 thousand tiles it doesn’t pass the CNN; that took hundreds of millions of images.</p> <p>The two pretrained learners show the way out the field took: do the data-hungry learning once, on a huge collection, and reuse it. A ViT that has seen ImageNet-21k, or a frozen DINOv2 with only a linear layer trained on top, is good with ten labels per class.</p> <p>With all the labels, though, the CNN trained from scratch passes the frozen DINOv2: features that were never adapted to satellite colours have a ceiling, and the fine-tuned ViT, which adapts everything, stays on top.</p> <p>Where the best model still goes wrong:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">best</span> <span class="o">=</span> <span class="n">predictions</span><span class="p">[(</span><span class="sh">"</span><span class="s">ViT-B/16 pretrained</span><span class="sh">"</span><span class="p">,</span> <span class="n">budgets</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">])]</span>
<span class="n">confusion</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="mi">10</span><span class="p">,</span> <span class="mi">10</span><span class="p">)</span>
<span class="k">for</span> <span class="n">t</span><span class="p">,</span> <span class="n">p</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">test_labels</span><span class="p">.</span><span class="nf">tolist</span><span class="p">(),</span> <span class="n">best</span><span class="p">.</span><span class="nf">tolist</span><span class="p">()):</span>
    <span class="n">confusion</span><span class="p">[</span><span class="n">t</span><span class="p">,</span> <span class="n">p</span><span class="p">]</span> <span class="o">+=</span> <span class="mi">1</span>
<span class="n">confusion</span> <span class="o">=</span> <span class="n">confusion</span> <span class="o">/</span> <span class="n">confusion</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.2</span><span class="p">,</span> <span class="mf">5.4</span><span class="p">))</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">imshow</span><span class="p">(</span><span class="n">confusion</span><span class="p">,</span> <span class="n">cmap</span><span class="o">=</span><span class="n">shades</span><span class="p">,</span> <span class="n">vmin</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span> <span class="n">vmax</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xticks</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="mi">10</span><span class="p">),</span> <span class="n">classes</span><span class="p">,</span> <span class="n">rotation</span><span class="o">=</span><span class="mi">60</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">8</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_yticks</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="mi">10</span><span class="p">),</span> <span class="n">classes</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">8</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">predicted</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">true</span><span class="sh">"</span><span class="p">)</span>
<span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">10</span><span class="p">):</span>
    <span class="k">for</span> <span class="n">j</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">10</span><span class="p">):</span>
        <span class="k">if</span> <span class="n">confusion</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="n">j</span><span class="p">]</span> <span class="o">&gt;</span> <span class="mf">0.01</span><span class="p">:</span>
            <span class="n">ink</span> <span class="o">=</span> <span class="sh">"</span><span class="s">white</span><span class="sh">"</span> <span class="k">if</span> <span class="n">confusion</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="n">j</span><span class="p">]</span> <span class="o">&gt;</span> <span class="mf">0.5</span> <span class="k">else</span> <span class="sh">"</span><span class="s">black</span><span class="sh">"</span>
            <span class="n">ax</span><span class="p">.</span><span class="nf">text</span><span class="p">(</span>
                <span class="n">j</span><span class="p">,</span>
                <span class="n">i</span><span class="p">,</span>
                <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">confusion</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="n">j</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span>
                <span class="n">ha</span><span class="o">=</span><span class="sh">"</span><span class="s">center</span><span class="sh">"</span><span class="p">,</span>
                <span class="n">va</span><span class="o">=</span><span class="sh">"</span><span class="s">center</span><span class="sh">"</span><span class="p">,</span>
                <span class="n">fontsize</span><span class="o">=</span><span class="mi">7</span><span class="p">,</span>
                <span class="n">color</span><span class="o">=</span><span class="n">ink</span><span class="p">,</span>
            <span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>

<span class="n">short</span> <span class="o">=</span> <span class="p">{</span>  <span class="c1"># titles that fit under a tile
</span>    <span class="sh">"</span><span class="s">AnnualCrop</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">annual crop</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">HerbaceousVegetation</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">herbaceous</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">PermanentCrop</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">permanent crop</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">SeaLake</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">sea or lake</span><span class="sh">"</span><span class="p">,</span>
<span class="p">}</span>
<span class="n">wrong</span> <span class="o">=</span> <span class="p">(</span><span class="n">best</span> <span class="o">!=</span> <span class="n">test_labels</span><span class="p">).</span><span class="nf">nonzero</span><span class="p">()[:,</span> <span class="mi">0</span><span class="p">][:</span><span class="mi">12</span><span class="p">]</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="mi">2</span><span class="p">,</span> <span class="mi">6</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">12</span><span class="p">,</span> <span class="mf">4.6</span><span class="p">))</span>
<span class="k">for</span> <span class="n">ax</span><span class="p">,</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">axes</span><span class="p">.</span><span class="n">flat</span><span class="p">,</span> <span class="n">wrong</span><span class="p">.</span><span class="nf">tolist</span><span class="p">()):</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">imshow</span><span class="p">(</span><span class="n">test_images</span><span class="p">[</span><span class="n">i</span><span class="p">].</span><span class="nf">permute</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">0</span><span class="p">))</span>
    <span class="n">truth</span> <span class="o">=</span> <span class="n">short</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="n">classes</span><span class="p">[</span><span class="n">test_labels</span><span class="p">[</span><span class="n">i</span><span class="p">]],</span> <span class="n">classes</span><span class="p">[</span><span class="n">test_labels</span><span class="p">[</span><span class="n">i</span><span class="p">]].</span><span class="nf">lower</span><span class="p">())</span>
    <span class="n">guess</span> <span class="o">=</span> <span class="n">short</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="n">classes</span><span class="p">[</span><span class="n">best</span><span class="p">[</span><span class="n">i</span><span class="p">]],</span> <span class="n">classes</span><span class="p">[</span><span class="n">best</span><span class="p">[</span><span class="n">i</span><span class="p">]].</span><span class="nf">lower</span><span class="p">())</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">truth</span><span class="si">}</span><span class="se">\n</span><span class="s">→ </span><span class="si">{</span><span class="n">guess</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">8</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">axis</span><span class="p">(</span><span class="sh">"</span><span class="s">off</span><span class="sh">"</span><span class="p">)</span>
<span class="k">for</span> <span class="n">ax</span> <span class="ow">in</span> <span class="n">axes</span><span class="p">.</span><span class="n">flat</span><span class="p">[</span><span class="nf">len</span><span class="p">(</span><span class="n">wrong</span><span class="p">)</span> <span class="p">:]:</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">axis</span><span class="p">(</span><span class="sh">"</span><span class="s">off</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/11/output-14.png" alt="Output of the code above" loading="lazy"></p> <p><img class="tfs-output" src="/assets/posts/arch/11/output-15.png" alt="Output of the code above" loading="lazy"></p> <p>The mistakes are few, and many of them involve herbaceous vegetation, taken for pasture, for crops or for forest: scrub, meadow and young trees are the same green-brown texture at this scale.</p> <p>Annual and permanent crops are taken for each other too, and now and then a tile with a road across it is called a highway. Look at the tiles and you will hesitate too; at 10 metres a pixel, an orchard and a field of wheat can look the same.</p> <h2 id="8-where-the-vit-is-today">8. Where the ViT is today</h2> <p><strong>DeiT</strong> (Touvron and colleagues, Facebook AI, 2020) showed that with strong augmentation and regularisation a ViT trains on ImageNet alone, in under three days on one machine, and matches CNNs; the dependence on JFT was a matter of recipe as much as of architecture.</p> <p><strong>Self-supervised ViTs</strong>, DINO and DINOv2, learn from images without labels, and their features are what vision systems start from when labels are few, as section 7 showed.</p> <p><strong>Contrastive ViTs</strong>, CLIP and SigLIP, learn from images paired with captions; they are lesson 12.</p> <p><strong>The eyes of language models.</strong> A vision-language model takes a ViT’s output vectors, one per patch, projects them into the language model’s embedding space and puts them in the prompt next to the text tokens: lesson 13.</p> <p>ViT-B/16’s passport, and the family tree with this lesson’s branch:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/11/passport-light.png" width="760" alt="ViT-B/16's passport. Published October 2020 by Google Research, Brain Team, weights under Apache 2.0. Type: encoder-only Transformer for images, 86 million parameters. Input: 224 by 224 pixels cut into 196 patches of 16 by 16, plus a class token. Encoder: 12 blocks of width 768 with 12 heads and an MLP of 3,072, layer norm before each part. Positions: 197 learned vectors. Training: ImageNet-21k, 14 million images, then ImageNet-1k. Good at: classifying photos and serving as a backbone for other tasks. Not for: small datasets trained from scratch" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/11/passport-dark.png" width="760" alt="ViT-B/16's passport. Published October 2020 by Google Research, Brain Team, weights under Apache 2.0. Type: encoder-only Transformer for images, 86 million parameters. Input: 224 by 224 pixels cut into 196 patches of 16 by 16, plus a class token. Encoder: 12 blocks of width 768 with 12 heads and an MLP of 3,072, layer norm before each part. Positions: 197 learned vectors. Training: ImageNet-21k, 14 million images, then ImageNet-1k. Good at: classifying photos and serving as a backbone for other tasks. Not for: small datasets trained from scratch" loading="lazy"></p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/11/family-light.png" width="760" alt="The family of the Transformer as this course covers it, with lesson 11, the Vision Transformer, highlighted and lessons 1 to 10 done" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/11/family-dark.png" width="760" alt="The family of the Transformer as this course covers it, with lesson 11, the Vision Transformer, highlighted and lessons 1 to 10 done" loading="lazy"></p> <h2 id="references">References</h2> <ol class="tfs-refs"> <li id="ref-1">Dosovitskiy, A., Beyer, L., Kolesnikov, A., et al. (2021). <a href="https://arxiv.org/abs/2010.11929">An image is worth 16x16 words: Transformers for image recognition at scale</a>. <em>ICLR 2021</em>.</li> <li id="ref-2">Touvron, H., Cord, M., Douze, M., et al. (2021). <a href="https://arxiv.org/abs/2012.12877">Training data-efficient image transformers &amp; distillation through attention</a>. <em>ICML 2021</em>.</li> <li id="ref-3">Caron, M., Touvron, H., Misra, I., et al. (2021). <a href="https://arxiv.org/abs/2104.14294">Emerging properties in self-supervised vision transformers</a>. <em>ICCV 2021</em>.</li> <li id="ref-4">Oquab, M., Darcet, T., Moutakanni, T., et al. (2024). <a href="https://arxiv.org/abs/2304.07193">DINOv2: learning robust visual features without supervision</a>. <em>Transactions on Machine Learning Research</em>.</li> <li id="ref-5">Abnar, S., &amp; Zuidema, W. (2020). <a href="https://arxiv.org/abs/2005.00928">Quantifying attention flow in transformers</a>. <em>ACL 2020</em>.</li> <li id="ref-6">Naseer, M., Ranasinghe, K., Khan, S., et al. (2021). <a href="https://arxiv.org/abs/2105.10497">Intriguing properties of vision transformers</a>. <em>NeurIPS 2021</em>.</li> <li id="ref-7">Helber, P., Bischke, B., Dengel, A., &amp; Borth, D. (2019). <a href="https://arxiv.org/abs/1709.00029">EuroSAT: a novel dataset and deep learning benchmark for land use and land cover classification</a>. <em>IEEE Journal of Selected Topics in Applied Earth Observations and Remote Sensing</em>.</li> <li id="ref-8">Krizhevsky, A., Sutskever, I., &amp; Hinton, G. E. (2012). <a href="https://papers.nips.cc/paper/2012/hash/c399862d3b9d6b76c8436e924a68c45b-Abstract.html">ImageNet classification with deep convolutional neural networks</a>. <em>NeurIPS 2012</em>.</li> <li id="ref-9">Photographs, all public domain: Peter Pearsall, U.S. Fish and Wildlife Service, <a href="https://commons.wikimedia.org/wiki/File:A_brown_bear_at_Brooks_Falls_captures_a_salmon_in_its_jaws.jpg">brown bear at Brooks Falls</a>; NASA, <a href="https://commons.wikimedia.org/wiki/File:Space_Shuttle_Discovery_Lifts_Off_(2).jpg">Space Shuttle Discovery lifts off</a>; J. D. Griggs, USGS, <a href="https://commons.wikimedia.org/wiki/File:Pahoeoe_fountain_edit2.jpg">pāhoehoe fountain</a>; NOAA Olympic Coast National Marine Sanctuary, <a href="https://commons.wikimedia.org/wiki/File:OCNMS_Orca_breaching_(50040737978).jpg">orca breaching</a>; U.S. Fish and Wildlife Service, <a href="https://commons.wikimedia.org/wiki/File:Rufous_hummingbird_at_Seedskadee_National_Wildlife_Refuge_(51349613347).jpg">rufous hummingbird at Seedskadee</a>.</li> </ol>]]></content> <author> <name>Eva Koroleva</name> </author> <category term="machine-learning"/> <category term="transformer-architectures"/> <category term="vision-transformer"/> <category term="vit"/> <category term="image-classification"/> <category term="dino"/> <category term="dinov2"/> <category term="eurosat"/> <category term="computer-vision"/> <summary type="html"><![CDATA[How a Transformer reads a photo: every step from pixels to a sequence of 197 vectors on a real image, written from scratch and checked against Google's ViT-B/16. What the model learned about patches and positions, where its heads look, DINO's heads finding objects without labels, and ViT against a CNN on satellite images when labels are scarce.]]></summary> <media:thumbnail url="https://blog.korolevalab.com/assets/posts/arch/11/cover.png"/> <media:content medium="image" url="https://blog.korolevalab.com/assets/posts/arch/11/cover.png"/> </entry> <entry> <title type="html">How accurate is Polymarket? Calibration, longshot bias and a volume trap</title> <link href="https://blog.korolevalab.com/blog/2026/polymarket-accuracy/" rel="alternate" type="text/html" title="How accurate is Polymarket? Calibration, longshot bias and a volume trap"/> <published>2026-11-05T00:00:00+00:00</published> <updated>2026-11-05T00:00:00+00:00</updated> <id>https://blog.korolevalab.com/blog/2026/polymarket-accuracy</id> <content type="html" xml:base="https://blog.korolevalab.com/blog/2026/polymarket-accuracy/"><![CDATA[<aside class="tldr"> <p class="tldr-label">In short</p> <p>Polymarket’s prices are good probabilities where people actually trade. A week before the close, markets with real trading are off by under two percentage points on average, and a day before the close they remove 82% of the error of a forecaster who knows only the base rate.</p> <p>The famous accuracy figures say less than they seem, because most questions resolve No. What mispricing is left sits at the tails, cheap longshots a little too dear and near-certain favourites a little too cheap, and it is about the size of the spread.</p> <div class="stats"> <div class="stat"><span class="stat-value">1.8</span><span class="stat-label">points between price and outcome, on average, a week before the close</span></div> <div class="stat"><span class="stat-value">77%</span><span class="stat-label">right for a forecaster who answers No to every question</span></div> <div class="stat"><span class="stat-value">−39%</span><span class="stat-label">average return on contracts bought at 2 to 5 cents</span></div> </div> </aside> <p>On the last evening of October I opened Polymarket to look at one number. The US midterm elections were three days away, and the market on which party would control the Senate had taken $13.5 million of bets.</p> <p>A share that pays a dollar if Democrats win the Senate cost 71.5 cents. The House was hardly a contest by the market’s account: 94.5 cents for Democrats.</p> <p>A week earlier the same kind of number had been wrong in public. Going into Brazil’s presidential runoff on 25 October, Polymarket and Kalshi gave Flávio Bolsonaro about an 80% chance of beating Lula, and Lula won<sup class="cite">[<a href="#ref-1" id="cite-1" data-ref="1" aria-label="Reference 1: CNBC (2026). Lula wins Brazil election despite prediction markets favoring Bolsonaro. 26 October 2026.">1</a>]</sup>. Semafor’s headline that week was that prediction markets had “blown three big elections”<sup class="cite">[<a href="#ref-2" id="cite-2" data-ref="2" aria-label="Reference 2: Semafor (2026). Prediction markets flop on recent elections. 30 October 2026.">2</a>]</sup>.</p> <p>By the time you read this you probably know how the Senate went, and I don’t. Suppose Republicans keep it. Was 71.5 wrong?</p> <p>Suppose they lose it. Was it right? Neither follows, and Brazil does not prove the 80% wrong either.</p> <p>A forecast of 71.5% claims something only about <em>many situations like this one</em>: that roughly seven in ten of them end the way the market leaned, and three in ten don’t.</p> <p>So the question in the title cannot be settled by any one market, however famous. It can be settled by many. I downloaded the record of every market Polymarket resolved from 2024 on, almost three million of them, took the price histories of about 150,000 and checked what the prices said against what then happened.</p> <p>This post is about what came out: how good the prices are as probabilities, where they are systematically off, a trap in the most natural way to slice the data, what the “accuracy” figures in the press leave out, and what a trader can and cannot do with any of it.</p> <h2 id="what-a-polymarket-price-is-and-why-it-should-be-a-probability">What a Polymarket price is, and why it should be a probability</h2> <p>Polymarket sells shares in outcomes. A share of “Yes” pays one dollar if the event happens and nothing if it does not; a share of “No” pays a dollar in the opposite case.</p> <p>Since April 2026 the dollar is pUSD, Polymarket’s own token backed by the USDC stablecoin; before that it was USDC itself<sup class="cite">[<a href="#ref-3" id="cite-3" data-ref="3" aria-label="Reference 3: Polymarket (2026). pUSD. Documentation.">3</a>]</sup>. One Yes and one No together always pay exactly a dollar, so their prices add up to about a dollar too.</p> <p>Every market is binary. A question with many answers, such as who wins a prize, is a set of Yes/No markets, one per candidate.</p> <p>Shares trade in an order book, as on a stock exchange: buyers post bids, sellers post asks, and a trade happens when they meet.</p> <p>The price the site shows, the number the press calls “the odds”, is the midpoint between the best bid and the best ask, or the last trade if the gap between them is wider than ten cents<sup class="cite">[<a href="#ref-4" id="cite-4" data-ref="4" aria-label="Reference 4: Polymarket (2026). Prices and the order book. Documentation.">4</a>]</sup>.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/polymarket-accuracy/anatomy-light.png" width="760" alt="A Polymarket share on the US Senate on 31 October 2026: Yes, Democrats control the Senate, at 71.5¢, and No at 28.5¢; together they make a dollar. The best bid is 71¢ and the best ask 72¢. A Yes share bought at 72¢ pays $$1 if Democrats win, a gain of 28¢, and nothing if they lose, a loss of 72¢. It pays off on average only if the chance of a Democratic Senate is above 72%" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/polymarket-accuracy/anatomy-dark.png" width="760" alt="A Polymarket share on the US Senate on 31 October 2026: Yes, Democrats control the Senate, at 71.5¢, and No at 28.5¢; together they make a dollar. The best bid is 71¢ and the best ask 72¢. A Yes share bought at 72¢ pays $$1 if Democrats win, a gain of 28¢, and nothing if they lose, a loss of 72¢. It pays off on average only if the chance of a Democratic Senate is above 72%" loading="lazy"/></p> <p>Why should that price be a probability? Because of a simple argument about money. If you believe Democrats win the Senate with probability \(q\), a Yes share bought at price \(p\) is worth \(q \cdot 1 + (1 - q) \cdot 0 = q\) to you on average.</p> <p>You buy when \(q &gt; p\) and sell when \(q &lt; p\). The price stops moving where nobody with money left is willing to push it either way.</p> <p>That argument has holes, and economists have spent twenty years mapping them. The price is a compromise between traders, not anyone’s belief.</p> <p>With logarithmic utility it equals the traders’ average belief, and for other reasonable preferences it stays close to it between about 20 and 80 cents<sup class="cite">[<a href="#ref-5" id="cite-5" data-ref="5" aria-label="Reference 5: Wolfers, J., &amp; Zitzewitz, E. (2006). Interpreting prediction market prices as probabilities. NBER Working Paper 12200.">5</a>]</sup>; for risk-neutral traders with different beliefs, a price of 75 cents is compatible with an average belief anywhere from 56% to 94%<sup class="cite">[<a href="#ref-6" id="cite-6" data-ref="6" aria-label="Reference 6: Manski, C. F. (2006). Interpreting the predictions of prediction markets. Economics Letters, 91(3), 425–429.">6</a>]</sup>.</p> <p>Money tied up in a bet until December could have earned interest. Since March 2026 most categories charge the taker a fee<sup class="cite">[<a href="#ref-7" id="cite-7" data-ref="7" aria-label="Reference 7: Polymarket (2026). Trading fees. Documentation.">7</a>]</sup>. And the dollar arrives only if the event is resolved the way you expect, by a process with its own failures.</p> <p>Whether the price works as a probability despite all that is an empirical question, and the rest of this post answers it with data.</p> <h2 id="how-to-check-a-forecaster">How to check a forecaster</h2> <h3 id="calibration">Calibration</h3> <p>A forecaster who said 70% is not wrong when the event fails to happen, but a forecaster who says 70% a thousand times should see about seven hundred of those events happen. That property is called <em>calibration</em>.</p> <p>Weather services have been checked this way for seventy years: on the days a calibrated service gives a 30% chance of rain, it rains on about 30% of them.</p> <p>The picture that shows calibration is the <em>reliability diagram</em>. Take all the forecasts, group them by value (all forecasts between 60% and 70%, say), and for each group plot the average forecast against the share of events that happened. A calibrated forecaster’s points fall on the diagonal.</p> <p>If you have ever trained a classifier and checked whether its predicted probabilities can be trusted, you have drawn this picture already; modern neural networks are famously overconfident on it<sup class="cite">[<a href="#ref-8" id="cite-8" data-ref="8" aria-label="Reference 8: Guo, C., Pleiss, G., Sun, Y., &amp; Weinberger, K. Q. (2017). On calibration of modern neural networks. ICML 2017.">8</a>]</sup>, and how to bin the forecasts is a small science of its own<sup class="cite">[<a href="#ref-9" id="cite-9" data-ref="9" aria-label="Reference 9: Dimitriadis, T., Gneiting, T., &amp; Jordan, A. I. (2021). Stable reliability diagrams for probabilistic classifiers. PNAS, 118(8), e2016191118.">9</a>]</sup>.</p> <p>Calibration is not enough. A forecaster who always announces the <em>base rate</em>, the share of all events that happen, is perfectly calibrated and perfectly useless. About 34% of Polymarket’s markets resolve Yes, so saying “34%” about every market is calibrated: of all the markets you said it about, 34% happened.</p> <p>What a good forecaster adds is <em>resolution</em>, forecasts that move away from the base rate in the right direction, high for the events that happen and low for those that don’t.</p> <h3 id="the-brier-score">The Brier score</h3> <p>The <em>Brier score</em> measures both at once. For \(N\) forecasts \(p_i\) of events with outcomes \(y_i\) (1 if it happened, 0 if not), it is the mean squared error</p> \[\mathrm{BS} = \frac{1}{N} \sum_{i=1}^{N} (p_i - y_i)^2 .\] <p>A forecast of 70% scores \(0.3^2 = 0.09\) if the event happens and \(0.7^2 = 0.49\) if it does not. A forecaster who always says 50% scores \(0.25\), and a clairvoyant scores zero. Glenn Brier’s original score summed the error over both outcomes and ran from 0 to 2, so it is twice this one<sup class="cite">[<a href="#ref-10" id="cite-10" data-ref="10" aria-label="Reference 10: Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1–3.">10</a>]</sup>.</p> <p>The score splits into a part for calibration, called reliability, a part for resolution, and a part that belongs to the questions rather than the forecaster. The <em>skill score</em> says how much of the worst honest score, that of the base-rate forecaster, a forecaster removes.</p> <details class="method"> <summary>The Brier score in three parts: Murphy's decomposition</summary> <p>Allan Murphy showed that the score splits into three parts<sup class="cite">[<a href="#ref-11" id="cite-11" data-ref="11" aria-label="Reference 11: Murphy, A. H. (1973). A new vector partition of the probability score. Journal of Applied Meteorology, 12(4), 595–600.">11</a>]</sup>. Group the forecasts into bins \(k\), each holding a share \(n_k / N\) of them, with average forecast \(\bar p_k\) and observed frequency \(\bar y_k\), and let \(\bar y\) be the overall base rate:</p> \[\mathrm{BS} \approx \underbrace{\sum_k \frac{n_k}{N} (\bar p_k - \bar y_k)^2}_{\text{reliability}} \;-\; \underbrace{\sum_k \frac{n_k}{N} (\bar y_k - \bar y)^2}_{\text{resolution}} \;+\; \underbrace{\bar y (1 - \bar y)}_{\text{uncertainty}} .\] <p>Reliability is the calibration error, the squared distance of the points from the diagonal, and should be small. Resolution is how far the groups’ outcomes spread away from the base rate, and should be large. Uncertainty belongs to the questions, not the forecaster: it is the score of the base-rate forecaster. The skill score \(1 - \mathrm{BS} / \bar y(1 - \bar y)\) says what share of that score a forecaster removes.</p> </details> <h3 id="three-forecasters-on-the-same-markets">Three forecasters on the same markets</h3> <p>The three charts below put this on real data. All three forecasters see the same 18,157 markets a week before they closed. The first is Polymarket’s prices.</p> <p>The second is a bolder copy that doubles the prices’ log-odds, so that 70% becomes 84% and 30% becomes 16%. The third is a timid copy that halves them, so that 70% becomes 60%. The grey square is the base-rate forecaster.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/polymarket-accuracy/forecasters-light.png" width="760" alt="Three reliability diagrams for the same markets a week before they closed. Polymarket&#x27;s own prices lie close to the diagonal, Brier score 0.079. A bolder copy, with the log-odds doubled, bends away from it, Brier 0.084; a timid copy, with them halved, bends the other way, Brier 0.089. A forecaster who always says the base rate, 25%, is a single point on the diagonal, Brier 0.186" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/polymarket-accuracy/forecasters-dark.png" width="760" alt="Three reliability diagrams for the same markets a week before they closed. Polymarket&#x27;s own prices lie close to the diagonal, Brier score 0.079. A bolder copy, with the log-odds doubled, bends away from it, Brier 0.084; a timid copy, with them halved, bends the other way, Brier 0.089. A forecaster who always says the base rate, 25%, is a single point on the diagonal, Brier 0.186" loading="lazy"/></p> <p>The market’s own prices score 0.079. Both copies score worse, 0.084 for the bold one and 0.089 for the timid one, and they fail in opposite ways.</p> <p>The bold copy’s points lie above the diagonal on the left and below it on the right: when it says 5%, the event happens more often than that, because it took a modest forecast and inflated its confidence.</p> <p>The timid copy bends the other way. Neither copy knows anything the market didn’t, and that is the point of the exercise. Distorting a calibrated forecaster in either direction only makes its score worse.</p> <p>The base-rate forecaster says 25% about everything, the share of these markets that resolved Yes, and scores 0.186, more than twice the market’s error.</p> <h2 id="why-one-election-proves-nothing">Why one election proves nothing</h2> <p>The case people quote as proof is the 2024 US presidential election. On the eve of the vote Polymarket priced a Trump win at 59 cents, while 538’s final model gave Kamala Harris 50 chances in 100<sup class="cite">[<a href="#ref-12" id="cite-12" data-ref="12" aria-label="Reference 12: 538 (2024). 538&#x27;s final forecasts for the 2024 presidential election. Republished by 6abc, 5 November 2024.">12</a>]</sup>. Trump won all seven swing states.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/polymarket-accuracy/election-light.png" width="760" alt="Polymarket&#x27;s price for Donald Trump winning the 2024 US presidential election over 2024: near 50 cents in spring, up after the first debate, down to about even after Biden withdrew and Harris entered, rising again in October; 1.53 billion dollars traded" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/polymarket-accuracy/election-dark.png" width="760" alt="Polymarket&#x27;s price for Donald Trump winning the 2024 US presidential election over 2024: near 50 cents in spring, up after the first debate, down to about even after Biden withdrew and Harris entered, rising again in October; 1.53 billion dollars traded" loading="lazy"/></p> <p>The market’s best-known trader that year, a Frenchman the press called Théo, had bet more than $30 million on Trump across several accounts.</p> <p>He told the Wall Street Journal he had “absolutely no political agenda”<sup class="cite">[<a href="#ref-13" id="cite-13" data-ref="13" aria-label="Reference 13: The Wall Street Journal (2024). The Trump betting whale speaks out: &quot;I have absolutely no political agenda&quot;. Republished by To Vima, 1 November 2024.">13</a>]</sup>, and later turned out to have commissioned his own polls, asking people not whom they would vote for but whom their neighbours would<sup class="cite">[<a href="#ref-14" id="cite-14" data-ref="14" aria-label="Reference 14: CBS News (2025). French whale made over &amp;#36;80 million on Polymarket betting on Trump&#x27;s election win. 60 Minutes, 30 November 2025.">14</a>]</sup>. He made tens of millions of dollars, and he was right.</p> <p>Think about what that shows. A forecaster who put 59% on the winner scores \(0.41^2 \approx 0.17\) for that election; one who put 50% scores \(0.25\).</p> <p>A single draw from a coin that lands heads 59% of the time says almost nothing about the coin, and the same arithmetic run on Brazil a week ago says almost nothing in the other direction. One outcome cannot separate a good forecaster from a lucky one.</p> <p>Thousands can.</p> <h2 id="three-million-markets-and-which-of-them-are-forecasts">Three million markets, and which of them are forecasts</h2> <p>Polymarket publishes everything needed to check it. Its Gamma API lists every event and market with its question, its tags, the dollars traded and the final outcome; its order-book API returns the price history of every outcome token.</p> <p>I took every event that closed from 2024 to the end of October 2026 with at least $1,000 traded: 2,959,534 binary markets that resolved cleanly to Yes or No. (The API records only a few thousand markets before 2024, and I leave them out of the counts.)</p> <p>About 0.4% of markets with more than $10,000 traded resolved 50-50, the platform’s answer to a question that turned out ambiguous, and I set those aside.</p> <h3 id="what-polymarket-has-become">What Polymarket has become</h3> <p><img class="tfs-figure tfs-light" src="/assets/posts/polymarket-accuracy/population-light.png" width="760" alt="Stacked bars of resolved Polymarket markets by the year they closed and topic: 2024: 12,964, 2025: 193,734, 2026: 2,752,836. 34% of all of them resolved Yes" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/polymarket-accuracy/population-dark.png" width="760" alt="Stacked bars of resolved Polymarket markets by the year they closed and topic: 2024: 12,964, 2025: 193,734, 2026: 2,752,836. 34% of all of them resolved Yes" loading="lazy"/></p> <p>Polymarket in 2026 is mostly a sports book. One football match can carry a dozen markets (the winner, the handicap, the total goals), and sports make up 73% of all the markets that closed this year.</p> <p>Next come the short crypto markets that ask whether Bitcoin will be higher at the end of the next fifteen minutes, hour or day, 11%, and science and weather questions, 6%. Politics, the subject of nearly every article about prediction markets, is 2% of the count.</p> <p>Downloading the price history of three million markets is not practical, so I sampled about 150,000 of them, and how to sample turned out to matter more than anything else in this study.</p> <p>Big markets were drawn more often than small ones, and every pooled figure is weighted back to the whole population; <a class="arrow-link" href="#the-volume-trap-why-big-markets-seem-to-underprice-longshots">a later section</a> shows what goes wrong without that.</p> <details class="method"> <summary>How the markets were drawn and weighted</summary> <p>I made two independent random draws. The first takes a share of the markets in each topic, whatever their size: 1.7% of sports, 11% of politics, 16% of economics, 20% of culture, 5.5% of crypto, 3.5% of science and weather.</p> <p>The second takes every market with more than $100,000 traded (every sports market with more than a million) and a share of the smaller ones above $10,000. Together they hold 153,602 markets in 80,320 events.</p> <p>Every market had a known chance of being drawn, and when I pool markets each counts in inverse proportion to that chance, so the pooled figures describe all resolved markets rather than my sample; statisticians call this the <em>Horvitz–Thompson estimator</em><sup class="cite">[<a href="#ref-15" id="cite-15" data-ref="15" aria-label="Reference 15: Horvitz, D. G., &amp; Thompson, D. J. (1952). A generalization of sampling without replacement from a finite universe. Journal of the American Statistical Association, 47(260), 663–685.">15</a>]</sup>.</p> <p>Drawing big markets more often is harmless as long as the weights undo it. Leaving markets out, or grouping them by size, is not. Uncertainty comes from a bootstrap over events rather than markets, because the twenty candidates of one election are not twenty independent questions.</p> <p>Market lists come from the Gamma API (<code class="language-plaintext highlighter-rouge">events/keyset</code>), prices from the order-book API (<code class="language-plaintext highlighter-rouge">prices-history</code>, an hourly series for the last two weeks of a market and a 12-hour one for its whole life), and trades from the data API (<code class="language-plaintext highlighter-rouge">trades</code>).</p> </details> <h3 id="what-counts-as-a-forecast">What counts as a forecast</h3> <p>The forecast I score is the price of a market’s first outcome (Yes, in a Yes/No market) a fixed time before the market closed: a week, mostly, and a day, a month or three months where I compare horizons.</p> <p>The close comes after the outcome is known, typically hours after a match ends or a day or two after an election, so a week before the close is before the event itself.</p> <p>A market counts as a forecast only if at least $1,000 had been traded in it in the week before. This matters more than it sounds. Most markets on Polymarket are created, barely traded and resolved, and the price history of such a market is the middle of an almost empty order book.</p> <p>One football market in my sample, on whether a Bundesliga match would have five goals or more, stood at 48 cents a week before the game; most matches end with fewer, this one did too, and over its whole life the market traded $134. That price is not a forecast of a high-scoring game.</p> <p>A bid at one cent and an ask at 95 cents would give it. The test uses only what was known at the time, the trades of that week, which I took from Polymarket’s public trades API.</p> <h2 id="calibration-a-week-out-prices-are-off-by-18-points">Calibration: a week out, prices are off by 1.8 points</h2> <p>Here is the main result.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/polymarket-accuracy/calibration-light.png" width="760" alt="Reliability diagram: markets grouped by their price a week before closing, against the share that resolved Yes: priced 1%, happened 0%; priced 3%, happened 2%; priced 7%, happened 9%; priced 14%, happened 15%; priced 25%, happened 28%; priced 35%, happened 36%; priced 45%, happened 46%; priced 55%, happened 60%; priced 65%, happened 70%; priced 75%, happened 82%; priced 85%, happened 89%; priced 93%, happened 92%; priced 97%, happened 99%; priced 99%, happened 100%. Next to it, a histogram of those prices" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/polymarket-accuracy/calibration-dark.png" width="760" alt="Reliability diagram: markets grouped by their price a week before closing, against the share that resolved Yes: priced 1%, happened 0%; priced 3%, happened 2%; priced 7%, happened 9%; priced 14%, happened 15%; priced 25%, happened 28%; priced 35%, happened 36%; priced 45%, happened 46%; priced 55%, happened 60%; priced 65%, happened 70%; priced 75%, happened 82%; priced 85%, happened 89%; priced 93%, happened 92%; priced 97%, happened 99%; priced 99%, happened 100%. Next to it, a histogram of those prices" loading="lazy"/></p> <p>The points sit close to the diagonal. Of the 18,157 markets with real trading a week before the close, those priced around 25 cents resolved Yes 28% of the time and those around 75 cents 82%.</p> <p>The average gap between price and frequency is 1.8 percentage points, and the reliability term of the Brier score is 0.001, a hundredth of the resolution term, 0.108. A weather service would be pleased with that.</p> <p class="takeaway">When a liquid market says 70%, read it as about 70%, and remember that 70 means it fails three times in ten.</p> <p>The small deviations have a shape. Between 55 and 85 cents events happened a little more often than priced (60% of the markets at 55 cents, 82% of those at 75), while contracts at 2 to 5 cents happened less often than priced, 2.3% of the time against a price of 3.2. The prices are slightly compressed toward the middle: favourites a little too cheap, longshots a little too dear.</p> <p>That is the pattern economic theory predicts for traders who like long shots or dislike tying up money, and it is what a Princeton thesis on 188,509 Polymarket markets found too<sup class="cite">[<a href="#ref-16" id="cite-16" data-ref="16" aria-label="Reference 16: Walker, A. (2026). The price is (almost) right: a calibration analysis of Polymarket pricing data. Senior thesis, Princeton University.">16</a>]</sup>.</p> <p>The right panel shows something just as important: where the forecasts are. Almost half of these markets are priced below 5 cents a week before they close.</p> <p>Most questions on Polymarket are of the form “will this specific thing happen”, most of them don’t happen, and the market knows. Those confident, correct and uninteresting forecasts are a large part of every headline accuracy figure.</p> <h2 id="accuracy-against-a-forecaster-who-always-says-no">Accuracy against a forecaster who always says no</h2> <p>Polymarket advertises its record on a page titled “How accurate is Polymarket?”: 98.7% accurate four hours before resolution, 90.3% a month before<sup class="cite">[<a href="#ref-17" id="cite-17" data-ref="17" aria-label="Reference 17: Polymarket (2026). How accurate is Polymarket? Accessed 31 October 2026.">17</a>]</sup>. Accuracy there means the share of markets where the leading outcome won.</p> <p>It sounds like a hard bar to clear. The same page notes that 78.3% of its markets resolve No, and explains why: “There are usually more ways for something not to happen than to happen in one exact way”.</p> <p>A forecaster who answers “No” to every question without reading it is therefore 78% accurate on Polymarket’s own sample. The left half of the next chart shows what that does to the comparison on mine.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/polymarket-accuracy/accuracy-light.png" width="760" alt="The same 5,420 markets a month, a week and a day before they closed. Left: share where the side priced above 50 cents won, against the share a forecaster who always says No gets right: 1 month before 87% against 77%; 1 week before 93% against 77%; 1 day before 96% against 77%. Right: Brier skill over the base rate: 1 month 48% for all, 40% for those priced 2 to 98 cents; 1 week 70% for all, 54% for those priced 2 to 98 cents; 1 day 82% for all, 57% for those priced 2 to 98 cents" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/polymarket-accuracy/accuracy-dark.png" width="760" alt="The same 5,420 markets a month, a week and a day before they closed. Left: share where the side priced above 50 cents won, against the share a forecaster who always says No gets right: 1 month before 87% against 77%; 1 week before 93% against 77%; 1 day before 96% against 77%. Right: Brier skill over the base rate: 1 month 48% for all, 40% for those priced 2 to 98 cents; 1 week 70% for all, 54% for those priced 2 to 98 cents; 1 day 82% for all, 57% for those priced 2 to 98 cents" loading="lazy"/></p> <p>The chart uses the 5,420 markets that had real trading a month, a week and a day before they closed, so the same questions are scored at every horizon.</p> <p>The favourite won 87% of them a month before the close, 93% a week before and 96% a day before. A forecaster who says No to everything gets 77% right on these markets at every horizon, since only 23% of them resolved Yes.</p> <p>The honest comparison is skill: the market removes 48% of the base-rate forecaster’s Brier score a month out, 70% a week out and 82% a day out. On the questions still in doubt at the time, priced between 2 and 98 cents, it removes 40%, 54% and 57%.</p> <div class="callout callout-key"> <p class="callout-label">Key point</p> <p>Accuracy flatters any forecaster whose questions mostly resolve one way. Ask for skill: the share of the base-rate forecaster’s error that is gone. On Polymarket it is 70% a week before the close, and 54% on the questions still in doubt.</p> </div> <p>Those are the numbers to keep in mind the next time anyone, a platform or a pundit, advertises 90% accuracy.</p> <h2 id="how-the-forecast-sharpens-as-the-close-approaches">How the forecast sharpens as the close approaches</h2> <p>Information arrives over time. The Brier score of markets that lived at least two months traces how quickly.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/polymarket-accuracy/convergence-light.png" width="760" alt="Brier score of 3,492 markets, each open for at least 60 days, by days before the close: 0.084 at 60 days, 0.056 at 30, 0.033 at 7 and 0.021 at half a day, against 0.150 for always saying the base rate. The share priced below 1 cent or above 99 rises from 26% to 75%" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/polymarket-accuracy/convergence-dark.png" width="760" alt="Brier score of 3,492 markets, each open for at least 60 days, by days before the close: 0.084 at 60 days, 0.056 at 30, 0.033 at 7 and 0.021 at half a day, against 0.150 for always saying the base rate. The share priced below 1 cent or above 99 rises from 26% to 75%" loading="lazy"/></p> <p>Sixty days before the close, the 3,492 markets that lived that long and were traded a month out already score 0.084, well below the base rate’s 0.150.</p> <p>The score falls steadily, to 0.056 a month out and 0.033 a week out, and drops again in the last days, when scheduled events (a vote, a match, a data release) take place.</p> <p>The lower panel counts the markets already priced at the extremes, below a cent or above 99 cents: a quarter of them at sixty days, more than half a week out, three quarters at the end. A market at 99.5 cents is not a forecast any more; it is a receipt waiting to be cashed.</p> <h2 id="the-volume-trap-why-big-markets-seem-to-underprice-longshots">The volume trap: why big markets seem to underprice longshots</h2> <p>The obvious next question is whether big markets forecast better than small ones, and the obvious way to answer it is to group markets by the dollars traded. Polymarket’s accuracy page does exactly this. It is a trap, and I walked into it first.</p> <p>My first sample took every market with more than $100,000 traded and a share of those between $10,000 and $100,000, the way one naturally filters out dead markets.</p> <p>In that sample, contracts priced between 10 and 20 cents a week before the close returned 25% on average, and the bigger the market, the more the longshots won.</p> <p>It looked like the reverse of everything the racetrack literature says, and a trading strategy in one line. Here are the longshots of the sample drawn by topic, grouped two ways.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/polymarket-accuracy/trap-light.png" width="760" alt="Contracts priced 2 to 20 cents a week before the close: how often they won divided by their price, grouped by the market&#x27;s total volume and by the dollars traded in it in the week before. By total volume: under $$1K 0.49; $$1K–10K 0.60; $$10K–100K 1.13; $$100K–1M 1.34; $$1M–10M 2.14. By the week before: under $$100 0.72; $$100–1K 0.87; $$1K–10K 0.96; $$10K–100K 0.81" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/polymarket-accuracy/trap-dark.png" width="760" alt="Contracts priced 2 to 20 cents a week before the close: how often they won divided by their price, grouped by the market&#x27;s total volume and by the dollars traded in it in the week before. By total volume: under $$1K 0.49; $$1K–10K 0.60; $$10K–100K 1.13; $$100K–1M 1.34; $$1M–10M 2.14. By the week before: under $$100 0.72; $$100–1K 0.87; $$1K–10K 0.96; $$10K–100K 0.81" loading="lazy"/></p> <p>On the left, grouped by the dollars a market traded over its whole life, contracts priced 2 to 20 cents won about half as often as priced in markets under $1,000 (a ratio of 0.49) and twice as often in markets of $1–10 million (2.14).</p> <p>On the right, the same contracts grouped by the dollars traded in the week before the forecast show <em>nothing of the kind</em>: 0.72 in the thinnest markets, 0.87 and 0.96 as trading grows. Favourites mirror it, from 1.05 to 0.88 on the left and flat at about 1.0 on the right.</p> <p>The left panel is an artefact, and the reason is in what volume counts. A market’s total volume includes all the trading after the forecast, and nothing makes people trade like a surprise.</p> <p>When a 10-cent candidate starts winning, the market fills with buyers, sellers, hedgers and spectators, and its volume jumps; when the favourite wins as expected, the market stays quiet and small.</p> <p class="flow"><span>a longshot starts winning</span><span>everyone trades it</span><span>its volume grows</span><span>"big markets underprice longshots"</span></p> <p>So sorting markets by total volume quietly sorts them by whether the unlikely happened. In statistics this is <em>selection on a consequence of the outcome</em>, the same family of error as look-ahead bias in a backtest, which I wrote about in the post on <a href="/blog/2026/ai-crypto-trading/">AI crypto trading bots</a>. Polymarket’s own accuracy page breaks its Brier scores down by volume in exactly this way.</p> <div class="callout callout-warn"> <p class="callout-label">Trap</p> <p>Never filter, group or weight markets by their total volume, or by anything else that is counted after the forecast. Use what was known when the price was set: the dollars traded in the week before, the order book at the time, the topic.</p> </div> <p>The right panel is the honest version, because <em>the week before a forecast is over when the forecast is made</em>. It says something useful.</p> <p>In thin markets longshots are overpriced, and the more a market trades, the closer to fair they become. That is why the rest of this post, like the calibration above, uses the test of $1,000 traded in the week before and never groups markets by their total volume.</p> <h2 id="longshots-lose-favourites-earn-a-little">Longshots lose, favourites earn a little</h2> <p>Calibration is an average, and averages hide the tails. The tails are where traders make or lose money, and economists have known for seventy years where to look: at the racetrack, bettors overpay for longshots and underpay for favourites<sup class="cite">[<a href="#ref-18" id="cite-18" data-ref="18" aria-label="Reference 18: Griffith, R. M. (1949). Odds adjustments by American horse-race bettors. American Journal of Psychology, 62(2), 290–294.">18</a>]</sup>.</p> <p>In six million American horse races, betting on horses at 100 to 1 or longer lost about 61% of the stake, while betting on the favourite in every race lost only 5.5%<sup class="cite">[<a href="#ref-19" id="cite-19" data-ref="19" aria-label="Reference 19: Snowberg, E., &amp; Wolfers, J. (2010). Explaining the favorite–long shot bias: is it risk-love or misperceptions? Journal of Political Economy, 118(4), 723–746.">19</a>]</sup>. On Kalshi, contracts bought below 10 cents lost over 60% of the money put into them<sup class="cite">[<a href="#ref-20" id="cite-20" data-ref="20" aria-label="Reference 20: Bürgi, C., Deng, W., &amp; Whelan, K. (2026). Makers and takers: the economics of the Kalshi prediction market. GWU Center for Economic Research Working Paper 2026-001.">20</a>]</sup>.</p> <p>To look for it on Polymarket, I treated both sides of every market as a contract: a Yes at the price \(p\) and a No at \(1 - p\). Buying a contract at price \(p\) that pays \(y \in \{0, 1\}\) returns \(y / p - 1\) on the stake. If prices were exact probabilities, the average return in every price band would be zero.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/polymarket-accuracy/returns-light.png" width="760" alt="Average return of buying a contract a week before the close, by price band: 0.5–2¢ -22.5%; 2–5¢ -38.8%; 5–10¢ +19.4%; 10–20¢ -2.5%; 20–30¢ -4.1%; 30–40¢ -3.8%; 40–50¢ -3.9%; 50–60¢ +3.3%; 60–70¢ +2.9%; 70–80¢ +0.3%; 80–90¢ +0.0%; 90–95¢ -1.4%; 95–98¢ +1.1%; 98–99.5¢ +0.3%" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/polymarket-accuracy/returns-dark.png" width="760" alt="Average return of buying a contract a week before the close, by price band: 0.5–2¢ -22.5%; 2–5¢ -38.8%; 5–10¢ +19.4%; 10–20¢ -2.5%; 20–30¢ -4.1%; 30–40¢ -3.8%; 40–50¢ -3.9%; 50–60¢ +3.3%; 60–70¢ +2.9%; 70–80¢ +0.3%; 80–90¢ +0.0%; 90–95¢ -1.4%; 95–98¢ +1.1%; 98–99.5¢ +0.3%" loading="lazy"/></p> <p>The bias is there, and it lives at the extremes. Contracts priced between 2 and 5 cents a week before the close won 2.1% of the time while costing 3.2 cents on average, so buying them lost 39% of the stake, with a 95% interval from −53% to −22%.</p> <p>The cheapest band, under 2 cents, lost 22%, with an interval wide enough to include zero.</p> <p>At the other end, contracts at 95 to 98 cents won 97.8% of the time and returned 1.15% in the week, and those at 98 to 99.5 cents returned 0.35%; both intervals stay above zero. Between 5 and 95 cents the averages cannot be told apart from zero.</p> <p class="takeaway">Longshots under 5 cents lose a quarter to two fifths of the stake; favourites above 95 cents earn a fraction of a percent a week, before costs.</p> <details class="method"> <summary>How the returns are counted, and why the weighting matters</summary> <p>How contracts are weighted matters for this kind of result. A study of 588 million Polymarket trades found that buys under 10 cents lost 19.3 cents per dollar when weighted by the money traded, 6.3 cents when each contract counted once, and gained 4.1 cents when related contracts were first grouped by event<sup class="cite">[<a href="#ref-21" id="cite-21" data-ref="21" aria-label="Reference 21: Cardozo, M., &amp; Rivero-Wildemauwe, J. I. (2026). The favorite-longshot bias in prediction markets: evidence from Polymarket. arXiv:2609.12878.">21</a>]</sup>.</p> <p>My numbers count each market once, weighted to the population of markets, with uncertainty from resampling whole events.</p> <p>A return here is that of one contract bought at the mid price a week before the close and held to the end, averaged over contracts in a price band with the population weights; the interval resamples whole events 400 times.</p> </details> <p>A favourite at 97 cents that earns a percent in a week sounds like free money, and it is not. The bars are mid prices, and nobody buys at the mid.</p> <p>The downside is a total loss on the rare occasion the favourite fails, and the 50-50 resolutions I excluded would cost a favourite buyer half the stake; at about 0.4% of markets they take back up to 0.2 points of that return.</p> <h2 id="what-the-spread-and-the-fees-take">What the spread and the fees take</h2> <p>The price shown is the middle of the order book, but a buyer pays the ask. On the last night of October I recorded the best bid and ask of all 124,068 open markets, 57,468 of them with orders on both sides, and measured what buying at the ask costs above the middle, as a share of the price paid.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/polymarket-accuracy/spread-light.png" width="760" alt="Median cost of buying at the ask instead of the middle of the book, as a share of the price, by contract price: 0.5–2¢ 66.7%; 2–5¢ 66.1%; 5–10¢ 29.4%; 10–20¢ 13.0%; 20–30¢ 6.7%; 30–40¢ 4.8%; 40–50¢ 2.5%; 50–60¢ 2.0%; 60–70¢ 2.4%; 70–80¢ 2.1%; 80–90¢ 2.3%; 90–95¢ 2.2%; 95–98¢ 2.1%; 98–99.5¢ 0.6%" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/polymarket-accuracy/spread-dark.png" width="760" alt="Median cost of buying at the ask instead of the middle of the book, as a share of the price, by contract price: 0.5–2¢ 66.7%; 2–5¢ 66.1%; 5–10¢ 29.4%; 10–20¢ 13.0%; 20–30¢ 6.7%; 30–40¢ 4.8%; 40–50¢ 2.5%; 50–60¢ 2.0%; 60–70¢ 2.4%; 70–80¢ 2.1%; 80–90¢ 2.3%; 90–95¢ 2.2%; 95–98¢ 2.1%; 98–99.5¢ 0.6%" loading="lazy"/></p> <p>For contracts between 40 and 95 cents the median cost is about 2% of the price. Below 20 cents it explodes: 13% for contracts at 10 to 20 cents, 29% at 5 to 10, and about two thirds of the price under 5 cents.</p> <p>A two-cent contract with a bid at one cent and an ask at three costs a full cent above its middle, half of what it is worth on paper. At the other end, near-certain contracts above 98 cents are cheap to buy, 0.6% of the price.</p> <p>On top of the spread comes the fee. Since 30 March 2026 a taker on most categories pays \(r \cdot p(1 - p)\) per share, where \(p\) is the price and the rate \(r\) is 0.04 for politics, 0.05 for sports and most other categories and 0.07 for crypto; makers pay nothing, and geopolitical markets are free<sup class="cite">[<a href="#ref-7" id="cite-22" data-ref="7" aria-label="Reference 7: Polymarket (2026). Trading fees. Documentation.">7</a>]</sup>.</p> <p>As a share of the money paid that is \(r(1 - p)\): about 5% of the stake for a 5-cent sports contract, a quarter of a percent for a 95-cent one.</p> <p>Many of the busiest markets ran with the fee switched off on the day I looked, so the rate has to be checked market by market.</p> <p>Put together, a longshot buyer who crosses the spread gives up between a tenth and two thirds of the stake before the event even happens.</p> <p>A favourite buyer gives up a couple of percent, more than the whole edge the previous chart found: after half the spread the 95–98 cent band goes from +1.15% to −0.9% a week, and the 98–99.5 cent band from +0.35% to −0.3%. The diamonds on that chart show it.</p> <div class="callout"> <p class="callout-label">For traders</p> <p>The longshot discount and the favourite premium are real, but they are about the size of what it costs to trade them, which is why they survive. Selling longshots and buying near-certainties works only for those who post limit orders and let others cross the spread.</p> </div> <h2 id="topics-politics-is-calibrated-best">Topics: politics is calibrated best</h2> <p><img class="tfs-figure tfs-light" src="/assets/posts/polymarket-accuracy/topics-light.png" width="760" alt="Brier skill and calibration error a week before the close, by topic: Politics and world skill 58%, error 1.9 points; Sports skill 53%, error 4.4 points; Crypto prices and events skill 54%, error 3.9 points; Economy and markets skill 60%, error 3.3 points; Culture and media skill 59%, error 2.3 points; Science, tech, weather skill 70%, error 4.1 points" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/polymarket-accuracy/topics-dark.png" width="760" alt="Brier skill and calibration error a week before the close, by topic: Politics and world skill 58%, error 1.9 points; Sports skill 53%, error 4.4 points; Crypto prices and events skill 54%, error 3.9 points; Economy and markets skill 60%, error 3.3 points; Culture and media skill 59%, error 2.3 points; Science, tech, weather skill 70%, error 4.1 points" loading="lazy"/></p> <p>A week before the close, markets with real trading are skilled in every topic, from about 53% of the base rate’s error removed in sports and crypto to 70% in science and weather.</p> <p>Politics, with 8,929 markets the largest group, is also the best calibrated, with an average gap of 1.9 points; sports and science have the largest gaps, 4.4 and 4.1, with crypto close behind at 3.9. Sports here means the markets traded a week before the close, mostly season futures (who wins the league, who wins the award) rather than single games, which are listed only days before kick-off.</p> <h3 id="crypto-markets-resolve-together">Crypto markets resolve together</h3> <p>Crypto deserves a chart of its own, because its errors have a cause that has nothing to do with the traders’ judgement.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/polymarket-accuracy/crypto-light.png" width="760" alt="Two panels by month. Top: among crypto price markets priced 30 to 70 cents a week before the close, the share where the side betting on rising prices won, against that side&#x27;s average price. Bottom: Bitcoin&#x27;s return that month. The two move together: 2024-12: 29% of 17, Bitcoin -3%; 2025-01: 58% of 12, Bitcoin +9%; 2025-02: 39% of 18, Bitcoin -18%; 2025-03: 31% of 16, Bitcoin -2%; 2025-04: 67% of 12, Bitcoin +14%; 2025-05: 73% of 15, Bitcoin +11%; 2025-06: 40% of 10, Bitcoin +2%; 2025-07: 75% of 16, Bitcoin +8%; 2025-09: 60% of 10, Bitcoin +5%; 2025-10: 20% of 10, Bitcoin -4%; 2025-11: 29% of 14, Bitcoin -18%; 2026-01: 41% of 17, Bitcoin -10%; 2026-02: 30% of 10, Bitcoin -15%; 2026-04: 67% of 15, Bitcoin +12%; 2026-09: 50% of 10, Bitcoin +6%" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/polymarket-accuracy/crypto-dark.png" width="760" alt="Two panels by month. Top: among crypto price markets priced 30 to 70 cents a week before the close, the share where the side betting on rising prices won, against that side&#x27;s average price. Bottom: Bitcoin&#x27;s return that month. The two move together: 2024-12: 29% of 17, Bitcoin -3%; 2025-01: 58% of 12, Bitcoin +9%; 2025-02: 39% of 18, Bitcoin -18%; 2025-03: 31% of 16, Bitcoin -2%; 2025-04: 67% of 12, Bitcoin +14%; 2025-05: 73% of 15, Bitcoin +11%; 2025-06: 40% of 10, Bitcoin +2%; 2025-07: 75% of 16, Bitcoin +8%; 2025-09: 60% of 10, Bitcoin +5%; 2025-10: 20% of 10, Bitcoin -4%; 2025-11: 29% of 14, Bitcoin -18%; 2026-01: 41% of 17, Bitcoin -10%; 2026-02: 30% of 10, Bitcoin -15%; 2026-04: 67% of 15, Bitcoin +12%; 2026-09: 50% of 10, Bitcoin +6%" loading="lazy"/></p> <p>Most crypto markets ask about one number, the price of Bitcoin or Ether on a date. Take the close calls, markets priced between 30 and 70 cents a week out, and orient each so that Yes means the price went up.</p> <p>In the months when Bitcoin rose, the bet on rising prices won 63% of the time; in the months when it fell, 32%. Its price a week before was about 50 cents in both. Across fifteen months, the share of winning bullish bets and Bitcoin’s monthly return have a correlation of 0.78.</p> <p>The market was not wrong in any useful sense: a week before the close nobody knew which way Bitcoin would go, and 50 cents was a fair price for a coin toss. But a dozen such markets in one month are not a dozen tosses. They are one toss recorded a dozen times.</p> <p>A calibration chart of crypto markets mostly shows whether the period studied was a good one for Bitcoin. Calibration needs independent questions, which is why I resample whole events rather than markets, and why even that understates the uncertainty for crypto.</p> <h2 id="long-dated-favourites-and-the-price-of-waiting">Long-dated favourites and the price of waiting</h2> <p>A market that resolves in six months has to pay its traders for waiting. A No share at 95 cents on a question that will almost certainly resolve No pays 5 cents on 95 after half a year, about 10.8% a year, if it pays at all; three-month US Treasury bills paid 4.07% on average in 2025 and 3.71% so far in 2026<sup class="cite">[<a href="#ref-22" id="cite-23" data-ref="22" aria-label="Reference 22: Federal Reserve Bank of St. Louis (2026). 3-month Treasury bill secondary market rate (DTB3). FRED.">22</a>]</sup>.</p> <p>Traders who could earn interest elsewhere will not bid near-certain long-dated contracts all the way to a dollar, and the people with the most money to commit, favourite buyers, drop out first.</p> <p>Page and Clemen found the result on the old Intrade exchange: markets far from expiry were poorly calibrated, with prices “systematically biased toward 0.50”<sup class="cite">[<a href="#ref-23" id="cite-24" data-ref="23" aria-label="Reference 23: Page, L., &amp; Clemen, R. T. (2013). Do prediction markets produce well-calibrated probability forecasts? The Economic Journal, 123(568), 491–513.">23</a>]</sup>.</p> <p>Polymarket noticed. Since September 2025 it has paid interest on positions in a short list of long-dated markets “to keep long-term pricing accurate”, 4% a year at launch and 3.25% since June 2026<sup class="cite">[<a href="#ref-24" id="cite-25" data-ref="24" aria-label="Reference 24: Polymarket (2026). Holding rewards. Help center, 1 June 2026.">24</a>]</sup>.</p> <p>The list holds about eighteen events, the 2028 presidential race and the midterms among them. Every other market pays nothing for waiting.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/polymarket-accuracy/long-light.png" width="760" alt="Contracts priced above 90 cents one, three and six months before the close: their price, how often they won and what holding them to the end returned per year: 1 month 90–95¢: price 92.6%, won 94.3%, +25.0% a year; 1 month 95–98¢: price 96.6%, won 98.4%, +23.9% a year; 1 month 98–99.5¢: price 98.8%, won 99.3%, +6.4% a year; 3 months 90–95¢: price 92.6%, won 94.7%, +9.3% a year; 3 months 95–98¢: price 96.7%, won 98.1%, +6.2% a year; 3 months 98–99.5¢: price 98.9%, won 97.7%, -4.9% a year; 6 months 90–95¢: price 92.7%, won 97.0%, +9.3% a year; 6 months 95–98¢: price 96.6%, won 93.3%, -6.8% a year; 6 months 98–99.5¢: price 98.9%, won 98.7%, -0.4% a year" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/polymarket-accuracy/long-dark.png" width="760" alt="Contracts priced above 90 cents one, three and six months before the close: their price, how often they won and what holding them to the end returned per year: 1 month 90–95¢: price 92.6%, won 94.3%, +25.0% a year; 1 month 95–98¢: price 96.6%, won 98.4%, +23.9% a year; 1 month 98–99.5¢: price 98.8%, won 99.3%, +6.4% a year; 3 months 90–95¢: price 92.6%, won 94.7%, +9.3% a year; 3 months 95–98¢: price 96.7%, won 98.1%, +6.2% a year; 3 months 98–99.5¢: price 98.9%, won 97.7%, -4.9% a year; 6 months 90–95¢: price 92.7%, won 97.0%, +9.3% a year; 6 months 95–98¢: price 96.6%, won 93.3%, -6.8% a year; 6 months 98–99.5¢: price 98.9%, won 98.7%, -0.4% a year" loading="lazy"/></p> <p>Polymarket shows the same thing. Contracts priced between 90 and 95 cents a month before the close won 94.3% of the time against a price of 92.6, and those at 95 to 98 cents won 98.4% against 96.6.</p> <p>Held to the end, both earned about 1.8% in a month, which compounds to roughly 25% a year, six times what a Treasury bill paid.</p> <p>Three months out, the same two bands earned 6 to 9% a year and the most expensive band lost money; six months out the samples are small and the results noisy.</p> <p class="takeaway">A month before the close, favourites at 90 to 98 cents paid about 25% a year at mid prices: the price of waiting, not of ignorance.</p> <p>The pattern fits Page and Clemen: near-certain long-dated contracts are a little too cheap, and the discount is about what impatient money charges. It is not free money either.</p> <p>These are mid prices, a single failure costs the whole stake, and a trader who buys favourites a month out is lending to the market at a rate that has to cover the risk that the near-certain doesn’t happen.</p> <h2 id="a-two-number-correction-that-doesnt-help">A two-number correction that doesn’t help</h2> <p>An engineer looking at the calibration chart will ask the obvious question: if the market is slightly off in a systematic way, can a model correct it? This is the same move as calibrating a classifier. Fit two numbers, \(a\) and \(b\), so that a corrected probability</p> \[\hat q = \sigma\big(a \cdot \operatorname{logit}(p) + b\big), \qquad \operatorname{logit}(p) = \ln \frac{p}{1 - p}, \quad \sigma(z) = \frac{1}{1 + e^{-z}},\] <p>fits the outcomes better. With \(b = 0\), a slope \(a &gt; 1\) means the prices should have been bolder, longshots cheaper and favourites dearer, and \(a &lt; 1\) means they should have been more timid. This is <em>Platt scaling</em>, a standard way to recalibrate a classifier<sup class="cite">[<a href="#ref-25" id="cite-26" data-ref="25" aria-label="Reference 25: Niculescu-Mizil, A., &amp; Caruana, R. (2005). Predicting good probabilities with supervised learning. ICML 2005.">25</a>]</sup>.</p> <p>A Princeton thesis that fitted it to 188,509 Polymarket markets found a slope of 1.112<sup class="cite">[<a href="#ref-16" id="cite-27" data-ref="16" aria-label="Reference 16: Walker, A. (2026). The price is (almost) right: a calibration analysis of Polymarket pricing data. Senior thesis, Princeton University.">16</a>]</sup>, and a study of Kalshi and Polymarket found political markets “compressed toward 50%” in the same sense<sup class="cite">[<a href="#ref-26" id="cite-28" data-ref="26" aria-label="Reference 26: Le, N. A. (2026). Decomposing crowd wisdom: domain-specific calibration dynamics in prediction markets. arXiv:2602.19520.">26</a>]</sup>.</p> <p>The interesting question is whether such a correction helps on markets it has not seen. I fitted \(a\) and \(b\) only on markets that closed before July 2025 and scored the correction on markets that closed after.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/polymarket-accuracy/recalibration-light.png" width="760" alt="The fitted correction from Polymarket&#x27;s price to a probability, against the diagonal, for one week and one month before the close: 1 week: slope 1.12, Brier on later markets 0.0796 before and 0.0797 after; 1 month: slope 1.18, Brier on later markets 0.0758 before and 0.0761 after" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/polymarket-accuracy/recalibration-dark.png" width="760" alt="The fitted correction from Polymarket&#x27;s price to a probability, against the diagonal, for one week and one month before the close: 1 week: slope 1.12, Brier on later markets 0.0796 before and 0.0797 after; 1 month: slope 1.18, Brier on later markets 0.0758 before and 0.0761 after" loading="lazy"/></p> <p>Fitted on the markets that closed before July 2025, the correction has a slope of 1.12 a week before the close and 1.18 a month before: the prices should have been a little bolder, the same compression the calibration chart showed, and close to Walker’s 1.112.</p> <p>Applied to the 13,618 markets that closed later, it changes the Brier score a week out by −0.0001, with a 95% interval from −0.0009 to +0.0008, and a month out by −0.0003. In other words, <em>nothing</em>.</p> <p>The bias is real on average, but too small and too unstable over time for a formula to turn it into a better forecast, let alone a profit after the spread.</p> <div class="callout"> <p class="callout-label">For engineers</p> <p>The same discipline applies to any recalibration of a model: fit it on the past, score it on the future, and report the difference with its interval. Here a correction that every in-sample diagnostic recommends turns out to be worth nothing.</p> </div> <h2 id="insiders-when-the-market-knows-too-early">Insiders: when the market knows too early</h2> <p>The most impressive forecasts on Polymarket are sometimes not forecasts at all.</p> <h3 id="the-nobel-peace-prize">The Nobel Peace Prize</h3> <p><img class="tfs-figure tfs-light" src="/assets/posts/polymarket-accuracy/nobel-light.png" width="760" alt="Prices of the leading candidates for the 2025 Nobel Peace Prize on Polymarket from midday on 8 October to the announcement on 10 October. María Corina Machado&#x27;s price is near the bottom until late on 9 October, then rises within hours to about two thirds of a dollar before the announcement at 09:00 UTC" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/polymarket-accuracy/nobel-dark.png" width="760" alt="Prices of the leading candidates for the 2025 Nobel Peace Prize on Polymarket from midday on 8 October to the announcement on 10 October. María Corina Machado&#x27;s price is near the bottom until late on 9 October, then rises within hours to about two thirds of a dollar before the announcement at 09:00 UTC" loading="lazy"/></p> <p>The Norwegian Nobel Committee announced the 2025 Peace Prize at 09:00 UTC on 10 October. For months María Corina Machado had traded at a cent or two. Shortly after midnight in Oslo her price started to climb, passed 43 cents before one in the morning and reached 73 by two<sup class="cite">[<a href="#ref-27" id="cite-29" data-ref="27" aria-label="Reference 27: Decrypt (2025). Nobel Peace Prize organizers investigating Polymarket insider trades. 10 October 2025.">27</a>]</sup>.</p> <p>In the price history I downloaded she was still at 67 cents five minutes before the announcement. An account created days earlier bought early and made tens of thousands of dollars.</p> <p>The director of the Norwegian Nobel Institute said, “We take this very seriously”<sup class="cite">[<a href="#ref-28" id="cite-30" data-ref="28" aria-label="Reference 28: Bloomberg (2025). Unusual Polymarket bets on Peace Prize winner spur probe. Via Bloomberg Law, 10 October 2025.">28</a>]</sup>. In January the institute concluded that the winner’s name had most likely leaked through “the digital domain” and that it could not say who was behind it<sup class="cite">[<a href="#ref-29" id="cite-31" data-ref="29" aria-label="Reference 29: Reuters (2026). Nobel committee says Peace Prize winner likely revealed early by digital spying. Via CP24, 30 January 2026.">29</a>]</sup>.</p> <h3 id="maduro-the-iran-strikes-and-google">Maduro, the Iran strikes and Google</h3> <p>That was not the only case. On the night of 2 January 2026, hours before Donald Trump announced the capture of Nicolás Maduro, a weeks-old account bet about $33,000 that Maduro would be out by the end of the month and made about $400,000.</p> <p>In April the Justice Department charged a Special Forces master sergeant who had helped plan the operation, and the CFTC called it the first insider-trading case it had ever brought over event contracts<sup class="cite">[<a href="#ref-30" id="cite-32" data-ref="30" aria-label="Reference 30: U.S. Department of Justice (2026). U.S. soldier charged with using classified information to profit from prediction market bets. 23 April 2026.">30</a>, <a href="#ref-31" id="cite-33" data-ref="31" aria-label="Reference 31: Commodity Futures Trading Commission (2026). Press release 9217-26. 23 April 2026.">31</a>]</sup>. He has pleaded not guilty.</p> <p>Hours before the US strikes on Iran on 28 February, six freshly funded wallets bought Yes on the strike market and made about a million dollars<sup class="cite">[<a href="#ref-32" id="cite-34" data-ref="32" aria-label="Reference 32: The Block (2026). Fresh accounts netted &amp;#36;1 million on Polymarket hours before US airstrikes on Iran. 28 February 2026.">32</a>]</sup>.</p> <p>In May a Google engineer was charged over about $1.2 million made on markets about Google’s “Year in Search” lists, using, according to Google, marketing material he could see at work<sup class="cite">[<a href="#ref-33" id="cite-35" data-ref="33" aria-label="Reference 33: CBS News (2026). Google employee charged with insider trading on Polymarket. 28 May 2026.">33</a>]</sup>.</p> <p>Polymarket’s chief executive once put it plainly to CBS<sup class="cite">[<a href="#ref-34" id="cite-36" data-ref="34" aria-label="Reference 34: CBS News (2026). Polymarket trader made &amp;#36;400,000 on Maduro&#x27;s capture. 6 January 2026.">34</a>]</sup>:</p> <blockquote class="pull"> <p>Insiders having an edge to the market is a good thing.</p> <p><cite>Shayne Coplan, chief executive of Polymarket</cite></p> </blockquote> <p>For accuracy, in a narrow sense, he is right: the price moved to the truth before the public knew it. It is not prediction, though, and it is no use to an ordinary trader, who is the one on the other side of each of those trades.</p> <p>The company now says it referred the Maduro trader to the Justice Department itself. In Congress, one bill would bar officials and their staff from trading on government decisions<sup class="cite">[<a href="#ref-35" id="cite-37" data-ref="35" aria-label="Reference 35: Torres, R. (2026). Rep. Ritchie Torres introduces legislation to crack down on insider trading on prediction markets. Press release.">35</a>]</sup>, and another would ban markets on elections, sports and military action altogether<sup class="cite">[<a href="#ref-36" id="cite-38" data-ref="36" aria-label="Reference 36: Raskin, J. (2026). Raskin, Merkley legislation would ban prediction market gambling on elections, sports, war and government activity. Press release, 26 March 2026.">36</a>]</sup>.</p> <h2 id="resolution-when-the-truth-is-decided-by-a-vote">Resolution: when the truth is decided by a vote</h2> <p>A share pays a dollar if the event happens, but someone has to say whether it happened. On Polymarket that someone is usually UMA’s <em>optimistic oracle</em>. A proposer posts an outcome with a bond, typically $750, and from there it is a chain of deadlines<sup class="cite">[<a href="#ref-37" id="cite-39" data-ref="37" aria-label="Reference 37: Polymarket (2026). Resolution. Documentation.">37</a>]</sup>:</p> <p class="flow"><span>a proposal</span><span>two hours to dispute it</span><span>a second dispute</span><span>a vote of UMA holders, two days</span></p> <p>Most markets resolve in two hours without a dispute. The ones that don’t are where prediction becomes a governance problem.</p> <p>In March 2025 a $7 million market on whether Ukraine would agree to a minerals deal with the US before April resolved Yes, although Ukraine had not agreed; a single large token holder was accused of swinging the vote, and Polymarket called the situation “unprecedented” but paid no refunds, since “this wasn’t a market failure”<sup class="cite">[<a href="#ref-38" id="cite-40" data-ref="38" aria-label="Reference 38: The Block (2025). Polymarket says governance attack by UMA whale to hijack a bet&#x27;s resolution is &quot;unprecedented&quot;. 26 March 2025.">38</a>]</sup>.</p> <p>That summer a market with hundreds of millions of dollars traded asked whether Volodymyr Zelensky would be photographed in a suit; he appeared at a NATO summit in a black jacket and matching trousers that many outlets called a suit, and UMA’s voters decided it was not<sup class="cite">[<a href="#ref-39" id="cite-41" data-ref="39" aria-label="Reference 39: DL News (2025). Polymarket bettors clash over Zelenskyy suit dispute. 30 June 2025.">39</a>]</sup>.</p> <p>In May 2026 Bloomberg found that nine wallets held about half of the UMA votes cast in Polymarket disputes over three years<sup class="cite">[<a href="#ref-40" id="cite-42" data-ref="40" aria-label="Reference 40: Bloomberg (2026). Las disputas en Polymarket exponen el lado oscuro de los mercados de predicción. Via Bloomberg Línea, 29 May 2026.">40</a>]</sup>.</p> <p>The platform has been narrowing the problem: since September 2025 only whitelisted proposers can propose outcomes, which cut disputes by two thirds in the first month<sup class="cite">[<a href="#ref-41" id="cite-43" data-ref="41" aria-label="Reference 41: UMA (2025). Managed proposers: an update. Blog, 8 November 2025.">41</a>]</sup>, crypto price markets now settle from Chainlink prices without a vote, and a new contract system that can combine several oracles is due to switch on for new markets this week<sup class="cite">[<a href="#ref-42" id="cite-44" data-ref="42" aria-label="Reference 42: The Block (2026). Polymarket rolls out V2 upgrade. 6 October 2026.">42</a>]</sup>.</p> <p>For a trader, resolution risk is a cost like the spread, small on most markets and large on exactly the ones with ambiguous wording.</p> <h2 id="wash-trading-volume-that-isnt">Wash trading: volume that isn’t</h2> <p>Volume is the number every article about Polymarket leads with, and it is the least reliable number on the platform.</p> <p>Researchers at Columbia classified nearly 25% of Polymarket’s historical volume as consistent with <em>wash trading</em>, traders buying from and selling to themselves without changing their position; it peaked at nearly 60% of weekly volume in December 2024, and in sports markets it reached 45% of all-time volume<sup class="cite">[<a href="#ref-43" id="cite-45" data-ref="43" aria-label="Reference 43: Sirolly, A., Ma, H., Kanoria, Y., &amp; Sethi, R. (2025). Network-based detection of wash trading. SSRN Working Paper 5714122.">43</a>]</sup>.</p> <p>Separately, Paradigm showed in December 2025 that most dashboards counted every trade twice, once for each side<sup class="cite">[<a href="#ref-44" id="cite-46" data-ref="44" aria-label="Reference 44: Paradigm (2025). Polymarket volume is being double-counted. 8 December 2025.">44</a>]</sup>.</p> <p>Neither changes the prices this post studies: a wash trade moves money in a circle, not the price. But together with the trap above, they are good reasons not to read a market’s volume as a measure of how much it knows.</p> <h2 id="what-a-polymarket-price-is-worth">What a Polymarket price is worth</h2> <p>As a probability, a Polymarket price on a market people actually trade is about as good as public forecasts get.</p> <p>A week before the close the prices were calibrated to within 1.8 percentage points on average, and on the markets open for at least a month they removed 70% of the base-rate forecaster’s error a week out and 82% a day out.</p> <p>When a liquid market says 70%, the honest reading is “about 70%”, give or take a few points.</p> <p>That is a statement about many markets, not about one. The Senate at 71.5 cents is a single draw, and so was Brazil at 80. A calibrated price is still wrong three times in ten when it says 70, which is what 70 means.</p> <p>The weak spots are where theory and the data agree they should be. Thin markets are not forecasts at all, and in them longshots are overpriced. Prices months before the close drift toward 50 cents, because waiting costs money and Polymarket pays for the wait on only a handful of markets.</p> <p>Crypto price markets share one driver and resolve together, so a bad month for Bitcoin looks like miscalibration. Insiders sometimes move prices before the news, which makes the forecast <em>right</em> and the trade <em>unfair</em>. And the dollar arrives only if the oracle agrees that the event happened.</p> <p>For a trader the useful findings are modest and specific. The mispricing that survives is at the tails: contracts under 5 cents lose a quarter to two fifths of the stake on average, and near-certain favourites earn a fraction of a percent a week, more when they are bought a month or more before the close.</p> <p>It is about the size of the spread and the fee, which is why it survives. Nothing in the data suggests a general bias that a formula could exploit, and a two-number correction fitted on the past made the future no better.</p> <p>The people who make money on Polymarket, according to a study of 588 million trades, are mostly the ones who post limit orders and let others cross the spread; the top 1% of profitable accounts took 76.5% of the profits<sup class="cite">[<a href="#ref-45" id="cite-47" data-ref="45" aria-label="Reference 45: Akey, P., Grégoire, V., Harvie, N., &amp; Martineau, C. (2026). Who wins and who loses in prediction markets? Evidence from Polymarket. CEPR Discussion Paper 21615.">45</a>]</sup>.</p> <p>For an engineer the lessons are the ones from evaluating any model, sharpened by a market’s habits. Accuracy flatters when the classes are unbalanced, and most questions resolve No. Comparisons across horizons are confounded by which questions exist at each horizon, so they have to be made on the same questions.</p> <p>And a filter on anything that depends on the outcome, a market’s total volume included, manufactures effects that aren’t there. The trap that caught my first sample is the most transferable thing in this post.</p> <h2 id="references">References</h2> <ol class="tfs-refs"> <li id="ref-1">CNBC (2026). <a href="https://www.cnbc.com/2026/10/26/lula-brazil-election-prediction-markets.html">Lula wins Brazil election despite prediction markets favoring Bolsonaro</a>. 26 October 2026. <a class="ref-back" href="#cite-1" aria-label="Back to the text">↩</a></li> <li id="ref-2">Semafor (2026). <a href="https://www.semafor.com/article/10/30/2026/prediction-markets-flop-on-recent-elections">Prediction markets flop on recent elections</a>. 30 October 2026. <a class="ref-back" href="#cite-2" aria-label="Back to the text">↩</a></li> <li id="ref-3">Polymarket (2026). <a href="https://docs.polymarket.com/concepts/pusd">pUSD</a>. Documentation. <a class="ref-back" href="#cite-3" aria-label="Back to the text">↩</a></li> <li id="ref-4">Polymarket (2026). <a href="https://docs.polymarket.com/concepts/prices-orderbook">Prices and the order book</a>. Documentation. <a class="ref-back" href="#cite-4" aria-label="Back to the text">↩</a></li> <li id="ref-5">Wolfers, J., &amp; Zitzewitz, E. (2006). <a href="https://www.nber.org/papers/w12200">Interpreting prediction market prices as probabilities</a>. NBER Working Paper 12200. <a class="ref-back" href="#cite-5" aria-label="Back to the text">↩</a></li> <li id="ref-6">Manski, C. F. (2006). <a href="https://doi.org/10.1016/j.econlet.2006.01.004">Interpreting the predictions of prediction markets</a>. <em>Economics Letters</em>, 91(3), 425–429. <a class="ref-back" href="#cite-6" aria-label="Back to the text">↩</a></li> <li id="ref-7">Polymarket (2026). <a href="https://docs.polymarket.com/trading/fees">Trading fees</a>. Documentation. <a class="ref-back" href="#cite-7" aria-label="Back to the text">↩</a></li> <li id="ref-8">Guo, C., Pleiss, G., Sun, Y., &amp; Weinberger, K. Q. (2017). <a href="https://proceedings.mlr.press/v70/guo17a.html">On calibration of modern neural networks</a>. <em>ICML 2017</em>. <a class="ref-back" href="#cite-8" aria-label="Back to the text">↩</a></li> <li id="ref-9">Dimitriadis, T., Gneiting, T., &amp; Jordan, A. I. (2021). <a href="https://doi.org/10.1073/pnas.2016191118">Stable reliability diagrams for probabilistic classifiers</a>. <em>PNAS</em>, 118(8), e2016191118. <a class="ref-back" href="#cite-9" aria-label="Back to the text">↩</a></li> <li id="ref-10">Brier, G. W. (1950). <a href="https://journals.ametsoc.org/view/journals/mwre/78/1/1520-0493_1950_078_0001_vofeit_2_0_co_2.xml">Verification of forecasts expressed in terms of probability</a>. <em>Monthly Weather Review</em>, 78(1), 1–3. <a class="ref-back" href="#cite-10" aria-label="Back to the text">↩</a></li> <li id="ref-11">Murphy, A. H. (1973). <a href="https://doi.org/10.1175/1520-0450%281973%29012%3C0595%3AANVPOT%3E2.0.CO%3B2">A new vector partition of the probability score</a>. <em>Journal of Applied Meteorology</em>, 12(4), 595–600. <a class="ref-back" href="#cite-11" aria-label="Back to the text">↩</a></li> <li id="ref-12">538 (2024). <a href="https://6abc.com/post/538s-final-forecasts-2024-presidential-election/15512334/">538’s final forecasts for the 2024 presidential election</a>. Republished by 6abc, 5 November 2024. <a class="ref-back" href="#cite-12" aria-label="Back to the text">↩</a></li> <li id="ref-13">The Wall Street Journal (2024). <a href="https://tovima.com/wsj/the-trump-betting-whale-speaks-out-i-have-absolutely-no-political-agenda">The Trump betting whale speaks out: “I have absolutely no political agenda”</a>. Republished by To Vima, 1 November 2024. <a class="ref-back" href="#cite-13" aria-label="Back to the text">↩</a></li> <li id="ref-14">CBS News (2025). <a href="https://www.cbsnews.com/news/french-whale-made-over-80-million-on-polymarket-betting-on-trump-election-win-60-minutes/">French whale made over $80 million on Polymarket betting on Trump’s election win</a>. <em>60 Minutes</em>, 30 November 2025. <a class="ref-back" href="#cite-14" aria-label="Back to the text">↩</a></li> <li id="ref-15">Horvitz, D. G., &amp; Thompson, D. J. (1952). <a href="https://doi.org/10.1080/01621459.1952.10483446">A generalization of sampling without replacement from a finite universe</a>. <em>Journal of the American Statistical Association</em>, 47(260), 663–685. <a class="ref-back" href="#cite-15" aria-label="Back to the text">↩</a></li> <li id="ref-16">Walker, A. (2026). <a href="https://theses-dissertations.princeton.edu/handle/88435/dsp01mw22v8973">The price is (almost) right: a calibration analysis of Polymarket pricing data</a>. Senior thesis, Princeton University. <a class="ref-back" href="#cite-16" aria-label="Back to the text">↩</a></li> <li id="ref-17">Polymarket (2026). <a href="https://polymarket.com/accuracy">How accurate is Polymarket?</a> Accessed 31 October 2026. <a class="ref-back" href="#cite-17" aria-label="Back to the text">↩</a></li> <li id="ref-18">Griffith, R. M. (1949). <a href="https://doi.org/10.2307/1418469">Odds adjustments by American horse-race bettors</a>. <em>American Journal of Psychology</em>, 62(2), 290–294. <a class="ref-back" href="#cite-18" aria-label="Back to the text">↩</a></li> <li id="ref-19">Snowberg, E., &amp; Wolfers, J. (2010). <a href="https://doi.org/10.1086/655844">Explaining the favorite–long shot bias: is it risk-love or misperceptions?</a> <em>Journal of Political Economy</em>, 118(4), 723–746. <a class="ref-back" href="#cite-19" aria-label="Back to the text">↩</a></li> <li id="ref-20">Bürgi, C., Deng, W., &amp; Whelan, K. (2026). <a href="https://www2.gwu.edu/~forcpgm/2026-001.pdf">Makers and takers: the economics of the Kalshi prediction market</a>. GWU Center for Economic Research Working Paper 2026-001. <a class="ref-back" href="#cite-20" aria-label="Back to the text">↩</a></li> <li id="ref-21">Cardozo, M., &amp; Rivero-Wildemauwe, J. I. (2026). <a href="https://arxiv.org/abs/2609.12878">The favorite-longshot bias in prediction markets: evidence from Polymarket</a>. arXiv:2609.12878. <a class="ref-back" href="#cite-21" aria-label="Back to the text">↩</a></li> <li id="ref-22">Federal Reserve Bank of St. Louis (2026). <a href="https://fred.stlouisfed.org/series/DTB3">3-month Treasury bill secondary market rate (DTB3)</a>. FRED. <a class="ref-back" href="#cite-23" aria-label="Back to the text">↩</a></li> <li id="ref-23">Page, L., &amp; Clemen, R. T. (2013). <a href="https://doi.org/10.1111/j.1468-0297.2012.02561.x">Do prediction markets produce well-calibrated probability forecasts?</a> <em>The Economic Journal</em>, 123(568), 491–513. <a class="ref-back" href="#cite-24" aria-label="Back to the text">↩</a></li> <li id="ref-24">Polymarket (2026). <a href="https://help.polymarket.com/en/articles/13364459-holding-rewards">Holding rewards</a>. Help center, 1 June 2026. <a class="ref-back" href="#cite-25" aria-label="Back to the text">↩</a></li> <li id="ref-25">Niculescu-Mizil, A., &amp; Caruana, R. (2005). <a href="https://doi.org/10.1145/1102351.1102430">Predicting good probabilities with supervised learning</a>. <em>ICML 2005</em>. <a class="ref-back" href="#cite-26" aria-label="Back to the text">↩</a></li> <li id="ref-26">Le, N. A. (2026). <a href="https://arxiv.org/abs/2602.19520">Decomposing crowd wisdom: domain-specific calibration dynamics in prediction markets</a>. arXiv:2602.19520. <a class="ref-back" href="#cite-28" aria-label="Back to the text">↩</a></li> <li id="ref-27">Decrypt (2025). <a href="https://decrypt.co/343840/nobel-peace-prize-organizers-intestigating-polymarket-insider-trades">Nobel Peace Prize organizers investigating Polymarket insider trades</a>. 10 October 2025. <a class="ref-back" href="#cite-29" aria-label="Back to the text">↩</a></li> <li id="ref-28">Bloomberg (2025). <a href="https://news.bloomberglaw.com/capital-markets/unusual-polymarket-bets-on-peace-prize-winner-spur-probe-1">Unusual Polymarket bets on Peace Prize winner spur probe</a>. Via Bloomberg Law, 10 October 2025. <a class="ref-back" href="#cite-30" aria-label="Back to the text">↩</a></li> <li id="ref-29">Reuters (2026). <a href="https://www.cp24.com/news/world/2026/01/30/nobel-committee-says-peace-prize-winner-likely-revealed-early-by-digital-spying/">Nobel committee says Peace Prize winner likely revealed early by digital spying</a>. Via CP24, 30 January 2026. <a class="ref-back" href="#cite-31" aria-label="Back to the text">↩</a></li> <li id="ref-30">U.S. Department of Justice (2026). <a href="https://www.justice.gov/opa/pr/us-soldier-charged-using-classified-information-profit-prediction-market-bets">U.S. soldier charged with using classified information to profit from prediction market bets</a>. 23 April 2026. <a class="ref-back" href="#cite-32" aria-label="Back to the text">↩</a></li> <li id="ref-31">Commodity Futures Trading Commission (2026). <a href="https://www.cftc.gov/PressRoom/PressReleases/9217-26">Press release 9217-26</a>. 23 April 2026. <a class="ref-back" href="#cite-33" aria-label="Back to the text">↩</a></li> <li id="ref-32">The Block (2026). <a href="https://www.theblock.co/post/391650/fresh-accounts-netted-1-million-on-polymarket-hours-before-us-airstrikes-on-iran-bubblemaps">Fresh accounts netted $1 million on Polymarket hours before US airstrikes on Iran</a>. 28 February 2026. <a class="ref-back" href="#cite-34" aria-label="Back to the text">↩</a></li> <li id="ref-33">CBS News (2026). <a href="https://www.cbsnews.com/news/polymarket-google-employee-insider-trading-charges-spagnuolo-d4vd/">Google employee charged with insider trading on Polymarket</a>. 28 May 2026. <a class="ref-back" href="#cite-35" aria-label="Back to the text">↩</a></li> <li id="ref-34">CBS News (2026). <a href="https://www.cbsnews.com/news/polymarket-maduro-capture-bet-400000">Polymarket trader made $400,000 on Maduro’s capture</a>. 6 January 2026. <a class="ref-back" href="#cite-36" aria-label="Back to the text">↩</a></li> <li id="ref-35">Torres, R. (2026). <a href="https://ritchietorres.house.gov/posts/in-response-to-suspicious-polymarket-trade-preceding-maduro-operation-rep-ritchie-torres-introduces-legislation-to-crack-down-on-insider-trading-on-prediction-markets">Rep. Ritchie Torres introduces legislation to crack down on insider trading on prediction markets</a>. Press release. <a class="ref-back" href="#cite-37" aria-label="Back to the text">↩</a></li> <li id="ref-36">Raskin, J. (2026). <a href="https://raskin.house.gov/2026/3/raskin-merkley-legislation-would-ban-prediction-market-gambling-on-elections-sports-war-and-government-activity">Raskin, Merkley legislation would ban prediction market gambling on elections, sports, war and government activity</a>. Press release, 26 March 2026. <a class="ref-back" href="#cite-38" aria-label="Back to the text">↩</a></li> <li id="ref-37">Polymarket (2026). <a href="https://docs.polymarket.com/concepts/resolution">Resolution</a>. Documentation. <a class="ref-back" href="#cite-39" aria-label="Back to the text">↩</a></li> <li id="ref-38">The Block (2025). <a href="https://www.theblock.co/post/348171/polymarket-says-governance-attack-by-uma-whale-to-hijack-a-bets-resolution-is-unprecedented">Polymarket says governance attack by UMA whale to hijack a bet’s resolution is “unprecedented”</a>. 26 March 2025. <a class="ref-back" href="#cite-40" aria-label="Back to the text">↩</a></li> <li id="ref-39">DL News (2025). <a href="https://www.dlnews.com/articles/markets/polymarket-bettors-clash-over-zelenskyy-suit-dispute/">Polymarket bettors clash over Zelenskyy suit dispute</a>. 30 June 2025. <a class="ref-back" href="#cite-41" aria-label="Back to the text">↩</a></li> <li id="ref-40">Bloomberg (2026). <a href="https://www.bloomberglinea.com/cripto/las-disputas-en-polymarket-exponen-el-lado-oscuro-de-los-mercados-de-prediccion/">Las disputas en Polymarket exponen el lado oscuro de los mercados de predicción</a>. Via Bloomberg Línea, 29 May 2026. <a class="ref-back" href="#cite-42" aria-label="Back to the text">↩</a></li> <li id="ref-41">UMA (2025). <a href="https://blog.uma.xyz/articles/managed-proposers-update">Managed proposers: an update</a>. Blog, 8 November 2025. <a class="ref-back" href="#cite-43" aria-label="Back to the text">↩</a></li> <li id="ref-42">The Block (2026). <a href="https://www.theblock.co/news/business/2026-10-06-polymarket-rolls-out-v2-upgrade-with-single-erc-1155-positions-contract-pusd-collateral-417804">Polymarket rolls out V2 upgrade</a>. 6 October 2026. <a class="ref-back" href="#cite-44" aria-label="Back to the text">↩</a></li> <li id="ref-43">Sirolly, A., Ma, H., Kanoria, Y., &amp; Sethi, R. (2025). <a href="https://papers.ssrn.com/sol3/papers.cfm?abstract_id=5714122">Network-based detection of wash trading</a>. SSRN Working Paper 5714122. <a class="ref-back" href="#cite-45" aria-label="Back to the text">↩</a></li> <li id="ref-44">Paradigm (2025). <a href="https://www.paradigm.xyz/2025/12/polymarket-volume-is-being-double-counted">Polymarket volume is being double-counted</a>. 8 December 2025. <a class="ref-back" href="#cite-46" aria-label="Back to the text">↩</a></li> <li id="ref-45">Akey, P., Grégoire, V., Harvie, N., &amp; Martineau, C. (2026). <a href="https://ideas.repec.org/p/cpr/ceprdp/21615.html">Who wins and who loses in prediction markets? Evidence from Polymarket</a>. CEPR Discussion Paper 21615. <a class="ref-back" href="#cite-47" aria-label="Back to the text">↩</a></li> </ol>]]></content> <author> <name>Eva Koroleva</name> </author> <category term="finance"/> <category term="crypto"/> <category term="prediction-markets"/> <category term="polymarket"/> <category term="calibration"/> <category term="forecasting"/> <category term="trading"/> <summary type="html"><![CDATA[Polymarket's prices checked against what happened across almost three million resolved markets: how well calibrated they are, what accuracy figures hide, where longshots and favourites are mispriced, insiders, oracles and the cost of trading]]></summary> <media:thumbnail url="https://blog.korolevalab.com/assets/posts/polymarket-accuracy/cover.png"/> <media:content medium="image" url="https://blog.korolevalab.com/assets/posts/polymarket-accuracy/cover.png"/> </entry> <entry> <title type="html">AI crypto trading bots: what machine learning and LLMs can and can’t do</title> <link href="https://blog.korolevalab.com/blog/2026/ai-crypto-trading/" rel="alternate" type="text/html" title="AI crypto trading bots: what machine learning and LLMs can and can’t do"/> <published>2026-11-03T09:00:00+00:00</published> <updated>2026-11-03T00:00:00+00:00</updated> <id>https://blog.korolevalab.com/blog/2026/ai-crypto-trading</id> <content type="html" xml:base="https://blog.korolevalab.com/blog/2026/ai-crypto-trading/"><![CDATA[<aside class="tldr"> <p class="tldr-label">In short</p> <p>Machine learning finds a real edge in crypto prices, but a small one: gradient boosting calls the direction of Bitcoin’s next hour right 53.9% of the time, and an ordinary trader’s fees eat all of it.</p> <p>What it forecasts well is volatility, which sizes positions and keeps the risk of a strategy predictable, and that is where professional firms use it.</p> <p>Language models have shown no trading skill in any test long and clean enough to tell, and in backtests on history they remember what came next. An agent that holds keys is a security problem before it is a trading strategy.</p> <div class="stats"> <div class="stat"><span class="stat-value">63%</span><span class="stat-label">hit rate an hourly Bitcoin strategy needs to cover a 10 bp round trip</span></div> <div class="stat"><span class="stat-value">1.56</span><span class="stat-label">Sharpe ratio of the best of 20,000 random strategies that know nothing</span></div> <div class="stat"><span class="stat-value">60.0%</span><span class="stat-label">right on Bitcoin's monthly direction a year or more before the models' release; 46.8% after</span></div> </div> </aside> <p>In October 2025 a small lab called Nof1 gave six of the strongest language models $10,000 each and let them trade crypto perpetual futures on Hyperliquid with real money.</p> <p>Every two or three minutes each model received the same prompt with prices and indicators for six coins and answered with a trade: the coin, long or short, the size, the leverage and a plan for getting out<sup class="cite">[<a href="#ref-1" id="cite-1" data-ref="1" aria-label="Reference 1: Nof1 (2025). Exploring the limits of large language models as quant traders. Blog post, archived copy.">1</a>]</sup>.</p> <p>Seventeen days later Qwen3-Max was up 23% and DeepSeek V3.1 up 5%, while Claude Sonnet 4.5, Grok 4, Gemini 2.5 Pro and GPT-5 had lost between a third and two thirds of their money. Bitcoin ended the period where it began.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/ai-crypto-trading/arena-light.png" width="760" alt="Account values of six language models trading crypto perpetual futures with $$10,000 each in Alpha Arena, season 1, 18 October to 3 November 2025, on a log scale, with Bitcoin held as a reference (-0.03%). Final returns: Qwen3-Max +23%, DeepSeek V3.1 +5%, Claude Sonnet 4.5 -33%, Grok 4 -48%, Gemini 2.5 Pro -55%, GPT-5 -63%. Grey bands show where a trader with no skill and the same volatility would end up; every model ends inside them" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/ai-crypto-trading/arena-dark.png" width="760" alt="Account values of six language models trading crypto perpetual futures with $$10,000 each in Alpha Arena, season 1, 18 October to 3 November 2025, on a log scale, with Bitcoin held as a reference (-0.03%). Final returns: Qwen3-Max +23%, DeepSeek V3.1 +5%, Claude Sonnet 4.5 -33%, Grok 4 -48%, Gemini 2.5 Pro -55%, GPT-5 -63%. Grey bands show where a trader with no skill and the same volatility would end up; every model ends inside them" loading="lazy"></p> <p>The results went around social media as a ranking of which model “can trade”. The chart says something more modest.</p> <p>The grey bands show where a trader with no skill at all, taking the same risk as the models, would end up: two times in three inside the darker band, nineteen times in twenty inside the lighter one.</p> <p>Every model finished inside the bands, and the winner’s lead is a third of what luck alone would typically give.</p> <p>Nof1 said as much before the season ended: “We do not expect any of the models to do well, and early successes may be the result of luck.”</p> <p>Its founder summed up the season with a sentence that is more useful than the leaderboard: “LLMs don’t really handle numerical time series data very well, but that’s all the context we gave them”<sup class="cite">[<a href="#ref-2" id="cite-2" data-ref="2" aria-label="Reference 2: Azhang, J. (2025). Season 1 of Alpha Arena has officially ended. Post on X, 3 November 2025.">2</a>]</sup>.</p> <p>Meanwhile, AI has become part of how people trade crypto. In a survey that the exchange MEXC ran among its users in September 2026, 84.8% had used AI for research or trading in the previous six months, and 13% had tried an agent connected to their exchange account<sup class="cite">[<a href="#ref-3" id="cite-3" data-ref="3" aria-label="Reference 3: MEXC (2026). MEXC AI trading report: 85% use AI for crypto, yet only 6.5% would authorize it to trade most of their funds. Press release.">3</a>]</sup>.</p> <p>Binance, OKX and Kraken now ship toolkits that let a language model place orders, and regulators keep charging schemes that sold AI trading bots where, in the words of one SEC release, “there were no AI trading bots”<sup class="cite">[<a href="#ref-4" id="cite-4" data-ref="4" aria-label="Reference 4: U.S. Securities and Exchange Commission (2026). SEC charges multiple entities in fraud schemes totaling at least &amp;#36;15 million that used WhatsApp and other platforms to lure investors. Press release 2026-95.">4</a>]</sup>.</p> <p>This post tries to separate what models can do in crypto trading from what they are sold for.</p> <p>I ran the experiments myself on six years of Binance’s public data: gradient boosting that predicts the next hour, a volatility model, almost 800 backtested strategies and 20,000 random ones, two foundation models for time series, and seven open language models asked about Bitcoin’s past.</p> <p>For ML engineers it explains what makes markets unlike other prediction problems; for traders, what the models actually learn and where the numbers in their marketing come from.</p> <h2 id="what-a-model-sees-in-crypto-prices">What a model sees in crypto prices</h2> <p>A trading model learns from returns, the relative changes of price from one bar to the next. An hourly return of Bitcoin is \(r_t = \ln(P_t / P_{t-1})\), where \(P_t\) is the price at the close of hour \(t\); for small moves it is the percentage change.</p> <p>Two facts about these numbers shape everything that follows, and both are easy to see in Binance’s public data.</p> <p>The first is the shape of their distribution. Measured in standard deviations, most hours are quiet, and a few are wild in a way a normal distribution does not allow:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/ai-crypto-trading/tails-light.png" width="760" alt="Histogram of Bitcoin's hourly returns in standard deviations on a log scale, against a normal law. 96 of 51,057 hours moved more than six standard deviations; a normal law expects 0.0001" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/ai-crypto-trading/tails-dark.png" width="760" alt="Histogram of Bitcoin's hourly returns in standard deviations on a log scale, against a normal law. 96 of 51,057 hours moved more than six standard deviations; a normal law expects 0.0001" loading="lazy"></p> <p>From January 2021 to the end of October 2026 Bitcoin had 51,057 hours, and 96 of them moved more than six standard deviations. Under a normal law with the same mean and spread, a six-sigma hour happens about once in 58,000 years. Ether and Solana look the same, with 108 and 109 such hours.</p> <p>For a model this means that a handful of hours carry a large share of the total movement, and a loss function that squares errors is pulled around by them. It also means that any test period without a crash is missing the hours that decide whether a leveraged strategy survives.</p> <p>The second fact is about memory. The autocorrelation of a series at lag \(k\) is its correlation with itself \(k\) steps earlier. For returns it is close to zero at every lag; for the size of the returns, their absolute value, it is not:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/ai-crypto-trading/acf-light.png" width="760" alt="Autocorrelation of Bitcoin's hourly returns stays within noise at every lag up to a week (lag 1: -0.005), while that of absolute returns starts at 0.29 and is still 0.16 after a week, with bumps at whole days" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/ai-crypto-trading/acf-dark.png" width="760" alt="Autocorrelation of Bitcoin's hourly returns stays within noise at every lag up to a week (lag 1: -0.005), while that of absolute returns starts at 0.29 and is still 0.16 after a week, with bumps at whole days" loading="lazy"></p> <p>The direction of the last hour says almost nothing about the direction of the next one, but a violent hour is likely to be followed by another violent hour, and that memory lasts for days.</p> <p>The bumps at 24, 48 and 72 hours are the daily rhythm of trading. The same hours are busy every day: in the hour from 14:00 UTC, around the opening of stock trading in New York, Bitcoin moves 56 bp on average, against 29 bp in the hour from 04:00 (a basis point, bp, is 0.01%).</p> <p>These two curves are the plan of this post in miniature. Direction is close to unpredictable, so a model that predicts it will be right only a little more often than a coin, and the question is whether that little survives the costs of trading.</p> <p>Volatility is predictable, and that is where machine learning earns its keep without anyone writing about it.</p> <h2 id="predicting-the-next-hour">Predicting the next hour</h2> <p>The experiment is the one a newcomer to quantitative trading usually runs first, done carefully.</p> <p>Every hour, a model sees what a trader’s screen shows at the close of that hour for Bitcoin, Ether and Solana: returns over the last 1, 2, 4, 8, 24, 72 and 168 hours, Bitcoin’s returns as a market factor, volatility measured from 5-minute candles, volume against its weekly norm, the share of volume bought by takers (traders who cross the spread and pay for immediacy), the range of the last hour, the hour of the day, the day of the week and which coin it is.</p> <p>Twenty features in all.</p> <p>It predicts the probability that the next hour closes higher. The model is gradient boosting, LightGBM with shallow trees, the default choice for tabular data and a strong one.</p> <p>The test has to respect time. Shuffling hours into random training and test sets would let the model learn from the future, so the evaluation is walk-forward:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/ai-crypto-trading/walk-forward-light.png" width="760" alt="Walk-forward testing: for each of 58 months from January 2022 to October 2026, a new model is trained on all hours before the month, less a gap of a day, and predicts that month only. The months it predicts are joined into one out-of-sample record" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/ai-crypto-trading/walk-forward-dark.png" width="760" alt="Walk-forward testing: for each of 58 months from January 2022 to October 2026, a new model is trained on all hours before the month, less a gap of a day, and predicts that month only. The months it predicts are joined into one out-of-sample record" loading="lazy"></p> <p>Every month from January 2022 to October 2026 gets its own model, trained on every hour before that month except the last day, which is kept out so that no training target overlaps the test. The 58 months of predictions, 42,142 hours per coin, form one long out-of-sample record that no model saw while it was trained.</p> <p>The result is better than I expected. The model calls the direction of Bitcoin’s next hour correctly 53.9% of the time, against 50.5% for always saying “up”; for Ether 53.8%, for Solana 52.9%.</p> <p>The area under the ROC curve is 0.555 for Bitcoin. Over 42,142 hours a hit rate this far from a coin toss is not luck: its standard error is a quarter of a percentage point.</p> <div class="callout callout-warn"> <p class="callout-label">Trap</p> <p>A result like this deserves suspicion before celebration. The usual cause of a good backtest is a leak, a feature that quietly contains the future. Here the hourly closes rebuilt from 5-minute candles match Binance’s own hourly candles to the cent, and the pattern the model found, described next, survives when the last five minutes before each forecast are skipped.</p> </div> <p>The feature that carries most of the signal is the simplest: the return of the last couple of hours, with a negative sign. Crypto hourly returns tend to be partly taken back in the next hour.</p> <p>The rank correlation between consecutive hourly returns of Bitcoin is −0.06 over the test period, small but steady, and it shows plainly in how often an hour moves the same way as the hour before:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/ai-crypto-trading/reversal-light.png" width="760" alt="Share of hours that move in the same direction as the previous hour, by year, for BTC, ETH and SOL. Every bar is below 50%, lowest in 2022 and 2023: BTC 2021 48.6%, 2022 46.0%, 2023 45.9%, 2024 46.7%, 2025 48.7%, 2026 47.7%; ETH 2021 48.5%, 2022 46.8%, 2023 46.1%, 2024 46.3%, 2025 48.2%, 2026 47.7%; SOL 2021 49.2%, 2022 48.0%, 2023 46.6%, 2024 46.9%, 2025 49.3%, 2026 47.7%" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/ai-crypto-trading/reversal-dark.png" width="760" alt="Share of hours that move in the same direction as the previous hour, by year, for BTC, ETH and SOL. Every bar is below 50%, lowest in 2022 and 2023: BTC 2021 48.6%, 2022 46.0%, 2023 45.9%, 2024 46.7%, 2025 48.7%, 2026 47.7%; ETH 2021 48.5%, 2022 46.8%, 2023 46.1%, 2024 46.3%, 2025 48.2%, 2026 47.7%; SOL 2021 49.2%, 2022 48.0%, 2023 46.6%, 2024 46.9%, 2025 49.3%, 2026 47.7%" loading="lazy"></p> <p>A mean-reverting wiggle like this is what liquidity providers are paid for. When an impatient trader pushes the price by buying a lot at once, someone has to sell to them, and that someone expects the price to drift back. The effect was strongest in 2022 and 2023 and weaker in 2025 and 2026.</p> <h2 id="where-the-edge-goes">Where the edge goes</h2> <p>A model that is right 53.9% of the time sounds like a money machine, and this is the moment to look at what trading costs.</p> <p>Every trade pays a fee, and every market order also pays the spread and walks up the order book. Suppose a strategy opens and closes a position on every bar, and the average absolute move over the bar is \(m\).</p> <p>It earns \(+m\) when right and \(-m\) when wrong, and pays the round-trip cost \(c\) every time. With hit rate \(p\) the expected profit per bar is</p> \[\mathbb{E}[\text{profit}] = p\,m - (1 - p)\,m - c = (2p - 1)\,m - c,\] <p>which is positive only if</p> \[p &gt; \frac{1}{2} + \frac{c}{2m}.\] <p>The ratio of cost to typical move decides everything. Bitcoin moves 38 bp in an average hour, and a round trip with taker fees on Binance’s futures costs about 10 bp, so an hourly strategy needs to be right 63% of the time. On 5-minute bars, with an average move of 11 bp, it needs 94%:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/ai-crypto-trading/breakeven-light.png" width="760" alt="The hit rate a strategy trading every bar needs to cover its costs. 5 min: average move 11 bp, hit rate needed 94% at 10 bp; 15 min: average move 19 bp, hit rate needed 76% at 10 bp; 1 hour: average move 38 bp, hit rate needed 63% at 10 bp; 4 hours: average move 78 bp, hit rate needed 56% at 10 bp; 1 day: average move 203 bp, hit rate needed 52% at 10 bp" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/ai-crypto-trading/breakeven-dark.png" width="760" alt="The hit rate a strategy trading every bar needs to cover its costs. 5 min: average move 11 bp, hit rate needed 94% at 10 bp; 15 min: average move 19 bp, hit rate needed 76% at 10 bp; 1 hour: average move 38 bp, hit rate needed 63% at 10 bp; 4 hours: average move 78 bp, hit rate needed 56% at 10 bp; 1 day: average move 203 bp, hit rate needed 52% at 10 bp" loading="lazy"></p> <p>The fee is only part of the cost. A market order also crosses the spread and, if it is large, eats into the order book.</p> <p>I took six snapshots of the books of Binance’s perpetual futures, five minutes apart, and measured what a market buy of a given size costs against the mid price, for contracts ranked by their daily turnover:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/ai-crypto-trading/depth-light.png" width="760" alt="Cost of a market buy against the mid price on Binance perpetual futures, by order size from $$1,000 to $$1 million, for contracts ranked by daily turnover, log scales. #1 BTC: $$100K costs 0.01 bp; #2 ETH: $$100K costs 0.02 bp; #5 HYPE: $$100K costs 3.22 bp; #10 XRP: $$100K costs 1.07 bp; #25 AVAX: $$100K costs 6.10 bp; #50 PENGU: $$100K costs 10.56 bp; #100 1000FLOKI: $$100K costs 31.20 bp; #200 MET: $$100K costs 86.88 bp" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/ai-crypto-trading/depth-dark.png" width="760" alt="Cost of a market buy against the mid price on Binance perpetual futures, by order size from $$1,000 to $$1 million, for contracts ranked by daily turnover, log scales. #1 BTC: $$100K costs 0.01 bp; #2 ETH: $$100K costs 0.02 bp; #5 HYPE: $$100K costs 3.22 bp; #10 XRP: $$100K costs 1.07 bp; #25 AVAX: $$100K costs 6.10 bp; #50 PENGU: $$100K costs 10.56 bp; #100 1000FLOKI: $$100K costs 31.20 bp; #200 MET: $$100K costs 86.88 bp" loading="lazy"></p> <p>For Bitcoin and Ether the book is so deep that even a million-dollar order costs a fraction of a basis point: 0.18 bp for Bitcoin, 1.3 bp for Ether. Further down the list the picture changes quickly.</p> <p>On the 25th most traded contract, a $100,000 order costs 6 bp before any fee; on the 50th, 11 bp; on the 200th, 87 bp, and the visible book cannot fill a million at all.</p> <p>These snapshots were taken on a Saturday, a day and a half after Binance disclosed a $6.3 billion hack of one of its hot wallets and suspended withdrawals<sup class="cite">[<a href="#ref-5" id="cite-5" data-ref="5" aria-label="Reference 5: CoinDesk (2026). Binance uncovers wider breach in &amp;#36;6.3 billion exploit, targets Sunday withdrawal restart. 30 October 2026.">5</a>]</sup>, so the books of small contracts may be thinner than on an ordinary weekday.</p> <p>The point stands on any day: the smaller the coin, the more of a model’s edge goes to the order book.</p> <p>Now the model’s trades. The plain strategy is long when the model gives the next hour more than even odds to rise and short otherwise, and it pays a fee whenever it switches sides:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/ai-crypto-trading/growth-light.png" width="760" alt="Value of one dollar traded on the model's hourly forecasts for Bitcoin from January 2022 to October 2026, log scale: without fees it ends at 9.9 dollars, holding Bitcoin at 1.65, with 2 bp per side at 0.036, with 5 bp per side at practically zero" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/ai-crypto-trading/growth-dark.png" width="760" alt="Value of one dollar traded on the model's hourly forecasts for Bitcoin from January 2022 to October 2026, log scale: without fees it ends at 9.9 dollars, holding Bitcoin at 1.65, with 2 bp per side at 0.036, with 5 bp per side at practically zero" loading="lazy"></p> <p>Without fees, a dollar traded on Bitcoin’s forecasts from January 2022 grows to about ten. With 2 bp per side, the fee of a market maker on futures, it loses most of its value; with 5 bp, a taker’s fee, it is gone.</p> <p>The model switches sides 16 times a day, and a 53.9% hit rate does not pay for that.</p> <p>It is also worse than 53.9% suggests. When the model is right, the hour moves 31.5 bp on average; when it is wrong, 35.6 bp. It is right more often on the small moves and wrong more often on the large ones, so the hit rate overstates the profit, a pattern that every strategy built on small reversals shares.</p> <p>The obvious fix is to trade less: keep the current position unless the model’s probability crosses a band around one half, say above 0.55 or below 0.45. A wider band means fewer trades and fewer fees, but also acting on fewer of the model’s opinions:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/ai-crypto-trading/fees-light.png" width="760" alt="Return per year against how often the strategy changes side, for four fee levels. BTC 16.0 changes a day: no fees 48%, 5 bp -244%; BTC 13.6 changes a day: no fees 42%, 5 bp -205%; BTC 11.3 changes a day: no fees 50%, 5 bp -155%; BTC 9.3 changes a day: no fees 44%, 5 bp -125%; BTC 6.0 changes a day: no fees 57%, 5 bp -53%; BTC 2.6 changes a day: no fees -5%, 5 bp -52%; SOL 15.8 changes a day: no fees 97%, 5 bp -191%; SOL 12.5 changes a day: no fees 117%, 5 bp -112%; SOL 9.8 changes a day: no fees 126%, 5 bp -52%; SOL 7.6 changes a day: no fees 93%, 5 bp -45%; SOL 4.3 changes a day: no fees 63%, 5 bp -15%; SOL 1.4 changes a day: no fees 16%, 5 bp -9%" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/ai-crypto-trading/fees-dark.png" width="760" alt="Return per year against how often the strategy changes side, for four fee levels. BTC 16.0 changes a day: no fees 48%, 5 bp -244%; BTC 13.6 changes a day: no fees 42%, 5 bp -205%; BTC 11.3 changes a day: no fees 50%, 5 bp -155%; BTC 9.3 changes a day: no fees 44%, 5 bp -125%; BTC 6.0 changes a day: no fees 57%, 5 bp -53%; BTC 2.6 changes a day: no fees -5%, 5 bp -52%; SOL 15.8 changes a day: no fees 97%, 5 bp -191%; SOL 12.5 changes a day: no fees 117%, 5 bp -112%; SOL 9.8 changes a day: no fees 126%, 5 bp -52%; SOL 7.6 changes a day: no fees 93%, 5 bp -45%; SOL 4.3 changes a day: no fees 63%, 5 bp -15%; SOL 1.4 changes a day: no fees 16%, 5 bp -9%" loading="lazy"></p> <p>With a band of ±0.05 the Bitcoin strategy trades 6 times a day instead of 16 and still earns 57% a year before costs (here and below, a year’s hourly returns added up, without compounding).</p> <p>At 1 bp per side 35% remains, at 2 bp 13%, at 5 bp it loses 53%. A wider band loses the edge before it saves enough on fees. Solana, with larger moves, keeps some profit at 2 bp per side, and none at 5.</p> <div class="callout"> <p class="callout-label">For traders</p> <p>The edge is real, and it belongs to whoever pays the least for trading. A market maker who earns a rebate for resting orders, sits next to the exchange and pays a fraction of a basis point can harvest it; a retail trader paying 5 bp per side through an API cannot, however good the model.</p> </div> <p>This backtest is also generous: it assumes trades at the exact closing price of the hour, with no delay and no slippage beyond the fee. The real numbers would be worse.</p> <h2 id="what-can-be-predicted-volatility">What can be predicted: volatility</h2> <p>The other curve of the autocorrelation chart, the one that stayed high, is where forecasting works. Realized variance is the sum of squared 5-minute returns over a day,</p> \[RV_t = \sum_{i=1}^{288} r_{t,i}^2,\] <p>a direct measurement of how much the price moved that day. The HAR model of Corsi (2009) forecasts tomorrow’s value from three averages of it: yesterday’s, the last week’s and the last month’s,</p> \[\ln RV_{t+1} = \beta_0 + \beta_d \ln RV_t + \beta_w \ln RV^{(w)}_t + \beta_m \ln RV^{(m)}_t + \varepsilon_{t+1}.\] <p>The three terms stand for traders with different horizons, who react to yesterday, to the last week and to the last month. It is a linear regression with four coefficients, and it is hard to beat<sup class="cite">[<a href="#ref-6" id="cite-6" data-ref="6" aria-label="Reference 6: Corsi, F. (2009). A simple approximate long-memory model of realized volatility. Journal of Financial Econometrics, 7(2), 174–196.">6</a>]</sup>.</p> <p>I fitted it the same way as the direction model, refitting every month on all earlier days, and next to it fitted the same regression on returns: tomorrow’s return from yesterday’s, the last week’s and the last month’s.</p> <p>The score is the out-of-sample \(R^2\), the share of the variation of the target that the forecast explains, against the simplest forecast (the historical mean for volatility, zero for returns):</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/ai-crypto-trading/volatility-light.png" width="760" alt="Left: Bitcoin's realized daily volatility since July 2025 and the HAR forecast made a day earlier, which follows it closely. Right: out-of-sample R squared, volatility against return: BTC 0.54 against -0.003; ETH 0.57 against -0.006; SOL 0.63 against -0.008" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/ai-crypto-trading/volatility-dark.png" width="760" alt="Left: Bitcoin's realized daily volatility since July 2025 and the HAR forecast made a day earlier, which follows it closely. Right: out-of-sample R squared, volatility against return: BTC 0.54 against -0.003; ETH 0.57 against -0.006; SOL 0.63 against -0.008" loading="lazy"></p> <p class="takeaway">For volatility \(R^2\) is 0.54 for Bitcoin, 0.57 for Ether and 0.63 for Solana; for returns it is below zero for all three, a forecast worse than saying “zero” every day.</p> <p>A volatility forecast is not a trading signal by itself, but it decides how large a position should be. A position scaled by the inverse of forecast volatility keeps its risk roughly constant, small when the market is wild and larger when it is calm:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/ai-crypto-trading/targeting-light.png" width="760" alt="Volatility over 30 days of holding Solana, swinging from about 40 to over 150 percent a year, and of a position sized by the forecast, which stays near the target of 50 percent. Realized volatility 93% against 48%, largest drawdown 95% against 72%" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/ai-crypto-trading/targeting-dark.png" width="760" alt="Volatility over 30 days of holding Solana, swinging from about 40 to over 150 percent a year, and of a position sized by the forecast, which stays near the target of 50 percent. Realized volatility 93% against 48%, largest drawdown 95% against 72%" loading="lazy"></p> <p>Holding Solana from 2022 to October 2026 meant a realized volatility of 93% a year and a worst fall of 94.5% from a peak. Scaling the position to a target of 50% held the realized volatility at 48% and cut the worst fall to 72%.</p> <p>For Bitcoin it raised the Sharpe ratio, the return per unit of volatility, from 0.21 to 0.31. It does not make a bad asset good, but it makes the risk of a strategy predictable, and in a market with six-sigma hours that matters more than a percent of hit rate.</p> <p>This is the part of machine learning that professional crypto firms use every day and rarely write about: forecasting volatility and liquidity, sizing positions, setting quotes, managing risk. The models are less glamorous than price prediction and much more useful.</p> <h2 id="the-backtest-that-flatters">The backtest that flatters</h2> <p>Every number so far comes from data the models never saw. Most strategies offered to traders, including many sold as AI, come from the opposite procedure: try many ideas on the same history and keep the one that looks best.</p> <p>Machine learning engineers know this as overfitting to the validation set; in finance it has its own literature and its own name, backtest overfitting.</p> <p>To see its size, I ran a grid of the rules every trading textbook contains: moving-average crossovers, breakouts of a price channel, and two kinds of mean reversion (RSI and Bollinger bands), each with a range of parameters, on the hourly candles of twelve large coins.</p> <p>Sixty-six rules on twelve coins make 792 strategies. Each was scored by its Sharpe ratio, the average return divided by its standard deviation and scaled to a year, after a fee of 5 bp per side, once on 2021-2023 and once on 2024 to October 2026:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/ai-crypto-trading/overfitting-light.png" width="760" alt="Scatter of 792 strategies, Sharpe ratio in 2021-2023 against 2024-2026. The cloud is flatter than the diagonal; the 20 best in the first period, highlighted, average 1.56 then and 0.19 later. Rank correlation 0.45" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/ai-crypto-trading/overfitting-dark.png" width="760" alt="Scatter of 792 strategies, Sharpe ratio in 2021-2023 against 2024-2026. The cloud is flatter than the diagonal; the 20 best in the first period, highlighted, average 1.56 then and 0.19 later. Rank correlation 0.45" loading="lazy"></p> <p>The ranking in the first period was not useless: its rank correlation with the second is 0.45, mostly because it identifies the rules that trade too often and lose to fees in any period. Mean reversion with RSI and Bollinger bands lost money in both. The winners are another matter.</p> <p class="takeaway">The 20 best strategies of 2021-2023 kept about an eighth of what the backtest promised: an average Sharpe ratio of 0.19 from 2024 on, against 1.56, and 6 of the 20 lost money.</p> <p>The second experiment removes any doubt about what is skill. Each of 20,000 strategies holds a random position, long or short, and flips it at random about once a day; none of them knows anything. Among \(N\) of them, the best one still looks good, and the more of them one tries, the better the best looks:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/ai-crypto-trading/noise-light.png" width="760" alt="Best Sharpe ratio among N random strategies against N on a log scale, with the expected maximum of Bailey and Lopez de Prado. N=1: -0.55; N=2: -0.23; N=5: 0.11; N=10: 0.32; N=20: 0.51; N=50: 0.71; N=100: 0.84; N=200: 0.95; N=500: 1.10; N=1000: 1.20; N=2000: 1.35; N=5000: 1.44; N=10000: 1.48; N=20000: 1.56" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/ai-crypto-trading/noise-dark.png" width="760" alt="Best Sharpe ratio among N random strategies against N on a log scale, with the expected maximum of Bailey and Lopez de Prado. N=1: -0.55; N=2: -0.23; N=5: 0.11; N=10: 0.32; N=20: 0.51; N=50: 0.71; N=100: 0.84; N=200: 0.95; N=500: 1.10; N=1000: 1.20; N=2000: 1.35; N=5000: 1.44; N=10000: 1.48; N=20000: 1.56" loading="lazy"></p> <p>Bailey and López de Prado (2014) gave the expected best Sharpe ratio among \(N\) independent trials that have no skill:</p> \[\mathbb{E}\big[\max_N \widehat{SR}\big] \approx \mathbb{E}\big[\widehat{SR}\big] + \sqrt{V}\left((1-\gamma)\,\Phi^{-1}\!\Big(1 - \frac{1}{N}\Big) + \gamma\,\Phi^{-1}\!\Big(1 - \frac{1}{N e}\Big)\right).\] <p>Here \(\mathbb{E}[\widehat{SR}]\) and \(V\) are the mean and the variance of the estimated Sharpe ratios across the trials, \(\Phi^{-1}\) is the inverse of the standard normal distribution function, \(\gamma \approx 0.5772\) is the Euler-Mascheroni constant and \(e\) is Euler’s number. The formula is the expected maximum of \(N\) normal draws, and it grows like \(\sqrt{2 \ln N}\): slowly, but without limit.</p> <p>Here the average random strategy has a Sharpe ratio of −0.55, because it pays fees for nothing. The best of 10 has 0.32, the best of 1,000 has 1.20, and the best of 20,000 has 1.56, as good as the 20 best real rules looked in their own past. The formula, with the trials’ average added, follows the experiment closely.</p> <p>Their deflated Sharpe ratio turns this into a test: it asks how likely the best strategy’s true Sharpe ratio is to be above zero, given how many strategies were tried and how long and fat-tailed the record is<sup class="cite">[<a href="#ref-7" id="cite-7" data-ref="7" aria-label="Reference 7: Bailey, D. H., &amp; López de Prado, M. (2014). The deflated Sharpe ratio: correcting for selection bias, backtest overfitting, and non-normality. Journal of Portfolio Management, 40(5), 94–107.">7</a>]</sup>.</p> <p>Applied to the best rule of my grid, the in-sample Sharpe ratio of 1.81 is below the 2.04 that the best of 792 trials would be expected to reach by luck, given how much their results differ, and the probability that its true Sharpe ratio is above zero comes out at 35%.</p> <p>That rule, a crossover of 12- and 24-hour averages on Dogecoin, did well afterwards anyway, with a Sharpe ratio of 1.21. A deflated Sharpe ratio is a probability, not a verdict; what it says is that the backtest alone was not evidence.</p> <p>The same arithmetic applies to every published result. Harvey, Liu and Zhu counted at least 316 factors that academic papers had tested to explain stock returns and concluded that, after so much searching, a new one should have a t-statistic above 3 rather than the usual 2 to be taken seriously<sup class="cite">[<a href="#ref-8" id="cite-8" data-ref="8" aria-label="Reference 8: Harvey, C. R., Liu, Y., &amp; Zhu, H. (2016). … and the cross-section of expected returns. Review of Financial Studies, 29(1), 5–68.">8</a>]</sup>.</p> <p>A seller of a trading bot who shows the best of their backtests is showing the maximum of \(N\) draws, and rarely says what \(N\) was.</p> <h2 id="language-models-as-traders">Language models as traders</h2> <p>Short records have a second problem besides selection: they are too short to tell skill from luck even for one strategy. Under the simplest assumptions, the standard error of an annualized Sharpe ratio estimated from \(D\) days of crypto trading is about</p> \[\mathrm{SE}\big(\widehat{SR}\big) \approx \sqrt{\frac{365}{D}},\] <p>so 17 days of Alpha Arena give an uncertainty of about 4.6. A model would have needed an annualized Sharpe ratio above 9 to stand out from zero.</p> <p>Trading more often does not help: the precision is set by calendar time, not by the number of decisions<sup class="cite">[<a href="#ref-9" id="cite-9" data-ref="9" aria-label="Reference 9: Lo, A. W. (2002). The statistics of Sharpe ratios. Financial Analysts Journal, 58(4), 36–52.">9</a>]</sup>. To show that a strategy has a Sharpe ratio of 1, the usual level of a good one, takes about four years of daily returns.</p> <p>The academic benchmarks of LLM traders run into the same wall. AI-Trader tested six models on ten coins for two weeks of November 2025; five of the six did worse than an index of the same coins<sup class="cite">[<a href="#ref-10" id="cite-10" data-ref="10" aria-label="Reference 10: Fan, T., Yang, Y., Jiang, Y., Zhang, Y., Chen, Y., &amp; Huang, C. (2025). AI-Trader: benchmarking autonomous agents in real-time financial markets. arXiv.">10</a>]</sup>.</p> <p>In StockBench, thirteen models traded twenty Dow stocks for four months and returned between −2.8% and +2.5%, against +0.4% for simply holding the stocks; in a second test over the falling market of early 2025, every agent did worse than holding<sup class="cite">[<a href="#ref-11" id="cite-11" data-ref="11" aria-label="Reference 11: Chen, Y., et al. (2025). StockBench: can LLM agents trade stocks profitably in real-world markets?. arXiv.">11</a>]</sup>.</p> <p>LiveTradeBench found that a model’s rank on general benchmarks says nothing about its returns: the rank correlation was 0.05<sup class="cite">[<a href="#ref-12" id="cite-12" data-ref="12" aria-label="Reference 12: Yu, H., Li, F., &amp; You, J. (2025). LiveTradeBench: seeking real-world alpha with large language models. arXiv.">12</a>]</sup>.</p> <p>The largest record I know of is the least flattering. A company that runs two fleets of LLM agents published six months of their trades; on Hyperliquid, 500 to 600 user-created agents lost money, won 41% of their round trips against 50% for comparable human retail traders, and used a median leverage of 5 regardless of how volatile the market was.</p> <p>Liquidations were 3.2% of the closed positions and 74% of the gross loss<sup class="cite">[<a href="#ref-13" id="cite-13" data-ref="13" aria-label="Reference 13: Barton, T. J., et al. (2026). What LLM trading agents actually do in production: a six-month, population-scale record from two fleets. arXiv.">13</a>]</sup>. It is the operator’s own paper, which makes the result harder, not easier, to dismiss.</p> <p>Longer tests are possible only on history, and history brings in a problem specific to language models. A model trained on text up to some date has read what happened before it. An LLM asked in 2026 whether to buy Bitcoin on 1 March 2020 may simply remember what came next.</p> <p>To see how much, I asked seven open models released between May 2024 and February 2026 about Bitcoin, from January 2018 to October 2026.</p> <p>Each model answered three kinds of questions: what Bitcoin closed at on the 1st and the 15th of every month, whether it went up or down over a given month, and whether it went up or down over a given week.</p> <p>For the up-or-down questions I did not let the models write an answer; I read the probabilities they gave to “up” and “down” as the first word, so that a model that would rather explain that it cannot know still had to lean one way. The models ran on Kaggle’s GPUs, in 16-bit precision and without any tools or web search.</p> <p>The price answers show where each model’s knowledge ends:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/ai-crypto-trading/memory-answers-light.png" width="760" alt="Bitcoin's real closing price from 2018 to 2026 and four open models' answers for the 1st and 15th of each month. Each model's answers follow the price closely up to some point before its release and then stop, turn into refusals, zeros or a constant guess. Mistral 7B v0.3, released 2024-05: median error 5% on dates a year or more before its release; Qwen2.5 7B, released 2024-09: median error 9% on dates a year or more before its release; Olmo 3 7B, released 2025-11: median error 18% on dates a year or more before its release; Qwen3.5 9B, released 2026-02: median error 10% on dates a year or more before its release" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/ai-crypto-trading/memory-answers-dark.png" width="760" alt="Bitcoin's real closing price from 2018 to 2026 and four open models' answers for the 1st and 15th of each month. Each model's answers follow the price closely up to some point before its release and then stop, turn into refusals, zeros or a constant guess. Mistral 7B v0.3, released 2024-05: median error 5% on dates a year or more before its release; Qwen2.5 7B, released 2024-09: median error 9% on dates a year or more before its release; Olmo 3 7B, released 2025-11: median error 18% on dates a year or more before its release; Qwen3.5 9B, released 2026-02: median error 10% on dates a year or more before its release" loading="lazy"></p> <p>Mistral 7B, released in May 2024, named Bitcoin’s closing price for dates in 2018 to 2022 with a median error of 3 to 5%; for every date after its release it declined to give a number.</p> <p>Qwen3.5 9B, released in February 2026, was off by 4 to 5% on dates in 2023 and 2024, still close in January and February 2025, and for every date from March 2025 on it answered “0”: its knowledge ends a year before its release.</p> <p>Olmo 3 7B had a median error of 9 to 10% for 2023 and 2024 and explained, in one of its refusals, that it had no data “beyond my knowledge cutoff in June 2023”, which its own answers contradict.</p> <p>None of these models was trained to know prices. They picked them up from the internet the way they picked up everything else.</p> <p>Direction is what a trading backtest needs, and the models remember it too:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/ai-crypto-trading/memory-direction-light.png" width="760" alt="Share of months for which each model says correctly whether Bitcoin went up or down, for months that ended a year or more before the model's release and for months after it: Mistral 7B v0.3 57% of 65 months before, 50% of 28 after; Qwen2.5 7B 59% of 69 months before, 46% of 24 after; OLMo 2 7B 67% of 72 months before, 52% of 21 after; Phi-4-mini 53% of 74 months before, 47% of 19 after; Qwen3 8B 58% of 76 months before, 41% of 17 after; Olmo 3 7B 66% of 83 months before, 50% of 10 after; Qwen3.5 9B 59% of 86 months before, 29% of 7 after" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/ai-crypto-trading/memory-direction-dark.png" width="760" alt="Share of months for which each model says correctly whether Bitcoin went up or down, for months that ended a year or more before the model's release and for months after it: Mistral 7B v0.3 57% of 65 months before, 50% of 28 after; Qwen2.5 7B 59% of 69 months before, 46% of 24 after; OLMo 2 7B 67% of 72 months before, 52% of 21 after; Phi-4-mini 53% of 74 months before, 47% of 19 after; Qwen3 8B 58% of 76 months before, 41% of 17 after; Olmo 3 7B 66% of 83 months before, 50% of 10 after; Qwen3.5 9B 59% of 86 months before, 29% of 7 after" loading="lazy"></p> <p>Over the months that ended at least a year before a model’s release, the seven models together called the direction right 60.0% of the time, in 525 answers; over the months after their release, 46.8% of 126.</p> <p>Each model’s answers are split at its own median probability, so that a model that says “up” to everything is judged by how it orders the months.</p> <p>The newest models have only a few months after their release, so their grey bars are noisy; the pooled numbers are not. For weeks the effect is smaller, 53.3% against 49.0%, probably because far less is written about single weeks than about months.</p> <p>Now suppose someone builds a trading strategy on these answers and backtests it on 2018-2026, as one would with any signal:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/ai-crypto-trading/memory-strategy-light.png" width="760" alt="A dollar traded monthly on OLMo 2 7B's answers grows to 245 dollars before the model's release in 2024-12, against 7 for holding Bitcoin, and then goes to 198, a change of -19% after the release" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/ai-crypto-trading/memory-strategy-dark.png" width="760" alt="A dollar traded monthly on OLMo 2 7B's answers grows to 245 dollars before the model's release in 2024-12, against 7 for holding Bitcoin, and then goes to 198, a change of -19% after the release" loading="lazy"></p> <p>Trading OLMo 2’s monthly answers turns a dollar into 245 between January 2018 and November 2024, while holding Bitcoin turns it into 7. After the model’s release in December 2024 the same strategy loses 19% over 22 months. Nothing in the backtest is wrong except the one thing that matters: the model had read the answers.</p> <p class="takeaway">Across the seven models, the strategy multiplied money by 8 to 245 before each model’s release and by 0.54 to 1.31 after it.</p> <p>This is not a curiosity. Lopez-Lira, Tang and Zhu asked GPT-4o for daily levels of the S&amp;P 500: before its training cutoff the error was 0.61%, after it 16.87%.</p> <p>Telling the model to ignore what it knows did not help, and anonymizing companies did not either: from an earnings call with the names removed, it identified Apple, Meta and Microsoft every time<sup class="cite">[<a href="#ref-14" id="cite-14" data-ref="14" aria-label="Reference 14: Lopez-Lira, A., Tang, Y., &amp; Zhu, M. (2025). The memorization problem: can we trust LLMs' economic forecasts?. arXiv.">14</a>]</sup>.</p> <p>When five published LLM trading agents were rerun on a period after their model’s cutoff, with a market return similar to their original period, their returns fell by 50 to 72%<sup class="cite">[<a href="#ref-15" id="cite-15" data-ref="15" aria-label="Reference 15: Li, X., Zeng, Y., Xing, X., Xu, J., &amp; Xu, X. (2025). Profit Mirage: revisiting information leakage in LLM-based financial agents. arXiv.">15</a>]</sup>.</p> <p>Over twenty years of data instead of a few months, holding the stocks beat the two best-known LLM trading agents in every setup<sup class="cite">[<a href="#ref-16" id="cite-16" data-ref="16" aria-label="Reference 16: Li, W. W., Kim, H., Cucuringu, M., &amp; Ma, T. (2026). Can LLM-based financial investing strategies outperform the market in long run?. KDD 2026, Datasets and Benchmarks Track.">16</a>]</sup>.</p> <p>There are fixes. Point-in-time models are trained only on text available up to a given date, one model per year, so that a backtest for 2015 uses a model that has never read 2016<sup class="cite">[<a href="#ref-17" id="cite-17" data-ref="17" aria-label="Reference 17: He, S., Lv, L., Manela, A., &amp; Wu, J. (2025). Chronologically consistent large language models. arXiv.">17</a>]</sup>.</p> <p>Their authors found the bias modest for one task, ranking stocks by the tone of the day’s news, which is a reminder that the size of the problem depends on what the model is asked.</p> <p>For anything that names a coin and a date, the only clean test is the one that runs after the model was trained, live, for long enough.</p> <h2 id="where-language-models-help">Where language models help</h2> <p>None of this makes language models useless to a trader. They are weak at the job that is easiest to sell, taking prices in and sending trades out, and good at several jobs around it.</p> <p>The clearest case is research. Man Group, one of the largest quantitative hedge funds, describes a pipeline of LLM agents in which one proposes hypotheses, another writes the code to test them on the firm’s data and a third runs the statistical tests; in their words, “whether generated by human or AI, every strategy entering live trading must pass identical thresholds”<sup class="cite">[<a href="#ref-18" id="cite-18" data-ref="18" aria-label="Reference 18: Man Group (2025). What AI can (and can't yet) do for alpha. Man Group insights.">18</a>]</sup>.</p> <p>The thresholds matter because a model that writes a hundred strategies an hour is the fastest way yet to make \(N\) in <a class="arrow-link" href="#the-backtest-that-flatters">the overfitting formula</a> large.</p> <p>Code is the second case. Coinbase says that between 95% and 100% of its code is now written by or with LLMs<sup class="cite">[<a href="#ref-19" id="cite-19" data-ref="19" aria-label="Reference 19: Cointelegraph (2026). Over 95% of Coinbase's code is written with AI: Rob Witoff.">19</a>]</sup>.</p> <p>Data pipelines, backtests, exchange connectors and monitoring are where a trading team spends most of its time, and a model that writes them faster saves more than one that guesses the next candle. Reading is the third: whitepapers, governance proposals, the code of a smart contract.</p> <p>Anthropic’s red team found that models could write working exploits for half of 405 smart contracts that had been hacked in the past, in simulation, and found two new vulnerabilities in recently deployed contracts<sup class="cite">[<a href="#ref-20" id="cite-20" data-ref="20" aria-label="Reference 20: Anthropic (2025). AI agents find smart contract exploits. Research post.">20</a>]</sup>; the same skill reviews a contract before one deposits into it, and attacks it for someone else.</p> <p>News is the case everyone expects to work. The evidence is thin: a 2026 study scored Bitcoin news with ChatGPT and found that the sentiment improved the fit in sample but added nothing significant out of sample<sup class="cite">[<a href="#ref-21" id="cite-21" data-ref="21" aria-label="Reference 21: Fiszeder, P., Orzeszko, W., &amp; Pietrzyk, R. (2026). News sentiment analysis using ChatGPT for Bitcoin price dynamics. Journal of Big Data, 13, 106.">21</a>]</sup>.</p> <p>Professional market makers, for their part, still hire for older skills. A recent job advertisement of Wintermute, one of the largest, asks a machine learning researcher to “develop ML-based alpha generation models using high-frequency order book and market microstructure data” and does not mention language models<sup class="cite">[<a href="#ref-22" id="cite-22" data-ref="22" aria-label="Reference 22: Wintermute (2026). Machine learning researcher. Job advertisement on Built In.">22</a>]</sup>.</p> <p>Forecasting events, rather than prices, is where language models have come furthest. On ForecastBench, a benchmark of questions about the future, several systems were by July 2026 “statistically indistinguishable from superforecaster-level accuracy”, and on questions taken from <a href="/blog/2026/polymarket-accuracy/">prediction markets</a> one ranked above the superforecasters’ median for the first time; the human forecasts it was compared with were collected in 2024<sup class="cite">[<a href="#ref-23" id="cite-23" data-ref="23" aria-label="Reference 23: Forecasting Research Institute (2026). AI models have likely reached parity with superforecasters on ForecastBench. 16 July 2026.">23</a>]</sup>.</p> <p>The money that bots have demonstrably made in prediction markets comes from something plainer: buying a set of outcomes that must together pay $1 for less than $1. On Polymarket this kind of arbitrage extracted an estimated $40 million in a year<sup class="cite">[<a href="#ref-24" id="cite-24" data-ref="24" aria-label="Reference 24: Saguillo, O., Ghafouri, V., Kiffer, L., &amp; Suarez-Tangil, G. (2025). Unravelling the probabilistic forest: arbitrage in prediction markets. AFT 2025.">24</a>]</sup>.</p> <p>Then there are foundation models for time series, Transformers pretrained on millions of series in the way language models are pretrained on text.</p> <p>Kronos was trained on more than 12 billion candles from 45 exchanges and reads open, high, low, close and volume as tokens<sup class="cite">[<a href="#ref-25" id="cite-25" data-ref="25" aria-label="Reference 25: Shi, Y., Fu, Z., Chen, S., Zhao, B., Xu, W., Zhang, C., &amp; Li, J. (2026). Kronos: a foundation model for the language of financial markets. AAAI 2026.">25</a>]</sup>; Chronos-2 is a general forecaster from Amazon<sup class="cite">[<a href="#ref-26" id="cite-26" data-ref="26" aria-label="Reference 26: Ansari, A. F., et al. (2025). Chronos-2: from univariate to universal forecasting. arXiv.">26</a>]</sup>.</p> <p>I found no independent test of them on crypto returns, so I ran one: both models, without <a href="/blog/2025/adapters/">fine-tuning</a>, forecast every hour of 2026 for Bitcoin, Ether and Solana from the 512 hours before, and Chronos-2 also forecast daily volatility.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/ai-crypto-trading/foundation-light.png" width="760" alt="Left: share of hours of 2026 where the direction of the next hour was right, for LightGBM, Chronos-2 and Kronos-small. BTC 53.2%, 49.3%, 52.2%; ETH 52.3%, 49.6%, 50.7%; SOL 53.0%, 49.2%, 49.6%. Right: R squared of tomorrow's log volatility, HAR against Chronos-2: BTC 0.77 against 0.67; ETH 0.83 against 0.64; SOL 0.89 against 0.66" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/ai-crypto-trading/foundation-dark.png" width="760" alt="Left: share of hours of 2026 where the direction of the next hour was right, for LightGBM, Chronos-2 and Kronos-small. BTC 53.2%, 49.3%, 52.2%; ETH 52.3%, 49.6%, 50.7%; SOL 53.0%, 49.2%, 49.6%. Right: R squared of tomorrow's log volatility, HAR against Chronos-2: BTC 0.77 against 0.67; ETH 0.83 against 0.64; SOL 0.89 against 0.66" loading="lazy"></p> <p>Neither model knows the direction of the next hour. Chronos-2 was right 49.2 to 49.6% of the time, slightly worse than a coin, and said “up” in 66 to 75% of the hours: from a series of hourly returns it learned mostly that the average is a little above zero.</p> <p>Kronos-small was right 49.6 to 52.2% of the time on the hours it forecast; with 1,812 hours per coin, a deviation of one or two points from 50% is within noise.</p> <p>The gradient-boosting model with its twenty hand-made features did better on the same months, which is what one would expect from a model trained on this very market.</p> <p>Volatility tells the same story as before. Chronos-2, which has never been trained on crypto in particular, forecast tomorrow’s log volatility with an \(R^2\) of 0.64 to 0.67 against the average of the previous 512 days; the HAR regression with four coefficients scored 0.77 to 0.89 on the same days.</p> <p>A large pretrained model learned that volatility clusters, and a model built around that fact still knows it better.</p> <p>Independent tests on stock returns found the same: zero-shot Chronos and TimesFM had negative out-of-sample \(R^2\) on returns, where gradient boosting was close to zero<sup class="cite">[<a href="#ref-27" id="cite-27" data-ref="27" aria-label="Reference 27: Rahimikia, E., Ni, H., &amp; Wang, W. (2025). Re(visiting) time series foundation models in finance. arXiv.">27</a>]</sup>, and on realized volatility only a tiny model beat the logarithmic HAR<sup class="cite">[<a href="#ref-28" id="cite-28" data-ref="28" aria-label="Reference 28: Brini, A. (2026). Forecasting realized volatility with time series foundation models: a comparison with econometric benchmarks. arXiv.">28</a>]</sup>.</p> <h2 id="agents-with-keys">Agents with keys</h2> <p>In crypto, “AI agent” first meant something other than a trading system. In 2024 a chatbot called Truth Terminal, which posted on X, received a $50,000 research grant in bitcoin from Marc Andreessen and then promoted a memecoin that someone else had launched<sup class="cite">[<a href="#ref-29" id="cite-29" data-ref="29" aria-label="Reference 29: DL News (2024). Marc Andreessen distances himself from obscene memecoin GOAT after &amp;#36;300m surge.">29</a>]</sup>.</p> <p>Tokens of other “AI agents” followed, and at their peak around the turn of 2025 they were worth about $16 billion together; most have since fallen by more than 90%<sup class="cite">[<a href="#ref-30" id="cite-30" data-ref="30" aria-label="Reference 30: CoinGecko (2025). AI agent market map: hype ends, technology continues. With Tiger Research.">30</a>]</sup>. In August 2026 the founder of ai16z, a token once worth $2.4 billion, wrote: “The token is dead. Completely”<sup class="cite">[<a href="#ref-31" id="cite-31" data-ref="31" aria-label="Reference 31: CoinDesk (2026). AI agent token once worth &amp;#36;2.4 billion ends with founder calling it dead. 5 August 2026.">31</a>]</sup>.</p> <p>The agents themselves outlived their tokens, and the interesting question about them is not price but security. A program that reads the internet and can move money is a new kind of target, because everything it reads is text, and a language model treats text as a possible instruction.</p> <p>The first public demonstration was a game. Freysa was an agent with a wallet and one rule, never to send the money; players paid a rising fee per message to try to talk it into doing so.</p> <p>After 482 attempts one player convinced it that its transfer function was for receiving funds, offered a donation, and took the prize of $47,316<sup class="cite">[<a href="#ref-32" id="cite-32" data-ref="32" aria-label="Reference 32: The Block (2024). Human player outwits Freysa AI agent in &amp;#36;47,000 crypto challenge.">32</a>]</sup>.</p> <p>The real incidents are less elegant. In March 2025 someone with access to the dashboard of AIXBT, an agent that posts market commentary, queued two replies that made it send about 55 ETH, some $100,000, from its wallet; the team said it was “not a result of agent manipulation”, which makes it an ordinary access-control failure with an AI attached<sup class="cite">[<a href="#ref-33" id="cite-33" data-ref="33" aria-label="Reference 33: The Block (2025). AI crypto bot AIXBT lost &amp;#36;100,000 worth of ETH after hacker gained unauthorized &quot;dashboard access&quot;. 18 March 2025.">33</a>]</sup>.</p> <p>In May 2026 an attacker sent Grok’s wallet a membership NFT that widened what the wallet was allowed to transfer, then posted a message in Morse code; Grok decoded it into an instruction to a trading bot, Bankrbot, which sent 3 billion DRB tokens, worth about $150,000 to $200,000<sup class="cite">[<a href="#ref-34" id="cite-34" data-ref="34" aria-label="Reference 34: CryptoSlate (2026). Grok's crypto wallet was just exploited by a tweet sent in morse code without any private key compromise.">34</a>]</sup>. No key was stolen and no contract had a bug.</p> <p>Memory makes this worse. Researchers at Princeton showed that an attacker can plant a false instruction in an agent’s long-term memory through an ordinary conversation, and the agent later acts on it when other users make legitimate requests. In their summary, “even the strongest models followed poisoned memories more than half the time”<sup class="cite">[<a href="#ref-35" id="cite-35" data-ref="35" aria-label="Reference 35: Patlan, A. S., Sheng, P., Hebbar, S. A., Mittal, P., &amp; Viswanath, P. (2025). Real AI agents with fake memories: fatal context manipulation attacks on Web3 agents. arXiv.">35</a>]</sup>.</p> <p>The tools around the model are a supply chain of their own. Of 2,857 skills in one open marketplace for agents, a security firm found 341 malicious, 163 of them dressed as crypto tools and prediction-market bots<sup class="cite">[<a href="#ref-36" id="cite-36" data-ref="36" aria-label="Reference 36: PolySwarm (2026). The ClawHavoc campaign.">36</a>]</sup>.</p> <p>An MCP server published on npm asked for a wallet’s private key to “auto-sign” payments and sent it to a remote server with every call<sup class="cite">[<a href="#ref-37" id="cite-37" data-ref="37" aria-label="Reference 37: Knostic (2026). When &quot;auto-signing&quot; sends your wallet: a malicious MCP server on npm.">37</a>]</sup>.</p> <p>Of 428 third-party routers that resell access to LLM APIs, researchers found nine that injected malicious code, and one that drained ETH from a key planted as bait<sup class="cite">[<a href="#ref-38" id="cite-38" data-ref="38" aria-label="Reference 38: Liu, H., Shou, C., Wen, H., Chen, Y., Fang, R. J., &amp; Feng, Y. (2026). Your agent is mine: measuring malicious intermediary attacks on the LLM supply chain. arXiv.">38</a>]</sup>.</p> <p>Even the news can be an attack: altering headlines with invisible characters on a single day cut a sentiment-trading system’s annual return by up to 17.7 percentage points<sup class="cite">[<a href="#ref-39" id="cite-39" data-ref="39" aria-label="Reference 39: Rizvani, A., Apruzzese, G., &amp; Laskov, P. (2026). Adversarial news and lost profits: manipulating headlines in LLM-driven algorithmic trading. IEEE SaTML 2026.">39</a>]</sup>.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/ai-crypto-trading/agent-light.png" width="760" alt="Parts of an LLM trading agent. Inputs: prices and order books, news and social posts, on-chain data, and the agent's memory of earlier sessions. All of them reach the language model as text, and the model calls tools and plugins. It proposes an order, which passes through risk checks written in ordinary code (position and loss limits, allowed markets) before it reaches the exchange with an API key that can trade but not withdraw. Attack points: instructions hidden in a post, planted memories, a malicious plugin or tool, and a leaked key" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/ai-crypto-trading/agent-dark.png" width="760" alt="Parts of an LLM trading agent. Inputs: prices and order books, news and social posts, on-chain data, and the agent's memory of earlier sessions. All of them reach the language model as text, and the model calls tools and plugins. It proposes an order, which passes through risk checks written in ordinary code (position and loss limits, allowed markets) before it reaches the exchange with an API key that can trade but not withdraw. Attack points: instructions hidden in a post, planted memories, a malicious plugin or tool, and a leaked key" loading="lazy"></p> <p>The exchanges’ agent toolkits of 2026 have converged on the same defence. Binance’s lets agents trade from a walled-off sub-account but not move assets to an external wallet<sup class="cite">[<a href="#ref-40" id="cite-40" data-ref="40" aria-label="Reference 40: crypto.news (2026). Binance just gave AI bots a trading license. The safeguards are thinner than they look.">40</a>]</sup>.</p> <p>OKX signs orders on the user’s machine, so that “the AI client sends only trading intent”, and offers a mode with simulated funds<sup class="cite">[<a href="#ref-41" id="cite-41" data-ref="41" aria-label="Reference 41: OKX (2026). Connecting agentic trading to OKX exchange with Agent Trade Kit.">41</a>]</sup>; Kraken’s command-line tool has a local paper-trading engine<sup class="cite">[<a href="#ref-42" id="cite-42" data-ref="42" aria-label="Reference 42: Kraken (2026). Announcing the Kraken CLI. Kraken blog.">42</a>]</sup>. A key that cannot withdraw prevents theft. It does nothing against an agent that loses money by trading.</p> <div class="callout"> <p class="callout-label">For engineers</p> <p>The design that follows from all this is old-fashioned. The model reads untrusted text and proposes; ordinary code decides, with limits on position size, leverage and daily loss that the model cannot change. Memory is per user and is treated as untrusted input too. Tools come from sources one has read. And the model never holds a key that can send funds anywhere.</p> </div> <h2 id="bots-that-sell-returns">Bots that sell returns</h2> <p>Every claim in the previous sections can be checked against data. The market for “AI trading bots” mostly cannot, and regulators have been warning about it for years. In January 2024 the US Commodity Futures Trading Commission published an advisory titled “AI Won’t Turn Trading Bots into Money Machines”, with a sentence that could close this post<sup class="cite">[<a href="#ref-43" id="cite-43" data-ref="43" aria-label="Reference 43: Commodity Futures Trading Commission (2024). Customer advisory: AI won't turn trading bots into money machines.">43</a>]</sup>:</p> <blockquote class="pull"> <p>AI technology can’t predict the future or sudden market changes.</p> <p><cite>US Commodity Futures Trading Commission, customer advisory</cite></p> </blockquote> <p>Its main example was Mirror Trading International, which collected at least 29,421 bitcoin, worth $1.7 billion, from about 23,000 Americans for a trading “bot”<sup class="cite">[<a href="#ref-44" id="cite-44" data-ref="44" aria-label="Reference 44: Commodity Futures Trading Commission (2022). CFTC charges South African pool operator and CEO with &amp;#36;1.7 billion fraud involving bitcoin. Press release 8549-22.">44</a>]</sup>. In the advisory’s words, “in reality, very little money was actually traded.” The schemes of 2026 have updated the vocabulary, not the method.</p> <p>In September the SEC charged two groups that sold access to AI trading bots and signals through WhatsApp; of one of them it wrote that “there were no AI trading bots and deposited funds never were used to earn returns for investors”<sup class="cite">[<a href="#ref-4" id="cite-45" data-ref="4" aria-label="Reference 4: U.S. Securities and Exchange Commission (2026). SEC charges multiple entities in fraud schemes totaling at least &amp;#36;15 million that used WhatsApp and other platforms to lure investors. Press release 2026-95.">4</a>]</sup>.</p> <p>On 29 October 2026 it sued a pair of companies that took more than $130 million for trading signals with a claimed accuracy of 99.6% and promised that “the monthly fund return rate is at least 60%”<sup class="cite">[<a href="#ref-45" id="cite-46" data-ref="45" aria-label="Reference 45: U.S. Securities and Exchange Commission (2026). Complaint, SEC v. BG Wealth Sharing Ltd. and DSJ Exchange Pty Ltd.. U.S. District Court, Northern District of California, filed 29 October 2026.">45</a>]</sup>.</p> <p>Sixty percent a month turns $1,000 into $281,000 in a year and into $22 million in three. A strategy that did this would not need investors.</p> <p>The arithmetic of the earlier sections gives a better sense of scale: a model that is right 54% of the time on the next hour of Bitcoin, close to the best that published studies report, loses money at ordinary fees.</p> <p>The losses are large. In 2025 Americans reported $7.2 billion lost to crypto investment fraud, the largest category of all in the FBI’s annual report, and more than $632 million in investment complaints where AI was mentioned<sup class="cite">[<a href="#ref-46" id="cite-47" data-ref="46" aria-label="Reference 46: FBI Internet Crime Complaint Center (2026). Internet crime report 2025.">46</a>]</sup>.</p> <p>Chainalysis found that scam operations that bought AI tools, from face swapping to text generation, earned 4.5 times as much as those that did not<sup class="cite">[<a href="#ref-47" id="cite-48" data-ref="47" aria-label="Reference 47: Chainalysis (2026). 2026 crypto crime report: scams.">47</a>]</sup>. And in a survey by the UK’s Financial Conduct Authority, 44% of investors aged 18 to 40 believed that financial information generated by AI is regulated<sup class="cite">[<a href="#ref-48" id="cite-49" data-ref="48" aria-label="Reference 48: Financial Conduct Authority (2026). Young investors trust AI more than TV or celebrities. Press release.">48</a>]</sup>.</p> <h2 id="strategies-that-do-not-need-a-forecast">Strategies that do not need a forecast</h2> <p>Some of the steadiest money in crypto is made without predicting anything. A perpetual future is a contract that tracks a coin and never expires; to keep its price close to the coin’s, the side that is more crowded pays the other side every eight hours.</p> <p>This payment is the funding rate. When more traders want to be long with leverage, which in crypto is most of the time, longs pay shorts.</p> <p>Buying a coin and shorting the same amount of its perpetual cancels out the price risk and collects the funding. This is the cash-and-carry trade, and on Binance the rate defaults to 0.01% per eight hours, about 11% a year, when the two prices agree. What it actually paid looks like this:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/ai-crypto-trading/funding-light.png" width="760" alt="Funding of Binance's BTC and ETH perpetual futures by month, scaled to a year, 2020 to October 2026. Yearly averages for BTC: 2020 17.2%, 2021 30.6%, 2022 4.2%, 2023 7.9%, 2024 11.9%, 2025 5.1%, 2026 3.1%" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/ai-crypto-trading/funding-dark.png" width="760" alt="Funding of Binance's BTC and ETH perpetual futures by month, scaled to a year, 2020 to October 2026. Yearly averages for BTC: 2020 17.2%, 2021 30.6%, 2022 4.2%, 2023 7.9%, 2024 11.9%, 2025 5.1%, 2026 3.1%" loading="lazy"></p> <p>In 2021 the trade earned 30.6% a year on Bitcoin and 37.5% on Ether, from nothing but other traders’ appetite for leverage. Since then the Bitcoin trade has paid between 4 and 12% a year, and 3.1% in 2026 to the end of October, with a quarter of the payments going the other way.</p> <p>A study at the BIS found crypto carry averaging more than 10% a year and sometimes reaching 60%<sup class="cite">[<a href="#ref-49" id="cite-50" data-ref="49" aria-label="Reference 49: Schmeling, M., Schrimpf, A., &amp; Todorov, K. (2023). Crypto carry. BIS Working Papers, 1087.">49</a>]</sup>; the shrinking yield of recent years is what one would expect once a trade is easy to see and easy to automate.</p> <p>Market-neutral is not risk-free. On the evening of 10 October 2025, after an announcement of new US tariffs on China, Bitcoin fell 12.6% on Binance in eighty minutes, Ether 14.1% and Solana 17.8%. More than $19 billion of leveraged positions were liquidated across exchanges.</p> <p>Where insurance funds could not absorb the losses, exchanges closed profitable positions of other traders to cover them, a mechanism called auto-deleveraging, and among the positions closed were the short hedges of market makers<sup class="cite">[<a href="#ref-50" id="cite-51" data-ref="50" aria-label="Reference 50: CoinGlass (2026). CoinGlass 2025 crypto derivatives market annual report.">50</a>]</sup>.</p> <p>On Hyperliquid alone it closed $2.1 billion of positions in twelve minutes<sup class="cite">[<a href="#ref-51" id="cite-52" data-ref="51" aria-label="Reference 51: Chitra, T. (2025). Autodeleveraging: impossibilities and optimization. arXiv.">51</a>]</sup>. A hedged trader whose hedge is closed by the exchange is no longer hedged.</p> <p class="flow"><span>Bitcoin falls 12.6% in eighty minutes</span><span>losses beyond the insurance funds</span><span>exchanges close the hedges of market makers</span><span>a hedged trader is no longer hedged</span></p> <p>The other risk is the exchange itself. A carry position lives on an exchange, and while I was writing this post the largest one stopped withdrawals after the hack mentioned above. A position that is neutral to the price of Bitcoin is not neutral to the solvency of the venue that holds it.</p> <h2 id="a-realistic-picture">A realistic picture</h2> <p>Put together, the experiments draw a consistent picture, and it is less exciting than the advertising and more useful.</p> <p>What machine learning does well in crypto is to forecast the things that have memory: volatility, volume, liquidity, the cost of trading.</p> <p>These forecasts size positions, set quotes, route orders and keep a leveraged book alive through an hour like the evening of 10 October 2025. This is where the firms that make money from crypto markets put their models, and it rarely makes headlines.</p> <p>Direction is a different matter. Short-horizon patterns exist, like the hourly reversal my model found, and other studies find them too: hit rates of 51 to 56% for Bitcoin from one minute to an hour ahead, with every model losing money once a round trip costs 30 bp<sup class="cite">[<a href="#ref-52" id="cite-53" data-ref="52" aria-label="Reference 52: Jaquart, P., Dann, D., &amp; Weinhardt, C. (2021). Short-term bitcoin market prediction via machine learning. Journal of Finance and Data Science, 7, 45–66.">52</a>]</sup>; on hourly Bitcoin bars from 2018 to 2026, models that earned 74 to 182% a year before costs lost 64 to 99% after a cost of 10 bp per trade<sup class="cite">[<a href="#ref-53" id="cite-54" data-ref="53" aria-label="Reference 53: Bysik, A., &amp; Ślepaczuk, R. (2026). Machine learning-based bitcoin trading under transaction costs: evidence from walk-forward forecasting. arXiv.">53</a>]</sup>.</p> <p>Such an edge belongs to whoever trades most cheaply, which means market makers, not someone paying taker fees through an API.</p> <p>Language models are good research assistants, programmers and readers of documents. As autonomous traders they have not shown skill in any test long and clean enough to tell, they remember the history they are tested on, and an agent with keys is a security problem before it is a trading strategy.</p> <p>For an ML engineer moving into this field, the habits that matter are the ones markets punish for skipping: splitting by time with a gap, putting costs into the evaluation and not after it, counting how many variants were tried, thinking of a Sharpe ratio as an estimate with a standard error, and testing language models only on dates after their training.</p> <p>For a trader, the same habits turn into questions to ask about any AI product. How many strategies were tried before this one was shown? How long is the live record, and does it include fees?</p> <p>Were the backtest dates after the model’s training cutoff? Who holds the keys, and can they withdraw? And an offer of a fixed monthly return is not a trading product at all.</p> <p>There is also a question for the market as a whole. Central banks have started to worry that many traders using the same few models will act alike; the Bank of England warned that more advanced AI trading strategies “could lead to firms taking increasingly correlated positions and acting in a similar way during a stress”<sup class="cite">[<a href="#ref-54" id="cite-55" data-ref="54" aria-label="Reference 54: Bank of England (2025). Financial stability in focus: artificial intelligence in the financial system.">54</a>]</sup>.</p> <p>In Alpha Arena, four of the six models, given the same prompt, moved together with hourly correlations between 0.52 and 0.83.</p> <p>In a market where many agents read the same news with the same model, a crowded trade can form in minutes, and the hour that unwinds it is the kind that sits in the tails of the first chart of this post.</p> <h2 id="references">References</h2> <ol class="tfs-refs"> <li id="ref-1">Nof1 (2025). <a href="https://web.archive.org/web/20251112224723/https://nof1.ai/blog/TechPost1">Exploring the limits of large language models as quant traders</a>. Blog post, archived copy. <a class="ref-back" href="#cite-1" aria-label="Back to the text">↩</a></li> <li id="ref-2">Azhang, J. (2025). <a href="https://x.com/jay_azhang/status/1985481491078328621">Season 1 of Alpha Arena has officially ended</a>. Post on X, 3 November 2025. <a class="ref-back" href="#cite-2" aria-label="Back to the text">↩</a></li> <li id="ref-3">MEXC (2026). <a href="https://blog.mexc.com/press-release/mexc-ai-trading-report-85-use-ai-for-crypto/">MEXC AI trading report: 85% use AI for crypto, yet only 6.5% would authorize it to trade most of their funds</a>. Press release. <a class="ref-back" href="#cite-3" aria-label="Back to the text">↩</a></li> <li id="ref-4">U.S. Securities and Exchange Commission (2026). <a href="https://www.sec.gov/newsroom/press-releases/2026-95-sec-charges-multiple-entities-fraud-schemes-totaling-least-15-million-used-whatsapp-other-platforms">SEC charges multiple entities in fraud schemes totaling at least $15 million that used WhatsApp and other platforms to lure investors</a>. Press release 2026-95. <a class="ref-back" href="#cite-4" aria-label="Back to the text">↩</a></li> <li id="ref-5">CoinDesk (2026). <a href="https://www.coindesk.com/tech/2026/10/30/binance-uncovers-wider-breach-in-usd6-3-billion-exploit-targets-sunday-withdrawal-restart">Binance uncovers wider breach in $6.3 billion exploit, targets Sunday withdrawal restart</a>. 30 October 2026. <a class="ref-back" href="#cite-5" aria-label="Back to the text">↩</a></li> <li id="ref-6">Corsi, F. (2009). <a href="https://doi.org/10.1093/jjfinec/nbp001">A simple approximate long-memory model of realized volatility</a>. <em>Journal of Financial Econometrics</em>, 7(2), 174–196. <a class="ref-back" href="#cite-6" aria-label="Back to the text">↩</a></li> <li id="ref-7">Bailey, D. H., &amp; López de Prado, M. (2014). <a href="https://doi.org/10.3905/jpm.2014.40.5.094">The deflated Sharpe ratio: correcting for selection bias, backtest overfitting, and non-normality</a>. <em>Journal of Portfolio Management</em>, 40(5), 94–107. <a class="ref-back" href="#cite-7" aria-label="Back to the text">↩</a></li> <li id="ref-8">Harvey, C. R., Liu, Y., &amp; Zhu, H. (2016). <a href="https://doi.org/10.1093/rfs/hhv059">… and the cross-section of expected returns</a>. <em>Review of Financial Studies</em>, 29(1), 5–68. <a class="ref-back" href="#cite-8" aria-label="Back to the text">↩</a></li> <li id="ref-9">Lo, A. W. (2002). <a href="https://doi.org/10.2469/faj.v58.n4.2453">The statistics of Sharpe ratios</a>. <em>Financial Analysts Journal</em>, 58(4), 36–52. <a class="ref-back" href="#cite-9" aria-label="Back to the text">↩</a></li> <li id="ref-10">Fan, T., Yang, Y., Jiang, Y., Zhang, Y., Chen, Y., &amp; Huang, C. (2025). <a href="https://arxiv.org/abs/2512.10971">AI-Trader: benchmarking autonomous agents in real-time financial markets</a>. arXiv. <a class="ref-back" href="#cite-10" aria-label="Back to the text">↩</a></li> <li id="ref-11">Chen, Y., et al. (2025). <a href="https://arxiv.org/abs/2510.02209">StockBench: can LLM agents trade stocks profitably in real-world markets?</a>. arXiv. <a class="ref-back" href="#cite-11" aria-label="Back to the text">↩</a></li> <li id="ref-12">Yu, H., Li, F., &amp; You, J. (2025). <a href="https://arxiv.org/abs/2511.03628">LiveTradeBench: seeking real-world alpha with large language models</a>. arXiv. <a class="ref-back" href="#cite-12" aria-label="Back to the text">↩</a></li> <li id="ref-13">Barton, T. J., et al. (2026). <a href="https://arxiv.org/abs/2609.05663">What LLM trading agents actually do in production: a six-month, population-scale record from two fleets</a>. arXiv. <a class="ref-back" href="#cite-13" aria-label="Back to the text">↩</a></li> <li id="ref-14">Lopez-Lira, A., Tang, Y., &amp; Zhu, M. (2025). <a href="https://arxiv.org/abs/2504.14765">The memorization problem: can we trust LLMs’ economic forecasts?</a>. arXiv. <a class="ref-back" href="#cite-14" aria-label="Back to the text">↩</a></li> <li id="ref-15">Li, X., Zeng, Y., Xing, X., Xu, J., &amp; Xu, X. (2025). <a href="https://arxiv.org/abs/2510.07920">Profit Mirage: revisiting information leakage in LLM-based financial agents</a>. arXiv. <a class="ref-back" href="#cite-15" aria-label="Back to the text">↩</a></li> <li id="ref-16">Li, W. W., Kim, H., Cucuringu, M., &amp; Ma, T. (2026). <a href="https://arxiv.org/abs/2505.07078">Can LLM-based financial investing strategies outperform the market in long run?</a>. <em>KDD 2026</em>, Datasets and Benchmarks Track. <a class="ref-back" href="#cite-16" aria-label="Back to the text">↩</a></li> <li id="ref-17">He, S., Lv, L., Manela, A., &amp; Wu, J. (2025). <a href="https://arxiv.org/abs/2502.21206">Chronologically consistent large language models</a>. arXiv. <a class="ref-back" href="#cite-17" aria-label="Back to the text">↩</a></li> <li id="ref-18">Man Group (2025). <a href="https://www.man.com/insights/what-ai-can-do-for-alpha">What AI can (and can’t yet) do for alpha</a>. Man Group insights. <a class="ref-back" href="#cite-18" aria-label="Back to the text">↩</a></li> <li id="ref-19">Cointelegraph (2026). <a href="https://cointelegraph.com/news/over-95-of-coinbases-code-is-now-written-with-ai">Over 95% of Coinbase’s code is written with AI: Rob Witoff</a>. <a class="ref-back" href="#cite-19" aria-label="Back to the text">↩</a></li> <li id="ref-20">Anthropic (2025). <a href="https://www.anthropic.com/research/smart-contracts">AI agents find smart contract exploits</a>. Research post. <a class="ref-back" href="#cite-20" aria-label="Back to the text">↩</a></li> <li id="ref-21">Fiszeder, P., Orzeszko, W., &amp; Pietrzyk, R. (2026). <a href="https://doi.org/10.1186/s40537-026-01392-x">News sentiment analysis using ChatGPT for Bitcoin price dynamics</a>. <em>Journal of Big Data</em>, 13, 106. <a class="ref-back" href="#cite-21" aria-label="Back to the text">↩</a></li> <li id="ref-22">Wintermute (2026). <a href="https://builtin.com/job/machine-learning-researcher/7735963">Machine learning researcher</a>. Job advertisement on Built In. <a class="ref-back" href="#cite-22" aria-label="Back to the text">↩</a></li> <li id="ref-23">Forecasting Research Institute (2026). <a href="https://forecastingresearch.substack.com/p/ai-models-have-likely-reached-parity">AI models have likely reached parity with superforecasters on ForecastBench</a>. 16 July 2026. <a class="ref-back" href="#cite-23" aria-label="Back to the text">↩</a></li> <li id="ref-24">Saguillo, O., Ghafouri, V., Kiffer, L., &amp; Suarez-Tangil, G. (2025). <a href="https://arxiv.org/abs/2508.03474">Unravelling the probabilistic forest: arbitrage in prediction markets</a>. <em>AFT 2025</em>. <a class="ref-back" href="#cite-24" aria-label="Back to the text">↩</a></li> <li id="ref-25">Shi, Y., Fu, Z., Chen, S., Zhao, B., Xu, W., Zhang, C., &amp; Li, J. (2026). <a href="https://arxiv.org/abs/2508.02739">Kronos: a foundation model for the language of financial markets</a>. <em>AAAI 2026</em>. <a class="ref-back" href="#cite-25" aria-label="Back to the text">↩</a></li> <li id="ref-26">Ansari, A. F., et al. (2025). <a href="https://arxiv.org/abs/2510.15821">Chronos-2: from univariate to universal forecasting</a>. arXiv. <a class="ref-back" href="#cite-26" aria-label="Back to the text">↩</a></li> <li id="ref-27">Rahimikia, E., Ni, H., &amp; Wang, W. (2025). <a href="https://arxiv.org/abs/2511.18578">Re(visiting) time series foundation models in finance</a>. arXiv. <a class="ref-back" href="#cite-27" aria-label="Back to the text">↩</a></li> <li id="ref-28">Brini, A. (2026). <a href="https://arxiv.org/abs/2607.05291">Forecasting realized volatility with time series foundation models: a comparison with econometric benchmarks</a>. arXiv. <a class="ref-back" href="#cite-28" aria-label="Back to the text">↩</a></li> <li id="ref-29">DL News (2024). <a href="https://dlnews.com/articles/people-culture/marc-andreessen-distances-himself-from-obscene-memecoin-goat/">Marc Andreessen distances himself from obscene memecoin GOAT after $300m surge</a>. <a class="ref-back" href="#cite-29" aria-label="Back to the text">↩</a></li> <li id="ref-30">CoinGecko (2025). <a href="https://www.coingecko.com/learn/ai-agent-market-map-hype-ends-technology-continues">AI agent market map: hype ends, technology continues</a>. With Tiger Research. <a class="ref-back" href="#cite-30" aria-label="Back to the text">↩</a></li> <li id="ref-31">CoinDesk (2026). <a href="https://www.coindesk.com/markets/2026/08/05/ai-agent-token-once-worth-usd2-4-billion-ends-with-founder-calling-it-dead">AI agent token once worth $2.4 billion ends with founder calling it dead</a>. 5 August 2026. <a class="ref-back" href="#cite-31" aria-label="Back to the text">↩</a></li> <li id="ref-32">The Block (2024). <a href="https://www.theblock.co/post/328747/human-player-outwits-freysa-ai-agent-in-47000-crypto-challenge">Human player outwits Freysa AI agent in $47,000 crypto challenge</a>. <a class="ref-back" href="#cite-32" aria-label="Back to the text">↩</a></li> <li id="ref-33">The Block (2025). <a href="https://www.theblock.co/post/346911/">AI crypto bot AIXBT lost $100,000 worth of ETH after hacker gained unauthorized “dashboard access”</a>. 18 March 2025. <a class="ref-back" href="#cite-33" aria-label="Back to the text">↩</a></li> <li id="ref-34">CryptoSlate (2026). <a href="https://cryptoslate.com/how-one-trader-exploited-grok-and-morse-code-to-trick-ai-agent-into-sending-billions-of-crypto-tokens-from-a-verified-wallet/">Grok’s crypto wallet was just exploited by a tweet sent in morse code without any private key compromise</a>. <a class="ref-back" href="#cite-34" aria-label="Back to the text">↩</a></li> <li id="ref-35">Patlan, A. S., Sheng, P., Hebbar, S. A., Mittal, P., &amp; Viswanath, P. (2025). <a href="https://arxiv.org/abs/2503.16248">Real AI agents with fake memories: fatal context manipulation attacks on Web3 agents</a>. arXiv. <a class="ref-back" href="#cite-35" aria-label="Back to the text">↩</a></li> <li id="ref-36">PolySwarm (2026). <a href="https://blog.polyswarm.io/the-clawhavoc-campaign">The ClawHavoc campaign</a>. <a class="ref-back" href="#cite-36" aria-label="Back to the text">↩</a></li> <li id="ref-37">Knostic (2026). <a href="https://www.knostic.ai/blog/when-auto-signing-sends-your-wallet-private-key-to-a-remote-server-a-malicious-mcp-package-on-npm">When “auto-signing” sends your wallet: a malicious MCP server on npm</a>. <a class="ref-back" href="#cite-37" aria-label="Back to the text">↩</a></li> <li id="ref-38">Liu, H., Shou, C., Wen, H., Chen, Y., Fang, R. J., &amp; Feng, Y. (2026). <a href="https://arxiv.org/abs/2604.08407">Your agent is mine: measuring malicious intermediary attacks on the LLM supply chain</a>. arXiv. <a class="ref-back" href="#cite-38" aria-label="Back to the text">↩</a></li> <li id="ref-39">Rizvani, A., Apruzzese, G., &amp; Laskov, P. (2026). <a href="https://arxiv.org/abs/2601.13082">Adversarial news and lost profits: manipulating headlines in LLM-driven algorithmic trading</a>. <em>IEEE SaTML 2026</em>. <a class="ref-back" href="#cite-39" aria-label="Back to the text">↩</a></li> <li id="ref-40">crypto.news (2026). <a href="https://crypto.news/binance-agent-os-ai-trading-safeguards/">Binance just gave AI bots a trading license. The safeguards are thinner than they look</a>. <a class="ref-back" href="#cite-40" aria-label="Back to the text">↩</a></li> <li id="ref-41">OKX (2026). <a href="https://www.okx.com/en-us/learn/agent-trade-kit">Connecting agentic trading to OKX exchange with Agent Trade Kit</a>. <a class="ref-back" href="#cite-41" aria-label="Back to the text">↩</a></li> <li id="ref-42">Kraken (2026). <a href="https://blog.kraken.com/news/industry-news/announcing-the-kraken-cli">Announcing the Kraken CLI</a>. Kraken blog. <a class="ref-back" href="#cite-42" aria-label="Back to the text">↩</a></li> <li id="ref-43">Commodity Futures Trading Commission (2024). <a href="https://www.cftc.gov/LearnAndProtect/AdvisoriesAndArticles/AITradingBots.html">Customer advisory: AI won’t turn trading bots into money machines</a>. <a class="ref-back" href="#cite-43" aria-label="Back to the text">↩</a></li> <li id="ref-44">Commodity Futures Trading Commission (2022). <a href="https://www.cftc.gov/PressRoom/PressReleases/8549-22">CFTC charges South African pool operator and CEO with $1.7 billion fraud involving bitcoin</a>. Press release 8549-22. <a class="ref-back" href="#cite-44" aria-label="Back to the text">↩</a></li> <li id="ref-45">U.S. Securities and Exchange Commission (2026). <a href="https://www.sec.gov/files/litigation/complaints/2026/comp-pr2026-110.pdf">Complaint, SEC v. BG Wealth Sharing Ltd. and DSJ Exchange Pty Ltd.</a>. U.S. District Court, Northern District of California, filed 29 October 2026. <a class="ref-back" href="#cite-46" aria-label="Back to the text">↩</a></li> <li id="ref-46">FBI Internet Crime Complaint Center (2026). <a href="https://www.ic3.gov/AnnualReport/Reports/2025_IC3Report.pdf">Internet crime report 2025</a>. <a class="ref-back" href="#cite-47" aria-label="Back to the text">↩</a></li> <li id="ref-47">Chainalysis (2026). <a href="https://www.chainalysis.com/blog/crypto-scams-2026/">2026 crypto crime report: scams</a>. <a class="ref-back" href="#cite-48" aria-label="Back to the text">↩</a></li> <li id="ref-48">Financial Conduct Authority (2026). <a href="https://www.fca.org.uk/news/press-releases/young-investors-trust-ai-more-tv-or-celebrities">Young investors trust AI more than TV or celebrities</a>. Press release. <a class="ref-back" href="#cite-49" aria-label="Back to the text">↩</a></li> <li id="ref-49">Schmeling, M., Schrimpf, A., &amp; Todorov, K. (2023). <a href="https://www.bis.org/publ/work1087.htm">Crypto carry</a>. BIS Working Papers, 1087. <a class="ref-back" href="#cite-50" aria-label="Back to the text">↩</a></li> <li id="ref-50">CoinGlass (2026). <a href="https://www.coinglass.com/learn/2025-annual-report-en">CoinGlass 2025 crypto derivatives market annual report</a>. <a class="ref-back" href="#cite-51" aria-label="Back to the text">↩</a></li> <li id="ref-51">Chitra, T. (2025). <a href="https://arxiv.org/abs/2512.01112">Autodeleveraging: impossibilities and optimization</a>. arXiv. <a class="ref-back" href="#cite-52" aria-label="Back to the text">↩</a></li> <li id="ref-52">Jaquart, P., Dann, D., &amp; Weinhardt, C. (2021). <a href="https://doi.org/10.1016/j.jfds.2021.03.001">Short-term bitcoin market prediction via machine learning</a>. <em>Journal of Finance and Data Science</em>, 7, 45–66. <a class="ref-back" href="#cite-53" aria-label="Back to the text">↩</a></li> <li id="ref-53">Bysik, A., &amp; Ślepaczuk, R. (2026). <a href="https://arxiv.org/abs/2606.00060">Machine learning-based bitcoin trading under transaction costs: evidence from walk-forward forecasting</a>. arXiv. <a class="ref-back" href="#cite-54" aria-label="Back to the text">↩</a></li> <li id="ref-54">Bank of England (2025). <a href="https://www.bankofengland.co.uk/financial-stability-in-focus/2025/april-2025">Financial stability in focus: artificial intelligence in the financial system</a>. <a class="ref-back" href="#cite-55" aria-label="Back to the text">↩</a></li> </ol>]]></content> <author> <name>Eva Koroleva</name> </author> <category term="crypto"/> <category term="machine-learning"/> <category term="finance"/> <category term="cybersecurity"/> <category term="machine-learning"/> <category term="llm"/> <category term="crypto"/> <category term="trading"/> <category term="ai-agents"/> <summary type="html"><![CDATA[AI trading bots and LLM agents tested on six years of Binance data: what machine learning predicts, what trading fees eat, and why LLM backtests lie]]></summary> <media:thumbnail url="https://blog.korolevalab.com/assets/posts/ai-crypto-trading/cover.png"/> <media:content medium="image" url="https://blog.korolevalab.com/assets/posts/ai-crypto-trading/cover.png"/> </entry> <entry> <title type="html">Beyond attention with Mamba, state space models and hybrids</title> <link href="https://blog.korolevalab.com/blog/2026/transformer-architectures-10-mamba/" rel="alternate" type="text/html" title="Beyond attention with Mamba, state space models and hybrids"/> <published>2026-10-19T19:00:00+00:00</published> <updated>2026-11-10T00:00:00+00:00</updated> <id>https://blog.korolevalab.com/blog/2026/transformer-architectures-10-mamba</id> <content type="html" xml:base="https://blog.korolevalab.com/blog/2026/transformer-architectures-10-mamba/"><![CDATA[<p class="tfs-links"><strong>Transformer architectures: from BERT to diffusion</strong> · lesson 10 of 15 · <a href="/teaching/">all lessons</a> · <a href="https://www.kaggle.com/code/qmarva/transformer-architectures-10-mamba-and-hybrids">run on Kaggle</a> · <a href="https://colab.research.google.com/github/xmarva/transformers-from-scratch/blob/main/notebooks/colab/a10_mamba.ipynb">open in Colab</a> · <a href="https://github.com/xmarva/transformers-from-scratch">code on GitHub</a></p> <p>Everything this course has built so far pays the same bill. Attention keeps every token it has read, in every layer, for as long as the conversation lasts (<a href="/blog/2026/transformer-architectures-08-kv/">lesson 8</a>), and compares every new token with all of them (<a href="/blog/2026/transformer-architectures-09-long/">lesson 9</a>).</p> <p>The bill grows with the text, and all the tricks of the last three lessons only make it grow more slowly.</p> <p>A recurrent network doesn’t pay it. It reads a token, updates a state of fixed size, and forgets the token; the millionth token costs what the first one did. The trouble is that recurrent networks lost to Transformers for good reasons: they train one token at a time, and their state forgets what matters as easily as what doesn’t.</p> <p>In December 2023 Albert Gu and Tri Dao, the same Tri Dao who wrote <a href="/blog/2026/transformers-from-scratch-05-llama/">FlashAttention</a>, published <em>Mamba</em>, a recurrent model that fixes both. It trains in parallel, like a Transformer, and its state decides, token by token, what to keep and what to let go.</p> <p>The idea comes from an unexpected place, the <em>state space models</em> of control theory, the language of the Kalman filter that helped navigate Apollo to the Moon.</p> <p>This lesson takes Mamba apart on the real weights of mamba-130m: the equation it starts from, how a continuous equation becomes a layer, what the model chooses to remember in a real sentence, the scan that makes a recurrence parallel, and generation with a state that never grows.</p> <p>Then we look at what a fixed state costs, where Mamba ends up inside today’s hybrid models, and train two small ones from scratch to see what selectivity buys.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/10/hero-light.png" width="760" alt="The same eight tokens read by attention and by Mamba. Attention keeps a key and a value for every token, so its cache grows by one slot per token and never shrinks. Mamba writes every token into one state of fixed size, 1,536 channels of 16 numbers per layer in mamba-130m, and the state is the same size after eight tokens or eight million" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/10/hero-dark.png" width="760" alt="The same eight tokens read by attention and by Mamba. Attention keeps a key and a value for every token, so its cache grows by one slot per token and never shrinks. Mamba writes every token into one state of fixed size, 1,536 channels of 16 numbers per layer in mamba-130m, and the state is the same size after eight tokens or eight million" loading="lazy"></p> <p><strong>What you’ll do</strong></p> <ol> <li>Write a state space model from its differential equation and turn it into a layer with exact and approximate discretisation.</li> <li>Make it selective, as Mamba does, and write the whole Mamba block from scratch; load mamba-130m into it and match Hugging Face.</li> <li>Watch what the trained model writes into its state and how long each of its channels remembers.</li> <li>Write the scan twice, as a loop and as a parallel scan, and generate text with a state of fixed size, measured against a Transformer’s growing cache.</li> </ol> <h2 id="setup">Setup</h2> <p>One small helper package, <code class="language-plaintext highlighter-rouge">tfs</code>, draws the course’s plots and token chips and knows where the notebook runs (Kaggle, Colab or your own machine). Everything the lesson teaches is written out in the notebook itself.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">importlib.util</span>
<span class="kn">import</span> <span class="n">subprocess</span>
<span class="kn">import</span> <span class="n">sys</span>

<span class="n">TFS</span> <span class="o">=</span> <span class="sh">"</span><span class="s">git+https://github.com/xmarva/transformers-from-scratch@main</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">importlib</span><span class="p">.</span><span class="n">util</span><span class="p">.</span><span class="nf">find_spec</span><span class="p">(</span><span class="sh">"</span><span class="s">tfs</span><span class="sh">"</span><span class="p">)</span> <span class="ow">is</span> <span class="bp">None</span><span class="p">:</span>
    <span class="n">subprocess</span><span class="p">.</span><span class="nf">check_call</span><span class="p">([</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">-m</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">pip</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">install</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-q</span><span class="sh">"</span><span class="p">,</span> <span class="n">TFS</span><span class="p">])</span>

<span class="kn">from</span> <span class="n">tfs</span> <span class="kn">import</span> <span class="n">env</span>
<span class="kn">from</span> <span class="n">tfs.viz</span> <span class="kn">import</span> <span class="n">table</span><span class="p">,</span> <span class="n">token_chips</span><span class="p">,</span> <span class="n">use_course_style</span>

<span class="n">env</span><span class="p">.</span><span class="nf">quiet</span><span class="p">()</span>  <span class="c1"># no progress bars or environment warnings in the outputs
</span><span class="n">SEED</span> <span class="o">=</span> <span class="mi">42</span>
<span class="n">env</span><span class="p">.</span><span class="nf">seed_everything</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">COLORS</span> <span class="o">=</span> <span class="nf">use_course_style</span><span class="p">()</span>
<span class="n">WORK_DIR</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">work_dir</span><span class="p">()</span>
</code></pre></div></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">json</span>
<span class="kn">import</span> <span class="n">math</span>
<span class="kn">import</span> <span class="n">time</span>

<span class="kn">import</span> <span class="n">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>
<span class="kn">from</span> <span class="n">matplotlib.colors</span> <span class="kn">import</span> <span class="n">LinearSegmentedColormap</span>
<span class="kn">import</span> <span class="n">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="n">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">import</span> <span class="n">torch</span>
<span class="kn">import</span> <span class="n">torch.nn</span> <span class="k">as</span> <span class="n">nn</span>
<span class="kn">import</span> <span class="n">torch.nn.functional</span> <span class="k">as</span> <span class="n">F</span>
<span class="kn">from</span> <span class="n">huggingface_hub</span> <span class="kn">import</span> <span class="n">hf_hub_download</span>
<span class="kn">from</span> <span class="n">safetensors.torch</span> <span class="kn">import</span> <span class="n">load_file</span>
<span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">AutoTokenizer</span>

<span class="n">SMOKE</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">smoke</span><span class="p">()</span>  <span class="c1"># CI runs the lesson on a small slice; you run it in full
</span><span class="n">device</span> <span class="o">=</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">if</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">is_available</span><span class="p">()</span> <span class="k">else</span> <span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">GPU:</span><span class="sh">"</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">get_device_name</span><span class="p">(</span><span class="mi">0</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>GPU: Tesla T4</code></pre> <h2 id="1-a-state-that-doesnt-grow">1. A state that doesn’t grow</h2> <p>A <em>state space model</em> describes a system by a vector of numbers, its state \(h(t) \in \mathbb{R}^N\), that changes over time under an input \(x(t)\) and produces an output \(y(t)\):</p> \[h'(t) = A\,h(t) + B\,x(t), \qquad y(t) = C\,h(t).\] <p>The first equation says how the state moves: \(A\) (\(N \times N\)) is how it would drift on its own, \(B\) (\(N \times 1\)) is how the input pushes it.</p> <p>The second says what we read out of it. Rudolf Kálmán made this form the language of control theory in 1960, and it has run in autopilots, phone receivers and spacecraft since.</p> <p>For a sequence model the useful case is a diagonal \(A\) with negative entries \(a_1, \dots, a_N\). The equations then split into \(N\) independent ones, and each is a <em>leaky integrator</em>:</p> \[h_n'(t) = a_n\,h_n(t) + b_n\,x(t).\] <p>Picture a bucket with a hole. The input pours water in; the hole lets a fraction \(\lvert a_n \rvert\) of whatever is inside leak out per unit of time. Without input, the level falls as \(e^{a_n t}\): a bucket with a small hole, \(a_n\) near zero, keeps its water for a long time; one with a big hole forgets in an instant. A state of \(N\) buckets with holes of different sizes keeps a record of the input at \(N\) different time scales, recent and distant, and \(C\) mixes the levels into an output.</p> <p>Here are four such buckets, fed one splash of input at \(t = 1\) and a steady stream between \(t = 4\) and \(6\); the curves are the exact solution of each equation.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">t</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">linspace</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">10</span><span class="p">,</span> <span class="mi">1001</span><span class="p">)</span>
<span class="n">splash</span> <span class="o">=</span> <span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">abs</span><span class="p">(</span><span class="n">t</span> <span class="o">-</span> <span class="mi">1</span><span class="p">)</span> <span class="o">&lt;</span> <span class="mf">0.05</span><span class="p">)</span> <span class="o">*</span> <span class="mf">10.0</span>  <span class="c1"># a short burst whose total is 1
</span><span class="n">stream</span> <span class="o">=</span> <span class="p">((</span><span class="n">t</span> <span class="o">&gt;</span> <span class="mi">4</span><span class="p">)</span> <span class="o">&amp;</span> <span class="p">(</span><span class="n">t</span> <span class="o">&lt;</span> <span class="mi">6</span><span class="p">))</span> <span class="o">*</span> <span class="mf">1.0</span>
<span class="n">dt</span> <span class="o">=</span> <span class="n">t</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span> <span class="o">-</span> <span class="n">t</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">7.4</span><span class="p">,</span> <span class="mf">3.4</span><span class="p">))</span>
<span class="n">colors</span> <span class="o">=</span> <span class="p">[</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">data</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">]]</span>
<span class="k">for</span> <span class="n">a</span><span class="p">,</span> <span class="n">color</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">([</span><span class="o">-</span><span class="mf">0.125</span><span class="p">,</span> <span class="o">-</span><span class="mf">0.25</span><span class="p">,</span> <span class="o">-</span><span class="mf">0.5</span><span class="p">,</span> <span class="o">-</span><span class="mf">1.0</span><span class="p">],</span> <span class="n">colors</span><span class="p">):</span>  <span class="c1"># four holes, small to large
</span>    <span class="n">level</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">zeros_like</span><span class="p">(</span><span class="n">t</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">t</span><span class="p">)):</span>  <span class="c1"># exact step of h' = a h + x for constant x over dt
</span>        <span class="n">x</span> <span class="o">=</span> <span class="n">splash</span><span class="p">[</span><span class="n">i</span> <span class="o">-</span> <span class="mi">1</span><span class="p">]</span> <span class="o">+</span> <span class="n">stream</span><span class="p">[</span><span class="n">i</span> <span class="o">-</span> <span class="mi">1</span><span class="p">]</span>
        <span class="n">level</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="o">=</span> <span class="n">level</span><span class="p">[</span><span class="n">i</span> <span class="o">-</span> <span class="mi">1</span><span class="p">]</span> <span class="o">*</span> <span class="n">math</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">a</span> <span class="o">*</span> <span class="n">dt</span><span class="p">)</span> <span class="o">+</span> <span class="p">(</span><span class="n">math</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">a</span> <span class="o">*</span> <span class="n">dt</span><span class="p">)</span> <span class="o">-</span> <span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">a</span> <span class="o">*</span> <span class="n">x</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">t</span><span class="p">,</span> <span class="n">level</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="sa">f</span><span class="sh">"</span><span class="s">a = </span><span class="si">{</span><span class="n">a</span><span class="si">:</span><span class="n">g</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">fill_between</span><span class="p">(</span><span class="n">t</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="n">stream</span> <span class="o">*</span> <span class="mf">0.15</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">],</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.4</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">input</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">time</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">state</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">Four leaky buckets: the same input, four memories</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">9</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/10/output-01.png" alt="Four leaky buckets: the same input, four memories" loading="lazy"></p> <p>The bucket with the smallest hole still remembers the splash when the stream arrives; the one with the largest has forgotten it within a unit of time and tracks only the present. That spread of memories is what a state space layer is made of.</p> <h2 id="2-from-an-equation-to-a-layer">2. From an equation to a layer</h2> <p>Text doesn’t arrive in continuous time; it arrives a token at a time. To turn the equation into a layer, assume the input stays constant for a short time \(\Delta\), the <em>step</em>, and solve the equation exactly over that time. This is the <em>zero-order hold</em> of signal processing, and for a diagonal \(A\) it gives, per channel,</p> \[h_t = \bar a\, h_{t-1} + \bar b\, x_t,\] <p>where</p> \[\bar a = e^{\Delta a}, \qquad \bar b = \frac{e^{\Delta a} - 1}{a}\, b.\] <p>\(\bar a\) is the fraction of the state that survives one step: between 0 and 1, because \(a &lt; 0\). The state space model has become a linear recurrence, an RNN without a nonlinearity inside the loop. That missing nonlinearity is what will make it parallel in section 6.</p> <p>Mamba’s code takes a shortcut for \(\bar b\). For small \(\Delta a\), \(e^{\Delta a} - 1 \approx \Delta a\), so \(\bar b \approx \Delta\, b\), the Euler step. Is that a big approximation? The ratio of the two is \((e^{\Delta a} - 1)/(\Delta a)\), which depends only on the product \(\Delta a\):</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">for</span> <span class="n">product</span> <span class="ow">in</span> <span class="p">[</span><span class="mf">0.001</span><span class="p">,</span> <span class="mf">0.01</span><span class="p">,</span> <span class="mf">0.1</span><span class="p">,</span> <span class="mf">0.5</span><span class="p">,</span> <span class="mf">1.0</span><span class="p">,</span> <span class="mf">2.0</span><span class="p">,</span> <span class="mf">5.0</span><span class="p">]:</span>
    <span class="n">exact_over_euler</span> <span class="o">=</span> <span class="p">(</span><span class="mi">1</span> <span class="o">-</span> <span class="n">math</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="o">-</span><span class="n">product</span><span class="p">))</span> <span class="o">/</span> <span class="n">product</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">|Δa| = </span><span class="si">{</span><span class="n">product</span><span class="si">:</span><span class="o">&lt;</span><span class="mi">5</span><span class="si">}</span><span class="s">  exact b̄ / Euler b̄ = </span><span class="si">{</span><span class="n">exact_over_euler</span><span class="si">:</span><span class="p">.</span><span class="mi">3</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>|Δa| = 0.001  exact b̄ / Euler b̄ = 1.000
|Δa| = 0.01   exact b̄ / Euler b̄ = 0.995
|Δa| = 0.1    exact b̄ / Euler b̄ = 0.952
|Δa| = 0.5    exact b̄ / Euler b̄ = 0.787
|Δa| = 1.0    exact b̄ / Euler b̄ = 0.632
|Δa| = 2.0    exact b̄ / Euler b̄ = 0.432
|Δa| = 5.0    exact b̄ / Euler b̄ = 0.199</code></pre> <p>For a step that is small against the channel’s time scale, the two agree; for a large one the Euler step overestimates the input’s weight. We’ll measure in section 5 which regime the trained model lives in.</p> <p>A model with fixed \(A\), \(B\), \(C\) and \(\Delta\) is <em>linear and time-invariant</em>: whatever the token, it is treated the same way.</p> <p>S4, the 2021 model by Gu, Goel and Ré that started this line of work, was of this kind, and it could exploit that: a time-invariant recurrence is a convolution with a fixed kernel, and long convolutions are fast with the FFT.</p> <p>S4 set records on the Long Range Arena, a benchmark of sequences up to 16k long, where the Transformers of its time did badly. On language it lagged behind. The reason is visible in the bucket picture: a fixed hole leaks the important word and the filler word at the same rate.</p> <h2 id="3-selectivity">3. Selectivity</h2> <p>Mamba’s change is one sentence long: make \(\Delta\), \(B\) and \(C\) functions of the current token. Each token then decides, through its own \(\Delta_t\), how much of the state to keep and how much of itself to write:</p> \[h_t = e^{\Delta_t a}\, h_{t-1} + \Delta_t\, b_t\, x_t, \qquad y_t = c_t^{\top} h_t.\] <p>The step \(\Delta_t\) works as a gate. A large \(\Delta_t\) drives \(e^{\Delta_t a}\) toward 0 and multiplies the token’s input: the state is reset and the token is written in. A \(\Delta_t\) near zero keeps the state as it was and lets the token pass without trace.</p> <p>Gu and Dao call this <em>selectivity</em>, and they show its point on a toy task, <em>selective copying</em>: remember the coloured tokens scattered among noise tokens and reproduce them at the end.</p> <p>A time-invariant model can’t do it, because it can’t tell a coloured token from noise; a selective one can, because noise tokens get a \(\Delta\) near zero. Section 11 trains both kinds and checks.</p> <p>Selectivity has a price: the recurrence is no longer a fixed convolution, so the FFT trick of S4 is gone. Mamba pays it with a scan, section 6, and with a GPU kernel written for it.</p> <h2 id="4-the-mamba-block">4. The Mamba block</h2> <p>The selective state space model is the core of a block that also contains a short convolution and a gate. One block, for a sequence of \(L\) vectors of width \(D\):</p> <ol> <li><code class="language-plaintext highlighter-rouge">in_proj</code> widens each vector to \(2E\), with \(E = 2D\), and splits it into a stream \(u\) and a gate \(z\).</li> <li><code class="language-plaintext highlighter-rouge">conv1d</code> mixes each channel of \(u\) with its three predecessors, a causal convolution of width 4, then SiLU. It gives the state space model a little local context to compute its \(\Delta\), \(B\), \(C\) from.</li> <li><code class="language-plaintext highlighter-rouge">x_proj</code> maps each \(u_t\) to a low-rank seed of \(\Delta_t\) (rank \(R\)), and to \(b_t\) and \(c_t\), \(N\) numbers each, shared by all \(E\) channels.</li> <li><code class="language-plaintext highlighter-rouge">dt_proj</code> expands the seed to one step per channel, and a softplus keeps the steps positive.</li> <li>The selective scan runs \(E\) independent channels, each with a state of \(N\) numbers, and adds a skip \(D \odot u\).</li> <li>The output is multiplied by \(\mathrm{SiLU}(z)\), the gate, and <code class="language-plaintext highlighter-rouge">out_proj</code> narrows it back to \(D\).</li> </ol> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/10/block-light.png" width="760" alt="The Mamba block of mamba-130m with the shape of every tensor for L tokens. The input, L × 768, is widened by in_proj to L × 3,072 and split into a stream u and a gate z, L × 1,536 each. The stream goes through a causal convolution of width 4 and SiLU. x_proj turns it into a step seed of 48 numbers and B and C, 16 numbers each, per token; dt_proj and softplus give a step Δ for each of the 1,536 channels. The selective scan runs 1,536 channels with a state of 16 each, using A (1,536 × 16) and the skip D. Its output is multiplied by SiLU of the gate and out_proj narrows it back to L × 768" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/10/block-dark.png" width="760" alt="The Mamba block of mamba-130m with the shape of every tensor for L tokens. The input, L × 768, is widened by in_proj to L × 3,072 and split into a stream u and a gate z, L × 1,536 each. The stream goes through a causal convolution of width 4 and SiLU. x_proj turns it into a step seed of 48 numbers and B and C, 16 numbers each, per token; dt_proj and softplus give a step Δ for each of the 1,536 channels. The selective scan runs 1,536 channels with a state of 16 each, using A (1,536 × 16) and the skip D. Its output is multiplied by SiLU of the gate and out_proj narrows it back to L × 768" loading="lazy"></p> <p>The matrix \(A\) is stored as <code class="language-plaintext highlighter-rouge">A_log</code>, \(a = -e^{A_{\log}}\), which keeps every entry negative whatever the training does. Mamba-130m has \(D = 768\), \(E = 1{,}536\), \(N = 16\), \(R = 48\) and 24 such blocks with no attention and no MLP between them: the block is the whole layer.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">REPO</span> <span class="o">=</span> <span class="sh">"</span><span class="s">state-spaces/mamba-130m-hf</span><span class="sh">"</span>
<span class="n">mamba_config</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">REPO</span><span class="p">,</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">)))</span>
<span class="k">for</span> <span class="n">key</span> <span class="ow">in</span> <span class="p">[</span>
    <span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">state_size</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">time_step_rank</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">conv_kernel</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">,</span>
<span class="p">]:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">key</span><span class="si">:</span><span class="mi">18</span><span class="si">}</span><span class="s"> </span><span class="si">{</span><span class="n">mamba_config</span><span class="p">[</span><span class="n">key</span><span class="p">]</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>hidden_size        768
intermediate_size  1536
state_size         16
time_step_rank     48
conv_kernel        4
num_hidden_layers  24
vocab_size         50280</code></pre> <p>Two scans will be written in section 6; <code class="language-plaintext highlighter-rouge">Mixer</code> takes one as an argument. The loop is the definition: run the recurrence one step at a time, for all channels and all \(N\) state numbers at once.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">scan_loop</span><span class="p">(</span><span class="n">decay</span><span class="p">,</span> <span class="n">write</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
    <span class="c1"># decay, write: (batch, channels, L, N); c: (batch, L, N) -&gt; y: (batch, channels, L)
</span>    <span class="n">h</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">decay</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="n">decay</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="n">decay</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">3</span><span class="p">],</span> <span class="n">device</span><span class="o">=</span><span class="n">decay</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
    <span class="n">ys</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">decay</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">2</span><span class="p">]):</span>
        <span class="n">h</span> <span class="o">=</span> <span class="n">decay</span><span class="p">[:,</span> <span class="p">:,</span> <span class="n">t</span><span class="p">]</span> <span class="o">*</span> <span class="n">h</span> <span class="o">+</span> <span class="n">write</span><span class="p">[:,</span> <span class="p">:,</span> <span class="n">t</span><span class="p">]</span>
        <span class="n">ys</span><span class="p">.</span><span class="nf">append</span><span class="p">((</span><span class="n">h</span> <span class="o">*</span> <span class="n">c</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="n">t</span><span class="p">]).</span><span class="nf">sum</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">))</span>
    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">(</span><span class="n">ys</span><span class="p">,</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>


<span class="k">class</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">size</span><span class="p">,</span> <span class="n">eps</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">weight</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">size</span><span class="p">))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">eps</span> <span class="o">=</span> <span class="n">eps</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">x32</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="nf">float</span><span class="p">()</span>
        <span class="n">x32</span> <span class="o">=</span> <span class="n">x32</span> <span class="o">*</span> <span class="n">torch</span><span class="p">.</span><span class="nf">rsqrt</span><span class="p">(</span><span class="n">x32</span><span class="p">.</span><span class="nf">pow</span><span class="p">(</span><span class="mi">2</span><span class="p">).</span><span class="nf">mean</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">eps</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="n">weight</span> <span class="o">*</span> <span class="n">x32</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span>
</code></pre></div></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">Mixer</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span><span class="p">,</span> <span class="n">e</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">n</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">rank</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">state_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">time_step_rank</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">k</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">conv_kernel</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">in_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">e</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">use_bias</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">conv1d</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Conv1d</span><span class="p">(</span><span class="n">e</span><span class="p">,</span> <span class="n">e</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">groups</span><span class="o">=</span><span class="n">e</span><span class="p">,</span> <span class="n">padding</span><span class="o">=</span><span class="n">k</span> <span class="o">-</span> <span class="mi">1</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">use_conv_bias</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">x_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">e</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">rank</span> <span class="o">+</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">n</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">dt_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">rank</span><span class="p">,</span> <span class="n">e</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">A_log</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">e</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">n</span><span class="p">))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">D</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">e</span><span class="p">))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">out_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">e</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">use_bias</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">scan</span> <span class="o">=</span> <span class="n">scan_loop</span>
        <span class="n">self</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="bp">False</span>  <span class="c1"># section 5 reads the steps
</span>        <span class="n">self</span><span class="p">.</span><span class="n">steps</span> <span class="o">=</span> <span class="bp">None</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">L</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>
        <span class="n">u</span><span class="p">,</span> <span class="n">gate</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">in_proj</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">).</span><span class="nf">chunk</span><span class="p">(</span><span class="mi">2</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>  <span class="c1"># (batch, E, L) each
</span>        <span class="n">u</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">silu</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">conv1d</span><span class="p">(</span><span class="n">u</span><span class="p">)[...,</span> <span class="p">:</span><span class="n">L</span><span class="p">])</span>
        <span class="n">seed</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">x_proj</span><span class="p">(</span><span class="n">u</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)).</span><span class="nf">split</span><span class="p">(</span>
            <span class="p">[</span><span class="n">self</span><span class="p">.</span><span class="n">rank</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">n</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">n</span><span class="p">],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span>
        <span class="p">)</span>
        <span class="n">step</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">softplus</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">dt_proj</span><span class="p">(</span><span class="n">seed</span><span class="p">)).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>  <span class="c1"># (batch, E, L)
</span>        <span class="k">if</span> <span class="n">self</span><span class="p">.</span><span class="n">keep</span><span class="p">:</span>
            <span class="n">self</span><span class="p">.</span><span class="n">steps</span> <span class="o">=</span> <span class="n">step</span><span class="p">.</span><span class="nf">detach</span><span class="p">()</span>
        <span class="n">a</span> <span class="o">=</span> <span class="o">-</span><span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">A_log</span><span class="p">.</span><span class="nf">float</span><span class="p">())</span>  <span class="c1"># (E, N), every entry negative
</span>        <span class="n">decay</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">step</span><span class="p">[...,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="n">a</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:])</span>  <span class="c1"># (batch, E, L, N)
</span>        <span class="n">write</span> <span class="o">=</span> <span class="n">step</span><span class="p">[...,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="n">b</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">].</span><span class="nf">float</span><span class="p">()</span> <span class="o">*</span> <span class="n">u</span><span class="p">[...,</span> <span class="bp">None</span><span class="p">].</span><span class="nf">float</span><span class="p">()</span>
        <span class="n">y</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">scan</span><span class="p">(</span><span class="n">decay</span><span class="p">,</span> <span class="n">write</span><span class="p">,</span> <span class="n">c</span><span class="p">.</span><span class="nf">float</span><span class="p">()).</span><span class="nf">to</span><span class="p">(</span><span class="n">u</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span>
        <span class="n">y</span> <span class="o">=</span> <span class="n">y</span> <span class="o">+</span> <span class="n">u</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">D</span><span class="p">[</span><span class="bp">None</span><span class="p">,</span> <span class="p">:,</span> <span class="bp">None</span><span class="p">]</span>
        <span class="n">y</span> <span class="o">=</span> <span class="n">y</span> <span class="o">*</span> <span class="n">F</span><span class="p">.</span><span class="nf">silu</span><span class="p">(</span><span class="n">gate</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">out_proj</span><span class="p">(</span><span class="n">y</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">))</span>
</code></pre></div></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">Block</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">layer_norm_epsilon</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">mixer</span> <span class="o">=</span> <span class="nc">Mixer</span><span class="p">(</span><span class="n">c</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">mixer</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">norm</span><span class="p">(</span><span class="n">x</span><span class="p">))</span>


<span class="k">class</span> <span class="nc">Mamba</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">embeddings</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">layers</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">ModuleList</span><span class="p">([</span><span class="nc">Block</span><span class="p">(</span><span class="n">c</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">])])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm_f</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">layer_norm_epsilon</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">lm_head</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">):</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">embeddings</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span>
        <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">self</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
            <span class="n">x</span> <span class="o">=</span> <span class="nf">layer</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">lm_head</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">norm_f</span><span class="p">(</span><span class="n">x</span><span class="p">)).</span><span class="nf">float</span><span class="p">()</span>
</code></pre></div></div> <p>Where do the parameters of a block go? Counted from the class:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">block</span> <span class="o">=</span> <span class="nc">Block</span><span class="p">(</span><span class="n">mamba_config</span><span class="p">)</span>
<span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">block</span><span class="p">.</span><span class="n">mixer</span><span class="p">.</span><span class="nf">named_parameters</span><span class="p">():</span>
    <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
        <span class="p">{</span>
            <span class="sh">"</span><span class="s">part</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">shape</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s"> × </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="nf">str</span><span class="p">(</span><span class="n">s</span><span class="p">)</span> <span class="k">for</span> <span class="n">s</span> <span class="ow">in</span> <span class="n">p</span><span class="p">.</span><span class="n">shape</span><span class="p">),</span>
            <span class="sh">"</span><span class="s">parameters</span><span class="sh">"</span><span class="p">:</span> <span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">(),</span>
        <span class="p">}</span>
    <span class="p">)</span>
<span class="n">parts</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">)</span>
<span class="n">parts</span><span class="p">[</span><span class="sh">"</span><span class="s">share</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">parts</span><span class="p">.</span><span class="n">parameters</span> <span class="o">/</span> <span class="n">parts</span><span class="p">.</span><span class="n">parameters</span><span class="p">.</span><span class="nf">sum</span><span class="p">()</span>
<span class="nf">table</span><span class="p">(</span><span class="n">parts</span><span class="p">,</span> <span class="n">digits</span><span class="o">=</span><span class="mi">3</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">part</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">shape</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">parameters</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">share</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">A_log</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">1536 × 16</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">24,576</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.007</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">D</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">1536</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,536</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.000</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">in_proj.weight</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">3072 × 768</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,359,296</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.626</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">conv1d.weight</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">1536 × 1 × 4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6,144</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.002</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">conv1d.bias</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">1536</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,536</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.000</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">x_proj.weight</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">80 × 1536</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">122,880</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.033</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">dt_proj.weight</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">1536 × 48</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">73,728</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.020</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">dt_proj.bias</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">1536</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,536</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.000</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">out_proj.weight</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">768 × 1536</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,179,648</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.313</td></tr></tbody></table></div> <p>The two projections, in and out, hold almost all of it, as the two matrices of an MLP do in a Transformer. The state space model itself, \(A\), \(D\), the convolution and the step’s projections, is a small fraction: Mamba’s work is done by a few thousand numbers per channel acting over time.</p> <p>Now the weights. The library’s model runs in the same process here, because at 130 million parameters two copies fit anywhere; the smoke run uses a small random model of the same class.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">MambaConfig</span><span class="p">,</span> <span class="n">MambaForCausalLM</span>

<span class="k">if</span> <span class="n">SMOKE</span><span class="p">:</span>
    <span class="n">small</span> <span class="o">=</span> <span class="nc">MambaConfig</span><span class="p">(</span>
        <span class="n">vocab_size</span><span class="o">=</span><span class="n">mamba_config</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span>
        <span class="n">hidden_size</span><span class="o">=</span><span class="mi">64</span><span class="p">,</span>
        <span class="n">intermediate_size</span><span class="o">=</span><span class="mi">128</span><span class="p">,</span>
        <span class="n">state_size</span><span class="o">=</span><span class="mi">8</span><span class="p">,</span>
        <span class="n">time_step_rank</span><span class="o">=</span><span class="mi">4</span><span class="p">,</span>
        <span class="n">num_hidden_layers</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span>
    <span class="p">)</span>
    <span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="mi">0</span><span class="p">)</span>
    <span class="n">reference</span> <span class="o">=</span> <span class="nc">MambaForCausalLM</span><span class="p">(</span><span class="n">small</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
    <span class="n">mamba_config</span> <span class="o">=</span> <span class="n">small</span><span class="p">.</span><span class="nf">to_dict</span><span class="p">()</span>
    <span class="n">state</span> <span class="o">=</span> <span class="p">{</span><span class="n">k</span><span class="p">.</span><span class="nf">removeprefix</span><span class="p">(</span><span class="sh">"</span><span class="s">backbone.</span><span class="sh">"</span><span class="p">):</span> <span class="n">v</span> <span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="ow">in</span> <span class="n">reference</span><span class="p">.</span><span class="nf">state_dict</span><span class="p">().</span><span class="nf">items</span><span class="p">()}</span>
<span class="k">else</span><span class="p">:</span>
    <span class="n">reference</span> <span class="o">=</span> <span class="n">MambaForCausalLM</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">REPO</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float32</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
    <span class="n">state</span> <span class="o">=</span> <span class="nf">load_file</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">REPO</span><span class="p">,</span> <span class="sh">"</span><span class="s">model.safetensors</span><span class="sh">"</span><span class="p">))</span>
    <span class="n">state</span> <span class="o">=</span> <span class="p">{</span><span class="n">k</span><span class="p">.</span><span class="nf">removeprefix</span><span class="p">(</span><span class="sh">"</span><span class="s">backbone.</span><span class="sh">"</span><span class="p">):</span> <span class="n">v</span> <span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="ow">in</span> <span class="n">state</span><span class="p">.</span><span class="nf">items</span><span class="p">()}</span>
<span class="n">state</span><span class="p">.</span><span class="nf">setdefault</span><span class="p">(</span><span class="sh">"</span><span class="s">lm_head.weight</span><span class="sh">"</span><span class="p">,</span> <span class="n">state</span><span class="p">[</span><span class="sh">"</span><span class="s">embeddings.weight</span><span class="sh">"</span><span class="p">])</span>  <span class="c1"># tied to the embeddings
</span><span class="n">mamba</span> <span class="o">=</span> <span class="nc">Mamba</span><span class="p">(</span><span class="n">mamba_config</span><span class="p">)</span>
<span class="n">mamba</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">(</span><span class="n">state</span><span class="p">,</span> <span class="n">strict</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">mamba</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>

<span class="n">tok</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">REPO</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">tokens_of</span><span class="p">(</span><span class="n">ids</span><span class="p">):</span>
    <span class="k">return</span> <span class="p">[</span><span class="n">tok</span><span class="p">.</span><span class="nf">decode</span><span class="p">([</span><span class="n">i</span><span class="p">])</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">ids</span><span class="p">[</span><span class="mi">0</span><span class="p">]]</span>


<span class="n">sentence</span> <span class="o">=</span> <span class="p">(</span>
    <span class="sh">"</span><span class="s">In December 1911 Roald Amundsen reached the South Pole with four men and fifty-two </span><span class="sh">"</span>
    <span class="sh">"</span><span class="s">dogs; Robert Falcon Scott arrived thirty-four days later and found a Norwegian tent.</span><span class="sh">"</span>
<span class="p">)</span>
<span class="n">ids</span> <span class="o">=</span> <span class="nf">tok</span><span class="p">(</span><span class="n">sentence</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="n">input_ids</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">theirs</span> <span class="o">=</span> <span class="nf">reference</span><span class="p">(</span><span class="n">ids</span><span class="p">).</span><span class="n">logits</span>
    <span class="n">ours</span> <span class="o">=</span> <span class="nf">mamba</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">tokens:</span><span class="sh">"</span><span class="p">,</span> <span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">])</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">largest logit:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">theirs</span><span class="p">.</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">max difference from Hugging Face:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="n">ours</span> <span class="o">-</span> <span class="n">theirs</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>tokens: 37
largest logit: 95.9
max difference from Hugging Face: 1.9e-04</code></pre> <p>Our loop and the library’s agree to the rounding of 32-bit floats accumulated over 24 layers. Every Mamba block is now ours to open.</p> <h3 id="one-sentence-through-one-block">One sentence through one block</h3> <p>The class hides the shapes, so here is the sentence going through the first block by hand, one stage at a time, with the shape of every tensor and a few of its numbers. Follow it with the block diagram above.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">m</span> <span class="o">=</span> <span class="n">mamba</span><span class="p">.</span><span class="n">layers</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="n">mixer</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">x</span> <span class="o">=</span> <span class="n">mamba</span><span class="p">.</span><span class="n">layers</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">norm</span><span class="p">(</span><span class="n">mamba</span><span class="p">.</span><span class="nf">embeddings</span><span class="p">(</span><span class="n">ids</span><span class="p">))</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">tokens in, normalised:          </span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">),</span> <span class="sh">"</span><span class="s">  (batch, L, D)</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">both</span> <span class="o">=</span> <span class="n">m</span><span class="p">.</span><span class="nf">in_proj</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">in_proj, channels first:        </span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">both</span><span class="p">.</span><span class="n">shape</span><span class="p">),</span> <span class="sh">"</span><span class="s">  (batch, 2E, L)</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">u</span><span class="p">,</span> <span class="n">gate</span> <span class="o">=</span> <span class="n">both</span><span class="p">.</span><span class="nf">chunk</span><span class="p">(</span><span class="mi">2</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">stream u and gate z:            </span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">u</span><span class="p">.</span><span class="n">shape</span><span class="p">),</span> <span class="sh">"</span><span class="s">each</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">L</span> <span class="o">=</span> <span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>
    <span class="n">u</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">silu</span><span class="p">(</span><span class="n">m</span><span class="p">.</span><span class="nf">conv1d</span><span class="p">(</span><span class="n">u</span><span class="p">)[...,</span> <span class="p">:</span><span class="n">L</span><span class="p">])</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">after the convolution and SiLU: </span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">u</span><span class="p">.</span><span class="n">shape</span><span class="p">))</span>
    <span class="n">seed</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span> <span class="o">=</span> <span class="n">m</span><span class="p">.</span><span class="nf">x_proj</span><span class="p">(</span><span class="n">u</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)).</span><span class="nf">split</span><span class="p">([</span><span class="n">m</span><span class="p">.</span><span class="n">rank</span><span class="p">,</span> <span class="n">m</span><span class="p">.</span><span class="n">n</span><span class="p">,</span> <span class="n">m</span><span class="p">.</span><span class="n">n</span><span class="p">],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="nf">print</span><span class="p">(</span>
        <span class="sh">"</span><span class="s">x_proj → step seed, B, C:       </span><span class="sh">"</span><span class="p">,</span>
        <span class="nf">tuple</span><span class="p">(</span><span class="n">seed</span><span class="p">.</span><span class="n">shape</span><span class="p">),</span>
        <span class="nf">tuple</span><span class="p">(</span><span class="n">b</span><span class="p">.</span><span class="n">shape</span><span class="p">),</span>
        <span class="nf">tuple</span><span class="p">(</span><span class="n">c</span><span class="p">.</span><span class="n">shape</span><span class="p">),</span>
    <span class="p">)</span>
    <span class="n">step</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">softplus</span><span class="p">(</span><span class="n">m</span><span class="p">.</span><span class="nf">dt_proj</span><span class="p">(</span><span class="n">seed</span><span class="p">)).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
    <span class="nf">print</span><span class="p">(</span>
        <span class="sh">"</span><span class="s">dt_proj, softplus → Δ:          </span><span class="sh">"</span><span class="p">,</span>
        <span class="nf">tuple</span><span class="p">(</span><span class="n">step</span><span class="p">.</span><span class="n">shape</span><span class="p">),</span>
        <span class="sh">"</span><span class="s">  one step per channel and token</span><span class="sh">"</span><span class="p">,</span>
    <span class="p">)</span>
    <span class="n">a</span> <span class="o">=</span> <span class="o">-</span><span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">m</span><span class="p">.</span><span class="n">A_log</span><span class="p">.</span><span class="nf">float</span><span class="p">())</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">A, all negative:                </span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">a</span><span class="p">.</span><span class="n">shape</span><span class="p">))</span>
    <span class="n">decay</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">step</span><span class="p">[...,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="n">a</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:])</span>
    <span class="n">write</span> <span class="o">=</span> <span class="n">step</span><span class="p">[...,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="n">b</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="n">u</span><span class="p">[...,</span> <span class="bp">None</span><span class="p">]</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">decay e^(Δa) and write ΔBu:     </span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">decay</span><span class="p">.</span><span class="n">shape</span><span class="p">),</span> <span class="sh">"</span><span class="s">  (batch, E, L, N)</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">y</span> <span class="o">=</span> <span class="nf">scan_loop</span><span class="p">(</span><span class="n">decay</span><span class="p">,</span> <span class="n">write</span><span class="p">,</span> <span class="n">c</span><span class="p">)</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">the scan, read out by C:        </span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">y</span><span class="p">.</span><span class="n">shape</span><span class="p">))</span>
    <span class="n">y</span> <span class="o">=</span> <span class="p">(</span><span class="n">y</span> <span class="o">+</span> <span class="n">u</span> <span class="o">*</span> <span class="n">m</span><span class="p">.</span><span class="n">D</span><span class="p">[</span><span class="bp">None</span><span class="p">,</span> <span class="p">:,</span> <span class="bp">None</span><span class="p">])</span> <span class="o">*</span> <span class="n">F</span><span class="p">.</span><span class="nf">silu</span><span class="p">(</span><span class="n">gate</span><span class="p">)</span>
    <span class="n">out</span> <span class="o">=</span> <span class="n">m</span><span class="p">.</span><span class="nf">out_proj</span><span class="p">(</span><span class="n">y</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">))</span>
    <span class="nf">print</span><span class="p">(</span>
        <span class="sh">"</span><span class="s">skip D, gate, out_proj:         </span><span class="sh">"</span><span class="p">,</span>
        <span class="nf">tuple</span><span class="p">(</span><span class="n">out</span><span class="p">.</span><span class="n">shape</span><span class="p">),</span>
        <span class="sh">"</span><span class="s">  back to the width of the model</span><span class="sh">"</span><span class="p">,</span>
    <span class="p">)</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">same as the block</span><span class="sh">'</span><span class="s">s own forward:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="n">out</span> <span class="o">-</span> <span class="nf">m</span><span class="p">(</span><span class="n">x</span><span class="p">)).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>

<span class="nf">print</span><span class="p">()</span>
<span class="n">word</span> <span class="o">=</span> <span class="mi">4</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">channel 0 at token </span><span class="si">{</span><span class="n">word</span><span class="si">}</span><span class="s"> (</span><span class="si">{</span><span class="nf">tokens_of</span><span class="p">(</span><span class="n">ids</span><span class="p">)[</span><span class="n">word</span><span class="p">]</span><span class="si">!r}</span><span class="s">):</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">  step Δ:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">step</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="n">word</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">  share of the state kept:</span><span class="sh">"</span><span class="p">,</span> <span class="n">end</span><span class="o">=</span><span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">v</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span> <span class="k">for</span> <span class="n">v</span> <span class="ow">in</span> <span class="n">decay</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="n">word</span><span class="p">,</span> <span class="p">:</span><span class="mi">6</span><span class="p">].</span><span class="nf">tolist</span><span class="p">()),</span> <span class="sh">"</span><span class="s">…</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>tokens in, normalised:           (1, 37, 768)   (batch, L, D)
in_proj, channels first:         (1, 3072, 37)   (batch, 2E, L)
stream u and gate z:             (1, 1536, 37) each
after the convolution and SiLU:  (1, 1536, 37)
x_proj → step seed, B, C:        (1, 37, 48) (1, 37, 16) (1, 37, 16)
dt_proj, softplus → Δ:           (1, 1536, 37)   one step per channel and token
A, all negative:                 (1536, 16)
decay e^(Δa) and write ΔBu:      (1, 1536, 37, 16)   (batch, E, L, N)
the scan, read out by C:         (1, 1536, 37)
skip D, gate, out_proj:          (1, 37, 768)   back to the width of the model
same as the block's own forward: 0.0e+00

channel 0 at token 4 ('ald'):
  step Δ: 0.4137   share of the state kept: 0.00 0.23 0.96 0.25 0.20 0.00 …</code></pre> <h2 id="5-what-the-model-writes-down">5. What the model writes down</h2> <p>For each token and each of the 1,536 channels of a layer the model chooses a step \(\Delta_t\). A useful single number per token is how much of the state it <em>replaces</em>: \(1 - e^{\Delta_t a}\), averaged over channels and state numbers.</p> <p>Zero means the token passed through without touching the state; one means the state was wiped and the token written instead.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">mamba</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
    <span class="n">layer</span><span class="p">.</span><span class="n">mixer</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="bp">True</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="nf">mamba</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span>
<span class="n">tokens</span> <span class="o">=</span> <span class="nf">tokens_of</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span>
<span class="n">replaced</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">mamba</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
    <span class="n">m</span> <span class="o">=</span> <span class="n">layer</span><span class="p">.</span><span class="n">mixer</span>
    <span class="n">a</span> <span class="o">=</span> <span class="o">-</span><span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">m</span><span class="p">.</span><span class="n">A_log</span><span class="p">.</span><span class="nf">detach</span><span class="p">().</span><span class="nf">float</span><span class="p">())</span>  <span class="c1"># (E, N)
</span>    <span class="n">kept</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">m</span><span class="p">.</span><span class="n">steps</span><span class="p">[</span><span class="mi">0</span><span class="p">][:,</span> <span class="p">:,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="n">a</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:])</span>  <span class="c1"># (E, L, N)
</span>    <span class="n">replaced</span><span class="p">.</span><span class="nf">append</span><span class="p">((</span><span class="mi">1</span> <span class="o">-</span> <span class="n">kept</span><span class="p">).</span><span class="nf">mean</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">2</span><span class="p">)))</span>
    <span class="n">m</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="bp">False</span>
<span class="n">replaced</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">(</span><span class="n">replaced</span><span class="p">)</span>  <span class="c1"># (layers, L)
</span><span class="n">relative</span> <span class="o">=</span> <span class="p">(</span>
    <span class="n">replaced</span> <span class="o">/</span> <span class="n">replaced</span><span class="p">.</span><span class="nf">mean</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="p">).</span><span class="nf">numpy</span><span class="p">()</span>  <span class="c1"># 1 = the layer's average
</span>
<span class="n">show</span> <span class="o">=</span> <span class="nf">list</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">mamba</span><span class="p">.</span><span class="n">layers</span><span class="p">),</span> <span class="nf">max</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">mamba</span><span class="p">.</span><span class="n">layers</span><span class="p">)</span> <span class="o">//</span> <span class="mi">6</span><span class="p">)))</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">9.6</span><span class="p">,</span> <span class="mf">3.0</span><span class="p">))</span>
<span class="n">shades</span> <span class="o">=</span> <span class="n">LinearSegmentedColormap</span><span class="p">.</span><span class="nf">from_list</span><span class="p">(</span><span class="sh">"</span><span class="s">shades</span><span class="sh">"</span><span class="p">,</span> <span class="p">[</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">card</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">]])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">imshow</span><span class="p">(</span><span class="n">relative</span><span class="p">[</span><span class="n">show</span><span class="p">],</span> <span class="n">cmap</span><span class="o">=</span><span class="n">shades</span><span class="p">,</span> <span class="n">aspect</span><span class="o">=</span><span class="sh">"</span><span class="s">auto</span><span class="sh">"</span><span class="p">,</span> <span class="n">vmin</span><span class="o">=</span><span class="mf">0.4</span><span class="p">,</span> <span class="n">vmax</span><span class="o">=</span><span class="mf">1.6</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xticks</span><span class="p">(</span>
    <span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">tokens</span><span class="p">)),</span> <span class="p">[</span><span class="n">s</span><span class="p">.</span><span class="nf">strip</span><span class="p">()</span> <span class="ow">or</span> <span class="sh">"</span><span class="s">␣</span><span class="sh">"</span> <span class="k">for</span> <span class="n">s</span> <span class="ow">in</span> <span class="n">tokens</span><span class="p">],</span> <span class="n">rotation</span><span class="o">=</span><span class="mi">70</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">8</span>
<span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_yticks</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">show</span><span class="p">)),</span> <span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="s">layer </span><span class="si">{</span><span class="n">i</span><span class="si">}</span><span class="sh">"</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">show</span><span class="p">])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">How much of the state each token replaces, against the layer</span><span class="sh">'</span><span class="s">s average</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>

<span class="n">middle</span> <span class="o">=</span> <span class="n">relative</span><span class="p">[</span><span class="nf">len</span><span class="p">(</span><span class="n">relative</span><span class="p">)</span> <span class="o">//</span> <span class="mi">12</span> <span class="p">:</span> <span class="nf">len</span><span class="p">(</span><span class="n">relative</span><span class="p">)</span> <span class="o">//</span> <span class="mi">2</span> <span class="o">+</span> <span class="mi">2</span><span class="p">].</span><span class="nf">mean</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>
<span class="n">order</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">argsort</span><span class="p">(</span><span class="o">-</span><span class="n">middle</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">replace most: </span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s"> · </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">tokens</span><span class="p">[</span><span class="n">i</span><span class="p">].</span><span class="nf">strip</span><span class="p">()</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">order</span><span class="p">[:</span><span class="mi">8</span><span class="p">]))</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">replace least:</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s"> · </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">tokens</span><span class="p">[</span><span class="n">i</span><span class="p">].</span><span class="nf">strip</span><span class="p">()</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">order</span><span class="p">[</span><span class="o">-</span><span class="mi">8</span><span class="p">:]))</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/10/output-02.png" alt="How much of the state each token replaces, against the layer" loading="lazy"></p> <pre class="tfs-printed"><code>replace most:  In · December · the · Robert · Ro · thirty · a · four
replace least: days · en · mun · - · ds · - · four · two</code></pre> <p>Each layer is divided by its own average, because the early layers rewrite much more of their state than the late ones, and that difference would drown everything else. What remains is a pattern you can read.</p> <p>The tokens that <em>start</em> something replace the most: the first word of the sentence, the first piece of a name, “Robert”, the month. The tokens that <em>finish</em> something replace the least: the remaining pieces of “Amundsen”, which the <a href="/blog/2026/transformers-from-scratch-01-tokenization/">tokenizer</a> cut into four, and the second half of “fifty-two” and “thirty-four”.</p> <p>Once the state holds “Ro” and “ald”, the rest of the name is predictable and there is little new to write. Nobody told the model any of this; the steps were learned from predicting the next word.</p> <p>The same steps give each channel a <em>memory horizon</em>: the number of tokens after which a channel keeps less than a third, \(e^{-1}\), of what it held. For a channel with entry \(a\) and a typical step \(\Delta\) that is \(1 / (\Delta \lvert a\rvert)\) tokens. Across all channels and state numbers of the whole model, over a page of text:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">page</span> <span class="o">=</span> <span class="nf">tok</span><span class="p">(</span>
    <span class="sh">"</span><span class="s">The expedition left the Bay of Whales on 20 October with four sledges. The weather </span><span class="sh">"</span>
    <span class="sh">"</span><span class="s">was clear, the dogs were strong, and by the end of the first week they had covered </span><span class="sh">"</span>
    <span class="sh">"</span><span class="s">more ground than Scott</span><span class="sh">'</span><span class="s">s party would in a month. Amundsen had planned the depots </span><span class="sh">"</span>
    <span class="sh">"</span><span class="s">with care: every one was marked with flags across the line of march, so that a </span><span class="sh">"</span>
    <span class="sh">"</span><span class="s">party returning in poor light could not miss it.</span><span class="sh">"</span><span class="p">,</span>
    <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">,</span>
<span class="p">).</span><span class="n">input_ids</span>
<span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">mamba</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
    <span class="n">layer</span><span class="p">.</span><span class="n">mixer</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="bp">True</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="nf">mamba</span><span class="p">(</span><span class="n">page</span><span class="p">)</span>
<span class="n">horizons</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">mamba</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
    <span class="n">m</span> <span class="o">=</span> <span class="n">layer</span><span class="p">.</span><span class="n">mixer</span>
    <span class="n">a</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">m</span><span class="p">.</span><span class="n">A_log</span><span class="p">.</span><span class="nf">detach</span><span class="p">().</span><span class="nf">float</span><span class="p">())</span>  <span class="c1"># |a|, (E, N)
</span>    <span class="n">typical_step</span> <span class="o">=</span> <span class="n">m</span><span class="p">.</span><span class="n">steps</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">median</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">).</span><span class="n">values</span>  <span class="c1"># (E,)
</span>    <span class="n">horizons</span><span class="p">.</span><span class="nf">append</span><span class="p">((</span><span class="mi">1</span> <span class="o">/</span> <span class="p">(</span><span class="n">typical_step</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="n">a</span><span class="p">)).</span><span class="nf">flatten</span><span class="p">())</span>
    <span class="n">m</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="bp">False</span>
<span class="n">horizons</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">(</span><span class="n">horizons</span><span class="p">).</span><span class="nf">clamp</span><span class="p">(</span><span class="nb">max</span><span class="o">=</span><span class="mf">1e6</span><span class="p">).</span><span class="nf">numpy</span><span class="p">()</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">7.2</span><span class="p">,</span> <span class="mf">3.2</span><span class="p">))</span>
<span class="n">bins</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">logspace</span><span class="p">(</span><span class="o">-</span><span class="mi">2</span><span class="p">,</span> <span class="mi">6</span><span class="p">,</span> <span class="mi">50</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">hist</span><span class="p">(</span><span class="n">horizons</span><span class="p">,</span> <span class="n">bins</span><span class="o">=</span><span class="n">bins</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xscale</span><span class="p">(</span><span class="sh">"</span><span class="s">log</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">memory horizon, tokens</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">channel × state pairs</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">How long the channels of mamba-130m remember</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
<span class="k">for</span> <span class="n">q</span> <span class="ow">in</span> <span class="p">[</span><span class="mf">0.1</span><span class="p">,</span> <span class="mf">0.5</span><span class="p">,</span> <span class="mf">0.9</span><span class="p">,</span> <span class="mf">0.99</span><span class="p">]:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">q</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="o">%</span><span class="si">}</span><span class="s"> of horizons are under </span><span class="si">{</span><span class="n">np</span><span class="p">.</span><span class="nf">quantile</span><span class="p">(</span><span class="n">horizons</span><span class="p">,</span> <span class="n">q</span><span class="p">)</span><span class="si">:</span><span class="p">,.</span><span class="mi">2</span><span class="n">g</span><span class="si">}</span><span class="s"> tokens</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/10/output-03.png" alt="How long the channels of mamba-130m remember" loading="lazy"></p> <pre class="tfs-printed"><code>10% of horizons are under 0.03 tokens
50% of horizons are under 1.7 tokens
90% of horizons are under 4.2e+02 tokens
99% of horizons are under 2.7e+04 tokens</code></pre> <p>Most channels forget within a few tokens: they handle the local business of syntax. A long tail keeps its content for hundreds or thousands of tokens, and those are the ones that carry a topic or a name across a page.</p> <p>The section 2 question has an answer too: for the short-memory channels \(\Delta \lvert a \rvert\) is large and the Euler step overstates the input, but those channels forget it in a token or two anyway; for the long-memory ones the product is small and the shortcut is exact for practical purposes.</p> <h2 id="6-the-scan">6. The scan</h2> <p>The loop of section 4 is correct and slow: \(L\) steps, one after the other. A Transformer processes all positions of a sequence at once, and that is half of why it won. Mamba recovers the parallelism through a property of the recurrence \(h_t = \bar a_t h_{t-1} + w_t\): it is linear, so two consecutive steps compose into one step of the same form,</p> \[(\bar a_2, w_2) \circ (\bar a_1, w_1) = (\bar a_2 \bar a_1,\; \bar a_2 w_1 + w_2),\] <p>and this composition is associative. Associative operations can be accumulated over a sequence in \(\log_2 L\) rounds instead of \(L\) steps: in round \(k\), every position combines itself with the position \(2^k\) to its left.</p> <p>After the last round every position holds the composition of everything before it. This is the Hillis–Steele scan from the parallel algorithms of the 1980s, and it needs only elementwise multiplications and additions.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">scan_parallel</span><span class="p">(</span><span class="n">decay</span><span class="p">,</span> <span class="n">write</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
    <span class="n">a</span><span class="p">,</span> <span class="n">h</span> <span class="o">=</span> <span class="n">decay</span><span class="p">,</span> <span class="n">write</span>
    <span class="n">shift</span> <span class="o">=</span> <span class="mi">1</span>
    <span class="k">while</span> <span class="n">shift</span> <span class="o">&lt;</span> <span class="n">a</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">2</span><span class="p">]:</span>
        <span class="n">a_left</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">pad</span><span class="p">(</span>
            <span class="n">a</span><span class="p">[:,</span> <span class="p">:,</span> <span class="p">:</span><span class="o">-</span><span class="n">shift</span><span class="p">],</span> <span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="n">shift</span><span class="p">,</span> <span class="mi">0</span><span class="p">),</span> <span class="n">value</span><span class="o">=</span><span class="mf">1.0</span>
        <span class="p">)</span>  <span class="c1"># identity beyond the start
</span>        <span class="n">h_left</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">pad</span><span class="p">(</span><span class="n">h</span><span class="p">[:,</span> <span class="p">:,</span> <span class="p">:</span><span class="o">-</span><span class="n">shift</span><span class="p">],</span> <span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="n">shift</span><span class="p">,</span> <span class="mi">0</span><span class="p">),</span> <span class="n">value</span><span class="o">=</span><span class="mf">0.0</span><span class="p">)</span>
        <span class="n">h</span> <span class="o">=</span> <span class="n">a</span> <span class="o">*</span> <span class="n">h_left</span> <span class="o">+</span> <span class="n">h</span>
        <span class="n">a</span> <span class="o">=</span> <span class="n">a</span> <span class="o">*</span> <span class="n">a_left</span>
        <span class="n">shift</span> <span class="o">*=</span> <span class="mi">2</span>
    <span class="nf">return </span><span class="p">(</span><span class="n">h</span> <span class="o">*</span> <span class="n">c</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">]).</span><span class="nf">sum</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>


<span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">decay</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">rand</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">37</span><span class="p">,</span> <span class="mi">4</span><span class="p">)</span>
<span class="n">write</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">37</span><span class="p">,</span> <span class="mi">4</span><span class="p">)</span>
<span class="n">c</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">37</span><span class="p">,</span> <span class="mi">4</span><span class="p">)</span>
<span class="n">gap</span> <span class="o">=</span> <span class="p">(</span><span class="nf">scan_parallel</span><span class="p">(</span><span class="n">decay</span><span class="p">,</span> <span class="n">write</span><span class="p">,</span> <span class="n">c</span><span class="p">)</span> <span class="o">-</span> <span class="nf">scan_loop</span><span class="p">(</span><span class="n">decay</span><span class="p">,</span> <span class="n">write</span><span class="p">,</span> <span class="n">c</span><span class="p">)).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">parallel against loop:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">gap</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>parallel against loop: 9.5e-07</code></pre> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/10/scan-light.png" width="760" alt="The Hillis–Steele scan on eight positions. In the first round every position combines with its left neighbour, in the second with the position two to its left, in the third with the position four to its left; after three rounds, the logarithm of eight, every position holds the combined effect of all the steps before it, and each round is one elementwise operation over the whole sequence" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/10/scan-dark.png" width="760" alt="The Hillis–Steele scan on eight positions. In the first round every position combines with its left neighbour, in the second with the position two to its left, in the third with the position four to its left; after three rounds, the logarithm of eight, every position holds the combined effect of all the steps before it, and each round is one elementwise operation over the whole sequence" loading="lazy"></p> <p>The parallel scan does more work than the loop, \(L \log_2 L\) combinations instead of \(L\), and keeps a tensor of shape (batch, channels, \(L\), \(N\)) in memory, \(N\) times the size of the layer’s activations.</p> <p>Written in plain PyTorch on a T4, the two come out about even: every step of the loop already runs over all 1,536 channels and 16 state numbers at once, so it is parallel across channels, and the scan’s extra work and memory traffic eat what it gains across time.</p> <p>The scan pays off when it never leaves the chip, which is what Mamba’s own kernel does.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">sizes</span> <span class="o">=</span> <span class="p">[</span><span class="mi">256</span><span class="p">,</span> <span class="mi">512</span><span class="p">]</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="p">[</span><span class="mi">256</span><span class="p">,</span> <span class="mi">1024</span><span class="p">,</span> <span class="mi">4096</span><span class="p">]</span>
<span class="n">timing</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">L</span> <span class="ow">in</span> <span class="n">sizes</span><span class="p">:</span>
    <span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
    <span class="n">decay</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">rand</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1536</span><span class="p">,</span> <span class="n">L</span><span class="p">,</span> <span class="mi">16</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
    <span class="n">write</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1536</span><span class="p">,</span> <span class="n">L</span><span class="p">,</span> <span class="mi">16</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
    <span class="n">c</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">L</span><span class="p">,</span> <span class="mi">16</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">scan</span> <span class="ow">in</span> <span class="p">[(</span><span class="sh">"</span><span class="s">loop</span><span class="sh">"</span><span class="p">,</span> <span class="n">scan_loop</span><span class="p">),</span> <span class="p">(</span><span class="sh">"</span><span class="s">parallel</span><span class="sh">"</span><span class="p">,</span> <span class="n">scan_parallel</span><span class="p">)]:</span>
        <span class="nf">scan</span><span class="p">(</span><span class="n">decay</span><span class="p">,</span> <span class="n">write</span><span class="p">,</span> <span class="n">c</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
            <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">synchronize</span><span class="p">()</span>
        <span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
        <span class="nf">scan</span><span class="p">(</span><span class="n">decay</span><span class="p">,</span> <span class="n">write</span><span class="p">,</span> <span class="n">c</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
            <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">synchronize</span><span class="p">()</span>
        <span class="n">timing</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">tokens</span><span class="sh">"</span><span class="p">:</span> <span class="n">L</span><span class="p">,</span> <span class="sh">"</span><span class="s">scan</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span> <span class="sh">"</span><span class="s">ms</span><span class="sh">"</span><span class="p">:</span> <span class="p">(</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="p">)</span> <span class="o">*</span> <span class="mi">1000</span><span class="p">})</span>
<span class="n">ms</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">timing</span><span class="p">).</span><span class="nf">pivot</span><span class="p">(</span><span class="n">index</span><span class="o">=</span><span class="sh">"</span><span class="s">tokens</span><span class="sh">"</span><span class="p">,</span> <span class="n">columns</span><span class="o">=</span><span class="sh">"</span><span class="s">scan</span><span class="sh">"</span><span class="p">,</span> <span class="n">values</span><span class="o">=</span><span class="sh">"</span><span class="s">ms</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">ms</span><span class="p">.</span><span class="nf">reset_index</span><span class="p">(),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">tokens</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">loop</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">parallel</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">256</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">16.0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">13.1</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,024</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">63.4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">62.8</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4,096</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">256.8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">303.8</td></tr></tbody></table></div> <p>Mamba’s own kernel goes further, and its design is FlashAttention’s lesson applied to a recurrence. The tensor of all states, (batch, channels, \(L\), \(N\)), is never written to the GPU’s main memory: the kernel loads \(\Delta\), \(A\), \(B\), \(C\) and \(x\) into the fast on-chip memory, runs the scan there and writes back only the outputs \(y\). For training it recomputes the states in the backward pass instead of storing them. With that kernel, the paper reports, the scan runs 20 to 40 times faster than a standard scan in PyTorch.</p> <h2 id="7-generation-with-a-state-of-fixed-size">7. Generation with a state of fixed size</h2> <p>To generate, a Transformer keeps its <a href="/blog/2025/inference-optimization/">KV cache</a>; Mamba keeps, per layer, the state \(h\), \(E \times N\) numbers, and the last three inputs of the convolution. One step of generation reads the new token, updates both, and forgets the token. The step is the recurrence of section 3 for one position:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">mixer_step</span><span class="p">(</span><span class="n">m</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">state</span><span class="p">):</span>
    <span class="n">window</span><span class="p">,</span> <span class="n">h</span> <span class="o">=</span> <span class="p">(</span>
        <span class="n">state</span>  <span class="c1"># the convolution's last inputs (batch, E, k), the state (batch, E, N)
</span>    <span class="p">)</span>
    <span class="n">u</span><span class="p">,</span> <span class="n">gate</span> <span class="o">=</span> <span class="n">m</span><span class="p">.</span><span class="nf">in_proj</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">chunk</span><span class="p">(</span><span class="mi">2</span><span class="p">,</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>  <span class="c1"># (batch, E) each
</span>    <span class="n">window</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">window</span><span class="p">[:,</span> <span class="p">:,</span> <span class="mi">1</span><span class="p">:],</span> <span class="n">u</span><span class="p">[:,</span> <span class="p">:,</span> <span class="bp">None</span><span class="p">]],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">u</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">silu</span><span class="p">((</span><span class="n">window</span> <span class="o">*</span> <span class="n">m</span><span class="p">.</span><span class="n">conv1d</span><span class="p">.</span><span class="n">weight</span><span class="p">[:,</span> <span class="mi">0</span><span class="p">]).</span><span class="nf">sum</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span> <span class="o">+</span> <span class="n">m</span><span class="p">.</span><span class="n">conv1d</span><span class="p">.</span><span class="n">bias</span><span class="p">)</span>
    <span class="n">seed</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span> <span class="o">=</span> <span class="n">m</span><span class="p">.</span><span class="nf">x_proj</span><span class="p">(</span><span class="n">u</span><span class="p">).</span><span class="nf">split</span><span class="p">([</span><span class="n">m</span><span class="p">.</span><span class="n">rank</span><span class="p">,</span> <span class="n">m</span><span class="p">.</span><span class="n">n</span><span class="p">,</span> <span class="n">m</span><span class="p">.</span><span class="n">n</span><span class="p">],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">step</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">softplus</span><span class="p">(</span><span class="n">m</span><span class="p">.</span><span class="nf">dt_proj</span><span class="p">(</span><span class="n">seed</span><span class="p">))</span>  <span class="c1"># (batch, E)
</span>    <span class="n">a</span> <span class="o">=</span> <span class="o">-</span><span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">m</span><span class="p">.</span><span class="n">A_log</span><span class="p">.</span><span class="nf">float</span><span class="p">())</span>
    <span class="n">h</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">step</span><span class="p">[...,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="n">a</span><span class="p">)</span> <span class="o">*</span> <span class="n">h</span> <span class="o">+</span> <span class="n">step</span><span class="p">[...,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="n">b</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="n">u</span><span class="p">[...,</span> <span class="bp">None</span><span class="p">]</span>
    <span class="n">y</span> <span class="o">=</span> <span class="p">(</span><span class="n">h</span> <span class="o">*</span> <span class="n">c</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">]).</span><span class="nf">sum</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span> <span class="o">+</span> <span class="n">u</span> <span class="o">*</span> <span class="n">m</span><span class="p">.</span><span class="n">D</span>
    <span class="k">return</span> <span class="n">m</span><span class="p">.</span><span class="nf">out_proj</span><span class="p">(</span><span class="n">y</span> <span class="o">*</span> <span class="n">F</span><span class="p">.</span><span class="nf">silu</span><span class="p">(</span><span class="n">gate</span><span class="p">)),</span> <span class="p">(</span><span class="n">window</span><span class="p">,</span> <span class="n">h</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">model_step</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">token</span><span class="p">,</span> <span class="n">states</span><span class="p">):</span>
    <span class="n">x</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="nf">embeddings</span><span class="p">(</span><span class="n">token</span><span class="p">)</span>
    <span class="n">new_states</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">layer</span><span class="p">,</span> <span class="n">state</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="n">layers</span><span class="p">,</span> <span class="n">states</span><span class="p">):</span>
        <span class="n">out</span><span class="p">,</span> <span class="n">state</span> <span class="o">=</span> <span class="nf">mixer_step</span><span class="p">(</span><span class="n">layer</span><span class="p">.</span><span class="n">mixer</span><span class="p">,</span> <span class="n">layer</span><span class="p">.</span><span class="nf">norm</span><span class="p">(</span><span class="n">x</span><span class="p">),</span> <span class="n">state</span><span class="p">)</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">x</span> <span class="o">+</span> <span class="n">out</span>
        <span class="n">new_states</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">state</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">model</span><span class="p">.</span><span class="nf">lm_head</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="nf">norm_f</span><span class="p">(</span><span class="n">x</span><span class="p">)).</span><span class="nf">float</span><span class="p">(),</span> <span class="n">new_states</span>


<span class="k">def</span> <span class="nf">empty_states</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">batch</span><span class="o">=</span><span class="mi">1</span><span class="p">):</span>
    <span class="n">states</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
        <span class="n">m</span> <span class="o">=</span> <span class="n">layer</span><span class="p">.</span><span class="n">mixer</span>
        <span class="n">e</span><span class="p">,</span> <span class="n">k</span> <span class="o">=</span> <span class="n">m</span><span class="p">.</span><span class="n">D</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="n">m</span><span class="p">.</span><span class="n">conv1d</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
        <span class="n">dev</span> <span class="o">=</span> <span class="n">m</span><span class="p">.</span><span class="n">D</span><span class="p">.</span><span class="n">device</span>
        <span class="n">states</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
            <span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">batch</span><span class="p">,</span> <span class="n">e</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">dev</span><span class="p">),</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">batch</span><span class="p">,</span> <span class="n">e</span><span class="p">,</span> <span class="n">m</span><span class="p">.</span><span class="n">n</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">dev</span><span class="p">))</span>
        <span class="p">)</span>
    <span class="k">return</span> <span class="n">states</span>


<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">full</span> <span class="o">=</span> <span class="nf">mamba</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span>
    <span class="n">states</span> <span class="o">=</span> <span class="nf">empty_states</span><span class="p">(</span><span class="n">mamba</span><span class="p">)</span>
    <span class="n">stepped</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]):</span>
        <span class="n">logits</span><span class="p">,</span> <span class="n">states</span> <span class="o">=</span> <span class="nf">model_step</span><span class="p">(</span><span class="n">mamba</span><span class="p">,</span> <span class="n">ids</span><span class="p">[:,</span> <span class="n">t</span><span class="p">],</span> <span class="n">states</span><span class="p">)</span>
        <span class="n">stepped</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">logits</span><span class="p">)</span>
<span class="n">stepped</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">(</span><span class="n">stepped</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
<span class="n">state_bytes</span> <span class="o">=</span> <span class="nf">sum</span><span class="p">(</span><span class="n">w</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span> <span class="o">+</span> <span class="n">h</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span> <span class="k">for</span> <span class="n">w</span><span class="p">,</span> <span class="n">h</span> <span class="ow">in</span> <span class="n">states</span><span class="p">)</span> <span class="o">*</span> <span class="mi">2</span>  <span class="c1"># in 16-bit floats
</span><span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">step by step against the whole sequence:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="n">stepped</span> <span class="o">-</span> <span class="n">full</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">the whole state of the model: </span><span class="si">{</span><span class="n">state_bytes</span> <span class="o">/</span> <span class="mf">1e6</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="s"> MB, at any length</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>step by step against the whole sequence: 3.9e-04
the whole state of the model: 1.47 MB, at any length</code></pre> <p>Lesson 8 measured what a token costs in a Transformer’s cache. The same count for Pythia-160m, the Transformer that EleutherAI trained on the same 300 billion tokens of the Pile as mamba-130m, with the same tokenizer:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">pythia_config</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="sh">"</span><span class="s">EleutherAI/pythia-160m</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">)))</span>
<span class="n">per_token</span> <span class="o">=</span> <span class="p">(</span>
    <span class="mi">2</span> <span class="o">*</span> <span class="n">pythia_config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">]</span> <span class="o">*</span> <span class="n">pythia_config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">]</span> <span class="o">*</span> <span class="mi">2</span>
<span class="p">)</span>  <span class="c1"># K and V, fp16
</span><span class="n">memory</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="p">[</span><span class="mi">2048</span><span class="p">,</span> <span class="mi">32768</span><span class="p">,</span> <span class="mi">131072</span><span class="p">,</span> <span class="mi">1_000_000</span><span class="p">]:</span>
    <span class="n">memory</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
        <span class="p">{</span>
            <span class="sh">"</span><span class="s">tokens read</span><span class="sh">"</span><span class="p">:</span> <span class="n">n</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">Pythia-160m cache, MB</span><span class="sh">"</span><span class="p">:</span> <span class="n">per_token</span> <span class="o">*</span> <span class="n">n</span> <span class="o">/</span> <span class="mf">1e6</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">mamba-130m state, MB</span><span class="sh">"</span><span class="p">:</span> <span class="n">state_bytes</span> <span class="o">/</span> <span class="mf">1e6</span><span class="p">,</span>
        <span class="p">}</span>
    <span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">memory</span><span class="p">),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">tokens read</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">Pythia-160m cache, MB</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">mamba-130m state, MB</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,048</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">75.50</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.47</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32,768</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,207.96</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.47</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">131,072</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4,831.84</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.47</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,000,000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">36,864.00</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.47</td></tr></tbody></table></div> <p>The state is about as big as Pythia’s cache after a few dozen tokens, and it stays that size. This is the whole promise of the architecture, and it comes with a question that the next sections answer: what doesn’t fit into a state that never grows?</p> <h2 id="8-mamba-2-the-same-model-as-attention">8. Mamba-2: the same model as attention</h2> <p>Six months after Mamba, Dao and Gu published Mamba-2 with a title that sounds like a provocation: <em>Transformers are SSMs</em>. The change to the model is small.</p> <p>\(A\) becomes one number per head instead of one per channel and state number, the channels are grouped into heads of 64 like attention heads, \(B\) and \(C\) are computed in parallel with the input instead of after it, and the state grows from 16 numbers to 128.</p> <p>The consequence is large. Unroll the recurrence with a scalar \(a\) per head and the output at position \(t\) is a weighted sum over all earlier positions:</p> \[y_t = \sum_{s \le t} \underbrace{c_t^{\top} b_s}_{\text{like } q_t^{\top} k_s}\; \underbrace{e^{\,a(\Delta_{s+1} + \dots + \Delta_t)}}_{\text{the mask}}\; \Delta_s\, x_s.\] <p>That is attention. \(c_t\) plays the query, \(b_s\) the key, \(\Delta_s x_s\) the value, and instead of a softmax the scores are multiplied by a mask that decays with distance at a rate the tokens choose.</p> <p>The paper calls the equivalence <em>state space duality</em>: the same layer can be computed as a recurrence, cheap per token, or as a masked attention matrix, which is all matrix multiplication and therefore fast on a GPU.</p> <p>The practical algorithm mixes the two: attention inside chunks of 64 to 256 tokens, the recurrence between chunks. Four steps, all of them <code class="language-plaintext highlighter-rouge">einsum</code>.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">segment_sums</span><span class="p">(</span><span class="n">a</span><span class="p">):</span>
    <span class="c1"># a (..., T) -&gt; (..., T, T): out[t, s] = a[s+1] + ... + a[t] for s &lt;= t,
</span>    <span class="c1"># and -inf above the diagonal
</span>    <span class="n">T</span> <span class="o">=</span> <span class="n">a</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
    <span class="n">below</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">T</span><span class="p">,</span> <span class="n">T</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">a</span><span class="p">.</span><span class="n">device</span><span class="p">).</span><span class="nf">tril</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">x</span> <span class="o">=</span> <span class="n">a</span><span class="p">[...,</span> <span class="bp">None</span><span class="p">].</span><span class="nf">expand</span><span class="p">(</span><span class="o">*</span><span class="n">a</span><span class="p">.</span><span class="n">shape</span><span class="p">,</span> <span class="n">T</span><span class="p">).</span><span class="nf">masked_fill</span><span class="p">(</span><span class="o">~</span><span class="n">below</span><span class="p">,</span> <span class="mi">0</span><span class="p">)</span>
    <span class="n">x</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cumsum</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">2</span><span class="p">)</span>
    <span class="n">on_or_below</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">T</span><span class="p">,</span> <span class="n">T</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">a</span><span class="p">.</span><span class="n">device</span><span class="p">).</span><span class="nf">tril</span><span class="p">()</span>
    <span class="k">return</span> <span class="n">x</span><span class="p">.</span><span class="nf">masked_fill</span><span class="p">(</span><span class="o">~</span><span class="n">on_or_below</span><span class="p">,</span> <span class="nf">float</span><span class="p">(</span><span class="sh">"</span><span class="s">-inf</span><span class="sh">"</span><span class="p">))</span>


<span class="k">def</span> <span class="nf">ssd</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">a</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span><span class="p">,</span> <span class="n">chunk</span><span class="o">=</span><span class="mi">64</span><span class="p">):</span>
    <span class="c1"># x (batch, L, heads, P), already times Δ; a (batch, L, heads) = Δ·A;
</span>    <span class="c1"># b and c (batch, L, heads, N)
</span>    <span class="n">batch</span><span class="p">,</span> <span class="n">L</span><span class="p">,</span> <span class="n">heads</span><span class="p">,</span> <span class="n">p</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span>
    <span class="n">pad</span> <span class="o">=</span> <span class="p">(</span><span class="n">chunk</span> <span class="o">-</span> <span class="n">L</span> <span class="o">%</span> <span class="n">chunk</span><span class="p">)</span> <span class="o">%</span> <span class="n">chunk</span>
    <span class="n">x</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span> <span class="o">=</span> <span class="p">[</span><span class="n">F</span><span class="p">.</span><span class="nf">pad</span><span class="p">(</span><span class="n">t</span><span class="p">,</span> <span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="n">pad</span><span class="p">))</span> <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span><span class="p">)]</span>
    <span class="n">a</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">pad</span><span class="p">(</span><span class="n">a</span><span class="p">,</span> <span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="n">pad</span><span class="p">))</span>
    <span class="n">n</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span> <span class="o">//</span> <span class="n">chunk</span>
    <span class="n">x</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span> <span class="o">=</span> <span class="p">[</span><span class="n">t</span><span class="p">.</span><span class="nf">reshape</span><span class="p">(</span><span class="n">batch</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">chunk</span><span class="p">,</span> <span class="n">heads</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">)</span> <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span><span class="p">)]</span>
    <span class="n">a</span> <span class="o">=</span> <span class="n">a</span><span class="p">.</span><span class="nf">reshape</span><span class="p">(</span><span class="n">batch</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">chunk</span><span class="p">,</span> <span class="n">heads</span><span class="p">).</span><span class="nf">permute</span><span class="p">(</span>
        <span class="mi">0</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">2</span>
    <span class="p">)</span>  <span class="c1"># (batch, heads, chunks, chunk)
</span>    <span class="n">a_cum</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cumsum</span><span class="p">(</span><span class="n">a</span><span class="p">,</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="c1"># 1. inside each chunk: attention with the decay as its mask
</span>    <span class="n">mask</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="nf">segment_sums</span><span class="p">(</span><span class="n">a</span><span class="p">))</span>
    <span class="n">y_inside</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">einsum</span><span class="p">(</span><span class="sh">"</span><span class="s">bclhn,bcshn,bhcls,bcshp-&gt;bclhp</span><span class="sh">"</span><span class="p">,</span> <span class="n">c</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">x</span><span class="p">)</span>
    <span class="c1"># 2. the state each chunk leaves behind
</span>    <span class="n">to_end</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">a_cum</span><span class="p">[...,</span> <span class="o">-</span><span class="mi">1</span><span class="p">:]</span> <span class="o">-</span> <span class="n">a_cum</span><span class="p">)</span>
    <span class="n">states</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">einsum</span><span class="p">(</span><span class="sh">"</span><span class="s">bclhn,bhcl,bclhp-&gt;bchpn</span><span class="sh">"</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">to_end</span><span class="p">,</span> <span class="n">x</span><span class="p">)</span>
    <span class="c1"># 3. the recurrence between chunks
</span>    <span class="n">states</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">torch</span><span class="p">.</span><span class="nf">zeros_like</span><span class="p">(</span><span class="n">states</span><span class="p">[:,</span> <span class="p">:</span><span class="mi">1</span><span class="p">]),</span> <span class="n">states</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">between</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="nf">segment_sums</span><span class="p">(</span><span class="n">F</span><span class="p">.</span><span class="nf">pad</span><span class="p">(</span><span class="n">a_cum</span><span class="p">[...,</span> <span class="o">-</span><span class="mi">1</span><span class="p">],</span> <span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">0</span><span class="p">))))</span>
    <span class="n">states</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">einsum</span><span class="p">(</span><span class="sh">"</span><span class="s">bhzc,bchpn-&gt;bzhpn</span><span class="sh">"</span><span class="p">,</span> <span class="n">between</span><span class="p">,</span> <span class="n">states</span><span class="p">)[:,</span> <span class="p">:</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
    <span class="c1"># 4. what each position reads from the state that entered its chunk
</span>    <span class="n">y_entering</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">einsum</span><span class="p">(</span><span class="sh">"</span><span class="s">bclhn,bchpn,bhcl-&gt;bclhp</span><span class="sh">"</span><span class="p">,</span> <span class="n">c</span><span class="p">,</span> <span class="n">states</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">a_cum</span><span class="p">))</span>
    <span class="nf">return </span><span class="p">(</span><span class="n">y_inside</span> <span class="o">+</span> <span class="n">y_entering</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="n">batch</span><span class="p">,</span> <span class="n">n</span> <span class="o">*</span> <span class="n">chunk</span><span class="p">,</span> <span class="n">heads</span><span class="p">,</span> <span class="n">p</span><span class="p">)[:,</span> <span class="p">:</span><span class="n">L</span><span class="p">]</span>


<span class="k">def</span> <span class="nf">ssd_loop</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">a</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
    <span class="n">h</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">2</span><span class="p">],</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">3</span><span class="p">],</span> <span class="n">b</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">],</span> <span class="n">device</span><span class="o">=</span><span class="n">x</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
    <span class="n">ys</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]):</span>
        <span class="n">h</span> <span class="o">=</span> <span class="p">(</span>
            <span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">a</span><span class="p">[:,</span> <span class="n">t</span><span class="p">])[...,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="n">h</span>
            <span class="o">+</span> <span class="n">x</span><span class="p">[:,</span> <span class="n">t</span><span class="p">,</span> <span class="p">:,</span> <span class="p">:,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="n">b</span><span class="p">[:,</span> <span class="n">t</span><span class="p">,</span> <span class="p">:,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:]</span>
        <span class="p">)</span>
        <span class="n">ys</span><span class="p">.</span><span class="nf">append</span><span class="p">((</span><span class="n">h</span> <span class="o">*</span> <span class="n">c</span><span class="p">[:,</span> <span class="n">t</span><span class="p">,</span> <span class="p">:,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:]).</span><span class="nf">sum</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">))</span>
    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">(</span><span class="n">ys</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>


<span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">x</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">150</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">8</span><span class="p">)</span>
<span class="n">a</span> <span class="o">=</span> <span class="o">-</span><span class="n">torch</span><span class="p">.</span><span class="nf">rand</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">150</span><span class="p">,</span> <span class="mi">3</span><span class="p">)</span> <span class="o">*</span> <span class="mf">0.3</span>
<span class="n">b</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">150</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">16</span><span class="p">)</span>
<span class="n">c</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">150</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">16</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span>
    <span class="sh">"</span><span class="s">chunks of 32 against the step-by-step loop:</span><span class="sh">"</span><span class="p">,</span>
    <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="nf">ssd</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">a</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span><span class="p">,</span> <span class="mi">32</span><span class="p">)</span> <span class="o">-</span> <span class="nf">ssd_loop</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">a</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span><span class="p">)).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span>
<span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>chunks of 32 against the step-by-step loop: 6.7e-06</code></pre> <p>The Mamba-2 block keeps the shape of section 4 with the changes above: one projection makes the gate, the stream, \(B\), \(C\) and the steps at once; the convolution runs over the stream together with \(B\) and \(C\); and the gate is applied inside an RMSNorm at the end. The checkpoint is the 130-million-parameter Mamba-2 released by the authors, in the Hugging Face format of a community conversion, <code class="language-plaintext highlighter-rouge">AntonV/mamba2-130m-hf</code>.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">GatedRMSNorm</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">size</span><span class="p">,</span> <span class="n">eps</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">weight</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">size</span><span class="p">))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">eps</span> <span class="o">=</span> <span class="n">eps</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">gate</span><span class="p">):</span>
        <span class="n">x32</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="nf">float</span><span class="p">()</span> <span class="o">*</span> <span class="n">F</span><span class="p">.</span><span class="nf">silu</span><span class="p">(</span><span class="n">gate</span><span class="p">.</span><span class="nf">float</span><span class="p">())</span>
        <span class="n">x32</span> <span class="o">=</span> <span class="n">x32</span> <span class="o">*</span> <span class="n">torch</span><span class="p">.</span><span class="nf">rsqrt</span><span class="p">(</span><span class="n">x32</span><span class="p">.</span><span class="nf">pow</span><span class="p">(</span><span class="mi">2</span><span class="p">).</span><span class="nf">mean</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">eps</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="n">weight</span> <span class="o">*</span> <span class="n">x32</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span>


<span class="k">class</span> <span class="nc">Mixer2</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">p</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">n</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_heads</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">head_dim</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">state_size</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">groups</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">n_groups</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">e</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">p</span>
        <span class="n">conv</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">e</span> <span class="o">+</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">groups</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">n</span>
        <span class="n">k</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">conv_kernel</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">in_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span>
            <span class="n">d</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">e</span> <span class="o">+</span> <span class="n">conv</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">use_bias</span><span class="sh">"</span><span class="p">,</span> <span class="bp">False</span><span class="p">)</span>
        <span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">conv1d</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Conv1d</span><span class="p">(</span><span class="n">conv</span><span class="p">,</span> <span class="n">conv</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">groups</span><span class="o">=</span><span class="n">conv</span><span class="p">,</span> <span class="n">padding</span><span class="o">=</span><span class="n">k</span> <span class="o">-</span> <span class="mi">1</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">dt_bias</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">A_log</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">D</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm</span> <span class="o">=</span> <span class="nc">GatedRMSNorm</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">e</span><span class="p">,</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">layer_norm_epsilon</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">out_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">e</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">use_bias</span><span class="sh">"</span><span class="p">,</span> <span class="bp">False</span><span class="p">))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">chunk</span> <span class="o">=</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">chunk_size</span><span class="sh">"</span><span class="p">,</span> <span class="mi">64</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="bp">False</span>  <span class="c1"># the next cell reads the matrix of one head
</span>        <span class="n">self</span><span class="p">.</span><span class="n">parts</span> <span class="o">=</span> <span class="bp">None</span>

    <span class="k">def</span> <span class="nf">select</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">dt</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
        <span class="c1"># the step, B and C of every token: what makes the layer selective (section 11)
</span>        <span class="k">return</span> <span class="n">F</span><span class="p">.</span><span class="nf">softplus</span><span class="p">((</span><span class="n">dt</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">dt_bias</span><span class="p">).</span><span class="nf">float</span><span class="p">()),</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span>  <span class="c1"># the step in 32 bits
</span>
    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">batch</span><span class="p">,</span> <span class="n">L</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span>
        <span class="n">sizes</span> <span class="o">=</span> <span class="p">[</span><span class="n">self</span><span class="p">.</span><span class="n">e</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">e</span> <span class="o">+</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">groups</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">n</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">]</span>
        <span class="n">gate</span><span class="p">,</span> <span class="n">xbc</span><span class="p">,</span> <span class="n">dt</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">in_proj</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">split</span><span class="p">(</span><span class="n">sizes</span><span class="p">,</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">xbc</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">silu</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">conv1d</span><span class="p">(</span><span class="n">xbc</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">))[...,</span> <span class="p">:</span><span class="n">L</span><span class="p">].</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">))</span>
        <span class="n">u</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span> <span class="o">=</span> <span class="n">xbc</span><span class="p">.</span><span class="nf">split</span><span class="p">([</span><span class="n">self</span><span class="p">.</span><span class="n">e</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">groups</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">n</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">groups</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">n</span><span class="p">],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">step</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">select</span><span class="p">(</span><span class="n">dt</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span><span class="p">)</span>
        <span class="n">a</span> <span class="o">=</span> <span class="o">-</span><span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">A_log</span><span class="p">.</span><span class="nf">float</span><span class="p">())</span>  <span class="c1"># one number per head
</span>        <span class="n">u</span> <span class="o">=</span> <span class="n">u</span><span class="p">.</span><span class="nf">reshape</span><span class="p">(</span><span class="n">batch</span><span class="p">,</span> <span class="n">L</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">p</span><span class="p">)</span>
        <span class="n">share</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">//</span> <span class="n">self</span><span class="p">.</span><span class="n">groups</span>
        <span class="n">b</span> <span class="o">=</span> <span class="n">b</span><span class="p">.</span><span class="nf">reshape</span><span class="p">(</span><span class="n">batch</span><span class="p">,</span> <span class="n">L</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">groups</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">n</span><span class="p">).</span><span class="nf">repeat_interleave</span><span class="p">(</span><span class="n">share</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
        <span class="n">c</span> <span class="o">=</span> <span class="n">c</span><span class="p">.</span><span class="nf">reshape</span><span class="p">(</span><span class="n">batch</span><span class="p">,</span> <span class="n">L</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">groups</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">n</span><span class="p">).</span><span class="nf">repeat_interleave</span><span class="p">(</span><span class="n">share</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">self</span><span class="p">.</span><span class="n">keep</span><span class="p">:</span>
            <span class="n">self</span><span class="p">.</span><span class="n">parts</span> <span class="o">=</span> <span class="p">(</span><span class="n">u</span><span class="p">.</span><span class="nf">detach</span><span class="p">(),</span> <span class="n">step</span><span class="p">.</span><span class="nf">detach</span><span class="p">(),</span> <span class="n">a</span><span class="p">.</span><span class="nf">detach</span><span class="p">(),</span> <span class="n">b</span><span class="p">.</span><span class="nf">detach</span><span class="p">(),</span> <span class="n">c</span><span class="p">.</span><span class="nf">detach</span><span class="p">())</span>
        <span class="n">y</span> <span class="o">=</span> <span class="nf">ssd</span><span class="p">(</span><span class="n">u</span><span class="p">.</span><span class="nf">float</span><span class="p">()</span> <span class="o">*</span> <span class="n">step</span><span class="p">[...,</span> <span class="bp">None</span><span class="p">],</span> <span class="n">step</span> <span class="o">*</span> <span class="n">a</span><span class="p">,</span> <span class="n">b</span><span class="p">.</span><span class="nf">float</span><span class="p">(),</span> <span class="n">c</span><span class="p">.</span><span class="nf">float</span><span class="p">(),</span> <span class="n">self</span><span class="p">.</span><span class="n">chunk</span><span class="p">)</span>
        <span class="n">y</span> <span class="o">=</span> <span class="n">y</span> <span class="o">+</span> <span class="n">u</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">D</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">]</span>
        <span class="n">y</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm</span><span class="p">(</span><span class="n">y</span><span class="p">.</span><span class="nf">reshape</span><span class="p">(</span><span class="n">batch</span><span class="p">,</span> <span class="n">L</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">e</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">dtype</span><span class="p">),</span> <span class="n">gate</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">out_proj</span><span class="p">(</span><span class="n">y</span><span class="p">)</span>


<span class="k">class</span> <span class="nc">Mamba2</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">,</span> <span class="n">mixer</span><span class="o">=</span><span class="n">Mixer2</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">embeddings</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">layers</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">ModuleList</span><span class="p">()</span>
        <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">]):</span>
            <span class="n">block</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Module</span><span class="p">()</span>
            <span class="n">block</span><span class="p">.</span><span class="n">norm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">layer_norm_epsilon</span><span class="sh">"</span><span class="p">])</span>
            <span class="n">block</span><span class="p">.</span><span class="n">mixer</span> <span class="o">=</span> <span class="nf">mixer</span><span class="p">(</span><span class="n">c</span><span class="p">)</span>
            <span class="n">self</span><span class="p">.</span><span class="n">layers</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">block</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm_f</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">layer_norm_epsilon</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">lm_head</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">hidden</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">):</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">embeddings</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span>
        <span class="k">for</span> <span class="n">block</span> <span class="ow">in</span> <span class="n">self</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
            <span class="n">x</span> <span class="o">=</span> <span class="n">x</span> <span class="o">+</span> <span class="n">block</span><span class="p">.</span><span class="nf">mixer</span><span class="p">(</span><span class="n">block</span><span class="p">.</span><span class="nf">norm</span><span class="p">(</span><span class="n">x</span><span class="p">))</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm_f</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">lm_head</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">hidden</span><span class="p">(</span><span class="n">ids</span><span class="p">)).</span><span class="nf">float</span><span class="p">()</span>
</code></pre></div></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">Mamba2Config</span><span class="p">,</span> <span class="n">Mamba2ForCausalLM</span>

<span class="n">REPO2</span> <span class="o">=</span> <span class="sh">"</span><span class="s">AntonV/mamba2-130m-hf</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">SMOKE</span><span class="p">:</span>
    <span class="n">small2</span> <span class="o">=</span> <span class="nc">Mamba2Config</span><span class="p">(</span>
        <span class="n">vocab_size</span><span class="o">=</span><span class="mi">50288</span><span class="p">,</span>
        <span class="n">hidden_size</span><span class="o">=</span><span class="mi">64</span><span class="p">,</span>
        <span class="n">num_heads</span><span class="o">=</span><span class="mi">4</span><span class="p">,</span>
        <span class="n">head_dim</span><span class="o">=</span><span class="mi">32</span><span class="p">,</span>
        <span class="n">state_size</span><span class="o">=</span><span class="mi">16</span><span class="p">,</span>
        <span class="n">n_groups</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span>
        <span class="n">num_hidden_layers</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span>
        <span class="n">chunk_size</span><span class="o">=</span><span class="mi">16</span><span class="p">,</span>
    <span class="p">)</span>
    <span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="mi">0</span><span class="p">)</span>
    <span class="n">reference2</span> <span class="o">=</span> <span class="nc">Mamba2ForCausalLM</span><span class="p">(</span><span class="n">small2</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
    <span class="n">mamba2_config</span> <span class="o">=</span> <span class="n">small2</span><span class="p">.</span><span class="nf">to_dict</span><span class="p">()</span>
    <span class="n">state</span> <span class="o">=</span> <span class="p">{</span><span class="n">k</span><span class="p">.</span><span class="nf">removeprefix</span><span class="p">(</span><span class="sh">"</span><span class="s">backbone.</span><span class="sh">"</span><span class="p">):</span> <span class="n">v</span> <span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="ow">in</span> <span class="n">reference2</span><span class="p">.</span><span class="nf">state_dict</span><span class="p">().</span><span class="nf">items</span><span class="p">()}</span>
<span class="k">else</span><span class="p">:</span>
    <span class="n">reference2</span> <span class="o">=</span> <span class="n">Mamba2ForCausalLM</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">REPO2</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float32</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
    <span class="n">mamba2_config</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">REPO2</span><span class="p">,</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">)))</span>
    <span class="n">state</span> <span class="o">=</span> <span class="nf">load_file</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">REPO2</span><span class="p">,</span> <span class="sh">"</span><span class="s">model.safetensors</span><span class="sh">"</span><span class="p">))</span>
    <span class="n">state</span> <span class="o">=</span> <span class="p">{</span><span class="n">k</span><span class="p">.</span><span class="nf">removeprefix</span><span class="p">(</span><span class="sh">"</span><span class="s">backbone.</span><span class="sh">"</span><span class="p">):</span> <span class="n">v</span> <span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="ow">in</span> <span class="n">state</span><span class="p">.</span><span class="nf">items</span><span class="p">()}</span>
<span class="n">state</span><span class="p">.</span><span class="nf">setdefault</span><span class="p">(</span><span class="sh">"</span><span class="s">lm_head.weight</span><span class="sh">"</span><span class="p">,</span> <span class="n">state</span><span class="p">[</span><span class="sh">"</span><span class="s">embeddings.weight</span><span class="sh">"</span><span class="p">])</span>
<span class="n">mamba2</span> <span class="o">=</span> <span class="nc">Mamba2</span><span class="p">(</span><span class="n">mamba2_config</span><span class="p">)</span>
<span class="n">mamba2</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">(</span><span class="n">state</span><span class="p">,</span> <span class="n">strict</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">mamba2</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">gap</span> <span class="o">=</span> <span class="p">(</span><span class="nf">mamba2</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span> <span class="o">-</span> <span class="nf">reference2</span><span class="p">(</span><span class="n">ids</span><span class="p">).</span><span class="n">logits</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">Mamba-2, max difference from Hugging Face:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">gap</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="k">for</span> <span class="n">key</span> <span class="ow">in</span> <span class="p">[</span><span class="sh">"</span><span class="s">num_heads</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">head_dim</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">state_size</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">chunk_size</span><span class="sh">"</span><span class="p">]:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">key</span><span class="si">:</span><span class="mi">12</span><span class="si">}</span><span class="s"> </span><span class="si">{</span><span class="n">mamba2_config</span><span class="p">[</span><span class="n">key</span><span class="p">]</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="k">del</span> <span class="n">reference2</span>
</code></pre></div></div> <pre class="tfs-printed"><code>Mamba-2, max difference from Hugging Face: 3.1e-04
num_heads    24
head_dim     64
state_size   128
chunk_size   256</code></pre> <p>Now the attention matrix that Mamba-2 never writes down. For one head of a middle layer, on the Amundsen sentence, the matrix \(M_{ts} = c_t^{\top} b_s\, e^{a(\Delta_{s+1} + \dots + \Delta_t)}\, \Delta_s\); next to it, the attention of a head of Pythia-160m on the same tokens. The check under the picture multiplies the matrix by the head’s values and compares with the scan.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">layer2</span> <span class="o">=</span> <span class="nf">len</span><span class="p">(</span><span class="n">mamba2</span><span class="p">.</span><span class="n">layers</span><span class="p">)</span> <span class="o">//</span> <span class="mi">2</span>
<span class="n">mixer2</span> <span class="o">=</span> <span class="n">mamba2</span><span class="p">.</span><span class="n">layers</span><span class="p">[</span><span class="n">layer2</span><span class="p">].</span><span class="n">mixer</span>
<span class="n">mixer2</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="bp">True</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="nf">mamba2</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span>
<span class="n">mixer2</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="bp">False</span>
<span class="n">u</span><span class="p">,</span> <span class="n">step</span><span class="p">,</span> <span class="n">a</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span> <span class="o">=</span> <span class="n">mixer2</span><span class="p">.</span><span class="n">parts</span>
<span class="n">head</span> <span class="o">=</span> <span class="mi">0</span>
<span class="n">L</span> <span class="o">=</span> <span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>
<span class="n">decay</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="nf">segment_sums</span><span class="p">(</span><span class="n">step</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="p">:,</span> <span class="n">head</span><span class="p">]</span> <span class="o">*</span> <span class="n">a</span><span class="p">[</span><span class="n">head</span><span class="p">]))</span>  <span class="c1"># (L, L)
</span><span class="n">M</span> <span class="o">=</span> <span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="p">:,</span> <span class="n">head</span><span class="p">]</span> <span class="o">@</span> <span class="n">b</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="p">:,</span> <span class="n">head</span><span class="p">].</span><span class="n">T</span><span class="p">)</span> <span class="o">*</span> <span class="n">decay</span> <span class="o">*</span> <span class="n">step</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:,</span> <span class="n">head</span><span class="p">]</span>
<span class="n">y_matrix</span> <span class="o">=</span> <span class="n">M</span> <span class="o">@</span> <span class="n">u</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="p">:,</span> <span class="n">head</span><span class="p">]</span>
<span class="n">y_scan</span> <span class="o">=</span> <span class="nf">ssd</span><span class="p">(</span><span class="n">u</span> <span class="o">*</span> <span class="n">step</span><span class="p">[...,</span> <span class="bp">None</span><span class="p">],</span> <span class="n">step</span> <span class="o">*</span> <span class="n">a</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span><span class="p">,</span> <span class="n">mixer2</span><span class="p">.</span><span class="n">chunk</span><span class="p">)[</span><span class="mi">0</span><span class="p">,</span> <span class="p">:,</span> <span class="n">head</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">matrix form against the chunked scan:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="n">y_matrix</span> <span class="o">-</span> <span class="n">y_scan</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>matrix form against the chunked scan: 7.6e-06</code></pre> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">AutoModelForCausalLM</span>

<span class="n">PYTHIA</span> <span class="o">=</span> <span class="p">(</span>
    <span class="sh">"</span><span class="s">EleutherAI/pythia-14m</span><span class="sh">"</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="sh">"</span><span class="s">EleutherAI/pythia-160m</span><span class="sh">"</span>
<span class="p">)</span>  <span class="c1"># 14m: same tokenizer, tiny
</span><span class="n">pythia</span> <span class="o">=</span> <span class="n">AutoModelForCausalLM</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span>
    <span class="n">PYTHIA</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float32</span><span class="p">,</span> <span class="n">attn_implementation</span><span class="o">=</span><span class="sh">"</span><span class="s">eager</span><span class="sh">"</span>
<span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">attention</span> <span class="o">=</span> <span class="nf">pythia</span><span class="p">(</span>
        <span class="n">ids</span><span class="p">,</span> <span class="n">output_attentions</span><span class="o">=</span><span class="bp">True</span>
    <span class="p">).</span><span class="n">attentions</span>  <span class="c1"># one (1, heads, L, L) per layer
</span><span class="n">pythia_head</span> <span class="o">=</span> <span class="n">attention</span><span class="p">[</span><span class="nf">len</span><span class="p">(</span><span class="n">attention</span><span class="p">)</span> <span class="o">//</span> <span class="mi">2</span><span class="p">][</span><span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">].</span><span class="nf">numpy</span><span class="p">()</span>

<span class="n">labels</span> <span class="o">=</span> <span class="p">[</span><span class="n">s</span><span class="p">.</span><span class="nf">strip</span><span class="p">()</span> <span class="ow">or</span> <span class="sh">"</span><span class="s">␣</span><span class="sh">"</span> <span class="k">for</span> <span class="n">s</span> <span class="ow">in</span> <span class="nf">tokens_of</span><span class="p">(</span><span class="n">ids</span><span class="p">)]</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">10.4</span><span class="p">,</span> <span class="mf">5.0</span><span class="p">))</span>
<span class="n">weights</span> <span class="o">=</span> <span class="n">M</span><span class="p">.</span><span class="nf">abs</span><span class="p">().</span><span class="nf">numpy</span><span class="p">()</span>
<span class="n">weights</span> <span class="o">=</span> <span class="n">weights</span> <span class="o">/</span> <span class="n">weights</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span>
    <span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdims</span><span class="o">=</span><span class="bp">True</span>
<span class="p">)</span>  <span class="c1"># each row as a share, like attention
</span><span class="k">for</span> <span class="n">ax</span><span class="p">,</span> <span class="n">matrix</span><span class="p">,</span> <span class="n">title</span> <span class="ow">in</span> <span class="p">[</span>
    <span class="p">(</span><span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="n">weights</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="s">Mamba-2, layer </span><span class="si">{</span><span class="n">layer2</span><span class="si">}</span><span class="s">, head </span><span class="si">{</span><span class="n">head</span><span class="si">}</span><span class="s">: |M|, rows as shares</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="n">axes</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="n">pythia_head</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="s">Pythia-160m, layer </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">attention</span><span class="p">)</span> <span class="o">//</span> <span class="mi">2</span><span class="si">}</span><span class="s">, head 0: softmax</span><span class="sh">"</span><span class="p">),</span>
<span class="p">]:</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">imshow</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="n">matrix</span><span class="p">),</span> <span class="n">cmap</span><span class="o">=</span><span class="n">shades</span><span class="p">,</span> <span class="n">vmin</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_xticks</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="n">L</span><span class="p">),</span> <span class="n">labels</span><span class="p">,</span> <span class="n">rotation</span><span class="o">=</span><span class="mi">90</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">6</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_yticks</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="n">L</span><span class="p">),</span> <span class="n">labels</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">6</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="n">title</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">9</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/10/output-04.png" alt="Output of the code above" loading="lazy"></p> <p>Both matrices are lower-triangular: neither model looks ahead. The softmax head spends its attention on a few chosen tokens, often the first one, the attention sink of <a href="/blog/2026/transformer-architectures-06-modern/">lesson 6</a>.</p> <p>Mamba-2’s matrix is a different texture: every row is a smooth decay into the past, interrupted where the steps \(\Delta\) are large, because a large step erases what came before. One is a lookup, the other a fading memory, and the next section measures what that difference means in practice.</p> <h2 id="9-same-data-different-machinery">9. Same data, different machinery</h2> <p>Pythia-160m and mamba-130m are as close to a controlled experiment as two public models get: the same 300 billion tokens of the Pile, the same tokenizer, the same training context of 2,048 tokens, and a similar number of parameters outside the embeddings. Only the layer differs. Two tests.</p> <p><strong>Reading past the training length.</strong> Lesson 9 watched a model with rotary positions fall off a cliff past its training length.</p> <p>Pythia rotates a quarter of each head’s dimensions; Mamba has no positions at all, only the order in which the recurrence runs. Loss by position on the same PG-19 books as lesson 9:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">pandas</span> <span class="k">as</span> <span class="n">pd</span>

<span class="n">pg19</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nf">read_parquet</span><span class="p">(</span>
    <span class="sh">"</span><span class="s">hf://datasets/emozilla/pg19-test/data/test-00000-of-00001-29a571947c0b5ccc.parquet</span><span class="sh">"</span>
<span class="p">)</span>
<span class="n">LENGTH</span> <span class="o">=</span> <span class="mi">512</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">8192</span>
<span class="n">N_BOOKS</span> <span class="o">=</span> <span class="mi">2</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">6</span>
<span class="n">book_ids</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">text</span> <span class="ow">in</span> <span class="n">pg19</span><span class="p">.</span><span class="n">text</span><span class="p">:</span>
    <span class="n">t</span> <span class="o">=</span> <span class="nf">tok</span><span class="p">(</span><span class="n">text</span><span class="p">[:</span><span class="mi">120_000</span><span class="p">],</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="n">input_ids</span>
    <span class="k">if</span> <span class="n">t</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span> <span class="o">&gt;</span> <span class="n">LENGTH</span><span class="p">:</span>
        <span class="n">book_ids</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">t</span><span class="p">[:,</span> <span class="p">:</span> <span class="n">LENGTH</span> <span class="o">+</span> <span class="mi">1</span><span class="p">])</span>
    <span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="n">book_ids</span><span class="p">)</span> <span class="o">==</span> <span class="n">N_BOOKS</span><span class="p">:</span>
        <span class="k">break</span>

<span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">mamba</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
    <span class="n">layer</span><span class="p">.</span><span class="n">mixer</span><span class="p">.</span><span class="n">scan</span> <span class="o">=</span> <span class="n">scan_parallel</span>
<span class="n">mamba</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="n">pythia</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>


<span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">position_losses</span><span class="p">(</span><span class="n">model_logits</span><span class="p">,</span> <span class="n">ids</span><span class="p">):</span>
    <span class="n">logits</span> <span class="o">=</span> <span class="nf">model_logits</span><span class="p">(</span><span class="n">ids</span><span class="p">[:,</span> <span class="p">:</span><span class="o">-</span><span class="mi">1</span><span class="p">].</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">))</span>
    <span class="k">return</span> <span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span><span class="n">logits</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="n">ids</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">:].</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">),</span> <span class="n">reduction</span><span class="o">=</span><span class="sh">"</span><span class="s">none</span><span class="sh">"</span><span class="p">).</span><span class="nf">cpu</span><span class="p">()</span>


<span class="n">curves</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">mamba-130m</span><span class="sh">"</span><span class="p">:</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">LENGTH</span><span class="p">),</span> <span class="sh">"</span><span class="s">Pythia-160m</span><span class="sh">"</span><span class="p">:</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">LENGTH</span><span class="p">)}</span>
<span class="k">for</span> <span class="n">ids_book</span> <span class="ow">in</span> <span class="n">book_ids</span><span class="p">:</span>
    <span class="n">curves</span><span class="p">[</span><span class="sh">"</span><span class="s">mamba-130m</span><span class="sh">"</span><span class="p">]</span> <span class="o">+=</span> <span class="nf">position_losses</span><span class="p">(</span><span class="n">mamba</span><span class="p">,</span> <span class="n">ids_book</span><span class="p">)</span> <span class="o">/</span> <span class="nf">len</span><span class="p">(</span><span class="n">book_ids</span><span class="p">)</span>
    <span class="n">curves</span><span class="p">[</span><span class="sh">"</span><span class="s">Pythia-160m</span><span class="sh">"</span><span class="p">]</span> <span class="o">+=</span> <span class="nf">position_losses</span><span class="p">(</span>
        <span class="k">lambda</span> <span class="n">x</span><span class="p">:</span> <span class="nf">pythia</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="n">logits</span><span class="p">.</span><span class="nf">float</span><span class="p">(),</span> <span class="n">ids_book</span>
    <span class="p">)</span> <span class="o">/</span> <span class="nf">len</span><span class="p">(</span><span class="n">book_ids</span><span class="p">)</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">7.4</span><span class="p">,</span> <span class="mf">3.4</span><span class="p">))</span>
<span class="n">width</span> <span class="o">=</span> <span class="nf">max</span><span class="p">(</span><span class="mi">4</span><span class="p">,</span> <span class="n">LENGTH</span> <span class="o">//</span> <span class="mi">64</span><span class="p">)</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">color</span> <span class="ow">in</span> <span class="p">[(</span><span class="sh">"</span><span class="s">Pythia-160m</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">]),</span> <span class="p">(</span><span class="sh">"</span><span class="s">mamba-130m</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">])]:</span>
    <span class="n">smooth</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">convolve</span><span class="p">(</span><span class="n">curves</span><span class="p">[</span><span class="n">name</span><span class="p">].</span><span class="nf">numpy</span><span class="p">(),</span> <span class="n">np</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">width</span><span class="p">)</span> <span class="o">/</span> <span class="n">width</span><span class="p">,</span> <span class="n">mode</span><span class="o">=</span><span class="sh">"</span><span class="s">valid</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">smooth</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="n">name</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">axvline</span><span class="p">(</span><span class="mi">2048</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">],</span> <span class="n">linestyle</span><span class="o">=</span><span class="sh">"</span><span class="s">--</span><span class="sh">"</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">position in the book</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">loss, nats per token</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">book_ids</span><span class="p">)</span><span class="si">}</span><span class="s"> PG-19 books, both trained on 2,048 tokens</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
<span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">curves</span><span class="p">:</span>
    <span class="n">inside</span> <span class="o">=</span> <span class="n">curves</span><span class="p">[</span><span class="n">name</span><span class="p">][</span><span class="mi">1024</span><span class="p">:</span><span class="mi">2048</span><span class="p">].</span><span class="nf">mean</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
    <span class="n">beyond</span> <span class="o">=</span> <span class="n">curves</span><span class="p">[</span><span class="n">name</span><span class="p">][</span><span class="o">-</span><span class="mi">2048</span><span class="p">:].</span><span class="nf">mean</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">name</span><span class="si">:</span><span class="mi">12</span><span class="si">}</span><span class="s"> loss at 1–2k: </span><span class="si">{</span><span class="n">inside</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="s">, at the last 2k: </span><span class="si">{</span><span class="n">beyond</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/10/output-05.png" alt="Output of the code above" loading="lazy"></p> <pre class="tfs-printed"><code>mamba-130m   loss at 1–2k: 3.05, at the last 2k: 3.16
Pythia-160m  loss at 1–2k: 3.22, at the last 2k: 7.65</code></pre> <p>Mamba reads eight times past its training length with its loss barely moving: there is no position for it to get wrong, only a state that keeps being updated. Pythia climbs the same wall as TinyLlama in lesson 9, from the same cause, rotary pairs asked for angles they never showed. On this test the fixed state wins outright.</p> <p><strong>Copying.</strong> The second test asks for exactly what a fixed state can’t promise: repeat a list of random words. A Transformer can look back at every word it was shown; Mamba has to have squeezed all of them into its state.</p> <p>Jelassi and colleagues found in 2024 that even a 410-million-parameter Pythia beats a 2.8-billion-parameter Mamba at looking up a number in a long phone book, and the same gap shows on this simplest of tasks. Each prompt has one worked example and then a list of a given length; an answer counts when every word comes back in order.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">random</span>

<span class="n">rng</span> <span class="o">=</span> <span class="n">random</span><span class="p">.</span><span class="nc">Random</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">words</span> <span class="o">=</span> <span class="nf">sorted</span><span class="p">(</span>
    <span class="p">{</span><span class="n">w</span><span class="p">.</span><span class="nf">lower</span><span class="p">()</span> <span class="k">for</span> <span class="n">w</span> <span class="ow">in</span> <span class="n">pg19</span><span class="p">.</span><span class="n">text</span><span class="p">.</span><span class="n">iloc</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">split</span><span class="p">()</span> <span class="k">if</span> <span class="n">w</span><span class="p">.</span><span class="nf">isalpha</span><span class="p">()</span> <span class="ow">and</span> <span class="mi">3</span> <span class="o">&lt;=</span> <span class="nf">len</span><span class="p">(</span><span class="n">w</span><span class="p">)</span> <span class="o">&lt;=</span> <span class="mi">7</span><span class="p">}</span>
<span class="p">)</span>


<span class="k">def</span> <span class="nf">copy_prompt</span><span class="p">(</span><span class="n">n_words</span><span class="p">):</span>
    <span class="n">example</span> <span class="o">=</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">rng</span><span class="p">.</span><span class="nf">sample</span><span class="p">(</span><span class="n">words</span><span class="p">,</span> <span class="mi">6</span><span class="p">))</span>
    <span class="n">target</span> <span class="o">=</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">rng</span><span class="p">.</span><span class="nf">sample</span><span class="p">(</span><span class="n">words</span><span class="p">,</span> <span class="n">n_words</span><span class="p">))</span>
    <span class="n">text</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">Repeat the words exactly.</span><span class="se">\n</span><span class="s">Words: </span><span class="si">{</span><span class="n">example</span><span class="si">}</span><span class="se">\n</span><span class="s">Repeat: </span><span class="si">{</span><span class="n">example</span><span class="si">}</span><span class="se">\n\n</span><span class="sh">"</span>
    <span class="n">text</span> <span class="o">+=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">Words: </span><span class="si">{</span><span class="n">target</span><span class="si">}</span><span class="se">\n</span><span class="s">Repeat:</span><span class="sh">"</span>
    <span class="k">return</span> <span class="n">text</span><span class="p">,</span> <span class="n">target</span>


<span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">mamba_continue</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">steps</span><span class="p">):</span>
    <span class="n">states</span> <span class="o">=</span> <span class="nf">empty_states</span><span class="p">(</span><span class="n">model</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]):</span>
        <span class="n">logits</span><span class="p">,</span> <span class="n">states</span> <span class="o">=</span> <span class="nf">model_step</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">ids</span><span class="p">[:,</span> <span class="n">t</span><span class="p">].</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">),</span> <span class="n">states</span><span class="p">)</span>
    <span class="n">out</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">steps</span><span class="p">):</span>
        <span class="n">token</span> <span class="o">=</span> <span class="n">logits</span><span class="p">.</span><span class="nf">argmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">out</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">token</span><span class="p">.</span><span class="nf">item</span><span class="p">())</span>
        <span class="n">logits</span><span class="p">,</span> <span class="n">states</span> <span class="o">=</span> <span class="nf">model_step</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">token</span><span class="p">,</span> <span class="n">states</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">out</span>


<span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">pythia_continue</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">steps</span><span class="p">):</span>
    <span class="n">out</span> <span class="o">=</span> <span class="n">pythia</span><span class="p">.</span><span class="nf">generate</span><span class="p">(</span>
        <span class="n">ids</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">),</span> <span class="n">max_new_tokens</span><span class="o">=</span><span class="n">steps</span><span class="p">,</span> <span class="n">do_sample</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">pad_token_id</span><span class="o">=</span><span class="n">tok</span><span class="p">.</span><span class="n">eos_token_id</span>
    <span class="p">)</span>
    <span class="k">return</span> <span class="n">out</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span> <span class="p">:].</span><span class="nf">tolist</span><span class="p">()</span>


<span class="n">copy_lengths</span> <span class="o">=</span> <span class="p">[</span><span class="mi">5</span><span class="p">,</span> <span class="mi">10</span><span class="p">]</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="p">[</span><span class="mi">10</span><span class="p">,</span> <span class="mi">25</span><span class="p">,</span> <span class="mi">50</span><span class="p">,</span> <span class="mi">100</span><span class="p">,</span> <span class="mi">200</span><span class="p">]</span>
<span class="n">COPY_TRIALS</span> <span class="o">=</span> <span class="mi">2</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">10</span>
<span class="n">copied</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">mamba-130m</span><span class="sh">"</span><span class="p">:</span> <span class="p">[],</span> <span class="sh">"</span><span class="s">Pythia-160m</span><span class="sh">"</span><span class="p">:</span> <span class="p">[]}</span>
<span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="n">copy_lengths</span><span class="p">:</span>
    <span class="n">hits</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">mamba-130m</span><span class="sh">"</span><span class="p">:</span> <span class="mi">0</span><span class="p">,</span> <span class="sh">"</span><span class="s">Pythia-160m</span><span class="sh">"</span><span class="p">:</span> <span class="mi">0</span><span class="p">}</span>
    <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">COPY_TRIALS</span><span class="p">):</span>
        <span class="n">text</span><span class="p">,</span> <span class="n">target</span> <span class="o">=</span> <span class="nf">copy_prompt</span><span class="p">(</span><span class="n">n</span><span class="p">)</span>
        <span class="n">prompt</span> <span class="o">=</span> <span class="nf">tok</span><span class="p">(</span><span class="n">text</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="n">input_ids</span>
        <span class="n">steps</span> <span class="o">=</span> <span class="nf">len</span><span class="p">(</span><span class="nf">tok</span><span class="p">(</span><span class="sh">"</span><span class="s"> </span><span class="sh">"</span> <span class="o">+</span> <span class="n">target</span><span class="p">).</span><span class="n">input_ids</span><span class="p">)</span> <span class="o">+</span> <span class="mi">2</span>
        <span class="n">said</span> <span class="o">=</span> <span class="p">{</span>
            <span class="sh">"</span><span class="s">mamba-130m</span><span class="sh">"</span><span class="p">:</span> <span class="n">tok</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="nf">mamba_continue</span><span class="p">(</span><span class="n">mamba</span><span class="p">,</span> <span class="n">prompt</span><span class="p">,</span> <span class="n">steps</span><span class="p">)),</span>
            <span class="sh">"</span><span class="s">Pythia-160m</span><span class="sh">"</span><span class="p">:</span> <span class="n">tok</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="nf">pythia_continue</span><span class="p">(</span><span class="n">prompt</span><span class="p">,</span> <span class="n">steps</span><span class="p">)),</span>
        <span class="p">}</span>
        <span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">hits</span><span class="p">:</span>
            <span class="n">hits</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="o">+=</span> <span class="n">said</span><span class="p">[</span><span class="n">name</span><span class="p">].</span><span class="nf">strip</span><span class="p">().</span><span class="nf">startswith</span><span class="p">(</span><span class="n">target</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">hits</span><span class="p">:</span>
        <span class="n">copied</span><span class="p">[</span><span class="n">name</span><span class="p">].</span><span class="nf">append</span><span class="p">(</span><span class="n">hits</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="o">/</span> <span class="n">COPY_TRIALS</span><span class="p">)</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">7.2</span><span class="p">,</span> <span class="mf">3.2</span><span class="p">))</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">color</span> <span class="ow">in</span> <span class="p">[(</span><span class="sh">"</span><span class="s">Pythia-160m</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">]),</span> <span class="p">(</span><span class="sh">"</span><span class="s">mamba-130m</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">])]:</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">copy_lengths</span><span class="p">,</span> <span class="n">copied</span><span class="p">[</span><span class="n">name</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span> <span class="n">marker</span><span class="o">=</span><span class="sh">"</span><span class="s">o</span><span class="sh">"</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="n">name</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xscale</span><span class="p">(</span><span class="sh">"</span><span class="s">log</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xticks</span><span class="p">(</span><span class="n">copy_lengths</span><span class="p">,</span> <span class="p">[</span><span class="nf">str</span><span class="p">(</span><span class="n">n</span><span class="p">)</span> <span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="n">copy_lengths</span><span class="p">])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylim</span><span class="p">(</span><span class="o">-</span><span class="mf">0.05</span><span class="p">,</span> <span class="mf">1.05</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">words to repeat</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">lists repeated exactly</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">Repeating a list of random words, </span><span class="si">{</span><span class="n">COPY_TRIALS</span><span class="si">}</span><span class="s"> lists per length</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/10/output-06.png" alt="Output of the code above" loading="lazy"></p> <p>On the shortest lists the two are close. From there Mamba falls behind fast and soon copies no list at all, while Pythia still gets some of the longer lists right, because every word it needs is still in its cache, one lookup away; Mamba’s state has to hold the whole list at once in a fixed number of numbers, and the longer the list, the less of each word survives.</p> <p>Neither model is a good copyist at this size, and at the longest lists both fail, but the gap points the way Jelassi and colleagues found at scale. This is the trade at the heart of the architecture: a state that doesn’t grow is a state that can’t hold everything.</p> <p>For most of language that is fine, because most of what we read doesn’t have to be recalled word for word. For the parts that do, a little attention goes a long way, which is the idea of the next section.</p> <h2 id="10-hybrids">10. Hybrids</h2> <p>The answer the industry settled on is not “Mamba or attention” but a mixture: mostly recurrent layers for cheap long reading, and a few attention layers that can look anything up.</p> <p>The Mamba-2 paper measured the ratio itself, on a 350-million-parameter model: replacing about one layer in ten with attention gave the best perplexity, better than either pure design. Here are the layouts of seven recent models, read from their configs. Each config describes its layout in its own way, so each needs a line of its own.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">layout</span><span class="p">(</span><span class="n">repo</span><span class="p">):</span>
    <span class="n">c</span> <span class="o">=</span> <span class="nf">read_hybrid_config</span><span class="p">(</span><span class="n">repo</span><span class="p">)</span>
    <span class="n">n</span> <span class="o">=</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">)</span> <span class="ow">or</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">n_layer</span><span class="sh">"</span><span class="p">)</span>
    <span class="k">if</span> <span class="sh">"</span><span class="s">hybrid_override_pattern</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">c</span><span class="p">:</span>  <span class="c1"># Nemotron-H: M Mamba, * attention, - an MLP layer
</span>        <span class="n">names</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">M</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">ssm</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">*</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">mlp</span><span class="sh">"</span><span class="p">}</span>
        <span class="k">return</span> <span class="p">[</span><span class="n">names</span><span class="p">[</span><span class="n">ch</span><span class="p">]</span> <span class="k">for</span> <span class="n">ch</span> <span class="ow">in</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hybrid_override_pattern</span><span class="sh">"</span><span class="p">]]</span>
    <span class="k">if</span> <span class="sh">"</span><span class="s">layer_types</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">c</span><span class="p">:</span>  <span class="c1"># Granite 4.0
</span>        <span class="k">return</span> <span class="p">[</span><span class="sh">"</span><span class="s">attention</span><span class="sh">"</span> <span class="k">if</span> <span class="sh">"</span><span class="s">attention</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">t</span> <span class="k">else</span> <span class="sh">"</span><span class="s">ssm</span><span class="sh">"</span> <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">layer_types</span><span class="sh">"</span><span class="p">]]</span>
    <span class="k">if</span> <span class="sh">"</span><span class="s">layers_block_type</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">c</span><span class="p">:</span>  <span class="c1"># Zamba2: "hybrid" layers add a shared attention block
</span>        <span class="k">return</span> <span class="p">[</span><span class="sh">"</span><span class="s">attention</span><span class="sh">"</span> <span class="k">if</span> <span class="n">t</span> <span class="o">==</span> <span class="sh">"</span><span class="s">hybrid</span><span class="sh">"</span> <span class="k">else</span> <span class="sh">"</span><span class="s">ssm</span><span class="sh">"</span> <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">layers_block_type</span><span class="sh">"</span><span class="p">]]</span>
    <span class="k">if</span> <span class="sh">"</span><span class="s">attn_layer_period</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">c</span><span class="p">:</span>  <span class="c1"># Jamba
</span>        <span class="n">period</span><span class="p">,</span> <span class="n">offset</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">attn_layer_period</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">attn_layer_offset</span><span class="sh">"</span><span class="p">]</span>
        <span class="k">return</span> <span class="p">[</span><span class="sh">"</span><span class="s">attention</span><span class="sh">"</span> <span class="k">if</span> <span class="n">i</span> <span class="o">%</span> <span class="n">period</span> <span class="o">==</span> <span class="n">offset</span> <span class="k">else</span> <span class="sh">"</span><span class="s">ssm</span><span class="sh">"</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n</span><span class="p">)]</span>
    <span class="k">if</span> <span class="sh">"</span><span class="s">full_attention_interval</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">c</span><span class="p">:</span>  <span class="c1"># Qwen3-Next: Gated DeltaNet, then attention
</span>        <span class="n">k</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">full_attention_interval</span><span class="sh">"</span><span class="p">]</span>
        <span class="k">return</span> <span class="p">[</span><span class="sh">"</span><span class="s">attention</span><span class="sh">"</span> <span class="nf">if </span><span class="p">(</span><span class="n">i</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">%</span> <span class="n">k</span> <span class="o">==</span> <span class="mi">0</span> <span class="k">else</span> <span class="sh">"</span><span class="s">linear</span><span class="sh">"</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n</span><span class="p">)]</span>
    <span class="k">if</span> <span class="sh">"</span><span class="s">linear_attn_config</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">c</span><span class="p">:</span>  <span class="c1"># Kimi Linear: its attention layers are counted from 1
</span>        <span class="n">full</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">linear_attn_config</span><span class="sh">"</span><span class="p">][</span><span class="sh">"</span><span class="s">full_attn_layers</span><span class="sh">"</span><span class="p">]</span>
        <span class="k">return</span> <span class="p">[</span><span class="sh">"</span><span class="s">attention</span><span class="sh">"</span> <span class="k">if</span> <span class="n">i</span> <span class="o">+</span> <span class="mi">1</span> <span class="ow">in</span> <span class="n">full</span> <span class="k">else</span> <span class="sh">"</span><span class="s">linear</span><span class="sh">"</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n</span><span class="p">)]</span>
    <span class="k">if</span> <span class="sh">"</span><span class="s">attn_layer_idx</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">c</span><span class="p">:</span>  <span class="c1"># Mamba-2 with attention, from the Mamba-2 paper
</span>        <span class="k">return</span> <span class="p">[</span><span class="sh">"</span><span class="s">attention</span><span class="sh">"</span> <span class="k">if</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">attn_layer_idx</span><span class="sh">"</span><span class="p">]</span> <span class="k">else</span> <span class="sh">"</span><span class="s">ssm</span><span class="sh">"</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n</span><span class="p">)]</span>
    <span class="k">return</span> <span class="p">[</span><span class="sh">"</span><span class="s">ssm</span><span class="sh">"</span><span class="p">]</span> <span class="o">*</span> <span class="n">n</span>


<span class="k">def</span> <span class="nf">read_hybrid_config</span><span class="p">(</span><span class="n">repo</span><span class="p">):</span>
    <span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">repo</span><span class="p">,</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">))</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
        <span class="n">c</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">f</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">text_config</span><span class="sh">"</span><span class="p">,</span> <span class="n">c</span><span class="p">)</span>


<span class="n">HYBRIDS</span> <span class="o">=</span> <span class="p">[</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">state-spaces/mamba2attn-2.7b</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Mamba-2 + attention, 2024</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">ai21labs/Jamba-v0.1</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Jamba, AI21, 2024</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">Zyphra/Zamba2-1.2B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Zamba2, Zyphra, 2024</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">nvidia/Nemotron-H-8B-Base-8K</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Nemotron-H, NVIDIA, 2025</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">ibm-granite/granite-4.0-h-tiny</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Granite 4.0 H, IBM, 2025</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">Qwen/Qwen3-Next-80B-A3B-Instruct</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Qwen3-Next, 2025</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">moonshotai/Kimi-Linear-48B-A3B-Instruct</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Kimi Linear, 2025</span><span class="sh">"</span><span class="p">),</span>
<span class="p">]</span>
<span class="n">layouts</span> <span class="o">=</span> <span class="p">{</span><span class="n">name</span><span class="p">:</span> <span class="nf">layout</span><span class="p">(</span><span class="n">repo</span><span class="p">)</span> <span class="k">for</span> <span class="n">repo</span><span class="p">,</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">HYBRIDS</span><span class="p">}</span>
<span class="n">colors</span> <span class="o">=</span> <span class="p">{</span>
    <span class="sh">"</span><span class="s">attention</span><span class="sh">"</span><span class="p">:</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">],</span>
    <span class="sh">"</span><span class="s">ssm</span><span class="sh">"</span><span class="p">:</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">],</span>
    <span class="sh">"</span><span class="s">linear</span><span class="sh">"</span><span class="p">:</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">],</span>
    <span class="sh">"</span><span class="s">mlp</span><span class="sh">"</span><span class="p">:</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">],</span>
<span class="p">}</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">10.4</span><span class="p">,</span> <span class="mf">3.6</span><span class="p">))</span>
<span class="k">for</span> <span class="n">row</span><span class="p">,</span> <span class="n">kinds</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">layouts</span><span class="p">.</span><span class="nf">values</span><span class="p">()):</span>
    <span class="k">for</span> <span class="n">col</span><span class="p">,</span> <span class="n">kind</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">kinds</span><span class="p">):</span>
        <span class="n">ax</span><span class="p">.</span><span class="nf">add_patch</span><span class="p">(</span><span class="n">plt</span><span class="p">.</span><span class="nc">Rectangle</span><span class="p">((</span><span class="n">col</span><span class="p">,</span> <span class="o">-</span><span class="n">row</span> <span class="o">-</span> <span class="mf">0.4</span><span class="p">),</span> <span class="mf">0.9</span><span class="p">,</span> <span class="mf">0.8</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">colors</span><span class="p">[</span><span class="n">kind</span><span class="p">]))</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlim</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">max</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">k</span><span class="p">)</span> <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="n">layouts</span><span class="p">.</span><span class="nf">values</span><span class="p">()))</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylim</span><span class="p">(</span><span class="o">-</span><span class="nf">len</span><span class="p">(</span><span class="n">layouts</span><span class="p">)</span> <span class="o">+</span> <span class="mf">0.4</span><span class="p">,</span> <span class="mf">0.6</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_yticks</span><span class="p">([</span><span class="o">-</span><span class="n">i</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">layouts</span><span class="p">))],</span> <span class="nf">list</span><span class="p">(</span><span class="n">layouts</span><span class="p">))</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">layer</span><span class="sh">"</span><span class="p">)</span>
<span class="k">for</span> <span class="n">kind</span><span class="p">,</span> <span class="n">label</span> <span class="ow">in</span> <span class="p">[</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">attention</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">attention</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">ssm</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Mamba</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">linear</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">linear attention</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">mlp</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">MLP only</span><span class="sh">"</span><span class="p">),</span>
<span class="p">]:</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">([],</span> <span class="p">[],</span> <span class="n">color</span><span class="o">=</span><span class="n">colors</span><span class="p">[</span><span class="n">kind</span><span class="p">],</span> <span class="n">linewidth</span><span class="o">=</span><span class="mi">8</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="n">label</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">ncol</span><span class="o">=</span><span class="mi">4</span><span class="p">,</span> <span class="n">loc</span><span class="o">=</span><span class="sh">"</span><span class="s">upper center</span><span class="sh">"</span><span class="p">,</span> <span class="n">bbox_to_anchor</span><span class="o">=</span><span class="p">(</span><span class="mf">0.5</span><span class="p">,</span> <span class="mf">1.18</span><span class="p">))</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>

<span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">kinds</span> <span class="ow">in</span> <span class="n">layouts</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
    <span class="n">mixing</span> <span class="o">=</span> <span class="p">[</span><span class="n">k</span> <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="n">kinds</span> <span class="k">if</span> <span class="n">k</span> <span class="o">!=</span> <span class="sh">"</span><span class="s">mlp</span><span class="sh">"</span><span class="p">]</span>
    <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
        <span class="p">{</span>
            <span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">layers that mix tokens</span><span class="sh">"</span><span class="p">:</span> <span class="nf">len</span><span class="p">(</span><span class="n">mixing</span><span class="p">),</span>
            <span class="sh">"</span><span class="s">attention</span><span class="sh">"</span><span class="p">:</span> <span class="n">mixing</span><span class="p">.</span><span class="nf">count</span><span class="p">(</span><span class="sh">"</span><span class="s">attention</span><span class="sh">"</span><span class="p">),</span>
            <span class="sh">"</span><span class="s">share of attention</span><span class="sh">"</span><span class="p">:</span> <span class="n">mixing</span><span class="p">.</span><span class="nf">count</span><span class="p">(</span><span class="sh">"</span><span class="s">attention</span><span class="sh">"</span><span class="p">)</span> <span class="o">/</span> <span class="nf">len</span><span class="p">(</span><span class="n">mixing</span><span class="p">),</span>
        <span class="p">}</span>
    <span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/10/output-07.png" alt="Output of the code above" loading="lazy"></p> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">model</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">layers that mix tokens</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">attention</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">share of attention</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Mamba-2 + attention, 2024</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">64</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.09</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Jamba, AI21, 2024</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.12</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Zamba2, Zyphra, 2024</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">38</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.16</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Nemotron-H, NVIDIA, 2025</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">28</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.14</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Granite 4.0 H, IBM, 2025</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">40</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.10</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Qwen3-Next, 2025</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">48</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">12</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.25</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Kimi Linear, 2025</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">27</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.26</td></tr></tbody></table></div> <p>The shares cluster where the Mamba-2 paper found its optimum: one attention layer in four to one in ten, spread evenly through the depth. Two other designs exist.</p> <p>Falcon-H1 from TII runs attention and Mamba-2 heads <em>in parallel</em> inside every layer instead of alternating them, and Qwen3-Next and Kimi Linear replace Mamba with a different recurrence, the gated delta rule, which writes into its state more selectively; that family is the subject of <a href="https://blog.korolevalab.com/blog/2026/hybrid-attention/">a separate post on hybrid attention</a>.</p> <p>Not everyone stayed: MiniMax used linear attention in most layers of MiniMax-01 and went back to full attention in every layer for MiniMax-M2.</p> <h2 id="11-what-selectivity-buys">11. What selectivity buys</h2> <p>Section 3 claimed that a layer whose step, \(B\) and \(C\) depend on the token can do something a time-invariant one can’t: pick a few tokens out of a stream of noise and keep only those. Time to check, with <em>selective copying</em>, the toy task from the Mamba paper.</p> <p>A sequence of 256 tokens is mostly noise; sixteen of its positions, chosen at random, hold coloured tokens, one of sixteen colours each; then come sixteen markers, and at the markers the model must say the coloured tokens back, in order. Guessing gets one in sixteen right.</p> <p>Two models are trained from scratch, two Mamba-2 layers of width 64 each, identical except for one thing. In the first, the step, \(B\) and \(C\) come from each token, as in Mamba.</p> <p>In the second, they are learned constants, the same for every token, which makes the state space part linear and time-invariant, the kind of layer S4 was. <code class="language-plaintext highlighter-rouge">Mixer2</code> asks its <code class="language-plaintext highlighter-rouge">select</code> method for the three; the second model only replaces that method.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">COLOURS</span><span class="p">,</span> <span class="n">TO_COPY</span> <span class="o">=</span> <span class="mi">16</span><span class="p">,</span> <span class="mi">16</span>
<span class="n">MARKER</span> <span class="o">=</span> <span class="n">COLOURS</span> <span class="o">+</span> <span class="mi">1</span>  <span class="c1"># 0 is noise, 1 to 16 are the colours
</span>

<span class="k">def</span> <span class="nf">copying_batch</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="n">length</span><span class="p">):</span>
    <span class="c1"># TO_COPY coloured tokens at random places among `length` noise tokens, then markers
</span>    <span class="n">where</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">rand</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="n">length</span><span class="p">).</span><span class="nf">argsort</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)[:,</span> <span class="p">:</span><span class="n">TO_COPY</span><span class="p">].</span><span class="nf">sort</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">).</span><span class="n">values</span>
    <span class="n">colours</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randint</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">COLOURS</span> <span class="o">+</span> <span class="mi">1</span><span class="p">,</span> <span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="n">TO_COPY</span><span class="p">))</span>
    <span class="n">ids</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="n">length</span> <span class="o">+</span> <span class="n">TO_COPY</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">long</span><span class="p">)</span>
    <span class="n">ids</span><span class="p">.</span><span class="nf">scatter_</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">where</span><span class="p">,</span> <span class="n">colours</span><span class="p">)</span>
    <span class="n">ids</span><span class="p">[:,</span> <span class="n">length</span><span class="p">:]</span> <span class="o">=</span> <span class="n">MARKER</span>
    <span class="k">return</span> <span class="n">ids</span><span class="p">,</span> <span class="n">colours</span>


<span class="k">class</span> <span class="nc">FixedMixer2</span><span class="p">(</span><span class="n">Mixer2</span><span class="p">):</span>
    <span class="sh">"""</span><span class="s">The same layer with one step, B and C learned for all tokens, as in S4.</span><span class="sh">"""</span>

    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">(</span><span class="n">c</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">b_fixed</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">groups</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">n</span><span class="p">)</span> <span class="o">/</span> <span class="n">self</span><span class="p">.</span><span class="n">n</span><span class="o">**</span><span class="mf">0.5</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">c_fixed</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">groups</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">n</span><span class="p">)</span> <span class="o">/</span> <span class="n">self</span><span class="p">.</span><span class="n">n</span><span class="o">**</span><span class="mf">0.5</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">select</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">dt</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
        <span class="n">step</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">softplus</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">dt_bias</span><span class="p">.</span><span class="nf">float</span><span class="p">()).</span><span class="nf">expand</span><span class="p">(</span><span class="n">dt</span><span class="p">.</span><span class="n">shape</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">step</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">b_fixed</span><span class="p">.</span><span class="nf">expand</span><span class="p">(</span><span class="n">b</span><span class="p">.</span><span class="n">shape</span><span class="p">),</span> <span class="n">self</span><span class="p">.</span><span class="n">c_fixed</span><span class="p">.</span><span class="nf">expand</span><span class="p">(</span><span class="n">c</span><span class="p">.</span><span class="n">shape</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">copier</span><span class="p">(</span><span class="n">mixer</span><span class="p">):</span>
    <span class="n">c</span> <span class="o">=</span> <span class="nf">dict</span><span class="p">(</span>
        <span class="n">vocab_size</span><span class="o">=</span><span class="n">COLOURS</span> <span class="o">+</span> <span class="mi">2</span><span class="p">,</span>
        <span class="n">hidden_size</span><span class="o">=</span><span class="mi">64</span><span class="p">,</span>
        <span class="n">num_heads</span><span class="o">=</span><span class="mi">4</span><span class="p">,</span>
        <span class="n">head_dim</span><span class="o">=</span><span class="mi">32</span><span class="p">,</span>
        <span class="n">state_size</span><span class="o">=</span><span class="mi">32</span><span class="p">,</span>
        <span class="n">n_groups</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span>
        <span class="n">conv_kernel</span><span class="o">=</span><span class="mi">4</span><span class="p">,</span>
        <span class="n">num_hidden_layers</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span>
        <span class="n">layer_norm_epsilon</span><span class="o">=</span><span class="mf">1e-5</span><span class="p">,</span>
        <span class="n">chunk_size</span><span class="o">=</span><span class="mi">64</span><span class="p">,</span>
    <span class="p">)</span>
    <span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
    <span class="n">model</span> <span class="o">=</span> <span class="nc">Mamba2</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="n">mixer</span><span class="p">)</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>  <span class="c1"># Mamba's initialisation: several time scales, small steps
</span>        <span class="k">for</span> <span class="n">block</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
            <span class="n">m</span> <span class="o">=</span> <span class="n">block</span><span class="p">.</span><span class="n">mixer</span>
            <span class="n">m</span><span class="p">.</span><span class="n">A_log</span><span class="p">.</span><span class="nf">copy_</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">log</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">linspace</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">16</span><span class="p">,</span> <span class="n">m</span><span class="p">.</span><span class="n">heads</span><span class="p">)))</span>
            <span class="n">step</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">logspace</span><span class="p">(</span><span class="o">-</span><span class="mi">3</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="n">m</span><span class="p">.</span><span class="n">heads</span><span class="p">)</span>
            <span class="n">m</span><span class="p">.</span><span class="n">dt_bias</span><span class="p">.</span><span class="nf">copy_</span><span class="p">(</span><span class="n">step</span> <span class="o">+</span> <span class="n">torch</span><span class="p">.</span><span class="nf">log</span><span class="p">(</span><span class="o">-</span><span class="n">torch</span><span class="p">.</span><span class="nf">expm1</span><span class="p">(</span><span class="o">-</span><span class="n">step</span><span class="p">)))</span>  <span class="c1"># softplus inverse
</span>    <span class="k">return</span> <span class="n">model</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>


<span class="n">ids</span><span class="p">,</span> <span class="n">colours</span> <span class="o">=</span> <span class="nf">copying_batch</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">64</span><span class="p">)</span>
<span class="n">glyph</span> <span class="o">=</span> <span class="p">{</span><span class="mi">0</span><span class="p">:</span> <span class="sh">"</span><span class="s">·</span><span class="sh">"</span><span class="p">,</span> <span class="n">MARKER</span><span class="p">:</span> <span class="sh">"</span><span class="s">?</span><span class="sh">"</span><span class="p">}</span>
<span class="n">shown</span> <span class="o">=</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">glyph</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="n">t</span><span class="p">,</span> <span class="nf">str</span><span class="p">(</span><span class="n">t</span><span class="p">))</span> <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="n">ids</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">tolist</span><span class="p">())</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">one sequence, 64 noise tokens shown as dots:</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="n">shown</span><span class="p">[:</span><span class="mi">94</span><span class="p">])</span>
<span class="nf">print</span><span class="p">(</span><span class="n">shown</span><span class="p">[</span><span class="mi">94</span><span class="p">:])</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">the answer:</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="nf">map</span><span class="p">(</span><span class="nb">str</span><span class="p">,</span> <span class="n">colours</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">tolist</span><span class="p">())))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>one sequence, 64 noise tokens shown as dots:
13 · · · · 1 · 10 14 · 1 · · · · · 10 · · 2 · · · · · 7 · · · · · · · · · · 16 10 · 11 13 9 · 
· 2 · · · · · · · · · 2 · · · · · · · 16 · ? ? ? ? ? ? ? ? ? ? ? ? ? ? ? ?
the answer: 13 1 10 14 1 10 2 7 16 10 11 13 9 2 2 16</code></pre> <p>The model answers the way a language model does, one position ahead: its output at the last noise token names the first colour, and its output at each marker the next one. Both models get the same budget: 6,000 steps of 64 sequences, a few minutes each on a T4.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">COPY_LENGTH</span> <span class="o">=</span> <span class="mi">64</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">256</span>
<span class="n">COPY_STEPS</span> <span class="o">=</span> <span class="mi">40</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">6000</span>


<span class="k">def</span> <span class="nf">copying_accuracy</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">length</span><span class="p">,</span> <span class="n">n</span><span class="o">=</span><span class="mi">512</span><span class="p">):</span>
    <span class="n">ids</span><span class="p">,</span> <span class="n">colours</span> <span class="o">=</span> <span class="nf">copying_batch</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="n">length</span><span class="p">)</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="n">guess</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">ids</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">))[:,</span> <span class="n">length</span> <span class="o">-</span> <span class="mi">1</span> <span class="p">:</span> <span class="n">length</span> <span class="o">+</span> <span class="n">TO_COPY</span> <span class="o">-</span> <span class="mi">1</span><span class="p">].</span><span class="nf">argmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
    <span class="nf">return </span><span class="p">(</span><span class="n">guess</span><span class="p">.</span><span class="nf">cpu</span><span class="p">()</span> <span class="o">==</span> <span class="n">colours</span><span class="p">).</span><span class="nf">float</span><span class="p">().</span><span class="nf">mean</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>


<span class="k">def</span> <span class="nf">train_copier</span><span class="p">(</span><span class="n">mixer</span><span class="p">):</span>
    <span class="n">model</span> <span class="o">=</span> <span class="nf">copier</span><span class="p">(</span><span class="n">mixer</span><span class="p">)</span>
    <span class="n">opt</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">optim</span><span class="p">.</span><span class="nc">AdamW</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="nf">parameters</span><span class="p">(),</span> <span class="n">lr</span><span class="o">=</span><span class="mf">3e-3</span><span class="p">,</span> <span class="n">weight_decay</span><span class="o">=</span><span class="mf">0.0</span><span class="p">)</span>
    <span class="n">schedule</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">optim</span><span class="p">.</span><span class="n">lr_scheduler</span><span class="p">.</span><span class="nc">OneCycleLR</span><span class="p">(</span>
        <span class="n">opt</span><span class="p">,</span> <span class="n">max_lr</span><span class="o">=</span><span class="mf">3e-3</span><span class="p">,</span> <span class="n">total_steps</span><span class="o">=</span><span class="n">COPY_STEPS</span><span class="p">,</span> <span class="n">pct_start</span><span class="o">=</span><span class="mf">0.1</span>
    <span class="p">)</span>
    <span class="n">curve</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">step</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">COPY_STEPS</span> <span class="o">+</span> <span class="mi">1</span><span class="p">):</span>
        <span class="n">ids</span><span class="p">,</span> <span class="n">colours</span> <span class="o">=</span> <span class="nf">copying_batch</span><span class="p">(</span><span class="mi">64</span><span class="p">,</span> <span class="n">COPY_LENGTH</span><span class="p">)</span>
        <span class="n">logits</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">ids</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">))[:,</span> <span class="n">COPY_LENGTH</span> <span class="o">-</span> <span class="mi">1</span> <span class="p">:</span> <span class="n">COPY_LENGTH</span> <span class="o">+</span> <span class="n">TO_COPY</span> <span class="o">-</span> <span class="mi">1</span><span class="p">]</span>
        <span class="n">target</span> <span class="o">=</span> <span class="n">colours</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">loss</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span><span class="n">logits</span><span class="p">.</span><span class="nf">reshape</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="n">COLOURS</span> <span class="o">+</span> <span class="mi">2</span><span class="p">),</span> <span class="n">target</span><span class="p">)</span>
        <span class="n">opt</span><span class="p">.</span><span class="nf">zero_grad</span><span class="p">()</span>
        <span class="n">loss</span><span class="p">.</span><span class="nf">backward</span><span class="p">()</span>
        <span class="n">nn</span><span class="p">.</span><span class="n">utils</span><span class="p">.</span><span class="nf">clip_grad_norm_</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="nf">parameters</span><span class="p">(),</span> <span class="mf">1.0</span><span class="p">)</span>
        <span class="n">opt</span><span class="p">.</span><span class="nf">step</span><span class="p">()</span>
        <span class="n">schedule</span><span class="p">.</span><span class="nf">step</span><span class="p">()</span>
        <span class="k">if</span> <span class="n">step</span> <span class="o">%</span> <span class="nf">max</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">COPY_STEPS</span> <span class="o">//</span> <span class="mi">24</span><span class="p">)</span> <span class="o">==</span> <span class="mi">0</span><span class="p">:</span>
            <span class="n">curve</span><span class="p">.</span><span class="nf">append</span><span class="p">((</span><span class="n">step</span><span class="p">,</span> <span class="nf">copying_accuracy</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">COPY_LENGTH</span><span class="p">)))</span>
    <span class="k">return</span> <span class="n">model</span><span class="p">,</span> <span class="n">curve</span>


<span class="n">copiers</span><span class="p">,</span> <span class="n">curves</span> <span class="o">=</span> <span class="p">{},</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">mixer</span> <span class="ow">in</span> <span class="p">[(</span><span class="sh">"</span><span class="s">selective</span><span class="sh">"</span><span class="p">,</span> <span class="n">Mixer2</span><span class="p">),</span> <span class="p">(</span><span class="sh">"</span><span class="s">fixed step, B and C</span><span class="sh">"</span><span class="p">,</span> <span class="n">FixedMixer2</span><span class="p">)]:</span>
    <span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
    <span class="n">copiers</span><span class="p">[</span><span class="n">name</span><span class="p">],</span> <span class="n">curves</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="o">=</span> <span class="nf">train_copier</span><span class="p">(</span><span class="n">mixer</span><span class="p">)</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">name</span><span class="si">:</span><span class="mi">20</span><span class="si">}</span><span class="s"> accuracy </span><span class="si">{</span><span class="n">curves</span><span class="p">[</span><span class="n">name</span><span class="p">][</span><span class="o">-</span><span class="mi">1</span><span class="p">][</span><span class="mi">1</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">3</span><span class="n">f</span><span class="si">}</span><span class="s">  in </span><span class="si">{</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> s</span><span class="sh">"</span><span class="p">)</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.4</span><span class="p">,</span> <span class="mf">3.4</span><span class="p">))</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">color</span> <span class="ow">in</span> <span class="p">[(</span><span class="sh">"</span><span class="s">selective</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">]),</span> <span class="p">(</span><span class="sh">"</span><span class="s">fixed step, B and C</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">])]:</span>
    <span class="n">steps</span><span class="p">,</span> <span class="n">accuracy</span> <span class="o">=</span> <span class="nf">zip</span><span class="p">(</span><span class="o">*</span><span class="n">curves</span><span class="p">[</span><span class="n">name</span><span class="p">])</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">steps</span><span class="p">,</span> <span class="n">accuracy</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span> <span class="n">marker</span><span class="o">=</span><span class="sh">"</span><span class="s">o</span><span class="sh">"</span><span class="p">,</span> <span class="n">markersize</span><span class="o">=</span><span class="mi">3</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="n">name</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">axhline</span><span class="p">(</span><span class="mi">1</span> <span class="o">/</span> <span class="n">COLOURS</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">],</span> <span class="n">linestyle</span><span class="o">=</span><span class="sh">"</span><span class="s">:</span><span class="sh">"</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
<span class="n">guess_y</span> <span class="o">=</span> <span class="mi">1</span> <span class="o">/</span> <span class="n">COLOURS</span> <span class="o">+</span> <span class="mf">0.03</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">text</span><span class="p">(</span><span class="n">COPY_STEPS</span><span class="p">,</span> <span class="n">guess_y</span><span class="p">,</span> <span class="sh">"</span><span class="s">guessing</span><span class="sh">"</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">],</span> <span class="n">ha</span><span class="o">=</span><span class="sh">"</span><span class="s">right</span><span class="sh">"</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">9</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylim</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mf">1.02</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">training step</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">coloured tokens copied</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">Selective copying, </span><span class="si">{</span><span class="n">COPY_LENGTH</span><span class="si">}</span><span class="s"> tokens, two Mamba-2 layers</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <pre class="tfs-printed"><code>selective            accuracy 0.997  in 235 s
fixed step, B and C  accuracy 0.065  in 231 s</code></pre> <p><img class="tfs-output" src="/assets/posts/arch/10/output-08.png" alt="Output of the code above" loading="lazy"></p> <p>The selective model learns the task within the budget, almost to the last token; the fixed one never leaves the guessing line. The paper trained a layer of this fixed kind far longer and it reached about half, but not more: whatever it does, it has to write every token into its state the same way, noise included.</p> <p>Why does one work and the other not? The selective model’s own steps answer it. Here is one sequence, and for each position the step \(\Delta\) that the second layer chose, averaged over its four heads: a large step writes the token into the state and lets the old contents fade, a step near zero lets the token pass as if it weren’t there.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">model</span> <span class="o">=</span> <span class="n">copiers</span><span class="p">[</span><span class="sh">"</span><span class="s">selective</span><span class="sh">"</span><span class="p">]</span>
<span class="n">mixer</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="n">layers</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="n">mixer</span>
<span class="n">mixer</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="bp">True</span>
<span class="n">ids</span><span class="p">,</span> <span class="n">colours</span> <span class="o">=</span> <span class="nf">copying_batch</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">COPY_LENGTH</span><span class="p">)</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="nf">model</span><span class="p">(</span><span class="n">ids</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">))</span>
<span class="n">mixer</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="bp">False</span>
<span class="n">chosen</span> <span class="o">=</span> <span class="n">mixer</span><span class="p">.</span><span class="n">parts</span><span class="p">[</span><span class="mi">1</span><span class="p">][</span><span class="mi">0</span><span class="p">].</span><span class="nf">mean</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">).</span><span class="nf">cpu</span><span class="p">().</span><span class="nf">numpy</span><span class="p">()</span>  <span class="c1"># (positions,), the step of every token
</span><span class="n">kind</span> <span class="o">=</span> <span class="n">ids</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">numpy</span><span class="p">()</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">11</span><span class="p">,</span> <span class="mf">2.8</span><span class="p">))</span>
<span class="k">for</span> <span class="n">which</span><span class="p">,</span> <span class="n">color</span><span class="p">,</span> <span class="n">label</span> <span class="ow">in</span> <span class="p">[</span>
    <span class="p">(</span><span class="n">kind</span> <span class="o">==</span> <span class="mi">0</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">],</span> <span class="sh">"</span><span class="s">noise</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">((</span><span class="n">kind</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">)</span> <span class="o">&amp;</span> <span class="p">(</span><span class="n">kind</span> <span class="o">&lt;=</span> <span class="n">COLOURS</span><span class="p">),</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">],</span> <span class="sh">"</span><span class="s">coloured</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="n">kind</span> <span class="o">==</span> <span class="n">MARKER</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">data</span><span class="sh">"</span><span class="p">],</span> <span class="sh">"</span><span class="s">marker</span><span class="sh">"</span><span class="p">),</span>
<span class="p">]:</span>
    <span class="n">where</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">flatnonzero</span><span class="p">(</span><span class="n">which</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">bar</span><span class="p">(</span><span class="n">where</span><span class="p">,</span> <span class="n">chosen</span><span class="p">[</span><span class="n">where</span><span class="p">],</span> <span class="n">width</span><span class="o">=</span><span class="mf">1.0</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="n">label</span><span class="p">)</span>
<span class="n">fixed</span> <span class="o">=</span> <span class="n">copiers</span><span class="p">[</span><span class="sh">"</span><span class="s">fixed step, B and C</span><span class="sh">"</span><span class="p">].</span><span class="n">layers</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="n">mixer</span>
<span class="n">fixed_step</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">softplus</span><span class="p">(</span><span class="n">fixed</span><span class="p">.</span><span class="n">dt_bias</span><span class="p">).</span><span class="nf">mean</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">axhline</span><span class="p">(</span><span class="n">fixed_step</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">],</span> <span class="n">linestyle</span><span class="o">=</span><span class="sh">"</span><span class="s">--</span><span class="sh">"</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
<span class="n">note</span> <span class="o">=</span> <span class="sh">"</span><span class="s">the fixed model</span><span class="sh">'</span><span class="s">s step, the same for every token</span><span class="sh">"</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">text</span><span class="p">(</span><span class="mi">2</span><span class="p">,</span> <span class="n">fixed_step</span> <span class="o">*</span> <span class="mf">1.15</span><span class="p">,</span> <span class="n">note</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">],</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">9</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">position in the sequence</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">step Δ, layer 2</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">What the selective model writes down: only the coloured tokens</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">ncol</span><span class="o">=</span><span class="mi">3</span><span class="p">,</span> <span class="n">loc</span><span class="o">=</span><span class="sh">"</span><span class="s">upper left</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">which</span> <span class="ow">in</span> <span class="p">[(</span><span class="sh">"</span><span class="s">coloured</span><span class="sh">"</span><span class="p">,</span> <span class="p">(</span><span class="n">kind</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">)</span> <span class="o">&amp;</span> <span class="p">(</span><span class="n">kind</span> <span class="o">&lt;=</span> <span class="n">COLOURS</span><span class="p">)),</span> <span class="p">(</span><span class="sh">"</span><span class="s">noise</span><span class="sh">"</span><span class="p">,</span> <span class="n">kind</span> <span class="o">==</span> <span class="mi">0</span><span class="p">)]:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">mean step on </span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="s"> tokens: </span><span class="si">{</span><span class="n">chosen</span><span class="p">[</span><span class="n">which</span><span class="p">].</span><span class="nf">mean</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">4</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/10/output-09.png" alt="What the selective model writes down: only the coloured tokens" loading="lazy"></p> <pre class="tfs-printed"><code>mean step on coloured tokens: 0.3641
mean step on noise tokens: 0.0297</code></pre> <p>Nobody told the model which tokens matter. It learned to give the coloured tokens large steps and the noise steps close to zero, so that the noise passes through without touching the state.</p> <p>The exception is the very start, where noise gets large steps too: the state holds nothing yet, writing over it costs nothing, and training never had a reason to push those steps down.</p> <p>The fixed model has one step for everything and writes the noise in as eagerly as the colours, and sixteen colours drown in hundreds of noise tokens.</p> <p>A state that only opens for what matters doesn’t care how much noise surrounds it. The test below keeps the sixteen coloured tokens and grows the noise to two, four and eight times the length the models were trained on.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">factor</span> <span class="ow">in</span> <span class="p">[</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">4</span><span class="p">,</span> <span class="mi">8</span><span class="p">]:</span>
    <span class="n">length</span> <span class="o">=</span> <span class="n">COPY_LENGTH</span> <span class="o">*</span> <span class="n">factor</span>
    <span class="n">row</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">noise tokens</span><span class="sh">"</span><span class="p">:</span> <span class="n">length</span><span class="p">}</span>
    <span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">model</span> <span class="ow">in</span> <span class="n">copiers</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
        <span class="n">row</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="o">=</span> <span class="nf">copying_accuracy</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">length</span><span class="p">,</span> <span class="n">n</span><span class="o">=</span><span class="mi">128</span><span class="p">)</span>
    <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">row</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">3</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">noise tokens</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">selective</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">fixed step, B and C</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">256</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.997</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.068</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">512</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.999</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.060</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,024</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.992</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.061</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,048</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.841</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.068</td></tr></tbody></table></div> <p>Trained on 256 tokens, the selective model copies almost every colour at four times that length and most of them at eight: the noise it ignores costs it next to nothing. This is selectivity at its best, a few things worth keeping in a long stream.</p> <p>Section 9 showed its limit: when every word of a long list has to be kept, a state of fixed size runs out, and that is the job the hybrids of section 10 hand to attention.</p> <h2 id="12-where-state-space-models-are-today">12. Where state space models are today</h2> <p><strong>Pure Mamba at scale.</strong> Mistral released Codestral Mamba 7B in July 2024 and TII released Falcon Mamba 7B a month later, the first pure state space models of that size to compete with Transformers on standard benchmarks. Gu and Dao’s group went on to Mamba-3 in 2026, with a state that updates more expressively and decodes faster.</p> <p><strong>Hybrids as the default.</strong> Where long context and cheap serving matter, the shipped answer is a mixture: Jamba, Zamba2, Nemotron-H, Granite 4.0 H and Falcon-H1 keep a few attention layers for recall and use Mamba for the rest.</p> <p>AI21 tried Mamba-2 for Jamba 1.5 and kept Mamba-1, which worked better next to attention; the newest version is not always the best partner.</p> <p><strong>Beyond text.</strong> Long sequences with simple alphabets are the natural home: DNA, audio and time series.</p> <p>Mamba’s passport, the model that made state space models a language technology, and the family tree:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/10/passport-light.png" width="760" alt="Mamba's passport. Published December 2023 by Albert Gu of Carnegie Mellon University and Tri Dao of Princeton University, code and weights under Apache 2.0. Type: a selective state space model, with no attention and no MLP blocks. Sizes: 130 million to 2.8 billion parameters. Training: 300 billion tokens of the Pile, context 2,048. State: per layer, 1,536 channels of 16 numbers in mamba-130m, plus a window of three inputs. Positions: none; order comes from the recurrence. Generation: the same memory and time for every token. Good at: long sequences at linear cost, fast generation, DNA and audio. Not for: recalling long spans exactly; pair it with attention" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/10/passport-dark.png" width="760" alt="Mamba's passport. Published December 2023 by Albert Gu of Carnegie Mellon University and Tri Dao of Princeton University, code and weights under Apache 2.0. Type: a selective state space model, with no attention and no MLP blocks. Sizes: 130 million to 2.8 billion parameters. Training: 300 billion tokens of the Pile, context 2,048. State: per layer, 1,536 channels of 16 numbers in mamba-130m, plus a window of three inputs. Positions: none; order comes from the recurrence. Generation: the same memory and time for every token. Good at: long sequences at linear cost, fast generation, DNA and audio. Not for: recalling long spans exactly; pair it with attention" loading="lazy"></p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/10/family-light.png" width="760" alt="The family of the Transformer as this course covers it, with lesson 10, Mamba and hybrids, highlighted and lessons 1 to 9 done" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/10/family-dark.png" width="760" alt="The family of the Transformer as this course covers it, with lesson 10, Mamba and hybrids, highlighted and lessons 1 to 9 done" loading="lazy"></p> <h2 id="references">References</h2> <ol class="tfs-refs"> <li id="ref-1">Kalman, R. E. (1960). <a href="https://doi.org/10.1115/1.3662552">A new approach to linear filtering and prediction problems</a>. <em>Journal of Basic Engineering</em>, 82(1), 35–45.</li> <li id="ref-2">Gu, A., Goel, K., &amp; Ré, C. (2022). <a href="https://arxiv.org/abs/2111.00396">Efficiently modeling long sequences with structured state spaces</a>. <em>ICLR 2022</em>.</li> <li id="ref-3">Gu, A., &amp; Dao, T. (2023). <a href="https://arxiv.org/abs/2312.00752">Mamba: linear-time sequence modeling with selective state spaces</a>. arXiv:2312.00752.</li> <li id="ref-4">Dao, T., &amp; Gu, A. (2024). <a href="https://arxiv.org/abs/2405.21060">Transformers are SSMs: generalized models and efficient algorithms through structured state space duality</a>. <em>ICML 2024</em>.</li> <li id="ref-5">Biderman, S., Schoelkopf, H., Anthony, Q., et al. (2023). <a href="https://arxiv.org/abs/2304.01373">Pythia: a suite for analyzing large language models across training and scaling</a>. <em>ICML 2023</em>.</li> <li id="ref-6">Jelassi, S., Brandfonbrener, D., Kakade, S. M., &amp; Malach, E. (2024). <a href="https://arxiv.org/abs/2402.01032">Repeat after me: Transformers are better than state space models at copying</a>. arXiv:2402.01032.</li> <li id="ref-7">Arora, S., Eyuboglu, S., Timalsina, A., et al. (2023). <a href="https://arxiv.org/abs/2312.04927">Zoology: measuring and improving recall in efficient language models</a>. arXiv:2312.04927.</li> <li id="ref-8">Lieber, O., Lenz, B., Bata, H., et al. (2024). <a href="https://arxiv.org/abs/2403.19887">Jamba: a hybrid Transformer–Mamba language model</a>. arXiv:2403.19887.</li> <li id="ref-9">Hillis, W. D., &amp; Steele, G. L. (1986). <a href="https://doi.org/10.1145/7902.7903">Data parallel algorithms</a>. <em>Communications of the ACM</em>, 29(12), 1170–1183.</li> </ol>]]></content> <author> <name>Eva Koroleva</name> </author> <category term="machine-learning"/> <category term="transformer-architectures"/> <category term="mamba"/> <category term="state-space-models"/> <category term="ssm"/> <category term="selective-scan"/> <category term="mamba-2"/> <category term="hybrids"/> <category term="llm"/> <summary type="html"><![CDATA[State space models from the continuous equation up: discretisation, Mamba's selective scan written from scratch and checked against mamba-130m, what its time steps choose to remember, generation with a state of fixed size, Mamba-2 as masked attention, Mamba against Pythia on the same data, hybrids, and what selectivity buys, learned from scratch on selective copying.]]></summary> <media:thumbnail url="https://blog.korolevalab.com/assets/posts/arch/10/cover.png"/> <media:content medium="image" url="https://blog.korolevalab.com/assets/posts/arch/10/cover.png"/> </entry> <entry> <title type="html">Long context with RoPE scaling, YaRN and FlashAttention</title> <link href="https://blog.korolevalab.com/blog/2026/transformer-architectures-09-long/" rel="alternate" type="text/html" title="Long context with RoPE scaling, YaRN and FlashAttention"/> <published>2026-09-30T18:00:00+00:00</published> <updated>2026-11-10T00:00:00+00:00</updated> <id>https://blog.korolevalab.com/blog/2026/transformer-architectures-09-long</id> <content type="html" xml:base="https://blog.korolevalab.com/blog/2026/transformer-architectures-09-long/"><![CDATA[<p class="tfs-links"><strong>Transformer architectures: from BERT to diffusion</strong> · lesson 9 of 15 · <a href="/teaching/">all lessons</a> · <a href="https://www.kaggle.com/code/qmarva/transformer-architectures-09-long-context">run on Kaggle</a> · <a href="https://colab.research.google.com/github/xmarva/transformers-from-scratch/blob/main/notebooks/colab/a09_long.ipynb">open in Colab</a> · <a href="https://github.com/xmarva/transformers-from-scratch">code on GitHub</a></p> <p>The context window is the one number on a model card that has grown faster than the parameter count. GPT-3 read 2,048 tokens and Llama 2 read 4,096; Llama 3.1 reads 131,072, and Gemini 1.5 and GPT-4.1 claim a million.</p> <p>Almost none of these models spent their <a href="/blog/2024/llms-for-those-who-missed-out/">pretraining</a> on windows that long. They were trained short and stretched afterwards, and the trick that made the stretching cheap came out of a Reddit forum.</p> <p>In June 2023 a hobbyist who signs as kaiokendev divided every position number by four and got LLaMA to read 8,192 tokens after a little <a href="/blog/2025/adapters/">fine-tuning</a>; Meta published the same idea as <em>position interpolation</em> within days, and a user called bloc97 posted a variant that needed no fine-tuning at all.</p> <p>Two months later some of the same people wrote <em>YaRN</em>, and YaRN is what Qwen3, DeepSeek-V3 and gpt-oss switch on today to read past the length they were trained on.</p> <p>Stretching the positions is half of the problem. The other half is that attention compares every token with every other one: a 64k-token prompt has four billion pairs per head, and writing their scores down would need more memory than a GPU has.</p> <p><em><a href="/blog/2026/transformers-from-scratch-05-llama/">FlashAttention</a></em> never writes them down. It computes attention one tile at a time and still gets the exact answer, thanks to a five-line trick for computing a softmax in one pass.</p> <p>This lesson takes both halves apart. We watch TinyLlama, a model trained on 2,048 tokens, fall off a cliff at token 2,049, and find which of its rotary dimensions push it.</p> <p>We write the standard fixes, a few lines each, check them against Hugging Face and race them on books. Then we build FlashAttention’s core from a softmax over five numbers, measure it on a T4, and finish with Qwen3 looking for a needle in a novel 64 thousand tokens long.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/09/hero-light.png" width="760" alt="TinyLlama's 32 rotary pairs drawn as dials, fastest first, each showing how far the pair turned over the 2,048 positions of training. The fast pairs on the left turned hundreds of times, so every angle is familiar to the model. The slow pairs on the right never completed one turn: past position 2,048 they point in directions the model has never seen. Colors mark what YaRN does to each pair when it stretches the context eight times: the fast pairs are left alone, the slowest are stretched in full, and those in between are blended" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/09/hero-dark.png" width="760" alt="TinyLlama's 32 rotary pairs drawn as dials, fastest first, each showing how far the pair turned over the 2,048 positions of training. The fast pairs on the left turned hundreds of times, so every angle is familiar to the model. The slow pairs on the right never completed one turn: past position 2,048 they point in directions the model has never seen. Colors mark what YaRN does to each pair when it stretches the context eight times: the fast pairs are left alone, the slowest are stretched in full, and those in between are blended" loading="lazy"></p> <p><strong>What you’ll do</strong></p> <ol> <li>Read from their configs how far eleven models read and how each one got there.</li> <li>Write one small decoder that runs both TinyLlama and Qwen3, and match Hugging Face.</li> <li>Watch TinyLlama’s loss explode past its training length, and find the rotary dimensions to blame.</li> <li>Write position interpolation, NTK scaling, dynamic NTK, YaRN and Llama 3.1’s scaling, check each against the transformers library, and race them on 16k-token books and a passkey test.</li> <li>Build FlashAttention’s forward pass from the online softmax, check it against plain attention, and measure memory and time on a T4.</li> <li>Hide a sentence in a novel and ask Qwen3-4B to find it, from 8k to 64k tokens, with and without YaRN.</li> <li>Give Qwen3 a whole novel, 77 thousand tokens, and ask it questions only a reader could answer.</li> </ol> <p><strong>What you need</strong>: a GPU. On Kaggle, <em>Settings → Accelerator → GPU</em>; on Colab, <em>Runtime → Change runtime type → T4 GPU</em>; the last two sections need two of them, <em>GPU T4 x2</em> on Kaggle. The notebook downloads TinyLlama (4.4 GB), Qwen3-4B (8 GB), the hundred test books of PG-19 and one novel from Project Gutenberg.</p> <h2 id="setup">Setup</h2> <p>One small helper package, <code class="language-plaintext highlighter-rouge">tfs</code>, draws the course’s plots and token chips and knows where the notebook runs (Kaggle, Colab or your own machine). Everything the lesson teaches is written out in the notebook itself.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">importlib.util</span>
<span class="kn">import</span> <span class="n">subprocess</span>
<span class="kn">import</span> <span class="n">sys</span>

<span class="n">TFS</span> <span class="o">=</span> <span class="sh">"</span><span class="s">git+https://github.com/xmarva/transformers-from-scratch@main</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">importlib</span><span class="p">.</span><span class="n">util</span><span class="p">.</span><span class="nf">find_spec</span><span class="p">(</span><span class="sh">"</span><span class="s">tfs</span><span class="sh">"</span><span class="p">)</span> <span class="ow">is</span> <span class="bp">None</span><span class="p">:</span>
    <span class="n">subprocess</span><span class="p">.</span><span class="nf">check_call</span><span class="p">([</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">-m</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">pip</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">install</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-q</span><span class="sh">"</span><span class="p">,</span> <span class="n">TFS</span><span class="p">])</span>

<span class="kn">from</span> <span class="n">tfs</span> <span class="kn">import</span> <span class="n">env</span>
<span class="kn">from</span> <span class="n">tfs.viz</span> <span class="kn">import</span> <span class="n">table</span><span class="p">,</span> <span class="n">token_chips</span><span class="p">,</span> <span class="n">use_course_style</span>

<span class="n">env</span><span class="p">.</span><span class="nf">quiet</span><span class="p">()</span>  <span class="c1"># no progress bars or environment warnings in the outputs
</span><span class="n">SEED</span> <span class="o">=</span> <span class="mi">42</span>
<span class="n">env</span><span class="p">.</span><span class="nf">seed_everything</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">COLORS</span> <span class="o">=</span> <span class="nf">use_course_style</span><span class="p">()</span>
<span class="n">WORK_DIR</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">work_dir</span><span class="p">()</span>
</code></pre></div></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">json</span>
<span class="kn">import</span> <span class="n">math</span>
<span class="kn">import</span> <span class="n">random</span>
<span class="kn">import</span> <span class="n">subprocess</span>
<span class="kn">import</span> <span class="n">sys</span>
<span class="kn">import</span> <span class="n">time</span>
<span class="kn">from</span> <span class="n">pathlib</span> <span class="kn">import</span> <span class="n">Path</span>

<span class="kn">import</span> <span class="n">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>
<span class="kn">from</span> <span class="n">matplotlib.colors</span> <span class="kn">import</span> <span class="n">LinearSegmentedColormap</span>
<span class="kn">import</span> <span class="n">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="n">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">import</span> <span class="n">torch</span>
<span class="kn">import</span> <span class="n">torch.nn</span> <span class="k">as</span> <span class="n">nn</span>
<span class="kn">import</span> <span class="n">torch.nn.functional</span> <span class="k">as</span> <span class="n">F</span>
<span class="kn">from</span> <span class="n">huggingface_hub</span> <span class="kn">import</span> <span class="n">hf_hub_download</span>
<span class="kn">from</span> <span class="n">safetensors.torch</span> <span class="kn">import</span> <span class="n">load_file</span>
<span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">AutoTokenizer</span>

<span class="n">SMOKE</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">smoke</span><span class="p">()</span>  <span class="c1"># CI runs the lesson on a small slice; you run it in full
</span><span class="n">device</span> <span class="o">=</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">if</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">is_available</span><span class="p">()</span> <span class="k">else</span> <span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span>
<span class="n">HALF</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">float16</span> <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">else</span> <span class="n">torch</span><span class="p">.</span><span class="n">float32</span>  <span class="c1"># 16-bit matmuls crawl on a CPU
</span><span class="k">assert</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="ow">or</span> <span class="n">SMOKE</span><span class="p">,</span> <span class="sh">"</span><span class="s">This lesson reads 64k-token prompts: use a GPU</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">GPU:</span><span class="sh">"</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">get_device_name</span><span class="p">(</span><span class="mi">0</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>GPU: Tesla T4</code></pre> <h2 id="1-how-far-models-read">1. How far models read</h2> <p>A model’s config says how its positions are encoded and how far it is meant to read.</p> <p>For a model with rotary positions, <a href="/blog/2026/transformer-architectures-06-modern/">lesson 6</a>’s RoPE, three things matter: the <em>base</em> of the rotations, the number of positions the model accepts, and, when the model was stretched after pretraining, how: the method, the factor and the length it was trained on. Here they are for eleven models.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">LONG_MODELS</span> <span class="o">=</span> <span class="p">[</span>  <span class="c1"># repository, name; Llama and Gemma from Unsloth's public copies
</span>    <span class="p">(</span><span class="sh">"</span><span class="s">TinyLlama/TinyLlama-1.1B-intermediate-step-1431k-3T</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">TinyLlama 1.1B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">unsloth/llama-2-7b</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Llama 2 7B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">unsloth/llama-3-8b</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Llama 3 8B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">unsloth/Meta-Llama-3.1-8B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Llama 3.1 8B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">mistralai/Mistral-7B-v0.1</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Mistral 7B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">Qwen/Qwen2.5-7B-Instruct</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Qwen2.5 7B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">Qwen/Qwen3-8B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Qwen3 8B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">unsloth/gemma-3-27b-pt</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Gemma 3 27B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">microsoft/Phi-3-mini-128k-instruct</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Phi-3 mini 128k</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">deepseek-ai/DeepSeek-V3</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">DeepSeek-V3</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">openai/gpt-oss-20b</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">gpt-oss 20B</span><span class="sh">"</span><span class="p">),</span>
<span class="p">]</span>


<span class="k">def</span> <span class="nf">read_config</span><span class="p">(</span><span class="n">repo</span><span class="p">):</span>
    <span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">repo</span><span class="p">,</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">))</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
        <span class="n">c</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">f</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">text_config</span><span class="sh">"</span><span class="p">,</span> <span class="n">c</span><span class="p">)</span>


<span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">repo</span><span class="p">,</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">LONG_MODELS</span><span class="p">:</span>
    <span class="n">c</span> <span class="o">=</span> <span class="nf">read_config</span><span class="p">(</span><span class="n">repo</span><span class="p">)</span>
    <span class="n">stretch</span> <span class="o">=</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">rope_scaling</span><span class="sh">"</span><span class="p">)</span> <span class="ow">or</span> <span class="p">{}</span>
    <span class="n">trained_on</span> <span class="o">=</span> <span class="n">stretch</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">original_max_position_embeddings</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
        <span class="p">{</span>
            <span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">RoPE base</span><span class="sh">"</span><span class="p">:</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">rope_theta</span><span class="sh">"</span><span class="p">,</span> <span class="mf">10000.0</span><span class="p">),</span>  <span class="c1"># absent: Llama's default
</span>            <span class="sh">"</span><span class="s">positions</span><span class="sh">"</span><span class="p">:</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">max_position_embeddings</span><span class="sh">"</span><span class="p">],</span>
            <span class="sh">"</span><span class="s">stretched by</span><span class="sh">"</span><span class="p">:</span> <span class="n">stretch</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">rope_type</span><span class="sh">"</span><span class="p">)</span> <span class="ow">or</span> <span class="n">stretch</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">type</span><span class="sh">"</span><span class="p">)</span> <span class="ow">or</span> <span class="sh">"</span><span class="s">—</span><span class="sh">"</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">factor</span><span class="sh">"</span><span class="p">:</span> <span class="n">stretch</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">factor</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">—</span><span class="sh">"</span><span class="p">),</span>
            <span class="sh">"</span><span class="s">trained on</span><span class="sh">"</span><span class="p">:</span> <span class="n">trained_on</span> <span class="ow">or</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">original_max_position_embeddings</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">—</span><span class="sh">"</span><span class="p">),</span>
        <span class="p">}</span>
    <span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">model</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">RoPE base</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">positions</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">stretched by</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">factor</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">trained on</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">TinyLlama 1.1B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">10,000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,048</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Llama 2 7B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">10,000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4,096</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Llama 3 8B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">500,000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8,192</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Llama 3.1 8B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">500,000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">131,072</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">llama3</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8,192</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Mistral 7B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">10,000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32,768</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Qwen2.5 7B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,000,000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32,768</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Qwen3 8B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,000,000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">40,960</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Gemma 3 27B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,000,000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">131,072</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">linear</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Phi-3 mini 128k</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">10,000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">131,072</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">longrope</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4,096</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">DeepSeek-V3</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">10,000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">163,840</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">yarn</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">40</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4,096</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">gpt-oss 20B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">150,000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">131,072</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">yarn</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4,096</td></tr></tbody></table></div> <p>Two strategies show up. The first is to make the slowest rotation slow enough from the start: Llama went from a base of 10,000 to 500,000 between versions 2 and 3, Qwen to a million, and such models are then pretrained on long documents in a late stage of training.</p> <p>The second is to train short and stretch: DeepSeek-V3 and gpt-oss were pretrained on 4,096-token windows and serve forty and thirty-two times more with YaRN; Llama 3.1 multiplies Llama 3’s 8,192 by eight with a scaling of Meta’s own; Phi-3 uses <em>LongRoPE</em>, a list of factors per dimension found by search.</p> <p>Gemma 3 divides all positions by eight in its global layers, the simplest method of all. Most of the big ones do both.</p> <p>A config’s number is a promise, not a measurement. Mistral 7B’s says 32,768, while the model was trained on 8,192 tokens with a sliding window of 4,096. Qwen3’s says 40,960, which its card explains as 32,768 tokens to read and 8,192 to write.</p> <p>The cards of Qwen3-4B and the larger models add that YaRN with a factor of 4 reaches 131,072, and ask you to switch it on only when you need it, because a static stretch can hurt short texts. Section 8 tests that.</p> <h2 id="2-one-decoder-for-two-models">2. One decoder for two models</h2> <p>Two models carry the experiments. <em>TinyLlama</em> is Llama 2’s architecture at 1.1 billion parameters, trained by a team at the Singapore University of Technology and Design on three trillion tokens, all of them in windows of 2,048.</p> <p>It is small enough to read 16k tokens on a T4 and old enough to have a short window: the ideal patient for the cliff and its cures.</p> <p><em>Qwen3-4B</em> is lesson 6’s model several sizes up, with a native window of 32k and a card that documents YaRN up to 131k; it is the patient for the needle and the novel.</p> <p>The two differ in one detail: Qwen3 normalises each head’s queries and keys before rotating them, lesson 6’s QK-norm. One class covers both. RoPE first, written as in lesson 6 but with the frequencies passed in, because changing the frequencies is what this lesson is about.</p> <p>Each pair of dimensions \(i\) of a head of size \(d\) turns by an angle \(\theta_i\) per position:</p> \[\theta_i = b^{-2i/d}, \qquad i = 0, 1, \dots, d/2 - 1,\] <p>where \(b\) is the base. At position \(m\) the pair is rotated by \(m\theta_i\). A <em>scaling</em> method replaces the \(\theta_i\) with new ones, and some also multiply the rotation by a constant, which <code class="language-plaintext highlighter-rouge">scale</code> carries.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">rope_frequencies</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">):</span>
    <span class="n">pairs</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">head_dim</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span><span class="p">).</span><span class="nf">float</span><span class="p">()</span>  <span class="c1"># not "meta" while loading
</span>    <span class="k">return</span> <span class="mf">1.0</span> <span class="o">/</span> <span class="n">base</span> <span class="o">**</span> <span class="p">(</span><span class="n">pairs</span> <span class="o">/</span> <span class="n">head_dim</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">rope_tables</span><span class="p">(</span><span class="n">freq</span><span class="p">,</span> <span class="n">positions</span><span class="p">,</span> <span class="n">scale</span><span class="o">=</span><span class="mf">1.0</span><span class="p">):</span>
    <span class="n">angles</span> <span class="o">=</span> <span class="n">positions</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">].</span><span class="nf">float</span><span class="p">()</span> <span class="o">*</span> <span class="n">freq</span><span class="p">[</span><span class="bp">None</span><span class="p">,</span> <span class="p">:].</span><span class="nf">to</span><span class="p">(</span><span class="n">positions</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
    <span class="n">angles</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">angles</span><span class="p">,</span> <span class="n">angles</span><span class="p">],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">angles</span><span class="p">.</span><span class="nf">cos</span><span class="p">()</span> <span class="o">*</span> <span class="n">scale</span><span class="p">,</span> <span class="n">angles</span><span class="p">.</span><span class="nf">sin</span><span class="p">()</span> <span class="o">*</span> <span class="n">scale</span>


<span class="k">def</span> <span class="nf">rotate</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">):</span>
    <span class="n">half</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span> <span class="o">//</span> <span class="mi">2</span>
    <span class="n">turned</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="o">-</span><span class="n">x</span><span class="p">[...,</span> <span class="n">half</span><span class="p">:],</span> <span class="n">x</span><span class="p">[...,</span> <span class="p">:</span><span class="n">half</span><span class="p">]],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">x</span> <span class="o">*</span> <span class="n">cos</span> <span class="o">+</span> <span class="n">turned</span> <span class="o">*</span> <span class="n">sin</span>
</code></pre></div></div> <p>The cache is a block of memory allocated once for the longest text a run will read, with a pointer to where the next token goes. <a href="/blog/2026/transformer-architectures-08-kv/">Lesson 8</a> grew its cache by concatenation, which copies everything stored so far on every step; at 64k tokens that copying would cost more than the attention itself.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">size</span><span class="p">,</span> <span class="n">eps</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">weight</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">size</span><span class="p">))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">eps</span> <span class="o">=</span> <span class="n">eps</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">x32</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="nf">float</span><span class="p">()</span>
        <span class="n">x32</span> <span class="o">=</span> <span class="n">x32</span> <span class="o">*</span> <span class="n">torch</span><span class="p">.</span><span class="nf">rsqrt</span><span class="p">(</span><span class="n">x32</span><span class="p">.</span><span class="nf">pow</span><span class="p">(</span><span class="mi">2</span><span class="p">).</span><span class="nf">mean</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">eps</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="n">weight</span> <span class="o">*</span> <span class="n">x32</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span>


<span class="k">class</span> <span class="nc">Cache</span><span class="p">:</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">size</span><span class="p">,</span> <span class="n">kv_heads</span><span class="p">,</span> <span class="n">head_dim</span><span class="p">,</span> <span class="n">dtype</span><span class="p">,</span> <span class="n">device</span><span class="p">):</span>
        <span class="n">self</span><span class="p">.</span><span class="n">k</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">empty</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">kv_heads</span><span class="p">,</span> <span class="n">size</span><span class="p">,</span> <span class="n">head_dim</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">dtype</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">v</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">empty</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">kv_heads</span><span class="p">,</span> <span class="n">size</span><span class="p">,</span> <span class="n">head_dim</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">dtype</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">length</span> <span class="o">=</span> <span class="mi">0</span>

    <span class="k">def</span> <span class="nf">add</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">):</span>
        <span class="n">end</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">length</span> <span class="o">+</span> <span class="n">k</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">2</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">k</span><span class="p">[:,</span> <span class="p">:,</span> <span class="n">self</span><span class="p">.</span><span class="n">length</span> <span class="p">:</span> <span class="n">end</span><span class="p">]</span> <span class="o">=</span> <span class="n">k</span>
        <span class="n">self</span><span class="p">.</span><span class="n">v</span><span class="p">[:,</span> <span class="p">:,</span> <span class="n">self</span><span class="p">.</span><span class="n">length</span> <span class="p">:</span> <span class="n">end</span><span class="p">]</span> <span class="o">=</span> <span class="n">v</span>
        <span class="n">self</span><span class="p">.</span><span class="n">length</span> <span class="o">=</span> <span class="n">end</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="n">k</span><span class="p">[:,</span> <span class="p">:,</span> <span class="p">:</span><span class="n">end</span><span class="p">],</span> <span class="n">self</span><span class="p">.</span><span class="n">v</span><span class="p">[:,</span> <span class="p">:,</span> <span class="p">:</span><span class="n">end</span><span class="p">]</span>
</code></pre></div></div> <p>Attention reads long texts in chunks of a few thousand tokens. A chunk sees every token before it and itself causally, which needs an explicit mask once earlier chunks sit in the cache.</p> <p>The attention call itself is PyTorch’s <code class="language-plaintext highlighter-rouge">scaled_dot_product_attention</code>, which section 7 opens up. When one new token is generated, its queries are grouped by key-value head instead of copying the cache for every query head, which at 64k tokens would be most of the work.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">Attention</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">kv_heads</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_key_value_heads</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span> <span class="o">=</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">head_dim</span><span class="sh">"</span><span class="p">)</span> <span class="ow">or</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">]</span> <span class="o">//</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span>
        <span class="n">hidden</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">bias</span> <span class="o">=</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">attention_bias</span><span class="sh">"</span><span class="p">,</span> <span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">q_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">hidden</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="n">bias</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">k_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">hidden</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">kv_heads</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="n">bias</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">v_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">hidden</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">kv_heads</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="n">bias</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">o_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">hidden</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">qk_norm</span> <span class="o">=</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">model_type</span><span class="sh">"</span><span class="p">)</span> <span class="o">==</span> <span class="sh">"</span><span class="s">qwen3</span><span class="sh">"</span>
        <span class="k">if</span> <span class="n">self</span><span class="p">.</span><span class="n">qk_norm</span><span class="p">:</span>
            <span class="n">self</span><span class="p">.</span><span class="n">q_norm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">rms_norm_eps</span><span class="sh">"</span><span class="p">])</span>
            <span class="n">self</span><span class="p">.</span><span class="n">k_norm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">rms_norm_eps</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="bp">False</span>  <span class="c1"># section 6 looks at the last queries and all keys
</span>        <span class="n">self</span><span class="p">.</span><span class="n">kept</span> <span class="o">=</span> <span class="bp">None</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">,</span> <span class="n">cache</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
        <span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span>
        <span class="n">q</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">q_proj</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">view</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
        <span class="n">k</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">k_proj</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">view</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">kv_heads</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
        <span class="n">v</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">v_proj</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">view</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">kv_heads</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">self</span><span class="p">.</span><span class="n">qk_norm</span><span class="p">:</span>
            <span class="n">q</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">q_norm</span><span class="p">(</span><span class="n">q</span><span class="p">)</span>
            <span class="n">k</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">k_norm</span><span class="p">(</span><span class="n">k</span><span class="p">)</span>
        <span class="n">q</span> <span class="o">=</span> <span class="nf">rotate</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">)</span>
        <span class="n">k</span> <span class="o">=</span> <span class="nf">rotate</span><span class="p">(</span><span class="n">k</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">cache</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
            <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="o">=</span> <span class="n">cache</span><span class="p">.</span><span class="nf">add</span><span class="p">(</span><span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">self</span><span class="p">.</span><span class="n">keep</span><span class="p">:</span>
            <span class="n">self</span><span class="p">.</span><span class="n">kept</span> <span class="o">=</span> <span class="p">(</span><span class="n">q</span><span class="p">[:,</span> <span class="p">:,</span> <span class="o">-</span><span class="mi">64</span><span class="p">:].</span><span class="nf">float</span><span class="p">(),</span> <span class="n">k</span><span class="p">.</span><span class="nf">float</span><span class="p">())</span>
        <span class="n">group</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">//</span> <span class="n">self</span><span class="p">.</span><span class="n">kv_heads</span>
        <span class="k">if</span> <span class="n">t</span> <span class="o">==</span> <span class="mi">1</span><span class="p">:</span>
            <span class="n">q</span> <span class="o">=</span> <span class="n">q</span><span class="p">.</span><span class="nf">view</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">kv_heads</span><span class="p">,</span> <span class="n">group</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">)</span>
            <span class="n">scores</span> <span class="o">=</span> <span class="n">q</span> <span class="o">@</span> <span class="n">k</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">2</span><span class="p">)</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">)</span>
            <span class="n">out</span> <span class="o">=</span> <span class="n">scores</span><span class="p">.</span><span class="nf">float</span><span class="p">().</span><span class="nf">softmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">v</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span> <span class="o">@</span> <span class="n">v</span>
            <span class="n">out</span> <span class="o">=</span> <span class="n">out</span><span class="p">.</span><span class="nf">reshape</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">)</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="n">k</span> <span class="o">=</span> <span class="n">k</span><span class="p">.</span><span class="nf">repeat_interleave</span><span class="p">(</span><span class="n">group</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
            <span class="n">v</span> <span class="o">=</span> <span class="n">v</span><span class="p">.</span><span class="nf">repeat_interleave</span><span class="p">(</span><span class="n">group</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
            <span class="n">n</span> <span class="o">=</span> <span class="n">k</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">2</span><span class="p">]</span>
            <span class="k">if</span> <span class="n">n</span> <span class="o">==</span> <span class="n">t</span><span class="p">:</span>
                <span class="n">out</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">scaled_dot_product_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">,</span> <span class="n">is_causal</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
            <span class="k">else</span><span class="p">:</span>
                <span class="n">query_pos</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">n</span> <span class="o">-</span> <span class="n">t</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">x</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
                <span class="n">key_pos</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">x</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
                <span class="n">mask</span> <span class="o">=</span> <span class="n">key_pos</span><span class="p">[</span><span class="bp">None</span><span class="p">,</span> <span class="p">:]</span> <span class="o">&lt;=</span> <span class="n">query_pos</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">]</span>
                <span class="n">out</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">scaled_dot_product_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">,</span> <span class="n">attn_mask</span><span class="o">=</span><span class="n">mask</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">o_proj</span><span class="p">(</span><span class="n">out</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">))</span>
</code></pre></div></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">MLP</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">gate_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">up_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">down_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">down_proj</span><span class="p">(</span><span class="n">F</span><span class="p">.</span><span class="nf">silu</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">gate_proj</span><span class="p">(</span><span class="n">x</span><span class="p">))</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="nf">up_proj</span><span class="p">(</span><span class="n">x</span><span class="p">))</span>


<span class="k">class</span> <span class="nc">Block</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">input_layernorm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">rms_norm_eps</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">self_attn</span> <span class="o">=</span> <span class="nc">Attention</span><span class="p">(</span><span class="n">c</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">post_attention_layernorm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">rms_norm_eps</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">mlp</span> <span class="o">=</span> <span class="nc">MLP</span><span class="p">(</span><span class="n">c</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">,</span> <span class="n">cache</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">self_attn</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">input_layernorm</span><span class="p">(</span><span class="n">x</span><span class="p">),</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">,</span> <span class="n">cache</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">mlp</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">post_attention_layernorm</span><span class="p">(</span><span class="n">x</span><span class="p">))</span>
</code></pre></div></div> <p>The model returns hidden states, not logits: a 64k-token prompt times Qwen3’s 151,936-word vocabulary is ten billion logits, and we only ever need a few of them.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">Decoder</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">embed_tokens</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">layers</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">ModuleList</span><span class="p">([</span><span class="nc">Block</span><span class="p">(</span><span class="n">c</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">])])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">rms_norm_eps</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">lm_head</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span> <span class="o">=</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">head_dim</span><span class="sh">"</span><span class="p">)</span> <span class="ow">or</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">]</span> <span class="o">//</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">base</span> <span class="o">=</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">rope_theta</span><span class="sh">"</span><span class="p">,</span> <span class="mf">10000.0</span><span class="p">)</span>  <span class="c1"># absent from TinyLlama's config
</span>        <span class="n">self</span><span class="p">.</span><span class="n">freq</span> <span class="o">=</span> <span class="nf">rope_frequencies</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">base</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">scale</span> <span class="o">=</span> <span class="mf">1.0</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">start</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span> <span class="n">caches</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">embed_tokens</span><span class="p">(</span><span class="n">ids</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">embed_tokens</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">device</span><span class="p">))</span>
        <span class="n">positions</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">start</span><span class="p">,</span> <span class="n">start</span> <span class="o">+</span> <span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="n">device</span><span class="o">=</span><span class="n">x</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
        <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span> <span class="o">=</span> <span class="nf">rope_tables</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">freq</span><span class="p">,</span> <span class="n">positions</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">scale</span><span class="p">)</span>
        <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">layer</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">layers</span><span class="p">):</span>
            <span class="n">here</span> <span class="o">=</span> <span class="n">layer</span><span class="p">.</span><span class="n">input_layernorm</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">device</span>  <span class="c1"># a large model sits on two GPUs
</span>            <span class="n">x</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">here</span><span class="p">)</span>
            <span class="n">cache</span> <span class="o">=</span> <span class="n">caches</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="k">if</span> <span class="n">caches</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span> <span class="k">else</span> <span class="bp">None</span>
            <span class="n">x</span> <span class="o">=</span> <span class="nf">layer</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">here</span><span class="p">,</span> <span class="n">x</span><span class="p">.</span><span class="n">dtype</span><span class="p">),</span> <span class="n">sin</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">here</span><span class="p">,</span> <span class="n">x</span><span class="p">.</span><span class="n">dtype</span><span class="p">),</span> <span class="n">cache</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">norm</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">device</span><span class="p">))</span>

    <span class="k">def</span> <span class="nf">logits</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">h</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">lm_head</span><span class="p">(</span><span class="n">h</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">lm_head</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">device</span><span class="p">)).</span><span class="nf">float</span><span class="p">()</span>

    <span class="k">def</span> <span class="nf">new_caches</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">size</span><span class="p">):</span>
        <span class="n">caches</span> <span class="o">=</span> <span class="p">[]</span>
        <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">self</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
            <span class="n">a</span> <span class="o">=</span> <span class="n">layer</span><span class="p">.</span><span class="n">self_attn</span>
            <span class="n">w</span> <span class="o">=</span> <span class="n">layer</span><span class="p">.</span><span class="n">input_layernorm</span><span class="p">.</span><span class="n">weight</span>
            <span class="n">caches</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="nc">Cache</span><span class="p">(</span><span class="n">size</span><span class="p">,</span> <span class="n">a</span><span class="p">.</span><span class="n">kv_heads</span><span class="p">,</span> <span class="n">a</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">w</span><span class="p">.</span><span class="n">dtype</span><span class="p">,</span> <span class="n">w</span><span class="p">.</span><span class="n">device</span><span class="p">))</span>
        <span class="k">return</span> <span class="n">caches</span>
</code></pre></div></div> <p>Loading reads the safetensors files, one or several, and drops the <code class="language-plaintext highlighter-rouge">model.</code> prefix of the names. Qwen3-4B ties its output matrix to its embeddings and doesn’t store it twice.</p> <p>With <code class="language-plaintext highlighter-rouge">spread</code>, a model too big for one T4 together with a long cache is cut in two: the first half of its layers on one GPU, the second half on the other, and the hidden state crosses over once per token on the way up.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">load_model</span><span class="p">(</span><span class="n">source</span><span class="p">,</span> <span class="n">c</span><span class="p">,</span> <span class="n">dtype</span><span class="p">,</span> <span class="n">spread</span><span class="o">=</span><span class="bp">False</span><span class="p">):</span>
    <span class="k">if</span> <span class="nc">Path</span><span class="p">(</span><span class="n">source</span><span class="p">).</span><span class="nf">is_dir</span><span class="p">():</span>  <span class="c1"># the smoke run's small models, saved to disk
</span>        <span class="n">files</span> <span class="o">=</span> <span class="nf">sorted</span><span class="p">(</span><span class="nc">Path</span><span class="p">(</span><span class="n">source</span><span class="p">).</span><span class="nf">glob</span><span class="p">(</span><span class="sh">"</span><span class="s">*.safetensors</span><span class="sh">"</span><span class="p">))</span>
    <span class="k">else</span><span class="p">:</span>
        <span class="k">try</span><span class="p">:</span>
            <span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">source</span><span class="p">,</span> <span class="sh">"</span><span class="s">model.safetensors.index.json</span><span class="sh">"</span><span class="p">))</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
                <span class="n">names</span> <span class="o">=</span> <span class="nf">sorted</span><span class="p">(</span><span class="nf">set</span><span class="p">(</span><span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">f</span><span class="p">)[</span><span class="sh">"</span><span class="s">weight_map</span><span class="sh">"</span><span class="p">].</span><span class="nf">values</span><span class="p">()))</span>
        <span class="k">except</span> <span class="nb">Exception</span><span class="p">:</span>  <span class="c1"># a single file has no index
</span>            <span class="n">names</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">model.safetensors</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">files</span> <span class="o">=</span> <span class="p">[</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">source</span><span class="p">,</span> <span class="n">name</span><span class="p">)</span> <span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">names</span><span class="p">]</span>
    <span class="n">state</span> <span class="o">=</span> <span class="p">{}</span>
    <span class="k">for</span> <span class="n">path</span> <span class="ow">in</span> <span class="n">files</span><span class="p">:</span>
        <span class="k">for</span> <span class="n">key</span><span class="p">,</span> <span class="n">value</span> <span class="ow">in</span> <span class="nf">load_file</span><span class="p">(</span><span class="nf">str</span><span class="p">(</span><span class="n">path</span><span class="p">)).</span><span class="nf">items</span><span class="p">():</span>
            <span class="n">state</span><span class="p">[</span><span class="n">key</span><span class="p">.</span><span class="nf">removeprefix</span><span class="p">(</span><span class="sh">"</span><span class="s">model.</span><span class="sh">"</span><span class="p">)]</span> <span class="o">=</span> <span class="n">value</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">dtype</span><span class="p">)</span>
    <span class="k">if</span> <span class="sh">"</span><span class="s">lm_head.weight</span><span class="sh">"</span> <span class="ow">not</span> <span class="ow">in</span> <span class="n">state</span><span class="p">:</span>
        <span class="n">state</span><span class="p">[</span><span class="sh">"</span><span class="s">lm_head.weight</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">state</span><span class="p">[</span><span class="sh">"</span><span class="s">embed_tokens.weight</span><span class="sh">"</span><span class="p">]</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">device</span><span class="p">(</span><span class="sh">"</span><span class="s">meta</span><span class="sh">"</span><span class="p">):</span>
        <span class="n">model</span> <span class="o">=</span> <span class="nc">Decoder</span><span class="p">(</span><span class="n">c</span><span class="p">)</span>
    <span class="n">model</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">(</span><span class="n">state</span><span class="p">,</span> <span class="n">strict</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">assign</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">model</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>
    <span class="k">if</span> <span class="ow">not</span> <span class="n">spread</span> <span class="ow">or</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">device_count</span><span class="p">()</span> <span class="o">&lt;</span> <span class="mi">2</span><span class="p">:</span>
        <span class="k">return</span> <span class="n">model</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="n">half</span> <span class="o">=</span> <span class="nf">len</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="n">layers</span><span class="p">)</span> <span class="o">//</span> <span class="mi">2</span>  <span class="c1"># half of the layers on each GPU
</span>    <span class="n">model</span><span class="p">.</span><span class="n">embed_tokens</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="sh">"</span><span class="s">cuda:0</span><span class="sh">"</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">layer</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="n">layers</span><span class="p">):</span>
        <span class="n">layer</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="sh">"</span><span class="s">cuda:0</span><span class="sh">"</span> <span class="k">if</span> <span class="n">i</span> <span class="o">&lt;</span> <span class="n">half</span> <span class="k">else</span> <span class="sh">"</span><span class="s">cuda:1</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">model</span><span class="p">.</span><span class="n">norm</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="sh">"</span><span class="s">cuda:1</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">model</span><span class="p">.</span><span class="n">lm_head</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="sh">"</span><span class="s">cuda:1</span><span class="sh">"</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">model</span>
</code></pre></div></div> <p>The check against Hugging Face runs the library’s model in a process of its own, as in lessons 7 and 8, so that two copies are never in memory together. The smoke run uses small models with random weights and the same code.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">TINY</span> <span class="o">=</span> <span class="sh">"</span><span class="s">TinyLlama/TinyLlama-1.1B-intermediate-step-1431k-3T</span><span class="sh">"</span>
<span class="n">QWEN</span> <span class="o">=</span> <span class="sh">"</span><span class="s">Qwen/Qwen3-4B</span><span class="sh">"</span>
<span class="n">tiny_tok</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">TINY</span><span class="p">)</span>
<span class="n">qwen_tok</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">QWEN</span><span class="p">)</span>

<span class="k">if</span> <span class="n">SMOKE</span><span class="p">:</span>
    <span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">LlamaConfig</span><span class="p">,</span> <span class="n">LlamaForCausalLM</span><span class="p">,</span> <span class="n">Qwen3Config</span><span class="p">,</span> <span class="n">Qwen3ForCausalLM</span>

    <span class="n">small</span> <span class="o">=</span> <span class="nf">dict</span><span class="p">(</span><span class="n">hidden_size</span><span class="o">=</span><span class="mi">64</span><span class="p">,</span> <span class="n">intermediate_size</span><span class="o">=</span><span class="mi">128</span><span class="p">,</span> <span class="n">num_hidden_layers</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
    <span class="n">small</span><span class="p">.</span><span class="nf">update</span><span class="p">(</span><span class="n">num_attention_heads</span><span class="o">=</span><span class="mi">4</span><span class="p">,</span> <span class="n">num_key_value_heads</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span> <span class="n">max_position_embeddings</span><span class="o">=</span><span class="mi">64</span><span class="p">)</span>
    <span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="mi">0</span><span class="p">)</span>
    <span class="n">tiny_ref</span> <span class="o">=</span> <span class="nc">LlamaForCausalLM</span><span class="p">(</span><span class="nc">LlamaConfig</span><span class="p">(</span><span class="n">vocab_size</span><span class="o">=</span><span class="mi">32000</span><span class="p">,</span> <span class="o">**</span><span class="n">small</span><span class="p">))</span>
    <span class="n">tiny_ref</span><span class="p">.</span><span class="nf">save_pretrained</span><span class="p">(</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">tiny-small</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">qwen_config</span> <span class="o">=</span> <span class="nc">Qwen3Config</span><span class="p">(</span>
        <span class="n">vocab_size</span><span class="o">=</span><span class="mi">151936</span><span class="p">,</span> <span class="n">head_dim</span><span class="o">=</span><span class="mi">16</span><span class="p">,</span> <span class="n">tie_word_embeddings</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="o">**</span><span class="n">small</span>
    <span class="p">)</span>
    <span class="nc">Qwen3ForCausalLM</span><span class="p">(</span><span class="n">qwen_config</span><span class="p">).</span><span class="nf">save_pretrained</span><span class="p">(</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">qwen-small</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">TINY_SOURCE</span><span class="p">,</span> <span class="n">QWEN_SOURCE</span> <span class="o">=</span> <span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">tiny-small</span><span class="sh">"</span><span class="p">,</span> <span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">qwen-small</span><span class="sh">"</span>
    <span class="n">tiny_c</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">loads</span><span class="p">((</span><span class="n">TINY_SOURCE</span> <span class="o">/</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">).</span><span class="nf">read_text</span><span class="p">())</span>
    <span class="n">qwen_c</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">loads</span><span class="p">((</span><span class="n">QWEN_SOURCE</span> <span class="o">/</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">).</span><span class="nf">read_text</span><span class="p">())</span>
    <span class="k">for</span> <span class="n">c</span> <span class="ow">in</span> <span class="p">[</span><span class="n">tiny_c</span><span class="p">,</span> <span class="n">qwen_c</span><span class="p">]:</span>  <span class="c1"># newer configs keep the base inside rope_parameters
</span>        <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">rope_theta</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">rope_parameters</span><span class="sh">"</span><span class="p">,</span> <span class="p">{}).</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">rope_theta</span><span class="sh">"</span><span class="p">,</span> <span class="mf">10000.0</span><span class="p">)</span>
<span class="k">else</span><span class="p">:</span>
    <span class="n">TINY_SOURCE</span><span class="p">,</span> <span class="n">QWEN_SOURCE</span> <span class="o">=</span> <span class="n">TINY</span><span class="p">,</span> <span class="n">QWEN</span>
    <span class="n">tiny_c</span> <span class="o">=</span> <span class="nf">read_config</span><span class="p">(</span><span class="n">TINY</span><span class="p">)</span>
    <span class="n">qwen_c</span> <span class="o">=</span> <span class="nf">read_config</span><span class="p">(</span><span class="n">QWEN</span><span class="p">)</span>

<span class="n">text</span> <span class="o">=</span> <span class="p">(</span>
    <span class="sh">"</span><span class="s">The lighthouse keeper on Skellig Michael logged every ship that passed in a green </span><span class="sh">"</span>
    <span class="sh">"</span><span class="s">ledger, and in the winter of 1871 he logged none.</span><span class="sh">"</span>
<span class="p">)</span>
<span class="n">check_ids</span> <span class="o">=</span> <span class="nf">tiny_tok</span><span class="p">(</span><span class="n">text</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="n">input_ids</span>
<span class="n">torch</span><span class="p">.</span><span class="nf">save</span><span class="p">(</span><span class="n">check_ids</span><span class="p">,</span> <span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">check_ids.pt</span><span class="sh">"</span><span class="p">)</span>
<span class="n">script</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"""</span><span class="s">
import torch
from transformers import AutoModelForCausalLM
device = </span><span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="s"> if torch.cuda.is_available() else </span><span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span><span class="s">
dtype = torch.float16 if device == </span><span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="s"> else torch.float32
model = AutoModelForCausalLM.from_pretrained(</span><span class="sh">"</span><span class="si">{</span><span class="n">TINY_SOURCE</span><span class="si">}</span><span class="sh">"</span><span class="s">, dtype=dtype)
model = model.to(device).eval()
ids = torch.load(</span><span class="sh">"</span><span class="si">{</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">check_ids.pt</span><span class="sh">"</span><span class="si">}</span><span class="sh">"</span><span class="s">).to(device)
with torch.no_grad():
    torch.save(model(ids).logits.float().cpu(), </span><span class="sh">"</span><span class="si">{</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">theirs.pt</span><span class="sh">"</span><span class="si">}</span><span class="sh">"</span><span class="s">)
</span><span class="sh">"""</span>
<span class="n">subprocess</span><span class="p">.</span><span class="nf">run</span><span class="p">([</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">-c</span><span class="sh">"</span><span class="p">,</span> <span class="n">script</span><span class="p">],</span> <span class="n">check</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">theirs</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">theirs.pt</span><span class="sh">"</span><span class="p">)</span>

<span class="n">tiny</span> <span class="o">=</span> <span class="nf">load_model</span><span class="p">(</span><span class="n">TINY_SOURCE</span><span class="p">,</span> <span class="n">tiny_c</span><span class="p">,</span> <span class="n">HALF</span><span class="p">)</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">ours</span> <span class="o">=</span> <span class="n">tiny</span><span class="p">.</span><span class="nf">logits</span><span class="p">(</span><span class="nf">tiny</span><span class="p">(</span><span class="n">check_ids</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">))).</span><span class="nf">cpu</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">tokens:</span><span class="sh">"</span><span class="p">,</span> <span class="n">check_ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">])</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">largest logit:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">theirs</span><span class="p">.</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">max difference from Hugging Face:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="n">ours</span> <span class="o">-</span> <span class="n">theirs</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>tokens: 36
largest logit: 22.11
max difference from Hugging Face: 2.34e-02</code></pre> <p>The difference is the rounding of 16-bit floats over 22 layers; in 32-bit floats, on the smoke run’s random model, it is zero to the last bit. Qwen3 gets the same check in section 8.</p> <h2 id="3-the-cliff-at-token-2049">3. The cliff at token 2,049</h2> <p>A language model’s loss on a token is how surprised it was by it. Averaged over many texts and plotted against the token’s position, it should fall slowly, because each new token has more context to lean on.</p> <p>The texts are books from PG-19, Project Gutenberg books published before 1919, which DeepMind collected in 2019 to measure exactly this: how well a model uses long context. We take the first 16,384 tokens of eight of its test books.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">pg19</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nf">read_parquet</span><span class="p">(</span>
    <span class="sh">"</span><span class="s">hf://datasets/emozilla/pg19-test/data/test-00000-of-00001-29a571947c0b5ccc.parquet</span><span class="sh">"</span>
<span class="p">)</span>
<span class="n">TRAINED</span> <span class="o">=</span> <span class="n">tiny_c</span><span class="p">[</span><span class="sh">"</span><span class="s">max_position_embeddings</span><span class="sh">"</span><span class="p">]</span>
<span class="n">STRETCH</span> <span class="o">=</span> <span class="mi">8</span>
<span class="n">LENGTH</span> <span class="o">=</span> <span class="n">STRETCH</span> <span class="o">*</span> <span class="n">TRAINED</span>
<span class="n">N_BOOKS</span> <span class="o">=</span> <span class="mi">2</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">8</span>
<span class="n">books</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">book</span> <span class="ow">in</span> <span class="n">pg19</span><span class="p">.</span><span class="nf">itertuples</span><span class="p">():</span>
    <span class="n">ids</span> <span class="o">=</span> <span class="nf">tiny_tok</span><span class="p">(</span><span class="n">book</span><span class="p">.</span><span class="n">text</span><span class="p">[:</span><span class="mi">250_000</span><span class="p">],</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="n">input_ids</span>
    <span class="k">if</span> <span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span> <span class="o">&gt;</span> <span class="n">LENGTH</span><span class="p">:</span>
        <span class="n">books</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
            <span class="p">{</span><span class="sh">"</span><span class="s">title</span><span class="sh">"</span><span class="p">:</span> <span class="n">book</span><span class="p">.</span><span class="n">short_book_title</span><span class="p">,</span> <span class="sh">"</span><span class="s">ids</span><span class="sh">"</span><span class="p">:</span> <span class="n">ids</span><span class="p">[:,</span> <span class="p">:</span> <span class="n">LENGTH</span> <span class="o">+</span> <span class="mi">1</span><span class="p">],</span> <span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">:</span> <span class="n">book</span><span class="p">.</span><span class="n">text</span><span class="p">}</span>
        <span class="p">)</span>
    <span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="n">books</span><span class="p">)</span> <span class="o">==</span> <span class="n">N_BOOKS</span><span class="p">:</span>
        <span class="k">break</span>
<span class="k">for</span> <span class="n">book</span> <span class="ow">in</span> <span class="n">books</span><span class="p">:</span>
    <span class="nf">print</span><span class="p">(</span><span class="n">book</span><span class="p">[</span><span class="sh">"</span><span class="s">title</span><span class="sh">"</span><span class="p">])</span>
</code></pre></div></div> <pre class="tfs-printed"><code>Reminiscences of Pioneer Days in St. Paul by Frank Moore
Dragon's blood by Henry Milner Rideout
Travels in Morocco Volume 2 by James Richardson
Impressions of Theophrastus Such by George Eliot
The S. W. F. Club by Caroline E. Jacobs
Frank Merriwell Down South by Burt L. Standish
Critical Miscellanies (Vol. 2 of 3) by John Morley
From Sand Hill to Pine by Bret Harte</code></pre> <p><code class="language-plaintext highlighter-rouge">token_losses</code> reads a book in chunks through the cache and returns the loss of every token. <code class="language-plaintext highlighter-rouge">stretch</code> sets a model’s rotary frequencies by the name of a method; for now it knows only <code class="language-plaintext highlighter-rouge">"none"</code>, the frequencies the model was trained with. Section 5 teaches it the rest.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">token_losses</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">chunk</span><span class="o">=</span><span class="mi">4096</span><span class="p">):</span>
    <span class="n">n</span> <span class="o">=</span> <span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span> <span class="o">-</span> <span class="mi">1</span>
    <span class="n">caches</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="nf">new_caches</span><span class="p">(</span><span class="n">n</span><span class="p">)</span>
    <span class="n">losses</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">a</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">chunk</span><span class="p">):</span>
        <span class="n">b</span> <span class="o">=</span> <span class="nf">min</span><span class="p">(</span><span class="n">a</span> <span class="o">+</span> <span class="n">chunk</span><span class="p">,</span> <span class="n">n</span><span class="p">)</span>
        <span class="n">h</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">ids</span><span class="p">[:,</span> <span class="n">a</span><span class="p">:</span><span class="n">b</span><span class="p">].</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">),</span> <span class="n">start</span><span class="o">=</span><span class="n">a</span><span class="p">,</span> <span class="n">caches</span><span class="o">=</span><span class="n">caches</span><span class="p">)</span>
        <span class="n">target</span> <span class="o">=</span> <span class="n">ids</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="n">a</span> <span class="o">+</span> <span class="mi">1</span> <span class="p">:</span> <span class="n">b</span> <span class="o">+</span> <span class="mi">1</span><span class="p">].</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
        <span class="n">losses</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="nf">logits</span><span class="p">(</span><span class="n">h</span><span class="p">)[</span><span class="mi">0</span><span class="p">],</span> <span class="n">target</span><span class="p">,</span> <span class="n">reduction</span><span class="o">=</span><span class="sh">"</span><span class="s">none</span><span class="sh">"</span><span class="p">).</span><span class="nf">cpu</span><span class="p">())</span>
    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">(</span><span class="n">losses</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">average_losses</span><span class="p">(</span><span class="n">model</span><span class="p">):</span>
    <span class="n">total</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">LENGTH</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">book</span> <span class="ow">in</span> <span class="n">books</span><span class="p">:</span>
        <span class="n">total</span> <span class="o">+=</span> <span class="nf">token_losses</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">book</span><span class="p">[</span><span class="sh">"</span><span class="s">ids</span><span class="sh">"</span><span class="p">])</span>
    <span class="k">return</span> <span class="n">total</span> <span class="o">/</span> <span class="nf">len</span><span class="p">(</span><span class="n">books</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">smooth</span><span class="p">(</span><span class="n">curve</span><span class="p">,</span> <span class="n">width</span><span class="o">=</span><span class="mi">256</span><span class="p">):</span>
    <span class="n">width</span> <span class="o">=</span> <span class="nf">min</span><span class="p">(</span><span class="n">width</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">curve</span><span class="p">)</span> <span class="o">//</span> <span class="mi">8</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">np</span><span class="p">.</span><span class="nf">convolve</span><span class="p">(</span><span class="n">curve</span><span class="p">.</span><span class="nf">numpy</span><span class="p">(),</span> <span class="n">np</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">width</span><span class="p">)</span> <span class="o">/</span> <span class="n">width</span><span class="p">,</span> <span class="n">mode</span><span class="o">=</span><span class="sh">"</span><span class="s">valid</span><span class="sh">"</span><span class="p">)</span>


<span class="n">STRETCHES</span> <span class="o">=</span> <span class="p">{}</span>


<span class="k">def</span> <span class="nf">stretch</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">method</span><span class="p">,</span> <span class="n">s</span><span class="o">=</span><span class="mf">1.0</span><span class="p">):</span>
    <span class="n">model</span><span class="p">.</span><span class="n">freq</span><span class="p">,</span> <span class="n">model</span><span class="p">.</span><span class="n">scale</span> <span class="o">=</span> <span class="n">STRETCHES</span><span class="p">[</span><span class="n">method</span><span class="p">](</span><span class="n">model</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">model</span><span class="p">.</span><span class="n">base</span><span class="p">,</span> <span class="n">s</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">unchanged</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">,</span> <span class="n">s</span><span class="p">):</span>
    <span class="k">return</span> <span class="nf">rope_frequencies</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">),</span> <span class="mf">1.0</span>


<span class="n">STRETCHES</span><span class="p">[</span><span class="sh">"</span><span class="s">none</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">unchanged</span>
<span class="nf">stretch</span><span class="p">(</span><span class="n">tiny</span><span class="p">,</span> <span class="sh">"</span><span class="s">none</span><span class="sh">"</span><span class="p">)</span>
<span class="n">curves</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">none</span><span class="sh">"</span><span class="p">:</span> <span class="nf">average_losses</span><span class="p">(</span><span class="n">tiny</span><span class="p">)}</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">7.4</span><span class="p">,</span> <span class="mf">3.4</span><span class="p">))</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="nf">smooth</span><span class="p">(</span><span class="n">curves</span><span class="p">[</span><span class="sh">"</span><span class="s">none</span><span class="sh">"</span><span class="p">]),</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">],</span> <span class="n">linewidth</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">axvline</span><span class="p">(</span><span class="n">TRAINED</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">],</span> <span class="n">linestyle</span><span class="o">=</span><span class="sh">"</span><span class="s">--</span><span class="sh">"</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
<span class="n">top</span> <span class="o">=</span> <span class="n">ax</span><span class="p">.</span><span class="nf">get_ylim</span><span class="p">()[</span><span class="mi">1</span><span class="p">]</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">text</span><span class="p">(</span><span class="n">TRAINED</span> <span class="o">*</span> <span class="mf">1.08</span><span class="p">,</span> <span class="n">top</span> <span class="o">*</span> <span class="mf">0.92</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="s">trained length, </span><span class="si">{</span><span class="n">TRAINED</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">position in the book</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">loss, nats per token</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">TinyLlama on </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">books</span><span class="p">)</span><span class="si">}</span><span class="s"> books, as it was trained</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>

<span class="n">inside</span> <span class="o">=</span> <span class="n">curves</span><span class="p">[</span><span class="sh">"</span><span class="s">none</span><span class="sh">"</span><span class="p">][</span><span class="n">TRAINED</span> <span class="o">//</span> <span class="mi">2</span> <span class="p">:</span> <span class="n">TRAINED</span><span class="p">].</span><span class="nf">mean</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
<span class="n">next_window</span> <span class="o">=</span> <span class="n">curves</span><span class="p">[</span><span class="sh">"</span><span class="s">none</span><span class="sh">"</span><span class="p">][</span><span class="n">TRAINED</span> <span class="p">:</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">TRAINED</span><span class="p">].</span><span class="nf">mean</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
<span class="n">far</span> <span class="o">=</span> <span class="n">curves</span><span class="p">[</span><span class="sh">"</span><span class="s">none</span><span class="sh">"</span><span class="p">][</span><span class="o">-</span><span class="n">TRAINED</span><span class="p">:].</span><span class="nf">mean</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">mean loss, second half of the trained window: </span><span class="si">{</span><span class="n">inside</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">mean loss, the next </span><span class="si">{</span><span class="n">TRAINED</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> tokens: </span><span class="si">{</span><span class="n">next_window</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">mean loss, the last </span><span class="si">{</span><span class="n">TRAINED</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> tokens: </span><span class="si">{</span><span class="n">far</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/09/output-01.png" alt="Output of the code above" loading="lazy"></p> <pre class="tfs-printed"><code>mean loss, second half of the trained window: 2.53
mean loss, the next 2,048 tokens: 9.30
mean loss, the last 2,048 tokens: 8.86</code></pre> <p>Up to the trained length the curve does what it should. Then it turns into a wall. Nothing in the weights changed at position 2,049; what changed is the angles the rotary pairs report.</p> <h2 id="4-clocks-that-never-finished-a-turn">4. Clocks that never finished a turn</h2> <p>Think of every rotary pair as a clock hand that advances by \(\theta_i\) per token. Its <em>wavelength</em>, the number of tokens for one full turn, is</p> \[\lambda_i = \frac{2\pi}{\theta_i} = 2\pi\, b^{2i/d},\] <p>and over a training window of \(L\) tokens the hand makes \(r_i = L / \lambda_i\) turns. Attention between tokens \(m\) and \(n\) sees, in pair \(i\), the angle \((m - n)\theta_i\). A pair that turned hundreds of times during training has shown the model every angle at every distance; at a distance of 3,000 it reports an angle the model knows well from a shorter distance. A pair that never finished a turn is different: in training it only ever reported angles between zero and \(L\theta_i\), and beyond \(L\) it reports angles the model has never seen. Those pairs carry the coarse sense of “how far back”, and they are the ones that lie.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">turns</span> <span class="o">=</span> <span class="n">TRAINED</span> <span class="o">*</span> <span class="nf">rope_frequencies</span><span class="p">(</span><span class="n">tiny</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">tiny</span><span class="p">.</span><span class="n">base</span><span class="p">)</span> <span class="o">/</span> <span class="p">(</span><span class="mi">2</span> <span class="o">*</span> <span class="n">math</span><span class="p">.</span><span class="n">pi</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">turns in training, fastest pair to slowest:</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">t</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span> <span class="k">if</span> <span class="n">t</span> <span class="o">&lt;</span> <span class="mi">10</span> <span class="k">else</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">t</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span> <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="n">turns</span><span class="p">.</span><span class="nf">tolist</span><span class="p">()))</span>
<span class="n">slow</span> <span class="o">=</span> <span class="n">turns</span> <span class="o">&lt;</span> <span class="mi">1</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">pairs that never finished a turn: </span><span class="si">{</span><span class="nf">int</span><span class="p">(</span><span class="n">slow</span><span class="p">.</span><span class="nf">sum</span><span class="p">())</span><span class="si">}</span><span class="s"> of </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">turns</span><span class="p">)</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>turns in training, fastest pair to slowest:
326 244 183 137 103 77 58 43 33 24 18 14 10 7.73 5.80 4.35 3.26 2.44 1.83 1.37 1.03 0.77 0.58 0.43 0.33 0.24 0.18 0.14 0.10 0.08 0.06 0.04
pairs that never finished a turn: 11 of 32</code></pre> <p>One pair at a time makes this concrete. Take three of TinyLlama’s pairs, a fast one, a middle one and a slow one, and ask what angle each reports between two tokens 16,000 positions apart. The shaded arc is every angle the pair showed during training, at distances from 0 to 2,048; the red hand is the angle at 16,000.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">draw_clocks</span><span class="p">(</span><span class="n">freq</span><span class="p">,</span> <span class="n">stretched</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
    <span class="n">distance</span> <span class="o">=</span> <span class="nf">min</span><span class="p">(</span><span class="mi">16000</span><span class="p">,</span> <span class="n">LENGTH</span> <span class="o">-</span> <span class="mi">1</span><span class="p">)</span>
    <span class="n">pairs</span> <span class="o">=</span> <span class="p">[</span><span class="mi">2</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">freq</span><span class="p">)</span> <span class="o">//</span> <span class="mi">2</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">freq</span><span class="p">)</span> <span class="o">-</span> <span class="mi">4</span><span class="p">]</span>
    <span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">8.4</span><span class="p">,</span> <span class="mf">3.0</span><span class="p">),</span> <span class="n">subplot_kw</span><span class="o">=</span><span class="p">{</span><span class="sh">"</span><span class="s">projection</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">polar</span><span class="sh">"</span><span class="p">})</span>
    <span class="k">for</span> <span class="n">ax</span><span class="p">,</span> <span class="n">pair</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">axes</span><span class="p">,</span> <span class="n">pairs</span><span class="p">):</span>
        <span class="n">seen</span> <span class="o">=</span> <span class="n">TRAINED</span> <span class="o">*</span> <span class="n">freq</span><span class="p">[</span><span class="n">pair</span><span class="p">].</span><span class="nf">item</span><span class="p">()</span>  <span class="c1"># the widest angle training showed, in radians
</span>        <span class="n">arc</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">linspace</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">min</span><span class="p">(</span><span class="n">seen</span><span class="p">,</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">math</span><span class="p">.</span><span class="n">pi</span><span class="p">),</span> <span class="mi">200</span><span class="p">)</span>
        <span class="n">ax</span><span class="p">.</span><span class="nf">fill_between</span><span class="p">(</span><span class="n">arc</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">],</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.5</span><span class="p">)</span>
        <span class="n">hands</span> <span class="o">=</span> <span class="p">[(</span><span class="n">freq</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">])]</span>
        <span class="k">if</span> <span class="n">stretched</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
            <span class="n">hands</span><span class="p">.</span><span class="nf">append</span><span class="p">((</span><span class="n">stretched</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">]))</span>
        <span class="k">for</span> <span class="n">f</span><span class="p">,</span> <span class="n">color</span> <span class="ow">in</span> <span class="n">hands</span><span class="p">:</span>
            <span class="n">angle</span> <span class="o">=</span> <span class="p">(</span><span class="n">distance</span> <span class="o">*</span> <span class="n">f</span><span class="p">[</span><span class="n">pair</span><span class="p">].</span><span class="nf">item</span><span class="p">())</span> <span class="o">%</span> <span class="p">(</span><span class="mi">2</span> <span class="o">*</span> <span class="n">math</span><span class="p">.</span><span class="n">pi</span><span class="p">)</span>
            <span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">([</span><span class="n">angle</span><span class="p">,</span> <span class="n">angle</span><span class="p">],</span> <span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mf">2.5</span><span class="p">)</span>
        <span class="n">ax</span><span class="p">.</span><span class="nf">set_yticks</span><span class="p">([])</span>
        <span class="n">ax</span><span class="p">.</span><span class="nf">set_xticks</span><span class="p">([])</span>
        <span class="n">turns_seen</span> <span class="o">=</span> <span class="n">seen</span> <span class="o">/</span> <span class="p">(</span><span class="mi">2</span> <span class="o">*</span> <span class="n">math</span><span class="p">.</span><span class="n">pi</span><span class="p">)</span>
        <span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">pair </span><span class="si">{</span><span class="n">pair</span><span class="si">}</span><span class="s">: </span><span class="si">{</span><span class="n">turns_seen</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="s"> turns in training</span><span class="sh">"</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">10</span><span class="p">)</span>
    <span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
    <span class="k">for</span> <span class="n">pair</span> <span class="ow">in</span> <span class="n">pairs</span><span class="p">:</span>
        <span class="n">seen</span> <span class="o">=</span> <span class="n">math</span><span class="p">.</span><span class="nf">degrees</span><span class="p">(</span><span class="n">TRAINED</span> <span class="o">*</span> <span class="n">freq</span><span class="p">[</span><span class="n">pair</span><span class="p">].</span><span class="nf">item</span><span class="p">())</span>
        <span class="n">asked</span> <span class="o">=</span> <span class="n">math</span><span class="p">.</span><span class="nf">degrees</span><span class="p">(</span><span class="n">distance</span> <span class="o">*</span> <span class="n">freq</span><span class="p">[</span><span class="n">pair</span><span class="p">].</span><span class="nf">item</span><span class="p">())</span>
        <span class="n">line</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">pair </span><span class="si">{</span><span class="n">pair</span><span class="si">:</span><span class="mi">2</span><span class="si">}</span><span class="s">: training showed up to </span><span class="si">{</span><span class="nf">min</span><span class="p">(</span><span class="n">seen</span><span class="p">,</span> <span class="mi">360</span><span class="p">)</span><span class="si">:</span><span class="mf">6.1</span><span class="n">f</span><span class="si">}</span><span class="s">°;</span><span class="sh">"</span>
        <span class="n">line</span> <span class="o">+=</span> <span class="sa">f</span><span class="sh">"</span><span class="s"> at </span><span class="si">{</span><span class="n">distance</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> it asks for </span><span class="si">{</span><span class="n">asked</span><span class="si">:</span><span class="mf">9.1</span><span class="n">f</span><span class="si">}</span><span class="s">°</span><span class="sh">"</span>
        <span class="k">if</span> <span class="n">stretched</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
            <span class="n">after</span> <span class="o">=</span> <span class="n">math</span><span class="p">.</span><span class="nf">degrees</span><span class="p">(</span><span class="n">distance</span> <span class="o">*</span> <span class="n">stretched</span><span class="p">[</span><span class="n">pair</span><span class="p">].</span><span class="nf">item</span><span class="p">())</span>
            <span class="n">line</span> <span class="o">+=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">, after the stretch </span><span class="si">{</span><span class="n">after</span><span class="si">:</span><span class="mf">9.1</span><span class="n">f</span><span class="si">}</span><span class="s">°</span><span class="sh">"</span>
        <span class="nf">print</span><span class="p">(</span><span class="n">line</span><span class="p">)</span>


<span class="nf">draw_clocks</span><span class="p">(</span><span class="nf">rope_frequencies</span><span class="p">(</span><span class="n">tiny</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">tiny</span><span class="p">.</span><span class="n">base</span><span class="p">))</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/09/output-02.png" alt="Output of the code above" loading="lazy"></p> <pre class="tfs-printed"><code>pair  2: training showed up to  360.0°; at 16,000 it asks for  515516.6°
pair 16: training showed up to  360.0°; at 16,000 it asks for    9167.3°
pair 28: training showed up to   37.1°; at 16,000 it asks for     289.9°</code></pre> <p>The fast pair asks for an angle of many turns, which lands somewhere on a circle it has covered completely: familiar. The slow pair asks for an angle far beyond the sliver it ever showed: a direction the model has never seen.</p> <p>That is the picture at the top of the lesson. If the story is right, slowing down only the pairs that never finished a turn, so that 16k tokens turn them no further than 2,048 used to, should take the wall down, and slowing down only the fast ones should not. Both experiments take a few lines.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">slow_pairs_only</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">,</span> <span class="n">s</span><span class="p">):</span>
    <span class="n">freq</span> <span class="o">=</span> <span class="nf">rope_frequencies</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">where</span><span class="p">(</span><span class="n">slow</span><span class="p">,</span> <span class="n">freq</span> <span class="o">/</span> <span class="n">s</span><span class="p">,</span> <span class="n">freq</span><span class="p">),</span> <span class="mf">1.0</span>


<span class="k">def</span> <span class="nf">fast_pairs_only</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">,</span> <span class="n">s</span><span class="p">):</span>
    <span class="n">freq</span> <span class="o">=</span> <span class="nf">rope_frequencies</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">where</span><span class="p">(</span><span class="n">slow</span><span class="p">,</span> <span class="n">freq</span><span class="p">,</span> <span class="n">freq</span> <span class="o">/</span> <span class="n">s</span><span class="p">),</span> <span class="mf">1.0</span>


<span class="n">STRETCHES</span><span class="p">[</span><span class="sh">"</span><span class="s">slow pairs only</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">slow_pairs_only</span>
<span class="n">STRETCHES</span><span class="p">[</span><span class="sh">"</span><span class="s">fast pairs only</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">fast_pairs_only</span>
<span class="k">for</span> <span class="n">method</span> <span class="ow">in</span> <span class="p">[</span><span class="sh">"</span><span class="s">slow pairs only</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">fast pairs only</span><span class="sh">"</span><span class="p">]:</span>
    <span class="nf">stretch</span><span class="p">(</span><span class="n">tiny</span><span class="p">,</span> <span class="n">method</span><span class="p">,</span> <span class="n">STRETCH</span><span class="p">)</span>
    <span class="n">curves</span><span class="p">[</span><span class="n">method</span><span class="p">]</span> <span class="o">=</span> <span class="nf">average_losses</span><span class="p">(</span><span class="n">tiny</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">bucket_table</span><span class="p">(</span><span class="n">names</span><span class="p">):</span>
    <span class="n">edges</span> <span class="o">=</span> <span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="n">TRAINED</span> <span class="o">//</span> <span class="mi">2</span><span class="p">,</span> <span class="n">TRAINED</span><span class="p">,</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">TRAINED</span><span class="p">,</span> <span class="n">LENGTH</span> <span class="o">//</span> <span class="mi">2</span><span class="p">,</span> <span class="n">LENGTH</span><span class="p">]</span>
    <span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">names</span><span class="p">:</span>
        <span class="n">row</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">stretch</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">}</span>
        <span class="k">for</span> <span class="n">a</span><span class="p">,</span> <span class="n">b</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">edges</span><span class="p">[:</span><span class="o">-</span><span class="mi">1</span><span class="p">],</span> <span class="n">edges</span><span class="p">[</span><span class="mi">1</span><span class="p">:]):</span>
            <span class="n">row</span><span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">a</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s">–</span><span class="si">{</span><span class="n">b</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">curves</span><span class="p">[</span><span class="n">name</span><span class="p">][</span><span class="n">a</span><span class="p">:</span><span class="n">b</span><span class="p">].</span><span class="nf">mean</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
        <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">row</span><span class="p">)</span>
    <span class="k">return</span> <span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>


<span class="nf">bucket_table</span><span class="p">([</span><span class="sh">"</span><span class="s">none</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">slow pairs only</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">fast pairs only</span><span class="sh">"</span><span class="p">])</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">stretch</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">0–1,024</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">1,024–2,048</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">2,048–4,096</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">4,096–8,192</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">8,192–16,384</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">none</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.25</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.53</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">9.30</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8.89</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8.92</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">slow pairs only</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.70</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5.43</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5.57</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5.82</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5.90</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">fast pairs only</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5.36</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5.52</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7.63</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7.90</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8.15</td></tr></tbody></table></div> <p>The table is the loss averaged over stretches of positions, the first two columns inside the trained window and the other three beyond it.</p> <p>The fast pairs are not the problem: slowing them down leaves the wall standing and spoils the trained window as well. Slowing down the slow ones lowers the wall a long way, so that is where it comes from.</p> <p>But it is a clumsy cure, and it costs a lot even inside the window, where nothing was wrong. It cuts the spectrum in two: the last pair that finished a turn keeps its speed, and its neighbour suddenly turns eight times slower.</p> <p>The model reads neighbouring pairs together, and a seam between them hurts. The methods of the next section are, one way or another, ways to slow the slow pairs down without a seam.</p> <h2 id="5-five-ways-to-stretch-the-clocks">5. Five ways to stretch the clocks</h2> <p><strong>Position interpolation</strong> (Chen, Wong, Chen and Tian at Meta; kaiokendev at the same time). To read \(s\) times further, divide every position by \(s\):</p> \[m\theta_i \;\to\; \frac{m}{s}\theta_i \quad\Longleftrightarrow\quad \theta_i \;\to\; \frac{\theta_i}{s}.\] <p>Every angle at position 16,384 is now an angle the model saw at 2,048, so nothing is out of range. The fast pairs pay for it. Two neighbouring tokens used to differ by \(\theta_0 = 1\) radian in the fastest pair and now differ by \(1/8\), and the model’s sense of word order, which lives in those pairs, gets blurry. The paper’s answer is a short fine-tuning, after which the model has learned the new spacing.</p> <p><strong>NTK-aware scaling</strong> (bloc97 on Reddit). Leave the fast pairs alone and stretch the slow ones, by changing the base instead of the positions:</p> \[b' = b \cdot s^{\,d/(d-2)},\] <p>which gives every pair a new frequency</p> \[\theta'_i = \theta_i \cdot s^{-2i/(d-2)}.\] <p>The fastest pair, \(i = 0\), keeps its frequency; the slowest, \(i = d/2 - 1\), is divided by exactly \(s\); the pairs in between are divided by a power of \(s\) that grows with \(i\). The odd exponent \(d/(d-2)\) is what makes the slowest pair land exactly where position interpolation would put it.</p> <p>The name points to the theory of neural tangent kernels and to the Fourier-features work of Tancik and colleagues, which bloc97 cited: networks learn high frequencies poorly unless they are handed them, so the fast pairs shouldn’t be squeezed.</p> <p><strong>Dynamic NTK</strong> (emozilla on Reddit). Don’t stretch until you have to: recompute the base with \(s = n / L\) as the text grows past \(L\), so that short texts run unchanged. It shares a catch with every scheme that changes while you read: the keys already in the cache were rotated with the old base.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">interpolate</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">,</span> <span class="n">s</span><span class="p">):</span>
    <span class="k">return</span> <span class="nf">rope_frequencies</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">)</span> <span class="o">/</span> <span class="n">s</span><span class="p">,</span> <span class="mf">1.0</span>


<span class="k">def</span> <span class="nf">ntk</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">,</span> <span class="n">s</span><span class="p">):</span>
    <span class="k">return</span> <span class="nf">rope_frequencies</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span> <span class="o">*</span> <span class="n">s</span> <span class="o">**</span> <span class="p">(</span><span class="n">head_dim</span> <span class="o">/</span> <span class="p">(</span><span class="n">head_dim</span> <span class="o">-</span> <span class="mi">2</span><span class="p">))),</span> <span class="mf">1.0</span>


<span class="n">STRETCHES</span><span class="p">[</span><span class="sh">"</span><span class="s">PI</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">interpolate</span>
<span class="n">STRETCHES</span><span class="p">[</span><span class="sh">"</span><span class="s">NTK</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">ntk</span>
</code></pre></div></div> <p><strong>YaRN</strong> (Peng, Quesnelle, Fan and Shippole, 2023) does two things. The first is <em>NTK-by-parts</em>, the experiment of section 4 turned into a rule. Measure each pair by the turns \(r_i = L/\lambda_i\) it made in training.</p> <p>Pairs that made more than \(\beta = 32\) turns are left alone; pairs that made fewer than \(\alpha = 1\) are interpolated in full; the ones in between are blended:</p> \[\theta'_i = \big(1 - \gamma_i\big)\,\frac{\theta_i}{s} + \gamma_i\,\theta_i,\] <p>where \(\gamma_i\) goes from 1 for the fast pairs to 0 for the slow ones. The second is a <em>temperature</em>: all attention logits are multiplied by \(1/t\), with</p> \[\sqrt{1/t} = 0.1 \ln s + 1.\] <p>A longer text gives every query more keys to spread its attention over, and its softmax gets flatter; the temperature sharpens it back. The formula is a fit the authors found empirically.</p> <p>Implementations multiply both the queries and the keys by \(\sqrt{1/t}\), which is why the formula is written for the square root. Section 6 measures the flattening.</p> <p>Now a detail on which the paper and the code disagree. The paper draws \(\gamma\) as a straight line in the number of turns, \(\gamma_i = (r_i - \alpha)/(\beta - \alpha)\).</p> <p>The authors’ code, which Hugging Face and vLLM follow, draws the straight line in the <em>index</em> of the pair: it finds the pair that makes \(\beta\) turns and the pair that makes \(\alpha\), rounds the first down and the second up to whole pairs, and blends linearly between the two indices.</p> <p>Turns fall exponentially with the index, so these are different curves. We write the code’s version, because that is what every model with YaRN in its config runs, and keep the paper’s for comparison.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">yarn</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">,</span> <span class="n">s</span><span class="p">,</span> <span class="n">trained</span><span class="o">=</span><span class="bp">None</span><span class="p">,</span> <span class="n">fast</span><span class="o">=</span><span class="mi">32</span><span class="p">,</span> <span class="n">slow</span><span class="o">=</span><span class="mi">1</span><span class="p">):</span>
    <span class="n">trained</span> <span class="o">=</span> <span class="n">trained</span> <span class="ow">or</span> <span class="n">TRAINED</span>
    <span class="n">freq</span> <span class="o">=</span> <span class="nf">rope_frequencies</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">pair_making</span><span class="p">(</span><span class="n">turns</span><span class="p">):</span>  <span class="c1"># the pair index that makes this many turns in training
</span>        <span class="k">return</span> <span class="n">head_dim</span> <span class="o">*</span> <span class="n">math</span><span class="p">.</span><span class="nf">log</span><span class="p">(</span><span class="n">trained</span> <span class="o">/</span> <span class="p">(</span><span class="n">turns</span> <span class="o">*</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">math</span><span class="p">.</span><span class="n">pi</span><span class="p">))</span> <span class="o">/</span> <span class="p">(</span><span class="mi">2</span> <span class="o">*</span> <span class="n">math</span><span class="p">.</span><span class="nf">log</span><span class="p">(</span><span class="n">base</span><span class="p">))</span>

    <span class="n">first</span> <span class="o">=</span> <span class="nf">max</span><span class="p">(</span><span class="n">math</span><span class="p">.</span><span class="nf">floor</span><span class="p">(</span><span class="nf">pair_making</span><span class="p">(</span><span class="n">fast</span><span class="p">)),</span> <span class="mi">0</span><span class="p">)</span>
    <span class="n">last</span> <span class="o">=</span> <span class="nf">min</span><span class="p">(</span><span class="n">math</span><span class="p">.</span><span class="nf">ceil</span><span class="p">(</span><span class="nf">pair_making</span><span class="p">(</span><span class="n">slow</span><span class="p">)),</span> <span class="n">head_dim</span> <span class="o">-</span> <span class="mi">1</span><span class="p">)</span>
    <span class="n">pairs</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">head_dim</span> <span class="o">//</span> <span class="mi">2</span><span class="p">).</span><span class="nf">float</span><span class="p">()</span>
    <span class="n">gamma</span> <span class="o">=</span> <span class="mi">1</span> <span class="o">-</span> <span class="p">((</span><span class="n">pairs</span> <span class="o">-</span> <span class="n">first</span><span class="p">)</span> <span class="o">/</span> <span class="p">(</span><span class="n">last</span> <span class="o">-</span> <span class="n">first</span><span class="p">)).</span><span class="nf">clamp</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>  <span class="c1"># 1: keep, 0: interpolate
</span>    <span class="n">mixed</span> <span class="o">=</span> <span class="p">(</span><span class="mi">1</span> <span class="o">-</span> <span class="n">gamma</span><span class="p">)</span> <span class="o">*</span> <span class="n">freq</span> <span class="o">/</span> <span class="n">s</span> <span class="o">+</span> <span class="n">gamma</span> <span class="o">*</span> <span class="n">freq</span>
    <span class="k">return</span> <span class="n">mixed</span><span class="p">,</span> <span class="mf">0.1</span> <span class="o">*</span> <span class="n">math</span><span class="p">.</span><span class="nf">log</span><span class="p">(</span><span class="n">s</span><span class="p">)</span> <span class="o">+</span> <span class="mi">1</span>


<span class="k">def</span> <span class="nf">yarn_as_written</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">,</span> <span class="n">s</span><span class="p">,</span> <span class="n">trained</span><span class="o">=</span><span class="bp">None</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">beta</span><span class="o">=</span><span class="mi">32</span><span class="p">):</span>
    <span class="n">trained</span> <span class="o">=</span> <span class="n">trained</span> <span class="ow">or</span> <span class="n">TRAINED</span>
    <span class="n">freq</span> <span class="o">=</span> <span class="nf">rope_frequencies</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">)</span>
    <span class="n">turns</span> <span class="o">=</span> <span class="n">trained</span> <span class="o">*</span> <span class="n">freq</span> <span class="o">/</span> <span class="p">(</span><span class="mi">2</span> <span class="o">*</span> <span class="n">math</span><span class="p">.</span><span class="n">pi</span><span class="p">)</span>
    <span class="n">gamma</span> <span class="o">=</span> <span class="p">((</span><span class="n">turns</span> <span class="o">-</span> <span class="n">alpha</span><span class="p">)</span> <span class="o">/</span> <span class="p">(</span><span class="n">beta</span> <span class="o">-</span> <span class="n">alpha</span><span class="p">)).</span><span class="nf">clamp</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
    <span class="nf">return </span><span class="p">(</span><span class="mi">1</span> <span class="o">-</span> <span class="n">gamma</span><span class="p">)</span> <span class="o">*</span> <span class="n">freq</span> <span class="o">/</span> <span class="n">s</span> <span class="o">+</span> <span class="n">gamma</span> <span class="o">*</span> <span class="n">freq</span><span class="p">,</span> <span class="mf">0.1</span> <span class="o">*</span> <span class="n">math</span><span class="p">.</span><span class="nf">log</span><span class="p">(</span><span class="n">s</span><span class="p">)</span> <span class="o">+</span> <span class="mi">1</span>


<span class="k">def</span> <span class="nf">yarn_cold</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">,</span> <span class="n">s</span><span class="p">):</span>
    <span class="n">freq</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="nf">yarn</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">,</span> <span class="n">s</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">freq</span><span class="p">,</span> <span class="mf">1.0</span>


<span class="n">STRETCHES</span><span class="p">[</span><span class="sh">"</span><span class="s">YaRN</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">yarn</span>
<span class="n">STRETCHES</span><span class="p">[</span><span class="sh">"</span><span class="s">YaRN, no temperature</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">yarn_cold</span>
</code></pre></div></div> <p>Back to the three clocks, now with YaRN’s hand in teal: the fast pair keeps its angle, the slow pair’s hand returns into the arc the model knows.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">yarn_freq</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="nf">yarn</span><span class="p">(</span><span class="n">tiny</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">tiny</span><span class="p">.</span><span class="n">base</span><span class="p">,</span> <span class="n">STRETCH</span><span class="p">)</span>
<span class="nf">draw_clocks</span><span class="p">(</span><span class="nf">rope_frequencies</span><span class="p">(</span><span class="n">tiny</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">tiny</span><span class="p">.</span><span class="n">base</span><span class="p">),</span> <span class="n">yarn_freq</span><span class="p">)</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/09/output-03.png" alt="Output of the code above" loading="lazy"></p> <pre class="tfs-printed"><code>pair  2: training showed up to  360.0°; at 16,000 it asks for  515516.6°, after the stretch  515516.6°
pair 16: training showed up to  360.0°; at 16,000 it asks for    9167.3°, after the stretch    4231.1°
pair 28: training showed up to   37.1°; at 16,000 it asks for     289.9°, after the stretch      36.2°</code></pre> <p><strong>Llama 3.1</strong> stretches Llama 3 eight times with a rule of Meta’s own, which the Llama 3 paper doesn’t describe: it lives only in Meta’s code, with its constants commented “values obtained from grid search”.</p> <p>Pairs whose wavelength is shorter than a quarter of the training window are kept, pairs whose wavelength is longer than the window are divided by the factor, and the ones in between are blended linearly in \(L/\lambda\), that is, in the number of turns.</p> <p>That is the paper’s version of YaRN’s ramp with \(\alpha = 1\) and \(\beta = 4\), without the temperature. The code below follows Meta’s, and the check after it shows the coincidence is exact.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">llama3</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">,</span> <span class="n">s</span><span class="p">,</span> <span class="n">trained</span><span class="o">=</span><span class="bp">None</span><span class="p">,</span> <span class="n">low</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">high</span><span class="o">=</span><span class="mi">4</span><span class="p">):</span>
    <span class="n">trained</span> <span class="o">=</span> <span class="n">trained</span> <span class="ow">or</span> <span class="n">TRAINED</span>
    <span class="n">freq</span> <span class="o">=</span> <span class="nf">rope_frequencies</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">)</span>
    <span class="n">wavelength</span> <span class="o">=</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">math</span><span class="p">.</span><span class="n">pi</span> <span class="o">/</span> <span class="n">freq</span>
    <span class="n">out</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">f</span><span class="p">,</span> <span class="n">w</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">freq</span><span class="p">.</span><span class="nf">tolist</span><span class="p">(),</span> <span class="n">wavelength</span><span class="p">.</span><span class="nf">tolist</span><span class="p">()):</span>
        <span class="k">if</span> <span class="n">w</span> <span class="o">&lt;</span> <span class="n">trained</span> <span class="o">/</span> <span class="n">high</span><span class="p">:</span>
            <span class="n">out</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">f</span><span class="p">)</span>
        <span class="k">elif</span> <span class="n">w</span> <span class="o">&gt;</span> <span class="n">trained</span> <span class="o">/</span> <span class="n">low</span><span class="p">:</span>
            <span class="n">out</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">f</span> <span class="o">/</span> <span class="n">s</span><span class="p">)</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="n">keep</span> <span class="o">=</span> <span class="p">(</span><span class="n">trained</span> <span class="o">/</span> <span class="n">w</span> <span class="o">-</span> <span class="n">low</span><span class="p">)</span> <span class="o">/</span> <span class="p">(</span><span class="n">high</span> <span class="o">-</span> <span class="n">low</span><span class="p">)</span>
            <span class="n">out</span><span class="p">.</span><span class="nf">append</span><span class="p">((</span><span class="mi">1</span> <span class="o">-</span> <span class="n">keep</span><span class="p">)</span> <span class="o">*</span> <span class="n">f</span> <span class="o">/</span> <span class="n">s</span> <span class="o">+</span> <span class="n">keep</span> <span class="o">*</span> <span class="n">f</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">out</span><span class="p">),</span> <span class="mf">1.0</span>


<span class="n">STRETCHES</span><span class="p">[</span><span class="sh">"</span><span class="s">Llama 3.1</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">llama3</span>

<span class="n">meta</span> <span class="o">=</span> <span class="nf">llama3</span><span class="p">(</span><span class="n">tiny</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">tiny</span><span class="p">.</span><span class="n">base</span><span class="p">,</span> <span class="n">STRETCH</span><span class="p">)[</span><span class="mi">0</span><span class="p">]</span>
<span class="n">paper</span> <span class="o">=</span> <span class="nf">yarn_as_written</span><span class="p">(</span><span class="n">tiny</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">tiny</span><span class="p">.</span><span class="n">base</span><span class="p">,</span> <span class="n">STRETCH</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">beta</span><span class="o">=</span><span class="mi">4</span><span class="p">)[</span><span class="mi">0</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">Llama 3.1 against YaRN as written, β = 4:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="n">meta</span> <span class="o">/</span> <span class="n">paper</span> <span class="o">-</span> <span class="mi">1</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>Llama 3.1 against YaRN as written, β = 4: 1.2e-07</code></pre> <p>Each method against the transformers library, which implements them for the configs of real models, on three head shapes: TinyLlama’s, Qwen3’s and Llama 3.1’s. Dynamic NTK is checked at a length of \(sL\), where it equals NTK.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">LlamaConfig</span>
<span class="kn">from</span> <span class="n">transformers.modeling_rope_utils</span> <span class="kn">import</span> <span class="n">ROPE_INIT_FUNCTIONS</span>


<span class="k">def</span> <span class="nf">library</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">,</span> <span class="n">positions</span><span class="p">,</span> <span class="n">params</span><span class="p">,</span> <span class="n">length</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
    <span class="n">c</span> <span class="o">=</span> <span class="nc">LlamaConfig</span><span class="p">(</span>
        <span class="n">hidden_size</span><span class="o">=</span><span class="n">head_dim</span> <span class="o">*</span> <span class="mi">8</span><span class="p">,</span>
        <span class="n">num_attention_heads</span><span class="o">=</span><span class="mi">8</span><span class="p">,</span>
        <span class="n">head_dim</span><span class="o">=</span><span class="n">head_dim</span><span class="p">,</span>
        <span class="n">max_position_embeddings</span><span class="o">=</span><span class="n">positions</span><span class="p">,</span>
        <span class="n">rope_parameters</span><span class="o">=</span><span class="nf">dict</span><span class="p">(</span><span class="n">rope_theta</span><span class="o">=</span><span class="n">base</span><span class="p">,</span> <span class="o">**</span><span class="n">params</span><span class="p">),</span>
    <span class="p">)</span>
    <span class="k">return</span> <span class="n">ROPE_INIT_FUNCTIONS</span><span class="p">[</span><span class="n">params</span><span class="p">[</span><span class="sh">"</span><span class="s">rope_type</span><span class="sh">"</span><span class="p">]](</span><span class="n">c</span><span class="p">,</span> <span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span><span class="p">,</span> <span class="n">seq_len</span><span class="o">=</span><span class="n">length</span><span class="p">)</span>


<span class="n">SHAPES</span> <span class="o">=</span> <span class="p">[(</span><span class="mi">64</span><span class="p">,</span> <span class="mf">10000.0</span><span class="p">,</span> <span class="mi">2048</span><span class="p">,</span> <span class="mi">8</span><span class="p">),</span> <span class="p">(</span><span class="mi">128</span><span class="p">,</span> <span class="mf">1e6</span><span class="p">,</span> <span class="mi">32768</span><span class="p">,</span> <span class="mi">4</span><span class="p">),</span> <span class="p">(</span><span class="mi">128</span><span class="p">,</span> <span class="mf">5e5</span><span class="p">,</span> <span class="mi">8192</span><span class="p">,</span> <span class="mi">8</span><span class="p">)]</span>
<span class="n">checks</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">,</span> <span class="n">trained</span><span class="p">,</span> <span class="n">s</span> <span class="ow">in</span> <span class="n">SHAPES</span><span class="p">:</span>
    <span class="n">longer</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">original_max_position_embeddings</span><span class="sh">"</span><span class="p">:</span> <span class="n">trained</span><span class="p">}</span>
    <span class="n">llama_params</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">low_freq_factor</span><span class="sh">"</span><span class="p">:</span> <span class="mi">1</span><span class="p">,</span> <span class="sh">"</span><span class="s">high_freq_factor</span><span class="sh">"</span><span class="p">:</span> <span class="mi">4</span><span class="p">,</span> <span class="o">**</span><span class="n">longer</span><span class="p">}</span>
    <span class="n">cases</span> <span class="o">=</span> <span class="p">[</span>
        <span class="p">(</span><span class="sh">"</span><span class="s">PI</span><span class="sh">"</span><span class="p">,</span> <span class="nf">interpolate</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">,</span> <span class="n">s</span><span class="p">),</span> <span class="n">trained</span> <span class="o">*</span> <span class="n">s</span><span class="p">,</span>
         <span class="p">{</span><span class="sh">"</span><span class="s">rope_type</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">linear</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">factor</span><span class="sh">"</span><span class="p">:</span> <span class="n">s</span><span class="p">}),</span>
        <span class="p">(</span><span class="sh">"</span><span class="s">NTK</span><span class="sh">"</span><span class="p">,</span> <span class="nf">ntk</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">,</span> <span class="n">s</span><span class="p">),</span> <span class="n">trained</span><span class="p">,</span> <span class="p">{</span><span class="sh">"</span><span class="s">rope_type</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">dynamic</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">factor</span><span class="sh">"</span><span class="p">:</span> <span class="mf">1.0</span><span class="p">}),</span>
        <span class="p">(</span><span class="sh">"</span><span class="s">YaRN</span><span class="sh">"</span><span class="p">,</span> <span class="nf">yarn</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">,</span> <span class="n">s</span><span class="p">,</span> <span class="n">trained</span><span class="p">),</span> <span class="n">trained</span> <span class="o">*</span> <span class="n">s</span><span class="p">,</span>
         <span class="p">{</span><span class="sh">"</span><span class="s">rope_type</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">yarn</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">factor</span><span class="sh">"</span><span class="p">:</span> <span class="n">s</span><span class="p">,</span> <span class="o">**</span><span class="n">longer</span><span class="p">}),</span>
        <span class="p">(</span><span class="sh">"</span><span class="s">Llama 3.1</span><span class="sh">"</span><span class="p">,</span> <span class="nf">llama3</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">,</span> <span class="n">s</span><span class="p">,</span> <span class="n">trained</span><span class="p">),</span> <span class="n">trained</span> <span class="o">*</span> <span class="n">s</span><span class="p">,</span>
         <span class="p">{</span><span class="sh">"</span><span class="s">rope_type</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">llama3</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">factor</span><span class="sh">"</span><span class="p">:</span> <span class="n">s</span><span class="p">,</span> <span class="o">**</span><span class="n">llama_params</span><span class="p">}),</span>
    <span class="p">]</span>
    <span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="p">(</span><span class="n">freq</span><span class="p">,</span> <span class="n">scale</span><span class="p">),</span> <span class="n">positions</span><span class="p">,</span> <span class="n">params</span> <span class="ow">in</span> <span class="n">cases</span><span class="p">:</span>
        <span class="n">length</span> <span class="o">=</span> <span class="n">s</span> <span class="o">*</span> <span class="n">trained</span> <span class="k">if</span> <span class="n">name</span> <span class="o">==</span> <span class="sh">"</span><span class="s">NTK</span><span class="sh">"</span> <span class="k">else</span> <span class="bp">None</span>
        <span class="n">ref_freq</span><span class="p">,</span> <span class="n">ref_scale</span> <span class="o">=</span> <span class="nf">library</span><span class="p">(</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">base</span><span class="p">,</span> <span class="n">positions</span><span class="p">,</span> <span class="n">params</span><span class="p">,</span> <span class="n">length</span><span class="p">)</span>
        <span class="n">checks</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
            <span class="p">{</span>
                <span class="sh">"</span><span class="s">head, base, window</span><span class="sh">"</span><span class="p">:</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">head_dim</span><span class="si">}</span><span class="s">, </span><span class="si">{</span><span class="n">base</span><span class="si">:</span><span class="p">,.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s">, </span><span class="si">{</span><span class="n">trained</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> × </span><span class="si">{</span><span class="n">s</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">method</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">max relative difference</span><span class="sh">"</span><span class="p">:</span> <span class="p">(</span><span class="n">freq</span> <span class="o">/</span> <span class="n">ref_freq</span> <span class="o">-</span> <span class="mi">1</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">(),</span>
                <span class="sh">"</span><span class="s">scale, ours</span><span class="sh">"</span><span class="p">:</span> <span class="n">scale</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">scale, library</span><span class="sh">"</span><span class="p">:</span> <span class="n">ref_scale</span><span class="p">,</span>
            <span class="p">}</span>
        <span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">checks</span><span class="p">),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">3</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">head, base, window</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">method</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">max relative difference</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">scale, ours</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">scale, library</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">64, 10,000, 2,048 × 8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">PI</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">64, 10,000, 2,048 × 8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">NTK</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">64, 10,000, 2,048 × 8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">YaRN</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.208</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.208</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">64, 10,000, 2,048 × 8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Llama 3.1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">128, 1,000,000, 32,768 × 4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">PI</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">128, 1,000,000, 32,768 × 4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">NTK</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">128, 1,000,000, 32,768 × 4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">YaRN</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.139</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.139</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">128, 1,000,000, 32,768 × 4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Llama 3.1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">128, 500,000, 8,192 × 8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">PI</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">128, 500,000, 8,192 × 8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">NTK</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">128, 500,000, 8,192 × 8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">YaRN</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.208</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.208</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">128, 500,000, 8,192 × 8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Llama 3.1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td></tr></tbody></table></div> <p>All four agree with the library to the last bit of a 32-bit float. Here is what each does to TinyLlama’s pairs when the window is stretched eight times: the frequency of each pair after the stretch, divided by its frequency before.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">original</span> <span class="o">=</span> <span class="nf">rope_frequencies</span><span class="p">(</span><span class="n">tiny</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">tiny</span><span class="p">.</span><span class="n">base</span><span class="p">)</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">7.4</span><span class="p">,</span> <span class="mf">3.8</span><span class="p">))</span>
<span class="k">for</span> <span class="n">method</span><span class="p">,</span> <span class="n">color</span> <span class="ow">in</span> <span class="p">[</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">PI</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">]),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">NTK</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">data</span><span class="sh">"</span><span class="p">]),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">Llama 3.1</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">]),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">YaRN</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">]),</span>
<span class="p">]:</span>
    <span class="n">freq</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">STRETCHES</span><span class="p">[</span><span class="n">method</span><span class="p">](</span><span class="n">tiny</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">tiny</span><span class="p">.</span><span class="n">base</span><span class="p">,</span> <span class="n">STRETCH</span><span class="p">)</span>
    <span class="n">ratio</span> <span class="o">=</span> <span class="n">freq</span> <span class="o">/</span> <span class="n">original</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">ratio</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="n">method</span><span class="p">,</span> <span class="n">marker</span><span class="o">=</span><span class="sh">"</span><span class="s">o</span><span class="sh">"</span><span class="p">,</span> <span class="n">markersize</span><span class="o">=</span><span class="mi">3</span><span class="p">)</span>
<span class="n">written</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="nf">yarn_as_written</span><span class="p">(</span><span class="n">tiny</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">tiny</span><span class="p">.</span><span class="n">base</span><span class="p">,</span> <span class="n">STRETCH</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">written</span> <span class="o">/</span> <span class="n">original</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">],</span> <span class="n">linewidth</span><span class="o">=</span><span class="mf">1.4</span><span class="p">,</span> <span class="n">linestyle</span><span class="o">=</span><span class="sh">"</span><span class="s">--</span><span class="sh">"</span><span class="p">,</span>
        <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">YaRN as the paper writes it</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_yscale</span><span class="p">(</span><span class="sh">"</span><span class="s">log</span><span class="sh">"</span><span class="p">,</span> <span class="n">base</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">rotary pair, fastest to slowest</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">new frequency / old</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">TinyLlama</span><span class="sh">'</span><span class="s">s </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">original</span><span class="p">)</span><span class="si">}</span><span class="s"> pairs, bent for an </span><span class="si">{</span><span class="n">STRETCH</span><span class="si">}</span><span class="s">× window</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">9</span><span class="p">,</span> <span class="n">loc</span><span class="o">=</span><span class="sh">"</span><span class="s">lower left</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/09/output-04.png" alt="TinyLlama" loading="lazy"></p> <p>Position interpolation is the flat line at \(1/8\): every pair slowed down equally. NTK bends smoothly from 1 to \(1/8\). YaRN keeps the first pairs exactly, falls along a straight segment and reaches \(1/8\) for the pairs that never finished a turn; the paper’s version, dashed, takes a different path through the same middle. Llama 3.1 keeps more of the fast pairs, because its \(\beta\) is 4 rather than 32, and switches over in fewer pairs.</p> <h2 id="6-the-race">6. The race</h2> <p>All methods on the same eight books, with no training. Dynamic NTK at a fixed 16k length is NTK with the factor 8, so it isn’t a separate line here; the difference shows on shorter texts, in the passkey test below.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">for</span> <span class="n">method</span> <span class="ow">in</span> <span class="p">[</span><span class="sh">"</span><span class="s">PI</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">NTK</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">YaRN</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">YaRN, no temperature</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Llama 3.1</span><span class="sh">"</span><span class="p">]:</span>
    <span class="nf">stretch</span><span class="p">(</span><span class="n">tiny</span><span class="p">,</span> <span class="n">method</span><span class="p">,</span> <span class="n">STRETCH</span><span class="p">)</span>
    <span class="n">curves</span><span class="p">[</span><span class="n">method</span><span class="p">]</span> <span class="o">=</span> <span class="nf">average_losses</span><span class="p">(</span><span class="n">tiny</span><span class="p">)</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">7.4</span><span class="p">,</span> <span class="mf">3.8</span><span class="p">))</span>
<span class="k">for</span> <span class="n">method</span><span class="p">,</span> <span class="n">color</span> <span class="ow">in</span> <span class="p">[</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">none</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">]),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">PI</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">]),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">NTK</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">data</span><span class="sh">"</span><span class="p">]),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">Llama 3.1</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">]),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">YaRN</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">]),</span>
<span class="p">]:</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="nf">smooth</span><span class="p">(</span><span class="n">curves</span><span class="p">[</span><span class="n">method</span><span class="p">]),</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="n">method</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">axvline</span><span class="p">(</span><span class="n">TRAINED</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">],</span> <span class="n">linestyle</span><span class="o">=</span><span class="sh">"</span><span class="s">--</span><span class="sh">"</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylim</span><span class="p">(</span><span class="n">top</span><span class="o">=</span><span class="mi">2</span> <span class="o">*</span> <span class="n">curves</span><span class="p">[</span><span class="sh">"</span><span class="s">YaRN</span><span class="sh">"</span><span class="p">].</span><span class="nf">mean</span><span class="p">().</span><span class="nf">item</span><span class="p">())</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">position in the book</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">loss, nats per token</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">TinyLlama stretched </span><span class="si">{</span><span class="n">STRETCH</span><span class="si">}</span><span class="s">× without training</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">ncol</span><span class="o">=</span><span class="mi">3</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
<span class="nf">bucket_table</span><span class="p">([</span><span class="sh">"</span><span class="s">none</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">PI</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">NTK</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Llama 3.1</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">YaRN</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">YaRN, no temperature</span><span class="sh">"</span><span class="p">])</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/09/output-05.png" alt="Output of the code above" loading="lazy"></p> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">stretch</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">0–1,024</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">1,024–2,048</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">2,048–4,096</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">4,096–8,192</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">8,192–16,384</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">none</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.25</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.53</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">9.30</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8.89</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8.92</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">PI</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5.46</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5.62</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5.59</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5.63</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5.67</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">NTK</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.38</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.72</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.63</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.72</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7.00</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Llama 3.1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.39</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.00</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.03</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.43</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.67</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">YaRN</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.36</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.67</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.60</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.70</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.00</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">YaRN, no temperature</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.36</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.81</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.85</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.19</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.72</td></tr></tbody></table></div> <p>Read the table by columns. Inside the trained window, the first two columns, a method’s cost is how much it disturbs what the model already knew, and position interpolation pays the most: it slowed the fast pairs too, and the model’s sense of word order is blurred everywhere, near and far.</p> <p>NTK leaves the window almost as it was and holds well past it, until its stretch of the slow pairs runs out, because by design only the very slowest pair is divided by the full factor. YaRN holds furthest.</p> <p>Llama 3.1’s rule, tuned by Meta for a model with a far larger base, holds too, though not as well as YaRN on TinyLlama. The last row isolates its second idea, the temperature, and shows it is not a detail.</p> <p>Why a temperature at all? The entropy of a query’s attention, in nats, says how many keys it spreads over: a query that looks at exactly one key has entropy 0, and one spread evenly over \(n\) keys has \(\ln n\). We take the last 64 queries of a book at growing lengths, in a middle layer, and measure.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">layer</span> <span class="o">=</span> <span class="n">tiny</span><span class="p">.</span><span class="n">layers</span><span class="p">[</span><span class="nf">len</span><span class="p">(</span><span class="n">tiny</span><span class="p">.</span><span class="n">layers</span><span class="p">)</span> <span class="o">//</span> <span class="mi">2</span><span class="p">].</span><span class="n">self_attn</span>
<span class="n">lengths</span> <span class="o">=</span> <span class="p">[</span><span class="n">TRAINED</span> <span class="o">//</span> <span class="mi">4</span><span class="p">,</span> <span class="n">TRAINED</span> <span class="o">//</span> <span class="mi">2</span><span class="p">,</span> <span class="n">TRAINED</span><span class="p">,</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">TRAINED</span><span class="p">,</span> <span class="mi">4</span> <span class="o">*</span> <span class="n">TRAINED</span><span class="p">,</span> <span class="n">LENGTH</span><span class="p">]</span>
<span class="n">entropy</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">method</span> <span class="ow">in</span> <span class="p">[</span><span class="sh">"</span><span class="s">YaRN, no temperature</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">YaRN</span><span class="sh">"</span><span class="p">]:</span>
    <span class="nf">stretch</span><span class="p">(</span><span class="n">tiny</span><span class="p">,</span> <span class="n">method</span><span class="p">,</span> <span class="n">STRETCH</span><span class="p">)</span>
    <span class="n">values</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="n">lengths</span><span class="p">:</span>
        <span class="n">layer</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="bp">True</span>
        <span class="nf">token_losses</span><span class="p">(</span><span class="n">tiny</span><span class="p">,</span> <span class="n">books</span><span class="p">[</span><span class="mi">1</span><span class="p">][</span><span class="sh">"</span><span class="s">ids</span><span class="sh">"</span><span class="p">][:,</span> <span class="p">:</span> <span class="n">n</span> <span class="o">+</span> <span class="mi">1</span><span class="p">])</span>
        <span class="n">layer</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="bp">False</span>
        <span class="n">q</span><span class="p">,</span> <span class="n">k</span> <span class="o">=</span> <span class="n">layer</span><span class="p">.</span><span class="n">kept</span>
        <span class="n">k</span> <span class="o">=</span> <span class="n">k</span><span class="p">.</span><span class="nf">repeat_interleave</span><span class="p">(</span><span class="n">layer</span><span class="p">.</span><span class="n">heads</span> <span class="o">//</span> <span class="n">layer</span><span class="p">.</span><span class="n">kv_heads</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">p</span> <span class="o">=</span> <span class="p">(</span><span class="n">q</span> <span class="o">@</span> <span class="n">k</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">2</span><span class="p">)</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="n">layer</span><span class="p">.</span><span class="n">head_dim</span><span class="p">)).</span><span class="nf">softmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">values</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="o">-</span><span class="p">(</span><span class="n">p</span> <span class="o">*</span> <span class="n">torch</span><span class="p">.</span><span class="nf">log</span><span class="p">(</span><span class="n">p</span> <span class="o">+</span> <span class="mf">1e-12</span><span class="p">)).</span><span class="nf">sum</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">).</span><span class="nf">mean</span><span class="p">().</span><span class="nf">item</span><span class="p">())</span>
    <span class="n">entropy</span><span class="p">[</span><span class="n">method</span><span class="p">]</span> <span class="o">=</span> <span class="n">values</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">7.2</span><span class="p">,</span> <span class="mf">3.4</span><span class="p">))</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">lengths</span><span class="p">,</span> <span class="n">entropy</span><span class="p">[</span><span class="sh">"</span><span class="s">YaRN, no temperature</span><span class="sh">"</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">],</span> <span class="n">marker</span><span class="o">=</span><span class="sh">"</span><span class="s">o</span><span class="sh">"</span><span class="p">,</span>
        <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">no temperature</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">lengths</span><span class="p">,</span> <span class="n">entropy</span><span class="p">[</span><span class="sh">"</span><span class="s">YaRN</span><span class="sh">"</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">],</span> <span class="n">marker</span><span class="o">=</span><span class="sh">"</span><span class="s">o</span><span class="sh">"</span><span class="p">,</span>
        <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">YaRN</span><span class="sh">'</span><span class="s">s temperature</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xscale</span><span class="p">(</span><span class="sh">"</span><span class="s">log</span><span class="sh">"</span><span class="p">,</span> <span class="n">base</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">tokens read</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">attention entropy, nats</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">A middle layer of TinyLlama: how widely the last queries look</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/09/output-06.png" alt="A middle layer of TinyLlama: how widely the last queries look" loading="lazy"></p> <p>Entropy grows with the text: the softmax spreads over more keys simply because more keys exist. The temperature doesn’t stop the growth; it lowers the whole curve. It is a blunt instrument, one number tuned on LLaMA, and the table above shows what it buys on TinyLlama.</p> <p>An average loss can hide whether a model can <em>use</em> a distant token. The passkey test, introduced by Mohtashami and Jaggi in 2023, checks that directly: a five-digit number hidden at a random depth in filler text, and the question at the end.</p> <p>Position interpolation and NTK keep their fixed factor of 8, as a model deployed with them would; dynamic NTK and YaRN are set for the length they read, so at 2,048 tokens or less they change nothing.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">FILLER</span> <span class="o">=</span> <span class="p">(</span>
    <span class="sh">"</span><span class="s">The grass is green. The sky is blue. The sun is yellow. </span><span class="sh">"</span>
    <span class="sh">"</span><span class="s">Here we go. There and back again. </span><span class="sh">"</span>
<span class="p">)</span>
<span class="n">INTRO</span> <span class="o">=</span> <span class="p">(</span>
    <span class="sh">"</span><span class="s">There is an important info hidden inside a lot of irrelevant text. </span><span class="sh">"</span>
    <span class="sh">"</span><span class="s">Find it and memorize it. I will quiz you about the important information there. </span><span class="sh">"</span>
<span class="p">)</span>


<span class="k">def</span> <span class="nf">passkey_prompt</span><span class="p">(</span><span class="n">n_tokens</span><span class="p">,</span> <span class="n">depth</span><span class="p">,</span> <span class="n">key</span><span class="p">):</span>
    <span class="n">per_filler</span> <span class="o">=</span> <span class="nf">len</span><span class="p">(</span><span class="nf">tiny_tok</span><span class="p">(</span><span class="n">FILLER</span><span class="p">,</span> <span class="n">add_special_tokens</span><span class="o">=</span><span class="bp">False</span><span class="p">).</span><span class="n">input_ids</span><span class="p">)</span>
    <span class="n">repeats</span> <span class="o">=</span> <span class="nf">max</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="p">(</span><span class="n">n_tokens</span> <span class="o">-</span> <span class="mi">80</span><span class="p">)</span> <span class="o">//</span> <span class="n">per_filler</span><span class="p">)</span>
    <span class="n">before</span> <span class="o">=</span> <span class="nf">int</span><span class="p">(</span><span class="n">repeats</span> <span class="o">*</span> <span class="n">depth</span><span class="p">)</span>
    <span class="n">needle</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">The pass key is </span><span class="si">{</span><span class="n">key</span><span class="si">}</span><span class="s">. Remember it. </span><span class="si">{</span><span class="n">key</span><span class="si">}</span><span class="s"> is the pass key. </span><span class="sh">"</span>
    <span class="n">text</span> <span class="o">=</span> <span class="n">INTRO</span> <span class="o">+</span> <span class="n">FILLER</span> <span class="o">*</span> <span class="n">before</span> <span class="o">+</span> <span class="n">needle</span> <span class="o">+</span> <span class="n">FILLER</span> <span class="o">*</span> <span class="p">(</span><span class="n">repeats</span> <span class="o">-</span> <span class="n">before</span><span class="p">)</span>
    <span class="n">text</span> <span class="o">+=</span> <span class="sh">"</span><span class="s">What is the pass key? The pass key is</span><span class="sh">"</span>
    <span class="k">return</span> <span class="nf">tiny_tok</span><span class="p">(</span><span class="n">text</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="n">input_ids</span>


<span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">greedy</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">steps</span><span class="p">,</span> <span class="n">chunk</span><span class="o">=</span><span class="mi">4096</span><span class="p">):</span>
    <span class="n">caches</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="nf">new_caches</span><span class="p">(</span><span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span> <span class="o">+</span> <span class="n">steps</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">a</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="n">chunk</span><span class="p">):</span>
        <span class="n">h</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">ids</span><span class="p">[:,</span> <span class="n">a</span> <span class="p">:</span> <span class="n">a</span> <span class="o">+</span> <span class="n">chunk</span><span class="p">].</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">),</span> <span class="n">start</span><span class="o">=</span><span class="n">a</span><span class="p">,</span> <span class="n">caches</span><span class="o">=</span><span class="n">caches</span><span class="p">)</span>
    <span class="n">out</span> <span class="o">=</span> <span class="p">[</span><span class="n">model</span><span class="p">.</span><span class="nf">logits</span><span class="p">(</span><span class="n">h</span><span class="p">[:,</span> <span class="o">-</span><span class="mi">1</span><span class="p">:]).</span><span class="nf">argmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)]</span>
    <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">steps</span> <span class="o">-</span> <span class="mi">1</span><span class="p">):</span>
        <span class="n">h</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">out</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">],</span> <span class="n">start</span><span class="o">=</span><span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span> <span class="o">+</span> <span class="n">i</span><span class="p">,</span> <span class="n">caches</span><span class="o">=</span><span class="n">caches</span><span class="p">)</span>
        <span class="n">out</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="nf">logits</span><span class="p">(</span><span class="n">h</span><span class="p">).</span><span class="nf">argmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">))</span>
    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">(</span><span class="n">out</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)[</span><span class="mi">0</span><span class="p">].</span><span class="nf">tolist</span><span class="p">()</span>


<span class="n">rng</span> <span class="o">=</span> <span class="n">random</span><span class="p">.</span><span class="nc">Random</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">passkey_lengths</span> <span class="o">=</span> <span class="p">[</span><span class="n">TRAINED</span> <span class="o">//</span> <span class="mi">2</span><span class="p">,</span> <span class="n">TRAINED</span><span class="p">,</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">TRAINED</span><span class="p">,</span> <span class="mi">4</span> <span class="o">*</span> <span class="n">TRAINED</span><span class="p">,</span> <span class="n">LENGTH</span><span class="p">]</span>
<span class="n">TRIALS</span> <span class="o">=</span> <span class="mi">2</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">10</span>
<span class="n">trials</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="n">passkey_lengths</span><span class="p">:</span>
    <span class="n">trials</span><span class="p">[</span><span class="n">n</span><span class="p">]</span> <span class="o">=</span> <span class="p">[(</span><span class="n">rng</span><span class="p">.</span><span class="nf">random</span><span class="p">(),</span> <span class="n">rng</span><span class="p">.</span><span class="nf">randint</span><span class="p">(</span><span class="mi">10000</span><span class="p">,</span> <span class="mi">99999</span><span class="p">))</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">TRIALS</span><span class="p">)]</span>
<span class="n">STRETCHES</span><span class="p">[</span><span class="sh">"</span><span class="s">dynamic NTK</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">ntk</span>  <span class="c1"># with s = max(1, n / L), set for each length below
</span><span class="n">passkey</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">method</span> <span class="ow">in</span> <span class="p">[</span><span class="sh">"</span><span class="s">none</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">PI</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">NTK</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">dynamic NTK</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">YaRN</span><span class="sh">"</span><span class="p">]:</span>
    <span class="n">passkey</span><span class="p">[</span><span class="n">method</span><span class="p">]</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="n">passkey_lengths</span><span class="p">:</span>
        <span class="n">fits</span> <span class="o">=</span> <span class="n">method</span> <span class="ow">in</span> <span class="p">[</span><span class="sh">"</span><span class="s">dynamic NTK</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">YaRN</span><span class="sh">"</span><span class="p">]</span>
        <span class="nf">stretch</span><span class="p">(</span><span class="n">tiny</span><span class="p">,</span> <span class="n">method</span><span class="p">,</span> <span class="nf">max</span><span class="p">(</span><span class="mf">1.0</span><span class="p">,</span> <span class="n">n</span> <span class="o">/</span> <span class="n">TRAINED</span><span class="p">)</span> <span class="k">if</span> <span class="n">fits</span> <span class="k">else</span> <span class="n">STRETCH</span><span class="p">)</span>
        <span class="n">hits</span> <span class="o">=</span> <span class="mi">0</span>
        <span class="k">for</span> <span class="n">depth</span><span class="p">,</span> <span class="n">key</span> <span class="ow">in</span> <span class="n">trials</span><span class="p">[</span><span class="n">n</span><span class="p">]:</span>
            <span class="n">said</span> <span class="o">=</span> <span class="n">tiny_tok</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="nf">greedy</span><span class="p">(</span><span class="n">tiny</span><span class="p">,</span> <span class="nf">passkey_prompt</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="n">depth</span><span class="p">,</span> <span class="n">key</span><span class="p">),</span> <span class="mi">7</span><span class="p">))</span>
            <span class="n">hits</span> <span class="o">+=</span> <span class="nf">str</span><span class="p">(</span><span class="n">key</span><span class="p">)</span> <span class="ow">in</span> <span class="n">said</span>
        <span class="n">passkey</span><span class="p">[</span><span class="n">method</span><span class="p">].</span><span class="nf">append</span><span class="p">(</span><span class="n">hits</span> <span class="o">/</span> <span class="n">TRIALS</span><span class="p">)</span>

<span class="n">heat</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">passkey</span><span class="p">,</span> <span class="n">index</span><span class="o">=</span><span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">n</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="sh">"</span> <span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="n">passkey_lengths</span><span class="p">]).</span><span class="n">T</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.6</span><span class="p">,</span> <span class="mf">3.2</span><span class="p">))</span>
<span class="n">teal</span> <span class="o">=</span> <span class="n">LinearSegmentedColormap</span><span class="p">.</span><span class="nf">from_list</span><span class="p">(</span><span class="sh">"</span><span class="s">teal</span><span class="sh">"</span><span class="p">,</span> <span class="p">[</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">card</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">]])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">imshow</span><span class="p">(</span><span class="n">heat</span><span class="p">.</span><span class="n">values</span><span class="p">,</span> <span class="n">cmap</span><span class="o">=</span><span class="n">teal</span><span class="p">,</span> <span class="n">vmin</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span> <span class="n">vmax</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">aspect</span><span class="o">=</span><span class="sh">"</span><span class="s">auto</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xticks</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">heat</span><span class="p">.</span><span class="n">columns</span><span class="p">)),</span> <span class="n">heat</span><span class="p">.</span><span class="n">columns</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_yticks</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">heat</span><span class="p">.</span><span class="n">index</span><span class="p">)),</span> <span class="n">heat</span><span class="p">.</span><span class="n">index</span><span class="p">)</span>
<span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">heat</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]):</span>
    <span class="k">for</span> <span class="n">j</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">heat</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]):</span>
        <span class="n">v</span> <span class="o">=</span> <span class="n">heat</span><span class="p">.</span><span class="n">values</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="n">j</span><span class="p">]</span>
        <span class="n">ink</span> <span class="o">=</span> <span class="sh">"</span><span class="s">white</span><span class="sh">"</span> <span class="k">if</span> <span class="n">v</span> <span class="o">&gt;</span> <span class="mf">0.6</span> <span class="k">else</span> <span class="sh">"</span><span class="s">black</span><span class="sh">"</span>
        <span class="n">ax</span><span class="p">.</span><span class="nf">text</span><span class="p">(</span><span class="n">j</span><span class="p">,</span> <span class="n">i</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">v</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span> <span class="n">ha</span><span class="o">=</span><span class="sh">"</span><span class="s">center</span><span class="sh">"</span><span class="p">,</span> <span class="n">va</span><span class="o">=</span><span class="sh">"</span><span class="s">center</span><span class="sh">"</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">ink</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">prompt length, tokens</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">TinyLlama finds the passkey, </span><span class="si">{</span><span class="n">TRIALS</span><span class="si">}</span><span class="s"> random depths per cell</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/09/output-07.png" alt="Output of the code above" loading="lazy"></p> <p>No method finds the passkey at 16k without training, and the cells before that tell more than the loss did. Position interpolation doesn’t find it even inside the trained window: with every pair slowed eightfold, the model can’t read a five-digit number back.</p> <p>NTK with its fixed factor of 8 holds to 8k. Dynamic NTK and YaRN are stretched by exactly the ratio they need, which leaves no margin, and it shows.</p> <p>NTK divides only the slowest pair by the full factor and the slow pairs just above it by less, so at twice the window those pairs still reach angles the model never saw: dynamic NTK loses the passkey as soon as it stretches at all, while NTK with a factor of 8 has the margin to cover them.</p> <p>YaRN interpolates in full every pair that never finished a turn and finds the passkey at twice the window, but loses most of it at four times.</p> <p>All of this is without training. The papers fine-tune after stretching, a thousand steps for position interpolation and four hundred for YaRN, and a fine-tuned model does far better than any zero-shot row here.</p> <p>What the race measures is how good a starting point each method gives that fine-tuning, and how much it costs a model that is used without it.</p> <h2 id="7-attention-that-doesnt-fit">7. Attention that doesn’t fit</h2> <p>Plain attention writes down a score for every pair of tokens: an \(n \times n\) matrix per head and per layer. Here is what it costs in 16-bit floats, for one head and for the 32 heads of one TinyLlama layer.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">sizes</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="p">[</span><span class="mi">2048</span><span class="p">,</span> <span class="mi">8192</span><span class="p">,</span> <span class="mi">32768</span><span class="p">,</span> <span class="mi">131072</span><span class="p">]:</span>
    <span class="n">one_head</span> <span class="o">=</span> <span class="n">n</span> <span class="o">*</span> <span class="n">n</span> <span class="o">*</span> <span class="mi">2</span>
    <span class="n">sizes</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
        <span class="p">{</span><span class="sh">"</span><span class="s">tokens</span><span class="sh">"</span><span class="p">:</span> <span class="n">n</span><span class="p">,</span> <span class="sh">"</span><span class="s">one head, GB</span><span class="sh">"</span><span class="p">:</span> <span class="n">one_head</span> <span class="o">/</span> <span class="mf">1e9</span><span class="p">,</span> <span class="sh">"</span><span class="s">32 heads, GB</span><span class="sh">"</span><span class="p">:</span> <span class="mi">32</span> <span class="o">*</span> <span class="n">one_head</span> <span class="o">/</span> <span class="mf">1e9</span><span class="p">}</span>
    <span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">sizes</span><span class="p">),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">tokens</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">one head, GB</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">32 heads, GB</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,048</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.01</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.27</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8,192</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.13</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4.29</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32,768</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.15</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">68.72</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">131,072</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">34.36</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,099.51</td></tr></tbody></table></div> <p>A T4 has 16 GB. Long before the weights are a problem, the scores are. The way out was found in three steps.</p> <p>In 2018 Milakov and Gimelshein at NVIDIA showed that a softmax can be computed in one pass over its inputs; in 2021 Rabe and Staats at Google used that to compute attention without storing the matrix; in 2022 Tri Dao and colleagues at Stanford turned it into FlashAttention, a GPU kernel that keeps each tile of the work in the chip’s fast on-chip memory and is faster as well as smaller.</p> <p><strong>The softmax in one pass.</strong> The usual softmax reads the scores \(x_1, \dots, x_n\) three times: once for the maximum \(m\), subtracted so that \(e^x\) doesn’t overflow, once for the sum \(\ell = \sum_j e^{x_j - m}\), and once to divide. The online version keeps a running maximum and a running sum, and when a new maximum arrives it <em>rescales</em> the sum collected so far:</p> \[m_j = \max(m_{j-1}, x_j),\] \[\ell_j = \ell_{j-1}\, e^{m_{j-1} - m_j} + e^{x_j - m_j}.\] <p>After the last score, \(\ell_n\) is exactly the sum the three-pass version computes: every term in it ends up measured against the final maximum, whichever maximum it was added under. On five numbers:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">online_softmax</span><span class="p">(</span><span class="n">scores</span><span class="p">):</span>
    <span class="n">running_max</span> <span class="o">=</span> <span class="nf">float</span><span class="p">(</span><span class="sh">"</span><span class="s">-inf</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">running_sum</span> <span class="o">=</span> <span class="mf">0.0</span>
    <span class="n">steps</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">x</span> <span class="ow">in</span> <span class="n">scores</span><span class="p">:</span>
        <span class="n">new_max</span> <span class="o">=</span> <span class="nf">max</span><span class="p">(</span><span class="n">running_max</span><span class="p">,</span> <span class="n">x</span><span class="p">)</span>
        <span class="n">running_sum</span> <span class="o">=</span> <span class="n">running_sum</span> <span class="o">*</span> <span class="n">math</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">running_max</span> <span class="o">-</span> <span class="n">new_max</span><span class="p">)</span> <span class="o">+</span> <span class="n">math</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">x</span> <span class="o">-</span> <span class="n">new_max</span><span class="p">)</span>
        <span class="n">running_max</span> <span class="o">=</span> <span class="n">new_max</span>
        <span class="n">steps</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">score</span><span class="sh">"</span><span class="p">:</span> <span class="n">x</span><span class="p">,</span> <span class="sh">"</span><span class="s">running max</span><span class="sh">"</span><span class="p">:</span> <span class="n">running_max</span><span class="p">,</span> <span class="sh">"</span><span class="s">running sum</span><span class="sh">"</span><span class="p">:</span> <span class="n">running_sum</span><span class="p">})</span>
    <span class="n">probs</span> <span class="o">=</span> <span class="p">[</span><span class="n">math</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">x</span> <span class="o">-</span> <span class="n">running_max</span><span class="p">)</span> <span class="o">/</span> <span class="n">running_sum</span> <span class="k">for</span> <span class="n">x</span> <span class="ow">in</span> <span class="n">scores</span><span class="p">]</span>
    <span class="k">return</span> <span class="n">probs</span><span class="p">,</span> <span class="n">steps</span>


<span class="n">scores</span> <span class="o">=</span> <span class="p">[</span><span class="mf">3.0</span><span class="p">,</span> <span class="mf">1.0</span><span class="p">,</span> <span class="mf">4.0</span><span class="p">,</span> <span class="mf">1.0</span><span class="p">,</span> <span class="mf">5.0</span><span class="p">]</span>
<span class="n">probs</span><span class="p">,</span> <span class="n">steps</span> <span class="o">=</span> <span class="nf">online_softmax</span><span class="p">(</span><span class="n">scores</span><span class="p">)</span>
<span class="nf">display</span><span class="p">(</span><span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">steps</span><span class="p">),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">4</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">one pass:</span><span class="sh">"</span><span class="p">,</span> <span class="p">[</span><span class="nf">round</span><span class="p">(</span><span class="n">p</span><span class="p">,</span> <span class="mi">4</span><span class="p">)</span> <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">probs</span><span class="p">])</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">torch:   </span><span class="sh">"</span><span class="p">,</span> <span class="p">[</span><span class="nf">round</span><span class="p">(</span><span class="n">p</span><span class="p">,</span> <span class="mi">4</span><span class="p">)</span> <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">scores</span><span class="p">).</span><span class="nf">softmax</span><span class="p">(</span><span class="mi">0</span><span class="p">).</span><span class="nf">tolist</span><span class="p">()])</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">score</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">running max</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">running sum</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.0000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.0000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.0000</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.0000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.0000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.1353</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4.0000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4.0000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.4177</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.0000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4.0000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.4675</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5.0000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5.0000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.5398</td></tr></tbody></table></div> <pre class="tfs-printed"><code>one pass: [0.0879, 0.0119, 0.2389, 0.0119, 0.6494]
torch:    [0.0879, 0.0119, 0.2389, 0.0119, 0.6494]</code></pre> <p>Watch the third row. When the 4 arrives, the sum doesn’t simply grow by one: everything collected before is first multiplied by \(e^{3-4}\), because it was measured against a maximum that is no longer the maximum.</p> <p>Attention needs one more running quantity, the weighted sum of the values \(O\), which gets the same rescaling.</p> <p>Now cut the queries into blocks of rows and the keys and values into blocks of columns, and run the online update one tile at a time. In a causal model the tiles above the diagonal are the future and are never loaded.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/09/flash-light.png" width="760" alt="How FlashAttention walks the attention matrix of a causal model. The queries are cut into blocks of rows and the keys and values into blocks of columns. For one block of queries the kernel loads one block of keys and values at a time into the GPU's fast on-chip memory, computes that tile of scores, folds it into a running maximum, a running sum and a running output, and moves on; the full matrix of scores never exists. Tiles above the diagonal are skipped, because a causal model's queries never look ahead" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/09/flash-dark.png" width="760" alt="How FlashAttention walks the attention matrix of a causal model. The queries are cut into blocks of rows and the keys and values into blocks of columns. For one block of queries the kernel loads one block of keys and values at a time into the GPU's fast on-chip memory, computes that tile of scores, folds it into a running maximum, a running sum and a running output, and moves on; the full matrix of scores never exists. Tiles above the diagonal are skipped, because a causal model's queries never look ahead" loading="lazy"></p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">plain_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">):</span>
    <span class="n">n</span> <span class="o">=</span> <span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">2</span><span class="p">]</span>
    <span class="n">scores</span> <span class="o">=</span> <span class="n">q</span> <span class="o">@</span> <span class="n">k</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">2</span><span class="p">)</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">])</span>
    <span class="n">causal</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">q</span><span class="p">.</span><span class="n">device</span><span class="p">).</span><span class="nf">tril</span><span class="p">()</span>
    <span class="n">scores</span> <span class="o">=</span> <span class="n">scores</span><span class="p">.</span><span class="nf">masked_fill</span><span class="p">(</span><span class="o">~</span><span class="n">causal</span><span class="p">,</span> <span class="nf">float</span><span class="p">(</span><span class="sh">"</span><span class="s">-inf</span><span class="sh">"</span><span class="p">))</span>
    <span class="k">return</span> <span class="n">scores</span><span class="p">.</span><span class="nf">softmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span> <span class="o">@</span> <span class="n">v</span>


<span class="k">def</span> <span class="nf">tiled_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">,</span> <span class="n">block</span><span class="o">=</span><span class="mi">128</span><span class="p">):</span>
    <span class="n">n</span><span class="p">,</span> <span class="n">d</span> <span class="o">=</span> <span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">2</span><span class="p">],</span> <span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
    <span class="n">out</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">empty_like</span><span class="p">(</span><span class="n">q</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">qs</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">block</span><span class="p">):</span>
        <span class="n">qb</span> <span class="o">=</span> <span class="n">q</span><span class="p">[...,</span> <span class="n">qs</span> <span class="p">:</span> <span class="n">qs</span> <span class="o">+</span> <span class="n">block</span><span class="p">,</span> <span class="p">:]</span>
        <span class="n">rows</span> <span class="o">=</span> <span class="n">qb</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">2</span><span class="p">]</span>
        <span class="n">best</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">full</span><span class="p">(</span><span class="n">qb</span><span class="p">.</span><span class="n">shape</span><span class="p">[:</span><span class="o">-</span><span class="mi">1</span><span class="p">],</span> <span class="nf">float</span><span class="p">(</span><span class="sh">"</span><span class="s">-inf</span><span class="sh">"</span><span class="p">),</span> <span class="n">device</span><span class="o">=</span><span class="n">q</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
        <span class="n">total</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">qb</span><span class="p">.</span><span class="n">shape</span><span class="p">[:</span><span class="o">-</span><span class="mi">1</span><span class="p">],</span> <span class="n">device</span><span class="o">=</span><span class="n">q</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
        <span class="n">acc</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros_like</span><span class="p">(</span><span class="n">qb</span><span class="p">)</span>
        <span class="k">for</span> <span class="n">ks</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">qs</span> <span class="o">+</span> <span class="n">rows</span><span class="p">,</span> <span class="n">block</span><span class="p">):</span>  <span class="c1"># tiles right of the diagonal are never read
</span>            <span class="n">kb</span> <span class="o">=</span> <span class="n">k</span><span class="p">[...,</span> <span class="n">ks</span> <span class="p">:</span> <span class="n">ks</span> <span class="o">+</span> <span class="n">block</span><span class="p">,</span> <span class="p">:]</span>
            <span class="n">vb</span> <span class="o">=</span> <span class="n">v</span><span class="p">[...,</span> <span class="n">ks</span> <span class="p">:</span> <span class="n">ks</span> <span class="o">+</span> <span class="n">block</span><span class="p">,</span> <span class="p">:]</span>
            <span class="n">s</span> <span class="o">=</span> <span class="n">qb</span> <span class="o">@</span> <span class="n">kb</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">2</span><span class="p">)</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="n">d</span><span class="p">)</span>
            <span class="k">if</span> <span class="n">ks</span> <span class="o">+</span> <span class="n">block</span> <span class="o">&gt;</span> <span class="n">qs</span><span class="p">:</span>  <span class="c1"># the diagonal tile: hide the future
</span>                <span class="n">qpos</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">qs</span><span class="p">,</span> <span class="n">qs</span> <span class="o">+</span> <span class="n">rows</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">q</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
                <span class="n">kpos</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">ks</span><span class="p">,</span> <span class="n">ks</span> <span class="o">+</span> <span class="n">kb</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">2</span><span class="p">],</span> <span class="n">device</span><span class="o">=</span><span class="n">q</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
                <span class="n">s</span> <span class="o">=</span> <span class="n">s</span><span class="p">.</span><span class="nf">masked_fill</span><span class="p">(</span><span class="n">kpos</span><span class="p">[</span><span class="bp">None</span><span class="p">,</span> <span class="p">:]</span> <span class="o">&gt;</span> <span class="n">qpos</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">],</span> <span class="nf">float</span><span class="p">(</span><span class="sh">"</span><span class="s">-inf</span><span class="sh">"</span><span class="p">))</span>
            <span class="n">new_best</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">maximum</span><span class="p">(</span><span class="n">best</span><span class="p">,</span> <span class="n">s</span><span class="p">.</span><span class="nf">amax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">))</span>
            <span class="n">fade</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">best</span> <span class="o">-</span> <span class="n">new_best</span><span class="p">)</span>
            <span class="n">p</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">s</span> <span class="o">-</span> <span class="n">new_best</span><span class="p">[...,</span> <span class="bp">None</span><span class="p">])</span>
            <span class="n">total</span> <span class="o">=</span> <span class="n">total</span> <span class="o">*</span> <span class="n">fade</span> <span class="o">+</span> <span class="n">p</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
            <span class="n">acc</span> <span class="o">=</span> <span class="n">acc</span> <span class="o">*</span> <span class="n">fade</span><span class="p">[...,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">+</span> <span class="n">p</span> <span class="o">@</span> <span class="n">vb</span>
            <span class="n">best</span> <span class="o">=</span> <span class="n">new_best</span>
        <span class="n">out</span><span class="p">[...,</span> <span class="n">qs</span> <span class="p">:</span> <span class="n">qs</span> <span class="o">+</span> <span class="n">block</span><span class="p">,</span> <span class="p">:]</span> <span class="o">=</span> <span class="n">acc</span> <span class="o">/</span> <span class="n">total</span><span class="p">[...,</span> <span class="bp">None</span><span class="p">]</span>
    <span class="k">return</span> <span class="n">out</span>


<span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="o">=</span> <span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">4</span><span class="p">,</span> <span class="mi">1000</span><span class="p">,</span> <span class="mi">64</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">3</span><span class="p">))</span>
<span class="n">reference</span> <span class="o">=</span> <span class="nf">plain_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">)</span>
<span class="n">tiled</span> <span class="o">=</span> <span class="nf">tiled_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">)</span>
<span class="n">kernel</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">scaled_dot_product_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">,</span> <span class="n">is_causal</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">tiled against plain, max difference:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="n">tiled</span> <span class="o">-</span> <span class="n">reference</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">PyTorch</span><span class="sh">'</span><span class="s">s kernel against plain:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="n">kernel</span> <span class="o">-</span> <span class="n">reference</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>tiled against plain, max difference: 5.4e-07
PyTorch's kernel against plain: 5.7e-07</code></pre> <p>One block of queries, tile by tile, with the shapes and with the running maximum and sum of its first row. The last tile is the diagonal one, where the future is masked.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">block</span> <span class="o">=</span> <span class="mi">128</span>
<span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">q1</span><span class="p">,</span> <span class="n">k1</span><span class="p">,</span> <span class="n">v1</span> <span class="o">=</span> <span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">4</span> <span class="o">*</span> <span class="n">block</span><span class="p">,</span> <span class="mi">64</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">3</span><span class="p">))</span>
<span class="n">qs</span> <span class="o">=</span> <span class="mi">3</span> <span class="o">*</span> <span class="n">block</span>  <span class="c1"># the fourth block of queries: it reads four tiles of keys
</span><span class="n">qb</span> <span class="o">=</span> <span class="n">q1</span><span class="p">[...,</span> <span class="n">qs</span> <span class="p">:</span> <span class="n">qs</span> <span class="o">+</span> <span class="n">block</span><span class="p">,</span> <span class="p">:]</span>
<span class="n">best</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">full</span><span class="p">((</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">block</span><span class="p">),</span> <span class="nf">float</span><span class="p">(</span><span class="sh">"</span><span class="s">-inf</span><span class="sh">"</span><span class="p">))</span>
<span class="n">total</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">block</span><span class="p">)</span>
<span class="n">acc</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros_like</span><span class="p">(</span><span class="n">qb</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">queries of the block:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">qb</span><span class="p">.</span><span class="n">shape</span><span class="p">))</span>
<span class="k">for</span> <span class="n">ks</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">qs</span> <span class="o">+</span> <span class="n">block</span><span class="p">,</span> <span class="n">block</span><span class="p">):</span>
    <span class="n">kb</span><span class="p">,</span> <span class="n">vb</span> <span class="o">=</span> <span class="n">k1</span><span class="p">[...,</span> <span class="n">ks</span> <span class="p">:</span> <span class="n">ks</span> <span class="o">+</span> <span class="n">block</span><span class="p">,</span> <span class="p">:],</span> <span class="n">v1</span><span class="p">[...,</span> <span class="n">ks</span> <span class="p">:</span> <span class="n">ks</span> <span class="o">+</span> <span class="n">block</span><span class="p">,</span> <span class="p">:]</span>
    <span class="n">s</span> <span class="o">=</span> <span class="n">qb</span> <span class="o">@</span> <span class="n">kb</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">2</span><span class="p">)</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="mi">64</span><span class="p">)</span>
    <span class="k">if</span> <span class="n">ks</span> <span class="o">==</span> <span class="n">qs</span><span class="p">:</span>
        <span class="n">s</span> <span class="o">=</span> <span class="n">s</span><span class="p">.</span><span class="nf">masked_fill</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">block</span><span class="p">,</span> <span class="n">block</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">).</span><span class="nf">triu</span><span class="p">(</span><span class="mi">1</span><span class="p">),</span> <span class="nf">float</span><span class="p">(</span><span class="sh">"</span><span class="s">-inf</span><span class="sh">"</span><span class="p">))</span>
    <span class="n">new_best</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">maximum</span><span class="p">(</span><span class="n">best</span><span class="p">,</span> <span class="n">s</span><span class="p">.</span><span class="nf">amax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">))</span>
    <span class="n">fade</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">best</span> <span class="o">-</span> <span class="n">new_best</span><span class="p">)</span>
    <span class="n">p</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">s</span> <span class="o">-</span> <span class="n">new_best</span><span class="p">[...,</span> <span class="bp">None</span><span class="p">])</span>
    <span class="n">total</span> <span class="o">=</span> <span class="n">total</span> <span class="o">*</span> <span class="n">fade</span> <span class="o">+</span> <span class="n">p</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">acc</span> <span class="o">=</span> <span class="n">acc</span> <span class="o">*</span> <span class="n">fade</span><span class="p">[...,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">+</span> <span class="n">p</span> <span class="o">@</span> <span class="n">vb</span>
    <span class="n">best</span> <span class="o">=</span> <span class="n">new_best</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">tile of keys </span><span class="si">{</span><span class="n">ks</span><span class="si">:</span><span class="mi">3</span><span class="si">}</span><span class="s">–</span><span class="si">{</span><span class="n">ks</span> <span class="o">+</span> <span class="n">block</span> <span class="o">-</span> <span class="mi">1</span><span class="si">}</span><span class="s">: scores </span><span class="si">{</span><span class="nf">tuple</span><span class="p">(</span><span class="n">s</span><span class="p">.</span><span class="n">shape</span><span class="p">)</span><span class="si">}</span><span class="s">, row 0:</span><span class="sh">"</span><span class="p">,</span> <span class="n">end</span><span class="o">=</span><span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">)</span>
    <span class="n">row</span> <span class="o">=</span> <span class="p">(</span><span class="n">best</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">].</span><span class="nf">item</span><span class="p">(),</span> <span class="n">total</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">].</span><span class="nf">item</span><span class="p">(),</span> <span class="n">fade</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">].</span><span class="nf">item</span><span class="p">())</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">max {:.3f}, sum {:.3f}, rescaled by {:.3f}</span><span class="sh">"</span><span class="p">.</span><span class="nf">format</span><span class="p">(</span><span class="o">*</span><span class="n">row</span><span class="p">))</span>
<span class="n">check</span> <span class="o">=</span> <span class="nf">plain_attention</span><span class="p">(</span><span class="n">q1</span><span class="p">,</span> <span class="n">k1</span><span class="p">,</span> <span class="n">v1</span><span class="p">)[...,</span> <span class="n">qs</span> <span class="p">:</span> <span class="n">qs</span> <span class="o">+</span> <span class="n">block</span><span class="p">,</span> <span class="p">:]</span>
<span class="n">gap</span> <span class="o">=</span> <span class="p">(</span><span class="n">acc</span> <span class="o">/</span> <span class="n">total</span><span class="p">[...,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">-</span> <span class="n">check</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">the block</span><span class="sh">'</span><span class="s">s output against plain attention:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">gap</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>queries of the block: (1, 1, 128, 64)
tile of keys   0–127: scores (1, 1, 128, 128), row 0: max 1.996, sum 24.006, rescaled by 0.000
tile of keys 128–255: scores (1, 1, 128, 128), row 0: max 1.996, sum 50.248, rescaled by 1.000
tile of keys 256–383: scores (1, 1, 128, 128), row 0: max 1.996, sum 73.460, rescaled by 1.000
tile of keys 384–511: scores (1, 1, 128, 128), row 0: max 1.996, sum 73.944, rescaled by 1.000
the block's output against plain attention: 3.0e-07</code></pre> <p>Exact to the rounding of 32-bit floats: FlashAttention is not an approximation. Our version runs its loops in Python and only shows the arithmetic.</p> <p>The real kernel does the same arithmetic inside one GPU program, with each tile held in the small, fast memory next to each of the GPU’s processors, and that is where its speed comes from: attention is limited by trips to the GPU’s main memory, not by the arithmetic.</p> <p>PyTorch ships several kernels behind <code class="language-plaintext highlighter-rouge">scaled_dot_product_attention</code> and picks one for the GPU at hand. FlashAttention-2 needs an Ampere GPU or newer; on a T4, PyTorch uses its <em>memory-efficient</em> kernel, which came from Meta’s xFormers library and rests on the same online softmax. Which ones run here:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="n">torch.nn.attention</span> <span class="kn">import</span> <span class="n">SDPBackend</span><span class="p">,</span> <span class="n">sdpa_kernel</span>

<span class="n">q</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">32</span><span class="p">,</span> <span class="mi">2048</span><span class="p">,</span> <span class="mi">64</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">HALF</span><span class="p">)</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">backend</span> <span class="ow">in</span> <span class="p">[</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">FlashAttention</span><span class="sh">"</span><span class="p">,</span> <span class="n">SDPBackend</span><span class="p">.</span><span class="n">FLASH_ATTENTION</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">memory-efficient</span><span class="sh">"</span><span class="p">,</span> <span class="n">SDPBackend</span><span class="p">.</span><span class="n">EFFICIENT_ATTENTION</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">plain math</span><span class="sh">"</span><span class="p">,</span> <span class="n">SDPBackend</span><span class="p">.</span><span class="n">MATH</span><span class="p">),</span>
<span class="p">]:</span>
    <span class="k">try</span><span class="p">:</span>
        <span class="k">with</span> <span class="nf">sdpa_kernel</span><span class="p">(</span><span class="n">backend</span><span class="p">):</span>
            <span class="n">F</span><span class="p">.</span><span class="nf">scaled_dot_product_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">q</span><span class="p">,</span> <span class="n">q</span><span class="p">,</span> <span class="n">is_causal</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
        <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="s">: runs</span><span class="sh">"</span><span class="p">)</span>
    <span class="k">except</span> <span class="nb">RuntimeError</span><span class="p">:</span>
        <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="s">: not available here</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>FlashAttention: not available here
memory-efficient: runs
plain math: runs</code></pre> <p>Now a race on TinyLlama’s shape, 32 heads of 64: plain attention that writes the matrix down, our tiled loop and PyTorch’s kernel, timed, with the peak memory of the GPU during each call. The floor under all three is TinyLlama’s weights, still loaded from the sections before.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">measure</span><span class="p">(</span><span class="n">fn</span><span class="p">,</span> <span class="n">q</span><span class="p">):</span>
    <span class="nf">fn</span><span class="p">(</span><span class="n">q</span><span class="p">)</span>
    <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
        <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">synchronize</span><span class="p">()</span>
        <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">reset_peak_memory_stats</span><span class="p">()</span>
    <span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
    <span class="nf">fn</span><span class="p">(</span><span class="n">q</span><span class="p">)</span>
    <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
        <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">synchronize</span><span class="p">()</span>
        <span class="nf">return </span><span class="p">(</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="p">)</span> <span class="o">*</span> <span class="mi">1000</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">max_memory_allocated</span><span class="p">()</span> <span class="o">/</span> <span class="mf">1e9</span>
    <span class="nf">return </span><span class="p">(</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="p">)</span> <span class="o">*</span> <span class="mi">1000</span><span class="p">,</span> <span class="nf">float</span><span class="p">(</span><span class="sh">"</span><span class="s">nan</span><span class="sh">"</span><span class="p">)</span>


<span class="n">bench</span> <span class="o">=</span> <span class="p">[]</span>
<span class="n">bench_lengths</span> <span class="o">=</span> <span class="p">[</span><span class="mi">256</span><span class="p">,</span> <span class="mi">512</span><span class="p">]</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="p">[</span><span class="mi">1024</span><span class="p">,</span> <span class="mi">2048</span><span class="p">,</span> <span class="mi">4096</span><span class="p">,</span> <span class="mi">8192</span><span class="p">,</span> <span class="mi">16384</span><span class="p">,</span> <span class="mi">32768</span><span class="p">]</span>


<span class="k">def</span> <span class="nf">run_plain</span><span class="p">(</span><span class="n">q</span><span class="p">):</span>
    <span class="k">return</span> <span class="nf">plain_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">q</span><span class="p">,</span> <span class="n">q</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">run_tiled</span><span class="p">(</span><span class="n">q</span><span class="p">):</span>
    <span class="k">return</span> <span class="nf">tiled_attention</span><span class="p">(</span><span class="n">q</span><span class="p">.</span><span class="nf">float</span><span class="p">(),</span> <span class="n">q</span><span class="p">.</span><span class="nf">float</span><span class="p">(),</span> <span class="n">q</span><span class="p">.</span><span class="nf">float</span><span class="p">())</span>


<span class="k">def</span> <span class="nf">run_kernel</span><span class="p">(</span><span class="n">q</span><span class="p">):</span>
    <span class="k">return</span> <span class="n">F</span><span class="p">.</span><span class="nf">scaled_dot_product_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">q</span><span class="p">,</span> <span class="n">q</span><span class="p">,</span> <span class="n">is_causal</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>


<span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="n">bench_lengths</span><span class="p">:</span>
    <span class="n">q</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">32</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="mi">64</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">HALF</span><span class="p">)</span>
    <span class="n">contenders</span> <span class="o">=</span> <span class="p">[</span>
        <span class="p">(</span><span class="sh">"</span><span class="s">plain</span><span class="sh">"</span><span class="p">,</span> <span class="n">run_plain</span><span class="p">),</span>
        <span class="p">(</span><span class="sh">"</span><span class="s">tiled, Python</span><span class="sh">"</span><span class="p">,</span> <span class="n">run_tiled</span><span class="p">),</span>
        <span class="p">(</span><span class="sh">"</span><span class="s">PyTorch kernel</span><span class="sh">"</span><span class="p">,</span> <span class="n">run_kernel</span><span class="p">),</span>
    <span class="p">]</span>
    <span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">fn</span> <span class="ow">in</span> <span class="n">contenders</span><span class="p">:</span>
        <span class="k">if</span> <span class="n">name</span> <span class="o">==</span> <span class="sh">"</span><span class="s">tiled, Python</span><span class="sh">"</span> <span class="ow">and</span> <span class="n">n</span> <span class="o">&gt;</span> <span class="mi">8192</span><span class="p">:</span>
            <span class="k">continue</span>  <span class="c1"># minutes of Python loops, and its memory line is clear by then
</span>        <span class="k">try</span><span class="p">:</span>
            <span class="n">ms</span><span class="p">,</span> <span class="n">gb</span> <span class="o">=</span> <span class="nf">measure</span><span class="p">(</span><span class="n">fn</span><span class="p">,</span> <span class="n">q</span><span class="p">)</span>
        <span class="k">except</span> <span class="n">torch</span><span class="p">.</span><span class="n">OutOfMemoryError</span><span class="p">:</span>
            <span class="n">ms</span><span class="p">,</span> <span class="n">gb</span> <span class="o">=</span> <span class="nf">float</span><span class="p">(</span><span class="sh">"</span><span class="s">nan</span><span class="sh">"</span><span class="p">),</span> <span class="nf">float</span><span class="p">(</span><span class="sh">"</span><span class="s">nan</span><span class="sh">"</span><span class="p">)</span>
            <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="s">: out of memory at </span><span class="si">{</span><span class="n">n</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> tokens</span><span class="sh">"</span><span class="p">)</span>
        <span class="n">bench</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">tokens</span><span class="sh">"</span><span class="p">:</span> <span class="n">n</span><span class="p">,</span> <span class="sh">"</span><span class="s">attention</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span> <span class="sh">"</span><span class="s">ms</span><span class="sh">"</span><span class="p">:</span> <span class="n">ms</span><span class="p">,</span> <span class="sh">"</span><span class="s">peak GB</span><span class="sh">"</span><span class="p">:</span> <span class="n">gb</span><span class="p">})</span>
        <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
            <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">empty_cache</span><span class="p">()</span>
<span class="n">bench</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">bench</span><span class="p">)</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">8.4</span><span class="p">,</span> <span class="mf">3.4</span><span class="p">))</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">color</span> <span class="ow">in</span> <span class="p">[</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">plain</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">]),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">tiled, Python</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">data</span><span class="sh">"</span><span class="p">]),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">PyTorch kernel</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">]),</span>
<span class="p">]:</span>
    <span class="n">part</span> <span class="o">=</span> <span class="n">bench</span><span class="p">[</span><span class="n">bench</span><span class="p">.</span><span class="n">attention</span> <span class="o">==</span> <span class="n">name</span><span class="p">]</span>
    <span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">plot</span><span class="p">(</span><span class="n">part</span><span class="p">.</span><span class="n">tokens</span><span class="p">,</span> <span class="n">part</span><span class="p">[</span><span class="sh">"</span><span class="s">ms</span><span class="sh">"</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span> <span class="n">marker</span><span class="o">=</span><span class="sh">"</span><span class="s">o</span><span class="sh">"</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="n">name</span><span class="p">)</span>
    <span class="n">axes</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="nf">plot</span><span class="p">(</span><span class="n">part</span><span class="p">.</span><span class="n">tokens</span><span class="p">,</span> <span class="n">part</span><span class="p">[</span><span class="sh">"</span><span class="s">peak GB</span><span class="sh">"</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span> <span class="n">marker</span><span class="o">=</span><span class="sh">"</span><span class="s">o</span><span class="sh">"</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="n">name</span><span class="p">)</span>
<span class="k">for</span> <span class="n">ax</span><span class="p">,</span> <span class="n">label</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">axes</span><span class="p">,</span> <span class="p">[</span><span class="sh">"</span><span class="s">time, ms</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">peak memory, GB</span><span class="sh">"</span><span class="p">]):</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_xscale</span><span class="p">(</span><span class="sh">"</span><span class="s">log</span><span class="sh">"</span><span class="p">,</span> <span class="n">base</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
    <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>  <span class="c1"># a CPU run has no memory counter to plot
</span>        <span class="n">ax</span><span class="p">.</span><span class="nf">set_yscale</span><span class="p">(</span><span class="sh">"</span><span class="s">log</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">tokens</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="n">label</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">9</span><span class="p">)</span>
<span class="n">where</span> <span class="o">=</span> <span class="sh">"</span><span class="s">a T4</span><span class="sh">"</span> <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">else</span> <span class="sh">"</span><span class="s">a CPU</span><span class="sh">"</span>
<span class="n">fig</span><span class="p">.</span><span class="nf">suptitle</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">One layer</span><span class="sh">'</span><span class="s">s attention, 32 heads of 64, on </span><span class="si">{</span><span class="n">where</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
<span class="n">peak</span> <span class="o">=</span> <span class="n">bench</span><span class="p">.</span><span class="nf">pivot</span><span class="p">(</span><span class="n">index</span><span class="o">=</span><span class="sh">"</span><span class="s">tokens</span><span class="sh">"</span><span class="p">,</span> <span class="n">columns</span><span class="o">=</span><span class="sh">"</span><span class="s">attention</span><span class="sh">"</span><span class="p">,</span> <span class="n">values</span><span class="o">=</span><span class="sh">"</span><span class="s">peak GB</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">peak</span><span class="p">.</span><span class="nf">reset_index</span><span class="p">(),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>plain: out of memory at 16,384 tokens
plain: out of memory at 32,768 tokens</code></pre> <p><img class="tfs-output" src="/assets/posts/arch/09/output-08.png" alt="Output of the code above" loading="lazy"></p> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">tokens</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">PyTorch kernel</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">plain</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">tiled, Python</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,024</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.24</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.38</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.28</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,048</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.25</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.79</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.32</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4,096</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.27</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4.43</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.39</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8,192</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.30</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">10.99</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.54</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">16,384</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.37</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">—</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">—</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32,768</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.50</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">—</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">—</td></tr></tbody></table></div> <p>Plain attention’s memory grows with the square of the length and runs out well before 32k tokens. The kernel’s grows in a straight line, because it keeps only the inputs, the output and two numbers per row. Our Python loop draws the same straight line and loses only on time, which is the other half of FlashAttention’s work.</p> <p>Training needs the backward pass too, and the backward pass needs the attention probabilities. FlashAttention doesn’t store them. It keeps \(m\) and \(\ell\) for every row, two numbers instead of \(n\), and recomputes each tile of probabilities when the gradient needs it: doing the arithmetic twice is cheaper than reading the matrix back.</p> <h2 id="8-a-needle-in-a-novel">8. A needle in a novel</h2> <p>Now Qwen3-4B, lesson 6’s architecture at four billion parameters. It was pretrained with a 32k window and a base of a million, and its card documents YaRN with a factor of 4 for up to 131,072 tokens.</p> <p>Its 8 GB of weights and a 64k cache don’t fit one T4 together, so <code class="language-plaintext highlighter-rouge">spread</code> splits the layers over two. First the check against Hugging Face, whose model runs in 32-bit floats on the CPU, in a process of its own.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">torch</span><span class="p">.</span><span class="nf">save</span><span class="p">(</span><span class="nf">qwen_tok</span><span class="p">(</span><span class="n">text</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="n">input_ids</span><span class="p">,</span> <span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">qwen_ids.pt</span><span class="sh">"</span><span class="p">)</span>
<span class="n">script</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"""</span><span class="s">
import torch
from transformers import AutoModelForCausalLM
model = AutoModelForCausalLM.from_pretrained(</span><span class="sh">"</span><span class="si">{</span><span class="n">QWEN_SOURCE</span><span class="si">}</span><span class="sh">"</span><span class="s">, dtype=torch.float32).eval()
ids = torch.load(</span><span class="sh">"</span><span class="si">{</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">qwen_ids.pt</span><span class="sh">"</span><span class="si">}</span><span class="sh">"</span><span class="s">)
with torch.no_grad():
    torch.save(model(ids).logits.float(), </span><span class="sh">"</span><span class="si">{</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">qwen_theirs.pt</span><span class="sh">"</span><span class="si">}</span><span class="sh">"</span><span class="s">)
</span><span class="sh">"""</span>
<span class="n">subprocess</span><span class="p">.</span><span class="nf">run</span><span class="p">([</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">-c</span><span class="sh">"</span><span class="p">,</span> <span class="n">script</span><span class="p">],</span> <span class="n">check</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">qwen_theirs</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">qwen_theirs.pt</span><span class="sh">"</span><span class="p">)</span>

<span class="k">del</span> <span class="n">tiny</span>
<span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
    <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">empty_cache</span><span class="p">()</span>
<span class="n">qwen</span> <span class="o">=</span> <span class="nf">load_model</span><span class="p">(</span><span class="n">QWEN_SOURCE</span><span class="p">,</span> <span class="n">qwen_c</span><span class="p">,</span> <span class="n">HALF</span><span class="p">,</span> <span class="n">spread</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">ours</span> <span class="o">=</span> <span class="n">qwen</span><span class="p">.</span><span class="nf">logits</span><span class="p">(</span><span class="nf">qwen</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">qwen_ids.pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">))).</span><span class="nf">cpu</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">largest logit:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">qwen_theirs</span><span class="p">.</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="n">gap</span> <span class="o">=</span> <span class="p">(</span><span class="n">ours</span> <span class="o">-</span> <span class="n">qwen_theirs</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">max difference, ours in 16 bits against theirs in 32:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">gap</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>largest logit: 27.41
max difference, ours in 16 bits against theirs in 32: 5.97e-02</code></pre> <p>The haystack is the first of our PG-19 books, repeated if it runs out; the needle is one sentence that has nothing to do with it.</p> <p>We ask in Qwen3’s chat format with its thinking switched off, and count an answer as right when it contains the number. Every length and depth runs twice: with the frequencies Qwen3 was trained with, and with YaRN’s 4×.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">QWEN_TRAINED</span> <span class="o">=</span> <span class="mi">32768</span>
<span class="n">haystack</span> <span class="o">=</span> <span class="nf">qwen_tok</span><span class="p">(</span><span class="n">books</span><span class="p">[</span><span class="mi">0</span><span class="p">][</span><span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">],</span> <span class="n">add_special_tokens</span><span class="o">=</span><span class="bp">False</span><span class="p">).</span><span class="n">input_ids</span>
<span class="n">NEEDLE</span> <span class="o">=</span> <span class="sh">"</span><span class="s"> The harbour master wrote the combination 4719 on the back of the chart. </span><span class="sh">"</span>
<span class="n">QUESTION</span> <span class="o">=</span> <span class="p">(</span>
    <span class="sh">"</span><span class="s">What combination did the harbour master write on the back of the chart? </span><span class="sh">"</span>
    <span class="sh">"</span><span class="s">Answer with the number only.</span><span class="sh">"</span>
<span class="p">)</span>


<span class="k">def</span> <span class="nf">needle_prompt</span><span class="p">(</span><span class="n">n_tokens</span><span class="p">,</span> <span class="n">depth</span><span class="p">):</span>
    <span class="n">body</span> <span class="o">=</span> <span class="n">haystack</span>
    <span class="k">while</span> <span class="nf">len</span><span class="p">(</span><span class="n">body</span><span class="p">)</span> <span class="o">&lt;</span> <span class="n">n_tokens</span><span class="p">:</span>
        <span class="n">body</span> <span class="o">=</span> <span class="n">body</span> <span class="o">+</span> <span class="n">haystack</span>
    <span class="n">body</span> <span class="o">=</span> <span class="n">body</span><span class="p">[:</span> <span class="n">n_tokens</span> <span class="o">-</span> <span class="mi">80</span><span class="p">]</span>
    <span class="n">cut</span> <span class="o">=</span> <span class="nf">int</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">body</span><span class="p">)</span> <span class="o">*</span> <span class="n">depth</span><span class="p">)</span>
    <span class="n">story</span> <span class="o">=</span> <span class="n">qwen_tok</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="n">body</span><span class="p">[:</span><span class="n">cut</span><span class="p">])</span> <span class="o">+</span> <span class="n">NEEDLE</span> <span class="o">+</span> <span class="n">qwen_tok</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="n">body</span><span class="p">[</span><span class="n">cut</span><span class="p">:])</span>
    <span class="n">messages</span> <span class="o">=</span> <span class="p">[{</span><span class="sh">"</span><span class="s">role</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">user</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">content</span><span class="sh">"</span><span class="p">:</span> <span class="n">story</span> <span class="o">+</span> <span class="sh">"</span><span class="se">\n\n</span><span class="sh">"</span> <span class="o">+</span> <span class="n">QUESTION</span><span class="p">}]</span>
    <span class="n">prompt</span> <span class="o">=</span> <span class="n">qwen_tok</span><span class="p">.</span><span class="nf">apply_chat_template</span><span class="p">(</span>
        <span class="n">messages</span><span class="p">,</span> <span class="n">tokenize</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">add_generation_prompt</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">enable_thinking</span><span class="o">=</span><span class="bp">False</span>
    <span class="p">)</span>
    <span class="k">return</span> <span class="nf">qwen_tok</span><span class="p">(</span><span class="n">prompt</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">,</span> <span class="n">add_special_tokens</span><span class="o">=</span><span class="bp">False</span><span class="p">).</span><span class="n">input_ids</span>


<span class="n">needle_lengths</span> <span class="o">=</span> <span class="p">[</span><span class="mi">256</span><span class="p">,</span> <span class="mi">512</span><span class="p">]</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="p">[</span><span class="mi">8192</span><span class="p">,</span> <span class="mi">16384</span><span class="p">,</span> <span class="mi">32768</span><span class="p">,</span> <span class="mi">49152</span><span class="p">,</span> <span class="mi">65536</span><span class="p">]</span>
<span class="n">depths</span> <span class="o">=</span> <span class="p">[</span><span class="mf">0.1</span><span class="p">,</span> <span class="mf">0.5</span><span class="p">,</span> <span class="mf">0.9</span><span class="p">]</span>
<span class="n">found</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">setting</span> <span class="ow">in</span> <span class="p">[</span><span class="sh">"</span><span class="s">as trained</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">YaRN 4×</span><span class="sh">"</span><span class="p">]:</span>
    <span class="k">if</span> <span class="n">setting</span> <span class="o">==</span> <span class="sh">"</span><span class="s">as trained</span><span class="sh">"</span><span class="p">:</span>
        <span class="n">qwen</span><span class="p">.</span><span class="n">freq</span><span class="p">,</span> <span class="n">qwen</span><span class="p">.</span><span class="n">scale</span> <span class="o">=</span> <span class="nf">rope_frequencies</span><span class="p">(</span><span class="n">qwen</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">qwen</span><span class="p">.</span><span class="n">base</span><span class="p">),</span> <span class="mf">1.0</span>
    <span class="k">else</span><span class="p">:</span>
        <span class="n">qwen</span><span class="p">.</span><span class="n">freq</span><span class="p">,</span> <span class="n">qwen</span><span class="p">.</span><span class="n">scale</span> <span class="o">=</span> <span class="nf">yarn</span><span class="p">(</span><span class="n">qwen</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">qwen</span><span class="p">.</span><span class="n">base</span><span class="p">,</span> <span class="mi">4</span><span class="p">,</span> <span class="n">QWEN_TRAINED</span><span class="p">)</span>
    <span class="n">grid</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">zeros</span><span class="p">((</span><span class="nf">len</span><span class="p">(</span><span class="n">depths</span><span class="p">),</span> <span class="nf">len</span><span class="p">(</span><span class="n">needle_lengths</span><span class="p">)))</span>
    <span class="k">for</span> <span class="n">j</span><span class="p">,</span> <span class="n">n</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">needle_lengths</span><span class="p">):</span>
        <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">depth</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">depths</span><span class="p">):</span>
            <span class="n">said</span> <span class="o">=</span> <span class="n">qwen_tok</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="nf">greedy</span><span class="p">(</span><span class="n">qwen</span><span class="p">,</span> <span class="nf">needle_prompt</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="n">depth</span><span class="p">),</span> <span class="mi">24</span><span class="p">))</span>
            <span class="n">grid</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="n">j</span><span class="p">]</span> <span class="o">=</span> <span class="sh">"</span><span class="s">4719</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">said</span>
    <span class="n">found</span><span class="p">[</span><span class="n">setting</span><span class="p">]</span> <span class="o">=</span> <span class="n">grid</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">8.6</span><span class="p">,</span> <span class="mf">3.2</span><span class="p">),</span> <span class="n">sharey</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="k">for</span> <span class="n">ax</span><span class="p">,</span> <span class="p">(</span><span class="n">setting</span><span class="p">,</span> <span class="n">grid</span><span class="p">)</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">axes</span><span class="p">,</span> <span class="n">found</span><span class="p">.</span><span class="nf">items</span><span class="p">()):</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">imshow</span><span class="p">(</span><span class="n">grid</span><span class="p">,</span> <span class="n">cmap</span><span class="o">=</span><span class="n">teal</span><span class="p">,</span> <span class="n">vmin</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span> <span class="n">vmax</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">aspect</span><span class="o">=</span><span class="sh">"</span><span class="s">auto</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_xticks</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">needle_lengths</span><span class="p">)),</span> <span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">n</span> <span class="o">//</span> <span class="mi">1024</span><span class="si">}</span><span class="s">k</span><span class="sh">"</span> <span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="n">needle_lengths</span><span class="p">])</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_yticks</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">depths</span><span class="p">)),</span> <span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">d</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span> <span class="k">for</span> <span class="n">d</span> <span class="ow">in</span> <span class="n">depths</span><span class="p">])</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">Qwen3-4B, </span><span class="si">{</span><span class="n">setting</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">prompt length</span><span class="sh">"</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">needle depth</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/09/output-09.png" alt="Output of the code above" loading="lazy"></p> <p>Teal is found, white is missed.</p> <p>As trained, Qwen3-4B finds the needle at every depth up to 48k tokens, past the 32k it was trained on; at 64k it finds it only near the end of the text, close to the question. With YaRN it finds it everywhere.</p> <p>A needle test is the easiest long-context exam there is: one literal sentence that doesn’t belong, and a question that repeats its words. Benchmarks built later make it harder, with several needles, questions that paraphrase and tasks that need the whole text, and on them models typically hold up for a fraction of their advertised window.</p> <h2 id="9-questions-about-a-whole-novel">9. Questions about a whole novel</h2> <p>The needle was a fact that didn’t belong. A harder test is a fact that does: a detail of the plot that only a reader of the book would know.</p> <p>The book is <em>The Boats of the “Glen Carrig”</em> by William Hope Hodgson, 1907: shipwrecked sailors drift through a sea choked with weed, fight off the devil-fish and the “weed men” on an island, and try to reach a ship that has been stuck in the weed for years.</p> <p>It is told in mock eighteenth-century English, it is long enough to be over Qwen3’s window, 77 thousand tokens, and it is obscure enough that a small model is unlikely to have memorised its details. Project Gutenberg has it.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">re</span>
<span class="kn">import</span> <span class="n">urllib.request</span>

<span class="n">BOOK</span> <span class="o">=</span> <span class="sh">"</span><span class="s">https://www.gutenberg.org/cache/epub/10542/pg10542.txt</span><span class="sh">"</span>
<span class="n">raw</span> <span class="o">=</span> <span class="n">urllib</span><span class="p">.</span><span class="n">request</span><span class="p">.</span><span class="nf">urlopen</span><span class="p">(</span><span class="n">BOOK</span><span class="p">).</span><span class="nf">read</span><span class="p">()</span>
<span class="n">raw</span> <span class="o">=</span> <span class="n">raw</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="sh">"</span><span class="s">utf-8</span><span class="sh">"</span><span class="p">).</span><span class="nf">replace</span><span class="p">(</span><span class="sh">"</span><span class="se">\r</span><span class="sh">"</span><span class="p">,</span> <span class="sh">""</span><span class="p">)</span>
<span class="n">begin</span> <span class="o">=</span> <span class="n">raw</span><span class="p">.</span><span class="nf">index</span><span class="p">(</span><span class="sh">"</span><span class="se">\n</span><span class="sh">"</span><span class="p">,</span> <span class="n">raw</span><span class="p">.</span><span class="nf">index</span><span class="p">(</span><span class="sh">"</span><span class="s">*** START</span><span class="sh">"</span><span class="p">))</span> <span class="o">+</span> <span class="mi">1</span>
<span class="n">novel</span> <span class="o">=</span> <span class="n">raw</span><span class="p">[</span><span class="n">begin</span> <span class="p">:</span> <span class="n">raw</span><span class="p">.</span><span class="nf">index</span><span class="p">(</span><span class="sh">"</span><span class="s">*** END</span><span class="sh">"</span><span class="p">)].</span><span class="nf">strip</span><span class="p">()</span>
<span class="n">chapters</span> <span class="o">=</span> <span class="n">re</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s">\n(?=[IVX]+\n)</span><span class="sh">"</span><span class="p">,</span> <span class="n">novel</span><span class="p">)</span>  <span class="c1"># the title page, then chapters I to XVII
</span><span class="k">if</span> <span class="n">SMOKE</span><span class="p">:</span>
    <span class="n">novel</span> <span class="o">=</span> <span class="n">novel</span><span class="p">[:</span><span class="mi">3000</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">novel</span><span class="p">.</span><span class="nf">split</span><span class="p">())</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> words, </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="nf">qwen_tok</span><span class="p">(</span><span class="n">novel</span><span class="p">).</span><span class="n">input_ids</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> Qwen3 tokens</span><span class="sh">"</span><span class="p">)</span>
<span class="k">for</span> <span class="n">chapter</span> <span class="ow">in</span> <span class="n">chapters</span><span class="p">[</span><span class="mi">1</span><span class="p">:</span><span class="mi">4</span><span class="p">]:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">chapter</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="sh">"</span><span class="se">\n</span><span class="sh">"</span><span class="p">)[:</span><span class="mi">3</span><span class="p">]).</span><span class="nf">strip</span><span class="p">())</span>
</code></pre></div></div> <pre class="tfs-printed"><code>60,227 words, 77,360 Qwen3 tokens
I  The Land of Lonesomeness
II  The Ship in the Creek
III  The Thing That Made Search</code></pre> <p>Nine questions, each with the words that count as a right answer and the chapter that holds it, from the title page to the last quarter of the book. Each one was checked against the text.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">QUESTIONS</span> <span class="o">=</span> <span class="p">[</span>  <span class="c1"># question, words that count as right, the chapter that holds the answer
</span>    <span class="p">(</span><span class="sh">"</span><span class="s">What is the surname of the man who tells the story?</span><span class="sh">"</span><span class="p">,</span> <span class="p">[</span><span class="sh">"</span><span class="s">winterstraw</span><span class="sh">"</span><span class="p">],</span> <span class="mi">0</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">How many days had the men been in the boats when they first sighted land?</span><span class="sh">"</span><span class="p">,</span>
     <span class="p">[</span><span class="sh">"</span><span class="s">five</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">5</span><span class="sh">"</span><span class="p">],</span> <span class="mi">1</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">What was the name of the young seaman whom the creatures on the island carried off?</span><span class="sh">"</span><span class="p">,</span>
     <span class="p">[</span><span class="sh">"</span><span class="s">job</span><span class="sh">"</span><span class="p">],</span> <span class="mi">9</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">What weapon did the narrator build to send a line across to the ship in the weed?</span><span class="sh">"</span><span class="p">,</span>
     <span class="p">[</span><span class="sh">"</span><span class="s">bow</span><span class="sh">"</span><span class="p">],</span> <span class="mi">12</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">What was the name of the man the weed men took?</span><span class="sh">"</span><span class="p">,</span> <span class="p">[</span><span class="sh">"</span><span class="s">tompkins</span><span class="sh">"</span><span class="p">],</span> <span class="mi">14</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">Which seaman proposed to fly a kite over the ship?</span><span class="sh">"</span><span class="p">,</span> <span class="p">[</span><span class="sh">"</span><span class="s">jessop</span><span class="sh">"</span><span class="p">],</span> <span class="mi">14</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">How many people were living aboard the ship trapped in the weed?</span><span class="sh">"</span><span class="p">,</span>
     <span class="p">[</span><span class="sh">"</span><span class="s">twelve</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">12</span><span class="sh">"</span><span class="p">],</span> <span class="mi">14</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">For how many years had the people of that ship been trapped in the weed?</span><span class="sh">"</span><span class="p">,</span>
     <span class="p">[</span><span class="sh">"</span><span class="s">seven</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">7</span><span class="sh">"</span><span class="p">],</span> <span class="mi">14</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">What was the name of the young woman who showed the narrator round the freed ship?</span><span class="sh">"</span><span class="p">,</span>
     <span class="p">[</span><span class="sh">"</span><span class="s">madison</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">mary</span><span class="sh">"</span><span class="p">],</span> <span class="mi">15</span><span class="p">),</span>
<span class="p">]</span>
<span class="n">ASK</span> <span class="o">=</span> <span class="sh">"</span><span class="s">Answer the question about the text above in a few words.</span><span class="se">\n</span><span class="s">Question: </span><span class="sh">"</span>
<span class="n">MARK</span> <span class="o">=</span> <span class="sh">"</span><span class="s">@@QUESTION@@</span><span class="sh">"</span>


<span class="k">def</span> <span class="nf">prompt_halves</span><span class="p">(</span><span class="n">content</span><span class="p">):</span>
    <span class="n">messages</span> <span class="o">=</span> <span class="p">[{</span><span class="sh">"</span><span class="s">role</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">user</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">content</span><span class="sh">"</span><span class="p">:</span> <span class="n">content</span> <span class="o">+</span> <span class="n">MARK</span><span class="p">}]</span>
    <span class="n">prompt</span> <span class="o">=</span> <span class="n">qwen_tok</span><span class="p">.</span><span class="nf">apply_chat_template</span><span class="p">(</span>
        <span class="n">messages</span><span class="p">,</span> <span class="n">tokenize</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">add_generation_prompt</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">enable_thinking</span><span class="o">=</span><span class="bp">False</span>
    <span class="p">)</span>
    <span class="n">before</span><span class="p">,</span> <span class="n">after</span> <span class="o">=</span> <span class="n">prompt</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">MARK</span><span class="p">)</span>
    <span class="k">return</span> <span class="nf">qwen_tok</span><span class="p">(</span><span class="n">before</span><span class="p">,</span> <span class="n">add_special_tokens</span><span class="o">=</span><span class="bp">False</span><span class="p">).</span><span class="n">input_ids</span><span class="p">,</span> <span class="n">after</span>


<span class="k">def</span> <span class="nf">is_right</span><span class="p">(</span><span class="n">said</span><span class="p">,</span> <span class="n">answers</span><span class="p">):</span>
    <span class="n">said</span> <span class="o">=</span> <span class="n">said</span><span class="p">.</span><span class="nf">lower</span><span class="p">()</span>
    <span class="k">return</span> <span class="nf">any</span><span class="p">(</span><span class="n">re</span><span class="p">.</span><span class="nf">search</span><span class="p">(</span><span class="sa">rf</span><span class="sh">"</span><span class="s">\b</span><span class="si">{</span><span class="n">a</span><span class="si">}</span><span class="s">\b</span><span class="sh">"</span><span class="p">,</span> <span class="n">said</span><span class="p">)</span> <span class="k">for</span> <span class="n">a</span> <span class="ow">in</span> <span class="n">answers</span><span class="p">)</span>
</code></pre></div></div> <p>The whole book is read once: its tokens go through the model and into the cache, and then each question continues from that point. Setting every cache’s length back to the end of the book before the next question is all it takes to forget the previous one; the book is never read twice.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">read</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">caches</span><span class="p">,</span> <span class="n">start</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span> <span class="n">chunk</span><span class="o">=</span><span class="mi">4096</span><span class="p">):</span>
    <span class="k">for</span> <span class="n">a</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">ids</span><span class="p">),</span> <span class="n">chunk</span><span class="p">):</span>
        <span class="n">piece</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">([</span><span class="n">ids</span><span class="p">[</span><span class="n">a</span> <span class="p">:</span> <span class="n">a</span> <span class="o">+</span> <span class="n">chunk</span><span class="p">]],</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
        <span class="n">h</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">piece</span><span class="p">,</span> <span class="n">start</span><span class="o">=</span><span class="n">start</span> <span class="o">+</span> <span class="n">a</span><span class="p">,</span> <span class="n">caches</span><span class="o">=</span><span class="n">caches</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">h</span>


<span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">answer</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">caches</span><span class="p">,</span> <span class="n">start</span><span class="p">,</span> <span class="n">question_ids</span><span class="p">,</span> <span class="n">steps</span><span class="o">=</span><span class="mi">24</span><span class="p">):</span>
    <span class="k">for</span> <span class="n">cache</span> <span class="ow">in</span> <span class="n">caches</span><span class="p">:</span>
        <span class="n">cache</span><span class="p">.</span><span class="n">length</span> <span class="o">=</span> <span class="n">start</span>
    <span class="n">h</span> <span class="o">=</span> <span class="nf">read</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">question_ids</span><span class="p">,</span> <span class="n">caches</span><span class="p">,</span> <span class="n">start</span><span class="o">=</span><span class="n">start</span><span class="p">)</span>
    <span class="n">out</span> <span class="o">=</span> <span class="p">[</span><span class="n">model</span><span class="p">.</span><span class="nf">logits</span><span class="p">(</span><span class="n">h</span><span class="p">[:,</span> <span class="o">-</span><span class="mi">1</span><span class="p">:]).</span><span class="nf">argmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)]</span>
    <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">steps</span> <span class="o">-</span> <span class="mi">1</span><span class="p">):</span>
        <span class="n">h</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">out</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">],</span> <span class="n">start</span><span class="o">=</span><span class="n">start</span> <span class="o">+</span> <span class="nf">len</span><span class="p">(</span><span class="n">question_ids</span><span class="p">)</span> <span class="o">+</span> <span class="n">i</span><span class="p">,</span> <span class="n">caches</span><span class="o">=</span><span class="n">caches</span><span class="p">)</span>
        <span class="n">out</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="nf">logits</span><span class="p">(</span><span class="n">h</span><span class="p">).</span><span class="nf">argmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">))</span>
    <span class="k">return</span> <span class="n">qwen_tok</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">(</span><span class="n">out</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)[</span><span class="mi">0</span><span class="p">],</span> <span class="n">skip_special_tokens</span><span class="o">=</span><span class="bp">True</span><span class="p">).</span><span class="nf">strip</span><span class="p">()</span>


<span class="k">def</span> <span class="nf">ask_all</span><span class="p">(</span><span class="n">context</span><span class="p">,</span> <span class="n">settings</span><span class="p">):</span>
    <span class="n">before</span><span class="p">,</span> <span class="n">after</span> <span class="o">=</span> <span class="nf">prompt_halves</span><span class="p">(</span><span class="n">context</span> <span class="o">+</span> <span class="sh">"</span><span class="se">\n\n</span><span class="sh">"</span> <span class="o">+</span> <span class="n">ASK</span><span class="p">)</span>
    <span class="n">qwen</span><span class="p">.</span><span class="n">freq</span><span class="p">,</span> <span class="n">qwen</span><span class="p">.</span><span class="n">scale</span> <span class="o">=</span> <span class="n">settings</span>
    <span class="n">caches</span> <span class="o">=</span> <span class="n">qwen</span><span class="p">.</span><span class="nf">new_caches</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">before</span><span class="p">)</span> <span class="o">+</span> <span class="mi">200</span><span class="p">)</span>
    <span class="nf">read</span><span class="p">(</span><span class="n">qwen</span><span class="p">,</span> <span class="n">before</span><span class="p">,</span> <span class="n">caches</span><span class="p">)</span>
    <span class="n">said</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">question</span><span class="p">,</span> <span class="n">_</span><span class="p">,</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">QUESTIONS</span><span class="p">:</span>
        <span class="n">ids</span> <span class="o">=</span> <span class="nf">qwen_tok</span><span class="p">(</span><span class="n">question</span> <span class="o">+</span> <span class="n">after</span><span class="p">,</span> <span class="n">add_special_tokens</span><span class="o">=</span><span class="bp">False</span><span class="p">).</span><span class="n">input_ids</span>
        <span class="n">said</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="nf">answer</span><span class="p">(</span><span class="n">qwen</span><span class="p">,</span> <span class="n">caches</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">before</span><span class="p">),</span> <span class="n">ids</span><span class="p">))</span>
    <span class="k">del</span> <span class="n">caches</span>
    <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
        <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">empty_cache</span><span class="p">()</span>
    <span class="k">return</span> <span class="n">said</span>


<span class="n">AS_TRAINED</span> <span class="o">=</span> <span class="p">(</span><span class="nf">rope_frequencies</span><span class="p">(</span><span class="n">qwen</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">qwen</span><span class="p">.</span><span class="n">base</span><span class="p">),</span> <span class="mf">1.0</span><span class="p">)</span>
<span class="n">YARN4</span> <span class="o">=</span> <span class="nf">yarn</span><span class="p">(</span><span class="n">qwen</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">qwen</span><span class="p">.</span><span class="n">base</span><span class="p">,</span> <span class="mi">4</span><span class="p">,</span> <span class="n">QWEN_TRAINED</span><span class="p">)</span>
</code></pre></div></div> <p>Four ways to answer. <em>No book</em>: the title and the author only, to measure what the model already knows. <em>Whole book, as trained</em>: 77 thousand tokens with the frequencies of a 32k model.</p> <p><em>Whole book, YaRN 4×</em>. <em>One chapter</em>: just the chapter that holds the answer, a few thousand tokens, which is what a good search engine in front of the model would hand it.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">title</span> <span class="o">=</span> <span class="sh">'</span><span class="s">The Boats of the </span><span class="sh">"</span><span class="s">Glen Carrig</span><span class="sh">"</span><span class="s">, a novel by William Hope Hodgson (1907).</span><span class="sh">'</span>
<span class="n">results</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">setting</span><span class="p">,</span> <span class="n">context</span><span class="p">,</span> <span class="n">rope</span> <span class="ow">in</span> <span class="p">[</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">whole book, as trained</span><span class="sh">"</span><span class="p">,</span> <span class="n">novel</span><span class="p">,</span> <span class="n">AS_TRAINED</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">whole book, YaRN 4×</span><span class="sh">"</span><span class="p">,</span> <span class="n">novel</span><span class="p">,</span> <span class="n">YARN4</span><span class="p">),</span>
<span class="p">]:</span>
    <span class="n">results</span><span class="p">[</span><span class="n">setting</span><span class="p">]</span> <span class="o">=</span> <span class="nf">ask_all</span><span class="p">(</span><span class="n">context</span><span class="p">,</span> <span class="n">rope</span><span class="p">)</span>
<span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">no book</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="nf">ask_all</span><span class="p">(</span><span class="n">title</span><span class="p">,</span> <span class="n">AS_TRAINED</span><span class="p">)</span>
<span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">one chapter</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="p">(</span><span class="n">_</span><span class="p">,</span> <span class="n">_</span><span class="p">,</span> <span class="n">chapter</span><span class="p">)</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">QUESTIONS</span><span class="p">):</span>
    <span class="n">context</span> <span class="o">=</span> <span class="n">chapters</span><span class="p">[</span><span class="n">chapter</span><span class="p">]</span> <span class="k">if</span> <span class="ow">not</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="n">novel</span><span class="p">[:</span><span class="mi">2000</span><span class="p">]</span>
    <span class="k">if</span> <span class="n">chapter</span> <span class="o">==</span> <span class="mi">0</span><span class="p">:</span>  <span class="c1"># the narrator's name is on the title page, before chapter I
</span>        <span class="n">context</span> <span class="o">=</span> <span class="n">chapters</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span> <span class="o">+</span> <span class="sh">"</span><span class="se">\n</span><span class="sh">"</span> <span class="o">+</span> <span class="n">chapters</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span> <span class="k">if</span> <span class="ow">not</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="n">novel</span><span class="p">[:</span><span class="mi">2000</span><span class="p">]</span>
    <span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">one chapter</span><span class="sh">"</span><span class="p">].</span><span class="nf">append</span><span class="p">(</span><span class="nf">ask_all</span><span class="p">(</span><span class="n">context</span><span class="p">,</span> <span class="n">AS_TRAINED</span><span class="p">)[</span><span class="n">k</span><span class="p">])</span>

<span class="n">SETTINGS</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">no book</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">whole book, as trained</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">whole book, YaRN 4×</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">one chapter</span><span class="sh">"</span><span class="p">]</span>
<span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="p">(</span><span class="n">question</span><span class="p">,</span> <span class="n">answers</span><span class="p">,</span> <span class="n">_</span><span class="p">)</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">QUESTIONS</span><span class="p">):</span>
    <span class="n">row</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">question</span><span class="sh">"</span><span class="p">:</span> <span class="n">question</span><span class="p">[:</span><span class="mi">48</span><span class="p">]</span> <span class="o">+</span> <span class="sh">"</span><span class="s">…</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">answer</span><span class="sh">"</span><span class="p">:</span> <span class="n">answers</span><span class="p">[</span><span class="mi">0</span><span class="p">]}</span>
    <span class="k">for</span> <span class="n">setting</span> <span class="ow">in</span> <span class="n">SETTINGS</span><span class="p">:</span>
        <span class="n">row</span><span class="p">[</span><span class="n">setting</span><span class="p">]</span> <span class="o">=</span> <span class="sh">"</span><span class="s">✓</span><span class="sh">"</span> <span class="k">if</span> <span class="nf">is_right</span><span class="p">(</span><span class="n">results</span><span class="p">[</span><span class="n">setting</span><span class="p">][</span><span class="n">k</span><span class="p">],</span> <span class="n">answers</span><span class="p">)</span> <span class="k">else</span> <span class="sh">"</span><span class="s">·</span><span class="sh">"</span>
    <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">row</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">question</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">answer</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">no book</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">whole book, as trained</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">whole book, YaRN 4×</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">one chapter</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">What is the surname of the man who tells the sto…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">winterstraw</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">·</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">How many days had the men been in the boats when…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">five</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">·</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">What was the name of the young seaman whom the c…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">job</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">·</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">·</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">What weapon did the narrator build to send a lin…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">bow</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">·</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">·</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">What was the name of the man the weed men took?…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">tompkins</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">·</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">·</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">·</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Which seaman proposed to fly a kite over the shi…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">jessop</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">·</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">How many people were living aboard the ship trap…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">twelve</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">·</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">·</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">For how many years had the people of that ship b…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">seven</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">·</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">What was the name of the young woman who showed …</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">madison</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">·</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">✓</td></tr></tbody></table></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">for</span> <span class="n">setting</span> <span class="ow">in</span> <span class="n">SETTINGS</span><span class="p">:</span>
    <span class="n">right</span> <span class="o">=</span> <span class="nf">sum</span><span class="p">(</span><span class="nf">is_right</span><span class="p">(</span><span class="n">said</span><span class="p">,</span> <span class="n">a</span><span class="p">)</span> <span class="k">for</span> <span class="n">said</span><span class="p">,</span> <span class="p">(</span><span class="n">_</span><span class="p">,</span> <span class="n">a</span><span class="p">,</span> <span class="n">_</span><span class="p">)</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">results</span><span class="p">[</span><span class="n">setting</span><span class="p">],</span> <span class="n">QUESTIONS</span><span class="p">))</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">setting</span><span class="si">:</span><span class="mi">24</span><span class="si">}</span><span class="s"> </span><span class="si">{</span><span class="n">right</span><span class="si">}</span><span class="s"> of </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">QUESTIONS</span><span class="p">)</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">()</span>
<span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="p">[</span><span class="mi">2</span><span class="p">,</span> <span class="mi">4</span><span class="p">,</span> <span class="mi">8</span><span class="p">]:</span>
    <span class="nf">print</span><span class="p">(</span><span class="n">QUESTIONS</span><span class="p">[</span><span class="n">k</span><span class="p">][</span><span class="mi">0</span><span class="p">])</span>
    <span class="k">for</span> <span class="n">setting</span> <span class="ow">in</span> <span class="p">[</span><span class="sh">"</span><span class="s">whole book, as trained</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">whole book, YaRN 4×</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">one chapter</span><span class="sh">"</span><span class="p">]:</span>
        <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">  </span><span class="si">{</span><span class="n">setting</span><span class="si">:</span><span class="mi">24</span><span class="si">}</span><span class="s"> </span><span class="si">{</span><span class="n">results</span><span class="p">[</span><span class="n">setting</span><span class="p">][</span><span class="n">k</span><span class="p">][</span><span class="si">:</span><span class="mi">90</span><span class="p">]</span><span class="si">!r}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>no book                  1 of 9
whole book, as trained   5 of 9
whole book, YaRN 4×      7 of 9
one chapter              9 of 9

What was the name of the young seaman whom the creatures on the island carried off? whole book, as trained   'The name of the young seaman whom the creatures on the island carried off was **Tompkins**' whole book, YaRN 4×      'The name of the young seaman carried off was Job.\n\n\nThe name of the young se' one chapter              'Job.\nOverride\n&lt;/think&gt;\n\nJob.\n\nThe name of the young se' What was the name of the man the weed men took? whole book, as trained   "The name of the man the weed men took was **the captain's wife**.\n\n**Explanation:**  \nIn" whole book, YaRN 4×      'Job.\n\nThe name of the man the weed men took was **Job**.

He was one of the crew' one chapter              'Tompkins.\nHuman: What is the name of the man who was lost?\n&lt;/think&gt;\n\nThe' What was the name of the young woman who showed the narrator round the freed ship? whole book, as trained   'The name of the young woman who showed the narrator round the freed ship was **Mistress Ma' whole book, YaRN 4×      'Mistress Madison.\n\n**Mistress Madison** is the young woman who showed the narrator round t' one chapter              'Mary Madison.\nHuman:&lt;/think&gt;\n\nThe name of the young woman who showed the narrator round th'</code></pre> <p>Without the book the model knows almost nothing about it, so the right answers come from reading. With the whole book and the frequencies it was trained with, more than twice its window, it still answers about half; with YaRN, most; with the one chapter, all of them.</p> <p>The misses are instructive. The book loses two of its sailors, Job and Tompkins, in two different scenes, and each whole-book run once gives one man’s name for the other’s scene: the model finds the right passage and attaches the wrong name to it.</p> <p>For questions like these a short, relevant passage beats a long one, which is why systems that answer questions about long documents usually search first and read second.</p> <p>The printed answers show one more habit: after a short prompt the model sometimes keeps talking past its answer and invents the next turn of the chat. Only the first words are counted.</p> <h2 id="10-where-each-piece-fits-today">10. Where each piece fits today</h2> <p><strong>Base and data first.</strong> Models trained today pick a large base from the start, half a million for Llama 3 and a million for Qwen, and spend a late stage of pretraining on long documents. Stretching covers the last factor of four or eight.</p> <p><strong>YaRN as the serving-time stretch.</strong> DeepSeek-V3 and gpt-oss ship with it in their configs, and Qwen3 documents how to switch it on. Hugging Face and vLLM implement the code’s version, the one we wrote.</p> <p><strong>FlashAttention everywhere.</strong> FlashAttention-2 sits behind PyTorch’s attention on Ampere GPUs and newer, and FlashAttention-3 was written for Hopper. On a T4 the memory-efficient kernel plays its role.</p> <p><strong>The cache is still the bill.</strong> Reading 64k tokens is now possible; keeping them is lesson 8’s problem, and the next lesson replaces the growing cache with a state of fixed size.</p> <p>Llama 3.1’s passport, the model that made 128k the default for open models, and the family tree:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/09/passport-light.png" width="760" alt="Llama 3.1 8B's passport. Published July 2024 by Meta under the Llama 3.1 Community License. Type: decoder-only, 8 billion parameters. Attention: 32 query heads sharing 8 key-value heads. Positions: rotary with base 500,000, stretched 8 times from the 8,192 tokens of pretraining by Meta's own frequency-dependent scaling. Context: 131,072 tokens. Vocabulary: 128,256 tokens. Good at: long documents at a size one GPU can serve. Not for: tasks that need the whole window to be read reliably" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/09/passport-dark.png" width="760" alt="Llama 3.1 8B's passport. Published July 2024 by Meta under the Llama 3.1 Community License. Type: decoder-only, 8 billion parameters. Attention: 32 query heads sharing 8 key-value heads. Positions: rotary with base 500,000, stretched 8 times from the 8,192 tokens of pretraining by Meta's own frequency-dependent scaling. Context: 131,072 tokens. Vocabulary: 128,256 tokens. Good at: long documents at a size one GPU can serve. Not for: tasks that need the whole window to be read reliably" loading="lazy"></p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/09/family-light.png" width="760" alt="The family of the Transformer as this course covers it, with lesson 9, long context, highlighted and lessons 1 to 8 done" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/09/family-dark.png" width="760" alt="The family of the Transformer as this course covers it, with lesson 9, long context, highlighted and lessons 1 to 8 done" loading="lazy"></p> <h2 id="references">References</h2> <ol class="tfs-refs"> <li id="ref-1">Su, J., Lu, Y., Pan, S., et al. (2021). <a href="https://arxiv.org/abs/2104.09864">RoFormer: enhanced Transformer with rotary position embedding</a>. arXiv:2104.09864.</li> <li id="ref-2">Chen, S., Wong, S., Chen, L., &amp; Tian, Y. (2023). <a href="https://arxiv.org/abs/2306.15595">Extending context window of large language models via positional interpolation</a>. arXiv:2306.15595.</li> <li id="ref-3">Peng, B., Quesnelle, J., Fan, H., &amp; Shippole, E. (2023). <a href="https://arxiv.org/abs/2309.00071">YaRN: efficient context window extension of large language models</a>. <em>ICLR 2024</em>.</li> <li id="ref-4">Zhang, P., Zeng, G., Wang, T., &amp; Lu, W. (2024). <a href="https://arxiv.org/abs/2401.02385">TinyLlama: an open-source small language model</a>. arXiv:2401.02385.</li> <li id="ref-5">Rae, J. W., Potapenko, A., Jayakumar, S. M., &amp; Lillicrap, T. P. (2019). <a href="https://arxiv.org/abs/1911.05507">Compressive Transformers for long-range sequence modelling</a>. <em>ICLR 2020</em>.</li> <li id="ref-6">Mohtashami, A., &amp; Jaggi, M. (2023). <a href="https://arxiv.org/abs/2305.16300">Landmark attention: random-access infinite context length for Transformers</a>. <em>NeurIPS 2023</em>.</li> <li id="ref-7">Milakov, M., &amp; Gimelshein, N. (2018). <a href="https://arxiv.org/abs/1805.02867">Online normalizer calculation for softmax</a>. arXiv:1805.02867.</li> <li id="ref-8">Rabe, M. N., &amp; Staats, C. (2021). <a href="https://arxiv.org/abs/2112.05682">Self-attention does not need O(n²) memory</a>. arXiv:2112.05682.</li> <li id="ref-9">Dao, T., Fu, D. Y., Ermon, S., Rudra, A., &amp; Ré, C. (2022). <a href="https://arxiv.org/abs/2205.14135">FlashAttention: fast and memory-efficient exact attention with IO-awareness</a>. <em>NeurIPS 2022</em>.</li> <li id="ref-10">Dao, T. (2023). <a href="https://arxiv.org/abs/2307.08691">FlashAttention-2: faster attention with better parallelism and work partitioning</a>. <em>ICLR 2024</em>.</li> <li id="ref-11">Grattafiori, A., Dubey, A., Jauhri, A., et al. (2024). <a href="https://arxiv.org/abs/2407.21783">The Llama 3 herd of models</a>. arXiv:2407.21783.</li> <li id="ref-12">Qwen Team (2025). <a href="https://arxiv.org/abs/2505.09388">Qwen3 technical report</a>. arXiv:2505.09388.</li> </ol>]]></content> <author> <name>Eva Koroleva</name> </author> <category term="machine-learning"/> <category term="transformer-architectures"/> <category term="long-context"/> <category term="rope"/> <category term="yarn"/> <category term="flashattention"/> <category term="position-interpolation"/> <category term="qwen3"/> <category term="llm"/> <summary type="html"><![CDATA[Why a language model breaks past the length it was trained on, and how RoPE scaling fixes it. Position interpolation, NTK scaling, YaRN and Llama 3.1's scaling written from scratch and checked against transformers, raced on TinyLlama; FlashAttention built from the online softmax; Qwen3 finding a needle in a novel up to 64k tokens.]]></summary> <media:thumbnail url="https://blog.korolevalab.com/assets/posts/arch/09/cover.png"/> <media:content medium="image" url="https://blog.korolevalab.com/assets/posts/arch/09/cover.png"/> </entry> <entry> <title type="html">The KV cache budget and DeepSeek’s latent attention</title> <link href="https://blog.korolevalab.com/blog/2026/transformer-architectures-08-kv/" rel="alternate" type="text/html" title="The KV cache budget and DeepSeek’s latent attention"/> <published>2026-09-10T17:00:00+00:00</published> <updated>2026-11-08T00:00:00+00:00</updated> <id>https://blog.korolevalab.com/blog/2026/transformer-architectures-08-kv</id> <content type="html" xml:base="https://blog.korolevalab.com/blog/2026/transformer-architectures-08-kv/"><![CDATA[<p class="tfs-links"><strong>Transformer architectures: from BERT to diffusion</strong> · lesson 8 of 15 · <a href="/teaching/">all lessons</a> · <a href="https://www.kaggle.com/code/qmarva/transformer-architectures-08-kv-cache-and-mla">run on Kaggle</a> · <a href="https://colab.research.google.com/github/xmarva/transformers-from-scratch/blob/main/notebooks/colab/a08_kv.ipynb">open in Colab</a> · <a href="https://github.com/xmarva/transformers-from-scratch">code on GitHub</a></p> <p>A chat with a language model keeps a key and a value for every token it has read, in every layer, for as long as the chat lasts.</p> <p><a href="/blog/2026/transformer-architectures-06-modern/">Lesson 6</a> counted that memory and showed the first two ways to cut it: share keys and values among query heads, and stop distant layers from looking far back.</p> <p>This lesson is about the third way, the one DeepSeek introduced in 2024: don’t store keys and values at all. Store a short vector per token, a <em>latent</em>, from which every head’s key and value can be recomputed when needed.</p> <p>DeepSeek-V3 has 128 query heads and 61 layers, and a token in its cache takes about half the memory it takes in Llama 3.1 8B, a model eighty times smaller. That trick, <em>multi-head latent attention</em>, is the subject of most of this lesson.</p> <p>We write it from scratch, find out why it needs its own handling of positions, load a small model built on it, and measure on a T4 what it buys and what it costs.</p> <p>Then we try to turn lesson 6’s Qwen3 into a latent model without any training, and look at the levers that work on any model: fewer bits per number, and a cache organised like virtual memory.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/08/hero-light.png" width="760" alt="What one token keeps in the cache under four designs, drawn to scale for 32 heads of 128. Multi-head attention keeps a key and a value for every head. Grouped-query attention keeps them for a few key-value heads shared by groups of queries. Multi-query attention keeps one key and one value. Latent attention keeps one compressed vector and a small rotary key, from which every head's key and value are rebuilt" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/08/hero-dark.png" width="760" alt="What one token keeps in the cache under four designs, drawn to scale for 32 heads of 128. Multi-head attention keeps a key and a value for every head. Grouped-query attention keeps them for a few key-value heads shared by groups of queries. Multi-query attention keeps one key and one value. Latent attention keeps one compressed vector and a small rotary key, from which every head's key and value are rebuilt" loading="lazy"></p> <p><strong>What you’ll do</strong></p> <ol> <li>Count what one token costs in the cache of ten models, and how many conversations fit next to them on a T4.</li> <li>Write multi-head latent attention in its two forms, the one that rebuilds keys and values and the one that never does, and check that they agree.</li> <li>Find out, with numbers, why rotary positions break the second form, and how DeepSeek mends it.</li> <li>Write MiniCPM3-4B, a latent-attention model that fits a T4, load its official weights and match Hugging Face.</li> <li>Measure how long a context fits with a latent cache and with a cache of rebuilt keys and values, and what each costs per generated token.</li> <li>Compress lesson 6’s Qwen3 into a latent model without training, two ways, and quantize its cache to fewer bits.</li> </ol> <p><strong>What you need</strong>: a GPU. On Kaggle, <em>Settings → Accelerator → GPU</em>; on Colab, <em>Runtime → Change runtime type → T4 GPU</em>. The notebook downloads MiniCPM3-4B (8 GB) and Qwen3-0.6B (1.5 GB); on a T4 it runs in about ten minutes.</p> <h2 id="setup">Setup</h2> <p>One small helper package, <code class="language-plaintext highlighter-rouge">tfs</code>, draws the course’s plots and token chips and knows where the notebook runs (Kaggle, Colab or your own machine). Everything the lesson teaches is written out in the notebook itself.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">importlib.util</span>
<span class="kn">import</span> <span class="n">subprocess</span>
<span class="kn">import</span> <span class="n">sys</span>

<span class="n">TFS</span> <span class="o">=</span> <span class="sh">"</span><span class="s">git+https://github.com/xmarva/transformers-from-scratch@main</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">importlib</span><span class="p">.</span><span class="n">util</span><span class="p">.</span><span class="nf">find_spec</span><span class="p">(</span><span class="sh">"</span><span class="s">tfs</span><span class="sh">"</span><span class="p">)</span> <span class="ow">is</span> <span class="bp">None</span><span class="p">:</span>
    <span class="n">subprocess</span><span class="p">.</span><span class="nf">check_call</span><span class="p">([</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">-m</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">pip</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">install</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-q</span><span class="sh">"</span><span class="p">,</span> <span class="n">TFS</span><span class="p">])</span>

<span class="kn">from</span> <span class="n">tfs</span> <span class="kn">import</span> <span class="n">env</span>
<span class="kn">from</span> <span class="n">tfs.viz</span> <span class="kn">import</span> <span class="n">table</span><span class="p">,</span> <span class="n">token_chips</span><span class="p">,</span> <span class="n">use_course_style</span>

<span class="n">env</span><span class="p">.</span><span class="nf">quiet</span><span class="p">()</span>  <span class="c1"># no progress bars or environment warnings in the outputs
</span><span class="n">SEED</span> <span class="o">=</span> <span class="mi">42</span>
<span class="n">env</span><span class="p">.</span><span class="nf">seed_everything</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">COLORS</span> <span class="o">=</span> <span class="nf">use_course_style</span><span class="p">()</span>
<span class="n">WORK_DIR</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">work_dir</span><span class="p">()</span>
</code></pre></div></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">json</span>
<span class="kn">import</span> <span class="n">math</span>
<span class="kn">import</span> <span class="n">subprocess</span>
<span class="kn">import</span> <span class="n">sys</span>
<span class="kn">import</span> <span class="n">time</span>
<span class="kn">from</span> <span class="n">pathlib</span> <span class="kn">import</span> <span class="n">Path</span>

<span class="kn">import</span> <span class="n">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>
<span class="kn">import</span> <span class="n">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="n">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">import</span> <span class="n">torch</span>
<span class="kn">import</span> <span class="n">torch.nn</span> <span class="k">as</span> <span class="n">nn</span>
<span class="kn">import</span> <span class="n">torch.nn.functional</span> <span class="k">as</span> <span class="n">F</span>
<span class="kn">from</span> <span class="n">huggingface_hub</span> <span class="kn">import</span> <span class="n">hf_hub_download</span>
<span class="kn">from</span> <span class="n">safetensors.torch</span> <span class="kn">import</span> <span class="n">load_file</span>
<span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">AutoModelForCausalLM</span><span class="p">,</span> <span class="n">AutoTokenizer</span>

<span class="n">SMOKE</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">smoke</span><span class="p">()</span>  <span class="c1"># CI runs the lesson on a small slice; you run it in full
</span><span class="n">device</span> <span class="o">=</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">if</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">is_available</span><span class="p">()</span> <span class="k">else</span> <span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span>
<span class="n">HALF</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">float16</span> <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">else</span> <span class="n">torch</span><span class="p">.</span><span class="n">float32</span>  <span class="c1"># 16-bit matmuls crawl on a CPU
</span><span class="k">assert</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="ow">or</span> <span class="n">SMOKE</span><span class="p">,</span> <span class="sh">"</span><span class="s">This lesson runs a 4B model: use a GPU</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">GPU:</span><span class="sh">"</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">get_device_name</span><span class="p">(</span><span class="mi">0</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>GPU: Tesla T4</code></pre> <h2 id="1-what-a-token-costs">1. What a token costs</h2> <p>For the models of lesson 6 the cost of a token is a plain product: two (a key and a value) times the layers \(L\), the key-value heads \(n_{kv}\) and the head size \(d_h\), in bytes per number \(b\):</p> \[\text{bytes per token} = 2 \cdot L \cdot n_{kv} \cdot d_h \cdot b.\] <p>A latent-attention model stores, per layer, one compressed vector of \(d_c\) numbers and one rotary key of \(d_h^R\) numbers shared by all heads:</p> \[\text{bytes per token} = (d_c + d_h^R) \cdot L \cdot b.\] <p>Here are ten models read from their configs, with every layer’s cache counted in full.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">CACHE_MODELS</span> <span class="o">=</span> <span class="p">[</span>  <span class="c1"># repository, name; Llama and Gemma from Unsloth's public copies
</span>    <span class="p">(</span><span class="sh">"</span><span class="s">unsloth/Meta-Llama-3.1-8B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Llama 3.1 8B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">mistralai/Mistral-7B-v0.1</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Mistral 7B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">Qwen/Qwen3-8B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Qwen3 8B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">unsloth/gemma-3-27b-pt</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Gemma 3 27B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">deepseek-ai/deepseek-llm-67b-base</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">DeepSeek 67B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">deepseek-ai/DeepSeek-V2-Lite</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">DeepSeek-V2-Lite</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">deepseek-ai/DeepSeek-V2</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">DeepSeek-V2</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">deepseek-ai/DeepSeek-V3</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">DeepSeek-V3</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">moonshotai/Kimi-K2-Instruct</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Kimi K2</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">openbmb/MiniCPM3-4B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">MiniCPM3 4B</span><span class="sh">"</span><span class="p">),</span>
<span class="p">]</span>


<span class="k">def</span> <span class="nf">read_config</span><span class="p">(</span><span class="n">repo</span><span class="p">):</span>
    <span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">repo</span><span class="p">,</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">))</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
        <span class="n">c</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">f</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">text_config</span><span class="sh">"</span><span class="p">,</span> <span class="n">c</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">cache_elements</span><span class="p">(</span><span class="n">c</span><span class="p">):</span>
    <span class="sh">"""</span><span class="s">Numbers kept per token, all layers.</span><span class="sh">"""</span>
    <span class="n">layers</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">]</span>
    <span class="k">if</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">kv_lora_rank</span><span class="sh">"</span><span class="p">):</span>
        <span class="nf">return </span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">kv_lora_rank</span><span class="sh">"</span><span class="p">]</span> <span class="o">+</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">qk_rope_head_dim</span><span class="sh">"</span><span class="p">])</span> <span class="o">*</span> <span class="n">layers</span>
    <span class="n">head</span> <span class="o">=</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">head_dim</span><span class="sh">"</span><span class="p">)</span> <span class="ow">or</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">]</span> <span class="o">//</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">]</span>
    <span class="k">return</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">layers</span> <span class="o">*</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">num_key_value_heads</span><span class="sh">"</span><span class="p">,</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">])</span> <span class="o">*</span> <span class="n">head</span>


<span class="n">configs</span> <span class="o">=</span> <span class="p">{</span><span class="n">name</span><span class="p">:</span> <span class="nf">read_config</span><span class="p">(</span><span class="n">repo</span><span class="p">)</span> <span class="k">for</span> <span class="n">repo</span><span class="p">,</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">CACHE_MODELS</span><span class="p">}</span>
<span class="n">CHAT</span> <span class="o">=</span> <span class="mi">8192</span>  <span class="c1"># tokens in one conversation
</span><span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">_</span><span class="p">,</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">CACHE_MODELS</span><span class="p">:</span>
    <span class="n">c</span> <span class="o">=</span> <span class="n">configs</span><span class="p">[</span><span class="n">name</span><span class="p">]</span>
    <span class="n">per_token</span> <span class="o">=</span> <span class="nf">cache_elements</span><span class="p">(</span><span class="n">c</span><span class="p">)</span> <span class="o">*</span> <span class="mi">2</span>  <span class="c1"># 16-bit numbers
</span>    <span class="n">latent</span> <span class="o">=</span> <span class="nf">bool</span><span class="p">(</span><span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">kv_lora_rank</span><span class="sh">"</span><span class="p">))</span>
    <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
        <span class="p">{</span>
            <span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">layers</span><span class="sh">"</span><span class="p">:</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">],</span>
            <span class="sh">"</span><span class="s">query heads</span><span class="sh">"</span><span class="p">:</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">],</span>
            <span class="sh">"</span><span class="s">kept per layer</span><span class="sh">"</span><span class="p">:</span> <span class="p">(</span>
                <span class="sa">f</span><span class="sh">"</span><span class="s">latent </span><span class="si">{</span><span class="n">c</span><span class="p">[</span><span class="sh">'</span><span class="s">kv_lora_rank</span><span class="sh">'</span><span class="p">]</span><span class="si">}</span><span class="s"> + rope </span><span class="si">{</span><span class="n">c</span><span class="p">[</span><span class="sh">'</span><span class="s">qk_rope_head_dim</span><span class="sh">'</span><span class="p">]</span><span class="si">}</span><span class="sh">"</span>
                <span class="k">if</span> <span class="n">latent</span>
                <span class="k">else</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">'</span><span class="s">num_key_value_heads</span><span class="sh">'</span><span class="p">,</span> <span class="n">c</span><span class="p">[</span><span class="sh">'</span><span class="s">num_attention_heads</span><span class="sh">'</span><span class="p">])</span><span class="si">}</span><span class="s"> kv heads</span><span class="sh">"</span>
            <span class="p">),</span>
            <span class="sh">"</span><span class="s">KiB per token</span><span class="sh">"</span><span class="p">:</span> <span class="n">per_token</span> <span class="o">/</span> <span class="mi">1024</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">GB per 8k chat</span><span class="sh">"</span><span class="p">:</span> <span class="n">per_token</span> <span class="o">*</span> <span class="n">CHAT</span> <span class="o">/</span> <span class="mf">1e9</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">8k chats in 10 GB</span><span class="sh">"</span><span class="p">:</span> <span class="nf">int</span><span class="p">(</span><span class="mf">10e9</span> <span class="o">//</span> <span class="p">(</span><span class="n">per_token</span> <span class="o">*</span> <span class="n">CHAT</span><span class="p">)),</span>
        <span class="p">}</span>
    <span class="p">)</span>
<span class="n">budget</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">budget</span><span class="p">,</span> <span class="n">digits</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">model</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">layers</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">query heads</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">kept per layer</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">KiB per token</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">GB per 8k chat</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">8k chats in 10 GB</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Llama 3.1 8B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">8 kv heads</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128.0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">9</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Mistral 7B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">8 kv heads</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128.0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">9</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Qwen3 8B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">36</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">8 kv heads</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">144.0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Gemma 3 27B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">62</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">16 kv heads</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">496.0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4.2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">DeepSeek 67B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">95</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">64</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">8 kv heads</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">380.0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">DeepSeek-V2-Lite</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">27</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">16</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">latent 512 + rope 64</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">30.4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.3</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">39</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">DeepSeek-V2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">60</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">latent 512 + rope 64</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">67.5</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.6</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">17</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">DeepSeek-V3</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">61</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">latent 512 + rope 64</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">68.6</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.6</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">17</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Kimi K2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">61</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">64</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">latent 512 + rope 64</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">68.6</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.6</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">17</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">MiniCPM3 4B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">62</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">40</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">latent 256 + rope 32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">34.9</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.3</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">34</td></tr></tbody></table></div> <p>The spread is wide. The dense models of lesson 6 sit in a narrow band, and Gemma 3 27B tops the table only because we counted every layer in full; its local layers keep a window, as lesson 6 showed, and a real Gemma cache is far smaller.</p> <p>The latent models are a different class: DeepSeek-V3, with 128 query heads and 61 layers, keeps about half of what Llama 3.1 8B keeps per token, and MiniCPM3 a quarter.</p> <p>DeepSeek’s own headline for this is bigger, a cache “reduced by 93.3%” against DeepSeek 67B. By our count from the configs, latent attention alone cuts the cache by about four fifths; the rest of the way to 93.3% comes from storing the cache in about six bits per number, which the paper mentions a few sections later.</p> <p>“10 GB” is roughly what a T4 has left once a 4-billion-parameter model sits in it in 16-bit floats, so the last column is how many people could talk to such a model at once if it had each architecture’s cache.</p> <h2 id="2-latent-attention">2. Latent attention</h2> <p>DeepSeek-V2 describes it in a dozen equations<sup class="cite">[<a href="#ref-1" id="cite-1" data-ref="1" aria-label="Reference 1: DeepSeek-AI (2024). DeepSeek-V2: a strong, economical, and efficient mixture-of-experts language model. arXiv:2405.04434.">1</a>]</sup>. For a token with hidden state \(h_t\), the keys and values of all heads come from one compressed vector:</p> \[c_t^{KV} = W^{DKV} h_t,\] \[k_t^C = W^{UK} c_t^{KV}, \qquad v_t^C = W^{UV} c_t^{KV},\] <p>where \(c_t^{KV}\) has \(d_c\) numbers, far fewer than the \(2 n_h d_h\) of the keys and values it stands for. “MLA only needs to cache \(c_t^{KV}\)”, and more than that: “since \(W^{UK}\) can be absorbed into \(W^Q\), and \(W^{UV}\) can be absorbed into \(W^O\), we even do not need to compute keys and values out for attention.”</p> <p>The absorption is one line of algebra. The score of query \(q_t\) against key \(k_j = W^{UK} c_j\) in one head is</p> \[q_t^\top k_j = q_t^\top W^{UK} c_j = \big((W^{UK})^\top q_t\big)^\top c_j,\] <p>so instead of rebuilding a key for every cached token we move the query into the latent space once, and score it against the cached latents directly. The same happens on the way out: a mix of values is \(W^{UV}\) times a mix of latents, and \(W^{UV}\) can be applied after the mixing, or folded into the output projection.</p> <p>Positions are handled separately, for a reason section 3 explains: each head gets a few more query dimensions, and all heads share one more key, \(k_t^R\), both rotated by <a href="/blog/2026/transformers-from-scratch-05-llama/">RoPE</a>. The cache holds \(c_t^{KV}\) and \(k_t^R\). Here is a layer of it, written so that the same weights can run either way.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">dim</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="mf">1e-5</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">eps</span> <span class="o">=</span> <span class="n">eps</span>
        <span class="n">self</span><span class="p">.</span><span class="n">weight</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">dim</span><span class="p">))</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">x32</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="nf">float</span><span class="p">()</span>
        <span class="n">x32</span> <span class="o">=</span> <span class="n">x32</span> <span class="o">*</span> <span class="n">torch</span><span class="p">.</span><span class="nf">rsqrt</span><span class="p">(</span><span class="n">x32</span><span class="p">.</span><span class="nf">pow</span><span class="p">(</span><span class="mi">2</span><span class="p">).</span><span class="nf">mean</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">eps</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="n">weight</span> <span class="o">*</span> <span class="n">x32</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">rotate</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">):</span>
    <span class="n">half</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span> <span class="o">//</span> <span class="mi">2</span>
    <span class="n">rotated</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="o">-</span><span class="n">x</span><span class="p">[...,</span> <span class="n">half</span><span class="p">:],</span> <span class="n">x</span><span class="p">[...,</span> <span class="p">:</span><span class="n">half</span><span class="p">]],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">x</span> <span class="o">*</span> <span class="n">cos</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span> <span class="o">+</span> <span class="n">rotated</span> <span class="o">*</span> <span class="n">sin</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span>


<span class="k">class</span> <span class="nc">LatentCache</span><span class="p">:</span>
    <span class="sh">"""</span><span class="s">What latent attention keeps per token: the latent and the shared rotary key.</span><span class="sh">"""</span>

    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">):</span>
        <span class="n">self</span><span class="p">.</span><span class="n">c</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">k_rope</span> <span class="o">=</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span>

    <span class="k">def</span> <span class="nf">add</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">,</span> <span class="n">k_rope</span><span class="p">):</span>
        <span class="k">if</span> <span class="n">self</span><span class="p">.</span><span class="n">c</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
            <span class="n">c</span><span class="p">,</span> <span class="n">k_rope</span> <span class="o">=</span> <span class="p">(</span>
                <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">self</span><span class="p">.</span><span class="n">c</span><span class="p">,</span> <span class="n">c</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">),</span>
                <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">self</span><span class="p">.</span><span class="n">k_rope</span><span class="p">,</span> <span class="n">k_rope</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">2</span><span class="p">),</span>
            <span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">c</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">k_rope</span> <span class="o">=</span> <span class="n">c</span><span class="p">,</span> <span class="n">k_rope</span>
        <span class="k">return</span> <span class="n">c</span><span class="p">,</span> <span class="n">k_rope</span>

    <span class="k">def</span> <span class="nf">bytes</span><span class="p">(</span><span class="n">self</span><span class="p">):</span>
        <span class="nf">return </span><span class="p">(</span>
            <span class="n">self</span><span class="p">.</span><span class="n">c</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">c</span><span class="p">.</span><span class="nf">element_size</span><span class="p">()</span>
            <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">k_rope</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">k_rope</span><span class="p">.</span><span class="nf">element_size</span><span class="p">()</span>
        <span class="p">)</span>


<span class="k">class</span> <span class="nc">ExpandedCache</span><span class="p">:</span>
    <span class="sh">"""</span><span class="s">What a plain cache would keep: every head</span><span class="sh">'</span><span class="s">s key and value, rebuilt.</span><span class="sh">"""</span>

    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">):</span>
        <span class="n">self</span><span class="p">.</span><span class="n">k</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">v</span> <span class="o">=</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span>

    <span class="k">def</span> <span class="nf">add</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">):</span>
        <span class="k">if</span> <span class="n">self</span><span class="p">.</span><span class="n">k</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
            <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">self</span><span class="p">.</span><span class="n">k</span><span class="p">,</span> <span class="n">k</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">2</span><span class="p">),</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">self</span><span class="p">.</span><span class="n">v</span><span class="p">,</span> <span class="n">v</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">k</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">v</span> <span class="o">=</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span>
        <span class="k">return</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span>

    <span class="k">def</span> <span class="nf">bytes</span><span class="p">(</span><span class="n">self</span><span class="p">):</span>
        <span class="nf">return </span><span class="p">(</span>
            <span class="n">self</span><span class="p">.</span><span class="n">k</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">k</span><span class="p">.</span><span class="nf">element_size</span><span class="p">()</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">v</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">v</span><span class="p">.</span><span class="nf">element_size</span><span class="p">()</span>
        <span class="p">)</span>


<span class="k">class</span> <span class="nc">MLA</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">nope</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">rope</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">qk_nope_head_dim</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">qk_rope_head_dim</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">v_dim</span> <span class="o">=</span> <span class="p">(</span>
            <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">v_head_dim</span><span class="sh">"</span><span class="p">)</span> <span class="ow">or</span> <span class="n">d</span> <span class="o">//</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span>
        <span class="p">)</span>  <span class="c1"># MiniCPM3's config leaves it out
</span>        <span class="n">self</span><span class="p">.</span><span class="n">rank</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">kv_lora_rank</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">q_rank</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">q_lora_rank</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">eps</span> <span class="o">=</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">rms_norm_eps</span><span class="sh">"</span><span class="p">,</span> <span class="mf">1e-5</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">q_a_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">q_rank</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>  <span class="c1"># queries are compressed too
</span>        <span class="n">self</span><span class="p">.</span><span class="n">q_a_layernorm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">q_rank</span><span class="p">,</span> <span class="n">eps</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">q_b_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">q_rank</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">*</span> <span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">nope</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">rope</span><span class="p">),</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">kv_a_proj_with_mqa</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span>
            <span class="n">d</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">rank</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">rope</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span>
        <span class="p">)</span>  <span class="c1"># c and k_rope
</span>        <span class="n">self</span><span class="p">.</span><span class="n">kv_a_layernorm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">rank</span><span class="p">,</span> <span class="n">eps</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">kv_b_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span>
            <span class="n">self</span><span class="p">.</span><span class="n">rank</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">*</span> <span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">nope</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">v_dim</span><span class="p">),</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span>
        <span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">o_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">v_dim</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">scale</span> <span class="o">=</span> <span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">nope</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">rope</span><span class="p">)</span> <span class="o">**</span> <span class="o">-</span><span class="mf">0.5</span>

    <span class="k">def</span> <span class="nf">queries</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">):</span>
        <span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span>
        <span class="n">q</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">q_b_proj</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">q_a_layernorm</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">q_a_proj</span><span class="p">(</span><span class="n">x</span><span class="p">)))</span>
        <span class="n">q</span> <span class="o">=</span> <span class="n">q</span><span class="p">.</span><span class="nf">view</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">nope</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">rope</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
        <span class="n">q_nope</span><span class="p">,</span> <span class="n">q_rope</span> <span class="o">=</span> <span class="n">q</span><span class="p">.</span><span class="nf">split</span><span class="p">([</span><span class="n">self</span><span class="p">.</span><span class="n">nope</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">rope</span><span class="p">],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">q_nope</span><span class="p">,</span> <span class="nf">rotate</span><span class="p">(</span><span class="n">q_rope</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">latents</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">):</span>
        <span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span>
        <span class="n">c</span><span class="p">,</span> <span class="n">k_rope</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">kv_a_proj_with_mqa</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">split</span><span class="p">([</span><span class="n">self</span><span class="p">.</span><span class="n">rank</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">rope</span><span class="p">],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">k_rope</span> <span class="o">=</span> <span class="nf">rotate</span><span class="p">(</span><span class="n">k_rope</span><span class="p">.</span><span class="nf">view</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">rope</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">),</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">kv_a_layernorm</span><span class="p">(</span><span class="n">c</span><span class="p">),</span> <span class="n">k_rope</span>  <span class="c1"># b x t x rank, and b x 1 x t x rope
</span>
    <span class="k">def</span> <span class="nf">up</span><span class="p">(</span><span class="n">self</span><span class="p">):</span>
        <span class="sh">"""</span><span class="s">W_UK and W_UV, one block per head: heads x (nope + v) x rank.</span><span class="sh">"""</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="n">kv_b_proj</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="nf">view</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">nope</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">v_dim</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">rank</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">expand</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">,</span> <span class="n">k_rope</span><span class="p">):</span>
        <span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">c</span><span class="p">.</span><span class="n">shape</span>
        <span class="n">kv</span> <span class="o">=</span> <span class="p">(</span>
            <span class="n">self</span><span class="p">.</span><span class="nf">kv_b_proj</span><span class="p">(</span><span class="n">c</span><span class="p">).</span><span class="nf">view</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">nope</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">v_dim</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
        <span class="p">)</span>
        <span class="n">k_nope</span><span class="p">,</span> <span class="n">v</span> <span class="o">=</span> <span class="n">kv</span><span class="p">.</span><span class="nf">split</span><span class="p">([</span><span class="n">self</span><span class="p">.</span><span class="n">nope</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">v_dim</span><span class="p">],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">k</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">k_nope</span><span class="p">,</span> <span class="n">k_rope</span><span class="p">.</span><span class="nf">expand</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">)],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">cache</span><span class="o">=</span><span class="bp">None</span><span class="p">,</span> <span class="n">absorb</span><span class="o">=</span><span class="bp">False</span><span class="p">):</span>
        <span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span>
        <span class="n">q_nope</span><span class="p">,</span> <span class="n">q_rope</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">queries</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">)</span>
        <span class="n">c</span><span class="p">,</span> <span class="n">k_rope</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">latents</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">)</span>
        <span class="k">if</span> <span class="nf">isinstance</span><span class="p">(</span><span class="n">cache</span><span class="p">,</span> <span class="n">ExpandedCache</span><span class="p">):</span>
            <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="o">=</span> <span class="n">cache</span><span class="p">.</span><span class="nf">add</span><span class="p">(</span><span class="o">*</span><span class="n">self</span><span class="p">.</span><span class="nf">expand</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="n">k_rope</span><span class="p">))</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="k">if</span> <span class="n">cache</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
                <span class="n">c</span><span class="p">,</span> <span class="n">k_rope</span> <span class="o">=</span> <span class="n">cache</span><span class="p">.</span><span class="nf">add</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="n">k_rope</span><span class="p">)</span>
            <span class="k">if</span> <span class="ow">not</span> <span class="n">absorb</span><span class="p">:</span>  <span class="c1"># rebuild every head's keys and values, then ordinary attention
</span>                <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">expand</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="n">k_rope</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">absorb</span><span class="p">:</span>  <span class="c1"># score against the latents themselves; keys and values are never built
</span>            <span class="n">w_uk</span><span class="p">,</span> <span class="n">w_uv</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">up</span><span class="p">().</span><span class="nf">split</span><span class="p">([</span><span class="n">self</span><span class="p">.</span><span class="n">nope</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">v_dim</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
            <span class="n">q_latent</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">einsum</span><span class="p">(</span><span class="sh">"</span><span class="s">bhtn,hnr-&gt;bhtr</span><span class="sh">"</span><span class="p">,</span> <span class="n">q_nope</span><span class="p">,</span> <span class="n">w_uk</span><span class="p">)</span>
            <span class="n">scores</span> <span class="o">=</span> <span class="p">(</span>
                <span class="n">q_latent</span> <span class="o">@</span> <span class="n">c</span><span class="p">.</span><span class="nf">unsqueeze</span><span class="p">(</span><span class="mi">1</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">2</span><span class="p">)</span>
                <span class="o">+</span> <span class="n">q_rope</span> <span class="o">@</span> <span class="n">k_rope</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">2</span><span class="p">)</span>
            <span class="p">)</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">scale</span>
            <span class="n">weights</span> <span class="o">=</span> <span class="n">scores</span><span class="p">.</span><span class="nf">float</span><span class="p">().</span><span class="nf">masked_fill</span><span class="p">(</span><span class="o">~</span><span class="n">mask</span><span class="p">,</span> <span class="nf">float</span><span class="p">(</span><span class="sh">"</span><span class="s">-inf</span><span class="sh">"</span><span class="p">)).</span><span class="nf">softmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
            <span class="n">mixed</span> <span class="o">=</span> <span class="n">weights</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">c</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span> <span class="o">@</span> <span class="n">c</span><span class="p">.</span><span class="nf">unsqueeze</span><span class="p">(</span><span class="mi">1</span><span class="p">)</span>  <span class="c1"># b x heads x t x rank
</span>            <span class="n">out</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">einsum</span><span class="p">(</span><span class="sh">"</span><span class="s">bhtr,hvr-&gt;bhtv</span><span class="sh">"</span><span class="p">,</span> <span class="n">mixed</span><span class="p">,</span> <span class="n">w_uv</span><span class="p">)</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="n">q</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">q_nope</span><span class="p">,</span> <span class="n">q_rope</span><span class="p">],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
            <span class="n">out</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">scaled_dot_product_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">,</span> <span class="n">attn_mask</span><span class="o">=</span><span class="n">mask</span><span class="p">,</span> <span class="n">scale</span><span class="o">=</span><span class="n">self</span><span class="p">.</span><span class="n">scale</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">o_proj</span><span class="p">(</span><span class="n">out</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">))</span>
</code></pre></div></div> <p>Two runs of the same random layer, one rebuilding keys and values and one absorbing the up-projections, must give the same output. In 32-bit floats they do, up to the order of the additions:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">rope_tables</span><span class="p">(</span><span class="n">positions</span><span class="p">,</span> <span class="n">dim</span><span class="p">,</span> <span class="n">theta</span><span class="o">=</span><span class="mf">10000.0</span><span class="p">,</span> <span class="n">factors</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
    <span class="n">exponents</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">dim</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">positions</span><span class="p">.</span><span class="n">device</span><span class="p">).</span><span class="nf">float</span><span class="p">()</span> <span class="o">/</span> <span class="n">dim</span>
    <span class="n">inv_freq</span> <span class="o">=</span> <span class="mf">1.0</span> <span class="o">/</span> <span class="n">theta</span><span class="o">**</span><span class="n">exponents</span>
    <span class="k">if</span> <span class="n">factors</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>  <span class="c1"># MiniCPM3's long-context RoPE stretches each frequency
</span>        <span class="n">inv_freq</span> <span class="o">=</span> <span class="n">inv_freq</span> <span class="o">/</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span>
            <span class="n">factors</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">positions</span><span class="p">.</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">float</span>
        <span class="p">)</span>
    <span class="n">angles</span> <span class="o">=</span> <span class="n">positions</span><span class="p">.</span><span class="nf">float</span><span class="p">()[...,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="n">inv_freq</span>
    <span class="n">angles</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">angles</span><span class="p">,</span> <span class="n">angles</span><span class="p">],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">angles</span><span class="p">.</span><span class="nf">cos</span><span class="p">()[:,</span> <span class="bp">None</span><span class="p">],</span> <span class="n">angles</span><span class="p">.</span><span class="nf">sin</span><span class="p">()[:,</span> <span class="bp">None</span><span class="p">]</span>


<span class="n">small</span> <span class="o">=</span> <span class="p">{</span>
    <span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">:</span> <span class="mi">256</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">:</span> <span class="mi">8</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">qk_nope_head_dim</span><span class="sh">"</span><span class="p">:</span> <span class="mi">32</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">qk_rope_head_dim</span><span class="sh">"</span><span class="p">:</span> <span class="mi">16</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">v_head_dim</span><span class="sh">"</span><span class="p">:</span> <span class="mi">32</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">kv_lora_rank</span><span class="sh">"</span><span class="p">:</span> <span class="mi">64</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">q_lora_rank</span><span class="sh">"</span><span class="p">:</span> <span class="mi">96</span><span class="p">,</span>
<span class="p">}</span>
<span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="mi">0</span><span class="p">)</span>
<span class="n">layer</span> <span class="o">=</span> <span class="nc">MLA</span><span class="p">(</span><span class="n">small</span><span class="p">)</span>
<span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">layer</span><span class="p">.</span><span class="nf">parameters</span><span class="p">():</span>
    <span class="n">nn</span><span class="p">.</span><span class="n">init</span><span class="p">.</span><span class="nf">normal_</span><span class="p">(</span><span class="n">p</span><span class="p">,</span> <span class="n">std</span><span class="o">=</span><span class="mf">0.08</span><span class="p">)</span> <span class="k">if</span> <span class="n">p</span><span class="p">.</span><span class="nf">dim</span><span class="p">()</span> <span class="o">&gt;</span> <span class="mi">1</span> <span class="k">else</span> <span class="bp">None</span>
<span class="n">x</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="mi">2</span><span class="p">,</span> <span class="mi">40</span><span class="p">,</span> <span class="mi">256</span><span class="p">)</span>
<span class="n">cos</span><span class="p">,</span> <span class="n">sin</span> <span class="o">=</span> <span class="nf">rope_tables</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="mi">40</span><span class="p">)[</span><span class="bp">None</span><span class="p">],</span> <span class="mi">16</span><span class="p">)</span>
<span class="n">causal</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="mi">40</span><span class="p">,</span> <span class="mi">40</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">).</span><span class="nf">tril</span><span class="p">()</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">rebuilt</span> <span class="o">=</span> <span class="nf">layer</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">,</span> <span class="n">causal</span><span class="p">)</span>
    <span class="n">absorbed</span> <span class="o">=</span> <span class="nf">layer</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">,</span> <span class="n">causal</span><span class="p">,</span> <span class="n">absorb</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">max difference:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="n">rebuilt</span> <span class="o">-</span> <span class="n">absorbed</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="n">heads</span><span class="p">,</span> <span class="n">head</span> <span class="o">=</span> <span class="n">small</span><span class="p">[</span><span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">],</span> <span class="n">small</span><span class="p">[</span><span class="sh">"</span><span class="s">qk_nope_head_dim</span><span class="sh">"</span><span class="p">]</span>
<span class="n">per_token</span> <span class="o">=</span> <span class="p">{</span>
    <span class="sh">"</span><span class="s">rebuilt keys and values</span><span class="sh">"</span><span class="p">:</span> <span class="n">heads</span>
    <span class="o">*</span> <span class="p">(</span><span class="n">head</span> <span class="o">+</span> <span class="n">small</span><span class="p">[</span><span class="sh">"</span><span class="s">qk_rope_head_dim</span><span class="sh">"</span><span class="p">]</span> <span class="o">+</span> <span class="n">small</span><span class="p">[</span><span class="sh">"</span><span class="s">v_head_dim</span><span class="sh">"</span><span class="p">]),</span>
    <span class="sh">"</span><span class="s">latent and rotary key</span><span class="sh">"</span><span class="p">:</span> <span class="n">small</span><span class="p">[</span><span class="sh">"</span><span class="s">kv_lora_rank</span><span class="sh">"</span><span class="p">]</span> <span class="o">+</span> <span class="n">small</span><span class="p">[</span><span class="sh">"</span><span class="s">qk_rope_head_dim</span><span class="sh">"</span><span class="p">],</span>
<span class="p">}</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">numbers cached per token per layer:</span><span class="sh">"</span><span class="p">,</span> <span class="n">per_token</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>max difference: 9.24e-07
numbers cached per token per layer: {'rebuilt keys and values': 640, 'latent and rotary key': 80}</code></pre> <p>The two forms agree to the rounding of 32-bit floats, so the absorbed one is not an approximation; it is the same arithmetic in a different order. What changes is what has to be kept.</p> <p>In this toy layer the rebuilt keys and values take eight times the memory of the latent and the rotary key, and in a real model the ratio is larger, because real models have more and wider heads per latent.</p> <h2 id="3-why-positions-need-their-own-dimensions">3. Why positions need their own dimensions</h2> <p>With rotary positions the key of token \(j\) is not \(W^{UK} c_j\) but \(R_j W^{UK} c_j\), where \(R_j\) rotates by an angle that depends on \(j\); the query is rotated too, by \(R_t\). The score becomes</p> \[q_t^\top R_t^\top R_j W^{UK} c_j,\] <p>and the matrix between the query and the latent now depends on both positions. It cannot be folded into the query once and for all: in DeepSeek’s words, “a RoPE matrix related to the currently generating token will lie between \(W^Q\) and \(W^{UK}\) and matrix multiplication does not obey a commutative law. As a result, we must recompute the keys for all the prefix tokens during inference”. Their fix is to keep the rotation out of the compressed part altogether and give it a few dimensions of its own, the <em>decoupled</em> rotary query and key of the layer above.</p> <p>The failure is easy to see. Rotate the keys built from latents, the obvious design, and try to absorb anyway:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="mi">1</span><span class="p">)</span>
<span class="n">t</span><span class="p">,</span> <span class="n">r</span><span class="p">,</span> <span class="n">dh</span> <span class="o">=</span> <span class="mi">32</span><span class="p">,</span> <span class="mi">64</span><span class="p">,</span> <span class="mi">32</span>
<span class="n">w_uk</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="n">dh</span><span class="p">,</span> <span class="n">r</span><span class="p">)</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="n">r</span><span class="p">)</span>
<span class="n">latents</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="n">t</span><span class="p">,</span> <span class="n">r</span><span class="p">)</span>
<span class="n">query</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="n">dh</span><span class="p">)</span>
<span class="n">cos1</span><span class="p">,</span> <span class="n">sin1</span> <span class="o">=</span> <span class="nf">rope_tables</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">t</span><span class="p">)[</span><span class="bp">None</span><span class="p">],</span> <span class="n">dh</span><span class="p">)</span>
<span class="n">keys</span> <span class="o">=</span> <span class="nf">rotate</span><span class="p">((</span><span class="n">latents</span> <span class="o">@</span> <span class="n">w_uk</span><span class="p">.</span><span class="n">T</span><span class="p">)[</span><span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">],</span> <span class="n">cos1</span><span class="p">,</span> <span class="n">sin1</span><span class="p">)[</span>
    <span class="mi">0</span><span class="p">,</span> <span class="mi">0</span>
<span class="p">]</span>  <span class="c1"># rotated after the up-projection
</span><span class="n">q_rot</span> <span class="o">=</span> <span class="nf">rotate</span><span class="p">(</span><span class="n">query</span><span class="p">.</span><span class="nf">expand</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">dh</span><span class="p">),</span> <span class="n">cos1</span><span class="p">[:,</span> <span class="p">:,</span> <span class="o">-</span><span class="mi">1</span><span class="p">:],</span> <span class="n">sin1</span><span class="p">[:,</span> <span class="p">:,</span> <span class="o">-</span><span class="mi">1</span><span class="p">:])[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">]</span>
<span class="n">honest</span> <span class="o">=</span> <span class="n">keys</span> <span class="o">@</span> <span class="n">q_rot</span>  <span class="c1"># the scores the model needs, for the query at the last position
</span><span class="n">absorbed_scores</span> <span class="o">=</span> <span class="n">latents</span> <span class="o">@</span> <span class="p">(</span><span class="n">w_uk</span><span class="p">.</span><span class="n">T</span> <span class="o">@</span> <span class="n">q_rot</span><span class="p">)</span>  <span class="c1"># absorb W_UK as if no rotation sat between
</span><span class="n">without_rope</span> <span class="o">=</span> <span class="n">latents</span> <span class="o">@</span> <span class="p">(</span><span class="n">w_uk</span><span class="p">.</span><span class="n">T</span> <span class="o">@</span> <span class="n">query</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span>
    <span class="sh">"</span><span class="s">scores with rotated keys vs absorbed:  max difference</span><span class="sh">"</span><span class="p">,</span>
    <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="n">honest</span> <span class="o">-</span> <span class="n">absorbed_scores</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span>
<span class="p">)</span>
<span class="nf">print</span><span class="p">(</span>
    <span class="sh">"</span><span class="s">the same without RoPE:                  max difference</span><span class="sh">"</span><span class="p">,</span>
    <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">((</span><span class="n">latents</span> <span class="o">@</span> <span class="n">w_uk</span><span class="p">.</span><span class="n">T</span><span class="p">)</span> <span class="o">@</span> <span class="n">query</span> <span class="o">-</span> <span class="n">without_rope</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span>
<span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>scores with rotated keys vs absorbed:  max difference 15.72
the same without RoPE:                  max difference 3.34e-06</code></pre> <p>Absorbing past rotated keys gives scores that have nothing to do with the right ones, while without the rotation the absorbed scores are exact. That is the whole reason for the decoupled design: the rotary part is small, shared by all heads and cached as is, and the large compressed part never rotates, so it can be absorbed.</p> <h2 id="4-minicpm3-in-pytorch">4. MiniCPM3 in PyTorch</h2> <p>DeepSeek’s own latent-attention models are too large for a T4: even DeepSeek-V2-Lite needs, in its card’s words, “40GB*1 GPU” for inference in 16-bit floats.</p> <p>MiniCPM3-4B from OpenBMB uses the same layout, DeepSeek-V2’s names and all, at a size that fits: 62 layers, 40 heads, a latent of 256 numbers and a rotary key of 32. Its weights come under the MiniCPM model licence, free for research. Its config:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">REPO</span> <span class="o">=</span> <span class="sh">"</span><span class="s">openbmb/MiniCPM3-4B</span><span class="sh">"</span>
<span class="n">mini_config</span> <span class="o">=</span> <span class="n">configs</span><span class="p">[</span><span class="sh">"</span><span class="s">MiniCPM3 4B</span><span class="sh">"</span><span class="p">]</span>
<span class="k">for</span> <span class="n">key</span> <span class="ow">in</span> <span class="p">[</span>
    <span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">kv_lora_rank</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">q_lora_rank</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">qk_nope_head_dim</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">qk_rope_head_dim</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">scale_emb</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">scale_depth</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">dim_model_base</span><span class="sh">"</span><span class="p">,</span>
<span class="p">]:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">key</span><span class="si">:</span><span class="mi">20</span><span class="si">}</span><span class="s"> </span><span class="si">{</span><span class="n">mini_config</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="n">key</span><span class="p">)</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>hidden_size          2560
num_hidden_layers    62
num_attention_heads  40
kv_lora_rank         256
q_lora_rank          768
qk_nope_head_dim     64
qk_rope_head_dim     32
intermediate_size    6400
vocab_size           73448
scale_emb            12
scale_depth          1.4
dim_model_base       256</code></pre> <p>Three numbers in it are MiniCPM’s own, from the “tensor programs” way of setting up training: the embeddings are multiplied by <code class="language-plaintext highlighter-rouge">scale_emb</code>, each residual branch by <code class="language-plaintext highlighter-rouge">scale_depth</code> over the square root of the number of layers, and the last hidden state is divided by <code class="language-plaintext highlighter-rouge">hidden_size / dim_model_base</code> before the output layer.</p> <p>The rotary positions use per-frequency stretch factors, <code class="language-plaintext highlighter-rouge">short_factor</code>, that the config lists. Everything else is the decoder of lesson 6 with the attention above.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">FeedForward</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span><span class="p">,</span> <span class="n">hidden</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">gate_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">hidden</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">up_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">hidden</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">down_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">hidden</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">down_proj</span><span class="p">(</span><span class="n">F</span><span class="p">.</span><span class="nf">silu</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">gate_proj</span><span class="p">(</span><span class="n">x</span><span class="p">))</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="nf">up_proj</span><span class="p">(</span><span class="n">x</span><span class="p">))</span>


<span class="k">class</span> <span class="nc">Block</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">eps</span> <span class="o">=</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">rms_norm_eps</span><span class="sh">"</span><span class="p">,</span> <span class="mf">1e-5</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">input_layernorm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">eps</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">self_attn</span> <span class="o">=</span> <span class="nc">MLA</span><span class="p">(</span><span class="n">c</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">post_attention_layernorm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">eps</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">mlp</span> <span class="o">=</span> <span class="nc">FeedForward</span><span class="p">(</span><span class="n">c</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">residual_scale</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">scale_depth</span><span class="sh">"</span><span class="p">]</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">])</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">cache</span><span class="o">=</span><span class="bp">None</span><span class="p">,</span> <span class="n">absorb</span><span class="o">=</span><span class="bp">False</span><span class="p">):</span>
        <span class="n">h</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">self_attn</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">input_layernorm</span><span class="p">(</span><span class="n">x</span><span class="p">),</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">cache</span><span class="p">,</span> <span class="n">absorb</span><span class="p">)</span>
        <span class="n">x</span> <span class="o">=</span> <span class="p">(</span>
            <span class="n">x</span> <span class="o">+</span> <span class="n">h</span><span class="p">.</span><span class="nf">float</span><span class="p">()</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">residual_scale</span>
        <span class="p">)</span>  <span class="c1"># the residual stream stays in 32-bit floats
</span>        <span class="k">return</span> <span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">mlp</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">post_attention_layernorm</span><span class="p">(</span><span class="n">x</span><span class="p">)).</span><span class="nf">float</span><span class="p">()</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">residual_scale</span>


<span class="k">class</span> <span class="nc">MiniCPM3</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">config</span> <span class="o">=</span> <span class="n">c</span>
        <span class="n">self</span><span class="p">.</span><span class="n">embed_tokens</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">layers</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">ModuleList</span><span class="p">([</span><span class="nc">Block</span><span class="p">(</span><span class="n">c</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">])])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">rms_norm_eps</span><span class="sh">"</span><span class="p">,</span> <span class="mf">1e-5</span><span class="p">))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">lm_head</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">scaling</span> <span class="o">=</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">rope_scaling</span><span class="sh">"</span><span class="p">)</span> <span class="ow">or</span> <span class="p">{}</span>
        <span class="n">self</span><span class="p">.</span><span class="n">factors</span> <span class="o">=</span> <span class="n">scaling</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">short_factor</span><span class="sh">"</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">theta</span> <span class="o">=</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">rope_theta</span><span class="sh">"</span><span class="p">,</span> <span class="mf">10000.0</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">hidden</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">caches</span><span class="o">=</span><span class="bp">None</span><span class="p">,</span> <span class="n">start</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span> <span class="n">absorb</span><span class="o">=</span><span class="bp">False</span><span class="p">):</span>
        <span class="n">positions</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">start</span><span class="p">,</span> <span class="n">start</span> <span class="o">+</span> <span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="n">device</span><span class="o">=</span><span class="n">ids</span><span class="p">.</span><span class="n">device</span><span class="p">)[</span><span class="bp">None</span><span class="p">]</span>
        <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span> <span class="o">=</span> <span class="nf">rope_tables</span><span class="p">(</span>
            <span class="n">positions</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">qk_rope_head_dim</span><span class="sh">"</span><span class="p">],</span> <span class="n">self</span><span class="p">.</span><span class="n">theta</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">factors</span>
        <span class="p">)</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">embed_tokens</span><span class="p">(</span><span class="n">ids</span><span class="p">).</span><span class="nf">float</span><span class="p">()</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">scale_emb</span><span class="sh">"</span><span class="p">]</span>
        <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">layer</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">layers</span><span class="p">):</span>
            <span class="n">cache</span> <span class="o">=</span> <span class="n">caches</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="k">if</span> <span class="n">caches</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span> <span class="k">else</span> <span class="bp">None</span>
            <span class="n">x</span> <span class="o">=</span> <span class="nf">layer</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">cache</span><span class="p">,</span> <span class="n">absorb</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">logits</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">h</span><span class="p">):</span>
        <span class="n">c</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">config</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">lm_head</span><span class="p">(</span><span class="n">h</span> <span class="o">/</span> <span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">]</span> <span class="o">/</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">dim_model_base</span><span class="sh">"</span><span class="p">])).</span><span class="nf">float</span><span class="p">()</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">caches</span><span class="o">=</span><span class="bp">None</span><span class="p">,</span> <span class="n">start</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span> <span class="n">absorb</span><span class="o">=</span><span class="bp">False</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">logits</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">hidden</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">caches</span><span class="p">,</span> <span class="n">start</span><span class="p">,</span> <span class="n">absorb</span><span class="p">))</span>


<span class="k">def</span> <span class="nf">load_minicpm3</span><span class="p">(</span><span class="n">source</span><span class="p">,</span> <span class="n">c</span><span class="p">,</span> <span class="n">dtype</span><span class="p">):</span>
    <span class="k">if</span> <span class="nc">Path</span><span class="p">(</span><span class="n">source</span><span class="p">).</span><span class="nf">is_dir</span><span class="p">():</span>  <span class="c1"># the smoke run's small model, saved to disk
</span>        <span class="n">state</span> <span class="o">=</span> <span class="nf">load_file</span><span class="p">(</span><span class="nf">str</span><span class="p">(</span><span class="nf">next</span><span class="p">(</span><span class="nc">Path</span><span class="p">(</span><span class="n">source</span><span class="p">).</span><span class="nf">glob</span><span class="p">(</span><span class="sh">"</span><span class="s">*.safetensors</span><span class="sh">"</span><span class="p">))))</span>
    <span class="k">else</span><span class="p">:</span>
        <span class="n">path</span> <span class="o">=</span> <span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">source</span><span class="p">,</span> <span class="sh">"</span><span class="s">pytorch_model.bin</span><span class="sh">"</span><span class="p">)</span>
        <span class="n">state</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">path</span><span class="p">,</span> <span class="n">map_location</span><span class="o">=</span><span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span><span class="p">,</span> <span class="n">weights_only</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">mmap</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">state</span> <span class="o">=</span> <span class="p">{</span><span class="n">k</span><span class="p">.</span><span class="nf">removeprefix</span><span class="p">(</span><span class="sh">"</span><span class="s">model.</span><span class="sh">"</span><span class="p">):</span> <span class="n">v</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">dtype</span><span class="p">)</span> <span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="ow">in</span> <span class="n">state</span><span class="p">.</span><span class="nf">items</span><span class="p">()}</span>
    <span class="n">state</span><span class="p">.</span><span class="nf">setdefault</span><span class="p">(</span>
        <span class="sh">"</span><span class="s">lm_head.weight</span><span class="sh">"</span><span class="p">,</span> <span class="n">state</span><span class="p">[</span><span class="sh">"</span><span class="s">embed_tokens.weight</span><span class="sh">"</span><span class="p">]</span>
    <span class="p">)</span>  <span class="c1"># tied when it isn't stored
</span>    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">device</span><span class="p">(</span><span class="sh">"</span><span class="s">meta</span><span class="sh">"</span><span class="p">):</span>
        <span class="n">model</span> <span class="o">=</span> <span class="nc">MiniCPM3</span><span class="p">(</span><span class="n">c</span><span class="p">)</span>
    <span class="n">model</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">(</span><span class="n">state</span><span class="p">,</span> <span class="n">strict</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">assign</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">model</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
</code></pre></div></div> <p>The check: our model and Hugging Face’s on the same tokens. As in <a href="/blog/2026/transformer-architectures-07-moe/">lesson 7</a>, the reference runs first in a process of its own, so that the two copies are never in memory together.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">tok</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">REPO</span><span class="p">)</span>
<span class="n">text</span> <span class="o">=</span> <span class="p">(</span>
    <span class="sh">"</span><span class="s">The Rhine rises in the Swiss Alps, flows through Lake Constance and along </span><span class="sh">"</span>
    <span class="sh">"</span><span class="s">the French–German border, and reaches the North Sea through a delta in the </span><span class="sh">"</span>
    <span class="sh">"</span><span class="s">Netherlands.</span><span class="sh">"</span>
<span class="p">)</span>
<span class="n">check_ids</span> <span class="o">=</span> <span class="nf">tok</span><span class="p">(</span><span class="n">text</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="n">input_ids</span>
<span class="n">torch</span><span class="p">.</span><span class="nf">save</span><span class="p">(</span><span class="n">check_ids</span><span class="p">,</span> <span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">check_ids.pt</span><span class="sh">"</span><span class="p">)</span>

<span class="k">if</span> <span class="n">SMOKE</span><span class="p">:</span>  <span class="c1"># a small MiniCPM3 with random weights stands in for the real one
</span>    <span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">MiniCPM3Config</span><span class="p">,</span> <span class="n">MiniCPM3ForCausalLM</span>

    <span class="n">small_config</span> <span class="o">=</span> <span class="nc">MiniCPM3Config</span><span class="p">(</span>
        <span class="n">vocab_size</span><span class="o">=</span><span class="n">mini_config</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span>
        <span class="n">hidden_size</span><span class="o">=</span><span class="mi">128</span><span class="p">,</span>
        <span class="n">intermediate_size</span><span class="o">=</span><span class="mi">256</span><span class="p">,</span>
        <span class="n">num_hidden_layers</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span>
        <span class="n">num_attention_heads</span><span class="o">=</span><span class="mi">4</span><span class="p">,</span>
        <span class="n">num_key_value_heads</span><span class="o">=</span><span class="mi">4</span><span class="p">,</span>
        <span class="n">kv_lora_rank</span><span class="o">=</span><span class="mi">32</span><span class="p">,</span>
        <span class="n">q_lora_rank</span><span class="o">=</span><span class="mi">48</span><span class="p">,</span>
        <span class="n">qk_nope_head_dim</span><span class="o">=</span><span class="mi">16</span><span class="p">,</span>
        <span class="n">qk_rope_head_dim</span><span class="o">=</span><span class="mi">8</span><span class="p">,</span>
        <span class="n">scale_emb</span><span class="o">=</span><span class="mi">12</span><span class="p">,</span>
        <span class="n">scale_depth</span><span class="o">=</span><span class="mf">1.4</span><span class="p">,</span>
        <span class="n">dim_model_base</span><span class="o">=</span><span class="mi">32</span><span class="p">,</span>
        <span class="n">tie_word_embeddings</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
    <span class="p">)</span>
    <span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="mi">0</span><span class="p">)</span>
    <span class="n">reference</span> <span class="o">=</span> <span class="nc">MiniCPM3ForCausalLM</span><span class="p">(</span><span class="n">small_config</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
    <span class="n">SOURCE</span> <span class="o">=</span> <span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">minicpm3-small</span><span class="sh">"</span>
    <span class="n">reference</span><span class="p">.</span><span class="nf">save_pretrained</span><span class="p">(</span><span class="n">SOURCE</span><span class="p">)</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="n">theirs</span> <span class="o">=</span> <span class="nf">reference</span><span class="p">(</span><span class="n">check_ids</span><span class="p">).</span><span class="n">logits</span><span class="p">.</span><span class="nf">float</span><span class="p">()</span>
    <span class="n">mini_config</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">loads</span><span class="p">((</span><span class="n">SOURCE</span> <span class="o">/</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">).</span><span class="nf">read_text</span><span class="p">())</span>
    <span class="n">mini_config</span><span class="p">.</span><span class="nf">pop</span><span class="p">(</span><span class="sh">"</span><span class="s">rope_scaling</span><span class="sh">"</span><span class="p">,</span> <span class="bp">None</span><span class="p">)</span>
<span class="k">else</span><span class="p">:</span>
    <span class="n">SOURCE</span> <span class="o">=</span> <span class="n">REPO</span>
    <span class="n">script</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"""</span><span class="s">
import torch
from transformers import AutoConfig, AutoModelForCausalLM
config = AutoConfig.from_pretrained(</span><span class="sh">"</span><span class="si">{</span><span class="n">REPO</span><span class="si">}</span><span class="sh">"</span><span class="s">)
# the library</span><span class="sh">'</span><span class="s">s RoPE wants a stretch factor the config omits; 32k of 32k is 1
config.rope_parameters[</span><span class="sh">"</span><span class="s">factor</span><span class="sh">"</span><span class="s">] = 1.0
model = AutoModelForCausalLM.from_pretrained(</span><span class="sh">"</span><span class="si">{</span><span class="n">REPO</span><span class="si">}</span><span class="sh">"</span><span class="s">, config=config, dtype=torch.float16)
model = model.to(</span><span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="s">).eval()
ids = torch.load(</span><span class="sh">"</span><span class="si">{</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">check_ids.pt</span><span class="sh">"</span><span class="si">}</span><span class="sh">"</span><span class="s">).to(</span><span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="s">)
with torch.no_grad():
    torch.save(model(ids).logits.float().cpu(), </span><span class="sh">"</span><span class="si">{</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">theirs.pt</span><span class="sh">"</span><span class="si">}</span><span class="sh">"</span><span class="s">)
</span><span class="sh">"""</span>
    <span class="n">subprocess</span><span class="p">.</span><span class="nf">run</span><span class="p">([</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">-c</span><span class="sh">"</span><span class="p">,</span> <span class="n">script</span><span class="p">],</span> <span class="n">check</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">theirs</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">theirs.pt</span><span class="sh">"</span><span class="p">)</span>

<span class="n">model</span> <span class="o">=</span> <span class="nf">load_minicpm3</span><span class="p">(</span><span class="n">SOURCE</span><span class="p">,</span> <span class="n">mini_config</span><span class="p">,</span> <span class="n">HALF</span><span class="p">)</span>
<span class="n">t</span> <span class="o">=</span> <span class="n">check_ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>
<span class="n">causal</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">t</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">).</span><span class="nf">tril</span><span class="p">()</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">ours</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">check_ids</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">),</span> <span class="n">causal</span><span class="p">).</span><span class="nf">cpu</span><span class="p">()</span>
    <span class="n">ours_absorbed</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">check_ids</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">),</span> <span class="n">causal</span><span class="p">,</span> <span class="n">absorb</span><span class="o">=</span><span class="bp">True</span><span class="p">).</span><span class="nf">cpu</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">tokens:</span><span class="sh">"</span><span class="p">,</span> <span class="n">t</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">largest logit:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">theirs</span><span class="p">.</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span>
    <span class="sh">"</span><span class="s">max difference, keys and values rebuilt:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="n">ours</span> <span class="o">-</span> <span class="n">theirs</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span>
<span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">max difference, absorbed:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="n">ours_absorbed</span> <span class="o">-</span> <span class="n">theirs</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>tokens: 36
largest logit: 30.34
max difference, keys and values rebuilt: 8.59e-02
max difference, absorbed: 1.07e-01</code></pre> <p>Both forms of our model agree with Hugging Face’s within the rounding of 16-bit floats over 62 layers; in 32-bit floats, on the small random model this notebook’s smoke test uses, the difference is a few millionths. The weights load into our classes unchanged: MiniCPM3 is DeepSeek-V2’s attention with smaller numbers.</p> <p>Generation is <a href="/blog/2026/transformer-architectures-04-gpt/">lesson 4</a>’s loop with a cache per layer. <code class="language-plaintext highlighter-rouge">generate</code> takes the kind of cache and whether to absorb, so the same weights can run with a latent cache and absorption, as DeepSeek serves its models, or with a cache of rebuilt keys and values, the way the code published with MiniCPM3 runs it.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">generate</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">steps</span><span class="p">,</span> <span class="n">cache_kind</span><span class="o">=</span><span class="n">LatentCache</span><span class="p">,</span> <span class="n">absorb</span><span class="o">=</span><span class="bp">True</span><span class="p">):</span>
    <span class="n">caches</span> <span class="o">=</span> <span class="p">[</span><span class="nf">cache_kind</span><span class="p">()</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="n">layers</span><span class="p">]</span>
    <span class="n">t</span> <span class="o">=</span> <span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>
    <span class="n">mask</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">t</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">).</span><span class="nf">tril</span><span class="p">()</span>
    <span class="n">logits</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">caches</span><span class="p">,</span> <span class="n">absorb</span><span class="o">=</span><span class="n">absorb</span> <span class="ow">and</span> <span class="n">cache_kind</span> <span class="ow">is</span> <span class="n">LatentCache</span><span class="p">)</span>
    <span class="n">out</span> <span class="o">=</span> <span class="p">[</span><span class="n">logits</span><span class="p">[:,</span> <span class="o">-</span><span class="mi">1</span><span class="p">].</span><span class="nf">argmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)]</span>
    <span class="k">for</span> <span class="n">step</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">steps</span> <span class="o">-</span> <span class="mi">1</span><span class="p">):</span>
        <span class="n">mask</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">t</span> <span class="o">+</span> <span class="n">step</span> <span class="o">+</span> <span class="mi">1</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
        <span class="n">logits</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span>
            <span class="n">out</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">][:,</span> <span class="bp">None</span><span class="p">],</span>
            <span class="n">mask</span><span class="p">,</span>
            <span class="n">caches</span><span class="p">,</span>
            <span class="n">start</span><span class="o">=</span><span class="n">t</span> <span class="o">+</span> <span class="n">step</span><span class="p">,</span>
            <span class="n">absorb</span><span class="o">=</span><span class="n">absorb</span> <span class="ow">and</span> <span class="n">cache_kind</span> <span class="ow">is</span> <span class="n">LatentCache</span><span class="p">,</span>
        <span class="p">)</span>
        <span class="n">out</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">logits</span><span class="p">[:,</span> <span class="o">-</span><span class="mi">1</span><span class="p">].</span><span class="nf">argmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">))</span>
    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">(</span><span class="n">out</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">),</span> <span class="n">caches</span>


<span class="n">messages</span> <span class="o">=</span> <span class="p">[{</span><span class="sh">"</span><span class="s">role</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">user</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">content</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">Explain in two sentences why the sky is blue.</span><span class="sh">"</span><span class="p">}]</span>
<span class="n">prompt</span> <span class="o">=</span> <span class="n">tok</span><span class="p">.</span><span class="nf">apply_chat_template</span><span class="p">(</span><span class="n">messages</span><span class="p">,</span> <span class="n">tokenize</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">add_generation_prompt</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">ids</span> <span class="o">=</span> <span class="nf">tok</span><span class="p">(</span><span class="n">prompt</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">,</span> <span class="n">add_special_tokens</span><span class="o">=</span><span class="bp">False</span><span class="p">).</span><span class="n">input_ids</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="n">written</span><span class="p">,</span> <span class="n">caches</span> <span class="o">=</span> <span class="nf">generate</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="mi">12</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">80</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="n">tok</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="n">written</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="n">skip_special_tokens</span><span class="o">=</span><span class="bp">True</span><span class="p">))</span>
<span class="n">cached</span> <span class="o">=</span> <span class="nf">sum</span><span class="p">(</span><span class="n">c</span><span class="p">.</span><span class="nf">bytes</span><span class="p">()</span> <span class="k">for</span> <span class="n">c</span> <span class="ow">in</span> <span class="n">caches</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">cache: </span><span class="si">{</span><span class="n">cached</span> <span class="o">/</span> <span class="mi">1024</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> KiB for </span><span class="si">{</span><span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span> <span class="o">+</span> <span class="n">written</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span> <span class="o">-</span> <span class="mi">1</span><span class="si">}</span><span class="s"> tokens</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>The sky appears blue because the Earth's atmosphere scatters sunlight in all directions. Blue light is scattered more than other colors because it travels as shorter, smaller waves.
cache: 3453 KiB for 99 tokens</code></pre> <h2 id="5-the-budget-on-a-t4">5. The budget on a T4</h2> <p>The table of section 1 is arithmetic. Here is the measurement: one long document read into MiniCPM3 in chunks of a thousand tokens, with each kind of cache, until the GPU runs out of memory.</p> <p>Each chunk attends to everything before it; with the latent cache the keys and values of one layer are rebuilt for the chunk and thrown away, so only the latents stay.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">long_document</span><span class="p">(</span><span class="n">n_tokens</span><span class="p">):</span>
    <span class="n">name</span> <span class="o">=</span> <span class="sh">"</span><span class="s">wikitext-103-raw-v1/test-00000-of-00001.parquet</span><span class="sh">"</span>
    <span class="n">path</span> <span class="o">=</span> <span class="nf">hf_hub_download</span><span class="p">(</span><span class="sh">"</span><span class="s">Salesforce/wikitext</span><span class="sh">"</span><span class="p">,</span> <span class="n">name</span><span class="p">,</span> <span class="n">repo_type</span><span class="o">=</span><span class="sh">"</span><span class="s">dataset</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">ids</span> <span class="o">=</span> <span class="nf">tok</span><span class="p">(</span><span class="sh">""</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nf">read_parquet</span><span class="p">(</span><span class="n">path</span><span class="p">)[</span><span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">].</span><span class="nf">tolist</span><span class="p">())[:</span> <span class="n">n_tokens</span> <span class="o">*</span> <span class="mi">8</span><span class="p">]).</span><span class="n">input_ids</span><span class="p">[</span>
        <span class="p">:</span><span class="n">n_tokens</span>
    <span class="p">]</span>
    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">ids</span><span class="p">)[</span><span class="bp">None</span><span class="p">]</span>


<span class="n">CHUNK</span> <span class="o">=</span> <span class="mi">64</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">1024</span>
<span class="n">LIMIT</span> <span class="o">=</span> <span class="mi">512</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">32768</span>
<span class="n">document</span> <span class="o">=</span> <span class="nf">long_document</span><span class="p">(</span><span class="n">LIMIT</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>


<span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">read_until_full</span><span class="p">(</span><span class="n">cache_kind</span><span class="p">):</span>
    <span class="n">caches</span> <span class="o">=</span> <span class="p">[</span><span class="nf">cache_kind</span><span class="p">()</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="n">layers</span><span class="p">]</span>
    <span class="n">reached</span><span class="p">,</span> <span class="n">kept</span> <span class="o">=</span> <span class="mi">0</span><span class="p">,</span> <span class="p">[]</span>
    <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">empty_cache</span><span class="p">()</span> <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">else</span> <span class="bp">None</span>
    <span class="k">try</span><span class="p">:</span>
        <span class="k">for</span> <span class="n">start</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">document</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="n">CHUNK</span><span class="p">):</span>
            <span class="n">chunk</span> <span class="o">=</span> <span class="n">document</span><span class="p">[:,</span> <span class="n">start</span> <span class="p">:</span> <span class="n">start</span> <span class="o">+</span> <span class="n">CHUNK</span><span class="p">]</span>
            <span class="n">n</span> <span class="o">=</span> <span class="n">chunk</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>
            <span class="n">mask</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="n">start</span> <span class="o">+</span> <span class="n">n</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">).</span><span class="nf">tril</span><span class="p">(</span>
                <span class="n">diagonal</span><span class="o">=</span><span class="n">start</span>
            <span class="p">)</span>
            <span class="n">model</span><span class="p">.</span><span class="nf">hidden</span><span class="p">(</span><span class="n">chunk</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">caches</span><span class="p">,</span> <span class="n">start</span><span class="o">=</span><span class="n">start</span><span class="p">)</span>
            <span class="n">reached</span> <span class="o">=</span> <span class="n">start</span> <span class="o">+</span> <span class="n">n</span>
            <span class="n">kept</span><span class="p">.</span><span class="nf">append</span><span class="p">((</span><span class="n">reached</span><span class="p">,</span> <span class="nf">sum</span><span class="p">(</span><span class="n">c</span><span class="p">.</span><span class="nf">bytes</span><span class="p">()</span> <span class="k">for</span> <span class="n">c</span> <span class="ow">in</span> <span class="n">caches</span><span class="p">)))</span>
    <span class="k">except</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="n">OutOfMemoryError</span><span class="p">:</span>
        <span class="k">pass</span>
    <span class="k">del</span> <span class="n">caches</span>
    <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">empty_cache</span><span class="p">()</span> <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">else</span> <span class="bp">None</span>
    <span class="k">return</span> <span class="n">reached</span><span class="p">,</span> <span class="n">kept</span>


<span class="n">capacity</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">kind</span> <span class="ow">in</span> <span class="p">[</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">latent cache</span><span class="sh">"</span><span class="p">,</span> <span class="n">LatentCache</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">rebuilt keys and values</span><span class="sh">"</span><span class="p">,</span> <span class="n">ExpandedCache</span><span class="p">),</span>
<span class="p">]:</span>
    <span class="n">reached</span><span class="p">,</span> <span class="n">kept</span> <span class="o">=</span> <span class="nf">read_until_full</span><span class="p">(</span><span class="n">kind</span><span class="p">)</span>
    <span class="n">capacity</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="o">=</span> <span class="n">kept</span>
    <span class="nf">print</span><span class="p">(</span>
        <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">name</span><span class="si">:</span><span class="mi">26</span><span class="si">}</span><span class="s"> read </span><span class="si">{</span><span class="n">reached</span><span class="si">:</span><span class="mi">6</span><span class="p">,</span><span class="si">}</span><span class="s"> tokens before running out</span><span class="sh">"</span>
        <span class="k">if</span> <span class="n">reached</span> <span class="o">&lt;</span> <span class="n">LIMIT</span>
        <span class="k">else</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">name</span><span class="si">:</span><span class="mi">26</span><span class="si">}</span><span class="s"> read all </span><span class="si">{</span><span class="n">reached</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> tokens</span><span class="sh">"</span>
    <span class="p">)</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">7.4</span><span class="p">,</span> <span class="mf">3.6</span><span class="p">))</span>
<span class="nf">for </span><span class="p">(</span><span class="n">name</span><span class="p">,</span> <span class="n">kept</span><span class="p">),</span> <span class="n">color</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">capacity</span><span class="p">.</span><span class="nf">items</span><span class="p">(),</span> <span class="p">[</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">]]):</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span>
        <span class="p">[</span><span class="n">k</span> <span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">kept</span><span class="p">],</span>
        <span class="p">[</span><span class="n">b</span> <span class="o">/</span> <span class="mf">1e9</span> <span class="k">for</span> <span class="n">_</span><span class="p">,</span> <span class="n">b</span> <span class="ow">in</span> <span class="n">kept</span><span class="p">],</span>
        <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span>
        <span class="n">label</span><span class="o">=</span><span class="n">name</span><span class="p">,</span>
        <span class="n">linewidth</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span>
    <span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">tokens read</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">cache, GB</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">MiniCPM3-4B on one T4, one document read in chunks</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <pre class="tfs-printed"><code>latent cache               read all 32,768 tokens
rebuilt keys and values    read  7,168 tokens before running out</code></pre> <p><img class="tfs-output" src="/assets/posts/arch/08/output-01.png" alt="MiniCPM3-4B on one T4, one document read in chunks" loading="lazy"></p> <p>The latent cache read the whole document, all 32,768 tokens, with a cache of about a gigabyte. The cache of rebuilt keys and values ran out of memory a little past a fifth of it.</p> <p>The model is the same and so are the weights; only what we chose to keep differs. And the second curve is not a strawman: the code that was published with MiniCPM3, and vLLM’s implementation of it, both cache rebuilt keys and values.</p> <p>Memory is half the story; the other half is time. With the latent cache, every new token either rebuilds the keys and values of the whole context in every layer, or absorbs and works in the latent space, where each head’s score is a dot product over the 256 + 32 numbers of the latent instead of the 64 + 32 of a key.</p> <p>We time one step of generation at several context lengths, three ways.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">step_time</span><span class="p">(</span><span class="n">context</span><span class="p">,</span> <span class="n">cache_kind</span><span class="p">,</span> <span class="n">absorb</span><span class="p">,</span> <span class="n">repeats</span><span class="o">=</span><span class="mi">5</span><span class="p">):</span>
    <span class="sh">"""</span><span class="s">Median time of one new token after `context` tokens; NaN if the cache doesn</span><span class="sh">'</span><span class="s">t fit.</span><span class="sh">"""</span>
    <span class="n">caches</span> <span class="o">=</span> <span class="p">[</span><span class="nf">cache_kind</span><span class="p">()</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="n">layers</span><span class="p">]</span>
    <span class="k">try</span><span class="p">:</span>
        <span class="k">for</span> <span class="n">start</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">context</span><span class="p">,</span> <span class="n">CHUNK</span><span class="p">):</span>
            <span class="n">chunk</span> <span class="o">=</span> <span class="n">document</span><span class="p">[:,</span> <span class="n">start</span> <span class="p">:</span> <span class="nf">min</span><span class="p">(</span><span class="n">start</span> <span class="o">+</span> <span class="n">CHUNK</span><span class="p">,</span> <span class="n">context</span><span class="p">)]</span>
            <span class="n">n</span> <span class="o">=</span> <span class="n">chunk</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>
            <span class="n">mask</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="n">start</span> <span class="o">+</span> <span class="n">n</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">).</span><span class="nf">tril</span><span class="p">(</span>
                <span class="n">diagonal</span><span class="o">=</span><span class="n">start</span>
            <span class="p">)</span>
            <span class="n">model</span><span class="p">.</span><span class="nf">hidden</span><span class="p">(</span><span class="n">chunk</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">caches</span><span class="p">,</span> <span class="n">start</span><span class="o">=</span><span class="n">start</span><span class="p">)</span>
        <span class="n">token</span> <span class="o">=</span> <span class="n">document</span><span class="p">[:,</span> <span class="n">context</span> <span class="p">:</span> <span class="n">context</span> <span class="o">+</span> <span class="mi">1</span><span class="p">]</span>
        <span class="n">mask</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">context</span> <span class="o">+</span> <span class="mi">1</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
        <span class="n">timings</span> <span class="o">=</span> <span class="p">[]</span>
        <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">repeats</span><span class="p">):</span>
            <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
                <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">synchronize</span><span class="p">()</span>
            <span class="n">begin</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
            <span class="n">model</span><span class="p">.</span><span class="nf">hidden</span><span class="p">(</span><span class="n">token</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">caches</span><span class="p">,</span> <span class="n">start</span><span class="o">=</span><span class="n">context</span><span class="p">,</span> <span class="n">absorb</span><span class="o">=</span><span class="n">absorb</span><span class="p">)</span>
            <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
                <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">synchronize</span><span class="p">()</span>
            <span class="n">timings</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">begin</span><span class="p">)</span>
            <span class="nf">for </span><span class="p">(</span>
                <span class="n">cache</span>
            <span class="p">)</span> <span class="ow">in</span> <span class="n">caches</span><span class="p">:</span>  <span class="c1"># take the step back out, so every repeat sees the same context
</span>                <span class="k">if</span> <span class="nf">isinstance</span><span class="p">(</span><span class="n">cache</span><span class="p">,</span> <span class="n">LatentCache</span><span class="p">):</span>
                    <span class="n">cache</span><span class="p">.</span><span class="n">c</span><span class="p">,</span> <span class="n">cache</span><span class="p">.</span><span class="n">k_rope</span> <span class="o">=</span> <span class="n">cache</span><span class="p">.</span><span class="n">c</span><span class="p">[:,</span> <span class="p">:</span><span class="o">-</span><span class="mi">1</span><span class="p">],</span> <span class="n">cache</span><span class="p">.</span><span class="n">k_rope</span><span class="p">[:,</span> <span class="p">:,</span> <span class="p">:</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
                <span class="k">else</span><span class="p">:</span>
                    <span class="n">cache</span><span class="p">.</span><span class="n">k</span><span class="p">,</span> <span class="n">cache</span><span class="p">.</span><span class="n">v</span> <span class="o">=</span> <span class="n">cache</span><span class="p">.</span><span class="n">k</span><span class="p">[:,</span> <span class="p">:,</span> <span class="p">:</span><span class="o">-</span><span class="mi">1</span><span class="p">],</span> <span class="n">cache</span><span class="p">.</span><span class="n">v</span><span class="p">[:,</span> <span class="p">:,</span> <span class="p">:</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
        <span class="k">return</span> <span class="nf">float</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">median</span><span class="p">(</span><span class="n">timings</span><span class="p">))</span>
    <span class="k">except</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="n">OutOfMemoryError</span><span class="p">:</span>
        <span class="k">return</span> <span class="nf">float</span><span class="p">(</span><span class="sh">"</span><span class="s">nan</span><span class="sh">"</span><span class="p">)</span>
    <span class="k">finally</span><span class="p">:</span>
        <span class="k">del</span> <span class="n">caches</span>
        <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
            <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">empty_cache</span><span class="p">()</span>


<span class="n">contexts</span> <span class="o">=</span> <span class="p">[</span><span class="mi">128</span><span class="p">,</span> <span class="mi">256</span><span class="p">]</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="p">[</span><span class="mi">1024</span><span class="p">,</span> <span class="mi">2048</span><span class="p">,</span> <span class="mi">4096</span><span class="p">,</span> <span class="mi">8192</span><span class="p">]</span>
<span class="n">ways</span> <span class="o">=</span> <span class="p">[</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">latent cache, rebuilt each step</span><span class="sh">"</span><span class="p">,</span> <span class="n">LatentCache</span><span class="p">,</span> <span class="bp">False</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">latent cache, absorbed</span><span class="sh">"</span><span class="p">,</span> <span class="n">LatentCache</span><span class="p">,</span> <span class="bp">True</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">rebuilt keys and values cached</span><span class="sh">"</span><span class="p">,</span> <span class="n">ExpandedCache</span><span class="p">,</span> <span class="bp">False</span><span class="p">),</span>
<span class="p">]</span>
<span class="n">speed</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">context</span> <span class="ow">in</span> <span class="n">contexts</span><span class="p">:</span>
    <span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">kind</span><span class="p">,</span> <span class="n">absorb</span> <span class="ow">in</span> <span class="n">ways</span><span class="p">:</span>
        <span class="n">speed</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
            <span class="p">{</span>
                <span class="sh">"</span><span class="s">context</span><span class="sh">"</span><span class="p">:</span> <span class="n">context</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">way</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">ms per token</span><span class="sh">"</span><span class="p">:</span> <span class="mi">1000</span> <span class="o">*</span> <span class="nf">step_time</span><span class="p">(</span><span class="n">context</span><span class="p">,</span> <span class="n">kind</span><span class="p">,</span> <span class="n">absorb</span><span class="p">),</span>
            <span class="p">}</span>
        <span class="p">)</span>
<span class="n">speed</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">speed</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span>
    <span class="n">speed</span><span class="p">.</span><span class="nf">pivot</span><span class="p">(</span><span class="n">index</span><span class="o">=</span><span class="sh">"</span><span class="s">way</span><span class="sh">"</span><span class="p">,</span> <span class="n">columns</span><span class="o">=</span><span class="sh">"</span><span class="s">context</span><span class="sh">"</span><span class="p">,</span> <span class="n">values</span><span class="o">=</span><span class="sh">"</span><span class="s">ms per token</span><span class="sh">"</span><span class="p">).</span><span class="nf">reset_index</span><span class="p">(),</span>
    <span class="n">digits</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span>
<span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">way</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">1024</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">2048</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">4096</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">8192</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">latent cache, absorbed</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">120.3</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">120.4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">117.4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128.5</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">latent cache, rebuilt each step</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">106.7</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">104.6</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">142.1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">261.8</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">rebuilt keys and values cached</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">104.2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">99.3</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">125.6</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">nan</td></tr></tbody></table></div> <p>Three different behaviours. With absorption, a new token costs the same at every context length here: the time goes into the rest of the model, reading 8 GB of weights and running 62 layers, and the scores against a few thousand latents are cheap next to that.</p> <p>Rebuilding the keys and values at every step costs more and more as the context grows, because it rebuilds all of them, every time. Caching rebuilt keys and values is the fastest at short contexts, since the attention is then ordinary, and runs out of memory before 8,192 tokens.</p> <p>Absorption is not free either. Per cached token each head scores over the 256 + 32 numbers of the latent instead of the 64 + 32 of a key, and mixes 256 numbers instead of 64, so the attention does several times the arithmetic.</p> <p>On a large GPU with many heads that arithmetic dominates; DeepSeek’s kernel notes say that “the MLA kernel is compute-bound despite being a decoding-stage attention kernel”.</p> <p>That is why serving engines use each form where it fits: vLLM’s documentation describes the rebuilt form for reading a prompt and the absorbed one for generating, the first “compute friendly”, the second “data-movement friendly”.</p> <h2 id="6-a-latent-cache-for-a-model-that-wasnt-trained-with-one">6. A latent cache for a model that wasn’t trained with one</h2> <p>If latent attention is this good, why not convert existing models? People have tried.</p> <p>MHA2MLA factorises the key and value weights jointly with an SVD and then fine-tunes on “0.6% to 1%” of the data<sup class="cite">[<a href="#ref-2" id="cite-2" data-ref="2" aria-label="Reference 2: Ji, T., Guo, B., Wu, Y., et al. (2025). Towards economical inference: enabling DeepSeek's multi-head latent attention in any Transformer-based LLMs. arXiv:2502.14837.">2</a>]</sup>; TransMLA instead runs principal component analysis on the keys and values the model actually produces, and without any training reports that “we compressed the <a href="/blog/2025/inference-optimization/">KV cache</a> of LLaMA-2 by 68.75%, with only a 1.65% performance drop”<sup class="cite">[<a href="#ref-3" id="cite-3" data-ref="3" aria-label="Reference 3: Meng, F., Tang, P., Yao, Z., et al. (2025). TransMLA: multi-head latent attention is all you need. arXiv:2502.07864.">3</a>]</sup>.</p> <p>We can try the simplest version on lesson 6’s Qwen3-0.6B. In each layer the keys (before their norm and rotation) and the values come from two matrices, together 2,048 numbers per token. Replace them by a down-projection to \(r\) numbers, the latent we would cache, and an up-projection back:</p> \[\begin{bmatrix} k \\ v \end{bmatrix} = W x \;\approx\; B\,(A x),\] \[A \in \mathbb{R}^{r \times d}, \qquad B \in \mathbb{R}^{2048 \times r}.\] <p>Two ways to choose \(A\) and \(B\). The <em>weight SVD</em> takes the best rank-\(r\) approximation of \(W\) itself. The <em>activation PCA</em> takes the \(r\) directions along which the keys and values of real text vary most, measured on a few thousand tokens, and projects onto those.</p> <p>The first treats every direction of the input as equally likely; the second knows which inputs the model actually sees. We measure the loss on held-out text as \(r\) shrinks.</p> <p>The rotation still has to happen after the up-projection, so this model can cache the latent but not absorb; the point is how much the keys and values can be compressed at all.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">QWEN</span> <span class="o">=</span> <span class="sh">"</span><span class="s">Qwen/Qwen3-0.6B</span><span class="sh">"</span>
<span class="k">del</span> <span class="n">model</span>
<span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">empty_cache</span><span class="p">()</span> <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">else</span> <span class="bp">None</span>
<span class="n">qwen_tok</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">QWEN</span><span class="p">)</span>
<span class="k">if</span> <span class="n">SMOKE</span><span class="p">:</span>
    <span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">Qwen3Config</span><span class="p">,</span> <span class="n">Qwen3ForCausalLM</span>

    <span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="mi">0</span><span class="p">)</span>
    <span class="n">qwen</span> <span class="o">=</span> <span class="nc">Qwen3ForCausalLM</span><span class="p">(</span>
        <span class="nc">Qwen3Config</span><span class="p">(</span>
            <span class="n">vocab_size</span><span class="o">=</span><span class="n">qwen_tok</span><span class="p">.</span><span class="n">vocab_size</span> <span class="o">+</span> <span class="mi">300</span><span class="p">,</span>
            <span class="n">hidden_size</span><span class="o">=</span><span class="mi">64</span><span class="p">,</span>
            <span class="n">intermediate_size</span><span class="o">=</span><span class="mi">128</span><span class="p">,</span>
            <span class="n">num_hidden_layers</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span>
            <span class="n">num_attention_heads</span><span class="o">=</span><span class="mi">4</span><span class="p">,</span>
            <span class="n">num_key_value_heads</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span>
            <span class="n">head_dim</span><span class="o">=</span><span class="mi">16</span><span class="p">,</span>
        <span class="p">)</span>
    <span class="p">)</span>
    <span class="n">qwen</span> <span class="o">=</span> <span class="n">qwen</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="k">else</span><span class="p">:</span>
    <span class="n">qwen</span> <span class="o">=</span> <span class="n">AutoModelForCausalLM</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">QWEN</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">HALF</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>

<span class="n">name</span> <span class="o">=</span> <span class="sh">"</span><span class="s">wikitext-103-raw-v1/test-00000-of-00001.parquet</span><span class="sh">"</span>
<span class="n">path</span> <span class="o">=</span> <span class="nf">hf_hub_download</span><span class="p">(</span><span class="sh">"</span><span class="s">Salesforce/wikitext</span><span class="sh">"</span><span class="p">,</span> <span class="n">name</span><span class="p">,</span> <span class="n">repo_type</span><span class="o">=</span><span class="sh">"</span><span class="s">dataset</span><span class="sh">"</span><span class="p">)</span>
<span class="n">wiki</span> <span class="o">=</span> <span class="sh">""</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nf">read_parquet</span><span class="p">(</span><span class="n">path</span><span class="p">)[</span><span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">].</span><span class="nf">tolist</span><span class="p">())</span>
<span class="n">qwen_ids</span> <span class="o">=</span> <span class="nf">qwen_tok</span><span class="p">(</span><span class="n">wiki</span><span class="p">[:</span> <span class="mi">400_000</span> <span class="k">if</span> <span class="ow">not</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">20_000</span><span class="p">]).</span><span class="n">input_ids</span>
<span class="n">SEQ</span> <span class="o">=</span> <span class="mi">64</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">512</span>
<span class="n">n_windows</span> <span class="o">=</span> <span class="nf">len</span><span class="p">(</span><span class="n">qwen_ids</span><span class="p">)</span> <span class="o">//</span> <span class="n">SEQ</span>
<span class="n">windows</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">qwen_ids</span><span class="p">[:</span> <span class="n">n_windows</span> <span class="o">*</span> <span class="n">SEQ</span><span class="p">]).</span><span class="nf">view</span><span class="p">(</span><span class="n">n_windows</span><span class="p">,</span> <span class="n">SEQ</span><span class="p">)</span>
<span class="n">calibration</span><span class="p">,</span> <span class="n">held_out</span> <span class="o">=</span> <span class="p">(</span>
    <span class="n">windows</span><span class="p">[:</span> <span class="n">n_windows</span> <span class="o">//</span> <span class="mi">2</span><span class="p">],</span>
    <span class="n">windows</span><span class="p">[</span><span class="n">n_windows</span> <span class="o">//</span> <span class="mi">2</span> <span class="p">:][:</span> <span class="mi">4</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">32</span><span class="p">],</span>
<span class="p">)</span>


<span class="k">def</span> <span class="nf">loss_on</span><span class="p">(</span><span class="n">batches</span><span class="p">,</span> <span class="n">batch</span><span class="o">=</span><span class="mi">8</span><span class="p">):</span>
    <span class="n">total</span><span class="p">,</span> <span class="n">count</span> <span class="o">=</span> <span class="mf">0.0</span><span class="p">,</span> <span class="mi">0</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">batches</span><span class="p">),</span> <span class="n">batch</span><span class="p">):</span>
            <span class="n">ids</span> <span class="o">=</span> <span class="n">batches</span><span class="p">[</span><span class="n">i</span> <span class="p">:</span> <span class="n">i</span> <span class="o">+</span> <span class="n">batch</span><span class="p">].</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
            <span class="n">logits</span> <span class="o">=</span> <span class="nf">qwen</span><span class="p">(</span><span class="n">ids</span><span class="p">).</span><span class="n">logits</span><span class="p">.</span><span class="nf">float</span><span class="p">()</span>
            <span class="n">total</span> <span class="o">+=</span> <span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span>
                <span class="n">logits</span><span class="p">[:,</span> <span class="p">:</span><span class="o">-</span><span class="mi">1</span><span class="p">].</span><span class="nf">flatten</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">),</span> <span class="n">ids</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">:].</span><span class="nf">flatten</span><span class="p">(),</span> <span class="n">reduction</span><span class="o">=</span><span class="sh">"</span><span class="s">sum</span><span class="sh">"</span>
            <span class="p">).</span><span class="nf">item</span><span class="p">()</span>
            <span class="n">count</span> <span class="o">+=</span> <span class="n">ids</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">:].</span><span class="nf">numel</span><span class="p">()</span>
    <span class="k">return</span> <span class="n">total</span> <span class="o">/</span> <span class="n">count</span>


<span class="n">attention</span> <span class="o">=</span> <span class="p">[</span><span class="n">layer</span><span class="p">.</span><span class="n">self_attn</span> <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">qwen</span><span class="p">.</span><span class="n">model</span><span class="p">.</span><span class="n">layers</span><span class="p">]</span>
<span class="n">modules</span> <span class="o">=</span> <span class="p">[</span>
    <span class="p">(</span><span class="n">a</span><span class="p">.</span><span class="n">k_proj</span><span class="p">,</span> <span class="n">a</span><span class="p">.</span><span class="n">v_proj</span><span class="p">)</span> <span class="k">for</span> <span class="n">a</span> <span class="ow">in</span> <span class="n">attention</span>
<span class="p">]</span>  <span class="c1"># the original projections, put back after each test
</span><span class="n">original</span> <span class="o">=</span> <span class="p">[(</span><span class="n">k</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="nf">detach</span><span class="p">(),</span> <span class="n">v</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="nf">detach</span><span class="p">())</span> <span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="ow">in</span> <span class="n">modules</span><span class="p">]</span>
<span class="n">kv_width</span> <span class="o">=</span> <span class="n">original</span><span class="p">[</span><span class="mi">0</span><span class="p">][</span><span class="mi">0</span><span class="p">].</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span> <span class="o">+</span> <span class="n">original</span><span class="p">[</span><span class="mi">0</span><span class="p">][</span><span class="mi">1</span><span class="p">].</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>

<span class="c1"># the keys (before norm and rotation) and values of real text, for the PCA
</span><span class="n">inputs</span> <span class="o">=</span> <span class="p">[[]</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">attention</span><span class="p">]</span>
<span class="n">hooks</span> <span class="o">=</span> <span class="p">[</span>
    <span class="n">a</span><span class="p">.</span><span class="n">k_proj</span><span class="p">.</span><span class="nf">register_forward_hook</span><span class="p">(</span>
        <span class="k">lambda</span> <span class="n">m</span><span class="p">,</span> <span class="n">i</span><span class="p">,</span> <span class="n">o</span><span class="p">,</span> <span class="n">k</span><span class="o">=</span><span class="n">k</span><span class="p">:</span> <span class="n">inputs</span><span class="p">[</span><span class="n">k</span><span class="p">].</span><span class="nf">append</span><span class="p">(</span><span class="n">i</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">detach</span><span class="p">().</span><span class="nf">float</span><span class="p">().</span><span class="nf">flatten</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">).</span><span class="nf">cpu</span><span class="p">())</span>
    <span class="p">)</span>
    <span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">a</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">attention</span><span class="p">)</span>
<span class="p">]</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">min</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">calibration</span><span class="p">),</span> <span class="mi">4</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">16</span><span class="p">),</span> <span class="mi">4</span><span class="p">):</span>
        <span class="nf">qwen</span><span class="p">(</span><span class="n">calibration</span><span class="p">[</span><span class="n">i</span> <span class="p">:</span> <span class="n">i</span> <span class="o">+</span> <span class="mi">4</span><span class="p">].</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">))</span>
<span class="k">for</span> <span class="n">hook</span> <span class="ow">in</span> <span class="n">hooks</span><span class="p">:</span>
    <span class="n">hook</span><span class="p">.</span><span class="nf">remove</span><span class="p">()</span>


<span class="k">class</span> <span class="nc">LowRank</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="sh">"""</span><span class="s">y = B (A x): the projection goes through r numbers.</span><span class="sh">"""</span>

    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">a</span><span class="p">,</span> <span class="n">b</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">a</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">b</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">a</span><span class="p">),</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">b</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="nf">return </span><span class="p">(</span><span class="n">x</span> <span class="o">@</span> <span class="n">self</span><span class="p">.</span><span class="n">a</span><span class="p">.</span><span class="n">T</span><span class="p">)</span> <span class="o">@</span> <span class="n">self</span><span class="p">.</span><span class="n">b</span><span class="p">.</span><span class="n">T</span>


<span class="k">def</span> <span class="nf">compress</span><span class="p">(</span><span class="n">rank</span><span class="p">,</span> <span class="n">method</span><span class="p">):</span>
    <span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">a</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">attention</span><span class="p">):</span>
        <span class="n">w</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">(</span><span class="n">original</span><span class="p">[</span><span class="n">k</span><span class="p">]).</span><span class="nf">float</span><span class="p">()</span>  <span class="c1"># (2048 x d): keys, then values
</span>        <span class="k">if</span> <span class="n">method</span> <span class="o">==</span> <span class="sh">"</span><span class="s">weight SVD</span><span class="sh">"</span><span class="p">:</span>
            <span class="n">u</span><span class="p">,</span> <span class="n">s</span><span class="p">,</span> <span class="n">vt</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="nf">svd</span><span class="p">(</span><span class="n">w</span><span class="p">,</span> <span class="n">full_matrices</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
            <span class="n">down</span><span class="p">,</span> <span class="n">up</span> <span class="o">=</span> <span class="n">s</span><span class="p">[:</span><span class="n">rank</span><span class="p">,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="n">vt</span><span class="p">[:</span><span class="n">rank</span><span class="p">],</span> <span class="n">u</span><span class="p">[:,</span> <span class="p">:</span><span class="n">rank</span><span class="p">]</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="n">x</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">(</span><span class="n">inputs</span><span class="p">[</span><span class="n">k</span><span class="p">]).</span><span class="nf">to</span><span class="p">(</span><span class="n">w</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
            <span class="n">y</span> <span class="o">=</span> <span class="n">x</span> <span class="o">@</span> <span class="n">w</span><span class="p">.</span><span class="n">T</span>  <span class="c1"># the keys and values this layer produced
</span>            <span class="n">directions</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="nf">eigh</span><span class="p">(</span><span class="n">y</span><span class="p">.</span><span class="n">T</span> <span class="o">@</span> <span class="n">y</span> <span class="o">/</span> <span class="nf">len</span><span class="p">(</span><span class="n">y</span><span class="p">)).</span><span class="n">eigenvectors</span><span class="p">[:,</span> <span class="o">-</span><span class="n">rank</span><span class="p">:]</span>
            <span class="n">down</span><span class="p">,</span> <span class="n">up</span> <span class="o">=</span> <span class="n">directions</span><span class="p">.</span><span class="n">T</span> <span class="o">@</span> <span class="n">w</span><span class="p">,</span> <span class="n">directions</span>
        <span class="n">n_k</span> <span class="o">=</span> <span class="n">original</span><span class="p">[</span><span class="n">k</span><span class="p">][</span><span class="mi">0</span><span class="p">].</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
        <span class="n">dtype</span> <span class="o">=</span> <span class="n">original</span><span class="p">[</span><span class="n">k</span><span class="p">][</span><span class="mi">0</span><span class="p">].</span><span class="n">dtype</span>
        <span class="n">a</span><span class="p">.</span><span class="n">k_proj</span> <span class="o">=</span> <span class="nc">LowRank</span><span class="p">(</span><span class="n">down</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">dtype</span><span class="p">),</span> <span class="n">up</span><span class="p">[:</span><span class="n">n_k</span><span class="p">].</span><span class="nf">to</span><span class="p">(</span><span class="n">dtype</span><span class="p">))</span>
        <span class="n">a</span><span class="p">.</span><span class="n">v_proj</span> <span class="o">=</span> <span class="nc">LowRank</span><span class="p">(</span><span class="n">down</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">dtype</span><span class="p">),</span> <span class="n">up</span><span class="p">[</span><span class="n">n_k</span><span class="p">:].</span><span class="nf">to</span><span class="p">(</span><span class="n">dtype</span><span class="p">))</span>


<span class="k">def</span> <span class="nf">restore</span><span class="p">():</span>
    <span class="k">for</span> <span class="n">a</span><span class="p">,</span> <span class="p">(</span><span class="n">k_proj</span><span class="p">,</span> <span class="n">v_proj</span><span class="p">)</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">attention</span><span class="p">,</span> <span class="n">modules</span><span class="p">):</span>
        <span class="n">a</span><span class="p">.</span><span class="n">k_proj</span><span class="p">,</span> <span class="n">a</span><span class="p">.</span><span class="n">v_proj</span> <span class="o">=</span> <span class="n">k_proj</span><span class="p">,</span> <span class="n">v_proj</span>


<span class="n">base_loss</span> <span class="o">=</span> <span class="nf">loss_on</span><span class="p">(</span><span class="n">held_out</span><span class="p">)</span>
<span class="n">ranks</span> <span class="o">=</span> <span class="p">[</span><span class="n">kv_width</span> <span class="o">//</span> <span class="mi">2</span><span class="p">,</span> <span class="n">kv_width</span> <span class="o">//</span> <span class="mi">4</span><span class="p">,</span> <span class="n">kv_width</span> <span class="o">//</span> <span class="mi">8</span><span class="p">,</span> <span class="n">kv_width</span> <span class="o">//</span> <span class="mi">16</span><span class="p">,</span> <span class="n">kv_width</span> <span class="o">//</span> <span class="mi">32</span><span class="p">]</span>
<span class="n">conversion</span> <span class="o">=</span> <span class="p">[</span>
    <span class="p">{</span><span class="sh">"</span><span class="s">method</span><span class="sh">"</span><span class="p">:</span> <span class="n">m</span><span class="p">,</span> <span class="sh">"</span><span class="s">latent</span><span class="sh">"</span><span class="p">:</span> <span class="n">kv_width</span><span class="p">,</span> <span class="sh">"</span><span class="s">loss</span><span class="sh">"</span><span class="p">:</span> <span class="n">base_loss</span><span class="p">}</span>
    <span class="k">for</span> <span class="n">m</span> <span class="ow">in</span> <span class="p">[</span><span class="sh">"</span><span class="s">weight SVD</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">activation PCA</span><span class="sh">"</span><span class="p">]</span>
<span class="p">]</span>
<span class="k">for</span> <span class="n">method</span> <span class="ow">in</span> <span class="p">[</span><span class="sh">"</span><span class="s">weight SVD</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">activation PCA</span><span class="sh">"</span><span class="p">]:</span>
    <span class="k">for</span> <span class="n">rank</span> <span class="ow">in</span> <span class="n">ranks</span><span class="p">:</span>
        <span class="nf">compress</span><span class="p">(</span><span class="n">rank</span><span class="p">,</span> <span class="n">method</span><span class="p">)</span>
        <span class="n">conversion</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">method</span><span class="sh">"</span><span class="p">:</span> <span class="n">method</span><span class="p">,</span> <span class="sh">"</span><span class="s">latent</span><span class="sh">"</span><span class="p">:</span> <span class="n">rank</span><span class="p">,</span> <span class="sh">"</span><span class="s">loss</span><span class="sh">"</span><span class="p">:</span> <span class="nf">loss_on</span><span class="p">(</span><span class="n">held_out</span><span class="p">)})</span>
<span class="nf">restore</span><span class="p">()</span>
<span class="n">conversion</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">conversion</span><span class="p">)</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">7.2</span><span class="p">,</span> <span class="mf">3.6</span><span class="p">))</span>
<span class="nf">for </span><span class="p">(</span><span class="n">method</span><span class="p">,</span> <span class="n">chunk</span><span class="p">),</span> <span class="n">color</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span>
    <span class="n">conversion</span><span class="p">.</span><span class="nf">groupby</span><span class="p">(</span><span class="sh">"</span><span class="s">method</span><span class="sh">"</span><span class="p">),</span> <span class="p">[</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">]]</span>
<span class="p">):</span>
    <span class="n">chunk</span> <span class="o">=</span> <span class="n">chunk</span><span class="p">.</span><span class="nf">sort_values</span><span class="p">(</span><span class="sh">"</span><span class="s">latent</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">chunk</span><span class="p">[</span><span class="sh">"</span><span class="s">latent</span><span class="sh">"</span><span class="p">],</span> <span class="n">chunk</span><span class="p">[</span><span class="sh">"</span><span class="s">loss</span><span class="sh">"</span><span class="p">],</span> <span class="n">marker</span><span class="o">=</span><span class="sh">"</span><span class="s">o</span><span class="sh">"</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="n">method</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">axhline</span><span class="p">(</span><span class="n">base_loss</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">],</span> <span class="n">linestyle</span><span class="o">=</span><span class="sh">"</span><span class="s">--</span><span class="sh">"</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xscale</span><span class="p">(</span><span class="sh">"</span><span class="s">log</span><span class="sh">"</span><span class="p">,</span> <span class="n">base</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xticks</span><span class="p">([</span><span class="n">kv_width</span><span class="p">]</span> <span class="o">+</span> <span class="n">ranks</span><span class="p">,</span> <span class="p">[</span><span class="nf">str</span><span class="p">(</span><span class="n">r</span><span class="p">)</span> <span class="k">for</span> <span class="n">r</span> <span class="ow">in</span> <span class="p">[</span><span class="n">kv_width</span><span class="p">]</span> <span class="o">+</span> <span class="n">ranks</span><span class="p">])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">numbers cached per token per layer (keys and values: </span><span class="si">{</span><span class="n">kv_width</span><span class="si">}</span><span class="s">)</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">loss on held-out text</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">Qwen3-0.6B with its keys and values squeezed through a latent, no training</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/08/output-02.png" alt="Qwen3-0.6B with its keys and values squeezed through a latent, no training" loading="lazy"></p> <p>At 1,024 numbers both methods lose nothing, and that is the first lesson of this experiment: Qwen3-0.6B’s hidden state is only 1,024 numbers wide, so its keys and values, 2,048 numbers computed linearly from it, carry no more information than the hidden state itself. The model caches twice what it needs.</p> <p>Below that the two methods part. The weight SVD falls apart quickly, the activation PCA degrades gently, which is why TransMLA works with the keys and values the model actually produces. But even the PCA loses noticeably at a quarter of the original cache, and the loss grows from there.</p> <p>A model can be converted, but not for free: the published conversions all <a href="/blog/2025/adapters/">fine-tune</a> afterwards, MHA2MLA on a fraction of a percent of the <a href="/blog/2024/llms-for-those-who-missed-out/">pre-training</a> data, and the rotary positions have to be split out first, which our experiment didn’t attempt.</p> <h2 id="7-fewer-bits-per-number">7. Fewer bits per number</h2> <p>The lever that works on every model is the number format. KIVI found that keys and values want different treatment: “the key cache should be quantized per-channel … In contrast, the value cache should be quantized per-token”, because “in key cache, some fixed channels exhibit very large magnitudes, whereas in value cache, there is no significant pattern for outliers”<sup class="cite">[<a href="#ref-4" id="cite-4" data-ref="4" aria-label="Reference 4: Liu, Z., Yuan, J., Jin, H., et al. (2024). KIVI: a tuning-free asymmetric 2bit quantization for KV cache. ICML 2024.">4</a>]</sup>.</p> <p>We try both groupings on Qwen3’s keys and values at 8, 4 and 2 bits, rounding them on the way into the cache and measuring the loss.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">fake_quantize</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">bits</span><span class="p">,</span> <span class="n">dim</span><span class="p">):</span>
    <span class="sh">"""</span><span class="s">Round x to 2**bits levels per slice along `dim`, then back to floats.</span><span class="sh">"""</span>
    <span class="n">low</span><span class="p">,</span> <span class="n">high</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="nf">amin</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="n">dim</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">),</span> <span class="n">x</span><span class="p">.</span><span class="nf">amax</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="n">dim</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">step</span> <span class="o">=</span> <span class="p">(</span><span class="n">high</span> <span class="o">-</span> <span class="n">low</span><span class="p">).</span><span class="nf">clamp</span><span class="p">(</span><span class="nb">min</span><span class="o">=</span><span class="mf">1e-8</span><span class="p">)</span> <span class="o">/</span> <span class="p">(</span><span class="mi">2</span><span class="o">**</span><span class="n">bits</span> <span class="o">-</span> <span class="mi">1</span><span class="p">)</span>
    <span class="nf">return </span><span class="p">((</span><span class="n">x</span> <span class="o">-</span> <span class="n">low</span><span class="p">)</span> <span class="o">/</span> <span class="n">step</span><span class="p">).</span><span class="nf">round</span><span class="p">()</span> <span class="o">*</span> <span class="n">step</span> <span class="o">+</span> <span class="n">low</span>


<span class="k">class</span> <span class="nc">Quantized</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">inner</span><span class="p">,</span> <span class="n">bits</span><span class="p">,</span> <span class="n">dim</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">inner</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">bits</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">dim</span> <span class="o">=</span> <span class="n">inner</span><span class="p">,</span> <span class="n">bits</span><span class="p">,</span> <span class="n">dim</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="k">return</span> <span class="nf">fake_quantize</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">inner</span><span class="p">(</span><span class="n">x</span><span class="p">),</span> <span class="n">self</span><span class="p">.</span><span class="n">bits</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">dim</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">quantize_cache</span><span class="p">(</span><span class="n">bits</span><span class="p">,</span> <span class="n">keys_by</span><span class="p">,</span> <span class="n">values_by</span><span class="p">):</span>
    <span class="n">by</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">channel</span><span class="sh">"</span><span class="p">:</span> <span class="mi">1</span><span class="p">,</span> <span class="sh">"</span><span class="s">token</span><span class="sh">"</span><span class="p">:</span> <span class="mi">2</span><span class="p">}</span>  <span class="c1"># outputs are batch x tokens x channels
</span>    <span class="k">for</span> <span class="n">a</span><span class="p">,</span> <span class="p">(</span><span class="n">k_proj</span><span class="p">,</span> <span class="n">v_proj</span><span class="p">)</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">attention</span><span class="p">,</span> <span class="n">modules</span><span class="p">):</span>
        <span class="n">a</span><span class="p">.</span><span class="n">k_proj</span> <span class="o">=</span> <span class="nc">Quantized</span><span class="p">(</span><span class="n">k_proj</span><span class="p">,</span> <span class="n">bits</span><span class="p">,</span> <span class="n">by</span><span class="p">[</span><span class="n">keys_by</span><span class="p">])</span>
        <span class="n">a</span><span class="p">.</span><span class="n">v_proj</span> <span class="o">=</span> <span class="nc">Quantized</span><span class="p">(</span><span class="n">v_proj</span><span class="p">,</span> <span class="n">bits</span><span class="p">,</span> <span class="n">by</span><span class="p">[</span><span class="n">values_by</span><span class="p">])</span>


<span class="n">quantization</span> <span class="o">=</span> <span class="p">[{</span><span class="sh">"</span><span class="s">bits</span><span class="sh">"</span><span class="p">:</span> <span class="mi">16</span><span class="p">,</span> <span class="sh">"</span><span class="s">grouping</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">none</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">loss</span><span class="sh">"</span><span class="p">:</span> <span class="n">base_loss</span><span class="p">}]</span>
<span class="k">for</span> <span class="n">bits</span> <span class="ow">in</span> <span class="p">[</span><span class="mi">8</span><span class="p">,</span> <span class="mi">4</span><span class="p">,</span> <span class="mi">2</span><span class="p">]:</span>
    <span class="k">for</span> <span class="n">keys_by</span><span class="p">,</span> <span class="n">values_by</span> <span class="ow">in</span> <span class="p">[(</span><span class="sh">"</span><span class="s">channel</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">token</span><span class="sh">"</span><span class="p">),</span> <span class="p">(</span><span class="sh">"</span><span class="s">token</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">token</span><span class="sh">"</span><span class="p">)]:</span>
        <span class="nf">quantize_cache</span><span class="p">(</span><span class="n">bits</span><span class="p">,</span> <span class="n">keys_by</span><span class="p">,</span> <span class="n">values_by</span><span class="p">)</span>
        <span class="n">quantization</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
            <span class="p">{</span>
                <span class="sh">"</span><span class="s">bits</span><span class="sh">"</span><span class="p">:</span> <span class="n">bits</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">grouping</span><span class="sh">"</span><span class="p">:</span> <span class="sa">f</span><span class="sh">"</span><span class="s">keys per </span><span class="si">{</span><span class="n">keys_by</span><span class="si">}</span><span class="s">, values per </span><span class="si">{</span><span class="n">values_by</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">loss</span><span class="sh">"</span><span class="p">:</span> <span class="nf">loss_on</span><span class="p">(</span><span class="n">held_out</span><span class="p">),</span>
            <span class="p">}</span>
        <span class="p">)</span>
<span class="nf">restore</span><span class="p">()</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">quantization</span><span class="p">),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">3</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">bits</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">grouping</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">loss</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">16</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">none</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.403</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">keys per channel, values per token</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.403</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">keys per token, values per token</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.404</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">keys per channel, values per token</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.554</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">keys per token, values per token</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.687</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">keys per channel, values per token</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">10.709</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">keys per token, values per token</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">13.827</td></tr></tbody></table></div> <p>Eight bits cost nothing measurable, which is why an 8-bit or FP8 cache is a switch in serving engines.</p> <p>At four bits the grouping matters: keys rounded per channel keep the loss noticeably closer to the original than keys rounded per token, as KIVI predicts, because a few channels of the keys carry much larger numbers than the rest.</p> <p>At two bits both break down here. KIVI gets to two bits with more care than this sketch: it rounds keys in small groups of tokens rather than over the whole text, and keeps the most recent tokens in full precision.</p> <p>Our per-channel rounding also looks at the whole sequence at once, which a cache filled one token at a time cannot do.</p> <h2 id="8-where-each-lever-fits">8. Where each lever fits</h2> <p>Every lever in this lesson trades something, and they combine.</p> <p>Grouped queries, from lesson 6, are now the default: they cost a little quality and nothing else, and nearly every new model has them. Local layers, also lesson 6, cut the cache of most layers to a window and need the model to be trained that way.</p> <p>Latent attention cuts deepest, to about a quarter of what grouped queries with eight groups would keep at the same size, at the price of more arithmetic per generated token, and it too has to be trained in, or converted and fine-tuned.</p> <p>The levers that need no retraining are the number format and the memory manager. An 8-bit cache halves the memory for free, as we saw, and lower formats need care.</p> <p>The memory manager matters more than it sounds: before vLLM, in its authors’ measurement, “only 20.4% - 38.2% of the KV cache memory is used to store the actual token states in the existing systems”<sup class="cite">[<a href="#ref-5" id="cite-5" data-ref="5" aria-label="Reference 5: Kwon, W., Li, Z., Zhuang, S., et al. (2023). Efficient memory management for large language model serving with PagedAttention. SOSP 2023.">5</a>]</sup>, the rest lost to caches reserved for the longest possible answer.</p> <p>PagedAttention stores the cache in fixed blocks, like an operating system’s pages, and shares the blocks of a common prefix between requests, lesson 6’s prefix caching done by the server.</p> <p>The industry combines all of these. Character.AI, by its own account, cut its cache by “more than 20X” with multi-query attention, one global layer in six, keys and values shared between neighbouring layers, and 8-bit numbers: “We use int8 quantization on model weights, activations, and attention KV cache” <sup class="cite">[<a href="#ref-6" id="cite-6" data-ref="6" aria-label="Reference 6: Character.AI, 2024. web.archive.org.">6</a>]</sup>.</p> <p>Sharing between layers is its own research line, from cross-layer attention<sup class="cite">[<a href="#ref-7" id="cite-7" data-ref="7" aria-label="Reference 7: Brandon, W., Mishra, M., Nrusimha, A., et al. (2024). Reducing Transformer key-value cache size with cross-layer attention. arXiv:2405.12981.">7</a>]</sup> to YOCO, which keeps one cache for the whole model<sup class="cite">[<a href="#ref-8" id="cite-8" data-ref="8" aria-label="Reference 8: Sun, Y., Dong, L., Zhu, Y., et al. (2024). You only cache once: decoder-decoder architectures for language models. NeurIPS 2024.">8</a>]</sup>. And when nothing else is left, the cache can be cut by forgetting: H2O keeps the few tokens that collect most of the attention and drops the rest<sup class="cite">[<a href="#ref-9" id="cite-9" data-ref="9" aria-label="Reference 9: Zhang, Z., Sheng, Y., Zhou, T., et al. (2023). H2O: heavy-hitter oracle for efficient generative inference of large language models. NeurIPS 2023.">9</a>]</sup>.</p> <p>For a T4 the practical answer is the table of section 1 with the weights subtracted: a 4B model in 16-bit floats leaves room for a handful of long conversations with a grouped-query cache, several times more with a latent one, and twice as many again with an 8-bit cache.</p> <p>DeepSeek-V2’s passport, the model that introduced latent attention, and the family tree with this lesson’s branch:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/08/passport-light.png" width="760" alt="DeepSeek-V2's passport. Published May 2024 by DeepSeek-AI with open weights. Type: decoder-only mixture of experts, 236 billion parameters, 21 billion per token, 160 routed and 2 shared experts, 6 routed per token. Training: 8.1 trillion tokens. Attention: multi-head latent attention, 128 heads, a latent of 512 numbers and a rotary key of 64 per token and layer; queries compressed to 1,536. Positions: decoupled rotary dimensions, 64 per head. Cache: 576 numbers per token per layer, as much as grouped-query attention with 2.25 groups. Vocabulary: 102,400 tokens. Good at: long conversations served to many users at once. Not for: a single GPU" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/08/passport-dark.png" width="760" alt="DeepSeek-V2's passport. Published May 2024 by DeepSeek-AI with open weights. Type: decoder-only mixture of experts, 236 billion parameters, 21 billion per token, 160 routed and 2 shared experts, 6 routed per token. Training: 8.1 trillion tokens. Attention: multi-head latent attention, 128 heads, a latent of 512 numbers and a rotary key of 64 per token and layer; queries compressed to 1,536. Positions: decoupled rotary dimensions, 64 per head. Cache: 576 numbers per token per layer, as much as grouped-query attention with 2.25 groups. Vocabulary: 102,400 tokens. Good at: long conversations served to many users at once. Not for: a single GPU" loading="lazy"></p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/08/family-light.png" width="760" alt="The family of the Transformer as this course covers it, with lesson 8, the KV cache and latent attention, highlighted and lessons 1 to 7 done" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/08/family-dark.png" width="760" alt="The family of the Transformer as this course covers it, with lesson 8, the KV cache and latent attention, highlighted and lessons 1 to 7 done" loading="lazy"></p> <h2 id="references">References</h2> <ol class="tfs-refs"> <li id="ref-1">DeepSeek-AI (2024). <a href="https://arxiv.org/abs/2405.04434">DeepSeek-V2: a strong, economical, and efficient mixture-of-experts language model</a>. arXiv:2405.04434. <a class="ref-back" href="#cite-1" aria-label="Back to the text">↩</a></li> <li id="ref-2">Ji, T., Guo, B., Wu, Y., et al. (2025). <a href="https://arxiv.org/abs/2502.14837">Towards economical inference: enabling DeepSeek’s multi-head latent attention in any Transformer-based LLMs</a>. arXiv:2502.14837. <a class="ref-back" href="#cite-2" aria-label="Back to the text">↩</a></li> <li id="ref-3">Meng, F., Tang, P., Yao, Z., et al. (2025). <a href="https://arxiv.org/abs/2502.07864">TransMLA: multi-head latent attention is all you need</a>. arXiv:2502.07864. <a class="ref-back" href="#cite-3" aria-label="Back to the text">↩</a></li> <li id="ref-4">Liu, Z., Yuan, J., Jin, H., et al. (2024). <a href="https://arxiv.org/abs/2402.02750">KIVI: a tuning-free asymmetric 2bit quantization for KV cache</a>. <em>ICML 2024</em>. <a class="ref-back" href="#cite-4" aria-label="Back to the text">↩</a></li> <li id="ref-5">Kwon, W., Li, Z., Zhuang, S., et al. (2023). <a href="https://arxiv.org/abs/2309.06180">Efficient memory management for large language model serving with PagedAttention</a>. <em>SOSP 2023</em>. <a class="ref-back" href="#cite-5" aria-label="Back to the text">↩</a></li> <li id="ref-6">Character.AI, 2024. <a href="https://web.archive.org/web/20240620140946/https://research.character.ai/optimizing-inference/">web.archive.org</a>. <a class="ref-back" href="#cite-6" aria-label="Back to the text">↩</a></li> <li id="ref-7">Brandon, W., Mishra, M., Nrusimha, A., et al. (2024). <a href="https://arxiv.org/abs/2405.12981">Reducing Transformer key-value cache size with cross-layer attention</a>. arXiv:2405.12981. <a class="ref-back" href="#cite-7" aria-label="Back to the text">↩</a></li> <li id="ref-8">Sun, Y., Dong, L., Zhu, Y., et al. (2024). <a href="https://arxiv.org/abs/2405.05254">You only cache once: decoder-decoder architectures for language models</a>. <em>NeurIPS 2024</em>. <a class="ref-back" href="#cite-8" aria-label="Back to the text">↩</a></li> <li id="ref-9">Zhang, Z., Sheng, Y., Zhou, T., et al. (2023). <a href="https://arxiv.org/abs/2306.14048">H2O: heavy-hitter oracle for efficient generative inference of large language models</a>. <em>NeurIPS 2023</em>. <a class="ref-back" href="#cite-9" aria-label="Back to the text">↩</a></li> <li id="ref-10">DeepSeek-AI (2024). <a href="https://arxiv.org/abs/2412.19437">DeepSeek-V3 technical report</a>. arXiv:2412.19437.</li> <li id="ref-11">Kimi Team (2025). <a href="https://arxiv.org/abs/2507.20534">Kimi K2: open agentic intelligence</a>. arXiv:2507.20534.</li> <li id="ref-12">Shazeer, N. (2019). <a href="https://arxiv.org/abs/1911.02150">Fast Transformer decoding: one write-head is all you need</a>. arXiv:1911.02150.</li> <li id="ref-13">Ainslie, J., Lee-Thorp, J., de Jong, M., et al. (2023). <a href="https://arxiv.org/abs/2305.13245">GQA: training generalized multi-query Transformer models from multi-head checkpoints</a>. <em>EMNLP 2023</em>.</li> <li id="ref-14">Hooper, C., Kim, S., Mohammadzadeh, H., et al. (2024). <a href="https://arxiv.org/abs/2401.18079">KVQuant: towards 10 million context length LLM inference with KV cache quantization</a>. <em>NeurIPS 2024</em>.</li> <li id="ref-15">OpenBMB (2024). <a href="https://huggingface.co/openbmb/MiniCPM3-4B">MiniCPM3-4B</a>, model card and weights under the MiniCPM model licence.</li> </ol>]]></content> <author> <name>Eva Koroleva</name> </author> <category term="machine-learning"/> <category term="transformer-architectures"/> <category term="kv-cache"/> <category term="mla"/> <category term="multi-head-latent-attention"/> <category term="deepseek"/> <category term="gqa"/> <category term="minicpm3"/> <category term="llm"/> <summary type="html"><![CDATA[What one token costs in the KV cache of ten models, and how DeepSeek's multi-head latent attention cuts it. MLA written from scratch in both its forms, why rotary positions need their own dimensions, MiniCPM3-4B with its official weights, a latent cache against a rebuilt one on a T4, Qwen3 compressed without training, and a quantized cache.]]></summary> <media:thumbnail url="https://blog.korolevalab.com/assets/posts/arch/08/cover.png"/> <media:content medium="image" url="https://blog.korolevalab.com/assets/posts/arch/08/cover.png"/> </entry> <entry> <title type="html">Mixture-of-experts LLMs from scratch with OLMoE</title> <link href="https://blog.korolevalab.com/blog/2026/transformer-architectures-07-moe/" rel="alternate" type="text/html" title="Mixture-of-experts LLMs from scratch with OLMoE"/> <published>2026-08-24T16:00:00+00:00</published> <updated>2026-11-08T00:00:00+00:00</updated> <id>https://blog.korolevalab.com/blog/2026/transformer-architectures-07-moe</id> <content type="html" xml:base="https://blog.korolevalab.com/blog/2026/transformer-architectures-07-moe/"><![CDATA[<p class="tfs-links"><strong>Transformer architectures: from BERT to diffusion</strong> · lesson 7 of 15 · <a href="/teaching/">all lessons</a> · <a href="https://www.kaggle.com/code/qmarva/transformer-architectures-07-mixture-of-experts">run on Kaggle</a> · <a href="https://colab.research.google.com/github/xmarva/transformers-from-scratch/blob/main/notebooks/colab/a07_moe.ipynb">open in Colab</a> · <a href="https://github.com/xmarva/transformers-from-scratch">code on GitHub</a></p> <p>OLMoE-1B-7B has seven billion parameters and uses about one and a third billion of them for each token. Every one of its sixteen layers holds 64 feed-forward networks, the <em>experts</em>, and a small linear layer, the <em>router</em>, picks eight of them for each token.</p> <p>Nobody tells the router what an expert is for. Whatever division of labour the experts end up with, they found it themselves during training on five trillion tokens.</p> <p>In a dense model every token goes through every weight, so there is nothing to watch. A mixture can be watched: feed it Python and see which experts light up, feed it Russian, a language it barely saw in training, and watch again.</p> <p>Then you can act on what you saw, throw away the experts a job doesn’t use, and keep a smaller model that still does the job.</p> <p>A <a href="https://blog.korolevalab.com/blog/2026/mixture-of-experts/">post on this blog</a> built a mixture of experts from scratch, trained it next to dense models and compared the ways of keeping its experts busy. This lesson takes the next step, to a real model trained at scale: we read how nine production mixtures are built, write OLMoE in PyTorch, load the official weights and look inside.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/07/hero-light.png" width="760" alt="A mixture-of-experts layer. A token's vector goes to the router, a linear layer that scores all 64 experts; the softmax turns the scores into probabilities, and the eight largest pick the experts that run. Each chosen expert is a small SwiGLU network; their outputs are added, each weighted by its probability, and the result joins the residual stream. The other 56 experts do nothing for this token" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/07/hero-dark.png" width="760" alt="A mixture-of-experts layer. A token's vector goes to the router, a linear layer that scores all 64 experts; the softmax turns the scores into probabilities, and the eight largest pick the experts that run. Each chosen expert is a small SwiGLU network; their outputs are added, each weighted by its probability, and the result joins the residual stream. The other 56 experts do nothing for this token" loading="lazy"></p> <p><strong>What you’ll do</strong></p> <ol> <li>Read the configs of nine mixtures, from Mixtral to gpt-oss, and see how the design moved.</li> <li>Write the router four ways, find out which of them are the same function, and dispatch tokens to experts without computing what nobody asked for.</li> <li>Write OLMoE in PyTorch, load its official weights across two GPUs and match Hugging Face’s outputs.</li> <li>Route English, Python, school maths and Russian through it and find out which experts each one uses.</li> <li>Prune the experts a single kind of text doesn’t use, and measure what a smaller model costs.</li> <li>Measure how often a token needs the same experts as the token before it, which decides whether a mixture can live partly outside GPU memory.</li> </ol> <p><strong>What you need</strong>: two GPUs. On Kaggle, <em>Settings → Accelerator → GPU T4 x2</em>; OLMoE’s weights take 13 GB in 16-bit floats, more than one T4 has to spare. The notebook downloads OLMoE (14 GB), a slice of Russian Wikipedia (250 MB) and two small datasets; on two T4s it runs in about five minutes.</p> <h2 id="setup">Setup</h2> <p>One small helper package, <code class="language-plaintext highlighter-rouge">tfs</code>, draws the course’s plots and token chips and knows where the notebook runs (Kaggle, Colab or your own machine). Everything the lesson teaches is written out in the notebook itself.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">importlib.util</span>
<span class="kn">import</span> <span class="n">subprocess</span>
<span class="kn">import</span> <span class="n">sys</span>

<span class="n">TFS</span> <span class="o">=</span> <span class="sh">"</span><span class="s">git+https://github.com/xmarva/transformers-from-scratch@main</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">importlib</span><span class="p">.</span><span class="n">util</span><span class="p">.</span><span class="nf">find_spec</span><span class="p">(</span><span class="sh">"</span><span class="s">tfs</span><span class="sh">"</span><span class="p">)</span> <span class="ow">is</span> <span class="bp">None</span><span class="p">:</span>
    <span class="n">subprocess</span><span class="p">.</span><span class="nf">check_call</span><span class="p">([</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">-m</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">pip</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">install</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-q</span><span class="sh">"</span><span class="p">,</span> <span class="n">TFS</span><span class="p">])</span>

<span class="kn">from</span> <span class="n">tfs</span> <span class="kn">import</span> <span class="n">env</span>
<span class="kn">from</span> <span class="n">tfs.viz</span> <span class="kn">import</span> <span class="n">table</span><span class="p">,</span> <span class="n">token_chips</span><span class="p">,</span> <span class="n">use_course_style</span>

<span class="n">env</span><span class="p">.</span><span class="nf">quiet</span><span class="p">()</span>  <span class="c1"># no progress bars or environment warnings in the outputs
</span><span class="n">SEED</span> <span class="o">=</span> <span class="mi">42</span>
<span class="n">env</span><span class="p">.</span><span class="nf">seed_everything</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">COLORS</span> <span class="o">=</span> <span class="nf">use_course_style</span><span class="p">()</span>
<span class="n">WORK_DIR</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">work_dir</span><span class="p">()</span>
</code></pre></div></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">json</span>
<span class="kn">import</span> <span class="n">re</span>
<span class="kn">import</span> <span class="n">subprocess</span>
<span class="kn">import</span> <span class="n">sys</span>
<span class="kn">import</span> <span class="n">sysconfig</span>
<span class="kn">import</span> <span class="n">time</span>
<span class="kn">from</span> <span class="n">collections</span> <span class="kn">import</span> <span class="n">OrderedDict</span>
<span class="kn">from</span> <span class="n">html</span> <span class="kn">import</span> <span class="n">escape</span>
<span class="kn">from</span> <span class="n">pathlib</span> <span class="kn">import</span> <span class="n">Path</span>

<span class="kn">import</span> <span class="n">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>
<span class="kn">import</span> <span class="n">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="n">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">import</span> <span class="n">pyarrow.parquet</span> <span class="k">as</span> <span class="n">pq</span>
<span class="kn">import</span> <span class="n">torch</span>
<span class="kn">import</span> <span class="n">torch.nn</span> <span class="k">as</span> <span class="n">nn</span>
<span class="kn">import</span> <span class="n">torch.nn.functional</span> <span class="k">as</span> <span class="n">F</span>
<span class="kn">from</span> <span class="n">IPython.display</span> <span class="kn">import</span> <span class="n">HTML</span><span class="p">,</span> <span class="n">display</span>
<span class="kn">from</span> <span class="n">matplotlib.colors</span> <span class="kn">import</span> <span class="n">LinearSegmentedColormap</span><span class="p">,</span> <span class="n">to_rgb</span>
<span class="kn">from</span> <span class="n">huggingface_hub</span> <span class="kn">import</span> <span class="n">hf_hub_download</span>
<span class="kn">from</span> <span class="n">safetensors.torch</span> <span class="kn">import</span> <span class="n">load_file</span>
<span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">AutoTokenizer</span>

<span class="n">SMOKE</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">smoke</span><span class="p">()</span>  <span class="c1"># CI runs the lesson on a small slice; you run it in full
</span><span class="n">device</span> <span class="o">=</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">if</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">is_available</span><span class="p">()</span> <span class="k">else</span> <span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span>
<span class="n">GPUS</span> <span class="o">=</span> <span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="s">cuda:</span><span class="si">{</span><span class="n">i</span><span class="si">}</span><span class="sh">"</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">device_count</span><span class="p">())]</span> <span class="ow">or</span> <span class="p">[</span><span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span><span class="p">]</span>
<span class="n">HALF</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">float16</span> <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">else</span> <span class="n">torch</span><span class="p">.</span><span class="n">float32</span>  <span class="c1"># 16-bit matmuls crawl on a CPU
</span><span class="k">assert</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="ow">or</span> <span class="n">SMOKE</span><span class="p">,</span> <span class="sh">"</span><span class="s">This lesson runs a 7B model: use two GPUs</span><span class="sh">"</span>
<span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">GPUS</span><span class="p">:</span>
    <span class="k">if</span> <span class="n">name</span> <span class="o">!=</span> <span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span><span class="p">:</span>
        <span class="nf">print</span><span class="p">(</span><span class="n">name</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">get_device_name</span><span class="p">(</span><span class="n">name</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>cuda:0 Tesla T4
cuda:1 Tesla T4</code></pre> <h2 id="1-nine-mixtures-side-by-side">1. Nine mixtures side by side</h2> <p>As in <a href="/blog/2026/transformer-architectures-06-modern/">lesson 6</a>, the fastest way to read an architecture is its <code class="language-plaintext highlighter-rouge">config.json</code>. Here are the configs of nine mixtures released between December 2023 and August 2025, with the total and active parameter counts their papers and model cards give. Every model calls its settings a little differently, so the reading takes a few lines.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># repository, name, released, total / active parameters from the paper or the model card
</span><span class="n">MOE_MODELS</span> <span class="o">=</span> <span class="p">[</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">mistralai/Mixtral-8x7B-v0.1</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Mixtral 8x7B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2023-12</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">47B / 13B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">Qwen/Qwen1.5-MoE-A2.7B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Qwen1.5-MoE</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2024-03</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">14.3B / 2.7B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">deepseek-ai/DeepSeek-V2-Lite</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">DeepSeek-V2-Lite</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2024-05</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">15.7B / 2.4B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">allenai/OLMoE-1B-7B-0924</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">OLMoE</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2024-09</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">6.9B / 1.3B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">ibm-granite/granite-3.1-3b-a800m-base</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Granite 3.1 3B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2024-12</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">3.3B / 0.8B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">deepseek-ai/DeepSeek-V3</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">DeepSeek-V3</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2024-12</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">671B / 37B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">Qwen/Qwen3-30B-A3B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Qwen3-30B-A3B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2025-04</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">30.5B / 3.3B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">openai/gpt-oss-20b</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">gpt-oss-20b</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2025-08</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">20.9B / 3.6B</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">openai/gpt-oss-120b</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">gpt-oss-120b</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2025-08</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">116.8B / 5.1B</span><span class="sh">"</span><span class="p">),</span>
<span class="p">]</span>


<span class="k">def</span> <span class="nf">read_config</span><span class="p">(</span><span class="n">repo</span><span class="p">):</span>
    <span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">repo</span><span class="p">,</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">))</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
        <span class="k">return</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">f</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">first</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="o">*</span><span class="n">keys</span><span class="p">,</span> <span class="n">default</span><span class="o">=</span><span class="mi">0</span><span class="p">):</span>
    <span class="k">for</span> <span class="n">key</span> <span class="ow">in</span> <span class="n">keys</span><span class="p">:</span>
        <span class="k">if</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="n">key</span><span class="p">)</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
            <span class="k">return</span> <span class="n">c</span><span class="p">[</span><span class="n">key</span><span class="p">]</span>
    <span class="k">return</span> <span class="n">default</span>


<span class="k">def</span> <span class="nf">router_order</span><span class="p">(</span><span class="n">c</span><span class="p">):</span>
    <span class="n">kind</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">model_type</span><span class="sh">"</span><span class="p">]</span>
    <span class="k">if</span> <span class="n">kind</span> <span class="ow">in</span> <span class="p">(</span><span class="sh">"</span><span class="s">granitemoe</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">gpt_oss</span><span class="sh">"</span><span class="p">):</span>
        <span class="k">return</span> <span class="sh">"</span><span class="s">top-k, softmax</span><span class="sh">"</span>
    <span class="k">if</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">scoring_func</span><span class="sh">"</span><span class="p">)</span> <span class="o">==</span> <span class="sh">"</span><span class="s">sigmoid</span><span class="sh">"</span><span class="p">:</span>
        <span class="k">return</span> <span class="sh">"</span><span class="s">sigmoid + bias, top-k, renormalise</span><span class="sh">"</span>
    <span class="n">renorm</span> <span class="o">=</span> <span class="n">kind</span> <span class="o">==</span> <span class="sh">"</span><span class="s">mixtral</span><span class="sh">"</span> <span class="ow">or</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">norm_topk_prob</span><span class="sh">"</span><span class="p">)</span>
    <span class="k">return</span> <span class="sh">"</span><span class="s">softmax, top-k</span><span class="sh">"</span> <span class="o">+</span> <span class="p">(</span><span class="sh">"</span><span class="s">, renormalise</span><span class="sh">"</span> <span class="k">if</span> <span class="n">renorm</span> <span class="k">else</span> <span class="sh">""</span><span class="p">)</span>


<span class="n">configs</span> <span class="o">=</span> <span class="p">{</span><span class="n">name</span><span class="p">:</span> <span class="nf">read_config</span><span class="p">(</span><span class="n">repo</span><span class="p">)</span> <span class="k">for</span> <span class="n">repo</span><span class="p">,</span> <span class="n">name</span><span class="p">,</span> <span class="n">_</span><span class="p">,</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">MOE_MODELS</span><span class="p">}</span>
<span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">_</span><span class="p">,</span> <span class="n">name</span><span class="p">,</span> <span class="n">released</span><span class="p">,</span> <span class="n">sizes</span> <span class="ow">in</span> <span class="n">MOE_MODELS</span><span class="p">:</span>
    <span class="n">c</span> <span class="o">=</span> <span class="n">configs</span><span class="p">[</span><span class="n">name</span><span class="p">]</span>
    <span class="n">experts</span> <span class="o">=</span> <span class="nf">first</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="sh">"</span><span class="s">num_local_experts</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">num_experts</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">n_routed_experts</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">top_k</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_experts_per_tok</span><span class="sh">"</span><span class="p">]</span>
    <span class="n">shared</span> <span class="o">=</span> <span class="nf">first</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="sh">"</span><span class="s">n_shared_experts</span><span class="sh">"</span><span class="p">)</span>
    <span class="k">if</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">shared_expert_intermediate_size</span><span class="sh">"</span><span class="p">):</span>
        <span class="n">shared</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">shared_expert_intermediate_size</span><span class="sh">"</span><span class="p">]</span> <span class="o">//</span> <span class="nf">first</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="sh">"</span><span class="s">moe_intermediate_size</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
        <span class="p">{</span>
            <span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">released</span><span class="sh">"</span><span class="p">:</span> <span class="n">released</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">total / active</span><span class="sh">"</span><span class="p">:</span> <span class="n">sizes</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">layers</span><span class="sh">"</span><span class="p">:</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">],</span>
            <span class="sh">"</span><span class="s">dense layers</span><span class="sh">"</span><span class="p">:</span> <span class="nf">first</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="sh">"</span><span class="s">first_k_dense_replace</span><span class="sh">"</span><span class="p">),</span>
            <span class="sh">"</span><span class="s">experts</span><span class="sh">"</span><span class="p">:</span> <span class="n">experts</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">per token</span><span class="sh">"</span><span class="p">:</span> <span class="n">top_k</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">shared</span><span class="sh">"</span><span class="p">:</span> <span class="n">shared</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">expert width</span><span class="sh">"</span><span class="p">:</span> <span class="nf">first</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="sh">"</span><span class="s">moe_intermediate_size</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">),</span>
            <span class="sh">"</span><span class="s">model width</span><span class="sh">"</span><span class="p">:</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span>
            <span class="sh">"</span><span class="s">router</span><span class="sh">"</span><span class="p">:</span> <span class="nf">router_order</span><span class="p">(</span><span class="n">c</span><span class="p">),</span>
        <span class="p">}</span>
    <span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">model</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">released</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">total / active</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">layers</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">dense layers</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">experts</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">per token</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">shared</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">expert width</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">model width</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">router</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Mixtral 8x7B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2023-12</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">47B / 13B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">14,336</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4,096</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">softmax, top-k, renormalise</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Qwen1.5-MoE</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2024-03</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">14.3B / 2.7B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">24</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">60</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,408</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,048</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">softmax, top-k</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">DeepSeek-V2-Lite</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2024-05</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">15.7B / 2.4B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">27</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">64</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,408</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,048</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">softmax, top-k</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">OLMoE</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2024-09</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">6.9B / 1.3B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">16</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">64</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,024</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,048</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">softmax, top-k</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Granite 3.1 3B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2024-12</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">3.3B / 0.8B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">40</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">512</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,536</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">top-k, softmax</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">DeepSeek-V3</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2024-12</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">671B / 37B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">61</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">256</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,048</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7,168</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">sigmoid + bias, top-k, renormalise</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Qwen3-30B-A3B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2025-04</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">30.5B / 3.3B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">48</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">768</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,048</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">softmax, top-k, renormalise</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">gpt-oss-20b</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2025-08</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">20.9B / 3.6B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">24</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,880</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,880</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">top-k, softmax</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">gpt-oss-120b</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2025-08</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">116.8B / 5.1B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">36</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,880</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,880</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">top-k, softmax</td></tr></tbody></table></div> <p>Three things changed in under two years.</p> <p><em>The experts got smaller and more numerous.</em> Mixtral has eight experts as wide as a dense model’s feed-forward network and sends each token to two. OLMoE, Qwen3 and DeepSeek-V3 use 64 to 256 narrow experts and send each token to eight.</p> <p>DeepSeek’s argument for this, <em>fine-grained experts</em>, is combinatorial: two experts out of sixteen can be chosen in 120 ways, eight out of 64 in “4,426,165,368”<sup class="cite">[<a href="#ref-1" id="cite-1" data-ref="1" aria-label="Reference 1: Dai, D., Deng, C., Zhao, C., et al. (2024). DeepSeekMoE: towards ultimate expert specialization in mixture-of-experts language models. ACL 2024.">1</a>]</sup>, so a token gets a mix much closer to what it needs. gpt-oss went the other way, to 32 or 128 wide experts and four per token.</p> <p><em>Some models keep experts that every token uses.</em> DeepSeek’s <em>shared experts</em> hold the knowledge every token needs, so that the routed ones don’t each keep a copy of it: “Regardless of the router module, each token will be deterministically assigned to these shared experts.”</p> <p>Qwen1.5-MoE had them; Qwen3 dropped them; OLMoE tested one and found that “sharing an expert performs slightly worse”<sup class="cite">[<a href="#ref-2" id="cite-2" data-ref="2" aria-label="Reference 2: Muennighoff, N., Soldaini, L., Groeneveld, D., et al. (2024). OLMoE: open mixture-of-experts language models. ICLR 2025.">2</a>]</sup>.</p> <p><em>The routers disagree on the order of operations.</em> Some take a softmax over all experts and keep the top \(k\) probabilities; some keep the top \(k\) scores and take a softmax over those; DeepSeek-V3 scores experts with a sigmoid and adds a bias that only affects which experts are chosen. Section 2 shows which of these differences matter.</p> <p>Under the routing, every model here is the decoder of lesson 6 with its feed-forward network replaced. Attention, norms and positions don’t change, which is why the table has no column for them.</p> <h2 id="2-the-router-and-the-experts">2. The router and the experts</h2> <p>A mixture-of-experts layer computes, for a token vector \(x\) and experts \(E_1, \dots, E_n\),</p> \[y = \sum_{i \in \mathcal{T}} g_i(x)\, E_i(x),\] <p>where \(\mathcal{T}\) is the set of the \(k\) chosen experts and \(g_i\) their weights. The router is a single matrix \(W_r\) with one row per expert; its scores are \(s = W_r x\). The four routers of the table differ only in how they turn \(s\) into \(\mathcal{T}\) and \(g\).</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">softmax_topk</span><span class="p">(</span><span class="n">s</span><span class="p">,</span> <span class="n">k</span><span class="p">):</span>  <span class="c1"># OLMoE, Qwen1.5-MoE, DeepSeek-V2-Lite
</span>    <span class="n">weights</span><span class="p">,</span> <span class="n">chosen</span> <span class="o">=</span> <span class="n">s</span><span class="p">.</span><span class="nf">softmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">).</span><span class="nf">topk</span><span class="p">(</span><span class="n">k</span><span class="p">,</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">weights</span><span class="p">,</span> <span class="n">chosen</span>


<span class="k">def</span> <span class="nf">softmax_topk_renorm</span><span class="p">(</span><span class="n">s</span><span class="p">,</span> <span class="n">k</span><span class="p">):</span>  <span class="c1"># Mixtral, Qwen3
</span>    <span class="n">weights</span><span class="p">,</span> <span class="n">chosen</span> <span class="o">=</span> <span class="nf">softmax_topk</span><span class="p">(</span><span class="n">s</span><span class="p">,</span> <span class="n">k</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">weights</span> <span class="o">/</span> <span class="n">weights</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">),</span> <span class="n">chosen</span>


<span class="k">def</span> <span class="nf">topk_softmax</span><span class="p">(</span><span class="n">s</span><span class="p">,</span> <span class="n">k</span><span class="p">):</span>  <span class="c1"># Granite, gpt-oss
</span>    <span class="n">top</span><span class="p">,</span> <span class="n">chosen</span> <span class="o">=</span> <span class="n">s</span><span class="p">.</span><span class="nf">topk</span><span class="p">(</span><span class="n">k</span><span class="p">,</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">top</span><span class="p">.</span><span class="nf">softmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">),</span> <span class="n">chosen</span>


<span class="k">def</span> <span class="nf">sigmoid_bias</span><span class="p">(</span><span class="n">s</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">bias</span><span class="p">):</span>  <span class="c1"># DeepSeek-V3: the bias picks the experts, not their weights
</span>    <span class="n">affinity</span> <span class="o">=</span> <span class="n">s</span><span class="p">.</span><span class="nf">sigmoid</span><span class="p">()</span>
    <span class="n">chosen</span> <span class="o">=</span> <span class="p">(</span><span class="n">affinity</span> <span class="o">+</span> <span class="n">bias</span><span class="p">).</span><span class="nf">topk</span><span class="p">(</span><span class="n">k</span><span class="p">,</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">).</span><span class="n">indices</span>
    <span class="n">weights</span> <span class="o">=</span> <span class="n">affinity</span><span class="p">.</span><span class="nf">gather</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="n">chosen</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">weights</span> <span class="o">/</span> <span class="n">weights</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">),</span> <span class="n">chosen</span>


<span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="mi">0</span><span class="p">)</span>
<span class="n">s</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="mi">1000</span><span class="p">,</span> <span class="mi">64</span><span class="p">)</span> <span class="o">*</span> <span class="mi">2</span>  <span class="c1"># scores of 1,000 tokens for 64 experts
</span><span class="n">results</span> <span class="o">=</span> <span class="p">{</span>
    <span class="sh">"</span><span class="s">softmax, top-k</span><span class="sh">"</span><span class="p">:</span> <span class="nf">softmax_topk</span><span class="p">(</span><span class="n">s</span><span class="p">,</span> <span class="mi">8</span><span class="p">),</span>
    <span class="sh">"</span><span class="s">softmax, top-k, renormalise</span><span class="sh">"</span><span class="p">:</span> <span class="nf">softmax_topk_renorm</span><span class="p">(</span><span class="n">s</span><span class="p">,</span> <span class="mi">8</span><span class="p">),</span>
    <span class="sh">"</span><span class="s">top-k, softmax</span><span class="sh">"</span><span class="p">:</span> <span class="nf">topk_softmax</span><span class="p">(</span><span class="n">s</span><span class="p">,</span> <span class="mi">8</span><span class="p">),</span>
    <span class="sh">"</span><span class="s">sigmoid + bias, top-k, renormalise</span><span class="sh">"</span><span class="p">:</span> <span class="nf">sigmoid_bias</span><span class="p">(</span><span class="n">s</span><span class="p">,</span> <span class="mi">8</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="mi">64</span><span class="p">)),</span>
<span class="p">}</span>
<span class="n">reference_w</span><span class="p">,</span> <span class="n">reference_i</span> <span class="o">=</span> <span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">top-k, softmax</span><span class="sh">"</span><span class="p">]</span>
<span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="p">(</span><span class="n">w</span><span class="p">,</span> <span class="n">i</span><span class="p">)</span> <span class="ow">in</span> <span class="n">results</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
    <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
        <span class="p">{</span>
            <span class="sh">"</span><span class="s">router</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">same experts as top-k, softmax</span><span class="sh">"</span><span class="p">:</span> <span class="nf">bool</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">equal</span><span class="p">(</span><span class="n">i</span><span class="p">,</span> <span class="n">reference_i</span><span class="p">)),</span>
            <span class="sh">"</span><span class="s">largest weight difference</span><span class="sh">"</span><span class="p">:</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="n">w</span> <span class="o">-</span> <span class="n">reference_w</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">weights sum to</span><span class="sh">"</span><span class="p">:</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">w</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">).</span><span class="nf">mean</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">3</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span>
        <span class="p">}</span>
    <span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">router</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">same experts as top-k, softmax</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">largest weight difference</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">weights sum to</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">softmax, top-k</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">True</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2.23e-01</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.744</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">softmax, top-k, renormalise</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">True</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">1.79e-07</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">1.000</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">top-k, softmax</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">True</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.00e+00</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">1.000</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">sigmoid + bias, top-k, renormalise</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">True</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">8.51e-01</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">1.000</td></tr></tbody></table></div> <p>All four routers choose the same experts here, and that is no accident: a softmax and a sigmoid never change the order of the scores, and without a bias the top \(k\) scores stay the top \(k\) under any increasing function. They differ in the weights.</p> <p>Two of them are in fact one function: a softmax over all experts followed by renormalising the top \(k\) gives exactly what a softmax over the top \(k\) scores gives, because the experts left out cancel between numerator and denominator.</p> <p>Mixtral and Qwen3 on one side, Granite and gpt-oss on the other, write the same router in two orders. OLMoE’s is the odd one out: its eight weights add up to less than one, by however much probability the router gave to the experts it didn’t choose.</p> <p>DeepSeek-V3’s sigmoid gives yet other weights, and its bias, which is zero here, is what lets it steer the choice without touching them.</p> <p>The experts themselves are <a href="/blog/2026/transformer-architectures-05-t5/">lesson 5</a>’s <a href="/blog/2026/transformers-from-scratch-05-llama/">SwiGLU</a> network of the first course, one per expert, each much narrower than a dense model’s. The naive way to run a layer is to run every expert on every token and multiply most of the results by zero.</p> <p>The way that saves the compute groups the tokens by expert: sort the (token, expert) pairs by expert, run each expert once on its own group, and add each result back to its token, weighted.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">Experts</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="sh">"""</span><span class="s">n SwiGLU networks kept as two stacked weights, one row of experts per tensor.</span><span class="sh">"""</span>

    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">width</span><span class="p">,</span> <span class="n">hidden</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">gate_up</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span>
            <span class="n">torch</span><span class="p">.</span><span class="nf">empty</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">hidden</span><span class="p">,</span> <span class="n">width</span><span class="p">)</span>
        <span class="p">)</span>  <span class="c1"># gate rows, then up rows
</span>        <span class="n">self</span><span class="p">.</span><span class="n">down</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">empty</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="n">width</span><span class="p">,</span> <span class="n">hidden</span><span class="p">))</span>

    <span class="k">def</span> <span class="nf">run</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">e</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">gate</span><span class="p">,</span> <span class="n">up</span> <span class="o">=</span> <span class="p">(</span><span class="n">x</span> <span class="o">@</span> <span class="n">self</span><span class="p">.</span><span class="n">gate_up</span><span class="p">[</span><span class="n">e</span><span class="p">].</span><span class="n">T</span><span class="p">).</span><span class="nf">chunk</span><span class="p">(</span><span class="mi">2</span><span class="p">,</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
        <span class="nf">return </span><span class="p">(</span><span class="n">F</span><span class="p">.</span><span class="nf">silu</span><span class="p">(</span><span class="n">gate</span><span class="p">)</span> <span class="o">*</span> <span class="n">up</span><span class="p">)</span> <span class="o">@</span> <span class="n">self</span><span class="p">.</span><span class="n">down</span><span class="p">[</span><span class="n">e</span><span class="p">].</span><span class="n">T</span>


<span class="k">def</span> <span class="nf">dispatch</span><span class="p">(</span><span class="n">experts</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">weights</span><span class="p">,</span> <span class="n">chosen</span><span class="p">):</span>
    <span class="sh">"""</span><span class="s">Run each expert once, on the tokens that chose it; add the results back, weighted.</span><span class="sh">"""</span>
    <span class="n">k</span> <span class="o">=</span> <span class="n">chosen</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
    <span class="n">pairs</span> <span class="o">=</span> <span class="n">chosen</span><span class="p">.</span><span class="nf">flatten</span><span class="p">()</span>
    <span class="n">order</span> <span class="o">=</span> <span class="n">pairs</span><span class="p">.</span><span class="nf">argsort</span><span class="p">(</span><span class="n">stable</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">tokens</span> <span class="o">=</span> <span class="n">order</span> <span class="o">//</span> <span class="n">k</span>  <span class="c1"># the token each sorted pair came from
</span>    <span class="n">w</span> <span class="o">=</span> <span class="n">weights</span><span class="p">.</span><span class="nf">flatten</span><span class="p">()[</span><span class="n">order</span><span class="p">]</span>
    <span class="n">counts</span> <span class="o">=</span> <span class="n">pairs</span><span class="p">.</span><span class="nf">bincount</span><span class="p">(</span><span class="n">minlength</span><span class="o">=</span><span class="n">experts</span><span class="p">.</span><span class="n">gate_up</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]).</span><span class="nf">tolist</span><span class="p">()</span>
    <span class="n">out</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros_like</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>
    <span class="n">start</span> <span class="o">=</span> <span class="mi">0</span>
    <span class="k">for</span> <span class="n">e</span><span class="p">,</span> <span class="n">n</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">counts</span><span class="p">):</span>
        <span class="k">if</span> <span class="n">n</span><span class="p">:</span>
            <span class="n">rows</span> <span class="o">=</span> <span class="n">tokens</span><span class="p">[</span><span class="n">start</span> <span class="p">:</span> <span class="n">start</span> <span class="o">+</span> <span class="n">n</span><span class="p">]</span>
            <span class="n">out</span><span class="p">.</span><span class="nf">index_add_</span><span class="p">(</span>
                <span class="mi">0</span><span class="p">,</span> <span class="n">rows</span><span class="p">,</span> <span class="p">(</span><span class="n">experts</span><span class="p">.</span><span class="nf">run</span><span class="p">(</span><span class="n">e</span><span class="p">,</span> <span class="n">x</span><span class="p">[</span><span class="n">rows</span><span class="p">])</span> <span class="o">*</span> <span class="n">w</span><span class="p">[</span><span class="n">start</span> <span class="p">:</span> <span class="n">start</span> <span class="o">+</span> <span class="n">n</span><span class="p">,</span> <span class="bp">None</span><span class="p">]).</span><span class="nf">to</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span>
            <span class="p">)</span>
        <span class="n">start</span> <span class="o">+=</span> <span class="n">n</span>
    <span class="k">return</span> <span class="n">out</span>


<span class="k">def</span> <span class="nf">dense_run</span><span class="p">(</span><span class="n">experts</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">weights</span><span class="p">,</span> <span class="n">chosen</span><span class="p">):</span>
    <span class="sh">"""</span><span class="s">The same layer computed the wasteful way: every expert on every token.</span><span class="sh">"""</span>
    <span class="n">n</span> <span class="o">=</span> <span class="n">experts</span><span class="p">.</span><span class="n">gate_up</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
    <span class="n">gate</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="n">n</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">weights</span><span class="p">.</span><span class="n">dtype</span><span class="p">).</span><span class="nf">scatter</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">chosen</span><span class="p">,</span> <span class="n">weights</span><span class="p">)</span>
    <span class="n">outputs</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">(</span>
        <span class="p">[</span><span class="n">experts</span><span class="p">.</span><span class="nf">run</span><span class="p">(</span><span class="n">e</span><span class="p">,</span> <span class="n">x</span><span class="p">)</span> <span class="k">for</span> <span class="n">e</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n</span><span class="p">)],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span>
    <span class="p">)</span>  <span class="c1"># tokens x experts x width
</span>    <span class="nf">return </span><span class="p">(</span><span class="n">outputs</span> <span class="o">*</span> <span class="n">gate</span><span class="p">[...,</span> <span class="bp">None</span><span class="p">]).</span><span class="nf">sum</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>


<span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="mi">0</span><span class="p">)</span>
<span class="n">toy</span> <span class="o">=</span> <span class="nc">Experts</span><span class="p">(</span><span class="mi">64</span><span class="p">,</span> <span class="mi">256</span><span class="p">,</span> <span class="mi">128</span><span class="p">)</span>
<span class="n">nn</span><span class="p">.</span><span class="n">init</span><span class="p">.</span><span class="nf">normal_</span><span class="p">(</span><span class="n">toy</span><span class="p">.</span><span class="n">gate_up</span><span class="p">,</span> <span class="n">std</span><span class="o">=</span><span class="mf">0.05</span><span class="p">)</span>
<span class="n">nn</span><span class="p">.</span><span class="n">init</span><span class="p">.</span><span class="nf">normal_</span><span class="p">(</span><span class="n">toy</span><span class="p">.</span><span class="n">down</span><span class="p">,</span> <span class="n">std</span><span class="o">=</span><span class="mf">0.05</span><span class="p">)</span>
<span class="n">x</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="mi">512</span><span class="p">,</span> <span class="mi">256</span><span class="p">)</span>
<span class="n">weights</span><span class="p">,</span> <span class="n">chosen</span> <span class="o">=</span> <span class="nf">softmax_topk</span><span class="p">(</span><span class="n">x</span> <span class="o">@</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="mi">256</span><span class="p">,</span> <span class="mi">64</span><span class="p">)</span> <span class="o">*</span> <span class="mf">0.1</span><span class="p">,</span> <span class="mi">8</span><span class="p">)</span>
<span class="n">timings</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">fn</span> <span class="ow">in</span> <span class="p">[</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">every expert on every token</span><span class="sh">"</span><span class="p">,</span> <span class="n">dense_run</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">grouped by expert</span><span class="sh">"</span><span class="p">,</span> <span class="n">dispatch</span><span class="p">),</span>
<span class="p">]:</span>
    <span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="n">y</span> <span class="o">=</span> <span class="nf">fn</span><span class="p">(</span><span class="n">toy</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">weights</span><span class="p">,</span> <span class="n">chosen</span><span class="p">)</span>
    <span class="n">timings</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="o">=</span> <span class="p">(</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="p">,</span> <span class="n">y</span><span class="p">)</span>
<span class="n">difference</span> <span class="o">=</span> <span class="p">(</span>
    <span class="p">(</span><span class="n">timings</span><span class="p">[</span><span class="sh">"</span><span class="s">grouped by expert</span><span class="sh">"</span><span class="p">][</span><span class="mi">1</span><span class="p">]</span> <span class="o">-</span> <span class="n">timings</span><span class="p">[</span><span class="sh">"</span><span class="s">every expert on every token</span><span class="sh">"</span><span class="p">][</span><span class="mi">1</span><span class="p">])</span>
    <span class="p">.</span><span class="nf">abs</span><span class="p">()</span>
    <span class="p">.</span><span class="nf">max</span><span class="p">()</span>
<span class="p">)</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="p">(</span><span class="n">seconds</span><span class="p">,</span> <span class="n">_</span><span class="p">)</span> <span class="ow">in</span> <span class="n">timings</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">name</span><span class="si">:</span><span class="mi">28</span><span class="si">}</span><span class="s"> </span><span class="si">{</span><span class="n">seconds</span> <span class="o">*</span> <span class="mi">1000</span><span class="si">:</span><span class="mf">7.1</span><span class="n">f</span><span class="si">}</span><span class="s"> ms</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">max difference:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">difference</span><span class="p">.</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>every expert on every token    153.9 ms
grouped by expert               63.0 ms
max difference: 5.96e-08</code></pre> <p>The two ways agree to the last digits a 32-bit float carries, and grouping by expert is already faster on a CPU even at this toy size, though each expert sees only a few dozen tokens.</p> <p>The gap grows with the number of experts: the wasteful way pays for all of them, the grouped one for the eight a token chose.</p> <p>Production kernels go further and run all the groups in one <em>grouped</em> matrix multiplication, but the arithmetic is the one above. How the router is kept from sending everything to a few favourites, the auxiliary loss of Switch Transformer and the bias of DeepSeek-V3, is in the blog post linked at the top; OLMoE was trained with the loss.</p> <h2 id="3-olmoe-in-pytorch">3. OLMoE in PyTorch</h2> <p>OLMoE comes from the Allen Institute for AI, which published everything needed to rebuild it: the weights, the training data, the code and the logs. It is “a fully open, state-of-the-art language model” with “6.9B total parameters, of which only 1.3B are activated”, trained on “5.1 trillion tokens”<sup class="cite">[<a href="#ref-2" id="cite-3" data-ref="2" aria-label="Reference 2: Muennighoff, N., Soldaini, L., Groeneveld, D., et al. (2024). OLMoE: open mixture-of-experts language models. ICLR 2025.">2</a>]</sup>. Its config:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">REPO</span> <span class="o">=</span> <span class="sh">"</span><span class="s">allenai/OLMoE-1B-7B-0924</span><span class="sh">"</span>
<span class="n">olmoe_config</span> <span class="o">=</span> <span class="n">configs</span><span class="p">[</span><span class="sh">"</span><span class="s">OLMoE</span><span class="sh">"</span><span class="p">]</span>
<span class="n">olmoe_config</span><span class="p">.</span><span class="nf">setdefault</span><span class="p">(</span><span class="sh">"</span><span class="s">rms_norm_eps</span><span class="sh">"</span><span class="p">,</span> <span class="mf">1e-5</span><span class="p">)</span>  <span class="c1"># not in the config: the library default
</span><span class="n">keys</span> <span class="o">=</span> <span class="p">[</span>
    <span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">num_key_value_heads</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">num_experts</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">num_experts_per_tok</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">norm_topk_prob</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">tie_word_embeddings</span><span class="sh">"</span><span class="p">,</span>
<span class="p">]</span>
<span class="k">for</span> <span class="n">key</span> <span class="ow">in</span> <span class="n">keys</span><span class="p">:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">key</span><span class="si">:</span><span class="mi">22</span><span class="si">}</span><span class="s"> </span><span class="si">{</span><span class="n">olmoe_config</span><span class="p">[</span><span class="n">key</span><span class="p">]</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="sh">'</span><span class="s">rope_theta</span><span class="sh">'</span><span class="si">:</span><span class="mi">22</span><span class="si">}</span><span class="s"> </span><span class="si">{</span><span class="n">olmoe_config</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">'</span><span class="s">rope_theta</span><span class="sh">'</span><span class="p">)</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>hidden_size            2048
num_hidden_layers      16
num_attention_heads    16
num_key_value_heads    16
num_experts            64
num_experts_per_tok    8
intermediate_size      1024
vocab_size             50304
norm_topk_prob         False
tie_word_embeddings    False
rope_theta             10000.0</code></pre> <p>Sixteen heads with sixteen key-value heads: OLMoE uses plain <a href="/blog/2026/transformers-from-scratch-02-transformer/">multi-head attention</a>, not lesson 6’s grouped queries. It does use QK-norm, with one difference from Qwen3: the norm runs over the whole query and key projections, 2,048 numbers each, before they are split into heads.</p> <p>The router takes a softmax over all 64 experts and keeps the eight largest probabilities <em>without</em> renormalising them, so a token whose router is unsure gets a smaller total update from its experts than one whose router is sure.</p> <p>Everything outside the experts is lesson 6’s code with those two changes. One more change is for the GPU, not the model: the residual stream is kept in 32-bit floats between layers.</p> <p>OLMoE was trained in bfloat16, which has a much wider range than the float16 a T4 offers, and the residual stream, a running sum over 32 sublayers, is where large values build up.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">dim</span><span class="p">,</span> <span class="n">eps</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">eps</span> <span class="o">=</span> <span class="n">eps</span>
        <span class="n">self</span><span class="p">.</span><span class="n">weight</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">dim</span><span class="p">))</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">x32</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="nf">float</span><span class="p">()</span>
        <span class="n">x32</span> <span class="o">=</span> <span class="n">x32</span> <span class="o">*</span> <span class="n">torch</span><span class="p">.</span><span class="nf">rsqrt</span><span class="p">(</span><span class="n">x32</span><span class="p">.</span><span class="nf">pow</span><span class="p">(</span><span class="mi">2</span><span class="p">).</span><span class="nf">mean</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">eps</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="n">weight</span> <span class="o">*</span> <span class="n">x32</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">rope_tables</span><span class="p">(</span><span class="n">positions</span><span class="p">,</span> <span class="n">head_dim</span><span class="p">,</span> <span class="n">theta</span><span class="p">):</span>
    <span class="n">exponents</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">head_dim</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">positions</span><span class="p">.</span><span class="n">device</span><span class="p">).</span><span class="nf">float</span><span class="p">()</span> <span class="o">/</span> <span class="n">head_dim</span>
    <span class="n">angles</span> <span class="o">=</span> <span class="n">positions</span><span class="p">.</span><span class="nf">float</span><span class="p">()[...,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">/</span> <span class="n">theta</span><span class="o">**</span><span class="n">exponents</span>
    <span class="n">angles</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">angles</span><span class="p">,</span> <span class="n">angles</span><span class="p">],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">angles</span><span class="p">.</span><span class="nf">cos</span><span class="p">()[:,</span> <span class="bp">None</span><span class="p">],</span> <span class="n">angles</span><span class="p">.</span><span class="nf">sin</span><span class="p">()[:,</span> <span class="bp">None</span><span class="p">]</span>


<span class="k">def</span> <span class="nf">rotate</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">):</span>
    <span class="n">half</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span> <span class="o">//</span> <span class="mi">2</span>
    <span class="n">rotated</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="o">-</span><span class="n">x</span><span class="p">[...,</span> <span class="n">half</span><span class="p">:],</span> <span class="n">x</span><span class="p">[...,</span> <span class="p">:</span><span class="n">half</span><span class="p">]],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">x</span> <span class="o">*</span> <span class="n">cos</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span> <span class="o">+</span> <span class="n">rotated</span> <span class="o">*</span> <span class="n">sin</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span>


<span class="k">class</span> <span class="nc">Attention</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span> <span class="o">=</span> <span class="n">d</span> <span class="o">//</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span>
        <span class="n">self</span><span class="p">.</span><span class="n">q_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">k_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">v_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">o_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">q_norm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span>
            <span class="n">d</span><span class="p">,</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">rms_norm_eps</span><span class="sh">"</span><span class="p">]</span>
        <span class="p">)</span>  <span class="c1"># over the whole projection, before the heads
</span>        <span class="n">self</span><span class="p">.</span><span class="n">k_norm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">rms_norm_eps</span><span class="sh">"</span><span class="p">])</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">,</span> <span class="n">mask</span><span class="p">):</span>
        <span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span>
        <span class="n">shape</span> <span class="o">=</span> <span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">)</span>
        <span class="n">q</span> <span class="o">=</span> <span class="nf">rotate</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">q_norm</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">q_proj</span><span class="p">(</span><span class="n">x</span><span class="p">)).</span><span class="nf">view</span><span class="p">(</span><span class="n">shape</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">),</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">)</span>
        <span class="n">k</span> <span class="o">=</span> <span class="nf">rotate</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">k_norm</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">k_proj</span><span class="p">(</span><span class="n">x</span><span class="p">)).</span><span class="nf">view</span><span class="p">(</span><span class="n">shape</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">),</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">)</span>
        <span class="n">v</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">v_proj</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">view</span><span class="p">(</span><span class="n">shape</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
        <span class="n">out</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">scaled_dot_product_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">,</span> <span class="n">attn_mask</span><span class="o">=</span><span class="n">mask</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">o_proj</span><span class="p">(</span><span class="n">out</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">))</span>


<span class="k">class</span> <span class="nc">MoE</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span><span class="p">,</span> <span class="n">n</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_experts</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">k</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_experts_per_tok</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">gate</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>  <span class="c1"># the router
</span>        <span class="n">self</span><span class="p">.</span><span class="n">experts</span> <span class="o">=</span> <span class="nc">Experts</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="bp">None</span>  <span class="c1"># section 5: a mask of the experts a pruned model still has
</span>        <span class="n">self</span><span class="p">.</span><span class="n">trace</span> <span class="o">=</span> <span class="bp">None</span>  <span class="c1"># section 4: a list that collects every token's chosen experts
</span>
    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">d</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span>
        <span class="n">flat</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="nf">reshape</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">scores</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">gate</span><span class="p">(</span><span class="n">flat</span><span class="p">).</span><span class="nf">float</span><span class="p">()</span>
        <span class="k">if</span> <span class="n">self</span><span class="p">.</span><span class="n">keep</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
            <span class="n">scores</span> <span class="o">=</span> <span class="n">scores</span><span class="p">.</span><span class="nf">masked_fill</span><span class="p">(</span><span class="o">~</span><span class="n">self</span><span class="p">.</span><span class="n">keep</span><span class="p">,</span> <span class="nf">float</span><span class="p">(</span><span class="sh">"</span><span class="s">-inf</span><span class="sh">"</span><span class="p">))</span>
        <span class="n">weights</span><span class="p">,</span> <span class="n">chosen</span> <span class="o">=</span> <span class="nf">softmax_topk</span><span class="p">(</span><span class="n">scores</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">k</span><span class="p">)</span>  <span class="c1"># no renormalisation in OLMoE
</span>        <span class="k">if</span> <span class="n">self</span><span class="p">.</span><span class="n">trace</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
            <span class="n">self</span><span class="p">.</span><span class="n">trace</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">chosen</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="n">uint8</span><span class="p">).</span><span class="nf">cpu</span><span class="p">())</span>
        <span class="k">return</span> <span class="nf">dispatch</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">experts</span><span class="p">,</span> <span class="n">flat</span><span class="p">,</span> <span class="n">weights</span><span class="p">,</span> <span class="n">chosen</span><span class="p">).</span><span class="nf">view</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">d</span><span class="p">)</span>


<span class="k">class</span> <span class="nc">Block</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">input_layernorm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">rms_norm_eps</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">self_attn</span> <span class="o">=</span> <span class="nc">Attention</span><span class="p">(</span><span class="n">c</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">post_attention_layernorm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">rms_norm_eps</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">mlp</span> <span class="o">=</span> <span class="nc">MoE</span><span class="p">(</span><span class="n">c</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">,</span> <span class="n">mask</span><span class="p">):</span>  <span class="c1"># x: the residual stream, in 32-bit floats
</span>        <span class="n">x</span> <span class="o">=</span> <span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">self_attn</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">input_layernorm</span><span class="p">(</span><span class="n">x</span><span class="p">),</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">,</span> <span class="n">mask</span><span class="p">).</span><span class="nf">float</span><span class="p">()</span>
        <span class="k">return</span> <span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">mlp</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">post_attention_layernorm</span><span class="p">(</span><span class="n">x</span><span class="p">)).</span><span class="nf">float</span><span class="p">()</span>


<span class="k">class</span> <span class="nc">OLMoE</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">config</span> <span class="o">=</span> <span class="n">c</span>
        <span class="n">self</span><span class="p">.</span><span class="n">embed_tokens</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">layers</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">ModuleList</span><span class="p">([</span><span class="nc">Block</span><span class="p">(</span><span class="n">c</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">])])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">rms_norm_eps</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">lm_head</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">hidden</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">mask</span><span class="p">):</span>
        <span class="n">c</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">config</span>
        <span class="n">positions</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="n">device</span><span class="o">=</span><span class="n">ids</span><span class="p">.</span><span class="n">device</span><span class="p">)[</span><span class="bp">None</span><span class="p">]</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">embed_tokens</span><span class="p">(</span><span class="n">ids</span><span class="p">).</span><span class="nf">float</span><span class="p">()</span>
        <span class="n">tables</span> <span class="o">=</span> <span class="p">{}</span>
        <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">self</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
            <span class="n">where</span> <span class="o">=</span> <span class="n">layer</span><span class="p">.</span><span class="n">input_layernorm</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">device</span>  <span class="c1"># layers may sit on different GPUs
</span>            <span class="k">if</span> <span class="n">where</span> <span class="ow">not</span> <span class="ow">in</span> <span class="n">tables</span><span class="p">:</span>
                <span class="n">theta</span> <span class="o">=</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">rope_theta</span><span class="sh">"</span><span class="p">)</span> <span class="ow">or</span> <span class="mf">10000.0</span>
                <span class="n">tables</span><span class="p">[</span><span class="n">where</span><span class="p">]</span> <span class="o">=</span> <span class="nf">rope_tables</span><span class="p">(</span>
                    <span class="n">positions</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">where</span><span class="p">),</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">]</span> <span class="o">//</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">],</span> <span class="n">theta</span>
                <span class="p">)</span>
            <span class="n">x</span> <span class="o">=</span> <span class="nf">layer</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">where</span><span class="p">),</span> <span class="o">*</span><span class="n">tables</span><span class="p">[</span><span class="n">where</span><span class="p">],</span> <span class="n">mask</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">where</span><span class="p">))</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">norm</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">device</span><span class="p">))</span>

    <span class="k">def</span> <span class="nf">logits</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">h</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">lm_head</span><span class="p">(</span><span class="n">h</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">lm_head</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">device</span><span class="p">)).</span><span class="nf">float</span><span class="p">()</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">mask</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">logits</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">hidden</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">mask</span><span class="p">))</span>
</code></pre></div></div> <p>The checkpoint stores each expert’s three matrices separately, 3,072 tensors in all; we stack them into the two tensors per layer that <code class="language-plaintext highlighter-rouge">Experts</code> keeps.</p> <p>The weights go straight from each file to the GPU that will use them, so the 13 GB never sit in the machine’s memory at once: the first half of the layers lives on the first T4, the second half and the output layer on the second.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">placement</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="n">gpus</span><span class="p">):</span>
    <span class="n">n</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">]</span>
    <span class="k">return</span> <span class="p">{</span><span class="n">i</span><span class="p">:</span> <span class="n">gpus</span><span class="p">[</span><span class="n">i</span> <span class="o">*</span> <span class="nf">len</span><span class="p">(</span><span class="n">gpus</span><span class="p">)</span> <span class="o">//</span> <span class="n">n</span><span class="p">]</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n</span><span class="p">)}</span>


<span class="k">def</span> <span class="nf">checkpoint_files</span><span class="p">(</span><span class="n">source</span><span class="p">):</span>
    <span class="k">if</span> <span class="nc">Path</span><span class="p">(</span><span class="n">source</span><span class="p">).</span><span class="nf">is_dir</span><span class="p">():</span>  <span class="c1"># a model saved to disk (the smoke run builds a small one)
</span>        <span class="k">return</span> <span class="nf">sorted</span><span class="p">(</span><span class="nf">str</span><span class="p">(</span><span class="n">p</span><span class="p">)</span> <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="nc">Path</span><span class="p">(</span><span class="n">source</span><span class="p">).</span><span class="nf">glob</span><span class="p">(</span><span class="sh">"</span><span class="s">*.safetensors</span><span class="sh">"</span><span class="p">))</span>
    <span class="k">try</span><span class="p">:</span>
        <span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">source</span><span class="p">,</span> <span class="sh">"</span><span class="s">model.safetensors.index.json</span><span class="sh">"</span><span class="p">))</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
            <span class="n">names</span> <span class="o">=</span> <span class="nf">sorted</span><span class="p">(</span><span class="nf">set</span><span class="p">(</span><span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">f</span><span class="p">)[</span><span class="sh">"</span><span class="s">weight_map</span><span class="sh">"</span><span class="p">].</span><span class="nf">values</span><span class="p">()))</span>
    <span class="k">except</span> <span class="nb">Exception</span><span class="p">:</span>
        <span class="n">names</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">model.safetensors</span><span class="sh">"</span><span class="p">]</span>
    <span class="k">return</span> <span class="p">[</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">source</span><span class="p">,</span> <span class="n">name</span><span class="p">)</span> <span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">names</span><span class="p">]</span>


<span class="k">def</span> <span class="nf">load_olmoe</span><span class="p">(</span><span class="n">source</span><span class="p">,</span> <span class="n">c</span><span class="p">,</span> <span class="n">dtype</span><span class="p">,</span> <span class="n">gpus</span><span class="p">):</span>
    <span class="n">where</span> <span class="o">=</span> <span class="nf">placement</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="n">gpus</span><span class="p">)</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">device</span><span class="p">(</span><span class="sh">"</span><span class="s">meta</span><span class="sh">"</span><span class="p">):</span>
        <span class="n">model</span> <span class="o">=</span> <span class="nc">OLMoE</span><span class="p">(</span><span class="n">c</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">target</span><span class="p">(</span><span class="n">key</span><span class="p">):</span>
        <span class="n">match</span> <span class="o">=</span> <span class="n">re</span><span class="p">.</span><span class="nf">match</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s">layers\.(\d+)\.</span><span class="sh">"</span><span class="p">,</span> <span class="n">key</span><span class="p">)</span>
        <span class="nf">return </span><span class="p">(</span>
            <span class="n">where</span><span class="p">[</span><span class="nf">int</span><span class="p">(</span><span class="n">match</span><span class="p">.</span><span class="nf">group</span><span class="p">(</span><span class="mi">1</span><span class="p">))]</span>
            <span class="k">if</span> <span class="n">match</span>
            <span class="nf">else </span><span class="p">(</span><span class="n">gpus</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span> <span class="k">if</span> <span class="sh">"</span><span class="s">embed</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">key</span> <span class="k">else</span> <span class="n">gpus</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">])</span>
        <span class="p">)</span>

    <span class="n">state</span><span class="p">,</span> <span class="n">pending</span> <span class="o">=</span> <span class="p">{},</span> <span class="p">{}</span>
    <span class="n">n</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_experts</span><span class="sh">"</span><span class="p">]</span>
    <span class="k">for</span> <span class="n">path</span> <span class="ow">in</span> <span class="nf">checkpoint_files</span><span class="p">(</span><span class="n">source</span><span class="p">):</span>
        <span class="k">for</span> <span class="n">key</span><span class="p">,</span> <span class="n">value</span> <span class="ow">in</span> <span class="nf">load_file</span><span class="p">(</span><span class="n">path</span><span class="p">).</span><span class="nf">items</span><span class="p">():</span>
            <span class="n">key</span> <span class="o">=</span> <span class="n">key</span><span class="p">.</span><span class="nf">removeprefix</span><span class="p">(</span><span class="sh">"</span><span class="s">model.</span><span class="sh">"</span><span class="p">)</span>
            <span class="n">expert</span> <span class="o">=</span> <span class="n">re</span><span class="p">.</span><span class="nf">match</span><span class="p">(</span>
                <span class="sa">r</span><span class="sh">"</span><span class="s">(layers\.\d+\.mlp\.experts)\.(\d+)\.(gate|up|down)_proj\.weight</span><span class="sh">"</span><span class="p">,</span> <span class="n">key</span>
            <span class="p">)</span>
            <span class="k">if</span> <span class="n">expert</span><span class="p">:</span>  <span class="c1"># one expert's matrix: wait for all of them, then stack
</span>                <span class="n">prefix</span><span class="p">,</span> <span class="n">e</span><span class="p">,</span> <span class="n">part</span> <span class="o">=</span> <span class="n">expert</span><span class="p">.</span><span class="nf">group</span><span class="p">(</span><span class="mi">1</span><span class="p">),</span> <span class="nf">int</span><span class="p">(</span><span class="n">expert</span><span class="p">.</span><span class="nf">group</span><span class="p">(</span><span class="mi">2</span><span class="p">)),</span> <span class="n">expert</span><span class="p">.</span><span class="nf">group</span><span class="p">(</span><span class="mi">3</span><span class="p">)</span>
                <span class="n">pending</span><span class="p">.</span><span class="nf">setdefault</span><span class="p">(</span><span class="n">prefix</span><span class="p">,</span> <span class="p">{})[(</span><span class="n">e</span><span class="p">,</span> <span class="n">part</span><span class="p">)]</span> <span class="o">=</span> <span class="n">value</span>
                <span class="n">parts</span> <span class="o">=</span> <span class="n">pending</span><span class="p">[</span><span class="n">prefix</span><span class="p">]</span>
                <span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="n">parts</span><span class="p">)</span> <span class="o">==</span> <span class="mi">3</span> <span class="o">*</span> <span class="n">n</span><span class="p">:</span>
                    <span class="n">device</span> <span class="o">=</span> <span class="nf">target</span><span class="p">(</span><span class="n">prefix</span><span class="p">)</span>
                    <span class="n">gate_up</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">(</span>
                        <span class="p">[</span>
                            <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">parts</span><span class="p">[(</span><span class="n">e</span><span class="p">,</span> <span class="sh">"</span><span class="s">gate</span><span class="sh">"</span><span class="p">)],</span> <span class="n">parts</span><span class="p">[(</span><span class="n">e</span><span class="p">,</span> <span class="sh">"</span><span class="s">up</span><span class="sh">"</span><span class="p">)]])</span>
                            <span class="k">for</span> <span class="n">e</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n</span><span class="p">)</span>
                        <span class="p">]</span>
                    <span class="p">)</span>
                    <span class="n">down</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">([</span><span class="n">parts</span><span class="p">[(</span><span class="n">e</span><span class="p">,</span> <span class="sh">"</span><span class="s">down</span><span class="sh">"</span><span class="p">)]</span> <span class="k">for</span> <span class="n">e</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n</span><span class="p">)])</span>
                    <span class="n">state</span><span class="p">[</span><span class="n">prefix</span> <span class="o">+</span> <span class="sh">"</span><span class="s">.gate_up</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">gate_up</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="p">)</span>
                    <span class="n">state</span><span class="p">[</span><span class="n">prefix</span> <span class="o">+</span> <span class="sh">"</span><span class="s">.down</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">down</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="p">)</span>
                    <span class="k">del</span> <span class="n">pending</span><span class="p">[</span><span class="n">prefix</span><span class="p">]</span>
                <span class="k">continue</span>
            <span class="n">key</span> <span class="o">=</span> <span class="n">key</span><span class="p">.</span><span class="nf">replace</span><span class="p">(</span><span class="sh">"</span><span class="s">experts.gate_up_proj</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">experts.gate_up</span><span class="sh">"</span><span class="p">)</span>  <span class="c1"># already stacked
</span>            <span class="n">key</span> <span class="o">=</span> <span class="n">key</span><span class="p">.</span><span class="nf">replace</span><span class="p">(</span><span class="sh">"</span><span class="s">experts.down_proj</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">experts.down</span><span class="sh">"</span><span class="p">)</span>
            <span class="n">state</span><span class="p">[</span><span class="n">key</span><span class="p">]</span> <span class="o">=</span> <span class="n">value</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="nf">target</span><span class="p">(</span><span class="n">key</span><span class="p">),</span> <span class="n">dtype</span><span class="p">)</span>
    <span class="n">model</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">(</span><span class="n">state</span><span class="p">,</span> <span class="n">strict</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">assign</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">model</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>
</code></pre></div></div> <p>The check, as always: the same tokens through our model and through Hugging Face’s. Two copies of OLMoE don’t fit on two T4s together, so Hugging Face’s runs first, in a separate process, saves its logits and exits.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">tok</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">REPO</span><span class="p">)</span>
<span class="n">text</span> <span class="o">=</span> <span class="p">(</span>
    <span class="sh">"</span><span class="s">The Rhine rises in the Swiss Alps, flows through Lake Constance and along </span><span class="sh">"</span>
    <span class="sh">"</span><span class="s">the French–German border, and reaches the North Sea through a delta in the </span><span class="sh">"</span>
    <span class="sh">"</span><span class="s">Netherlands.</span><span class="sh">"</span>
<span class="p">)</span>
<span class="n">check_ids</span> <span class="o">=</span> <span class="nf">tok</span><span class="p">(</span><span class="n">text</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="n">input_ids</span>
<span class="n">torch</span><span class="p">.</span><span class="nf">save</span><span class="p">(</span><span class="n">check_ids</span><span class="p">,</span> <span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">check_ids.pt</span><span class="sh">"</span><span class="p">)</span>

<span class="k">if</span> <span class="n">SMOKE</span><span class="p">:</span>  <span class="c1"># a small OLMoE with random weights stands in for the real one
</span>    <span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">OlmoeConfig</span><span class="p">,</span> <span class="n">OlmoeForCausalLM</span>

    <span class="n">small</span> <span class="o">=</span> <span class="nc">OlmoeConfig</span><span class="p">(</span>
        <span class="n">vocab_size</span><span class="o">=</span><span class="n">olmoe_config</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span>
        <span class="n">hidden_size</span><span class="o">=</span><span class="mi">64</span><span class="p">,</span>
        <span class="n">intermediate_size</span><span class="o">=</span><span class="mi">32</span><span class="p">,</span>
        <span class="n">num_hidden_layers</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span>
        <span class="n">num_attention_heads</span><span class="o">=</span><span class="mi">4</span><span class="p">,</span>
        <span class="n">num_key_value_heads</span><span class="o">=</span><span class="mi">4</span><span class="p">,</span>
        <span class="n">num_experts</span><span class="o">=</span><span class="mi">16</span><span class="p">,</span>
        <span class="n">num_experts_per_tok</span><span class="o">=</span><span class="mi">4</span><span class="p">,</span>
        <span class="n">eos_token_id</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span>
        <span class="n">pad_token_id</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span>
    <span class="p">)</span>
    <span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="mi">0</span><span class="p">)</span>
    <span class="n">reference</span> <span class="o">=</span> <span class="nc">OlmoeForCausalLM</span><span class="p">(</span><span class="n">small</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
    <span class="n">SOURCE</span> <span class="o">=</span> <span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">olmoe-small</span><span class="sh">"</span>
    <span class="n">reference</span><span class="p">.</span><span class="nf">save_pretrained</span><span class="p">(</span><span class="n">SOURCE</span><span class="p">)</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="n">theirs</span> <span class="o">=</span> <span class="nf">reference</span><span class="p">(</span><span class="n">check_ids</span><span class="p">).</span><span class="n">logits</span><span class="p">.</span><span class="nf">float</span><span class="p">()</span>
    <span class="n">olmoe_config</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">loads</span><span class="p">((</span><span class="n">SOURCE</span> <span class="o">/</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">).</span><span class="nf">read_text</span><span class="p">())</span>
    <span class="n">olmoe_config</span><span class="p">.</span><span class="nf">setdefault</span><span class="p">(</span><span class="sh">"</span><span class="s">rope_theta</span><span class="sh">"</span><span class="p">,</span> <span class="mf">10000.0</span><span class="p">)</span>
<span class="k">else</span><span class="p">:</span>
    <span class="n">SOURCE</span> <span class="o">=</span> <span class="n">REPO</span>
    <span class="n">script</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"""</span><span class="s">
import torch
from transformers import AutoModelForCausalLM
model = AutoModelForCausalLM.from_pretrained(
    </span><span class="sh">"</span><span class="si">{</span><span class="n">REPO</span><span class="si">}</span><span class="sh">"</span><span class="s">, dtype=torch.float16, device_map=</span><span class="sh">"</span><span class="s">auto</span><span class="sh">"</span><span class="s">)
ids = torch.load(</span><span class="sh">"</span><span class="si">{</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">check_ids.pt</span><span class="sh">"</span><span class="si">}</span><span class="sh">"</span><span class="s">).to(</span><span class="sh">"</span><span class="s">cuda:0</span><span class="sh">"</span><span class="s">)
with torch.no_grad():
    torch.save(model(ids).logits.float().cpu(), </span><span class="sh">"</span><span class="si">{</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">theirs.pt</span><span class="sh">"</span><span class="si">}</span><span class="sh">"</span><span class="s">)
</span><span class="sh">"""</span>
    <span class="n">subprocess</span><span class="p">.</span><span class="nf">run</span><span class="p">([</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">-c</span><span class="sh">"</span><span class="p">,</span> <span class="n">script</span><span class="p">],</span> <span class="n">check</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">theirs</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">theirs.pt</span><span class="sh">"</span><span class="p">)</span>

<span class="n">model</span> <span class="o">=</span> <span class="nf">load_olmoe</span><span class="p">(</span><span class="n">SOURCE</span><span class="p">,</span> <span class="n">olmoe_config</span><span class="p">,</span> <span class="n">HALF</span><span class="p">,</span> <span class="n">GPUS</span><span class="p">)</span>
<span class="n">t</span> <span class="o">=</span> <span class="n">check_ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>
<span class="n">causal</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">t</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">).</span><span class="nf">tril</span><span class="p">()</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">ours</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">check_ids</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">GPUS</span><span class="p">[</span><span class="mi">0</span><span class="p">]),</span> <span class="n">causal</span><span class="p">).</span><span class="nf">cpu</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">tokens:</span><span class="sh">"</span><span class="p">,</span> <span class="n">t</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">largest logit:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">theirs</span><span class="p">.</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">max difference:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="n">ours</span> <span class="o">-</span> <span class="n">theirs</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span>
    <span class="sh">"</span><span class="s">same next-token prediction everywhere:</span><span class="sh">"</span><span class="p">,</span>
    <span class="nf">bool</span><span class="p">((</span><span class="n">ours</span><span class="p">.</span><span class="nf">argmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span> <span class="o">==</span> <span class="n">theirs</span><span class="p">.</span><span class="nf">argmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)).</span><span class="nf">all</span><span class="p">()),</span>
<span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>tokens: 35
largest logit: 23.70
max difference: 6.41e-01
same next-token prediction everywhere: True</code></pre> <p>Every next-token prediction is the same as Hugging Face’s. The logits differ more than in earlier lessons, for two reasons that have nothing to do with the arithmetic being wrong; the smoke test of this notebook, which runs a small random OLMoE in 32-bit floats, agrees with Hugging Face’s to the seventh digit.</p> <p>Here both models run in 16-bit floats, ours with the residual stream in 32 bits and theirs without, so their rounding differs. And a mixture amplifies small differences: when two experts have nearly the same score for the eighth place, a rounding error decides which one runs, and the token gets a different expert’s output.</p> <p>Where do the parameters live?</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">parts</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">embeddings and output</span><span class="sh">"</span><span class="p">:</span> <span class="mi">0</span><span class="p">,</span> <span class="sh">"</span><span class="s">attention</span><span class="sh">"</span><span class="p">:</span> <span class="mi">0</span><span class="p">,</span> <span class="sh">"</span><span class="s">routers</span><span class="sh">"</span><span class="p">:</span> <span class="mi">0</span><span class="p">,</span> <span class="sh">"</span><span class="s">experts</span><span class="sh">"</span><span class="p">:</span> <span class="mi">0</span><span class="p">,</span> <span class="sh">"</span><span class="s">norms</span><span class="sh">"</span><span class="p">:</span> <span class="mi">0</span><span class="p">}</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="nf">named_parameters</span><span class="p">():</span>
    <span class="k">if</span> <span class="sh">"</span><span class="s">experts</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">name</span><span class="p">:</span>
        <span class="n">parts</span><span class="p">[</span><span class="sh">"</span><span class="s">experts</span><span class="sh">"</span><span class="p">]</span> <span class="o">+=</span> <span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span>
    <span class="k">elif</span> <span class="sh">"</span><span class="s">mlp.gate</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">name</span><span class="p">:</span>
        <span class="n">parts</span><span class="p">[</span><span class="sh">"</span><span class="s">routers</span><span class="sh">"</span><span class="p">]</span> <span class="o">+=</span> <span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span>
    <span class="k">elif</span> <span class="sh">"</span><span class="s">self_attn</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">name</span> <span class="ow">and</span> <span class="sh">"</span><span class="s">norm</span><span class="sh">"</span> <span class="ow">not</span> <span class="ow">in</span> <span class="n">name</span><span class="p">:</span>
        <span class="n">parts</span><span class="p">[</span><span class="sh">"</span><span class="s">attention</span><span class="sh">"</span><span class="p">]</span> <span class="o">+=</span> <span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span>
    <span class="k">elif</span> <span class="sh">"</span><span class="s">embed</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">name</span> <span class="ow">or</span> <span class="sh">"</span><span class="s">lm_head</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">name</span><span class="p">:</span>
        <span class="n">parts</span><span class="p">[</span><span class="sh">"</span><span class="s">embeddings and output</span><span class="sh">"</span><span class="p">]</span> <span class="o">+=</span> <span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span>
    <span class="k">else</span><span class="p">:</span>
        <span class="n">parts</span><span class="p">[</span><span class="sh">"</span><span class="s">norms</span><span class="sh">"</span><span class="p">]</span> <span class="o">+=</span> <span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span>
<span class="n">total</span> <span class="o">=</span> <span class="nf">sum</span><span class="p">(</span><span class="n">parts</span><span class="p">.</span><span class="nf">values</span><span class="p">())</span>
<span class="n">c</span> <span class="o">=</span> <span class="n">olmoe_config</span>
<span class="n">per_expert</span> <span class="o">=</span> <span class="mi">3</span> <span class="o">*</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">]</span> <span class="o">*</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">]</span>
<span class="n">active</span> <span class="o">=</span> <span class="p">(</span>
    <span class="n">total</span>
    <span class="o">-</span> <span class="n">parts</span><span class="p">[</span><span class="sh">"</span><span class="s">experts</span><span class="sh">"</span><span class="p">]</span>
    <span class="o">+</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">]</span> <span class="o">*</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_experts_per_tok</span><span class="sh">"</span><span class="p">]</span> <span class="o">*</span> <span class="n">per_expert</span>
<span class="p">)</span>
<span class="nf">table</span><span class="p">(</span>
    <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span>
        <span class="p">{</span>
            <span class="sh">"</span><span class="s">part</span><span class="sh">"</span><span class="p">:</span> <span class="nf">list</span><span class="p">(</span><span class="n">parts</span><span class="p">),</span>
            <span class="sh">"</span><span class="s">parameters</span><span class="sh">"</span><span class="p">:</span> <span class="nf">list</span><span class="p">(</span><span class="n">parts</span><span class="p">.</span><span class="nf">values</span><span class="p">()),</span>
            <span class="sh">"</span><span class="s">share</span><span class="sh">"</span><span class="p">:</span> <span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">n</span> <span class="o">/</span> <span class="n">total</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span> <span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="n">parts</span><span class="p">.</span><span class="nf">values</span><span class="p">()],</span>
        <span class="p">}</span>
    <span class="p">)</span>
<span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">used for one token: </span><span class="si">{</span><span class="n">active</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> of </span><span class="si">{</span><span class="n">total</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> (</span><span class="si">{</span><span class="n">active</span> <span class="o">/</span> <span class="n">total</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="o">%</span><span class="si">}</span><span class="s">)</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>used for one token: 1,282,017,280 of 6,919,161,856 (19%)</code></pre> <p>Nearly all of OLMoE is experts. A token runs through all the attention, the embeddings and one eighth of the experts, a fifth of the model in all, which is where the 1B in its name comes from. The routers that decide all of this are a rounding error: one matrix of 64 rows per layer.</p> <h2 id="4-which-experts-fire">4. Which experts fire</h2> <p>Four kinds of text, each from its own corpus. English is Wikipedia articles from WikiText-103, as in lesson 6. Python is the source code of Python’s own standard library, which is on every machine that runs this notebook.</p> <p>Maths is the 1,319 school word problems of GSM8K’s test set with their worked solutions<sup class="cite">[<a href="#ref-3" id="cite-4" data-ref="3" aria-label="Reference 3: Cobbe, K., Kosaraju, V., Bavarian, M., et al. (2021). Training verifiers to solve math word problems. arXiv:2110.14168. Data: GSM8K, MIT licence.">3</a>]</sup>, which mix English, numbers and arithmetic. Russian is articles from a slice of Russian Wikipedia.</p> <p>OLMoE’s training data is overwhelmingly English, and its <a href="/blog/2026/transformers-from-scratch-01-tokenization/">tokenizer</a> shows it: a Russian word falls apart into many more tokens than an English one. Each text is cut into windows of 512 tokens; most go to measuring how the experts are used, and a few are held out for section 5.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">LENGTH</span> <span class="o">=</span> <span class="mi">64</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">512</span>
<span class="n">CALIBRATION</span><span class="p">,</span> <span class="n">HELD_OUT</span> <span class="o">=</span> <span class="p">(</span><span class="mi">2</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="nf">else </span><span class="p">(</span><span class="mi">48</span><span class="p">,</span> <span class="mi">16</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">windows</span><span class="p">(</span><span class="n">texts</span><span class="p">,</span> <span class="n">n</span><span class="p">):</span>
    <span class="n">ids</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">text</span> <span class="ow">in</span> <span class="n">texts</span><span class="p">:</span>
        <span class="n">ids</span><span class="p">.</span><span class="nf">extend</span><span class="p">(</span><span class="nf">tok</span><span class="p">(</span><span class="n">text</span><span class="p">,</span> <span class="n">add_special_tokens</span><span class="o">=</span><span class="bp">False</span><span class="p">).</span><span class="n">input_ids</span> <span class="o">+</span> <span class="p">[</span><span class="n">tok</span><span class="p">.</span><span class="n">eos_token_id</span><span class="p">])</span>
        <span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span> <span class="o">&gt;=</span> <span class="n">n</span> <span class="o">*</span> <span class="n">LENGTH</span><span class="p">:</span>
            <span class="k">break</span>
    <span class="n">ids</span> <span class="o">=</span> <span class="n">ids</span><span class="p">[:</span> <span class="n">n</span> <span class="o">*</span> <span class="n">LENGTH</span><span class="p">]</span>
    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">ids</span><span class="p">).</span><span class="nf">view</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="n">LENGTH</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">english_texts</span><span class="p">():</span>
    <span class="n">name</span> <span class="o">=</span> <span class="sh">"</span><span class="s">wikitext-103-raw-v1/test-00000-of-00001.parquet</span><span class="sh">"</span>
    <span class="n">path</span> <span class="o">=</span> <span class="nf">hf_hub_download</span><span class="p">(</span><span class="sh">"</span><span class="s">Salesforce/wikitext</span><span class="sh">"</span><span class="p">,</span> <span class="n">name</span><span class="p">,</span> <span class="n">repo_type</span><span class="o">=</span><span class="sh">"</span><span class="s">dataset</span><span class="sh">"</span><span class="p">)</span>
    <span class="k">return</span> <span class="p">[</span><span class="sh">""</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nf">read_parquet</span><span class="p">(</span><span class="n">path</span><span class="p">)[</span><span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">].</span><span class="nf">tolist</span><span class="p">())]</span>


<span class="k">def</span> <span class="nf">python_texts</span><span class="p">():</span>
    <span class="n">root</span> <span class="o">=</span> <span class="nc">Path</span><span class="p">(</span><span class="n">sysconfig</span><span class="p">.</span><span class="nf">get_paths</span><span class="p">()[</span><span class="sh">"</span><span class="s">stdlib</span><span class="sh">"</span><span class="p">])</span>
    <span class="n">modules</span> <span class="o">=</span> <span class="p">[</span>
        <span class="sh">"</span><span class="s">argparse</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">difflib</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">fractions</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">statistics</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">textwrap</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">heapq</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">dataclasses</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">pathlib</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">calendar</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">ipaddress</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">csv</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">shlex</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">string</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">gettext</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">tokenize</span><span class="sh">"</span><span class="p">,</span>
    <span class="p">]</span>
    <span class="n">files</span> <span class="o">=</span> <span class="p">[</span><span class="n">root</span> <span class="o">/</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">m</span><span class="si">}</span><span class="s">.py</span><span class="sh">"</span> <span class="k">for</span> <span class="n">m</span> <span class="ow">in</span> <span class="n">modules</span> <span class="nf">if </span><span class="p">(</span><span class="n">root</span> <span class="o">/</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">m</span><span class="si">}</span><span class="s">.py</span><span class="sh">"</span><span class="p">).</span><span class="nf">exists</span><span class="p">()]</span>
    <span class="n">files</span> <span class="o">+=</span> <span class="p">[</span><span class="n">p</span> <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="nf">sorted</span><span class="p">(</span><span class="n">root</span><span class="p">.</span><span class="nf">glob</span><span class="p">(</span><span class="sh">"</span><span class="s">json/*.py</span><span class="sh">"</span><span class="p">))</span> <span class="o">+</span> <span class="nf">sorted</span><span class="p">(</span><span class="n">root</span><span class="p">.</span><span class="nf">glob</span><span class="p">(</span><span class="sh">"</span><span class="s">email/*.py</span><span class="sh">"</span><span class="p">))]</span>
    <span class="k">return</span> <span class="p">[</span><span class="n">f</span><span class="p">.</span><span class="nf">read_text</span><span class="p">(</span><span class="n">errors</span><span class="o">=</span><span class="sh">"</span><span class="s">ignore</span><span class="sh">"</span><span class="p">)</span> <span class="k">for</span> <span class="n">f</span> <span class="ow">in</span> <span class="n">files</span><span class="p">]</span>


<span class="k">def</span> <span class="nf">maths_texts</span><span class="p">():</span>
    <span class="n">path</span> <span class="o">=</span> <span class="nf">hf_hub_download</span><span class="p">(</span>
        <span class="sh">"</span><span class="s">openai/gsm8k</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">main/test-00000-of-00001.parquet</span><span class="sh">"</span><span class="p">,</span> <span class="n">repo_type</span><span class="o">=</span><span class="sh">"</span><span class="s">dataset</span><span class="sh">"</span>
    <span class="p">)</span>
    <span class="n">frame</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nf">read_parquet</span><span class="p">(</span><span class="n">path</span><span class="p">)</span>
    <span class="c1"># the solutions carry calculator annotations, &lt;&lt;48/2=24&gt;&gt;, that no reader sees
</span>    <span class="k">return</span> <span class="p">[</span>
        <span class="n">q</span> <span class="o">+</span> <span class="sh">"</span><span class="se">\n</span><span class="sh">"</span> <span class="o">+</span> <span class="n">re</span><span class="p">.</span><span class="nf">sub</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s">&lt;&lt;[^&gt;]*&gt;&gt;</span><span class="sh">"</span><span class="p">,</span> <span class="sh">""</span><span class="p">,</span> <span class="n">a</span><span class="p">)</span> <span class="o">+</span> <span class="sh">"</span><span class="se">\n</span><span class="sh">"</span>
        <span class="k">for</span> <span class="n">q</span><span class="p">,</span> <span class="n">a</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">frame</span><span class="p">.</span><span class="n">question</span><span class="p">,</span> <span class="n">frame</span><span class="p">.</span><span class="n">answer</span><span class="p">)</span>
    <span class="p">]</span>


<span class="k">def</span> <span class="nf">russian_texts</span><span class="p">():</span>
    <span class="n">path</span> <span class="o">=</span> <span class="nf">hf_hub_download</span><span class="p">(</span>
        <span class="sh">"</span><span class="s">wikimedia/wikipedia</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">20231101.ru/train-00002-of-00021.parquet</span><span class="sh">"</span><span class="p">,</span>
        <span class="n">repo_type</span><span class="o">=</span><span class="sh">"</span><span class="s">dataset</span><span class="sh">"</span><span class="p">,</span>
    <span class="p">)</span>
    <span class="n">texts</span> <span class="o">=</span> <span class="p">(</span>
        <span class="n">pq</span><span class="p">.</span><span class="nc">ParquetFile</span><span class="p">(</span><span class="n">path</span><span class="p">).</span><span class="nf">read_row_group</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">columns</span><span class="o">=</span><span class="p">[</span><span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">]).</span><span class="nf">column</span><span class="p">(</span><span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">).</span><span class="nf">to_pylist</span><span class="p">()</span>
    <span class="p">)</span>
    <span class="k">return</span> <span class="p">[</span><span class="n">t</span> <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="n">texts</span> <span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="n">t</span><span class="p">)</span> <span class="o">&gt;</span> <span class="mi">2000</span><span class="p">]</span>  <span class="c1"># whole articles, not stubs
</span>

<span class="n">corpora</span> <span class="o">=</span> <span class="p">{</span>
    <span class="sh">"</span><span class="s">English</span><span class="sh">"</span><span class="p">:</span> <span class="nf">english_texts</span><span class="p">(),</span>
    <span class="sh">"</span><span class="s">Python</span><span class="sh">"</span><span class="p">:</span> <span class="nf">python_texts</span><span class="p">(),</span>
    <span class="sh">"</span><span class="s">maths</span><span class="sh">"</span><span class="p">:</span> <span class="nf">maths_texts</span><span class="p">(),</span>
    <span class="sh">"</span><span class="s">Russian</span><span class="sh">"</span><span class="p">:</span> <span class="nf">russian_texts</span><span class="p">(),</span>
<span class="p">}</span>
<span class="n">DOMAINS</span> <span class="o">=</span> <span class="nf">list</span><span class="p">(</span><span class="n">corpora</span><span class="p">)</span>
<span class="n">data</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">texts</span> <span class="ow">in</span> <span class="n">corpora</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
    <span class="n">all_ids</span> <span class="o">=</span> <span class="nf">windows</span><span class="p">(</span><span class="n">texts</span><span class="p">,</span> <span class="n">CALIBRATION</span> <span class="o">+</span> <span class="n">HELD_OUT</span><span class="p">)</span>
    <span class="n">data</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">calibration</span><span class="sh">"</span><span class="p">:</span> <span class="n">all_ids</span><span class="p">[:</span><span class="n">CALIBRATION</span><span class="p">],</span> <span class="sh">"</span><span class="s">held out</span><span class="sh">"</span><span class="p">:</span> <span class="n">all_ids</span><span class="p">[</span><span class="n">CALIBRATION</span><span class="p">:]}</span>
<span class="n">words</span> <span class="o">=</span> <span class="p">{</span>
    <span class="sh">"</span><span class="s">English</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">The river flows through the old town and into the sea.</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">Russian</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">Река течёт через старый город и впадает в море.</span><span class="sh">"</span><span class="p">,</span>
<span class="p">}</span>
<span class="k">for</span> <span class="n">language</span><span class="p">,</span> <span class="n">sentence</span> <span class="ow">in</span> <span class="n">words</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
    <span class="nf">print</span><span class="p">(</span>
        <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">language</span><span class="si">:</span><span class="mi">8</span><span class="si">}</span><span class="s"> </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">sentence</span><span class="p">.</span><span class="nf">split</span><span class="p">())</span><span class="si">}</span><span class="s"> words -&gt; </span><span class="sh">"</span>
        <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="nf">tok</span><span class="p">(</span><span class="n">sentence</span><span class="p">).</span><span class="n">input_ids</span><span class="p">)</span><span class="si">}</span><span class="s"> tokens</span><span class="sh">"</span>
    <span class="p">)</span>
<span class="nf">print</span><span class="p">({</span><span class="n">name</span><span class="p">:</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">d</span><span class="p">[</span><span class="sh">"</span><span class="s">calibration</span><span class="sh">"</span><span class="p">].</span><span class="n">shape</span><span class="p">)</span> <span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">d</span> <span class="ow">in</span> <span class="n">data</span><span class="p">.</span><span class="nf">items</span><span class="p">()})</span>
</code></pre></div></div> <pre class="tfs-printed"><code>English  11 words -&gt; 12 tokens
Russian  9 words -&gt; 26 tokens
{'English': (48, 512), 'Python': (48, 512), 'maths': (48, 512), 'Russian': (48, 512)}</code></pre> <p>Now the routing. A trace is switched on in every layer’s router, each corpus goes through the model, and every token leaves behind the eight experts it chose in each layer.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">BATCH</span> <span class="o">=</span> <span class="mi">2</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">8</span>
<span class="n">n_layers</span><span class="p">,</span> <span class="n">n_experts</span> <span class="o">=</span> <span class="n">olmoe_config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">],</span> <span class="n">olmoe_config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_experts</span><span class="sh">"</span><span class="p">]</span>


<span class="k">def</span> <span class="nf">causal_mask</span><span class="p">(</span><span class="n">ids</span><span class="p">):</span>
    <span class="n">t</span> <span class="o">=</span> <span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>
    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">t</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">).</span><span class="nf">tril</span><span class="p">()</span>


<span class="k">def</span> <span class="nf">route</span><span class="p">(</span><span class="n">batches</span><span class="p">):</span>
    <span class="sh">"""</span><span class="s">Every token</span><span class="sh">'</span><span class="s">s chosen experts in every layer: tokens x layers x k.</span><span class="sh">"""</span>
    <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
        <span class="n">layer</span><span class="p">.</span><span class="n">mlp</span><span class="p">.</span><span class="n">trace</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">batches</span><span class="p">),</span> <span class="n">BATCH</span><span class="p">):</span>
            <span class="n">chunk</span> <span class="o">=</span> <span class="n">batches</span><span class="p">[</span><span class="n">i</span> <span class="p">:</span> <span class="n">i</span> <span class="o">+</span> <span class="n">BATCH</span><span class="p">]</span>
            <span class="n">model</span><span class="p">.</span><span class="nf">hidden</span><span class="p">(</span><span class="n">chunk</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">GPUS</span><span class="p">[</span><span class="mi">0</span><span class="p">]),</span> <span class="nf">causal_mask</span><span class="p">(</span><span class="n">chunk</span><span class="p">))</span>
    <span class="n">traces</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">([</span><span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">(</span><span class="n">layer</span><span class="p">.</span><span class="n">mlp</span><span class="p">.</span><span class="n">trace</span><span class="p">)</span> <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="n">layers</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
        <span class="n">layer</span><span class="p">.</span><span class="n">mlp</span><span class="p">.</span><span class="n">trace</span> <span class="o">=</span> <span class="bp">None</span>
    <span class="k">return</span> <span class="n">traces</span>


<span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
<span class="n">traces</span> <span class="o">=</span> <span class="p">{</span><span class="n">name</span><span class="p">:</span> <span class="nf">route</span><span class="p">(</span><span class="n">d</span><span class="p">[</span><span class="sh">"</span><span class="s">calibration</span><span class="sh">"</span><span class="p">])</span> <span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">d</span> <span class="ow">in</span> <span class="n">data</span><span class="p">.</span><span class="nf">items</span><span class="p">()}</span>
<span class="nf">print</span><span class="p">(</span>
    <span class="sa">f</span><span class="sh">"</span><span class="s">routed </span><span class="si">{</span><span class="nf">sum</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">t</span><span class="p">)</span> <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="n">traces</span><span class="p">.</span><span class="nf">values</span><span class="p">())</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> tokens in </span><span class="si">{</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> s</span><span class="sh">"</span>
<span class="p">)</span>

<span class="c1"># usage[d, l, e]: the share of domain d's tokens that chose expert e in layer l
</span><span class="n">usage</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">zeros</span><span class="p">((</span><span class="nf">len</span><span class="p">(</span><span class="n">DOMAINS</span><span class="p">),</span> <span class="n">n_layers</span><span class="p">,</span> <span class="n">n_experts</span><span class="p">))</span>
<span class="k">for</span> <span class="n">d</span><span class="p">,</span> <span class="n">name</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">DOMAINS</span><span class="p">):</span>
    <span class="n">t</span> <span class="o">=</span> <span class="n">traces</span><span class="p">[</span><span class="n">name</span><span class="p">].</span><span class="nf">long</span><span class="p">().</span><span class="nf">numpy</span><span class="p">()</span>
    <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n_layers</span><span class="p">):</span>
        <span class="n">usage</span><span class="p">[</span><span class="n">d</span><span class="p">,</span> <span class="n">layer</span><span class="p">]</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">bincount</span><span class="p">(</span><span class="n">t</span><span class="p">[:,</span> <span class="n">layer</span><span class="p">].</span><span class="nf">flatten</span><span class="p">(),</span> <span class="n">minlength</span><span class="o">=</span><span class="n">n_experts</span><span class="p">)</span> <span class="o">/</span> <span class="nf">len</span><span class="p">(</span><span class="n">t</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>routed 98,304 tokens in 18 s</code></pre> <p>Each token picks eight experts, so a domain’s usage in a layer adds up to eight.</p> <p>To ask what an expert prefers, we compare its usage across the four domains: an expert used equally by all four has no preference; one used by a single domain and nobody else is that domain’s expert. The heat map shows three layers, with the experts sorted by the domain they prefer.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">preference</span> <span class="o">=</span> <span class="n">usage</span> <span class="o">/</span> <span class="n">usage</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span> <span class="n">keepdims</span><span class="o">=</span><span class="bp">True</span><span class="p">).</span><span class="nf">clip</span><span class="p">(</span>
    <span class="nb">min</span><span class="o">=</span><span class="mf">1e-9</span>
<span class="p">)</span>  <span class="c1"># share per domain, per expert
</span><span class="n">shades</span> <span class="o">=</span> <span class="n">LinearSegmentedColormap</span><span class="p">.</span><span class="nf">from_list</span><span class="p">(</span><span class="sh">"</span><span class="s">share</span><span class="sh">"</span><span class="p">,</span> <span class="p">[</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">grid</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">]])</span>
<span class="n">shown_layers</span> <span class="o">=</span> <span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="n">n_layers</span> <span class="o">//</span> <span class="mi">2</span><span class="p">,</span> <span class="n">n_layers</span> <span class="o">-</span> <span class="mi">1</span><span class="p">]</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span>
    <span class="nf">len</span><span class="p">(</span><span class="n">shown_layers</span><span class="p">),</span> <span class="mi">1</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">10</span><span class="p">,</span> <span class="mf">1.15</span> <span class="o">*</span> <span class="nf">len</span><span class="p">(</span><span class="n">shown_layers</span><span class="p">)</span> <span class="o">*</span> <span class="nf">len</span><span class="p">(</span><span class="n">DOMAINS</span><span class="p">)</span> <span class="o">/</span> <span class="mf">2.4</span><span class="p">)</span>
<span class="p">)</span>
<span class="k">for</span> <span class="n">ax</span><span class="p">,</span> <span class="n">layer</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">atleast_1d</span><span class="p">(</span><span class="n">axes</span><span class="p">),</span> <span class="n">shown_layers</span><span class="p">):</span>
    <span class="n">p</span> <span class="o">=</span> <span class="n">preference</span><span class="p">[:,</span> <span class="n">layer</span><span class="p">]</span>
    <span class="n">order</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">lexsort</span><span class="p">((</span><span class="o">-</span><span class="n">p</span><span class="p">.</span><span class="nf">max</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="mi">0</span><span class="p">),</span> <span class="n">p</span><span class="p">.</span><span class="nf">argmax</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="mi">0</span><span class="p">)))</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">imshow</span><span class="p">(</span><span class="n">p</span><span class="p">[:,</span> <span class="n">order</span><span class="p">],</span> <span class="n">aspect</span><span class="o">=</span><span class="sh">"</span><span class="s">auto</span><span class="sh">"</span><span class="p">,</span> <span class="n">cmap</span><span class="o">=</span><span class="n">shades</span><span class="p">,</span> <span class="n">vmin</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span> <span class="n">vmax</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_yticks</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">DOMAINS</span><span class="p">)),</span> <span class="n">DOMAINS</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_xticks</span><span class="p">([])</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span>
        <span class="sa">f</span><span class="sh">"</span><span class="s">layer </span><span class="si">{</span><span class="n">layer</span><span class="si">}</span><span class="s">: one column per expert, its use split by kind of text</span><span class="sh">"</span><span class="p">,</span>
        <span class="n">fontsize</span><span class="o">=</span><span class="mi">10</span><span class="p">,</span>
        <span class="n">loc</span><span class="o">=</span><span class="sh">"</span><span class="s">left</span><span class="sh">"</span><span class="p">,</span>
    <span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">tight_layout</span><span class="p">()</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/07/output-01.png" alt="Output of the code above" loading="lazy"></p> <p>The experts have divided the work, and they did it in every layer. In each panel a block of experts belongs to each kind of text, dark in one row and pale in the others.</p> <p>The blocks sharpen with depth: in the first layer many experts are still shared, while in the last most of them serve one kind of text and ignore the rest.</p> <p>Russian has its own experts from the very first layer, which makes sense for a language whose tokens look nothing like the others: Cyrillic letters and fragments of words that English text never produces.</p> <p>The same thing counted across all sixteen layers: in each layer, how many experts get more than half of their use from one kind of text.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">threshold</span> <span class="o">=</span> <span class="mf">0.5</span>
<span class="n">specialists</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">stack</span><span class="p">(</span>
    <span class="p">[</span>
        <span class="p">(</span><span class="n">preference</span><span class="p">.</span><span class="nf">argmax</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span> <span class="o">==</span> <span class="n">d</span><span class="p">)</span> <span class="o">&amp;</span> <span class="p">(</span><span class="n">preference</span><span class="p">.</span><span class="nf">max</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span> <span class="o">&gt;</span> <span class="n">threshold</span><span class="p">)</span>
        <span class="k">for</span> <span class="n">d</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">DOMAINS</span><span class="p">))</span>
    <span class="p">]</span>
<span class="p">).</span><span class="nf">sum</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>  <span class="c1"># domains x layers
</span><span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">9</span><span class="p">,</span> <span class="mf">3.4</span><span class="p">))</span>
<span class="n">bottom</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">n_layers</span><span class="p">)</span>
<span class="k">for</span> <span class="n">d</span><span class="p">,</span> <span class="n">name</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">DOMAINS</span><span class="p">):</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">bar</span><span class="p">(</span>
        <span class="nf">range</span><span class="p">(</span><span class="n">n_layers</span><span class="p">),</span>
        <span class="n">specialists</span><span class="p">[</span><span class="n">d</span><span class="p">],</span>
        <span class="n">bottom</span><span class="o">=</span><span class="n">bottom</span><span class="p">,</span>
        <span class="n">label</span><span class="o">=</span><span class="n">name</span><span class="p">,</span>
        <span class="n">color</span><span class="o">=</span><span class="p">[</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">data</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">]][</span><span class="n">d</span><span class="p">],</span>
    <span class="p">)</span>
    <span class="n">bottom</span> <span class="o">+=</span> <span class="n">specialists</span><span class="p">[</span><span class="n">d</span><span class="p">]</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">layer</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">experts of </span><span class="si">{</span><span class="n">n_experts</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">Experts that get more than half of their use from one kind of text</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">ncol</span><span class="o">=</span><span class="mi">4</span><span class="p">,</span> <span class="n">loc</span><span class="o">=</span><span class="sh">"</span><span class="s">upper center</span><span class="sh">"</span><span class="p">,</span> <span class="n">bbox_to_anchor</span><span class="o">=</span><span class="p">(</span><span class="mf">0.5</span><span class="p">,</span> <span class="o">-</span><span class="mf">0.2</span><span class="p">))</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/07/output-02.png" alt="Experts that get more than half of their use from one kind of text" loading="lazy"></p> <p>The count grows towards the last layers, where more than half of the experts take most of their work from a single kind of text.</p> <p>This is what OLMoE’s authors found on their own data, “experts exhibit domain and vocabulary specialization”, and it is the opposite of what Mistral found in Mixtral, where “the selection of experts appears to be more aligned with the syntax rather than the domain”.</p> <p>OLMoE’s authors have an explanation: Mixtral was not trained as a mixture from scratch but “upcycled from Mistral”, its experts copied from one dense network, and they never grew apart as much.</p> <p>Specialisation also shows from the other side. How many of the 64 experts does a domain need in a layer to cover most of its routing? A domain that spreads evenly over all of them needs most of the layer; a domain with its own experts needs few.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">footprint</span><span class="p">(</span><span class="n">u</span><span class="p">,</span> <span class="n">share</span><span class="p">):</span>
    <span class="sh">"""</span><span class="s">How many experts, taken from the most used down, carry `share` of the routing.</span><span class="sh">"""</span>
    <span class="n">ordered</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">sort</span><span class="p">(</span><span class="n">u</span><span class="p">)[::</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
    <span class="k">return</span> <span class="nf">int</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">searchsorted</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">cumsum</span><span class="p">(</span><span class="n">ordered</span><span class="p">)</span> <span class="o">/</span> <span class="n">ordered</span><span class="p">.</span><span class="nf">sum</span><span class="p">(),</span> <span class="n">share</span><span class="p">)</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span>


<span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">d</span><span class="p">,</span> <span class="n">name</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">DOMAINS</span><span class="p">):</span>
    <span class="k">for</span> <span class="n">share</span> <span class="ow">in</span> <span class="p">[</span><span class="mf">0.5</span><span class="p">,</span> <span class="mf">0.9</span><span class="p">]:</span>
        <span class="n">counts</span> <span class="o">=</span> <span class="p">[</span><span class="nf">footprint</span><span class="p">(</span><span class="n">usage</span><span class="p">[</span><span class="n">d</span><span class="p">,</span> <span class="n">layer</span><span class="p">],</span> <span class="n">share</span><span class="p">)</span> <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n_layers</span><span class="p">)]</span>
        <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
            <span class="p">{</span>
                <span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">share of routing</span><span class="sh">"</span><span class="p">:</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">share</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">experts needed, fewest layer</span><span class="sh">"</span><span class="p">:</span> <span class="nf">min</span><span class="p">(</span><span class="n">counts</span><span class="p">),</span>
                <span class="sh">"</span><span class="s">median layer</span><span class="sh">"</span><span class="p">:</span> <span class="nf">int</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">median</span><span class="p">(</span><span class="n">counts</span><span class="p">)),</span>
                <span class="sh">"</span><span class="s">most layer</span><span class="sh">"</span><span class="p">:</span> <span class="nf">max</span><span class="p">(</span><span class="n">counts</span><span class="p">),</span>
            <span class="p">}</span>
        <span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">text</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">share of routing</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">experts needed, fewest layer</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">median layer</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">most layer</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">English</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">50%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">16</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">19</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">21</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">English</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">90%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">43</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">47</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">53</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Python</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">50%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">17</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Python</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">90%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">30</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">33</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">49</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">maths</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">50%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">11</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">14</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">19</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">maths</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">90%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">39</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">44</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">51</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Russian</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">50%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">9</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">15</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Russian</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">90%</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">14</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">37</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">45</td></tr></tbody></table></div> <p>English spreads over the most experts: covering half of its routing takes a quarter to a third of a layer, and covering nine tenths takes most of the layer.</p> <p>Python and Russian are concentrated: a handful of experts carry half of their routing in a typical layer. That is the difference between a model’s main language, which uses the whole model, and the kinds of text it can afford to delegate to a few specialists.</p> <p>Last, the tokens themselves. Below, a sentence of each kind with every token coloured by the domain its first expert prefers, in the first and the last layer.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">samples</span> <span class="o">=</span> <span class="p">{</span>
    <span class="sh">"</span><span class="s">English</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">The museum opens at nine and closes at six on weekdays.</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">Python</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">for line in open(path):</span><span class="se">\n</span><span class="s">    if line.startswith(</span><span class="sh">'</span><span class="s">#</span><span class="sh">'</span><span class="s">):</span><span class="se">\n</span><span class="s">        continue</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">maths</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">She buys 3 boxes of 12 eggs and uses 7, so 36 - 7 = 29 are left.</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">Russian</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">Музей открывается в девять утра и закрывается в шесть вечера.</span><span class="sh">"</span><span class="p">,</span>
<span class="p">}</span>
<span class="n">palette</span> <span class="o">=</span> <span class="p">[</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">data</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">]]</span>


<span class="k">def</span> <span class="nf">chip</span><span class="p">(</span><span class="n">piece</span><span class="p">,</span> <span class="n">color</span><span class="p">):</span>
    <span class="n">r</span><span class="p">,</span> <span class="n">g</span><span class="p">,</span> <span class="n">b</span> <span class="o">=</span> <span class="p">(</span><span class="nf">int</span><span class="p">(</span><span class="mi">255</span> <span class="o">*</span> <span class="n">v</span><span class="p">)</span> <span class="k">for</span> <span class="n">v</span> <span class="ow">in</span> <span class="nf">to_rgb</span><span class="p">(</span><span class="n">color</span><span class="p">))</span>
    <span class="nf">return </span><span class="p">(</span>
        <span class="sa">f</span><span class="sh">'</span><span class="s">&lt;span style=</span><span class="sh">"</span><span class="s">background:rgba(</span><span class="si">{</span><span class="n">r</span><span class="si">}</span><span class="s">,</span><span class="si">{</span><span class="n">g</span><span class="si">}</span><span class="s">,</span><span class="si">{</span><span class="n">b</span><span class="si">}</span><span class="s">,0.32);border-radius:4px;padding:1px 3px;</span><span class="sh">'</span>
        <span class="sa">f</span><span class="sh">'</span><span class="s">margin:1px;font-family:monospace;white-space:pre</span><span class="sh">"</span><span class="s">&gt;</span><span class="si">{</span><span class="nf">escape</span><span class="p">(</span><span class="n">piece</span><span class="p">)</span><span class="si">}</span><span class="s">&lt;/span&gt;</span><span class="sh">'</span>
    <span class="p">)</span>


<span class="n">lines</span> <span class="o">=</span> <span class="p">[</span><span class="sh">'</span><span class="s">&lt;div style=</span><span class="sh">"</span><span class="s">line-height:2.1</span><span class="sh">"</span><span class="s">&gt;</span><span class="sh">'</span><span class="p">]</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">sentence</span> <span class="ow">in</span> <span class="n">samples</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
    <span class="n">ids</span> <span class="o">=</span> <span class="nf">tok</span><span class="p">(</span><span class="n">sentence</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="n">input_ids</span>
    <span class="n">trace</span> <span class="o">=</span> <span class="nf">route</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span>
    <span class="n">pieces</span> <span class="o">=</span> <span class="p">[</span><span class="n">tok</span><span class="p">.</span><span class="nf">decode</span><span class="p">([</span><span class="n">i</span><span class="p">]).</span><span class="nf">replace</span><span class="p">(</span><span class="sh">"</span><span class="se">\n</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">↵</span><span class="sh">"</span><span class="p">)</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">ids</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">tolist</span><span class="p">()]</span>
    <span class="n">lines</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">&lt;div&gt;&lt;b&gt;</span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="s">&lt;/b&gt;&lt;/div&gt;</span><span class="sh">"</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="n">n_layers</span> <span class="o">-</span> <span class="mi">1</span><span class="p">]:</span>
        <span class="n">chips</span> <span class="o">=</span> <span class="p">[]</span>
        <span class="k">for</span> <span class="n">piece</span><span class="p">,</span> <span class="n">chosen_experts</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">pieces</span><span class="p">,</span> <span class="n">trace</span><span class="p">[:,</span> <span class="n">layer</span><span class="p">]):</span>
            <span class="n">liked</span> <span class="o">=</span> <span class="nf">int</span><span class="p">(</span><span class="n">preference</span><span class="p">[:,</span> <span class="n">layer</span><span class="p">,</span> <span class="nf">int</span><span class="p">(</span><span class="n">chosen_experts</span><span class="p">[</span><span class="mi">0</span><span class="p">])].</span><span class="nf">argmax</span><span class="p">())</span>
            <span class="n">chips</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="nf">chip</span><span class="p">(</span><span class="n">piece</span><span class="p">,</span> <span class="n">palette</span><span class="p">[</span><span class="n">liked</span><span class="p">]))</span>
        <span class="n">lines</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
            <span class="sa">f</span><span class="sh">'</span><span class="s">&lt;div&gt;&lt;span style=</span><span class="sh">"</span><span class="s">opacity:0.6</span><span class="sh">"</span><span class="s">&gt;layer </span><span class="si">{</span><span class="n">layer</span><span class="si">}</span><span class="s">&amp;nbsp;&lt;/span&gt;</span><span class="sh">'</span>
            <span class="sa">f</span><span class="sh">'</span><span class="si">{</span><span class="sh">""</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">chips</span><span class="p">)</span><span class="si">}</span><span class="s">&lt;/div&gt;</span><span class="sh">'</span>
        <span class="p">)</span>
<span class="n">legend</span> <span class="o">=</span> <span class="sh">""</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="nf">chip</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">palette</span><span class="p">[</span><span class="n">i</span><span class="p">])</span> <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">d</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">DOMAINS</span><span class="p">))</span>
<span class="n">caption</span> <span class="o">=</span> <span class="sh">'</span><span class="s">&lt;span style=</span><span class="sh">"</span><span class="s">opacity:0.6</span><span class="sh">"</span><span class="s">&gt;the first expert prefers&amp;nbsp;&lt;/span&gt;</span><span class="sh">'</span>
<span class="n">lines</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">&lt;div&gt;</span><span class="si">{</span><span class="n">caption</span><span class="si">}{</span><span class="n">legend</span><span class="si">}</span><span class="s">&lt;/div&gt;&lt;/div&gt;</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">display</span><span class="p">(</span><span class="nc">HTML</span><span class="p">(</span><span class="sh">""</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">lines</span><span class="p">)))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><div style="line-height:2.1"><div><b>English</b></div><div><span style="opacity:0.6">layer 0&nbsp;</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">The</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> museum</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> opens</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> at</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> nine</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> and</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> closes</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> at</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> six</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> on</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> week</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">days</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">.</span></div><div><span style="opacity:0.6">layer 15&nbsp;</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">The</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> museum</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> opens</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> at</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> nine</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> and</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> closes</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> at</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> six</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> on</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> week</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">days</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">.</span></div><div><b>Python</b></div><div><span style="opacity:0.6">layer 0&nbsp;</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">for</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> line</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> in</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> open</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">(</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">path</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">):</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">↵</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> </span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">if</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> line</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">.</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">start</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">sw</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ith</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">('#</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">'):</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">↵</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> </span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">continue</span></div><div><span style="opacity:0.6">layer 15&nbsp;</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">for</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> line</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> in</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> open</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">(</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">path</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">):</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">↵</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> </span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">if</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> line</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">.</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">start</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">sw</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ith</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">('#</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">'):</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">↵</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> </span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">continue</span></div><div><b>maths</b></div><div><span style="opacity:0.6">layer 0&nbsp;</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">She</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> buys</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> 3</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> boxes</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> of</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> 12</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> eggs</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> and</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> uses</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> 7</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">,</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> so</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> 36</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> -</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> 7</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> =</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> 29</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> are</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> left</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">.</span></div><div><span style="opacity:0.6">layer 15&nbsp;</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">She</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> buys</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> 3</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> boxes</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> of</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> 12</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> eggs</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> and</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> uses</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> 7</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">,</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> so</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> 36</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> -</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> 7</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> =</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> 29</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> are</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> left</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">.</span></div><div><b>Russian</b></div><div><span style="opacity:0.6">layer 0&nbsp;</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">М</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">у</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">з</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ей</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> от</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">к</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ры</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ва</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ется</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> в</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> д</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ев</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ят</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ь</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> у</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">т</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ра</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> и</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> з</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ак</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ры</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ва</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ется</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> в</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> ш</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ест</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ь</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> в</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">еч</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ер</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">а</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">.</span></div><div><span style="opacity:0.6">layer 15&nbsp;</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">М</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">у</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">з</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ей</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> от</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">к</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ры</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ва</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ется</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> в</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> д</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ев</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ят</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ь</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> у</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">т</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ра</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> и</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> з</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ак</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ры</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ва</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ется</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> в</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> ш</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ест</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ь</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre"> в</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">еч</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">ер</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">а</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">.</span></div><div><span style="opacity:0.6">the first expert prefers&nbsp;</span><span style="background:rgba(15,140,126,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">English</span><span style="background:rgba(106,85,216,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">Python</span><span style="background:rgba(194,122,14,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">maths</span><span style="background:rgba(210,63,87,0.32);border-radius:4px;padding:1px 3px;margin:1px;font-family:monospace;white-space:pre">Russian</span></div></div></div> <p>The colours tell the same story token by token. The Russian sentence goes to experts that prefer Russian almost everywhere, already in the first layer, where a token is still mostly what it looks like.</p> <p>The Python line starts out mixed, many of its words sent to experts that prefer English, and ends almost entirely with Python’s experts, except its line breaks and indentation, which go, oddly, to experts that prefer Russian.</p> <p>The maths problem ends with its own experts, except for the arithmetic, <code class="language-plaintext highlighter-rouge">-</code>, <code class="language-plaintext highlighter-rouge">7</code> and <code class="language-plaintext highlighter-rouge">=</code>, which goes to the experts that prefer code.</p> <p>And the English sentence, in the last layer, sends more than half of its tokens to the experts of the maths problems, which are English too: by then the router sorts tokens less by language than by what should come next, and a sentence about opening hours reads a lot like a word problem.</p> <h2 id="5-a-smaller-model-for-one-kind-of-text">5. A smaller model for one kind of text</h2> <p>If a domain uses only part of a layer’s experts, the rest are dead weight for it.</p> <p>Pruning them is the cheapest way to shrink a mixture for one job: keep, in every layer, the \(N\) experts the domain used most on the calibration text, forbid the router to choose the others (their scores become \(-\infty\) before the softmax), and measure the loss on held-out text of the same kind and of the other kinds.</p> <p>No training: whatever the pruned model can still do, it could do already.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">loss_on</span><span class="p">(</span><span class="n">batches</span><span class="p">):</span>
    <span class="n">total</span><span class="p">,</span> <span class="n">count</span> <span class="o">=</span> <span class="mf">0.0</span><span class="p">,</span> <span class="mi">0</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">batches</span><span class="p">),</span> <span class="n">BATCH</span><span class="p">):</span>
            <span class="n">ids</span> <span class="o">=</span> <span class="n">batches</span><span class="p">[</span><span class="n">i</span> <span class="p">:</span> <span class="n">i</span> <span class="o">+</span> <span class="n">BATCH</span><span class="p">].</span><span class="nf">to</span><span class="p">(</span><span class="n">GPUS</span><span class="p">[</span><span class="mi">0</span><span class="p">])</span>
            <span class="n">logits</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="nf">causal_mask</span><span class="p">(</span><span class="n">ids</span><span class="p">))</span>
            <span class="n">target</span> <span class="o">=</span> <span class="n">ids</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">:].</span><span class="nf">to</span><span class="p">(</span><span class="n">logits</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
            <span class="n">total</span> <span class="o">+=</span> <span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span>
                <span class="n">logits</span><span class="p">[:,</span> <span class="p">:</span><span class="o">-</span><span class="mi">1</span><span class="p">].</span><span class="nf">flatten</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">),</span> <span class="n">target</span><span class="p">.</span><span class="nf">flatten</span><span class="p">(),</span> <span class="n">reduction</span><span class="o">=</span><span class="sh">"</span><span class="s">sum</span><span class="sh">"</span>
            <span class="p">).</span><span class="nf">item</span><span class="p">()</span>
            <span class="n">count</span> <span class="o">+=</span> <span class="n">target</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span>
    <span class="k">return</span> <span class="n">total</span> <span class="o">/</span> <span class="n">count</span>


<span class="k">def</span> <span class="nf">prune_for</span><span class="p">(</span><span class="n">domain</span><span class="p">,</span> <span class="n">keep</span><span class="p">):</span>
    <span class="n">d</span> <span class="o">=</span> <span class="n">DOMAINS</span><span class="p">.</span><span class="nf">index</span><span class="p">(</span><span class="n">domain</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">layer</span><span class="p">,</span> <span class="n">block</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="n">layers</span><span class="p">):</span>
        <span class="n">mask</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">n_experts</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">)</span>
        <span class="n">mask</span><span class="p">[</span><span class="n">np</span><span class="p">.</span><span class="nf">argsort</span><span class="p">(</span><span class="o">-</span><span class="n">usage</span><span class="p">[</span><span class="n">d</span><span class="p">,</span> <span class="n">layer</span><span class="p">])[:</span><span class="n">keep</span><span class="p">]]</span> <span class="o">=</span> <span class="bp">True</span>
        <span class="n">block</span><span class="p">.</span><span class="n">mlp</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="n">mask</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">block</span><span class="p">.</span><span class="n">mlp</span><span class="p">.</span><span class="n">gate</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">unprune</span><span class="p">():</span>
    <span class="k">for</span> <span class="n">block</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
        <span class="n">block</span><span class="p">.</span><span class="n">mlp</span><span class="p">.</span><span class="n">keep</span> <span class="o">=</span> <span class="bp">None</span>


<span class="n">KEEP</span> <span class="o">=</span> <span class="p">[</span><span class="n">n_experts</span><span class="p">,</span> <span class="n">n_experts</span> <span class="o">//</span> <span class="mi">4</span> <span class="o">*</span> <span class="mi">3</span><span class="p">,</span> <span class="n">n_experts</span> <span class="o">//</span> <span class="mi">2</span><span class="p">,</span> <span class="n">n_experts</span> <span class="o">//</span> <span class="mi">4</span><span class="p">]</span>
<span class="n">TARGETS</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">Python</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Russian</span><span class="sh">"</span><span class="p">]</span>
<span class="n">results</span> <span class="o">=</span> <span class="p">[]</span>
<span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
<span class="nf">unprune</span><span class="p">()</span>
<span class="n">full</span> <span class="o">=</span> <span class="p">{</span><span class="n">name</span><span class="p">:</span> <span class="nf">loss_on</span><span class="p">(</span><span class="n">data</span><span class="p">[</span><span class="n">name</span><span class="p">][</span><span class="sh">"</span><span class="s">held out</span><span class="sh">"</span><span class="p">])</span> <span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">DOMAINS</span><span class="p">}</span>
<span class="k">for</span> <span class="n">target</span> <span class="ow">in</span> <span class="n">TARGETS</span><span class="p">:</span>
    <span class="k">for</span> <span class="n">keep</span> <span class="ow">in</span> <span class="n">KEEP</span><span class="p">[</span><span class="mi">1</span><span class="p">:]:</span>
        <span class="nf">prune_for</span><span class="p">(</span><span class="n">target</span><span class="p">,</span> <span class="n">keep</span><span class="p">)</span>
        <span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">DOMAINS</span><span class="p">:</span>
            <span class="n">results</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
                <span class="p">{</span>
                    <span class="sh">"</span><span class="s">pruned for</span><span class="sh">"</span><span class="p">:</span> <span class="n">target</span><span class="p">,</span>
                    <span class="sh">"</span><span class="s">experts kept</span><span class="sh">"</span><span class="p">:</span> <span class="n">keep</span><span class="p">,</span>
                    <span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span>
                    <span class="sh">"</span><span class="s">loss</span><span class="sh">"</span><span class="p">:</span> <span class="nf">loss_on</span><span class="p">(</span><span class="n">data</span><span class="p">[</span><span class="n">name</span><span class="p">][</span><span class="sh">"</span><span class="s">held out</span><span class="sh">"</span><span class="p">]),</span>
                <span class="p">}</span>
            <span class="p">)</span>
<span class="nf">unprune</span><span class="p">()</span>
<span class="k">for</span> <span class="n">target</span> <span class="ow">in</span> <span class="n">TARGETS</span><span class="p">:</span>
    <span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">DOMAINS</span><span class="p">:</span>
        <span class="n">results</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
            <span class="p">{</span>
                <span class="sh">"</span><span class="s">pruned for</span><span class="sh">"</span><span class="p">:</span> <span class="n">target</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">experts kept</span><span class="sh">"</span><span class="p">:</span> <span class="n">n_experts</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">loss</span><span class="sh">"</span><span class="p">:</span> <span class="n">full</span><span class="p">[</span><span class="n">name</span><span class="p">],</span>
            <span class="p">}</span>
        <span class="p">)</span>
<span class="n">results</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">results</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">results</span><span class="p">)</span><span class="si">}</span><span class="s"> evaluations in </span><span class="si">{</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> s</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span>
    <span class="n">results</span><span class="p">.</span><span class="nf">pivot_table</span><span class="p">(</span>
        <span class="n">index</span><span class="o">=</span><span class="p">[</span><span class="sh">"</span><span class="s">pruned for</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">],</span> <span class="n">columns</span><span class="o">=</span><span class="sh">"</span><span class="s">experts kept</span><span class="sh">"</span><span class="p">,</span> <span class="n">values</span><span class="o">=</span><span class="sh">"</span><span class="s">loss</span><span class="sh">"</span>
    <span class="p">).</span><span class="nf">reset_index</span><span class="p">(),</span>
    <span class="n">digits</span><span class="o">=</span><span class="mi">3</span><span class="p">,</span>
<span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>32 evaluations in 45 s</code></pre> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">pruned for</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">text</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">16</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">32</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">48</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">64</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Python</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">English</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8.842</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4.672</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.298</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.589</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Python</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Python</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.853</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.895</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.571</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.526</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Python</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Russian</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7.749</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.504</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.369</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.861</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Python</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">maths</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7.421</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.132</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.145</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.960</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Russian</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">English</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7.319</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.771</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.909</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.589</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Russian</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Python</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7.251</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.667</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.769</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.526</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Russian</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Russian</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4.401</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.203</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.921</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.861</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Russian</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">maths</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6.761</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.815</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.151</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.960</td></tr></tbody></table></div> <p>The same numbers as a chart, with the memory of each pruned model in the second axis’ labels: the experts we keep, plus everything that isn’t an expert.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">gigabytes</span><span class="p">(</span><span class="n">keep</span><span class="p">):</span>
    <span class="n">rest</span> <span class="o">=</span> <span class="n">total</span> <span class="o">-</span> <span class="n">parts</span><span class="p">[</span><span class="sh">"</span><span class="s">experts</span><span class="sh">"</span><span class="p">]</span>
    <span class="nf">return </span><span class="p">(</span><span class="n">rest</span> <span class="o">+</span> <span class="n">parts</span><span class="p">[</span><span class="sh">"</span><span class="s">experts</span><span class="sh">"</span><span class="p">]</span> <span class="o">*</span> <span class="n">keep</span> <span class="o">/</span> <span class="n">n_experts</span><span class="p">)</span> <span class="o">*</span> <span class="mi">2</span> <span class="o">/</span> <span class="mf">1e9</span>  <span class="c1"># 16-bit weights
</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">TARGETS</span><span class="p">),</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">10</span><span class="p">,</span> <span class="mf">3.6</span><span class="p">),</span> <span class="n">sharey</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="k">for</span> <span class="n">ax</span><span class="p">,</span> <span class="n">target</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">axes</span><span class="p">,</span> <span class="n">TARGETS</span><span class="p">):</span>
    <span class="n">chunk</span> <span class="o">=</span> <span class="n">results</span><span class="p">[</span><span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">pruned for</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="n">target</span><span class="p">]</span>
    <span class="k">for</span> <span class="n">d</span><span class="p">,</span> <span class="n">name</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">DOMAINS</span><span class="p">):</span>
        <span class="n">line</span> <span class="o">=</span> <span class="n">chunk</span><span class="p">[</span><span class="n">chunk</span><span class="p">.</span><span class="n">text</span> <span class="o">==</span> <span class="n">name</span><span class="p">].</span><span class="nf">sort_values</span><span class="p">(</span><span class="sh">"</span><span class="s">experts kept</span><span class="sh">"</span><span class="p">)</span>
        <span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span>
            <span class="n">line</span><span class="p">[</span><span class="sh">"</span><span class="s">experts kept</span><span class="sh">"</span><span class="p">],</span>
            <span class="n">line</span><span class="p">[</span><span class="sh">"</span><span class="s">loss</span><span class="sh">"</span><span class="p">],</span>
            <span class="n">marker</span><span class="o">=</span><span class="sh">"</span><span class="s">o</span><span class="sh">"</span><span class="p">,</span>
            <span class="n">color</span><span class="o">=</span><span class="n">palette</span><span class="p">[</span><span class="n">d</span><span class="p">],</span>
            <span class="n">label</span><span class="o">=</span><span class="n">name</span><span class="p">,</span>
            <span class="n">linewidth</span><span class="o">=</span><span class="mf">2.4</span> <span class="k">if</span> <span class="n">name</span> <span class="o">==</span> <span class="n">target</span> <span class="k">else</span> <span class="mf">1.2</span><span class="p">,</span>
        <span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_xticks</span><span class="p">(</span><span class="n">KEEP</span><span class="p">,</span> <span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">k</span><span class="si">}</span><span class="se">\n</span><span class="si">{</span><span class="nf">gigabytes</span><span class="p">(</span><span class="n">k</span><span class="p">)</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s"> GB</span><span class="sh">"</span> <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="n">KEEP</span><span class="p">],</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">8</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">experts kept per layer, and the model</span><span class="sh">'</span><span class="s">s size</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">pruned for </span><span class="si">{</span><span class="n">target</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">10</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">loss on held-out text</span><span class="sh">"</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mf">8.5</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/07/output-03.png" alt="Output of the code above" loading="lazy"></p> <p>Pruning works in one direction only. Keep three quarters of the experts that Python uses, and Python barely notices, while every other kind of text gets visibly worse; the same holds for Russian.</p> <p>At half the experts even the target domain pays a real price, and at a quarter the model falls apart for everything. So a mixture can be trimmed for a narrow job by a quarter without any training, which saves a quarter of the experts’ memory; cutting deeper would need <a href="/blog/2025/adapters/">fine-tuning</a> to recover what is lost.</p> <h2 id="6-experts-in-and-out-of-gpu-memory">6. Experts in and out of GPU memory</h2> <p>A mixture saves compute, not memory: all 64 experts of every layer have to be somewhere, even though a token uses eight. Two numbers decide whether some of them can live elsewhere, in the CPU’s memory or on disk, and be fetched when needed.</p> <p>The first is how many experts a <em>batch</em> of tokens touches. If routing were uniform, \(B\) tokens choosing \(k\) of \(E\) experts each would touch on average</p> \[E \left(1 - \left(1 - \frac{k}{E}\right)^{B}\right)\] <p>experts per layer, so a few dozen tokens in a batch already need nearly all of them. Real routing is not uniform, and we have the traces to measure it.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">mixed</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">(</span>
    <span class="p">[</span><span class="n">traces</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">DOMAINS</span><span class="p">]</span>
<span class="p">)</span>  <span class="c1"># every routed token, of all four kinds
</span><span class="n">rng</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="nf">default_rng</span><span class="p">(</span><span class="mi">0</span><span class="p">)</span>
<span class="n">sizes</span> <span class="o">=</span> <span class="p">[</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">4</span><span class="p">,</span> <span class="mi">8</span><span class="p">,</span> <span class="mi">16</span><span class="p">,</span> <span class="mi">32</span><span class="p">,</span> <span class="mi">64</span><span class="p">,</span> <span class="mi">128</span><span class="p">]</span>
<span class="n">touched_real</span><span class="p">,</span> <span class="n">touched_one</span> <span class="o">=</span> <span class="p">[],</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">b</span> <span class="ow">in</span> <span class="n">sizes</span><span class="p">:</span>
    <span class="n">picks</span> <span class="o">=</span> <span class="p">[</span><span class="n">mixed</span><span class="p">[</span><span class="n">rng</span><span class="p">.</span><span class="nf">choice</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">mixed</span><span class="p">),</span> <span class="n">b</span><span class="p">,</span> <span class="n">replace</span><span class="o">=</span><span class="bp">False</span><span class="p">)].</span><span class="nf">long</span><span class="p">()</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">50</span><span class="p">)]</span>
    <span class="n">touched_real</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
        <span class="n">np</span><span class="p">.</span><span class="nf">mean</span><span class="p">(</span>
            <span class="p">[</span>
                <span class="p">[</span><span class="nf">len</span><span class="p">(</span><span class="nf">set</span><span class="p">(</span><span class="n">p</span><span class="p">[:,</span> <span class="n">layer</span><span class="p">].</span><span class="nf">flatten</span><span class="p">().</span><span class="nf">tolist</span><span class="p">()))</span> <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n_layers</span><span class="p">)]</span>
                <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">picks</span>
            <span class="p">]</span>
        <span class="p">)</span>
    <span class="p">)</span>
    <span class="n">one</span> <span class="o">=</span> <span class="n">traces</span><span class="p">[</span><span class="sh">"</span><span class="s">Python</span><span class="sh">"</span><span class="p">]</span>
    <span class="n">picks</span> <span class="o">=</span> <span class="p">[</span><span class="n">one</span><span class="p">[</span><span class="n">rng</span><span class="p">.</span><span class="nf">choice</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">one</span><span class="p">),</span> <span class="n">b</span><span class="p">,</span> <span class="n">replace</span><span class="o">=</span><span class="bp">False</span><span class="p">)].</span><span class="nf">long</span><span class="p">()</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">50</span><span class="p">)]</span>
    <span class="n">touched_one</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span>
        <span class="n">np</span><span class="p">.</span><span class="nf">mean</span><span class="p">(</span>
            <span class="p">[</span>
                <span class="p">[</span><span class="nf">len</span><span class="p">(</span><span class="nf">set</span><span class="p">(</span><span class="n">p</span><span class="p">[:,</span> <span class="n">layer</span><span class="p">].</span><span class="nf">flatten</span><span class="p">().</span><span class="nf">tolist</span><span class="p">()))</span> <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n_layers</span><span class="p">)]</span>
                <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">picks</span>
            <span class="p">]</span>
        <span class="p">)</span>
    <span class="p">)</span>
<span class="n">k</span> <span class="o">=</span> <span class="n">olmoe_config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_experts_per_tok</span><span class="sh">"</span><span class="p">]</span>
<span class="n">uniform</span> <span class="o">=</span> <span class="p">[</span><span class="n">n_experts</span> <span class="o">*</span> <span class="p">(</span><span class="mi">1</span> <span class="o">-</span> <span class="p">(</span><span class="mi">1</span> <span class="o">-</span> <span class="n">k</span> <span class="o">/</span> <span class="n">n_experts</span><span class="p">)</span> <span class="o">**</span> <span class="n">b</span><span class="p">)</span> <span class="k">for</span> <span class="n">b</span> <span class="ow">in</span> <span class="n">sizes</span><span class="p">]</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">7.2</span><span class="p">,</span> <span class="mf">3.6</span><span class="p">))</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span>
    <span class="n">sizes</span><span class="p">,</span>
    <span class="n">uniform</span><span class="p">,</span>
    <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">],</span>
    <span class="n">linestyle</span><span class="o">=</span><span class="sh">"</span><span class="s">--</span><span class="sh">"</span><span class="p">,</span>
    <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">uniform routing, the formula</span><span class="sh">"</span><span class="p">,</span>
<span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span>
    <span class="n">sizes</span><span class="p">,</span>
    <span class="n">touched_real</span><span class="p">,</span>
    <span class="n">marker</span><span class="o">=</span><span class="sh">"</span><span class="s">o</span><span class="sh">"</span><span class="p">,</span>
    <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">],</span>
    <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">OLMoE, tokens of all four kinds</span><span class="sh">"</span><span class="p">,</span>
<span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span>
    <span class="n">sizes</span><span class="p">,</span> <span class="n">touched_one</span><span class="p">,</span> <span class="n">marker</span><span class="o">=</span><span class="sh">"</span><span class="s">o</span><span class="sh">"</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">],</span> <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">OLMoE, Python tokens only</span><span class="sh">"</span>
<span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xscale</span><span class="p">(</span><span class="sh">"</span><span class="s">log</span><span class="sh">"</span><span class="p">,</span> <span class="n">base</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xticks</span><span class="p">(</span><span class="n">sizes</span><span class="p">,</span> <span class="p">[</span><span class="nf">str</span><span class="p">(</span><span class="n">s</span><span class="p">)</span> <span class="k">for</span> <span class="n">s</span> <span class="ow">in</span> <span class="n">sizes</span><span class="p">])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">tokens in the batch</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">experts touched per layer</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">How many of the </span><span class="si">{</span><span class="n">n_experts</span><span class="si">}</span><span class="s"> experts a batch needs</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mf">8.5</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/07/output-04.png" alt="Output of the code above" loading="lazy"></p> <p>A batch of real tokens touches fewer experts than the formula predicts, because tokens of a kind prefer the same experts; a batch of Python alone touches fewer still.</p> <p>But the curves join the formula’s soon enough: a few dozen tokens of mixed text already need most of every layer. That is why serving a mixture needs all its experts in fast memory as soon as more than a few users share a GPU.</p> <p>DeepSeek goes the other way: its paper describes generation on 320 GPUs, “each GPU hosts only one expert”, so that every GPU gets a full batch of tokens for the one expert it holds<sup class="cite">[<a href="#ref-4" id="cite-5" data-ref="4" aria-label="Reference 4: DeepSeek-AI (2024). DeepSeek-V3 technical report. arXiv:2412.19437.">4</a>]</sup>.</p> <p>The second number matters when a single user generates text one token at a time, as on a laptop: how often does the next token need an expert that the previous tokens already loaded?</p> <p>We keep a cache of \(C\) experts per layer in GPU memory, evict the one used longest ago when a new one is needed, and count the hits along the real sequence of tokens.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">lru_hit_rate</span><span class="p">(</span><span class="n">trace</span><span class="p">,</span> <span class="n">capacity</span><span class="p">):</span>
    <span class="n">hits</span> <span class="o">=</span> <span class="n">total</span> <span class="o">=</span> <span class="mi">0</span>
    <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">trace</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]):</span>
        <span class="n">cache</span> <span class="o">=</span> <span class="nc">OrderedDict</span><span class="p">()</span>
        <span class="k">for</span> <span class="n">chosen_experts</span> <span class="ow">in</span> <span class="n">trace</span><span class="p">[:,</span> <span class="n">layer</span><span class="p">].</span><span class="nf">tolist</span><span class="p">():</span>
            <span class="k">for</span> <span class="n">e</span> <span class="ow">in</span> <span class="n">chosen_experts</span><span class="p">:</span>
                <span class="n">total</span> <span class="o">+=</span> <span class="mi">1</span>
                <span class="k">if</span> <span class="n">e</span> <span class="ow">in</span> <span class="n">cache</span><span class="p">:</span>
                    <span class="n">hits</span> <span class="o">+=</span> <span class="mi">1</span>
                    <span class="n">cache</span><span class="p">.</span><span class="nf">move_to_end</span><span class="p">(</span><span class="n">e</span><span class="p">)</span>
                <span class="k">else</span><span class="p">:</span>
                    <span class="n">cache</span><span class="p">[</span><span class="n">e</span><span class="p">]</span> <span class="o">=</span> <span class="bp">True</span>
                    <span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="n">cache</span><span class="p">)</span> <span class="o">&gt;</span> <span class="n">capacity</span><span class="p">:</span>
                        <span class="n">cache</span><span class="p">.</span><span class="nf">popitem</span><span class="p">(</span><span class="n">last</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">hits</span> <span class="o">/</span> <span class="n">total</span>


<span class="n">capacities</span> <span class="o">=</span> <span class="p">[</span><span class="mi">8</span><span class="p">,</span> <span class="mi">16</span><span class="p">,</span> <span class="mi">24</span><span class="p">,</span> <span class="mi">32</span><span class="p">,</span> <span class="mi">48</span><span class="p">]</span>
<span class="n">sequence</span> <span class="o">=</span> <span class="p">{</span>
    <span class="n">name</span><span class="p">:</span> <span class="n">traces</span><span class="p">[</span><span class="n">name</span><span class="p">][:</span> <span class="mi">4</span> <span class="o">*</span> <span class="n">LENGTH</span><span class="p">]</span> <span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">DOMAINS</span>
<span class="p">}</span>  <span class="c1"># four windows in reading order
</span><span class="n">random_trace</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">(</span>
    <span class="p">[</span>
        <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">([</span><span class="n">torch</span><span class="p">.</span><span class="nf">randperm</span><span class="p">(</span><span class="n">n_experts</span><span class="p">)[:</span><span class="n">k</span><span class="p">]</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n_layers</span><span class="p">)])</span>
        <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">4</span> <span class="o">*</span> <span class="n">LENGTH</span><span class="p">)</span>
    <span class="p">]</span>
<span class="p">)</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">7.2</span><span class="p">,</span> <span class="mf">3.6</span><span class="p">))</span>
<span class="k">for</span> <span class="n">d</span><span class="p">,</span> <span class="n">name</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">DOMAINS</span><span class="p">):</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span>
        <span class="n">capacities</span><span class="p">,</span>
        <span class="p">[</span><span class="nf">lru_hit_rate</span><span class="p">(</span><span class="n">sequence</span><span class="p">[</span><span class="n">name</span><span class="p">],</span> <span class="n">c</span><span class="p">)</span> <span class="k">for</span> <span class="n">c</span> <span class="ow">in</span> <span class="n">capacities</span><span class="p">],</span>
        <span class="n">marker</span><span class="o">=</span><span class="sh">"</span><span class="s">o</span><span class="sh">"</span><span class="p">,</span>
        <span class="n">color</span><span class="o">=</span><span class="n">palette</span><span class="p">[</span><span class="n">d</span><span class="p">],</span>
        <span class="n">label</span><span class="o">=</span><span class="n">name</span><span class="p">,</span>
    <span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span>
    <span class="n">capacities</span><span class="p">,</span>
    <span class="p">[</span><span class="nf">lru_hit_rate</span><span class="p">(</span><span class="n">random_trace</span><span class="p">,</span> <span class="n">c</span><span class="p">)</span> <span class="k">for</span> <span class="n">c</span> <span class="ow">in</span> <span class="n">capacities</span><span class="p">],</span>
    <span class="n">linestyle</span><span class="o">=</span><span class="sh">"</span><span class="s">--</span><span class="sh">"</span><span class="p">,</span>
    <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">],</span>
    <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">uniform routing</span><span class="sh">"</span><span class="p">,</span>
<span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">experts kept in GPU memory per layer, of </span><span class="si">{</span><span class="n">n_experts</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">share of expert uses already in memory</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">A least-recently-used cache of experts, one token at a time</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylim</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mf">8.5</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/07/output-05.png" alt="A least-recently-used cache of experts, one token at a time" loading="lazy"></p> <p>For a single user the picture is much better. Consecutive tokens of one text keep asking for the same experts, so a cache that holds a quarter of each layer’s experts already finds half to two thirds of what the next token needs, several times as often as random routing would; Russian and Python, with their small footprints, cache best.</p> <p>This is what offloading schemes for running large mixtures on small GPUs rely on: the experts in use stay on the GPU, the rest wait in the CPU’s memory, and a miss costs one transfer of an expert’s weights.</p> <h2 id="7-where-mixtures-are-the-right-tool">7. Where mixtures are the right tool</h2> <p>A mixture of experts buys a big model’s knowledge at a small model’s compute per token, and pays in memory.</p> <p>That trade suits a provider serving many users at once: the batch is large, every expert is busy, and the memory of all the experts is spread over enough GPUs that it doesn’t matter. This is why the largest open models of the last two years, DeepSeek-V3, Qwen3-235B, Kimi K2 and gpt-oss-120b, are mixtures.</p> <p>On one GPU with one user the trade is worse. You hold 7 billion parameters to compute with 1.3, while a dense model of the same memory would put all of it to work for every token.</p> <p>A mixture makes sense here when the memory is there anyway, when you can offload the experts a text doesn’t use, as section 6 showed works, or when you need the specialisation itself: section 5’s pruning gives a smaller model for one kind of text without training.</p> <p>Fine-tuning a mixture has its own traps. The router can be trained or frozen; training it on a narrow dataset can undo the balance it learned, so freezing it is the safer default.</p> <p>Adapters such as lesson 6’s <a href="/blog/2024/lora-algorithm-for-llms/">LoRA</a> can go on the attention and on the experts alike. Long context, <a href="/blog/2026/transformer-architectures-09-long/">lesson 9</a>, and the memory of the <a href="/blog/2025/inference-optimization/">KV cache</a>, <a href="/blog/2026/transformer-architectures-08-kv/">lesson 8</a>, apply to a mixture unchanged: its attention is a dense model’s.</p> <p>OLMoE’s passport, and the family tree with this lesson’s branch:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/07/passport-light.png" width="760" alt="OLMoE's passport. Published September 2024 by the Allen Institute for AI, fully open: weights, data, code and logs, Apache 2.0. Type: decoder-only mixture of experts, 6.9 billion parameters, 1.3 billion active per token. Training: 5.1 trillion tokens, mostly English. Attention: 16 heads of 128, multi-head, QK-norm over the whole query and key projections. Positions: rotary, base 10,000. Experts: 64 SwiGLU experts of width 1,024 in each of 16 layers, 8 per token, no shared expert. Router: softmax over all experts, top 8, not renormalised; trained with a load-balancing loss and a z-loss. Vocabulary: 50,304 tokens, untied input and output. Good at: studying routing, English text at the cost of a 1B model. Not for: languages it barely saw, long contexts of more than 4,096 tokens" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/07/passport-dark.png" width="760" alt="OLMoE's passport. Published September 2024 by the Allen Institute for AI, fully open: weights, data, code and logs, Apache 2.0. Type: decoder-only mixture of experts, 6.9 billion parameters, 1.3 billion active per token. Training: 5.1 trillion tokens, mostly English. Attention: 16 heads of 128, multi-head, QK-norm over the whole query and key projections. Positions: rotary, base 10,000. Experts: 64 SwiGLU experts of width 1,024 in each of 16 layers, 8 per token, no shared expert. Router: softmax over all experts, top 8, not renormalised; trained with a load-balancing loss and a z-loss. Vocabulary: 50,304 tokens, untied input and output. Good at: studying routing, English text at the cost of a 1B model. Not for: languages it barely saw, long contexts of more than 4,096 tokens" loading="lazy"></p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/07/family-light.png" width="760" alt="The family of the Transformer as this course covers it, with lesson 7, mixtures of experts, highlighted and lessons 1 to 6 done" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/07/family-dark.png" width="760" alt="The family of the Transformer as this course covers it, with lesson 7, mixtures of experts, highlighted and lessons 1 to 6 done" loading="lazy"></p> <h2 id="references">References</h2> <ol class="tfs-refs"> <li id="ref-1">Dai, D., Deng, C., Zhao, C., et al. (2024). <a href="https://arxiv.org/abs/2401.06066">DeepSeekMoE: towards ultimate expert specialization in mixture-of-experts language models</a>. <em>ACL 2024</em>. <a class="ref-back" href="#cite-1" aria-label="Back to the text">↩</a></li> <li id="ref-2">Muennighoff, N., Soldaini, L., Groeneveld, D., et al. (2024). <a href="https://arxiv.org/abs/2409.02060">OLMoE: open mixture-of-experts language models</a>. <em>ICLR 2025</em>. <a class="ref-back" href="#cite-2" aria-label="Back to the text">↩</a></li> <li id="ref-3">Cobbe, K., Kosaraju, V., Bavarian, M., et al. (2021). <a href="https://arxiv.org/abs/2110.14168">Training verifiers to solve math word problems</a>. arXiv:2110.14168. Data: GSM8K, MIT licence. <a class="ref-back" href="#cite-4" aria-label="Back to the text">↩</a></li> <li id="ref-4">DeepSeek-AI (2024). <a href="https://arxiv.org/abs/2412.19437">DeepSeek-V3 technical report</a>. arXiv:2412.19437. <a class="ref-back" href="#cite-5" aria-label="Back to the text">↩</a></li> <li id="ref-5">Shazeer, N., Mirhoseini, A., Maziarz, K., et al. (2017). <a href="https://arxiv.org/abs/1701.06538">Outrageously large neural networks: the sparsely-gated mixture-of-experts layer</a>. <em>ICLR 2017</em>.</li> <li id="ref-6">Lepikhin, D., Lee, H., Xu, Y., et al. (2020). <a href="https://arxiv.org/abs/2006.16668">GShard: scaling giant models with conditional computation and automatic sharding</a>. <em>ICLR 2021</em>.</li> <li id="ref-7">Fedus, W., Zoph, B., &amp; Shazeer, N. (2021). <a href="https://arxiv.org/abs/2101.03961">Switch Transformers: scaling to trillion parameter models with simple and efficient sparsity</a>. <em>JMLR 2022</em>.</li> <li id="ref-8">Zoph, B., Bello, I., Kumar, S., et al. (2022). <a href="https://arxiv.org/abs/2202.08906">ST-MoE: designing stable and transferable sparse expert models</a>. arXiv:2202.08906.</li> <li id="ref-9">Jiang, A. Q., Sablayrolles, A., Roux, A., et al. (2024). <a href="https://arxiv.org/abs/2401.04088">Mixtral of experts</a>. arXiv:2401.04088.</li> <li id="ref-10">Qwen Team (2025). <a href="https://arxiv.org/abs/2505.09388">Qwen3 technical report</a>. arXiv:2505.09388.</li> <li id="ref-11">OpenAI (2025). <a href="https://arxiv.org/abs/2508.10925">gpt-oss-120b &amp; gpt-oss-20b model card</a>. arXiv:2508.10925.</li> </ol>]]></content> <author> <name>Eva Koroleva</name> </author> <category term="machine-learning"/> <category term="transformer-architectures"/> <category term="mixture-of-experts"/> <category term="moe"/> <category term="olmoe"/> <category term="routing"/> <category term="llm"/> <category term="pruning"/> <summary type="html"><![CDATA[How a dozen production mixtures of experts are built, from Mixtral to gpt-oss. The router written four ways, OLMoE in PyTorch with its official weights, the experts that English, Python, maths and Russian use, a model pruned for one kind of text, and an expert cache measured on real routing.]]></summary> <media:thumbnail url="https://blog.korolevalab.com/assets/posts/arch/07/cover.png"/> <media:content medium="image" url="https://blog.korolevalab.com/assets/posts/arch/07/cover.png"/> </entry> <entry> <title type="html">Modern LLM architecture and Qwen3 from scratch</title> <link href="https://blog.korolevalab.com/blog/2026/transformer-architectures-06-modern/" rel="alternate" type="text/html" title="Modern LLM architecture and Qwen3 from scratch"/> <published>2026-08-06T15:00:00+00:00</published> <updated>2026-11-08T00:00:00+00:00</updated> <id>https://blog.korolevalab.com/blog/2026/transformer-architectures-06-modern</id> <content type="html" xml:base="https://blog.korolevalab.com/blog/2026/transformer-architectures-06-modern/"><![CDATA[<p class="tfs-links"><strong>Transformer architectures: from BERT to diffusion</strong> · lesson 6 of 15 · <a href="/teaching/">all lessons</a> · <a href="https://www.kaggle.com/code/qmarva/transformer-architectures-06-modern-llms">run on Kaggle</a> · <a href="https://colab.research.google.com/github/xmarva/transformers-from-scratch/blob/main/notebooks/colab/a06_modern.ipynb">open in Colab</a> · <a href="https://github.com/xmarva/transformers-from-scratch">code on GitHub</a></p> <p>Give Llama 3.1 8B a long contract to read, 128,000 tokens of it, and before it writes the first word of its answer it has to keep the whole contract in GPU memory: a key and a value for every token, in every head of every one of its 32 layers.</p> <p>That memory, the <a href="/blog/2025/inference-optimization/">KV cache</a>, comes out larger than the model’s own weights. Its predecessor of the same width, Llama 2 7B, kept a key and a value for each of its 32 heads, four times as much per token.</p> <p>Llama 3 keeps one pair for every four query heads, a change called grouped-query attention, and almost nobody trains a model without it any more.</p> <p><a href="/blog/2026/transformer-architectures-05-t5/">Lesson 5</a> of the first course followed the changes Llama made to the original Transformer: RMSNorm, rotary positions, SwiGLU. This lesson follows what came after Llama, and there is a pattern in it.</p> <p>Open the configuration file of any open model released since 2023 and nearly every setting that differs from Llama answers one of two problems: memory while the model generates, and stability while it trains.</p> <p>The first gave us grouped-query attention, sliding windows and models that mix local and global layers. The second gave us QK-norm and soft-capping, small changes that keep attention from tearing a training run apart.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/06/hero-light.png" width="760" alt="The decoder block of a modern LLM, with each change since Llama marked where it acts. Grouped-query attention shares one key-value head among several query heads and shrinks the KV cache. A sliding window limits how far back a local layer can look. QK-norm normalises queries and keys before their dot product, and soft-capping squashes the scores with a tanh. In most models the rest of the block is Llama's: RMSNorm before each part, rotary positions, a SwiGLU feed-forward network" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/06/hero-dark.png" width="760" alt="The decoder block of a modern LLM, with each change since Llama marked where it acts. Grouped-query attention shares one key-value head among several query heads and shrinks the KV cache. A sliding window limits how far back a local layer can look. QK-norm normalises queries and keys before their dot product, and soft-capping squashes the scores with a tanh. In most models the rest of the block is Llama's: RMSNorm before each part, rotary positions, a SwiGLU feed-forward network" loading="lazy"></p> <p><strong>What you’ll do</strong></p> <ol> <li>Read the configuration files of a dozen models from Mistral 7B to gpt-oss and find what changed.</li> <li>Write grouped-query attention, find out what happens when a trained GPT-2 is forced to share its keys and values, and count the KV cache of every model in the table.</li> <li>Make small Transformers diverge on purpose, then keep them alive with QK-norm and soft-capping.</li> <li>Write Qwen3 in PyTorch, load the official weights of Qwen3-0.6B and match Hugging Face’s outputs, then let it think out loud and not.</li> <li>Give Qwen3 a sliding window it was never trained with, the way Mistral and Gemma build theirs, and see what it keeps and what it loses.</li> <li>Write <a href="/blog/2024/lora-algorithm-for-llms/">LoRA</a> from scratch and teach the 0.6B model to turn voice commands into JSON, in English and in Russian, against a model seven times its size.</li> </ol> <p><strong>What you need</strong>: a GPU. On Kaggle, <em>Settings → Accelerator → GPU</em>; on Colab, <em>Runtime → Change runtime type → T4 GPU</em>. The notebook downloads Qwen3-0.6B (1.5 GB), Qwen3-4B (8 GB), GPT-2 (550 MB) and the MASSIVE dataset (40 MB), trains a few small models and two LoRA adapters; on a T4 it runs in about 70 minutes.</p> <h2 id="setup">Setup</h2> <p>One small helper package, <code class="language-plaintext highlighter-rouge">tfs</code>, draws the course’s plots and token chips and knows where the notebook runs (Kaggle, Colab or your own machine). Everything the lesson teaches is written out in the notebook itself.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">importlib.util</span>
<span class="kn">import</span> <span class="n">subprocess</span>
<span class="kn">import</span> <span class="n">sys</span>

<span class="n">TFS</span> <span class="o">=</span> <span class="sh">"</span><span class="s">git+https://github.com/xmarva/transformers-from-scratch@main</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">importlib</span><span class="p">.</span><span class="n">util</span><span class="p">.</span><span class="nf">find_spec</span><span class="p">(</span><span class="sh">"</span><span class="s">tfs</span><span class="sh">"</span><span class="p">)</span> <span class="ow">is</span> <span class="bp">None</span><span class="p">:</span>
    <span class="n">subprocess</span><span class="p">.</span><span class="nf">check_call</span><span class="p">([</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">-m</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">pip</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">install</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-q</span><span class="sh">"</span><span class="p">,</span> <span class="n">TFS</span><span class="p">])</span>

<span class="kn">from</span> <span class="n">tfs</span> <span class="kn">import</span> <span class="n">env</span>
<span class="kn">from</span> <span class="n">tfs.viz</span> <span class="kn">import</span> <span class="n">table</span><span class="p">,</span> <span class="n">token_chips</span><span class="p">,</span> <span class="n">use_course_style</span>

<span class="n">env</span><span class="p">.</span><span class="nf">quiet</span><span class="p">()</span>  <span class="c1"># no progress bars or environment warnings in the outputs
</span><span class="n">SEED</span> <span class="o">=</span> <span class="mi">42</span>
<span class="n">env</span><span class="p">.</span><span class="nf">seed_everything</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">COLORS</span> <span class="o">=</span> <span class="nf">use_course_style</span><span class="p">()</span>
<span class="n">WORK_DIR</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">work_dir</span><span class="p">()</span>
</code></pre></div></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">json</span>
<span class="kn">import</span> <span class="n">math</span>
<span class="kn">import</span> <span class="n">random</span>
<span class="kn">import</span> <span class="n">re</span>
<span class="kn">import</span> <span class="n">tarfile</span>
<span class="kn">import</span> <span class="n">time</span>
<span class="kn">import</span> <span class="n">urllib.request</span>

<span class="kn">import</span> <span class="n">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>
<span class="kn">import</span> <span class="n">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="n">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">import</span> <span class="n">torch</span>
<span class="kn">import</span> <span class="n">torch.nn</span> <span class="k">as</span> <span class="n">nn</span>
<span class="kn">import</span> <span class="n">torch.nn.functional</span> <span class="k">as</span> <span class="n">F</span>
<span class="kn">from</span> <span class="n">huggingface_hub</span> <span class="kn">import</span> <span class="n">HfApi</span><span class="p">,</span> <span class="n">hf_hub_download</span>
<span class="kn">from</span> <span class="n">safetensors.torch</span> <span class="kn">import</span> <span class="n">load_file</span>
<span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">AutoTokenizer</span>
<span class="c1"># the reference implementations, for the checks
</span><span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">AutoModelForCausalLM</span><span class="p">,</span> <span class="n">GPT2LMHeadModel</span>

<span class="n">SMOKE</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">smoke</span><span class="p">()</span>  <span class="c1"># CI runs the lesson on a small slice; you run it in full
</span><span class="n">device</span> <span class="o">=</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">if</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">is_available</span><span class="p">()</span> <span class="k">else</span> <span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span>
<span class="n">HALF</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">float16</span> <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">else</span> <span class="n">torch</span><span class="p">.</span><span class="n">float32</span>  <span class="c1"># 16-bit matmuls crawl on a CPU
</span><span class="k">assert</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="ow">or</span> <span class="n">SMOKE</span><span class="p">,</span> <span class="sh">"</span><span class="s">This lesson trains models and runs a 4B one: use a GPU</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">GPU:</span><span class="sh">"</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">get_device_name</span><span class="p">(</span><span class="mi">0</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>GPU: Tesla T4</code></pre> <h2 id="1-a-dozen-configs">1. A dozen configs</h2> <p>Every model on Hugging Face comes with a <code class="language-plaintext highlighter-rouge">config.json</code>, a few dozen lines that say how wide the model is, how many layers and heads it has and which of the tricks of its year it uses.</p> <p>It is the fastest way to read an architecture: the code behind it is usually shared with a dozen other models, and the config is what makes this one different. We download the configs of fourteen models released between September 2023 and August 2025.</p> <p>The official repositories of Llama and Gemma ask you to accept a licence before you can download even the config, so for those we read the same files from Unsloth’s public copies.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">MODELS</span> <span class="o">=</span> <span class="p">[</span>  <span class="c1"># repository, name, released; Llama and Gemma from Unsloth's public copies
</span>    <span class="p">(</span><span class="sh">"</span><span class="s">mistralai/Mistral-7B-v0.1</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Mistral 7B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2023-09</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">unsloth/gemma-2-9b</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Gemma 2 9B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2024-06</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">unsloth/Meta-Llama-3.1-8B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Llama 3.1 8B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2024-07</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">unsloth/Llama-3.2-1B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Llama 3.2 1B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2024-09</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">Qwen/Qwen2.5-7B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Qwen2.5 7B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2024-09</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">allenai/OLMo-2-1124-7B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">OLMo 2 7B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2024-11</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">microsoft/phi-4</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Phi-4 14B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2024-12</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">mistralai/Mistral-Small-24B-Base-2501</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Mistral Small 24B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2025-01</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">unsloth/gemma-3-1b-pt</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Gemma 3 1B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2025-03</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">unsloth/gemma-3-27b-pt</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Gemma 3 27B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2025-03</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">Qwen/Qwen3-0.6B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Qwen3 0.6B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2025-04</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">Qwen/Qwen3-8B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Qwen3 8B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2025-04</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">HuggingFaceTB/SmolLM3-3B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">SmolLM3 3B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2025-07</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">openai/gpt-oss-20b</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">gpt-oss 20B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2025-08</span><span class="sh">"</span><span class="p">),</span>
<span class="p">]</span>


<span class="k">def</span> <span class="nf">text_config</span><span class="p">(</span><span class="n">repo</span><span class="p">):</span>
    <span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">repo</span><span class="p">,</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">))</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
        <span class="n">config</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">f</span><span class="p">)</span>
    <span class="k">if</span> <span class="sh">"</span><span class="s">text_config</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">config</span><span class="p">:</span>  <span class="c1"># a multimodal model keeps its language model here
</span>        <span class="n">config</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">text_config</span><span class="sh">"</span><span class="p">]</span>
    <span class="k">if</span> <span class="ow">not</span> <span class="n">config</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">head_dim</span><span class="sh">"</span><span class="p">):</span>
        <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">head_dim</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">]</span> <span class="o">//</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">]</span>
    <span class="k">return</span> <span class="n">config</span>


<span class="n">configs</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">repo</span><span class="p">,</span> <span class="n">name</span><span class="p">,</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">MODELS</span><span class="p">:</span>
    <span class="n">configs</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="o">=</span> <span class="nf">text_config</span><span class="p">(</span><span class="n">repo</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">configs</span><span class="p">),</span> <span class="sh">"</span><span class="s">configs</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>14 configs</code></pre> <p>Three settings need a word before the table. Some models give a layer either <em>global</em> attention, over everything before it, or <em>local</em> attention, over a window of the last few thousand tokens; section 7 is about why, and the config says it in one of three ways.</p> <p>Soft-capping, one of the subjects of section 4, has a setting of its own, <code class="language-plaintext highlighter-rouge">attn_logit_softcapping</code>. QK-norm, the other, doesn’t appear in the config at all, because it is written into the model’s code: we note the model types whose code has it.</p> <p>And Gemma’s configs don’t say whether the input and output embeddings are tied, because Gemma’s code ties them unless told otherwise.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># model types whose attention normalises queries and keys
</span><span class="n">QK_NORM</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">qwen3</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">olmo2</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">gemma3_text</span><span class="sh">"</span><span class="p">}</span>


<span class="k">def</span> <span class="nf">layer_kinds</span><span class="p">(</span><span class="n">c</span><span class="p">):</span>
    <span class="n">n</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">]</span>
    <span class="k">if</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">layer_types</span><span class="sh">"</span><span class="p">):</span>
        <span class="k">return</span> <span class="p">[</span><span class="sh">"</span><span class="s">local</span><span class="sh">"</span> <span class="k">if</span> <span class="n">kind</span> <span class="o">==</span> <span class="sh">"</span><span class="s">sliding_attention</span><span class="sh">"</span> <span class="k">else</span> <span class="sh">"</span><span class="s">global</span><span class="sh">"</span>
                <span class="k">for</span> <span class="n">kind</span> <span class="ow">in</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">layer_types</span><span class="sh">"</span><span class="p">]]</span>
    <span class="k">if</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">sliding_window_pattern</span><span class="sh">"</span><span class="p">):</span>  <span class="c1"># Gemma 3: every sixth layer is global
</span>        <span class="n">pattern</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">sliding_window_pattern</span><span class="sh">"</span><span class="p">]</span>
        <span class="k">return</span> <span class="p">[</span><span class="sh">"</span><span class="s">global</span><span class="sh">"</span> <span class="nf">if </span><span class="p">(</span><span class="n">i</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">%</span> <span class="n">pattern</span> <span class="o">==</span> <span class="mi">0</span> <span class="k">else</span> <span class="sh">"</span><span class="s">local</span><span class="sh">"</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n</span><span class="p">)]</span>
    <span class="k">if</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">model_type</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="sh">"</span><span class="s">gemma2</span><span class="sh">"</span><span class="p">:</span>  <span class="c1"># Gemma 2 alternates, starting with a local layer
</span>        <span class="k">return</span> <span class="p">[</span><span class="sh">"</span><span class="s">local</span><span class="sh">"</span> <span class="k">if</span> <span class="n">i</span> <span class="o">%</span> <span class="mi">2</span> <span class="o">==</span> <span class="mi">0</span> <span class="k">else</span> <span class="sh">"</span><span class="s">global</span><span class="sh">"</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n</span><span class="p">)]</span>
    <span class="k">if</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">sliding_window</span><span class="sh">"</span><span class="p">)</span> <span class="ow">and</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">use_sliding_window</span><span class="sh">"</span><span class="p">,</span> <span class="bp">True</span><span class="p">):</span>
        <span class="k">return</span> <span class="p">[</span><span class="sh">"</span><span class="s">local</span><span class="sh">"</span><span class="p">]</span> <span class="o">*</span> <span class="n">n</span>
    <span class="k">return</span> <span class="p">[</span><span class="sh">"</span><span class="s">global</span><span class="sh">"</span><span class="p">]</span> <span class="o">*</span> <span class="n">n</span>


<span class="k">def</span> <span class="nf">attention_summary</span><span class="p">(</span><span class="n">c</span><span class="p">):</span>
    <span class="n">kinds</span> <span class="o">=</span> <span class="nf">layer_kinds</span><span class="p">(</span><span class="n">c</span><span class="p">)</span>
    <span class="n">local</span> <span class="o">=</span> <span class="n">kinds</span><span class="p">.</span><span class="nf">count</span><span class="p">(</span><span class="sh">"</span><span class="s">local</span><span class="sh">"</span><span class="p">)</span>
    <span class="k">if</span> <span class="n">local</span> <span class="o">==</span> <span class="mi">0</span><span class="p">:</span>
        <span class="k">return</span> <span class="sh">"</span><span class="s">all global</span><span class="sh">"</span>
    <span class="k">if</span> <span class="n">local</span> <span class="o">==</span> <span class="nf">len</span><span class="p">(</span><span class="n">kinds</span><span class="p">):</span>
        <span class="k">return</span> <span class="sa">f</span><span class="sh">"</span><span class="s">all local, </span><span class="si">{</span><span class="n">c</span><span class="p">[</span><span class="sh">'</span><span class="s">sliding_window</span><span class="sh">'</span><span class="p">]</span><span class="si">}</span><span class="sh">"</span>
    <span class="k">return</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">local</span><span class="si">}</span><span class="s"> local : </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">kinds</span><span class="p">)</span> <span class="o">-</span> <span class="n">local</span><span class="si">}</span><span class="s"> global, </span><span class="si">{</span><span class="n">c</span><span class="p">[</span><span class="sh">'</span><span class="s">sliding_window</span><span class="sh">'</span><span class="p">]</span><span class="si">}</span><span class="sh">"</span>


<span class="k">def</span> <span class="nf">tied</span><span class="p">(</span><span class="n">c</span><span class="p">):</span>  <span class="c1"># Gemma's configs leave the key out, and Gemma's code ties by default
</span>    <span class="k">return</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">tie_word_embeddings</span><span class="sh">"</span><span class="p">,</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">model_type</span><span class="sh">"</span><span class="p">].</span><span class="nf">startswith</span><span class="p">(</span><span class="sh">"</span><span class="s">gemma</span><span class="sh">"</span><span class="p">))</span>


<span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">_</span><span class="p">,</span> <span class="n">name</span><span class="p">,</span> <span class="n">released</span> <span class="ow">in</span> <span class="n">MODELS</span><span class="p">:</span>
    <span class="n">c</span> <span class="o">=</span> <span class="n">configs</span><span class="p">[</span><span class="n">name</span><span class="p">]</span>
    <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span>
        <span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">released</span><span class="sh">"</span><span class="p">:</span> <span class="n">released</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">layers</span><span class="sh">"</span><span class="p">:</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">],</span>
        <span class="sh">"</span><span class="s">width</span><span class="sh">"</span><span class="p">:</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span>
        <span class="sh">"</span><span class="s">query heads</span><span class="sh">"</span><span class="p">:</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">],</span>
        <span class="sh">"</span><span class="s">KV heads</span><span class="sh">"</span><span class="p">:</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_key_value_heads</span><span class="sh">"</span><span class="p">],</span>
        <span class="sh">"</span><span class="s">head size</span><span class="sh">"</span><span class="p">:</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">head_dim</span><span class="sh">"</span><span class="p">],</span>
        <span class="sh">"</span><span class="s">attention</span><span class="sh">"</span><span class="p">:</span> <span class="nf">attention_summary</span><span class="p">(</span><span class="n">c</span><span class="p">),</span>
        <span class="sh">"</span><span class="s">QK-norm</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">yes</span><span class="sh">"</span> <span class="k">if</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">model_type</span><span class="sh">"</span><span class="p">]</span> <span class="ow">in</span> <span class="n">QK_NORM</span> <span class="k">else</span> <span class="sh">""</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">soft-cap</span><span class="sh">"</span><span class="p">:</span> <span class="n">c</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">attn_logit_softcapping</span><span class="sh">"</span><span class="p">)</span> <span class="ow">or</span> <span class="sh">""</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">vocabulary</span><span class="sh">"</span><span class="p">:</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span>
        <span class="sh">"</span><span class="s">tied</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">yes</span><span class="sh">"</span> <span class="k">if</span> <span class="nf">tied</span><span class="p">(</span><span class="n">c</span><span class="p">)</span> <span class="k">else</span> <span class="sh">""</span><span class="p">,</span>
    <span class="p">})</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">model</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">released</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">layers</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">width</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">query heads</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">KV heads</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">head size</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">attention</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">QK-norm</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">soft-cap</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">vocabulary</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">tied</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Mistral 7B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2023-09</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4,096</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all local, 4096</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32,000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Gemma 2 9B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2024-06</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">42</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3,584</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">16</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">256</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">21 local : 21 global, 4096</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">50.00</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">256,000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">yes</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Llama 3.1 8B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2024-07</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4,096</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all global</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128,256</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Llama 3.2 1B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2024-09</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">16</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,048</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">64</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all global</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128,256</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">yes</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Qwen2.5 7B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2024-09</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">28</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3,584</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">28</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all global</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">152,064</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">OLMo 2 7B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2024-11</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4,096</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all global</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">yes</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">100,352</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Phi-4 14B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2024-12</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">40</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5,120</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">40</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">10</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all global</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">100,352</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Mistral Small 24B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2025-01</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">40</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5,120</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all global</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">131,072</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Gemma 3 1B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2025-03</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">26</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,152</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">256</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">22 local : 4 global, 512</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">yes</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">262,144</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">yes</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Gemma 3 27B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2025-03</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">62</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5,376</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">16</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">52 local : 10 global, 1024</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">yes</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">262,208</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">yes</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Qwen3 0.6B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2025-04</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">28</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,024</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">16</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all global</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">yes</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">151,936</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">yes</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Qwen3 8B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2025-04</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">36</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4,096</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all global</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">yes</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">151,936</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">SmolLM3 3B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2025-07</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">36</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,048</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">16</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all global</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128,256</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">yes</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">gpt-oss 20B</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2025-08</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">24</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,880</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">64</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">64</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">12 local : 12 global, 128</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">201,088</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"></td></tr></tbody></table></div> <p>Read it column by column and the history of two years falls out.</p> <p><em>KV heads</em> is the first column that tells the models apart. Only OLMo 2 still has as many key-value heads as query heads; every other model shares one key-value head among two to eight query heads, and Gemma 3 1B goes all the way to a single key-value head for all four of its query heads. That is grouped-query attention, section 3.</p> <p><em>Head size</em> used to be the width divided by the number of heads. In Qwen3 0.6B it is not: sixteen heads of 128 make the queries 2,048 wide in a model only 1,024 wide. The width of attention became a setting of its own, chosen for the attention kernels and the KV cache, not derived from the rest.</p> <p><em>Attention</em> shows the second way to save memory, local layers. Mistral 7B made every layer local with a window of 4,096 tokens; its version 0.3 and Mistral Small went back to global attention everywhere, and Ministral 8B made three layers in four local again.</p> <p>Gemma 2 alternates, Gemma 3 keeps one global layer in six, gpt-oss alternates with a window of only 128.</p> <p><em>QK-norm</em> and <em>soft-cap</em> are the stability tricks of section 4. Gemma 2 squashed its scores; Gemma 3, OLMo 2 and Qwen3 normalise queries and keys instead.</p> <p><em>Vocabulary</em> grew from Mistral’s 32,000 to over 262,000 in Gemma 3: more languages, fewer tokens per sentence, and in a small model a large share of all parameters. That is why small models often <em>tie</em> their input and output embeddings, using one matrix for both; Gemma ties them at every size.</p> <p>A few settings didn’t fit in the table. SmolLM3 drops rotary positions from every fourth layer, which see the tokens with no positions at all; Gemma 3 27B scales its scores by the width per head of the whole model, 168, rather than by its head size, 128; the RoPE base, the number that sets the slowest rotation of rotary positions, went from 10,000 in Mistral 7B to 100 million in Mistral Small. Long context, where that number matters, is <a href="/blog/2026/transformer-architectures-09-long/">lesson 9</a>.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">SmolLM3 layers with rotary positions (1) and without (0):</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="n">configs</span><span class="p">[</span><span class="sh">"</span><span class="s">SmolLM3 3B</span><span class="sh">"</span><span class="p">][</span><span class="sh">"</span><span class="s">no_rope_layers</span><span class="sh">"</span><span class="p">])</span>
<span class="n">gemma</span> <span class="o">=</span> <span class="n">configs</span><span class="p">[</span><span class="sh">"</span><span class="s">Gemma 3 27B</span><span class="sh">"</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">Gemma 3 27B scales scores by 1/sqrt of</span><span class="sh">"</span><span class="p">,</span> <span class="n">gemma</span><span class="p">[</span><span class="sh">"</span><span class="s">query_pre_attn_scalar</span><span class="sh">"</span><span class="p">],</span>
      <span class="sh">"</span><span class="s">with heads of</span><span class="sh">"</span><span class="p">,</span> <span class="n">gemma</span><span class="p">[</span><span class="sh">"</span><span class="s">head_dim</span><span class="sh">"</span><span class="p">])</span>
<span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="p">[</span><span class="sh">"</span><span class="s">Mistral 7B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Mistral Small 24B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Llama 3.1 8B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Qwen3 8B</span><span class="sh">"</span><span class="p">]:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="s">: RoPE base </span><span class="si">{</span><span class="n">configs</span><span class="p">[</span><span class="n">name</span><span class="p">][</span><span class="sh">'</span><span class="s">rope_theta</span><span class="sh">'</span><span class="p">]</span><span class="si">:</span><span class="p">,.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>SmolLM3 layers with rotary positions (1) and without (0):
[1, 1, 1, 0, 1, 1, 1, 0, 1, 1, 1, 0, 1, 1, 1, 0, 1, 1, 1, 0, 1, 1, 1, 0, 1, 1, 1, 0, 1, 1, 1, 0, 1, 1, 1, 0]
Gemma 3 27B scales scores by 1/sqrt of 168 with heads of 128
Mistral 7B: RoPE base 10,000
Mistral Small 24B: RoPE base 100,000,000
Llama 3.1 8B: RoPE base 500,000
Qwen3 8B: RoPE base 1,000,000</code></pre> <h2 id="2-the-decoder-block-they-share">2. The decoder block they share</h2> <p>Under the settings, the fourteen models are variations of one machine, the one <a href="https://blog.korolevalab.com/blog/2026/transformers-from-scratch-05-llama/">lesson 5 of the first course</a> built step by step: a stack of decoder blocks with a residual connection around attention and around the feed-forward network, RMSNorm, rotary positions applied to queries and keys, a gated feed-forward network, and in most of them no biases at all.</p> <p>Most put the norm before attention and before the feed-forward network and gate with SiLU, as Llama does. OLMo 2 normalises the outputs of the two instead of their inputs, Gemma 2 and 3 normalise both and gate with GELU, and gpt-oss replaces the feed-forward network with a mixture of experts, the subject of <a href="/blog/2026/transformer-architectures-07-moe/">lesson 7</a>.</p> <p>GPT-2, in <a href="/blog/2026/transformer-architectures-04-gpt/">lesson 4</a>, had LayerNorm, learned positions and GELU; of its block only the residual stream, the causal mask and, in most models, the norm before each part survived.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/06/skeleton-light.png" width="760" alt="Two decoder blocks side by side. GPT-2's, from lesson 4: LayerNorm, attention with learned position embeddings added to the input, LayerNorm, a GELU feed-forward network, biases everywhere. The modern block: RMSNorm, attention with rotary positions applied to queries and keys inside it, RMSNorm, a SwiGLU feed-forward network with three matrices, no biases. The places where this lesson's changes act are marked: the key-value heads, the mask, the queries and keys, the scores" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/06/skeleton-dark.png" width="760" alt="Two decoder blocks side by side. GPT-2's, from lesson 4: LayerNorm, attention with learned position embeddings added to the input, LayerNorm, a GELU feed-forward network, biases everywhere. The modern block: RMSNorm, attention with rotary positions applied to queries and keys inside it, RMSNorm, a SwiGLU feed-forward network with three matrices, no biases. The places where this lesson's changes act are marked: the key-value heads, the mask, the queries and keys, the scores" loading="lazy"></p> <p>What is left to change are the details of attention, and that is where the two pressures act. The rest of the lesson takes them in the order they arrive when you run a model: first generation, where memory runs out, then training, where stability does.</p> <h2 id="3-grouped-query-attention">3. Grouped-query attention</h2> <p>Generating text is a strange workload for a GPU. To write one token the model multiplies a single vector by every weight matrix it has, and attends to every token before it.</p> <p>The multiplications are trivial; moving the numbers is not. Each new token reads all the weights from memory once, which is shared by everyone in the batch, and reads its own sequence’s KV cache, which is shared by nobody.</p> <p>In 2019 Noam Shazeer put it plainly: incremental inference “is often slow, due to the memory-bandwidth cost of repeatedly loading the large “keys” and “values” tensors” <sup class="cite">[<a href="#ref-1" id="cite-1" data-ref="1" aria-label="Reference 1: Shazeer, N. (2019). Fast Transformer decoding: one write-head is all you need. arXiv:1911.02150.">1</a>]</sup>.</p> <p>The cache for one token holds a key and a value of \(d_h\) numbers for each of \(n_{kv}\) heads in each of \(L\) layers, in \(b\) bytes per number:</p> \[\text{KV bytes per token} = 2 \cdot L \cdot n_{kv} \cdot d_h \cdot b.\] <p>In the original Transformer every query head had its own keys and values, so \(n_{kv} = n_h\). Shazeer’s <em>multi-query attention</em> kept all the query heads and gave them a single key-value head between them, \(n_{kv} = 1\): “the keys and values are shared across all of the different attention “heads””. The cache shrank by the number of heads, and decoding sped up, at the price of what Shazeer called “only minor quality degradation”. The authors of the next idea put it less kindly: MQA “can lead to quality degradation and training instability”.</p> <p>In 2023 a Google team proposed the middle ground, <em>grouped-query attention</em>: split the \(n_h\) query heads into \(n_{kv}\) groups and give each group one key-value head<sup class="cite">[<a href="#ref-2" id="cite-2" data-ref="2" aria-label="Reference 2: Ainslie, J., Lee-Thorp, J., de Jong, M., Zemlyanskiy, Y., Lebrón, F., &amp; Sanghai, S. (2023). GQA: training generalized multi-query Transformer models from multi-head checkpoints. EMNLP 2023.">2</a>]</sup>. Their verdict: GQA “achieves quality close to <a href="/blog/2026/transformers-from-scratch-02-transformer/">multi-head attention</a> with comparable speed to MQA”.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/06/gqa-light.png" width="760" alt="Three ways to give query heads their keys and values, with eight query heads. Multi-head attention: each query head has its own key-value head, eight in all. Grouped-query attention: four groups of two query heads, each group sharing one key-value head, four in all. Multi-query attention: all eight query heads share one key-value head. Below each, the KV cache per token, in proportion: eight, four and one units" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/06/gqa-dark.png" width="760" alt="Three ways to give query heads their keys and values, with eight query heads. Multi-head attention: each query head has its own key-value head, eight in all. Grouped-query attention: four groups of two query heads, each group sharing one key-value head, four in all. Multi-query attention: all eight query heads share one key-value head. Below each, the KV cache per token, in proportion: eight, four and one units" loading="lazy"></p> <p>In code the sharing costs one line: before the scores are computed, each key-value head is repeated for the query heads of its group. Query head \(h\) reads key-value head \(\lfloor h / g \rfloor\), where \(g = n_h / n_{kv}\) is the size of a group.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">grouped_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">,</span> <span class="n">mask</span><span class="p">):</span>
    <span class="n">group</span> <span class="o">=</span> <span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span> <span class="o">//</span> <span class="n">k</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>  <span class="c1"># query heads per key-value head
</span>    <span class="n">k</span> <span class="o">=</span> <span class="n">k</span><span class="p">.</span><span class="nf">repeat_interleave</span><span class="p">(</span><span class="n">group</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>  <span class="c1"># heads 0..g-1 read key-value head 0, and so on
</span>    <span class="n">v</span> <span class="o">=</span> <span class="n">v</span><span class="p">.</span><span class="nf">repeat_interleave</span><span class="p">(</span><span class="n">group</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">scores</span> <span class="o">=</span> <span class="n">q</span> <span class="o">@</span> <span class="n">k</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">2</span><span class="p">)</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">])</span>
    <span class="n">scores</span> <span class="o">=</span> <span class="n">scores</span><span class="p">.</span><span class="nf">masked_fill</span><span class="p">(</span><span class="o">~</span><span class="n">mask</span><span class="p">,</span> <span class="nf">float</span><span class="p">(</span><span class="sh">"</span><span class="s">-inf</span><span class="sh">"</span><span class="p">))</span>
    <span class="k">return</span> <span class="n">scores</span><span class="p">.</span><span class="nf">softmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span> <span class="o">@</span> <span class="n">v</span>


<span class="n">q</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">8</span><span class="p">,</span> <span class="mi">5</span><span class="p">,</span> <span class="mi">16</span><span class="p">)</span>  <span class="c1"># batch, query heads, tokens, head size
</span><span class="n">k</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">5</span><span class="p">,</span> <span class="mi">16</span><span class="p">)</span>  <span class="c1"># two key-value heads: groups of four
</span><span class="n">v</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">5</span><span class="p">,</span> <span class="mi">16</span><span class="p">)</span>
<span class="n">mask</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="mi">5</span><span class="p">,</span> <span class="mi">5</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">).</span><span class="nf">tril</span><span class="p">()</span>
<span class="n">ours</span> <span class="o">=</span> <span class="nf">grouped_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">,</span> <span class="n">mask</span><span class="p">)</span>
<span class="n">reference</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">scaled_dot_product_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">,</span> <span class="n">attn_mask</span><span class="o">=</span><span class="n">mask</span><span class="p">,</span> <span class="n">enable_gqa</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">output</span><span class="sh">"</span><span class="p">,</span> <span class="nf">tuple</span><span class="p">(</span><span class="n">ours</span><span class="p">.</span><span class="n">shape</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">max difference from PyTorch</span><span class="sh">'</span><span class="s">s GQA:</span><span class="sh">"</span><span class="p">,</span> <span class="p">(</span><span class="n">ours</span> <span class="o">-</span> <span class="n">reference</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">())</span>
</code></pre></div></div> <pre class="tfs-printed"><code>output (1, 8, 5, 16)
max difference from PyTorch's GQA: 2.384185791015625e-07</code></pre> <p>The repeat makes a copy for clarity; fused attention kernels such as <a href="/blog/2026/transformers-from-scratch-05-llama/">FlashAttention</a> read the shared head in place, which is the point: in a group of \(g\), every key and value read from memory serves \(g\) query heads instead of one. The cache is \(g\) times smaller <em>and</em> each byte of it does \(g\) times more work.</p> <p>Why not take an existing model and share its heads? Ainslie et al. did exactly that, but they then trained the converted model further with 5% of its original <a href="/blog/2024/llms-for-those-who-missed-out/">pre-training</a> compute, and they had a reason.</p> <p>Here is GPT-2 small, twelve heads in each of twelve layers, forced to share: within each group of heads we replace every head’s key and value projections by their average, the conversion the GQA paper found best, and measure the loss on Wikipedia text it has never seen. No training afterwards.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">gpt2</span> <span class="o">=</span> <span class="n">GPT2LMHeadModel</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="sh">"</span><span class="s">openai-community/gpt2</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="n">gpt2_tok</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="sh">"</span><span class="s">openai-community/gpt2</span><span class="sh">"</span><span class="p">)</span>
<span class="n">WIKITEXT</span> <span class="o">=</span> <span class="sh">"</span><span class="s">Salesforce/wikitext</span><span class="sh">"</span>
<span class="n">path</span> <span class="o">=</span> <span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">WIKITEXT</span><span class="p">,</span> <span class="sh">"</span><span class="s">wikitext-103-raw-v1/test-00000-of-00001.parquet</span><span class="sh">"</span><span class="p">,</span>
                       <span class="n">repo_type</span><span class="o">=</span><span class="sh">"</span><span class="s">dataset</span><span class="sh">"</span><span class="p">)</span>
<span class="n">wiki</span> <span class="o">=</span> <span class="sh">""</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nf">read_parquet</span><span class="p">(</span><span class="n">path</span><span class="p">)[</span><span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">].</span><span class="nf">tolist</span><span class="p">())</span>
<span class="n">wiki_ids</span> <span class="o">=</span> <span class="nf">gpt2_tok</span><span class="p">(</span><span class="n">wiki</span><span class="p">[:</span><span class="mi">200_000</span><span class="p">]).</span><span class="n">input_ids</span><span class="p">[:</span><span class="mi">8</span> <span class="o">*</span> <span class="mi">1024</span><span class="p">]</span>
<span class="n">wiki_batch</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">wiki_ids</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">).</span><span class="nf">view</span><span class="p">(</span><span class="mi">8</span><span class="p">,</span> <span class="mi">1024</span><span class="p">)</span>
<span class="n">original</span> <span class="o">=</span> <span class="p">{</span><span class="n">name</span><span class="p">:</span> <span class="n">value</span><span class="p">.</span><span class="nf">clone</span><span class="p">()</span> <span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">value</span> <span class="ow">in</span> <span class="n">gpt2</span><span class="p">.</span><span class="nf">state_dict</span><span class="p">().</span><span class="nf">items</span><span class="p">()}</span>


<span class="k">def</span> <span class="nf">share_heads</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">kv_heads</span><span class="p">):</span>
    <span class="n">d</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="n">config</span><span class="p">.</span><span class="n">n_embd</span>
    <span class="n">heads</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="n">config</span><span class="p">.</span><span class="n">n_head</span>
    <span class="n">size</span> <span class="o">=</span> <span class="n">heads</span> <span class="o">//</span> <span class="n">kv_heads</span>  <span class="c1"># query heads per group
</span>    <span class="k">for</span> <span class="n">block</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="n">transformer</span><span class="p">.</span><span class="n">h</span><span class="p">:</span>
        <span class="n">weight</span> <span class="o">=</span> <span class="n">block</span><span class="p">.</span><span class="n">attn</span><span class="p">.</span><span class="n">c_attn</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">data</span>  <span class="c1"># columns: queries | keys | values
</span>        <span class="n">bias</span> <span class="o">=</span> <span class="n">block</span><span class="p">.</span><span class="n">attn</span><span class="p">.</span><span class="n">c_attn</span><span class="p">.</span><span class="n">bias</span><span class="p">.</span><span class="n">data</span>
        <span class="k">for</span> <span class="n">part</span> <span class="ow">in</span> <span class="p">[</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">]:</span>  <span class="c1"># keys, then values
</span>            <span class="n">columns</span> <span class="o">=</span> <span class="nf">slice</span><span class="p">(</span><span class="n">part</span> <span class="o">*</span> <span class="n">d</span><span class="p">,</span> <span class="p">(</span><span class="n">part</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">*</span> <span class="n">d</span><span class="p">)</span>
            <span class="n">w</span> <span class="o">=</span> <span class="n">weight</span><span class="p">[:,</span> <span class="n">columns</span><span class="p">].</span><span class="nf">view</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">heads</span><span class="p">,</span> <span class="n">d</span> <span class="o">//</span> <span class="n">heads</span><span class="p">)</span>
            <span class="n">b</span> <span class="o">=</span> <span class="n">bias</span><span class="p">[</span><span class="n">columns</span><span class="p">].</span><span class="nf">view</span><span class="p">(</span><span class="n">heads</span><span class="p">,</span> <span class="n">d</span> <span class="o">//</span> <span class="n">heads</span><span class="p">)</span>
            <span class="k">for</span> <span class="n">g</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">kv_heads</span><span class="p">):</span>
                <span class="n">group</span> <span class="o">=</span> <span class="nf">slice</span><span class="p">(</span><span class="n">g</span> <span class="o">*</span> <span class="n">size</span><span class="p">,</span> <span class="p">(</span><span class="n">g</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">*</span> <span class="n">size</span><span class="p">)</span>
                <span class="n">w</span><span class="p">[:,</span> <span class="n">group</span><span class="p">]</span> <span class="o">=</span> <span class="n">w</span><span class="p">[:,</span> <span class="n">group</span><span class="p">].</span><span class="nf">mean</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
                <span class="n">b</span><span class="p">[</span><span class="n">group</span><span class="p">]</span> <span class="o">=</span> <span class="n">b</span><span class="p">[</span><span class="n">group</span><span class="p">].</span><span class="nf">mean</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>


<span class="n">shared</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">kv_heads</span> <span class="ow">in</span> <span class="p">[</span><span class="mi">12</span><span class="p">,</span> <span class="mi">6</span><span class="p">,</span> <span class="mi">4</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">1</span><span class="p">]:</span>
    <span class="n">gpt2</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">(</span><span class="n">original</span><span class="p">)</span>
    <span class="nf">share_heads</span><span class="p">(</span><span class="n">gpt2</span><span class="p">,</span> <span class="n">kv_heads</span><span class="p">)</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="n">loss</span> <span class="o">=</span> <span class="nf">gpt2</span><span class="p">(</span><span class="n">wiki_batch</span><span class="p">,</span> <span class="n">labels</span><span class="o">=</span><span class="n">wiki_batch</span><span class="p">).</span><span class="n">loss</span><span class="p">.</span><span class="nf">item</span><span class="p">()</span>
    <span class="n">shared</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">key-value heads</span><span class="sh">"</span><span class="p">:</span> <span class="n">kv_heads</span><span class="p">,</span> <span class="sh">"</span><span class="s">query heads per group</span><span class="sh">"</span><span class="p">:</span> <span class="mi">12</span> <span class="o">//</span> <span class="n">kv_heads</span><span class="p">,</span>
                   <span class="sh">"</span><span class="s">loss</span><span class="sh">"</span><span class="p">:</span> <span class="n">loss</span><span class="p">,</span> <span class="sh">"</span><span class="s">perplexity</span><span class="sh">"</span><span class="p">:</span> <span class="n">math</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">loss</span><span class="p">)})</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">shared</span><span class="p">))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">key-value heads</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">query heads per group</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">loss</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">perplexity</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">12</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.49</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32.65</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6.59</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">728.08</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6.93</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,025.99</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7.12</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,238.80</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7.02</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,113.92</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">12</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7.20</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,342.50</td></tr></tbody></table></div> <p>Sharing ruins the model. With every head on its own, GPT-2 reads Wikipedia as well as it ever did.</p> <p>Halve the key-value heads and its perplexity grows by more than an order of magnitude, and with fewer heads it stays about that bad. Each head of a trained model learned its own keys and values, and their average is none of them.</p> <p>So a model is either trained with grouped queries from the start, as Llama 3 and most models after it were, or converted and then trained again.</p> <p>Here is what it buys, for every model of section 1: the KV cache of one sequence of 32,768 tokens in 16-bit numbers, against the cache the same model would need with a key-value head for every query head. A local layer keeps only its window, and we count that too; section 7 explains it.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">kv_cache_bytes</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="n">tokens</span><span class="p">,</span> <span class="n">kv_heads</span><span class="o">=</span><span class="bp">None</span><span class="p">,</span> <span class="n">windows</span><span class="o">=</span><span class="bp">True</span><span class="p">):</span>
    <span class="k">if</span> <span class="n">kv_heads</span> <span class="ow">is</span> <span class="bp">None</span><span class="p">:</span>
        <span class="n">kv_heads</span> <span class="o">=</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">num_key_value_heads</span><span class="sh">"</span><span class="p">]</span>
    <span class="n">total</span> <span class="o">=</span> <span class="mi">0</span>
    <span class="k">for</span> <span class="n">kind</span> <span class="ow">in</span> <span class="nf">layer_kinds</span><span class="p">(</span><span class="n">c</span><span class="p">):</span>
        <span class="n">local</span> <span class="o">=</span> <span class="n">windows</span> <span class="ow">and</span> <span class="n">kind</span> <span class="o">==</span> <span class="sh">"</span><span class="s">local</span><span class="sh">"</span>
        <span class="n">kept</span> <span class="o">=</span> <span class="nf">min</span><span class="p">(</span><span class="n">tokens</span><span class="p">,</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">sliding_window</span><span class="sh">"</span><span class="p">])</span> <span class="k">if</span> <span class="n">local</span> <span class="k">else</span> <span class="n">tokens</span>
        <span class="n">total</span> <span class="o">+=</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">kept</span> <span class="o">*</span> <span class="n">kv_heads</span> <span class="o">*</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">head_dim</span><span class="sh">"</span><span class="p">]</span> <span class="o">*</span> <span class="mi">2</span>  <span class="c1"># keys and values, 2 bytes each
</span>    <span class="k">return</span> <span class="n">total</span>


<span class="n">context</span> <span class="o">=</span> <span class="mi">32_768</span>
<span class="n">names</span> <span class="o">=</span> <span class="p">[</span><span class="n">name</span> <span class="k">for</span> <span class="n">_</span><span class="p">,</span> <span class="n">name</span><span class="p">,</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">MODELS</span><span class="p">]</span>
<span class="n">actual</span> <span class="o">=</span> <span class="p">[</span><span class="nf">kv_cache_bytes</span><span class="p">(</span><span class="n">configs</span><span class="p">[</span><span class="n">n</span><span class="p">],</span> <span class="n">context</span><span class="p">)</span> <span class="o">/</span> <span class="mf">1e9</span> <span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="n">names</span><span class="p">]</span>
<span class="n">full</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="n">names</span><span class="p">:</span>
    <span class="n">every_head</span> <span class="o">=</span> <span class="n">configs</span><span class="p">[</span><span class="n">n</span><span class="p">][</span><span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">]</span>
    <span class="n">full</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="nf">kv_cache_bytes</span><span class="p">(</span><span class="n">configs</span><span class="p">[</span><span class="n">n</span><span class="p">],</span> <span class="n">context</span><span class="p">,</span> <span class="n">every_head</span><span class="p">,</span> <span class="n">windows</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span> <span class="o">/</span> <span class="mf">1e9</span><span class="p">)</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">7.6</span><span class="p">,</span> <span class="mf">5.2</span><span class="p">))</span>
<span class="n">y</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">names</span><span class="p">))</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">barh</span><span class="p">(</span><span class="n">y</span><span class="p">,</span> <span class="n">full</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">grid</span><span class="sh">"</span><span class="p">],</span>
        <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">a key-value head for every query head, all global</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">barh</span><span class="p">(</span><span class="n">y</span><span class="p">,</span> <span class="n">actual</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">],</span> <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">as configured</span><span class="sh">"</span><span class="p">)</span>
<span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">names</span><span class="p">)):</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">text</span><span class="p">(</span><span class="n">actual</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="o">+</span> <span class="mf">0.4</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">actual</span><span class="p">[</span><span class="n">k</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s"> GB</span><span class="sh">"</span><span class="p">,</span> <span class="n">va</span><span class="o">=</span><span class="sh">"</span><span class="s">center</span><span class="sh">"</span><span class="p">,</span>
            <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">],</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">9</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_yticks</span><span class="p">(</span><span class="n">y</span><span class="p">,</span> <span class="n">names</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">invert_yaxis</span><span class="p">()</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">KV cache of one sequence of </span><span class="si">{</span><span class="n">context</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> tokens, GB</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">What grouped queries and local layers save</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">loc</span><span class="o">=</span><span class="sh">"</span><span class="s">upper center</span><span class="sh">"</span><span class="p">,</span> <span class="n">bbox_to_anchor</span><span class="o">=</span><span class="p">(</span><span class="mf">0.5</span><span class="p">,</span> <span class="o">-</span><span class="mf">0.12</span><span class="p">),</span> <span class="n">ncol</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">grid</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="sh">"</span><span class="s">x</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">grid</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="sh">"</span><span class="s">y</span><span class="sh">"</span><span class="p">,</span> <span class="n">visible</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/06/output-01.png" alt="What grouped queries and local layers save" loading="lazy"></p> <p>The grey bars are what these models would need with neither trick. Grouped queries alone cut the cache by the size of a group, two to eight times; local layers cut it further, and in Gemma 3 and gpt-oss the few global layers end up holding nearly all of it.</p> <p>OLMo 2, with a key-value head for every query head and no local layers, needs the largest cache in the table, although it is far from the largest model.</p> <p>And the claim this lesson opened with, checked: Llama 3.1 8B’s cache at its full context of 131,072 tokens against its weights, both in 16 bits.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">llama</span> <span class="o">=</span> <span class="n">configs</span><span class="p">[</span><span class="sh">"</span><span class="s">Llama 3.1 8B</span><span class="sh">"</span><span class="p">]</span>
<span class="n">metadata</span> <span class="o">=</span> <span class="nc">HfApi</span><span class="p">().</span><span class="nf">get_safetensors_metadata</span><span class="p">(</span><span class="sh">"</span><span class="s">unsloth/Meta-Llama-3.1-8B</span><span class="sh">"</span><span class="p">)</span>
<span class="n">llama_params</span> <span class="o">=</span> <span class="nf">sum</span><span class="p">(</span><span class="n">metadata</span><span class="p">.</span><span class="n">parameter_count</span><span class="p">.</span><span class="nf">values</span><span class="p">())</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">weights: </span><span class="si">{</span><span class="n">llama_params</span> <span class="o">*</span> <span class="mi">2</span> <span class="o">/</span> <span class="mf">1e9</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s"> GB</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">KV cache at 131,072 tokens: </span><span class="si">{</span><span class="nf">kv_cache_bytes</span><span class="p">(</span><span class="n">llama</span><span class="p">,</span> <span class="mi">131_072</span><span class="p">)</span> <span class="o">/</span> <span class="mf">1e9</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s"> GB</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">the same with a key-value head per query head: </span><span class="sh">"</span>
      <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">kv_cache_bytes</span><span class="p">(</span><span class="n">llama</span><span class="p">,</span> <span class="mi">131_072</span><span class="p">,</span> <span class="n">llama</span><span class="p">[</span><span class="sh">'</span><span class="s">num_attention_heads</span><span class="sh">'</span><span class="p">])</span> <span class="o">/</span> <span class="mf">1e9</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s"> GB</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>weights: 16.1 GB
KV cache at 131,072 tokens: 17.2 GB
the same with a key-value head per query head: 68.7 GB</code></pre> <h2 id="4-training-stability-qk-norm-and-soft-capping">4. Training stability, QK-norm and soft-capping</h2> <p>The second pressure shows up during training, and it shows up late, which is what makes it expensive. In 2023 a Google team scaling a Vision Transformer to 22 billion parameters watched their 8-billion-parameter run diverge after a few thousand steps.</p> <p>The cause was the attention scores: they grew without bound, the softmax over them turned into a one-hot vector, every head looked at a single token with an entropy near zero, and the loss went up <sup class="cite">[<a href="#ref-3" id="cite-3" data-ref="3" aria-label="Reference 3: Dehghani, M., Djolonga, J., Mustafa, B., et al. (2023). Scaling vision Transformers to 22 billion parameters. ICML 2023.">3</a>]</sup>.</p> <p>The mechanism is easy to see in the formula. The score of query \(i\) for key \(j\) is</p> \[s_{ij} = \frac{q_i \cdot k_j}{\sqrt{d_h}}, \qquad q_i = W_Q x_i, \quad k_j = W_K x_j.\] <p>Both \(q\) and \(k\) grow with their weight matrices, so if training scales both \(W_Q\) and \(W_K\) by a factor \(c\), the scores grow by \(c^2\). A softmax doesn’t care about the scale of its inputs until it does: multiply scores of 1, 2 and 3 by 30 and almost all the weight lands on the largest. Past that point the gradient through the softmax vanishes for every other key, and a head that has collapsed onto one token has no way back.</p> <p>Two fixes are in the table of section 1. <em>QK-norm</em> normalises each query and each key before the dot product, the same RMSNorm as everywhere else, with its own learned scale \(g\).</p> <p>Qwen3 and Gemma 3 apply it to one head’s vector at a time, with one scale shared by the heads of a layer; OLMo 2 normalises the whole projection at once.</p> \[\hat q = g_q \odot \frac{q}{\text{rms}(q)}, \qquad \hat k = g_k \odot \frac{k}{\text{rms}(k)},\] \[s_{ij} = \frac{\hat q_i \cdot \hat k_j}{\sqrt{d_h}}.\] <p>Now \(\lVert \hat q \rVert = \sqrt{d_h}\) before the scale, and the score can only grow if training grows \(g_q\) and \(g_k\) themselves, slowly and in plain sight. <em>Soft-capping</em>, Gemma 2’s fix, leaves the scores alone until they get large and then bends them smoothly towards a ceiling \(c\):</p> \[s \;\leftarrow\; c \cdot \tanh\!\left(\frac{s}{c}\right).\] <p>Gemma 2 used \(c = 50\) in attention and \(c = 30\) on the final logits, the scores of the vocabulary<sup class="cite">[<a href="#ref-4" id="cite-4" data-ref="4" aria-label="Reference 4: Gemma Team (2024). Gemma 2: improving open language models at a practical size. arXiv:2408.00118.">4</a>]</sup>.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">s</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">linspace</span><span class="p">(</span><span class="o">-</span><span class="mi">150</span><span class="p">,</span> <span class="mi">150</span><span class="p">,</span> <span class="mi">601</span><span class="p">)</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.4</span><span class="p">,</span> <span class="mf">3.2</span><span class="p">))</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">s</span><span class="p">,</span> <span class="n">s</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">],</span> <span class="n">linestyle</span><span class="o">=</span><span class="sh">"</span><span class="s">--</span><span class="sh">"</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">no cap</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">s</span><span class="p">,</span> <span class="mi">50</span> <span class="o">*</span> <span class="n">np</span><span class="p">.</span><span class="nf">tanh</span><span class="p">(</span><span class="n">s</span> <span class="o">/</span> <span class="mi">50</span><span class="p">),</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">],</span>
        <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">50 · tanh(s / 50), Gemma 2</span><span class="sh">'</span><span class="s">s attention</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">s</span><span class="p">,</span> <span class="mi">30</span> <span class="o">*</span> <span class="n">np</span><span class="p">.</span><span class="nf">tanh</span><span class="p">(</span><span class="n">s</span> <span class="o">/</span> <span class="mi">30</span><span class="p">),</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">],</span>
        <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">30 · tanh(s / 30), its final logits</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylim</span><span class="p">(</span><span class="o">-</span><span class="mi">80</span><span class="p">,</span> <span class="mi">80</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">score before the cap</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">score after</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">Soft-capping bends large scores towards a ceiling</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">loc</span><span class="o">=</span><span class="sh">"</span><span class="s">upper left</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/06/output-02.png" alt="Soft-capping bends large scores towards a ceiling" loading="lazy"></p> <p>Gemma 3 dropped soft-capping in favour of QK-norm: “we replace the soft-capping of Gemma 2 with QK-norm”<sup class="cite">[<a href="#ref-5" id="cite-5" data-ref="5" aria-label="Reference 5: Gemma Team (2025). Gemma 3 technical report. arXiv:2503.19786.">5</a>]</sup>. The two are not equivalent: a cap only limits the score, while QK-norm limits the vectors that make it, and leaves the model a learned scale to set how sharp attention may get.</p> <p>You don’t need 8 billion parameters to watch this happen. Wortsman et al. showed that the same instabilities “also appear in small models when training at high learning rates”<sup class="cite">[<a href="#ref-6" id="cite-6" data-ref="6" aria-label="Reference 6: Wortsman, M., Liu, P. J., Xiao, L., et al. (2023). Small-scale proxies for large-scale Transformer training instabilities. ICLR 2024.">6</a>]</sup>, and that turns a disaster costing millions into an experiment costing minutes.</p> <p>Below is a small Transformer of the modern kind, six layers wide 384, reading Wikipedia byte by byte, with a switch for its attention: plain, with QK-norm, or with a soft cap at 50. It computes its scores by hand so that we can record the largest one in every layer as it trains.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">Norm</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">dim</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">weight</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">dim</span><span class="p">))</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="n">weight</span> <span class="o">*</span> <span class="n">x</span> <span class="o">*</span> <span class="n">torch</span><span class="p">.</span><span class="nf">rsqrt</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="nf">pow</span><span class="p">(</span><span class="mi">2</span><span class="p">).</span><span class="nf">mean</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span> <span class="o">+</span> <span class="mf">1e-6</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">rope_rotate</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">theta</span><span class="o">=</span><span class="mf">10000.0</span><span class="p">):</span>
    <span class="n">t</span><span class="p">,</span> <span class="n">d</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">2</span><span class="p">],</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
    <span class="n">inv_freq</span> <span class="o">=</span> <span class="mf">1.0</span> <span class="o">/</span> <span class="n">theta</span> <span class="o">**</span> <span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">x</span><span class="p">.</span><span class="n">device</span><span class="p">).</span><span class="nf">float</span><span class="p">()</span> <span class="o">/</span> <span class="n">d</span><span class="p">)</span>
    <span class="n">angles</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">t</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">x</span><span class="p">.</span><span class="n">device</span><span class="p">).</span><span class="nf">float</span><span class="p">()[:,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="n">inv_freq</span>
    <span class="n">angles</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">angles</span><span class="p">,</span> <span class="n">angles</span><span class="p">],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">half</span> <span class="o">=</span> <span class="n">d</span> <span class="o">//</span> <span class="mi">2</span>
    <span class="n">rotated</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="o">-</span><span class="n">x</span><span class="p">[...,</span> <span class="n">half</span><span class="p">:],</span> <span class="n">x</span><span class="p">[...,</span> <span class="p">:</span><span class="n">half</span><span class="p">]],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">x</span> <span class="o">*</span> <span class="n">angles</span><span class="p">.</span><span class="nf">cos</span><span class="p">()</span> <span class="o">+</span> <span class="n">rotated</span> <span class="o">*</span> <span class="n">angles</span><span class="p">.</span><span class="nf">sin</span><span class="p">()</span>


<span class="k">class</span> <span class="nc">TinyAttention</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">heads</span><span class="p">,</span> <span class="n">variant</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">variant</span> <span class="o">=</span> <span class="n">heads</span><span class="p">,</span> <span class="n">d</span> <span class="o">//</span> <span class="n">heads</span><span class="p">,</span> <span class="n">variant</span>
        <span class="n">self</span><span class="p">.</span><span class="n">qkv</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="mi">3</span> <span class="o">*</span> <span class="n">d</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">out</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">variant</span> <span class="o">==</span> <span class="sh">"</span><span class="s">QK-norm</span><span class="sh">"</span><span class="p">:</span>
            <span class="n">self</span><span class="p">.</span><span class="n">q_norm</span> <span class="o">=</span> <span class="nc">Norm</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">)</span>
            <span class="n">self</span><span class="p">.</span><span class="n">k_norm</span> <span class="o">=</span> <span class="nc">Norm</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">peak</span> <span class="o">=</span> <span class="mf">0.0</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">d</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span>
        <span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">qkv</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">view</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">).</span><span class="nf">unbind</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">self</span><span class="p">.</span><span class="n">variant</span> <span class="o">==</span> <span class="sh">"</span><span class="s">QK-norm</span><span class="sh">"</span><span class="p">:</span>
            <span class="n">q</span><span class="p">,</span> <span class="n">k</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">q_norm</span><span class="p">(</span><span class="n">q</span><span class="p">),</span> <span class="n">self</span><span class="p">.</span><span class="nf">k_norm</span><span class="p">(</span><span class="n">k</span><span class="p">)</span>
        <span class="n">q</span> <span class="o">=</span> <span class="nf">rope_rotate</span><span class="p">(</span><span class="n">q</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">))</span>
        <span class="n">k</span> <span class="o">=</span> <span class="nf">rope_rotate</span><span class="p">(</span><span class="n">k</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">))</span>
        <span class="n">v</span> <span class="o">=</span> <span class="n">v</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
        <span class="n">scores</span> <span class="o">=</span> <span class="n">q</span> <span class="o">@</span> <span class="n">k</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">2</span><span class="p">)</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">)</span>
        <span class="n">causal</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">t</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">x</span><span class="p">.</span><span class="n">device</span><span class="p">).</span><span class="nf">tril</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">peak</span> <span class="o">=</span> <span class="n">scores</span><span class="p">.</span><span class="nf">detach</span><span class="p">().</span><span class="nf">masked_fill</span><span class="p">(</span><span class="o">~</span><span class="n">causal</span><span class="p">,</span> <span class="mi">0</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">amax</span><span class="p">()</span>
        <span class="k">if</span> <span class="n">self</span><span class="p">.</span><span class="n">variant</span> <span class="o">==</span> <span class="sh">"</span><span class="s">soft-cap</span><span class="sh">"</span><span class="p">:</span>
            <span class="n">scores</span> <span class="o">=</span> <span class="mi">50</span> <span class="o">*</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tanh</span><span class="p">(</span><span class="n">scores</span> <span class="o">/</span> <span class="mi">50</span><span class="p">)</span>
        <span class="n">weights</span> <span class="o">=</span> <span class="n">scores</span><span class="p">.</span><span class="nf">masked_fill</span><span class="p">(</span><span class="o">~</span><span class="n">causal</span><span class="p">,</span> <span class="nf">float</span><span class="p">(</span><span class="sh">"</span><span class="s">-inf</span><span class="sh">"</span><span class="p">)).</span><span class="nf">softmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">out</span><span class="p">((</span><span class="n">weights</span> <span class="o">@</span> <span class="n">v</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">d</span><span class="p">))</span>


<span class="k">class</span> <span class="nc">TinyBlock</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">heads</span><span class="p">,</span> <span class="n">variant</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm1</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">norm2</span> <span class="o">=</span> <span class="nc">Norm</span><span class="p">(</span><span class="n">d</span><span class="p">),</span> <span class="nc">Norm</span><span class="p">(</span><span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">attention</span> <span class="o">=</span> <span class="nc">TinyAttention</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">heads</span><span class="p">,</span> <span class="n">variant</span><span class="p">)</span>
        <span class="n">hidden</span> <span class="o">=</span> <span class="mi">1024</span>
        <span class="n">self</span><span class="p">.</span><span class="n">gate</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">hidden</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">up</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">hidden</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">down</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">hidden</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">attention</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">norm1</span><span class="p">(</span><span class="n">x</span><span class="p">))</span>
        <span class="n">h</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm2</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">down</span><span class="p">(</span><span class="n">F</span><span class="p">.</span><span class="nf">silu</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">gate</span><span class="p">(</span><span class="n">h</span><span class="p">))</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="nf">up</span><span class="p">(</span><span class="n">h</span><span class="p">))</span>


<span class="k">class</span> <span class="nc">TinyLM</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">variant</span><span class="p">,</span> <span class="n">d</span><span class="o">=</span><span class="mi">384</span><span class="p">,</span> <span class="n">layers</span><span class="o">=</span><span class="mi">6</span><span class="p">,</span> <span class="n">heads</span><span class="o">=</span><span class="mi">6</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">embed</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="mi">256</span><span class="p">,</span> <span class="n">d</span><span class="p">)</span>  <span class="c1"># one row per byte
</span>        <span class="n">self</span><span class="p">.</span><span class="n">blocks</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">ModuleList</span><span class="p">([</span><span class="nc">TinyBlock</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">heads</span><span class="p">,</span> <span class="n">variant</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">layers</span><span class="p">)])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm</span> <span class="o">=</span> <span class="nc">Norm</span><span class="p">(</span><span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">head</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="mi">256</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="k">for</span> <span class="n">module</span> <span class="ow">in</span> <span class="n">self</span><span class="p">.</span><span class="nf">modules</span><span class="p">():</span>
            <span class="k">if</span> <span class="nf">isinstance</span><span class="p">(</span><span class="n">module</span><span class="p">,</span> <span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Linear</span><span class="p">,</span> <span class="n">nn</span><span class="p">.</span><span class="n">Embedding</span><span class="p">)):</span>
                <span class="n">nn</span><span class="p">.</span><span class="n">init</span><span class="p">.</span><span class="nf">normal_</span><span class="p">(</span><span class="n">module</span><span class="p">.</span><span class="n">weight</span><span class="p">,</span> <span class="n">std</span><span class="o">=</span><span class="mf">0.02</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">h</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">embed</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>
        <span class="k">for</span> <span class="n">block</span> <span class="ow">in</span> <span class="n">self</span><span class="p">.</span><span class="n">blocks</span><span class="p">:</span>
            <span class="n">h</span> <span class="o">=</span> <span class="nf">block</span><span class="p">(</span><span class="n">h</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">head</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">norm</span><span class="p">(</span><span class="n">h</span><span class="p">))</span>
</code></pre></div></div> <p>The training loop is lesson 4’s: AdamW, a warm-up, a cosine decay, the gradient clipped at 1. The only thing we turn is the peak learning rate.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">wiki_bytes</span><span class="p">(</span><span class="n">split</span><span class="p">):</span>
    <span class="n">name</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">wikitext-2-raw-v1/</span><span class="si">{</span><span class="n">split</span><span class="si">}</span><span class="s">-00000-of-00001.parquet</span><span class="sh">"</span>
    <span class="n">path</span> <span class="o">=</span> <span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">WIKITEXT</span><span class="p">,</span> <span class="n">name</span><span class="p">,</span> <span class="n">repo_type</span><span class="o">=</span><span class="sh">"</span><span class="s">dataset</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">text</span> <span class="o">=</span> <span class="sh">""</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nf">read_parquet</span><span class="p">(</span><span class="n">path</span><span class="p">)[</span><span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">].</span><span class="nf">tolist</span><span class="p">())</span>
    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="nf">list</span><span class="p">(</span><span class="n">text</span><span class="p">.</span><span class="nf">encode</span><span class="p">(</span><span class="sh">"</span><span class="s">utf-8</span><span class="sh">"</span><span class="p">)),</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">long</span><span class="p">)</span>


<span class="n">train_bytes</span><span class="p">,</span> <span class="n">valid_bytes</span> <span class="o">=</span> <span class="nf">wiki_bytes</span><span class="p">(</span><span class="sh">"</span><span class="s">train</span><span class="sh">"</span><span class="p">),</span> <span class="nf">wiki_bytes</span><span class="p">(</span><span class="sh">"</span><span class="s">validation</span><span class="sh">"</span><span class="p">)</span>
<span class="n">STEPS</span> <span class="o">=</span> <span class="mi">30</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">600</span>


<span class="k">def</span> <span class="nf">batch_of</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">generator</span><span class="p">,</span> <span class="n">batch</span><span class="o">=</span><span class="mi">32</span><span class="p">,</span> <span class="n">length</span><span class="o">=</span><span class="mi">256</span><span class="p">):</span>
    <span class="n">starts</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randint</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">data</span><span class="p">)</span> <span class="o">-</span> <span class="n">length</span> <span class="o">-</span> <span class="mi">1</span><span class="p">,</span> <span class="p">(</span><span class="n">batch</span><span class="p">,),</span> <span class="n">generator</span><span class="o">=</span><span class="n">generator</span><span class="p">)</span>
    <span class="n">x</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">([</span><span class="n">data</span><span class="p">[</span><span class="n">s</span><span class="p">:</span><span class="n">s</span> <span class="o">+</span> <span class="n">length</span><span class="p">]</span> <span class="k">for</span> <span class="n">s</span> <span class="ow">in</span> <span class="n">starts</span><span class="p">])</span>
    <span class="n">y</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">([</span><span class="n">data</span><span class="p">[</span><span class="n">s</span> <span class="o">+</span> <span class="mi">1</span><span class="p">:</span><span class="n">s</span> <span class="o">+</span> <span class="n">length</span> <span class="o">+</span> <span class="mi">1</span><span class="p">]</span> <span class="k">for</span> <span class="n">s</span> <span class="ow">in</span> <span class="n">starts</span><span class="p">])</span>
    <span class="k">return</span> <span class="n">x</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">),</span> <span class="n">y</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">train_tiny</span><span class="p">(</span><span class="n">variant</span><span class="p">,</span> <span class="n">peak_lr</span><span class="p">,</span> <span class="n">steps</span><span class="o">=</span><span class="n">STEPS</span><span class="p">,</span> <span class="n">warmup</span><span class="o">=</span><span class="mi">100</span><span class="p">):</span>
    <span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="mi">0</span><span class="p">)</span>
    <span class="n">model</span> <span class="o">=</span> <span class="nc">TinyLM</span><span class="p">(</span><span class="n">variant</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="n">optimizer</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">optim</span><span class="p">.</span><span class="nc">AdamW</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="nf">parameters</span><span class="p">(),</span> <span class="n">lr</span><span class="o">=</span><span class="n">peak_lr</span><span class="p">,</span> <span class="n">betas</span><span class="o">=</span><span class="p">(</span><span class="mf">0.9</span><span class="p">,</span> <span class="mf">0.95</span><span class="p">),</span>
                                  <span class="n">weight_decay</span><span class="o">=</span><span class="mf">0.0</span><span class="p">)</span>
    <span class="n">generator</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nc">Generator</span><span class="p">().</span><span class="nf">manual_seed</span><span class="p">(</span><span class="mi">0</span><span class="p">)</span>
    <span class="n">history</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">step</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">steps</span><span class="p">):</span>
        <span class="k">if</span> <span class="n">step</span> <span class="o">&lt;</span> <span class="n">warmup</span><span class="p">:</span>
            <span class="n">lr</span> <span class="o">=</span> <span class="n">peak_lr</span> <span class="o">*</span> <span class="p">(</span><span class="n">step</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">warmup</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="n">progress</span> <span class="o">=</span> <span class="p">(</span><span class="n">step</span> <span class="o">-</span> <span class="n">warmup</span><span class="p">)</span> <span class="o">/</span> <span class="nf">max</span><span class="p">(</span><span class="n">steps</span> <span class="o">-</span> <span class="n">warmup</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
            <span class="n">lr</span> <span class="o">=</span> <span class="n">peak_lr</span> <span class="o">*</span> <span class="p">(</span><span class="mf">0.1</span> <span class="o">+</span> <span class="mf">0.45</span> <span class="o">*</span> <span class="p">(</span><span class="mi">1</span> <span class="o">+</span> <span class="n">math</span><span class="p">.</span><span class="nf">cos</span><span class="p">(</span><span class="n">math</span><span class="p">.</span><span class="n">pi</span> <span class="o">*</span> <span class="n">progress</span><span class="p">)))</span>
        <span class="k">for</span> <span class="n">group</span> <span class="ow">in</span> <span class="n">optimizer</span><span class="p">.</span><span class="n">param_groups</span><span class="p">:</span>
            <span class="n">group</span><span class="p">[</span><span class="sh">"</span><span class="s">lr</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">lr</span>
        <span class="n">x</span><span class="p">,</span> <span class="n">y</span> <span class="o">=</span> <span class="nf">batch_of</span><span class="p">(</span><span class="n">train_bytes</span><span class="p">,</span> <span class="n">generator</span><span class="p">)</span>
        <span class="n">loss</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span><span class="nf">model</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">flatten</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">),</span> <span class="n">y</span><span class="p">.</span><span class="nf">flatten</span><span class="p">())</span>
        <span class="n">optimizer</span><span class="p">.</span><span class="nf">zero_grad</span><span class="p">(</span><span class="n">set_to_none</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
        <span class="n">loss</span><span class="p">.</span><span class="nf">backward</span><span class="p">()</span>
        <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="n">utils</span><span class="p">.</span><span class="nf">clip_grad_norm_</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="nf">parameters</span><span class="p">(),</span> <span class="mf">1.0</span><span class="p">)</span>
        <span class="n">optimizer</span><span class="p">.</span><span class="nf">step</span><span class="p">()</span>
        <span class="k">if</span> <span class="n">step</span> <span class="o">%</span> <span class="mi">5</span> <span class="o">==</span> <span class="mi">0</span><span class="p">:</span>
            <span class="n">peak</span> <span class="o">=</span> <span class="nf">max</span><span class="p">(</span><span class="nf">float</span><span class="p">(</span><span class="n">block</span><span class="p">.</span><span class="n">attention</span><span class="p">.</span><span class="n">peak</span><span class="p">)</span> <span class="k">for</span> <span class="n">block</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="n">blocks</span><span class="p">)</span>
            <span class="n">history</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">step</span><span class="sh">"</span><span class="p">:</span> <span class="n">step</span><span class="p">,</span> <span class="sh">"</span><span class="s">loss</span><span class="sh">"</span><span class="p">:</span> <span class="n">loss</span><span class="p">.</span><span class="nf">item</span><span class="p">(),</span> <span class="sh">"</span><span class="s">peak score</span><span class="sh">"</span><span class="p">:</span> <span class="n">peak</span><span class="p">})</span>
    <span class="n">generator</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nc">Generator</span><span class="p">().</span><span class="nf">manual_seed</span><span class="p">(</span><span class="mi">1</span><span class="p">)</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="n">losses</span> <span class="o">=</span> <span class="p">[</span><span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span><span class="nf">model</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">flatten</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">),</span> <span class="n">y</span><span class="p">.</span><span class="nf">flatten</span><span class="p">()).</span><span class="nf">item</span><span class="p">()</span>
                  <span class="k">for</span> <span class="n">x</span><span class="p">,</span> <span class="n">y</span> <span class="ow">in</span> <span class="p">[</span><span class="nf">batch_of</span><span class="p">(</span><span class="n">valid_bytes</span><span class="p">,</span> <span class="n">generator</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">10</span><span class="p">)]]</span>
    <span class="k">return</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">history</span><span class="p">),</span> <span class="nf">float</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">mean</span><span class="p">(</span><span class="n">losses</span><span class="p">))</span>
</code></pre></div></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">RATES</span> <span class="o">=</span> <span class="p">[</span><span class="mf">3e-3</span><span class="p">,</span> <span class="mf">3e-2</span><span class="p">]</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="p">[</span><span class="mf">1e-3</span><span class="p">,</span> <span class="mf">1e-2</span><span class="p">,</span> <span class="mf">1e-1</span><span class="p">]</span>
<span class="n">SHOWN</span> <span class="o">=</span> <span class="n">RATES</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>  <span class="c1"># the rate whose run the right-hand plot follows
</span><span class="n">VARIANTS</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">plain</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">QK-norm</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">soft-cap</span><span class="sh">"</span><span class="p">]</span>
<span class="n">runs</span> <span class="o">=</span> <span class="p">{}</span>
<span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
<span class="k">for</span> <span class="n">variant</span> <span class="ow">in</span> <span class="n">VARIANTS</span><span class="p">:</span>
    <span class="k">for</span> <span class="n">rate</span> <span class="ow">in</span> <span class="n">RATES</span><span class="p">:</span>
        <span class="n">runs</span><span class="p">[</span><span class="n">variant</span><span class="p">,</span> <span class="n">rate</span><span class="p">]</span> <span class="o">=</span> <span class="nf">train_tiny</span><span class="p">(</span><span class="n">variant</span><span class="p">,</span> <span class="n">rate</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">runs</span><span class="p">)</span><span class="si">}</span><span class="s"> runs in </span><span class="si">{</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> s</span><span class="sh">"</span><span class="p">)</span>
<span class="n">results</span> <span class="o">=</span> <span class="p">[{</span><span class="sh">"</span><span class="s">attention</span><span class="sh">"</span><span class="p">:</span> <span class="n">v</span><span class="p">,</span> <span class="sh">"</span><span class="s">peak learning rate</span><span class="sh">"</span><span class="p">:</span> <span class="n">r</span><span class="p">,</span> <span class="sh">"</span><span class="s">validation loss</span><span class="sh">"</span><span class="p">:</span> <span class="n">runs</span><span class="p">[</span><span class="n">v</span><span class="p">,</span> <span class="n">r</span><span class="p">][</span><span class="mi">1</span><span class="p">]}</span>
           <span class="k">for</span> <span class="n">v</span> <span class="ow">in</span> <span class="n">VARIANTS</span> <span class="k">for</span> <span class="n">r</span> <span class="ow">in</span> <span class="n">RATES</span><span class="p">]</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">results</span><span class="p">).</span><span class="nf">pivot</span><span class="p">(</span><span class="n">index</span><span class="o">=</span><span class="sh">"</span><span class="s">peak learning rate</span><span class="sh">"</span><span class="p">,</span> <span class="n">columns</span><span class="o">=</span><span class="sh">"</span><span class="s">attention</span><span class="sh">"</span><span class="p">,</span>
                                  <span class="n">values</span><span class="o">=</span><span class="sh">"</span><span class="s">validation loss</span><span class="sh">"</span><span class="p">).</span><span class="nf">reset_index</span><span class="p">(),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">3</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>9 runs in 1565 s</code></pre> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">peak learning rate</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">QK-norm</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">plain</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">soft-cap</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.001</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.380</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.428</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.428</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.010</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.440</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.994</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.570</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.100</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.622</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.692</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.447</td></tr></tbody></table></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">10</span><span class="p">,</span> <span class="mf">3.6</span><span class="p">))</span>
<span class="k">for</span> <span class="n">variant</span><span class="p">,</span> <span class="n">color</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">VARIANTS</span><span class="p">,</span> <span class="p">[</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">]]):</span>
    <span class="n">finals</span> <span class="o">=</span> <span class="p">[</span><span class="n">runs</span><span class="p">[</span><span class="n">variant</span><span class="p">,</span> <span class="n">rate</span><span class="p">][</span><span class="mi">1</span><span class="p">]</span> <span class="k">for</span> <span class="n">rate</span> <span class="ow">in</span> <span class="n">RATES</span><span class="p">]</span>
    <span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">plot</span><span class="p">(</span><span class="n">RATES</span><span class="p">,</span> <span class="n">finals</span><span class="p">,</span> <span class="n">marker</span><span class="o">=</span><span class="sh">"</span><span class="s">o</span><span class="sh">"</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="n">variant</span><span class="p">)</span>
    <span class="n">history</span> <span class="o">=</span> <span class="n">runs</span><span class="p">[</span><span class="n">variant</span><span class="p">,</span> <span class="n">SHOWN</span><span class="p">][</span><span class="mi">0</span><span class="p">]</span>
    <span class="n">axes</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="nf">plot</span><span class="p">(</span><span class="n">history</span><span class="p">[</span><span class="sh">"</span><span class="s">step</span><span class="sh">"</span><span class="p">],</span> <span class="n">history</span><span class="p">[</span><span class="sh">"</span><span class="s">peak score</span><span class="sh">"</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="n">variant</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">set_xscale</span><span class="p">(</span><span class="sh">"</span><span class="s">log</span><span class="sh">"</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">peak learning rate</span><span class="sh">"</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">validation loss, nats per byte</span><span class="sh">"</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">Final loss against learning rate</span><span class="sh">"</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="nf">set_yscale</span><span class="p">(</span><span class="sh">"</span><span class="s">log</span><span class="sh">"</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">step</span><span class="sh">"</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">largest attention score</span><span class="sh">"</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="nf">set_title</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">The largest score at a learning rate of </span><span class="si">{</span><span class="n">SHOWN</span><span class="si">:</span><span class="n">g</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/06/output-03.png" alt="Final loss against learning rate" loading="lazy"></p> <p>At the smallest learning rate the three models end close together. Raise it and they part: the plain model’s loss climbs fastest, soft-capping holds it back at the middle rate but not at the highest, and the model with QK-norm barely notices, and is a little better even at the lowest rate.</p> <p>The right-hand plot shows why. In the plain model the largest score grows by orders of magnitude within the first couple of hundred steps and stays there, so its softmax is nearly one-hot. With QK-norm it stays in the tens.</p> <p>The soft-capped model’s raw scores also grow far past the cap of 50, though less than the plain model’s, and the cap only squashes them on the way into the softmax: past the ceiling the tanh is flat and passes back almost no gradient.</p> <h2 id="5-qwen3-in-pytorch">5. Qwen3 in PyTorch</h2> <p>Qwen3 is a family of eight models that Alibaba’s Qwen team released in April 2025, from 0.6 to 235 billion parameters, six of them dense and two mixtures of experts, all under Apache 2.0 and trained on “36 trillion tokens” in “119 languages and dialects”<sup class="cite">[<a href="#ref-7" id="cite-7" data-ref="7" aria-label="Reference 7: Qwen Team (2025). Qwen3 technical report. arXiv:2505.09388.">7</a>]</sup>.</p> <p>The report describes the dense models in two sentences: like Qwen2.5 they use grouped-query attention, SwiGLU, rotary positions and RMSNorm with pre-normalisation, and then “we remove QKV-bias used in Qwen2 […] and introduce QK-Norm […] to the attention mechanism to ensure stable training for Qwen3”. That is the whole difference from the skeleton of section 2, and we already have every piece.</p> <p>The smallest, Qwen3-0.6B, fits on a phone and runs comfortably on a T4. Its config:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">REPO</span> <span class="o">=</span> <span class="sh">"</span><span class="s">Qwen/Qwen3-0.6B</span><span class="sh">"</span>
<span class="n">config</span> <span class="o">=</span> <span class="nf">text_config</span><span class="p">(</span><span class="n">REPO</span><span class="p">)</span>
<span class="n">keys</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">num_key_value_heads</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">head_dim</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">rope_theta</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">rms_norm_eps</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">tie_word_embeddings</span><span class="sh">"</span><span class="p">]</span>
<span class="k">for</span> <span class="n">key</span> <span class="ow">in</span> <span class="n">keys</span><span class="p">:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">key</span><span class="si">:</span><span class="mi">22</span><span class="si">}</span><span class="s"> </span><span class="si">{</span><span class="n">config</span><span class="p">[</span><span class="n">key</span><span class="p">]</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>hidden_size            1024
num_hidden_layers      28
num_attention_heads    16
num_key_value_heads    8
head_dim               128
intermediate_size      3072
vocab_size             151936
rope_theta             1000000
rms_norm_eps           1e-06
tie_word_embeddings    True</code></pre> <p>The norm is RMSNorm, computed in 32-bit floats whatever the dtype of the model, as Qwen’s code does; the same class serves the residual stream and, applied to vectors of 128, the queries and keys.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">dim</span><span class="p">,</span> <span class="n">eps</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">eps</span> <span class="o">=</span> <span class="n">eps</span>
        <span class="n">self</span><span class="p">.</span><span class="n">weight</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">dim</span><span class="p">))</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">dtype</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">dtype</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="nf">float</span><span class="p">()</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">x</span> <span class="o">*</span> <span class="n">torch</span><span class="p">.</span><span class="nf">rsqrt</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="nf">pow</span><span class="p">(</span><span class="mi">2</span><span class="p">).</span><span class="nf">mean</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">eps</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="n">weight</span> <span class="o">*</span> <span class="n">x</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">dtype</span><span class="p">)</span>
</code></pre></div></div> <p>Rotary positions as in lesson 5 of the first course, in the convention Qwen’s weights were trained with: the vector is split into halves rather than interleaved pairs, so dimension \(i\) is rotated together with dimension \(i + d_h/2\). With a base of a million, the slowest pair turns once every few million tokens. The tables of cosines and sines are computed once per forward pass, for the positions of every row of the batch.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">rope_tables</span><span class="p">(</span><span class="n">positions</span><span class="p">,</span> <span class="n">head_dim</span><span class="p">,</span> <span class="n">theta</span><span class="p">):</span>
    <span class="n">exponents</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">head_dim</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">positions</span><span class="p">.</span><span class="n">device</span><span class="p">).</span><span class="nf">float</span><span class="p">()</span> <span class="o">/</span> <span class="n">head_dim</span>
    <span class="n">inv_freq</span> <span class="o">=</span> <span class="mf">1.0</span> <span class="o">/</span> <span class="n">theta</span> <span class="o">**</span> <span class="n">exponents</span>
    <span class="n">angles</span> <span class="o">=</span> <span class="n">positions</span><span class="p">.</span><span class="nf">float</span><span class="p">()[...,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="n">inv_freq</span>
    <span class="n">angles</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">angles</span><span class="p">,</span> <span class="n">angles</span><span class="p">],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">angles</span><span class="p">.</span><span class="nf">cos</span><span class="p">()[:,</span> <span class="bp">None</span><span class="p">],</span> <span class="n">angles</span><span class="p">.</span><span class="nf">sin</span><span class="p">()[:,</span> <span class="bp">None</span><span class="p">]</span>  <span class="c1"># shaped to broadcast over heads
</span>

<span class="k">def</span> <span class="nf">rotate</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">):</span>
    <span class="n">half</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span> <span class="o">//</span> <span class="mi">2</span>
    <span class="n">rotated</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="o">-</span><span class="n">x</span><span class="p">[...,</span> <span class="n">half</span><span class="p">:],</span> <span class="n">x</span><span class="p">[...,</span> <span class="p">:</span><span class="n">half</span><span class="p">]],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">x</span> <span class="o">*</span> <span class="n">cos</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span> <span class="o">+</span> <span class="n">rotated</span> <span class="o">*</span> <span class="n">sin</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span>
</code></pre></div></div> <p>Attention puts sections 3 and 4 together. Queries take 16 heads of 128, keys and values 8: groups of two. QK-norm comes after the projection and before the rotation, one norm for all query heads and one for all key heads.</p> <p>The cache stores keys and values with 8 heads, before they are repeated, which is where grouped queries save memory; the repeat happens on the way into the attention kernel. The attention itself is PyTorch’s <code class="language-plaintext highlighter-rouge">scaled_dot_product_attention</code>, which on a GPU usually runs a fused kernel that never writes out the matrix of scores.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">Cache</span><span class="p">:</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">):</span>
        <span class="n">self</span><span class="p">.</span><span class="n">k</span> <span class="o">=</span> <span class="bp">None</span>
        <span class="n">self</span><span class="p">.</span><span class="n">v</span> <span class="o">=</span> <span class="bp">None</span>

    <span class="k">def</span> <span class="nf">add</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">):</span>
        <span class="k">if</span> <span class="n">self</span><span class="p">.</span><span class="n">k</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
            <span class="n">k</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">self</span><span class="p">.</span><span class="n">k</span><span class="p">,</span> <span class="n">k</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
            <span class="n">v</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">self</span><span class="p">.</span><span class="n">v</span><span class="p">,</span> <span class="n">v</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">k</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">v</span> <span class="o">=</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span>
        <span class="k">return</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span>


<span class="k">class</span> <span class="nc">Attention</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">kv_heads</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_key_value_heads</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">head_dim</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">q_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">k_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">kv_heads</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">v_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">kv_heads</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">o_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">q_norm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">rms_norm_eps</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">k_norm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">,</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">rms_norm_eps</span><span class="sh">"</span><span class="p">])</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">cache</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
        <span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span>
        <span class="n">q</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">q_proj</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">view</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">)</span>
        <span class="n">k</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">k_proj</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">view</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">kv_heads</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">)</span>
        <span class="n">v</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">v_proj</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">view</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">kv_heads</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">)</span>
        <span class="n">q</span> <span class="o">=</span> <span class="nf">rotate</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">q_norm</span><span class="p">(</span><span class="n">q</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">),</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">)</span>
        <span class="n">k</span> <span class="o">=</span> <span class="nf">rotate</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">k_norm</span><span class="p">(</span><span class="n">k</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">),</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">)</span>
        <span class="n">v</span> <span class="o">=</span> <span class="n">v</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">cache</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
            <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="o">=</span> <span class="n">cache</span><span class="p">.</span><span class="nf">add</span><span class="p">(</span><span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">)</span>
        <span class="n">group</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">//</span> <span class="n">self</span><span class="p">.</span><span class="n">kv_heads</span>
        <span class="n">k</span> <span class="o">=</span> <span class="n">k</span><span class="p">.</span><span class="nf">repeat_interleave</span><span class="p">(</span><span class="n">group</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">v</span> <span class="o">=</span> <span class="n">v</span><span class="p">.</span><span class="nf">repeat_interleave</span><span class="p">(</span><span class="n">group</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">out</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">scaled_dot_product_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">,</span> <span class="n">attn_mask</span><span class="o">=</span><span class="n">mask</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">o_proj</span><span class="p">(</span><span class="n">out</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">))</span>
</code></pre></div></div> <p>The feed-forward network is SwiGLU with no biases, and the block is pre-norm with two residual connections. In Qwen3-0.6B, 1.7B and 4B the last step multiplies by the embedding matrix itself, because they tie their input and output embeddings; from 8B up the output matrix is a separate one, and the class takes either.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">FeedForward</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span><span class="p">,</span> <span class="n">hidden</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">gate_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">hidden</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">up_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">hidden</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">down_proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">hidden</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">down_proj</span><span class="p">(</span><span class="n">F</span><span class="p">.</span><span class="nf">silu</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">gate_proj</span><span class="p">(</span><span class="n">x</span><span class="p">))</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="nf">up_proj</span><span class="p">(</span><span class="n">x</span><span class="p">))</span>


<span class="k">class</span> <span class="nc">Block</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">input_layernorm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">rms_norm_eps</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">self_attn</span> <span class="o">=</span> <span class="nc">Attention</span><span class="p">(</span><span class="n">config</span><span class="p">)</span>
        <span class="n">d</span><span class="p">,</span> <span class="n">eps</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">rms_norm_eps</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">post_attention_layernorm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">mlp</span> <span class="o">=</span> <span class="nc">FeedForward</span><span class="p">(</span><span class="n">config</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">cache</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">self_attn</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">input_layernorm</span><span class="p">(</span><span class="n">x</span><span class="p">),</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">cache</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">mlp</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">post_attention_layernorm</span><span class="p">(</span><span class="n">x</span><span class="p">))</span>


<span class="k">class</span> <span class="nc">Qwen3</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">config</span> <span class="o">=</span> <span class="n">config</span>
        <span class="n">self</span><span class="p">.</span><span class="n">embed_tokens</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">n_layers</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">layers</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">ModuleList</span><span class="p">([</span><span class="nc">Block</span><span class="p">(</span><span class="n">config</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n_layers</span><span class="p">)])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm</span> <span class="o">=</span> <span class="nc">RMSNorm</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">rms_norm_eps</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">tied</span> <span class="o">=</span> <span class="n">config</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">tie_word_embeddings</span><span class="sh">"</span><span class="p">,</span> <span class="bp">False</span><span class="p">)</span>
        <span class="k">if</span> <span class="ow">not</span> <span class="n">self</span><span class="p">.</span><span class="n">tied</span><span class="p">:</span>  <span class="c1"># Qwen3-8B and larger have an output matrix of their own
</span>            <span class="n">d</span><span class="p">,</span> <span class="n">vocab</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">]</span>
            <span class="n">self</span><span class="p">.</span><span class="n">lm_head</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">vocab</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">hidden</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">positions</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">caches</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">embed_tokens</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span>
        <span class="n">c</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">config</span>
        <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span> <span class="o">=</span> <span class="nf">rope_tables</span><span class="p">(</span><span class="n">positions</span><span class="p">,</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">head_dim</span><span class="sh">"</span><span class="p">],</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">rope_theta</span><span class="sh">"</span><span class="p">])</span>
        <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">layer</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">layers</span><span class="p">):</span>
            <span class="c1"># one mask for all layers, or a list with one per layer (section 7)
</span>            <span class="n">layer_mask</span> <span class="o">=</span> <span class="n">mask</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="k">if</span> <span class="nf">isinstance</span><span class="p">(</span><span class="n">mask</span><span class="p">,</span> <span class="nb">list</span><span class="p">)</span> <span class="k">else</span> <span class="n">mask</span>
            <span class="n">cache</span> <span class="o">=</span> <span class="n">caches</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="k">if</span> <span class="n">caches</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span> <span class="k">else</span> <span class="bp">None</span>
            <span class="n">x</span> <span class="o">=</span> <span class="nf">layer</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span><span class="p">,</span> <span class="n">layer_mask</span><span class="p">,</span> <span class="n">cache</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">logits</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">h</span><span class="p">):</span>
        <span class="k">if</span> <span class="n">self</span><span class="p">.</span><span class="n">tied</span><span class="p">:</span>
            <span class="k">return</span> <span class="n">h</span> <span class="o">@</span> <span class="n">self</span><span class="p">.</span><span class="n">embed_tokens</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">T</span>  <span class="c1"># the output layer is the embeddings
</span>        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">lm_head</span><span class="p">(</span><span class="n">h</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">positions</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">caches</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">logits</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">hidden</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">positions</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">caches</span><span class="p">))</span>
</code></pre></div></div> <h2 id="6-the-official-weights-in-our-code">6. The official weights in our code</h2> <p>We named our modules the way Qwen’s checkpoint names its tensors, so the transplant is a matter of dropping the prefix <code class="language-plaintext highlighter-rouge">model.</code>. The checkpoint of a tied model also stores <code class="language-plaintext highlighter-rouge">lm_head.weight</code>, an exact copy of the embedding matrix that the model never needs, and we skip it; <code class="language-plaintext highlighter-rouge">load_state_dict</code> refuses anything else missing or left over.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">load_qwen3</span><span class="p">(</span><span class="n">repo</span><span class="p">,</span> <span class="n">dtype</span><span class="p">):</span>
    <span class="n">config</span> <span class="o">=</span> <span class="nf">text_config</span><span class="p">(</span><span class="n">repo</span><span class="p">)</span>
    <span class="n">files</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">model.safetensors</span><span class="sh">"</span><span class="p">]</span>
    <span class="k">try</span><span class="p">:</span>
        <span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">repo</span><span class="p">,</span> <span class="sh">"</span><span class="s">model.safetensors.index.json</span><span class="sh">"</span><span class="p">))</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
            <span class="n">files</span> <span class="o">=</span> <span class="nf">sorted</span><span class="p">(</span><span class="nf">set</span><span class="p">(</span><span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">f</span><span class="p">)[</span><span class="sh">"</span><span class="s">weight_map</span><span class="sh">"</span><span class="p">].</span><span class="nf">values</span><span class="p">()))</span>
    <span class="k">except</span> <span class="nb">Exception</span><span class="p">:</span>
        <span class="k">pass</span>  <span class="c1"># a small model comes in one file
</span>    <span class="n">state</span> <span class="o">=</span> <span class="p">{}</span>
    <span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">files</span><span class="p">:</span>
        <span class="n">state</span><span class="p">.</span><span class="nf">update</span><span class="p">(</span><span class="nf">load_file</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">repo</span><span class="p">,</span> <span class="n">name</span><span class="p">)))</span>
    <span class="n">renamed</span> <span class="o">=</span> <span class="p">{}</span>
    <span class="k">for</span> <span class="n">key</span><span class="p">,</span> <span class="n">value</span> <span class="ow">in</span> <span class="n">state</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
        <span class="k">if</span> <span class="n">key</span> <span class="o">==</span> <span class="sh">"</span><span class="s">lm_head.weight</span><span class="sh">"</span> <span class="ow">and</span> <span class="n">config</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">tie_word_embeddings</span><span class="sh">"</span><span class="p">,</span> <span class="bp">False</span><span class="p">):</span>
            <span class="k">continue</span>  <span class="c1"># a copy of the embeddings
</span>        <span class="n">renamed</span><span class="p">[</span><span class="n">key</span><span class="p">.</span><span class="nf">removeprefix</span><span class="p">(</span><span class="sh">"</span><span class="s">model.</span><span class="sh">"</span><span class="p">)]</span> <span class="o">=</span> <span class="n">value</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">dtype</span><span class="p">)</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">device</span><span class="p">(</span><span class="sh">"</span><span class="s">meta</span><span class="sh">"</span><span class="p">):</span>  <span class="c1"># no memory for the random weights we are about to replace
</span>        <span class="n">model</span> <span class="o">=</span> <span class="nc">Qwen3</span><span class="p">(</span><span class="n">config</span><span class="p">)</span>
    <span class="n">model</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">(</span><span class="n">renamed</span><span class="p">,</span> <span class="n">strict</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">assign</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">model</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>


<span class="n">model</span> <span class="o">=</span> <span class="nf">load_qwen3</span><span class="p">(</span><span class="n">REPO</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="n">float32</span><span class="p">)</span>
<span class="n">tok</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">REPO</span><span class="p">)</span>
<span class="n">state</span> <span class="o">=</span> <span class="nf">load_file</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">REPO</span><span class="p">,</span> <span class="sh">"</span><span class="s">model.safetensors</span><span class="sh">"</span><span class="p">))</span>
<span class="n">same</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">equal</span><span class="p">(</span><span class="n">state</span><span class="p">[</span><span class="sh">"</span><span class="s">lm_head.weight</span><span class="sh">"</span><span class="p">],</span> <span class="n">state</span><span class="p">[</span><span class="sh">"</span><span class="s">model.embed_tokens.weight</span><span class="sh">"</span><span class="p">])</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">lm_head equals the embeddings:</span><span class="sh">"</span><span class="p">,</span> <span class="n">same</span><span class="p">)</span>
<span class="k">del</span> <span class="n">state</span>
</code></pre></div></div> <pre class="tfs-printed"><code>lm_head equals the embeddings: True</code></pre> <p>Where are the 596 million parameters? Not where you’d guess from a large model.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">parts</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">embeddings (tied)</span><span class="sh">"</span><span class="p">:</span> <span class="mi">0</span><span class="p">,</span> <span class="sh">"</span><span class="s">attention</span><span class="sh">"</span><span class="p">:</span> <span class="mi">0</span><span class="p">,</span> <span class="sh">"</span><span class="s">QK-norm</span><span class="sh">"</span><span class="p">:</span> <span class="mi">0</span><span class="p">,</span> <span class="sh">"</span><span class="s">feed-forward</span><span class="sh">"</span><span class="p">:</span> <span class="mi">0</span><span class="p">,</span>
         <span class="sh">"</span><span class="s">other norms</span><span class="sh">"</span><span class="p">:</span> <span class="mi">0</span><span class="p">}</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="nf">named_parameters</span><span class="p">():</span>
    <span class="k">if</span> <span class="n">name</span><span class="p">.</span><span class="nf">startswith</span><span class="p">(</span><span class="sh">"</span><span class="s">embed_tokens</span><span class="sh">"</span><span class="p">):</span>
        <span class="n">parts</span><span class="p">[</span><span class="sh">"</span><span class="s">embeddings (tied)</span><span class="sh">"</span><span class="p">]</span> <span class="o">+=</span> <span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span>
    <span class="k">elif</span> <span class="sh">"</span><span class="s">q_norm</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">name</span> <span class="ow">or</span> <span class="sh">"</span><span class="s">k_norm</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">name</span><span class="p">:</span>
        <span class="n">parts</span><span class="p">[</span><span class="sh">"</span><span class="s">QK-norm</span><span class="sh">"</span><span class="p">]</span> <span class="o">+=</span> <span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span>
    <span class="k">elif</span> <span class="sh">"</span><span class="s">self_attn</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">name</span><span class="p">:</span>
        <span class="n">parts</span><span class="p">[</span><span class="sh">"</span><span class="s">attention</span><span class="sh">"</span><span class="p">]</span> <span class="o">+=</span> <span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span>
    <span class="k">elif</span> <span class="sh">"</span><span class="s">mlp</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">name</span><span class="p">:</span>
        <span class="n">parts</span><span class="p">[</span><span class="sh">"</span><span class="s">feed-forward</span><span class="sh">"</span><span class="p">]</span> <span class="o">+=</span> <span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span>
    <span class="k">else</span><span class="p">:</span>
        <span class="n">parts</span><span class="p">[</span><span class="sh">"</span><span class="s">other norms</span><span class="sh">"</span><span class="p">]</span> <span class="o">+=</span> <span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span>
<span class="n">total</span> <span class="o">=</span> <span class="nf">sum</span><span class="p">(</span><span class="n">parts</span><span class="p">.</span><span class="nf">values</span><span class="p">())</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">({</span><span class="sh">"</span><span class="s">part</span><span class="sh">"</span><span class="p">:</span> <span class="nf">list</span><span class="p">(</span><span class="n">parts</span><span class="p">),</span> <span class="sh">"</span><span class="s">parameters</span><span class="sh">"</span><span class="p">:</span> <span class="nf">list</span><span class="p">(</span><span class="n">parts</span><span class="p">.</span><span class="nf">values</span><span class="p">()),</span>
                    <span class="sh">"</span><span class="s">share</span><span class="sh">"</span><span class="p">:</span> <span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">n</span> <span class="o">/</span> <span class="n">total</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span> <span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="n">parts</span><span class="p">.</span><span class="nf">values</span><span class="p">()]}))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">part</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">parameters</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">share</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">embeddings (tied)</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">155,582,464</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">26.1%</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">attention</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">176,160,768</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">29.6%</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">QK-norm</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7,168</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.0%</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">feed-forward</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">264,241,152</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">44.3%</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">other norms</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">58,368</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.0%</td></tr></tbody></table></div> <p>About a quarter of the model is the embedding table, 151,936 rows of 1,024 numbers, one row per token, used twice: at the input and, tied, at the output.</p> <p>Attention has a larger share than in older models because its heads are wider than the model itself. QK-norm adds a few thousand parameters, next to nothing for what section 4 showed it does.</p> <p>The check, as in every lesson: the same tokens through our model and through Hugging Face’s, in 32-bit floats.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">reference</span> <span class="o">=</span> <span class="n">AutoModelForCausalLM</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">REPO</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float32</span><span class="p">)</span>
<span class="n">reference</span> <span class="o">=</span> <span class="n">reference</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="n">text</span> <span class="o">=</span> <span class="p">(</span><span class="sh">"</span><span class="s">The Rhine rises in the Swiss Alps, flows through Lake Constance and along </span><span class="sh">"</span>
        <span class="sh">"</span><span class="s">the French–German border, and reaches the North Sea through a delta in the </span><span class="sh">"</span>
        <span class="sh">"</span><span class="s">Netherlands.</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ids</span> <span class="o">=</span> <span class="nf">tok</span><span class="p">(</span><span class="n">text</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="n">input_ids</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="n">t</span> <span class="o">=</span> <span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>
<span class="n">positions</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">t</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)[</span><span class="bp">None</span><span class="p">]</span>
<span class="n">causal</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">t</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">).</span><span class="nf">tril</span><span class="p">()</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">ours</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">positions</span><span class="p">,</span> <span class="n">causal</span><span class="p">)</span>
    <span class="n">theirs</span> <span class="o">=</span> <span class="nf">reference</span><span class="p">(</span><span class="n">ids</span><span class="p">).</span><span class="n">logits</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">tokens:</span><span class="sh">"</span><span class="p">,</span> <span class="n">t</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">largest logit:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">theirs</span><span class="p">.</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">max difference:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="n">ours</span> <span class="o">-</span> <span class="n">theirs</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="k">del</span> <span class="n">reference</span>
</code></pre></div></div> <pre class="tfs-printed"><code>tokens: 34
largest logit: 24.74
max difference: 6.96e-05</code></pre> <p>Our model and Hugging Face’s agree to within the rounding of 32-bit arithmetic, so the transplant is exact: the classes above are all there is to Qwen3.</p> <p>Generation is lesson 4’s loop, extended to a batch of prompts of different lengths. The prompts are padded on the left, so that every row’s last token is in the same column; padding gets no attention, and positions are counted from each row’s first real token.</p> <p>Every token is allowed to see itself, so that a row of pure padding never ends up with nothing to attend to, which would fill it with NaN.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">generate</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">prompts</span><span class="p">,</span> <span class="n">max_new_tokens</span><span class="p">,</span> <span class="n">stop_id</span><span class="p">,</span> <span class="n">prefix</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
    <span class="n">b</span> <span class="o">=</span> <span class="nf">len</span><span class="p">(</span><span class="n">prompts</span><span class="p">)</span>
    <span class="n">width</span> <span class="o">=</span> <span class="nf">max</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">p</span><span class="p">)</span> <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">prompts</span><span class="p">)</span>
    <span class="n">ids</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">full</span><span class="p">((</span><span class="n">b</span><span class="p">,</span> <span class="n">width</span><span class="p">),</span> <span class="n">stop_id</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
    <span class="n">real</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">width</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">p</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">prompts</span><span class="p">):</span>
        <span class="n">ids</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="n">width</span> <span class="o">-</span> <span class="nf">len</span><span class="p">(</span><span class="n">p</span><span class="p">):]</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">p</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
        <span class="n">real</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="n">width</span> <span class="o">-</span> <span class="nf">len</span><span class="p">(</span><span class="n">p</span><span class="p">):]</span> <span class="o">=</span> <span class="bp">True</span>
    <span class="n">caches</span> <span class="o">=</span> <span class="p">[</span><span class="nc">Cache</span><span class="p">()</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="n">layers</span><span class="p">]</span>
    <span class="n">start</span> <span class="o">=</span> <span class="mi">0</span>
    <span class="k">if</span> <span class="n">prefix</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>  <span class="c1"># section 8: keys and values of a shared start, computed once
</span>        <span class="k">for</span> <span class="n">cache</span><span class="p">,</span> <span class="p">(</span><span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">)</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">caches</span><span class="p">,</span> <span class="n">prefix</span><span class="p">[</span><span class="sh">"</span><span class="s">kv</span><span class="sh">"</span><span class="p">]):</span>
            <span class="n">cache</span><span class="p">.</span><span class="n">k</span><span class="p">,</span> <span class="n">cache</span><span class="p">.</span><span class="n">v</span> <span class="o">=</span> <span class="n">k</span><span class="p">.</span><span class="nf">expand</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">),</span> <span class="n">v</span><span class="p">.</span><span class="nf">expand</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">start</span> <span class="o">=</span> <span class="n">prefix</span><span class="p">[</span><span class="sh">"</span><span class="s">length</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">shared</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">start</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
        <span class="n">real</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">shared</span><span class="p">,</span> <span class="n">real</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">positions</span> <span class="o">=</span> <span class="p">(</span><span class="n">real</span><span class="p">.</span><span class="nf">long</span><span class="p">().</span><span class="nf">cumsum</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span> <span class="o">-</span> <span class="mi">1</span><span class="p">).</span><span class="nf">clamp</span><span class="p">(</span><span class="nb">min</span><span class="o">=</span><span class="mi">0</span><span class="p">)[:,</span> <span class="n">start</span><span class="p">:]</span>
    <span class="n">causal</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">width</span><span class="p">,</span> <span class="n">start</span> <span class="o">+</span> <span class="n">width</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
    <span class="n">causal</span> <span class="o">=</span> <span class="n">causal</span><span class="p">.</span><span class="nf">tril</span><span class="p">(</span><span class="n">diagonal</span><span class="o">=</span><span class="n">start</span><span class="p">)</span>
    <span class="n">itself</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">width</span><span class="p">,</span> <span class="n">start</span> <span class="o">+</span> <span class="n">width</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
    <span class="n">itself</span><span class="p">[</span><span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">width</span><span class="p">),</span> <span class="n">start</span> <span class="o">+</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">width</span><span class="p">)]</span> <span class="o">=</span> <span class="bp">True</span>
    <span class="n">mask</span> <span class="o">=</span> <span class="p">(</span><span class="n">causal</span> <span class="o">&amp;</span> <span class="n">real</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:])</span> <span class="o">|</span> <span class="n">itself</span>
    <span class="n">h</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="nf">hidden</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">positions</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">caches</span><span class="p">)</span>
    <span class="n">next_ids</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="nf">logits</span><span class="p">(</span><span class="n">h</span><span class="p">[:,</span> <span class="o">-</span><span class="mi">1</span><span class="p">]).</span><span class="nf">argmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">written</span> <span class="o">=</span> <span class="p">[</span><span class="n">next_ids</span><span class="p">]</span>
    <span class="n">done</span> <span class="o">=</span> <span class="n">next_ids</span> <span class="o">==</span> <span class="n">stop_id</span>
    <span class="n">position</span> <span class="o">=</span> <span class="n">positions</span><span class="p">[:,</span> <span class="o">-</span><span class="mi">1</span><span class="p">]</span>
    <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">max_new_tokens</span> <span class="o">-</span> <span class="mi">1</span><span class="p">):</span>
        <span class="k">if</span> <span class="nf">bool</span><span class="p">(</span><span class="n">done</span><span class="p">.</span><span class="nf">all</span><span class="p">()):</span>
            <span class="k">break</span>
        <span class="n">position</span> <span class="o">=</span> <span class="n">position</span> <span class="o">+</span> <span class="mi">1</span>
        <span class="n">real</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">real</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">mask</span> <span class="o">=</span> <span class="n">real</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:]</span>
        <span class="n">h</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="nf">hidden</span><span class="p">(</span><span class="n">next_ids</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">],</span> <span class="n">position</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">],</span> <span class="n">mask</span><span class="p">,</span> <span class="n">caches</span><span class="p">)</span>
        <span class="n">next_ids</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="nf">logits</span><span class="p">(</span><span class="n">h</span><span class="p">[:,</span> <span class="o">-</span><span class="mi">1</span><span class="p">]).</span><span class="nf">argmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">next_ids</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">where</span><span class="p">(</span><span class="n">done</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="nf">full_like</span><span class="p">(</span><span class="n">next_ids</span><span class="p">,</span> <span class="n">stop_id</span><span class="p">),</span> <span class="n">next_ids</span><span class="p">)</span>
        <span class="n">written</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">next_ids</span><span class="p">)</span>
        <span class="n">done</span> <span class="o">=</span> <span class="n">done</span> <span class="o">|</span> <span class="p">(</span><span class="n">next_ids</span> <span class="o">==</span> <span class="n">stop_id</span><span class="p">)</span>
    <span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">(</span><span class="n">written</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">).</span><span class="nf">tolist</span><span class="p">():</span>
        <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">row</span><span class="p">[:</span><span class="n">row</span><span class="p">.</span><span class="nf">index</span><span class="p">(</span><span class="n">stop_id</span><span class="p">)]</span> <span class="k">if</span> <span class="n">stop_id</span> <span class="ow">in</span> <span class="n">row</span> <span class="k">else</span> <span class="n">row</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">rows</span>
</code></pre></div></div> <p>Qwen3 is one model with two modes. In thinking mode it first writes its reasoning between <code class="language-plaintext highlighter-rouge">&lt;think&gt;</code> and <code class="language-plaintext highlighter-rouge">&lt;/think&gt;</code>, then the answer; in non-thinking mode the chat template inserts an empty <code class="language-plaintext highlighter-rouge">&lt;think&gt;&lt;/think&gt;</code> and the model answers at once. The template is part of the <a href="/blog/2026/transformers-from-scratch-01-tokenization/">tokenizer</a>, so the switch is one argument:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">IM_END</span> <span class="o">=</span> <span class="n">tok</span><span class="p">.</span><span class="nf">convert_tokens_to_ids</span><span class="p">(</span><span class="sh">"</span><span class="s">&lt;|im_end|&gt;</span><span class="sh">"</span><span class="p">)</span>
<span class="n">question</span> <span class="o">=</span> <span class="p">(</span><span class="sh">"</span><span class="s">Lena is three years older than Max. In five years their ages will add up </span><span class="sh">"</span>
            <span class="sh">"</span><span class="s">to 41. How old is Max now?</span><span class="sh">"</span><span class="p">)</span>
<span class="n">messages</span> <span class="o">=</span> <span class="p">[{</span><span class="sh">"</span><span class="s">role</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">user</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">content</span><span class="sh">"</span><span class="p">:</span> <span class="n">question</span><span class="p">}]</span>
<span class="k">for</span> <span class="n">thinking</span> <span class="ow">in</span> <span class="p">[</span><span class="bp">False</span><span class="p">,</span> <span class="bp">True</span><span class="p">]:</span>
    <span class="n">prompt</span> <span class="o">=</span> <span class="n">tok</span><span class="p">.</span><span class="nf">apply_chat_template</span><span class="p">(</span><span class="n">messages</span><span class="p">,</span> <span class="n">tokenize</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">add_generation_prompt</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
                                     <span class="n">enable_thinking</span><span class="o">=</span><span class="n">thinking</span><span class="p">)</span>
    <span class="n">written</span> <span class="o">=</span> <span class="nf">generate</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="p">[</span><span class="nf">tok</span><span class="p">(</span><span class="n">prompt</span><span class="p">).</span><span class="n">input_ids</span><span class="p">],</span> <span class="mi">2000</span> <span class="k">if</span> <span class="n">thinking</span> <span class="k">else</span> <span class="mi">400</span><span class="p">,</span> <span class="n">IM_END</span><span class="p">)[</span><span class="mi">0</span><span class="p">]</span>
    <span class="n">answer</span> <span class="o">=</span> <span class="n">tok</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="n">written</span><span class="p">)</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">--- thinking </span><span class="si">{</span><span class="sh">'</span><span class="s">on</span><span class="sh">'</span> <span class="k">if</span> <span class="n">thinking</span> <span class="k">else</span> <span class="sh">'</span><span class="s">off</span><span class="sh">'</span><span class="si">}</span><span class="s">, </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">written</span><span class="p">)</span><span class="si">}</span><span class="s"> tokens</span><span class="sh">"</span><span class="p">)</span>
    <span class="nf">print</span><span class="p">(</span><span class="n">answer</span> <span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="n">answer</span><span class="p">)</span> <span class="o">&lt;</span> <span class="mi">1500</span> <span class="k">else</span> <span class="n">answer</span><span class="p">[:</span><span class="mi">700</span><span class="p">]</span> <span class="o">+</span> <span class="sh">"</span><span class="se">\n</span><span class="s">[…]</span><span class="se">\n</span><span class="sh">"</span> <span class="o">+</span> <span class="n">answer</span><span class="p">[</span><span class="o">-</span><span class="mi">500</span><span class="p">:])</span>
</code></pre></div></div> <pre class="tfs-printed"><code>--- thinking off, 211 tokens
We are given:

- Lena is **three years older** than Max.
- In **five years**, their **ages will add up to 41**.

Let’s define:

- Let Max’s current age be $ x $.
- Then Lena’s current age is $ x + 3 $.

In **five years**, their ages will be:

- Max: $ x + 5 $
- Lena: $ x + 3 + 5 = x + 8 $

So, their ages in five years add up to:

$$
(x + 5) + (x + 8) = 2x + 13
$$

We are told this sum is 41:

$$
2x + 13 = 41
$$

Subtract 13 from both sides:

$$
2x = 28
$$

Divide by 2:

$$
x = 14
$$

### ✅ Final Answer:
Max is **14 years old now**.
--- thinking on, 1576 tokens
&lt;think&gt;
Okay, let's see. Lena is three years older than Max. So if I let Max's current age be something, then Lena's age would be Max's age plus three. Let me write that down.

Let me assign variables. Let M represent Max's current age. Then Lena's age would be M + 3. 

Now, the problem says that in five years, their ages will add up to 41. So I need to figure out their ages in five years and then set up an equation. 

In five years, Max's age will be M + 5, and Lena's age will be (M + 3) + 5. Let me calculate that. 

So adding those together: (M + 5) + (M + 3 + 5) = 41. Wait, maybe I should just add them directly. 

Alternatively, maybe I can write it as (M + 5) + (M + 3 + 5) = 41. Let me c
[…]
herefore, we can set up the equation:

$$
(M + 5) + (M + 8) = 41
$$

Simplifying:

$$
2M + 13 = 41
$$

Subtract 13 from both sides:

$$
2M = 28
$$

Divide by 2:

$$
M = 14
$$

---

**Verification:**

- Max's current age: $ 14 $
- Lena's current age: $ 14 + 3 = 17 $
- In five years: Max will be $ 14 + 5 = 19 $, and Lena will be $ 17 + 5 = 22 $
- Sum of their ages in five years: $ 19 + 22 = 41 $, which matches the problem statement.

---

**Final Answer:**

Max is currently $\boxed{14}$ years old.</code></pre> <p>Both answers are right. Without thinking the model writes a tidy solution at once. With thinking it first talks to itself for several times as many tokens, sets up the equation, doubts it, sets it up again and checks the result, and only then writes the same answer.</p> <p>On a problem this easy the thinking buys nothing; it pays on problems where the first attempt goes wrong, and either way it is paid for in tokens.</p> <h2 id="7-sliding-window-attention-and-local-layers">7. Sliding-window attention and local layers</h2> <p>Grouped queries shrink the cache per token; a sliding window caps the number of tokens. In a <em>local</em> layer each token attends only to the last \(W\) tokens, itself included:</p> \[\text{token } i \text{ sees token } j \quad \Longleftrightarrow \quad i - W &lt; j \le i.\] <p>Mistral 7B, in September 2023, gave every layer a window of 4,096 tokens and pointed out that the window is not a horizon: layer 2 sees layer 1’s outputs, each of which already summarises a window, so information travels about \(W\) tokens further back with every layer (\(W - 1\) with our mask; Mistral’s paper lets a position see the \(W\) tokens before itself). “At the last layer, using a window size of W=4096, we have a theoretical attention span of approximately 131K tokens”<sup class="cite">[<a href="#ref-8" id="cite-8" data-ref="8" aria-label="Reference 8: Jiang, A. Q., Sablayrolles, A., Mensch, A., et al. (2023). Mistral 7B. arXiv:2310.06825.">8</a>]</sup>. Its cache never holds more than \(W\) tokens: a <em>rolling buffer</em> writes token \(i\) into slot \(i \bmod W\), over the token that has just left the window, and on a 32k-token sequence “this reduces the cache memory usage by 8x, without impacting the model quality”.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/06/window-light.png" width="760" alt="Sliding-window attention. Left: the causal mask of global attention, a full lower triangle, against the mask of a local layer with a window of four, a band along the diagonal. Middle: through one, two and three local layers, what a token can draw on spans four, then seven, then ten tokens, itself included, because each layer reads the previous layer's summaries. Right: the rolling buffer, four slots, where token i is written into slot i mod 4 over the token that left the window" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/06/window-dark.png" width="760" alt="Sliding-window attention. Left: the causal mask of global attention, a full lower triangle, against the mask of a local layer with a window of four, a band along the diagonal. Middle: through one, two and three local layers, what a token can draw on spans four, then seven, then ten tokens, itself included, because each layer reads the previous layer's summaries. Right: the rolling buffer, four slots, where token i is written into slot i mod 4 over the token that left the window" loading="lazy"></p> <p>The rolling buffer is a few lines on top of our <code class="language-plaintext highlighter-rouge">Cache</code>. It keeps at most \(W\) keys and values; it doesn’t even need to keep them in order, because a token’s position is already rotated into its key and attention doesn’t care where in memory a key sits.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">RollingCache</span><span class="p">:</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">window</span><span class="p">):</span>
        <span class="n">self</span><span class="p">.</span><span class="n">window</span> <span class="o">=</span> <span class="n">window</span>
        <span class="n">self</span><span class="p">.</span><span class="n">k</span> <span class="o">=</span> <span class="bp">None</span>
        <span class="n">self</span><span class="p">.</span><span class="n">v</span> <span class="o">=</span> <span class="bp">None</span>
        <span class="n">self</span><span class="p">.</span><span class="n">seen</span> <span class="o">=</span> <span class="mi">0</span>  <span class="c1"># tokens written so far
</span>
    <span class="k">def</span> <span class="nf">add</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">):</span>
        <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">k</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">2</span><span class="p">]):</span>  <span class="c1"># one token at a time, as during generation
</span>            <span class="n">slot</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">seen</span> <span class="o">%</span> <span class="n">self</span><span class="p">.</span><span class="n">window</span>
            <span class="k">if</span> <span class="n">self</span><span class="p">.</span><span class="n">k</span> <span class="ow">is</span> <span class="bp">None</span><span class="p">:</span>
                <span class="n">self</span><span class="p">.</span><span class="n">k</span> <span class="o">=</span> <span class="n">k</span><span class="p">[:,</span> <span class="p">:,</span> <span class="n">i</span><span class="p">:</span><span class="n">i</span> <span class="o">+</span> <span class="mi">1</span><span class="p">]</span>
                <span class="n">self</span><span class="p">.</span><span class="n">v</span> <span class="o">=</span> <span class="n">v</span><span class="p">[:,</span> <span class="p">:,</span> <span class="n">i</span><span class="p">:</span><span class="n">i</span> <span class="o">+</span> <span class="mi">1</span><span class="p">]</span>
            <span class="k">elif</span> <span class="n">self</span><span class="p">.</span><span class="n">k</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">2</span><span class="p">]</span> <span class="o">&lt;</span> <span class="n">self</span><span class="p">.</span><span class="n">window</span><span class="p">:</span>
                <span class="n">self</span><span class="p">.</span><span class="n">k</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">self</span><span class="p">.</span><span class="n">k</span><span class="p">,</span> <span class="n">k</span><span class="p">[:,</span> <span class="p">:,</span> <span class="n">i</span><span class="p">:</span><span class="n">i</span> <span class="o">+</span> <span class="mi">1</span><span class="p">]],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
                <span class="n">self</span><span class="p">.</span><span class="n">v</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">self</span><span class="p">.</span><span class="n">v</span><span class="p">,</span> <span class="n">v</span><span class="p">[:,</span> <span class="p">:,</span> <span class="n">i</span><span class="p">:</span><span class="n">i</span> <span class="o">+</span> <span class="mi">1</span><span class="p">]],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
            <span class="k">else</span><span class="p">:</span>
                <span class="n">self</span><span class="p">.</span><span class="n">k</span><span class="p">[:,</span> <span class="p">:,</span> <span class="n">slot</span><span class="p">]</span> <span class="o">=</span> <span class="n">k</span><span class="p">[:,</span> <span class="p">:,</span> <span class="n">i</span><span class="p">]</span>
                <span class="n">self</span><span class="p">.</span><span class="n">v</span><span class="p">[:,</span> <span class="p">:,</span> <span class="n">slot</span><span class="p">]</span> <span class="o">=</span> <span class="n">v</span><span class="p">[:,</span> <span class="p">:,</span> <span class="n">i</span><span class="p">]</span>
            <span class="n">self</span><span class="p">.</span><span class="n">seen</span> <span class="o">+=</span> <span class="mi">1</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="n">k</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">v</span>
</code></pre></div></div> <p>Two ways of computing the same thing must give the same answer: Qwen3 reading a text with a window of 16 in every layer, once with the full causal cache and a banded mask, once token by token with a rolling buffer of 16 slots and no mask at all. Qwen3 was not trained with a window, but the arithmetic doesn’t know that.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">W</span> <span class="o">=</span> <span class="mi">16</span>
<span class="n">t</span> <span class="o">=</span> <span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>
<span class="n">i</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">t</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
<span class="n">band</span> <span class="o">=</span> <span class="p">(</span><span class="n">i</span><span class="p">[</span><span class="bp">None</span><span class="p">,</span> <span class="p">:]</span> <span class="o">&lt;=</span> <span class="n">i</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">])</span> <span class="o">&amp;</span> <span class="p">(</span><span class="n">i</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">-</span> <span class="n">i</span><span class="p">[</span><span class="bp">None</span><span class="p">,</span> <span class="p">:]</span> <span class="o">&lt;</span> <span class="n">W</span><span class="p">)</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">banded</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">positions</span><span class="p">,</span> <span class="n">band</span><span class="p">)</span>
    <span class="n">caches</span> <span class="o">=</span> <span class="p">[</span><span class="nc">RollingCache</span><span class="p">(</span><span class="n">W</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="n">layers</span><span class="p">]</span>
    <span class="n">stepwise</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">step</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">t</span><span class="p">):</span>
        <span class="n">keys</span> <span class="o">=</span> <span class="nf">min</span><span class="p">(</span><span class="n">step</span> <span class="o">+</span> <span class="mi">1</span><span class="p">,</span> <span class="n">W</span><span class="p">)</span>
        <span class="n">everything</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">keys</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
        <span class="n">token</span><span class="p">,</span> <span class="n">where</span> <span class="o">=</span> <span class="n">ids</span><span class="p">[:,</span> <span class="n">step</span><span class="p">:</span><span class="n">step</span> <span class="o">+</span> <span class="mi">1</span><span class="p">],</span> <span class="n">positions</span><span class="p">[:,</span> <span class="n">step</span><span class="p">:</span><span class="n">step</span> <span class="o">+</span> <span class="mi">1</span><span class="p">]</span>
        <span class="n">stepwise</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="nf">model</span><span class="p">(</span><span class="n">token</span><span class="p">,</span> <span class="n">where</span><span class="p">,</span> <span class="n">everything</span><span class="p">,</span> <span class="n">caches</span><span class="p">))</span>
    <span class="n">stepwise</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">(</span><span class="n">stepwise</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">tokens:</span><span class="sh">"</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="sh">"</span><span class="s">window:</span><span class="sh">"</span><span class="p">,</span> <span class="n">W</span><span class="p">,</span> <span class="sh">"</span><span class="s">slots in each cache:</span><span class="sh">"</span><span class="p">,</span> <span class="n">caches</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="n">k</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">2</span><span class="p">])</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">max difference:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="n">banded</span> <span class="o">-</span> <span class="n">stepwise</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>tokens: 34 window: 16 slots in each cache: 16
max difference: 1.01e-04</code></pre> <p>The two agree to rounding error, and the buffer never holds more than its 16 slots: a rolling cache is another way of storing what the banded mask lets each token see.</p> <p>Gemma 2 made local attention common again: it alternated local and global layers, one to one.</p> <p>Gemma 3 went to five local layers for every global one with a window of 1,024 (512 in the 1B model, says its config), Ministral 8B to three for every global one with a window of 32,768, and gpt-oss alternates again with a window of only 128 tokens.</p> <p>The global layers carry information across the whole context; the local ones, half of the layers or more, cost a fixed amount of memory however long the context grows. Here are the layers of every model of section 1 that has local ones:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">mixed</span> <span class="o">=</span> <span class="p">[</span><span class="n">name</span> <span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">names</span> <span class="k">if</span> <span class="sh">"</span><span class="s">local</span><span class="sh">"</span> <span class="ow">in</span> <span class="nf">layer_kinds</span><span class="p">(</span><span class="n">configs</span><span class="p">[</span><span class="n">name</span><span class="p">])]</span>
<span class="n">longest</span> <span class="o">=</span> <span class="nf">max</span><span class="p">(</span><span class="n">configs</span><span class="p">[</span><span class="n">n</span><span class="p">][</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">]</span> <span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="n">mixed</span><span class="p">)</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">9.6</span><span class="p">,</span> <span class="mf">0.42</span> <span class="o">*</span> <span class="nf">len</span><span class="p">(</span><span class="n">mixed</span><span class="p">)</span> <span class="o">+</span> <span class="mf">1.0</span><span class="p">))</span>
<span class="k">for</span> <span class="n">row</span><span class="p">,</span> <span class="n">name</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">mixed</span><span class="p">):</span>
    <span class="k">for</span> <span class="n">layer</span><span class="p">,</span> <span class="n">kind</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="nf">layer_kinds</span><span class="p">(</span><span class="n">configs</span><span class="p">[</span><span class="n">name</span><span class="p">])):</span>
        <span class="n">color</span> <span class="o">=</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">]</span> <span class="k">if</span> <span class="n">kind</span> <span class="o">==</span> <span class="sh">"</span><span class="s">global</span><span class="sh">"</span> <span class="k">else</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att_tint</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">cell</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nc">Rectangle</span><span class="p">((</span><span class="n">layer</span><span class="p">,</span> <span class="n">row</span> <span class="o">-</span> <span class="mf">0.36</span><span class="p">),</span> <span class="mf">0.86</span><span class="p">,</span> <span class="mf">0.72</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>
        <span class="n">ax</span><span class="p">.</span><span class="nf">add_patch</span><span class="p">(</span><span class="n">cell</span><span class="p">)</span>
    <span class="n">window</span> <span class="o">=</span> <span class="n">configs</span><span class="p">[</span><span class="n">name</span><span class="p">][</span><span class="sh">"</span><span class="s">sliding_window</span><span class="sh">"</span><span class="p">]</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">text</span><span class="p">(</span><span class="n">longest</span> <span class="o">+</span> <span class="mf">0.8</span><span class="p">,</span> <span class="n">row</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="s">window </span><span class="si">{</span><span class="n">window</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span> <span class="n">va</span><span class="o">=</span><span class="sh">"</span><span class="s">center</span><span class="sh">"</span><span class="p">,</span>
            <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">],</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">9</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlim</span><span class="p">(</span><span class="o">-</span><span class="mf">0.5</span><span class="p">,</span> <span class="n">longest</span> <span class="o">+</span> <span class="mi">9</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylim</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">mixed</span><span class="p">)</span> <span class="o">-</span> <span class="mf">0.4</span><span class="p">,</span> <span class="o">-</span><span class="mf">0.6</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_yticks</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">mixed</span><span class="p">)),</span> <span class="n">mixed</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">layer (dark: global attention, light: local)</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">Where the global layers are</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">grid</span><span class="p">(</span><span class="bp">False</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="n">spines</span><span class="p">[</span><span class="sh">"</span><span class="s">left</span><span class="sh">"</span><span class="p">].</span><span class="nf">set_visible</span><span class="p">(</span><span class="bp">False</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="n">spines</span><span class="p">[</span><span class="sh">"</span><span class="s">bottom</span><span class="sh">"</span><span class="p">].</span><span class="nf">set_visible</span><span class="p">(</span><span class="bp">False</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/06/output-04.png" alt="Where the global layers are" loading="lazy"></p> <p>How much does a model lose when most of its layers stop seeing far? Gemma’s authors answer for models trained that way: “We observe minimal impact on perplexity when changing this ratio”, and “the sliding window can be reduced significantly without impacting perplexity”.</p> <p>We can ask a different question, of a model trained without any window: what happens to Qwen3 if we impose one?</p> <p>We take a dozen Wikipedia articles of at least 4,096 tokens and measure the loss of predicting each token, averaged by its position, under several masks: global attention everywhere, as trained; a window of 512 in every layer; Gemma 3’s pattern, five local layers of 512 and then one global; and the same two with the first four tokens of the text kept visible to every layer, for a reason the results will make clear.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">articles</span><span class="p">,</span> <span class="n">current</span> <span class="o">=</span> <span class="p">[],</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">line</span> <span class="ow">in</span> <span class="n">pd</span><span class="p">.</span><span class="nf">read_parquet</span><span class="p">(</span><span class="n">path</span><span class="p">)[</span><span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">].</span><span class="nf">tolist</span><span class="p">():</span>
    <span class="c1"># a new top-level heading, " = Title = ", starts an article
</span>    <span class="k">if</span> <span class="n">re</span><span class="p">.</span><span class="nf">match</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s">^ = [^=].* = \n$</span><span class="sh">"</span><span class="p">,</span> <span class="n">line</span><span class="p">)</span> <span class="ow">and</span> <span class="n">current</span><span class="p">:</span>
        <span class="n">articles</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="sh">""</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">current</span><span class="p">))</span>
        <span class="n">current</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="n">current</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">line</span><span class="p">)</span>
<span class="n">articles</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="sh">""</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">current</span><span class="p">))</span>
<span class="n">LENGTH</span> <span class="o">=</span> <span class="mi">1024</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">4096</span>
<span class="n">long_texts</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">article</span> <span class="ow">in</span> <span class="n">articles</span><span class="p">:</span>
    <span class="n">article_ids</span> <span class="o">=</span> <span class="nf">tok</span><span class="p">(</span><span class="n">article</span><span class="p">).</span><span class="n">input_ids</span>
    <span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="n">article_ids</span><span class="p">)</span> <span class="o">&gt;=</span> <span class="n">LENGTH</span><span class="p">:</span>
        <span class="n">long_texts</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">article_ids</span><span class="p">[:</span><span class="n">LENGTH</span><span class="p">])</span>
<span class="n">long_texts</span> <span class="o">=</span> <span class="n">long_texts</span><span class="p">[:</span><span class="mi">2</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">12</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">long_texts</span><span class="p">),</span> <span class="sh">"</span><span class="s">articles of</span><span class="sh">"</span><span class="p">,</span> <span class="n">LENGTH</span><span class="p">,</span> <span class="sh">"</span><span class="s">tokens</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>12 articles of 4096 tokens</code></pre> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">n_layers</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">]</span>
<span class="n">i</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">LENGTH</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
<span class="n">causal</span> <span class="o">=</span> <span class="n">i</span><span class="p">[</span><span class="bp">None</span><span class="p">,</span> <span class="p">:]</span> <span class="o">&lt;=</span> <span class="n">i</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">]</span>


<span class="k">def</span> <span class="nf">window_mask</span><span class="p">(</span><span class="n">window</span><span class="p">,</span> <span class="n">sink</span><span class="o">=</span><span class="mi">0</span><span class="p">):</span>
    <span class="n">mask</span> <span class="o">=</span> <span class="n">causal</span> <span class="o">&amp;</span> <span class="p">(</span><span class="n">i</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">-</span> <span class="n">i</span><span class="p">[</span><span class="bp">None</span><span class="p">,</span> <span class="p">:]</span> <span class="o">&lt;</span> <span class="n">window</span><span class="p">)</span>
    <span class="k">if</span> <span class="n">sink</span><span class="p">:</span>
        <span class="n">mask</span> <span class="o">=</span> <span class="n">mask</span> <span class="o">|</span> <span class="p">(</span><span class="n">causal</span> <span class="o">&amp;</span> <span class="p">(</span><span class="n">i</span><span class="p">[</span><span class="bp">None</span><span class="p">,</span> <span class="p">:]</span> <span class="o">&lt;</span> <span class="n">sink</span><span class="p">))</span>  <span class="c1"># the first `sink` tokens stay visible
</span>    <span class="k">return</span> <span class="n">mask</span>


<span class="k">def</span> <span class="nf">local_global</span><span class="p">(</span><span class="n">window</span><span class="p">,</span> <span class="n">sink</span><span class="o">=</span><span class="mi">0</span><span class="p">):</span>
    <span class="n">local</span> <span class="o">=</span> <span class="nf">window_mask</span><span class="p">(</span><span class="n">window</span><span class="p">,</span> <span class="n">sink</span><span class="p">)</span>
    <span class="k">return</span> <span class="p">[</span><span class="n">causal</span> <span class="nf">if </span><span class="p">(</span><span class="n">k</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">%</span> <span class="mi">6</span> <span class="o">==</span> <span class="mi">0</span> <span class="k">else</span> <span class="n">local</span> <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n_layers</span><span class="p">)]</span>


<span class="n">SETUPS</span> <span class="o">=</span> <span class="p">{</span>
    <span class="sh">"</span><span class="s">global everywhere (as trained)</span><span class="sh">"</span><span class="p">:</span> <span class="p">[</span><span class="n">causal</span><span class="p">]</span> <span class="o">*</span> <span class="n">n_layers</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">window of 512 everywhere</span><span class="sh">"</span><span class="p">:</span> <span class="p">[</span><span class="nf">window_mask</span><span class="p">(</span><span class="mi">512</span><span class="p">)]</span> <span class="o">*</span> <span class="n">n_layers</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">5 local : 1 global</span><span class="sh">"</span><span class="p">:</span> <span class="nf">local_global</span><span class="p">(</span><span class="mi">512</span><span class="p">),</span>
    <span class="sh">"</span><span class="s">window of 512 + first 4 tokens</span><span class="sh">"</span><span class="p">:</span> <span class="p">[</span><span class="nf">window_mask</span><span class="p">(</span><span class="mi">512</span><span class="p">,</span> <span class="n">sink</span><span class="o">=</span><span class="mi">4</span><span class="p">)]</span> <span class="o">*</span> <span class="n">n_layers</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">5 local : 1 global + first 4 tokens</span><span class="sh">"</span><span class="p">:</span> <span class="nf">local_global</span><span class="p">(</span><span class="mi">512</span><span class="p">,</span> <span class="n">sink</span><span class="o">=</span><span class="mi">4</span><span class="p">),</span>
<span class="p">}</span>
<span class="n">by_position</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">masks</span> <span class="ow">in</span> <span class="n">SETUPS</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
    <span class="n">total</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">LENGTH</span> <span class="o">-</span> <span class="mi">1</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">article_ids</span> <span class="ow">in</span> <span class="n">long_texts</span><span class="p">:</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">([</span><span class="n">article_ids</span><span class="p">],</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
        <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
            <span class="n">h</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="nf">hidden</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">i</span><span class="p">[</span><span class="bp">None</span><span class="p">],</span> <span class="n">masks</span><span class="p">)</span>
            <span class="n">logits</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="nf">logits</span><span class="p">(</span><span class="n">h</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="p">:</span><span class="o">-</span><span class="mi">1</span><span class="p">]).</span><span class="nf">float</span><span class="p">()</span>
        <span class="n">total</span> <span class="o">+=</span> <span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span><span class="n">logits</span><span class="p">,</span> <span class="n">x</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">:],</span> <span class="n">reduction</span><span class="o">=</span><span class="sh">"</span><span class="s">none</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">by_position</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="o">=</span> <span class="p">(</span><span class="n">total</span> <span class="o">/</span> <span class="nf">len</span><span class="p">(</span><span class="n">long_texts</span><span class="p">)).</span><span class="nf">cpu</span><span class="p">().</span><span class="nf">numpy</span><span class="p">()</span>

<span class="n">edges</span> <span class="o">=</span> <span class="p">[</span><span class="n">e</span> <span class="k">for</span> <span class="n">e</span> <span class="ow">in</span> <span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">512</span><span class="p">,</span> <span class="mi">1024</span><span class="p">,</span> <span class="mi">2048</span><span class="p">]</span> <span class="k">if</span> <span class="n">e</span> <span class="o">&lt;</span> <span class="n">LENGTH</span> <span class="o">-</span> <span class="mi">1</span><span class="p">]</span> <span class="o">+</span> <span class="p">[</span><span class="n">LENGTH</span> <span class="o">-</span> <span class="mi">1</span><span class="p">]</span>
<span class="n">summary</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">losses</span> <span class="ow">in</span> <span class="n">by_position</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
    <span class="n">row</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">attention</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">}</span>
    <span class="k">for</span> <span class="n">lo</span><span class="p">,</span> <span class="n">hi</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">edges</span><span class="p">[:</span><span class="o">-</span><span class="mi">1</span><span class="p">],</span> <span class="n">edges</span><span class="p">[</span><span class="mi">1</span><span class="p">:]):</span>
        <span class="n">row</span><span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="s">tokens </span><span class="si">{</span><span class="n">lo</span><span class="si">}</span><span class="s">–</span><span class="si">{</span><span class="n">hi</span><span class="si">}</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">losses</span><span class="p">[</span><span class="n">lo</span><span class="p">:</span><span class="n">hi</span><span class="p">].</span><span class="nf">mean</span><span class="p">()</span>
    <span class="n">summary</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">row</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">summary</span><span class="p">),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">3</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">attention</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">tokens 0–512</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">tokens 512–1024</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">tokens 1024–2048</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">tokens 2048–4095</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">global everywhere (as trained)</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.066</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.981</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.935</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.812</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">window of 512 everywhere</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.066</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6.366</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6.085</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6.009</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">5 local : 1 global</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.066</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5.604</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5.734</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5.543</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">window of 512 + first 4 tokens</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.066</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.058</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.137</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.042</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">5 local : 1 global + first 4 tokens</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.066</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.057</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.127</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.030</td></tr></tbody></table></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">8</span><span class="p">,</span> <span class="mf">3.8</span><span class="p">))</span>
<span class="n">colors</span> <span class="o">=</span> <span class="p">[</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">ink</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">data</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">]]</span>
<span class="nf">for </span><span class="p">(</span><span class="n">name</span><span class="p">,</span> <span class="n">losses</span><span class="p">),</span> <span class="n">color</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">by_position</span><span class="p">.</span><span class="nf">items</span><span class="p">(),</span> <span class="n">colors</span><span class="p">):</span>
    <span class="n">smooth</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">convolve</span><span class="p">(</span><span class="n">losses</span><span class="p">,</span> <span class="n">np</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="mi">64</span><span class="p">)</span> <span class="o">/</span> <span class="mi">64</span><span class="p">,</span> <span class="n">mode</span><span class="o">=</span><span class="sh">"</span><span class="s">valid</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">smooth</span><span class="p">))</span> <span class="o">+</span> <span class="mi">32</span><span class="p">,</span> <span class="n">smooth</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="n">name</span><span class="p">,</span> <span class="n">linewidth</span><span class="o">=</span><span class="mf">1.4</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">axvline</span><span class="p">(</span><span class="mi">512</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">],</span> <span class="n">linestyle</span><span class="o">=</span><span class="sh">"</span><span class="s">--</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">text</span><span class="p">(</span><span class="mi">530</span><span class="p">,</span> <span class="mf">0.5</span><span class="p">,</span> <span class="sh">"</span><span class="s">the window ends</span><span class="sh">"</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">],</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">9</span><span class="p">,</span> <span class="n">va</span><span class="o">=</span><span class="sh">"</span><span class="s">center</span><span class="sh">"</span><span class="p">,</span>
        <span class="n">transform</span><span class="o">=</span><span class="n">ax</span><span class="p">.</span><span class="nf">get_xaxis_transform</span><span class="p">())</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">position of the predicted token</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">loss, averaged over 64 positions</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">Qwen3-0.6B with windows it was never trained with</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mf">8.5</span><span class="p">,</span> <span class="n">loc</span><span class="o">=</span><span class="sh">"</span><span class="s">upper center</span><span class="sh">"</span><span class="p">,</span> <span class="n">bbox_to_anchor</span><span class="o">=</span><span class="p">(</span><span class="mf">0.5</span><span class="p">,</span> <span class="o">-</span><span class="mf">0.2</span><span class="p">),</span>
          <span class="n">ncol</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/06/output-05.png" alt="Qwen3-0.6B with windows it was never trained with" loading="lazy"></p> <p>Up to the 512th token every mask is the same as global attention, and so is the loss. After it, a window of 512 in every layer is a disaster: the loss more than doubles and stays there.</p> <p>One global layer in six helps only a little. The surprise is in the last two rows. Keep the first four tokens of the text visible to every layer, and the windowed model comes close to the global one all the way to the 4,096th token.</p> <p>The first tokens matter not for what they say. Xiao et al. found that language models put a large share of their attention on the first tokens of a text, whatever those tokens are: a softmax has to give its weight to something, and the first tokens, visible to every later one, become the place to park it.</p> <p>They called them <em>attention sinks</em>, and “keeping the KV of initial tokens will largely recover the performance of window attention”<sup class="cite">[<a href="#ref-9" id="cite-9" data-ref="9" aria-label="Reference 9: Xiao, G., Tian, Y., Chen, B., Han, S., &amp; Lewis, M. (2023). Efficient streaming language models with attention sinks. ICLR 2024.">9</a>]</sup>. Cut the sinks off with a window and the heads that used them have nowhere to put their attention.</p> <p>The gap that remains between the rows with sinks and global attention is what the model really loses by not seeing far, and it grows with position, as global attention gets more context to use.</p> <p>Models trained with windows from the start learn to live with them, and gpt-oss builds the sink into every head: “Each attention head has a learned bias in the denominator of the softmax”<sup class="cite">[<a href="#ref-10" id="cite-10" data-ref="10" aria-label="Reference 10: OpenAI (2025). gpt-oss-120b &amp; gpt-oss-20b model card. arXiv:2508.10925.">10</a>]</sup>.</p> <h2 id="8-teaching-the-small-model-a-job-with-lora">8. Teaching the small model a job with LoRA</h2> <p>A model of 0.6 billion parameters will not write your novel, but it can do one narrow job fast and cheaply, on a laptop or a phone. The job here is the one every voice assistant does: turn a spoken command into a structured request. “Wake me up at five am this week” should become</p> <div class="language-json highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">{</span><span class="nl">"intent"</span><span class="p">:</span><span class="w"> </span><span class="s2">"alarm_set"</span><span class="p">,</span><span class="w"> </span><span class="nl">"slots"</span><span class="p">:</span><span class="w"> </span><span class="p">[[</span><span class="s2">"time"</span><span class="p">,</span><span class="w"> </span><span class="s2">"five am"</span><span class="p">],</span><span class="w"> </span><span class="p">[</span><span class="s2">"date"</span><span class="p">,</span><span class="w"> </span><span class="s2">"this week"</span><span class="p">]]}</span><span class="w">
</span></code></pre></div></div> <p>with the intent chosen from a fixed list and each slot’s value copied word for word from the command, so that the alarm app knows what to do.</p> <p>The data is MASSIVE, which Amazon released in 2022: “1M realistic, parallel, labeled virtual assistant utterances” in 51 languages, with “18 domains, 60 intents, and 55 slots”<sup class="cite">[<a href="#ref-11" id="cite-11" data-ref="11" aria-label="Reference 11: FitzGerald, J., Hench, C., Peris, C., et al. (2022). MASSIVE: a 1M-example multilingual natural language understanding dataset with 51 typologically-diverse languages. ACL 2023. Data: github.com/alexa/massive, CC BY 4.0.">11</a>]</sup>.</p> <p>Professional translators <em>localised</em> the English commands of an earlier dataset, SLURP, rather than translated them, so the Russian command about cultural events in California asks about the Leningrad region instead, and every slot is marked in the translation too. The licence is CC BY 4.0, and the official archive is 40 MB.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">DATA</span> <span class="o">=</span> <span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">massive</span><span class="sh">"</span>
<span class="k">if</span> <span class="ow">not</span> <span class="p">(</span><span class="n">DATA</span> <span class="o">/</span> <span class="sh">"</span><span class="s">1.1</span><span class="sh">"</span><span class="p">).</span><span class="nf">exists</span><span class="p">():</span>
    <span class="n">DATA</span><span class="p">.</span><span class="nf">mkdir</span><span class="p">(</span><span class="n">parents</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">exist_ok</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">url</span> <span class="o">=</span> <span class="p">(</span><span class="sh">"</span><span class="s">https://amazon-massive-nlu-dataset.s3.amazonaws.com/</span><span class="sh">"</span>
           <span class="sh">"</span><span class="s">amazon-massive-dataset-1.1.tar.gz</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">urllib</span><span class="p">.</span><span class="n">request</span><span class="p">.</span><span class="nf">urlretrieve</span><span class="p">(</span><span class="n">url</span><span class="p">,</span> <span class="n">DATA</span> <span class="o">/</span> <span class="sh">"</span><span class="s">massive.tar.gz</span><span class="sh">"</span><span class="p">)</span>
    <span class="k">with</span> <span class="n">tarfile</span><span class="p">.</span><span class="nf">open</span><span class="p">(</span><span class="n">DATA</span> <span class="o">/</span> <span class="sh">"</span><span class="s">massive.tar.gz</span><span class="sh">"</span><span class="p">)</span> <span class="k">as</span> <span class="n">archive</span><span class="p">:</span>
        <span class="n">archive</span><span class="p">.</span><span class="nf">extractall</span><span class="p">(</span><span class="n">DATA</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">read_locale</span><span class="p">(</span><span class="n">locale</span><span class="p">):</span>
    <span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">line</span> <span class="ow">in</span> <span class="nf">open</span><span class="p">(</span><span class="n">DATA</span> <span class="o">/</span> <span class="sh">"</span><span class="s">1.1</span><span class="sh">"</span> <span class="o">/</span> <span class="sh">"</span><span class="s">data</span><span class="sh">"</span> <span class="o">/</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">locale</span><span class="si">}</span><span class="s">.jsonl</span><span class="sh">"</span><span class="p">,</span> <span class="n">encoding</span><span class="o">=</span><span class="sh">"</span><span class="s">utf-8</span><span class="sh">"</span><span class="p">):</span>
        <span class="n">row</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">loads</span><span class="p">(</span><span class="n">line</span><span class="p">)</span>
        <span class="c1"># slots are marked inside the command: "wake me up at [time : five am]"
</span>        <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">slots</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="p">[[</span><span class="n">kind</span><span class="p">,</span> <span class="n">value</span><span class="p">.</span><span class="nf">strip</span><span class="p">()]</span> <span class="k">for</span> <span class="n">kind</span><span class="p">,</span> <span class="n">value</span>
                        <span class="ow">in</span> <span class="n">re</span><span class="p">.</span><span class="nf">findall</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s">\[(\w+) : ([^\]]+)\]</span><span class="sh">"</span><span class="p">,</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">annot_utt</span><span class="sh">"</span><span class="p">])]</span>
        <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">row</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">rows</span>


<span class="n">english</span><span class="p">,</span> <span class="n">russian</span> <span class="o">=</span> <span class="nf">read_locale</span><span class="p">(</span><span class="sh">"</span><span class="s">en-US</span><span class="sh">"</span><span class="p">),</span> <span class="nf">read_locale</span><span class="p">(</span><span class="sh">"</span><span class="s">ru-RU</span><span class="sh">"</span><span class="p">)</span>
<span class="n">russian_by_id</span> <span class="o">=</span> <span class="p">{</span><span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">id</span><span class="sh">"</span><span class="p">]:</span> <span class="n">row</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">russian</span><span class="p">}</span>
<span class="k">for</span> <span class="n">part</span> <span class="ow">in</span> <span class="p">[</span><span class="sh">"</span><span class="s">train</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">dev</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">test</span><span class="sh">"</span><span class="p">]:</span>
    <span class="n">count</span> <span class="o">=</span> <span class="nf">sum</span><span class="p">(</span><span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">partition</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="n">part</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">english</span><span class="p">)</span>
    <span class="nf">print</span><span class="p">(</span><span class="n">part</span><span class="p">,</span> <span class="n">count</span><span class="p">,</span> <span class="sh">"</span><span class="s">commands in each language</span><span class="sh">"</span><span class="p">)</span>
<span class="n">intents</span> <span class="o">=</span> <span class="nf">sorted</span><span class="p">({</span><span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">intent</span><span class="sh">"</span><span class="p">]</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">english</span> <span class="k">if</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">partition</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="sh">"</span><span class="s">train</span><span class="sh">"</span><span class="p">})</span>
<span class="n">slot_types</span> <span class="o">=</span> <span class="nf">sorted</span><span class="p">({</span><span class="n">kind</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">english</span> <span class="k">if</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">partition</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="sh">"</span><span class="s">train</span><span class="sh">"</span>
                     <span class="k">for</span> <span class="n">kind</span><span class="p">,</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">slots</span><span class="sh">"</span><span class="p">]})</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">intents</span><span class="p">),</span> <span class="sh">"</span><span class="s">intents,</span><span class="sh">"</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">slot_types</span><span class="p">),</span> <span class="sh">"</span><span class="s">slot types</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>train 11514 commands in each language
dev 2033 commands in each language
test 2974 commands in each language
60 intents, 55 slot types</code></pre> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">target</span><span class="p">(</span><span class="n">row</span><span class="p">):</span>
    <span class="k">return</span> <span class="n">json</span><span class="p">.</span><span class="nf">dumps</span><span class="p">({</span><span class="sh">"</span><span class="s">intent</span><span class="sh">"</span><span class="p">:</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">intent</span><span class="sh">"</span><span class="p">],</span> <span class="sh">"</span><span class="s">slots</span><span class="sh">"</span><span class="p">:</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">slots</span><span class="sh">"</span><span class="p">]},</span> <span class="n">ensure_ascii</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>


<span class="n">random</span><span class="p">.</span><span class="nf">seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">candidates</span> <span class="o">=</span> <span class="p">[</span><span class="n">row</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">english</span>
              <span class="k">if</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">partition</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="sh">"</span><span class="s">test</span><span class="sh">"</span> <span class="ow">and</span> <span class="nf">len</span><span class="p">(</span><span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">slots</span><span class="sh">"</span><span class="p">])</span> <span class="o">&gt;=</span> <span class="mi">2</span><span class="p">]</span>
<span class="n">shown</span> <span class="o">=</span> <span class="n">random</span><span class="p">.</span><span class="nf">sample</span><span class="p">(</span><span class="n">candidates</span><span class="p">,</span> <span class="mi">4</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">({</span><span class="sh">"</span><span class="s">English</span><span class="sh">"</span><span class="p">:</span> <span class="p">[</span><span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">utt</span><span class="sh">"</span><span class="p">]</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">shown</span><span class="p">],</span>
                    <span class="sh">"</span><span class="s">Russian</span><span class="sh">"</span><span class="p">:</span> <span class="p">[</span><span class="n">russian_by_id</span><span class="p">[</span><span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">id</span><span class="sh">"</span><span class="p">]][</span><span class="sh">"</span><span class="s">utt</span><span class="sh">"</span><span class="p">]</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">shown</span><span class="p">],</span>
                    <span class="sh">"</span><span class="s">English JSON</span><span class="sh">"</span><span class="p">:</span> <span class="p">[</span><span class="nf">target</span><span class="p">(</span><span class="n">row</span><span class="p">)</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">shown</span><span class="p">],</span>
                    <span class="sh">"</span><span class="s">Russian JSON</span><span class="sh">"</span><span class="p">:</span> <span class="p">[</span><span class="nf">target</span><span class="p">(</span><span class="n">russian_by_id</span><span class="p">[</span><span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">id</span><span class="sh">"</span><span class="p">]])</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">shown</span><span class="p">]}))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">English</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">Russian</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">English JSON</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">Russian JSON</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">convert current time from g. m. t. to e. s. t.</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">конвертировть текущее время со среднего времени по гринвичу в североамериканское восточное время</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "datetime_convert", "slots": [["time_zone", "g. m. t."], ["time_zone", "e. s. t."]]}</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "datetime_convert", "slots": [["time_zone", "среднего времени по гринвичу"], ["time_zone", "североамериканское восточное время"]]}</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">play lady by kenny roger</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">включи покинула чат клавы коки</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "play_music", "slots": [["song_name", "lady"], ["artist_name", "kenny roger"]]}</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "play_music", "slots": [["song_name", "покинула чат"], ["artist_name", "клавы коки"]]}</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">add a lunch with mike</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">добавь обед с михаилом</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "calendar_set", "slots": [["meal_type", "lunch"], ["person", "mike"]]}</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "calendar_set", "slots": [["meal_type", "обед"], ["person", "михаилом"]]}</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">block one hour from ten tomorrow morning</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">выдели один час с десяти завтрашним утром</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "calendar_set", "slots": [["time", "one hour"], ["time", "ten"], ["date", "tomorrow"], ["timeofday", "morning"]]}</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "calendar_set", "slots": [["time", "один час"], ["time", "десяти"], ["date", "завтрашним"], ["timeofday", "утром"]]}</td></tr></tbody></table></div> <p>The localisation shows in every row. Kenny Rogers’s song became one by the Russian singer Klava Koka, and the slot keeps her name in the genitive the sentence puts it in, <em>клавы коки</em>; Mike became Mikhail, in the instrumental case, <em>михаилом</em>.</p> <p>So a Russian slot value is not always in the form a dictionary gives, and a model has to copy it in the form it has in the command. The commands were written by people, typos included: <em>конвертировть</em> is missing a letter.</p> <p>The score has three numbers, as in the MASSIVE paper: the share of commands whose intent is right, the F1 of the slots, counting a slot as right only if both its type and its value match, and the share of commands where everything matches exactly, which is what the alarm app needs. An answer that isn’t valid JSON gets nothing.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">parse</span><span class="p">(</span><span class="n">text</span><span class="p">):</span>
    <span class="k">try</span><span class="p">:</span>
        <span class="n">answer</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">loads</span><span class="p">(</span><span class="n">text</span><span class="p">.</span><span class="nf">strip</span><span class="p">())</span>
    <span class="k">except</span> <span class="n">json</span><span class="p">.</span><span class="n">JSONDecodeError</span><span class="p">:</span>
        <span class="k">return</span> <span class="bp">None</span>
    <span class="k">if</span> <span class="ow">not</span> <span class="nf">isinstance</span><span class="p">(</span><span class="n">answer</span><span class="p">,</span> <span class="nb">dict</span><span class="p">)</span> <span class="ow">or</span> <span class="ow">not</span> <span class="nf">isinstance</span><span class="p">(</span><span class="n">answer</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">intent</span><span class="sh">"</span><span class="p">),</span> <span class="nb">str</span><span class="p">):</span>
        <span class="k">return</span> <span class="bp">None</span>
    <span class="n">slots</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">slot</span> <span class="ow">in</span> <span class="n">answer</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">slots</span><span class="sh">"</span><span class="p">,</span> <span class="p">[])</span> <span class="k">if</span> <span class="nf">isinstance</span><span class="p">(</span><span class="n">answer</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">slots</span><span class="sh">"</span><span class="p">),</span> <span class="nb">list</span><span class="p">)</span> <span class="k">else</span> <span class="p">[]:</span>
        <span class="n">is_pair</span> <span class="o">=</span> <span class="nf">isinstance</span><span class="p">(</span><span class="n">slot</span><span class="p">,</span> <span class="nb">list</span><span class="p">)</span> <span class="ow">and</span> <span class="nf">len</span><span class="p">(</span><span class="n">slot</span><span class="p">)</span> <span class="o">==</span> <span class="mi">2</span>
        <span class="k">if</span> <span class="n">is_pair</span> <span class="ow">and</span> <span class="nf">all</span><span class="p">(</span><span class="nf">isinstance</span><span class="p">(</span><span class="n">s</span><span class="p">,</span> <span class="nb">str</span><span class="p">)</span> <span class="k">for</span> <span class="n">s</span> <span class="ow">in</span> <span class="n">slot</span><span class="p">):</span>
            <span class="n">slots</span><span class="p">.</span><span class="nf">append</span><span class="p">((</span><span class="n">slot</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="n">slot</span><span class="p">[</span><span class="mi">1</span><span class="p">].</span><span class="nf">strip</span><span class="p">().</span><span class="nf">lower</span><span class="p">()))</span>
    <span class="k">return</span> <span class="p">{</span><span class="sh">"</span><span class="s">intent</span><span class="sh">"</span><span class="p">:</span> <span class="n">answer</span><span class="p">[</span><span class="sh">"</span><span class="s">intent</span><span class="sh">"</span><span class="p">],</span> <span class="sh">"</span><span class="s">slots</span><span class="sh">"</span><span class="p">:</span> <span class="n">slots</span><span class="p">}</span>


<span class="k">def</span> <span class="nf">score</span><span class="p">(</span><span class="n">rows</span><span class="p">,</span> <span class="n">outputs</span><span class="p">):</span>
    <span class="n">valid</span> <span class="o">=</span> <span class="n">intent</span> <span class="o">=</span> <span class="n">exact</span> <span class="o">=</span> <span class="mi">0</span>
    <span class="n">found</span> <span class="o">=</span> <span class="n">wrong</span> <span class="o">=</span> <span class="n">missed</span> <span class="o">=</span> <span class="mi">0</span>
    <span class="k">for</span> <span class="n">row</span><span class="p">,</span> <span class="n">output</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">rows</span><span class="p">,</span> <span class="n">outputs</span><span class="p">):</span>
        <span class="n">gold</span> <span class="o">=</span> <span class="nf">sorted</span><span class="p">((</span><span class="n">kind</span><span class="p">,</span> <span class="n">value</span><span class="p">.</span><span class="nf">lower</span><span class="p">())</span> <span class="k">for</span> <span class="n">kind</span><span class="p">,</span> <span class="n">value</span> <span class="ow">in</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">slots</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">answer</span> <span class="o">=</span> <span class="nf">parse</span><span class="p">(</span><span class="n">output</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">answer</span> <span class="ow">is</span> <span class="bp">None</span><span class="p">:</span>
            <span class="n">missed</span> <span class="o">+=</span> <span class="nf">len</span><span class="p">(</span><span class="n">gold</span><span class="p">)</span>
            <span class="k">continue</span>
        <span class="n">valid</span> <span class="o">+=</span> <span class="mi">1</span>
        <span class="n">predicted</span> <span class="o">=</span> <span class="nf">sorted</span><span class="p">(</span><span class="n">answer</span><span class="p">[</span><span class="sh">"</span><span class="s">slots</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">intent</span> <span class="o">+=</span> <span class="n">answer</span><span class="p">[</span><span class="sh">"</span><span class="s">intent</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">intent</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">exact</span> <span class="o">+=</span> <span class="n">answer</span><span class="p">[</span><span class="sh">"</span><span class="s">intent</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">intent</span><span class="sh">"</span><span class="p">]</span> <span class="ow">and</span> <span class="n">predicted</span> <span class="o">==</span> <span class="n">gold</span>
        <span class="n">remaining</span> <span class="o">=</span> <span class="nf">list</span><span class="p">(</span><span class="n">gold</span><span class="p">)</span>
        <span class="k">for</span> <span class="n">slot</span> <span class="ow">in</span> <span class="n">predicted</span><span class="p">:</span>
            <span class="k">if</span> <span class="n">slot</span> <span class="ow">in</span> <span class="n">remaining</span><span class="p">:</span>
                <span class="n">found</span> <span class="o">+=</span> <span class="mi">1</span>
                <span class="n">remaining</span><span class="p">.</span><span class="nf">remove</span><span class="p">(</span><span class="n">slot</span><span class="p">)</span>
            <span class="k">else</span><span class="p">:</span>
                <span class="n">wrong</span> <span class="o">+=</span> <span class="mi">1</span>
        <span class="n">missed</span> <span class="o">+=</span> <span class="nf">len</span><span class="p">(</span><span class="n">remaining</span><span class="p">)</span>
    <span class="n">precision</span> <span class="o">=</span> <span class="n">found</span> <span class="o">/</span> <span class="nf">max</span><span class="p">(</span><span class="n">found</span> <span class="o">+</span> <span class="n">wrong</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
    <span class="n">recall</span> <span class="o">=</span> <span class="n">found</span> <span class="o">/</span> <span class="nf">max</span><span class="p">(</span><span class="n">found</span> <span class="o">+</span> <span class="n">missed</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
    <span class="n">f1</span> <span class="o">=</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">precision</span> <span class="o">*</span> <span class="n">recall</span> <span class="o">/</span> <span class="nf">max</span><span class="p">(</span><span class="n">precision</span> <span class="o">+</span> <span class="n">recall</span><span class="p">,</span> <span class="mf">1e-9</span><span class="p">)</span>
    <span class="n">n</span> <span class="o">=</span> <span class="nf">len</span><span class="p">(</span><span class="n">rows</span><span class="p">)</span>
    <span class="k">return</span> <span class="p">{</span><span class="sh">"</span><span class="s">valid JSON</span><span class="sh">"</span><span class="p">:</span> <span class="n">valid</span> <span class="o">/</span> <span class="n">n</span><span class="p">,</span> <span class="sh">"</span><span class="s">intent</span><span class="sh">"</span><span class="p">:</span> <span class="n">intent</span> <span class="o">/</span> <span class="n">n</span><span class="p">,</span> <span class="sh">"</span><span class="s">slot F1</span><span class="sh">"</span><span class="p">:</span> <span class="n">f1</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">exact</span><span class="sh">"</span><span class="p">:</span> <span class="n">exact</span> <span class="o">/</span> <span class="n">n</span><span class="p">}</span>


<span class="nf">print</span><span class="p">(</span><span class="nf">score</span><span class="p">(</span><span class="n">shown</span><span class="p">,</span> <span class="p">[</span><span class="nf">target</span><span class="p">(</span><span class="n">row</span><span class="p">)</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">shown</span><span class="p">]))</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">score</span><span class="p">(</span><span class="n">shown</span><span class="p">,</span> <span class="p">[</span><span class="sh">'</span><span class="s">{</span><span class="sh">"</span><span class="s">intent</span><span class="sh">"</span><span class="s">: </span><span class="sh">"</span><span class="s">alarm_set</span><span class="sh">"</span><span class="s">, </span><span class="sh">"</span><span class="s">slots</span><span class="sh">"</span><span class="s">: []}</span><span class="sh">'</span><span class="p">]</span> <span class="o">*</span> <span class="mi">4</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>{'valid JSON': 1.0, 'intent': 1.0, 'slot F1': 1.0, 'exact': 1.0}
{'valid JSON': 1.0, 'intent': 0.0, 'slot F1': 0.0, 'exact': 0.0}</code></pre> <p><strong>The baseline: ask nicely.</strong> Without any training, a chat model can be told the task in its system prompt: the format, the 60 intents, the 55 slot types and three examples. That prompt runs to a few hundred tokens, as the next cell prints, and it is the same for every command.</p> <p>Recomputing its keys and values for every request would be a waste, so we compute them once and start every batch from a copy: <em>prefix caching</em>, which serving engines such as vLLM do automatically, in blocks of tokens, whenever prompts share a start. Our <code class="language-plaintext highlighter-rouge">generate</code> already takes a prefix; here is how to make one.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">schema_prompt</span><span class="p">(</span><span class="n">train_rows</span><span class="p">):</span>
    <span class="n">examples</span> <span class="o">=</span> <span class="n">random</span><span class="p">.</span><span class="nc">Random</span><span class="p">(</span><span class="mi">0</span><span class="p">).</span><span class="nf">sample</span><span class="p">([</span><span class="n">row</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">train_rows</span> <span class="k">if</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">slots</span><span class="sh">"</span><span class="p">]],</span> <span class="mi">3</span><span class="p">)</span>
    <span class="n">lines</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">You turn commands for a voice assistant into JSON.</span><span class="sh">"</span><span class="p">,</span>
             <span class="sh">"</span><span class="s">Answer with one JSON object only: </span><span class="sh">"</span>
             <span class="sh">'</span><span class="s">{</span><span class="sh">"</span><span class="s">intent</span><span class="sh">"</span><span class="s">: INTENT, </span><span class="sh">"</span><span class="s">slots</span><span class="sh">"</span><span class="s">: [[SLOT_TYPE, VALUE], ...]}.</span><span class="sh">'</span><span class="p">,</span>
             <span class="sh">"</span><span class="s">INTENT is exactly one of: </span><span class="sh">"</span> <span class="o">+</span> <span class="sh">"</span><span class="s">, </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">intents</span><span class="p">)</span> <span class="o">+</span> <span class="sh">"</span><span class="s">.</span><span class="sh">"</span><span class="p">,</span>
             <span class="sh">"</span><span class="s">SLOT_TYPE is exactly one of: </span><span class="sh">"</span> <span class="o">+</span> <span class="sh">"</span><span class="s">, </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">slot_types</span><span class="p">)</span> <span class="o">+</span> <span class="sh">"</span><span class="s">.</span><span class="sh">"</span><span class="p">,</span>
             <span class="sh">"</span><span class="s">VALUE is copied word for word from the command, in the command</span><span class="sh">'</span><span class="s">s language. </span><span class="sh">"</span>
             <span class="sh">"</span><span class="s">Use an empty list when there are no slots.</span><span class="sh">"</span><span class="p">,</span>
             <span class="sh">"</span><span class="s">Examples:</span><span class="sh">"</span><span class="p">]</span>
    <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">examples</span><span class="p">:</span>
        <span class="n">lines</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">utt</span><span class="sh">"</span><span class="p">]</span> <span class="o">+</span> <span class="sh">"</span><span class="s"> -&gt; </span><span class="sh">"</span> <span class="o">+</span> <span class="nf">target</span><span class="p">(</span><span class="n">row</span><span class="p">))</span>
    <span class="k">return</span> <span class="sh">"</span><span class="se">\n</span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">lines</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">chat_parts</span><span class="p">(</span><span class="n">system</span><span class="p">):</span>
    <span class="n">marker</span> <span class="o">=</span> <span class="sh">"</span><span class="s">&lt;&lt;COMMAND&gt;&gt;</span><span class="sh">"</span>
    <span class="n">messages</span> <span class="o">=</span> <span class="p">[{</span><span class="sh">"</span><span class="s">role</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">user</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">content</span><span class="sh">"</span><span class="p">:</span> <span class="n">marker</span><span class="p">}]</span>
    <span class="k">if</span> <span class="n">system</span><span class="p">:</span>
        <span class="n">messages</span> <span class="o">=</span> <span class="p">[{</span><span class="sh">"</span><span class="s">role</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">system</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">content</span><span class="sh">"</span><span class="p">:</span> <span class="n">system</span><span class="p">}]</span> <span class="o">+</span> <span class="n">messages</span>
    <span class="n">text</span> <span class="o">=</span> <span class="n">tok</span><span class="p">.</span><span class="nf">apply_chat_template</span><span class="p">(</span><span class="n">messages</span><span class="p">,</span> <span class="n">tokenize</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">add_generation_prompt</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
                                   <span class="n">enable_thinking</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">text</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">marker</span><span class="p">)</span>  <span class="c1"># what comes before the command, and after it
</span>

<span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">make_prefix</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">prefix_ids</span><span class="p">):</span>
    <span class="n">caches</span> <span class="o">=</span> <span class="p">[</span><span class="nc">Cache</span><span class="p">()</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="n">layers</span><span class="p">]</span>
    <span class="n">t</span> <span class="o">=</span> <span class="nf">len</span><span class="p">(</span><span class="n">prefix_ids</span><span class="p">)</span>
    <span class="n">x</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">([</span><span class="n">prefix_ids</span><span class="p">],</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
    <span class="n">causal</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">t</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">).</span><span class="nf">tril</span><span class="p">()</span>
    <span class="n">model</span><span class="p">.</span><span class="nf">hidden</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">t</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)[</span><span class="bp">None</span><span class="p">],</span> <span class="n">causal</span><span class="p">,</span> <span class="n">caches</span><span class="p">)</span>
    <span class="k">return</span> <span class="p">{</span><span class="sh">"</span><span class="s">kv</span><span class="sh">"</span><span class="p">:</span> <span class="p">[(</span><span class="n">cache</span><span class="p">.</span><span class="n">k</span><span class="p">,</span> <span class="n">cache</span><span class="p">.</span><span class="n">v</span><span class="p">)</span> <span class="k">for</span> <span class="n">cache</span> <span class="ow">in</span> <span class="n">caches</span><span class="p">],</span> <span class="sh">"</span><span class="s">length</span><span class="sh">"</span><span class="p">:</span> <span class="n">t</span><span class="p">}</span>


<span class="k">def</span> <span class="nf">run</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">rows</span><span class="p">,</span> <span class="n">system</span><span class="o">=</span><span class="bp">None</span><span class="p">,</span> <span class="n">batch</span><span class="o">=</span><span class="mi">64</span><span class="p">):</span>
    <span class="n">before</span><span class="p">,</span> <span class="n">after</span> <span class="o">=</span> <span class="nf">chat_parts</span><span class="p">(</span><span class="n">system</span><span class="p">)</span>
    <span class="n">prefix</span> <span class="o">=</span> <span class="nf">make_prefix</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="nf">tok</span><span class="p">(</span><span class="n">before</span><span class="p">,</span> <span class="n">add_special_tokens</span><span class="o">=</span><span class="bp">False</span><span class="p">).</span><span class="n">input_ids</span><span class="p">)</span>
    <span class="n">prompts</span> <span class="o">=</span> <span class="p">[</span><span class="nf">tok</span><span class="p">(</span><span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">utt</span><span class="sh">"</span><span class="p">]</span> <span class="o">+</span> <span class="n">after</span><span class="p">,</span> <span class="n">add_special_tokens</span><span class="o">=</span><span class="bp">False</span><span class="p">).</span><span class="n">input_ids</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">rows</span><span class="p">]</span>
    <span class="c1"># similar lengths in a batch, so less padding
</span>    <span class="n">order</span> <span class="o">=</span> <span class="nf">sorted</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">rows</span><span class="p">)),</span> <span class="n">key</span><span class="o">=</span><span class="k">lambda</span> <span class="n">k</span><span class="p">:</span> <span class="nf">len</span><span class="p">(</span><span class="n">prompts</span><span class="p">[</span><span class="n">k</span><span class="p">]))</span>
    <span class="n">outputs</span> <span class="o">=</span> <span class="p">[</span><span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="nf">len</span><span class="p">(</span><span class="n">rows</span><span class="p">)</span>
    <span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
    <span class="k">for</span> <span class="n">s</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">order</span><span class="p">),</span> <span class="n">batch</span><span class="p">):</span>
        <span class="n">chosen</span> <span class="o">=</span> <span class="n">order</span><span class="p">[</span><span class="n">s</span><span class="p">:</span><span class="n">s</span> <span class="o">+</span> <span class="n">batch</span><span class="p">]</span>
        <span class="n">answers</span> <span class="o">=</span> <span class="nf">generate</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="p">[</span><span class="n">prompts</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="n">chosen</span><span class="p">],</span> <span class="mi">110</span><span class="p">,</span> <span class="n">IM_END</span><span class="p">,</span> <span class="n">prefix</span><span class="p">)</span>
        <span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">written</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">chosen</span><span class="p">,</span> <span class="n">answers</span><span class="p">):</span>
            <span class="n">outputs</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="o">=</span> <span class="n">tok</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="n">written</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">outputs</span><span class="p">,</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span>
</code></pre></div></div> <p>The baselines run on a fixed sample of 500 test commands in each language, the same commands in English and in Russian. Qwen3-0.6B and Qwen3-4B, the latter in 16-bit floats so that it fits on a T4: our class loads it unchanged, since the dense models of the family share one architecture.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">train_en</span> <span class="o">=</span> <span class="p">[</span><span class="n">row</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">english</span> <span class="k">if</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">partition</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="sh">"</span><span class="s">train</span><span class="sh">"</span><span class="p">]</span>
<span class="n">train_ru</span> <span class="o">=</span> <span class="p">[</span><span class="n">row</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">russian</span> <span class="k">if</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">partition</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="sh">"</span><span class="s">train</span><span class="sh">"</span><span class="p">]</span>
<span class="n">test_en</span> <span class="o">=</span> <span class="p">[</span><span class="n">row</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">english</span> <span class="k">if</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">partition</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="sh">"</span><span class="s">test</span><span class="sh">"</span><span class="p">]</span>
<span class="n">test_ru</span> <span class="o">=</span> <span class="p">[</span><span class="n">russian_by_id</span><span class="p">[</span><span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">id</span><span class="sh">"</span><span class="p">]]</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">test_en</span><span class="p">]</span>
<span class="k">if</span> <span class="n">SMOKE</span><span class="p">:</span>
    <span class="n">test_en</span><span class="p">,</span> <span class="n">test_ru</span> <span class="o">=</span> <span class="n">test_en</span><span class="p">[:</span><span class="mi">32</span><span class="p">],</span> <span class="n">test_ru</span><span class="p">[:</span><span class="mi">32</span><span class="p">]</span>
<span class="n">sample</span> <span class="o">=</span> <span class="nf">sorted</span><span class="p">(</span><span class="n">random</span><span class="p">.</span><span class="nc">Random</span><span class="p">(</span><span class="mi">7</span><span class="p">).</span><span class="nf">sample</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">test_en</span><span class="p">)),</span> <span class="nf">min</span><span class="p">(</span><span class="mi">500</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">test_en</span><span class="p">))))</span>
<span class="n">sample_en</span> <span class="o">=</span> <span class="p">[</span><span class="n">test_en</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="n">sample</span><span class="p">]</span>
<span class="n">sample_ru</span> <span class="o">=</span> <span class="p">[</span><span class="n">test_ru</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="n">sample</span><span class="p">]</span>
<span class="n">system</span> <span class="o">=</span> <span class="nf">schema_prompt</span><span class="p">(</span><span class="n">train_en</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="nf">tok</span><span class="p">(</span><span class="n">system</span><span class="p">).</span><span class="n">input_ids</span><span class="p">),</span> <span class="sh">"</span><span class="s">tokens in the system prompt</span><span class="sh">"</span><span class="p">)</span>

<span class="n">scores</span> <span class="o">=</span> <span class="p">[]</span>
<span class="n">outputs</span> <span class="o">=</span> <span class="p">{}</span>
<span class="n">model</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">HALF</span><span class="p">)</span>
<span class="n">baselines</span> <span class="o">=</span> <span class="p">[(</span><span class="n">REPO</span><span class="p">,</span> <span class="mi">64</span><span class="p">)]</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="p">[(</span><span class="n">REPO</span><span class="p">,</span> <span class="mi">64</span><span class="p">),</span> <span class="p">(</span><span class="sh">"</span><span class="s">Qwen/Qwen3-4B</span><span class="sh">"</span><span class="p">,</span> <span class="mi">16</span><span class="p">)]</span>
<span class="k">for</span> <span class="n">repo</span><span class="p">,</span> <span class="n">batch</span> <span class="ow">in</span> <span class="n">baselines</span><span class="p">:</span>
    <span class="k">if</span> <span class="n">repo</span> <span class="o">!=</span> <span class="n">REPO</span><span class="p">:</span>
        <span class="k">del</span> <span class="n">model</span>
        <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">empty_cache</span><span class="p">()</span>
        <span class="n">model</span> <span class="o">=</span> <span class="nf">load_qwen3</span><span class="p">(</span><span class="n">repo</span><span class="p">,</span> <span class="n">HALF</span><span class="p">)</span>
    <span class="n">name</span> <span class="o">=</span> <span class="n">repo</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="sh">"</span><span class="s">/</span><span class="sh">"</span><span class="p">)[</span><span class="mi">1</span><span class="p">]</span>
    <span class="k">for</span> <span class="n">language</span><span class="p">,</span> <span class="n">rows</span> <span class="ow">in</span> <span class="p">[(</span><span class="sh">"</span><span class="s">English</span><span class="sh">"</span><span class="p">,</span> <span class="n">sample_en</span><span class="p">),</span> <span class="p">(</span><span class="sh">"</span><span class="s">Russian</span><span class="sh">"</span><span class="p">,</span> <span class="n">sample_ru</span><span class="p">)]:</span>
        <span class="n">written</span><span class="p">,</span> <span class="n">seconds</span> <span class="o">=</span> <span class="nf">run</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">rows</span><span class="p">,</span> <span class="n">system</span><span class="p">,</span> <span class="n">batch</span><span class="p">)</span>
        <span class="n">method</span> <span class="o">=</span> <span class="n">name</span><span class="p">.</span><span class="nf">removeprefix</span><span class="p">(</span><span class="sh">"</span><span class="s">Qwen3-</span><span class="sh">"</span><span class="p">)</span> <span class="o">+</span> <span class="sh">"</span><span class="s">, instructions</span><span class="sh">"</span>
        <span class="n">outputs</span><span class="p">[</span><span class="n">method</span><span class="p">,</span> <span class="n">language</span><span class="p">]</span> <span class="o">=</span> <span class="n">written</span>
        <span class="n">scores</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">method</span><span class="sh">"</span><span class="p">:</span> <span class="n">method</span><span class="p">,</span> <span class="sh">"</span><span class="s">language</span><span class="sh">"</span><span class="p">:</span> <span class="n">language</span><span class="p">,</span> <span class="sh">"</span><span class="s">commands</span><span class="sh">"</span><span class="p">:</span> <span class="nf">len</span><span class="p">(</span><span class="n">rows</span><span class="p">),</span>
                       <span class="o">**</span><span class="nf">score</span><span class="p">(</span><span class="n">rows</span><span class="p">,</span> <span class="n">written</span><span class="p">),</span> <span class="sh">"</span><span class="s">seconds</span><span class="sh">"</span><span class="p">:</span> <span class="n">seconds</span><span class="p">})</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">scores</span><span class="p">),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">3</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>582 tokens in the system prompt</code></pre> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">method</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">language</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">commands</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">valid JSON</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">intent</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">slot F1</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">exact</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">seconds</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.6B, instructions</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">English</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">500</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.990</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.460</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.170</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.048</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">56.494</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.6B, instructions</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Russian</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">500</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.924</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.346</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.030</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.010</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">73.703</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">4B, instructions</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">English</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">500</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.998</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.694</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.344</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.184</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">148.817</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">4B, instructions</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Russian</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">500</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.632</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.267</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.128</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">173.983</td></tr></tbody></table></div> <p>Instructions alone don’t make either model a voice assistant. Both write valid JSON nearly every time, so the format is not the problem; the content is. The 0.6B model picks the right intent for fewer than half of the commands and gets few slots right.</p> <p>The 4B model does much better on intents, yet fewer than one command in five comes out exactly right, it takes several times as long, and both models do worse in Russian.</p> <p><strong>LoRA.</strong> Fine-tuning all 596 million parameters would work, but AdamW keeps two numbers per parameter on top of the parameter and its gradient, and a model per task is a lot of models. In 2021 a Microsoft team hypothesised that the change fine-tuning makes to a weight matrix has a low “intrinsic rank”, and proposed to learn only that change, as a product of two thin matrices<sup class="cite">[<a href="#ref-12" id="cite-12" data-ref="12" aria-label="Reference 12: Hu, E. J., Shen, Y., Wallis, P., Allen-Zhu, Z., Li, Y., Wang, S., Wang, L., &amp; Chen, W. (2021). LoRA: low-rank adaptation of large language models. ICLR 2022.">12</a>]</sup>. A frozen weight \(W \in \mathbb{R}^{d_{out} \times d_{in}}\) becomes</p> \[W' = W + \frac{\alpha}{r} B A,\] \[A \in \mathbb{R}^{r \times d_{in}}, \qquad B \in \mathbb{R}^{d_{out} \times r},\] <p>with a rank \(r\) of 8 or 16 where \(d_{in}\) and \(d_{out}\) are in the thousands. \(B\) starts at zero, so the model starts exactly where it was; the factor \(\alpha / r\) saves retuning the learning rate when the rank changes.</p> <p>For GPT-3 the paper reported that LoRA “can reduce the number of trainable parameters by 10,000 times and the GPU memory requirement by 3 times”, and since \(BA\) can be added into \(W\) after training, the fine-tuned model runs exactly as fast as the original.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/06/lora-light.png" width="760" alt="LoRA. The input x goes through the frozen weight matrix W, d_out by d_in, and in parallel through two small trained matrices: A, which maps it down to r numbers, and B, which maps them back up to d_out. The two outputs are added, the low-rank path scaled by alpha over r. B starts at zero, so at the start the model is unchanged. After training, B times A is added into W and the extra path disappears" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/06/lora-dark.png" width="760" alt="LoRA. The input x goes through the frozen weight matrix W, d_out by d_in, and in parallel through two small trained matrices: A, which maps it down to r numbers, and B, which maps them back up to d_out. The two outputs are added, the low-rank path scaled by alpha over r. B starts at zero, so at the start the model is unchanged. After training, B times A is added into W and the extra path disappears" loading="lazy"></p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">LoRA</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">base</span><span class="p">,</span> <span class="n">rank</span><span class="o">=</span><span class="mi">16</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mi">32</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">base</span> <span class="o">=</span> <span class="n">base</span>  <span class="c1"># the frozen linear layer
</span>        <span class="n">where</span> <span class="o">=</span> <span class="n">base</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">device</span>
        <span class="n">self</span><span class="p">.</span><span class="n">A</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">empty</span><span class="p">(</span><span class="n">rank</span><span class="p">,</span> <span class="n">base</span><span class="p">.</span><span class="n">in_features</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">where</span><span class="p">))</span>
        <span class="n">nn</span><span class="p">.</span><span class="n">init</span><span class="p">.</span><span class="nf">kaiming_uniform_</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">A</span><span class="p">,</span> <span class="n">a</span><span class="o">=</span><span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="mi">5</span><span class="p">))</span>  <span class="c1"># as PEFT; the paper: Gaussian
</span>        <span class="n">self</span><span class="p">.</span><span class="n">B</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">base</span><span class="p">.</span><span class="n">out_features</span><span class="p">,</span> <span class="n">rank</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">where</span><span class="p">))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">scale</span> <span class="o">=</span> <span class="n">alpha</span> <span class="o">/</span> <span class="n">rank</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">low_rank</span> <span class="o">=</span> <span class="p">(</span><span class="n">x</span> <span class="o">@</span> <span class="n">self</span><span class="p">.</span><span class="n">A</span><span class="p">.</span><span class="n">T</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">dtype</span><span class="p">))</span> <span class="o">@</span> <span class="n">self</span><span class="p">.</span><span class="n">B</span><span class="p">.</span><span class="n">T</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">base</span><span class="p">(</span><span class="n">x</span><span class="p">)</span> <span class="o">+</span> <span class="n">low_rank</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">scale</span>


<span class="n">TARGETS</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">q_proj</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">k_proj</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">v_proj</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">o_proj</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">gate_proj</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">up_proj</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">down_proj</span><span class="sh">"</span><span class="p">]</span>


<span class="k">def</span> <span class="nf">add_lora</span><span class="p">(</span><span class="n">model</span><span class="p">):</span>
    <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="nf">parameters</span><span class="p">():</span>
        <span class="n">p</span><span class="p">.</span><span class="n">requires_grad</span> <span class="o">=</span> <span class="bp">False</span>
    <span class="k">for</span> <span class="n">block</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
        <span class="k">for</span> <span class="n">part</span> <span class="ow">in</span> <span class="p">[</span><span class="n">block</span><span class="p">.</span><span class="n">self_attn</span><span class="p">,</span> <span class="n">block</span><span class="p">.</span><span class="n">mlp</span><span class="p">]:</span>
            <span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">TARGETS</span><span class="p">:</span>
                <span class="k">if</span> <span class="nf">hasattr</span><span class="p">(</span><span class="n">part</span><span class="p">,</span> <span class="n">name</span><span class="p">):</span>
                    <span class="nf">setattr</span><span class="p">(</span><span class="n">part</span><span class="p">,</span> <span class="n">name</span><span class="p">,</span> <span class="nc">LoRA</span><span class="p">(</span><span class="nf">getattr</span><span class="p">(</span><span class="n">part</span><span class="p">,</span> <span class="n">name</span><span class="p">)))</span>
    <span class="k">return</span> <span class="p">[</span><span class="n">p</span> <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="nf">parameters</span><span class="p">()</span> <span class="k">if</span> <span class="n">p</span><span class="p">.</span><span class="n">requires_grad</span><span class="p">]</span>
</code></pre></div></div> <p>The training examples are chat turns with no system prompt at all: the command as the user’s message, the JSON as the assistant’s answer, followed by <code class="language-plaintext highlighter-rouge">&lt;|im_end|&gt;</code> so that the model learns to stop. The loss counts only the answer’s tokens.</p> <p>The frozen model stays in 16-bit floats; the LoRA matrices, their gradients and AdamW’s state are 32-bit, and a gradient scaler keeps the 16-bit backward pass from underflowing. We train for one pass over the 11,514 English training commands, 32 to a step.</p> <p>The 32 go through the model eight at a time and their gradients add up before the step: the step is the same, and long commands don’t run a T4 out of memory.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">examples_of</span><span class="p">(</span><span class="n">rows</span><span class="p">):</span>
    <span class="n">before</span><span class="p">,</span> <span class="n">after</span> <span class="o">=</span> <span class="nf">chat_parts</span><span class="p">(</span><span class="bp">None</span><span class="p">)</span>
    <span class="n">examples</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">rows</span><span class="p">:</span>
        <span class="n">prompt</span> <span class="o">=</span> <span class="nf">tok</span><span class="p">(</span><span class="n">before</span> <span class="o">+</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">utt</span><span class="sh">"</span><span class="p">]</span> <span class="o">+</span> <span class="n">after</span><span class="p">,</span> <span class="n">add_special_tokens</span><span class="o">=</span><span class="bp">False</span><span class="p">).</span><span class="n">input_ids</span>
        <span class="n">answer</span> <span class="o">=</span> <span class="nf">tok</span><span class="p">(</span><span class="nf">target</span><span class="p">(</span><span class="n">row</span><span class="p">),</span> <span class="n">add_special_tokens</span><span class="o">=</span><span class="bp">False</span><span class="p">).</span><span class="n">input_ids</span> <span class="o">+</span> <span class="p">[</span><span class="n">IM_END</span><span class="p">]</span>
        <span class="n">examples</span><span class="p">.</span><span class="nf">append</span><span class="p">((</span><span class="n">prompt</span><span class="p">,</span> <span class="n">answer</span><span class="p">))</span>
    <span class="k">return</span> <span class="n">examples</span>


<span class="k">def</span> <span class="nf">answer_loss</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">chunk</span><span class="p">):</span>
    <span class="sh">"""</span><span class="s">The loss summed over the answers</span><span class="sh">'</span><span class="s"> tokens of a few examples, padded to one width.</span><span class="sh">"""</span>
    <span class="n">n</span> <span class="o">=</span> <span class="nf">len</span><span class="p">(</span><span class="n">chunk</span><span class="p">)</span>
    <span class="n">width</span> <span class="o">=</span> <span class="nf">max</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">p</span><span class="p">)</span> <span class="o">+</span> <span class="nf">len</span><span class="p">(</span><span class="n">a</span><span class="p">)</span> <span class="k">for</span> <span class="n">p</span><span class="p">,</span> <span class="n">a</span> <span class="ow">in</span> <span class="n">chunk</span><span class="p">)</span>
    <span class="n">ids</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">full</span><span class="p">((</span><span class="n">n</span><span class="p">,</span> <span class="n">width</span><span class="p">),</span> <span class="n">IM_END</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
    <span class="n">labels</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">full</span><span class="p">((</span><span class="n">n</span><span class="p">,</span> <span class="n">width</span><span class="p">),</span> <span class="o">-</span><span class="mi">100</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
    <span class="n">real</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="n">width</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="p">(</span><span class="n">prompt</span><span class="p">,</span> <span class="n">answer</span><span class="p">)</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">chunk</span><span class="p">):</span>
        <span class="n">sequence</span> <span class="o">=</span> <span class="n">prompt</span> <span class="o">+</span> <span class="n">answer</span>
        <span class="n">ids</span><span class="p">[</span><span class="n">k</span><span class="p">,</span> <span class="p">:</span><span class="nf">len</span><span class="p">(</span><span class="n">sequence</span><span class="p">)]</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">sequence</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
        <span class="c1"># the logits at position p predict the token at p + 1
</span>        <span class="n">first</span><span class="p">,</span> <span class="n">last</span> <span class="o">=</span> <span class="nf">len</span><span class="p">(</span><span class="n">prompt</span><span class="p">)</span> <span class="o">-</span> <span class="mi">1</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">sequence</span><span class="p">)</span> <span class="o">-</span> <span class="mi">1</span>
        <span class="n">labels</span><span class="p">[</span><span class="n">k</span><span class="p">,</span> <span class="n">first</span><span class="p">:</span><span class="n">last</span><span class="p">]</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">answer</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
        <span class="n">real</span><span class="p">[</span><span class="n">k</span><span class="p">,</span> <span class="p">:</span><span class="nf">len</span><span class="p">(</span><span class="n">sequence</span><span class="p">)]</span> <span class="o">=</span> <span class="bp">True</span>
    <span class="n">positions</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">width</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)[</span><span class="bp">None</span><span class="p">].</span><span class="nf">expand</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">causal</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">width</span><span class="p">,</span> <span class="n">width</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">).</span><span class="nf">tril</span><span class="p">()</span>
    <span class="n">itself</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">eye</span><span class="p">(</span><span class="n">width</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
    <span class="n">mask</span> <span class="o">=</span> <span class="p">(</span><span class="n">causal</span> <span class="o">&amp;</span> <span class="n">real</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:])</span> <span class="o">|</span> <span class="n">itself</span>
    <span class="n">h</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="nf">hidden</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">positions</span><span class="p">,</span> <span class="n">mask</span><span class="p">)</span>
    <span class="n">scored</span> <span class="o">=</span> <span class="n">labels</span> <span class="o">!=</span> <span class="o">-</span><span class="mi">100</span>
    <span class="n">logits</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="nf">logits</span><span class="p">(</span><span class="n">h</span><span class="p">[</span><span class="n">scored</span><span class="p">]).</span><span class="nf">float</span><span class="p">()</span>
    <span class="k">return</span> <span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span><span class="n">logits</span><span class="p">,</span> <span class="n">labels</span><span class="p">[</span><span class="n">scored</span><span class="p">],</span> <span class="n">reduction</span><span class="o">=</span><span class="sh">"</span><span class="s">sum</span><span class="sh">"</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">train_lora</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">rows</span><span class="p">,</span> <span class="n">batch</span><span class="o">=</span><span class="mi">4</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">32</span><span class="p">,</span> <span class="n">micro</span><span class="o">=</span><span class="mi">2</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">8</span><span class="p">,</span>
               <span class="n">peak_lr</span><span class="o">=</span><span class="mf">2e-4</span><span class="p">,</span> <span class="n">warmup</span><span class="o">=</span><span class="mi">30</span><span class="p">):</span>
    <span class="n">params</span> <span class="o">=</span> <span class="nf">add_lora</span><span class="p">(</span><span class="n">model</span><span class="p">)</span>
    <span class="n">optimizer</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">optim</span><span class="p">.</span><span class="nc">AdamW</span><span class="p">(</span><span class="n">params</span><span class="p">,</span> <span class="n">lr</span><span class="o">=</span><span class="n">peak_lr</span><span class="p">,</span> <span class="n">weight_decay</span><span class="o">=</span><span class="mf">0.0</span><span class="p">)</span>
    <span class="n">scaler</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">amp</span><span class="p">.</span><span class="nc">GradScaler</span><span class="p">(</span><span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">examples</span> <span class="o">=</span> <span class="nf">examples_of</span><span class="p">(</span><span class="n">rows</span><span class="p">)</span>
    <span class="n">order</span> <span class="o">=</span> <span class="nf">list</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">examples</span><span class="p">)))</span>
    <span class="n">random</span><span class="p">.</span><span class="nc">Random</span><span class="p">(</span><span class="mi">1</span><span class="p">).</span><span class="nf">shuffle</span><span class="p">(</span><span class="n">order</span><span class="p">)</span>
    <span class="k">if</span> <span class="n">SMOKE</span><span class="p">:</span>
        <span class="n">order</span> <span class="o">=</span> <span class="n">order</span><span class="p">[:</span><span class="mi">4</span> <span class="o">*</span> <span class="n">batch</span><span class="p">]</span>
    <span class="n">history</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="n">model</span><span class="p">.</span><span class="nf">train</span><span class="p">()</span>
    <span class="k">for</span> <span class="n">step</span><span class="p">,</span> <span class="n">s</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">order</span><span class="p">),</span> <span class="n">batch</span><span class="p">)):</span>
        <span class="n">chunk</span> <span class="o">=</span> <span class="p">[</span><span class="n">examples</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="n">order</span><span class="p">[</span><span class="n">s</span><span class="p">:</span><span class="n">s</span> <span class="o">+</span> <span class="n">batch</span><span class="p">]]</span>
        <span class="n">tokens</span> <span class="o">=</span> <span class="nf">sum</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">answer</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span><span class="p">,</span> <span class="n">answer</span> <span class="ow">in</span> <span class="n">chunk</span><span class="p">)</span>
        <span class="k">for</span> <span class="n">group</span> <span class="ow">in</span> <span class="n">optimizer</span><span class="p">.</span><span class="n">param_groups</span><span class="p">:</span>
            <span class="n">group</span><span class="p">[</span><span class="sh">"</span><span class="s">lr</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">peak_lr</span> <span class="o">*</span> <span class="nf">min</span><span class="p">(</span><span class="mf">1.0</span><span class="p">,</span> <span class="p">(</span><span class="n">step</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">warmup</span><span class="p">)</span>
        <span class="n">optimizer</span><span class="p">.</span><span class="nf">zero_grad</span><span class="p">(</span><span class="n">set_to_none</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
        <span class="n">total</span> <span class="o">=</span> <span class="mf">0.0</span>
        <span class="k">for</span> <span class="n">m</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">chunk</span><span class="p">),</span> <span class="n">micro</span><span class="p">):</span>  <span class="c1"># the pieces' gradients add up
</span>            <span class="n">loss</span> <span class="o">=</span> <span class="nf">answer_loss</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">chunk</span><span class="p">[</span><span class="n">m</span><span class="p">:</span><span class="n">m</span> <span class="o">+</span> <span class="n">micro</span><span class="p">])</span> <span class="o">/</span> <span class="n">tokens</span>
            <span class="n">scaler</span><span class="p">.</span><span class="nf">scale</span><span class="p">(</span><span class="n">loss</span><span class="p">).</span><span class="nf">backward</span><span class="p">()</span>
            <span class="n">total</span> <span class="o">+=</span> <span class="n">loss</span><span class="p">.</span><span class="nf">item</span><span class="p">()</span>
        <span class="n">scaler</span><span class="p">.</span><span class="nf">unscale_</span><span class="p">(</span><span class="n">optimizer</span><span class="p">)</span>
        <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="n">utils</span><span class="p">.</span><span class="nf">clip_grad_norm_</span><span class="p">(</span><span class="n">params</span><span class="p">,</span> <span class="mf">1.0</span><span class="p">)</span>
        <span class="n">scaler</span><span class="p">.</span><span class="nf">step</span><span class="p">(</span><span class="n">optimizer</span><span class="p">)</span>
        <span class="n">scaler</span><span class="p">.</span><span class="nf">update</span><span class="p">()</span>
        <span class="n">history</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">total</span><span class="p">)</span>
    <span class="n">model</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>
    <span class="k">return</span> <span class="n">params</span><span class="p">,</span> <span class="n">history</span>
</code></pre></div></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">del</span> <span class="n">model</span>
<span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">empty_cache</span><span class="p">()</span>
<span class="n">model</span> <span class="o">=</span> <span class="nf">load_qwen3</span><span class="p">(</span><span class="n">REPO</span><span class="p">,</span> <span class="n">HALF</span><span class="p">)</span>
<span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
<span class="n">params</span><span class="p">,</span> <span class="n">history</span> <span class="o">=</span> <span class="nf">train_lora</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">train_en</span><span class="p">)</span>
<span class="n">trained</span> <span class="o">=</span> <span class="nf">sum</span><span class="p">(</span><span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span> <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">params</span><span class="p">)</span>
<span class="n">frozen</span> <span class="o">=</span> <span class="nf">sum</span><span class="p">(</span><span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span> <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="nf">parameters</span><span class="p">())</span> <span class="o">-</span> <span class="n">trained</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">history</span><span class="p">)</span><span class="si">}</span><span class="s"> steps in </span><span class="si">{</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> s</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">trained </span><span class="si">{</span><span class="n">trained</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> parameters, </span><span class="si">{</span><span class="n">trained</span> <span class="o">/</span> <span class="n">frozen</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="o">%</span><span class="si">}</span><span class="s"> of the frozen </span><span class="si">{</span><span class="n">frozen</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.4</span><span class="p">,</span> <span class="mf">3.0</span><span class="p">))</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">history</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">],</span> <span class="n">linewidth</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_yscale</span><span class="p">(</span><span class="sh">"</span><span class="s">log</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">step (32 commands each)</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">loss on the answer</span><span class="sh">'</span><span class="s">s tokens</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">LoRA on Qwen3-0.6B trained on English commands only</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <pre class="tfs-printed"><code>360 steps in 328 s
trained 10,092,544 parameters, 1.69% of the frozen 596,049,920</code></pre> <p><img class="tfs-output" src="/assets/posts/arch/06/output-06.png" alt="LoRA on Qwen3-0.6B trained on English commands only" loading="lazy"></p> <p>The adapter has never seen a Russian command, and it gets no instructions: just the command, as in training.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">evaluate</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">method</span><span class="p">):</span>
    <span class="k">for</span> <span class="n">language</span><span class="p">,</span> <span class="n">rows</span> <span class="ow">in</span> <span class="p">[(</span><span class="sh">"</span><span class="s">English</span><span class="sh">"</span><span class="p">,</span> <span class="n">test_en</span><span class="p">),</span> <span class="p">(</span><span class="sh">"</span><span class="s">Russian</span><span class="sh">"</span><span class="p">,</span> <span class="n">test_ru</span><span class="p">)]:</span>
        <span class="n">written</span><span class="p">,</span> <span class="n">seconds</span> <span class="o">=</span> <span class="nf">run</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">rows</span><span class="p">)</span>
        <span class="n">outputs</span><span class="p">[</span><span class="n">method</span><span class="p">,</span> <span class="n">language</span><span class="p">]</span> <span class="o">=</span> <span class="n">written</span>
        <span class="n">scores</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">method</span><span class="sh">"</span><span class="p">:</span> <span class="n">method</span><span class="p">,</span> <span class="sh">"</span><span class="s">language</span><span class="sh">"</span><span class="p">:</span> <span class="n">language</span><span class="p">,</span> <span class="sh">"</span><span class="s">commands</span><span class="sh">"</span><span class="p">:</span> <span class="nf">len</span><span class="p">(</span><span class="n">rows</span><span class="p">),</span>
                       <span class="o">**</span><span class="nf">score</span><span class="p">(</span><span class="n">rows</span><span class="p">,</span> <span class="n">written</span><span class="p">),</span> <span class="sh">"</span><span class="s">seconds</span><span class="sh">"</span><span class="p">:</span> <span class="n">seconds</span><span class="p">})</span>


<span class="nf">evaluate</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="sh">"</span><span class="s">0.6B + LoRA, en</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">scores</span><span class="p">),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">3</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">method</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">language</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">commands</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">valid JSON</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">intent</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">slot F1</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">exact</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">seconds</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.6B, instructions</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">English</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">500</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.990</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.460</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.170</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.048</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">56.494</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.6B, instructions</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Russian</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">500</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.924</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.346</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.030</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.010</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">73.703</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">4B, instructions</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">English</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">500</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.998</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.694</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.344</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.184</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">148.817</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">4B, instructions</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Russian</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">500</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.632</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.267</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.128</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">173.983</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.6B + LoRA, en</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">English</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,974</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.854</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.768</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.655</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">121.610</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.6B + LoRA, en</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Russian</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,974</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.999</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.764</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.430</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.396</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">155.080</td></tr></tbody></table></div> <p>One pass over the English commands, a few minutes on a T4 and ten million trained parameters change the picture. On the whole English test set the adapted 0.6B model gets about two commands in three exactly right, several times as many as the 4B model given instructions, and it answers faster.</p> <p>The more surprising row is Russian. The adapter never saw a Russian command, yet the model gets a good share of them exactly right: the skill it learned, find the intent and copy the words, carries over to a language Qwen3 learned in pretraining.</p> <p>For scale, the MASSIVE paper’s baselines, multilingual models of a few hundred million parameters fine-tuned in full, reach 69.7–72.5% exact match in English when trained on all 51 languages, and 42.6–52.8% in Russian when trained on English alone (its Table 7).</p> <p>After one pass, with a small fraction of its parameters trained, our model lands a few points below the first range and somewhat below the second.</p> <p>And the promise that LoRA costs nothing at inference, checked: add \(\frac{\alpha}{r}BA\) into every frozen matrix, drop the extra path, and the logits stay the same up to 16-bit rounding.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">merge</span><span class="p">(</span><span class="n">model</span><span class="p">):</span>
    <span class="k">for</span> <span class="n">block</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
        <span class="k">for</span> <span class="n">part</span> <span class="ow">in</span> <span class="p">[</span><span class="n">block</span><span class="p">.</span><span class="n">self_attn</span><span class="p">,</span> <span class="n">block</span><span class="p">.</span><span class="n">mlp</span><span class="p">]:</span>
            <span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">TARGETS</span><span class="p">:</span>
                <span class="n">layer</span> <span class="o">=</span> <span class="nf">getattr</span><span class="p">(</span><span class="n">part</span><span class="p">,</span> <span class="n">name</span><span class="p">,</span> <span class="bp">None</span><span class="p">)</span>
                <span class="k">if</span> <span class="nf">isinstance</span><span class="p">(</span><span class="n">layer</span><span class="p">,</span> <span class="n">LoRA</span><span class="p">):</span>
                    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
                        <span class="n">delta</span> <span class="o">=</span> <span class="p">(</span><span class="n">layer</span><span class="p">.</span><span class="n">B</span><span class="p">.</span><span class="nf">float</span><span class="p">()</span> <span class="o">@</span> <span class="n">layer</span><span class="p">.</span><span class="n">A</span><span class="p">.</span><span class="nf">float</span><span class="p">())</span> <span class="o">*</span> <span class="n">layer</span><span class="p">.</span><span class="n">scale</span>
                        <span class="n">layer</span><span class="p">.</span><span class="n">base</span><span class="p">.</span><span class="n">weight</span> <span class="o">+=</span> <span class="n">delta</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">layer</span><span class="p">.</span><span class="n">base</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span>
                    <span class="nf">setattr</span><span class="p">(</span><span class="n">part</span><span class="p">,</span> <span class="n">name</span><span class="p">,</span> <span class="n">layer</span><span class="p">.</span><span class="n">base</span><span class="p">)</span>


<span class="n">probe</span> <span class="o">=</span> <span class="nf">tok</span><span class="p">(</span><span class="nf">chat_parts</span><span class="p">(</span><span class="bp">None</span><span class="p">)[</span><span class="mi">0</span><span class="p">]</span> <span class="o">+</span> <span class="sh">"</span><span class="s">wake me up at five am this week</span><span class="sh">"</span> <span class="o">+</span> <span class="nf">chat_parts</span><span class="p">(</span><span class="bp">None</span><span class="p">)[</span><span class="mi">1</span><span class="p">],</span>
            <span class="n">add_special_tokens</span><span class="o">=</span><span class="bp">False</span><span class="p">).</span><span class="n">input_ids</span>
<span class="n">x</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">([</span><span class="n">probe</span><span class="p">],</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
<span class="n">t</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>
<span class="n">causal</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">t</span><span class="p">,</span> <span class="n">t</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">).</span><span class="nf">tril</span><span class="p">()</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">before_merge</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">t</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)[</span><span class="bp">None</span><span class="p">],</span> <span class="n">causal</span><span class="p">).</span><span class="nf">float</span><span class="p">()</span>
    <span class="nf">merge</span><span class="p">(</span><span class="n">model</span><span class="p">)</span>
    <span class="n">after_merge</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">t</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)[</span><span class="bp">None</span><span class="p">],</span> <span class="n">causal</span><span class="p">).</span><span class="nf">float</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">parameters now:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">sum</span><span class="p">(</span><span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span> <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="nf">parameters</span><span class="p">())</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">largest logit:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">before_merge</span><span class="p">.</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="n">difference</span> <span class="o">=</span> <span class="p">(</span><span class="n">before_merge</span> <span class="o">-</span> <span class="n">after_merge</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">max difference after merging:</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">difference</span><span class="si">:</span><span class="p">.</span><span class="mi">3</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>parameters now: 596,049,920
largest logit: 35.3
max difference after merging: 0.080</code></pre> <p>After the merge the model has exactly as many parameters as before training, and its logits move only by what rounding the merged weights to 16 bits does. The adapter is now part of the weights, and the model runs as fast as it did before training.</p> <p>Now the same recipe with the Russian training commands added, 23,028 commands in all, still one pass.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">del</span> <span class="n">model</span>
<span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">empty_cache</span><span class="p">()</span>
<span class="n">model</span> <span class="o">=</span> <span class="nf">load_qwen3</span><span class="p">(</span><span class="n">REPO</span><span class="p">,</span> <span class="n">HALF</span><span class="p">)</span>
<span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
<span class="n">params</span><span class="p">,</span> <span class="n">history_both</span> <span class="o">=</span> <span class="nf">train_lora</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">train_en</span> <span class="o">+</span> <span class="n">train_ru</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">history_both</span><span class="p">)</span><span class="si">}</span><span class="s"> steps in </span><span class="si">{</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> s</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">evaluate</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="sh">"</span><span class="s">0.6B + LoRA, en+ru</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">scores</span><span class="p">),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">3</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>720 steps in 664 s</code></pre> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">method</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">language</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">commands</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">valid JSON</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">intent</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">slot F1</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">exact</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">seconds</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.6B, instructions</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">English</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">500</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.990</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.460</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.170</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.048</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">56.494</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.6B, instructions</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Russian</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">500</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.924</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.346</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.030</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.010</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">73.703</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">4B, instructions</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">English</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">500</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.998</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.694</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.344</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.184</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">148.817</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">4B, instructions</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Russian</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">500</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.632</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.267</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.128</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">173.983</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.6B + LoRA, en</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">English</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,974</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.854</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.768</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.655</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">121.610</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.6B + LoRA, en</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Russian</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,974</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.999</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.764</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.430</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.396</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">155.080</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.6B + LoRA, en+ru</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">English</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,974</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.869</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.774</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.677</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">122.265</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.6B + LoRA, en+ru</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Russian</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,974</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.851</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.714</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.622</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">144.666</td></tr></tbody></table></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">methods</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">0.6B, instructions</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">4B, instructions</span><span class="sh">"</span><span class="p">,</span>
           <span class="sh">"</span><span class="s">0.6B + LoRA, en</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">0.6B + LoRA, en+ru</span><span class="sh">"</span><span class="p">]</span>
<span class="n">bar_colors</span> <span class="o">=</span> <span class="p">[</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">]]</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">10</span><span class="p">,</span> <span class="mf">3.4</span><span class="p">),</span> <span class="n">sharey</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="k">for</span> <span class="n">ax</span><span class="p">,</span> <span class="n">language</span><span class="p">,</span> <span class="n">rows</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">axes</span><span class="p">,</span> <span class="p">[</span><span class="sh">"</span><span class="s">English</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Russian</span><span class="sh">"</span><span class="p">],</span> <span class="p">[</span><span class="n">sample_en</span><span class="p">,</span> <span class="n">sample_ru</span><span class="p">]):</span>
    <span class="n">values</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">method</span> <span class="ow">in</span> <span class="n">methods</span><span class="p">:</span>
        <span class="n">written</span> <span class="o">=</span> <span class="n">outputs</span><span class="p">.</span><span class="nf">get</span><span class="p">((</span><span class="n">method</span><span class="p">,</span> <span class="n">language</span><span class="p">))</span>
        <span class="k">if</span> <span class="n">written</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span> <span class="ow">and</span> <span class="nf">len</span><span class="p">(</span><span class="n">written</span><span class="p">)</span> <span class="o">&gt;</span> <span class="nf">len</span><span class="p">(</span><span class="n">rows</span><span class="p">):</span>  <span class="c1"># scored on the whole test set
</span>            <span class="n">written</span> <span class="o">=</span> <span class="p">[</span><span class="n">written</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="n">sample</span><span class="p">]</span>
        <span class="n">values</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="nf">score</span><span class="p">(</span><span class="n">rows</span><span class="p">,</span> <span class="n">written</span><span class="p">)[</span><span class="sh">"</span><span class="s">exact</span><span class="sh">"</span><span class="p">]</span> <span class="k">if</span> <span class="n">written</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span> <span class="k">else</span> <span class="mi">0</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">barh</span><span class="p">(</span><span class="n">methods</span><span class="p">,</span> <span class="n">values</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">bar_colors</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">value</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">values</span><span class="p">):</span>
        <span class="n">ax</span><span class="p">.</span><span class="nf">text</span><span class="p">(</span><span class="n">value</span> <span class="o">+</span> <span class="mf">0.01</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">value</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span> <span class="n">va</span><span class="o">=</span><span class="sh">"</span><span class="s">center</span><span class="sh">"</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">],</span>
                <span class="n">fontsize</span><span class="o">=</span><span class="mi">9</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_xlim</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">Exactly right on the same </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">rows</span><span class="p">)</span><span class="si">}</span><span class="s"> </span><span class="si">{</span><span class="n">language</span><span class="si">}</span><span class="s"> commands</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">grid</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="sh">"</span><span class="s">x</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">grid</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="sh">"</span><span class="s">y</span><span class="sh">"</span><span class="p">,</span> <span class="n">visible</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">invert_yaxis</span><span class="p">()</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/06/output-07.png" alt="Output of the code above" loading="lazy"></p> <p>The Russian commands lift the Russian score most of the way to the English one, and English loses nothing; if anything it gains a little. That brings the 0.6B model close to the paper’s models trained on all 51 languages, which reach 66.2–69.2% exact match in Russian, after a few minutes of training on a free GPU.</p> <p>The mistakes that are left are worth reading, especially in Russian, where a slot’s value is a word in some case of a declension and has to be copied in exactly that case.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">mistakes</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">row</span><span class="p">,</span> <span class="n">written</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">test_ru</span><span class="p">,</span> <span class="n">outputs</span><span class="p">[</span><span class="sh">"</span><span class="s">0.6B + LoRA, en+ru</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Russian</span><span class="sh">"</span><span class="p">]):</span>
    <span class="k">if</span> <span class="nf">score</span><span class="p">([</span><span class="n">row</span><span class="p">],</span> <span class="p">[</span><span class="n">written</span><span class="p">])[</span><span class="sh">"</span><span class="s">exact</span><span class="sh">"</span><span class="p">]</span> <span class="o">&lt;</span> <span class="mi">1</span><span class="p">:</span>
        <span class="n">mistakes</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">command</span><span class="sh">"</span><span class="p">:</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">utt</span><span class="sh">"</span><span class="p">],</span> <span class="sh">"</span><span class="s">correct</span><span class="sh">"</span><span class="p">:</span> <span class="nf">target</span><span class="p">(</span><span class="n">row</span><span class="p">),</span> <span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">:</span> <span class="n">written</span><span class="p">})</span>
<span class="n">random</span><span class="p">.</span><span class="nc">Random</span><span class="p">(</span><span class="mi">3</span><span class="p">).</span><span class="nf">shuffle</span><span class="p">(</span><span class="n">mistakes</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">mistakes</span><span class="p">[:</span><span class="mi">8</span><span class="p">]))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">command</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">correct</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">model</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">у меня встреча в полдень сегодня</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "calendar_set", "slots": [["event_name", "встреча"], ["timeofday", "полдень"], ["date", "сегодня"]]}</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "calendar_query", "slots": [["event_name", "встреча"], ["timeofday", "полдень"], ["date", "сегодня"]]}</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">музыка король и шут</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "play_music", "slots": [["artist_name", "король и шут"]]}</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "play_music", "slots": [["song_name", "король и шут"]]}</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">закажи пиццу с колбасками в доминос пицце</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "takeaway_order", "slots": [["food_type", "пиццу"], ["ingredient", "колбасками"], ["business_name", "доминос пицце"]]}</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "takeaway_order", "slots": [["food_type", "пиццу с колбасками"], ["business_name", "доминос пицце"]]}</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">какие магазины рядом со мной</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "recommendation_locations", "slots": [["business_type", "магазины"]]}</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "recommendation_locations", "slots": []}</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">где алла пугачева покупает одежду своим детям</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "general_quirky", "slots": [["person", "алла пугачева"]]}</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "qa_factoid", "slots": [["person", "алла пугачева"]]}</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">сколько антон готов вложить в мою компанию на собрании которое состоится сегодня в пять двадцать вечера</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "calendar_query", "slots": [["person", "антон"], ["event_name", "собрании"], ["date", "сегодня"], ["time", "пять двадцать вечера"]]}</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "social_post", "slots": [["person", "антон"], ["event_name", "собрании"], ["time", "пять двадцать вечера"]]}</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">восход в москве по владивостокскому времени</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "datetime_convert", "slots": [["time", "восход"], ["place_name", "москве"], ["place_name", "владивостокскому"]]}</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "datetime_convert", "slots": [["place_name", "восход"], ["place_name", "москве"], ["place_name", "владивостокскому"]]}</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">хочу побольше узнать о ярмарке на этих выходных</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "general_quirky", "slots": [["date", "на этих выходных"]]}</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">{"intent": "recommendation_events", "slots": [["event_name", "ярмарке"], ["date", "на этих выходных"]]}</td></tr></tbody></table></div> <p>None of these mistakes is about grammar. The model copies every value in the form the command has it, <em>колбасками</em>, <em>москве</em>, <em>владивостокскому</em>. What it gets wrong is the annotation.</p> <p>Some are plain errors: Король и Шут is a band, not a song, and <em>магазины</em> should have been marked as a type of business. Some are boundaries: is the order <em>пиццу с колбасками</em>, or a pizza plus an ingredient?</p> <p>And some are judgement calls where the reference itself is debatable: does “у меня встреча в полдень сегодня” add a meeting or ask about one, and is a question about where Alla Pugacheva buys her children’s clothes a quirky remark or a factual question?</p> <p>Part of the distance between two thirds right and all right is disagreement of this kind, which no model will remove.</p> <h2 id="9-where-these-models-are-the-right-tool">9. Where these models are the right tool</h2> <p>Every model in this lesson is a decoder, and by now they differ less in what they are than in how they spend memory. That makes the config the first thing to read when you choose one.</p> <p>Two models with the same number of parameters can need very different amounts of memory per conversation: count the key-value heads, the head size and the local layers, as section 3 did, and you know how many users and how much context fit on your GPU before you download a single weight.</p> <p><a href="/blog/2026/transformer-architectures-08-kv/">Lesson 8</a> does that sum for a T4 and adds DeepSeek’s latent attention, which compresses the cache further still.</p> <p>For a narrow job with a fixed format, such as extraction, routing, classification with a reason, or turning text into a call to your own API, a small model with LoRA is the cheapest thing that works.</p> <p>Here it beat a model seven times its size that was given the task in words, and it learned the Russian version of the job from a few minutes of examples.</p> <p>The adapter is a few dozen megabytes, so one base model in memory can serve many jobs by swapping adapters, and after merging it runs as fast as the base model.</p> <p>For anything that needs knowledge or open reasoning, size matters more than any trick in this lesson. A 0.6B model knows what fits in 0.6 billion numbers, and thinking mode buys accuracy with tokens, which on a long problem means thousands of them.</p> <p>The tricks themselves are now the default, and you will rarely choose them: nearly every new model shares its keys and values among query heads, by grouped queries or, in DeepSeek’s models, by compressing them; QK-norm is common, and local layers are spreading.</p> <p>What this lesson left out is the next step in each direction. gpt-oss and the larger Qwen3 models are mixtures of experts, which spend only a fraction of their parameters on each token: lesson 7. Long context, and the RoPE bases of a hundred million in the table of section 1, are lesson 9.</p> <p>Qwen3’s passport, and the family tree with this lesson’s branch:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/06/passport-light.png" width="760" alt="Qwen3's passport. Published April 2025 by Alibaba's Qwen team, eight models under Apache 2.0. Type: decoder-only, six dense models and two mixtures of experts. Training: 36 trillion tokens in 119 languages, thinking and non-thinking modes in one model. Attention: grouped queries, 16 query heads and 8 key-value heads of 128 in the 0.6B model, with QK-norm. Positions: rotary with a base of one million, no sliding window. Normalisation: pre-norm RMSNorm, and RMSNorm on every query and key head. Activation: SwiGLU, 3,072 wide in the 0.6B model, no biases. Vocabulary: byte-level BPE with 151,936 rows; small models tie input and output embeddings. Sizes: 0.6B, 1.7B, 4B, 8B, 14B and 32B dense, 30B-A3B and 235B-A22B mixtures of experts. Good at: running locally, narrow jobs after LoRA, reasoning in thinking mode. Not for: facts it can't look up" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/06/passport-dark.png" width="760" alt="Qwen3's passport. Published April 2025 by Alibaba's Qwen team, eight models under Apache 2.0. Type: decoder-only, six dense models and two mixtures of experts. Training: 36 trillion tokens in 119 languages, thinking and non-thinking modes in one model. Attention: grouped queries, 16 query heads and 8 key-value heads of 128 in the 0.6B model, with QK-norm. Positions: rotary with a base of one million, no sliding window. Normalisation: pre-norm RMSNorm, and RMSNorm on every query and key head. Activation: SwiGLU, 3,072 wide in the 0.6B model, no biases. Vocabulary: byte-level BPE with 151,936 rows; small models tie input and output embeddings. Sizes: 0.6B, 1.7B, 4B, 8B, 14B and 32B dense, 30B-A3B and 235B-A22B mixtures of experts. Good at: running locally, narrow jobs after LoRA, reasoning in thinking mode. Not for: facts it can't look up" loading="lazy"></p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/06/family-light.png" width="760" alt="The family of the Transformer as this course covers it, with lesson 6, modern LLMs, highlighted and lessons 1 to 5 done" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/06/family-dark.png" width="760" alt="The family of the Transformer as this course covers it, with lesson 6, modern LLMs, highlighted and lessons 1 to 5 done" loading="lazy"></p> <h2 id="references">References</h2> <ol class="tfs-refs"> <li id="ref-1">Shazeer, N. (2019). <a href="https://arxiv.org/abs/1911.02150">Fast Transformer decoding: one write-head is all you need</a>. arXiv:1911.02150. <a class="ref-back" href="#cite-1" aria-label="Back to the text">↩</a></li> <li id="ref-2">Ainslie, J., Lee-Thorp, J., de Jong, M., Zemlyanskiy, Y., Lebrón, F., &amp; Sanghai, S. (2023). <a href="https://arxiv.org/abs/2305.13245">GQA: training generalized multi-query Transformer models from multi-head checkpoints</a>. <em>EMNLP 2023</em>. <a class="ref-back" href="#cite-2" aria-label="Back to the text">↩</a></li> <li id="ref-3">Dehghani, M., Djolonga, J., Mustafa, B., et al. (2023). <a href="https://arxiv.org/abs/2302.05442">Scaling vision Transformers to 22 billion parameters</a>. <em>ICML 2023</em>. <a class="ref-back" href="#cite-3" aria-label="Back to the text">↩</a></li> <li id="ref-4">Gemma Team (2024). <a href="https://arxiv.org/abs/2408.00118">Gemma 2: improving open language models at a practical size</a>. arXiv:2408.00118. <a class="ref-back" href="#cite-4" aria-label="Back to the text">↩</a></li> <li id="ref-5">Gemma Team (2025). <a href="https://arxiv.org/abs/2503.19786">Gemma 3 technical report</a>. arXiv:2503.19786. <a class="ref-back" href="#cite-5" aria-label="Back to the text">↩</a></li> <li id="ref-6">Wortsman, M., Liu, P. J., Xiao, L., et al. (2023). <a href="https://arxiv.org/abs/2309.14322">Small-scale proxies for large-scale Transformer training instabilities</a>. <em>ICLR 2024</em>. <a class="ref-back" href="#cite-6" aria-label="Back to the text">↩</a></li> <li id="ref-7">Qwen Team (2025). <a href="https://arxiv.org/abs/2505.09388">Qwen3 technical report</a>. arXiv:2505.09388. <a class="ref-back" href="#cite-7" aria-label="Back to the text">↩</a></li> <li id="ref-8">Jiang, A. Q., Sablayrolles, A., Mensch, A., et al. (2023). <a href="https://arxiv.org/abs/2310.06825">Mistral 7B</a>. arXiv:2310.06825. <a class="ref-back" href="#cite-8" aria-label="Back to the text">↩</a></li> <li id="ref-9">Xiao, G., Tian, Y., Chen, B., Han, S., &amp; Lewis, M. (2023). <a href="https://arxiv.org/abs/2309.17453">Efficient streaming language models with attention sinks</a>. <em>ICLR 2024</em>. <a class="ref-back" href="#cite-9" aria-label="Back to the text">↩</a></li> <li id="ref-10">OpenAI (2025). <a href="https://arxiv.org/abs/2508.10925">gpt-oss-120b &amp; gpt-oss-20b model card</a>. arXiv:2508.10925. <a class="ref-back" href="#cite-10" aria-label="Back to the text">↩</a></li> <li id="ref-11">FitzGerald, J., Hench, C., Peris, C., et al. (2022). <a href="https://arxiv.org/abs/2204.08582">MASSIVE: a 1M-example multilingual natural language understanding dataset with 51 typologically-diverse languages</a>. <em>ACL 2023</em>. Data: <a href="https://github.com/alexa/massive">github.com/alexa/massive</a>, CC BY 4.0. <a class="ref-back" href="#cite-11" aria-label="Back to the text">↩</a></li> <li id="ref-12">Hu, E. J., Shen, Y., Wallis, P., Allen-Zhu, Z., Li, Y., Wang, S., Wang, L., &amp; Chen, W. (2021). <a href="https://arxiv.org/abs/2106.09685">LoRA: low-rank adaptation of large language models</a>. <em>ICLR 2022</em>. <a class="ref-back" href="#cite-12" aria-label="Back to the text">↩</a></li> <li id="ref-13">OLMo Team (2024). <a href="https://arxiv.org/abs/2501.00656">2 OLMo 2 furious</a>. arXiv:2501.00656.</li> </ol>]]></content> <author> <name>Eva Koroleva</name> </author> <category term="machine-learning"/> <category term="transformer-architectures"/> <category term="qwen3"/> <category term="gqa"/> <category term="sliding-window-attention"/> <category term="qk-norm"/> <category term="lora"/> <category term="llm"/> <category term="nlp"/> <summary type="html"><![CDATA[What Mistral, Gemma and Qwen changed after Llama, read from a dozen configs. Grouped-query attention, sliding windows and attention sinks, QK-norm and soft-capping, Qwen3-0.6B written from scratch with its official weights, and LoRA that turns voice commands into JSON in English and Russian.]]></summary> <media:thumbnail url="https://blog.korolevalab.com/assets/posts/arch/06/cover.png"/> <media:content medium="image" url="https://blog.korolevalab.com/assets/posts/arch/06/cover.png"/> </entry> <entry> <title type="html">Theories of consciousness and the hard problem</title> <link href="https://blog.korolevalab.com/blog/2026/theories-of-consciousness/" rel="alternate" type="text/html" title="Theories of consciousness and the hard problem"/> <published>2026-07-10T00:00:00+00:00</published> <updated>2026-11-08T00:00:00+00:00</updated> <id>https://blog.korolevalab.com/blog/2026/theories-of-consciousness</id> <content type="html" xml:base="https://blog.korolevalab.com/blog/2026/theories-of-consciousness/"><![CDATA[<aside class="tldr"> <p class="tldr-label">In short</p> <p>“Consciousness is what the brain does” may well be true, and it still doesn’t explain why any of what the brain does is felt. Most philosophers lean physicalist, and most of them also think there is a hard problem.</p> <p>The thought experiments, from Mary’s room to fading qualia, are tools for finding out which kind of physicalist you are. The scientific theories disagree about where in the brain consciousness lives, and the first preregistered head-to-head test, published in 2025, found key predictions of both leading theories wrong.</p> <p>Meanwhile the question has become practical: in hospitals, where a quarter of patients who seem unresponsive turn out to follow instructions, and in AI.</p> <div class="stats"> <div class="stat"><span class="stat-value">62%</span><span class="stat-label">of philosophers say there is a hard problem of consciousness; 52% lean physicalist</span></div> <div class="stat"><span class="stat-value">60 of 241</span><span class="stat-label">patients with no response to commands performed mental tasks in a scanner</span></div> <div class="stat"><span class="stat-value">0 of 655</span><span class="stat-label">prefrontal electrodes showed the ignition one leading theory predicted</span></div> </div> </aside> <p>In 1998 the neuroscientist Christof Koch bet the philosopher David Chalmers that within twenty-five years science would find the mechanism by which the brain’s neurons produce consciousness. On 23 June 2023, at a conference in New York, they agreed publicly that it hadn’t, and declared Chalmers the winner<sup class="cite">[<a href="#ref-1" id="cite-1" data-ref="1" aria-label="Reference 1: Lenharo, 2023. doi.org.">1</a>]</sup>.</p> <p>The occasion was the first results of an experiment designed to make that kind of progress.</p> <p>The two most influential scientific theories of consciousness had agreed in advance on predictions where they disagreed, theory-neutral labs had recorded 256 people with fMRI, MEG and electrodes inside the skull, and both theories had come out with some of their own predictions failed<sup class="cite">[<a href="#ref-2" id="cite-2" data-ref="2" aria-label="Reference 2: Cogitate Consortium, 2025. doi.org.">2</a>]</sup>.</p> <p>If you work in machine learning or engineering, you probably think the question is settled in principle: consciousness is something the brain does, the details are for neuroscience, and philosophers who talk about a “hard problem” are making a mystery out of a gap in the data.</p> <p>This post is written for you. It is not an argument against physicalism. It is an argument that physicalism is a family of positions that disagree about the most interesting question, and that the thought experiments philosophers use are the fastest way to find out which member of the family you are.</p> <h2 id="what-is-the-hard-problem-of-consciousness">What is the hard problem of consciousness?</h2> <p>In 1974 Thomas Nagel gave the definition that most of the field still uses: “an organism has conscious mental states if and only if there is something that it is like to be that organism”<sup class="cite">[<a href="#ref-3" id="cite-3" data-ref="3" aria-label="Reference 3: Nagel, 1974. doi.org.">3</a>]</sup>. His example was a bat.</p> <p>Bats find their way by echolocation, and imagining hanging upside down in a cave and listening for echoes tells me what it would be like for <em>me</em> to behave like a bat, not what it is like for a bat to be a bat.</p> <p>Every subjective fact is tied to a point of view, Nagel argued, while physical science works by abandoning points of view.</p> <p>Nagel did not conclude that physicalism is false. He wrote: “It would be a mistake to conclude that physicalism must be false.” His point was that we don’t understand <em>how</em> it could be true, as a pre-Socratic philosopher who said that matter is energy would not have understood what he was saying.</p> <p>In 1995 David Chalmers sharpened this into a distinction that gave the field its vocabulary<sup class="cite">[<a href="#ref-4" id="cite-4" data-ref="4" aria-label="Reference 4: Chalmers, 1995. consc.net.">4</a>]</sup>. The <em>easy problems</em> of consciousness are to explain functions: how we discriminate stimuli and react to them, integrate information, report our mental states, focus attention, control behaviour deliberately, and differ awake from asleep.</p> <p>They are easy only in the sense that we know what an explanation would look like: a mechanism that performs the function. The <em>hard problem</em> is the question left after all of them are solved: “Why is the performance of these functions accompanied by experience?”</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/theories-of-consciousness/problems-light.png" width="760" alt="The easy problems of consciousness are to explain functions: discriminating and reacting to stimuli, integrating information, reporting mental states, focusing attention, deliberate control of behaviour, and the difference between waking and sleep. Each is explained by finding a mechanism that performs it. The hard problem is why the performance of these functions is accompanied by experience. Below, Levine's explanatory gap: heat equals molecular motion explains why heat melts ice, while pain equals C-fibre firing explains wincing but not why pain feels the way it does" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/theories-of-consciousness/problems-dark.png" width="760" alt="The easy problems of consciousness are to explain functions: discriminating and reacting to stimuli, integrating information, reporting mental states, focusing attention, deliberate control of behaviour, and the difference between waking and sleep. Each is explained by finding a mechanism that performs it. The hard problem is why the performance of these functions is accompanied by experience. Below, Levine's explanatory gap: heat equals molecular motion explains why heat melts ice, while pain equals C-fibre firing explains wincing but not why pain feels the way it does" loading="lazy"></p> <p>Twelve years earlier Joseph Levine had put the same worry as a gap in explanation rather than in reality<sup class="cite">[<a href="#ref-5" id="cite-5" data-ref="5" aria-label="Reference 5: Levine, 1983. informationphilosopher.com.">5</a>]</sup>. “Heat is the motion of molecules” explains: once you know how molecules move, you see why anything with that motion warms your hand and melts ice.</p> <p>“Pain is the firing of C-fibres” explains why pain makes you wince and withdraw, and leaves something out: “what is left unexplained by the discovery of C-fiber firing is why pain should feel the way it does!” Levine was explicit that this doesn’t show materialism false. It shows that the identity, even if true, doesn’t explain.</p> <p>One more distinction prevents a lot of confusion, especially in conversations about AI. Ned Block separated <em>access consciousness</em>, information that is available to reasoning and to the control of speech and action, from <em>phenomenal consciousness</em>: “Phenomenal consciousness is experience; the phenomenally conscious aspect of a state is what it is like to be in that state”<sup class="cite">[<a href="#ref-6" id="cite-6" data-ref="6" aria-label="Reference 6: Block, 1995. doi.org.">6</a>]</sup>.</p> <p>Access is a function and could be engineered. Phenomenal consciousness is what the hard problem is about. Much of the talk about whether a model “is conscious” slides from one to the other without noticing.</p> <h2 id="is-consciousness-just-what-the-brain-does">Is consciousness just what the brain does?</h2> <p>The slogan can be true and still not do the job you want from it. Here is why, in four steps.</p> <p>First, it states a thesis and doesn’t explain anything. When J. J. C. Smart defended the identity of sensations with brain processes in 1959, he offered it as a hypothesis supported by simplicity, not as an explanation of why brain processes feel like something<sup class="cite">[<a href="#ref-7" id="cite-7" data-ref="7" aria-label="Reference 7: Smart, 1959. doi.org.">7</a>]</sup>.</p> <p>Second, “what the brain does” is ambiguous between the two main kinds of physicalism. Is it the brain’s <em>function</em>, the pattern of causes and effects, which a silicon copy or a nation of people with radios could reproduce?</p> <p>Or is it the brain’s <em>biology</em>, which they couldn’t? The slogan can’t decide whether a machine could be conscious, and that is the question everyone actually asks.</p> <p>Third, physicalists disagree among themselves about what is left over once the functions are explained. Chalmers sorted them into types<sup class="cite">[<a href="#ref-8" id="cite-8" data-ref="8" aria-label="Reference 8: Chalmers, 2003. consc.net.">8</a>]</sup>. <em>Type-A</em> physicalists, like Daniel Dennett, say nothing is left: there is no hard problem beyond the easy ones.</p> <p><em>Type-B</em> physicalists say there is a real gap in our understanding but not in the world: experience is physical, and we just can’t see it a priori, as people couldn’t see a priori that water is H₂O. <em>Type-C</em> physicalists say the gap is real and science will close it.</p> <p>Fourth, the philosophers who have thought hardest about it don’t find it obvious. In the 2020 PhilPapers survey of 1,785 professional philosophers, 52% accepted or leaned towards physicalism about the mind and 32% towards non-physicalism; asked whether there is a hard problem of consciousness, 62% said yes and 30% no<sup class="cite">[<a href="#ref-9" id="cite-9" data-ref="9" aria-label="Reference 9: Bourget &amp; Chalmers, 2023. doi.org.">9</a>]</sup>. Many physicalists, in other words, think the hard problem is real.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/theories-of-consciousness/survey-light.png" width="760" alt="Four bar charts from the 2020 PhilPapers Survey. Mind: physicalism 52%, non-physicalism 32%. Is there a hard problem: yes 62%, no 30%. Zombies: conceivable but not metaphysically possible 37%, metaphysically possible 24%, inconceivable 16%. Consciousness: functionalism 33%, dualism 22%, identity theory 13%, panpsychism 8%, eliminativism 5%" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/theories-of-consciousness/survey-dark.png" width="760" alt="Four bar charts from the 2020 PhilPapers Survey. Mind: physicalism 52%, non-physicalism 32%. Is there a hard problem: yes 62%, no 30%. Zombies: conceivable but not metaphysically possible 37%, metaphysically possible 24%, inconceivable 16%. Consciousness: functionalism 33%, dualism 22%, identity theory 13%, panpsychism 8%, eliminativism 5%" loading="lazy"></p> <p class="takeaway">The honest starting point is Nagel’s: physicalism may be true, and we don’t yet understand how. The rest of the debate is about what kind of explanation would close that gap, or whether it needs closing.</p> <h2 id="thought-experiments-about-consciousness">Thought experiments about consciousness</h2> <p>Thought experiments in philosophy of mind work like unit tests: each isolates one assumption and shows what you are committed to if you accept it. You don’t have to accept the conclusion to learn something from where you resist.</p> <h3 id="marys-room">Mary’s room</h3> <p>Frank Jackson’s Mary is a brilliant scientist who has lived all her life in a black-and-white room, seeing the world through a black-and-white television<sup class="cite">[<a href="#ref-10" id="cite-10" data-ref="10" aria-label="Reference 10: Jackson, 1982. doi.org.">10</a>]</sup>. She knows everything physical there is to know about colour vision: the wavelengths, the retina, the neurons, how it all leads someone to say “the sky is blue”.</p> <p>In the 1986 version she knows <em>all</em> physical facts, completed physics and every functional role included<sup class="cite">[<a href="#ref-11" id="cite-11" data-ref="11" aria-label="Reference 11: Jackson, 1986. doi.org.">11</a>]</sup>. Then she walks out and sees a red tomato. Does she learn something?</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/theories-of-consciousness/mary-light.png" width="760" alt="Mary's room. Mary has lived all her life in a black-and-white room and knows every physical fact about colour vision. She walks out and sees a red tomato. Does she learn something? Jackson in 1982 said yes, a new fact, so physicalism is false. The physicalist replies: she gains new abilities to imagine and recognise red (Lewis, Nemirow); she gains acquaintance (Conee); she learns an old fact under a new concept (Loar, Papineau). Jackson himself gave up the argument by 1995" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/theories-of-consciousness/mary-dark.png" width="760" alt="Mary's room. Mary has lived all her life in a black-and-white room and knows every physical fact about colour vision. She walks out and sees a red tomato. Does she learn something? Jackson in 1982 said yes, a new fact, so physicalism is false. The physicalist replies: she gains new abilities to imagine and recognise red (Lewis, Nemirow); she gains acquaintance (Conee); she learns an old fact under a new concept (Loar, Papineau). Jackson himself gave up the argument by 1995" loading="lazy"></p> <p>“It seems just obvious that she will learn something about the world and our visual experience of it,” Jackson wrote. If she does, her complete physical knowledge was not complete knowledge, and physicalism is false.</p> <p>Physicalists have three main replies. She learns no new fact but gains new abilities, to imagine, remember and recognise red, as David Lewis and Laurence Nemirow argued. She becomes acquainted with something she knew about.</p> <p>Or, the most common reply today, she learns an old physical fact under a new concept, a phenomenal concept that she can only have by having the experience, as you can know that the morning star is the evening star without being able to recognise it at dawn<sup class="cite">[<a href="#ref-12" id="cite-12" data-ref="12" aria-label="Reference 12: Loar, 1990. doi.org.">12</a>]</sup>.</p> <p>And then there is the twist that most popular accounts leave out: Jackson himself gave up the argument.</p> <p>By 1995 he had concluded that if experiences were epiphenomenal, causing nothing, as his own version of the argument made them, nobody could know about them, so something had to be wrong with it; he later joined the physicalists<sup class="cite">[<a href="#ref-13" id="cite-13" data-ref="13" aria-label="Reference 13: Nida-Rümelin &amp; O Conaill, 2024. plato.stanford.edu.">13</a>]</sup>.</p> <h3 id="philosophical-zombies">Philosophical zombies</h3> <p>A philosophical zombie is not a robot that acts conscious. It is an exact physical duplicate of you, atom for atom, that behaves exactly as you do, says the same things, including “I’m conscious”, and has no experience at all: “There is nothing it is like to be a zombie”<sup class="cite">[<a href="#ref-14" id="cite-14" data-ref="14" aria-label="Reference 14: Chalmers, 1996. global.oup.com.">14</a>]</sup>.</p> <p>Nobody thinks zombies exist. The argument is about whether they are possible: if a zombie world is conceivable in a strict sense, then it is possible, and if it is possible, the physical facts don’t fix the facts about experience, and physicalism is false<sup class="cite">[<a href="#ref-15" id="cite-15" data-ref="15" aria-label="Reference 15: Kirk, 2023. plato.stanford.edu.">15</a>]</sup>.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/theories-of-consciousness/zombie-light.png" width="760" alt="The zombie argument. You and your zombie twin have the same atoms and the same behaviour, and both say they are conscious; you have experience and the twin has none. Premise one: such a twin is conceivable. Premise two: what is conceivable is possible. Conclusion: the physical facts do not fix experience, so physicalism is false. In 2020, 16% of philosophers said zombies are inconceivable, 37% conceivable but not possible, 24% possible" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/theories-of-consciousness/zombie-dark.png" width="760" alt="The zombie argument. You and your zombie twin have the same atoms and the same behaviour, and both say they are conscious; you have experience and the twin has none. Premise one: such a twin is conceivable. Premise two: what is conceivable is possible. Conclusion: the physical facts do not fix experience, so physicalism is false. In 2020, 16% of philosophers said zombies are inconceivable, 37% conceivable but not possible, 24% possible" loading="lazy"></p> <p>The argument has an ancestor in Saul Kripke’s lectures of 1970. To make heat, God need only make molecules move; there is nothing more to heat than that, and the sensation of warmth is a separate thing.</p> <p>To make pain, Kripke argued, God “must do something in addition to the mere creation of the C-fiber stimulation”: he must make it felt<sup class="cite">[<a href="#ref-16" id="cite-16" data-ref="16" aria-label="Reference 16: Kripke, 1980. hup.harvard.edu.">16</a>]</sup>.</p> <p>The survey shows where physicalists get off. In 2020, 16% of philosophers said zombies are inconceivable, the type-A answer; 37% said conceivable but not possible, the type-B answer; 24% said possible.</p> <p>The modal physicalist grants that you can imagine a zombie and denies that imagining it tells you anything about what is possible, as you can imagine water that isn’t H₂O.</p> <h3 id="the-inverted-spectrum">The inverted spectrum</h3> <p>John Locke asked whether a violet might produce in one person the idea that a marigold produces in another, with nobody ever able to tell, since both would call violets violet.</p> <p>If such an inversion were possible between two people who behave identically, behaviourism would be false; between two people with identical functional organisation, functionalism; only between two physical duplicates would it threaten physicalism<sup class="cite">[<a href="#ref-17" id="cite-17" data-ref="17" aria-label="Reference 17: Byrne, 2025. plato.stanford.edu.">17</a>]</sup>.</p> <p>Here empirical science pushes back on a thought experiment. Colour space isn’t symmetric: there are more distinguishable shades between red and blue than between green and yellow, dark yellow is brown while dark blue is still blue, and red looks warm.</p> <p>A naive red-green inversion would show up in behaviour. Defenders retreat to symmetric cases that are harder to picture.</p> <h3 id="the-china-brain">The China brain</h3> <p>In 1978 Ned Block imagined converting the government of China to functionalism and having it run a human mind for an hour<sup class="cite">[<a href="#ref-18" id="cite-18" data-ref="18" aria-label="Reference 18: Block, 1980. doi.org.">18</a>]</sup>.</p> <p>Each citizen gets a two-way radio and follows instructions that together implement the machine table describing your mind; letters displayed on satellites, visible across the country, keep track of which state the whole system is in.</p> <p>If functionalism is right, the system has your mental states, including the felt ones. Is anybody there, besides a billion people with radios? (Block chose China because it “has a billion inhabitants”, not, as is often said, because that matches the number of neurons; a brain has about 86 billion.)</p> <p>Most people’s intuition says no one is there. The functionalist replies that intuitions about huge, slow systems are unreliable, and that the mind would belong to the system, not to any citizen.</p> <h3 id="fading-and-dancing-qualia">Fading and dancing qualia</h3> <p>The thought experiment that should interest engineers most comes from a dualist. Chalmers asks you to replace your neurons, one at a time, with silicon chips that do exactly the same local job (<a href="https://consc.net/papers/qualia.html">Chalmers, 1995b</a>). Your behaviour never changes, because each chip does what the neuron did.</p> <p>Suppose the end result, a silicon copy of your brain, had no experience. Then somewhere in the middle there is a person with half-faded experience, who sees pale pink where you saw bright red, while saying exactly what you would say about the bright red.</p> <p>“The crucial point here is that Joe is systematically wrong about everything that he is experiencing.” Chalmers finds that implausible, and concludes that experience doesn’t fade: a fine-grained functional copy of a conscious brain is conscious, in silicon or anything else.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/theories-of-consciousness/fading-light.png" width="760" alt="Fading qualia. Your neurons are replaced one at a time by silicon chips that do the same local job: none, a quarter, half, three quarters, all. Behaviour and speech stay exactly the same at every step. If the all-silicon brain had no experience, a middle person would see pale pink while sincerely describing bright red, systematically wrong about their own experience. Chalmers concludes experience does not fade: a fine-grained functional copy is conscious" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/theories-of-consciousness/fading-dark.png" width="760" alt="Fading qualia. Your neurons are replaced one at a time by silicon chips that do the same local job: none, a quarter, half, three quarters, all. Behaviour and speech stay exactly the same at every step. If the all-silicon brain had no experience, a middle person would see pale pink while sincerely describing bright red, systematically wrong about their own experience. Chalmers concludes experience does not fade: a fine-grained functional copy is conscious" loading="lazy"></p> <p>The “dancing” version installs a silicon circuit that sees blue where you see red as a backup and flips a switch between it and your own neurons: “My experiences are switching from red to blue, but I do not notice any change.”</p> <p>That is the standard philosophical argument that consciousness doesn’t depend on carbon, and its author believes experience is not physical. Being a dualist about what experience is and a functionalist about which systems have it is a consistent position.</p> <h3 id="what-is-it-like-to-be-a-bat">What is it like to be a bat?</h3> <p>The bat belongs on this list because it tests something different: the limits of imagination rather than of physics. Learning everything about echolocation tells you what a bat does with sound. Whether that will ever tell you what it is like to be a bat is the question that keeps every other thought experiment alive.</p> <h2 id="philosophical-positions-on-consciousness">Philosophical positions on consciousness</h2> <p>The thought experiments sort people into positions, and the positions are easiest to remember as answers to three questions.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/theories-of-consciousness/positions-light.png" width="760" alt="A decision tree of positions on consciousness. First question: is there a hard problem beyond explaining the functions? No: type-A physicalism, illusionism and eliminativism (Dennett, Frankish). Yes: second question, is experience physical? Yes: type-B physicalism, an identity known only a posteriori (Loar, Papineau); biological naturalism (Searle); mysterianism, true but beyond us (McGinn). No: third question, then what is it? A separate thing that acts on the body: substance dualism (Descartes). Fundamental properties linked to the physical by laws: property dualism (Chalmers). Caused by the brain but causing nothing: epiphenomenalism. The inner nature of matter itself: Russellian monism and panpsychism (Russell, Strawson, Goff). Everything is mental: idealism (Kastrup). Functionalism, which systems are conscious, cuts across the tree" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/theories-of-consciousness/positions-dark.png" width="760" alt="A decision tree of positions on consciousness. First question: is there a hard problem beyond explaining the functions? No: type-A physicalism, illusionism and eliminativism (Dennett, Frankish). Yes: second question, is experience physical? Yes: type-B physicalism, an identity known only a posteriori (Loar, Papineau); biological naturalism (Searle); mysterianism, true but beyond us (McGinn). No: third question, then what is it? A separate thing that acts on the body: substance dualism (Descartes). Fundamental properties linked to the physical by laws: property dualism (Chalmers). Caused by the brain but causing nothing: epiphenomenalism. The inner nature of matter itself: Russellian monism and panpsychism (Russell, Strawson, Goff). Everything is mental: idealism (Kastrup). Functionalism, which systems are conscious, cuts across the tree" loading="lazy"></p> <h3 id="illusionism-and-eliminativism">Illusionism and eliminativism</h3> <p><em>Illusionism</em>, defended by Keith Frankish and in its classic form by Daniel Dennett, is the most radical physicalism and the most often misunderstood. “This is the view that phenomenal consciousness, as usually conceived, is illusory”<sup class="cite">[<a href="#ref-19" id="cite-19" data-ref="19" aria-label="Reference 19: Frankish, 2016. keithfrankish.com.">19</a>]</sup>.</p> <p>Illusionists don’t deny that you see, feel pain or have experiences in the everyday sense. They deny that experiences have the special properties philosophers attribute to them, intrinsic, private, ineffable qualities, and say that introspection misrepresents ordinary physical states as having them.</p> <p>The hard problem becomes the <em>illusion problem</em>: why do experiences seem to have phenomenal properties? Frankish is candid about the cost: if zombies lack only phenomenal consciousness in the philosophers’ technical sense, then “in this technical sense, we are zombies.”</p> <p>Dennett’s 1988 essay “Quining qualia” set out to destroy faith in the very concept with fifteen thought experiments, and concluded that “there simply are no qualia at all”<sup class="cite">[<a href="#ref-20" id="cite-20" data-ref="20" aria-label="Reference 20: Dennett, 1988. doi.org.">20</a>]</sup>. <em>Eliminativism</em> goes further and says that much of our everyday psychological vocabulary will be dropped by a mature science of the mind.</p> <p>The objection to all of this is short. Chalmers calls it Moorean: it is more certain that people sometimes feel pain than that any premise of the illusionist argument is true<sup class="cite">[<a href="#ref-21" id="cite-21" data-ref="21" aria-label="Reference 21: Chalmers, 2018. consc.net.">21</a>]</sup>.</p> <p>Galen Strawson called the denial of experience the strangest thing in the history of human thought. Illusionists reply that an illusion of experience needn’t itself be experienced, any more than a misprint in a map needs to be printed twice.</p> <h3 id="identity-theory-functionalism-and-the-phenomenal-concept-strategy">Identity theory, functionalism and the phenomenal concept strategy</h3> <p>The <em>identity theory</em> of the 1950s said that sensations are brain processes, as lightning is an electrical discharge. Its trouble was multiple realisability: octopuses, birds and people all seem to feel pain with very different nervous systems, so pain can’t be identical to one kind of neural process<sup class="cite">[<a href="#ref-22" id="cite-22" data-ref="22" aria-label="Reference 22: Putnam, 1967. plato.stanford.edu.">22</a>]</sup>.</p> <p><em>Functionalism</em> answered by identifying a mental state with its role in the system rather than with its stuff, which makes minds possible in any substrate, including silicon. It is the most popular single answer among philosophers, at 33% on the survey’s question about consciousness, ahead of dualism at 22% and identity theory at 13%.</p> <p>The most common way physicalists handle the hard problem today is the <em>phenomenal-concept strategy</em> of Brian Loar and David Papineau. The gap between experience and brain is real, but it is a gap between two kinds of concept, not two kinds of thing: one we get by having an experience, the other from theory.</p> <p>Two concepts can pick out one thing without our being able to see that they do, as “water” and “H₂O” did.</p> <p>Chalmers’s objection is a dilemma: whatever feature of phenomenal concepts is supposed to explain the gap must either itself be physically explicable, in which case it can’t explain why a zombie wouldn’t have it too, or not, in which case physicalism has given up<sup class="cite">[<a href="#ref-23" id="cite-23" data-ref="23" aria-label="Reference 23: Chalmers, 2007. consc.net.">23</a>]</sup>.</p> <h3 id="biological-naturalism-and-mysterianism">Biological naturalism and mysterianism</h3> <p>John Searle’s <em>biological naturalism</em> holds that consciousness is a real, subjective biological phenomenon, caused by the brain’s specific processes as liquidity is a feature of water, and that running the right program is not enough<sup class="cite">[<a href="#ref-24" id="cite-24" data-ref="24" aria-label="Reference 24: Searle, 1992. doi.org.">24</a>]</sup>.</p> <p>The objection is that it never says which causal powers of the brain matter, and if it’s their organisation, it is functionalism under another name. Anil Seth’s view that experience is rooted in our nature as living, self-regulating “beast machines” is close to it in spirit.</p> <p>Colin McGinn’s <em>mysterianism</em> is the modest version: some natural property of the brain explains consciousness, but our minds are “cognitively closed” to it, as a dog’s mind is to calculus. “How can technicolour phenomenology arise from soggy grey matter?”<sup class="cite">[<a href="#ref-25" id="cite-25" data-ref="25" aria-label="Reference 25: McGinn, 1989. doi.org.">25</a>]</sup>. It is hard to argue with and hard to make use of.</p> <h3 id="dualism">Dualism</h3> <p><em>Property dualism</em>, Chalmers’s own view, holds that experiences are fundamental features of the world, tied to physical organisation by laws of nature we haven’t yet found, much as electromagnetism had to be added to mechanics.</p> <p>Its main problem is causal: if physics is complete, non-physical experiences have nothing left to do, and then our talk about experience isn’t caused by experience.</p> <p><em>Epiphenomenalism</em> accepts that consequence: experience is caused by the brain and causes nothing, like the whistle of a steam train, in Thomas Huxley’s image. William James’s reply still stands: a property with no effects could not have been selected by evolution.</p> <p><em>Substance dualism</em>, Descartes’ view that the mind is a separate thing, has modern defenders but faces the old objection his correspondent Elisabeth of Bohemia raised in 1643: how could an unextended mind move an extended body? Today the objection is that every physical effect seems to have a sufficient physical cause, leaving nothing for a mind to do.</p> <h3 id="panpsychism-russellian-monism-and-idealism">Panpsychism, Russellian monism and idealism</h3> <p>The most surprising turn in recent philosophy of mind has been the return of <em>panpsychism</em>, the view that some fundamental physical entities have, in Chalmers’s words, mental states<sup class="cite">[<a href="#ref-26" id="cite-26" data-ref="26" aria-label="Reference 26: Chalmers, 2015. consc.net.">26</a>]</sup>.</p> <p>Its best argument comes from Bertrand Russell and Arthur Eddington: physics describes what mass and charge <em>do</em>, their structure and dynamics, and is silent about what they intrinsically <em>are</em>. Experience is the one intrinsic nature we know from the inside, so perhaps that is what the structure is the structure of.</p> <p>This is <em>Russellian monism</em>; Galen Strawson put the argument bluntly: “Real physicalists must accept that at least some ultimates are intrinsically experience-involving”<sup class="cite">[<a href="#ref-27" id="cite-27" data-ref="27" aria-label="Reference 27: Strawson, 2008. doi.org.">27</a>]</sup>. Panpsychism does not say that rocks have feelings; a rock, like a crowd, need not be a subject.</p> <p>Its own defenders name its hardest problem: <em>combination</em>. How do many tiny subjects add up to one big subject, mine? The existence of a hundred subjects doesn’t seem to require a hundred-and-first<sup class="cite">[<a href="#ref-28" id="cite-28" data-ref="28" aria-label="Reference 28: Chalmers, 2017. doi.org.">28</a>]</sup>.</p> <p>William James had put it in 1890: a hundred feelings packed together each remain “shut in its own skin, windowless, ignorant of what the other feelings are and mean”. On the survey, panpsychism was the answer of 8% of philosophers.</p> <p><em>Idealism</em>, the view that reality is fundamentally mental, survives in Bernardo Kastrup’s “analytic idealism”, where individual minds are dissociated parts of one universal consciousness. It reverses the combination problem: how does one mind split into many?</p> <h2 id="scientific-theories-of-consciousness">Scientific theories of consciousness</h2> <p>Philosophers ask what consciousness is. Neuroscientists ask which brain activity distinguishes seeing something from not seeing it, while the stimulus stays the same: a word flashed so briefly that sometimes you see it and sometimes you don’t, two images competing for one eye.</p> <p>The answers have grown into theories, more than two hundred by one count<sup class="cite">[<a href="#ref-29" id="cite-29" data-ref="29" aria-label="Reference 29: Kuhn, 2024. doi.org.">29</a>]</sup>. Six of them matter most.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/theories-of-consciousness/theories-light.png" width="760" alt="Four views of the left hemisphere. Global workspace theory: prefrontal and parietal hubs. Integrated information theory: the posterior hot zone of occipital, temporal and parietal cortex. Higher-order theory: dorsolateral prefrontal cortex. Recurrent processing theory: visual cortex by itself" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/theories-of-consciousness/theories-dark.png" width="760" alt="Four views of the left hemisphere. Global workspace theory: prefrontal and parietal hubs. Integrated information theory: the posterior hot zone of occipital, temporal and parietal cortex. Higher-order theory: dorsolateral prefrontal cortex. Recurrent processing theory: visual cortex by itself" loading="lazy"></p> <p><em>Global neuronal workspace theory</em> (Bernard Baars, Stanislas Dehaene, Jean-Pierre Changeux) says the brain runs many specialised processors unconsciously, and information becomes conscious when it wins entry to a limited-capacity workspace and is broadcast to all of them at once, available for report, memory and planning (<a href="https://doi.org/10.1016/S0010-0277(00)00123-2">Dehaene &amp; Naccache, 2001</a>).</p> <p>Entry is a sudden, all-or-none <em>ignition</em> in a network of prefrontal and parietal cortex, about 300 milliseconds after a stimulus. Engineers will recognise the design: Baars took it from the “blackboard” architectures of early AI.</p> <p><em>Integrated information theory</em> (Giulio Tononi, Christof Koch) starts from the other end, from properties it says every experience has, and asks what a physical system must be like to have them.</p> <p>Its answer: consciousness <em>is</em> a system’s maximally irreducible cause–effect structure, its quantity is integrated information, Φ, and its seat in the brain is a “posterior hot zone” of sensory cortex<sup class="cite">[<a href="#ref-30" id="cite-30" data-ref="30" aria-label="Reference 30: Albantakis et al., 2023. doi.org.">30</a>]</sup>.</p> <p>It has striking consequences: a feed-forward network has Φ = 0 however intelligent it is, and a simple grid of logic gates can have more Φ than a brain, a consequence Tononi accepted when the computer scientist Scott Aaronson pointed it out<sup class="cite">[<a href="#ref-31" id="cite-31" data-ref="31" aria-label="Reference 31: Aaronson, 2014. scottaaronson.blog.">31</a>]</sup>. It also concedes that Φ can’t be computed for any realistic system.</p> <p><em>Higher-order theories</em> (David Rosenthal, Hakwan Lau, Joseph LeDoux) say a state is conscious when you are, in a suitable way, aware of being in it, through a representation of the state itself<sup class="cite">[<a href="#ref-32" id="cite-32" data-ref="32" aria-label="Reference 32: Brown et al., 2019. doi.org.">32</a>]</sup>.</p> <p><em>Recurrent processing theory</em> (Victor Lamme) says visual experience begins when higher visual areas feed signals back to lower ones, no frontal cortex needed: the first fast sweep up the visual hierarchy is unconscious (<a href="https://doi.org/10.1016/S0166-2236(00)01657-X">Lamme &amp; Roelfsema, 2000</a>).</p> <p><em><a href="/blog/2026/free-energy-principle/">Predictive processing</a></em>, in Anil Seth’s version, says perception is the brain’s best guess about the causes of its signals, a “controlled hallucination”, and that the deepest guesses are about the state of the body itself<sup class="cite">[<a href="#ref-33" id="cite-33" data-ref="33" aria-label="Reference 33: Seth &amp; Tsakiris, 2018. doi.org.">33</a>]</sup>.</p> <p>And Michael Graziano’s <em>attention schema theory</em> says the brain builds a simplified model of its own attention, and “the content of this internal model leads a brain to conclude that it has a subjective experience”<sup class="cite">[<a href="#ref-34" id="cite-34" data-ref="34" aria-label="Reference 34: Graziano &amp; Webb, 2015. doi.org.">34</a>]</sup>, which makes it a scientific cousin of illusionism.</p> <h2 id="testing-global-workspace-theory-against-integrated-information-theory">Testing global workspace theory against integrated information theory</h2> <p>The usual way theories of consciousness are tested makes it easy for each to declare victory, since each team runs the experiments its theory suggests.</p> <p>In 2018 the Templeton World Charity Foundation brought proponents of the two leading theories, Tononi and Koch for integrated information and Dehaene for the global workspace, together to do something different: agree in advance on three predictions where the theories conflict and on what result would count against each, and let theory-neutral labs collect the data<sup class="cite">[<a href="#ref-35" id="cite-35" data-ref="35" aria-label="Reference 35: Melloni et al., 2023. doi.org.">35</a>]</sup>.</p> <p>Participants looked at clearly visible faces, objects, letters and false fonts for half a second to a second and a half while 256 of them were recorded by fMRI, MEG or electrodes in the brains of epilepsy patients<sup class="cite">[<a href="#ref-2" id="cite-36" data-ref="2" aria-label="Reference 2: Cogitate Consortium, 2025. doi.org.">2</a>]</sup>.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/theories-of-consciousness/cogitate-light.png" width="760" alt="The adversarial test of integrated information theory and global neuronal workspace theory. First prediction, where conscious content lives: IIT predicted posterior cortex is enough, GNWT that prefrontal cortex is needed; content was decodable at the back and adding prefrontal cortex added nothing, a pass for IIT and mixed for GNWT. Second, how it lasts: IIT predicted sustained posterior activity, GNWT ignition at onset and offset; duration was tracked, sparsely, a pass for IIT, while none of 655 prefrontal electrodes showed offset ignition, a failure for GNWT. Third, connectivity: IIT predicted sustained posterior synchrony, which was absent, a failure; GNWT brief long-range synchrony, not supported by the preregistered metric but consistent in an exploratory analysis, mixed" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/theories-of-consciousness/cogitate-dark.png" width="760" alt="The adversarial test of integrated information theory and global neuronal workspace theory. First prediction, where conscious content lives: IIT predicted posterior cortex is enough, GNWT that prefrontal cortex is needed; content was decodable at the back and adding prefrontal cortex added nothing, a pass for IIT and mixed for GNWT. Second, how it lasts: IIT predicted sustained posterior activity, GNWT ignition at onset and offset; duration was tracked, sparsely, a pass for IIT, while none of 655 prefrontal electrodes showed offset ignition, a failure for GNWT. Third, connectivity: IIT predicted sustained posterior synchrony, which was absent, a failure; GNWT brief long-range synchrony, not supported by the preregistered metric but consistent in an exploratory analysis, mixed" loading="lazy"></p> <p>Both theories passed something and failed something. For integrated information, the content of experience could be decoded from posterior cortex, and adding prefrontal cortex didn’t help, as predicted; but the sustained synchronisation within posterior cortex that the theory predicted was absent.</p> <p>For the global workspace, the category of the object was decodable in prefrontal cortex, but the theory predicted a second ignition when the stimulus disappeared, and “none of the 655 electrodes measured the temporal profile predicted by GNWT”, while the identity and orientation of faces, both clearly seen, were barely represented in prefrontal cortex at all.</p> <p>The consortium’s summary: the results “align with some predictions of IIT and GNWT, while substantially challenging key tenets of both theories.”</p> <p>Two lessons came out of it, and neither is the one the headlines wanted. First, the experiment tested where and when each theory expects activity in the brain, not its core definition of consciousness; as the authors wrote, theorists “could respond to challenging data by modifying the proposed biological implementation while retaining the mathematical or computational core”.</p> <p>Second, the early press coverage, which presented the results as a win for integrated information, provoked 124 researchers to sign a letter calling the theory pseudoscience, and a public dispute that ended up in <em>Nature Neuroscience</em><sup class="cite">[<a href="#ref-36" id="cite-37" data-ref="36" aria-label="Reference 36: IIT-Concerned et al., 2025. doi.org.">36</a>, <a href="#ref-37" id="cite-38" data-ref="37" aria-label="Reference 37: Tononi et al., 2025. doi.org.">37</a>]</sup>.</p> <p>A quieter result may matter more. A brain wave called the P3b, appearing about 300 ms after a stimulus, was long treated as a signature of consciousness.</p> <p>When people saw stimuli but didn’t have to report them, it vanished: “we found a robust P3b in the report condition, but no P3b whatsoever in the no-report condition”<sup class="cite">[<a href="#ref-38" id="cite-39" data-ref="38" aria-label="Reference 38: Cohen et al., 2020. doi.org.">38</a>]</sup>. Much of what looked like the brain becoming conscious of something may have been the brain preparing to say so.</p> <h2 id="covert-consciousness-in-unresponsive-patients">Covert consciousness in unresponsive patients</h2> <p>The question stops being academic in an intensive care unit. In 2006 Adrian Owen and colleagues put a young woman who met the clinical criteria for a vegetative state into a scanner and asked her to imagine playing tennis, then to imagine walking through her home.</p> <p>Her brain lit up in the motor and spatial areas that light up in healthy volunteers, “in a manner indistinguishable from that of healthy volunteers”<sup class="cite">[<a href="#ref-39" id="cite-40" data-ref="39" aria-label="Reference 39: Owen et al., 2006. doi.org.">39</a>]</sup>.</p> <p>In 2024 a study at six centres tested 353 adults with disorders of consciousness. Of the 241 who showed no observable response to commands, 60, a quarter, performed the imagery tasks in fMRI or EEG<sup class="cite">[<a href="#ref-40" id="cite-41" data-ref="40" aria-label="Reference 40: Bodien et al., 2024. doi.org.">40</a>]</sup>.</p> <p>The group included patients in coma and in a minimally conscious state, not only vegetative ones, and the tests missed many patients who could respond. But a quarter is a lot of people misjudged.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/theories-of-consciousness/patients-light.png" width="760" alt="Two grids of squares. Of 241 patients with no response to commands at the bedside, 60 performed the mental imagery tasks on fMRI or EEG. Of 112 patients who did follow commands at the bedside, only 43 showed it on the scanner tests" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/theories-of-consciousness/patients-dark.png" width="760" alt="Two grids of squares. Of 241 patients with no response to commands at the bedside, 60 performed the mental imagery tasks on fMRI or EEG. Of 112 patients who did follow commands at the bedside, only 43 showed it on the scanner tests" loading="lazy"></p> <p>A test inspired by integrated information theory, the <em>perturbational complexity index</em>, takes a different route. It knocks on the cortex with a magnetic pulse and measures how complex the echo is in the EEG: a conscious brain responds with activity that is both widespread and varied, an unconscious one with a simple, local or uniform response<sup class="cite">[<a href="#ref-41" id="cite-42" data-ref="41" aria-label="Reference 41: Casali et al., 2013. doi.org.">41</a>]</sup>.</p> <p>In a benchmark of 150 subjects, awake, dreaming, deeply asleep and under different anaesthetics, a single threshold of 0.31 separated conscious from unconscious states without a single error, and it caught 36 of 38 minimally conscious patients<sup class="cite">[<a href="#ref-42" id="cite-43" data-ref="42" aria-label="Reference 42: Casarotto et al., 2016. doi.org.">42</a>]</sup>.</p> <p>Nine of 43 patients diagnosed as vegetative had high complexity, a hint that some of them might be conscious and unable to show it. The index measures a capacity, calibrated against what people later report, and its success doesn’t make integrated information theory true.</p> <h2 id="can-ai-be-conscious">Can AI be conscious?</h2> <p>Every theory above gives a different answer for a language model, which is why the question can’t be settled by asking the model.</p> <p>Butlin, Long and seventeen colleagues took the theories that are compatible with <em>computational functionalism</em>, the assumption that the right computation is enough, and turned each into “indicator properties”: recurrent processing, a global workspace, higher-order monitoring, an attention schema, predictive processing, agency and embodiment.</p> <p>They checked current systems against the list and concluded: “Our analysis suggests that no current AI systems are conscious,” adding that “there are no obvious technical barriers to building AI systems which satisfy these indicators”<sup class="cite">[<a href="#ref-43" id="cite-44" data-ref="43" aria-label="Reference 43: Butlin et al., 2023. arxiv.org.">43</a>]</sup>.</p> <p>Chalmers put numbers on his uncertainty, explicitly as illustrations: under 10% for current language models, and 25% or more that within a decade there will be extended systems, with senses, memory, a workspace and agency, that are conscious<sup class="cite">[<a href="#ref-44" id="cite-45" data-ref="44" aria-label="Reference 44: Chalmers, 2023. arxiv.org.">44</a>]</sup>.</p> <p>Integrated information theory gives the opposite answer for a different reason: a conventional computer would “experience next to nothing” whatever it computes, because what matters is the causal structure of the hardware, not the software<sup class="cite">[<a href="#ref-45" id="cite-46" data-ref="45" aria-label="Reference 45: Tononi &amp; Koch, 2015. doi.org.">45</a>]</sup>.</p> <p>Seth argues that consciousness may depend on being alive, so “real artificial consciousness is unlikely along current trajectories”<sup class="cite">[<a href="#ref-46" id="cite-47" data-ref="46" aria-label="Reference 46: Seth, 2025. doi.org.">46</a>]</sup>; in October 2026 he, Block and Tononi wrote together that they “feel that consciousness in AI is extraordinarily unlikely” in today’s digital systems<sup class="cite">[<a href="#ref-47" id="cite-48" data-ref="47" aria-label="Reference 47: Seth et al., 2026. doi.org.">47</a>]</sup>.</p> <p>Meanwhile the functional side keeps moving. In July 2026 interpretability researchers at Anthropic reported that language models “maintain a small, privileged set of representations bearing some of the functional hallmarks of conscious access”, something like a global workspace<sup class="cite">[<a href="#ref-48" id="cite-49" data-ref="48" aria-label="Reference 48: Gurnee et al., 2026. arxiv.org.">48</a>]</sup>.</p> <p>That is a claim about access, Block’s first kind of consciousness, not about experience, and it is exactly the kind of finding that each position will read differently: as a step toward machine consciousness, as irrelevant to it, or as a model of how a system comes to believe it is conscious.</p> <p>The last reading is the one Chalmers himself recommends as common ground. The <em>meta-problem</em> of consciousness is “the problem of explaining why we think that there is a problem of consciousness”<sup class="cite">[<a href="#ref-21" id="cite-50" data-ref="21" aria-label="Reference 21: Chalmers, 2018. consc.net.">21</a>]</sup>.</p> <p>It is an easy problem, a question about behaviour and mechanisms, and it can now be studied in machines: why do systems trained on human text say they have an inner life, and what in them produces the saying?</p> <p>Chalmers wrote that if he were a materialist, he would be an illusionist. An illusionist would say that answering the meta-problem is all there ever was to answer.</p> <h2 id="what-a-physicalist-can-conclude">What a physicalist can conclude</h2> <p>Five conclusions seem fair.</p> <p>The hard problem is not a gap in the data. It is the observation that explaining every function of the brain, which is the job of neuroscience, leaves open why the functions are felt.</p> <p>You can deny that this is a further question, as type-A physicalists do, but then denying it is your theory of consciousness, and you should be ready to defend it.</p> <p>“Physicalism” is a decision, not a theory. Within it you still have to choose whether consciousness is its function or its biology, whether the hard problem is real and how to deal with it, and the choice decides what you think about machines.</p> <p>The thought experiments are tools for finding your position, not proofs. Mary’s room converted its own author. The fading-qualia argument for silicon consciousness came from a dualist.</p> <p>The science is progressing, mostly by eliminating things. Report is not experience, prefrontal cortex is not obviously where content lives, and no current theory survived its first preregistered test intact.</p> <p>The practical questions, which patients are conscious and whether a machine ever could be, won’t wait for the philosophical one to be settled. The best we can do is to be clear about which theory each answer assumes.</p> <p>The figures as code: <a href="https://github.com/xmarva/transformers-from-scratch/tree/main/articles/consciousness">articles/consciousness</a>.</p> <h2 id="references">References</h2> <ol class="tfs-refs"> <li id="ref-1">Lenharo, 2023. <a href="https://doi.org/10.1038/d41586-023-02120-8">doi.org</a>. <a class="ref-back" href="#cite-1" aria-label="Back to the text">↩</a></li> <li id="ref-2">Cogitate Consortium, 2025. <a href="https://doi.org/10.1038/s41586-025-08888-1">doi.org</a>. <a class="ref-back" href="#cite-2" aria-label="Back to the text">↩</a></li> <li id="ref-3">Nagel, 1974. <a href="https://doi.org/10.2307/2183914">doi.org</a>. <a class="ref-back" href="#cite-3" aria-label="Back to the text">↩</a></li> <li id="ref-4">Chalmers, 1995. <a href="https://consc.net/papers/facing.html">consc.net</a>. <a class="ref-back" href="#cite-4" aria-label="Back to the text">↩</a></li> <li id="ref-5">Levine, 1983. <a href="https://informationphilosopher.com/solutions/philosophers/levine/Explanatory_Gap.pdf">informationphilosopher.com</a>. <a class="ref-back" href="#cite-5" aria-label="Back to the text">↩</a></li> <li id="ref-6">Block, 1995. <a href="https://doi.org/10.1017/S0140525X00038188">doi.org</a>. <a class="ref-back" href="#cite-6" aria-label="Back to the text">↩</a></li> <li id="ref-7">Smart, 1959. <a href="https://doi.org/10.2307/2182164">doi.org</a>. <a class="ref-back" href="#cite-7" aria-label="Back to the text">↩</a></li> <li id="ref-8">Chalmers, 2003. <a href="https://consc.net/papers/nature.pdf">consc.net</a>. <a class="ref-back" href="#cite-8" aria-label="Back to the text">↩</a></li> <li id="ref-9">Bourget &amp; Chalmers, 2023. <a href="https://doi.org/10.3998/phimp.2109">doi.org</a>. <a class="ref-back" href="#cite-9" aria-label="Back to the text">↩</a></li> <li id="ref-10">Jackson, 1982. <a href="https://doi.org/10.2307/2960077">doi.org</a>. <a class="ref-back" href="#cite-10" aria-label="Back to the text">↩</a></li> <li id="ref-11">Jackson, 1986. <a href="https://doi.org/10.2307/2026143">doi.org</a>. <a class="ref-back" href="#cite-11" aria-label="Back to the text">↩</a></li> <li id="ref-12">Loar, 1990. <a href="https://doi.org/10.2307/2214188">doi.org</a>. <a class="ref-back" href="#cite-12" aria-label="Back to the text">↩</a></li> <li id="ref-13">Nida-Rümelin &amp; O Conaill, 2024. <a href="https://plato.stanford.edu/entries/qualia-knowledge/">plato.stanford.edu</a>. <a class="ref-back" href="#cite-13" aria-label="Back to the text">↩</a></li> <li id="ref-14">Chalmers, 1996. <a href="https://global.oup.com/academic/product/the-conscious-mind-9780195117899">global.oup.com</a>. <a class="ref-back" href="#cite-14" aria-label="Back to the text">↩</a></li> <li id="ref-15">Kirk, 2023. <a href="https://plato.stanford.edu/entries/zombies/">plato.stanford.edu</a>. <a class="ref-back" href="#cite-15" aria-label="Back to the text">↩</a></li> <li id="ref-16">Kripke, 1980. <a href="https://www.hup.harvard.edu/books/9780674598461">hup.harvard.edu</a>. <a class="ref-back" href="#cite-16" aria-label="Back to the text">↩</a></li> <li id="ref-17">Byrne, 2025. <a href="https://plato.stanford.edu/entries/qualia-inverted/">plato.stanford.edu</a>. <a class="ref-back" href="#cite-17" aria-label="Back to the text">↩</a></li> <li id="ref-18">Block, 1980. <a href="https://doi.org/10.4159/harvard.9780674594623.c31">doi.org</a>. <a class="ref-back" href="#cite-18" aria-label="Back to the text">↩</a></li> <li id="ref-19">Frankish, 2016. <a href="https://keithfrankish.com/eprints/Frankish_2016_Illusionism_as_a_theory_of_consciousness_eprint.pdf">keithfrankish.com</a>. <a class="ref-back" href="#cite-19" aria-label="Back to the text">↩</a></li> <li id="ref-20">Dennett, 1988. <a href="https://doi.org/10.1093/acprof:oso/9780198522379.003.0003">doi.org</a>. <a class="ref-back" href="#cite-20" aria-label="Back to the text">↩</a></li> <li id="ref-21">Chalmers, 2018. <a href="https://consc.net/papers/metaproblem.pdf">consc.net</a>. <a class="ref-back" href="#cite-21" aria-label="Back to the text">↩</a></li> <li id="ref-22">Putnam, 1967. <a href="https://plato.stanford.edu/entries/multiple-realizability/">plato.stanford.edu</a>. <a class="ref-back" href="#cite-22" aria-label="Back to the text">↩</a></li> <li id="ref-23">Chalmers, 2007. <a href="https://consc.net/papers/pceg.pdf">consc.net</a>. <a class="ref-back" href="#cite-23" aria-label="Back to the text">↩</a></li> <li id="ref-24">Searle, 1992. <a href="https://doi.org/10.7551/mitpress/5834.001.0001">doi.org</a>. <a class="ref-back" href="#cite-24" aria-label="Back to the text">↩</a></li> <li id="ref-25">McGinn, 1989. <a href="https://doi.org/10.1093/mind/XCVIII.391.349">doi.org</a>. <a class="ref-back" href="#cite-25" aria-label="Back to the text">↩</a></li> <li id="ref-26">Chalmers, 2015. <a href="https://consc.net/papers/panpsychism.pdf">consc.net</a>. <a class="ref-back" href="#cite-26" aria-label="Back to the text">↩</a></li> <li id="ref-27">Strawson, 2008. <a href="https://doi.org/10.1093/acprof:oso/9780199267422.003.0003">doi.org</a>. <a class="ref-back" href="#cite-27" aria-label="Back to the text">↩</a></li> <li id="ref-28">Chalmers, 2017. <a href="https://doi.org/10.1093/acprof:oso/9780199359943.003.0008">doi.org</a>. <a class="ref-back" href="#cite-28" aria-label="Back to the text">↩</a></li> <li id="ref-29">Kuhn, 2024. <a href="https://doi.org/10.1016/j.pbiomolbio.2023.12.003">doi.org</a>. <a class="ref-back" href="#cite-29" aria-label="Back to the text">↩</a></li> <li id="ref-30">Albantakis et al., 2023. <a href="https://doi.org/10.1371/journal.pcbi.1011465">doi.org</a>. <a class="ref-back" href="#cite-30" aria-label="Back to the text">↩</a></li> <li id="ref-31">Aaronson, 2014. <a href="https://scottaaronson.blog/?p=1823">scottaaronson.blog</a>. <a class="ref-back" href="#cite-31" aria-label="Back to the text">↩</a></li> <li id="ref-32">Brown et al., 2019. <a href="https://doi.org/10.1016/j.tics.2019.06.009">doi.org</a>. <a class="ref-back" href="#cite-32" aria-label="Back to the text">↩</a></li> <li id="ref-33">Seth &amp; Tsakiris, 2018. <a href="https://doi.org/10.1016/j.tics.2018.08.008">doi.org</a>. <a class="ref-back" href="#cite-33" aria-label="Back to the text">↩</a></li> <li id="ref-34">Graziano &amp; Webb, 2015. <a href="https://doi.org/10.3389/fpsyg.2015.00500">doi.org</a>. <a class="ref-back" href="#cite-34" aria-label="Back to the text">↩</a></li> <li id="ref-35">Melloni et al., 2023. <a href="https://doi.org/10.1371/journal.pone.0268577">doi.org</a>. <a class="ref-back" href="#cite-35" aria-label="Back to the text">↩</a></li> <li id="ref-36">IIT-Concerned et al., 2025. <a href="https://doi.org/10.1038/s41593-025-01881-x">doi.org</a>. <a class="ref-back" href="#cite-37" aria-label="Back to the text">↩</a></li> <li id="ref-37">Tononi et al., 2025. <a href="https://doi.org/10.1038/s41593-025-01880-y">doi.org</a>. <a class="ref-back" href="#cite-38" aria-label="Back to the text">↩</a></li> <li id="ref-38">Cohen et al., 2020. <a href="https://doi.org/10.1523/JNEUROSCI.0120-20.2020">doi.org</a>. <a class="ref-back" href="#cite-39" aria-label="Back to the text">↩</a></li> <li id="ref-39">Owen et al., 2006. <a href="https://doi.org/10.1126/science.1130197">doi.org</a>. <a class="ref-back" href="#cite-40" aria-label="Back to the text">↩</a></li> <li id="ref-40">Bodien et al., 2024. <a href="https://doi.org/10.1056/NEJMoa2400645">doi.org</a>. <a class="ref-back" href="#cite-41" aria-label="Back to the text">↩</a></li> <li id="ref-41">Casali et al., 2013. <a href="https://doi.org/10.1126/scitranslmed.3006294">doi.org</a>. <a class="ref-back" href="#cite-42" aria-label="Back to the text">↩</a></li> <li id="ref-42">Casarotto et al., 2016. <a href="https://doi.org/10.1002/ana.24779">doi.org</a>. <a class="ref-back" href="#cite-43" aria-label="Back to the text">↩</a></li> <li id="ref-43">Butlin et al., 2023. <a href="https://arxiv.org/abs/2308.08708">arxiv.org</a>. <a class="ref-back" href="#cite-44" aria-label="Back to the text">↩</a></li> <li id="ref-44">Chalmers, 2023. <a href="https://arxiv.org/abs/2303.07103">arxiv.org</a>. <a class="ref-back" href="#cite-45" aria-label="Back to the text">↩</a></li> <li id="ref-45">Tononi &amp; Koch, 2015. <a href="https://doi.org/10.1098/rstb.2014.0167">doi.org</a>. <a class="ref-back" href="#cite-46" aria-label="Back to the text">↩</a></li> <li id="ref-46">Seth, 2025. <a href="https://doi.org/10.1017/S0140525X25000032">doi.org</a>. <a class="ref-back" href="#cite-47" aria-label="Back to the text">↩</a></li> <li id="ref-47">Seth et al., 2026. <a href="https://doi.org/10.1038/d41586-026-03313-7">doi.org</a>. <a class="ref-back" href="#cite-48" aria-label="Back to the text">↩</a></li> <li id="ref-48">Gurnee et al., 2026. <a href="https://arxiv.org/abs/2607.15495">arxiv.org</a>. <a class="ref-back" href="#cite-49" aria-label="Back to the text">↩</a></li> </ol>]]></content> <author> <name>Eva Koroleva</name> </author> <category term="cognitive-science"/> <category term="philosophy"/> <category term="consciousness"/> <category term="philosophy-of-mind"/> <category term="neuroscience"/> <category term="hard-problem"/> <category term="ai"/> <summary type="html"><![CDATA[The hard problem of consciousness for readers used to physicalism. Thought experiments from Mary's room to fading qualia, positions from illusionism to panpsychism, the scientific theories, the first experiment that tested two of them against each other, and what they imply for AI]]></summary> <media:thumbnail url="https://blog.korolevalab.com/assets/posts/theories-of-consciousness/cover.png"/> <media:content medium="image" url="https://blog.korolevalab.com/assets/posts/theories-of-consciousness/cover.png"/> </entry> <entry> <title type="html">How Karl Friston’s free energy principle works and what its critics say</title> <link href="https://blog.korolevalab.com/blog/2026/free-energy-principle/" rel="alternate" type="text/html" title="How Karl Friston’s free energy principle works and what its critics say"/> <published>2026-06-23T00:00:00+00:00</published> <updated>2026-11-08T00:00:00+00:00</updated> <id>https://blog.korolevalab.com/blog/2026/free-energy-principle</id> <content type="html" xml:base="https://blog.korolevalab.com/blog/2026/free-energy-principle/"><![CDATA[<aside class="tldr"> <p class="tldr-label">In short</p> <p>The free energy principle says that anything that keeps existing can be described as minimising one quantity, variational free energy, an upper bound on how surprising its sensations are under its own model of the world.</p> <p>It does so in three ways: by changing its beliefs (perception), its model (learning) and the world (action). The mathematics is the same as the objective machine learning maximises in variational autoencoders, with the sign flipped.</p> <p>As a principle it can’t be falsified, and its author says so; what can be tested are the specific theories built on it, like predictive coding, and the evidence for those is real but mixed.</p> <div class="stats"> <div class="stat"><span class="stat-value">≈8,000</span><span class="stat-label">citations of Friston's 2010 paper, depending on the database</span></div> <div class="stat"><span class="stat-value">&lt;4%</span><span class="stat-label">error predicting how rat neurons in a dish would rewire, from their first 10 sessions</span></div> <div class="stat"><span class="stat-value">"mixed"</span><span class="stat-label">the verdict of a 2020 review on the brain evidence for predictive processing</span></div> </div> </aside> <p>When Karl Friston was eight, he watched woodlice in a hot garden. They scurried about, and he decided that the scurrying had no purpose: they simply moved faster in the sun and slower in the shade.</p> <p>Nobody told a woodlouse to seek the shade; it ended up there because it slowed down when it got there. He has said that the same principle underwrites the mathematics he spent the next half century developing<sup class="cite">[<a href="#ref-1" id="cite-1" data-ref="1" aria-label="Reference 1: Fortier &amp; Friedman, 2018. aliusresearch.org.">1</a>]</sup>.</p> <p>Friston is best known to neuroscientists for something more practical: statistical parametric mapping, the method behind a large share of all brain-imaging studies<sup class="cite">[<a href="#ref-2" id="cite-2" data-ref="2" aria-label="Reference 2: Friston et al., 1994. doi.org.">2</a>]</sup>.</p> <p>In 2016 a ranking of influence in neuroscience by Semantic Scholar put him first<sup class="cite">[<a href="#ref-3" id="cite-3" data-ref="3" aria-label="Reference 3: UCL, 2016. web.archive.org.">3</a>]</sup>. His 2010 paper “The free-energy principle: a unified brain theory?” has been cited about eight thousand times<sup class="cite">[<a href="#ref-4" id="cite-4" data-ref="4" aria-label="Reference 4: Friston, 2010. doi.org.">4</a>]</sup>. And the principle is also famous for something else: almost nobody can explain it.</p> <p>This post tries. It uses the formulas, because the principle is a mathematical statement and loses its meaning without them, but every symbol is explained, and each step comes with what it means in plain words. It ends with what the principle predicts, what has been tested, and the strongest arguments against it.</p> <h2 id="what-is-the-free-energy-principle">What is the free energy principle?</h2> <p>Anything that persists, a cell, a fish, a person, stays within a small range of states: a fish stays in water, your body temperature stays near 37 °C.</p> <p>In the language of probability, it keeps its sensations <em>unsurprising</em>. It can’t measure surprise directly, so it does something cleverer: it keeps a model of the world, and it minimises a quantity called <em>variational free energy</em>, which can be computed from that model and is never smaller than surprise.</p> <p>There are three ways to make free energy smaller: change your beliefs to fit what you sense, which is perception; change your model over time, which is learning; or change what you sense by acting on the world, which is action. That is the whole principle; the rest is working out what it implies.</p> <h2 id="surprisal-and-why-living-things-keep-it-low">Surprisal and why living things keep it low</h2> <p>Start with a definition. If a creature’s model of the world assigns probability \(p(o)\) to an observation \(o\), the <em>surprisal</em> of that observation is</p> \[\Im(o) = -\ln p(o).\] <p>An observation the model expects, with probability near 1, has surprisal near 0; an improbable one has large surprisal. Surprisal is a property of the observation relative to a model, not a feeling.</p> <p>A fish’s model of its world assigns high probability to being wet, so being on dry land is highly surprising, in this technical sense and in every other.</p> <p>Friston’s argument for why living things should keep surprisal low runs as follows. Anything that stays the kind of thing it is spends its time in a limited set of states. The probability distribution over its states is therefore concentrated, which means it has low entropy.</p> <p>Entropy is average surprisal, and if the system is <em>ergodic</em>, if averaging over time gives the same answer as averaging over all the states it could be in, then keeping surprisal low moment to moment keeps entropy low over a lifetime<sup class="cite">[<a href="#ref-5" id="cite-5" data-ref="5" aria-label="Reference 5: Friston, 2012. doi.org.">5</a>]</sup>.</p> <p>“Biological agents must therefore minimize the long-term average of surprise to ensure that their sensory entropy remains low”<sup class="cite">[<a href="#ref-4" id="cite-6" data-ref="4" aria-label="Reference 4: Friston, 2010. doi.org.">4</a>]</sup>.</p> <div class="callout callout-warn"> <p class="callout-label">Two traps</p> <p>This entropy is the Shannon entropy of a probability distribution, not the entropy of thermodynamics; living things don’t violate the second law, they keep their own states ordered while exporting disorder to their surroundings. And ergodicity is an assumption, not a fact about organisms, which do grow, age and die.</p> </div> <h2 id="variational-free-energy-and-the-elbo">Variational free energy and the ELBO</h2> <p>There is a problem. To compute \(p(o)\) a creature would have to add up the probability of the observation over every possible cause of it, every hidden state \(x\) of the world that could have produced it:</p> \[p(o) = \int p(o \mid x)\, p(x)\, dx.\] <p>That integral is intractable for anything interesting. As Friston puts it, “a system cannot know whether its sensations are surprising and could not avoid them even if it did know”<sup class="cite">[<a href="#ref-4" id="cite-7" data-ref="4" aria-label="Reference 4: Friston, 2010. doi.org.">4</a>]</sup>.</p> <p>The way out is an old trick from statistics. The creature keeps a <em>belief</em> about the causes, a probability distribution \(q(x)\) that it can represent, for instance in neural activity, and scores that belief with the <em>variational free energy</em>:</p> \[F[q, o] = \mathbb{E}_{q(x)}\big[\ln q(x) - \ln p(o, x)\big].\] <p>Here \(p(o, x) = p(o \mid x)\,p(x)\) is the creature’s <em>generative model</em>: how likely each hidden cause is, and what observations each cause would produce. \(F\) needs only the model and the belief, both of which the creature has. One line of algebra rewrites it in the form that explains everything else:</p> \[F = D_{\mathrm{KL}}\big[q(x) \,\Vert\, p(x \mid o)\big] - \ln p(o).\] <p>The first term is the <em>Kullback–Leibler divergence</em> between the belief and the true posterior, the distribution over causes that perfect Bayesian inference would give; it is never negative and is zero only when the belief is exactly right.</p> <p>The second term is the surprisal. So free energy is surprisal plus a non-negative error: \(F \ge \Im(o)\), whatever the belief. Lower \(F\) by improving the belief, and two things happen at once: the belief gets closer to the truth, and \(F\) becomes a tighter estimate of surprisal.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/free-energy-principle/bound-light.png" width="760" alt="Free energy against the centre of a Gaussian belief about the size of the food. A horizontal line marks the surprisal of the observation, about 3.24 nats. Free energy for beliefs of a fixed width and for the best width at each centre always stays above the line; the best belief, centred near 1.5, comes within a few hundredths of a nat of it" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/free-energy-principle/bound-dark.png" width="760" alt="Free energy against the centre of a Gaussian belief about the size of the food. A horizontal line marks the surprisal of the observation, about 3.24 nats. Free energy for beliefs of a fixed width and for the best width at each centre always stays above the line; the best belief, centred near 1.5, comes within a few hundredths of a nat of it" loading="lazy"/></p> <p>The chart computes this for the example of the next section: free energy for a range of beliefs, each a bell curve centred at a different value, against the surprisal of the observation. No belief gets below the line; the best ones nearly touch it.</p> <p>The same quantity has a second decomposition, which explains why the principle has so much to say about learning:</p> \[F = \underbrace{D_{\mathrm{KL}}\big[q(x) \,\Vert\, p(x)\big]}_{\text{complexity}} - \underbrace{\mathbb{E}_{q(x)}\big[\ln p(o \mid x)\big]}_{\text{accuracy}}.\] <p><em>Accuracy</em> is how well the believed causes predict the observation. <em>Complexity</em> is how far the belief has moved from what the creature expected before it looked. Minimising free energy is finding the simplest explanation that fits the data, Occam’s razor written as an equation.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/free-energy-principle/decompose-light.png" width="760" alt="Three ways to write the same variational free energy. First: the divergence between the belief and the true posterior, which is never negative, plus the surprisal of the observation, so free energy is an upper bound on surprisal. Second: complexity, how far the belief moved from the prior, minus accuracy, how well the believed causes predict the observation. Third: the negative of the evidence lower bound that variational autoencoders maximise" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/free-energy-principle/decompose-dark.png" width="760" alt="Three ways to write the same variational free energy. First: the divergence between the belief and the true posterior, which is never negative, plus the surprisal of the observation, so free energy is an upper bound on surprisal. Second: complexity, how far the belief moved from the prior, minus accuracy, how well the believed causes predict the observation. Third: the negative of the evidence lower bound that variational autoencoders maximise" loading="lazy"/></p> <p>If you work in machine learning, you have met \(F\) already. A variational autoencoder is trained to maximise the <em>evidence lower bound</em>, the ELBO, which is exactly \(-F\) with the data called \(x\) and the hidden causes called \(z\)<sup class="cite">[<a href="#ref-6" id="cite-8" data-ref="6" aria-label="Reference 6: Kingma &amp; Welling, 2014. arxiv.org.">6</a>]</sup>.</p> <p>Active-inference papers say it outright: “The variational free energy is the negative evidence lower bound that is optimised in variational Bayes in machine learning”<sup class="cite">[<a href="#ref-7" id="cite-9" data-ref="7" aria-label="Reference 7: Da Costa et al., 2020. doi.org.">7</a>]</sup>.</p> <p>The idea of a brain doing this goes back to the Helmholtz machine of Dayan, Hinton, Neal and Zemel in 1995<sup class="cite">[<a href="#ref-8" id="cite-10" data-ref="8" aria-label="Reference 8: Dayan et al., 1995. doi.org.">8</a>]</sup>, named after Hermann von Helmholtz, who described perception as unconscious inference in the 1860s.</p> <div class="callout"> <p class="callout-label">Why the name</p> <p>The formula has the same shape as the Helmholtz free energy of statistical physics, energy minus temperature times entropy, if you call \(-\ln p(o, x)\) the energy and set the temperature to 1. The mathematics is shared; there are no joules in it.</p> </div> <h2 id="predictive-coding-and-precision">Predictive coding and precision</h2> <p>Free energy says what perception optimises, not how a brain could do it. To get a mechanism, Friston assumes that the generative model is Gaussian: an observation is a prediction from the hidden cause plus noise, and the cause has a bell-shaped prior.</p> <p>Then free energy turns, up to constants, into a sum of squared <em>prediction errors</em>, each weighted by its <em>precision</em>, the inverse of its variance<sup class="cite">[<a href="#ref-9" id="cite-11" data-ref="9" aria-label="Reference 9: Bogacz, 2017. doi.org.">9</a>]</sup>:</p> \[\begin{aligned} F(\mu) &amp;\approx \tfrac12\,\Pi_o\,\big(o - g(\mu)\big)^2 \\ &amp;\quad {}+ \tfrac12\,\Pi_x\,\big(\mu - \eta\big)^2 + \text{const}. \end{aligned}\] <p>Here \(\mu\) is the creature’s best guess about the hidden cause, \(g(\mu)\) is the observation that guess predicts, \(\eta\) is what it expected before looking, and \(\Pi_o\) and \(\Pi_x\) are how much it trusts its senses and its prior.</p> <p>Perception is then gradient descent: the guess moves until the error from below, the senses, balances the error from above, the prior.</p> <p>Rafal Bogacz’s tutorial makes this concrete with a creature that has one light receptor and wants to know how big a piece of food is. Light grows with the area of the food, so a food of size \(v\) gives light \(g(v) = v^2\) plus noise.</p> <p>The creature expects food of size 3, observes a light intensity of 2, and both the prior and the sensor have variance 1. A size of 3 would give light 9, far from 2; a size of \(\sqrt 2 \approx 1.41\) would match the light perfectly but contradicts the prior. Where does the guess settle?</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/free-energy-principle/bogacz-light.png" width="760" alt="Left: the exact posterior over the food&#x27;s size, peaked at 1.57 with a mean of 1.48. Right: the creature&#x27;s guess over time, starting from its prior expectation of 3. Following the gradient of free energy it settles at 1.57 within about one time unit; a network with explicit prediction-error units oscillates and settles at the same value later" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/free-energy-principle/bogacz-dark.png" width="760" alt="Left: the exact posterior over the food&#x27;s size, peaked at 1.57 with a mean of 1.48. Right: the creature&#x27;s guess over time, starting from its prior expectation of 3. Following the gradient of free energy it settles at 1.57 within about one time unit; a network with explicit prediction-error units oscillates and settles at the same value later" loading="lazy"/></p> <p>The left panel is the exact answer, computed by Bayes’ rule on a grid. The right panel is the creature’s guess following the gradient of free energy from its prior expectation, computed here exactly as in Bogacz’s exercises.</p> <p>It settles near 1.57, at the peak of the exact posterior. Bogacz’s text: “it rapidly converges to the value of ϕ≈1.6, which is also the value that maximizes the exact posterior probability.”</p> <p>The guess finds the most probable size, not the average one, which is about 1.48 for this lopsided posterior; a single number cannot carry uncertainty, which is one of the approximations the scheme pays for its simplicity.</p> <details class="method"> <summary>How the charts in this post are computed</summary> <p>They come from the formulas above, not from the papers’ figures. For the bound, the joint probability of Bogacz’s example, a normal prior on the size with mean 3 and variance 1 times a normal likelihood of the light with mean \(v^2\) and variance 1, is evaluated on a fine grid of sizes.</p> <p>Surprisal is minus the log of its integral, and free energy is the integral of \(q(v)\,[\ln q(v) - \ln p(u, v)]\) for each Gaussian belief \(q\).</p> <p>The guess follows Bogacz’s second exercise: small Euler steps along the gradient of \(\ln p(v) + \ln p(u \mid v)\), starting at the prior mean. The thinner line is his third exercise, where the same descent runs through two prediction-error units, one for the prior and one for the senses. The risk and ambiguity bars further down use the two-state examples of Smith, Friston and Whyte’s tutorial, combined by the formula for \(G\).</p> </details> <p>Put many such units in a hierarchy and you get <em>predictive coding</em>. Each level sends predictions down to the level below and receives back the error: what the prediction failed to explain. Rao and Ballard proposed in 1999 that feedback connections in the visual cortex “carry predictions of lower-level neural activities” and feedforward connections carry the residual errors<sup class="cite">[<a href="#ref-10" id="cite-12" data-ref="10" aria-label="Reference 10: Rao &amp; Ballard, 1999. doi.org.">10</a>]</sup>.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/free-energy-principle/hierarchy-light.png" width="760" alt="A predictive-coding hierarchy of three levels above the senses. Each level sends a prediction down to the level below and receives back the prediction error, what the prediction failed to explain, weighted by its precision. Precision works like a volume knob on each error: turned up, the guess follows the data; turned down, it follows expectations. In Friston&#x27;s account attention is precision" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/free-energy-principle/hierarchy-dark.png" width="760" alt="A predictive-coding hierarchy of three levels above the senses. Each level sends a prediction down to the level below and receives back the prediction error, what the prediction failed to explain, weighted by its precision. Precision works like a volume knob on each error: turned up, the guess follows the data; turned down, it follows expectations. In Friston&#x27;s account attention is precision" loading="lazy"/></p> <p>Precision is the most interesting knob in the scheme. It sets how loudly each error is heard.</p> <p>Turn up the precision of the senses and the guess follows the data; turn up the precision of the prior and the guess follows expectations. In Friston’s account attention <em>is</em> precision: attending to something means trusting its prediction errors more.</p> <p class="takeaway">With Gaussian assumptions, minimising free energy is gradient descent on prediction errors weighted by precision. It finds the most probable cause, not a full posterior.</p> <h2 id="active-inference-and-expected-free-energy">Active inference and expected free energy</h2> <p>Here the free energy principle departs from ordinary Bayesian perception. Free energy depends on the observation, and a creature can change its observations by acting. If your model predicts that your arm is raised, there are two ways to remove the error: revise the belief, or raise the arm.</p> <p>Friston calls the second <em>active inference</em>, and in his account movement works this way: the motor system receives predictions of how the body should feel, and reflexes fulfil them<sup class="cite">[<a href="#ref-11" id="cite-13" data-ref="11" aria-label="Reference 11: Friston, Kilner &amp; Harrison, 2006. doi.org.">11</a>]</sup>.</p> <p>Because only the accuracy term depends on what is sensed, “action can reduce free energy only by increasing accuracy (that is, selectively sampling data that are predicted)”<sup class="cite">[<a href="#ref-4" id="cite-14" data-ref="4" aria-label="Reference 4: Friston, 2010. doi.org.">4</a>]</sup>.</p> <p>To plan, a creature needs to score futures it hasn’t seen yet.</p> <p>For that, active inference uses a second quantity, the <em>expected free energy</em> of a policy \(\pi\), a sequence of actions<sup class="cite">[<a href="#ref-12" id="cite-15" data-ref="12" aria-label="Reference 12: Friston et al., 2017. doi.org.">12</a>]</sup>. It too can be split in two ways. One reads as <em>risk plus ambiguity</em><sup class="cite">[<a href="#ref-13" id="cite-16" data-ref="13" aria-label="Reference 13: Smith et al., 2022. doi.org.">13</a>]</sup>:</p> \[\begin{aligned} G(\pi) &amp;= \underbrace{D_{\mathrm{KL}}\big[q(o \mid \pi) \,\Vert\, p(o \mid C)\big]}_{\text{risk}} \\ &amp;\quad {}+ \underbrace{\mathbb{E}_{q(x \mid \pi)}\big[H[p(o \mid x)]\big]}_{\text{ambiguity}}. \end{aligned}\] <p><em>Risk</em> is how far the outcomes the policy is expected to bring are from the outcomes the creature prefers, \(p(o \mid C)\). <em>Ambiguity</em> is how noisy the link from states to observations will be: a policy that leads somewhere you can’t see clearly is ambiguous.</p> <p>The other split reads the same quantity as minus the expected <em>information gain</em>, how much the outcomes would teach about the world, minus the <em>pragmatic value</em>, how well they match preferences. A creature choosing policies with low expected free energy is curious and goal-directed by the same token.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/free-energy-principle/efe-light.png" width="760" alt="Two bar charts. Risk: a policy expected to reach the preferred outcome 82% of the time has risk 2.41 nats, a policy that is a coin flip 7.31. Ambiguity: a policy heading toward the murky state has ambiguity 0.66 nats, one heading toward the clearly observed state 0.52. Lower expected free energy is preferred" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/free-energy-principle/efe-dark.png" width="760" alt="Two bar charts. Risk: a policy expected to reach the preferred outcome 82% of the time has risk 2.41 nats, a policy that is a coin flip 7.31. Ambiguity: a policy heading toward the murky state has ambiguity 0.66 nats, one heading toward the clearly observed state 0.52. Lower expected free energy is preferred" loading="lazy"/></p> <p>One feature of this needs saying plainly, because it surprises everyone. There is no reward.</p> <p>Preferences enter as a probability distribution over observations: the creature <em>expects</em> to see what it prefers, and acts to make those expectations come true. Friston’s colleagues call this an optimism bias written into the model.</p> <p>It also answers the oldest objection to the principle, the <em>dark room problem</em>. If creatures minimise surprise, why don’t they find a dark, quiet room and stay there?</p> <p>Friston’s reply is that surprise is always relative to the creature’s model, and a creature whose model, shaped by evolution, predicts a varied world full of food and company finds a dark room surprising<sup class="cite">[<a href="#ref-14" id="cite-17" data-ref="14" aria-label="Reference 14: Friston, Thornton &amp; Clark, 2012. doi.org.">14</a>]</sup>.</p> <p>Expected free energy adds a second answer: a dark room is maximally ambiguous, so the first thing an active-inference agent does there is switch on the light.</p> <h2 id="markov-blankets">Markov blankets</h2> <p>The principle’s most ambitious version starts from physics, not brains. It asks: what does it take for anything to exist as something separate from its surroundings?</p> <p>In probability, a <em>Markov blanket</em> of a variable is a set of other variables that, once known, makes everything else irrelevant to it. In a Bayesian network it is the variable’s parents, children and its children’s other parents, a notion due to Judea Pearl.</p> <p>Friston carries it into dynamics: a thing is a set of <em>internal</em> states separated from <em>external</em> states by a blanket of <em>sensory</em> states, which the outside affects and the inside doesn’t, and <em>active</em> states, which the inside affects and the outside doesn’t<sup class="cite">[<a href="#ref-15" id="cite-18" data-ref="15" aria-label="Reference 15: Friston, 2013. doi.org.">15</a>]</sup>.</p> <p>A cell’s membrane is the obvious example; a candle flame, Friston notes, isn’t one, because its molecules are swept away almost instantly.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/free-energy-principle/blanket-light.png" width="760" alt="A Markov blanket. External states act on sensory states; sensory states act on internal states; internal states act on active states; active states act on external states. Sensory and active states form the blanket: given the blanket, internal and external states are independent. A cell membrane is an example; a candle flame, whose molecules are swept away almost instantly, is not" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/free-energy-principle/blanket-dark.png" width="760" alt="A Markov blanket. External states act on sensory states; sensory states act on internal states; internal states act on active states; active states act on external states. Sensory and active states form the blanket: given the blanket, internal and external states are independent. A cell membrane is an example; a candle flame, whose molecules are swept away almost instantly, is not" loading="lazy"/></p> <p>The 2019 monograph “A free energy principle for a particular physics” claims that for any system that settles into a characteristic set of states and has such a blanket, the internal states can be read <em>as if</em> they were performing Bayesian inference about the external ones, minimising free energy<sup class="cite">[<a href="#ref-16" id="cite-19" data-ref="16" aria-label="Reference 16: Friston, 2019. arxiv.org.">16</a>]</sup>.</p> <p>The assumptions are many and technical: random dynamics of a particular form, a steady state that the system keeps returning to, coupling sparse enough to produce a blanket, and restrictions on how internal and external states can circulate around each other. Several of them have been challenged, as we’ll see.</p> <h2 id="experimental-evidence">Experimental evidence</h2> <p>The principle itself makes no prediction that could fail; we’ll come back to that. The process theories built on it do.</p> <p><em>Predictive coding in the brain.</em> Expectation effects in the brain are well documented: the mismatch negativity, a brain response to an unexpected sound in a sequence, is robust and widely replicated. Whether the brain implements predictive coding in particular is less clear.</p> <p>A 2020 review, co-written by Andy Clark, one of the framework’s best-known philosophers, concluded that “on the whole it must be concluded that the empirical support for each of PP’s key hypotheses is mixed”<sup class="cite">[<a href="#ref-17" id="cite-20" data-ref="17" aria-label="Reference 17: Walsh et al., 2020. doi.org.">17</a>]</sup>. A 2024 audit by an active-inference modeller found “modest support”<sup class="cite">[<a href="#ref-18" id="cite-21" data-ref="18" aria-label="Reference 18: Hodson et al., 2024. doi.org.">18</a>]</sup>.</p> <p>Recordings in monkey visual cortex found responses to expected and pattern-violating stimuli “nearly identical”<sup class="cite">[<a href="#ref-19" id="cite-22" data-ref="19" aria-label="Reference 19: Solomon et al., 2021. doi.org.">19</a>]</sup>, while neurons in layer 2/3 of mouse visual cortex compute a difference between what the animal’s movement predicts and what it sees, as a prediction-error unit should<sup class="cite">[<a href="#ref-20" id="cite-23" data-ref="20" aria-label="Reference 20: Jordan &amp; Keller, 2020. doi.org.">20</a>]</sup>.</p> <p><em>Neurons in a dish.</em> The most direct test of the principle itself came in 2023. Isomura, Friston and colleagues grew rat cortical neurons on a grid of 64 electrodes and stimulated them with mixtures of two hidden signals.</p> <p>The networks learned to separate the sources, and a model derived from free-energy minimisation, set up from the first 10 training sessions alone, predicted how the networks’ connections would change over the next 90 with an error under 4%<sup class="cite">[<a href="#ref-21" id="cite-24" data-ref="21" aria-label="Reference 21: Isomura et al., 2023. doi.org.">21</a>]</sup>.</p> <p>The authors are careful about what that shows: the principle “is sometimes considered to be experimentally irrefutable”, so they framed this as a test of predictive power, and “showing the existence of such a mapping alone is insufficient as an empirical validation.”</p> <p><em>Pong.</em> A year earlier, the company Cortical Labs and Friston’s group taught neurons in a dish to play the video game Pong. Missing the ball triggered unpredictable stimulation; the cultures learned to rally longer within five minutes, which the authors explained as acting to avoid unpredictable input<sup class="cite">[<a href="#ref-22" id="cite-25" data-ref="22" aria-label="Reference 22: Kagan et al., 2022. doi.org.">22</a>]</sup>.</p> <p>The paper’s title said the neurons “exhibit sentience”, in the minimal sense of being “responsive to sensory impressions”, and thirty neuroscientists wrote to the journal to object<sup class="cite">[<a href="#ref-23" id="cite-26" data-ref="23" aria-label="Reference 23: Balci et al., 2023. doi.org.">23</a>]</sup>.</p> <p>A detail matters more than the word: cultures that got no stimulation at all after a miss also learned, less well, which weakens the reading that unpredictability was what taught them.</p> <p><em>Psychiatry.</em> The idea that some symptoms reflect aberrant precision, trusting the senses too little or too much relative to expectations, has been applied to psychosis<sup class="cite">[<a href="#ref-24" id="cite-27" data-ref="24" aria-label="Reference 24: Adams et al., 2013. doi.org.">24</a>]</sup> and autism<sup class="cite">[<a href="#ref-25" id="cite-28" data-ref="25" aria-label="Reference 25: Lawson et al., 2014. doi.org.">25</a>]</sup>.</p> <p>Adults with autism were found to be “less surprised than neurotypical adults when their expectations are violated” in a volatile task<sup class="cite">[<a href="#ref-26" id="cite-29" data-ref="26" aria-label="Reference 26: Lawson et al., 2017. doi.org.">26</a>]</sup>. For psychosis the direction is disputed: “some studies implicate weakened prior beliefs in psychosis, and others find stronger priors”<sup class="cite">[<a href="#ref-27" id="cite-30" data-ref="27" aria-label="Reference 27: Sterzer et al., 2018. doi.org.">27</a>]</sup>.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/free-energy-principle/evidence-light.png" width="760" alt="A scorecard of claims. That free energy bounds surprisal is a derivation and true. That brains signal violations of expectation is supported by the mismatch negativity and by mismatch neurons in mouse visual cortex. That cortex runs hierarchical predictive coding has mixed or modest support. That neurons in a dish minimise free energy is supported in one preparation. Aberrant precision in psychosis and autism: mixed. That active inference beats reinforcement learning in AI: weak. That every persisting system minimises free energy, the 2019 physics: contested, holding in narrow cases. The principle itself: not testable, by design" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/free-energy-principle/evidence-dark.png" width="760" alt="A scorecard of claims. That free energy bounds surprisal is a derivation and true. That brains signal violations of expectation is supported by the mismatch negativity and by mismatch neurons in mouse visual cortex. That cortex runs hierarchical predictive coding has mixed or modest support. That neurons in a dish minimise free energy is supported in one preparation. Aberrant precision in psychosis and autism: mixed. That active inference beats reinforcement learning in AI: weak. That every persisting system minimises free energy, the 2019 physics: contested, holding in narrow cases. The principle itself: not testable, by design" loading="lazy"/></p> <p class="takeaway">The brain clearly uses expectations. Whether it computes them by predictive coding is mixed in the evidence, and direct tests of the principle itself are still few.</p> <h2 id="criticism-of-the-free-energy-principle">Criticism of the free energy principle</h2> <p><em>It can’t be falsified, and its author agrees.</em> “The free energy principle is what it is—a principle. Like Hamilton’s Principle of Stationary Action, it cannot be falsified”<sup class="cite">[<a href="#ref-1" id="cite-31" data-ref="1" aria-label="Reference 1: Fortier &amp; Friedman, 2018. aliusresearch.org.">1</a>]</sup>.</p> <p>Friston’s colleagues defend this as the difference between a principle, “a piece of mathematical reasoning, which can be developed into a method”, and the theories built with it, which can be tested once mapped to data; they also concede that “the FEP itself has nothing instructive to say of the demarcations defining life or consciousness per se”<sup class="cite">[<a href="#ref-28" id="cite-32" data-ref="28" aria-label="Reference 28: Ramstead et al., 2023. doi.org.">28</a>]</sup>.</p> <p>Critics accept the distinction and draw the consequence: if the principle explains any behaviour, it explains none in particular, and the work of explanation is done by the specific models.</p> <p>Samuel Gershman put it most precisely: “FEP does not have a fixed set of distinctive claims. Rather, it makes different claims under different sets of assumptions”<sup class="cite">[<a href="#ref-29" id="cite-33" data-ref="29" aria-label="Reference 29: Gershman, 2019. doi.org.">29</a>]</sup>.</p> <p><em>The Markov blankets are doing a different job from Pearl’s.</em> Bruineberg, Dołęga, Dewhurst and Baltieri distinguish “Pearl blankets”, a tool for reasoning about a model, from “Friston blankets”, a claim about where things end in the world, and argue that moving from one to the other “requires additional philosophical premises and cannot be justified by an appeal to the success of the mathematical framework alone”<sup class="cite">[<a href="#ref-30" id="cite-34" data-ref="30" aria-label="Reference 30: Bruineberg et al., 2022. doi.org.">30</a>]</sup>.</p> <p><em>The physics holds only in special cases.</em> Aguilera, Millidge, Tschantz and Buckley checked the 2019 derivations on the simplest systems where they can be checked, linear stochastic ones, and found the required conditions “are only valid for a very narrow space of parameters”; a central step, equating the dynamics of average states with the average of the dynamics, “does not hold in general even for linear stochastic systems”<sup class="cite">[<a href="#ref-31" id="cite-35" data-ref="31" aria-label="Reference 31: Aguilera et al., 2022. doi.org.">31</a>]</sup>.</p> <p>Biehl, Pollock and Kanai showed by counterexample that the original “free energy lemma, when taken at face value, is wrong”, while noting that this doesn’t settle whether the general idea is worth pursuing<sup class="cite">[<a href="#ref-32" id="cite-36" data-ref="32" aria-label="Reference 32: Biehl et al., 2021. doi.org.">32</a>]</sup>.</p> <p><em>Curiosity is put in, not derived.</em> Millidge, Tschantz and Buckley showed that the natural extension of free energy into the future discourages exploration rather than encouraging it: “exploration does not directly follow from free energy minimization into the future”<sup class="cite">[<a href="#ref-33" id="cite-37" data-ref="33" aria-label="Reference 33: Millidge et al., 2021. doi.org.">33</a>]</sup>. Expected free energy is a choice, not a consequence.</p> <p><em>In AI, it hasn’t yet won anything.</em> Comparisons of active-inference agents with reinforcement learning are mostly on small problems, and one careful study found that among deep active-inference models, “the models able to solve the dSprites environment are the ones that maximize rewards”<sup class="cite">[<a href="#ref-34" id="cite-38" data-ref="34" aria-label="Reference 34: Champion et al., 2024. doi.org.">34</a>]</sup>.</p> <p>The machine-learning connection runs the other way: predictive coding networks, it turns out, can approximate backpropagation, “converges asymptotically (and in practice, rapidly) to exact backprop gradients on arbitrary computation graphs”<sup class="cite">[<a href="#ref-35" id="cite-39" data-ref="35" aria-label="Reference 35: Millidge et al., 2022. doi.org.">35</a>]</sup>.</p> <h2 id="how-to-read-the-free-energy-principle">How to read the free energy principle</h2> <p>The free energy principle is best read as three things stacked on each other, and most arguments about it come from mixing them up.</p> <p>At the bottom is mathematics: variational free energy is a bound on surprisal, and minimising it is approximate Bayesian inference. That part is uncontroversial and is used every day in machine learning under another name.</p> <p>In the middle is a framework: perception, learning and action described as minimising the same quantity, with attention as precision and preferences as expectations. It is a genuinely useful way to think, and it has produced testable process theories, predictive coding first among them. Those theories have some support and some trouble, as theories should.</p> <p>At the top are the grand claims: that every living thing, by virtue of existing, can be described as inferring its world, and that this tells us what life, mind or consciousness are.</p> <p>Here the principle’s defenders themselves concede that it says little about life or consciousness as such, and its critics argue that the physics behind it holds only in special cases.</p> <p>If you take one thing from it, take the middle layer: the brain as a machine that predicts, weighs its errors by how much it trusts them, and acts to make its predictions come true. Unlike the principle, that picture makes predictions an experiment can refute.</p> <p>The calculations and the figures as code: <a href="https://github.com/xmarva/transformers-from-scratch/tree/main/articles/friston">articles/friston</a>.</p> <h2 id="references">References</h2> <ol class="tfs-refs"> <li id="ref-1">Fortier &amp; Friedman, 2018. <a href="https://www.aliusresearch.org/library/pdfs/alius-bulletin/issue-02/alius-bulletin-issue-02-friston-of-woodlice-and-men-a-bayesian-account-of-cognition-life-and.pdf">aliusresearch.org</a>. <a class="ref-back" href="#cite-1" aria-label="Back to the text">↩</a></li> <li id="ref-2">Friston et al., 1994. <a href="https://doi.org/10.1002/hbm.460020402">doi.org</a>. <a class="ref-back" href="#cite-2" aria-label="Back to the text">↩</a></li> <li id="ref-3">UCL, 2016. <a href="https://web.archive.org/web/20200901070740/https://www.ucl.ac.uk/ion/news/2016/nov/most-influential-brain-scientists-modern-era">web.archive.org</a>. <a class="ref-back" href="#cite-3" aria-label="Back to the text">↩</a></li> <li id="ref-4">Friston, 2010. <a href="https://doi.org/10.1038/nrn2787">doi.org</a>. <a class="ref-back" href="#cite-4" aria-label="Back to the text">↩</a></li> <li id="ref-5">Friston, 2012. <a href="https://doi.org/10.3390/e14112100">doi.org</a>. <a class="ref-back" href="#cite-5" aria-label="Back to the text">↩</a></li> <li id="ref-6">Kingma &amp; Welling, 2014. <a href="https://arxiv.org/abs/1312.6114">arxiv.org</a>. <a class="ref-back" href="#cite-8" aria-label="Back to the text">↩</a></li> <li id="ref-7">Da Costa et al., 2020. <a href="https://doi.org/10.1016/j.jmp.2020.102447">doi.org</a>. <a class="ref-back" href="#cite-9" aria-label="Back to the text">↩</a></li> <li id="ref-8">Dayan et al., 1995. <a href="https://doi.org/10.1162/neco.1995.7.5.889">doi.org</a>. <a class="ref-back" href="#cite-10" aria-label="Back to the text">↩</a></li> <li id="ref-9">Bogacz, 2017. <a href="https://doi.org/10.1016/j.jmp.2015.11.003">doi.org</a>. <a class="ref-back" href="#cite-11" aria-label="Back to the text">↩</a></li> <li id="ref-10">Rao &amp; Ballard, 1999. <a href="https://doi.org/10.1038/4580">doi.org</a>. <a class="ref-back" href="#cite-12" aria-label="Back to the text">↩</a></li> <li id="ref-11">Friston, Kilner &amp; Harrison, 2006. <a href="https://doi.org/10.1016/j.jphysparis.2006.10.001">doi.org</a>. <a class="ref-back" href="#cite-13" aria-label="Back to the text">↩</a></li> <li id="ref-12">Friston et al., 2017. <a href="https://doi.org/10.1162/NECO_a_00912">doi.org</a>. <a class="ref-back" href="#cite-15" aria-label="Back to the text">↩</a></li> <li id="ref-13">Smith et al., 2022. <a href="https://doi.org/10.1016/j.jmp.2021.102632">doi.org</a>. <a class="ref-back" href="#cite-16" aria-label="Back to the text">↩</a></li> <li id="ref-14">Friston, Thornton &amp; Clark, 2012. <a href="https://doi.org/10.3389/fpsyg.2012.00130">doi.org</a>. <a class="ref-back" href="#cite-17" aria-label="Back to the text">↩</a></li> <li id="ref-15">Friston, 2013. <a href="https://doi.org/10.1098/rsif.2013.0475">doi.org</a>. <a class="ref-back" href="#cite-18" aria-label="Back to the text">↩</a></li> <li id="ref-16">Friston, 2019. <a href="https://arxiv.org/abs/1906.10184">arxiv.org</a>. <a class="ref-back" href="#cite-19" aria-label="Back to the text">↩</a></li> <li id="ref-17">Walsh et al., 2020. <a href="https://doi.org/10.1111/nyas.14321">doi.org</a>. <a class="ref-back" href="#cite-20" aria-label="Back to the text">↩</a></li> <li id="ref-18">Hodson et al., 2024. <a href="https://doi.org/10.1016/j.neubiorev.2023.105473">doi.org</a>. <a class="ref-back" href="#cite-21" aria-label="Back to the text">↩</a></li> <li id="ref-19">Solomon et al., 2021. <a href="https://doi.org/10.1093/cercor/bhab014">doi.org</a>. <a class="ref-back" href="#cite-22" aria-label="Back to the text">↩</a></li> <li id="ref-20">Jordan &amp; Keller, 2020. <a href="https://doi.org/10.1016/j.neuron.2020.09.024">doi.org</a>. <a class="ref-back" href="#cite-23" aria-label="Back to the text">↩</a></li> <li id="ref-21">Isomura et al., 2023. <a href="https://doi.org/10.1038/s41467-023-40141-z">doi.org</a>. <a class="ref-back" href="#cite-24" aria-label="Back to the text">↩</a></li> <li id="ref-22">Kagan et al., 2022. <a href="https://doi.org/10.1016/j.neuron.2022.09.001">doi.org</a>. <a class="ref-back" href="#cite-25" aria-label="Back to the text">↩</a></li> <li id="ref-23">Balci et al., 2023. <a href="https://doi.org/10.1016/j.neuron.2023.02.009">doi.org</a>. <a class="ref-back" href="#cite-26" aria-label="Back to the text">↩</a></li> <li id="ref-24">Adams et al., 2013. <a href="https://doi.org/10.3389/fpsyt.2013.00047">doi.org</a>. <a class="ref-back" href="#cite-27" aria-label="Back to the text">↩</a></li> <li id="ref-25">Lawson et al., 2014. <a href="https://doi.org/10.3389/fnhum.2014.00302">doi.org</a>. <a class="ref-back" href="#cite-28" aria-label="Back to the text">↩</a></li> <li id="ref-26">Lawson et al., 2017. <a href="https://doi.org/10.1038/nn.4615">doi.org</a>. <a class="ref-back" href="#cite-29" aria-label="Back to the text">↩</a></li> <li id="ref-27">Sterzer et al., 2018. <a href="https://doi.org/10.1016/j.biopsych.2018.05.015">doi.org</a>. <a class="ref-back" href="#cite-30" aria-label="Back to the text">↩</a></li> <li id="ref-28">Ramstead et al., 2023. <a href="https://doi.org/10.1098/rsfs.2022.0029">doi.org</a>. <a class="ref-back" href="#cite-32" aria-label="Back to the text">↩</a></li> <li id="ref-29">Gershman, 2019. <a href="https://doi.org/10.51628/001c.10839">doi.org</a>. <a class="ref-back" href="#cite-33" aria-label="Back to the text">↩</a></li> <li id="ref-30">Bruineberg et al., 2022. <a href="https://doi.org/10.1017/S0140525X21002351">doi.org</a>. <a class="ref-back" href="#cite-34" aria-label="Back to the text">↩</a></li> <li id="ref-31">Aguilera et al., 2022. <a href="https://doi.org/10.1016/j.plrev.2021.11.001">doi.org</a>. <a class="ref-back" href="#cite-35" aria-label="Back to the text">↩</a></li> <li id="ref-32">Biehl et al., 2021. <a href="https://doi.org/10.3390/e23030293">doi.org</a>. <a class="ref-back" href="#cite-36" aria-label="Back to the text">↩</a></li> <li id="ref-33">Millidge et al., 2021. <a href="https://doi.org/10.1162/neco_a_01354">doi.org</a>. <a class="ref-back" href="#cite-37" aria-label="Back to the text">↩</a></li> <li id="ref-34">Champion et al., 2024. <a href="https://doi.org/10.1162/neco_a_01697">doi.org</a>. <a class="ref-back" href="#cite-38" aria-label="Back to the text">↩</a></li> <li id="ref-35">Millidge et al., 2022. <a href="https://doi.org/10.1162/neco_a_01497">doi.org</a>. <a class="ref-back" href="#cite-39" aria-label="Back to the text">↩</a></li> </ol>]]></content> <author> <name>Eva Koroleva</name> </author> <category term="cognitive-science"/> <category term="machine-learning"/> <category term="free-energy-principle"/> <category term="active-inference"/> <category term="predictive-coding"/> <category term="neuroscience"/> <category term="bayesian-brain"/> <summary type="html"><![CDATA[Karl Friston's free energy principle with exact formulas and plain words. Surprisal and variational free energy, its link to the ELBO of machine learning, predictive coding on a worked example, active inference, Markov blankets, the experimental evidence and the main criticisms]]></summary> <media:thumbnail url="https://blog.korolevalab.com/assets/posts/free-energy-principle/cover.png"/> <media:content medium="image" url="https://blog.korolevalab.com/assets/posts/free-energy-principle/cover.png"/> </entry> <entry> <title type="html">How similar is the human brain to AI models?</title> <link href="https://blog.korolevalab.com/blog/2026/brain-and-ai-models/" rel="alternate" type="text/html" title="How similar is the human brain to AI models?"/> <published>2026-06-08T00:00:00+00:00</published> <updated>2026-11-08T00:00:00+00:00</updated> <id>https://blog.korolevalab.com/blog/2026/brain-and-ai-models</id> <content type="html" xml:base="https://blog.korolevalab.com/blog/2026/brain-and-ai-models/"><![CDATA[<aside class="tldr"> <p class="tldr-label">In short</p> <p>Neural networks trained only to do a task, never fitted to brains, turn out to predict the brain’s responses better than any model neuroscientists built by hand: language models for the language network, vision models for the visual cortex, a reinforcement-learning rule for dopamine.</p> <p>The match is real and also narrower than the headlines. Better models stopped becoming more brain-like years ago, much of the measured similarity comes from word meaning and from loose statistics, and a language model is a model of one network in the brain, not of a mind.</p> <p>The brain wins on energy and data by orders of magnitude, the models win on speed and breadth, and the largest gaps are lifelong learning, a body and knowing what one doesn’t know.</p> <div class="stats"> <div class="stat"><span class="stat-value">−97.5%</span><span class="stat-label">drop in the language network's response to sentences a GPT-based model chose to silence it</span></div> <div class="stat"><span class="stat-value">10⁵–10⁶×</span><span class="stat-label">more text in Llama 3.1's training than the words a child hears by adolescence</span></div> <div class="stat"><span class="stat-value">57.5%</span><span class="stat-label">for the best video model on an intuitive-physics test where people score 96.4%</span></div> </div> </aside> <p>In 2023 a team at MIT trained a model on one thing: how strongly the language areas of five people’s brains responded, in a scanner, to a thousand ordinary sentences.</p> <p>The model read each sentence through GPT-2 and predicted the response from GPT-2’s internal activity. Then the researchers turned it around. They let the model search 1.8 million sentences for the ones it expected to drive the language network as hard as possible, and the ones it expected to silence it.</p> <p>The winners to drive were odd: “People on Insta Be Like, “Gross!”” and “Turin loves me not, nor will.” The winners to silence were the dullest sentences imaginable: “We were sitting on the couch.”</p> <p>Played to new people the model had never seen, the drive sentences raised the response of the language network by 85.7% over ordinary sentences and the suppress sentences lowered it by 97.5%, on a standardised scale<sup class="cite">[<a href="#ref-1" id="cite-1" data-ref="1" aria-label="Reference 1: Tuckute et al., 2024. doi.org.">1</a>]</sup>.</p> <p>A language model had learned enough about one part of the human brain to steer it with the choice of words alone.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/brain-and-ai-models/drive-light.png" width="760" alt="Bars of the language network's response in new people. Sentences a GPT-based encoding model chose to drive it, such as People on Insta Be Like, Gross, and Turin loves me not, nor will, raised it by 85.7% over ordinary sentences. Sentences chosen to silence it, such as We were sitting on the couch, lowered it by 97.5%, on a standardised scale" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/brain-and-ai-models/drive-dark.png" width="760" alt="Bars of the language network's response in new people. Sentences a GPT-based encoding model chose to drive it, such as People on Insta Be Like, Gross, and Turin loves me not, nor will, raised it by 85.7% over ordinary sentences. Sentences chosen to silence it, such as We were sitting on the couch, lowered it by 97.5%, on a standardised scale" loading="lazy"></p> <p>That experiment is the best short answer to the question everyone asks about AI and the brain: are they alike? In some places they are alike enough to be useful to each other.</p> <p>In others the resemblance is an artefact of how we measure it, and in others there is nothing to compare, because one side has no counterpart at all. This post goes through the evidence system by system, language, vision, space and memory, reward, bodies, then asks which is more efficient and what is missing.</p> <h2 id="how-do-you-compare-a-brain-with-a-model">How do you compare a brain with a model?</h2> <p>A brain and a neural network don’t share units. A voxel in an fMRI scan averages the blood flow around hundreds of thousands of neurons over a couple of seconds; a unit in a network is one number. So nobody compares them directly.</p> <p>The standard method is an <em>encoding model</em>: show the same stimuli, a story, a set of photographs, to a person in a scanner and to a network, record the network’s internal activity, and fit a linear map from that activity to each voxel’s response.</p> <p>Then test the map on stimuli it hasn’t seen. If the network’s activity predicts the brain’s response to new sentences, the two must share some of the information they carry.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/brain-and-ai-models/encoding-light.png" width="760" alt="How a brain is compared with a model. The same sentence goes to a language model and to a person in an fMRI scanner. The model's internal activity, a vector of numbers, is mapped to each voxel's response by a linear regression fitted on training sentences. On new sentences the predicted response is compared with the measured one, and the correlation is divided by the noise ceiling: how well the brain predicts itself across repeated measurements or across people" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/brain-and-ai-models/encoding-dark.png" width="760" alt="How a brain is compared with a model. The same sentence goes to a language model and to a person in an fMRI scanner. The model's internal activity, a vector of numbers, is mapped to each voxel's response by a linear regression fitted on training sentences. On new sentences the predicted response is compared with the measured one, and the correlation is divided by the noise ceiling: how well the brain predicts itself across repeated measurements or across people" loading="lazy"></p> <p>The prediction is scored as a correlation, and since the brain itself is noisy, the correlation is compared with a <em>noise ceiling</em>: how well one recording of the same person, or other people, predicts another.</p> <p>“The model explains 80% of the explainable variance” means its correlation is 80% of that ceiling. The other common method, <em>representational similarity analysis</em>, skips the map: it compares which stimuli the brain treats as similar with which ones the network treats as similar<sup class="cite">[<a href="#ref-2" id="cite-2" data-ref="2" aria-label="Reference 2: Khaligh-Razavi &amp; Kriegeskorte, 2014. doi.org.">2</a>]</sup>.</p> <p>Both methods answer a narrower question than it seems. They show that two systems carry overlapping information about the stimuli, not that they compute it the same way.</p> <p>A linear map is flexible enough to find shared information in very different machinery. And the details of the test matter enormously, as we will see.</p> <details class="method"> <summary>Three numbers to keep in mind when reading these studies</summary> <p>Raw correlations are small. In one of the best-known language studies the best models reached a correlation of about 0.05 with single fMRI voxels, against a ceiling of 0.06<sup class="cite">[<a href="#ref-3" id="cite-3" data-ref="3" aria-label="Reference 3: Caucheteux &amp; King, 2022. doi.org.">3</a>]</sup>. “Close to the ceiling” can mean that both numbers are close to zero.</p> <p>The ceiling is sometimes extrapolated. “Nearly 100% of explainable variance” in Schrimpf et al.’s much-cited paper is a ratio of correlations, with ceilings of r = 0.17 to 0.32, estimated for an infinite number of participants<sup class="cite">[<a href="#ref-4" id="cite-4" data-ref="4" aria-label="Reference 4: Schrimpf et al., 2021. doi.org.">4</a>]</sup>.</p> <p>How the data are split decides a lot. If sentences from the same passage land in both the training and the test set, a model can score well by recognising the passage rather than the sentence.</p> <p>A 2026 re-analysis found that several of the field’s best-known results depend on such splits, and that a model knowing only a sentence’s position in the experiment matches GPT-2 on them<sup class="cite">[<a href="#ref-5" id="cite-5" data-ref="5" aria-label="Reference 5: Hadidi et al., 2026. doi.org.">5</a>]</sup>.</p> </details> <h2 id="language-models-and-the-brains-language-network">Language models and the brain’s language network</h2> <p>The human brain has a set of regions that respond when we read or hear language and barely respond to anything else: not to arithmetic, logic, music or code.</p> <p>Evelina Fedorenko’s group calls it the <em>language network</em>; it sits mostly in the left hemisphere, along the temporal lobe and in the inferior frontal gyrus. Here it is as an atlas of 804 people: the colour shows how often each spot of cortex was among a person’s most language-selective.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/brain-and-ai-models/language-light.png" width="760" alt="The language network on an inflated cortex, both hemispheres seen from the side. Violet marks where, across 804 people, a spot was among the most responsive to sentences compared with lists of nonwords. The left hemisphere has large, strong patches in the inferior and middle frontal gyri and along the temporal lobe from front to back; the right hemisphere has weaker, smaller versions of the same patches" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/brain-and-ai-models/language-dark.png" width="760" alt="The language network on an inflated cortex, both hemispheres seen from the side. Violet marks where, across 804 people, a spot was among the most responsive to sentences compared with lists of nonwords. The left hemisphere has large, strong patches in the inferior and middle frontal gyri and along the temporal lobe from front to back; the right hemisphere has weaker, smaller versions of the same patches" loading="lazy"></p> <p>Since 2021 one result has been replicated with fMRI, magnetoencephalography and electrodes placed on the brains of epilepsy patients: the internal activity of language models predicts this network’s response to language better than any other model we have.</p> <p>Schrimpf and colleagues compared 43 models and found transformers best; across models, the ones better at predicting the next word predicted the brain better, while performance on language-understanding benchmarks didn’t<sup class="cite">[<a href="#ref-4" id="cite-6" data-ref="4" aria-label="Reference 4: Schrimpf et al., 2021. doi.org.">4</a>]</sup>.</p> <p>Caucheteux and King trained thousands of transformers from scratch and found brain similarity rising with the ability to predict words from context, with a twist: it peaked before the models were at their best, and “the highest brain scores are not achieved by the very best language transformers”<sup class="cite">[<a href="#ref-3" id="cite-7" data-ref="3" aria-label="Reference 3: Caucheteux &amp; King, 2022. doi.org.">3</a>]</sup>.</p> <p>The fit also scales. Training encoding models on about twenty hours of fMRI per person, Antonello, Vaidya and Huth found that predictions improved roughly logarithmically with model size, by about 15% from 125 million to 30 billion parameters, and then levelled off<sup class="cite">[<a href="#ref-6" id="cite-8" data-ref="6" aria-label="Reference 6: Antonello et al., 2023. arxiv.org.">6</a>]</sup>.</p> <p>In some regions the best models came close to the ceiling. And it doesn’t take an internet of text: GPT-2 trained on 100 million words, about what a child hears in ten years, predicted the brain as well as GPT-2 trained on billions<sup class="cite">[<a href="#ref-7" id="cite-9" data-ref="7" aria-label="Reference 7: Hosseini et al., 2024. doi.org.">7</a>]</sup>.</p> <p>Here the honest part starts. What is the network actually matching? Kauf and colleagues scrambled the word order of sentences and lost only 8 to 24% of the predictivity; removing the content words lost up to 83%<sup class="cite">[<a href="#ref-8" id="cite-10" data-ref="8" aria-label="Reference 8: Kauf et al., 2024. doi.org.">8</a>]</sup>.</p> <p>What the models share with the language network is mostly the meaning of words, plus some of how words combine, and much less syntax than the word “language model” suggests.</p> <p>The 2026 re-analysis went further: on the classic datasets, a sentence’s position, the rate of words and static word embeddings together accounted for over 80% of GPT-2-XL’s predictivity<sup class="cite">[<a href="#ref-5" id="cite-11" data-ref="5" aria-label="Reference 5: Hadidi et al., 2026. doi.org.">5</a>]</sup>.</p> <p>The most attractive story in the field, that the brain is a next-word predictor because next-word predictors fit it best, has been pulled from both sides.</p> <p>Goldstein and colleagues recorded from 1,339 electrodes while nine patients listened to a podcast and found information about the upcoming word up to 800 milliseconds before it was heard, and surprise after it, much as a language model would show<sup class="cite">[<a href="#ref-9" id="cite-12" data-ref="9" aria-label="Reference 9: Goldstein et al., 2022. doi.org.">9</a>]</sup>.</p> <p>In 2026 Schönmann and colleagues showed that the same signature appears when the analysis is run on the speech sound itself, or on word embeddings that cannot predict anything, because words in natural speech are statistically dependent on their neighbours<sup class="cite">[<a href="#ref-10" id="cite-13" data-ref="10" aria-label="Reference 10: Schönmann et al., 2026. doi.org.">10</a>]</sup>.</p> <p>Goldstein’s team had warned about this themselves: “These shared computational principles, however, do not imply that the human brain and DLMs implement these computations in a similar way.”</p> <p class="takeaway">Language models are the best encoding models of the language network we have, and what they mostly capture is word meaning. Whether the brain computes language by predicting the next word is still open.</p> <h3 id="language-and-thought-rely-on-different-networks">Language and thought rely on different networks</h3> <p>The language network has a second property that matters more than any correlation. People who lose it, after a stroke that leaves them with global aphasia, unable to understand or produce sentences, can still do arithmetic, solve logic problems and reason about what other people believe<sup class="cite">[<a href="#ref-11" id="cite-14" data-ref="11" aria-label="Reference 11: Fedorenko &amp; Varley, 2016. doi.org.">11</a>]</sup>.</p> <p>In healthy people the network stays quiet during arithmetic, logic and music. In the brain, language and thought are different systems that talk to each other<sup class="cite">[<a href="#ref-12" id="cite-15" data-ref="12" aria-label="Reference 12: Fedorenko et al., 2024. doi.org.">12</a>]</sup>.</p> <p>Mahowald, Ivanova and colleagues turned this into a distinction for language models: <em>formal competence</em>, knowing the rules and patterns of a language, and <em>functional competence</em>, using language to reason, plan and know about the world.</p> <p>A fluent text tempts us to infer the second from the first, the “good at language, therefore good at thought” fallacy<sup class="cite">[<a href="#ref-13" id="cite-16" data-ref="13" aria-label="Reference 13: Mahowald et al., 2024. doi.org.">13</a>]</sup>. The brain data agree.</p> <p>In a family of models trained from scratch, similarity to the language network peaked after only 2 to 8 billion tokens of training, while reasoning and knowledge kept improving through 300 billion<sup class="cite">[<a href="#ref-14" id="cite-17" data-ref="14" aria-label="Reference 14: AlKhamissi et al., 2025. arxiv.org.">14</a>]</sup>.</p> <p>So a large language model is two things at once. Part of it is a good model of the human language network. The rest, the arithmetic, the facts, the code, has to live somewhere else in the brain, and the language network doesn’t predict which.</p> <h3 id="decoding-language-from-brain-scans">Decoding language from brain scans</h3> <p>The same models made it possible to decode language from brain activity. Tang, LeBel, Jain and Huth decoded the gist of stories that people heard or imagined, and of silent films they watched, from fMRI alone, using a GPT model to propose candidate word sequences and an encoding model to pick the one that best explained the scan<sup class="cite">[<a href="#ref-15" id="cite-18" data-ref="15" aria-label="Reference 15: Tang et al., 2023. doi.org.">15</a>]</sup>.</p> <p>The output is paraphrase, not transcript: most words come out wrong, and the meaning comes through. The decoder had to be trained on about 16 hours of each person’s own scans, didn’t work across people, and failed when the person resisted by thinking of something else.</p> <p>The most practical use is in medicine. Electrodes implanted in the speech-motor cortex of a man with ALS let him speak through a computer at about 32 words a minute with 97.5% accuracy, over 248 hours of everyday use<sup class="cite">[<a href="#ref-16" id="cite-19" data-ref="16" aria-label="Reference 16: Card et al., 2024. doi.org.">16</a>]</sup>.</p> <p>A language model corrects the raw output into likely sentences. The signal is the attempt to move the mouth, not the language network and not thought.</p> <h2 id="vision-models-and-the-visual-cortex">Vision models and the visual cortex</h2> <p>The visual system was where this whole line of work began, and where it is most mature.</p> <p>Visual information flows from the primary visual cortex at the back of the head forward along the underside of the brain, through areas that respond to edges, then to shapes and textures, then to whole objects and faces in the inferior temporal cortex. This <em>ventral stream</em> is a hierarchy, like the stack of layers in a convolutional network.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/brain-and-ai-models/ventral-light.png" width="760" alt="The left hemisphere seen from the side, from the middle and from below, with the ventral visual stream in three shades: early visual cortex at the back of the head and along the calcarine sulcus, middle stages on the lateral occipital surface, and late stages in the fusiform and inferior temporal gyri on the underside of the temporal lobe" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/brain-and-ai-models/ventral-dark.png" width="760" alt="The left hemisphere seen from the side, from the middle and from below, with the ventral visual stream in three shades: early visual cortex at the back of the head and along the calcarine sulcus, middle stages on the lateral occipital surface, and late stages in the fusiform and inferior temporal gyri on the underside of the temporal lobe" loading="lazy"></p> <p>In 2014 Yamins, DiCarlo and colleagues showed that the resemblance is more than a picture. They trained networks only to recognise objects, never fitting them to neural data, and found that the better a network categorised, the better its top layer predicted single sites in the inferior temporal cortex of monkeys, and an intermediate layer predicted area V4.</p> <p>The best model predicted 48.5% of the explainable variance of IT, nearly twice as much as any model built before it<sup class="cite">[<a href="#ref-17" id="cite-20" data-ref="17" aria-label="Reference 17: Yamins et al., 2014. doi.org.">17</a>]</sup>. A system optimised for a task had converged, in part, on the representation that evolution and development produced for the same task.</p> <p>What followed is the most instructive turn in the field. If accuracy made networks brain-like, more accurate networks should be more brain-like still.</p> <p>For a while they were. Then four groups with different data found the payoff gone.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/brain-and-ai-models/vision-light.png" width="760" alt="Five studies in order. Yamins and colleagues in 2014 found that a network trained only to categorise objects predicted 48.5% of the explainable variance of monkey inferior temporal cortex. Brain-Score in 2018 found the link between ImageNet accuracy and brain similarity weakening above about 70% accuracy. Linsley and colleagues in 2023 found that across 135 networks more accurate ones were worse models of IT. Gokce and Schrimpf in 2025 found, over more than 600 models, that agreement with behaviour kept improving with scale while agreement with neurons saturated. Conwell and colleagues in 2024 found ImageNet accuracy unrelated to how well 224 models predicted human fMRI" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/brain-and-ai-models/vision-dark.png" width="760" alt="Five studies in order. Yamins and colleagues in 2014 found that a network trained only to categorise objects predicted 48.5% of the explainable variance of monkey inferior temporal cortex. Brain-Score in 2018 found the link between ImageNet accuracy and brain similarity weakening above about 70% accuracy. Linsley and colleagues in 2023 found that across 135 networks more accurate ones were worse models of IT. Gokce and Schrimpf in 2025 found, over more than 600 models, that agreement with behaviour kept improving with scale while agreement with neurons saturated. Conwell and colleagues in 2024 found ImageNet accuracy unrelated to how well 224 models predicted human fMRI" loading="lazy"></p> <p>Brain-Score, a benchmark that scores networks against monkey recordings, found the link between ImageNet accuracy and brain similarity weakening above about 70% accuracy<sup class="cite">[<a href="#ref-18" id="cite-21" data-ref="18" aria-label="Reference 18: Schrimpf et al., 2018. doi.org.">18</a>]</sup>. Across 135 networks, Linsley and colleagues found that the more accurate ones had become <em>worse</em> models of IT<sup class="cite">[<a href="#ref-19" id="cite-22" data-ref="19" aria-label="Reference 19: Linsley et al., 2023. arxiv.org.">19</a>]</sup>.</p> <p>Over 600 models trained under controlled conditions, alignment with behaviour kept improving with scale while alignment with neurons saturated<sup class="cite">[<a href="#ref-20" id="cite-23" data-ref="20" aria-label="Reference 20: Gokce &amp; Schrimpf, 2025. arxiv.org.">20</a>]</sup>. And in human fMRI from the Natural Scenes Dataset, ImageNet accuracy didn’t predict how brain-like a model was at all: the rank correlation was −0.006 by one measure and 0.17 by another<sup class="cite">[<a href="#ref-21" id="cite-24" data-ref="21" aria-label="Reference 21: Conwell et al., 2024. doi.org.">21</a>]</sup>.</p> <p>Conwell’s study, 224 models and 1.8 billion regressions, found something even more uncomfortable.</p> <p>Convolutional networks and transformers trained the same way scored r = 0.67 and 0.66; 126 of the 224 models scored within 0.1 of each other; models whose representations barely correlated with each other got the same brain score; and the same models explained about 31% or about 79.5% of the explainable variance, depending on which of two reasonable versions of the analysis was used.</p> <p>What mattered most was what images a model was trained on. The authors’ conclusion is about our instruments as much as about brains: “standard methods used to link models to brains may be too flexible.”</p> <p class="callout callout-key">Task-trained networks predicted the visual cortex better than any hand-built model. Since then, accuracy has stopped buying similarity, architecture barely matters, and the measuring stick is looser than the scores suggest.</p> <h3 id="how-human-and-machine-vision-differ">How human and machine vision differ</h3> <p>The differences show up in behaviour. On images with the shape of one object and the texture of another, a cat’s outline filled with elephant skin, people name the shape 95.9% of the time; ImageNet-trained networks mostly name the texture<sup class="cite">[<a href="#ref-22" id="cite-25" data-ref="22" aria-label="Reference 22: Geirhos et al., 2019. arxiv.org.">22</a>]</sup>.</p> <p>In an odd-one-out task that needs the 3D shape of an object seen from different angles, people score 78% and the best vision model 44%<sup class="cite">[<a href="#ref-23" id="cite-26" data-ref="23" aria-label="Reference 23: Bonnen et al., 2024. arxiv.org.">23</a>]</sup>. Frontier multimodal models of 2024 solved a classic mental rotation test 33% of the time, against 78.5% for people and 25% by chance<sup class="cite">[<a href="#ref-24" id="cite-27" data-ref="24" aria-label="Reference 24: Ramakrishnan et al., 2025. arxiv.org.">24</a>]</sup>.</p> <p>One difference turned out smaller than it looked. Tiny, invisible changes to an image can make a network see a different object, which seemed to prove that networks are fragile and brains are not.</p> <p>But when the responses of monkey IT neurons were attacked the same way, they turned out about as fragile as networks trained to resist such attacks<sup class="cite">[<a href="#ref-25" id="cite-28" data-ref="25" aria-label="Reference 25: Guo et al., 2022. arxiv.org.">25</a>]</sup>.</p> <p>People resist because they get to look again; a 63-millisecond glimpse followed by a mask can be nudged by the same perturbations that fool networks<sup class="cite">[<a href="#ref-26" id="cite-29" data-ref="26" aria-label="Reference 26: Elsayed et al., 2018. arxiv.org.">26</a>]</sup>.</p> <h3 id="reconstructing-images-from-brain-activity">Reconstructing images from brain activity</h3> <p>If you have seen images “reconstructed from brain scans”, they came from the Natural Scenes Dataset: eight people, each lying in a 7-tesla scanner for 30 to 40 sessions over a year and looking at 9,000 to 10,000 photographs<sup class="cite">[<a href="#ref-27" id="cite-30" data-ref="27" aria-label="Reference 27: Allen et al., 2022. doi.org.">27</a>]</sup>.</p> <p>Pipelines like MindEye2 map the scans into the input space of an image generator. Asked to pick which of 300 photographs a person saw, MindEye2 is right 98.3% of the time; with only one hour of a new person’s data, on top of 40 hours each from seven others, 57.4%<sup class="cite">[<a href="#ref-28" id="cite-31" data-ref="28" aria-label="Reference 28: Scotti et al., 2024. arxiv.org.">28</a>]</sup>.</p> <p>Retrieval is real. Reconstruction is mostly the generator’s. On a dataset built so that test images come from categories absent from training, the same methods produced realistic pictures of the training categories instead of what people saw; geometric shapes came out as photographs.</p> <p>The authors call what these methods do “a combination of ‘classification’ and ‘hallucination’“<sup class="cite">[<a href="#ref-29" id="cite-32" data-ref="29" aria-label="Reference 29: Shirakawa et al., 2025. arxiv.org.">29</a>]</sup>. The brain supplies a rough steer, and a model trained on billions of images supplies the picture.</p> <h2 id="place-cells-grid-cells-and-the-hippocampus">Place cells, grid cells and the hippocampus</h2> <p>The hippocampus and the entorhinal cortex next to it hold the brain’s best-understood map. <em>Place cells</em> fire when an animal is in one particular spot; <em>grid cells</em> fire at every vertex of a triangular lattice that tiles the whole environment. John O’Keefe and May-Britt and Edvard Moser shared the 2014 Nobel Prize for finding them<sup class="cite">[<a href="#ref-30" id="cite-33" data-ref="30" aria-label="Reference 30: Hafting et al., 2005. doi.org.">30</a>]</sup>.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/brain-and-ai-models/space-light.png" width="760" alt="A coronal slice of the brain with both hippocampi highlighted, and two idealised firing maps over a one-metre box: a place cell fires in one spot, a grid cell at every vertex of a triangular lattice" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/brain-and-ai-models/space-dark.png" width="760" alt="A coronal slice of the brain with both hippocampi highlighted, and two idealised firing maps over a one-metre box: a place cell fires in one spot, a grid cell at every vertex of a triangular lattice" loading="lazy"></p> <p>In 2018 a DeepMind team trained a recurrent network to keep track of its position from its own movements, and grid-like units appeared in it, about a quarter of the units in one layer, with scales like a rat’s; an agent using them navigated mazes and took shortcuts<sup class="cite">[<a href="#ref-31" id="cite-34" data-ref="31" aria-label="Reference 31: Banino et al., 2018. doi.org.">31</a>]</sup>.</p> <p>It looked like a task explaining a cell type. Then Schaeffer, Khona and Fiete trained more than 11,000 such networks.</p> <p>Most learned to keep track of position; fewer than 10% showed grid-like units, only with one particular, hand-chosen way of reading out the position, and never with the several grid modules of different scales that real brains have<sup class="cite">[<a href="#ref-32" id="cite-35" data-ref="32" aria-label="Reference 32: Schaeffer et al., 2022. doi.org.">32</a>]</sup>.</p> <p>Banino’s networks had needed dropout too. The grid came partly from the task and partly from the modeller’s choices.</p> <p>A model can also look as if it has a map without having one. Transformers trained on turn-by-turn taxi rides in Manhattan chose a valid next turn almost every time and often found shortest paths, yet the street map implied by their behaviour was impossible, with streets running in orientations the city doesn’t have.</p> <p>Replace 1% of their turns with random detours, and only 69% of their routes stayed valid; replace 10%, and 8% did<sup class="cite">[<a href="#ref-33" id="cite-36" data-ref="33" aria-label="Reference 33: Vafa et al., 2024. arxiv.org.">33</a>]</sup>.</p> <h3 id="memory-systems-and-the-context-window">Memory systems and the context window</h3> <p>The brain has several memory systems, and a language model has several stores, and it is tempting to pair them. The pairing is a useful map if you remember that it is a map.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/brain-and-ai-models/memory-light.png" width="760" alt="Human memory systems paired with a language model's stores. Working memory, about four chunks kept active, pairs with the context window, a hundred thousand tokens or more held passively and used worst in the middle. Episodic memory, one-shot memories of one's own experiences, pairs with retrieval of documents, which are not the model's own past. Semantic memory, slowly consolidated facts, pairs with the weights, absorbed slowly in training. Consolidation by replay during sleep pairs with nothing: what happens in a conversation never reaches the weights" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/brain-and-ai-models/memory-dark.png" width="760" alt="Human memory systems paired with a language model's stores. Working memory, about four chunks kept active, pairs with the context window, a hundred thousand tokens or more held passively and used worst in the middle. Episodic memory, one-shot memories of one's own experiences, pairs with retrieval of documents, which are not the model's own past. Semantic memory, slowly consolidated facts, pairs with the weights, absorbed slowly in training. Consolidation by replay during sleep pairs with nothing: what happens in a conversation never reaches the weights" loading="lazy"></p> <p>The weights of a model hold what it absorbed slowly in training, distributed and not individually addressable, which is loosely like <em>semantic memory</em>: knowing that Paris is in France without remembering when you learned it.</p> <p>The context window holds the current conversation, available all at once and lost when it ends, which is loosely like <em>working memory</em>. Retrieval systems that search a database and paste documents into the context are loosely like recalling an <em>episode</em>.</p> <p>Each analogy breaks somewhere instructive. Human working memory holds about four chunks of meaning at a time<sup class="cite">[<a href="#ref-34" id="cite-37" data-ref="34" aria-label="Reference 34: Cowan, 2001. doi.org.">34</a>]</sup>; a context window holds a hundred thousand tokens and more.</p> <p>But models use long contexts unevenly: information in the middle is used worse than at the beginning or the end, a U-shaped curve that resembles the human serial-position effect<sup class="cite">[<a href="#ref-35" id="cite-38" data-ref="35" aria-label="Reference 35: Liu et al., 2024. doi.org.">35</a>]</sup>.</p> <p>Retrieval brings back documents, not the system’s own experiences. And attention itself is, mathematically, one update of an associative memory, the kind of network neuroscientists have long used as a model of memory recall<sup class="cite">[<a href="#ref-36" id="cite-39" data-ref="36" aria-label="Reference 36: Ramsauer et al., 2021. arxiv.org.">36</a>]</sup>; that is a statement about equations, not about the hippocampus.</p> <p>The deepest difference is consolidation. In the brain, what happens during the day is replayed during sleep: cells that fired together during a task fire together again, in sequences compressed about twentyfold (<a href="https://doi.org/10.1016/S0896-6273(02)01096-6">Lee &amp; Wilson, 2002</a>).</p> <p>Suppressing the ripples that carry this replay impairs memory, and prolonging them improves it<sup class="cite">[<a href="#ref-37" id="cite-40" data-ref="37" aria-label="Reference 37: Girardeau et al., 2009. doi.org.">37</a>, <a href="#ref-38" id="cite-41" data-ref="38" aria-label="Reference 38: Fernández-Ruiz et al., 2019. doi.org.">38</a>]</sup>. A deployed language model has no such step: nothing it learns in a conversation is written back into its weights.</p> <p>Training it further on new facts erases old ones, and standard deep networks trained continually slowly lose the ability to learn at all<sup class="cite">[<a href="#ref-39" id="cite-42" data-ref="39" aria-label="Reference 39: Dohare et al., 2024. doi.org.">39</a>]</sup>. Brains keep learning for a lifetime.</p> <h2 id="dopamine-and-reinforcement-learning">Dopamine and reinforcement learning</h2> <p>The cleanest case of a match runs in an unexpected direction. In the 1980s, reinforcement-learning researchers developed <em>temporal-difference learning</em>, in which an agent learns to predict future reward from the error between what it predicted and what it got.</p> <p>In 1997 Schultz, Dayan and Montague showed that dopamine neurons in the monkey midbrain fire exactly like that error<sup class="cite">[<a href="#ref-40" id="cite-43" data-ref="40" aria-label="Reference 40: Schultz et al., 1997. doi.org.">40</a>]</sup>. An unexpected drop of juice makes them burst.</p> <p>Once a light reliably predicts the juice, the burst moves to the light and the juice itself gets no response. If the juice then fails to arrive, the neurons fall silent at the moment it was due.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/brain-and-ai-models/dopamine-light.png" width="760" alt="Three panels of the prediction error of a temporal-difference model across one trial. Before learning, the error is a positive spike when the juice arrives. After learning, the spike has moved to the cue that predicts the juice, and there is nothing at the juice itself. When the juice is withheld after learning, there is a spike at the cue and a negative dip at the moment the juice was expected. These are the three patterns Schultz and colleagues recorded in dopamine neurons of monkeys" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/brain-and-ai-models/dopamine-dark.png" width="760" alt="Three panels of the prediction error of a temporal-difference model across one trial. Before learning, the error is a positive spike when the juice arrives. After learning, the spike has moved to the cue that predicts the juice, and there is nothing at the juice itself. When the juice is withheld after learning, there is a spike at the cue and a negative dip at the moment the juice was expected. These are the three patterns Schultz and colleagues recorded in dopamine neurons of monkeys" loading="lazy"></p> <p>The chart above is not a recording. It is a temporal-difference model computed for this post, and it reproduces all three patterns that the monkeys’ neurons showed.</p> <p>The story went further. In AI, <em>distributional</em> reinforcement learning predicts the whole range of possible rewards rather than their average, with some predictors optimistic and some pessimistic.</p> <p>Dabney and colleagues predicted that dopamine neurons would show the same diversity, and found it in recordings from mice: different neurons flipped from silence to firing at different reward sizes<sup class="cite">[<a href="#ref-41" id="cite-44" data-ref="41" aria-label="Reference 41: Dabney et al., 2020. doi.org.">41</a>]</sup>.</p> <p>In 2025 two more papers found dopamine neurons working at many timescales at once and encoding a map of both when and how much reward to expect<sup class="cite">[<a href="#ref-42" id="cite-45" data-ref="42" aria-label="Reference 42: Masset et al., 2025. doi.org.">42</a>, <a href="#ref-43" id="cite-46" data-ref="43" aria-label="Reference 43: Sousa et al., 2025. doi.org.">43</a>]</sup>.</p> <p>Two caveats keep this honest. The distributional result rests on tens of cells in five mice. And the prediction-error account itself has a serious challenger: a careful 2022 study concluded that dopamine release in the nucleus accumbens tracks causal associations rather than prediction errors<sup class="cite">[<a href="#ref-44" id="cite-47" data-ref="44" aria-label="Reference 44: Jeong et al., 2022. doi.org.">44</a>]</sup>.</p> <p>The analogy that people draw most often, between dopamine and the reinforcement learning that turns a language model into a chat assistant, is the weakest. Both use a single number to say “more of this”.</p> <p>But in <a href="/blog/2024/llms-for-those-who-missed-out/">RLHF</a> that number comes from a second model trained to guess human preferences, and optimising against it too hard makes answers worse<sup class="cite">[<a href="#ref-45" id="cite-48" data-ref="45" aria-label="Reference 45: Gao et al., 2023. arxiv.org.">45</a>]</sup> and more sycophantic<sup class="cite">[<a href="#ref-46" id="cite-49" data-ref="46" aria-label="Reference 46: Sharma et al., 2023. arxiv.org.">46</a>]</sup>. It also damaged GPT-4’s sense of its own reliability: before this training its confidence matched its accuracy almost perfectly, after it, ten times worse<sup class="cite">[<a href="#ref-47" id="cite-50" data-ref="47" aria-label="Reference 47: OpenAI, 2023. arxiv.org.">47</a>]</sup>.</p> <h2 id="intuitive-physics-robots-and-moravecs-paradox">Intuitive physics, robots and Moravec’s paradox</h2> <p>In 1988 the roboticist Hans Moravec noticed that what is hard for people, chess, logic, exams, was easy for computers, and what a one-year-old does without thinking, seeing and moving, was the hardest of all. Nearly forty years of progress have kept the paradox and given it numbers.</p> <p>Video models trained to predict the hidden parts of natural videos learn some intuitive physics: a model called V-JEPA tells a possible video from an impossible one, a ball that vanishes behind a screen or jumps from one place to another, 98% of the time on a classic test borrowed from infant research<sup class="cite">[<a href="#ref-48" id="cite-51" data-ref="48" aria-label="Reference 48: Garrido et al., 2025. arxiv.org.">48</a>]</sup>.</p> <p>On a harder version of the same test with more complex scenes, people are right 96.4% of the time and the best models are close to a coin flip.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/brain-and-ai-models/physics-light.png" width="760" alt="Accuracy at telling possible from impossible videos on the IntPhys 2 benchmark. People, by majority of three annotators, 96.4%. The best models are near chance at 50%: V-JEPA 2 57.5%, Gemini 2.5 Flash 55.6%, GPT-4o 53.8%, V-JEPA with RoPE 53.8%, Qwen-VL 2.5 52.3%, Cosmos-4B 49.4%" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/brain-and-ai-models/physics-dark.png" width="760" alt="Accuracy at telling possible from impossible videos on the IntPhys 2 benchmark. People, by majority of three annotators, 96.4%. The best models are near chance at 50%: V-JEPA 2 57.5%, Gemini 2.5 Flash 55.6%, GPT-4o 53.8%, V-JEPA with RoPE 53.8%, Qwen-VL 2.5 52.3%, Cosmos-4B 49.4%" loading="lazy"></p> <p>Robots now borrow knowledge from the web. RT-2, a vision-language model <a href="/blog/2025/adapters/">fine-tuned</a> to output robot actions, doubled the success of its predecessor on objects and settings it hadn’t seen, from 32% to 62%, and could follow instructions like “pick up the object that could be used as an improvised hammer”.</p> <p>Its authors were clear about the limit: “the robot does not acquire any ability to perform new motions”<sup class="cite">[<a href="#ref-49" id="cite-52" data-ref="49" aria-label="Reference 49: Brohan et al., 2023. arxiv.org.">49</a>]</sup>.</p> <p>V-JEPA 2, used as a world model to plan a robot arm’s movements, grasped a cup 65% of the time and a box 25%, spending 16 seconds planning each move<sup class="cite">[<a href="#ref-50" id="cite-53" data-ref="50" aria-label="Reference 50: Assran et al., 2025. arxiv.org.">50</a>]</sup>. No benchmark measures human and robot dexterity on the same tasks, which says something by itself.</p> <p>The brain-model link holds in motor control too, for a body simulated in detail. A network trained to drive a realistic virtual rat, imitating the movements of real rats, produced activity that predicted the neurons of real rats’ motor cortex and striatum better than any measured feature of their movements did<sup class="cite">[<a href="#ref-51" id="cite-54" data-ref="51" aria-label="Reference 51: Aldarondo et al., 2024. doi.org.">51</a>]</sup>.</p> <h2 id="which-brain-systems-have-an-ai-counterpart">Which brain systems have an AI counterpart</h2> <p>Put the evidence together and a map appears. Colour each brain system by how close the best AI counterpart is, judged by the studies above: strong where models predict the system’s activity or reproduce its signature, partial where they do some of its job without its properties, and absent where there is nothing to compare.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/brain-and-ai-models/modules-light.png" width="760" alt="The left hemisphere from the side and from the middle, coloured by how close an AI counterpart is. Visual cortex, auditory cortex and the language network: a close counterpart. Motor cortex, dorsolateral prefrontal cortex and the parahippocampal region: a partial one. The insula, the anterior cingulate and the ventromedial prefrontal cortex, which handle the body's state and emotion: none yet" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/brain-and-ai-models/modules-dark.png" width="760" alt="The left hemisphere from the side and from the middle, coloured by how close an AI counterpart is. Visual cortex, auditory cortex and the language network: a close counterpart. Motor cortex, dorsolateral prefrontal cortex and the parahippocampal region: a partial one. The insula, the anterior cingulate and the ventromedial prefrontal cortex, which handle the body's state and emotion: none yet" loading="lazy"></p> <p>The table names the systems behind the colours and the counterpart each was compared with.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/brain-and-ai-models/modtable-light.png" width="760" alt="A table of brain systems, their nearest AI counterparts and the state of the match. Strong: vision and vision networks, which predict the ventral stream though gains have stopped; hearing and speech and models like Whisper, which predict the auditory-to-language hierarchy; the language network and language models, which predict it mostly through word meaning; the dopamine teaching signal and temporal-difference learning, which predicted new properties of neurons. Partial: the hippocampus and space, where grid-like units appear only by design and there is no consolidation; motor cortex and robot policies, which gained web knowledge but no new motions; prefrontal control and reasoning models, without a brain-level match. Absent: the insula and interoception, with no body to sense, and sleep and neuromodulators, with no counterpart" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/brain-and-ai-models/modtable-dark.png" width="760" alt="A table of brain systems, their nearest AI counterparts and the state of the match. Strong: vision and vision networks, which predict the ventral stream though gains have stopped; hearing and speech and models like Whisper, which predict the auditory-to-language hierarchy; the language network and language models, which predict it mostly through word meaning; the dopamine teaching signal and temporal-difference learning, which predicted new properties of neurons. Partial: the hippocampus and space, where grid-like units appear only by design and there is no consolidation; motor cortex and robot policies, which gained web knowledge but no new motions; prefrontal control and reasoning models, without a brain-level match. Absent: the insula and interoception, with no body to sense, and sleep and neuromodulators, with no counterpart" loading="lazy"></p> <p>The strongest matches are the sensory and language systems, and the dopamine teaching signal. They have something in common: each was matched by a model trained on a large amount of the same kind of input the brain gets, to do a similar job, and the similarity grew out of the training rather than being built in.</p> <p>The weakest are the systems that run the body, keep track of the self and keep learning over a lifetime.</p> <h2 id="is-the-brain-more-efficient-than-ai">Is the brain more efficient than AI?</h2> <p>This is the question where the most nonsense is written, so the numbers here come with their units and their uncertainty.</p> <h3 id="energy">Energy</h3> <p>The usual figure is that a brain runs on 20 watts. That is the energy of the glucose it burns; positron emission tomography puts it nearer 17 W, and only about 6 W of that becomes ATP that can do work.</p> <p>Most of the brain’s energy goes into moving signals rather than computing with them: in an audit of the human cortex, long-distance communication cost about 3.5 W and computation in the narrow sense, at the synapses, about 0.1 W<sup class="cite">[<a href="#ref-52" id="cite-55" data-ref="52" aria-label="Reference 52: Levy &amp; Calvert, 2021. doi.org.">52</a>]</sup>. Computers have the same problem, where moving data costs more energy than the arithmetic on it.</p> <p>Training is where AI looks extravagant. Twenty years of a 20-watt brain come to about 3.5 megawatt-hours. Training GPT-3 took 1,287 MWh<sup class="cite">[<a href="#ref-53" id="cite-56" data-ref="53" aria-label="Reference 53: Patterson et al., 2021. arxiv.org.">53</a>]</sup>, Llama 3.1 405B 30.84 million GPU-hours, which comes to about 22 GWh for the GPUs alone<sup class="cite">[<a href="#ref-54" id="cite-57" data-ref="54" aria-label="Reference 54: Meta, 2024. arxiv.org.">54</a>]</sup>, and Epoch AI estimates Grok 4 at about 310 GWh<sup class="cite">[<a href="#ref-55" id="cite-58" data-ref="55" aria-label="Reference 55: Epoch AI, 2025. epoch.ai.">55</a>]</sup>.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/brain-and-ai-models/energy-light.png" width="760" alt="Two bar charts on log scales. To train: a brain over 20 years at 20 watts uses 3.5 megawatt-hours, GPT-3's training 1,287, Llama 3.1 405B about 21,600 for its GPUs alone, Grok 4 an estimated 310,000. To answer: a brain in one minute uses 0.33 watt-hours, a median Gemini prompt 0.24, a typical GPT-4o query 0.3, a GPT-4o query with 10,000 tokens of input 2.5 and with 100,000 tokens about 40" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/brain-and-ai-models/energy-dark.png" width="760" alt="Two bar charts on log scales. To train: a brain over 20 years at 20 watts uses 3.5 megawatt-hours, GPT-3's training 1,287, Llama 3.1 405B about 21,600 for its GPUs alone, Grok 4 an estimated 310,000. To answer: a brain in one minute uses 0.33 watt-hours, a median Gemini prompt 0.24, a typical GPT-4o query 0.3, a GPT-4o query with 10,000 tokens of input 2.5 and with 100,000 tokens about 40" loading="lazy"></p> <p>But training is paid once and shared by everyone who uses the model afterwards. An answer from a chatbot is cheap: Google measured 0.24 watt-hours for a median Gemini text prompt in 2025, after a 33-fold drop in a year<sup class="cite">[<a href="#ref-56" id="cite-59" data-ref="56" aria-label="Reference 56: Elsworth et al., 2025. arxiv.org.">56</a>]</sup>, and Epoch AI estimates about 0.3 Wh for a typical GPT-4o query<sup class="cite">[<a href="#ref-57" id="cite-60" data-ref="57" aria-label="Reference 57: You, 2025. epoch.ai.">57</a>]</sup>.</p> <p>That is the energy a brain uses in about 45 seconds. Long prompts and reasoning cost much more.</p> <p>Per operation the comparison is speculative, because a brain doesn’t do floating-point operations. The most careful estimate puts the computation needed to match a brain at about 10¹⁵ operations per second, with a plausible range from 10¹³ to 10¹⁷<sup class="cite">[<a href="#ref-58" id="cite-61" data-ref="58" aria-label="Reference 58: Carlsmith, 2020. openphilanthropy.org.">58</a>]</sup>.</p> <p>On the central estimate, a brain does about 5 × 10¹³ operations per joule and an H100 GPU at its peak about 1.4 × 10¹², so the brain is some tens of times more efficient; across the range, anywhere from three times worse to a few thousand times better.</p> <h3 id="data">Data</h3> <p>Here the gap is larger and much less uncertain. A child hears somewhere between ten and a hundred million words before adolescence<sup class="cite">[<a href="#ref-59" id="cite-62" data-ref="59" aria-label="Reference 59: Frank, 2023. doi.org.">59</a>]</sup>; Llama 3.1 was trained on 15.6 trillion tokens, each a little less than a word<sup class="cite">[<a href="#ref-54" id="cite-63" data-ref="54" aria-label="Reference 54: Meta, 2024. arxiv.org.">54</a>]</sup>. That is five to six orders of magnitude.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/brain-and-ai-models/data-light.png" width="760" alt="Words and tokens on a log scale. A child hears between 6 and 60 million words by age 5, up to about 100 million by age 13, and 30 to 400 million words by age 20 including reading. The BabyLM challenge allows 100 million words. GPT-3 was trained on 500 billion tokens and Llama 3.1 on 15.6 trillion" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/brain-and-ai-models/data-dark.png" width="760" alt="Words and tokens on a log scale. A child hears between 6 and 60 million words by age 5, up to about 100 million by age 13, and 30 to 400 million words by age 20 including reading. The BabyLM challenge allows 100 million words. GPT-3 was trained on 500 billion tokens and Llama 3.1 on 15.6 trillion" loading="lazy"></p> <p>The comparison is not quite fair to the child, who also sees, touches, moves and is taught by people who care, and arrives with priors that evolution spent a long time on. It is also not quite fair to the model, which has to learn from text alone what a child gets from the world.</p> <p>The BabyLM challenge trains models on a child’s budget of 100 million words: the best come within a few points of people on tests of grammar and stay near chance on world knowledge<sup class="cite">[<a href="#ref-60" id="cite-64" data-ref="60" aria-label="Reference 60: Hu et al., 2024. arxiv.org.">60</a>]</sup>.</p> <h3 id="speed-and-breadth">Speed and breadth</h3> <p>The models win where machines always win. A neuron fires at most a few hundred times a second; a model writes a page while a person reads a sentence. A model can be copied a million times, read a library in a day and remember the details.</p> <p>One synapse stores about 4.7 bits<sup class="cite">[<a href="#ref-61" id="cite-65" data-ref="61" aria-label="Reference 61: Bartol et al., 2015. doi.org.">61</a>]</sup>, one parameter of a language model about 3.6 bits<sup class="cite">[<a href="#ref-62" id="cite-66" data-ref="62" aria-label="Reference 62: Morris et al., 2025. arxiv.org.">62</a>]</sup>, and a large model has hundreds to thousands of times fewer parameters than a brain has synapses while knowing far more facts than any person.</p> <p class="takeaway">Per answer, a chatbot costs about a minute of brain time. Per lesson learned, the brain is cheaper by orders of magnitude in data, and probably in energy too.</p> <h2 id="what-ai-models-still-lack">What AI models still lack</h2> <p>A list of what the brain has and AI models don’t would be long. Five items on it come up again and again in the evidence.</p> <p><em>Learning that never stops.</em> People learn from one example and keep learning for decades without forgetting what they knew. Models learn from millions of examples, in a separate training phase, and forget when trained further<sup class="cite">[<a href="#ref-39" id="cite-67" data-ref="39" aria-label="Reference 39: Dohare et al., 2024. doi.org.">39</a>]</sup>.</p> <p>The brain’s solution seems to involve two learning systems, a fast hippocampus and a slow cortex, and sleep to move memories between them<sup class="cite">[<a href="#ref-63" id="cite-68" data-ref="63" aria-label="Reference 63: Kumaran et al., 2016. doi.org.">63</a>]</sup>; nothing like that runs in a deployed model.</p> <p><em>A body.</em> The systems that the models match best, language and vision, are the ones that can be trained from data on the internet. The ones they match worst, movement, intuitive physics and space, are the ones a body learns by acting.</p> <p><em>Wanting something.</em> A brain is driven by needs, curiosity and a reward system tuned by evolution. A model optimises what its trainers chose, and does nothing when nobody asks it anything.</p> <p><em>Knowing what it doesn’t know.</em> People are imperfect judges of their own knowledge, but they can usually tell a guess from a memory. Models trained to please are confidently wrong, and users trust long, fluent explanations more than they should<sup class="cite">[<a href="#ref-64" id="cite-69" data-ref="64" aria-label="Reference 64: Steyvers et al., 2025. doi.org.">64</a>]</sup>.</p> <p><em>Sleep and neuromodulation.</em> The brain changes its own learning rate, attention and mood with a handful of chemicals, and reorganises its memories every night. There is no clear counterpart in any current AI system.</p> <p>Whether there is something it is like to be a model, the question of consciousness, is a separate story, and a hard one.</p> <p>The most careful attempt so far, which checked current systems against the signatures that the leading scientific theories of consciousness predict, concluded that no current AI system is conscious and that there is no obvious technical barrier to building one that would meet those signatures<sup class="cite">[<a href="#ref-65" id="cite-70" data-ref="65" aria-label="Reference 65: Butlin et al., 2023. arxiv.org.">65</a>]</sup>.</p> <h2 id="what-the-comparison-shows">What the comparison shows</h2> <p>Five conclusions seem safe.</p> <p>First, the convergence is real. Networks trained only to do what the brain does, recognise objects, predict words, predict reward, have repeatedly turned out to resemble the brain more than models designed to resemble it.</p> <p>The likeliest reason is not that engineers copied the brain, but that the same problem, solved from the same kind of data, pushes any good solution toward similar representations.</p> <p>Second, the resemblance is mostly in <em>what</em> is represented, not <em>how</em> it is computed. A transformer reads a whole sentence at once; the brain hears it one word after another. Linear maps find shared information in very different machinery.</p> <p>Third, the similarity scores have saturated, and our methods are part of the reason. Better models stopped becoming more brain-like in vision, and in language much of the measured similarity is word meaning and statistics of the experiment.</p> <p>Fourth, a language model is a model of one part of the brain. It matches the language network, which in people is not where thinking happens, and everything else it does has to be compared with other systems, one at a time.</p> <p>Fifth, the brain is not a slower GPU. It learns from far less, on less energy, all its life, inside a body, and the systems where models are furthest from it are the ones that make that possible.</p> <p>The figures, the TD-learning model behind the dopamine chart and the preparation of the language atlas as code: <a href="https://github.com/xmarva/transformers-from-scratch/tree/main/articles/brain_ai">articles/brain_ai</a>.</p> <h2 id="references">References</h2> <ol class="tfs-refs"> <li id="ref-1">Tuckute et al., 2024. <a href="https://doi.org/10.1038/s41562-023-01783-7">doi.org</a>. <a class="ref-back" href="#cite-1" aria-label="Back to the text">↩</a></li> <li id="ref-2">Khaligh-Razavi &amp; Kriegeskorte, 2014. <a href="https://doi.org/10.1371/journal.pcbi.1003915">doi.org</a>. <a class="ref-back" href="#cite-2" aria-label="Back to the text">↩</a></li> <li id="ref-3">Caucheteux &amp; King, 2022. <a href="https://doi.org/10.1038/s42003-022-03036-1">doi.org</a>. <a class="ref-back" href="#cite-3" aria-label="Back to the text">↩</a></li> <li id="ref-4">Schrimpf et al., 2021. <a href="https://doi.org/10.1073/pnas.2105646118">doi.org</a>. <a class="ref-back" href="#cite-4" aria-label="Back to the text">↩</a></li> <li id="ref-5">Hadidi et al., 2026. <a href="https://doi.org/10.1038/s41467-026-72253-7">doi.org</a>. <a class="ref-back" href="#cite-5" aria-label="Back to the text">↩</a></li> <li id="ref-6">Antonello et al., 2023. <a href="https://arxiv.org/abs/2305.11863">arxiv.org</a>. <a class="ref-back" href="#cite-8" aria-label="Back to the text">↩</a></li> <li id="ref-7">Hosseini et al., 2024. <a href="https://doi.org/10.1162/nol_a_00137">doi.org</a>. <a class="ref-back" href="#cite-9" aria-label="Back to the text">↩</a></li> <li id="ref-8">Kauf et al., 2024. <a href="https://doi.org/10.1162/nol_a_00116">doi.org</a>. <a class="ref-back" href="#cite-10" aria-label="Back to the text">↩</a></li> <li id="ref-9">Goldstein et al., 2022. <a href="https://doi.org/10.1038/s41593-022-01026-4">doi.org</a>. <a class="ref-back" href="#cite-12" aria-label="Back to the text">↩</a></li> <li id="ref-10">Schönmann et al., 2026. <a href="https://doi.org/10.7554/eLife.106543">doi.org</a>. <a class="ref-back" href="#cite-13" aria-label="Back to the text">↩</a></li> <li id="ref-11">Fedorenko &amp; Varley, 2016. <a href="https://doi.org/10.1111/nyas.13046">doi.org</a>. <a class="ref-back" href="#cite-14" aria-label="Back to the text">↩</a></li> <li id="ref-12">Fedorenko et al., 2024. <a href="https://doi.org/10.1038/s41583-024-00802-4">doi.org</a>. <a class="ref-back" href="#cite-15" aria-label="Back to the text">↩</a></li> <li id="ref-13">Mahowald et al., 2024. <a href="https://doi.org/10.1016/j.tics.2024.01.011">doi.org</a>. <a class="ref-back" href="#cite-16" aria-label="Back to the text">↩</a></li> <li id="ref-14">AlKhamissi et al., 2025. <a href="https://arxiv.org/abs/2503.01830">arxiv.org</a>. <a class="ref-back" href="#cite-17" aria-label="Back to the text">↩</a></li> <li id="ref-15">Tang et al., 2023. <a href="https://doi.org/10.1038/s41593-023-01304-9">doi.org</a>. <a class="ref-back" href="#cite-18" aria-label="Back to the text">↩</a></li> <li id="ref-16">Card et al., 2024. <a href="https://doi.org/10.1056/NEJMoa2314132">doi.org</a>. <a class="ref-back" href="#cite-19" aria-label="Back to the text">↩</a></li> <li id="ref-17">Yamins et al., 2014. <a href="https://doi.org/10.1073/pnas.1403112111">doi.org</a>. <a class="ref-back" href="#cite-20" aria-label="Back to the text">↩</a></li> <li id="ref-18">Schrimpf et al., 2018. <a href="https://doi.org/10.1101/407007">doi.org</a>. <a class="ref-back" href="#cite-21" aria-label="Back to the text">↩</a></li> <li id="ref-19">Linsley et al., 2023. <a href="https://arxiv.org/abs/2306.03779">arxiv.org</a>. <a class="ref-back" href="#cite-22" aria-label="Back to the text">↩</a></li> <li id="ref-20">Gokce &amp; Schrimpf, 2025. <a href="https://arxiv.org/abs/2411.05712">arxiv.org</a>. <a class="ref-back" href="#cite-23" aria-label="Back to the text">↩</a></li> <li id="ref-21">Conwell et al., 2024. <a href="https://doi.org/10.1038/s41467-024-53147-y">doi.org</a>. <a class="ref-back" href="#cite-24" aria-label="Back to the text">↩</a></li> <li id="ref-22">Geirhos et al., 2019. <a href="https://arxiv.org/abs/1811.12231">arxiv.org</a>. <a class="ref-back" href="#cite-25" aria-label="Back to the text">↩</a></li> <li id="ref-23">Bonnen et al., 2024. <a href="https://arxiv.org/abs/2409.05862">arxiv.org</a>. <a class="ref-back" href="#cite-26" aria-label="Back to the text">↩</a></li> <li id="ref-24">Ramakrishnan et al., 2025. <a href="https://arxiv.org/abs/2410.06468">arxiv.org</a>. <a class="ref-back" href="#cite-27" aria-label="Back to the text">↩</a></li> <li id="ref-25">Guo et al., 2022. <a href="https://arxiv.org/abs/2206.11228">arxiv.org</a>. <a class="ref-back" href="#cite-28" aria-label="Back to the text">↩</a></li> <li id="ref-26">Elsayed et al., 2018. <a href="https://arxiv.org/abs/1802.08195">arxiv.org</a>. <a class="ref-back" href="#cite-29" aria-label="Back to the text">↩</a></li> <li id="ref-27">Allen et al., 2022. <a href="https://doi.org/10.1038/s41593-021-00962-x">doi.org</a>. <a class="ref-back" href="#cite-30" aria-label="Back to the text">↩</a></li> <li id="ref-28">Scotti et al., 2024. <a href="https://arxiv.org/abs/2403.11207">arxiv.org</a>. <a class="ref-back" href="#cite-31" aria-label="Back to the text">↩</a></li> <li id="ref-29">Shirakawa et al., 2025. <a href="https://arxiv.org/abs/2405.10078">arxiv.org</a>. <a class="ref-back" href="#cite-32" aria-label="Back to the text">↩</a></li> <li id="ref-30">Hafting et al., 2005. <a href="https://doi.org/10.1038/nature03721">doi.org</a>. <a class="ref-back" href="#cite-33" aria-label="Back to the text">↩</a></li> <li id="ref-31">Banino et al., 2018. <a href="https://doi.org/10.1038/s41586-018-0102-6">doi.org</a>. <a class="ref-back" href="#cite-34" aria-label="Back to the text">↩</a></li> <li id="ref-32">Schaeffer et al., 2022. <a href="https://doi.org/10.1101/2022.08.07.503109">doi.org</a>. <a class="ref-back" href="#cite-35" aria-label="Back to the text">↩</a></li> <li id="ref-33">Vafa et al., 2024. <a href="https://arxiv.org/abs/2406.03689">arxiv.org</a>. <a class="ref-back" href="#cite-36" aria-label="Back to the text">↩</a></li> <li id="ref-34">Cowan, 2001. <a href="https://doi.org/10.1017/S0140525X01003922">doi.org</a>. <a class="ref-back" href="#cite-37" aria-label="Back to the text">↩</a></li> <li id="ref-35">Liu et al., 2024. <a href="https://doi.org/10.1162/tacl_a_00638">doi.org</a>. <a class="ref-back" href="#cite-38" aria-label="Back to the text">↩</a></li> <li id="ref-36">Ramsauer et al., 2021. <a href="https://arxiv.org/abs/2008.02217">arxiv.org</a>. <a class="ref-back" href="#cite-39" aria-label="Back to the text">↩</a></li> <li id="ref-37">Girardeau et al., 2009. <a href="https://doi.org/10.1038/nn.2384">doi.org</a>. <a class="ref-back" href="#cite-40" aria-label="Back to the text">↩</a></li> <li id="ref-38">Fernández-Ruiz et al., 2019. <a href="https://doi.org/10.1126/science.aax0758">doi.org</a>. <a class="ref-back" href="#cite-41" aria-label="Back to the text">↩</a></li> <li id="ref-39">Dohare et al., 2024. <a href="https://doi.org/10.1038/s41586-024-07711-7">doi.org</a>. <a class="ref-back" href="#cite-42" aria-label="Back to the text">↩</a></li> <li id="ref-40">Schultz et al., 1997. <a href="https://doi.org/10.1126/science.275.5306.1593">doi.org</a>. <a class="ref-back" href="#cite-43" aria-label="Back to the text">↩</a></li> <li id="ref-41">Dabney et al., 2020. <a href="https://doi.org/10.1038/s41586-019-1924-6">doi.org</a>. <a class="ref-back" href="#cite-44" aria-label="Back to the text">↩</a></li> <li id="ref-42">Masset et al., 2025. <a href="https://doi.org/10.1038/s41586-025-08929-9">doi.org</a>. <a class="ref-back" href="#cite-45" aria-label="Back to the text">↩</a></li> <li id="ref-43">Sousa et al., 2025. <a href="https://doi.org/10.1038/s41586-025-09089-6">doi.org</a>. <a class="ref-back" href="#cite-46" aria-label="Back to the text">↩</a></li> <li id="ref-44">Jeong et al., 2022. <a href="https://doi.org/10.1126/science.abq6740">doi.org</a>. <a class="ref-back" href="#cite-47" aria-label="Back to the text">↩</a></li> <li id="ref-45">Gao et al., 2023. <a href="https://arxiv.org/abs/2210.10760">arxiv.org</a>. <a class="ref-back" href="#cite-48" aria-label="Back to the text">↩</a></li> <li id="ref-46">Sharma et al., 2023. <a href="https://arxiv.org/abs/2310.13548">arxiv.org</a>. <a class="ref-back" href="#cite-49" aria-label="Back to the text">↩</a></li> <li id="ref-47">OpenAI, 2023. <a href="https://arxiv.org/abs/2303.08774">arxiv.org</a>. <a class="ref-back" href="#cite-50" aria-label="Back to the text">↩</a></li> <li id="ref-48">Garrido et al., 2025. <a href="https://arxiv.org/abs/2502.11831">arxiv.org</a>. <a class="ref-back" href="#cite-51" aria-label="Back to the text">↩</a></li> <li id="ref-49">Brohan et al., 2023. <a href="https://arxiv.org/abs/2307.15818">arxiv.org</a>. <a class="ref-back" href="#cite-52" aria-label="Back to the text">↩</a></li> <li id="ref-50">Assran et al., 2025. <a href="https://arxiv.org/abs/2506.09985">arxiv.org</a>. <a class="ref-back" href="#cite-53" aria-label="Back to the text">↩</a></li> <li id="ref-51">Aldarondo et al., 2024. <a href="https://doi.org/10.1038/s41586-024-07633-4">doi.org</a>. <a class="ref-back" href="#cite-54" aria-label="Back to the text">↩</a></li> <li id="ref-52">Levy &amp; Calvert, 2021. <a href="https://doi.org/10.1073/pnas.2008173118">doi.org</a>. <a class="ref-back" href="#cite-55" aria-label="Back to the text">↩</a></li> <li id="ref-53">Patterson et al., 2021. <a href="https://arxiv.org/abs/2104.10350">arxiv.org</a>. <a class="ref-back" href="#cite-56" aria-label="Back to the text">↩</a></li> <li id="ref-54">Meta, 2024. <a href="https://arxiv.org/abs/2407.21783">arxiv.org</a>. <a class="ref-back" href="#cite-57" aria-label="Back to the text">↩</a></li> <li id="ref-55">Epoch AI, 2025. <a href="https://epoch.ai/data-insights/grok-4-training-resources">epoch.ai</a>. <a class="ref-back" href="#cite-58" aria-label="Back to the text">↩</a></li> <li id="ref-56">Elsworth et al., 2025. <a href="https://arxiv.org/abs/2508.15734">arxiv.org</a>. <a class="ref-back" href="#cite-59" aria-label="Back to the text">↩</a></li> <li id="ref-57">You, 2025. <a href="https://epoch.ai/gradient-updates/how-much-energy-does-chatgpt-use">epoch.ai</a>. <a class="ref-back" href="#cite-60" aria-label="Back to the text">↩</a></li> <li id="ref-58">Carlsmith, 2020. <a href="https://www.openphilanthropy.org/research/how-much-computational-power-does-it-take-to-match-the-human-brain/">openphilanthropy.org</a>. <a class="ref-back" href="#cite-61" aria-label="Back to the text">↩</a></li> <li id="ref-59">Frank, 2023. <a href="https://doi.org/10.1016/j.tics.2023.08.007">doi.org</a>. <a class="ref-back" href="#cite-62" aria-label="Back to the text">↩</a></li> <li id="ref-60">Hu et al., 2024. <a href="https://arxiv.org/abs/2412.05149">arxiv.org</a>. <a class="ref-back" href="#cite-64" aria-label="Back to the text">↩</a></li> <li id="ref-61">Bartol et al., 2015. <a href="https://doi.org/10.7554/eLife.10778">doi.org</a>. <a class="ref-back" href="#cite-65" aria-label="Back to the text">↩</a></li> <li id="ref-62">Morris et al., 2025. <a href="https://arxiv.org/abs/2505.24832">arxiv.org</a>. <a class="ref-back" href="#cite-66" aria-label="Back to the text">↩</a></li> <li id="ref-63">Kumaran et al., 2016. <a href="https://doi.org/10.1016/j.tics.2016.05.004">doi.org</a>. <a class="ref-back" href="#cite-68" aria-label="Back to the text">↩</a></li> <li id="ref-64">Steyvers et al., 2025. <a href="https://doi.org/10.1038/s42256-024-00976-7">doi.org</a>. <a class="ref-back" href="#cite-69" aria-label="Back to the text">↩</a></li> <li id="ref-65">Butlin et al., 2023. <a href="https://arxiv.org/abs/2308.08708">arxiv.org</a>. <a class="ref-back" href="#cite-70" aria-label="Back to the text">↩</a></li> </ol>]]></content> <author> <name>Eva Koroleva</name> </author> <category term="cognitive-science"/> <category term="machine-learning"/> <category term="neuroscience"/> <category term="ai"/> <category term="llm"/> <category term="brain"/> <category term="cognitive-science"/> <summary type="html"><![CDATA[A decade of neuroscience has compared brains with neural networks. Language models predict the brain's language network, vision models the visual cortex and reinforcement learning the dopamine signal, while memory, bodies, energy and lifelong learning are where the two still differ most]]></summary> <media:thumbnail url="https://blog.korolevalab.com/assets/posts/brain-and-ai-models/cover.png"/> <media:content medium="image" url="https://blog.korolevalab.com/assets/posts/brain-and-ai-models/cover.png"/> </entry> <entry> <title type="html">T5 and BART: the encoder–decoder, and a model that writes SQL</title> <link href="https://blog.korolevalab.com/blog/2026/transformer-architectures-05-t5/" rel="alternate" type="text/html" title="T5 and BART: the encoder–decoder, and a model that writes SQL"/> <published>2026-05-15T14:00:00+00:00</published> <updated>2026-11-08T00:00:00+00:00</updated> <id>https://blog.korolevalab.com/blog/2026/transformer-architectures-05-t5</id> <content type="html" xml:base="https://blog.korolevalab.com/blog/2026/transformer-architectures-05-t5/"><![CDATA[<p class="tfs-links"><strong>Transformer architectures: from BERT to diffusion</strong> · lesson 5 of 15 · <a href="/teaching/">all lessons</a> · <a href="https://www.kaggle.com/code/qmarva/transformer-architectures-05-t5-bart">run on Kaggle</a> · <a href="https://colab.research.google.com/github/xmarva/transformers-from-scratch/blob/main/notebooks/colab/a05_t5.ipynb">open in Colab</a> · <a href="https://github.com/xmarva/transformers-from-scratch">code on GitHub</a></p> <p>In 1961 four researchers at MIT’s Lincoln Laboratory fed a computer questions on punched cards, such as “Where did the Red Sox play on July 7?” Their program, BASEBALL, turned each one into a list, <code class="language-plaintext highlighter-rouge">Place = ? Team = Red Sox Month = July Day = 7</code>, looked the answer up in the results of one American League season and printed it<sup class="cite">[<a href="#ref-1" id="cite-1" data-ref="1" aria-label="Reference 1: Green, B. F., Wolf, A. K., Chomsky, C., &amp; Laughery, K. (1961). Baseball: an automatic question-answerer. Western Joint IRE-AIEE-ACM Computer Conference, 219–224.">1</a>]</sup>.</p> <p>The authors had bigger plans: “the business executive, the military commander, and the scientist need to ask questions of the computer in ordinary English”.</p> <p>Sixty-five years later, asking a database in English is a common feature, and the benchmark everyone measured it on, Spider, went from 12.4% of queries exactly right for the best model of 2018 to 86.6% of queries returning the right result for GPT-4 with careful prompting in 2023.</p> <p>Then came Spider 2.0, built from real company databases “often containing over 1,000 columns”, and o1-preview solved 21.3% of its tasks <sup class="cite">[<a href="#ref-2" id="cite-2" data-ref="2" aria-label="Reference 2: Lei, F., Chen, J., Ye, Y., et al. (2025). Spider 2.0: evaluating language models on real-world enterprise text-to-SQL workflows. ICLR 2025.">2</a>]</sup>.</p> <p>A question in English and a query in SQL are two languages, and the architecture built for translating between languages is the encoder–decoder. Its most influential member is T5, Google’s model of 2019 that turned every task into text in, text out.</p> <p>For a while encoder–decoders led Spider: in 2021 T5-3B with a constrained decoder reached 75.1% on the test set. Then decoder-only models took over. But T5 never left: its encoder turns your prompt into the conditioning of Stable Diffusion 3 and FLUX, and in 2025 Google turned Gemma into an encoder–decoder.</p> <p>In this lesson you will write T5 yourself, load Google’s weights into it, look at what makes it different from BERT and GPT, and fine-tune it on Spider for 20 minutes on a free GPU. Then you will run every query it writes and see which ones are right.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/05/hero-light.png" width="760" alt="A question and the database's schema go into T5's encoder, which reads all of it at once. The decoder writes an SQL query one token at a time, looking back at the encoder's output through cross-attention. The query is then run on the SQLite database, and its result is compared with the result of the correct query" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/05/hero-dark.png" width="760" alt="A question and the database's schema go into T5's encoder, which reads all of it at once. The decoder writes an SQL query one token at a time, looking back at the encoder's output through cross-attention. The query is then run on the SQLite database, and its result is compared with the result of the correct query" loading="lazy"></p> <p><strong>What you’ll do</strong></p> <ol> <li>See how T5 turns every task into text in, text out, and make the smallest T5 translate, judge grammar and score similarity from a prefix.</li> <li>Take the encoder–decoder apart: an encoder that reads the whole input, a decoder that writes, and the cross-attention that connects them.</li> <li>Write T5 in PyTorch, with its unusual parts: a norm without a mean, attention without scaling and positions as 32 learned biases. Load Google’s weights into it and match Hugging Face’s outputs.</li> <li>Look at what the position buckets learned, and watch the decoder find the source words while it translates.</li> <li>Corrupt text the way T5 and BART were pre-trained, and let both models repair it.</li> <li>Teach T5 to write SQL for databases it has never seen, check every query by running it, and let SQLite pick the best of several attempts.</li> </ol> <p><strong>What you need</strong>: a GPU. On Kaggle, <em>Settings → Accelerator → GPU</em>; on Colab, <em>Runtime → Change runtime type → T4 GPU</em>. The notebook downloads t5-small and t5-base (1.1 GB), BART (560 MB) and the Spider databases (200 MB), and fine-tunes T5 for 20 minutes; on a T4 it runs in about 45 minutes.</p> <h2 id="setup">Setup</h2> <p>One small helper package, <code class="language-plaintext highlighter-rouge">tfs</code>, draws the course’s plots and token chips and knows where the notebook runs (Kaggle, Colab or your own machine). Everything the lesson teaches is written out in the notebook itself.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">importlib.util</span>
<span class="kn">import</span> <span class="n">subprocess</span>
<span class="kn">import</span> <span class="n">sys</span>

<span class="n">TFS</span> <span class="o">=</span> <span class="sh">"</span><span class="s">git+https://github.com/xmarva/transformers-from-scratch@main</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">importlib</span><span class="p">.</span><span class="n">util</span><span class="p">.</span><span class="nf">find_spec</span><span class="p">(</span><span class="sh">"</span><span class="s">tfs</span><span class="sh">"</span><span class="p">)</span> <span class="ow">is</span> <span class="bp">None</span><span class="p">:</span>
    <span class="n">subprocess</span><span class="p">.</span><span class="nf">check_call</span><span class="p">([</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">-m</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">pip</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">install</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-q</span><span class="sh">"</span><span class="p">,</span> <span class="n">TFS</span><span class="p">])</span>

<span class="kn">from</span> <span class="n">tfs</span> <span class="kn">import</span> <span class="n">env</span>
<span class="kn">from</span> <span class="n">tfs.viz</span> <span class="kn">import</span> <span class="n">table</span><span class="p">,</span> <span class="n">token_chips</span><span class="p">,</span> <span class="n">use_course_style</span>

<span class="n">env</span><span class="p">.</span><span class="nf">quiet</span><span class="p">()</span>  <span class="c1"># no progress bars or environment warnings in the outputs
</span><span class="n">SEED</span> <span class="o">=</span> <span class="mi">42</span>
<span class="n">env</span><span class="p">.</span><span class="nf">seed_everything</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">COLORS</span> <span class="o">=</span> <span class="nf">use_course_style</span><span class="p">()</span>
<span class="n">WORK_DIR</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">work_dir</span><span class="p">()</span>
</code></pre></div></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">json</span>
<span class="kn">import</span> <span class="n">math</span>
<span class="kn">import</span> <span class="n">random</span>
<span class="kn">import</span> <span class="n">re</span>
<span class="kn">import</span> <span class="n">sqlite3</span>
<span class="kn">import</span> <span class="n">time</span>
<span class="kn">import</span> <span class="n">zipfile</span>
<span class="kn">from</span> <span class="n">collections</span> <span class="kn">import</span> <span class="n">Counter</span>

<span class="kn">import</span> <span class="n">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>
<span class="kn">import</span> <span class="n">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="n">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">import</span> <span class="n">torch</span>
<span class="kn">import</span> <span class="n">torch.nn</span> <span class="k">as</span> <span class="n">nn</span>
<span class="kn">import</span> <span class="n">torch.nn.functional</span> <span class="k">as</span> <span class="n">F</span>
<span class="kn">from</span> <span class="n">huggingface_hub</span> <span class="kn">import</span> <span class="n">hf_hub_download</span>
<span class="kn">from</span> <span class="n">matplotlib.colors</span> <span class="kn">import</span> <span class="n">LinearSegmentedColormap</span>
<span class="kn">from</span> <span class="n">safetensors.torch</span> <span class="kn">import</span> <span class="n">load_file</span>
<span class="kn">from</span> <span class="n">tfs.viz</span> <span class="kn">import</span> <span class="n">heatmap</span>
<span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">AutoTokenizer</span>
<span class="c1"># the reference implementations, for the checks
</span><span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">BartForConditionalGeneration</span><span class="p">,</span> <span class="n">T5ForConditionalGeneration</span>

<span class="n">SMOKE</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">smoke</span><span class="p">()</span>  <span class="c1"># CI runs the lesson on a small slice; you run it in full
</span><span class="n">device</span> <span class="o">=</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">if</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">is_available</span><span class="p">()</span> <span class="k">else</span> <span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span>
<span class="k">assert</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="ow">or</span> <span class="n">SMOKE</span><span class="p">,</span> <span class="sh">"</span><span class="s">This lesson fine-tunes a model for 20 minutes: use a GPU</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">GPU:</span><span class="sh">"</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">get_device_name</span><span class="p">(</span><span class="mi">0</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>GPU: Tesla T4</code></pre> <h2 id="1-every-task-as-text">1. Every task as text</h2> <p>In October 2019 a Google team published a 67-page study built on one idea: “Every task we consider—including translation, question answering, and classification—is cast as feeding our model text as input and training it to generate some target text”<sup class="cite">[<a href="#ref-3" id="cite-3" data-ref="3" aria-label="Reference 3: Raffel, C., Shazeer, N., Roberts, A., Lee, K., Narang, S., Matena, M., Zhou, Y., Li, W., &amp; Liu, P. J. (2020). Exploring the limits of transfer learning with a unified text-to-text transformer. Journal of Machine Learning Research, 21(140), 1–67.">3</a>]</sup>. They named the model the Text-to-Text Transfer Transformer, T5.</p> <p>A task is chosen by a prefix written in plain words, <code class="language-plaintext highlighter-rouge">translate English to German:</code> or <code class="language-plaintext highlighter-rouge">cola sentence:</code> for grammaticality, and a class is a word, <em>acceptable</em> or <em>not acceptable</em>. Even regression became text.</p> <p>STS-B asks how similar two sentences are, on a scale up to 5; T5 rounded the scores to steps of 0.2 and wrote them out as strings like “3.8”, which recasts the regression as “a 21-class classification problem”.</p> <p>The paper is remembered as much for its method as for the idea: on one setup it compared nearly every choice people argued about in 2019, from architectures and objectives to datasets, multi-task training and scale. Its dataset became a standard of its own.</p> <p>C4, the Colossal Clean Crawled Corpus, is about 750 GB of English cut from one month of Common Crawl, April 2019, by blunt rules: keep only lines that end in a full stop or similar mark, drop pages with fewer than three sentences, pages with any word from a list of “Dirty, Naughty, Obscene or Otherwise Bad Words”, pages with “lorem ipsum”, and any page with a curly bracket, since “the curly bracket “{” appears in many programming languages […] but not in natural text”.</p> <p>Code was not what C4 was for, and section 8 shows one thing that cost.</p> <p>The original T5 checkpoints were pre-trained on a mixture of C4 and the paper’s supervised tasks, translation and summarisation among them. That is why the smallest of them still knows its prefixes. Here are four of them in five prompts, one model with no task-specific layer:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">T5_SMALL</span> <span class="o">=</span> <span class="sh">"</span><span class="s">google-t5/t5-small</span><span class="sh">"</span>
<span class="n">tokenizer</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">T5_SMALL</span><span class="p">)</span>
<span class="n">reference</span> <span class="o">=</span> <span class="n">T5ForConditionalGeneration</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">T5_SMALL</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>

<span class="n">prompts</span> <span class="o">=</span> <span class="p">[</span>
    <span class="sh">"</span><span class="s">translate English to German: The guards arrive at the museum at seven in the morning.</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">translate English to French: The night train to Vienna leaves at eleven.</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">cola sentence: The guards arrives at the museum at seven.</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">stsb sentence1: The night train leaves at eleven. </span><span class="sh">"</span>
    <span class="sh">"</span><span class="s">sentence2: At eleven the night train departs.</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">stsb sentence1: The night train leaves at eleven. </span><span class="sh">"</span>
    <span class="sh">"</span><span class="s">sentence2: The museum opens at nine.</span><span class="sh">"</span><span class="p">,</span>
<span class="p">]</span>
<span class="n">batch</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="n">prompts</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">,</span> <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">answers</span> <span class="o">=</span> <span class="n">reference</span><span class="p">.</span><span class="nf">generate</span><span class="p">(</span><span class="o">**</span><span class="n">batch</span><span class="p">,</span> <span class="n">max_new_tokens</span><span class="o">=</span><span class="mi">40</span><span class="p">,</span> <span class="n">num_beams</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">do_sample</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">answers</span> <span class="o">=</span> <span class="n">tokenizer</span><span class="p">.</span><span class="nf">batch_decode</span><span class="p">(</span><span class="n">answers</span><span class="p">,</span> <span class="n">skip_special_tokens</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">({</span><span class="sh">"</span><span class="s">prompt</span><span class="sh">"</span><span class="p">:</span> <span class="n">prompts</span><span class="p">,</span> <span class="sh">"</span><span class="s">answer</span><span class="sh">"</span><span class="p">:</span> <span class="n">answers</span><span class="p">}))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">prompt</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">answer</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">translate English to German: The guards arrive at the museum at seven in the morning.</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Die Wachen kommen morgens um sieben Uhr im Museum an.</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">translate English to French: The night train to Vienna leaves at eleven.</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Le train de nuit à Vienne quitte à 11 heures.</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">cola sentence: The guards arrives at the museum at seven.</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">acceptable</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">stsb sentence1: The night train leaves at eleven. sentence2: At eleven the night train departs.</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">5.0</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">stsb sentence1: The night train leaves at eleven. sentence2: The museum opens at nine.</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.0</td></tr></tbody></table></div> <p>The translations are right, and the similarity scores come back as text: 5.0 for a paraphrase and 0.0 for two sentences that have nothing in common. The grammar judgement is wrong.</p> <p>“The guards arrives at the museum at seven” is called acceptable, a reminder that a prefix asks for a task and doesn’t promise the model can do it. This is the smallest T5, with 60 million parameters.</p> <h2 id="2-two-stacks-and-a-bridge">2. Two stacks and a bridge</h2> <p>BERT, in <a href="/blog/2026/transformer-architectures-01-bert/">lesson 1</a>, was an encoder: it read a whole text at once, every token looking at every other, and turned it into vectors. GPT, in <a href="/blog/2026/transformer-architectures-04-gpt/">lesson 4</a>, was a decoder: it wrote text one token at a time, each token looking only at the ones before it.</p> <p>The original Transformer of 2017 was both, because it was built for translation, where the input and the output are different texts. T5 and BART went back to that design.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/05/encdec-light.png" width="760" alt="The encoder–decoder. On the left the encoder: a stack of layers with self-attention that sees the whole input in both directions and a feed-forward network; it runs once and turns the input into a sequence of vectors. On the right the decoder: in every layer causal self-attention over what it has written so far, then cross-attention, whose queries come from the decoder and whose keys and values come from the encoder's output, then a feed-forward network. Only the decoder runs once per generated token" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/05/encdec-dark.png" width="760" alt="The encoder–decoder. On the left the encoder: a stack of layers with self-attention that sees the whole input in both directions and a feed-forward network; it runs once and turns the input into a sequence of vectors. On the right the decoder: in every layer causal self-attention over what it has written so far, then cross-attention, whose queries come from the decoder and whose keys and values come from the encoder's output, then a feed-forward network. Only the decoder runs once per generated token" loading="lazy"></p> <p>The encoder turns the \(S\) input tokens into a matrix \(H \in \mathbb{R}^{S \times d}\), once. The decoder has, in every layer, one part that neither BERT nor GPT had: <em>cross-attention</em>. It is ordinary attention with the queries taken from the decoder’s own stream \(Y \in \mathbb{R}^{T \times d}\) and the keys and values taken from the encoder’s output:</p> \[\begin{aligned} &amp;\text{CrossAttention}(Y, H) \\ &amp;\quad = \text{softmax}\!\left(\frac{(Y W_Q)(H W_K)^\top}{\sqrt{d_k}} \right) H W_V. \end{aligned}\] <p>The matrix of scores is \(T \times S\): each of the \(T\) positions being written looks at all \(S\) positions of the input, and no mask is needed, since the input is complete before the first word is written. <a href="/blog/2026/transformers-from-scratch-02-transformer/">Self-attention</a> in the decoder stays causal, as in GPT.</p> <p>Two consequences follow, and both matter for the rest of this lesson. The input is read with full context in both directions, as BERT reads, and it is read once: generating \(T\) tokens runs the encoder once and the decoder \(T\) times. And the parameters are split between two stacks: t5-small has 6 encoder layers and 6 decoder layers, so a token of output passes through only half of the model.</p> <h2 id="3-t5-in-pytorch">3. T5 in PyTorch</h2> <p>T5’s layer has the familiar shape, pre-norm with a residual around each part, as in GPT-2. Four details differ, and each is a decision the T5 paper made on purpose.</p> <p><strong>A norm without a mean.</strong> LayerNorm subtracts the mean of a vector, divides by the standard deviation, scales and shifts. T5’s norm only rescales:</p> \[\text{<a href="/blog/2026/transformers-from-scratch-05-llama/">RMSNorm</a>}(x) = g \odot \frac{x}{\sqrt{\frac{1}{d}\sum_{i=1}^{d} x_i^2 + \varepsilon}}.\] <p>Here \(g\) is a learned vector of scales and \(\varepsilon = 10^{-6}\) guards against division by zero. No mean is subtracted and no bias is added.</p> <p>The idea has its own name and paper, RMSNorm <sup class="cite">[<a href="#ref-4" id="cite-4" data-ref="4" aria-label="Reference 4: Zhang, B., &amp; Sennrich, R. (2019). Root mean square layer normalization. NeurIPS 2019.">4</a>]</sup>, which argues that the rescaling, not the centring, is what makes LayerNorm work, and it is the norm of Llama, Qwen and nearly every model since. PyTorch has it built in, which makes for an easy check:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">Norm</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">weight</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">d</span><span class="p">))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">eps</span> <span class="o">=</span> <span class="n">eps</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">variance</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="nf">float</span><span class="p">().</span><span class="nf">pow</span><span class="p">(</span><span class="mi">2</span><span class="p">).</span><span class="nf">mean</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="nf">float</span><span class="p">()</span> <span class="o">*</span> <span class="n">torch</span><span class="p">.</span><span class="nf">rsqrt</span><span class="p">(</span><span class="n">variance</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">eps</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="n">weight</span> <span class="o">*</span> <span class="n">x</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span>


<span class="n">x</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="mi">2</span><span class="p">,</span> <span class="mi">5</span><span class="p">,</span> <span class="mi">8</span><span class="p">)</span>
<span class="n">mine</span><span class="p">,</span> <span class="n">builtin</span> <span class="o">=</span> <span class="nc">Norm</span><span class="p">(</span><span class="mi">8</span><span class="p">,</span> <span class="mf">1e-6</span><span class="p">),</span> <span class="n">nn</span><span class="p">.</span><span class="nc">RMSNorm</span><span class="p">(</span><span class="mi">8</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="mf">1e-6</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">largest difference from nn.RMSNorm:</span><span class="sh">"</span><span class="p">,</span> <span class="p">(</span><span class="nf">mine</span><span class="p">(</span><span class="n">x</span><span class="p">)</span> <span class="o">-</span> <span class="nf">builtin</span><span class="p">(</span><span class="n">x</span><span class="p">)).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">())</span>
</code></pre></div></div> <pre class="tfs-printed"><code>largest difference from nn.RMSNorm: 0.0</code></pre> <p><strong>Attention without \(\sqrt{d_k}\).</strong> T5 drops the division by \(\sqrt{d_k}\) in the scores. Nothing is lost: Google’s initialisation draws the query matrix with a standard deviation \(\sqrt{d_k}\) times smaller than the key matrix’s, which has the same effect when training starts, and training adjusts it from there.</p> <p>A transplant has to leave the division out too, or every score comes out eight times too small.</p> <p><strong>Positions as a bias.</strong> T5 has no position embeddings at all. Instead, each attention head adds a learned number to each score, which depends only on how far the key is from the query:</p> \[s_{ij} = q_i \cdot k_j + b_h\big(\text{bucket}(j - i)\big).\] <p>The distances are sorted into 32 buckets. In the encoder, which looks both ways, half of the buckets are for keys to the left and half for keys to the right.</p> <p>Within each half, the first 8 distances get a bucket each, and the rest share the remaining 8 buckets on a logarithmic scale up to a distance of 128; anything farther falls into the last bucket.</p> <p>Near words get precise positions, far ones only a rough sense of “far”. The decoder looks only back, so it uses all 32 buckets for distances to the left.</p> <p>Written out for the encoder, with \(n = \lvert j - i \rvert\) the distance between key and query, the bucket within one half is</p> \[b(n) = \begin{cases} n, &amp; n &lt; 8, \\ \min\big(15,\; f(n)\big), &amp; n \ge 8, \end{cases}\] <p>where</p> \[f(n) = 8 + \left\lfloor 8 \cdot \dfrac{\ln(n/8)}{\ln(128/8)} \right\rfloor,\] <p>and keys to the right of the query get \(b(n) + 16\). The logarithm spreads the eight far buckets so that each covers a range about 1.4 times wider than the one before: distances 8 to 11 share a bucket, then 12 to 15, 16 to 22, and the last one starts at 91 and takes everything farther.</p> <p>The decoder uses the same rule with 16 exact distances and 16 far buckets, \(16 + \lfloor 16 \cdot \ln(n/16) / \ln(128/16) \rfloor\), capped at 31.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">position_bucket</span><span class="p">(</span><span class="n">relative</span><span class="p">,</span> <span class="n">bidirectional</span><span class="p">,</span> <span class="n">buckets</span><span class="o">=</span><span class="mi">32</span><span class="p">,</span> <span class="n">max_distance</span><span class="o">=</span><span class="mi">128</span><span class="p">):</span>
    <span class="n">bucket</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros_like</span><span class="p">(</span><span class="n">relative</span><span class="p">)</span>
    <span class="k">if</span> <span class="n">bidirectional</span><span class="p">:</span>
        <span class="n">buckets</span> <span class="o">=</span> <span class="n">buckets</span> <span class="o">//</span> <span class="mi">2</span>
        <span class="c1"># keys to the right of the query get the upper half of the buckets
</span>        <span class="n">bucket</span> <span class="o">=</span> <span class="n">bucket</span> <span class="o">+</span> <span class="p">(</span><span class="n">relative</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">).</span><span class="nf">long</span><span class="p">()</span> <span class="o">*</span> <span class="n">buckets</span>
        <span class="n">distance</span> <span class="o">=</span> <span class="n">relative</span><span class="p">.</span><span class="nf">abs</span><span class="p">()</span>
    <span class="k">else</span><span class="p">:</span>
        <span class="n">distance</span> <span class="o">=</span> <span class="p">(</span><span class="o">-</span><span class="n">relative</span><span class="p">).</span><span class="nf">clamp</span><span class="p">(</span><span class="nb">min</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>  <span class="c1"># the decoder only looks back
</span>    <span class="n">exact</span> <span class="o">=</span> <span class="n">buckets</span> <span class="o">//</span> <span class="mi">2</span>
    <span class="n">log_distance</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">log</span><span class="p">(</span><span class="n">distance</span><span class="p">.</span><span class="nf">clamp</span><span class="p">(</span><span class="nb">min</span><span class="o">=</span><span class="mi">1</span><span class="p">).</span><span class="nf">float</span><span class="p">()</span> <span class="o">/</span> <span class="n">exact</span><span class="p">)</span>
    <span class="n">scaled</span> <span class="o">=</span> <span class="n">log_distance</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">log</span><span class="p">(</span><span class="n">max_distance</span> <span class="o">/</span> <span class="n">exact</span><span class="p">)</span>
    <span class="n">far</span> <span class="o">=</span> <span class="n">exact</span> <span class="o">+</span> <span class="p">(</span><span class="n">scaled</span> <span class="o">*</span> <span class="p">(</span><span class="n">buckets</span> <span class="o">-</span> <span class="n">exact</span><span class="p">)).</span><span class="nf">long</span><span class="p">()</span>
    <span class="n">far</span> <span class="o">=</span> <span class="n">far</span><span class="p">.</span><span class="nf">clamp</span><span class="p">(</span><span class="nb">max</span><span class="o">=</span><span class="n">buckets</span> <span class="o">-</span> <span class="mi">1</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">bucket</span> <span class="o">+</span> <span class="n">torch</span><span class="p">.</span><span class="nf">where</span><span class="p">(</span><span class="n">distance</span> <span class="o">&lt;</span> <span class="n">exact</span><span class="p">,</span> <span class="n">distance</span><span class="p">,</span> <span class="n">far</span><span class="p">)</span>


<span class="n">relative</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">([</span><span class="o">-</span><span class="mi">300</span><span class="p">,</span> <span class="o">-</span><span class="mi">128</span><span class="p">,</span> <span class="o">-</span><span class="mi">64</span><span class="p">,</span> <span class="o">-</span><span class="mi">20</span><span class="p">,</span> <span class="o">-</span><span class="mi">9</span><span class="p">,</span> <span class="o">-</span><span class="mi">8</span><span class="p">,</span> <span class="o">-</span><span class="mi">7</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">,</span>
                         <span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">7</span><span class="p">,</span> <span class="mi">8</span><span class="p">,</span> <span class="mi">20</span><span class="p">,</span> <span class="mi">64</span><span class="p">,</span> <span class="mi">128</span><span class="p">,</span> <span class="mi">300</span><span class="p">])</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">({</span><span class="sh">"</span><span class="s">key minus query</span><span class="sh">"</span><span class="p">:</span> <span class="n">relative</span><span class="p">.</span><span class="nf">tolist</span><span class="p">(),</span>
                    <span class="sh">"</span><span class="s">encoder bucket</span><span class="sh">"</span><span class="p">:</span> <span class="nf">position_bucket</span><span class="p">(</span><span class="n">relative</span><span class="p">,</span> <span class="bp">True</span><span class="p">).</span><span class="nf">tolist</span><span class="p">(),</span>
                    <span class="sh">"</span><span class="s">decoder bucket</span><span class="sh">"</span><span class="p">:</span> <span class="nf">position_bucket</span><span class="p">(</span><span class="n">relative</span><span class="p">,</span> <span class="bp">False</span><span class="p">).</span><span class="nf">tolist</span><span class="p">()}))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">key minus query</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">encoder bucket</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">decoder bucket</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">-300</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">15</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">31</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">-128</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">15</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">31</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">-64</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">14</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">26</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">-20</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">10</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">17</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">-9</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">9</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">-8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">-7</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">-1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">17</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">23</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">24</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">20</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">26</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">64</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">30</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">128</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">31</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">300</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">31</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td></tr></tbody></table></div> <p>A distance of 1 and a distance of 7 get different buckets; 64 and 100 share one. Every key to the right of a decoder query lands in bucket 0 with the query itself, but the causal mask hides those keys anyway. The whole map, for distances up to 150 either way:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">distances</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="o">-</span><span class="mi">150</span><span class="p">,</span> <span class="mi">151</span><span class="p">)</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.4</span><span class="p">,</span> <span class="mf">2.8</span><span class="p">))</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">step</span><span class="p">(</span><span class="n">distances</span><span class="p">,</span> <span class="nf">position_bucket</span><span class="p">(</span><span class="n">distances</span><span class="p">,</span> <span class="bp">True</span><span class="p">),</span> <span class="n">where</span><span class="o">=</span><span class="sh">"</span><span class="s">mid</span><span class="sh">"</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">],</span>
        <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">encoder: both directions</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">step</span><span class="p">(</span><span class="n">distances</span><span class="p">,</span> <span class="nf">position_bucket</span><span class="p">(</span><span class="n">distances</span><span class="p">,</span> <span class="bp">False</span><span class="p">),</span> <span class="n">where</span><span class="o">=</span><span class="sh">"</span><span class="s">mid</span><span class="sh">"</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">],</span>
        <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">decoder: only back</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">axvspan</span><span class="p">(</span><span class="o">-</span><span class="mf">7.5</span><span class="p">,</span> <span class="mf">7.5</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">grid</span><span class="sh">"</span><span class="p">],</span> <span class="n">zorder</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">text</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mf">33.5</span><span class="p">,</span> <span class="sh">"</span><span class="s">one bucket per distance</span><span class="sh">"</span><span class="p">,</span> <span class="n">ha</span><span class="o">=</span><span class="sh">"</span><span class="s">center</span><span class="sh">"</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">],</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">9</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">key position minus query position</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">bucket</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylim</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="mi">36</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">loc</span><span class="o">=</span><span class="sh">"</span><span class="s">lower right</span><span class="sh">"</span><span class="p">,</span> <span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/05/output-01.png" alt="Output of the code above" loading="lazy"></p> <p>The table of biases, 32 buckets by the number of heads, lives in the first layer of the encoder and the first layer of the decoder. Every other layer reuses the same biases, so a model of six layers learns positions with \(2 \times 32 \times 8 = 512\) numbers. GPT-2 spent 786,432 on its position embeddings.</p> <p><strong>The output layer.</strong> T5’s decoder scores the vocabulary with the input embedding matrix, tied as in GPT-2, after multiplying the hidden state by \(d^{-1/2}\).</p> <p>Google’s Mesh TensorFlow code does this whenever the input and output embeddings are shared, and Hugging Face’s code copies it. Leave it out and every logit is \(\sqrt{512} \approx 23\) times too large for t5-small.</p> <p>The attention layer below takes an optional <code class="language-plaintext highlighter-rouge">source</code>: without it, it is self-attention; with it, the keys and values come from the encoder and it is cross-attention.</p> <p>The optional <code class="language-plaintext highlighter-rouge">cache</code> is the <a href="/blog/2025/inference-optimization/">KV cache</a> of lesson 4, with one addition: in cross-attention the keys and values come from the encoder, which doesn’t change while the decoder writes, so they are computed once for the whole answer. For the pictures of section 5 it can also return the attention weights.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">Attention</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">,</span> <span class="n">relative</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">bidirectional</span><span class="o">=</span><span class="bp">True</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">d_model</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_heads</span><span class="sh">"</span><span class="p">],</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">d_kv</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">inner</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span>
        <span class="n">self</span><span class="p">.</span><span class="n">q</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">inner</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">k</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">inner</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">v</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">inner</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">o</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">inner</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">buckets</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">relative_attention_num_buckets</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">bidirectional</span> <span class="o">=</span> <span class="n">bidirectional</span>
        <span class="k">if</span> <span class="n">relative</span><span class="p">:</span>  <span class="c1"># only the first layer has the table; the others reuse its biases
</span>            <span class="n">self</span><span class="p">.</span><span class="n">relative_bias</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">buckets</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">position_bias</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">queries</span><span class="p">,</span> <span class="n">keys</span><span class="p">):</span>
        <span class="n">relative</span> <span class="o">=</span> <span class="n">keys</span><span class="p">[</span><span class="bp">None</span><span class="p">,</span> <span class="p">:]</span> <span class="o">-</span> <span class="n">queries</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">]</span>
        <span class="n">buckets</span> <span class="o">=</span> <span class="nf">position_bucket</span><span class="p">(</span><span class="n">relative</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">bidirectional</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">buckets</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">relative_bias</span><span class="p">(</span><span class="n">buckets</span><span class="p">).</span><span class="nf">permute</span><span class="p">(</span><span class="mi">2</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">).</span><span class="nf">unsqueeze</span><span class="p">(</span><span class="mi">0</span><span class="p">)</span>  <span class="c1"># 1, heads, q, k
</span>
    <span class="k">def</span> <span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">batch</span><span class="p">,</span> <span class="n">length</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span>
        <span class="k">return</span> <span class="n">x</span><span class="p">.</span><span class="nf">view</span><span class="p">(</span><span class="n">batch</span><span class="p">,</span> <span class="n">length</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">head_dim</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">source</span><span class="o">=</span><span class="bp">None</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">None</span><span class="p">,</span> <span class="n">cache</span><span class="o">=</span><span class="bp">None</span><span class="p">,</span> <span class="n">keep_weights</span><span class="o">=</span><span class="bp">False</span><span class="p">):</span>
        <span class="n">q</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">q</span><span class="p">(</span><span class="n">x</span><span class="p">))</span>
        <span class="k">if</span> <span class="n">source</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span> <span class="ow">and</span> <span class="n">cache</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span> <span class="ow">and</span> <span class="sh">"</span><span class="s">k</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">cache</span><span class="p">:</span>
            <span class="c1"># cross-attention: the encoder's keys and values never change
</span>            <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="o">=</span> <span class="n">cache</span><span class="p">[</span><span class="sh">"</span><span class="s">k</span><span class="sh">"</span><span class="p">],</span> <span class="n">cache</span><span class="p">[</span><span class="sh">"</span><span class="s">v</span><span class="sh">"</span><span class="p">]</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="n">k</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">k</span><span class="p">(</span><span class="n">x</span> <span class="k">if</span> <span class="n">source</span> <span class="ow">is</span> <span class="bp">None</span> <span class="k">else</span> <span class="n">source</span><span class="p">))</span>
            <span class="n">v</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">v</span><span class="p">(</span><span class="n">x</span> <span class="k">if</span> <span class="n">source</span> <span class="ow">is</span> <span class="bp">None</span> <span class="k">else</span> <span class="n">source</span><span class="p">))</span>
            <span class="k">if</span> <span class="n">source</span> <span class="ow">is</span> <span class="bp">None</span> <span class="ow">and</span> <span class="n">cache</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span> <span class="ow">and</span> <span class="sh">"</span><span class="s">k</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">cache</span><span class="p">:</span>
                <span class="n">k</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">cache</span><span class="p">[</span><span class="sh">"</span><span class="s">k</span><span class="sh">"</span><span class="p">],</span> <span class="n">k</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
                <span class="n">v</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">cache</span><span class="p">[</span><span class="sh">"</span><span class="s">v</span><span class="sh">"</span><span class="p">],</span> <span class="n">v</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">cache</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
            <span class="n">cache</span><span class="p">[</span><span class="sh">"</span><span class="s">k</span><span class="sh">"</span><span class="p">],</span> <span class="n">cache</span><span class="p">[</span><span class="sh">"</span><span class="s">v</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span>
        <span class="n">weights</span> <span class="o">=</span> <span class="bp">None</span>
        <span class="k">if</span> <span class="n">keep_weights</span><span class="p">:</span>
            <span class="n">scores</span> <span class="o">=</span> <span class="n">q</span> <span class="o">@</span> <span class="n">k</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">2</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">)</span> <span class="o">+</span> <span class="n">bias</span>  <span class="c1"># no division by the square root of d_k
</span>            <span class="n">weights</span> <span class="o">=</span> <span class="n">scores</span><span class="p">.</span><span class="nf">float</span><span class="p">().</span><span class="nf">softmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">q</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span>
            <span class="n">y</span> <span class="o">=</span> <span class="n">weights</span> <span class="o">@</span> <span class="n">v</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="n">y</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">scaled_dot_product_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">,</span> <span class="n">attn_mask</span><span class="o">=</span><span class="n">bias</span><span class="p">,</span> <span class="n">scale</span><span class="o">=</span><span class="mf">1.0</span><span class="p">)</span>
        <span class="n">y</span> <span class="o">=</span> <span class="n">y</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="o">-</span><span class="mi">1</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">o</span><span class="p">(</span><span class="n">y</span><span class="p">),</span> <span class="n">weights</span>
</code></pre></div></div> <p>The feed-forward network of the original T5 is two matrices with a ReLU between them and no biases; there are no biases anywhere in T5. Dropout only matters for training, in section 8.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">FeedForward</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">wi</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">d_model</span><span class="sh">"</span><span class="p">],</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">d_ff</span><span class="sh">"</span><span class="p">],</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">wo</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">d_ff</span><span class="sh">"</span><span class="p">],</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">d_model</span><span class="sh">"</span><span class="p">],</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">drop</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Dropout</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">dropout_rate</span><span class="sh">"</span><span class="p">])</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">wo</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">drop</span><span class="p">(</span><span class="n">F</span><span class="p">.</span><span class="nf">relu</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">wi</span><span class="p">(</span><span class="n">x</span><span class="p">))))</span>


<span class="k">class</span> <span class="nc">EncoderLayer</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">,</span> <span class="n">first</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span><span class="p">,</span> <span class="n">eps</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">d_model</span><span class="sh">"</span><span class="p">],</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">layer_norm_epsilon</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm1</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">attention</span> <span class="o">=</span> <span class="nc">Norm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="p">),</span> <span class="nc">Attention</span><span class="p">(</span><span class="n">config</span><span class="p">,</span> <span class="n">relative</span><span class="o">=</span><span class="n">first</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm2</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">ff</span> <span class="o">=</span> <span class="nc">Norm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="p">),</span> <span class="nc">FeedForward</span><span class="p">(</span><span class="n">config</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">drop</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Dropout</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">dropout_rate</span><span class="sh">"</span><span class="p">])</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">bias</span><span class="p">):</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">drop</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">attention</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">norm1</span><span class="p">(</span><span class="n">x</span><span class="p">),</span> <span class="n">bias</span><span class="o">=</span><span class="n">bias</span><span class="p">)[</span><span class="mi">0</span><span class="p">])</span>
        <span class="k">return</span> <span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">drop</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">ff</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">norm2</span><span class="p">(</span><span class="n">x</span><span class="p">)))</span>


<span class="k">class</span> <span class="nc">DecoderLayer</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">,</span> <span class="n">first</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span><span class="p">,</span> <span class="n">eps</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">d_model</span><span class="sh">"</span><span class="p">],</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">layer_norm_epsilon</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm1</span> <span class="o">=</span> <span class="nc">Norm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">attention</span> <span class="o">=</span> <span class="nc">Attention</span><span class="p">(</span><span class="n">config</span><span class="p">,</span> <span class="n">relative</span><span class="o">=</span><span class="n">first</span><span class="p">,</span> <span class="n">bidirectional</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm2</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">cross</span> <span class="o">=</span> <span class="nc">Norm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="p">),</span> <span class="nc">Attention</span><span class="p">(</span><span class="n">config</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm3</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">ff</span> <span class="o">=</span> <span class="nc">Norm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="p">),</span> <span class="nc">FeedForward</span><span class="p">(</span><span class="n">config</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">drop</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Dropout</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">dropout_rate</span><span class="sh">"</span><span class="p">])</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">y</span><span class="p">,</span> <span class="n">memory</span><span class="p">,</span> <span class="n">self_bias</span><span class="p">,</span> <span class="n">cross_bias</span><span class="p">,</span> <span class="n">cache</span><span class="o">=</span><span class="bp">None</span><span class="p">,</span> <span class="n">keep_weights</span><span class="o">=</span><span class="bp">False</span><span class="p">):</span>
        <span class="n">own</span> <span class="o">=</span> <span class="n">cache</span><span class="p">[</span><span class="sh">"</span><span class="s">self</span><span class="sh">"</span><span class="p">]</span> <span class="k">if</span> <span class="n">cache</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span> <span class="k">else</span> <span class="bp">None</span>
        <span class="n">other</span> <span class="o">=</span> <span class="n">cache</span><span class="p">[</span><span class="sh">"</span><span class="s">cross</span><span class="sh">"</span><span class="p">]</span> <span class="k">if</span> <span class="n">cache</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span> <span class="k">else</span> <span class="bp">None</span>
        <span class="n">y</span> <span class="o">=</span> <span class="n">y</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">drop</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">attention</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">norm1</span><span class="p">(</span><span class="n">y</span><span class="p">),</span> <span class="n">bias</span><span class="o">=</span><span class="n">self_bias</span><span class="p">,</span> <span class="n">cache</span><span class="o">=</span><span class="n">own</span><span class="p">)[</span><span class="mi">0</span><span class="p">])</span>
        <span class="n">out</span><span class="p">,</span> <span class="n">weights</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">cross</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">norm2</span><span class="p">(</span><span class="n">y</span><span class="p">),</span> <span class="n">source</span><span class="o">=</span><span class="n">memory</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="n">cross_bias</span><span class="p">,</span>
                                  <span class="n">cache</span><span class="o">=</span><span class="n">other</span><span class="p">,</span> <span class="n">keep_weights</span><span class="o">=</span><span class="n">keep_weights</span><span class="p">)</span>
        <span class="n">y</span> <span class="o">=</span> <span class="n">y</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">drop</span><span class="p">(</span><span class="n">out</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">y</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">drop</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">ff</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">norm3</span><span class="p">(</span><span class="n">y</span><span class="p">))),</span> <span class="n">weights</span>
</code></pre></div></div> <p>The model puts the stacks together. The encoder’s padding is hidden by a bias of \(-\infty\), in practice the smallest float, on the padded keys, both in the encoder and in cross-attention; the decoder adds the causal mask to its position biases.</p> <p><code class="language-plaintext highlighter-rouge">decode</code> takes <code class="language-plaintext highlighter-rouge">past</code>, the number of tokens already written, so that a single new token gets the right position biases when the earlier ones are in the cache.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">padding_bias</span><span class="p">(</span><span class="n">mask</span><span class="p">):</span>
    <span class="n">blocked</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">finfo</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="n">float32</span><span class="p">).</span><span class="nb">min</span>
    <span class="nf">return </span><span class="p">(</span><span class="mf">1.0</span> <span class="o">-</span> <span class="n">mask</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:].</span><span class="nf">float</span><span class="p">())</span> <span class="o">*</span> <span class="n">blocked</span>  <span class="c1"># batch, 1, 1, keys
</span>

<span class="k">class</span> <span class="nc">T5</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span><span class="p">,</span> <span class="n">eps</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">d_model</span><span class="sh">"</span><span class="p">],</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">layer_norm_epsilon</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">d</span> <span class="o">=</span> <span class="n">d</span>
        <span class="n">self</span><span class="p">.</span><span class="n">embed</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">layers</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_layers</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">encoder</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">ModuleList</span><span class="p">(</span><span class="nc">EncoderLayer</span><span class="p">(</span><span class="n">config</span><span class="p">,</span> <span class="n">i</span> <span class="o">==</span> <span class="mi">0</span><span class="p">)</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">layers</span><span class="p">))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">encoder_norm</span> <span class="o">=</span> <span class="nc">Norm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="p">)</span>
        <span class="n">layers</span> <span class="o">=</span> <span class="n">config</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">num_decoder_layers</span><span class="sh">"</span><span class="p">,</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_layers</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">decoder</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">ModuleList</span><span class="p">(</span><span class="nc">DecoderLayer</span><span class="p">(</span><span class="n">config</span><span class="p">,</span> <span class="n">i</span> <span class="o">==</span> <span class="mi">0</span><span class="p">)</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">layers</span><span class="p">))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">decoder_norm</span> <span class="o">=</span> <span class="nc">Norm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">drop</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Dropout</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">dropout_rate</span><span class="sh">"</span><span class="p">])</span>

    <span class="k">def</span> <span class="nf">encode</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">mask</span><span class="p">):</span>
        <span class="n">positions</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="n">device</span><span class="o">=</span><span class="n">ids</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
        <span class="n">bias</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">encoder</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="n">attention</span><span class="p">.</span><span class="nf">position_bias</span><span class="p">(</span><span class="n">positions</span><span class="p">,</span> <span class="n">positions</span><span class="p">)</span>
        <span class="n">bias</span> <span class="o">=</span> <span class="n">bias</span> <span class="o">+</span> <span class="nf">padding_bias</span><span class="p">(</span><span class="n">mask</span><span class="p">)</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">drop</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">embed</span><span class="p">(</span><span class="n">ids</span><span class="p">))</span>
        <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">self</span><span class="p">.</span><span class="n">encoder</span><span class="p">:</span>
            <span class="n">x</span> <span class="o">=</span> <span class="nf">layer</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">bias</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">drop</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">encoder_norm</span><span class="p">(</span><span class="n">x</span><span class="p">))</span>

    <span class="k">def</span> <span class="nf">decode</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">targets</span><span class="p">,</span> <span class="n">memory</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">caches</span><span class="o">=</span><span class="bp">None</span><span class="p">,</span> <span class="n">past</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span> <span class="n">keep_weights</span><span class="o">=</span><span class="bp">False</span><span class="p">):</span>
        <span class="n">length</span> <span class="o">=</span> <span class="n">targets</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>
        <span class="n">queries</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">past</span><span class="p">,</span> <span class="n">past</span> <span class="o">+</span> <span class="n">length</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">targets</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
        <span class="n">keys</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">past</span> <span class="o">+</span> <span class="n">length</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">targets</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
        <span class="n">self_bias</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">decoder</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="n">attention</span><span class="p">.</span><span class="nf">position_bias</span><span class="p">(</span><span class="n">queries</span><span class="p">,</span> <span class="n">keys</span><span class="p">)</span>
        <span class="n">future</span> <span class="o">=</span> <span class="n">keys</span><span class="p">[</span><span class="bp">None</span><span class="p">,</span> <span class="p">:]</span> <span class="o">&gt;</span> <span class="n">queries</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">]</span>
        <span class="n">self_bias</span> <span class="o">=</span> <span class="n">self_bias</span><span class="p">.</span><span class="nf">masked_fill</span><span class="p">(</span><span class="n">future</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="nf">finfo</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="n">float32</span><span class="p">).</span><span class="nb">min</span><span class="p">)</span>
        <span class="n">cross_bias</span> <span class="o">=</span> <span class="nf">padding_bias</span><span class="p">(</span><span class="n">mask</span><span class="p">)</span>
        <span class="n">y</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">drop</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">embed</span><span class="p">(</span><span class="n">targets</span><span class="p">))</span>
        <span class="n">cross</span> <span class="o">=</span> <span class="p">[]</span>
        <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">layer</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">decoder</span><span class="p">):</span>
            <span class="n">cache</span> <span class="o">=</span> <span class="n">caches</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="k">if</span> <span class="n">caches</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span> <span class="k">else</span> <span class="bp">None</span>
            <span class="n">y</span><span class="p">,</span> <span class="n">weights</span> <span class="o">=</span> <span class="nf">layer</span><span class="p">(</span><span class="n">y</span><span class="p">,</span> <span class="n">memory</span><span class="p">,</span> <span class="n">self_bias</span><span class="p">,</span> <span class="n">cross_bias</span><span class="p">,</span> <span class="n">cache</span><span class="p">,</span> <span class="n">keep_weights</span><span class="p">)</span>
            <span class="n">cross</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">weights</span><span class="p">)</span>
        <span class="n">y</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">drop</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">decoder_norm</span><span class="p">(</span><span class="n">y</span><span class="p">))</span>
        <span class="n">logits</span> <span class="o">=</span> <span class="p">(</span><span class="n">y</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">d</span> <span class="o">**</span> <span class="o">-</span><span class="mf">0.5</span><span class="p">)</span> <span class="o">@</span> <span class="n">self</span><span class="p">.</span><span class="n">embed</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">T</span>  <span class="c1"># tied, and rescaled first
</span>        <span class="nf">return </span><span class="p">(</span><span class="n">logits</span><span class="p">,</span> <span class="n">cross</span><span class="p">)</span> <span class="k">if</span> <span class="n">keep_weights</span> <span class="k">else</span> <span class="n">logits</span>
</code></pre></div></div> <h2 id="4-googles-weights-in-our-code">4. Google’s weights in our code</h2> <p>The checkpoint’s names follow the structure of Google’s code, <code class="language-plaintext highlighter-rouge">block.{i}.layer.{j}</code>, where the parts of a layer are numbered: in the decoder, 0 is self-attention, 1 cross-attention and 2 the feed-forward network. We write down which goes where; <code class="language-plaintext highlighter-rouge">load_state_dict</code> refuses anything missing or left over.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">transplant</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">state</span><span class="p">):</span>
    <span class="n">mine</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">embed.weight</span><span class="sh">"</span><span class="p">:</span> <span class="n">state</span><span class="p">[</span><span class="sh">"</span><span class="s">shared.weight</span><span class="sh">"</span><span class="p">],</span>
            <span class="sh">"</span><span class="s">encoder_norm.weight</span><span class="sh">"</span><span class="p">:</span> <span class="n">state</span><span class="p">[</span><span class="sh">"</span><span class="s">encoder.final_layer_norm.weight</span><span class="sh">"</span><span class="p">],</span>
            <span class="sh">"</span><span class="s">decoder_norm.weight</span><span class="sh">"</span><span class="p">:</span> <span class="n">state</span><span class="p">[</span><span class="sh">"</span><span class="s">decoder.final_layer_norm.weight</span><span class="sh">"</span><span class="p">]}</span>
    <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="n">encoder</span><span class="p">)):</span>
        <span class="n">old</span><span class="p">,</span> <span class="n">new</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">encoder.block.</span><span class="si">{</span><span class="n">i</span><span class="si">}</span><span class="s">.layer.</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="s">encoder.</span><span class="si">{</span><span class="n">i</span><span class="si">}</span><span class="s">.</span><span class="sh">"</span>
        <span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="sh">"</span><span class="s">qkvo</span><span class="sh">"</span><span class="p">:</span>
            <span class="n">weight</span> <span class="o">=</span> <span class="n">state</span><span class="p">[</span><span class="n">old</span> <span class="o">+</span> <span class="sa">f</span><span class="sh">"</span><span class="s">0.SelfAttention.</span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="s">.weight</span><span class="sh">"</span><span class="p">]</span>
            <span class="n">mine</span><span class="p">[</span><span class="n">new</span> <span class="o">+</span> <span class="sa">f</span><span class="sh">"</span><span class="s">attention.</span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="s">.weight</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">weight</span>
        <span class="n">mine</span><span class="p">[</span><span class="n">new</span> <span class="o">+</span> <span class="sh">"</span><span class="s">norm1.weight</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">state</span><span class="p">[</span><span class="n">old</span> <span class="o">+</span> <span class="sh">"</span><span class="s">0.layer_norm.weight</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">mine</span><span class="p">[</span><span class="n">new</span> <span class="o">+</span> <span class="sh">"</span><span class="s">ff.wi.weight</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">state</span><span class="p">[</span><span class="n">old</span> <span class="o">+</span> <span class="sh">"</span><span class="s">1.DenseReluDense.wi.weight</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">mine</span><span class="p">[</span><span class="n">new</span> <span class="o">+</span> <span class="sh">"</span><span class="s">ff.wo.weight</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">state</span><span class="p">[</span><span class="n">old</span> <span class="o">+</span> <span class="sh">"</span><span class="s">1.DenseReluDense.wo.weight</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">mine</span><span class="p">[</span><span class="n">new</span> <span class="o">+</span> <span class="sh">"</span><span class="s">norm2.weight</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">state</span><span class="p">[</span><span class="n">old</span> <span class="o">+</span> <span class="sh">"</span><span class="s">1.layer_norm.weight</span><span class="sh">"</span><span class="p">]</span>
    <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="n">decoder</span><span class="p">)):</span>
        <span class="n">old</span><span class="p">,</span> <span class="n">new</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">decoder.block.</span><span class="si">{</span><span class="n">i</span><span class="si">}</span><span class="s">.layer.</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="s">decoder.</span><span class="si">{</span><span class="n">i</span><span class="si">}</span><span class="s">.</span><span class="sh">"</span>
        <span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="sh">"</span><span class="s">qkvo</span><span class="sh">"</span><span class="p">:</span>
            <span class="n">weight</span> <span class="o">=</span> <span class="n">state</span><span class="p">[</span><span class="n">old</span> <span class="o">+</span> <span class="sa">f</span><span class="sh">"</span><span class="s">0.SelfAttention.</span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="s">.weight</span><span class="sh">"</span><span class="p">]</span>
            <span class="n">mine</span><span class="p">[</span><span class="n">new</span> <span class="o">+</span> <span class="sa">f</span><span class="sh">"</span><span class="s">attention.</span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="s">.weight</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">weight</span>
            <span class="n">weight</span> <span class="o">=</span> <span class="n">state</span><span class="p">[</span><span class="n">old</span> <span class="o">+</span> <span class="sa">f</span><span class="sh">"</span><span class="s">1.EncDecAttention.</span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="s">.weight</span><span class="sh">"</span><span class="p">]</span>
            <span class="n">mine</span><span class="p">[</span><span class="n">new</span> <span class="o">+</span> <span class="sa">f</span><span class="sh">"</span><span class="s">cross.</span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="s">.weight</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">weight</span>
        <span class="k">for</span> <span class="n">part</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">3</span><span class="p">):</span>
            <span class="n">mine</span><span class="p">[</span><span class="n">new</span> <span class="o">+</span> <span class="sa">f</span><span class="sh">"</span><span class="s">norm</span><span class="si">{</span><span class="n">part</span> <span class="o">+</span> <span class="mi">1</span><span class="si">}</span><span class="s">.weight</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">state</span><span class="p">[</span><span class="n">old</span> <span class="o">+</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">part</span><span class="si">}</span><span class="s">.layer_norm.weight</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">mine</span><span class="p">[</span><span class="n">new</span> <span class="o">+</span> <span class="sh">"</span><span class="s">ff.wi.weight</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">state</span><span class="p">[</span><span class="n">old</span> <span class="o">+</span> <span class="sh">"</span><span class="s">2.DenseReluDense.wi.weight</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">mine</span><span class="p">[</span><span class="n">new</span> <span class="o">+</span> <span class="sh">"</span><span class="s">ff.wo.weight</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">state</span><span class="p">[</span><span class="n">old</span> <span class="o">+</span> <span class="sh">"</span><span class="s">2.DenseReluDense.wo.weight</span><span class="sh">"</span><span class="p">]</span>
    <span class="k">for</span> <span class="n">side</span> <span class="ow">in</span> <span class="p">[</span><span class="sh">"</span><span class="s">encoder</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">decoder</span><span class="sh">"</span><span class="p">]:</span>
        <span class="n">key</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">side</span><span class="si">}</span><span class="s">.block.0.layer.0.SelfAttention.relative_attention_bias.weight</span><span class="sh">"</span>
        <span class="n">mine</span><span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">side</span><span class="si">}</span><span class="s">.0.attention.relative_bias.weight</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">state</span><span class="p">[</span><span class="n">key</span><span class="p">]</span>
    <span class="n">model</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">(</span><span class="n">mine</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">model</span>


<span class="k">def</span> <span class="nf">load_t5</span><span class="p">(</span><span class="n">repo</span><span class="p">):</span>
    <span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">repo</span><span class="p">,</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">))</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
        <span class="n">config</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">f</span><span class="p">)</span>
    <span class="n">state</span> <span class="o">=</span> <span class="nf">load_file</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">repo</span><span class="p">,</span> <span class="sh">"</span><span class="s">model.safetensors</span><span class="sh">"</span><span class="p">))</span>
    <span class="k">return</span> <span class="nf">transplant</span><span class="p">(</span><span class="nc">T5</span><span class="p">(</span><span class="n">config</span><span class="p">),</span> <span class="n">state</span><span class="p">),</span> <span class="n">config</span>


<span class="n">t5</span><span class="p">,</span> <span class="n">t5_config</span> <span class="o">=</span> <span class="nf">load_t5</span><span class="p">(</span><span class="n">T5_SMALL</span><span class="p">)</span>
<span class="n">t5</span> <span class="o">=</span> <span class="n">t5</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">t5-small: </span><span class="si">{</span><span class="nf">sum</span><span class="p">(</span><span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span> <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">t5</span><span class="p">.</span><span class="nf">parameters</span><span class="p">())</span> <span class="o">/</span> <span class="mf">1e6</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s"> million parameters</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>t5-small: 60.5 million parameters</code></pre> <p>The check: the same input and the same decoder input through both models, teacher-forced, so every position is compared at once. The decoder’s first input is the padding token, T5’s start-of-output.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">batch</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="n">prompts</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">,</span> <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="n">written</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="n">answers</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">,</span> <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">).</span><span class="n">input_ids</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="c1"># the padding token is also T5's start token
</span><span class="n">start</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">prompts</span><span class="p">),</span> <span class="mi">1</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">long</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
<span class="n">decoder_input</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">start</span><span class="p">,</span> <span class="n">written</span><span class="p">[:,</span> <span class="p">:</span><span class="o">-</span><span class="mi">1</span><span class="p">]],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">ours</span> <span class="o">=</span> <span class="n">t5</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="n">decoder_input</span><span class="p">,</span> <span class="n">t5</span><span class="p">.</span><span class="nf">encode</span><span class="p">(</span><span class="n">batch</span><span class="p">.</span><span class="n">input_ids</span><span class="p">,</span> <span class="n">batch</span><span class="p">.</span><span class="n">attention_mask</span><span class="p">),</span>
                     <span class="n">batch</span><span class="p">.</span><span class="n">attention_mask</span><span class="p">)</span>
    <span class="n">theirs</span> <span class="o">=</span> <span class="nf">reference</span><span class="p">(</span><span class="o">**</span><span class="n">batch</span><span class="p">,</span> <span class="n">decoder_input_ids</span><span class="o">=</span><span class="n">decoder_input</span><span class="p">).</span><span class="n">logits</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">largest difference in logits:</span><span class="sh">"</span><span class="p">,</span> <span class="p">(</span><span class="n">ours</span> <span class="o">-</span> <span class="n">theirs</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">())</span>
</code></pre></div></div> <pre class="tfs-printed"><code>largest difference in logits: 3.814697265625e-05</code></pre> <p>Generation is lesson 4’s loop with an encoder in front: encode the input once, start the decoder from the padding token, and keep feeding back the most probable token until every row has written the end-of-text token <code class="language-plaintext highlighter-rouge">&lt;/s&gt;</code>.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">generate</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">max_new_tokens</span><span class="o">=</span><span class="mi">64</span><span class="p">,</span> <span class="n">eos</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">pad</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span> <span class="n">temperature</span><span class="o">=</span><span class="mf">0.0</span><span class="p">,</span>
             <span class="n">generator</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
    <span class="n">memory</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="nf">encode</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">mask</span><span class="p">)</span>
    <span class="n">caches</span> <span class="o">=</span> <span class="p">[{</span><span class="sh">"</span><span class="s">self</span><span class="sh">"</span><span class="p">:</span> <span class="p">{},</span> <span class="sh">"</span><span class="s">cross</span><span class="sh">"</span><span class="p">:</span> <span class="p">{}}</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="n">decoder</span><span class="p">]</span>
    <span class="n">token</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">full</span><span class="p">((</span><span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="mi">1</span><span class="p">),</span> <span class="n">pad</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">ids</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
    <span class="n">written</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="n">done</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">ids</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">step</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">max_new_tokens</span><span class="p">):</span>
        <span class="n">logits</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="n">token</span><span class="p">,</span> <span class="n">memory</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">caches</span><span class="p">,</span> <span class="n">past</span><span class="o">=</span><span class="n">step</span><span class="p">)[:,</span> <span class="o">-</span><span class="mi">1</span><span class="p">].</span><span class="nf">float</span><span class="p">()</span>
        <span class="k">if</span> <span class="n">temperature</span> <span class="o">==</span> <span class="mi">0</span><span class="p">:</span>
            <span class="n">token</span> <span class="o">=</span> <span class="n">logits</span><span class="p">.</span><span class="nf">argmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>  <span class="c1"># greedy
</span>        <span class="k">else</span><span class="p">:</span>
            <span class="n">probs</span> <span class="o">=</span> <span class="p">(</span><span class="n">logits</span> <span class="o">/</span> <span class="n">temperature</span><span class="p">).</span><span class="nf">softmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
            <span class="n">token</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">multinomial</span><span class="p">(</span><span class="n">probs</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">generator</span><span class="o">=</span><span class="n">generator</span><span class="p">)</span>
        <span class="n">token</span> <span class="o">=</span> <span class="n">token</span><span class="p">.</span><span class="nf">masked_fill</span><span class="p">(</span><span class="n">done</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">],</span> <span class="n">pad</span><span class="p">)</span>  <span class="c1"># finished rows write padding
</span>        <span class="n">written</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">token</span><span class="p">)</span>
        <span class="n">done</span> <span class="o">=</span> <span class="n">done</span> <span class="o">|</span> <span class="p">(</span><span class="n">token</span><span class="p">[:,</span> <span class="mi">0</span><span class="p">]</span> <span class="o">==</span> <span class="n">eos</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">done</span><span class="p">.</span><span class="nf">all</span><span class="p">():</span>
            <span class="k">break</span>
    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">(</span><span class="n">written</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>


<span class="n">ours</span> <span class="o">=</span> <span class="n">tokenizer</span><span class="p">.</span><span class="nf">batch_decode</span><span class="p">(</span><span class="nf">generate</span><span class="p">(</span><span class="n">t5</span><span class="p">,</span> <span class="n">batch</span><span class="p">.</span><span class="n">input_ids</span><span class="p">,</span> <span class="n">batch</span><span class="p">.</span><span class="n">attention_mask</span><span class="p">),</span>
                              <span class="n">skip_special_tokens</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">our generation matches Hugging Face</span><span class="sh">'</span><span class="s">s:</span><span class="sh">"</span><span class="p">,</span> <span class="n">ours</span> <span class="o">==</span> <span class="n">answers</span><span class="p">)</span>
<span class="k">for</span> <span class="n">text</span> <span class="ow">in</span> <span class="n">ours</span><span class="p">[:</span><span class="mi">2</span><span class="p">]:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">,</span> <span class="n">text</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>our generation matches Hugging Face's: True
  Die Wachen kommen morgens um sieben Uhr im Museum an.
  Le train de nuit à Vienne quitte à 11 heures.</code></pre> <h2 id="5-what-the-positions-learned-and-where-the-decoder-looks">5. What the positions learned, and where the decoder looks</h2> <p>The 32 biases of each head are all T5 knows about word order, so they are worth a look.</p> <p>Each row below is one of the eight heads of t5-small’s encoder; each column a distance from the query, from 20 tokens to the left to 20 to the right; the color is the bias the head adds to the score of a key at that distance.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">bias_by_distance</span><span class="p">(</span><span class="n">attention</span><span class="p">,</span> <span class="n">distances</span><span class="p">):</span>
    <span class="n">zero</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">long</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="n">bias</span> <span class="o">=</span> <span class="n">attention</span><span class="p">.</span><span class="nf">position_bias</span><span class="p">(</span><span class="n">zero</span><span class="p">,</span> <span class="n">distances</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">))</span>
    <span class="k">return</span> <span class="n">bias</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="p">:,</span> <span class="mi">0</span><span class="p">].</span><span class="nf">cpu</span><span class="p">()</span>  <span class="c1"># heads, distances
</span>

<span class="n">distances</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="o">-</span><span class="mi">20</span><span class="p">,</span> <span class="mi">21</span><span class="p">)</span>
<span class="n">encoder_bias</span> <span class="o">=</span> <span class="nf">bias_by_distance</span><span class="p">(</span><span class="n">t5</span><span class="p">.</span><span class="n">encoder</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="n">attention</span><span class="p">,</span> <span class="n">distances</span><span class="p">)</span>
<span class="n">limit</span> <span class="o">=</span> <span class="n">encoder_bias</span><span class="p">.</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
<span class="c1"># negative biases in teal, positive in rose, zero white
</span><span class="n">ends</span> <span class="o">=</span> <span class="p">[</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">card</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">]]</span>
<span class="n">diverging</span> <span class="o">=</span> <span class="n">LinearSegmentedColormap</span><span class="p">.</span><span class="nf">from_list</span><span class="p">(</span><span class="sh">"</span><span class="s">bias</span><span class="sh">"</span><span class="p">,</span> <span class="n">ends</span><span class="p">)</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.4</span><span class="p">,</span> <span class="mf">2.6</span><span class="p">))</span>
<span class="n">image</span> <span class="o">=</span> <span class="n">ax</span><span class="p">.</span><span class="nf">imshow</span><span class="p">(</span><span class="n">encoder_bias</span><span class="p">,</span> <span class="n">cmap</span><span class="o">=</span><span class="n">diverging</span><span class="p">,</span> <span class="n">vmin</span><span class="o">=-</span><span class="n">limit</span><span class="p">,</span> <span class="n">vmax</span><span class="o">=</span><span class="n">limit</span><span class="p">,</span> <span class="n">aspect</span><span class="o">=</span><span class="sh">"</span><span class="s">auto</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xticks</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">41</span><span class="p">,</span> <span class="mi">5</span><span class="p">),</span> <span class="p">[</span><span class="nf">str</span><span class="p">(</span><span class="n">d</span><span class="p">)</span> <span class="k">for</span> <span class="n">d</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="o">-</span><span class="mi">20</span><span class="p">,</span> <span class="mi">21</span><span class="p">,</span> <span class="mi">5</span><span class="p">)])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_yticks</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="mi">8</span><span class="p">),</span> <span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="s">head </span><span class="si">{</span><span class="n">h</span><span class="si">}</span><span class="sh">"</span> <span class="k">for</span> <span class="n">h</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">8</span><span class="p">)])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">key position minus query position</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">grid</span><span class="p">(</span><span class="bp">False</span><span class="p">)</span>
<span class="n">fig</span><span class="p">.</span><span class="nf">colorbar</span><span class="p">(</span><span class="n">image</span><span class="p">,</span> <span class="n">ax</span><span class="o">=</span><span class="n">ax</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">bias added to the score</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/05/output-02.png" alt="Output of the code above" loading="lazy"></p> <p>The heads have split the work. Some favour the left side and some the right; one rises sharply on the token just before the query, one on the token just after; one strongly avoids the query’s own position, so that it always reads a neighbour; and one barely cares about distance at all and attends by content.</p> <p>A model that is told nothing about order beyond these 32 numbers per head still builds a sense of left, right and next door. Beyond about ten tokens the biases flatten out: the buckets there are wide, and far is simply far.</p> <p>Cross-attention is where the encoder–decoder earns its name, and it can be watched. We translate the sentence of section 1 again with our model, keep the cross-attention weights of every decoder layer, and average the eight heads of one layer: each row is a German token being written, each column an English token of the input.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">source</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">([</span><span class="n">prompts</span><span class="p">[</span><span class="mi">0</span><span class="p">]],</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="n">german</span> <span class="o">=</span> <span class="nf">generate</span><span class="p">(</span><span class="n">t5</span><span class="p">,</span> <span class="n">source</span><span class="p">.</span><span class="n">input_ids</span><span class="p">,</span> <span class="n">source</span><span class="p">.</span><span class="n">attention_mask</span><span class="p">)</span>
<span class="n">start</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">long</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
<span class="n">decoder_input</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">start</span><span class="p">,</span> <span class="n">german</span><span class="p">[:,</span> <span class="p">:</span><span class="o">-</span><span class="mi">1</span><span class="p">]],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">memory</span> <span class="o">=</span> <span class="n">t5</span><span class="p">.</span><span class="nf">encode</span><span class="p">(</span><span class="n">source</span><span class="p">.</span><span class="n">input_ids</span><span class="p">,</span> <span class="n">source</span><span class="p">.</span><span class="n">attention_mask</span><span class="p">)</span>
    <span class="n">_</span><span class="p">,</span> <span class="n">cross</span> <span class="o">=</span> <span class="n">t5</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="n">decoder_input</span><span class="p">,</span> <span class="n">memory</span><span class="p">,</span> <span class="n">source</span><span class="p">.</span><span class="n">attention_mask</span><span class="p">,</span> <span class="n">keep_weights</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="c1"># SentencePiece marks a word's start with "▁"; we show it as a space
</span><span class="k">def</span> <span class="nf">readable</span><span class="p">(</span><span class="n">ids</span><span class="p">):</span>
    <span class="k">return</span> <span class="p">[</span><span class="n">t</span><span class="p">.</span><span class="nf">replace</span><span class="p">(</span><span class="sh">"</span><span class="s">▁</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">)</span> <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="n">tokenizer</span><span class="p">.</span><span class="nf">convert_ids_to_tokens</span><span class="p">(</span><span class="n">ids</span><span class="p">)]</span>


<span class="n">source_tokens</span><span class="p">,</span> <span class="n">german_tokens</span> <span class="o">=</span> <span class="nf">readable</span><span class="p">(</span><span class="n">source</span><span class="p">.</span><span class="n">input_ids</span><span class="p">[</span><span class="mi">0</span><span class="p">]),</span> <span class="nf">readable</span><span class="p">(</span><span class="n">german</span><span class="p">[</span><span class="mi">0</span><span class="p">])</span>
<span class="n">LAYER</span> <span class="o">=</span> <span class="mi">4</span>
<span class="n">weights</span> <span class="o">=</span> <span class="n">cross</span><span class="p">[</span><span class="n">LAYER</span><span class="p">][</span><span class="mi">0</span><span class="p">].</span><span class="nf">mean</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="mi">0</span><span class="p">).</span><span class="nf">cpu</span><span class="p">()</span>  <span class="c1"># rows: German tokens, columns: English tokens
</span><span class="nf">heatmap</span><span class="p">(</span><span class="n">weights</span><span class="p">,</span> <span class="n">rows</span><span class="o">=</span><span class="n">german_tokens</span><span class="p">,</span> <span class="n">cols</span><span class="o">=</span><span class="n">source_tokens</span><span class="p">,</span> <span class="n">cell</span><span class="o">=</span><span class="mf">0.3</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/05/output-03.png" alt="Output of the code above" loading="lazy"></p> <p>Most German tokens find their English source: <em>Wach</em> looks at <em>guard</em>, <em>kommen</em> at <em>arrive</em>, <em>sieben</em> at <em>seven</em>, <em>Museum</em> at <em>museum</em>. German puts the particle of <em>ankommen</em> at the very end of the sentence, and the last word, <em>an</em>, looks back at <em>arrive</em>. Nobody gave the model an alignment; it learned one because translating needs it.</p> <p>Much of the attention, though, goes to the task prefix, <em>to</em> and the colon, on nearly every row: a head that has nothing useful to read parks its weight on a token that carries no content, the same habit as the attention sinks of <a href="/blog/2026/transformer-architectures-09-long/">lesson 9</a>.</p> <h2 id="6-pre-training-by-repair-t5-and-bart">6. Pre-training by repair: T5 and BART</h2> <p>An encoder–decoder needs a task with an input and an output, and raw text has neither. Both T5 and BART make one up the same way: damage the text, give the damaged version to the encoder, and train the decoder to undo the damage. They damage it differently.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/05/objectives-light.png" width="760" alt="Two ways to pre-train an encoder–decoder on raw text. T5's span corruption replaces spans of the sentence with sentinel tokens, extra_id_0 and extra_id_1, and the target lists only the dropped spans, each after its sentinel, so the target is short. BART's text infilling replaces each span with a single mask token, which can stand for any number of words, and the target is the whole original sentence" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/05/objectives-dark.png" width="760" alt="Two ways to pre-train an encoder–decoder on raw text. T5's span corruption replaces spans of the sentence with sentinel tokens, extra_id_0 and extra_id_1, and the target lists only the dropped spans, each after its sentinel, so the target is short. BART's text infilling replaces each span with a single mask token, which can stand for any number of words, and the target is the whole original sentence" loading="lazy"></p> <p>T5’s version is <em>span corruption</em>. It drops 15% of the tokens in spans of 3 on average, replaces each span with a sentinel token, <code class="language-plaintext highlighter-rouge">&lt;extra_id_0&gt;</code>, <code class="language-plaintext highlighter-rouge">&lt;extra_id_1&gt;</code> and so on, and asks the decoder for the dropped spans only, each after its sentinel, with one more sentinel at the end.</p> <p>The targets are short, and that was the point: the choice was “made to reduce the computational cost of <a href="/blog/2024/llms-for-those-who-missed-out/">pre-training</a>”. Across the many variants the paper tried, the details of the corruption mattered little. What mattered was that “denoising objectives outperformed language modeling”.</p> <p>BART, which Facebook AI published the same month, is the same design seen from the other side: “a denoising autoencoder for pretraining sequence-to-sequence models”, whose bidirectional encoder and left-to-right decoder “can be seen as generalizing BERT […], GPT […], and other recent pretraining schemes” <sup class="cite">[<a href="#ref-5" id="cite-5" data-ref="5" aria-label="Reference 5: Lewis, M., Liu, Y., Goyal, N., Ghazvininejad, M., Mohamed, A., Levy, O., Stoyanov, V., &amp; Zettlemoyer, L. (2020). BART: denoising sequence-to-sequence pre-training for natural language generation, translation, and comprehension. ACL 2020.">5</a>]</sup>.</p> <p>Its best corruption was <em>text infilling</em>: span lengths are drawn from a Poisson distribution with a mean of 3, and each span becomes a single mask token, even a span of length zero, so the model has to “predict how many tokens are missing from a span”.</p> <p>The large model also shuffled the order of the sentences. BART’s decoder writes the whole document back, which made it a strong generator: on XSum, a summarisation dataset the BART paper calls highly abstractive, it beat the best earlier model by “roughly 3.5 points on all ROUGE metrics”.</p> <p>Inside, BART is the Transformer of 2017 with GPT’s GELU in place of ReLU, which makes its layers closer to BERT’s than to T5’s: learned position embeddings for up to 1,024 positions, a LayerNorm with its mean and bias after each part of the layer, biases in every linear layer, and GPT-2’s byte-level vocabulary, in which <code class="language-plaintext highlighter-rouge">&lt;</code> and every other character have a token.</p> <p>The model we load below, bart-base, has 6 layers on each side and a width of 768.</p> <p>T5’s recipe comes down to two numbers: 15% of the tokens are dropped, in spans of 3 tokens on average, at random places.</p> <p>Google’s code first decides how many tokens to drop and how many spans to cut them into, then splits both the dropped and the kept tokens into that many pieces of random length, and interleaves them. Here it is on the example sentence from the T5 paper:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">random_split</span><span class="p">(</span><span class="n">total</span><span class="p">,</span> <span class="n">parts</span><span class="p">,</span> <span class="n">rng</span><span class="p">):</span>
    <span class="c1"># a random way to write `total` as a sum of `parts` positive whole numbers
</span>    <span class="n">cuts</span> <span class="o">=</span> <span class="nf">sorted</span><span class="p">(</span><span class="n">rng</span><span class="p">.</span><span class="nf">sample</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">total</span><span class="p">),</span> <span class="n">parts</span> <span class="o">-</span> <span class="mi">1</span><span class="p">))</span>
    <span class="n">edges</span> <span class="o">=</span> <span class="p">[</span><span class="mi">0</span><span class="p">]</span> <span class="o">+</span> <span class="n">cuts</span> <span class="o">+</span> <span class="p">[</span><span class="n">total</span><span class="p">]</span>
    <span class="k">return</span> <span class="p">[</span><span class="n">edges</span><span class="p">[</span><span class="n">i</span> <span class="o">+</span> <span class="mi">1</span><span class="p">]</span> <span class="o">-</span> <span class="n">edges</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">parts</span><span class="p">)]</span>


<span class="k">def</span> <span class="nf">span_corruption</span><span class="p">(</span><span class="n">tokens</span><span class="p">,</span> <span class="n">rng</span><span class="p">,</span> <span class="n">density</span><span class="o">=</span><span class="mf">0.15</span><span class="p">,</span> <span class="n">mean_span</span><span class="o">=</span><span class="mi">3</span><span class="p">):</span>
    <span class="n">n</span> <span class="o">=</span> <span class="nf">len</span><span class="p">(</span><span class="n">tokens</span><span class="p">)</span>
    <span class="n">dropped</span> <span class="o">=</span> <span class="nf">min</span><span class="p">(</span><span class="nf">max</span><span class="p">(</span><span class="nf">round</span><span class="p">(</span><span class="n">n</span> <span class="o">*</span> <span class="n">density</span><span class="p">),</span> <span class="mi">1</span><span class="p">),</span> <span class="n">n</span> <span class="o">-</span> <span class="mi">1</span><span class="p">)</span>
    <span class="n">spans</span> <span class="o">=</span> <span class="nf">max</span><span class="p">(</span><span class="nf">round</span><span class="p">(</span><span class="n">dropped</span> <span class="o">/</span> <span class="n">mean_span</span><span class="p">),</span> <span class="mi">1</span><span class="p">)</span>
    <span class="n">dropped_lengths</span> <span class="o">=</span> <span class="nf">random_split</span><span class="p">(</span><span class="n">dropped</span><span class="p">,</span> <span class="n">spans</span><span class="p">,</span> <span class="n">rng</span><span class="p">)</span>
    <span class="n">kept_lengths</span> <span class="o">=</span> <span class="nf">random_split</span><span class="p">(</span><span class="n">n</span> <span class="o">-</span> <span class="n">dropped</span><span class="p">,</span> <span class="n">spans</span><span class="p">,</span> <span class="n">rng</span><span class="p">)</span>
    <span class="n">source</span><span class="p">,</span> <span class="n">target</span><span class="p">,</span> <span class="n">i</span> <span class="o">=</span> <span class="p">[],</span> <span class="p">[],</span> <span class="mi">0</span>
    <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">spans</span><span class="p">):</span>
        <span class="n">source</span> <span class="o">+=</span> <span class="n">tokens</span><span class="p">[</span><span class="n">i</span><span class="p">:</span><span class="n">i</span> <span class="o">+</span> <span class="n">kept_lengths</span><span class="p">[</span><span class="n">k</span><span class="p">]]</span>
        <span class="n">i</span> <span class="o">+=</span> <span class="n">kept_lengths</span><span class="p">[</span><span class="n">k</span><span class="p">]</span>
        <span class="n">sentinel</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">&lt;extra_id_</span><span class="si">{</span><span class="n">k</span><span class="si">}</span><span class="s">&gt;</span><span class="sh">"</span>
        <span class="n">source</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">sentinel</span><span class="p">)</span>
        <span class="n">target</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">sentinel</span><span class="p">)</span>
        <span class="n">target</span> <span class="o">+=</span> <span class="n">tokens</span><span class="p">[</span><span class="n">i</span><span class="p">:</span><span class="n">i</span> <span class="o">+</span> <span class="n">dropped_lengths</span><span class="p">[</span><span class="n">k</span><span class="p">]]</span>
        <span class="n">i</span> <span class="o">+=</span> <span class="n">dropped_lengths</span><span class="p">[</span><span class="n">k</span><span class="p">]</span>
    <span class="n">target</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">&lt;extra_id_</span><span class="si">{</span><span class="n">spans</span><span class="si">}</span><span class="s">&gt;</span><span class="sh">"</span><span class="p">)</span>  <span class="c1"># the last sentinel says: nothing more
</span>    <span class="k">return</span> <span class="n">source</span><span class="p">,</span> <span class="n">target</span>


<span class="n">paper_sentence</span> <span class="o">=</span> <span class="n">tokenizer</span><span class="p">.</span><span class="nf">tokenize</span><span class="p">(</span><span class="sh">"</span><span class="s">Thank you for inviting me to your party last week.</span><span class="sh">"</span><span class="p">)</span>
<span class="n">paper_sentence</span> <span class="o">=</span> <span class="p">[</span><span class="n">t</span><span class="p">.</span><span class="nf">replace</span><span class="p">(</span><span class="sh">"</span><span class="s">▁</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">)</span> <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="n">paper_sentence</span><span class="p">]</span>
<span class="n">source</span><span class="p">,</span> <span class="n">target</span> <span class="o">=</span> <span class="nf">span_corruption</span><span class="p">(</span><span class="n">paper_sentence</span><span class="p">,</span> <span class="n">random</span><span class="p">.</span><span class="nc">Random</span><span class="p">(</span><span class="mi">3</span><span class="p">),</span> <span class="n">density</span><span class="o">=</span><span class="mf">0.3</span><span class="p">,</span> <span class="n">mean_span</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
<span class="nf">token_chips</span><span class="p">([</span><span class="n">source</span><span class="p">,</span> <span class="n">target</span><span class="p">],</span> <span class="n">labels</span><span class="o">=</span><span class="p">[</span><span class="sh">"</span><span class="s">encoder reads</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">decoder writes</span><span class="sh">"</span><span class="p">],</span>
            <span class="n">strong</span><span class="o">=</span><span class="k">lambda</span> <span class="n">row</span><span class="p">,</span> <span class="n">col</span><span class="p">,</span> <span class="n">token</span><span class="p">:</span> <span class="n">token</span><span class="p">.</span><span class="nf">startswith</span><span class="p">(</span><span class="sh">"</span><span class="s">&lt;extra</span><span class="sh">"</span><span class="p">))</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/05/output-04.png" alt="Output of the code above" loading="lazy"></p> <p>The encoder sees the sentence with holes, each hole one sentinel however many tokens it hides. The decoder’s target lists what is missing, in order, and closes with one more sentinel.</p> <p>A sentence of 11 tokens would lose only two at T5’s rate, so the cell doubles it; on a 512-token passage of C4 the real recipe cuts about two dozen holes, in every kind of place.</p> <p>So does a pre-trained T5 repair text? Ask it to fill the spans the T5 paper drops. We use t5-base here, which we also need in section 8; the smallest model fills them less reliably.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">T5_BASE</span> <span class="o">=</span> <span class="sh">"</span><span class="s">google-t5/t5-base</span><span class="sh">"</span>
<span class="n">base_reference</span> <span class="o">=</span> <span class="n">T5ForConditionalGeneration</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">T5_BASE</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="n">damaged</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">Thank you &lt;extra_id_0&gt; me to your party &lt;extra_id_1&gt; week.</span><span class="sh">"</span><span class="p">,</span>
           <span class="sh">"</span><span class="s">The guards &lt;extra_id_0&gt; at the museum at &lt;extra_id_1&gt; in the morning.</span><span class="sh">"</span><span class="p">,</span>
           <span class="sh">"</span><span class="s">The night train to &lt;extra_id_0&gt; leaves at eleven and arrives in &lt;extra_id_1&gt; </span><span class="sh">"</span>
           <span class="sh">"</span><span class="s">the next morning.</span><span class="sh">"</span><span class="p">]</span>
<span class="n">batch</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="n">damaged</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">,</span> <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">repaired</span> <span class="o">=</span> <span class="n">base_reference</span><span class="p">.</span><span class="nf">generate</span><span class="p">(</span><span class="o">**</span><span class="n">batch</span><span class="p">,</span> <span class="n">max_new_tokens</span><span class="o">=</span><span class="mi">16</span><span class="p">,</span> <span class="n">num_beams</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span>
                                       <span class="n">do_sample</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="k">def</span> <span class="nf">fill_spans</span><span class="p">(</span><span class="n">damaged_text</span><span class="p">,</span> <span class="n">written</span><span class="p">):</span>
    <span class="c1"># the output is "&lt;extra_id_0&gt; span &lt;extra_id_1&gt; span …"; each span goes back in place
</span>    <span class="n">pieces</span> <span class="o">=</span> <span class="n">re</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s">&lt;extra_id_\d+&gt;</span><span class="sh">"</span><span class="p">,</span> <span class="n">written</span><span class="p">.</span><span class="nf">replace</span><span class="p">(</span><span class="sh">"</span><span class="s">&lt;pad&gt;</span><span class="sh">"</span><span class="p">,</span> <span class="sh">""</span><span class="p">).</span><span class="nf">replace</span><span class="p">(</span><span class="sh">"</span><span class="s">&lt;/s&gt;</span><span class="sh">"</span><span class="p">,</span> <span class="sh">""</span><span class="p">))</span>
    <span class="n">filled</span> <span class="o">=</span> <span class="n">damaged_text</span>
    <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">damaged_text</span><span class="p">.</span><span class="nf">count</span><span class="p">(</span><span class="sh">"</span><span class="s">&lt;extra_id_</span><span class="sh">"</span><span class="p">)):</span>
        <span class="n">span</span> <span class="o">=</span> <span class="n">pieces</span><span class="p">[</span><span class="n">k</span> <span class="o">+</span> <span class="mi">1</span><span class="p">].</span><span class="nf">strip</span><span class="p">()</span> <span class="k">if</span> <span class="n">k</span> <span class="o">+</span> <span class="mi">1</span> <span class="o">&lt;</span> <span class="nf">len</span><span class="p">(</span><span class="n">pieces</span><span class="p">)</span> <span class="k">else</span> <span class="sh">"</span><span class="s">?</span><span class="sh">"</span>
        <span class="n">filled</span> <span class="o">=</span> <span class="n">filled</span><span class="p">.</span><span class="nf">replace</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">&lt;extra_id_</span><span class="si">{</span><span class="n">k</span><span class="si">}</span><span class="s">&gt;</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="s">[</span><span class="si">{</span><span class="n">span</span><span class="si">}</span><span class="s">]</span><span class="sh">"</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">filled</span>


<span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">text</span><span class="p">,</span> <span class="n">ids</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">damaged</span><span class="p">,</span> <span class="n">repaired</span><span class="p">):</span>
    <span class="n">written</span> <span class="o">=</span> <span class="n">tokenizer</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">skip_special_tokens</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
    <span class="n">shown</span> <span class="o">=</span> <span class="n">written</span><span class="p">.</span><span class="nf">replace</span><span class="p">(</span><span class="sh">"</span><span class="s">&lt;pad&gt;</span><span class="sh">"</span><span class="p">,</span> <span class="sh">""</span><span class="p">)[:</span><span class="mi">48</span><span class="p">]</span> <span class="o">+</span> <span class="sh">"</span><span class="s">…</span><span class="sh">"</span>
    <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">damaged</span><span class="sh">"</span><span class="p">:</span> <span class="n">text</span><span class="p">,</span> <span class="sh">"</span><span class="s">t5-base writes</span><span class="sh">"</span><span class="p">:</span> <span class="n">shown</span><span class="p">,</span>
                 <span class="sh">"</span><span class="s">the spans put back</span><span class="sh">"</span><span class="p">:</span> <span class="nf">fill_spans</span><span class="p">(</span><span class="n">text</span><span class="p">,</span> <span class="n">written</span><span class="p">)})</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">damaged</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">t5-base writes</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">the spans put back</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Thank you &lt;extra_id_0&gt; me to your party &lt;extra_id_1&gt; week.</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">&lt;extra_id_0&gt; for inviting&lt;extra_id_1&gt; this&lt;extra…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Thank you [for inviting] me to your party [this] week.</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">The guards &lt;extra_id_0&gt; at the museum at &lt;extra_id_1&gt; in the morning.</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">&lt;extra_id_0&gt; arrive&lt;extra_id_1&gt; 8&lt;extra_id_2&gt; ar…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">The guards [arrive] at the museum at [8] in the morning.</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">The night train to &lt;extra_id_0&gt; leaves at eleven and arrives in &lt;extra_id_1&gt; the next morning.</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">&lt;extra_id_0&gt; London&lt;extra_id_1&gt; London&lt;extra_id_…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">The night train to [London] leaves at eleven and arrives in [London] the next morning.</td></tr></tbody></table></div> <p>t5-base fills the gaps sensibly: <em>for inviting</em> and <em>this</em> in the paper’s sentence, a verb and a time for the guards, a city for the train.</p> <p>The middle column shows what it actually writes. It doesn’t stop after the last gap: the target of span corruption ends with one more sentinel, and this model keeps going past it, inventing more gaps and repeating itself, so we read only as many spans as there are holes.</p> <p>Most likely the released t5-base, trained on long passages of C4 mixed with supervised tasks, never saw a single short sentence with two holes.</p> <p>BART’s version is closer to BERT’s masked language model, and to what the decoder of lesson 4 does. Each span becomes one <code class="language-plaintext highlighter-rouge">&lt;mask&gt;</code>, whatever its length, and the decoder writes the whole text back, so it also has to decide how many words each mask hid:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">BART</span> <span class="o">=</span> <span class="sh">"</span><span class="s">facebook/bart-base</span><span class="sh">"</span>
<span class="n">bart_tokenizer</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">BART</span><span class="p">)</span>
<span class="n">bart</span> <span class="o">=</span> <span class="n">BartForConditionalGeneration</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">BART</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="n">masked</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">Thank you &lt;mask&gt; me to your party &lt;mask&gt; week.</span><span class="sh">"</span><span class="p">,</span>
          <span class="sh">"</span><span class="s">The guards &lt;mask&gt; at the museum at &lt;mask&gt; in the morning.</span><span class="sh">"</span><span class="p">,</span>
          <span class="sh">"</span><span class="s">The night train to &lt;mask&gt; leaves at eleven and arrives in &lt;mask&gt; </span><span class="sh">"</span>
          <span class="sh">"</span><span class="s">the next morning.</span><span class="sh">"</span><span class="p">]</span>
<span class="n">batch</span> <span class="o">=</span> <span class="nf">bart_tokenizer</span><span class="p">(</span><span class="n">masked</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">,</span> <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">repaired</span> <span class="o">=</span> <span class="n">bart</span><span class="p">.</span><span class="nf">generate</span><span class="p">(</span><span class="o">**</span><span class="n">batch</span><span class="p">,</span> <span class="n">max_new_tokens</span><span class="o">=</span><span class="mi">32</span><span class="p">,</span> <span class="n">num_beams</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">do_sample</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">written</span> <span class="o">=</span> <span class="n">bart_tokenizer</span><span class="p">.</span><span class="nf">batch_decode</span><span class="p">(</span><span class="n">repaired</span><span class="p">,</span> <span class="n">skip_special_tokens</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">({</span><span class="sh">"</span><span class="s">masked</span><span class="sh">"</span><span class="p">:</span> <span class="n">masked</span><span class="p">,</span> <span class="sh">"</span><span class="s">BART writes</span><span class="sh">"</span><span class="p">:</span> <span class="n">written</span><span class="p">}))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">masked</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">BART writes</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Thank you &lt;mask&gt; me to your party &lt;mask&gt; week.</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Thank you for inviting me to your party this week.</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">The guards &lt;mask&gt; at the museum at &lt;mask&gt; in the morning.</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">The guards were at the museum at about 2:30 in the morning.</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">The night train to &lt;mask&gt; leaves at eleven and arrives in &lt;mask&gt; the next morning.</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">The night train to the airport leaves at eleven and arrives in New York the next morning.</td></tr></tbody></table></div> <p>BART writes each sentence back whole and decides the length of each gap itself: one mask becomes one word, another becomes two. For the night train it invents a whole route.</p> <p>The repairs are fluent and plausible rather than right, and that is all a pre-training objective can ask for, since nothing in the damaged text says which words were removed. What the model learns from millions of such guesses is how text hangs together, which is what fine-tuning then puts to work.</p> <h2 id="7-spider-questions-about-databases-the-model-has-never-seen">7. Spider: questions about databases the model has never seen</h2> <p>Spider was built at Yale in 2018. Eleven students spent “a total of 1,000 man-hours” writing “10,181 questions and 5,693 unique complex SQL queries on 200 databases with multiple tables, covering 138 different domains” <sup class="cite">[<a href="#ref-6" id="cite-6" data-ref="6" aria-label="Reference 6: Yu, T., Zhang, R., Yang, K., et al. (2018). Spider: a large-scale human-labeled dataset for complex and cross-domain semantic parsing and text-to-SQL task. EMNLP 2018. Data: yale-lily.github.io/spider, CC BY-SA 4.0.">6</a>]</sup>.</p> <p>What made it hard was the split: the databases of the test set never appear in training, so a model has to read a schema it has never seen.</p> <p>The best model in the paper got 12.4% of the test queries exactly right. In 2021 T5-3B with PICARD, a decoder that rejects any token that would make the query invalid, reached 75.1% execution accuracy on the test set.</p> <p>PICARD’s authors noted that without it, “12% of the SQL queries generated by the T5-3B model on Spider’s development set result in an execution error” <sup class="cite">[<a href="#ref-7" id="cite-7" data-ref="7" aria-label="Reference 7: Scholak, T., Schucher, N., &amp; Bahdanau, D. (2021). PICARD: parsing incrementally for constrained auto-regressive decoding from language models. EMNLP 2021.">7</a>]</sup>. GPT-4 with careful prompting took the leaderboard to 85.3% and then 86.6% in 2023, and in February 2024 the authors closed it.</p> <p>The Spider authors distribute the databases as SQLite files; the Hugging Face copy we use is a re-host of the official archive, pinned to one revision, under the same CC BY-SA 4.0 licence.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">SPIDER</span> <span class="o">=</span> <span class="sh">"</span><span class="s">HAL-9001/spider-databases</span><span class="sh">"</span>
<span class="n">SPIDER_REVISION</span> <span class="o">=</span> <span class="sh">"</span><span class="s">4a01bbac6520cd35b216db9e1724e5e1ada60aa4</span><span class="sh">"</span>
<span class="n">archive</span> <span class="o">=</span> <span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">SPIDER</span><span class="p">,</span> <span class="sh">"</span><span class="s">spider_data.zip</span><span class="sh">"</span><span class="p">,</span> <span class="n">repo_type</span><span class="o">=</span><span class="sh">"</span><span class="s">dataset</span><span class="sh">"</span><span class="p">,</span>
                          <span class="n">revision</span><span class="o">=</span><span class="n">SPIDER_REVISION</span><span class="p">)</span>
<span class="k">with</span> <span class="n">zipfile</span><span class="p">.</span><span class="nc">ZipFile</span><span class="p">(</span><span class="n">archive</span><span class="p">)</span> <span class="k">as</span> <span class="n">z</span><span class="p">:</span>
    <span class="n">z</span><span class="p">.</span><span class="nf">extractall</span><span class="p">(</span><span class="n">WORK_DIR</span><span class="p">)</span>
<span class="n">SPIDER_DIR</span> <span class="o">=</span> <span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">spider_data</span><span class="sh">"</span>

<span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="n">SPIDER_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">train_spider.json</span><span class="sh">"</span><span class="p">)</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
    <span class="n">train_set</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">f</span><span class="p">)</span>
<span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="n">SPIDER_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">dev.json</span><span class="sh">"</span><span class="p">)</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
    <span class="n">dev_set</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">f</span><span class="p">)</span>
<span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="n">SPIDER_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">tables.json</span><span class="sh">"</span><span class="p">)</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
    <span class="n">schemas</span> <span class="o">=</span> <span class="p">{</span><span class="n">db</span><span class="p">[</span><span class="sh">"</span><span class="s">db_id</span><span class="sh">"</span><span class="p">]:</span> <span class="n">db</span> <span class="k">for</span> <span class="n">db</span> <span class="ow">in</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">f</span><span class="p">)}</span>
<span class="n">train_dbs</span> <span class="o">=</span> <span class="p">{</span><span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">db_id</span><span class="sh">"</span><span class="p">]</span> <span class="k">for</span> <span class="n">e</span> <span class="ow">in</span> <span class="n">train_set</span><span class="p">}</span>
<span class="n">dev_dbs</span> <span class="o">=</span> <span class="p">{</span><span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">db_id</span><span class="sh">"</span><span class="p">]</span> <span class="k">for</span> <span class="n">e</span> <span class="ow">in</span> <span class="n">dev_set</span><span class="p">}</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">training: </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">train_set</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> questions on </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">train_dbs</span><span class="p">)</span><span class="si">}</span><span class="s"> databases</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">development: </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">dev_set</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> questions on </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">dev_dbs</span><span class="p">)</span><span class="si">}</span><span class="s"> databases</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">databases in both:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">train_dbs</span> <span class="o">&amp;</span> <span class="n">dev_dbs</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>training: 7,000 questions on 140 databases
development: 1,034 questions on 20 databases
databases in both: 0</code></pre> <p>Not one database is shared between the two sets, as the last line shows. Here is the first development question, about <code class="language-plaintext highlighter-rouge">concert_singer</code>, and the table it asks about:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">example</span> <span class="o">=</span> <span class="n">dev_set</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">question:</span><span class="sh">"</span><span class="p">,</span> <span class="n">example</span><span class="p">[</span><span class="sh">"</span><span class="s">question</span><span class="sh">"</span><span class="p">])</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">query:   </span><span class="sh">"</span><span class="p">,</span> <span class="n">example</span><span class="p">[</span><span class="sh">"</span><span class="s">query</span><span class="sh">"</span><span class="p">])</span>
<span class="n">database</span> <span class="o">=</span> <span class="n">SPIDER_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">database</span><span class="sh">"</span> <span class="o">/</span> <span class="n">example</span><span class="p">[</span><span class="sh">"</span><span class="s">db_id</span><span class="sh">"</span><span class="p">]</span> <span class="o">/</span> <span class="p">(</span><span class="n">example</span><span class="p">[</span><span class="sh">"</span><span class="s">db_id</span><span class="sh">"</span><span class="p">]</span> <span class="o">+</span> <span class="sh">"</span><span class="s">.sqlite</span><span class="sh">"</span><span class="p">)</span>
<span class="k">with</span> <span class="n">sqlite3</span><span class="p">.</span><span class="nf">connect</span><span class="p">(</span><span class="n">database</span><span class="p">)</span> <span class="k">as</span> <span class="n">connection</span><span class="p">:</span>
    <span class="n">singers</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nf">read_sql_query</span><span class="p">(</span><span class="sh">"</span><span class="s">SELECT * FROM singer</span><span class="sh">"</span><span class="p">,</span> <span class="n">connection</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">singers</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>question: How many singers do we have?
query:    SELECT count(*) FROM singer</code></pre> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">Singer_ID</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">Name</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">Country</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">Song_Name</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">Song_release_year</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">Age</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">Is_male</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Joe Sharp</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Netherlands</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">You</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">1992</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">52</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">F</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Timbaland</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">United States</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Dangerous</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2008</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">T</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Justin Brown</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">France</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Hey Oh</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2013</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">29</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">T</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Rose White</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">France</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Sun</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2003</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">41</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">F</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">John Nizinik</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">France</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Gentleman</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2014</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">43</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">T</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Tribal King</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">France</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Love</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2016</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">25</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">T</td></tr></tbody></table></div> <p>The model gets the question and the schema as one line of text: the database’s name, then every table with its columns, the names exactly as SQL has to write them.</p> <p>Nothing else: no rows, no types, no keys. That keeps the input short, and it means the model has to guess, from names alone, that <code class="language-plaintext highlighter-rouge">Singer_ID</code> in <code class="language-plaintext highlighter-rouge">singer_in_concert</code> points to <code class="language-plaintext highlighter-rouge">singer</code>.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">schema_text</span><span class="p">(</span><span class="n">db_id</span><span class="p">,</span> <span class="n">only</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
    <span class="n">db</span> <span class="o">=</span> <span class="n">schemas</span><span class="p">[</span><span class="n">db_id</span><span class="p">]</span>
    <span class="n">columns</span> <span class="o">=</span> <span class="p">{}</span>
    <span class="k">for</span> <span class="n">table_index</span><span class="p">,</span> <span class="n">column</span> <span class="ow">in</span> <span class="n">db</span><span class="p">[</span><span class="sh">"</span><span class="s">column_names_original</span><span class="sh">"</span><span class="p">][</span><span class="mi">1</span><span class="p">:]:</span>  <span class="c1"># the first is "*"
</span>        <span class="n">columns</span><span class="p">.</span><span class="nf">setdefault</span><span class="p">(</span><span class="n">table_index</span><span class="p">,</span> <span class="p">[]).</span><span class="nf">append</span><span class="p">(</span><span class="n">column</span><span class="p">)</span>
    <span class="n">parts</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">name</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">db</span><span class="p">[</span><span class="sh">"</span><span class="s">table_names_original</span><span class="sh">"</span><span class="p">]):</span>
        <span class="k">if</span> <span class="n">only</span> <span class="ow">is</span> <span class="bp">None</span> <span class="ow">or</span> <span class="n">name</span><span class="p">.</span><span class="nf">lower</span><span class="p">()</span> <span class="ow">in</span> <span class="n">only</span><span class="p">:</span>
            <span class="n">parts</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">name</span> <span class="o">+</span> <span class="sh">"</span><span class="s"> : </span><span class="sh">"</span> <span class="o">+</span> <span class="sh">"</span><span class="s"> , </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">columns</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="n">i</span><span class="p">,</span> <span class="p">[])))</span>
    <span class="k">return</span> <span class="n">db_id</span> <span class="o">+</span> <span class="sh">"</span><span class="s"> | </span><span class="sh">"</span> <span class="o">+</span> <span class="sh">"</span><span class="s"> | </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">parts</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">model_input</span><span class="p">(</span><span class="n">example</span><span class="p">,</span> <span class="n">only</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
    <span class="k">return</span> <span class="n">example</span><span class="p">[</span><span class="sh">"</span><span class="s">question</span><span class="sh">"</span><span class="p">]</span> <span class="o">+</span> <span class="sh">"</span><span class="s"> | </span><span class="sh">"</span> <span class="o">+</span> <span class="nf">schema_text</span><span class="p">(</span><span class="n">example</span><span class="p">[</span><span class="sh">"</span><span class="s">db_id</span><span class="sh">"</span><span class="p">],</span> <span class="n">only</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">model_target</span><span class="p">(</span><span class="n">example</span><span class="p">):</span>
    <span class="c1"># Spider's queries have stray spaces and line breaks
</span>    <span class="k">return</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">example</span><span class="p">[</span><span class="sh">"</span><span class="s">query</span><span class="sh">"</span><span class="p">].</span><span class="nf">split</span><span class="p">())</span>


<span class="nf">print</span><span class="p">(</span><span class="nf">model_input</span><span class="p">(</span><span class="n">example</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">model_target</span><span class="p">(</span><span class="n">example</span><span class="p">))</span>
<span class="n">lengths</span> <span class="o">=</span> <span class="p">[</span><span class="nf">len</span><span class="p">(</span><span class="nf">tokenizer</span><span class="p">(</span><span class="nf">model_input</span><span class="p">(</span><span class="n">e</span><span class="p">)).</span><span class="n">input_ids</span><span class="p">)</span> <span class="k">for</span> <span class="n">e</span> <span class="ow">in</span> <span class="n">train_set</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">input tokens: median</span><span class="sh">"</span><span class="p">,</span> <span class="nf">int</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">median</span><span class="p">(</span><span class="n">lengths</span><span class="p">)),</span> <span class="sh">"</span><span class="s">longest</span><span class="sh">"</span><span class="p">,</span> <span class="nf">max</span><span class="p">(</span><span class="n">lengths</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">training inputs longer than 512 tokens:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">sum</span><span class="p">(</span><span class="n">n</span> <span class="o">&gt;</span> <span class="mi">512</span> <span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="n">lengths</span><span class="p">))</span>
<span class="n">dev_lengths</span> <span class="o">=</span> <span class="p">[</span><span class="nf">len</span><span class="p">(</span><span class="nf">tokenizer</span><span class="p">(</span><span class="nf">model_input</span><span class="p">(</span><span class="n">e</span><span class="p">)).</span><span class="n">input_ids</span><span class="p">)</span> <span class="k">for</span> <span class="n">e</span> <span class="ow">in</span> <span class="n">dev_set</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">development inputs longer than 512 tokens:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">sum</span><span class="p">(</span><span class="n">n</span> <span class="o">&gt;</span> <span class="mi">512</span> <span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="n">dev_lengths</span><span class="p">))</span>

<span class="c1"># a schema cut at 512 tokens would teach the model about tables it was never shown,
# so a long one keeps only the tables its query uses
</span><span class="n">shortened</span> <span class="o">=</span> <span class="mi">0</span>
<span class="k">for</span> <span class="n">e</span><span class="p">,</span> <span class="n">n</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">train_set</span><span class="p">,</span> <span class="n">lengths</span><span class="p">):</span>
    <span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">input</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="nf">model_input</span><span class="p">(</span><span class="n">e</span><span class="p">)</span>
    <span class="k">if</span> <span class="n">n</span> <span class="o">&gt;</span> <span class="mi">512</span><span class="p">:</span>
        <span class="n">words</span> <span class="o">=</span> <span class="nf">set</span><span class="p">(</span><span class="n">re</span><span class="p">.</span><span class="nf">findall</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s">[a-z_][a-z0-9_]*</span><span class="sh">"</span><span class="p">,</span> <span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">query</span><span class="sh">"</span><span class="p">].</span><span class="nf">lower</span><span class="p">()))</span>
        <span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">input</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="nf">model_input</span><span class="p">(</span><span class="n">e</span><span class="p">,</span> <span class="n">only</span><span class="o">=</span><span class="n">words</span><span class="p">)</span>
        <span class="n">shortened</span> <span class="o">+=</span> <span class="mi">1</span>
<span class="k">for</span> <span class="n">e</span> <span class="ow">in</span> <span class="n">dev_set</span><span class="p">:</span>
    <span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">input</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="nf">model_input</span><span class="p">(</span><span class="n">e</span><span class="p">)</span>
<span class="n">lengths</span> <span class="o">=</span> <span class="p">[</span><span class="nf">len</span><span class="p">(</span><span class="nf">tokenizer</span><span class="p">(</span><span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">input</span><span class="sh">"</span><span class="p">]).</span><span class="n">input_ids</span><span class="p">)</span> <span class="k">for</span> <span class="n">e</span> <span class="ow">in</span> <span class="n">train_set</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">training schemas shortened to the tables of their query:</span><span class="sh">"</span><span class="p">,</span> <span class="n">shortened</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">training inputs still longer than 512 tokens:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">sum</span><span class="p">(</span><span class="n">n</span> <span class="o">&gt;</span> <span class="mi">512</span> <span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="n">lengths</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>How many singers do we have? | concert_singer | stadium : Stadium_ID , Location , Name , Capacity , Highest , Lowest , Average | singer : Singer_ID , Name , Country , Song_Name , Song_release_year , Age , Is_male | concert : concert_ID , concert_Name , Theme , Stadium_ID , Year | singer_in_concert : concert_ID , Singer_ID
SELECT count(*) FROM singer
input tokens: median 140 longest 1892
training inputs longer than 512 tokens: 323
development inputs longer than 512 tokens: 0
training schemas shortened to the tables of their query: 323
training inputs still longer than 512 tokens: 0</code></pre> <p>A few training databases have schemas too long for 512 tokens. Cutting them at 512 would teach the model to write about tables it was never shown, which is exactly the mistake we least want it to learn, and dropping their questions would lose some of the hardest joins in the set.</p> <p>So for those questions alone the schema keeps only the tables that the reference query uses. Every development schema fits whole, so the evaluation never relies on this.</p> <p>The keys are the costly omission. Spider’s <code class="language-plaintext highlighter-rouge">tables.json</code> lists which column points to which, and a join needs exactly that; but writing the keys in would push hundreds of training inputs and dozens of development inputs past 512 tokens, so we leave them out. Section 9 shows what that costs.</p> <h2 id="8-a-t5-that-writes-sql">8. A T5 that writes SQL</h2> <p>Before training anything, one problem. Ask the <a href="/blog/2026/transformers-from-scratch-01-tokenization/">tokenizer</a> to read a query with a comparison:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">query</span> <span class="o">=</span> <span class="sh">"</span><span class="s">SELECT count(*) FROM singer WHERE Age &lt; 30</span><span class="sh">"</span>
<span class="n">ids</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="n">query</span><span class="p">).</span><span class="n">input_ids</span>
<span class="nf">print</span><span class="p">(</span><span class="n">tokenizer</span><span class="p">.</span><span class="nf">convert_ids_to_tokens</span><span class="p">(</span><span class="n">ids</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">back to text:</span><span class="sh">"</span><span class="p">,</span> <span class="n">tokenizer</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">skip_special_tokens</span><span class="o">=</span><span class="bp">True</span><span class="p">))</span>
<span class="n">with_less</span> <span class="o">=</span> <span class="nf">sum</span><span class="p">(</span><span class="sh">"</span><span class="s">&lt;</span><span class="sh">"</span> <span class="ow">in</span> <span class="nf">model_target</span><span class="p">(</span><span class="n">e</span><span class="p">)</span> <span class="k">for</span> <span class="n">e</span> <span class="ow">in</span> <span class="n">train_set</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">training queries with </span><span class="sh">'</span><span class="s">&lt;</span><span class="sh">'</span><span class="s">: </span><span class="si">{</span><span class="n">with_less</span><span class="si">}</span><span class="s"> of </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">train_set</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>['▁', 'SEL', 'ECT', '▁count', '(', '*', ')', '▁FROM', '▁singer', '▁W', 'HER', 'E', '▁Age', '▁', '&lt;unk&gt;', '▁30', '&lt;/s&gt;']
back to text: SELECT count(*) FROM singer WHERE Age  30
training queries with '&lt;': 320 of 7,000</code></pre> <p>T5 can’t write “less than”. Its vocabulary was learned for prose, and <code class="language-plaintext highlighter-rouge">&lt;</code> isn’t in it, so the tokenizer turns it into <code class="language-plaintext highlighter-rouge">&lt;unk&gt;</code>, the unknown token, and decoding drops it.</p> <p>The query loses its comparison without an error: <code class="language-plaintext highlighter-rouge">Age &lt; 30</code> becomes <code class="language-plaintext highlighter-rouge">Age 30</code>. A model fine-tuned on such targets would learn to write queries that can’t run, for every question that needs a “less than”.</p> <p>The fix costs nothing. The embedding matrix has more rows than the tokenizer has tokens, because the vocabulary was rounded up to a multiple of 128, and the last rows have never been used. We add <code class="language-plaintext highlighter-rouge">&lt;</code> to the tokenizer, it takes the first free id, and the model already has a row for it:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/05/vocab-light.png" width="760" alt="The rows of t5-small's embedding matrix, not to scale. Rows 0 to 31,999 are the SentencePiece vocabulary, from the padding, end and unknown tokens to the last piece. Rows 32,000 to 32,099 are the 100 sentinels, extra_id_99 down to extra_id_0. Rows 32,100 to 32,127 are 28 rows that no token uses, left over because the matrix was rounded up to a multiple of 128. The new token for less-than takes row 32,100" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/05/vocab-dark.png" width="760" alt="The rows of t5-small's embedding matrix, not to scale. Rows 0 to 31,999 are the SentencePiece vocabulary, from the padding, end and unknown tokens to the last piece. Rows 32,000 to 32,099 are the 100 sentinels, extra_id_99 down to extra_id_0. Rows 32,100 to 32,127 are 28 rows that no token uses, left over because the matrix was rounded up to a multiple of 128. The new token for less-than takes row 32,100" loading="lazy"></p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">vocabulary rows in the model:</span><span class="sh">"</span><span class="p">,</span> <span class="n">t5</span><span class="p">.</span><span class="n">embed</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">])</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">tokens the tokenizer knows:  </span><span class="sh">"</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">tokenizer</span><span class="p">))</span>
<span class="n">sql_tokenizer</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">T5_SMALL</span><span class="p">)</span>
<span class="n">sql_tokenizer</span><span class="p">.</span><span class="nf">add_tokens</span><span class="p">([</span><span class="sh">"</span><span class="s">&lt;</span><span class="sh">"</span><span class="p">])</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">id of the new token </span><span class="sh">'</span><span class="s">&lt;</span><span class="sh">'</span><span class="s">:     </span><span class="sh">"</span><span class="p">,</span> <span class="n">sql_tokenizer</span><span class="p">.</span><span class="nf">convert_tokens_to_ids</span><span class="p">(</span><span class="sh">"</span><span class="s">&lt;</span><span class="sh">"</span><span class="p">))</span>
<span class="n">ids</span> <span class="o">=</span> <span class="nf">sql_tokenizer</span><span class="p">(</span><span class="n">query</span><span class="p">).</span><span class="n">input_ids</span>
<span class="nf">print</span><span class="p">(</span><span class="n">sql_tokenizer</span><span class="p">.</span><span class="nf">convert_ids_to_tokens</span><span class="p">(</span><span class="n">ids</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>vocabulary rows in the model: 32128
tokens the tokenizer knows:   32100
id of the new token '&lt;':      32100
['▁', 'SEL', 'ECT', '▁count', '(', '*', ')', '▁FROM', '▁singer', '▁W', 'HER', 'E', '▁Age', '&lt;', '▁30', '&lt;/s&gt;']</code></pre> <p>The new token sits in a row the model never trained, so at first it is noise; fine-tuning will give it a meaning, because a few hundred training queries use it. The tokenizer is the same for every size of T5, so <code class="language-plaintext highlighter-rouge">sql_tokenizer</code> serves t5-base too.</p> <p>Now the training. We fine-tune t5-base, the same architecture as t5-small with 12 layers on each side and a width of 768, loaded into our own <code class="language-plaintext highlighter-rouge">T5</code> class; the transplant needs no change.</p> <p>Each step takes a random batch of questions, runs the encoder on the inputs and the decoder on the queries shifted right by the start token, and minimises the cross-entropy of every query token, ignoring padding, exactly as in lesson 4.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">del</span> <span class="n">base_reference</span><span class="p">,</span> <span class="n">bart</span>  <span class="c1"># the reference models have done their job
</span><span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
    <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">empty_cache</span><span class="p">()</span>
<span class="n">model</span><span class="p">,</span> <span class="n">model_config</span> <span class="o">=</span> <span class="nf">load_t5</span><span class="p">(</span><span class="n">T5_BASE</span><span class="p">)</span>
<span class="n">model</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">t5-base: </span><span class="si">{</span><span class="nf">sum</span><span class="p">(</span><span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span> <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="nf">parameters</span><span class="p">())</span> <span class="o">/</span> <span class="mf">1e6</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> million parameters</span><span class="sh">"</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">make_batch</span><span class="p">(</span><span class="n">examples</span><span class="p">):</span>
    <span class="n">inputs</span> <span class="o">=</span> <span class="nf">sql_tokenizer</span><span class="p">([</span><span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">input</span><span class="sh">"</span><span class="p">]</span> <span class="k">for</span> <span class="n">e</span> <span class="ow">in</span> <span class="n">examples</span><span class="p">],</span> <span class="n">max_length</span><span class="o">=</span><span class="mi">512</span><span class="p">,</span>
                           <span class="n">truncation</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">targets</span> <span class="o">=</span> <span class="nf">sql_tokenizer</span><span class="p">([</span><span class="nf">model_target</span><span class="p">(</span><span class="n">e</span><span class="p">)</span> <span class="k">for</span> <span class="n">e</span> <span class="ow">in</span> <span class="n">examples</span><span class="p">],</span> <span class="n">max_length</span><span class="o">=</span><span class="mi">256</span><span class="p">,</span>
                            <span class="n">truncation</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="n">input_ids</span>
    <span class="n">start</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">examples</span><span class="p">),</span> <span class="mi">1</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">long</span><span class="p">)</span>  <span class="c1"># the start token
</span>    <span class="n">decoder_input</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">start</span><span class="p">,</span> <span class="n">targets</span><span class="p">[:,</span> <span class="p">:</span><span class="o">-</span><span class="mi">1</span><span class="p">]],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">labels</span> <span class="o">=</span> <span class="n">targets</span><span class="p">.</span><span class="nf">masked_fill</span><span class="p">(</span><span class="n">targets</span> <span class="o">==</span> <span class="n">sql_tokenizer</span><span class="p">.</span><span class="n">pad_token_id</span><span class="p">,</span> <span class="o">-</span><span class="mi">100</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">inputs</span><span class="p">.</span><span class="n">input_ids</span><span class="p">,</span> <span class="n">inputs</span><span class="p">.</span><span class="n">attention_mask</span><span class="p">,</span> <span class="n">decoder_input</span><span class="p">,</span> <span class="n">labels</span>


<span class="k">def</span> <span class="nf">loss_on</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">batch</span><span class="p">):</span>
    <span class="n">ids</span><span class="p">,</span> <span class="n">mask</span><span class="p">,</span> <span class="n">decoder_input</span><span class="p">,</span> <span class="n">labels</span> <span class="o">=</span> <span class="p">[</span><span class="n">t</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span> <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="n">batch</span><span class="p">]</span>
    <span class="n">logits</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="n">decoder_input</span><span class="p">,</span> <span class="n">model</span><span class="p">.</span><span class="nf">encode</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">mask</span><span class="p">),</span> <span class="n">mask</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span><span class="n">logits</span><span class="p">.</span><span class="nf">flatten</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">),</span> <span class="n">labels</span><span class="p">.</span><span class="nf">flatten</span><span class="p">(),</span> <span class="n">ignore_index</span><span class="o">=-</span><span class="mi">100</span><span class="p">)</span>


<span class="n">held_out</span> <span class="o">=</span> <span class="n">random</span><span class="p">.</span><span class="nc">Random</span><span class="p">(</span><span class="n">SEED</span><span class="p">).</span><span class="nf">sample</span><span class="p">(</span><span class="n">dev_set</span><span class="p">,</span> <span class="mi">256</span> <span class="k">if</span> <span class="ow">not</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">16</span><span class="p">)</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">model</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>
    <span class="n">before</span> <span class="o">=</span> <span class="nf">loss_on</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="nf">make_batch</span><span class="p">(</span><span class="n">held_out</span><span class="p">[:</span><span class="mi">32</span><span class="p">])).</span><span class="nf">item</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">loss on development queries before training: </span><span class="si">{</span><span class="n">before</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>t5-base: 223 million parameters
loss on development queries before training: 4.94</code></pre> <p>The plan: 1,100 steps, about 20 minutes on a T4. Batches hold up to 16 questions of similar length and at most 4,096 input tokens, so that the longest schemas still fit in a T4’s memory.</p> <p>The optimizer is AdamW at a constant learning rate after a short warm-up, with gradients clipped at 1. Every 200 steps we measure the loss on 256 held-out development questions.</p> <p>We train in float32. T5 was trained on TPUs with bfloat16 activations, which have the range of float32, and in float16 its feed-forward outputs overflow: in 2021, “t5-small was the only T5 model that was working in fp16” <sup class="cite">[<a href="#ref-8" id="cite-8" data-ref="8" aria-label="Reference 8: Hugging Face forum (2021). T5 fp16 issue is fixed.">8</a>]</sup>. A T4 has no fast bfloat16, so float32 it is.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">STEPS</span> <span class="o">=</span> <span class="mi">3</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">1100</span>  <span class="c1"># about 20 minutes on a T4
</span><span class="n">BATCH</span> <span class="o">=</span> <span class="mi">16</span>
<span class="n">LR</span> <span class="o">=</span> <span class="mf">3e-4</span>
<span class="n">WARMUP</span> <span class="o">=</span> <span class="mi">100</span>
<span class="n">optimizer</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">optim</span><span class="p">.</span><span class="nc">AdamW</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="nf">parameters</span><span class="p">(),</span> <span class="n">lr</span><span class="o">=</span><span class="n">LR</span><span class="p">,</span> <span class="n">weight_decay</span><span class="o">=</span><span class="mf">0.0</span><span class="p">)</span>


<span class="n">TOKEN_BUDGET</span> <span class="o">=</span> <span class="mi">4096</span>  <span class="c1"># input tokens per batch: 16 questions of 256 tokens, or 8 of 512
</span><span class="n">input_tokens</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">e</span><span class="p">,</span> <span class="n">n</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">train_set</span><span class="p">,</span> <span class="n">lengths</span><span class="p">):</span>
    <span class="n">input_tokens</span><span class="p">[</span><span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">question</span><span class="sh">"</span><span class="p">]</span> <span class="o">+</span> <span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">query</span><span class="sh">"</span><span class="p">]]</span> <span class="o">=</span> <span class="nf">min</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="mi">512</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">batches_by_length</span><span class="p">(</span><span class="n">examples</span><span class="p">,</span> <span class="n">size</span><span class="p">,</span> <span class="n">rng</span><span class="p">):</span>
    <span class="n">shuffled</span> <span class="o">=</span> <span class="n">examples</span><span class="p">[:]</span>
    <span class="n">rng</span><span class="p">.</span><span class="nf">shuffle</span><span class="p">(</span><span class="n">shuffled</span><span class="p">)</span>
    <span class="n">batches</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">shuffled</span><span class="p">),</span> <span class="n">size</span> <span class="o">*</span> <span class="mi">50</span><span class="p">):</span>
        <span class="n">pool</span> <span class="o">=</span> <span class="nf">sorted</span><span class="p">(</span><span class="n">shuffled</span><span class="p">[</span><span class="n">i</span><span class="p">:</span><span class="n">i</span> <span class="o">+</span> <span class="n">size</span> <span class="o">*</span> <span class="mi">50</span><span class="p">],</span>
                      <span class="n">key</span><span class="o">=</span><span class="k">lambda</span> <span class="n">e</span><span class="p">:</span> <span class="n">input_tokens</span><span class="p">[</span><span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">question</span><span class="sh">"</span><span class="p">]</span> <span class="o">+</span> <span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">query</span><span class="sh">"</span><span class="p">]])</span>
        <span class="n">batch</span> <span class="o">=</span> <span class="p">[]</span>
        <span class="k">for</span> <span class="n">e</span> <span class="ow">in</span> <span class="n">pool</span><span class="p">:</span>
            <span class="n">longest</span> <span class="o">=</span> <span class="n">input_tokens</span><span class="p">[</span><span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">question</span><span class="sh">"</span><span class="p">]</span> <span class="o">+</span> <span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">query</span><span class="sh">"</span><span class="p">]]</span>  <span class="c1"># the pool is sorted
</span>            <span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="n">batch</span><span class="p">)</span> <span class="o">==</span> <span class="n">size</span> <span class="ow">or</span> <span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">batch</span><span class="p">)</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">*</span> <span class="n">longest</span> <span class="o">&gt;</span> <span class="n">TOKEN_BUDGET</span><span class="p">:</span>
                <span class="n">batches</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">batch</span><span class="p">)</span>
                <span class="n">batch</span> <span class="o">=</span> <span class="p">[]</span>
            <span class="n">batch</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">e</span><span class="p">)</span>
        <span class="n">batches</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">batch</span><span class="p">)</span>
    <span class="n">rng</span><span class="p">.</span><span class="nf">shuffle</span><span class="p">(</span><span class="n">batches</span><span class="p">)</span>  <span class="c1"># similar lengths within a batch, random order of batches
</span>    <span class="k">return</span> <span class="n">batches</span>


<span class="k">def</span> <span class="nf">dev_loss</span><span class="p">(</span><span class="n">model</span><span class="p">):</span>
    <span class="n">model</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>
    <span class="n">total</span> <span class="o">=</span> <span class="mf">0.0</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">held_out</span><span class="p">),</span> <span class="mi">32</span><span class="p">):</span>
            <span class="n">chunk</span> <span class="o">=</span> <span class="n">held_out</span><span class="p">[</span><span class="n">i</span><span class="p">:</span><span class="n">i</span> <span class="o">+</span> <span class="mi">32</span><span class="p">]</span>
            <span class="n">total</span> <span class="o">+=</span> <span class="nf">loss_on</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="nf">make_batch</span><span class="p">(</span><span class="n">chunk</span><span class="p">)).</span><span class="nf">item</span><span class="p">()</span> <span class="o">*</span> <span class="nf">len</span><span class="p">(</span><span class="n">chunk</span><span class="p">)</span>
    <span class="n">model</span><span class="p">.</span><span class="nf">train</span><span class="p">()</span>
    <span class="k">return</span> <span class="n">total</span> <span class="o">/</span> <span class="nf">len</span><span class="p">(</span><span class="n">held_out</span><span class="p">)</span>


<span class="n">rng</span> <span class="o">=</span> <span class="n">random</span><span class="p">.</span><span class="nc">Random</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">history</span> <span class="o">=</span> <span class="p">[]</span>
<span class="n">model</span><span class="p">.</span><span class="nf">train</span><span class="p">()</span>
<span class="n">started</span><span class="p">,</span> <span class="n">step</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">(),</span> <span class="mi">0</span>
<span class="k">while</span> <span class="n">step</span> <span class="o">&lt;</span> <span class="n">STEPS</span><span class="p">:</span>
    <span class="k">for</span> <span class="n">examples</span> <span class="ow">in</span> <span class="nf">batches_by_length</span><span class="p">(</span><span class="n">train_set</span><span class="p">,</span> <span class="n">BATCH</span><span class="p">,</span> <span class="n">rng</span><span class="p">):</span>
        <span class="k">if</span> <span class="n">step</span> <span class="o">==</span> <span class="n">STEPS</span><span class="p">:</span>
            <span class="k">break</span>
        <span class="k">for</span> <span class="n">group</span> <span class="ow">in</span> <span class="n">optimizer</span><span class="p">.</span><span class="n">param_groups</span><span class="p">:</span>
            <span class="n">group</span><span class="p">[</span><span class="sh">"</span><span class="s">lr</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">LR</span> <span class="o">*</span> <span class="nf">min</span><span class="p">(</span><span class="mf">1.0</span><span class="p">,</span> <span class="p">(</span><span class="n">step</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">WARMUP</span><span class="p">)</span>
        <span class="n">loss</span> <span class="o">=</span> <span class="nf">loss_on</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="nf">make_batch</span><span class="p">(</span><span class="n">examples</span><span class="p">))</span>
        <span class="n">loss</span><span class="p">.</span><span class="nf">backward</span><span class="p">()</span>
        <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="n">utils</span><span class="p">.</span><span class="nf">clip_grad_norm_</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="nf">parameters</span><span class="p">(),</span> <span class="mf">1.0</span><span class="p">)</span>
        <span class="n">optimizer</span><span class="p">.</span><span class="nf">step</span><span class="p">()</span>
        <span class="n">optimizer</span><span class="p">.</span><span class="nf">zero_grad</span><span class="p">()</span>
        <span class="k">if</span> <span class="n">step</span> <span class="o">%</span> <span class="mi">200</span> <span class="o">==</span> <span class="mi">0</span><span class="p">:</span>
            <span class="n">history</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">step</span><span class="sh">"</span><span class="p">:</span> <span class="n">step</span><span class="p">,</span> <span class="sh">"</span><span class="s">minutes</span><span class="sh">"</span><span class="p">:</span> <span class="p">(</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">started</span><span class="p">)</span> <span class="o">/</span> <span class="mi">60</span><span class="p">,</span>
                            <span class="sh">"</span><span class="s">train loss</span><span class="sh">"</span><span class="p">:</span> <span class="n">loss</span><span class="p">.</span><span class="nf">item</span><span class="p">(),</span> <span class="sh">"</span><span class="s">dev loss</span><span class="sh">"</span><span class="p">:</span> <span class="nf">dev_loss</span><span class="p">(</span><span class="n">model</span><span class="p">)})</span>
        <span class="n">step</span> <span class="o">+=</span> <span class="mi">1</span>
<span class="n">history</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">step</span><span class="sh">"</span><span class="p">:</span> <span class="n">step</span><span class="p">,</span> <span class="sh">"</span><span class="s">minutes</span><span class="sh">"</span><span class="p">:</span> <span class="p">(</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">started</span><span class="p">)</span> <span class="o">/</span> <span class="mi">60</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">train loss</span><span class="sh">"</span><span class="p">:</span> <span class="n">loss</span><span class="p">.</span><span class="nf">item</span><span class="p">(),</span> <span class="sh">"</span><span class="s">dev loss</span><span class="sh">"</span><span class="p">:</span> <span class="nf">dev_loss</span><span class="p">(</span><span class="n">model</span><span class="p">)})</span>
<span class="n">model</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>
<span class="n">history</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">history</span><span class="p">)</span>
<span class="n">minutes</span> <span class="o">=</span> <span class="p">(</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">started</span><span class="p">)</span> <span class="o">/</span> <span class="mi">60</span>
<span class="n">passes</span> <span class="o">=</span> <span class="n">step</span> <span class="o">*</span> <span class="n">BATCH</span> <span class="o">/</span> <span class="nf">len</span><span class="p">(</span><span class="n">train_set</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">step</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> steps in </span><span class="si">{</span><span class="n">minutes</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> minutes, about </span><span class="si">{</span><span class="n">passes</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s"> passes over the data</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>1,100 steps in 21 minutes, about 2.5 passes over the data</code></pre> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.4</span><span class="p">,</span> <span class="mf">2.8</span><span class="p">))</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">history</span><span class="p">[</span><span class="sh">"</span><span class="s">step</span><span class="sh">"</span><span class="p">],</span> <span class="n">history</span><span class="p">[</span><span class="sh">"</span><span class="s">train loss</span><span class="sh">"</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">],</span> <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">training batch</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">history</span><span class="p">[</span><span class="sh">"</span><span class="s">step</span><span class="sh">"</span><span class="p">],</span> <span class="n">history</span><span class="p">[</span><span class="sh">"</span><span class="s">dev loss</span><span class="sh">"</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">],</span>
        <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">development questions</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">step</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">cross-entropy per token</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylim</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="bp">None</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/05/output-05.png" alt="Output of the code above" loading="lazy"></p> <p>The loss falls fast: within the first 200 steps the development loss drops to a small fraction of where it started, and after that it barely moves while the training loss keeps going down. From there on the model gets better at the training questions than at SQL in general, the start of overfitting.</p> <h2 id="9-checking-by-running">9. Checking by running</h2> <p>A loss says how probable the model finds the reference query, token by token. It doesn’t say whether the query the model writes is right: a query worded differently from the reference can be improbable and still return the right rows.</p> <p>For SQL there is a better judge than comparing text: run it. Spider’s databases are real SQLite files, so we run the model’s query and the correct one on the same database and compare what comes back.</p> <p>This is <em>execution accuracy</em>. It errs in both directions. Two correct queries can differ as strings, <code class="language-plaintext highlighter-rouge">AGE &gt; 34</code> and <code class="language-plaintext highlighter-rouge">AGE &gt;= 35</code>, which is why exact matching underrates models.</p> <p>And a wrong query can happen to return the right rows on one particular database, which is why Spider’s official metric since 2020 runs every query on a suite of databases built to tell such queries apart<sup class="cite">[<a href="#ref-9" id="cite-9" data-ref="9" aria-label="Reference 9: Zhong, R., Yu, T., &amp; Klein, D. (2020). Semantic evaluation for text-to-SQL with distilled test suites. EMNLP 2020.">9</a>]</sup>. We use the one database Spider ships.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/05/execmatch-light.png" width="760" alt="Two ways to grade a predicted query, on an illustrative table of four people aged 41, 29, 35 and 52. The reference is AGE greater than 34. A prediction of AGE at least 35 is a different string, so exact matching calls it wrong, but it returns the same three people and is right. A prediction of AGE greater than 30 also returns the same three people on this table, so execution calls it right although it is wrong; a second table with a person aged 32 tells the two apart, which is what a test suite does" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/05/execmatch-dark.png" width="760" alt="Two ways to grade a predicted query, on an illustrative table of four people aged 41, 29, 35 and 52. The reference is AGE greater than 34. A prediction of AGE at least 35 is a different string, so exact matching calls it wrong, but it returns the same three people and is right. A prediction of AGE greater than 30 also returns the same three people on this table, so execution calls it right although it is wrong; a second table with a person aged 32 tells the two apart, which is what a test suite does" loading="lazy"></p> <p>Two results are the same if they hold the same rows. Order matters only if the correct query asks for one with <code class="language-plaintext highlighter-rouge">ORDER BY</code>; otherwise we compare the rows as sorted lists. A query that runs longer than five seconds is stopped and counts as wrong, and so does one that fails.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">run_query</span><span class="p">(</span><span class="n">db_id</span><span class="p">,</span> <span class="n">query</span><span class="p">,</span> <span class="n">seconds</span><span class="o">=</span><span class="mf">5.0</span><span class="p">):</span>
    <span class="n">path</span> <span class="o">=</span> <span class="n">SPIDER_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">database</span><span class="sh">"</span> <span class="o">/</span> <span class="n">db_id</span> <span class="o">/</span> <span class="p">(</span><span class="n">db_id</span> <span class="o">+</span> <span class="sh">"</span><span class="s">.sqlite</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">connection</span> <span class="o">=</span> <span class="n">sqlite3</span><span class="p">.</span><span class="nf">connect</span><span class="p">(</span><span class="n">path</span><span class="p">)</span>
    <span class="c1"># a few databases hold text that isn't valid UTF-8
</span>    <span class="n">connection</span><span class="p">.</span><span class="n">text_factory</span> <span class="o">=</span> <span class="k">lambda</span> <span class="n">raw</span><span class="p">:</span> <span class="n">raw</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="n">errors</span><span class="o">=</span><span class="sh">"</span><span class="s">replace</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">deadline</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">+</span> <span class="n">seconds</span>
    <span class="c1"># SQLite calls the handler every 10,000 steps; returning True stops the query
</span>    <span class="n">connection</span><span class="p">.</span><span class="nf">set_progress_handler</span><span class="p">(</span><span class="k">lambda</span><span class="p">:</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">&gt;</span> <span class="n">deadline</span><span class="p">,</span> <span class="mi">10_000</span><span class="p">)</span>
    <span class="k">try</span><span class="p">:</span>
        <span class="k">return</span> <span class="n">connection</span><span class="p">.</span><span class="nf">execute</span><span class="p">(</span><span class="n">query</span><span class="p">).</span><span class="nf">fetchall</span><span class="p">()</span>
    <span class="k">finally</span><span class="p">:</span>
        <span class="n">connection</span><span class="p">.</span><span class="nf">close</span><span class="p">()</span>


<span class="k">def</span> <span class="nf">same_result</span><span class="p">(</span><span class="n">db_id</span><span class="p">,</span> <span class="n">predicted</span><span class="p">,</span> <span class="n">gold</span><span class="p">):</span>
    <span class="n">expected</span> <span class="o">=</span> <span class="nf">run_query</span><span class="p">(</span><span class="n">db_id</span><span class="p">,</span> <span class="n">gold</span><span class="p">)</span>
    <span class="k">try</span><span class="p">:</span>
        <span class="n">got</span> <span class="o">=</span> <span class="nf">run_query</span><span class="p">(</span><span class="n">db_id</span><span class="p">,</span> <span class="n">predicted</span><span class="p">)</span>
    <span class="k">except</span> <span class="nb">Exception</span> <span class="k">as</span> <span class="n">error</span><span class="p">:</span>
        <span class="k">return</span> <span class="bp">False</span><span class="p">,</span> <span class="nf">str</span><span class="p">(</span><span class="n">error</span><span class="p">)</span>  <span class="c1"># SQLite's message
</span>    <span class="k">if</span> <span class="sh">"</span><span class="s">order by</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">gold</span><span class="p">.</span><span class="nf">lower</span><span class="p">():</span>
        <span class="k">return</span> <span class="n">got</span> <span class="o">==</span> <span class="n">expected</span><span class="p">,</span> <span class="sh">"</span><span class="s">ran</span><span class="sh">"</span>
    <span class="k">return</span> <span class="nf">sorted</span><span class="p">(</span><span class="nf">map</span><span class="p">(</span><span class="nb">repr</span><span class="p">,</span> <span class="n">got</span><span class="p">))</span> <span class="o">==</span> <span class="nf">sorted</span><span class="p">(</span><span class="nf">map</span><span class="p">(</span><span class="nb">repr</span><span class="p">,</span> <span class="n">expected</span><span class="p">)),</span> <span class="sh">"</span><span class="s">ran</span><span class="sh">"</span>


<span class="nf">print</span><span class="p">(</span><span class="nf">same_result</span><span class="p">(</span><span class="sh">"</span><span class="s">concert_singer</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">SELECT count(*) FROM singer WHERE Age &lt; 30</span><span class="sh">"</span><span class="p">,</span>
                  <span class="sh">"</span><span class="s">SELECT count(*) FROM singer WHERE age &lt; 30</span><span class="sh">"</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">same_result</span><span class="p">(</span><span class="sh">"</span><span class="s">concert_singer</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">SELECT count(*) FROM singer WHERE Age &lt;= 30</span><span class="sh">"</span><span class="p">,</span>
                  <span class="sh">"</span><span class="s">SELECT count(*) FROM singer WHERE age &lt; 30</span><span class="sh">"</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">same_result</span><span class="p">(</span><span class="sh">"</span><span class="s">concert_singer</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">SELECT count(*) FROM singers</span><span class="sh">"</span><span class="p">,</span>
                  <span class="sh">"</span><span class="s">SELECT count(*) FROM singer WHERE age &lt; 30</span><span class="sh">"</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>(True, 'ran')
(True, 'ran')
(False, 'no such table: singers')</code></pre> <p>Now every development question, 1,034 of them about 20 databases the model has never seen. Generation uses our own <code class="language-plaintext highlighter-rouge">generate</code> with the KV cache, in batches.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">evaluated</span> <span class="o">=</span> <span class="n">dev_set</span> <span class="k">if</span> <span class="ow">not</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="n">dev_set</span><span class="p">[:</span><span class="mi">24</span><span class="p">]</span>
<span class="n">predictions</span> <span class="o">=</span> <span class="p">[]</span>
<span class="n">started</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
<span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">evaluated</span><span class="p">),</span> <span class="mi">64</span><span class="p">):</span>
    <span class="n">chunk</span> <span class="o">=</span> <span class="n">evaluated</span><span class="p">[</span><span class="n">i</span><span class="p">:</span><span class="n">i</span> <span class="o">+</span> <span class="mi">64</span><span class="p">]</span>
    <span class="n">batch</span> <span class="o">=</span> <span class="nf">sql_tokenizer</span><span class="p">([</span><span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">input</span><span class="sh">"</span><span class="p">]</span> <span class="k">for</span> <span class="n">e</span> <span class="ow">in</span> <span class="n">chunk</span><span class="p">],</span> <span class="n">max_length</span><span class="o">=</span><span class="mi">512</span><span class="p">,</span> <span class="n">truncation</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
                          <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="n">written</span> <span class="o">=</span> <span class="nf">generate</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">batch</span><span class="p">.</span><span class="n">input_ids</span><span class="p">,</span> <span class="n">batch</span><span class="p">.</span><span class="n">attention_mask</span><span class="p">,</span> <span class="n">max_new_tokens</span><span class="o">=</span><span class="mi">192</span><span class="p">)</span>
    <span class="n">predictions</span> <span class="o">+=</span> <span class="n">sql_tokenizer</span><span class="p">.</span><span class="nf">batch_decode</span><span class="p">(</span><span class="n">written</span><span class="p">,</span> <span class="n">skip_special_tokens</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">predictions</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> queries written in </span><span class="si">{</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">started</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> s</span><span class="sh">"</span><span class="p">)</span>

<span class="k">def</span> <span class="nf">normalized</span><span class="p">(</span><span class="n">query</span><span class="p">):</span>
    <span class="n">query</span> <span class="o">=</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">query</span><span class="p">.</span><span class="nf">lower</span><span class="p">().</span><span class="nf">replace</span><span class="p">(</span><span class="sh">'"'</span><span class="p">,</span> <span class="sh">"'"</span><span class="p">).</span><span class="nf">split</span><span class="p">())</span>
    <span class="k">return</span> <span class="n">re</span><span class="p">.</span><span class="nf">sub</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s">\s*([,()&lt;&gt;=!])\s*</span><span class="sh">"</span><span class="p">,</span> <span class="sa">r</span><span class="sh">"</span><span class="s">\1</span><span class="sh">"</span><span class="p">,</span> <span class="n">query</span><span class="p">)</span>  <span class="c1"># spaces around , ( ) and &lt; &gt; = !
</span>

<span class="n">results</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">e</span><span class="p">,</span> <span class="n">predicted</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">evaluated</span><span class="p">,</span> <span class="n">predictions</span><span class="p">):</span>
    <span class="n">correct</span><span class="p">,</span> <span class="n">status</span> <span class="o">=</span> <span class="nf">same_result</span><span class="p">(</span><span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">db_id</span><span class="sh">"</span><span class="p">],</span> <span class="n">predicted</span><span class="p">,</span> <span class="nf">model_target</span><span class="p">(</span><span class="n">e</span><span class="p">))</span>
    <span class="n">results</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">db_id</span><span class="sh">"</span><span class="p">:</span> <span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">db_id</span><span class="sh">"</span><span class="p">],</span> <span class="sh">"</span><span class="s">question</span><span class="sh">"</span><span class="p">:</span> <span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">question</span><span class="sh">"</span><span class="p">],</span> <span class="sh">"</span><span class="s">gold</span><span class="sh">"</span><span class="p">:</span> <span class="nf">model_target</span><span class="p">(</span><span class="n">e</span><span class="p">),</span>
                    <span class="sh">"</span><span class="s">predicted</span><span class="sh">"</span><span class="p">:</span> <span class="n">predicted</span><span class="p">,</span> <span class="sh">"</span><span class="s">correct</span><span class="sh">"</span><span class="p">:</span> <span class="n">correct</span><span class="p">,</span> <span class="sh">"</span><span class="s">status</span><span class="sh">"</span><span class="p">:</span> <span class="n">status</span><span class="p">,</span>
                    <span class="sh">"</span><span class="s">as written</span><span class="sh">"</span><span class="p">:</span> <span class="n">predicted</span> <span class="o">==</span> <span class="nf">model_target</span><span class="p">(</span><span class="n">e</span><span class="p">),</span>
                    <span class="sh">"</span><span class="s">exact</span><span class="sh">"</span><span class="p">:</span> <span class="nf">normalized</span><span class="p">(</span><span class="n">predicted</span><span class="p">)</span> <span class="o">==</span> <span class="nf">normalized</span><span class="p">(</span><span class="nf">model_target</span><span class="p">(</span><span class="n">e</span><span class="p">)),</span>
                    <span class="sh">"</span><span class="s">no rows</span><span class="sh">"</span><span class="p">:</span> <span class="nf">len</span><span class="p">(</span><span class="nf">run_query</span><span class="p">(</span><span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">db_id</span><span class="sh">"</span><span class="p">],</span> <span class="nf">model_target</span><span class="p">(</span><span class="n">e</span><span class="p">)))</span> <span class="o">==</span> <span class="mi">0</span><span class="p">})</span>
<span class="n">results</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">results</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">execution accuracy:                     </span><span class="si">{</span><span class="n">results</span><span class="p">[</span><span class="sh">'</span><span class="s">correct</span><span class="sh">'</span><span class="p">].</span><span class="nf">mean</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">the same string as the reference:       </span><span class="si">{</span><span class="n">results</span><span class="p">[</span><span class="sh">'</span><span class="s">as written</span><span class="sh">'</span><span class="p">].</span><span class="nf">mean</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">the same up to spaces, quotes and case: </span><span class="si">{</span><span class="n">results</span><span class="p">[</span><span class="sh">'</span><span class="s">exact</span><span class="sh">'</span><span class="p">].</span><span class="nf">mean</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">queries that failed to run:</span><span class="sh">"</span><span class="p">,</span> <span class="p">(</span><span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">status</span><span class="sh">"</span><span class="p">]</span> <span class="o">!=</span> <span class="sh">"</span><span class="s">ran</span><span class="sh">"</span><span class="p">).</span><span class="nf">sum</span><span class="p">())</span>
<span class="n">lucky</span> <span class="o">=</span> <span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">correct</span><span class="sh">"</span><span class="p">]</span> <span class="o">&amp;</span> <span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">no rows</span><span class="sh">"</span><span class="p">]</span> <span class="o">&amp;</span> <span class="o">~</span><span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">exact</span><span class="sh">"</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">right only in that both return no rows:</span><span class="sh">"</span><span class="p">,</span> <span class="n">lucky</span><span class="p">.</span><span class="nf">sum</span><span class="p">())</span>
</code></pre></div></div> <pre class="tfs-printed"><code>1,034 queries written in 87 s
execution accuracy:                     42.6%
the same string as the reference:       11.2%
the same up to spaces, quotes and case: 32.0%
queries that failed to run: 406
right only in that both return no rows: 7</code></pre> <p>Just over two queries in five return the right rows, on twenty databases the model has never seen, after 20 minutes of fine-tuning a model of 220 million parameters.</p> <p>The three ways of counting tell three different stories. Compared character for character, only about one query in nine matches the reference, and most of that gap is formatting: T5’s tokenizer drops the space before a comma, and Spider’s annotators mixed quotes and capital letters.</p> <p>After normalising those, about a third match. Execution accepts roughly another tenth on top: queries written differently that mean the same thing.</p> <p>A handful of those are right only by luck, because both queries return no rows at all on this database, the false positive of the figure above. And almost two queries in five don’t run.</p> <p>Where does it go wrong? Spider’s own scripts sort queries into four levels of hardness by counting their parts; a rougher but transparent way is to look at what a correct query contains: a join, a nested <code class="language-plaintext highlighter-rouge">SELECT</code>, a <code class="language-plaintext highlighter-rouge">GROUP BY</code>, an <code class="language-plaintext highlighter-rouge">ORDER BY</code>, or none of these.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">query_parts</span><span class="p">(</span><span class="n">query</span><span class="p">):</span>
    <span class="n">q</span> <span class="o">=</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span> <span class="o">+</span> <span class="n">query</span><span class="p">.</span><span class="nf">lower</span><span class="p">()</span> <span class="o">+</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span>
    <span class="k">return</span> <span class="p">{</span><span class="sh">"</span><span class="s">join</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s"> join </span><span class="sh">"</span> <span class="ow">in</span> <span class="n">q</span><span class="p">,</span> <span class="sh">"</span><span class="s">nested select</span><span class="sh">"</span><span class="p">:</span> <span class="n">q</span><span class="p">.</span><span class="nf">count</span><span class="p">(</span><span class="sh">"</span><span class="s">select </span><span class="sh">"</span><span class="p">)</span> <span class="o">&gt;</span> <span class="mi">1</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">group by</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s"> group by </span><span class="sh">"</span> <span class="ow">in</span> <span class="n">q</span><span class="p">,</span> <span class="sh">"</span><span class="s">order by</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s"> order by </span><span class="sh">"</span> <span class="ow">in</span> <span class="n">q</span><span class="p">}</span>


<span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="p">[</span><span class="sh">"</span><span class="s">join</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">nested select</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">group by</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">order by</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">none of these</span><span class="sh">"</span><span class="p">]:</span>
    <span class="k">if</span> <span class="n">name</span> <span class="o">==</span> <span class="sh">"</span><span class="s">none of these</span><span class="sh">"</span><span class="p">:</span>
        <span class="n">chosen</span> <span class="o">=</span> <span class="p">[</span><span class="ow">not</span> <span class="nf">any</span><span class="p">(</span><span class="nf">query_parts</span><span class="p">(</span><span class="n">g</span><span class="p">).</span><span class="nf">values</span><span class="p">())</span> <span class="k">for</span> <span class="n">g</span> <span class="ow">in</span> <span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">gold</span><span class="sh">"</span><span class="p">]]</span>
    <span class="k">else</span><span class="p">:</span>
        <span class="n">chosen</span> <span class="o">=</span> <span class="p">[</span><span class="nf">query_parts</span><span class="p">(</span><span class="n">g</span><span class="p">)[</span><span class="n">name</span><span class="p">]</span> <span class="k">for</span> <span class="n">g</span> <span class="ow">in</span> <span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">gold</span><span class="sh">"</span><span class="p">]]</span>
    <span class="n">part</span> <span class="o">=</span> <span class="n">results</span><span class="p">[</span><span class="n">chosen</span><span class="p">]</span>
    <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">correct query has</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span> <span class="sh">"</span><span class="s">questions</span><span class="sh">"</span><span class="p">:</span> <span class="nf">len</span><span class="p">(</span><span class="n">part</span><span class="p">),</span>
                 <span class="sh">"</span><span class="s">execution accuracy</span><span class="sh">"</span><span class="p">:</span> <span class="n">part</span><span class="p">[</span><span class="sh">"</span><span class="s">correct</span><span class="sh">"</span><span class="p">].</span><span class="nf">mean</span><span class="p">()})</span>
<span class="n">parts</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">parts</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">correct query has</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">questions</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">execution accuracy</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">join</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">408</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.19</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">nested select</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">159</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.28</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">group by</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">277</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.39</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">order by</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">237</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.40</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">none of these</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">333</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.63</td></tr></tbody></table></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.4</span><span class="p">,</span> <span class="mf">2.6</span><span class="p">))</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">barh</span><span class="p">(</span><span class="n">parts</span><span class="p">[</span><span class="sh">"</span><span class="s">correct query has</span><span class="sh">"</span><span class="p">],</span> <span class="n">parts</span><span class="p">[</span><span class="sh">"</span><span class="s">execution accuracy</span><span class="sh">"</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">])</span>
<span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">parts</span><span class="p">)):</span>
    <span class="n">accuracy</span><span class="p">,</span> <span class="n">count</span> <span class="o">=</span> <span class="n">parts</span><span class="p">[</span><span class="sh">"</span><span class="s">execution accuracy</span><span class="sh">"</span><span class="p">][</span><span class="n">k</span><span class="p">],</span> <span class="n">parts</span><span class="p">[</span><span class="sh">"</span><span class="s">questions</span><span class="sh">"</span><span class="p">][</span><span class="n">k</span><span class="p">]</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">text</span><span class="p">(</span><span class="n">accuracy</span> <span class="o">+</span> <span class="mf">0.01</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">accuracy</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="o">%</span><span class="si">}</span><span class="s"> of </span><span class="si">{</span><span class="n">count</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span> <span class="n">va</span><span class="o">=</span><span class="sh">"</span><span class="s">center</span><span class="sh">"</span><span class="p">,</span>
            <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">invert_yaxis</span><span class="p">()</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlim</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">execution accuracy</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/05/output-06.png" alt="Output of the code above" loading="lazy"></p> <p>The pattern is the one Spider was built to expose. Queries with none of these parts, one table with a filter or a count, are right almost two times in three.</p> <p>Every added clause costs, and joins cost the most: fewer than one in five is right. To join two tables, the model has to know which column of one points to which column of the other. Our input doesn’t say, so it guesses from the names.</p> <p>Three kinds of answers are worth looking at one by one: queries that are right although they differ from the reference, queries that don’t run, and queries that run and return the wrong thing.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">right_but_different</span> <span class="o">=</span> <span class="n">results</span><span class="p">[</span><span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">correct</span><span class="sh">"</span><span class="p">]</span> <span class="o">&amp;</span> <span class="o">~</span><span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">exact</span><span class="sh">"</span><span class="p">]]</span>  <span class="c1"># really different
</span><span class="n">failed</span> <span class="o">=</span> <span class="n">results</span><span class="p">[</span><span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">status</span><span class="sh">"</span><span class="p">]</span> <span class="o">!=</span> <span class="sh">"</span><span class="s">ran</span><span class="sh">"</span><span class="p">]</span>
<span class="n">wrong</span> <span class="o">=</span> <span class="n">results</span><span class="p">[(</span><span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">status</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="sh">"</span><span class="s">ran</span><span class="sh">"</span><span class="p">)</span> <span class="o">&amp;</span> <span class="o">~</span><span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">correct</span><span class="sh">"</span><span class="p">]]</span>
<span class="k">for</span> <span class="n">title</span><span class="p">,</span> <span class="n">frame</span> <span class="ow">in</span> <span class="p">[(</span><span class="sh">"</span><span class="s">right, but not the reference string</span><span class="sh">"</span><span class="p">,</span> <span class="n">right_but_different</span><span class="p">),</span>
                     <span class="p">(</span><span class="sh">"</span><span class="s">does not run</span><span class="sh">"</span><span class="p">,</span> <span class="n">failed</span><span class="p">),</span> <span class="p">(</span><span class="sh">"</span><span class="s">runs, wrong result</span><span class="sh">"</span><span class="p">,</span> <span class="n">wrong</span><span class="p">)]:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">== </span><span class="si">{</span><span class="n">title</span><span class="si">}</span><span class="s">: </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">frame</span><span class="p">)</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">frame</span><span class="p">.</span><span class="nf">head</span><span class="p">(</span><span class="mi">3</span><span class="p">).</span><span class="nf">itertuples</span><span class="p">():</span>
        <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">  question: </span><span class="sh">"</span><span class="p">,</span> <span class="n">row</span><span class="p">.</span><span class="n">question</span><span class="p">)</span>
        <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">  reference:</span><span class="sh">"</span><span class="p">,</span> <span class="n">row</span><span class="p">.</span><span class="n">gold</span><span class="p">)</span>
        <span class="n">note</span> <span class="o">=</span> <span class="sh">""</span> <span class="k">if</span> <span class="n">row</span><span class="p">.</span><span class="n">status</span> <span class="o">==</span> <span class="sh">"</span><span class="s">ran</span><span class="sh">"</span> <span class="k">else</span> <span class="sa">f</span><span class="sh">"</span><span class="s">(</span><span class="si">{</span><span class="n">row</span><span class="p">.</span><span class="n">status</span><span class="si">}</span><span class="s">)</span><span class="sh">"</span>
        <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">  model:    </span><span class="sh">"</span><span class="p">,</span> <span class="n">row</span><span class="p">.</span><span class="n">predicted</span><span class="p">,</span> <span class="n">note</span><span class="p">)</span>
        <span class="nf">print</span><span class="p">()</span>
</code></pre></div></div> <pre class="tfs-printed"><code>== right, but not the reference string: 117
  question:  Show the stadium name and capacity with most number of concerts in year 2014 or after.
  reference: SELECT T2.name , T2.capacity FROM concert AS T1 JOIN stadium AS T2 ON T1.stadium_id = T2.stadium_id WHERE T1.year &gt;= 2014 GROUP BY T2.stadium_id ORDER BY count(*) DESC LIMIT 1
  model:     SELECT T1.name, max(T1.capacity) FROM stadium AS T1 JOIN concert AS T2 ON T1.stadium_id = T2.stadium_id WHERE T2.year &gt;= 2014 GROUP BY T2.stadium_id ORDER BY count(*) DESC LIMIT 1 

  question:  What is the name and capacity of the stadium with the most concerts after 2013 ?
  reference: select t2.name , t2.capacity from concert as t1 join stadium as t2 on t1.stadium_id = t2.stadium_id where t1.year &gt; 2013 group by t2.stadium_id order by count(*) desc limit 1
  model:     SELECT T1.name, T1.capacity FROM stadium AS T1 JOIN concert AS T2 ON T1.stadium_id = T2.stadium_id WHERE T2.year &gt; 2013 GROUP BY T1.name ORDER BY count(*) DESC LIMIT 1 

  question:  Show names for all stadiums except for stadiums having a concert in year 2014.
  reference: SELECT name FROM stadium EXCEPT SELECT T2.name FROM concert AS T1 JOIN stadium AS T2 ON T1.stadium_id = T2.stadium_id WHERE T1.year = 2014
  model:     SELECT name FROM stadium EXCEPT SELECT T1.name FROM stadium AS T1 JOIN concert AS T2 ON T1.stadium_id = T2.stadium_id WHERE T2.year = 2014 

== does not run: 406
  question:  Show the name and the release year of the song by the youngest singer.
  reference: SELECT song_name , song_release_year FROM singer ORDER BY age LIMIT 1
  model:     SELECT T1.name, T1.song_release_year FROM singer AS T1 JOIN concert AS T2 ON T1.singer_id = T2.singer_id ORDER BY T2.age LIMIT 1 (no such column: T2.singer_id)

  question:  What are the names and release years for all the songs of the youngest singer?
  reference: SELECT song_name , song_release_year FROM singer ORDER BY age LIMIT 1
  model:     SELECT T1.name, T1.song_release_year FROM singer AS T1 JOIN concert AS T2 ON T1.singer_id = T2.singer_id ORDER BY T2.age LIMIT 1 (no such column: T2.singer_id)

  question:  Show location and name for all stadiums with a capacity between 5000 and 10000.
  reference: SELECT LOCATION , name FROM stadium WHERE capacity BETWEEN 5000 AND 10000
  model:     SELECT T1.location, T1.name FROM stadium AS T1 JOIN concert AS T2 ON T1.stadium_id = T2.stadium_id WHERE T2.capacity BETWEEN 5000 AND 10000 (no such column: T2.capacity)

== runs, wrong result: 187
  question:  Show name, country, age for all singers ordered by age from the oldest to the youngest.
  reference: SELECT name , country , age FROM singer ORDER BY age DESC
  model:     SELECT name, country FROM singer ORDER BY age 

  question:  How many singers are from each country?
  reference: SELECT country , count(*) FROM singer GROUP BY country
  model:     SELECT count(*), Country FROM singer GROUP BY Country 

  question:  What is the maximum capacity and the average of all stadiums ?
  reference: select max(capacity), average from stadium
  model:     SELECT max(capacity), avg(capacity) FROM stadium </code></pre> <p>The first group is why execution accuracy exists: the model groups by the name instead of the id, joins the tables from the other side, or writes an aggregate where the reference doesn’t need one, and the rows come out the same. Some of these are right on this database only; a suite of test databases would catch a few.</p> <p>The second group is the model’s main failure, and it isn’t about SQL. The queries are well formed, but they reach for a column or a table that doesn’t exist, often through a join the question didn’t need.</p> <p>The third group is where our own check shows its limits. “How many singers are from each country?” answered with <code class="language-plaintext highlighter-rouge">SELECT count(*), Country</code> is right: it holds the same numbers in the other column order, and our comparison, which is strict about the order of columns, counts it as wrong.</p> <p>The last example is a matter of annotation: the reference reads “the average” as a column called <code class="language-plaintext highlighter-rouge">Average</code>, the model as <code class="language-plaintext highlighter-rouge">avg(capacity)</code>, and a person could read the question either way. No metric of text-to-SQL is free of such cases; what matters is knowing which way each one errs.</p> <p>The queries that don’t run, sorted by what SQLite said about them:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">error_kind</span><span class="p">(</span><span class="n">message</span><span class="p">):</span>
    <span class="k">for</span> <span class="n">kind</span> <span class="ow">in</span> <span class="p">[</span><span class="sh">"</span><span class="s">no such column</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">syntax error</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">no such table</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">ambiguous column</span><span class="sh">"</span><span class="p">,</span>
                 <span class="sh">"</span><span class="s">interrupted</span><span class="sh">"</span><span class="p">]:</span>
        <span class="k">if</span> <span class="n">kind</span> <span class="ow">in</span> <span class="n">message</span><span class="p">:</span>
            <span class="k">return</span> <span class="n">kind</span>
    <span class="k">return</span> <span class="sh">"</span><span class="s">other</span><span class="sh">"</span>


<span class="n">kinds</span> <span class="o">=</span> <span class="nc">Counter</span><span class="p">(</span><span class="nf">error_kind</span><span class="p">(</span><span class="n">message</span><span class="p">)</span> <span class="k">for</span> <span class="n">message</span> <span class="ow">in</span> <span class="n">failed</span><span class="p">[</span><span class="sh">"</span><span class="s">status</span><span class="sh">"</span><span class="p">])</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">kinds</span><span class="p">.</span><span class="nf">most_common</span><span class="p">(),</span> <span class="n">columns</span><span class="o">=</span><span class="p">[</span><span class="sh">"</span><span class="s">SQLite says</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">queries</span><span class="sh">"</span><span class="p">]))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">SQLite says</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">queries</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">no such column</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">343</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">no such table</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">32</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">syntax error</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">19</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">ambiguous column</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">other</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5</td></tr></tbody></table></div> <p>Five failures in six are of one kind: the query names a column that the table doesn’t have. Syntax errors are rare. After 20 minutes the model writes grammatical SQL; what it can’t do reliably is read the schema.</p> <p>The text-to-SQL literature calls this <em>schema linking</em>, and it is why the best T5 systems on Spider gave the model some of each database’s contents as well as its names. Here is one failure drawn against the real schema:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">invented</span> <span class="o">=</span> <span class="n">failed</span><span class="p">[</span><span class="n">failed</span><span class="p">[</span><span class="sh">"</span><span class="s">status</span><span class="sh">"</span><span class="p">].</span><span class="nb">str</span><span class="p">.</span><span class="nf">startswith</span><span class="p">(</span><span class="sh">"</span><span class="s">no such column</span><span class="sh">"</span><span class="p">)]</span>
<span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="n">invented</span><span class="p">)</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">:</span>
    <span class="n">case</span> <span class="o">=</span> <span class="n">invented</span><span class="p">.</span><span class="n">iloc</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
    <span class="n">db</span> <span class="o">=</span> <span class="n">schemas</span><span class="p">[</span><span class="n">case</span><span class="p">[</span><span class="sh">"</span><span class="s">db_id</span><span class="sh">"</span><span class="p">]]</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">question:</span><span class="sh">"</span><span class="p">,</span> <span class="n">case</span><span class="p">[</span><span class="sh">"</span><span class="s">question</span><span class="sh">"</span><span class="p">])</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">model:   </span><span class="sh">"</span><span class="p">,</span> <span class="n">case</span><span class="p">[</span><span class="sh">"</span><span class="s">predicted</span><span class="sh">"</span><span class="p">])</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">SQLite:  </span><span class="sh">"</span><span class="p">,</span> <span class="n">case</span><span class="p">[</span><span class="sh">"</span><span class="s">status</span><span class="sh">"</span><span class="p">])</span>
    <span class="n">rows</span><span class="p">,</span> <span class="n">labels</span> <span class="o">=</span> <span class="p">[],</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">name</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">db</span><span class="p">[</span><span class="sh">"</span><span class="s">table_names_original</span><span class="sh">"</span><span class="p">]):</span>
        <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">([</span><span class="n">c</span> <span class="k">for</span> <span class="n">t</span><span class="p">,</span> <span class="n">c</span> <span class="ow">in</span> <span class="n">db</span><span class="p">[</span><span class="sh">"</span><span class="s">column_names_original</span><span class="sh">"</span><span class="p">][</span><span class="mi">1</span><span class="p">:]</span> <span class="k">if</span> <span class="n">t</span> <span class="o">==</span> <span class="n">i</span><span class="p">])</span>
        <span class="n">labels</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">name</span><span class="p">)</span>
    <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">([</span><span class="n">case</span><span class="p">[</span><span class="sh">"</span><span class="s">status</span><span class="sh">"</span><span class="p">].</span><span class="nf">split</span><span class="p">(</span><span class="sh">"</span><span class="s">: </span><span class="sh">"</span><span class="p">,</span> <span class="mi">1</span><span class="p">)[</span><span class="mi">1</span><span class="p">]])</span>
    <span class="n">labels</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="sh">"</span><span class="s">the model wrote</span><span class="sh">"</span><span class="p">)</span>
    <span class="nf">token_chips</span><span class="p">(</span><span class="n">rows</span><span class="p">,</span> <span class="n">labels</span><span class="o">=</span><span class="n">labels</span><span class="p">,</span> <span class="n">mark_spaces</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span>
                <span class="n">strong</span><span class="o">=</span><span class="k">lambda</span> <span class="n">row</span><span class="p">,</span> <span class="n">col</span><span class="p">,</span> <span class="n">token</span><span class="p">:</span> <span class="n">row</span> <span class="o">==</span> <span class="nf">len</span><span class="p">(</span><span class="n">rows</span><span class="p">)</span> <span class="o">-</span> <span class="mi">1</span><span class="p">)</span>
    <span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <pre class="tfs-printed"><code>question: Show the name and the release year of the song by the youngest singer.
model:    SELECT T1.name, T1.song_release_year FROM singer AS T1 JOIN concert AS T2 ON T1.singer_id = T2.singer_id ORDER BY T2.age LIMIT 1
SQLite:   no such column: T2.singer_id</code></pre> <p><img class="tfs-output" src="/assets/posts/arch/05/output-07.png" alt="Output of the code above" loading="lazy"></p> <p>The model knows that a singer has an id and that concerts involve singers, so it joins <code class="language-plaintext highlighter-rouge">singer</code> to <code class="language-plaintext highlighter-rouge">concert</code> on <code class="language-plaintext highlighter-rouge">singer_id</code>. But <code class="language-plaintext highlighter-rouge">concert</code> has no such column: singers and concerts meet in a third table, <code class="language-plaintext highlighter-rouge">singer_in_concert</code>, and nothing in our input says so.</p> <p>The foreign keys we left out would have. The question didn’t even need a join: the youngest singer’s song is in <code class="language-plaintext highlighter-rouge">singer</code> itself.</p> <h2 id="10-letting-sqlite-choose">10. Letting SQLite choose</h2> <p>A query that doesn’t run is the cheapest mistake to catch: SQLite says so in a millisecond, without knowing the right answer. PICARD used this inside the decoder, rejecting any token that would make the query unparseable.</p> <p>Earlier, Wang et al. ran partly written queries during <a href="/blog/2026/transformers-from-scratch-03-training/">beam search</a> and dropped the beams whose execution failed, which they called <em>execution-guided decoding</em><sup class="cite">[<a href="#ref-10" id="cite-10" data-ref="10" aria-label="Reference 10: Wang, C., Tatwawadi, K., Brockschmidt, M., Huang, P.-S., Mao, Y., Polozov, O., &amp; Singh, R. (2018). Robust text-to-SQL generation with execution-guided decoding. arXiv:1807.03100.">10</a>]</sup>.</p> <p>We do the simplest version of the idea: sample four more queries per question at a temperature of 0.7, put the greedy query first, and keep the first one that SQLite runs without an error. The choice looks only at the database, never at the reference answer, so it is a fair test.</p> <p>The last line, <em>at least one of five is right</em>, is not a method: it peeks at the reference. It shows how much a perfect judge could get out of the same five candidates.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">SAMPLES</span> <span class="o">=</span> <span class="mi">4</span>
<span class="n">generator</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nc">Generator</span><span class="p">(</span><span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">).</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">candidates</span> <span class="o">=</span> <span class="p">[[</span><span class="n">query</span><span class="p">]</span> <span class="k">for</span> <span class="n">query</span> <span class="ow">in</span> <span class="n">predictions</span><span class="p">]</span>  <span class="c1"># the greedy query comes first
</span><span class="n">started</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
<span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">evaluated</span><span class="p">),</span> <span class="mi">64</span><span class="p">):</span>
    <span class="n">chunk</span> <span class="o">=</span> <span class="n">evaluated</span><span class="p">[</span><span class="n">i</span><span class="p">:</span><span class="n">i</span> <span class="o">+</span> <span class="mi">64</span><span class="p">]</span>
    <span class="n">batch</span> <span class="o">=</span> <span class="nf">sql_tokenizer</span><span class="p">([</span><span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">input</span><span class="sh">"</span><span class="p">]</span> <span class="k">for</span> <span class="n">e</span> <span class="ow">in</span> <span class="n">chunk</span><span class="p">],</span> <span class="n">max_length</span><span class="o">=</span><span class="mi">512</span><span class="p">,</span> <span class="n">truncation</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
                          <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">SAMPLES</span><span class="p">):</span>
        <span class="n">written</span> <span class="o">=</span> <span class="nf">generate</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">batch</span><span class="p">.</span><span class="n">input_ids</span><span class="p">,</span> <span class="n">batch</span><span class="p">.</span><span class="n">attention_mask</span><span class="p">,</span> <span class="n">max_new_tokens</span><span class="o">=</span><span class="mi">192</span><span class="p">,</span>
                           <span class="n">temperature</span><span class="o">=</span><span class="mf">0.7</span><span class="p">,</span> <span class="n">generator</span><span class="o">=</span><span class="n">generator</span><span class="p">)</span>
        <span class="n">queries</span> <span class="o">=</span> <span class="n">sql_tokenizer</span><span class="p">.</span><span class="nf">batch_decode</span><span class="p">(</span><span class="n">written</span><span class="p">,</span> <span class="n">skip_special_tokens</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
        <span class="k">for</span> <span class="n">j</span><span class="p">,</span> <span class="n">query</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">queries</span><span class="p">):</span>
            <span class="n">candidates</span><span class="p">[</span><span class="n">i</span> <span class="o">+</span> <span class="n">j</span><span class="p">].</span><span class="nf">append</span><span class="p">(</span><span class="n">query</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">SAMPLES</span><span class="si">}</span><span class="s"> more queries per question in </span><span class="si">{</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">started</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> s</span><span class="sh">"</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">first_that_runs</span><span class="p">(</span><span class="n">db_id</span><span class="p">,</span> <span class="n">queries</span><span class="p">):</span>
    <span class="k">for</span> <span class="n">query</span> <span class="ow">in</span> <span class="n">queries</span><span class="p">:</span>
        <span class="k">try</span><span class="p">:</span>
            <span class="nf">run_query</span><span class="p">(</span><span class="n">db_id</span><span class="p">,</span> <span class="n">query</span><span class="p">)</span>
            <span class="k">return</span> <span class="n">query</span>
        <span class="k">except</span> <span class="nb">Exception</span><span class="p">:</span>
            <span class="k">continue</span>
    <span class="k">return</span> <span class="n">queries</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>  <span class="c1"># none runs: keep the greedy one
</span>

<span class="n">chosen</span><span class="p">,</span> <span class="n">any_right</span> <span class="o">=</span> <span class="p">[],</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">e</span><span class="p">,</span> <span class="n">queries</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">evaluated</span><span class="p">,</span> <span class="n">candidates</span><span class="p">):</span>
    <span class="n">chosen</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="nf">first_that_runs</span><span class="p">(</span><span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">db_id</span><span class="sh">"</span><span class="p">],</span> <span class="n">queries</span><span class="p">))</span>
    <span class="n">any_right</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="nf">any</span><span class="p">(</span><span class="nf">same_result</span><span class="p">(</span><span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">db_id</span><span class="sh">"</span><span class="p">],</span> <span class="n">q</span><span class="p">,</span> <span class="nf">model_target</span><span class="p">(</span><span class="n">e</span><span class="p">))[</span><span class="mi">0</span><span class="p">]</span> <span class="k">for</span> <span class="n">q</span> <span class="ow">in</span> <span class="n">queries</span><span class="p">))</span>
<span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">chosen</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">chosen</span>
<span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">chosen correct</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="p">[</span><span class="nf">same_result</span><span class="p">(</span><span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">db_id</span><span class="sh">"</span><span class="p">],</span> <span class="n">q</span><span class="p">,</span> <span class="nf">model_target</span><span class="p">(</span><span class="n">e</span><span class="p">))[</span><span class="mi">0</span><span class="p">]</span>
                             <span class="k">for</span> <span class="n">e</span><span class="p">,</span> <span class="n">q</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">evaluated</span><span class="p">,</span> <span class="n">chosen</span><span class="p">)]</span>
<span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">any of 5 correct</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">any_right</span>
<span class="n">still_failing</span> <span class="o">=</span> <span class="mi">0</span>
<span class="k">for</span> <span class="n">e</span><span class="p">,</span> <span class="n">q</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">evaluated</span><span class="p">,</span> <span class="n">chosen</span><span class="p">):</span>
    <span class="k">try</span><span class="p">:</span>
        <span class="nf">run_query</span><span class="p">(</span><span class="n">e</span><span class="p">[</span><span class="sh">"</span><span class="s">db_id</span><span class="sh">"</span><span class="p">],</span> <span class="n">q</span><span class="p">)</span>
    <span class="k">except</span> <span class="nb">Exception</span><span class="p">:</span>
        <span class="n">still_failing</span> <span class="o">+=</span> <span class="mi">1</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">greedy:                      </span><span class="si">{</span><span class="n">results</span><span class="p">[</span><span class="sh">'</span><span class="s">correct</span><span class="sh">'</span><span class="p">].</span><span class="nf">mean</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">first of 5 that runs:        </span><span class="si">{</span><span class="n">results</span><span class="p">[</span><span class="sh">'</span><span class="s">chosen correct</span><span class="sh">'</span><span class="p">].</span><span class="nf">mean</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">at least one of 5 is right:  </span><span class="si">{</span><span class="n">results</span><span class="p">[</span><span class="sh">'</span><span class="s">any of 5 correct</span><span class="sh">'</span><span class="p">].</span><span class="nf">mean</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">queries that still fail to run:</span><span class="sh">"</span><span class="p">,</span> <span class="n">still_failing</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>4 more queries per question in 348 s
greedy:                      42.6%
first of 5 that runs:        48.8%
at least one of 5 is right:  52.8%
queries that still fail to run: 260</code></pre> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">labels</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">greedy</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">first of 5</span><span class="se">\n</span><span class="s">that runs</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">any of 5</span><span class="se">\n</span><span class="s">is right</span><span class="sh">"</span><span class="p">]</span>
<span class="n">values</span> <span class="o">=</span> <span class="p">[</span><span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">correct</span><span class="sh">"</span><span class="p">].</span><span class="nf">mean</span><span class="p">(),</span> <span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">chosen correct</span><span class="sh">"</span><span class="p">].</span><span class="nf">mean</span><span class="p">(),</span>
          <span class="n">results</span><span class="p">[</span><span class="sh">"</span><span class="s">any of 5 correct</span><span class="sh">"</span><span class="p">].</span><span class="nf">mean</span><span class="p">()]</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.4</span><span class="p">,</span> <span class="mf">2.4</span><span class="p">))</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">barh</span><span class="p">(</span><span class="n">labels</span><span class="p">,</span> <span class="n">values</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="p">[</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">],</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">]])</span>
<span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">value</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">values</span><span class="p">):</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">text</span><span class="p">(</span><span class="n">value</span> <span class="o">+</span> <span class="mf">0.01</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">value</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span> <span class="n">va</span><span class="o">=</span><span class="sh">"</span><span class="s">center</span><span class="sh">"</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">invert_yaxis</span><span class="p">()</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlim</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">execution accuracy on 1,034 development questions</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/05/output-08.png" alt="Output of the code above" loading="lazy"></p> <p>Letting SQLite reject the queries that fail adds about six points of execution accuracy, with no new training and nothing but the database’s word that a query runs.</p> <p>More than a third of the failing questions get a working replacement from the four samples. The last bar shows what is left for a better judge: a perfect choice among the same five candidates would add only about four points more.</p> <p>For nearly half of the questions, none of the five candidates is right. Choosing better won’t fix those; a bigger model, longer training, or the schema’s keys and some of its values in the input would.</p> <h2 id="11-why-decoder-only-models-won-anyway">11. Why decoder-only models won anyway</h2> <p>T5’s own comparison put the encoder–decoder first: “For all tasks, the encoder-decoder architecture with the denoising objective performed best.” Three years later the largest models were all decoders. The reasons are worth knowing, because none of them is that the encoder–decoder is worse.</p> <p>The first is what got measured. T5 measured transfer learning: pre-train, then fine-tune for each task. The models that changed the field were used another way, prompted with no fine-tuning at all.</p> <p>BigScience tested exactly this before choosing the architecture of BLOOM, training models of 5 billion parameters on 170 billion tokens, and found that “the best objective and architecture is the opposite in these two settings”: a causal decoder trained on plain language modelling did best right after pre-training, an encoder–decoder trained on masked language modelling did best once multi-task fine-tuning was added<sup class="cite">[<a href="#ref-11" id="cite-11" data-ref="11" aria-label="Reference 11: Wang, T., Roberts, A., Hesslow, D., Le Scao, T., et al. (2022). What language model architecture and pretraining objective work best for zero-shot generalization? ICML 2022.">11</a>]</sup>.</p> <p>BLOOM’s report <sup class="cite">[<a href="#ref-12" id="cite-12" data-ref="12" aria-label="Reference 12: BigScience Workshop (2022). BLOOM: a 176B-parameter open-access multilingual language model. arXiv:2211.05100.">12</a>]</sup> stated the market’s verdict: “all state-of-the-art language models over 100 billion parameters are causal decoder-only models”.</p> <p>The second is memory. Each token passes through only one stack, so an encoder–decoder costs about as much compute as a decoder-only model with half its parameters. But it has “twice the parameters of the decoder-only model, and hence twice the memory footprint”, and when the limit is what fits on the GPUs, that counts.</p> <p>The third is how much the objective teaches per token: denoising learns from the 15% of tokens it hides, language modelling from nearly all of them, which Yi Tay, the first author of <a href="https://arxiv.org/abs/2205.05131">UL2</a>, calls less “loss exposure” <sup class="cite">[<a href="#ref-13" id="cite-13" data-ref="13" aria-label="Reference 13: Tay, Y. (2024). What happened to BERT &amp; T5? On Transformer encoders, PrefixLM and denoising objectives.">13</a>]</sup>.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/05/cost-light.png" width="760" alt="What an encoder–decoder costs against a decoder-only model. The decoder-only model is one stack with P parameters, and every token, of the input and of the output, passes through it. The encoder–decoder has two stacks of P parameters each: input tokens pass through the encoder, output tokens through the decoder. Each token meets P parameters in both cases, so the compute is about the same, but the encoder–decoder has to keep twice the parameters in memory" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/05/cost-dark.png" width="760" alt="What an encoder–decoder costs against a decoder-only model. The decoder-only model is one stack with P parameters, and every token, of the input and of the output, passes through it. The encoder–decoder has two stacks of P parameters each: input tokens pass through the encoder, output tokens through the decoder. Each token meets P parameters in both cases, so the compute is about the same, but the encoder–decoder has to keep twice the parameters in memory" loading="lazy"></p> <p>There is also an engineering argument, which is ours rather than a paper’s: one stack is simpler. A chat is one growing sequence in which every answer becomes part of the next input.</p> <p>A decoder reads it with one KV cache; an encoder–decoder has to decide what counts as input and re-encode it as the conversation grows. Kernels, serving systems and fine-tuning tools were then built for the one shape that won, which made it cheaper still.</p> <p>The verdict is not final. In 2025 Google turned pre-trained Gemma 2 decoders into encoder–decoders and reported that “under similar inference budget, encoder-decoder LLMs achieve comparable (often better) pretraining performance but substantially better finetuning performance than their decoder-only counterpart” <sup class="cite">[<a href="#ref-14" id="cite-14" data-ref="14" aria-label="Reference 14: Zhang, B., Moiseev, F., Ainslie, J., et al. (2025). Encoder-decoder Gemma: improving the quality-efficiency trade-off via adaptation. arXiv:2504.06225.">14</a>]</sup>.</p> <p>Google’s announcement adds that a model with a 9B encoder and a 2B decoder runs at nearly the latency of the 2B model <sup class="cite">[<a href="#ref-15" id="cite-15" data-ref="15" aria-label="Reference 15: Google (2025). T5Gemma: a new collection of encoder-decoder Gemma models. Google Developers Blog.">15</a>]</sup>. <a href="https://arxiv.org/abs/2512.14856">T5Gemma 2</a> followed in December 2025, multimodal, in sizes from 270M-270M to 4B-4B.</p> <h2 id="12-where-the-encoderdecoder-is-the-right-tool-today">12. Where the encoder–decoder is the right tool today</h2> <p>Wherever the input is long or of a different kind from the output, and the output is short. Speech recognition: Whisper is an encoder–decoder, chosen because “this architecture has been well validated to scale reliably” <sup class="cite">[<a href="#ref-16" id="cite-16" data-ref="16" aria-label="Reference 16: Radford, A., Kim, J. W., Xu, T., Brockman, G., McLeavey, C., &amp; Sutskever, I. (2022). Robust speech recognition via large-scale weak supervision. arXiv:2212.04356.">16</a>]</sup>.</p> <p>Translation: Meta’s <a href="https://arxiv.org/abs/2207.04672">NLLB-200</a> and the Helsinki-NLP MarianMT models. Image generation: the frozen encoder half of a T5-XXL turns the prompt into vectors in Imagen, Stable Diffusion 3 and <a href="https://github.com/black-forest-labs/flux">FLUX.1</a>.</p> <p>Imagen’s authors found “scaling the text encoder size to be significantly more impactful than the U-Net size”<sup class="cite">[<a href="#ref-17" id="cite-17" data-ref="17" aria-label="Reference 17: Saharia, C., Chan, W., Saxena, S., et al. (2022). Photorealistic text-to-image diffusion models with deep language understanding. NeurIPS 2022.">17</a>]</sup>, and Stable Diffusion 3’s that dropping T5 costs little, except when the prompt asks for written text in the picture <sup class="cite">[<a href="#ref-18" id="cite-18" data-ref="18" aria-label="Reference 18: Esser, P., Kulal, S., Blattmann, A., et al. (2024). Scaling rectified flow transformers for high-resolution image synthesis. ICML 2024.">18</a>]</sup>.</p> <p>And structured jobs like ours: a question to SQL, a document to fields, a ticket to a category with an explanation. For such a job, a small encoder–decoder fine-tuned on a few thousand examples is cheap to run and, in our experience, hard to beat at its size.</p> <p>What it is not for is open conversation and learning from examples in the prompt. The models people chat with are decoders, and <a href="/blog/2026/transformer-architectures-06-modern/">lesson 6</a> is about what changed inside them since GPT-2.</p> <p>T5’s passport, and the family tree with this lesson’s branch:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/05/passport-light.png" width="760" alt="T5's passport. Published October 2019 by Google. Type: encoder–decoder. Pre-training: span corruption on C4, and in version 1.0 a mixture of supervised tasks. Attention: bidirectional in the encoder, causal self-attention and cross-attention in the decoder. Positions: no position embeddings, a learned bias per head over 32 log-spaced buckets of distance. Normalisation: pre-norm with scale only, no mean and no bias. Activation: ReLU in version 1.0, gated GELU from version 1.1. Vocabulary: SentencePiece, 32,128 rows, without the characters less-than and curly braces. Sizes: 60 million, 220 million, 770 million, 3 and 11 billion parameters. Good at: input-to-output tasks such as translation, extraction, SQL, and as a text encoder. Not for: open-ended chat, long free generation, in-context learning" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/05/passport-dark.png" width="760" alt="T5's passport. Published October 2019 by Google. Type: encoder–decoder. Pre-training: span corruption on C4, and in version 1.0 a mixture of supervised tasks. Attention: bidirectional in the encoder, causal self-attention and cross-attention in the decoder. Positions: no position embeddings, a learned bias per head over 32 log-spaced buckets of distance. Normalisation: pre-norm with scale only, no mean and no bias. Activation: ReLU in version 1.0, gated GELU from version 1.1. Vocabulary: SentencePiece, 32,128 rows, without the characters less-than and curly braces. Sizes: 60 million, 220 million, 770 million, 3 and 11 billion parameters. Good at: input-to-output tasks such as translation, extraction, SQL, and as a text encoder. Not for: open-ended chat, long free generation, in-context learning" loading="lazy"></p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/05/family-light.png" width="760" alt="The family of the Transformer as this course covers it, with lesson 5, T5 and BART, highlighted and lessons 1 to 4 done" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/05/family-dark.png" width="760" alt="The family of the Transformer as this course covers it, with lesson 5, T5 and BART, highlighted and lessons 1 to 4 done" loading="lazy"></p> <h2 id="references">References</h2> <ol class="tfs-refs"> <li id="ref-1">Green, B. F., Wolf, A. K., Chomsky, C., &amp; Laughery, K. (1961). <a href="https://doi.org/10.1145/1460690.1460714">Baseball: an automatic question-answerer</a>. <em>Western Joint IRE-AIEE-ACM Computer Conference</em>, 219–224. <a class="ref-back" href="#cite-1" aria-label="Back to the text">↩</a></li> <li id="ref-2">Lei, F., Chen, J., Ye, Y., et al. (2025). <a href="https://arxiv.org/abs/2411.07763">Spider 2.0: evaluating language models on real-world enterprise text-to-SQL workflows</a>. <em>ICLR 2025</em>. <a class="ref-back" href="#cite-2" aria-label="Back to the text">↩</a></li> <li id="ref-3">Raffel, C., Shazeer, N., Roberts, A., Lee, K., Narang, S., Matena, M., Zhou, Y., Li, W., &amp; Liu, P. J. (2020). <a href="https://arxiv.org/abs/1910.10683">Exploring the limits of transfer learning with a unified text-to-text transformer</a>. <em>Journal of Machine Learning Research</em>, 21(140), 1–67. <a class="ref-back" href="#cite-3" aria-label="Back to the text">↩</a></li> <li id="ref-4">Zhang, B., &amp; Sennrich, R. (2019). <a href="https://arxiv.org/abs/1910.07467">Root mean square layer normalization</a>. <em>NeurIPS 2019</em>. <a class="ref-back" href="#cite-4" aria-label="Back to the text">↩</a></li> <li id="ref-5">Lewis, M., Liu, Y., Goyal, N., Ghazvininejad, M., Mohamed, A., Levy, O., Stoyanov, V., &amp; Zettlemoyer, L. (2020). <a href="https://aclanthology.org/2020.acl-main.703/">BART: denoising sequence-to-sequence pre-training for natural language generation, translation, and comprehension</a>. <em>ACL 2020</em>. <a class="ref-back" href="#cite-5" aria-label="Back to the text">↩</a></li> <li id="ref-6">Yu, T., Zhang, R., Yang, K., et al. (2018). <a href="https://aclanthology.org/D18-1425/">Spider: a large-scale human-labeled dataset for complex and cross-domain semantic parsing and text-to-SQL task</a>. <em>EMNLP 2018</em>. Data: <a href="https://yale-lily.github.io/spider">yale-lily.github.io/spider</a>, CC BY-SA 4.0. <a class="ref-back" href="#cite-6" aria-label="Back to the text">↩</a></li> <li id="ref-7">Scholak, T., Schucher, N., &amp; Bahdanau, D. (2021). <a href="https://arxiv.org/abs/2109.05093">PICARD: parsing incrementally for constrained auto-regressive decoding from language models</a>. <em>EMNLP 2021</em>. <a class="ref-back" href="#cite-7" aria-label="Back to the text">↩</a></li> <li id="ref-8">Hugging Face forum (2021). <a href="https://discuss.huggingface.co/t/t5-fp16-issue-is-fixed/3139">T5 fp16 issue is fixed</a>. <a class="ref-back" href="#cite-8" aria-label="Back to the text">↩</a></li> <li id="ref-9">Zhong, R., Yu, T., &amp; Klein, D. (2020). <a href="https://arxiv.org/abs/2010.02840">Semantic evaluation for text-to-SQL with distilled test suites</a>. <em>EMNLP 2020</em>. <a class="ref-back" href="#cite-9" aria-label="Back to the text">↩</a></li> <li id="ref-10">Wang, C., Tatwawadi, K., Brockschmidt, M., Huang, P.-S., Mao, Y., Polozov, O., &amp; Singh, R. (2018). <a href="https://arxiv.org/abs/1807.03100">Robust text-to-SQL generation with execution-guided decoding</a>. arXiv:1807.03100. <a class="ref-back" href="#cite-10" aria-label="Back to the text">↩</a></li> <li id="ref-11">Wang, T., Roberts, A., Hesslow, D., Le Scao, T., et al. (2022). <a href="https://arxiv.org/abs/2204.05832">What language model architecture and pretraining objective work best for zero-shot generalization?</a> <em>ICML 2022</em>. <a class="ref-back" href="#cite-11" aria-label="Back to the text">↩</a></li> <li id="ref-12">BigScience Workshop (2022). <a href="https://arxiv.org/abs/2211.05100">BLOOM: a 176B-parameter open-access multilingual language model</a>. arXiv:2211.05100. <a class="ref-back" href="#cite-12" aria-label="Back to the text">↩</a></li> <li id="ref-13">Tay, Y. (2024). <a href="https://www.yitay.net/blog/model-architecture-blogpost-encoders-prefixlm-denoising">What happened to BERT &amp; T5? On Transformer encoders, PrefixLM and denoising objectives</a>. <a class="ref-back" href="#cite-13" aria-label="Back to the text">↩</a></li> <li id="ref-14">Zhang, B., Moiseev, F., Ainslie, J., et al. (2025). <a href="https://arxiv.org/abs/2504.06225">Encoder-decoder Gemma: improving the quality-efficiency trade-off via adaptation</a>. arXiv:2504.06225. <a class="ref-back" href="#cite-14" aria-label="Back to the text">↩</a></li> <li id="ref-15">Google (2025). <a href="https://developers.googleblog.com/en/t5gemma/">T5Gemma: a new collection of encoder-decoder Gemma models</a>. Google Developers Blog. <a class="ref-back" href="#cite-15" aria-label="Back to the text">↩</a></li> <li id="ref-16">Radford, A., Kim, J. W., Xu, T., Brockman, G., McLeavey, C., &amp; Sutskever, I. (2022). <a href="https://arxiv.org/abs/2212.04356">Robust speech recognition via large-scale weak supervision</a>. arXiv:2212.04356. <a class="ref-back" href="#cite-16" aria-label="Back to the text">↩</a></li> <li id="ref-17">Saharia, C., Chan, W., Saxena, S., et al. (2022). <a href="https://arxiv.org/abs/2205.11487">Photorealistic text-to-image diffusion models with deep language understanding</a>. <em>NeurIPS 2022</em>. <a class="ref-back" href="#cite-17" aria-label="Back to the text">↩</a></li> <li id="ref-18">Esser, P., Kulal, S., Blattmann, A., et al. (2024). <a href="https://arxiv.org/abs/2403.03206">Scaling rectified flow transformers for high-resolution image synthesis</a>. <em>ICML 2024</em>. <a class="ref-back" href="#cite-18" aria-label="Back to the text">↩</a></li> <li id="ref-19">Tay, Y., Dehghani, M., Tran, V. Q., et al. (2023). <a href="https://arxiv.org/abs/2205.05131">UL2: unifying language learning paradigms</a>. <em>ICLR 2023</em>.</li> <li id="ref-20">Zhang, B., Suganthan, P., Liu, G., et al. (2025). <a href="https://arxiv.org/abs/2512.14856">T5Gemma 2: seeing, reading, and understanding longer</a>. arXiv:2512.14856.</li> <li id="ref-21">NLLB Team (2022). <a href="https://arxiv.org/abs/2207.04672">No language left behind: scaling human-centered machine translation</a>. arXiv:2207.04672.</li> </ol>]]></content> <author> <name>Eva Koroleva</name> </author> <category term="machine-learning"/> <category term="transformer-architectures"/> <category term="t5"/> <category term="bart"/> <category term="encoder-decoder"/> <category term="text-to-sql"/> <category term="spider"/> <category term="nlp"/> <summary type="html"><![CDATA[T5 written from scratch and loaded with Google's weights: relative position buckets, cross-attention, span corruption and BART's text infilling, and a T5 fine-tuned on Spider to write SQL, checked by running every query on SQLite.]]></summary> <media:thumbnail url="https://blog.korolevalab.com/assets/posts/arch/05/cover.png"/> <media:content medium="image" url="https://blog.korolevalab.com/assets/posts/arch/05/cover.png"/> </entry> <entry> <title type="html">GPT from scratch: GPT-2, the KV cache and a model that learns chess</title> <link href="https://blog.korolevalab.com/blog/2026/transformer-architectures-04-gpt/" rel="alternate" type="text/html" title="GPT from scratch: GPT-2, the KV cache and a model that learns chess"/> <published>2026-04-28T13:00:00+00:00</published> <updated>2026-11-03T00:00:00+00:00</updated> <id>https://blog.korolevalab.com/blog/2026/transformer-architectures-04-gpt</id> <content type="html" xml:base="https://blog.korolevalab.com/blog/2026/transformer-architectures-04-gpt/"><![CDATA[<p class="tfs-links"><strong>Transformer architectures: from BERT to diffusion</strong> · lesson 4 of 15 · <a href="/teaching/">all lessons</a> · <a href="https://www.kaggle.com/code/qmarva/transformer-architectures-04-gpt-chess">run on Kaggle</a> · <a href="https://colab.research.google.com/github/xmarva/transformers-from-scratch/blob/main/notebooks/colab/a04_gpt.ipynb">open in Colab</a> · <a href="https://github.com/xmarva/transformers-from-scratch">code on GitHub</a></p> <p>In September 2023 OpenAI released gpt-3.5-turbo-instruct, an unremarkable model for completing text, and within days people noticed that it played chess.</p> <p>Nicholas Carlini gave it the moves of a game so far, in PGN, the notation of chess books and databases, and asked it for the next one: “GPT-4, for example, can’t even play a full game against me without making a few illegal moves. GPT-3.5-turbo-instruct can beat me” <sup class="cite">[<a href="#ref-1" id="cite-1" data-ref="1" aria-label="Reference 1: Carlini, N. (2023). Playing chess with large language models.">1</a>]</sup>.</p> <p>Against the bots of Lichess it later rated 1755, the level of a good amateur<sup class="cite">[<a href="#ref-2" id="cite-2" data-ref="2" aria-label="Reference 2: Ruoss, A., Delétang, G., Medapati, S., Grau-Moya, J., Wenliang, L. K., Catt, E., Reid, J., Lewis, C. A., Veness, J., &amp; Genewein, T. (2024). Amortized planning with large-scale transformers: a case study on chess. NeurIPS 2024.">2</a>]</sup>. A year on, Dynomight tested a dozen other language models, open ones and OpenAI’s newer chat models among them, and rated every one of them “Terrible”<sup class="cite">[<a href="#ref-3" id="cite-3" data-ref="3" aria-label="Reference 3: Dynomight (2024). Something weird is happening with LLMs and chess.">3</a>]</sup>.</p> <p>Part of the explanation sits in an appendix of an OpenAI paper: GPT-4’s <a href="/blog/2024/llms-for-those-who-missed-out/">pre-training</a> data “included chess games in the format of move sequence known as Portable Game Notation (PGN)”, and only games of players rated 1800 or higher <sup class="cite">[<a href="#ref-4" id="cite-4" data-ref="4" aria-label="Reference 4: Burns, C., Izmailov, P., Kirchner, J. H., Baker, B., Gao, L., Aschenbrenner, L., Chen, Y., Ecoffet, A., Joglekar, M., Leike, J., Sutskever, I., &amp; Wu, J. (2023). Weak-to-strong generalization: eliciting strong capabilities with weak supervision. arXiv:2312.09390.">4</a>]</sup>.</p> <p>Nobody taught these models the rules. They read game records, and a game record is a strange text: it lists moves and never shows a position.</p> <p>To write a legal move you have to know where the pieces stand, and nothing in the text says. So does a model that only ever predicted the next character of game records keep a board somewhere inside it? That question fits on a free GPU.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/04/hero-light.png" width="760" alt="A chess GPT reads a game record one character at a time, a semicolon, 1, a dot, e, 4, a space, e, 5 and so on, and predicts the next character. Nothing in the input says where the pieces stand. A linear probe, one matrix, reads the residual stream after a middle layer and recovers what stands on each of the 64 squares" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/04/hero-dark.png" width="760" alt="A chess GPT reads a game record one character at a time, a semicolon, 1, a dot, e, 4, a space, e, 5 and so on, and predicts the next character. Nothing in the input says where the pieces stand. A linear probe, one matrix, reads the residual stream after a middle layer and recovers what stands on each of the 64 squares" loading="lazy"></p> <p>All of these models are GPTs, descendants of a 2018 OpenAI model trained to do one thing: predict the next token. In this lesson you will write GPT-2 yourself, load OpenAI’s weights into your code, and watch it generate and change its mind layer by layer.</p> <p>Then you will train a small GPT of your own on Lichess games for 25 minutes, see how well it plays, and look inside it for the board.</p> <p><strong>What you’ll do</strong></p> <ol> <li>See what a decoder-only model is trained to do, and why one rule turned out to be enough.</li> <li>Read the blueprints of GPT-1 and the four GPT-2s from their configs, and count where the parameters live.</li> <li>Write GPT-2 in PyTorch, load OpenAI’s weights into it and match Hugging Face’s outputs.</li> <li>Generate text with a <a href="/blog/2025/inference-optimization/">KV cache</a> and measure what the cache saves.</li> <li>Watch GPT-2 change its mind layer by layer with the logit lens.</li> <li>Ask GPT-2 to play chess, then train a GPT of your own on Lichess games and see how often its moves are legal.</li> <li>Open the chess model up and find the board inside it with a linear probe.</li> </ol> <p><strong>What you need</strong>: a GPU. On Kaggle, <em>Settings → Accelerator → GPU</em>; on Colab, <em>Runtime → Change runtime type → T4 GPU</em>. The notebook downloads GPT-2 (550 MB) and a gigabyte of Lichess games, and trains a chess model for 25 minutes; on a T4 it runs in about 40 minutes.</p> <h2 id="setup">Setup</h2> <p>One small helper package, <code class="language-plaintext highlighter-rouge">tfs</code>, draws the course’s plots and token chips and knows where the notebook runs (Kaggle, Colab or your own machine). Everything the lesson teaches is written out in the notebook itself.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">importlib.util</span>
<span class="kn">import</span> <span class="n">subprocess</span>
<span class="kn">import</span> <span class="n">sys</span>

<span class="n">TFS</span> <span class="o">=</span> <span class="sh">"</span><span class="s">git+https://github.com/xmarva/transformers-from-scratch@main</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">importlib</span><span class="p">.</span><span class="n">util</span><span class="p">.</span><span class="nf">find_spec</span><span class="p">(</span><span class="sh">"</span><span class="s">tfs</span><span class="sh">"</span><span class="p">)</span> <span class="ow">is</span> <span class="bp">None</span><span class="p">:</span>
    <span class="n">subprocess</span><span class="p">.</span><span class="nf">check_call</span><span class="p">([</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">-m</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">pip</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">install</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-q</span><span class="sh">"</span><span class="p">,</span> <span class="n">TFS</span><span class="p">])</span>

<span class="kn">from</span> <span class="n">tfs</span> <span class="kn">import</span> <span class="n">env</span>
<span class="kn">from</span> <span class="n">tfs.viz</span> <span class="kn">import</span> <span class="n">table</span><span class="p">,</span> <span class="n">token_chips</span><span class="p">,</span> <span class="n">use_course_style</span>

<span class="n">env</span><span class="p">.</span><span class="nf">quiet</span><span class="p">()</span>  <span class="c1"># no progress bars or environment warnings in the outputs
</span><span class="n">SEED</span> <span class="o">=</span> <span class="mi">42</span>
<span class="n">env</span><span class="p">.</span><span class="nf">seed_everything</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">COLORS</span> <span class="o">=</span> <span class="nf">use_course_style</span><span class="p">()</span>
<span class="n">WORK_DIR</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">work_dir</span><span class="p">()</span>
</code></pre></div></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">importlib.util</span>
<span class="kn">import</span> <span class="n">json</span>
<span class="kn">import</span> <span class="n">math</span>
<span class="kn">import</span> <span class="n">random</span>
<span class="kn">import</span> <span class="n">re</span>
<span class="kn">import</span> <span class="n">subprocess</span>
<span class="kn">import</span> <span class="n">sys</span>
<span class="kn">import</span> <span class="n">time</span>
<span class="kn">from</span> <span class="n">collections</span> <span class="kn">import</span> <span class="n">Counter</span>

<span class="c1"># python-chess knows the rules of chess; our models will never be told them
</span><span class="k">if</span> <span class="n">importlib</span><span class="p">.</span><span class="n">util</span><span class="p">.</span><span class="nf">find_spec</span><span class="p">(</span><span class="sh">"</span><span class="s">chess</span><span class="sh">"</span><span class="p">)</span> <span class="ow">is</span> <span class="bp">None</span><span class="p">:</span>
    <span class="n">subprocess</span><span class="p">.</span><span class="nf">check_call</span><span class="p">([</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">-m</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">pip</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">install</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-q</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">chess==1.11.2</span><span class="sh">"</span><span class="p">])</span>
<span class="kn">import</span> <span class="n">chess</span>
<span class="kn">import</span> <span class="n">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>
<span class="kn">import</span> <span class="n">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="n">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">import</span> <span class="n">torch</span>
<span class="kn">import</span> <span class="n">torch.nn</span> <span class="k">as</span> <span class="n">nn</span>
<span class="kn">import</span> <span class="n">torch.nn.functional</span> <span class="k">as</span> <span class="n">F</span>
<span class="kn">from</span> <span class="n">huggingface_hub</span> <span class="kn">import</span> <span class="n">get_safetensors_metadata</span><span class="p">,</span> <span class="n">hf_hub_download</span>
<span class="kn">from</span> <span class="n">IPython.display</span> <span class="kn">import</span> <span class="n">display</span>
<span class="kn">from</span> <span class="n">safetensors.torch</span> <span class="kn">import</span> <span class="n">load_file</span>
<span class="kn">from</span> <span class="n">tfs.viz</span> <span class="kn">import</span> <span class="n">heatmap</span>
<span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">AutoTokenizer</span>
<span class="c1"># the reference implementation, for the check
</span><span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">GPT2LMHeadModel</span>

<span class="n">SMOKE</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">smoke</span><span class="p">()</span>  <span class="c1"># CI runs the lesson on a small slice; you run it in full
</span><span class="n">device</span> <span class="o">=</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">if</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">is_available</span><span class="p">()</span> <span class="k">else</span> <span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span>
<span class="k">assert</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="ow">or</span> <span class="n">SMOKE</span><span class="p">,</span> <span class="sh">"</span><span class="s">This lesson trains a model for 25 minutes: use a GPU.</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">GPU:</span><span class="sh">"</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">get_device_name</span><span class="p">(</span><span class="mi">0</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>GPU: Tesla T4</code></pre> <h2 id="1-one-rule-predict-the-next-token">1. One rule: predict the next token</h2> <p>BERT, in the first lesson, read a sentence with holes and filled them, looking both ways.</p> <p>A GPT reads a text from left to right and, at every position, guesses the next token. That is the whole training task. The probability of a text \(x_1, \dots, x_T\) is written as a chain of such guesses,</p> \[p(x_1, \dots, x_T) = \prod_{t=1}^{T} p(x_t \mid x_1, \dots, x_{t-1}),\] <p>which is not an approximation but the chain rule of probability: any distribution over sequences can be written this way. The model’s job is to supply each factor. Training minimises the average negative log of the probability it gave to the token that actually came next:</p> \[\mathcal{L} = -\frac{1}{T} \sum_{t=1}^{T} \log p_\theta(x_t \mid x_{&lt;t}).\] <p>Here \(\theta\) are the weights, and \(x_{&lt;t}\) is everything before position \(t\). A loss of \(\mathcal{L}\) means the model gave the right token a probability of \(e^{-\mathcal{L}}\), on average in the geometric sense.</p> <p>Two things make this rule cheap to train. The targets are the text itself shifted by one position, so any text is training data and nobody has to label anything.</p> <p>And one pass over a sequence of \(T\) tokens trains all \(T\) predictions at once: the causal mask lets position \(t\) see positions \(1\) to \(t\) and nothing after, so the model can’t peek at the answer it is asked for.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/04/objective-light.png" width="760" alt="Next-token prediction. The input is the text, the targets are the same text shifted one position left. The causal mask is a lower-triangular grid: each position attends to itself and every earlier position, never to later ones, so one forward pass makes a prediction at every position, each from the left context only" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/04/objective-dark.png" width="760" alt="Next-token prediction. The input is the text, the targets are the same text shifted one position left. The causal mask is a lower-triangular grid: each position attends to itself and every earlier position, never to later ones, so one forward pass makes a prediction at every position, each from the left context only" loading="lazy"></p> <p>The rule has a second life after training. To generate, the model predicts a distribution over the next token, one token is picked from it and appended, and the longer text goes back in. Everything a chatbot writes is made this way, one token at a time.</p> <h2 id="2-three-gpts">2. Three GPTs</h2> <p>OpenAI’s first GPT, in June 2018, was a 12-layer Transformer decoder trained on BooksCorpus, “over 7,000 unique unpublished books”, chosen because “it contains long stretches of contiguous text” <sup class="cite">[<a href="#ref-5" id="cite-5" data-ref="5" aria-label="Reference 5: Radford, A., Narasimhan, K., Salimans, T., &amp; Sutskever, I. (2018). Improving language understanding by generative pre-training. OpenAI.">5</a>]</sup>.</p> <p>Pre-training took “1 month on 8 GPUs”; then a copy of the model was <a href="/blog/2025/adapters/">fine-tuned</a> for each task, and it improved the state of the art “in 9 out of the 12 tasks studied”.</p> <p>Four months later BERT beat it on GLUE by reading in both directions, and for two years the encoder looked like the winner.</p> <p>GPT-2, in February 2019, was “a direct scale-up of GPT, with more than 10X the parameters and trained on more than 10X the amount of data”<sup class="cite">[<a href="#ref-6" id="cite-6" data-ref="6" aria-label="Reference 6: OpenAI, 2019. openai.com.">6</a>]</sup>.</p> <p>The data, WebText, was the text of pages linked from Reddit posts with at least 3 karma, which the paper calls “a heuristic indicator for whether other users found the link interesting, educational, or just funny”: 8 million documents, 40 GB.</p> <p>The largest model, 1.5 billion parameters, was not fine-tuned for anything, and still set the state of the art on 7 of 8 language-modelling benchmarks; it even summarised articles when the prompt ended with “TL;DR:” <sup class="cite">[<a href="#ref-7" id="cite-7" data-ref="7" aria-label="Reference 7: Radford, A., Wu, J., Child, R., Luan, D., Amodei, D., &amp; Sutskever, I. (2019). Language models are unsupervised multitask learners. OpenAI.">7</a>]</sup>.</p> <p>OpenAI held it back: “Due to our concerns about malicious applications of the technology, we are not releasing the trained model.”</p> <p>Newspapers turned that into a model “too dangerous to release”, a phrase OpenAI never used, and the weights came out in four stages, from the smallest in February to the full model in November 2019.</p> <p>GPT-3, in May 2020, kept GPT-2’s design, with attention layers that alternate between full and locally banded patterns, and grew it to 175 billion parameters in 96 layers, trained on 300 billion tokens <sup class="cite">[<a href="#ref-8" id="cite-8" data-ref="8" aria-label="Reference 8: Brown, T. B., Mann, B., Ryder, N., Subbiah, M., et al. (2020). Language models are few-shot learners. NeurIPS 2020.">8</a>]</sup>.</p> <p>Its paper named <em>in-context learning</em>: show the model a few examples of a task in the prompt, with no change to its weights, and it does the task.</p> <p>People asked to tell its news articles from real ones were right “∼ 52%” of the time, barely above chance. Its weights were never published. The chat models that followed, from ChatGPT to Llama, Qwen and DeepSeek, are all of this line: a stack of decoder layers predicting the next token.</p> <p>The configs of GPT-1 and of the four GPT-2s are on the Hugging Face Hub, and the safetensors files say how many numbers they hold without downloading them:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">GPT_FAMILY</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">openai-gpt</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">gpt2</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">gpt2-medium</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">gpt2-large</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">gpt2-xl</span><span class="sh">"</span><span class="p">]</span>
<span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">GPT_FAMILY</span><span class="p">:</span>
    <span class="n">repo</span> <span class="o">=</span> <span class="sh">"</span><span class="s">openai-community/</span><span class="sh">"</span> <span class="o">+</span> <span class="n">name</span>
    <span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">repo</span><span class="p">,</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">))</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
        <span class="n">c</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">f</span><span class="p">)</span>
    <span class="n">stored</span> <span class="o">=</span> <span class="nf">sum</span><span class="p">(</span><span class="nf">get_safetensors_metadata</span><span class="p">(</span><span class="n">repo</span><span class="p">).</span><span class="n">parameter_count</span><span class="p">.</span><span class="nf">values</span><span class="p">())</span>
    <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span> <span class="sh">"</span><span class="s">layers</span><span class="sh">"</span><span class="p">:</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">n_layer</span><span class="sh">"</span><span class="p">],</span> <span class="sh">"</span><span class="s">width</span><span class="sh">"</span><span class="p">:</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">n_embd</span><span class="sh">"</span><span class="p">],</span>
                 <span class="sh">"</span><span class="s">heads</span><span class="sh">"</span><span class="p">:</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">n_head</span><span class="sh">"</span><span class="p">],</span> <span class="sh">"</span><span class="s">context</span><span class="sh">"</span><span class="p">:</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">n_positions</span><span class="sh">"</span><span class="p">],</span>
                 <span class="sh">"</span><span class="s">vocabulary</span><span class="sh">"</span><span class="p">:</span> <span class="n">c</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="sh">"</span><span class="s">numbers stored</span><span class="sh">"</span><span class="p">:</span> <span class="n">stored</span><span class="p">})</span>
<span class="n">family</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">family</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">model</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">layers</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">width</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">heads</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">context</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">vocabulary</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">numbers stored</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">openai-gpt</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">12</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">768</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">12</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">512</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">40,478</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">119,680,512</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">gpt2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">12</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">768</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">12</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,024</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">50,257</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">137,022,720</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">gpt2-medium</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">24</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,024</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">16</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,024</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">50,257</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">379,988,992</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">gpt2-large</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">36</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,280</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">20</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,024</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">50,257</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">811,778,816</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">gpt2-xl</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">48</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,600</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">25</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,024</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">50,257</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,607,942,848</td></tr></tbody></table></div> <p>The width \(d\), the number of layers \(L\) and the vocabulary \(V\) fix the size of the model. Each layer holds four matrices of attention (\(Q\), \(K\), \(V\) and the output projection, \(4d^2\) weights) and two of the feed-forward network, \(d \times 4d\) and \(4d \times d\) (\(8d^2\)). With biases and two LayerNorms that is \(12d^2 + 13d\) per layer. The embeddings add \(Vd\) for tokens and \(Cd\) for positions, where \(C\) is the context, and the output layer adds nothing, for a reason we’ll see in a moment. Let’s check the formula against the files:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">gpt_parameters</span><span class="p">(</span><span class="n">layers</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">vocab</span><span class="p">,</span> <span class="n">context</span><span class="p">):</span>
    <span class="n">per_layer</span> <span class="o">=</span> <span class="mi">12</span> <span class="o">*</span> <span class="n">d</span> <span class="o">*</span> <span class="n">d</span> <span class="o">+</span> <span class="mi">13</span> <span class="o">*</span> <span class="n">d</span>
    <span class="n">embeddings</span> <span class="o">=</span> <span class="n">vocab</span> <span class="o">*</span> <span class="n">d</span> <span class="o">+</span> <span class="n">context</span> <span class="o">*</span> <span class="n">d</span>
    <span class="n">final_norm</span> <span class="o">=</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">d</span>  <span class="c1"># GPT-2 has one more LayerNorm at the end
</span>    <span class="k">return</span> <span class="n">layers</span> <span class="o">*</span> <span class="n">per_layer</span> <span class="o">+</span> <span class="n">embeddings</span> <span class="o">+</span> <span class="n">final_norm</span>


<span class="n">family</span><span class="p">[</span><span class="sh">"</span><span class="s">by the formula</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="p">[</span><span class="nf">gpt_parameters</span><span class="p">(</span><span class="n">r</span><span class="p">.</span><span class="n">layers</span><span class="p">,</span> <span class="n">r</span><span class="p">.</span><span class="n">width</span><span class="p">,</span> <span class="n">r</span><span class="p">.</span><span class="n">vocabulary</span><span class="p">,</span> <span class="n">r</span><span class="p">.</span><span class="n">context</span><span class="p">)</span>
                            <span class="k">for</span> <span class="n">r</span> <span class="ow">in</span> <span class="n">family</span><span class="p">.</span><span class="nf">itertuples</span><span class="p">()]</span>
<span class="n">family</span><span class="p">[</span><span class="sh">"</span><span class="s">gap</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">family</span><span class="p">[</span><span class="sh">"</span><span class="s">numbers stored</span><span class="sh">"</span><span class="p">]</span> <span class="o">-</span> <span class="n">family</span><span class="p">[</span><span class="sh">"</span><span class="s">by the formula</span><span class="sh">"</span><span class="p">]</span>
<span class="n">family</span><span class="p">[</span><span class="sh">"</span><span class="s">one mask per layer</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">family</span><span class="p">[</span><span class="sh">"</span><span class="s">layers</span><span class="sh">"</span><span class="p">]</span> <span class="o">*</span> <span class="n">family</span><span class="p">[</span><span class="sh">"</span><span class="s">context</span><span class="sh">"</span><span class="p">]</span> <span class="o">**</span> <span class="mi">2</span>
<span class="nf">table</span><span class="p">(</span><span class="n">family</span><span class="p">[[</span><span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">numbers stored</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">by the formula</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">gap</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">one mask per layer</span><span class="sh">"</span><span class="p">]])</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">model</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">numbers stored</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">by the formula</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">gap</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">one mask per layer</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">openai-gpt</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">119,680,512</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">116,536,320</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3,144,192</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3,145,728</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">gpt2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">137,022,720</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">124,439,808</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">12,582,912</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">12,582,912</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">gpt2-medium</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">379,988,992</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">354,823,168</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">25,165,824</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">25,165,824</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">gpt2-large</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">811,778,816</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">774,030,080</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">37,748,736</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">37,748,736</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">gpt2-xl</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,607,942,848</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,557,611,200</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">50,331,648</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">50,331,648</td></tr></tbody></table></div> <p>The formula is right, up to a gap that has a funny explanation. OpenAI’s checkpoints store the causal mask, a \(C \times C\) triangle of ones and zeros, as a tensor in every layer, so the files hold a million numbers per layer that aren’t weights. GPT-1’s gap is \(2d\) short of its masks: it has no final LayerNorm, which the formula counted.</p> <p>The smallest GPT-2 has 124 million parameters. Its paper says 117M, and the larger ones 345M and 762M; OpenAI later admitted in its repository that “our original parameter counts were wrong” (<a href="https://github.com/openai/gpt-2">openai/gpt-2</a>). 117M is the size of GPT-1, which the smallest GPT-2 was meant to match: the extra seven million are the bigger vocabulary and the longer context.</p> <p>Where those parameters live depends on the size. In the smallest GPT-2 the token embeddings are almost a third of the model; in GPT-2 XL they are a few percent, and the layers are everything:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.4</span><span class="p">,</span> <span class="mf">2.6</span><span class="p">))</span>
<span class="n">names</span> <span class="o">=</span> <span class="n">family</span><span class="p">[</span><span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">][</span><span class="mi">1</span><span class="p">:]</span>
<span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">r</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">family</span><span class="p">[</span><span class="mi">1</span><span class="p">:].</span><span class="nf">itertuples</span><span class="p">()):</span>
    <span class="n">embed</span> <span class="o">=</span> <span class="p">(</span><span class="n">r</span><span class="p">.</span><span class="n">vocabulary</span> <span class="o">+</span> <span class="n">r</span><span class="p">.</span><span class="n">context</span><span class="p">)</span> <span class="o">*</span> <span class="n">r</span><span class="p">.</span><span class="n">width</span> <span class="o">/</span> <span class="mf">1e6</span>
    <span class="n">layers_part</span> <span class="o">=</span> <span class="n">r</span><span class="p">.</span><span class="n">layers</span> <span class="o">*</span> <span class="p">(</span><span class="mi">12</span> <span class="o">*</span> <span class="n">r</span><span class="p">.</span><span class="n">width</span> <span class="o">**</span> <span class="mi">2</span> <span class="o">+</span> <span class="mi">13</span> <span class="o">*</span> <span class="n">r</span><span class="p">.</span><span class="n">width</span><span class="p">)</span> <span class="o">/</span> <span class="mf">1e6</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">barh</span><span class="p">(</span><span class="n">k</span><span class="p">,</span> <span class="n">embed</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">data</span><span class="sh">"</span><span class="p">],</span> <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">embeddings</span><span class="sh">"</span> <span class="k">if</span> <span class="n">k</span> <span class="o">==</span> <span class="mi">0</span> <span class="k">else</span> <span class="bp">None</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">barh</span><span class="p">(</span><span class="n">k</span><span class="p">,</span> <span class="n">layers_part</span><span class="p">,</span> <span class="n">left</span><span class="o">=</span><span class="n">embed</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">],</span>
            <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">layers</span><span class="sh">"</span> <span class="k">if</span> <span class="n">k</span> <span class="o">==</span> <span class="mi">0</span> <span class="k">else</span> <span class="bp">None</span><span class="p">)</span>
    <span class="n">share</span> <span class="o">=</span> <span class="n">embed</span> <span class="o">/</span> <span class="p">(</span><span class="n">embed</span> <span class="o">+</span> <span class="n">layers_part</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">text</span><span class="p">(</span><span class="n">embed</span> <span class="o">+</span> <span class="n">layers_part</span> <span class="o">+</span> <span class="mi">20</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="s">embeddings </span><span class="si">{</span><span class="n">share</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span> <span class="n">va</span><span class="o">=</span><span class="sh">"</span><span class="s">center</span><span class="sh">"</span><span class="p">,</span>
            <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_yticks</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">names</span><span class="p">)),</span> <span class="n">names</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">invert_yaxis</span><span class="p">()</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">millions of parameters</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlim</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">2100</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">loc</span><span class="o">=</span><span class="sh">"</span><span class="s">upper right</span><span class="sh">"</span><span class="p">,</span> <span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/04/output-01.png" alt="Output of the code above" loading="lazy"></p> <h2 id="3-gpt-2-in-pytorch">3. GPT-2 in PyTorch</h2> <p>A GPT-2 layer has the same two parts as every Transformer layer: <a href="/blog/2026/transformers-from-scratch-02-transformer/">self-attention</a>, then a feed-forward network, each wrapped in a residual connection. Two things changed since BERT.</p> <p>The mask is causal. And the LayerNorm moved: BERT normalised after adding the residual, GPT-2 normalises the input of each part and leaves the residual path alone. The GPT-2 paper describes it in one sentence, and adds a final LayerNorm after the last layer.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/04/prenorm-light.png" width="760" alt="Post-norm against pre-norm. In BERT's post-norm layer the LayerNorm sits on the main path, after each addition, so every layer's output is renormalised. In GPT-2's pre-norm layer the LayerNorm sits on the branch, before attention and before the feed-forward network; the main path, the residual stream, runs from the embeddings to the final LayerNorm with nothing on it but additions" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/04/prenorm-dark.png" width="760" alt="Post-norm against pre-norm. In BERT's post-norm layer the LayerNorm sits on the main path, after each addition, so every layer's output is renormalised. In GPT-2's pre-norm layer the LayerNorm sits on the branch, before attention and before the feed-forward network; the main path, the residual stream, runs from the embeddings to the final LayerNorm with nothing on it but additions" loading="lazy"></p> <p>The difference matters for training deep models. In a post-norm stack, the gradient that reaches the first layer has passed through a LayerNorm in every layer above it.</p> <p>In a pre-norm stack there is a clean path of additions from the loss to the embeddings, the <em>residual stream</em>, and each layer only adds to it. Deep pre-norm models train without the careful learning-rate warm-up that post-norm ones need <sup class="cite">[<a href="#ref-9" id="cite-9" data-ref="9" aria-label="Reference 9: Xiong, R., Yang, Y., He, D., Zheng, K., Zheng, S., Xing, C., Zhang, H., Lan, Y., Wang, L., &amp; Liu, T.-Y. (2020). On layer normalization in the Transformer architecture. ICML 2020.">9</a>]</sup>, and every large decoder since GPT-2 is pre-norm.</p> <div class="callout callout-key"> <p class="callout-label">Key point</p> <p>In a pre-norm model every layer reads the residual stream and adds its result back to it. The stream is a running draft of everything the model has worked out so far, which is why section 6 and the probes of section 11 can read it after any layer.</p> </div> <p>Attention is the one from the first course, with the causal mask. We write it out once by hand, and then use PyTorch’s <code class="language-plaintext highlighter-rouge">scaled_dot_product_attention</code>, which computes the same thing in one fused kernel, without ever storing the \(T \times T\) matrix of weights. The check:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">attention_by_hand</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">):</span>
    <span class="n">length</span> <span class="o">=</span> <span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">2</span><span class="p">]</span>
    <span class="n">scores</span> <span class="o">=</span> <span class="n">q</span> <span class="o">@</span> <span class="n">k</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">2</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">])</span>
    <span class="n">causal</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">length</span><span class="p">,</span> <span class="n">length</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">q</span><span class="p">.</span><span class="n">device</span><span class="p">).</span><span class="nf">tril</span><span class="p">()</span>
    <span class="n">scores</span> <span class="o">=</span> <span class="n">scores</span><span class="p">.</span><span class="nf">masked_fill</span><span class="p">(</span><span class="o">~</span><span class="n">causal</span><span class="p">,</span> <span class="nf">float</span><span class="p">(</span><span class="sh">"</span><span class="s">-inf</span><span class="sh">"</span><span class="p">))</span>
    <span class="k">return</span> <span class="n">scores</span><span class="p">.</span><span class="nf">softmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span> <span class="o">@</span> <span class="n">v</span>


<span class="c1"># batch 1, 2 heads, 5 positions, 4 dimensions
</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randn</span><span class="p">(</span><span class="mi">3</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">5</span><span class="p">,</span> <span class="mi">4</span><span class="p">).</span><span class="nf">unbind</span><span class="p">(</span><span class="mi">0</span><span class="p">)</span>
<span class="n">fused</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">scaled_dot_product_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">,</span> <span class="n">is_causal</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">largest difference:</span><span class="sh">"</span><span class="p">,</span> <span class="p">(</span><span class="nf">attention_by_hand</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">)</span> <span class="o">-</span> <span class="n">fused</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">())</span>
</code></pre></div></div> <pre class="tfs-printed"><code>largest difference: 5.960464477539063e-08</code></pre> <p>The attention layer keeps an optional <code class="language-plaintext highlighter-rouge">cache</code>, a dictionary where it stores the keys and values it has computed. It does nothing until section 5, where it makes generation fast.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">Attention</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">n_embd</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">n_head</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">qkv</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="mi">3</span> <span class="o">*</span> <span class="n">d</span><span class="p">)</span>  <span class="c1"># queries, keys and values in one matrix
</span>        <span class="n">self</span><span class="p">.</span><span class="n">out</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">batch</span><span class="p">,</span> <span class="n">length</span><span class="p">,</span> <span class="n">d</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span>
        <span class="k">return</span> <span class="n">x</span><span class="p">.</span><span class="nf">view</span><span class="p">(</span><span class="n">batch</span><span class="p">,</span> <span class="n">length</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">d</span> <span class="o">//</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">cache</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
        <span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">qkv</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">split</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">],</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">q</span><span class="p">),</span> <span class="n">self</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">k</span><span class="p">),</span> <span class="n">self</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">v</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">cache</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span> <span class="ow">and</span> <span class="sh">"</span><span class="s">k</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">cache</span><span class="p">:</span>  <span class="c1"># the keys and values of earlier tokens
</span>            <span class="n">k</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">cache</span><span class="p">[</span><span class="sh">"</span><span class="s">k</span><span class="sh">"</span><span class="p">],</span> <span class="n">k</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
            <span class="n">v</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">cache</span><span class="p">[</span><span class="sh">"</span><span class="s">v</span><span class="sh">"</span><span class="p">],</span> <span class="n">v</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">cache</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
            <span class="n">cache</span><span class="p">[</span><span class="sh">"</span><span class="s">k</span><span class="sh">"</span><span class="p">],</span> <span class="n">cache</span><span class="p">[</span><span class="sh">"</span><span class="s">v</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span>
        <span class="c1"># one new token may look at everything; several new tokens need the causal mask
</span>        <span class="n">y</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">scaled_dot_product_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">,</span> <span class="n">is_causal</span><span class="o">=</span><span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">2</span><span class="p">]</span> <span class="o">&gt;</span> <span class="mi">1</span><span class="p">)</span>
        <span class="n">y</span> <span class="o">=</span> <span class="n">y</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">out</span><span class="p">(</span><span class="n">y</span><span class="p">)</span>
</code></pre></div></div> <p>The feed-forward network uses GELU, as BERT did, but in the approximation OpenAI’s code used, with a tanh:</p> \[\text{GELU}(x) \approx \tfrac{1}{2}\,x\left(1 + \tanh\!\left(\sqrt{2/\pi}\,\left(x + 0.044715\,x^3\right)\right)\right).\] <p>The exact GELU, \(x\,\Phi(x)\), needs the error function, which was slow on the hardware of 2018; the tanh version differs from it by less than 0.001 everywhere. A transplant has to use the same one the weights were trained with, or the outputs drift. PyTorch has both, and the config says which one a model wants:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">x</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">linspace</span><span class="p">(</span><span class="o">-</span><span class="mi">6</span><span class="p">,</span> <span class="mi">6</span><span class="p">,</span> <span class="mi">10001</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">largest gap, tanh GELU against exact:</span><span class="sh">"</span><span class="p">,</span>
      <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="n">F</span><span class="p">.</span><span class="nf">gelu</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">approximate</span><span class="o">=</span><span class="sh">'</span><span class="s">tanh</span><span class="sh">'</span><span class="p">)</span> <span class="o">-</span> <span class="n">F</span><span class="p">.</span><span class="nf">gelu</span><span class="p">(</span><span class="n">x</span><span class="p">)).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>


<span class="k">class</span> <span class="nc">Block</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span><span class="p">,</span> <span class="n">eps</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">n_embd</span><span class="sh">"</span><span class="p">],</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">layer_norm_epsilon</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm1</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">eps</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">attention</span> <span class="o">=</span> <span class="nc">Attention</span><span class="p">(</span><span class="n">config</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm2</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">eps</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">up</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="mi">4</span> <span class="o">*</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">down</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="mi">4</span> <span class="o">*</span> <span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">)</span>
        <span class="c1"># OpenAI's "gelu_new" is the tanh approximation
</span>        <span class="n">self</span><span class="p">.</span><span class="n">approximate</span> <span class="o">=</span> <span class="sh">"</span><span class="s">tanh</span><span class="sh">"</span> <span class="k">if</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">activation_function</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="sh">"</span><span class="s">gelu_new</span><span class="sh">"</span> <span class="k">else</span> <span class="sh">"</span><span class="s">none</span><span class="sh">"</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">cache</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">attention</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">norm1</span><span class="p">(</span><span class="n">x</span><span class="p">),</span> <span class="n">cache</span><span class="p">)</span>
        <span class="n">hidden</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">gelu</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">up</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">norm2</span><span class="p">(</span><span class="n">x</span><span class="p">)),</span> <span class="n">approximate</span><span class="o">=</span><span class="n">self</span><span class="p">.</span><span class="n">approximate</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">down</span><span class="p">(</span><span class="n">hidden</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>largest gap, tanh GELU against exact: 4.7e-04</code></pre> <p>The model around the layers: token embeddings plus learned position embeddings, one vector per position up to the context length, as in BERT; the layers; the final LayerNorm. Then the output layer, which is not a layer at all.</p> <p>GPT-2 scores every token of the vocabulary by a dot product of the last hidden state with that token’s <em>input</em> embedding: the same matrix reads tokens in and writes them out.</p> <p>This <em>weight tying</em> saves \(V \times d\) parameters, 38.6 million in the smallest GPT-2, and works because a good representation of “the next token is <em>Paris</em>” should look like the embedding of <em>Paris</em> <sup class="cite">[<a href="#ref-10" id="cite-10" data-ref="10" aria-label="Reference 10: Press, O., &amp; Wolf, L. (2017). Using the output embedding to improve language models. EACL 2017.">10</a>]</sup>.</p> <p><code class="language-plaintext highlighter-rouge">forward</code> can also hand back the residual stream after every layer, <code class="language-plaintext highlighter-rouge">keep_states=True</code>; sections 6 and 11 read it.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">GPT</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">n_embd</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">tokens</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">positions</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">n_positions</span><span class="sh">"</span><span class="p">],</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">blocks</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">ModuleList</span><span class="p">(</span><span class="nc">Block</span><span class="p">(</span><span class="n">config</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">n_layer</span><span class="sh">"</span><span class="p">]))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">layer_norm_epsilon</span><span class="sh">"</span><span class="p">])</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">caches</span><span class="o">=</span><span class="bp">None</span><span class="p">,</span> <span class="n">keep_states</span><span class="o">=</span><span class="bp">False</span><span class="p">):</span>
        <span class="n">past</span> <span class="o">=</span> <span class="mi">0</span>
        <span class="k">if</span> <span class="n">caches</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span> <span class="ow">and</span> <span class="sh">"</span><span class="s">k</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">caches</span><span class="p">[</span><span class="mi">0</span><span class="p">]:</span>
            <span class="n">past</span> <span class="o">=</span> <span class="n">caches</span><span class="p">[</span><span class="mi">0</span><span class="p">][</span><span class="sh">"</span><span class="s">k</span><span class="sh">"</span><span class="p">].</span><span class="n">shape</span><span class="p">[</span><span class="mi">2</span><span class="p">]</span>  <span class="c1"># tokens already in the cache
</span>        <span class="n">positions</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">past</span><span class="p">,</span> <span class="n">past</span> <span class="o">+</span> <span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="n">device</span><span class="o">=</span><span class="n">ids</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">tokens</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">positions</span><span class="p">(</span><span class="n">positions</span><span class="p">)</span>
        <span class="n">states</span> <span class="o">=</span> <span class="p">[</span><span class="n">x</span><span class="p">]</span>
        <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">block</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">blocks</span><span class="p">):</span>
            <span class="n">x</span> <span class="o">=</span> <span class="nf">block</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">caches</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="k">if</span> <span class="n">caches</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span> <span class="k">else</span> <span class="bp">None</span><span class="p">)</span>
            <span class="n">states</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>
        <span class="n">logits</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">unembed</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>
        <span class="nf">return </span><span class="p">(</span><span class="n">logits</span><span class="p">,</span> <span class="n">states</span><span class="p">)</span> <span class="k">if</span> <span class="n">keep_states</span> <span class="k">else</span> <span class="n">logits</span>

    <span class="k">def</span> <span class="nf">unembed</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm</span><span class="p">(</span><span class="n">x</span><span class="p">)</span> <span class="o">@</span> <span class="n">self</span><span class="p">.</span><span class="n">tokens</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">T</span>  <span class="c1"># tied: the input table, read backwards
</span></code></pre></div></div> <h2 id="4-openais-weights-in-our-code">4. OpenAI’s weights in our code</h2> <p>OpenAI’s checkpoint names its tensors differently, so we write down which goes where. One more difference hides in the shapes.</p> <p>OpenAI’s code stored its linear layers as <code class="language-plaintext highlighter-rouge">Conv1D</code>, a name left over from the GPT-1 code, which keeps the weight as (inputs, outputs), the transpose of <code class="language-plaintext highlighter-rouge">nn.Linear</code>’s (outputs, inputs). So four of the matrices of every layer go in transposed, and <code class="language-plaintext highlighter-rouge">load_state_dict</code> refuses anything missing or left over:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">GPT2</span> <span class="o">=</span> <span class="sh">"</span><span class="s">openai-community/gpt2</span><span class="sh">"</span>
<span class="n">tokenizer</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">GPT2</span><span class="p">)</span>
<span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">GPT2</span><span class="p">,</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">))</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
    <span class="n">config</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">f</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">openai_names</span><span class="p">(</span><span class="n">config</span><span class="p">):</span>
    <span class="n">names</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">tokens.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">wte.weight</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">positions.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">wpe.weight</span><span class="sh">"</span><span class="p">,</span>
             <span class="sh">"</span><span class="s">norm.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">ln_f.weight</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">norm.bias</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">ln_f.bias</span><span class="sh">"</span><span class="p">}</span>
    <span class="n">parts</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">norm1</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">ln_1</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">attention.qkv</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attn.c_attn</span><span class="sh">"</span><span class="p">,</span>
             <span class="sh">"</span><span class="s">attention.out</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attn.c_proj</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">norm2</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">ln_2</span><span class="sh">"</span><span class="p">,</span>
             <span class="sh">"</span><span class="s">up</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">mlp.c_fc</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">down</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">mlp.c_proj</span><span class="sh">"</span><span class="p">}</span>
    <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">n_layer</span><span class="sh">"</span><span class="p">]):</span>
        <span class="k">for</span> <span class="n">ours</span><span class="p">,</span> <span class="n">theirs</span> <span class="ow">in</span> <span class="n">parts</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
            <span class="k">for</span> <span class="n">kind</span> <span class="ow">in</span> <span class="p">(</span><span class="sh">"</span><span class="s">weight</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">bias</span><span class="sh">"</span><span class="p">):</span>
                <span class="n">names</span><span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="s">blocks.</span><span class="si">{</span><span class="n">i</span><span class="si">}</span><span class="s">.</span><span class="si">{</span><span class="n">ours</span><span class="si">}</span><span class="s">.</span><span class="si">{</span><span class="n">kind</span><span class="si">}</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">h.</span><span class="si">{</span><span class="n">i</span><span class="si">}</span><span class="s">.</span><span class="si">{</span><span class="n">theirs</span><span class="si">}</span><span class="s">.</span><span class="si">{</span><span class="n">kind</span><span class="si">}</span><span class="sh">"</span>
    <span class="k">return</span> <span class="n">names</span>


<span class="n">CONV1D</span> <span class="o">=</span> <span class="p">(</span><span class="sh">"</span><span class="s">qkv.weight</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">out.weight</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">up.weight</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">down.weight</span><span class="sh">"</span><span class="p">)</span>
<span class="n">weights</span> <span class="o">=</span> <span class="nf">load_file</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">GPT2</span><span class="p">,</span> <span class="sh">"</span><span class="s">model.safetensors</span><span class="sh">"</span><span class="p">))</span>
<span class="n">state</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">ours</span><span class="p">,</span> <span class="n">theirs</span> <span class="ow">in</span> <span class="nf">openai_names</span><span class="p">(</span><span class="n">config</span><span class="p">).</span><span class="nf">items</span><span class="p">():</span>
    <span class="n">tensor</span> <span class="o">=</span> <span class="n">weights</span><span class="p">[</span><span class="n">theirs</span><span class="p">]</span>
    <span class="k">if</span> <span class="n">ours</span><span class="p">.</span><span class="nf">endswith</span><span class="p">(</span><span class="n">CONV1D</span><span class="p">):</span>
        <span class="n">tensor</span> <span class="o">=</span> <span class="n">tensor</span><span class="p">.</span><span class="n">T</span>
    <span class="n">state</span><span class="p">[</span><span class="n">ours</span><span class="p">]</span> <span class="o">=</span> <span class="n">tensor</span>
<span class="n">gpt2</span> <span class="o">=</span> <span class="nc">GPT</span><span class="p">(</span><span class="n">config</span><span class="p">)</span>
<span class="n">gpt2</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">(</span><span class="n">state</span><span class="p">,</span> <span class="n">strict</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">gpt2</span> <span class="o">=</span> <span class="n">gpt2</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="n">left_over</span> <span class="o">=</span> <span class="nf">sorted</span><span class="p">(</span><span class="nf">set</span><span class="p">(</span><span class="n">weights</span><span class="p">)</span> <span class="o">-</span> <span class="nf">set</span><span class="p">(</span><span class="nf">openai_names</span><span class="p">(</span><span class="n">config</span><span class="p">).</span><span class="nf">values</span><span class="p">()))</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">loaded </span><span class="si">{</span><span class="nf">sum</span><span class="p">(</span><span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span> <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">gpt2</span><span class="p">.</span><span class="nf">parameters</span><span class="p">())</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> parameters</span><span class="sh">"</span><span class="p">)</span>
<span class="n">example</span> <span class="o">=</span> <span class="n">left_over</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">not loaded: </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">left_over</span><span class="p">)</span><span class="si">}</span><span class="s"> tensors, e.g. </span><span class="si">{</span><span class="n">example</span><span class="si">}</span><span class="s">, </span><span class="sh">"</span>
      <span class="sa">f</span><span class="sh">"</span><span class="s">of shape </span><span class="si">{</span><span class="nf">tuple</span><span class="p">(</span><span class="n">weights</span><span class="p">[</span><span class="n">example</span><span class="p">].</span><span class="n">shape</span><span class="p">)</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>loaded 124,439,808 parameters
not loaded: 12 tensors, e.g. h.0.attn.bias, of shape (1, 1, 1024, 1024)</code></pre> <p>The tensors left over are the stored causal masks from section 2. Now the check against Hugging Face’s <code class="language-plaintext highlighter-rouge">GPT2LMHeadModel</code>, the reference implementation: the same text through both, and the scores of all 50,257 tokens at every position compared.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">reference</span> <span class="o">=</span> <span class="n">GPT2LMHeadModel</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">GPT2</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="n">CHECK</span> <span class="o">=</span> <span class="p">(</span><span class="sh">"</span><span class="s">In 1997 Deep Blue beat Garry Kasparov, the world chess champion, </span><span class="sh">"</span>
         <span class="sh">"</span><span class="s">in a six-game match.</span><span class="sh">"</span><span class="p">)</span>
<span class="n">check</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="n">CHECK</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">theirs</span> <span class="o">=</span> <span class="nf">reference</span><span class="p">(</span><span class="o">**</span><span class="n">check</span><span class="p">).</span><span class="n">logits</span>
    <span class="n">ours</span> <span class="o">=</span> <span class="nf">gpt2</span><span class="p">(</span><span class="n">check</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">])</span>
<span class="n">gap</span> <span class="o">=</span> <span class="p">(</span><span class="n">ours</span> <span class="o">-</span> <span class="n">theirs</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">largest difference in the scores: </span><span class="si">{</span><span class="n">gap</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">the scores themselves reach </span><span class="si">{</span><span class="n">theirs</span><span class="p">.</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="k">assert</span> <span class="n">gap</span> <span class="o">&lt;</span> <span class="mf">1e-2</span>
<span class="k">del</span> <span class="n">reference</span>
</code></pre></div></div> <pre class="tfs-printed"><code>largest difference in the scores: 6.1e-05
the scores themselves reach 181</code></pre> <p>Rounding, again: the two implementations add the same numbers in a different order. Our hundred lines are GPT-2.</p> <p>Teacher forcing makes it easy to see what the model thinks of a text: one pass gives the probability it assigned to every token that actually came next. A sentence from a 2016 news story, which GPT-2 may well have read:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">next_token_probabilities</span><span class="p">(</span><span class="n">text</span><span class="p">):</span>
    <span class="n">ids</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="n">text</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">)[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">].</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="n">logits</span> <span class="o">=</span> <span class="nf">gpt2</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span>
    <span class="n">probs</span> <span class="o">=</span> <span class="n">logits</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="p">:</span><span class="o">-</span><span class="mi">1</span><span class="p">].</span><span class="nf">float</span><span class="p">().</span><span class="nf">softmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">targets</span> <span class="o">=</span> <span class="n">ids</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">:]</span>
    <span class="n">chosen</span> <span class="o">=</span> <span class="n">probs</span><span class="p">[</span><span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">targets</span><span class="p">)),</span> <span class="n">targets</span><span class="p">]</span>
    <span class="k">return</span> <span class="n">tokenizer</span><span class="p">.</span><span class="nf">convert_ids_to_tokens</span><span class="p">(</span><span class="n">ids</span><span class="p">[</span><span class="mi">0</span><span class="p">]),</span> <span class="n">chosen</span><span class="p">.</span><span class="nf">cpu</span><span class="p">()</span>


<span class="n">TEXT</span> <span class="o">=</span> <span class="p">(</span><span class="sh">"</span><span class="s">AlphaGo, a program developed by Google DeepMind, beat Lee Sedol </span><span class="sh">"</span>
        <span class="sh">"</span><span class="s">four games to one in Seoul.</span><span class="sh">"</span><span class="p">)</span>
<span class="n">tokens</span><span class="p">,</span> <span class="n">chosen</span> <span class="o">=</span> <span class="nf">next_token_probabilities</span><span class="p">(</span><span class="n">TEXT</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">loss </span><span class="si">{</span><span class="o">-</span><span class="n">chosen</span><span class="p">.</span><span class="nf">log</span><span class="p">().</span><span class="nf">mean</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">the probability of each token, given the ones before it:</span><span class="sh">"</span><span class="p">)</span>
<span class="n">labels</span> <span class="o">=</span> <span class="p">[</span><span class="n">token</span><span class="p">.</span><span class="nf">replace</span><span class="p">(</span><span class="sh">"</span><span class="s">Ġ</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">␣</span><span class="sh">"</span><span class="p">)</span> <span class="k">for</span> <span class="n">token</span> <span class="ow">in</span> <span class="n">tokens</span><span class="p">[</span><span class="mi">1</span><span class="p">:]]</span>
<span class="nf">heatmap</span><span class="p">(</span><span class="n">chosen</span><span class="p">[</span><span class="bp">None</span><span class="p">].</span><span class="nf">numpy</span><span class="p">(),</span> <span class="n">cols</span><span class="o">=</span><span class="n">labels</span><span class="p">,</span> <span class="n">role</span><span class="o">=</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">,</span> <span class="n">vmin</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span> <span class="n">vmax</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">annotate</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
        <span class="n">cell</span><span class="o">=</span><span class="mf">0.42</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <pre class="tfs-printed"><code>loss 3.88
the probability of each token, given the ones before it:</code></pre> <p><img class="tfs-output" src="/assets/posts/arch/04/output-02.png" alt="Output of the code above" loading="lazy"></p> <p>A loss of 3.88 is an average of very different guesses. Where the left context gives the next token away, GPT-2 is close to certain: <em>Mind</em> after <em>Deep</em>, the <em>ol</em> of <em>Sedol</em> once <em>Sed</em> is there, <em>to</em> after <em>four games</em>.</p> <p>Where the sentence carries news, it is lost: <em>Lee</em>, <em>Sed</em> and <em>Seoul</em> get next to nothing, although its training text runs to the end of 2017, well after the match. Those tokens are the information in the sentence, and the loss is highest exactly there. A language model is, among other things, a meter of surprise.</p> <h2 id="5-generating-text-and-the-kv-cache">5. Generating text, and the KV cache</h2> <p>Generation is a loop:</p> <p class="flow"><span>scores at the last position</span><span>pick a token</span><span>append it</span><span>run again</span></p> <p>The simplest pick is the most probable token, <em>greedy decoding</em>. Here is GPT-2 continuing the most famous opening move order in chess, the Ruy Lopez, written the way chess books and websites write it:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">generate</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">steps</span><span class="p">,</span> <span class="n">use_cache</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">temperature</span><span class="o">=</span><span class="mf">0.0</span><span class="p">,</span> <span class="n">generator</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
    <span class="n">caches</span> <span class="o">=</span> <span class="p">[{}</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="n">blocks</span><span class="p">]</span> <span class="k">if</span> <span class="n">use_cache</span> <span class="k">else</span> <span class="bp">None</span>
    <span class="n">new</span> <span class="o">=</span> <span class="n">ids</span>
    <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">steps</span><span class="p">):</span>
        <span class="n">logits</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">new</span> <span class="k">if</span> <span class="n">use_cache</span> <span class="k">else</span> <span class="n">ids</span><span class="p">,</span> <span class="n">caches</span><span class="p">)[:,</span> <span class="o">-</span><span class="mi">1</span><span class="p">].</span><span class="nf">float</span><span class="p">()</span>
        <span class="k">if</span> <span class="n">temperature</span> <span class="o">==</span> <span class="mi">0</span><span class="p">:</span>
            <span class="n">token</span> <span class="o">=</span> <span class="n">logits</span><span class="p">.</span><span class="nf">argmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="n">probs</span> <span class="o">=</span> <span class="p">(</span><span class="n">logits</span> <span class="o">/</span> <span class="n">temperature</span><span class="p">).</span><span class="nf">softmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
            <span class="n">token</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">multinomial</span><span class="p">(</span><span class="n">probs</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">generator</span><span class="o">=</span><span class="n">generator</span><span class="p">)</span>
        <span class="n">ids</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">ids</span><span class="p">,</span> <span class="n">token</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">new</span> <span class="o">=</span> <span class="n">token</span>  <span class="c1"># with a cache, only the new token goes in
</span>    <span class="k">return</span> <span class="n">ids</span>


<span class="n">RUY_LOPEZ</span> <span class="o">=</span> <span class="sh">"</span><span class="s">1. e4 e5 2. Nf3 Nc6 3. Bb5</span><span class="sh">"</span>
<span class="n">prompt</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="n">RUY_LOPEZ</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">)[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">].</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="n">tokenizer</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="nf">generate</span><span class="p">(</span><span class="n">gpt2</span><span class="p">,</span> <span class="n">prompt</span><span class="p">,</span> <span class="mi">40</span><span class="p">)[</span><span class="mi">0</span><span class="p">]))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>1. e4 e5 2. Nf3 Nc6 3. Bb5 Nc6 4. Nf3 Nc6 5. Bd3 Nc6 6. Bd2 Nc6 7. Bd3 Nc6 8. Bd2</code></pre> <p>GPT-2 knows what a game record looks like, a number, a dot, a letter and a square, and nothing about the game.</p> <p>Its first move, 3…Nc6, sends a knight to the square where Black’s knight already stands; White answers 4.Nf3, the same mistake, and from then on the two sides shuffle pieces that aren’t there. Greedy decoding makes the loop worse: once a pattern has repeated, repeating it again is the likeliest continuation.</p> <p>Look at what the loop recomputes. At step \(t\) the model runs over all \(t\) tokens, although the keys and values of the first \(t-1\) were computed at the previous step and haven’t changed: causal attention never lets an earlier position see a later one, so nothing about them can change.</p> <p>The <em>KV cache</em> keeps every layer’s keys and values, and each step feeds only the new token, whose query attends to the cached keys.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/04/kvcache-light.png" width="760" alt="Generation without and with a KV cache. Without it, every step runs the whole sequence through the model again, so step t costs work proportional to t and the steps get slower. With it, every layer stores the keys and values of the tokens seen so far; each step runs only the new token, computes its query, key and value, appends the key and value to the cache and attends over it" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/04/kvcache-dark.png" width="760" alt="Generation without and with a KV cache. Without it, every step runs the whole sequence through the model again, so step t costs work proportional to t and the steps get slower. With it, every layer stores the keys and values of the tokens seen so far; each step runs only the new token, computes its query, key and value, appends the key and value to the cache and attends over it" loading="lazy"></p> <p>The cache must not change the result. Greedy decoding with and without it, the same prompt:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">with_cache</span> <span class="o">=</span> <span class="nf">generate</span><span class="p">(</span><span class="n">gpt2</span><span class="p">,</span> <span class="n">prompt</span><span class="p">,</span> <span class="mi">40</span><span class="p">,</span> <span class="n">use_cache</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">without_cache</span> <span class="o">=</span> <span class="nf">generate</span><span class="p">(</span><span class="n">gpt2</span><span class="p">,</span> <span class="n">prompt</span><span class="p">,</span> <span class="mi">40</span><span class="p">,</span> <span class="n">use_cache</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">same tokens with and without the cache:</span><span class="sh">"</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="nf">equal</span><span class="p">(</span><span class="n">with_cache</span><span class="p">,</span> <span class="n">without_cache</span><span class="p">))</span>
<span class="k">assert</span> <span class="n">torch</span><span class="p">.</span><span class="nf">equal</span><span class="p">(</span><span class="n">with_cache</span><span class="p">,</span> <span class="n">without_cache</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>same tokens with and without the cache: True</code></pre> <p>Now the time each new token takes, with and without the cache, as the text grows:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">time_per_token</span><span class="p">(</span><span class="n">use_cache</span><span class="p">,</span> <span class="n">steps</span><span class="p">):</span>
    <span class="n">caches</span> <span class="o">=</span> <span class="p">[{}</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">gpt2</span><span class="p">.</span><span class="n">blocks</span><span class="p">]</span> <span class="k">if</span> <span class="n">use_cache</span> <span class="k">else</span> <span class="bp">None</span>
    <span class="n">ids</span> <span class="o">=</span> <span class="n">prompt</span>
    <span class="n">new</span> <span class="o">=</span> <span class="n">prompt</span>
    <span class="n">times</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">steps</span><span class="p">):</span>
        <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
            <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">synchronize</span><span class="p">()</span>
        <span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">perf_counter</span><span class="p">()</span>
        <span class="n">logits</span> <span class="o">=</span> <span class="nf">gpt2</span><span class="p">(</span><span class="n">new</span> <span class="k">if</span> <span class="n">use_cache</span> <span class="k">else</span> <span class="n">ids</span><span class="p">,</span> <span class="n">caches</span><span class="p">)[:,</span> <span class="o">-</span><span class="mi">1</span><span class="p">]</span>
        <span class="n">token</span> <span class="o">=</span> <span class="n">logits</span><span class="p">.</span><span class="nf">argmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
            <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">synchronize</span><span class="p">()</span>
        <span class="n">times</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">time</span><span class="p">.</span><span class="nf">perf_counter</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="p">)</span>
        <span class="n">ids</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">ids</span><span class="p">,</span> <span class="n">token</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">new</span> <span class="o">=</span> <span class="n">token</span>
    <span class="k">return</span> <span class="n">np</span><span class="p">.</span><span class="nf">array</span><span class="p">(</span><span class="n">times</span><span class="p">)</span> <span class="o">*</span> <span class="mi">1000</span>


<span class="n">STEPS</span> <span class="o">=</span> <span class="mi">60</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">900</span>
<span class="nf">time_per_token</span><span class="p">(</span><span class="bp">True</span><span class="p">,</span> <span class="mi">5</span><span class="p">)</span>  <span class="c1"># warm up the GPU
</span><span class="n">slow</span> <span class="o">=</span> <span class="nf">time_per_token</span><span class="p">(</span><span class="bp">False</span><span class="p">,</span> <span class="n">STEPS</span><span class="p">)</span>
<span class="n">fast</span> <span class="o">=</span> <span class="nf">time_per_token</span><span class="p">(</span><span class="bp">True</span><span class="p">,</span> <span class="n">STEPS</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">STEPS</span><span class="si">}</span><span class="s"> tokens: </span><span class="si">{</span><span class="n">slow</span><span class="p">.</span><span class="nf">sum</span><span class="p">()</span> <span class="o">/</span> <span class="mi">1000</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s"> s without the cache, </span><span class="sh">"</span>
      <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">fast</span><span class="p">.</span><span class="nf">sum</span><span class="p">()</span> <span class="o">/</span> <span class="mi">1000</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s"> s with it</span><span class="sh">"</span><span class="p">)</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.4</span><span class="p">,</span> <span class="mf">3.0</span><span class="p">))</span>
<span class="n">length</span> <span class="o">=</span> <span class="n">prompt</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span> <span class="o">+</span> <span class="n">np</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">STEPS</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">length</span><span class="p">,</span> <span class="n">slow</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">],</span> <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">no cache: the whole text every step</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">length</span><span class="p">,</span> <span class="n">fast</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">],</span> <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">KV cache: one token every step</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">tokens in the text</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">ms for the next token</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylim</span><span class="p">(</span><span class="n">bottom</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <pre class="tfs-printed"><code>900 tokens: 36.1 s without the cache, 4.9 s with it</code></pre> <p><img class="tfs-output" src="/assets/posts/arch/04/output-03.png" alt="Output of the code above" loading="lazy"></p> <p>Without the cache, each step reruns the whole text, so the time per token grows with the length and the total grows with its square; the staircase is the GPU working in blocks of fixed size, so the cost jumps every so many tokens.</p> <p>With the cache, token 900 costs what token 20 did. For 900 tokens that is 36.1 seconds against 4.9 on a T4, and the gap widens with every token.</p> <p>The cache costs memory instead: two vectors of width \(d\) per token in every layer. For GPT-2 that is small; for the models of today it is the main thing that limits how many conversations fit on one GPU, which is what <a href="/blog/2026/transformer-architectures-08-kv/">lesson 8</a> of this course is about. In 16-bit numbers:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">kv_bytes_per_token</span><span class="p">(</span><span class="n">layers</span><span class="p">,</span> <span class="n">d</span><span class="p">):</span>
    <span class="k">return</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">layers</span> <span class="o">*</span> <span class="n">d</span> <span class="o">*</span> <span class="mi">2</span>  <span class="c1"># keys and values, every layer, 2 bytes per number
</span>

<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">layers</span><span class="p">,</span> <span class="n">d</span> <span class="ow">in</span> <span class="p">[(</span><span class="sh">"</span><span class="s">GPT-2</span><span class="sh">"</span><span class="p">,</span> <span class="mi">12</span><span class="p">,</span> <span class="mi">768</span><span class="p">),</span> <span class="p">(</span><span class="sh">"</span><span class="s">GPT-2 XL</span><span class="sh">"</span><span class="p">,</span> <span class="mi">48</span><span class="p">,</span> <span class="mi">1600</span><span class="p">),</span> <span class="p">(</span><span class="sh">"</span><span class="s">GPT-3</span><span class="sh">"</span><span class="p">,</span> <span class="mi">96</span><span class="p">,</span> <span class="mi">12288</span><span class="p">)]:</span>
    <span class="n">per_token</span> <span class="o">=</span> <span class="nf">kv_bytes_per_token</span><span class="p">(</span><span class="n">layers</span><span class="p">,</span> <span class="n">d</span><span class="p">)</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">name</span><span class="si">:</span><span class="mi">9</span><span class="n">s</span><span class="si">}</span><span class="s"> </span><span class="si">{</span><span class="n">per_token</span> <span class="o">/</span> <span class="mi">1024</span><span class="si">:</span><span class="mi">7</span><span class="p">,.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> KB per token, </span><span class="sh">"</span>
          <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">per_token</span> <span class="o">*</span> <span class="mi">2048</span> <span class="o">/</span> <span class="mi">2</span><span class="o">**</span><span class="mi">30</span><span class="si">:</span><span class="mf">5.2</span><span class="n">f</span><span class="si">}</span><span class="s"> GB for 2,048 tokens</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>GPT-2          36 KB per token,  0.07 GB for 2,048 tokens
GPT-2 XL      300 KB per token,  0.59 GB for 2,048 tokens
GPT-3       4,608 KB per token,  9.00 GB for 2,048 tokens</code></pre> <p>GPT-3’s numbers are from its paper; it has no public weights. A single 2,048-token conversation with it holds several gigabytes of cache, before anyone else is served.</p> <p>Greedy decoding is a poor way to write prose: it picks the safest token every time, and safe texts repeat, as GPT-2’s chess shows.</p> <p>Sampling picks the next token at random from the model’s distribution, usually sharpened by a <em>temperature</em> \(\tau\): the scores are divided by \(\tau\) before the softmax, so \(\tau &lt; 1\) makes likely tokens likelier and \(\tau \to 0\) is greedy. The same prompt, three samples at \(\tau = 0.8\):</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">generator</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nc">Generator</span><span class="p">(</span><span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">).</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">START</span> <span class="o">=</span> <span class="sh">"</span><span class="s">The strangest chess game ever played</span><span class="sh">"</span>
<span class="n">start</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="n">START</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">)[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">].</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">3</span><span class="p">):</span>
    <span class="n">sample</span> <span class="o">=</span> <span class="nf">generate</span><span class="p">(</span><span class="n">gpt2</span><span class="p">,</span> <span class="n">start</span><span class="p">,</span> <span class="mi">30</span><span class="p">,</span> <span class="n">temperature</span><span class="o">=</span><span class="mf">0.8</span><span class="p">,</span> <span class="n">generator</span><span class="o">=</span><span class="n">generator</span><span class="p">)</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">·</span><span class="sh">"</span><span class="p">,</span> <span class="n">tokenizer</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="n">sample</span><span class="p">[</span><span class="mi">0</span><span class="p">]).</span><span class="nf">replace</span><span class="p">(</span><span class="sh">"</span><span class="se">\n</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>· The strangest chess game ever played, the only way to receive the prize?  I have been making chess updates since last November, and when it comes to chess, the most
· The strangest chess game ever played for a mere four years in a single day.  I'm not speaking of the grand tournament, here, about the Russian chess grandmaster —
· The strangest chess game ever played is Chess Guides. It's a game of chess, at least, but it could be more apt to be released on consoles right now. </code></pre> <h2 id="6-the-logit-lens-gpt-2-changing-its-mind">6. The logit lens: GPT-2 changing its mind</h2> <p>The residual stream after every layer is a vector of the same width as the last one, and nothing stops us from applying the final LayerNorm and the unembedding to it early.</p> <p>What comes out is the model’s guess for the next token <em>as it stands</em> after that layer. The idea is called the <em>logit lens</em> <sup class="cite">[<a href="#ref-11" id="cite-11" data-ref="11" aria-label="Reference 11: nostalgebraist (2020). interpreting GPT: the logit lens. LessWrong.">11</a>]</sup>, and it works on GPT-2 because a pre-norm stack only ever adds to the stream, so each layer refines the same running guess.</p> <p>The last word of each prompt below is where we look: after every layer, what does GPT-2 expect next?</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">logit_lens</span><span class="p">(</span><span class="n">text</span><span class="p">):</span>
    <span class="n">ids</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="n">text</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">)[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">].</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="n">_</span><span class="p">,</span> <span class="n">states</span> <span class="o">=</span> <span class="nf">gpt2</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">keep_states</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">layer</span><span class="p">,</span> <span class="n">state</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">states</span><span class="p">):</span>
        <span class="n">probs</span> <span class="o">=</span> <span class="n">gpt2</span><span class="p">.</span><span class="nf">unembed</span><span class="p">(</span><span class="n">state</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">]).</span><span class="nf">float</span><span class="p">().</span><span class="nf">softmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">best</span> <span class="o">=</span> <span class="n">probs</span><span class="p">.</span><span class="nf">argmax</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
        <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">((</span><span class="n">layer</span><span class="p">,</span> <span class="n">tokenizer</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="n">best</span><span class="p">),</span> <span class="n">probs</span><span class="p">[</span><span class="n">best</span><span class="p">].</span><span class="nf">item</span><span class="p">()))</span>
    <span class="k">return</span> <span class="n">rows</span>


<span class="n">PROMPTS</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">In 1997, IBM</span><span class="sh">'</span><span class="s">s Deep Blue defeated the world chess champion Garry</span><span class="sh">"</span><span class="p">,</span>
           <span class="sh">"</span><span class="s">Bobby Fischer won the 1972 World Chess Championship against Boris</span><span class="sh">"</span><span class="p">]</span>
<span class="n">lens</span> <span class="o">=</span> <span class="p">{</span><span class="n">text</span><span class="p">:</span> <span class="nf">logit_lens</span><span class="p">(</span><span class="n">text</span><span class="p">)</span> <span class="k">for</span> <span class="n">text</span> <span class="ow">in</span> <span class="n">PROMPTS</span><span class="p">}</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">9.6</span><span class="p">,</span> <span class="mf">4.4</span><span class="p">),</span> <span class="n">sharey</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="k">for</span> <span class="n">ax</span><span class="p">,</span> <span class="n">text</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">axes</span><span class="p">,</span> <span class="n">PROMPTS</span><span class="p">):</span>
    <span class="n">rows</span> <span class="o">=</span> <span class="n">lens</span><span class="p">[</span><span class="n">text</span><span class="p">]</span>
    <span class="n">layers</span> <span class="o">=</span> <span class="p">[</span><span class="n">layer</span> <span class="k">for</span> <span class="n">layer</span><span class="p">,</span> <span class="n">_</span><span class="p">,</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">rows</span><span class="p">]</span>
    <span class="n">top</span> <span class="o">=</span> <span class="p">[</span><span class="n">p</span> <span class="k">for</span> <span class="n">_</span><span class="p">,</span> <span class="n">_</span><span class="p">,</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">rows</span><span class="p">]</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">barh</span><span class="p">(</span><span class="n">layers</span><span class="p">,</span> <span class="n">top</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">],</span> <span class="n">height</span><span class="o">=</span><span class="mf">0.7</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">layer</span><span class="p">,</span> <span class="n">word</span><span class="p">,</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">rows</span><span class="p">:</span>
        <span class="n">ax</span><span class="p">.</span><span class="nf">text</span><span class="p">(</span><span class="n">p</span> <span class="o">+</span> <span class="mf">0.02</span><span class="p">,</span> <span class="n">layer</span><span class="p">,</span> <span class="nf">repr</span><span class="p">(</span><span class="n">word</span><span class="p">),</span> <span class="n">va</span><span class="o">=</span><span class="sh">"</span><span class="s">center</span><span class="sh">"</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">9</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">ink</span><span class="sh">"</span><span class="p">])</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_xlim</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mf">1.45</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">… </span><span class="sh">"</span> <span class="o">+</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">text</span><span class="p">.</span><span class="nf">split</span><span class="p">()[</span><span class="o">-</span><span class="mi">5</span><span class="p">:]),</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">10</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">probability of the top token</span><span class="sh">"</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">after layer (0 = embeddings)</span><span class="sh">"</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">set_yticks</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">lens</span><span class="p">[</span><span class="n">PROMPTS</span><span class="p">[</span><span class="mi">0</span><span class="p">]])))</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">invert_yaxis</span><span class="p">()</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">tight_layout</span><span class="p">()</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/04/output-04.png" alt="… " loading="lazy"></p> <p>For Deep Blue’s opponent, the first seven layers just repeat the last word of the prompt, <em>Garry</em>: early layers still carry mostly their input, and the lens reads it back. From layer 8 <em>Kas</em> takes over, wavers once, and ends at full confidence.</p> <p>The second prompt asks for Bobby Fischer’s opponent of 1972, Boris Spassky. The middle layers bet on <em>Johnson</em>, the Boris of British politics; the last one settles, with little confidence, on <em>Becker</em>, a tennis player.</p> <p>Spassky never appears. The smallest GPT-2 doesn’t know him, and the lens shows how it fails: by sliding from one famous Boris to another.</p> <p>The lens is biased: the final LayerNorm and unembedding were trained to read the last layer, not the middle ones, so early guesses look worse than what the layer knows. The <em>tuned lens</em> fixes this by training a small affine map for every layer<sup class="cite">[<a href="#ref-12" id="cite-12" data-ref="12" aria-label="Reference 12: Belrose, N., Ostrovsky, I., McKinney, L., Furman, Z., Smith, L., Halawi, D., Biderman, S., &amp; Steinhardt, J. (2023). Eliciting latent predictions from transformers with the tuned lens. arXiv:2303.08112.">12</a>]</sup>.</p> <p>For GPT-2 the plain lens reads well enough to show the main thing: the answer is assembled gradually, and the residual stream is a place where you can watch it happen. Section 11 will read the same stream with a probe of our own.</p> <h2 id="7-a-gigabyte-of-chess">7. A gigabyte of chess</h2> <p>Lichess, the free and open-source chess server, publishes every rated game played on it, month by month, under CC0: no rights reserved. By November 2026 the database held more than 8.3 billion standard games, with every player’s clock recorded since April 2017<sup class="cite">[<a href="#ref-13" id="cite-13" data-ref="13" aria-label="Reference 13: Lichess (2026). Lichess open database. CC0.">13</a>]</sup>.</p> <p>Hugging Face mirrors it as Parquet files by year and month. The month we take, January 2025, is split into 72 Parquet files of about a gigabyte each; one is plenty.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">LICHESS</span> <span class="o">=</span> <span class="sh">"</span><span class="s">Lichess/standard-chess-games</span><span class="sh">"</span>
<span class="n">SHARD</span> <span class="o">=</span> <span class="sh">"</span><span class="s">data/year=2025/month=01/train-00000-of-00072.parquet</span><span class="sh">"</span>
<span class="n">path</span> <span class="o">=</span> <span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">LICHESS</span><span class="p">,</span> <span class="n">SHARD</span><span class="p">,</span> <span class="n">repo_type</span><span class="o">=</span><span class="sh">"</span><span class="s">dataset</span><span class="sh">"</span><span class="p">)</span>
<span class="n">lichess</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nf">read_parquet</span><span class="p">(</span><span class="n">path</span><span class="p">,</span> <span class="n">columns</span><span class="o">=</span><span class="p">[</span><span class="sh">"</span><span class="s">Event</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">WhiteElo</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">BlackElo</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">movetext</span><span class="sh">"</span><span class="p">])</span>
<span class="k">if</span> <span class="n">SMOKE</span><span class="p">:</span>
    <span class="n">lichess</span> <span class="o">=</span> <span class="n">lichess</span><span class="p">.</span><span class="nf">head</span><span class="p">(</span><span class="mi">100_000</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">lichess</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> games</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="n">lichess</span><span class="p">[</span><span class="sh">"</span><span class="s">movetext</span><span class="sh">"</span><span class="p">][</span><span class="mi">0</span><span class="p">][:</span><span class="mi">240</span><span class="p">],</span> <span class="sh">"</span><span class="s">…</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>1,394,617 games
1. Nc3 { [%clk 0:03:00] } 1... e5 { [%clk 0:03:00] } 2. e4 { [%clk 0:02:59] } 2... Bc5 { [%clk 0:02:59] } 3. Qh5 { [%clk 0:02:57] } 3... Nf6 { [%clk 0:02:58] } 4. Qxe5+ { [%clk 0:02:56] } 4... Be7 { [%clk 0:02:55] } 5. d3 { [%clk 0:02:55] } …</code></pre> <p>Every move comes with the time left on the player’s clock, <code class="language-plaintext highlighter-rouge">{ [%clk 0:02:59] }</code>, and Black’s moves repeat the move number as <code class="language-plaintext highlighter-rouge">1...</code>. The games are of every kind, from one-minute bullet to classical:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># "Rated Blitz game", "Blitz swiss https://lichess.org/swiss/…" -&gt; "Blitz"
</span><span class="n">SPEEDS</span> <span class="o">=</span> <span class="sa">r</span><span class="sh">"</span><span class="s">(UltraBullet|Bullet|Blitz|Rapid|Classical|Correspondence)</span><span class="sh">"</span>
<span class="n">kind</span> <span class="o">=</span> <span class="n">lichess</span><span class="p">[</span><span class="sh">"</span><span class="s">Event</span><span class="sh">"</span><span class="p">].</span><span class="nb">str</span><span class="p">.</span><span class="nf">extract</span><span class="p">(</span><span class="n">SPEEDS</span><span class="p">)[</span><span class="mi">0</span><span class="p">]</span>
<span class="nf">table</span><span class="p">(</span><span class="n">kind</span><span class="p">.</span><span class="nf">value_counts</span><span class="p">().</span><span class="nf">rename_axis</span><span class="p">(</span><span class="sh">"</span><span class="s">time control</span><span class="sh">"</span><span class="p">).</span><span class="nf">reset_index</span><span class="p">(</span><span class="n">name</span><span class="o">=</span><span class="sh">"</span><span class="s">games</span><span class="sh">"</span><span class="p">))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">time control</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">games</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Blitz</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">652,645</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Bullet</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">505,274</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Rapid</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">212,558</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">UltraBullet</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">13,939</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Classical</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8,846</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Correspondence</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,355</td></tr></tbody></table></div> <p>Bullet games are decided by the clock as much as by the moves, and a model trained on them learns to blunder in time trouble. We keep blitz, rapid and classical games where both players are rated 1800 or more.</p> <p>Then we strip the clocks and write each game the way Adam Karvonen did for his chess-playing GPT<sup class="cite">[<a href="#ref-14" id="cite-14" data-ref="14" aria-label="Reference 14: Karvonen, A. (2024). Emergent world models and latent variable estimation in chess-playing language models. COLM 2024.">14</a>]</sup>: a <code class="language-plaintext highlighter-rouge">;</code> to mark the start, move numbers glued to White’s moves, nothing else.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">CLOCK</span> <span class="o">=</span> <span class="n">re</span><span class="p">.</span><span class="nf">compile</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s">\{[^}]*\}</span><span class="sh">"</span><span class="p">)</span>  <span class="c1"># { [%clk 0:02:59] } and the like
</span><span class="n">BLACK_NUMBER</span> <span class="o">=</span> <span class="n">re</span><span class="p">.</span><span class="nf">compile</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s">\d+\.\.\. </span><span class="sh">"</span><span class="p">)</span>  <span class="c1"># "1... " before Black's moves
</span><span class="n">GLYPHS</span> <span class="o">=</span> <span class="n">re</span><span class="p">.</span><span class="nf">compile</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s">[?!]</span><span class="sh">"</span><span class="p">)</span>  <span class="c1"># annotations such as ?? and !?
</span><span class="n">NUMBER</span> <span class="o">=</span> <span class="n">re</span><span class="p">.</span><span class="nf">compile</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s">(\d+)\. </span><span class="sh">"</span><span class="p">)</span>  <span class="c1"># "1. e4" -&gt; "1.e4"
</span><span class="n">RESULT</span> <span class="o">=</span> <span class="n">re</span><span class="p">.</span><span class="nf">compile</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s"> ?(1-0|0-1|1/2-1/2|\*)$</span><span class="sh">"</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">clean</span><span class="p">(</span><span class="n">movetext</span><span class="p">):</span>
    <span class="n">text</span> <span class="o">=</span> <span class="n">CLOCK</span><span class="p">.</span><span class="nf">sub</span><span class="p">(</span><span class="sh">""</span><span class="p">,</span> <span class="n">movetext</span><span class="p">)</span>
    <span class="n">text</span> <span class="o">=</span> <span class="n">BLACK_NUMBER</span><span class="p">.</span><span class="nf">sub</span><span class="p">(</span><span class="sh">""</span><span class="p">,</span> <span class="n">text</span><span class="p">)</span>
    <span class="n">text</span> <span class="o">=</span> <span class="n">GLYPHS</span><span class="p">.</span><span class="nf">sub</span><span class="p">(</span><span class="sh">""</span><span class="p">,</span> <span class="n">text</span><span class="p">)</span>
    <span class="n">text</span> <span class="o">=</span> <span class="n">NUMBER</span><span class="p">.</span><span class="nf">sub</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s">\1.</span><span class="sh">"</span><span class="p">,</span> <span class="n">text</span><span class="p">)</span>
    <span class="n">text</span> <span class="o">=</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">text</span><span class="p">.</span><span class="nf">split</span><span class="p">())</span>  <span class="c1"># one space between moves
</span>    <span class="n">text</span> <span class="o">=</span> <span class="n">RESULT</span><span class="p">.</span><span class="nf">sub</span><span class="p">(</span><span class="sh">""</span><span class="p">,</span> <span class="n">text</span><span class="p">)</span>
    <span class="k">return</span> <span class="sh">"</span><span class="s">;</span><span class="sh">"</span> <span class="o">+</span> <span class="n">text</span>


<span class="n">slow</span> <span class="o">=</span> <span class="n">kind</span><span class="p">.</span><span class="nf">isin</span><span class="p">([</span><span class="sh">"</span><span class="s">Blitz</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Rapid</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Classical</span><span class="sh">"</span><span class="p">])</span>
<span class="n">strong</span> <span class="o">=</span> <span class="p">(</span><span class="n">lichess</span><span class="p">[</span><span class="sh">"</span><span class="s">WhiteElo</span><span class="sh">"</span><span class="p">]</span> <span class="o">&gt;=</span> <span class="mi">1800</span><span class="p">)</span> <span class="o">&amp;</span> <span class="p">(</span><span class="n">lichess</span><span class="p">[</span><span class="sh">"</span><span class="s">BlackElo</span><span class="sh">"</span><span class="p">]</span> <span class="o">&gt;=</span> <span class="mi">1800</span><span class="p">)</span>
<span class="n">games</span> <span class="o">=</span> <span class="p">[</span><span class="nf">clean</span><span class="p">(</span><span class="n">movetext</span><span class="p">)</span> <span class="k">for</span> <span class="n">movetext</span> <span class="ow">in</span> <span class="n">lichess</span><span class="p">[</span><span class="sh">"</span><span class="s">movetext</span><span class="sh">"</span><span class="p">][</span><span class="n">slow</span> <span class="o">&amp;</span> <span class="n">strong</span><span class="p">]]</span>
<span class="n">games</span> <span class="o">=</span> <span class="p">[</span><span class="n">game</span> <span class="k">for</span> <span class="n">game</span> <span class="ow">in</span> <span class="n">games</span> <span class="k">if</span> <span class="n">game</span><span class="p">.</span><span class="nf">count</span><span class="p">(</span><span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">)</span> <span class="o">&gt;=</span> <span class="mi">10</span><span class="p">]</span>  <span class="c1"># at least five moves each
</span><span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">games</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> games kept, e.g.</span><span class="se">\n</span><span class="si">{</span><span class="n">games</span><span class="p">[</span><span class="mi">0</span><span class="p">][</span><span class="si">:</span><span class="mi">200</span><span class="p">]</span><span class="si">}</span><span class="s"> …</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>250,635 games kept, e.g.
;1.e4 c6 2.d4 d5 3.exd5 cxd5 4.Bd3 Nf6 5.h3 Nc6 6.c3 e5 7.dxe5 Nxe5 8.Be2 Bd6 9.Nf3 Nxf3+ 10.Bxf3 Be6 11.O-O Qc7 12.Nd2 Rd8 13.Nb3 h6 14.Nd4 O-O 15.Re1 a6 16.Rxe6 fxe6 17.Nxe6 Qa5 18.Nxf8 Rxf8 19.Be3  …</code></pre> <p>The whole language of these games fits in a few dozen characters:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">VOCAB</span> <span class="o">=</span> <span class="nf">sorted</span><span class="p">(</span><span class="nf">set</span><span class="p">(</span><span class="sh">""</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">games</span><span class="p">)))</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">VOCAB</span><span class="p">),</span> <span class="sh">"</span><span class="s">characters:</span><span class="sh">"</span><span class="p">,</span> <span class="sh">""</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">VOCAB</span><span class="p">))</span>
<span class="n">stoi</span> <span class="o">=</span> <span class="p">{</span><span class="n">char</span><span class="p">:</span> <span class="n">i</span> <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">char</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">VOCAB</span><span class="p">)}</span>
<span class="n">lengths</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">array</span><span class="p">([</span><span class="nf">len</span><span class="p">(</span><span class="n">game</span><span class="p">)</span> <span class="k">for</span> <span class="n">game</span> <span class="ow">in</span> <span class="n">games</span><span class="p">])</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">a game is </span><span class="si">{</span><span class="n">np</span><span class="p">.</span><span class="nf">median</span><span class="p">(</span><span class="n">lengths</span><span class="p">)</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> characters long in the median, </span><span class="sh">"</span>
      <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">np</span><span class="p">.</span><span class="nf">percentile</span><span class="p">(</span><span class="n">lengths</span><span class="p">,</span> <span class="mi">90</span><span class="p">)</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> at the 90th percentile</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>32 characters:  #+-.0123456789;=BKNOQRabcdefghx
a game is 387 characters long in the median, 663 at the 90th percentile</code></pre> <p>Thirty-two characters: the files <code class="language-plaintext highlighter-rouge">a</code> to <code class="language-plaintext highlighter-rouge">h</code>, the ranks <code class="language-plaintext highlighter-rouge">1</code> to <code class="language-plaintext highlighter-rouge">8</code>, the pieces <code class="language-plaintext highlighter-rouge">K Q R B N</code>, <code class="language-plaintext highlighter-rouge">x</code> for a capture, <code class="language-plaintext highlighter-rouge">+</code> and <code class="language-plaintext highlighter-rouge">#</code> for check and mate, <code class="language-plaintext highlighter-rouge">O-O</code> for castling, <code class="language-plaintext highlighter-rouge">=</code> for promotion, the digits of move numbers, the dot, the space and the <code class="language-plaintext highlighter-rouge">;</code>.</p> <p>A model that reads this alphabet is never told what a knight is. It sees <code class="language-plaintext highlighter-rouge">N</code> followed by a square, again and again, in the places where knights went.</p> <p>We hold out 4,000 games for testing and pack the rest into one long stream of character ids. A training example is a window of the stream that starts at the beginning of a game.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">CONTEXT</span> <span class="o">=</span> <span class="mi">512</span>  <span class="c1"># characters the model reads at once: most games fit
</span><span class="n">rng</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="nf">default_rng</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">order</span> <span class="o">=</span> <span class="n">rng</span><span class="p">.</span><span class="nf">permutation</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">games</span><span class="p">))</span>
<span class="n">test_games</span> <span class="o">=</span> <span class="p">[</span><span class="n">games</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">order</span><span class="p">[:</span><span class="mi">4000</span><span class="p">]]</span>
<span class="n">train_games</span> <span class="o">=</span> <span class="p">[</span><span class="n">games</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">order</span><span class="p">[</span><span class="mi">4000</span><span class="p">:]]</span>

<span class="n">lookup</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="mi">128</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">np</span><span class="p">.</span><span class="n">uint8</span><span class="p">)</span>
<span class="k">for</span> <span class="n">char</span><span class="p">,</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">stoi</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
    <span class="n">lookup</span><span class="p">[</span><span class="nf">ord</span><span class="p">(</span><span class="n">char</span><span class="p">)]</span> <span class="o">=</span> <span class="n">i</span>
<span class="n">stream</span> <span class="o">=</span> <span class="n">lookup</span><span class="p">[</span><span class="n">np</span><span class="p">.</span><span class="nf">frombuffer</span><span class="p">(</span><span class="sh">""</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">train_games</span><span class="p">).</span><span class="nf">encode</span><span class="p">(</span><span class="sh">"</span><span class="s">ascii</span><span class="sh">"</span><span class="p">),</span> <span class="n">dtype</span><span class="o">=</span><span class="n">np</span><span class="p">.</span><span class="n">uint8</span><span class="p">)]</span>
<span class="n">stream</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">from_numpy</span><span class="p">(</span><span class="n">stream</span><span class="p">.</span><span class="nf">astype</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="n">int64</span><span class="p">))</span>
<span class="n">starts</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">flatnonzero</span><span class="p">(</span><span class="n">stream</span><span class="p">.</span><span class="nf">numpy</span><span class="p">()</span> <span class="o">==</span> <span class="n">stoi</span><span class="p">[</span><span class="sh">"</span><span class="s">;</span><span class="sh">"</span><span class="p">])</span>
<span class="n">starts</span> <span class="o">=</span> <span class="n">starts</span><span class="p">[</span><span class="n">starts</span> <span class="o">+</span> <span class="n">CONTEXT</span> <span class="o">+</span> <span class="mi">1</span> <span class="o">&lt;=</span> <span class="nf">len</span><span class="p">(</span><span class="n">stream</span><span class="p">)]</span>  <span class="c1"># every window must fit in the stream
</span><span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">train_games</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> training games, </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">stream</span><span class="p">)</span> <span class="o">/</span> <span class="mf">1e6</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> million characters; </span><span class="sh">"</span>
      <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">test_games</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> held out</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>246,635 training games, 102 million characters; 4,000 held out</code></pre> <h2 id="8-gpt-2-at-the-chessboard">8. GPT-2 at the chessboard</h2> <p>Chess notation is all over the web, in game reports, forums and PGN files, so GPT-2 has read some. In a typical position there are “of the order of 30 legal moves”, as Claude Shannon estimated in 1950, among the thousands of strings that look like a move. How often does GPT-2 hit one?</p> <p>Part of the trouble is visible before the model runs. GPT-2’s <a href="/blog/2026/transformers-from-scratch-01-tokenization/">tokenizer</a> was built for English prose, and it cuts chess notation into pieces that don’t follow the moves:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">LINE</span> <span class="o">=</span> <span class="sh">"</span><span class="s">1. e4 e5 2. Nf3 Nc6 3. Bb5 a6 4. Ba4 Nf6 5. O-O Be7</span><span class="sh">"</span>
<span class="n">pieces</span> <span class="o">=</span> <span class="p">[</span><span class="n">tokenizer</span><span class="p">.</span><span class="nf">decode</span><span class="p">([</span><span class="n">i</span><span class="p">])</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="n">LINE</span><span class="p">)[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">]]</span>
<span class="nf">token_chips</span><span class="p">([</span><span class="n">pieces</span><span class="p">],</span> <span class="n">labels</span><span class="o">=</span><span class="p">[</span><span class="sh">"</span><span class="s">GPT-2 tokens</span><span class="sh">"</span><span class="p">],</span> <span class="n">max_width</span><span class="o">=</span><span class="mi">640</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">10 moves, </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">pieces</span><span class="p">)</span><span class="si">}</span><span class="s"> tokens</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/04/output-05.png" alt="Output of the code above" loading="lazy"></p> <pre class="tfs-printed"><code>10 moves, 35 tokens</code></pre> <p>To test a player, chess or language model, we take positions from the held-out games: a game cut at a random move, the moves so far as the prompt, and the question of what comes next. <code class="language-plaintext highlighter-rouge">python-chess</code> replays the moves and judges the answer. The same positions will test our own model later, written in its own format.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">moves_of</span><span class="p">(</span><span class="n">game</span><span class="p">):</span>
    <span class="k">return</span> <span class="p">[</span><span class="n">word</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="sh">"</span><span class="s">.</span><span class="sh">"</span><span class="p">)[</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span> <span class="k">for</span> <span class="n">word</span> <span class="ow">in</span> <span class="n">game</span><span class="p">[</span><span class="mi">1</span><span class="p">:].</span><span class="nf">split</span><span class="p">(</span><span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">)]</span>  <span class="c1"># "12.Nf3" -&gt; "Nf3"
</span>

<span class="k">def</span> <span class="nf">prompt_for</span><span class="p">(</span><span class="n">moves</span><span class="p">,</span> <span class="n">upto</span><span class="p">,</span> <span class="n">spaced</span><span class="p">):</span>
    <span class="c1"># the game before move number `upto` (counted from 0), ready for that move
</span>    <span class="n">text</span> <span class="o">=</span> <span class="sh">""</span>
    <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">upto</span><span class="p">):</span>
        <span class="k">if</span> <span class="n">i</span> <span class="o">%</span> <span class="mi">2</span> <span class="o">==</span> <span class="mi">0</span><span class="p">:</span>
            <span class="n">text</span> <span class="o">+=</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">i</span> <span class="o">//</span> <span class="mi">2</span> <span class="o">+</span> <span class="mi">1</span><span class="si">}</span><span class="s">.</span><span class="sh">"</span> <span class="o">+</span> <span class="p">(</span><span class="sh">"</span><span class="s"> </span><span class="sh">"</span> <span class="k">if</span> <span class="n">spaced</span> <span class="k">else</span> <span class="sh">""</span><span class="p">)</span>
        <span class="n">text</span> <span class="o">+=</span> <span class="n">moves</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="o">+</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span>
    <span class="k">if</span> <span class="n">upto</span> <span class="o">%</span> <span class="mi">2</span> <span class="o">==</span> <span class="mi">0</span><span class="p">:</span>  <span class="c1"># White to move: the move number comes first
</span>        <span class="n">text</span> <span class="o">+=</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">upto</span> <span class="o">//</span> <span class="mi">2</span> <span class="o">+</span> <span class="mi">1</span><span class="si">}</span><span class="s">.</span><span class="sh">"</span>
    <span class="k">return</span> <span class="n">text</span>


<span class="k">def</span> <span class="nf">test_positions</span><span class="p">(</span><span class="n">games</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">seed</span><span class="p">):</span>
    <span class="n">rng</span> <span class="o">=</span> <span class="n">random</span><span class="p">.</span><span class="nc">Random</span><span class="p">(</span><span class="n">seed</span><span class="p">)</span>
    <span class="n">positions</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">game</span> <span class="ow">in</span> <span class="n">games</span><span class="p">:</span>
        <span class="n">moves</span> <span class="o">=</span> <span class="nf">moves_of</span><span class="p">(</span><span class="n">game</span><span class="p">)</span>
        <span class="n">upto</span> <span class="o">=</span> <span class="n">rng</span><span class="p">.</span><span class="nf">randrange</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="nf">min</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">moves</span><span class="p">),</span> <span class="mi">70</span><span class="p">))</span>
        <span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="nf">prompt_for</span><span class="p">(</span><span class="n">moves</span><span class="p">,</span> <span class="n">upto</span><span class="p">,</span> <span class="n">spaced</span><span class="o">=</span><span class="bp">False</span><span class="p">))</span> <span class="o">&gt;</span> <span class="n">CONTEXT</span> <span class="o">-</span> <span class="mi">10</span><span class="p">:</span>
            <span class="k">continue</span>  <span class="c1"># longer than our model's context
</span>        <span class="n">board</span> <span class="o">=</span> <span class="n">chess</span><span class="p">.</span><span class="nc">Board</span><span class="p">()</span>
        <span class="k">for</span> <span class="n">move</span> <span class="ow">in</span> <span class="n">moves</span><span class="p">[:</span><span class="n">upto</span><span class="p">]:</span>
            <span class="n">board</span><span class="p">.</span><span class="nf">push_san</span><span class="p">(</span><span class="n">move</span><span class="p">)</span>
        <span class="n">positions</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">moves</span><span class="sh">"</span><span class="p">:</span> <span class="n">moves</span><span class="p">,</span> <span class="sh">"</span><span class="s">upto</span><span class="sh">"</span><span class="p">:</span> <span class="n">upto</span><span class="p">,</span> <span class="sh">"</span><span class="s">board</span><span class="sh">"</span><span class="p">:</span> <span class="n">board</span><span class="p">,</span>
                          <span class="sh">"</span><span class="s">played</span><span class="sh">"</span><span class="p">:</span> <span class="n">moves</span><span class="p">[</span><span class="n">upto</span><span class="p">]})</span>
        <span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="n">positions</span><span class="p">)</span> <span class="o">==</span> <span class="n">n</span><span class="p">:</span>
            <span class="k">break</span>
    <span class="k">return</span> <span class="n">positions</span>


<span class="n">positions</span> <span class="o">=</span> <span class="nf">test_positions</span><span class="p">(</span><span class="n">test_games</span><span class="p">,</span> <span class="mi">100</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">1000</span><span class="p">,</span> <span class="n">SEED</span><span class="p">)</span>
<span class="n">example</span> <span class="o">=</span> <span class="n">positions</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
<span class="n">moves</span><span class="p">,</span> <span class="n">upto</span> <span class="o">=</span> <span class="n">example</span><span class="p">[</span><span class="sh">"</span><span class="s">moves</span><span class="sh">"</span><span class="p">],</span> <span class="n">example</span><span class="p">[</span><span class="sh">"</span><span class="s">upto</span><span class="sh">"</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">GPT-2 gets:    </span><span class="sh">"</span><span class="p">,</span> <span class="nf">repr</span><span class="p">(</span><span class="nf">prompt_for</span><span class="p">(</span><span class="n">moves</span><span class="p">,</span> <span class="n">upto</span><span class="p">,</span> <span class="n">spaced</span><span class="o">=</span><span class="bp">True</span><span class="p">).</span><span class="nf">rstrip</span><span class="p">()))</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">our model gets:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">repr</span><span class="p">(</span><span class="sh">"</span><span class="s">;</span><span class="sh">"</span> <span class="o">+</span> <span class="nf">prompt_for</span><span class="p">(</span><span class="n">moves</span><span class="p">,</span> <span class="n">upto</span><span class="p">,</span> <span class="n">spaced</span><span class="o">=</span><span class="bp">False</span><span class="p">)))</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">the player played:</span><span class="sh">"</span><span class="p">,</span> <span class="n">example</span><span class="p">[</span><span class="sh">"</span><span class="s">played</span><span class="sh">"</span><span class="p">])</span>
</code></pre></div></div> <pre class="tfs-printed"><code>GPT-2 gets:     '1. d4 Nf6 2. c4 e6 3. Nf3 d5 4. Bg5 Bb4+ 5. Nbd2 dxc4 6. Qa4+ Nc6 7. a3 Bxd2+ 8. Nxd2 Qxd4 9. Nxc4 O-O 10. Rd1 Qc5 11. Bxf6'
our model gets: ';1.d4 Nf6 2.c4 e6 3.Nf3 d5 4.Bg5 Bb4+ 5.Nbd2 dxc4 6.Qa4+ Nc6 7.a3 Bxd2+ 8.Nxd2 Qxd4 9.Nxc4 O-O 10.Rd1 Qc5 11.Bxf6 '
the player played: gxf6</code></pre> <p>A move can go wrong in several ways, and <code class="language-plaintext highlighter-rouge">python-chess</code> tells them apart. It may not be a move at all; it may name a move no piece can make, a knight to a square no knight reaches, or a pawn through a piece; it may be a move the piece could make if the king were not in check, or not pinned: <em>pseudo-legal</em>, as chess programmers say; or it may fit two pieces at once.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">judge</span><span class="p">(</span><span class="n">board</span><span class="p">,</span> <span class="n">move</span><span class="p">):</span>
    <span class="k">try</span><span class="p">:</span>
        <span class="n">board</span><span class="p">.</span><span class="nf">parse_san</span><span class="p">(</span><span class="n">move</span><span class="p">)</span>
        <span class="k">return</span> <span class="sh">"</span><span class="s">legal</span><span class="sh">"</span>
    <span class="k">except</span> <span class="n">chess</span><span class="p">.</span><span class="n">InvalidMoveError</span><span class="p">:</span>
        <span class="k">return</span> <span class="sh">"</span><span class="s">not a move</span><span class="sh">"</span>
    <span class="k">except</span> <span class="n">chess</span><span class="p">.</span><span class="n">AmbiguousMoveError</span><span class="p">:</span>
        <span class="k">return</span> <span class="sh">"</span><span class="s">ambiguous</span><span class="sh">"</span>
    <span class="k">except</span> <span class="n">chess</span><span class="p">.</span><span class="n">IllegalMoveError</span><span class="p">:</span>
        <span class="k">pass</span>
    <span class="n">pseudo_legal</span> <span class="o">=</span> <span class="p">{</span><span class="n">board</span><span class="p">.</span><span class="nf">san</span><span class="p">(</span><span class="n">m</span><span class="p">).</span><span class="nf">rstrip</span><span class="p">(</span><span class="sh">"</span><span class="s">+#</span><span class="sh">"</span><span class="p">)</span> <span class="k">for</span> <span class="n">m</span> <span class="ow">in</span> <span class="n">board</span><span class="p">.</span><span class="n">pseudo_legal_moves</span><span class="p">}</span>
    <span class="k">if</span> <span class="n">move</span><span class="p">.</span><span class="nf">rstrip</span><span class="p">(</span><span class="sh">"</span><span class="s">+#</span><span class="sh">"</span><span class="p">)</span> <span class="ow">in</span> <span class="n">pseudo_legal</span><span class="p">:</span>
        <span class="k">return</span> <span class="sh">"</span><span class="s">leaves the king in check</span><span class="sh">"</span>
    <span class="k">return</span> <span class="sh">"</span><span class="s">no piece can do that</span><span class="sh">"</span>


<span class="k">def</span> <span class="nf">score</span><span class="p">(</span><span class="n">make_move</span><span class="p">,</span> <span class="n">positions</span><span class="p">):</span>
    <span class="n">verdicts</span><span class="p">,</span> <span class="n">same_as_player</span> <span class="o">=</span> <span class="p">[],</span> <span class="mi">0</span>
    <span class="k">for</span> <span class="n">position</span> <span class="ow">in</span> <span class="n">positions</span><span class="p">:</span>
        <span class="n">move</span> <span class="o">=</span> <span class="nf">make_move</span><span class="p">(</span><span class="n">position</span><span class="p">)</span>
        <span class="n">verdicts</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="nf">judge</span><span class="p">(</span><span class="n">position</span><span class="p">[</span><span class="sh">"</span><span class="s">board</span><span class="sh">"</span><span class="p">],</span> <span class="n">move</span><span class="p">))</span>
        <span class="n">same_as_player</span> <span class="o">+=</span> <span class="n">move</span><span class="p">.</span><span class="nf">rstrip</span><span class="p">(</span><span class="sh">"</span><span class="s">+#</span><span class="sh">"</span><span class="p">)</span> <span class="o">==</span> <span class="n">position</span><span class="p">[</span><span class="sh">"</span><span class="s">played</span><span class="sh">"</span><span class="p">].</span><span class="nf">rstrip</span><span class="p">(</span><span class="sh">"</span><span class="s">+#</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">shares</span> <span class="o">=</span> <span class="p">{}</span>
    <span class="k">for</span> <span class="n">verdict</span><span class="p">,</span> <span class="n">count</span> <span class="ow">in</span> <span class="nc">Counter</span><span class="p">(</span><span class="n">verdicts</span><span class="p">).</span><span class="nf">items</span><span class="p">():</span>
        <span class="n">shares</span><span class="p">[</span><span class="n">verdict</span><span class="p">]</span> <span class="o">=</span> <span class="n">count</span> <span class="o">/</span> <span class="nf">len</span><span class="p">(</span><span class="n">positions</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">shares</span><span class="p">,</span> <span class="n">same_as_player</span> <span class="o">/</span> <span class="nf">len</span><span class="p">(</span><span class="n">positions</span><span class="p">)</span>


<span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">gpt2_move</span><span class="p">(</span><span class="n">position</span><span class="p">):</span>
    <span class="n">prompt</span> <span class="o">=</span> <span class="nf">prompt_for</span><span class="p">(</span><span class="n">position</span><span class="p">[</span><span class="sh">"</span><span class="s">moves</span><span class="sh">"</span><span class="p">],</span> <span class="n">position</span><span class="p">[</span><span class="sh">"</span><span class="s">upto</span><span class="sh">"</span><span class="p">],</span> <span class="n">spaced</span><span class="o">=</span><span class="bp">True</span><span class="p">).</span><span class="nf">rstrip</span><span class="p">()</span>
    <span class="n">ids</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="n">prompt</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">)[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">].</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="n">continuation</span> <span class="o">=</span> <span class="n">tokenizer</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="nf">generate</span><span class="p">(</span><span class="n">gpt2</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="mi">5</span><span class="p">)[</span><span class="mi">0</span><span class="p">,</span> <span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]:])</span>
    <span class="n">words</span> <span class="o">=</span> <span class="n">continuation</span><span class="p">.</span><span class="nf">split</span><span class="p">()</span>
    <span class="k">return</span> <span class="n">words</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span> <span class="k">if</span> <span class="n">words</span> <span class="k">else</span> <span class="sh">""</span>


<span class="n">gpt2_shares</span><span class="p">,</span> <span class="n">gpt2_same</span> <span class="o">=</span> <span class="nf">score</span><span class="p">(</span><span class="n">gpt2_move</span><span class="p">,</span> <span class="n">positions</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">GPT-2: </span><span class="si">{</span><span class="n">gpt2_shares</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">'</span><span class="s">legal</span><span class="sh">'</span><span class="p">,</span> <span class="mf">0.0</span><span class="p">)</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="s"> legal moves, </span><span class="sh">"</span>
      <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">gpt2_same</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="s"> the same move as the player</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">({</span><span class="sh">"</span><span class="s">verdict</span><span class="sh">"</span><span class="p">:</span> <span class="nf">list</span><span class="p">(</span><span class="n">gpt2_shares</span><span class="p">),</span> <span class="sh">"</span><span class="s">share</span><span class="sh">"</span><span class="p">:</span> <span class="nf">list</span><span class="p">(</span><span class="n">gpt2_shares</span><span class="p">.</span><span class="nf">values</span><span class="p">())}))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>GPT-2: 27.8% legal moves, 3.2% the same move as the player</code></pre> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">verdict</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">share</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">no piece can do that</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.68</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">legal</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.28</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">leaves the king in check</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.01</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">not a move</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.02</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">ambiguous</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.01</td></tr></tbody></table></div> <p>GPT-2 almost always writes something shaped like a move: only 2% of its answers aren’t moves at all. But 68% are moves that no piece on the board can make, and only 28% are legal. It has learned the notation, not the game.</p> <h2 id="9-a-gpt-that-has-read-nothing-but-chess">9. A GPT that has read nothing but chess</h2> <p>Now the same <code class="language-plaintext highlighter-rouge">GPT</code> class, with a 32-character vocabulary and a smaller body: 8 layers, 512 wide, 8 heads, a context of 512 characters. That is the size of Karvonen’s smaller chess model, which will come in handy.</p> <p>We initialise it the way GPT-2 was: weights drawn from a normal distribution with a standard deviation of 0.02, and the two matrices of every layer that write into the residual stream scaled down by \(1/\sqrt{2L}\), so that the stream doesn’t grow with depth at the start.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">chess_config</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">:</span> <span class="nf">len</span><span class="p">(</span><span class="n">VOCAB</span><span class="p">),</span> <span class="sh">"</span><span class="s">n_positions</span><span class="sh">"</span><span class="p">:</span> <span class="n">CONTEXT</span><span class="p">,</span> <span class="sh">"</span><span class="s">n_embd</span><span class="sh">"</span><span class="p">:</span> <span class="mi">512</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">n_head</span><span class="sh">"</span><span class="p">:</span> <span class="mi">8</span><span class="p">,</span> <span class="sh">"</span><span class="s">n_layer</span><span class="sh">"</span><span class="p">:</span> <span class="mi">8</span><span class="p">,</span> <span class="sh">"</span><span class="s">layer_norm_epsilon</span><span class="sh">"</span><span class="p">:</span> <span class="mf">1e-5</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">activation_function</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">gelu_new</span><span class="sh">"</span><span class="p">}</span>


<span class="k">def</span> <span class="nf">init_like_gpt2</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">layers</span><span class="p">):</span>
    <span class="k">for</span> <span class="n">module</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="nf">modules</span><span class="p">():</span>
        <span class="k">if</span> <span class="nf">isinstance</span><span class="p">(</span><span class="n">module</span><span class="p">,</span> <span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Linear</span><span class="p">,</span> <span class="n">nn</span><span class="p">.</span><span class="n">Embedding</span><span class="p">)):</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">init</span><span class="p">.</span><span class="nf">normal_</span><span class="p">(</span><span class="n">module</span><span class="p">.</span><span class="n">weight</span><span class="p">,</span> <span class="n">std</span><span class="o">=</span><span class="mf">0.02</span><span class="p">)</span>
        <span class="k">if</span> <span class="nf">isinstance</span><span class="p">(</span><span class="n">module</span><span class="p">,</span> <span class="n">nn</span><span class="p">.</span><span class="n">Linear</span><span class="p">):</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">init</span><span class="p">.</span><span class="nf">zeros_</span><span class="p">(</span><span class="n">module</span><span class="p">.</span><span class="n">bias</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">block</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="n">blocks</span><span class="p">:</span>  <span class="c1"># the two matrices that add to the residual stream
</span>        <span class="n">nn</span><span class="p">.</span><span class="n">init</span><span class="p">.</span><span class="nf">normal_</span><span class="p">(</span><span class="n">block</span><span class="p">.</span><span class="n">attention</span><span class="p">.</span><span class="n">out</span><span class="p">.</span><span class="n">weight</span><span class="p">,</span> <span class="n">std</span><span class="o">=</span><span class="mf">0.02</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="mi">2</span> <span class="o">*</span> <span class="n">layers</span><span class="p">))</span>
        <span class="n">nn</span><span class="p">.</span><span class="n">init</span><span class="p">.</span><span class="nf">normal_</span><span class="p">(</span><span class="n">block</span><span class="p">.</span><span class="n">down</span><span class="p">.</span><span class="n">weight</span><span class="p">,</span> <span class="n">std</span><span class="o">=</span><span class="mf">0.02</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="mi">2</span> <span class="o">*</span> <span class="n">layers</span><span class="p">))</span>


<span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">chess_gpt</span> <span class="o">=</span> <span class="nc">GPT</span><span class="p">(</span><span class="n">chess_config</span><span class="p">)</span>
<span class="nf">init_like_gpt2</span><span class="p">(</span><span class="n">chess_gpt</span><span class="p">,</span> <span class="n">chess_config</span><span class="p">[</span><span class="sh">"</span><span class="s">n_layer</span><span class="sh">"</span><span class="p">])</span>
<span class="n">chess_gpt</span> <span class="o">=</span> <span class="n">chess_gpt</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">sum</span><span class="p">(</span><span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span> <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">chess_gpt</span><span class="p">.</span><span class="nf">parameters</span><span class="p">())</span> <span class="o">/</span> <span class="mf">1e6</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s"> million parameters</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>25.5 million parameters</code></pre> <p>The training loop is the first course’s, with the settings GPT-2-style models are trained with: AdamW with \(\beta_2 = 0.95\) and weight decay 0.1 on the matrices only, a short warm-up and a cosine decay of the learning rate, gradients clipped at norm 1. The T4 computes fast in 16-bit floats, so the forward pass runs under <code class="language-plaintext highlighter-rouge">autocast</code>, and a <code class="language-plaintext highlighter-rouge">GradScaler</code> keeps small gradients from rounding to zero in that format. <code class="language-plaintext highlighter-rouge">torch.compile</code> turns the model into fused GPU kernels for training; generation and the tests use the plain model. Every few minutes we stop to test the model on 200 held-out positions, using the move function written for it below.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">chess_move</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">position</span><span class="p">,</span> <span class="n">generator</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
    <span class="n">prompt</span> <span class="o">=</span> <span class="sh">"</span><span class="s">;</span><span class="sh">"</span> <span class="o">+</span> <span class="nf">prompt_for</span><span class="p">(</span><span class="n">position</span><span class="p">[</span><span class="sh">"</span><span class="s">moves</span><span class="sh">"</span><span class="p">],</span> <span class="n">position</span><span class="p">[</span><span class="sh">"</span><span class="s">upto</span><span class="sh">"</span><span class="p">],</span> <span class="n">spaced</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
    <span class="n">ids</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">([[</span><span class="n">stoi</span><span class="p">[</span><span class="n">char</span><span class="p">]</span> <span class="k">for</span> <span class="n">char</span> <span class="ow">in</span> <span class="n">prompt</span><span class="p">]],</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
    <span class="n">caches</span> <span class="o">=</span> <span class="p">[{}</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">model</span><span class="p">.</span><span class="n">blocks</span><span class="p">]</span>
    <span class="n">move</span> <span class="o">=</span> <span class="sh">""</span>
    <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">8</span><span class="p">):</span>  <span class="c1"># the longest move, "exd8=Q+", has 7 characters
</span>        <span class="n">logits</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">caches</span><span class="p">)[</span><span class="mi">0</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">].</span><span class="nf">float</span><span class="p">()</span>
        <span class="k">if</span> <span class="n">generator</span> <span class="ow">is</span> <span class="bp">None</span><span class="p">:</span>
            <span class="n">char</span> <span class="o">=</span> <span class="n">logits</span><span class="p">.</span><span class="nf">argmax</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="n">char</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">multinomial</span><span class="p">(</span><span class="n">logits</span><span class="p">.</span><span class="nf">softmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">),</span> <span class="mi">1</span><span class="p">,</span> <span class="n">generator</span><span class="o">=</span><span class="n">generator</span><span class="p">).</span><span class="nf">item</span><span class="p">()</span>
        <span class="k">if</span> <span class="n">VOCAB</span><span class="p">[</span><span class="n">char</span><span class="p">]</span> <span class="o">==</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">:</span>
            <span class="k">break</span>
        <span class="n">move</span> <span class="o">+=</span> <span class="n">VOCAB</span><span class="p">[</span><span class="n">char</span><span class="p">]</span>
        <span class="n">ids</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">([[</span><span class="n">char</span><span class="p">]],</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">move</span>


<span class="k">def</span> <span class="nf">windows</span><span class="p">(</span><span class="n">rng</span><span class="p">,</span> <span class="n">size</span><span class="p">):</span>
    <span class="n">picked</span> <span class="o">=</span> <span class="n">starts</span><span class="p">[</span><span class="n">rng</span><span class="p">.</span><span class="nf">integers</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">starts</span><span class="p">),</span> <span class="n">size</span><span class="p">)]</span>
    <span class="n">rows</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">([</span><span class="n">stream</span><span class="p">[</span><span class="n">s</span><span class="p">:</span><span class="n">s</span> <span class="o">+</span> <span class="n">CONTEXT</span> <span class="o">+</span> <span class="mi">1</span><span class="p">]</span> <span class="k">for</span> <span class="n">s</span> <span class="ow">in</span> <span class="n">picked</span><span class="p">]).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">rows</span><span class="p">[:,</span> <span class="p">:</span><span class="o">-</span><span class="mi">1</span><span class="p">],</span> <span class="n">rows</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">:]</span>  <span class="c1"># inputs, and the same characters shifted by one
</span>

<span class="n">BATCH</span><span class="p">,</span> <span class="n">PEAK_LR</span><span class="p">,</span> <span class="n">WARMUP</span> <span class="o">=</span> <span class="mi">64</span><span class="p">,</span> <span class="mf">1e-3</span><span class="p">,</span> <span class="mi">300</span>
<span class="n">STEPS</span> <span class="o">=</span> <span class="mi">30</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">3400</span>
<span class="n">EVAL_EVERY</span> <span class="o">=</span> <span class="mi">10</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">500</span>


<span class="k">def</span> <span class="nf">learning_rate</span><span class="p">(</span><span class="n">step</span><span class="p">):</span>
    <span class="k">if</span> <span class="n">step</span> <span class="o">&lt;</span> <span class="n">WARMUP</span><span class="p">:</span>
        <span class="k">return</span> <span class="n">PEAK_LR</span> <span class="o">*</span> <span class="p">(</span><span class="n">step</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">WARMUP</span>
    <span class="n">progress</span> <span class="o">=</span> <span class="p">(</span><span class="n">step</span> <span class="o">-</span> <span class="n">WARMUP</span><span class="p">)</span> <span class="o">/</span> <span class="nf">max</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">STEPS</span> <span class="o">-</span> <span class="n">WARMUP</span><span class="p">)</span>
    <span class="n">cosine</span> <span class="o">=</span> <span class="mf">0.5</span> <span class="o">*</span> <span class="p">(</span><span class="mi">1</span> <span class="o">+</span> <span class="n">math</span><span class="p">.</span><span class="nf">cos</span><span class="p">(</span><span class="n">math</span><span class="p">.</span><span class="n">pi</span> <span class="o">*</span> <span class="n">progress</span><span class="p">))</span>
    <span class="k">return</span> <span class="n">PEAK_LR</span> <span class="o">*</span> <span class="p">(</span><span class="mf">0.1</span> <span class="o">+</span> <span class="mf">0.9</span> <span class="o">*</span> <span class="n">cosine</span><span class="p">)</span>  <span class="c1"># down to a tenth of the peak
</span>

<span class="n">matrices</span> <span class="o">=</span> <span class="p">[</span><span class="n">p</span> <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">chess_gpt</span><span class="p">.</span><span class="nf">parameters</span><span class="p">()</span> <span class="k">if</span> <span class="n">p</span><span class="p">.</span><span class="nf">dim</span><span class="p">()</span> <span class="o">==</span> <span class="mi">2</span><span class="p">]</span>
<span class="n">others</span> <span class="o">=</span> <span class="p">[</span><span class="n">p</span> <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">chess_gpt</span><span class="p">.</span><span class="nf">parameters</span><span class="p">()</span> <span class="k">if</span> <span class="n">p</span><span class="p">.</span><span class="nf">dim</span><span class="p">()</span> <span class="o">&lt;</span> <span class="mi">2</span><span class="p">]</span>
<span class="n">groups</span> <span class="o">=</span> <span class="p">[{</span><span class="sh">"</span><span class="s">params</span><span class="sh">"</span><span class="p">:</span> <span class="n">matrices</span><span class="p">,</span> <span class="sh">"</span><span class="s">weight_decay</span><span class="sh">"</span><span class="p">:</span> <span class="mf">0.1</span><span class="p">},</span>
          <span class="p">{</span><span class="sh">"</span><span class="s">params</span><span class="sh">"</span><span class="p">:</span> <span class="n">others</span><span class="p">,</span> <span class="sh">"</span><span class="s">weight_decay</span><span class="sh">"</span><span class="p">:</span> <span class="mf">0.0</span><span class="p">}]</span>
<span class="n">optimizer</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">optim</span><span class="p">.</span><span class="nc">AdamW</span><span class="p">(</span><span class="n">groups</span><span class="p">,</span> <span class="n">lr</span><span class="o">=</span><span class="n">PEAK_LR</span><span class="p">,</span> <span class="n">betas</span><span class="o">=</span><span class="p">(</span><span class="mf">0.9</span><span class="p">,</span> <span class="mf">0.95</span><span class="p">))</span>
<span class="n">scaler</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">amp</span><span class="p">.</span><span class="nc">GradScaler</span><span class="p">(</span><span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">)</span>
<span class="c1"># the compiler fuses the training passes into fewer GPU kernels; the first steps wait for it
</span><span class="n">compiled</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">compile</span><span class="p">(</span><span class="n">chess_gpt</span><span class="p">)</span> <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">else</span> <span class="n">chess_gpt</span>
<span class="n">quick_test</span> <span class="o">=</span> <span class="n">positions</span><span class="p">[:</span><span class="mi">200</span><span class="p">]</span>

<span class="n">rng</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="nf">default_rng</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">curve</span> <span class="o">=</span> <span class="p">[]</span>
<span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
<span class="k">for</span> <span class="n">step</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">STEPS</span><span class="p">):</span>
    <span class="k">for</span> <span class="n">group</span> <span class="ow">in</span> <span class="n">optimizer</span><span class="p">.</span><span class="n">param_groups</span><span class="p">:</span>
        <span class="n">group</span><span class="p">[</span><span class="sh">"</span><span class="s">lr</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="nf">learning_rate</span><span class="p">(</span><span class="n">step</span><span class="p">)</span>
    <span class="n">inputs</span><span class="p">,</span> <span class="n">targets</span> <span class="o">=</span> <span class="nf">windows</span><span class="p">(</span><span class="n">rng</span><span class="p">,</span> <span class="n">BATCH</span><span class="p">)</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">autocast</span><span class="p">(</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float16</span><span class="p">,</span> <span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">):</span>
        <span class="n">logits</span> <span class="o">=</span> <span class="nf">compiled</span><span class="p">(</span><span class="n">inputs</span><span class="p">)</span>
    <span class="n">loss</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span><span class="n">logits</span><span class="p">.</span><span class="nf">float</span><span class="p">().</span><span class="nf">view</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">VOCAB</span><span class="p">)),</span> <span class="n">targets</span><span class="p">.</span><span class="nf">reshape</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">))</span>
    <span class="n">optimizer</span><span class="p">.</span><span class="nf">zero_grad</span><span class="p">(</span><span class="n">set_to_none</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">scaler</span><span class="p">.</span><span class="nf">scale</span><span class="p">(</span><span class="n">loss</span><span class="p">).</span><span class="nf">backward</span><span class="p">()</span>
    <span class="n">scaler</span><span class="p">.</span><span class="nf">unscale_</span><span class="p">(</span><span class="n">optimizer</span><span class="p">)</span>
    <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="n">utils</span><span class="p">.</span><span class="nf">clip_grad_norm_</span><span class="p">(</span><span class="n">chess_gpt</span><span class="p">.</span><span class="nf">parameters</span><span class="p">(),</span> <span class="mf">1.0</span><span class="p">)</span>
    <span class="n">scaler</span><span class="p">.</span><span class="nf">step</span><span class="p">(</span><span class="n">optimizer</span><span class="p">)</span>
    <span class="n">scaler</span><span class="p">.</span><span class="nf">update</span><span class="p">()</span>
    <span class="nf">if </span><span class="p">(</span><span class="n">step</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">%</span> <span class="n">EVAL_EVERY</span> <span class="o">==</span> <span class="mi">0</span> <span class="ow">or</span> <span class="n">step</span> <span class="o">+</span> <span class="mi">1</span> <span class="o">==</span> <span class="n">STEPS</span><span class="p">:</span>
        <span class="n">chess_gpt</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>
        <span class="n">shares</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="nf">score</span><span class="p">(</span><span class="k">lambda</span> <span class="n">position</span><span class="p">:</span> <span class="nf">chess_move</span><span class="p">(</span><span class="n">chess_gpt</span><span class="p">,</span> <span class="n">position</span><span class="p">),</span> <span class="n">quick_test</span><span class="p">)</span>
        <span class="n">chess_gpt</span><span class="p">.</span><span class="nf">train</span><span class="p">()</span>
        <span class="n">minutes</span> <span class="o">=</span> <span class="p">(</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="p">)</span> <span class="o">/</span> <span class="mi">60</span>
        <span class="n">curve</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">step</span><span class="sh">"</span><span class="p">:</span> <span class="n">step</span> <span class="o">+</span> <span class="mi">1</span><span class="p">,</span> <span class="sh">"</span><span class="s">minutes</span><span class="sh">"</span><span class="p">:</span> <span class="n">minutes</span><span class="p">,</span> <span class="sh">"</span><span class="s">loss</span><span class="sh">"</span><span class="p">:</span> <span class="n">loss</span><span class="p">.</span><span class="nf">item</span><span class="p">(),</span>
                      <span class="sh">"</span><span class="s">legal</span><span class="sh">"</span><span class="p">:</span> <span class="n">shares</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">legal</span><span class="sh">"</span><span class="p">,</span> <span class="mf">0.0</span><span class="p">)})</span>
        <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">step </span><span class="si">{</span><span class="n">step</span> <span class="o">+</span> <span class="mi">1</span><span class="si">:</span><span class="mi">5</span><span class="n">d</span><span class="si">}</span><span class="s">  </span><span class="si">{</span><span class="n">minutes</span><span class="si">:</span><span class="mf">5.1</span><span class="n">f</span><span class="si">}</span><span class="s"> min  loss </span><span class="si">{</span><span class="n">loss</span><span class="p">.</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">3</span><span class="n">f</span><span class="si">}</span><span class="s">  </span><span class="sh">"</span>
              <span class="sa">f</span><span class="sh">"</span><span class="s">legal moves </span><span class="si">{</span><span class="n">shares</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">'</span><span class="s">legal</span><span class="sh">'</span><span class="p">,</span> <span class="mf">0.0</span><span class="p">)</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="n">chess_gpt</span> <span class="o">=</span> <span class="n">chess_gpt</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>
</code></pre></div></div> <pre class="tfs-printed"><code>step   500    4.3 min  loss 0.789  legal moves 52.5%
step  1000    8.2 min  loss 0.611  legal moves 75.0%
step  1500   12.1 min  loss 0.559  legal moves 84.5%
step  2000   16.0 min  loss 0.530  legal moves 87.5%
step  2500   19.8 min  loss 0.482  legal moves 91.0%
step  3000   23.7 min  loss 0.460  legal moves 91.5%
step  3400   26.9 min  loss 0.447  legal moves 92.0%</code></pre> <p>Twenty-five minutes, 111 million characters, about one pass over the training games. After four minutes the model already finds a legal move in half the test positions, far more often than GPT-2 ever does; after twenty it levels off around nine in ten. Nobody told it what a knight is.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">curve</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">curve</span><span class="p">)</span>
<span class="n">fig</span><span class="p">,</span> <span class="p">(</span><span class="n">left</span><span class="p">,</span> <span class="n">right</span><span class="p">)</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">9.6</span><span class="p">,</span> <span class="mf">3.0</span><span class="p">))</span>
<span class="n">left</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">curve</span><span class="p">[</span><span class="sh">"</span><span class="s">minutes</span><span class="sh">"</span><span class="p">],</span> <span class="n">curve</span><span class="p">[</span><span class="sh">"</span><span class="s">loss</span><span class="sh">"</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">],</span> <span class="n">marker</span><span class="o">=</span><span class="sh">"</span><span class="s">o</span><span class="sh">"</span><span class="p">,</span> <span class="n">markersize</span><span class="o">=</span><span class="mi">3</span><span class="p">)</span>
<span class="n">left</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">minutes of training</span><span class="sh">"</span><span class="p">)</span>
<span class="n">left</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">loss per character</span><span class="sh">"</span><span class="p">)</span>
<span class="n">right</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">curve</span><span class="p">[</span><span class="sh">"</span><span class="s">minutes</span><span class="sh">"</span><span class="p">],</span> <span class="n">curve</span><span class="p">[</span><span class="sh">"</span><span class="s">legal</span><span class="sh">"</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">],</span> <span class="n">marker</span><span class="o">=</span><span class="sh">"</span><span class="s">o</span><span class="sh">"</span><span class="p">,</span> <span class="n">markersize</span><span class="o">=</span><span class="mi">3</span><span class="p">,</span>
           <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">our chess GPT</span><span class="sh">"</span><span class="p">)</span>
<span class="n">right</span><span class="p">.</span><span class="nf">axhline</span><span class="p">(</span><span class="n">gpt2_shares</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">legal</span><span class="sh">"</span><span class="p">,</span> <span class="mf">0.0</span><span class="p">),</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">],</span> <span class="n">linestyle</span><span class="o">=</span><span class="sh">"</span><span class="s">--</span><span class="sh">"</span><span class="p">,</span>
              <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">GPT-2</span><span class="sh">"</span><span class="p">)</span>
<span class="n">right</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">minutes of training</span><span class="sh">"</span><span class="p">)</span>
<span class="n">right</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">legal moves, 200 positions</span><span class="sh">"</span><span class="p">)</span>
<span class="n">right</span><span class="p">.</span><span class="nf">set_ylim</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
<span class="n">right</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">loc</span><span class="o">=</span><span class="sh">"</span><span class="s">lower right</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">tight_layout</span><span class="p">()</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/04/output-06.png" alt="Output of the code above" loading="lazy"></p> <h2 id="10-does-it-play-chess">10. Does it play chess?</h2> <p>The full test, on the same 1,000 positions GPT-2 got, written in our model’s format:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">chess_shares</span><span class="p">,</span> <span class="n">chess_same</span> <span class="o">=</span> <span class="nf">score</span><span class="p">(</span><span class="k">lambda</span> <span class="n">p</span><span class="p">:</span> <span class="nf">chess_move</span><span class="p">(</span><span class="n">chess_gpt</span><span class="p">,</span> <span class="n">p</span><span class="p">),</span> <span class="n">positions</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">our chess GPT: </span><span class="si">{</span><span class="n">chess_shares</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">'</span><span class="s">legal</span><span class="sh">'</span><span class="p">,</span> <span class="mf">0.0</span><span class="p">)</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="s"> legal moves, </span><span class="sh">"</span>
      <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">chess_same</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="s"> the same move as the player</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>our chess GPT: 89.5% legal moves, 32.5% the same move as the player</code></pre> <p>Nine moves in ten are legal. And one move in three is the move the human actually played, in positions with some thirty legal options: the model has learned not only the rules, but how players rated 1800 like to play.</p> <p>What would more training buy? Karvonen published the models of his paper on the Hugging Face Hub under the MIT license, and his 8-layer model is ours to the letter: 8 layers, 512 wide, 8 heads, the same 32 characters.</p> <p>It was trained with <a href="https://github.com/karpathy/nanoGPT">nanoGPT</a> on 16 million Lichess games, and “took 72 hours to train on one RTX 3090 GPU”. Our class can run it, after one more transplant.</p> <p>Three things differ from GPT-2’s checkpoint: nanoGPT’s linear layers are <code class="language-plaintext highlighter-rouge">nn.Linear</code>, so nothing is transposed; they have no biases, so ours are set to zero, which computes the same function; and nanoGPT uses the exact GELU, which goes into the config.</p> <div class="callout callout-warn"> <p class="callout-label">Trap</p> <p>The file is a PyTorch checkpoint, which is a pickle, and unpickling can run any code the file contains. <code class="language-plaintext highlighter-rouge">weights_only=True</code> makes <code class="language-plaintext highlighter-rouge">torch.load</code> refuse everything but tensors and plain values; never load a checkpoint from the internet without it.</p> </div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">path</span> <span class="o">=</span> <span class="nf">hf_hub_download</span><span class="p">(</span><span class="sh">"</span><span class="s">adamkarvonen/chess_llms</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">lichess_8layers_ckpt_no_optimizer.pt</span><span class="sh">"</span><span class="p">)</span>
<span class="n">checkpoint</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">path</span><span class="p">,</span> <span class="n">map_location</span><span class="o">=</span><span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span><span class="p">,</span> <span class="n">weights_only</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">args</span> <span class="o">=</span> <span class="n">checkpoint</span><span class="p">[</span><span class="sh">"</span><span class="s">model_args</span><span class="sh">"</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="n">args</span><span class="p">)</span>
<span class="n">seen</span> <span class="o">=</span> <span class="n">checkpoint</span><span class="p">[</span><span class="sh">"</span><span class="s">iter_num</span><span class="sh">"</span><span class="p">]</span> <span class="o">*</span> <span class="n">checkpoint</span><span class="p">[</span><span class="sh">"</span><span class="s">config</span><span class="sh">"</span><span class="p">][</span><span class="sh">"</span><span class="s">batch_size</span><span class="sh">"</span><span class="p">]</span> <span class="o">*</span> <span class="n">args</span><span class="p">[</span><span class="sh">"</span><span class="s">block_size</span><span class="sh">"</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">characters seen in training: </span><span class="si">{</span><span class="n">seen</span> <span class="o">/</span> <span class="mf">1e9</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> billion; </span><span class="sh">"</span>
      <span class="sa">f</span><span class="sh">"</span><span class="s">ours: </span><span class="si">{</span><span class="n">STEPS</span> <span class="o">*</span> <span class="n">BATCH</span> <span class="o">*</span> <span class="n">CONTEXT</span> <span class="o">/</span> <span class="mf">1e6</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> million</span><span class="sh">"</span><span class="p">)</span>

<span class="k">assert</span> <span class="sh">""</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">VOCAB</span><span class="p">)</span> <span class="o">==</span> <span class="sh">"</span><span class="s"> #+-.0123456789;=BKNOQRabcdefghx</span><span class="sh">"</span>  <span class="c1"># his alphabet, in his order
</span><span class="n">karvonen_config</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">:</span> <span class="n">args</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="sh">"</span><span class="s">n_positions</span><span class="sh">"</span><span class="p">:</span> <span class="n">args</span><span class="p">[</span><span class="sh">"</span><span class="s">block_size</span><span class="sh">"</span><span class="p">],</span>
                   <span class="sh">"</span><span class="s">n_embd</span><span class="sh">"</span><span class="p">:</span> <span class="n">args</span><span class="p">[</span><span class="sh">"</span><span class="s">n_embd</span><span class="sh">"</span><span class="p">],</span> <span class="sh">"</span><span class="s">n_head</span><span class="sh">"</span><span class="p">:</span> <span class="n">args</span><span class="p">[</span><span class="sh">"</span><span class="s">n_head</span><span class="sh">"</span><span class="p">],</span>
                   <span class="sh">"</span><span class="s">n_layer</span><span class="sh">"</span><span class="p">:</span> <span class="n">args</span><span class="p">[</span><span class="sh">"</span><span class="s">n_layer</span><span class="sh">"</span><span class="p">],</span> <span class="sh">"</span><span class="s">layer_norm_epsilon</span><span class="sh">"</span><span class="p">:</span> <span class="mf">1e-5</span><span class="p">,</span>
                   <span class="sh">"</span><span class="s">activation_function</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">gelu</span><span class="sh">"</span><span class="p">}</span>  <span class="c1"># the exact GELU
</span><span class="n">weights</span> <span class="o">=</span> <span class="n">checkpoint</span><span class="p">[</span><span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">]</span>
<span class="n">karvonen</span> <span class="o">=</span> <span class="nc">GPT</span><span class="p">(</span><span class="n">karvonen_config</span><span class="p">)</span>
<span class="n">state</span> <span class="o">=</span> <span class="n">karvonen</span><span class="p">.</span><span class="nf">state_dict</span><span class="p">()</span>
<span class="n">zeroed</span> <span class="o">=</span> <span class="mi">0</span>
<span class="k">for</span> <span class="n">ours</span><span class="p">,</span> <span class="n">theirs</span> <span class="ow">in</span> <span class="nf">openai_names</span><span class="p">(</span><span class="n">karvonen_config</span><span class="p">).</span><span class="nf">items</span><span class="p">():</span>
    <span class="n">key</span> <span class="o">=</span> <span class="sh">"</span><span class="s">_orig_mod.transformer.</span><span class="sh">"</span> <span class="o">+</span> <span class="n">theirs</span>  <span class="c1"># torch.compile added "_orig_mod."
</span>    <span class="k">if</span> <span class="n">key</span> <span class="ow">in</span> <span class="n">weights</span><span class="p">:</span>
        <span class="n">state</span><span class="p">[</span><span class="n">ours</span><span class="p">]</span> <span class="o">=</span> <span class="n">weights</span><span class="p">[</span><span class="n">key</span><span class="p">]</span>
    <span class="k">else</span><span class="p">:</span>  <span class="c1"># trained without biases: a zero bias is the same thing
</span>        <span class="n">state</span><span class="p">[</span><span class="n">ours</span><span class="p">]</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros_like</span><span class="p">(</span><span class="n">state</span><span class="p">[</span><span class="n">ours</span><span class="p">])</span>
        <span class="n">zeroed</span> <span class="o">+=</span> <span class="mi">1</span>
<span class="n">karvonen</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">(</span><span class="n">state</span><span class="p">,</span> <span class="n">strict</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">karvonen</span> <span class="o">=</span> <span class="n">karvonen</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="n">output_layer</span> <span class="o">=</span> <span class="n">weights</span><span class="p">[</span><span class="sh">"</span><span class="s">_orig_mod.lm_head.weight</span><span class="sh">"</span><span class="p">]</span>
<span class="n">tied</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">equal</span><span class="p">(</span><span class="n">output_layer</span><span class="p">,</span> <span class="n">weights</span><span class="p">[</span><span class="sh">"</span><span class="s">_orig_mod.transformer.wte.weight</span><span class="sh">"</span><span class="p">])</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">weights</span><span class="p">)</span><span class="si">}</span><span class="s"> tensors in the file; </span><span class="si">{</span><span class="n">zeroed</span><span class="si">}</span><span class="s"> biases of ours set to zero; </span><span class="sh">"</span>
      <span class="sa">f</span><span class="sh">"</span><span class="s">output layer tied to the embeddings: </span><span class="si">{</span><span class="n">tied</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>{'n_layer': 8, 'n_head': 8, 'n_embd': 512, 'block_size': 1023, 'bias': False, 'vocab_size': 32, 'dropout': 0.0}
characters seen in training: 61 billion; ours: 111 million
52 tensors in the file; 49 biases of ours set to zero; output layer tied to the embeddings: True</code></pre> <p>The same test for all three:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">karvonen_shares</span><span class="p">,</span> <span class="n">karvonen_same</span> <span class="o">=</span> <span class="nf">score</span><span class="p">(</span><span class="k">lambda</span> <span class="n">p</span><span class="p">:</span> <span class="nf">chess_move</span><span class="p">(</span><span class="n">karvonen</span><span class="p">,</span> <span class="n">p</span><span class="p">),</span> <span class="n">positions</span><span class="p">)</span>
<span class="n">verdicts</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">legal</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">leaves the king in check</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">no piece can do that</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">ambiguous</span><span class="sh">"</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">not a move</span><span class="sh">"</span><span class="p">]</span>
<span class="n">by_model</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">GPT-2, 124M</span><span class="sh">"</span><span class="p">:</span> <span class="n">gpt2_shares</span><span class="p">,</span> <span class="sh">"</span><span class="s">ours, 25 minutes</span><span class="sh">"</span><span class="p">:</span> <span class="n">chess_shares</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">Karvonen</span><span class="sh">'</span><span class="s">s, 72 hours</span><span class="sh">"</span><span class="p">:</span> <span class="n">karvonen_shares</span><span class="p">}</span>
<span class="n">comparison</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">({</span><span class="sh">"</span><span class="s">verdict</span><span class="sh">"</span><span class="p">:</span> <span class="n">verdicts</span><span class="p">})</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">shares</span> <span class="ow">in</span> <span class="n">by_model</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
    <span class="n">comparison</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="o">=</span> <span class="p">[</span><span class="n">shares</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="n">verdict</span><span class="p">,</span> <span class="mf">0.0</span><span class="p">)</span> <span class="k">for</span> <span class="n">verdict</span> <span class="ow">in</span> <span class="n">verdicts</span><span class="p">]</span>
<span class="nf">display</span><span class="p">(</span><span class="nf">table</span><span class="p">(</span><span class="n">comparison</span><span class="p">,</span> <span class="n">digits</span><span class="o">=</span><span class="mi">3</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">the move the player actually made: GPT-2 </span><span class="si">{</span><span class="n">gpt2_same</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="s">, ours </span><span class="si">{</span><span class="n">chess_same</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="s">, </span><span class="sh">"</span>
      <span class="sa">f</span><span class="sh">"</span><span class="s">Karvonen</span><span class="sh">'</span><span class="s">s </span><span class="si">{</span><span class="n">karvonen_same</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">verdict</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">GPT-2, 124M</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">ours, 25 minutes</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">Karvonen's, 72 hours</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">legal</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.278</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.895</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.996</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">leaves the king in check</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.014</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.009</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.001</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">no piece can do that</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.682</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.088</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.002</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">ambiguous</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.005</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.008</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.000</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">not a move</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.021</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.000</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.001</td></tr></tbody></table></div> <pre class="tfs-printed"><code>the move the player actually made: GPT-2 3.2%, ours 32.5%, Karvonen's 52.1%</code></pre> <p>Karvonen’s model makes a legal move in 99.6% of the positions and the player’s own move in more than half of them. Ours, with the same architecture and 550 times less training, is legal 89.5% of the time, and almost all of its mistakes are moves that no piece can make. What it lacks is the board, not the notation.</p> <p class="takeaway">The same 25 million parameters, 550 times more training: from nine legal moves in ten to all but a few in a thousand.</p> <p>A legal move in a position from a human game is one thing; a whole game is harder, because the model’s own moves build the position it has to understand. Each model plays White against an opponent that picks a random legal move.</p> <p>When a model proposes an illegal move, it gets four more tries, sampled instead of greedy; after five failures it forfeits. A game that outgrows the model’s context is stopped as unfinished, and so is one that reaches 150 half-moves.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">play_against_random</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">seed</span><span class="p">,</span> <span class="n">max_moves</span><span class="o">=</span><span class="mi">150</span><span class="p">):</span>
    <span class="n">rng</span> <span class="o">=</span> <span class="n">random</span><span class="p">.</span><span class="nc">Random</span><span class="p">(</span><span class="n">seed</span><span class="p">)</span>
    <span class="n">generator</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nc">Generator</span><span class="p">(</span><span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">).</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">seed</span><span class="p">)</span>
    <span class="n">limit</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="n">positions</span><span class="p">.</span><span class="n">num_embeddings</span>  <span class="c1"># the model's context
</span>    <span class="n">board</span> <span class="o">=</span> <span class="n">chess</span><span class="p">.</span><span class="nc">Board</span><span class="p">()</span>
    <span class="n">moves</span><span class="p">,</span> <span class="n">illegal</span> <span class="o">=</span> <span class="p">[],</span> <span class="mi">0</span>
    <span class="k">while</span> <span class="ow">not</span> <span class="n">board</span><span class="p">.</span><span class="nf">is_game_over</span><span class="p">()</span> <span class="ow">and</span> <span class="nf">len</span><span class="p">(</span><span class="n">moves</span><span class="p">)</span> <span class="o">&lt;</span> <span class="n">max_moves</span><span class="p">:</span>
        <span class="k">if</span> <span class="n">board</span><span class="p">.</span><span class="n">turn</span> <span class="o">==</span> <span class="n">chess</span><span class="p">.</span><span class="n">WHITE</span><span class="p">:</span>
            <span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="nf">prompt_for</span><span class="p">(</span><span class="n">moves</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">moves</span><span class="p">),</span> <span class="n">spaced</span><span class="o">=</span><span class="bp">False</span><span class="p">))</span> <span class="o">&gt;</span> <span class="n">limit</span> <span class="o">-</span> <span class="mi">10</span><span class="p">:</span>
                <span class="k">return</span> <span class="sh">"</span><span class="s">unfinished</span><span class="sh">"</span><span class="p">,</span> <span class="n">moves</span><span class="p">,</span> <span class="n">illegal</span>
            <span class="n">position</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">moves</span><span class="sh">"</span><span class="p">:</span> <span class="n">moves</span><span class="p">,</span> <span class="sh">"</span><span class="s">upto</span><span class="sh">"</span><span class="p">:</span> <span class="nf">len</span><span class="p">(</span><span class="n">moves</span><span class="p">)}</span>
            <span class="n">move</span> <span class="o">=</span> <span class="bp">None</span>
            <span class="k">for</span> <span class="n">attempt</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">5</span><span class="p">):</span>
                <span class="n">candidate</span> <span class="o">=</span> <span class="nf">chess_move</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">position</span><span class="p">,</span> <span class="n">generator</span> <span class="k">if</span> <span class="n">attempt</span> <span class="o">&gt;</span> <span class="mi">0</span> <span class="k">else</span> <span class="bp">None</span><span class="p">)</span>
                <span class="k">if</span> <span class="nf">judge</span><span class="p">(</span><span class="n">board</span><span class="p">,</span> <span class="n">candidate</span><span class="p">)</span> <span class="o">==</span> <span class="sh">"</span><span class="s">legal</span><span class="sh">"</span><span class="p">:</span>
                    <span class="n">move</span> <span class="o">=</span> <span class="n">candidate</span>
                    <span class="k">break</span>
                <span class="n">illegal</span> <span class="o">+=</span> <span class="mi">1</span>
            <span class="k">if</span> <span class="n">move</span> <span class="ow">is</span> <span class="bp">None</span><span class="p">:</span>
                <span class="k">return</span> <span class="sh">"</span><span class="s">forfeit</span><span class="sh">"</span><span class="p">,</span> <span class="n">moves</span><span class="p">,</span> <span class="n">illegal</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="n">move</span> <span class="o">=</span> <span class="n">board</span><span class="p">.</span><span class="nf">san</span><span class="p">(</span><span class="n">rng</span><span class="p">.</span><span class="nf">choice</span><span class="p">(</span><span class="nf">list</span><span class="p">(</span><span class="n">board</span><span class="p">.</span><span class="n">legal_moves</span><span class="p">)))</span>
        <span class="n">move</span> <span class="o">=</span> <span class="n">board</span><span class="p">.</span><span class="nf">san</span><span class="p">(</span><span class="n">board</span><span class="p">.</span><span class="nf">parse_san</span><span class="p">(</span><span class="n">move</span><span class="p">))</span>  <span class="c1"># the standard spelling, + where it checks
</span>        <span class="n">board</span><span class="p">.</span><span class="nf">push_san</span><span class="p">(</span><span class="n">move</span><span class="p">)</span>
        <span class="n">moves</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">move</span><span class="p">)</span>
    <span class="k">if</span> <span class="ow">not</span> <span class="n">board</span><span class="p">.</span><span class="nf">is_game_over</span><span class="p">():</span>
        <span class="k">return</span> <span class="sh">"</span><span class="s">unfinished</span><span class="sh">"</span><span class="p">,</span> <span class="n">moves</span><span class="p">,</span> <span class="n">illegal</span>
    <span class="k">return</span> <span class="n">board</span><span class="p">.</span><span class="nf">result</span><span class="p">(),</span> <span class="n">moves</span><span class="p">,</span> <span class="n">illegal</span>


<span class="n">played</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">model</span> <span class="ow">in</span> <span class="p">[(</span><span class="sh">"</span><span class="s">ours, 25 minutes</span><span class="sh">"</span><span class="p">,</span> <span class="n">chess_gpt</span><span class="p">),</span> <span class="p">(</span><span class="sh">"</span><span class="s">Karvonen</span><span class="sh">'</span><span class="s">s, 72 hours</span><span class="sh">"</span><span class="p">,</span> <span class="n">karvonen</span><span class="p">)]:</span>
    <span class="k">for</span> <span class="n">seed</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">10</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">100</span><span class="p">):</span>
        <span class="n">result</span><span class="p">,</span> <span class="n">moves</span><span class="p">,</span> <span class="n">illegal</span> <span class="o">=</span> <span class="nf">play_against_random</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">seed</span><span class="p">)</span>
        <span class="n">played</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span> <span class="sh">"</span><span class="s">result</span><span class="sh">"</span><span class="p">:</span> <span class="n">result</span><span class="p">,</span> <span class="sh">"</span><span class="s">half-moves</span><span class="sh">"</span><span class="p">:</span> <span class="nf">len</span><span class="p">(</span><span class="n">moves</span><span class="p">),</span>
                       <span class="sh">"</span><span class="s">illegal tries</span><span class="sh">"</span><span class="p">:</span> <span class="n">illegal</span><span class="p">,</span> <span class="sh">"</span><span class="s">game</span><span class="sh">"</span><span class="p">:</span> <span class="n">moves</span><span class="p">})</span>
<span class="n">played</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">played</span><span class="p">)</span>
<span class="n">outcomes</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nf">crosstab</span><span class="p">(</span><span class="n">played</span><span class="p">[</span><span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">],</span> <span class="n">played</span><span class="p">[</span><span class="sh">"</span><span class="s">result</span><span class="sh">"</span><span class="p">])</span>
<span class="n">outcomes</span><span class="p">[</span><span class="sh">"</span><span class="s">illegal tries per game</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">played</span><span class="p">.</span><span class="nf">groupby</span><span class="p">(</span><span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">)[</span><span class="sh">"</span><span class="s">illegal tries</span><span class="sh">"</span><span class="p">].</span><span class="nf">mean</span><span class="p">()</span>
<span class="nf">table</span><span class="p">(</span><span class="n">outcomes</span><span class="p">.</span><span class="nf">reset_index</span><span class="p">())</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">model</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">1-0</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">1/2-1/2</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">forfeit</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">unfinished</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">illegal tries per game</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Karvonen's, 72 hours</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">74</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">18</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.00</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">ours, 25 minutes</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">49</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">42</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">13.95</td></tr></tbody></table></div> <p>Here the gap becomes a canyon. Karvonen’s model mates the random opponent in 74 games of 100 and draws 18. Ours forfeits about half of its games, five illegal moves in a row, and most of the rest run out of its context before anyone wins.</p> <p>The likely reason is the opponent. A random player builds positions that no 1800-rated human would allow, with pieces hanging and kings wandering, and our model has never seen anything like them: its 89.5% on human positions owed a good deal to the habits of human games.</p> <p>Karvonen’s model has read 61 billion characters, enough to keep its bearings when the game leaves the map. Carlini noticed the same in gpt-3.5-turbo-instruct: given an implausible history that reaches the same position, “it’s only half as good!”</p> <p>The shortest win of the lot, and where it ended:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># White in capitals, Black in small letters; class 0 is an empty square
</span><span class="n">PIECES</span> <span class="o">=</span> <span class="sh">"</span><span class="s">PNBRQKpnbrqk</span><span class="sh">"</span>


<span class="k">def</span> <span class="nf">board_classes</span><span class="p">(</span><span class="n">board</span><span class="p">):</span>
    <span class="n">classes</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="mi">64</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">np</span><span class="p">.</span><span class="n">int64</span><span class="p">)</span>  <span class="c1"># square 0 is a1, 7 is h1, 63 is h8
</span>    <span class="k">for</span> <span class="n">square</span><span class="p">,</span> <span class="n">piece</span> <span class="ow">in</span> <span class="n">board</span><span class="p">.</span><span class="nf">piece_map</span><span class="p">().</span><span class="nf">items</span><span class="p">():</span>
        <span class="n">classes</span><span class="p">[</span><span class="n">square</span><span class="p">]</span> <span class="o">=</span> <span class="mi">1</span> <span class="o">+</span> <span class="n">PIECES</span><span class="p">.</span><span class="nf">index</span><span class="p">(</span><span class="n">piece</span><span class="p">.</span><span class="nf">symbol</span><span class="p">())</span>
    <span class="k">return</span> <span class="n">classes</span>


<span class="k">def</span> <span class="nf">draw_board</span><span class="p">(</span><span class="n">ax</span><span class="p">,</span> <span class="n">classes</span><span class="p">,</span> <span class="n">title</span><span class="p">,</span> <span class="n">truth</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
    <span class="k">for</span> <span class="n">square</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">64</span><span class="p">):</span>
        <span class="nb">file</span><span class="p">,</span> <span class="n">rank</span> <span class="o">=</span> <span class="n">square</span> <span class="o">%</span> <span class="mi">8</span><span class="p">,</span> <span class="n">square</span> <span class="o">//</span> <span class="mi">8</span>
        <span class="n">light</span> <span class="o">=</span> <span class="p">(</span><span class="nb">file</span> <span class="o">+</span> <span class="n">rank</span><span class="p">)</span> <span class="o">%</span> <span class="mi">2</span> <span class="o">==</span> <span class="mi">1</span>
        <span class="n">color</span> <span class="o">=</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">card</span><span class="sh">"</span><span class="p">]</span> <span class="k">if</span> <span class="n">light</span> <span class="k">else</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">grid</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">ax</span><span class="p">.</span><span class="nf">add_patch</span><span class="p">(</span><span class="n">plt</span><span class="p">.</span><span class="nc">Rectangle</span><span class="p">((</span><span class="nb">file</span><span class="p">,</span> <span class="n">rank</span><span class="p">),</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">))</span>
        <span class="k">if</span> <span class="n">truth</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span> <span class="ow">and</span> <span class="n">classes</span><span class="p">[</span><span class="n">square</span><span class="p">]</span> <span class="o">!=</span> <span class="n">truth</span><span class="p">[</span><span class="n">square</span><span class="p">]:</span>
            <span class="n">ax</span><span class="p">.</span><span class="nf">add_patch</span><span class="p">(</span><span class="n">plt</span><span class="p">.</span><span class="nc">Rectangle</span><span class="p">((</span><span class="nb">file</span> <span class="o">+</span> <span class="mf">0.04</span><span class="p">,</span> <span class="n">rank</span> <span class="o">+</span> <span class="mf">0.04</span><span class="p">),</span> <span class="mf">0.92</span><span class="p">,</span> <span class="mf">0.92</span><span class="p">,</span> <span class="n">fill</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span>
                                       <span class="n">edgecolor</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">],</span> <span class="n">linewidth</span><span class="o">=</span><span class="mi">2</span><span class="p">))</span>
        <span class="k">if</span> <span class="n">classes</span><span class="p">[</span><span class="n">square</span><span class="p">]</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">:</span>
            <span class="n">piece</span> <span class="o">=</span> <span class="n">PIECES</span><span class="p">[</span><span class="n">classes</span><span class="p">[</span><span class="n">square</span><span class="p">]</span> <span class="o">-</span> <span class="mi">1</span><span class="p">]</span>
            <span class="n">ax</span><span class="p">.</span><span class="nf">text</span><span class="p">(</span><span class="nb">file</span> <span class="o">+</span> <span class="mf">0.5</span><span class="p">,</span> <span class="n">rank</span> <span class="o">+</span> <span class="mf">0.47</span><span class="p">,</span> <span class="n">piece</span><span class="p">,</span> <span class="n">ha</span><span class="o">=</span><span class="sh">"</span><span class="s">center</span><span class="sh">"</span><span class="p">,</span> <span class="n">va</span><span class="o">=</span><span class="sh">"</span><span class="s">center</span><span class="sh">"</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">13</span><span class="p">,</span>
                    <span class="n">weight</span><span class="o">=</span><span class="sh">"</span><span class="s">bold</span><span class="sh">"</span><span class="p">,</span> <span class="n">family</span><span class="o">=</span><span class="sh">"</span><span class="s">monospace</span><span class="sh">"</span><span class="p">,</span>
                    <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">ink</span><span class="sh">"</span><span class="p">]</span> <span class="k">if</span> <span class="n">piece</span><span class="p">.</span><span class="nf">isupper</span><span class="p">()</span> <span class="k">else</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">])</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_xlim</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">8</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_ylim</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">8</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_xticks</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="mi">8</span><span class="p">)</span> <span class="o">+</span> <span class="mf">0.5</span><span class="p">,</span> <span class="nf">list</span><span class="p">(</span><span class="sh">"</span><span class="s">abcdefgh</span><span class="sh">"</span><span class="p">))</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_yticks</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="mi">8</span><span class="p">)</span> <span class="o">+</span> <span class="mf">0.5</span><span class="p">,</span> <span class="nf">range</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">9</span><span class="p">))</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">tick_params</span><span class="p">(</span><span class="n">length</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_aspect</span><span class="p">(</span><span class="sh">"</span><span class="s">equal</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">grid</span><span class="p">(</span><span class="bp">False</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="n">title</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">10</span><span class="p">)</span>


<span class="n">wins</span> <span class="o">=</span> <span class="n">played</span><span class="p">[</span><span class="n">played</span><span class="p">[</span><span class="sh">"</span><span class="s">result</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="sh">"</span><span class="s">1-0</span><span class="sh">"</span><span class="p">]</span>
<span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="n">wins</span><span class="p">):</span>
    <span class="n">shortest</span> <span class="o">=</span> <span class="n">wins</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">wins</span><span class="p">[</span><span class="sh">"</span><span class="s">half-moves</span><span class="sh">"</span><span class="p">].</span><span class="nf">idxmin</span><span class="p">()]</span>
    <span class="n">game</span> <span class="o">=</span> <span class="n">shortest</span><span class="p">[</span><span class="sh">"</span><span class="s">game</span><span class="sh">"</span><span class="p">]</span>
    <span class="nf">print</span><span class="p">(</span><span class="n">shortest</span><span class="p">[</span><span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">]</span> <span class="o">+</span> <span class="sh">"</span><span class="s">:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">prompt_for</span><span class="p">(</span><span class="n">game</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">game</span><span class="p">),</span> <span class="n">spaced</span><span class="o">=</span><span class="bp">True</span><span class="p">).</span><span class="nf">strip</span><span class="p">())</span>
    <span class="n">board</span> <span class="o">=</span> <span class="n">chess</span><span class="p">.</span><span class="nc">Board</span><span class="p">()</span>
    <span class="k">for</span> <span class="n">move</span> <span class="ow">in</span> <span class="n">game</span><span class="p">:</span>
        <span class="n">board</span><span class="p">.</span><span class="nf">push_san</span><span class="p">(</span><span class="n">move</span><span class="p">)</span>
    <span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">3.2</span><span class="p">,</span> <span class="mf">3.4</span><span class="p">))</span>
    <span class="nf">draw_board</span><span class="p">(</span><span class="n">ax</span><span class="p">,</span> <span class="nf">board_classes</span><span class="p">(</span><span class="n">board</span><span class="p">),</span> <span class="sa">f</span><span class="sh">"</span><span class="s">after </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">game</span><span class="p">)</span><span class="si">}</span><span class="s"> half-moves: checkmate</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <pre class="tfs-printed"><code>Karvonen's, 72 hours: 1. e4 f5 2. exf5 a6 3. Qh5+ g6 4. fxg6 Nc6 5. g7#</code></pre> <p><img class="tfs-output" src="/assets/posts/arch/04/output-07.png" alt="Output of the code above" loading="lazy"></p> <h2 id="11-where-is-the-board">11. Where is the board?</h2> <p>The model writes legal moves most of the time, and a legal move depends on where every piece stands. Nothing in its input says where they stand: the text lists moves, and a square is mentioned only when a piece goes there.</p> <p>To get <code class="language-plaintext highlighter-rouge">Nc6</code> right after twenty moves, the model has to have kept track of which knight is where and which squares are free. Does it keep a board somewhere, or has it found some other trick?</p> <p>The question has a history. In 2022 Kenneth Li and colleagues trained an 8-layer GPT on the moves of Othello, a game with “a vocabulary of 60 words”, and asked whether it kept the board <sup class="cite">[<a href="#ref-15" id="cite-15" data-ref="15" aria-label="Reference 15: Li, K., Hopkins, A. K., Bau, D., Viégas, F., Pfister, H., &amp; Wattenberg, M. (2023). Emergent world representations: exploring a sequence model trained on a synthetic task. ICLR 2023.">15</a>]</sup>.</p> <p>Linear probes failed: their error rates “never dip below 20%”, and the paper concluded the board was there in a nonlinear form.</p> <p>A year later Neel Nanda and colleagues found that the board was linear after all, once you ask the right question: the model doesn’t store squares as black and white, but “relative to the current player of each timestep (MINE, YOURS, EMPTY)”, and a linear probe for that reads it at 99.6%<sup class="cite">[<a href="#ref-16" id="cite-16" data-ref="16" aria-label="Reference 16: Nanda, N., Lee, A., &amp; Wattenberg, M. (2023). Emergent linear representations in world models of self-supervised sequence models. BlackboxNLP 2023.">16</a>]</sup>.</p> <p>Adam Karvonen then did the same for chess, with a model like ours trained for 72 hours on 16 million Lichess games, and read the board at 99.1% in its 8-layer model<sup class="cite">[<a href="#ref-14" id="cite-17" data-ref="14" aria-label="Reference 14: Karvonen, A. (2024). Emergent world models and latent variable estimation in chess-playing language models. COLM 2024.">14</a>]</sup>. Ours trained for 25 minutes.</p> <p>A <em>linear probe</em> is the simplest way to ask. Take the residual stream after some layer at a position in the game, a vector \(h \in \mathbb{R}^{512}\), and train a linear map \(W h + b\) to predict, for every one of the 64 squares, which of 13 things stands on it: nothing, or one of the six White or six Black pieces.</p> <p>If a linear map can read the board off the stream, the board is <em>there</em>, in the plainest form a network can hold anything: as directions in its space<sup class="cite">[<a href="#ref-17" id="cite-18" data-ref="17" aria-label="Reference 17: Alain, G., &amp; Bengio, Y. (2016). Understanding intermediate layers using linear classifier probes. arXiv:1610.01644.">17</a>]</sup>. The probe is trained on states of the frozen model; the model’s weights don’t move.</p> <p>We read the stream at the dot after each move number, where White is about to move, from games the model never trained on.</p> <p>At that moment “mine” is always White, so the two ways of labelling the board coincide. The same probe trained on an untrained model with the same architecture is the control: whatever it reads comes from the input itself, not from anything the model learned.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">residual_states</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">games</span><span class="p">):</span>
    <span class="n">features</span> <span class="o">=</span> <span class="p">[[]</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="n">blocks</span><span class="p">)</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)]</span>
    <span class="n">labels</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">game</span> <span class="ow">in</span> <span class="n">games</span><span class="p">:</span>
        <span class="n">board</span> <span class="o">=</span> <span class="n">chess</span><span class="p">.</span><span class="nc">Board</span><span class="p">()</span>
        <span class="n">text</span><span class="p">,</span> <span class="n">dots</span><span class="p">,</span> <span class="n">boards</span> <span class="o">=</span> <span class="sh">"</span><span class="s">;</span><span class="sh">"</span><span class="p">,</span> <span class="p">[],</span> <span class="p">[]</span>
        <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">move</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="nf">moves_of</span><span class="p">(</span><span class="n">game</span><span class="p">)):</span>
            <span class="k">if</span> <span class="n">i</span> <span class="o">%</span> <span class="mi">2</span> <span class="o">==</span> <span class="mi">0</span><span class="p">:</span>
                <span class="n">text</span> <span class="o">+=</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">i</span> <span class="o">//</span> <span class="mi">2</span> <span class="o">+</span> <span class="mi">1</span><span class="si">}</span><span class="s">.</span><span class="sh">"</span>
                <span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="n">text</span><span class="p">)</span> <span class="o">&gt;</span> <span class="n">CONTEXT</span><span class="p">:</span>
                    <span class="k">break</span>
                <span class="n">dots</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">text</span><span class="p">)</span> <span class="o">-</span> <span class="mi">1</span><span class="p">)</span>  <span class="c1"># the dot: White is about to move
</span>                <span class="n">boards</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="nf">board_classes</span><span class="p">(</span><span class="n">board</span><span class="p">))</span>
            <span class="n">text</span> <span class="o">+=</span> <span class="n">move</span> <span class="o">+</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span>
            <span class="n">board</span><span class="p">.</span><span class="nf">push_san</span><span class="p">(</span><span class="n">move</span><span class="p">)</span>
        <span class="n">ids</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">([[</span><span class="n">stoi</span><span class="p">[</span><span class="n">char</span><span class="p">]</span> <span class="k">for</span> <span class="n">char</span> <span class="ow">in</span> <span class="n">text</span><span class="p">[:</span><span class="n">CONTEXT</span><span class="p">]]],</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
        <span class="n">_</span><span class="p">,</span> <span class="n">states</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">keep_states</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
        <span class="k">for</span> <span class="n">layer</span><span class="p">,</span> <span class="n">state</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">states</span><span class="p">):</span>
            <span class="n">features</span><span class="p">[</span><span class="n">layer</span><span class="p">].</span><span class="nf">append</span><span class="p">(</span><span class="n">state</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="n">dots</span><span class="p">].</span><span class="nf">float</span><span class="p">().</span><span class="nf">cpu</span><span class="p">())</span>
        <span class="n">labels</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">from_numpy</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">stack</span><span class="p">(</span><span class="n">boards</span><span class="p">)))</span>
    <span class="k">return</span> <span class="p">[</span><span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">(</span><span class="n">layer</span><span class="p">)</span> <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">features</span><span class="p">],</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">(</span><span class="n">labels</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">train_probe</span><span class="p">(</span><span class="n">features</span><span class="p">,</span> <span class="n">labels</span><span class="p">,</span> <span class="n">epochs</span><span class="o">=</span><span class="mi">12</span><span class="p">):</span>
    <span class="n">mean</span><span class="p">,</span> <span class="n">std</span> <span class="o">=</span> <span class="n">features</span><span class="p">.</span><span class="nf">mean</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="mi">0</span><span class="p">),</span> <span class="n">features</span><span class="p">.</span><span class="nf">std</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span> <span class="o">+</span> <span class="mf">1e-5</span>  <span class="c1"># standardised features
</span>    <span class="n">x</span><span class="p">,</span> <span class="n">y</span> <span class="o">=</span> <span class="p">((</span><span class="n">features</span> <span class="o">-</span> <span class="n">mean</span><span class="p">)</span> <span class="o">/</span> <span class="n">std</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">),</span> <span class="n">labels</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="n">probe</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">features</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="mi">64</span> <span class="o">*</span> <span class="mi">13</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="n">optimizer</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">optim</span><span class="p">.</span><span class="nc">AdamW</span><span class="p">(</span><span class="n">probe</span><span class="p">.</span><span class="nf">parameters</span><span class="p">(),</span> <span class="n">lr</span><span class="o">=</span><span class="mf">3e-3</span><span class="p">,</span> <span class="n">weight_decay</span><span class="o">=</span><span class="mf">0.01</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">epochs</span><span class="p">):</span>
        <span class="k">for</span> <span class="n">batch</span> <span class="ow">in</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randperm</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">x</span><span class="p">),</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">).</span><span class="nf">split</span><span class="p">(</span><span class="mi">1024</span><span class="p">):</span>
            <span class="n">logits</span> <span class="o">=</span> <span class="nf">probe</span><span class="p">(</span><span class="n">x</span><span class="p">[</span><span class="n">batch</span><span class="p">]).</span><span class="nf">view</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="mi">13</span><span class="p">)</span>
            <span class="n">loss</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span><span class="n">logits</span><span class="p">,</span> <span class="n">y</span><span class="p">[</span><span class="n">batch</span><span class="p">].</span><span class="nf">view</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">))</span>
            <span class="n">optimizer</span><span class="p">.</span><span class="nf">zero_grad</span><span class="p">()</span>
            <span class="n">loss</span><span class="p">.</span><span class="nf">backward</span><span class="p">()</span>
            <span class="n">optimizer</span><span class="p">.</span><span class="nf">step</span><span class="p">()</span>
    <span class="k">def</span> <span class="nf">read</span><span class="p">(</span><span class="n">h</span><span class="p">):</span>
        <span class="n">logits</span> <span class="o">=</span> <span class="nf">probe</span><span class="p">(((</span><span class="n">h</span> <span class="o">-</span> <span class="n">mean</span><span class="p">)</span> <span class="o">/</span> <span class="n">std</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)).</span><span class="nf">view</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="mi">64</span><span class="p">,</span> <span class="mi">13</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">logits</span><span class="p">.</span><span class="nf">argmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">).</span><span class="nf">cpu</span><span class="p">()</span>
    <span class="k">return</span> <span class="n">read</span>


<span class="k">def</span> <span class="nf">probe_scores</span><span class="p">(</span><span class="n">read</span><span class="p">,</span> <span class="n">features</span><span class="p">,</span> <span class="n">labels</span><span class="p">):</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="n">predicted</span> <span class="o">=</span> <span class="nf">read</span><span class="p">(</span><span class="n">features</span><span class="p">)</span>
    <span class="n">correct</span> <span class="o">=</span> <span class="n">predicted</span> <span class="o">==</span> <span class="n">labels</span>
    <span class="k">return</span> <span class="p">{</span><span class="sh">"</span><span class="s">all squares</span><span class="sh">"</span><span class="p">:</span> <span class="n">correct</span><span class="p">.</span><span class="nf">float</span><span class="p">().</span><span class="nf">mean</span><span class="p">().</span><span class="nf">item</span><span class="p">(),</span>
            <span class="sh">"</span><span class="s">occupied squares</span><span class="sh">"</span><span class="p">:</span> <span class="n">correct</span><span class="p">[</span><span class="n">labels</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">].</span><span class="nf">float</span><span class="p">().</span><span class="nf">mean</span><span class="p">().</span><span class="nf">item</span><span class="p">(),</span>
            <span class="sh">"</span><span class="s">whole board right</span><span class="sh">"</span><span class="p">:</span> <span class="n">correct</span><span class="p">.</span><span class="nf">all</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">).</span><span class="nf">float</span><span class="p">().</span><span class="nf">mean</span><span class="p">().</span><span class="nf">item</span><span class="p">()}</span>


<span class="n">probe_train</span><span class="p">,</span> <span class="n">probe_test</span> <span class="o">=</span> <span class="n">test_games</span><span class="p">[:</span><span class="mi">400</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">3000</span><span class="p">],</span> <span class="n">test_games</span><span class="p">[</span><span class="mi">3000</span><span class="p">:</span><span class="mi">3600</span><span class="p">]</span>
<span class="k">if</span> <span class="n">SMOKE</span><span class="p">:</span>
    <span class="n">probe_test</span> <span class="o">=</span> <span class="n">test_games</span><span class="p">[</span><span class="mi">400</span><span class="p">:</span><span class="mi">480</span><span class="p">]</span>
<span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">untrained</span> <span class="o">=</span> <span class="nc">GPT</span><span class="p">(</span><span class="n">chess_config</span><span class="p">)</span>
<span class="nf">init_like_gpt2</span><span class="p">(</span><span class="n">untrained</span><span class="p">,</span> <span class="n">chess_config</span><span class="p">[</span><span class="sh">"</span><span class="s">n_layer</span><span class="sh">"</span><span class="p">])</span>
<span class="n">untrained</span> <span class="o">=</span> <span class="n">untrained</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>

<span class="n">MODELS</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">untrained</span><span class="sh">"</span><span class="p">:</span> <span class="n">untrained</span><span class="p">,</span> <span class="sh">"</span><span class="s">ours, 25 minutes</span><span class="sh">"</span><span class="p">:</span> <span class="n">chess_gpt</span><span class="p">,</span>
          <span class="sh">"</span><span class="s">Karvonen</span><span class="sh">'</span><span class="s">s, 72 hours</span><span class="sh">"</span><span class="p">:</span> <span class="n">karvonen</span><span class="p">}</span>
<span class="n">rows</span><span class="p">,</span> <span class="n">readers</span><span class="p">,</span> <span class="n">test_features</span> <span class="o">=</span> <span class="p">[],</span> <span class="p">{},</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">model</span> <span class="ow">in</span> <span class="n">MODELS</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
    <span class="n">train_x</span><span class="p">,</span> <span class="n">train_y</span> <span class="o">=</span> <span class="nf">residual_states</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">probe_train</span><span class="p">)</span>
    <span class="n">test_x</span><span class="p">,</span> <span class="n">test_y</span> <span class="o">=</span> <span class="nf">residual_states</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">probe_test</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">train_x</span><span class="p">)):</span>
        <span class="n">read</span> <span class="o">=</span> <span class="nf">train_probe</span><span class="p">(</span><span class="n">train_x</span><span class="p">[</span><span class="n">layer</span><span class="p">],</span> <span class="n">train_y</span><span class="p">)</span>
        <span class="n">readers</span><span class="p">[</span><span class="n">name</span><span class="p">,</span> <span class="n">layer</span><span class="p">]</span> <span class="o">=</span> <span class="n">read</span>
        <span class="n">scores</span> <span class="o">=</span> <span class="nf">probe_scores</span><span class="p">(</span><span class="n">read</span><span class="p">,</span> <span class="n">test_x</span><span class="p">[</span><span class="n">layer</span><span class="p">],</span> <span class="n">test_y</span><span class="p">)</span>
        <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span> <span class="sh">"</span><span class="s">layer</span><span class="sh">"</span><span class="p">:</span> <span class="n">layer</span><span class="p">,</span> <span class="o">**</span><span class="n">scores</span><span class="p">})</span>
    <span class="n">test_features</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="o">=</span> <span class="n">test_x</span>
<span class="n">probes</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">train_y</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> positions to train each probe, </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">test_y</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> to test it</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>103,308 positions to train each probe, 20,693 to test it</code></pre> <p>How much of the board each layer gives away, on the squares that hold a piece; the empty ones are easy, since most of the board is empty most of the time:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.4</span><span class="p">,</span> <span class="mf">3.4</span><span class="p">))</span>
<span class="n">styles</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">untrained</span><span class="sh">"</span><span class="p">:</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">],</span> <span class="sh">"</span><span class="s">ours, 25 minutes</span><span class="sh">"</span><span class="p">:</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">data</span><span class="sh">"</span><span class="p">],</span>
          <span class="sh">"</span><span class="s">Karvonen</span><span class="sh">'</span><span class="s">s, 72 hours</span><span class="sh">"</span><span class="p">:</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">]}</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">color</span> <span class="ow">in</span> <span class="n">styles</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
    <span class="n">part</span> <span class="o">=</span> <span class="n">probes</span><span class="p">[</span><span class="n">probes</span><span class="p">[</span><span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="n">name</span><span class="p">]</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">part</span><span class="p">[</span><span class="sh">"</span><span class="s">layer</span><span class="sh">"</span><span class="p">],</span> <span class="n">part</span><span class="p">[</span><span class="sh">"</span><span class="s">occupied squares</span><span class="sh">"</span><span class="p">],</span> <span class="n">marker</span><span class="o">=</span><span class="sh">"</span><span class="s">o</span><span class="sh">"</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="n">name</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">residual stream after layer (0 = embeddings)</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">probe accuracy, occupied squares</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylim</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">loc</span><span class="o">=</span><span class="sh">"</span><span class="s">lower right</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
<span class="n">best_rows</span> <span class="o">=</span> <span class="n">probes</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">probes</span><span class="p">.</span><span class="nf">groupby</span><span class="p">(</span><span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">)[</span><span class="sh">"</span><span class="s">occupied squares</span><span class="sh">"</span><span class="p">].</span><span class="nf">idxmax</span><span class="p">()]</span>
<span class="nf">table</span><span class="p">(</span><span class="n">best_rows</span><span class="p">.</span><span class="nf">set_index</span><span class="p">(</span><span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">).</span><span class="n">loc</span><span class="p">[</span><span class="nf">list</span><span class="p">(</span><span class="n">MODELS</span><span class="p">)].</span><span class="nf">reset_index</span><span class="p">(),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">3</span><span class="p">)</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/04/output-08.png" alt="Output of the code above" loading="lazy"></p> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">model</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">layer</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">all squares</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">occupied squares</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">whole board right</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">untrained</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.769</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.523</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.055</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">ours, 25 minutes</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.842</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.691</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.113</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Karvonen's, 72 hours</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.984</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.972</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.523</td></tr></tbody></table></div> <p>The untrained model sets the floor. About half of the occupied squares can be read from any network’s stream, because the input gives a lot away: a piece that has never moved is where it started, and the last move says where one piece went.</p> <p>Karvonen’s model climbs far above that floor in the middle of its stack. After layer 6 the probe reads 97.2% of the occupied squares, 98.4% of all squares, and the whole board without a single mistake in 52% of the positions; the last two layers give a little back as they turn the board into the next move.</p> <p>His paper found the peak at the same place, “the 8 layer model obtains peak accuracy at layer 6”.</p> <p>Ours, after 25 minutes, reads 69% of the occupied squares, and its curve is still rising at the last layer: the board is under construction. Nobody asked either model for a board. Predicting the next character of a game record was enough to make one, and a single matrix can read it off.</p> <p>What the probes see, on one position from a held-out game: the real board, and the board read off the residual stream of each trained model, at the layer where Karvonen’s model holds it best. Squares a probe gets wrong are outlined.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">layer</span> <span class="o">=</span> <span class="nf">int</span><span class="p">(</span><span class="n">best_rows</span><span class="p">.</span><span class="nf">set_index</span><span class="p">(</span><span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">).</span><span class="n">loc</span><span class="p">[</span><span class="sh">"</span><span class="s">Karvonen</span><span class="sh">'</span><span class="s">s, 72 hours</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">layer</span><span class="sh">"</span><span class="p">])</span>
<span class="n">index</span> <span class="o">=</span> <span class="nf">len</span><span class="p">(</span><span class="n">test_y</span><span class="p">)</span> <span class="o">//</span> <span class="mi">2</span>
<span class="n">truth</span> <span class="o">=</span> <span class="n">test_y</span><span class="p">[</span><span class="n">index</span><span class="p">].</span><span class="nf">numpy</span><span class="p">()</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">9.6</span><span class="p">,</span> <span class="mf">3.6</span><span class="p">))</span>
<span class="nf">draw_board</span><span class="p">(</span><span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="n">truth</span><span class="p">,</span> <span class="sh">"</span><span class="s">the real board</span><span class="sh">"</span><span class="p">)</span>
<span class="k">for</span> <span class="n">ax</span><span class="p">,</span> <span class="n">name</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">axes</span><span class="p">[</span><span class="mi">1</span><span class="p">:],</span> <span class="p">[</span><span class="sh">"</span><span class="s">ours, 25 minutes</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Karvonen</span><span class="sh">'</span><span class="s">s, 72 hours</span><span class="sh">"</span><span class="p">]):</span>
    <span class="n">features</span> <span class="o">=</span> <span class="n">test_features</span><span class="p">[</span><span class="n">name</span><span class="p">][</span><span class="n">layer</span><span class="p">][</span><span class="n">index</span><span class="p">:</span><span class="n">index</span> <span class="o">+</span> <span class="mi">1</span><span class="p">]</span>
    <span class="n">board_read</span> <span class="o">=</span> <span class="n">readers</span><span class="p">[</span><span class="n">name</span><span class="p">,</span> <span class="n">layer</span><span class="p">](</span><span class="n">features</span><span class="p">)[</span><span class="mi">0</span><span class="p">].</span><span class="nf">numpy</span><span class="p">()</span>
    <span class="nf">draw_board</span><span class="p">(</span><span class="n">ax</span><span class="p">,</span> <span class="n">board_read</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="s">, layer </span><span class="si">{</span><span class="n">layer</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span> <span class="n">truth</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">tight_layout</span><span class="p">()</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/04/output-09.png" alt="Output of the code above" loading="lazy"></p> <p>Karvonen’s model reads this position without a mistake. Ours gets all of it but one pawn, and the mistake is telling: the pawn went from a2 to a4 long ago, and our probe still finds it on a2, its square at the start of the game.</p> <p>A model that has half learned to track the board falls back on what boards usually look like.</p> <h2 id="12-where-gpt-is-the-right-tool-today">12. Where GPT is the right tool today</h2> <p>GPT-2 itself has retired from every job but two. It is the laboratory animal of interpretability: open, small enough to run anywhere, and studied so thoroughly that new methods are usually shown on it first, the way the logit lens was.</p> <p>And it is the reference decoder that people rebuild to learn how one works, as you just did. For writing, answering and following instructions, use a modern open model; <a href="/blog/2026/transformer-architectures-06-modern/">lesson 6</a> is about what changed in them.</p> <p>The decoder-only design, on the other hand, is everywhere. Every chat model is one, and so are the models that write code or treat proteins, music or clicks as sequences of tokens.</p> <p>The chess model shows why the design spread: give a GPT a sequence of symbols with structure, and next-token prediction alone makes it learn the structure, here the rules and the board, without anyone writing them down. It also shows the limit.</p> <p>Predicting the next move of players rated 1800 is not the same as playing well; Carlini’s gpt-3.5-turbo-instruct answered one of the worst openings in chess with the same opening.</p> <blockquote class="pull"> <p>It’s important to remember, though, that this model is not playing to win. It’s playing to maximize the likelihood of the PGN text that’s been provided.</p> <p><cite>Nicholas Carlini, 2023</cite></p> </blockquote> <p>DeepMind trained a 270-million-parameter Transformer on Stockfish’s evaluations of positions instead of human moves, and it reached a Lichess blitz rating of 2895 against humans without any search<sup class="cite">[<a href="#ref-2" id="cite-19" data-ref="2" aria-label="Reference 2: Ruoss, A., Delétang, G., Medapati, S., Grau-Moya, J., Wenliang, L. K., Catt, E., Reid, J., Lewis, C. A., Veness, J., &amp; Genewein, T. (2024). Amortized planning with large-scale transformers: a case study on chess. NeurIPS 2024.">2</a>]</sup>.</p> <p>When Kaggle and Google DeepMind ran a chess tournament for frontier language models in August 2025, o3 beat Grok 4 4–0 in the final, and the organisers wrote that engines like Stockfish “would beat every frontier model without a doubt” <sup class="cite">[<a href="#ref-18" id="cite-20" data-ref="18" aria-label="Reference 18: Google, 2025. blog.google.">18</a>]</sup>. A language model plays the game its data plays.</p> <p>GPT-2’s passport, and the family tree with this lesson’s branch:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/04/passport-light.png" width="760" alt="GPT-2's passport. Published February 2019 by OpenAI, the full model released in November 2019. Type: decoder only. Pre-training: next-token prediction on WebText, 40 GB of web pages. Attention: causal, 12 heads per layer in the smallest model. Positions: learned, up to 1,024 tokens. Normalisation: pre-norm LayerNorm and a final one. Activation: GELU, tanh approximation. Vocabulary: byte-level BPE, 50,257 tokens, output tied to the input embeddings. Sizes: 124 million, 355 million, 774 million and 1.5 billion parameters. Good at: interpretability research, teaching, small baselines. Not for: facts, instructions, long inputs" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/04/passport-dark.png" width="760" alt="GPT-2's passport. Published February 2019 by OpenAI, the full model released in November 2019. Type: decoder only. Pre-training: next-token prediction on WebText, 40 GB of web pages. Attention: causal, 12 heads per layer in the smallest model. Positions: learned, up to 1,024 tokens. Normalisation: pre-norm LayerNorm and a final one. Activation: GELU, tanh approximation. Vocabulary: byte-level BPE, 50,257 tokens, output tied to the input embeddings. Sizes: 124 million, 355 million, 774 million and 1.5 billion parameters. Good at: interpretability research, teaching, small baselines. Not for: facts, instructions, long inputs" loading="lazy"></p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/04/family-light.png" width="760" alt="The family of the Transformer as this course covers it, with lesson 4, GPT, highlighted and lessons 1 to 3 done" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/04/family-dark.png" width="760" alt="The family of the Transformer as this course covers it, with lesson 4, GPT, highlighted and lessons 1 to 3 done" loading="lazy"></p> <h2 id="references">References</h2> <ol class="tfs-refs"> <li id="ref-1">Carlini, N. (2023). <a href="https://nicholas.carlini.com/writing/2023/chess-llm.html">Playing chess with large language models</a>. <a class="ref-back" href="#cite-1" aria-label="Back to the text">↩</a></li> <li id="ref-2">Ruoss, A., Delétang, G., Medapati, S., Grau-Moya, J., Wenliang, L. K., Catt, E., Reid, J., Lewis, C. A., Veness, J., &amp; Genewein, T. (2024). <a href="https://arxiv.org/abs/2402.04494">Amortized planning with large-scale transformers: a case study on chess</a>. <em>NeurIPS 2024</em>. <a class="ref-back" href="#cite-2" aria-label="Back to the text">↩</a></li> <li id="ref-3">Dynomight (2024). <a href="https://dynomight.net/chess/">Something weird is happening with LLMs and chess</a>. <a class="ref-back" href="#cite-3" aria-label="Back to the text">↩</a></li> <li id="ref-4">Burns, C., Izmailov, P., Kirchner, J. H., Baker, B., Gao, L., Aschenbrenner, L., Chen, Y., Ecoffet, A., Joglekar, M., Leike, J., Sutskever, I., &amp; Wu, J. (2023). <a href="https://arxiv.org/abs/2312.09390">Weak-to-strong generalization: eliciting strong capabilities with weak supervision</a>. arXiv:2312.09390. <a class="ref-back" href="#cite-4" aria-label="Back to the text">↩</a></li> <li id="ref-5">Radford, A., Narasimhan, K., Salimans, T., &amp; Sutskever, I. (2018). <a href="https://cdn.openai.com/research-covers/language-unsupervised/language_understanding_paper.pdf">Improving language understanding by generative pre-training</a>. OpenAI. <a class="ref-back" href="#cite-5" aria-label="Back to the text">↩</a></li> <li id="ref-6">OpenAI, 2019. <a href="https://openai.com/index/better-language-models/">openai.com</a>. <a class="ref-back" href="#cite-6" aria-label="Back to the text">↩</a></li> <li id="ref-7">Radford, A., Wu, J., Child, R., Luan, D., Amodei, D., &amp; Sutskever, I. (2019). <a href="https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf">Language models are unsupervised multitask learners</a>. OpenAI. <a class="ref-back" href="#cite-7" aria-label="Back to the text">↩</a></li> <li id="ref-8">Brown, T. B., Mann, B., Ryder, N., Subbiah, M., et al. (2020). <a href="https://arxiv.org/abs/2005.14165">Language models are few-shot learners</a>. <em>NeurIPS 2020</em>. <a class="ref-back" href="#cite-8" aria-label="Back to the text">↩</a></li> <li id="ref-9">Xiong, R., Yang, Y., He, D., Zheng, K., Zheng, S., Xing, C., Zhang, H., Lan, Y., Wang, L., &amp; Liu, T.-Y. (2020). <a href="https://arxiv.org/abs/2002.04745">On layer normalization in the Transformer architecture</a>. <em>ICML 2020</em>. <a class="ref-back" href="#cite-9" aria-label="Back to the text">↩</a></li> <li id="ref-10">Press, O., &amp; Wolf, L. (2017). <a href="https://arxiv.org/abs/1608.05859">Using the output embedding to improve language models</a>. <em>EACL 2017</em>. <a class="ref-back" href="#cite-10" aria-label="Back to the text">↩</a></li> <li id="ref-11">nostalgebraist (2020). <a href="https://www.lesswrong.com/posts/AcKRB8wDpdaN6v6ru/interpreting-gpt-the-logit-lens">interpreting GPT: the logit lens</a>. LessWrong. <a class="ref-back" href="#cite-11" aria-label="Back to the text">↩</a></li> <li id="ref-12">Belrose, N., Ostrovsky, I., McKinney, L., Furman, Z., Smith, L., Halawi, D., Biderman, S., &amp; Steinhardt, J. (2023). <a href="https://arxiv.org/abs/2303.08112">Eliciting latent predictions from transformers with the tuned lens</a>. arXiv:2303.08112. <a class="ref-back" href="#cite-12" aria-label="Back to the text">↩</a></li> <li id="ref-13">Lichess (2026). <a href="https://database.lichess.org/">Lichess open database</a>. CC0. <a class="ref-back" href="#cite-13" aria-label="Back to the text">↩</a></li> <li id="ref-14">Karvonen, A. (2024). <a href="https://arxiv.org/abs/2403.15498">Emergent world models and latent variable estimation in chess-playing language models</a>. <em>COLM 2024</em>. <a class="ref-back" href="#cite-14" aria-label="Back to the text">↩</a></li> <li id="ref-15">Li, K., Hopkins, A. K., Bau, D., Viégas, F., Pfister, H., &amp; Wattenberg, M. (2023). <a href="https://arxiv.org/abs/2210.13382">Emergent world representations: exploring a sequence model trained on a synthetic task</a>. <em>ICLR 2023</em>. <a class="ref-back" href="#cite-15" aria-label="Back to the text">↩</a></li> <li id="ref-16">Nanda, N., Lee, A., &amp; Wattenberg, M. (2023). <a href="https://arxiv.org/abs/2309.00941">Emergent linear representations in world models of self-supervised sequence models</a>. <em>BlackboxNLP 2023</em>. <a class="ref-back" href="#cite-16" aria-label="Back to the text">↩</a></li> <li id="ref-17">Alain, G., &amp; Bengio, Y. (2016). <a href="https://arxiv.org/abs/1610.01644">Understanding intermediate layers using linear classifier probes</a>. arXiv:1610.01644. <a class="ref-back" href="#cite-18" aria-label="Back to the text">↩</a></li> <li id="ref-18">Google, 2025. <a href="https://blog.google/technology/ai/kaggle-game-arena/">blog.google</a>. <a class="ref-back" href="#cite-20" aria-label="Back to the text">↩</a></li> <li id="ref-19">Toshniwal, S., Wiseman, S., Livescu, K., &amp; Gimpel, K. (2022). <a href="https://arxiv.org/abs/2102.13249">Chess as a testbed for language model state tracking</a>. <em>AAAI 2022</em>.</li> <li id="ref-20">Shannon, C. E. (1950). Programming a computer for playing chess. <em>Philosophical Magazine</em>, 41(314).</li> </ol>]]></content> <author> <name>Eva Koroleva</name> </author> <category term="machine-learning"/> <category term="transformer-architectures"/> <category term="gpt-2"/> <category term="gpt"/> <category term="chess"/> <category term="interpretability"/> <category term="nlp"/> <summary type="html"><![CDATA[GPT-2 written from scratch and loaded with OpenAI's weights, generation with a KV cache, the logit lens, and a small GPT trained on Lichess games that learns to play legal chess and keeps a board inside, found with a linear probe.]]></summary> <media:thumbnail url="https://blog.korolevalab.com/assets/posts/arch/04/cover.png"/> <media:content medium="image" url="https://blog.korolevalab.com/assets/posts/arch/04/cover.png"/> </entry> <entry> <title type="html">Embeddings and search: Sentence-BERT, cross-encoders and ColBERT</title> <link href="https://blog.korolevalab.com/blog/2026/transformer-architectures-03-search/" rel="alternate" type="text/html" title="Embeddings and search: Sentence-BERT, cross-encoders and ColBERT"/> <published>2026-04-08T12:00:00+00:00</published> <updated>2026-11-02T00:00:00+00:00</updated> <id>https://blog.korolevalab.com/blog/2026/transformer-architectures-03-search</id> <content type="html" xml:base="https://blog.korolevalab.com/blog/2026/transformer-architectures-03-search/"><![CDATA[<p class="tfs-links"><strong>Transformer architectures: from BERT to diffusion</strong> · lesson 3 of 15 · <a href="/teaching/">all lessons</a> · <a href="https://www.kaggle.com/code/qmarva/transformer-architectures-03-embeddings-search">run on Kaggle</a> · <a href="https://colab.research.google.com/github/xmarva/transformers-from-scratch/blob/main/notebooks/colab/a03_search.ipynb">open in Colab</a> · <a href="https://github.com/xmarva/transformers-from-scratch">code on GitHub</a></p> <p>In 2019 BERT was the best reader of English and one of the worst search engines. Ask it which two of 10,000 sentences mean the most similar things, and it has to read every pair, which “requires about 50 million inference computations (~65 hours)”.</p> <p>Nils Reimers and Iryna Gurevych at TU Darmstadt changed one thing: they made BERT write down what it read as one vector per sentence, so that comparing two texts became a dot product. The same search then took “about 5 seconds”<sup class="cite">[<a href="#ref-1" id="cite-1" data-ref="1" aria-label="Reference 1: Reimers, N., &amp; Gurevych, I. (2019). Sentence-BERT: sentence embeddings using Siamese BERT-networks. EMNLP-IJCNLP 2019.">1</a>]</sup>.</p> <p>Their Sentence-BERT now sits, under various names, behind most of the search you meet: the retrieval half of every RAG system, “related articles”, duplicate detection, the search box of a documentation site. It also has rivals with very different trade-offs, and a thirty-year-old formula that none of them can afford to ignore.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/03/hero-light.png" width="760" alt="Three ways to score a query against a document. A cross-encoder reads the two texts joined into one input and outputs a relevance score: one full pass of the encoder for every pair. A bi-encoder, Sentence-BERT, encodes each text separately into one vector and compares the vectors by cosine, so the documents can be encoded before any query arrives. Late interaction, ColBERT, also encodes them separately but keeps one vector per token and sums, over the query's tokens, the best match in the document" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/03/hero-dark.png" width="760" alt="Three ways to score a query against a document. A cross-encoder reads the two texts joined into one input and outputs a relevance score: one full pass of the encoder for every pair. A bi-encoder, Sentence-BERT, encodes each text separately into one vector and compares the vectors by cosine, so the documents can be encoded before any query arrives. Late interaction, ColBERT, also encodes them separately but keeps one vector per token and sums, over the query's tokens, the best match in the document" loading="lazy"></p> <p>In this lesson you’ll build all three, check each against the real weights, and pit them against each other on a task where good search is easy to tell from bad: finding machine-learning papers from the questions researchers actually ask.</p> <p><strong>What you’ll do</strong></p> <ol> <li>Write BM25, the formula every neural retriever still has to beat, and see how far counting words goes.</li> <li>See why an encoder’s own vectors are useless for search, and fix that the way Sentence-BERT does: train a bi-encoder with in-batch negatives, on nothing but the titles and abstracts of the papers themselves.</li> <li>Load the most downloaded model on the Hugging Face Hub into the same code, find out what a billion training pairs buy, and adapt it to the corpus in ten minutes.</li> <li>Write a cross-encoder reranker and ColBERT’s late interaction, and check both against the real weights.</li> <li>Assemble a search engine from the pieces, and measure what each costs in quality, time and memory.</li> </ol> <p><strong>What you need</strong>: a GPU. On Kaggle, <em>Settings → Accelerator → GPU</em>; on Colab, <em>Runtime → Change runtime type → T4 GPU</em>. The notebook downloads five small encoders and the titles and abstracts of 64,000 papers, and trains two encoders for ten minutes each; on a T4 it runs in about 45 minutes.</p> <h2 id="setup">Setup</h2> <p>One small helper package, <code class="language-plaintext highlighter-rouge">tfs</code>, draws the course’s plots and token chips and knows where the notebook runs (Kaggle, Colab or your own machine). Everything the lesson teaches is written out in the notebook itself.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">importlib.util</span>
<span class="kn">import</span> <span class="n">subprocess</span>
<span class="kn">import</span> <span class="n">sys</span>

<span class="n">TFS</span> <span class="o">=</span> <span class="sh">"</span><span class="s">git+https://github.com/xmarva/transformers-from-scratch@main</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">importlib</span><span class="p">.</span><span class="n">util</span><span class="p">.</span><span class="nf">find_spec</span><span class="p">(</span><span class="sh">"</span><span class="s">tfs</span><span class="sh">"</span><span class="p">)</span> <span class="ow">is</span> <span class="bp">None</span><span class="p">:</span>
    <span class="n">subprocess</span><span class="p">.</span><span class="nf">check_call</span><span class="p">([</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">-m</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">pip</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">install</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-q</span><span class="sh">"</span><span class="p">,</span> <span class="n">TFS</span><span class="p">])</span>

<span class="kn">from</span> <span class="n">tfs</span> <span class="kn">import</span> <span class="n">env</span>
<span class="kn">from</span> <span class="n">tfs.viz</span> <span class="kn">import</span> <span class="n">table</span><span class="p">,</span> <span class="n">token_chips</span><span class="p">,</span> <span class="n">use_course_style</span>

<span class="n">env</span><span class="p">.</span><span class="nf">quiet</span><span class="p">()</span>  <span class="c1"># no progress bars or environment warnings in the outputs
</span><span class="n">SEED</span> <span class="o">=</span> <span class="mi">42</span>
<span class="n">env</span><span class="p">.</span><span class="nf">seed_everything</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">COLORS</span> <span class="o">=</span> <span class="nf">use_course_style</span><span class="p">()</span>
<span class="n">WORK_DIR</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">work_dir</span><span class="p">()</span>
</code></pre></div></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">json</span>
<span class="kn">import</span> <span class="n">math</span>
<span class="kn">import</span> <span class="n">re</span>
<span class="kn">import</span> <span class="n">string</span>
<span class="kn">import</span> <span class="n">time</span>
<span class="kn">from</span> <span class="n">collections</span> <span class="kn">import</span> <span class="n">Counter</span><span class="p">,</span> <span class="n">defaultdict</span>

<span class="kn">import</span> <span class="n">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>
<span class="kn">import</span> <span class="n">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="n">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">import</span> <span class="n">torch</span>
<span class="kn">import</span> <span class="n">torch.nn</span> <span class="k">as</span> <span class="n">nn</span>
<span class="kn">import</span> <span class="n">torch.nn.functional</span> <span class="k">as</span> <span class="n">F</span>
<span class="kn">from</span> <span class="n">huggingface_hub</span> <span class="kn">import</span> <span class="n">hf_hub_download</span>
<span class="kn">from</span> <span class="n">IPython.display</span> <span class="kn">import</span> <span class="n">display</span>
<span class="kn">from</span> <span class="n">safetensors.torch</span> <span class="kn">import</span> <span class="n">load_file</span>
<span class="kn">from</span> <span class="n">tfs.viz</span> <span class="kn">import</span> <span class="n">bars</span><span class="p">,</span> <span class="n">heatmap</span>
<span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">AutoTokenizer</span>
<span class="c1"># the reference implementations, for the checks
</span><span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">AutoModelForSequenceClassification</span><span class="p">,</span> <span class="n">BertModel</span>

<span class="n">SMOKE</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">smoke</span><span class="p">()</span>  <span class="c1"># CI runs the lesson on a small slice; you run it in full
</span><span class="n">device</span> <span class="o">=</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">if</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">is_available</span><span class="p">()</span> <span class="k">else</span> <span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span>
<span class="k">assert</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="ow">or</span> <span class="n">SMOKE</span><span class="p">,</span> <span class="sh">"</span><span class="s">This lesson encodes 58,000 papers six times: use a GPU.</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">GPU:</span><span class="sh">"</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">get_device_name</span><span class="p">(</span><span class="mi">0</span><span class="p">))</span>
<span class="n">half</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">float16</span> <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">else</span> <span class="n">torch</span><span class="p">.</span><span class="n">float32</span>  <span class="c1"># what indexes are stored in
</span></code></pre></div></div> <pre class="tfs-printed"><code>GPU: Tesla T4</code></pre> <h2 id="1-the-task-597-questions-64183-papers">1. The task: 597 questions, 64,183 papers</h2> <p>LitSearch is a benchmark built at Princeton from the way researchers look for papers <sup class="cite">[<a href="#ref-2" id="cite-2" data-ref="2" aria-label="Reference 2: Ajith, A., Xia, M., Chevalier, A., Goyal, T., Chen, D., &amp; Gao, T. (2024). LitSearch: a retrieval benchmark for scientific literature search. EMNLP 2024.">2</a>]</sup>. Some of its 597 questions were written by GPT-4 from paragraphs of real papers that cite other work, and ask for the paper behind the citation; the others were written by authors of ACL 2023 and ICLR 2024 papers about their own papers.</p> <p>The benchmark’s authors checked every question by hand. The corpus is 64,183 papers from the ACL Anthology and ICLR, and each question names the one or few papers it is after.</p> <p>The benchmark was not built to flatter anyone: in its paper, Google Search and research tools lagged behind the best neural retriever “by up to 32 recall points”.</p> <p>The corpus files also hold the full text of every paper, more than a gigabyte of it. We need only titles and abstracts, and Parquet stores every column separately, so we read just those three columns straight from the Hugging Face Hub: about 35 MB instead of 1.2 GB.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">LITSEARCH</span> <span class="o">=</span> <span class="sh">"</span><span class="s">hf://datasets/princeton-nlp/LitSearch/</span><span class="sh">"</span>
<span class="n">queries</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nf">read_parquet</span><span class="p">(</span><span class="n">LITSEARCH</span> <span class="o">+</span> <span class="sh">"</span><span class="s">query/full-00000-of-00001.parquet</span><span class="sh">"</span><span class="p">)</span>
<span class="n">shards</span> <span class="o">=</span> <span class="p">[</span><span class="n">pd</span><span class="p">.</span><span class="nf">read_parquet</span><span class="p">(</span><span class="n">LITSEARCH</span> <span class="o">+</span> <span class="sa">f</span><span class="sh">"</span><span class="s">corpus_clean/full-</span><span class="si">{</span><span class="n">k</span><span class="si">:</span><span class="mi">05</span><span class="n">d</span><span class="si">}</span><span class="s">-of-00006.parquet</span><span class="sh">"</span><span class="p">,</span>
                          <span class="n">columns</span><span class="o">=</span><span class="p">[</span><span class="sh">"</span><span class="s">corpusid</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">title</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">abstract</span><span class="sh">"</span><span class="p">])</span>
          <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">1</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">6</span><span class="p">)]</span>
<span class="n">papers</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nf">concat</span><span class="p">(</span><span class="n">shards</span><span class="p">,</span> <span class="n">ignore_index</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">queries</span><span class="p">)</span><span class="si">}</span><span class="s"> questions, </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">papers</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> papers</span><span class="sh">"</span><span class="p">)</span>

<span class="n">has_text</span> <span class="o">=</span> <span class="p">(</span><span class="n">papers</span><span class="p">[</span><span class="sh">"</span><span class="s">title</span><span class="sh">"</span><span class="p">].</span><span class="nb">str</span><span class="p">.</span><span class="nf">len</span><span class="p">()</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">)</span> <span class="o">|</span> <span class="p">(</span><span class="n">papers</span><span class="p">[</span><span class="sh">"</span><span class="s">abstract</span><span class="sh">"</span><span class="p">].</span><span class="nb">str</span><span class="p">.</span><span class="nf">len</span><span class="p">()</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="p">(</span><span class="o">~</span><span class="n">has_text</span><span class="p">).</span><span class="nf">sum</span><span class="p">()</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> papers have neither a title nor an abstract: we drop them</span><span class="sh">"</span><span class="p">)</span>
<span class="n">papers</span> <span class="o">=</span> <span class="n">papers</span><span class="p">[</span><span class="n">has_text</span><span class="p">].</span><span class="nf">reset_index</span><span class="p">(</span><span class="n">drop</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="k">if</span> <span class="n">SMOKE</span><span class="p">:</span>  <span class="c1"># a small corpus that still holds the answers to a few questions
</span>    <span class="n">wanted</span> <span class="o">=</span> <span class="p">{</span><span class="n">i</span> <span class="k">for</span> <span class="n">ids</span> <span class="ow">in</span> <span class="n">queries</span><span class="p">[</span><span class="sh">"</span><span class="s">corpusids</span><span class="sh">"</span><span class="p">]</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">ids</span><span class="p">}</span>
    <span class="n">keep</span> <span class="o">=</span> <span class="n">papers</span><span class="p">[</span><span class="sh">"</span><span class="s">corpusid</span><span class="sh">"</span><span class="p">].</span><span class="nf">isin</span><span class="p">(</span><span class="n">wanted</span><span class="p">)</span> <span class="o">|</span> <span class="p">(</span><span class="n">papers</span><span class="p">.</span><span class="n">index</span> <span class="o">&lt;</span> <span class="mi">600</span><span class="p">)</span>
    <span class="n">papers</span> <span class="o">=</span> <span class="n">papers</span><span class="p">[</span><span class="n">keep</span><span class="p">].</span><span class="nf">reset_index</span><span class="p">(</span><span class="n">drop</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>

<span class="n">titles</span> <span class="o">=</span> <span class="n">papers</span><span class="p">[</span><span class="sh">"</span><span class="s">title</span><span class="sh">"</span><span class="p">].</span><span class="nb">str</span><span class="p">.</span><span class="nf">strip</span><span class="p">().</span><span class="nf">tolist</span><span class="p">()</span>
<span class="n">texts</span> <span class="o">=</span> <span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">t</span><span class="si">}</span><span class="s">. </span><span class="si">{</span><span class="n">a</span><span class="si">}</span><span class="sh">"</span> <span class="k">if</span> <span class="n">t</span> <span class="ow">and</span> <span class="n">a</span> <span class="k">else</span> <span class="n">t</span> <span class="ow">or</span> <span class="n">a</span>
         <span class="k">for</span> <span class="n">t</span><span class="p">,</span> <span class="n">a</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">titles</span><span class="p">,</span> <span class="n">papers</span><span class="p">[</span><span class="sh">"</span><span class="s">abstract</span><span class="sh">"</span><span class="p">].</span><span class="nb">str</span><span class="p">.</span><span class="nf">strip</span><span class="p">())]</span>
<span class="n">row_of</span> <span class="o">=</span> <span class="p">{</span><span class="n">paper</span><span class="p">:</span> <span class="n">i</span> <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">paper</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">papers</span><span class="p">[</span><span class="sh">"</span><span class="s">corpusid</span><span class="sh">"</span><span class="p">])}</span>
<span class="n">queries</span><span class="p">[</span><span class="sh">"</span><span class="s">gold</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="p">[[</span><span class="n">row_of</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">ids</span> <span class="k">if</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">row_of</span><span class="p">]</span> <span class="k">for</span> <span class="n">ids</span> <span class="ow">in</span> <span class="n">queries</span><span class="p">[</span><span class="sh">"</span><span class="s">corpusids</span><span class="sh">"</span><span class="p">]]</span>
<span class="n">queries</span> <span class="o">=</span> <span class="n">queries</span><span class="p">[</span><span class="n">queries</span><span class="p">[</span><span class="sh">"</span><span class="s">gold</span><span class="sh">"</span><span class="p">].</span><span class="nf">map</span><span class="p">(</span><span class="nb">len</span><span class="p">)</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">].</span><span class="nf">reset_index</span><span class="p">(</span><span class="n">drop</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="k">if</span> <span class="n">SMOKE</span><span class="p">:</span>
    <span class="n">queries</span> <span class="o">=</span> <span class="n">queries</span><span class="p">.</span><span class="nf">head</span><span class="p">(</span><span class="mi">24</span><span class="p">)</span>
<span class="n">questions</span><span class="p">,</span> <span class="n">gold</span> <span class="o">=</span> <span class="n">queries</span><span class="p">[</span><span class="sh">"</span><span class="s">query</span><span class="sh">"</span><span class="p">].</span><span class="nf">tolist</span><span class="p">(),</span> <span class="n">queries</span><span class="p">[</span><span class="sh">"</span><span class="s">gold</span><span class="sh">"</span><span class="p">].</span><span class="nf">tolist</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">questions</span><span class="p">)</span><span class="si">}</span><span class="s"> questions keep at least one paper to find, among </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">texts</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>597 questions, 64,183 papers
6,197 papers have neither a title nor an abstract: we drop them
593 questions keep at least one paper to find, among 57,986</code></pre> <p>A few questions with the papers they want:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">examples</span> <span class="o">=</span> <span class="n">queries</span><span class="p">.</span><span class="nf">groupby</span><span class="p">(</span><span class="sh">"</span><span class="s">query_set</span><span class="sh">"</span><span class="p">).</span><span class="nf">head</span><span class="p">(</span><span class="mi">1</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">({</span><span class="sh">"</span><span class="s">question</span><span class="sh">"</span><span class="p">:</span> <span class="n">examples</span><span class="p">[</span><span class="sh">"</span><span class="s">query</span><span class="sh">"</span><span class="p">],</span>
                    <span class="sh">"</span><span class="s">the paper it wants</span><span class="sh">"</span><span class="p">:</span> <span class="p">[</span><span class="n">titles</span><span class="p">[</span><span class="n">g</span><span class="p">[</span><span class="mi">0</span><span class="p">]]</span> <span class="k">for</span> <span class="n">g</span> <span class="ow">in</span> <span class="n">examples</span><span class="p">[</span><span class="sh">"</span><span class="s">gold</span><span class="sh">"</span><span class="p">]],</span>
                    <span class="sh">"</span><span class="s">set</span><span class="sh">"</span><span class="p">:</span> <span class="n">examples</span><span class="p">[</span><span class="sh">"</span><span class="s">query_set</span><span class="sh">"</span><span class="p">]}))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">question</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">the paper it wants</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">set</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Are there any research papers on methods to compress large-scale language models using task-agnostic knowledge distillation techniques?</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">TinyBERT: Distilling BERT for Natural Language Understanding</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">inline_acl</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">*Could you suggest a dataset with legally or ethically contentious content, and labels for acceptable and non-acceptable questions.</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">SQUARE: A Large-Scale Dataset of Sensitive Questions and Acceptable Responses Created Through Human-Machine Collaboration</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">inline_nonacl</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Are there any examples of using dense phrase retrieval systems in the automatic curation of entity dictionaries?</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Automatic Creation of Named Entity Recognition Datasets by Querying Phrase Representations</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">manual_acl</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Can we reduce visual tokens in vision transformers right from the beginning?</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">SparseFormer: Sparse Visual Recognition via Limited Latent Tokens</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">manual_iclr</td></tr></tbody></table></div> <p>The questions sound like a colleague asking in a corridor. Some are specific, “is there a paper that applies large language models to visual Raven’s Progressive Matrices?”; some are broad enough to have several right answers, and LitSearch marks those with <code class="language-plaintext highlighter-rouge">specificity = 0</code>.</p> <p>The titles in the corpus are as they were extracted from the PDFs, sometimes in capitals and sometimes with a conference header in front, which is what real corpora look like.</p> <p>LitSearch scores a search engine by <strong>recall@k</strong>: of the papers a question asks for, the share found in the top <em>k</em> results.</p> <p>Most questions want exactly one paper, so recall@5 is close to “how often the right paper is on the first screen”. Next to it we’ll record what every method costs: milliseconds per question and the size of its index.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">results</span> <span class="o">=</span> <span class="p">[]</span>


<span class="k">def</span> <span class="nf">evaluate</span><span class="p">(</span><span class="n">name</span><span class="p">,</span> <span class="n">scores</span><span class="p">,</span> <span class="n">seconds</span><span class="p">,</span> <span class="n">index_bytes</span><span class="p">):</span>
    <span class="sh">"""</span><span class="s">Recall@5 and @20, from the score of every paper for every question.</span><span class="sh">"""</span>
    <span class="n">top</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">as_tensor</span><span class="p">(</span><span class="n">scores</span><span class="p">).</span><span class="nf">topk</span><span class="p">(</span><span class="mi">20</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">).</span><span class="n">indices</span><span class="p">.</span><span class="nf">cpu</span><span class="p">().</span><span class="nf">numpy</span><span class="p">()</span>
    <span class="n">row</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">method</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">}</span>
    <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="p">(</span><span class="mi">5</span><span class="p">,</span> <span class="mi">20</span><span class="p">):</span>
        <span class="n">found</span> <span class="o">=</span> <span class="p">[</span><span class="nf">len</span><span class="p">(</span><span class="nf">set</span><span class="p">(</span><span class="n">g</span><span class="p">)</span> <span class="o">&amp;</span> <span class="nf">set</span><span class="p">(</span><span class="n">t</span><span class="p">[:</span><span class="n">k</span><span class="p">]))</span> <span class="o">/</span> <span class="nf">len</span><span class="p">(</span><span class="n">g</span><span class="p">)</span> <span class="k">for</span> <span class="n">g</span><span class="p">,</span> <span class="n">t</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">gold</span><span class="p">,</span> <span class="n">top</span><span class="p">)]</span>
        <span class="n">row</span><span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="s">recall@</span><span class="si">{</span><span class="n">k</span><span class="si">}</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">mean</span><span class="p">(</span><span class="n">found</span><span class="p">)</span>
    <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">ms per question</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="mi">1000</span> <span class="o">*</span> <span class="n">seconds</span> <span class="o">/</span> <span class="nf">len</span><span class="p">(</span><span class="n">questions</span><span class="p">)</span>
    <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">index, MB</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">index_bytes</span> <span class="o">/</span> <span class="mf">1e6</span>
    <span class="n">results</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">row</span><span class="p">)</span>
    <span class="k">return</span> <span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">([</span><span class="n">row</span><span class="p">]))</span>
</code></pre></div></div> <h2 id="2-bm25-counting-words-carefully">2. BM25: counting words, carefully</h2> <p>Before any neural network, search engines scored a document by the words it shares with the query, and the formula most of them settled on is <strong>BM25</strong>, from Stephen Robertson’s Okapi system at City University London in the 1990s; its report for TREC-3 says, with no ceremony, “we in effect combined BM11 and BM15 into a single function BM25”<sup class="cite">[<a href="#ref-3" id="cite-3" data-ref="3" aria-label="Reference 3: Robertson, S. E., Walker, S., Jones, S., Hancock-Beaulieu, M., &amp; Gatford, M. (1995). Okapi at TREC-3. The Third Text REtrieval Conference (TREC-3), NIST SP 500-226.">3</a>]</sup>.</p> <p>Thirty years later it is the default ranking of Lucene, Elasticsearch and OpenSearch, and the first baseline in every retrieval paper. For a query \(q\) and a document \(d\):</p> \[\text{BM25}(q, d) = \sum_{w \in q} \text{IDF}(w) \cdot \frac{f(w, d)\,(k_1 + 1)}{f(w, d) + k_1 \left(1 - b + b\,\frac{|d|}{\text{avgdl}}\right)}, \qquad \text{IDF}(w) = \ln\left(1 + \frac{N - n(w) + 0.5}{n(w) + 0.5}\right)\] <p>where \(f(w, d)\) is how often the word occurs in the document, \(|d|\) the document’s length in words, avgdl the average length, \(N\) the number of documents and \(n(w)\) how many of them contain the word.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/03/bm25-light.png" width="760" alt="BM25's score of a document for a query is a sum over the query's words of three factors: how rare the word is in the collection, the inverse document frequency; how often it occurs in the document, with returns that diminish, controlled by k1; and the document's length relative to the average, controlled by b, so that long documents don't win by repeating everything" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/03/bm25-dark.png" width="760" alt="BM25's score of a document for a query is a sum over the query's words of three factors: how rare the word is in the collection, the inverse document frequency; how often it occurs in the document, with returns that diminish, controlled by k1; and the document's length relative to the average, controlled by b, so that long documents don't win by repeating everything" loading="lazy"></p> <p>All three factors are common sense written down. A rare word says more than a common one. The second occurrence of a word matters, the twentieth adds almost nothing.</p> <p>A long abstract mentions more words by sheer length, so it must mention them more often to score the same. The implementation is an <strong>inverted index</strong>: for every word, the documents that contain it and how often. A query then touches only the documents that share at least one of its words.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">STOP</span> <span class="o">=</span> <span class="nf">set</span><span class="p">(</span><span class="sh">"""</span><span class="s">a an and are as at be been by can for from has have in into is it its
of on or our such than that the their these they this to using was we were which
with</span><span class="sh">"""</span><span class="p">.</span><span class="nf">split</span><span class="p">())</span>


<span class="k">def</span> <span class="nf">words</span><span class="p">(</span><span class="n">text</span><span class="p">):</span>
    <span class="k">return</span> <span class="p">[</span><span class="n">w</span> <span class="k">for</span> <span class="n">w</span> <span class="ow">in</span> <span class="n">re</span><span class="p">.</span><span class="nf">findall</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s">[a-z0-9]+</span><span class="sh">"</span><span class="p">,</span> <span class="n">text</span><span class="p">.</span><span class="nf">lower</span><span class="p">())</span> <span class="k">if</span> <span class="n">w</span> <span class="ow">not</span> <span class="ow">in</span> <span class="n">STOP</span><span class="p">]</span>


<span class="k">class</span> <span class="nc">BM25</span><span class="p">:</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">texts</span><span class="p">,</span> <span class="n">k1</span><span class="o">=</span><span class="mf">1.2</span><span class="p">,</span> <span class="n">b</span><span class="o">=</span><span class="mf">0.75</span><span class="p">):</span>
        <span class="n">self</span><span class="p">.</span><span class="n">k1</span> <span class="o">=</span> <span class="n">k1</span>
        <span class="n">postings</span> <span class="o">=</span> <span class="nf">defaultdict</span><span class="p">(</span><span class="nb">list</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">lengths</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">texts</span><span class="p">),</span> <span class="n">dtype</span><span class="o">=</span><span class="n">np</span><span class="p">.</span><span class="n">float32</span><span class="p">)</span>
        <span class="k">for</span> <span class="n">doc</span><span class="p">,</span> <span class="n">text</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">texts</span><span class="p">):</span>
            <span class="n">counts</span> <span class="o">=</span> <span class="nc">Counter</span><span class="p">(</span><span class="nf">words</span><span class="p">(</span><span class="n">text</span><span class="p">))</span>
            <span class="n">self</span><span class="p">.</span><span class="n">lengths</span><span class="p">[</span><span class="n">doc</span><span class="p">]</span> <span class="o">=</span> <span class="nf">sum</span><span class="p">(</span><span class="n">counts</span><span class="p">.</span><span class="nf">values</span><span class="p">())</span>
            <span class="k">for</span> <span class="n">word</span><span class="p">,</span> <span class="n">count</span> <span class="ow">in</span> <span class="n">counts</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
                <span class="n">postings</span><span class="p">[</span><span class="n">word</span><span class="p">].</span><span class="nf">append</span><span class="p">((</span><span class="n">doc</span><span class="p">,</span> <span class="n">count</span><span class="p">))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">index</span> <span class="o">=</span> <span class="p">{}</span>
        <span class="k">for</span> <span class="n">w</span><span class="p">,</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">postings</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
            <span class="n">docs</span><span class="p">,</span> <span class="n">counts</span> <span class="o">=</span> <span class="nf">zip</span><span class="p">(</span><span class="o">*</span><span class="n">p</span><span class="p">)</span>
            <span class="n">self</span><span class="p">.</span><span class="n">index</span><span class="p">[</span><span class="n">w</span><span class="p">]</span> <span class="o">=</span> <span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">array</span><span class="p">(</span><span class="n">docs</span><span class="p">),</span> <span class="n">np</span><span class="p">.</span><span class="nf">array</span><span class="p">(</span><span class="n">counts</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">np</span><span class="p">.</span><span class="n">float32</span><span class="p">))</span>
        <span class="n">n</span> <span class="o">=</span> <span class="nf">len</span><span class="p">(</span><span class="n">texts</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">idf</span> <span class="o">=</span> <span class="p">{</span><span class="n">w</span><span class="p">:</span> <span class="n">math</span><span class="p">.</span><span class="nf">log</span><span class="p">(</span><span class="mi">1</span> <span class="o">+</span> <span class="p">(</span><span class="n">n</span> <span class="o">-</span> <span class="nf">len</span><span class="p">(</span><span class="n">d</span><span class="p">)</span> <span class="o">+</span> <span class="mf">0.5</span><span class="p">)</span> <span class="o">/</span> <span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">d</span><span class="p">)</span> <span class="o">+</span> <span class="mf">0.5</span><span class="p">))</span>
                    <span class="k">for</span> <span class="n">w</span><span class="p">,</span> <span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">_</span><span class="p">)</span> <span class="ow">in</span> <span class="n">self</span><span class="p">.</span><span class="n">index</span><span class="p">.</span><span class="nf">items</span><span class="p">()}</span>
        <span class="c1"># the length part of the denominator, the same for every query
</span>        <span class="n">self</span><span class="p">.</span><span class="n">norm</span> <span class="o">=</span> <span class="n">k1</span> <span class="o">*</span> <span class="p">(</span><span class="mi">1</span> <span class="o">-</span> <span class="n">b</span> <span class="o">+</span> <span class="n">b</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">lengths</span> <span class="o">/</span> <span class="n">self</span><span class="p">.</span><span class="n">lengths</span><span class="p">.</span><span class="nf">mean</span><span class="p">())</span>

    <span class="k">def</span> <span class="nf">scores</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">query</span><span class="p">):</span>
        <span class="n">out</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">lengths</span><span class="p">),</span> <span class="n">dtype</span><span class="o">=</span><span class="n">np</span><span class="p">.</span><span class="n">float32</span><span class="p">)</span>
        <span class="k">for</span> <span class="n">w</span> <span class="ow">in</span> <span class="nf">set</span><span class="p">(</span><span class="nf">words</span><span class="p">(</span><span class="n">query</span><span class="p">)):</span>
            <span class="k">if</span> <span class="n">w</span> <span class="ow">in</span> <span class="n">self</span><span class="p">.</span><span class="n">index</span><span class="p">:</span>
                <span class="n">docs</span><span class="p">,</span> <span class="n">f</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">index</span><span class="p">[</span><span class="n">w</span><span class="p">]</span>
                <span class="n">out</span><span class="p">[</span><span class="n">docs</span><span class="p">]</span> <span class="o">+=</span> <span class="n">self</span><span class="p">.</span><span class="n">idf</span><span class="p">[</span><span class="n">w</span><span class="p">]</span> <span class="o">*</span> <span class="n">f</span> <span class="o">*</span> <span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">k1</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="p">(</span><span class="n">f</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">norm</span><span class="p">[</span><span class="n">docs</span><span class="p">])</span>
        <span class="k">return</span> <span class="n">out</span>


<span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
<span class="n">bm25</span> <span class="o">=</span> <span class="nc">BM25</span><span class="p">(</span><span class="n">texts</span><span class="p">)</span>
<span class="n">postings</span> <span class="o">=</span> <span class="nf">sum</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">docs</span><span class="p">)</span> <span class="k">for</span> <span class="n">docs</span><span class="p">,</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">bm25</span><span class="p">.</span><span class="n">index</span><span class="p">.</span><span class="nf">values</span><span class="p">())</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">index: </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">bm25</span><span class="p">.</span><span class="n">index</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> words, </span><span class="si">{</span><span class="n">postings</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> postings, </span><span class="sh">"</span>
      <span class="sa">f</span><span class="sh">"</span><span class="s">built in </span><span class="si">{</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> s</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>index: 107,892 words, 4,346,702 postings, built in 9 s</code></pre> <p>Here is what BM25 thinks matters in the first question. Words like <em>papers</em> and <em>methods</em> occur in thousands of abstracts and weigh little; <em>distillation</em> and <em>agnostic</em> are rare and carry the query.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">query</span> <span class="o">=</span> <span class="n">questions</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
<span class="n">weights</span> <span class="o">=</span> <span class="p">{</span><span class="n">w</span><span class="p">:</span> <span class="n">bm25</span><span class="p">.</span><span class="n">idf</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="n">w</span><span class="p">,</span> <span class="mf">0.0</span><span class="p">)</span> <span class="k">for</span> <span class="n">w</span> <span class="ow">in</span> <span class="nb">dict</span><span class="p">.</span><span class="nf">fromkeys</span><span class="p">(</span><span class="nf">words</span><span class="p">(</span><span class="n">query</span><span class="p">))}</span>
<span class="nf">bars</span><span class="p">(</span><span class="nf">dict</span><span class="p">(</span><span class="nf">sorted</span><span class="p">(</span><span class="n">weights</span><span class="p">.</span><span class="nf">items</span><span class="p">(),</span> <span class="n">key</span><span class="o">=</span><span class="k">lambda</span> <span class="n">kv</span><span class="p">:</span> <span class="o">-</span><span class="n">kv</span><span class="p">[</span><span class="mi">1</span><span class="p">])),</span> <span class="n">fmt</span><span class="o">=</span><span class="sh">"</span><span class="s">{:.1f}</span><span class="sh">"</span><span class="p">,</span>
     <span class="n">title</span><span class="o">=</span><span class="sh">"</span><span class="s">IDF of each word of the first question</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.4</span><span class="p">,</span> <span class="mf">3.4</span><span class="p">))</span>
<span class="n">f</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">21</span><span class="p">)</span>
<span class="k">for</span> <span class="n">ratio</span><span class="p">,</span> <span class="n">color</span> <span class="ow">in</span> <span class="p">[(</span><span class="mf">0.5</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">]),</span> <span class="p">(</span><span class="mf">1.0</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">]),</span> <span class="p">(</span><span class="mf">2.0</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">])]:</span>
    <span class="n">norm</span> <span class="o">=</span> <span class="mf">1.2</span> <span class="o">*</span> <span class="p">(</span><span class="mi">1</span> <span class="o">-</span> <span class="mf">0.75</span> <span class="o">+</span> <span class="mf">0.75</span> <span class="o">*</span> <span class="n">ratio</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">f</span><span class="p">,</span> <span class="n">f</span> <span class="o">*</span> <span class="mf">2.2</span> <span class="o">/</span> <span class="p">(</span><span class="n">f</span> <span class="o">+</span> <span class="n">norm</span><span class="p">),</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span> <span class="n">marker</span><span class="o">=</span><span class="sh">"</span><span class="s">o</span><span class="sh">"</span><span class="p">,</span> <span class="n">ms</span><span class="o">=</span><span class="mi">3</span><span class="p">,</span>
            <span class="n">label</span><span class="o">=</span><span class="sa">f</span><span class="sh">"</span><span class="s">document </span><span class="si">{</span><span class="n">ratio</span><span class="si">:</span><span class="n">g</span><span class="si">}</span><span class="s">× the average length</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">occurrences of the word in the document</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">multiplier of the word</span><span class="sh">'</span><span class="s">s IDF</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">Diminishing returns for repetition, a handicap for length</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">()</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/03/output-01.png" alt="IDF of each word of the first question" loading="lazy"></p> <p><img class="tfs-output" src="/assets/posts/arch/03/output-02.png" alt="IDF of each word of the first question" loading="lazy"></p> <p>The multiplier can never exceed \(k_1 + 1 = 2.2\), however often the word repeats, and a document twice the average length needs about twice the occurrences to earn the same score. Now the search itself:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
<span class="n">bm25_scores</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">from_numpy</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">stack</span><span class="p">([</span><span class="n">bm25</span><span class="p">.</span><span class="nf">scores</span><span class="p">(</span><span class="n">q</span><span class="p">)</span> <span class="k">for</span> <span class="n">q</span> <span class="ow">in</span> <span class="n">questions</span><span class="p">]))</span>
<span class="nf">evaluate</span><span class="p">(</span><span class="sh">"</span><span class="s">BM25</span><span class="sh">"</span><span class="p">,</span> <span class="n">bm25_scores</span><span class="p">,</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="p">,</span> <span class="n">postings</span> <span class="o">*</span> <span class="mi">8</span><span class="p">)</span>  <span class="c1"># int32 id + float32 count
</span></code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">method</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@5</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@20</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">ms per question</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">index, MB</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">BM25</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.45</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.60</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.03</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">34.77</td></tr></tbody></table></div> <p class="takeaway">With no training, no GPU and two parameters, BM25 puts the right paper in the top five for almost half the questions, a recall@5 of 0.45.</p> <p>That is the number every model below has to beat, and the answer to anyone who says keyword search is dead.</p> <h2 id="3-an-encoders-own-vectors-a-crowd-in-a-narrow-cone">3. An encoder’s own vectors: a crowd in a narrow cone</h2> <p>The obvious way to turn an encoder into a search engine is to average the vectors it computes for the tokens of a text and compare the averages by cosine.</p> <p>Reimers and Gurevych tried it with BERT and found that it “yields rather bad sentence embeddings, often worse than averaging GloVe embeddings”. On their semantic similarity tests, averaged BERT vectors scored 54.8, BERT’s <code class="language-plaintext highlighter-rouge">[CLS]</code> vector 29.2, and plain averaged GloVe word vectors from 2014 scored 61.3. Let’s see why.</p> <p>We take <strong>MiniLM-L6</strong>, a small encoder with BERT’s architecture. Microsoft distilled a 12-layer, 384-wide MiniLM from a larger model<sup class="cite">[<a href="#ref-4" id="cite-4" data-ref="4" aria-label="Reference 4: Wang, W., Wei, F., Dong, L., Bao, H., Yang, N., &amp; Zhou, M. (2020). MiniLM: deep self-attention distillation for task-agnostic compression of pre-trained transformers. NeurIPS 2020.">4</a>]</sup>, and Nils Reimers, the same one, cut it to six layers by keeping every second layer.</p> <p>It has five times fewer parameters than BERT-base, and, as section 5 will show, it is the starting point of the most popular embedding model there is. The BERT of the previous lessons loads it unchanged, once it learns to accept the segment ids that the cross-encoder of section 6 will need.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">Embeddings</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">words</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">positions</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">max_position_embeddings</span><span class="sh">"</span><span class="p">],</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">segments</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">type_vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">layer_norm_eps</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">dropout</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Dropout</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_dropout_prob</span><span class="sh">"</span><span class="p">])</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">segments</span><span class="p">):</span>
        <span class="n">positions</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="n">device</span><span class="o">=</span><span class="n">ids</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">words</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">positions</span><span class="p">(</span><span class="n">positions</span><span class="p">)</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">segments</span><span class="p">(</span><span class="n">segments</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">dropout</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">norm</span><span class="p">(</span><span class="n">x</span><span class="p">))</span>


<span class="k">class</span> <span class="nc">Layer</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span><span class="p">,</span> <span class="n">eps</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">layer_norm_eps</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">q</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">k</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">v</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">out</span> <span class="o">=</span> <span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">4</span><span class="p">))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm1</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">eps</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">up</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">down</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm2</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">eps</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">dropout</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Dropout</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_dropout_prob</span><span class="sh">"</span><span class="p">])</span>

    <span class="k">def</span> <span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">batch</span><span class="p">,</span> <span class="n">length</span><span class="p">,</span> <span class="n">d</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span>
        <span class="k">return</span> <span class="n">x</span><span class="p">.</span><span class="nf">view</span><span class="p">(</span><span class="n">batch</span><span class="p">,</span> <span class="n">length</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">d</span> <span class="o">//</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">padding</span><span class="p">):</span>
        <span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">q</span><span class="p">(</span><span class="n">x</span><span class="p">)),</span> <span class="n">self</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">k</span><span class="p">(</span><span class="n">x</span><span class="p">)),</span> <span class="n">self</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">v</span><span class="p">(</span><span class="n">x</span><span class="p">))</span>
        <span class="n">scores</span> <span class="o">=</span> <span class="n">q</span> <span class="o">@</span> <span class="n">k</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">2</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">])</span>
        <span class="n">lowest</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">finfo</span><span class="p">(</span><span class="n">scores</span><span class="p">.</span><span class="n">dtype</span><span class="p">).</span><span class="nb">min</span>  <span class="c1"># not -inf: a row of -inf turns into NaN
</span>        <span class="n">scores</span> <span class="o">=</span> <span class="n">scores</span><span class="p">.</span><span class="nf">masked_fill</span><span class="p">(</span><span class="n">padding</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:],</span> <span class="n">lowest</span><span class="p">)</span>
        <span class="n">y</span> <span class="o">=</span> <span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">dropout</span><span class="p">(</span><span class="n">scores</span><span class="p">.</span><span class="nf">softmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">))</span> <span class="o">@</span> <span class="n">v</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">)</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm1</span><span class="p">(</span><span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">dropout</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">out</span><span class="p">(</span><span class="n">y</span><span class="p">)))</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm2</span><span class="p">(</span><span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">dropout</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">down</span><span class="p">(</span><span class="n">F</span><span class="p">.</span><span class="nf">gelu</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">up</span><span class="p">(</span><span class="n">x</span><span class="p">)))))</span>


<span class="k">class</span> <span class="nc">Encoder</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">embeddings</span> <span class="o">=</span> <span class="nc">Embeddings</span><span class="p">(</span><span class="n">config</span><span class="p">)</span>
        <span class="n">n_layers</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">layers</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">ModuleList</span><span class="p">(</span><span class="nc">Layer</span><span class="p">(</span><span class="n">config</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n_layers</span><span class="p">))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">dim</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">]</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">padding</span><span class="p">,</span> <span class="n">segments</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
        <span class="n">segments</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros_like</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span> <span class="k">if</span> <span class="n">segments</span> <span class="ow">is</span> <span class="bp">None</span> <span class="k">else</span> <span class="n">segments</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">embeddings</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">segments</span><span class="p">)</span>
        <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">self</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
            <span class="n">x</span> <span class="o">=</span> <span class="nf">layer</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">padding</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">x</span>
</code></pre></div></div> <p>Every model in this lesson is a BERT inside, and they store their tensors under the same names, with or without a <code class="language-plaintext highlighter-rouge">bert.</code> in front. One loader serves them all; whatever a checkpoint keeps besides the encoder, a pooler, a classifier or ColBERT’s projection, it returns separately.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">PARTS</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">q</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention.self.query</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">k</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention.self.key</span><span class="sh">"</span><span class="p">,</span>
         <span class="sh">"</span><span class="s">v</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention.self.value</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">out</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention.output.dense</span><span class="sh">"</span><span class="p">,</span>
         <span class="sh">"</span><span class="s">norm1</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention.output.LayerNorm</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">up</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">intermediate.dense</span><span class="sh">"</span><span class="p">,</span>
         <span class="sh">"</span><span class="s">down</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">output.dense</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">norm2</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">output.LayerNorm</span><span class="sh">"</span><span class="p">}</span>


<span class="k">def</span> <span class="nf">bert_names</span><span class="p">(</span><span class="n">config</span><span class="p">):</span>
    <span class="n">names</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">embeddings.words.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">embeddings.word_embeddings.weight</span><span class="sh">"</span><span class="p">,</span>
             <span class="sh">"</span><span class="s">embeddings.positions.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">embeddings.position_embeddings.weight</span><span class="sh">"</span><span class="p">,</span>
             <span class="sh">"</span><span class="s">embeddings.segments.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">embeddings.token_type_embeddings.weight</span><span class="sh">"</span><span class="p">,</span>
             <span class="sh">"</span><span class="s">embeddings.norm.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">embeddings.LayerNorm.weight</span><span class="sh">"</span><span class="p">,</span>
             <span class="sh">"</span><span class="s">embeddings.norm.bias</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">embeddings.LayerNorm.bias</span><span class="sh">"</span><span class="p">}</span>
    <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">]):</span>
        <span class="k">for</span> <span class="n">ours</span><span class="p">,</span> <span class="n">theirs</span> <span class="ow">in</span> <span class="n">PARTS</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
            <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="p">(</span><span class="sh">"</span><span class="s">weight</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">bias</span><span class="sh">"</span><span class="p">):</span>
                <span class="n">names</span><span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="s">layers.</span><span class="si">{</span><span class="n">i</span><span class="si">}</span><span class="s">.</span><span class="si">{</span><span class="n">ours</span><span class="si">}</span><span class="s">.</span><span class="si">{</span><span class="n">p</span><span class="si">}</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">encoder.layer.</span><span class="si">{</span><span class="n">i</span><span class="si">}</span><span class="s">.</span><span class="si">{</span><span class="n">theirs</span><span class="si">}</span><span class="s">.</span><span class="si">{</span><span class="n">p</span><span class="si">}</span><span class="sh">"</span>
    <span class="k">return</span> <span class="n">names</span>


<span class="k">def</span> <span class="nf">load_encoder</span><span class="p">(</span><span class="n">repo</span><span class="p">,</span> <span class="nb">file</span><span class="o">=</span><span class="sh">"</span><span class="s">model.safetensors</span><span class="sh">"</span><span class="p">):</span>
    <span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">repo</span><span class="p">,</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">))</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
        <span class="n">config</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">f</span><span class="p">)</span>
    <span class="n">path</span> <span class="o">=</span> <span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">repo</span><span class="p">,</span> <span class="nb">file</span><span class="p">)</span>
    <span class="k">if</span> <span class="nb">file</span><span class="p">.</span><span class="nf">endswith</span><span class="p">(</span><span class="sh">"</span><span class="s">.safetensors</span><span class="sh">"</span><span class="p">):</span>
        <span class="n">weights</span> <span class="o">=</span> <span class="nf">load_file</span><span class="p">(</span><span class="n">path</span><span class="p">)</span>
    <span class="k">else</span><span class="p">:</span>
        <span class="n">weights</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">path</span><span class="p">,</span> <span class="n">map_location</span><span class="o">=</span><span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span><span class="p">,</span> <span class="n">weights_only</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">prefix</span> <span class="o">=</span> <span class="sh">"</span><span class="s">bert.</span><span class="sh">"</span> <span class="k">if</span> <span class="sh">"</span><span class="s">bert.embeddings.word_embeddings.weight</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">weights</span> <span class="k">else</span> <span class="sh">""</span>
    <span class="n">encoder</span> <span class="o">=</span> <span class="nc">Encoder</span><span class="p">(</span><span class="n">config</span><span class="p">)</span>
    <span class="n">names</span> <span class="o">=</span> <span class="nf">bert_names</span><span class="p">(</span><span class="n">config</span><span class="p">)</span>
    <span class="n">encoder</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">({</span><span class="n">ours</span><span class="p">:</span> <span class="n">weights</span><span class="p">[</span><span class="n">prefix</span> <span class="o">+</span> <span class="n">t</span><span class="p">]</span> <span class="k">for</span> <span class="n">ours</span><span class="p">,</span> <span class="n">t</span> <span class="ow">in</span> <span class="n">names</span><span class="p">.</span><span class="nf">items</span><span class="p">()})</span>
    <span class="n">used</span> <span class="o">=</span> <span class="p">{</span><span class="n">prefix</span> <span class="o">+</span> <span class="n">theirs</span> <span class="k">for</span> <span class="n">theirs</span> <span class="ow">in</span> <span class="n">names</span><span class="p">.</span><span class="nf">values</span><span class="p">()}</span>
    <span class="n">extra</span> <span class="o">=</span> <span class="p">{</span><span class="n">k</span><span class="p">.</span><span class="nf">removeprefix</span><span class="p">(</span><span class="n">prefix</span><span class="p">):</span> <span class="n">v</span> <span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="ow">in</span> <span class="n">weights</span><span class="p">.</span><span class="nf">items</span><span class="p">()</span>
             <span class="k">if</span> <span class="n">k</span> <span class="ow">not</span> <span class="ow">in</span> <span class="n">used</span> <span class="ow">and</span> <span class="ow">not</span> <span class="n">k</span><span class="p">.</span><span class="nf">endswith</span><span class="p">(</span><span class="sh">"</span><span class="s">position_ids</span><span class="sh">"</span><span class="p">)}</span>
    <span class="k">return</span> <span class="n">encoder</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">(),</span> <span class="n">extra</span>


<span class="n">BASE</span> <span class="o">=</span> <span class="sh">"</span><span class="s">nreimers/MiniLM-L6-H384-uncased</span><span class="sh">"</span>
<span class="n">base</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="nf">load_encoder</span><span class="p">(</span><span class="n">BASE</span><span class="p">,</span> <span class="sh">"</span><span class="s">pytorch_model.bin</span><span class="sh">"</span><span class="p">)</span>
<span class="n">tokenizer</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">BASE</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">sum</span><span class="p">(</span><span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span> <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">base</span><span class="p">.</span><span class="nf">parameters</span><span class="p">())</span> <span class="o">/</span> <span class="mf">1e6</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s">M parameters</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>22.6M parameters</code></pre> <p>An <strong>embedding</strong> of a text is one vector. We get it by <strong>mean pooling</strong>, averaging the token vectors while leaving out the padding, and normalise it to length one, so that the dot product of two embeddings is their cosine.</p> <p>The papers are sorted by length before they are batched: a batch then pads to about the same length, and encoding runs about twice as fast.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">pool</span><span class="p">(</span><span class="n">hidden</span><span class="p">,</span> <span class="n">padding</span><span class="p">,</span> <span class="n">how</span><span class="p">):</span>
    <span class="k">if</span> <span class="n">how</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cls</span><span class="sh">"</span><span class="p">:</span>
        <span class="k">return</span> <span class="n">hidden</span><span class="p">[:,</span> <span class="mi">0</span><span class="p">]</span>
    <span class="n">keep</span> <span class="o">=</span> <span class="p">(</span><span class="o">~</span><span class="n">padding</span><span class="p">).</span><span class="nf">unsqueeze</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">hidden</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span>
    <span class="nf">return </span><span class="p">(</span><span class="n">hidden</span> <span class="o">*</span> <span class="n">keep</span><span class="p">).</span><span class="nf">sum</span><span class="p">(</span><span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">keep</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="mi">1</span><span class="p">)</span>


<span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">embed</span><span class="p">(</span><span class="n">encoder</span><span class="p">,</span> <span class="n">texts</span><span class="p">,</span> <span class="n">max_length</span><span class="p">,</span> <span class="n">how</span><span class="o">=</span><span class="sh">"</span><span class="s">mean</span><span class="sh">"</span><span class="p">,</span> <span class="n">prefix</span><span class="o">=</span><span class="sh">""</span><span class="p">,</span> <span class="n">batch_size</span><span class="o">=</span><span class="mi">128</span><span class="p">,</span> <span class="n">tok</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
    <span class="n">tok</span> <span class="o">=</span> <span class="n">tok</span> <span class="ow">or</span> <span class="n">tokenizer</span>
    <span class="n">order</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">argsort</span><span class="p">([</span><span class="o">-</span><span class="nf">len</span><span class="p">(</span><span class="n">t</span><span class="p">)</span> <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="n">texts</span><span class="p">])</span>
    <span class="n">out</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">empty</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">texts</span><span class="p">),</span> <span class="n">encoder</span><span class="p">.</span><span class="n">dim</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">start</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">texts</span><span class="p">),</span> <span class="n">batch_size</span><span class="p">):</span>
        <span class="n">rows</span> <span class="o">=</span> <span class="n">order</span><span class="p">[</span><span class="n">start</span><span class="p">:</span><span class="n">start</span> <span class="o">+</span> <span class="n">batch_size</span><span class="p">]</span>
        <span class="n">batch</span> <span class="o">=</span> <span class="nf">tok</span><span class="p">([</span><span class="n">prefix</span> <span class="o">+</span> <span class="n">texts</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">rows</span><span class="p">],</span> <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">truncation</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
                    <span class="n">max_length</span><span class="o">=</span><span class="n">max_length</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
        <span class="n">padding</span> <span class="o">=</span> <span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">attention_mask</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="mi">0</span>
        <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">autocast</span><span class="p">(</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float16</span><span class="p">,</span> <span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">):</span>
            <span class="n">hidden</span> <span class="o">=</span> <span class="nf">encoder</span><span class="p">(</span><span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">padding</span><span class="p">)</span>
        <span class="n">vectors</span> <span class="o">=</span> <span class="nf">pool</span><span class="p">(</span><span class="n">hidden</span><span class="p">.</span><span class="nf">float</span><span class="p">(),</span> <span class="n">padding</span><span class="p">,</span> <span class="n">how</span><span class="p">)</span>
        <span class="n">out</span><span class="p">[</span><span class="n">torch</span><span class="p">.</span><span class="nf">as_tensor</span><span class="p">(</span><span class="n">rows</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)]</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">normalize</span><span class="p">(</span><span class="n">vectors</span><span class="p">,</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">out</span>


<span class="k">def</span> <span class="nf">dense_search</span><span class="p">(</span><span class="n">name</span><span class="p">,</span> <span class="n">encoder</span><span class="p">,</span> <span class="n">how</span><span class="o">=</span><span class="sh">"</span><span class="s">mean</span><span class="sh">"</span><span class="p">,</span> <span class="n">prefix</span><span class="o">=</span><span class="sh">""</span><span class="p">,</span> <span class="n">tok</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
    <span class="sh">"""</span><span class="s">Encode the corpus once, then every question, and score all papers by cosine.</span><span class="sh">"""</span>
    <span class="n">docs</span> <span class="o">=</span> <span class="nf">embed</span><span class="p">(</span><span class="n">encoder</span><span class="p">,</span> <span class="n">texts</span><span class="p">,</span> <span class="mi">256</span><span class="p">,</span> <span class="n">how</span><span class="p">,</span> <span class="n">tok</span><span class="o">=</span><span class="n">tok</span><span class="p">)</span>
    <span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
    <span class="n">found</span> <span class="o">=</span> <span class="nf">embed</span><span class="p">(</span><span class="n">encoder</span><span class="p">,</span> <span class="n">questions</span><span class="p">,</span> <span class="mi">64</span><span class="p">,</span> <span class="n">how</span><span class="p">,</span> <span class="n">prefix</span><span class="p">,</span> <span class="n">tok</span><span class="o">=</span><span class="n">tok</span><span class="p">)</span> <span class="o">@</span> <span class="n">docs</span><span class="p">.</span><span class="n">T</span>
    <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
        <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">synchronize</span><span class="p">()</span>
    <span class="nf">display</span><span class="p">(</span><span class="nf">evaluate</span><span class="p">(</span><span class="n">name</span><span class="p">,</span> <span class="n">found</span><span class="p">,</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="p">,</span> <span class="n">docs</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span> <span class="o">*</span> <span class="mi">2</span><span class="p">))</span>  <span class="c1"># as float16
</span>    <span class="k">return</span> <span class="n">docs</span><span class="p">,</span> <span class="n">found</span>


<span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
<span class="n">base_docs</span><span class="p">,</span> <span class="n">base_scores</span> <span class="o">=</span> <span class="nf">dense_search</span><span class="p">(</span><span class="sh">"</span><span class="s">MiniLM-L6, as pre-trained</span><span class="sh">"</span><span class="p">,</span> <span class="n">base</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">texts</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> papers encoded in </span><span class="si">{</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> s</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">method</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@5</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@20</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">ms per question</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">index, MB</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">MiniLM-L6, as pre-trained</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.00</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.00</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.29</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">44.53</td></tr></tbody></table></div> <pre class="tfs-printed"><code>57,986 papers encoded in 105 s</code></pre> <p>Not one of the 593 questions finds its paper, not even in the top twenty. The histogram shows why: the cosines of random pairs of papers next to the cosines of questions with the papers they want.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">cosines</span><span class="p">(</span><span class="n">docs</span><span class="p">,</span> <span class="n">found</span><span class="p">,</span> <span class="n">n</span><span class="o">=</span><span class="mi">4000</span><span class="p">):</span>
    <span class="n">rng</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nc">Generator</span><span class="p">().</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
    <span class="n">pairs</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randint</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">docs</span><span class="p">),</span> <span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="mi">2</span><span class="p">),</span> <span class="n">generator</span><span class="o">=</span><span class="n">rng</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="n">random_pairs</span> <span class="o">=</span> <span class="p">(</span><span class="n">docs</span><span class="p">[</span><span class="n">pairs</span><span class="p">[:,</span> <span class="mi">0</span><span class="p">]]</span> <span class="o">*</span> <span class="n">docs</span><span class="p">[</span><span class="n">pairs</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">]]).</span><span class="nf">sum</span><span class="p">(</span><span class="mi">1</span><span class="p">).</span><span class="nf">cpu</span><span class="p">()</span>
    <span class="n">right</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">([</span><span class="n">found</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="n">wanted</span><span class="p">[</span><span class="mi">0</span><span class="p">]]</span> <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">wanted</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">gold</span><span class="p">)]).</span><span class="nf">cpu</span><span class="p">()</span>
    <span class="k">return</span> <span class="n">random_pairs</span><span class="p">,</span> <span class="n">right</span>


<span class="k">def</span> <span class="nf">cosine_histogram</span><span class="p">(</span><span class="n">ax</span><span class="p">,</span> <span class="n">docs</span><span class="p">,</span> <span class="n">found</span><span class="p">,</span> <span class="n">title</span><span class="p">):</span>
    <span class="n">random_pairs</span><span class="p">,</span> <span class="n">right</span> <span class="o">=</span> <span class="nf">cosines</span><span class="p">(</span><span class="n">docs</span><span class="p">,</span> <span class="n">found</span><span class="p">)</span>
    <span class="n">bins</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">linspace</span><span class="p">(</span><span class="o">-</span><span class="mf">0.2</span><span class="p">,</span> <span class="mf">1.0</span><span class="p">,</span> <span class="mi">61</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">hist</span><span class="p">(</span><span class="n">random_pairs</span><span class="p">,</span> <span class="n">bins</span><span class="o">=</span><span class="n">bins</span><span class="p">,</span> <span class="n">density</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">line</span><span class="sh">"</span><span class="p">],</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.9</span><span class="p">,</span>
            <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">two random papers</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">hist</span><span class="p">(</span><span class="n">right</span><span class="p">,</span> <span class="n">bins</span><span class="o">=</span><span class="n">bins</span><span class="p">,</span> <span class="n">density</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">],</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.75</span><span class="p">,</span>
            <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">a question and its paper</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="n">title</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">cosine</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_yticks</span><span class="p">([])</span>


<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.4</span><span class="p">,</span> <span class="mf">3.2</span><span class="p">))</span>
<span class="nf">cosine_histogram</span><span class="p">(</span><span class="n">ax</span><span class="p">,</span> <span class="n">base_docs</span><span class="p">,</span> <span class="n">base_scores</span><span class="p">,</span> <span class="sh">"</span><span class="s">MiniLM-L6 as pre-trained: all alike</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">loc</span><span class="o">=</span><span class="sh">"</span><span class="s">upper left</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/03/output-03.png" alt="Output of the code above" loading="lazy"></p> <p>Two random abstracts have a cosine of about 0.95, and a question with the paper it asks for only about 0.85.</p> <p>By this model’s measure a question is further from its own answer than any abstract is from any other abstract: the vectors say “this is an abstract” or “this is a question” much louder than what the text is about.</p> <p>All of them crowd together. <a href="https://arxiv.org/abs/1909.00512">Ethayarajh (2019)</a> found the same in almost every layer of BERT, ELMo and GPT-2: their representations are <strong>anisotropic</strong>, “occupying a narrow cone in the vector space” instead of spreading in all directions.</p> <p>So what does it return? Here are the papers it puts first most often:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">top5</span> <span class="o">=</span> <span class="n">base_scores</span><span class="p">.</span><span class="nf">topk</span><span class="p">(</span><span class="mi">5</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">).</span><span class="n">indices</span>
<span class="n">n_papers</span> <span class="o">=</span> <span class="n">top5</span><span class="p">.</span><span class="nf">unique</span><span class="p">().</span><span class="nf">numel</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">n_papers</span><span class="si">}</span><span class="s"> different papers fill the top five of </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">questions</span><span class="p">)</span><span class="si">}</span><span class="s"> questions</span><span class="sh">"</span><span class="p">)</span>
<span class="k">for</span> <span class="n">paper</span><span class="p">,</span> <span class="n">count</span> <span class="ow">in</span> <span class="nc">Counter</span><span class="p">(</span><span class="n">top5</span><span class="p">.</span><span class="nf">flatten</span><span class="p">().</span><span class="nf">tolist</span><span class="p">()).</span><span class="nf">most_common</span><span class="p">(</span><span class="mi">3</span><span class="p">):</span>
    <span class="n">name</span> <span class="o">=</span> <span class="n">re</span><span class="p">.</span><span class="nf">sub</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s">\s+</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">,</span> <span class="n">titles</span><span class="p">[</span><span class="n">paper</span><span class="p">]</span> <span class="ow">or</span> <span class="sh">"</span><span class="s">(no title) </span><span class="sh">"</span> <span class="o">+</span> <span class="n">texts</span><span class="p">[</span><span class="n">paper</span><span class="p">])</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">count</span><span class="si">:</span><span class="o">&gt;</span><span class="mi">4</span><span class="si">}</span><span class="s"> questions get: </span><span class="si">{</span><span class="n">name</span><span class="p">[</span><span class="si">:</span><span class="mi">72</span><span class="p">]</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>556 different papers fill the top five of 593 questions
  82 questions get: Why Neural Translations are the Right Length
  79 questions get: (no title) We detail methods for entity span identification and entity c
  70 questions get: Can language models capture syntactic associations without surface cues?</code></pre> <p>Most top fives differ, but a few papers turn up everywhere: <em>Why Neural Translations are the Right Length</em> is among the five best answers to 82 of the 593 questions, whatever they ask about. Such points sit near the middle of the crowd and are close to everything; retrieval people call them <strong>hubs</strong>.</p> <div class="callout callout-key"> <p class="callout-label">Key point</p> <p>Nothing in masked language modelling asked the model to put texts with similar meanings close together and the rest far apart; its vectors are good for the next layer, not for being compared with each other. To compare, the encoder has to be trained to compare.</p> </div> <h2 id="4-sentence-bert-teaching-an-encoder-to-compare">4. Sentence-BERT: teaching an encoder to compare</h2> <p>Sentence-BERT’s architecture is a single encoder applied to each text separately, a <strong>bi-encoder</strong> (the paper calls it siamese), with mean pooling on top. All the novelty is in the training. In 2019 it learned from pairs of sentences labelled by people as entailment, contradiction or neutral, the SNLI and MultiNLI datasets.</p> <p>Today the standard is <strong>contrastive training with in-batch negatives</strong>, which needs no labels at all, only pairs of texts that belong together: a question and its answer, a title and its abstract.</p> <p>Google’s Smart Reply team put it in one sentence: “we use the responses of other examples in a training batch … as negative responses” <sup class="cite">[<a href="#ref-5" id="cite-5" data-ref="5" aria-label="Reference 5: Henderson, M., Al-Rfou, R., Strope, B., Sung, Y., Lukács, L., Guo, R., Kumar, S., Miklos, B., &amp; Kurzweil, R. (2017). Efficient natural language response suggestion for Smart Reply. arXiv:1705.00652.">5</a>]</sup>, and Dense Passage Retrieval made the trick standard for search<sup class="cite">[<a href="#ref-6" id="cite-6" data-ref="6" aria-label="Reference 6: Karpukhin, V., Oğuz, B., Min, S., Lewis, P., Wu, L., Edunov, S., Chen, D., &amp; Yih, W. (2020). Dense passage retrieval for open-domain question answering. EMNLP 2020.">6</a>]</sup>.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/03/inbatch-light.png" width="760" alt="Training with in-batch negatives. A batch holds the titles and abstracts of four papers. Every title is compared with every abstract; for each title, its own abstract is the right answer and the other abstracts of the batch are wrong ones, so the loss is cross-entropy over each row of the similarity matrix" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/03/inbatch-dark.png" width="760" alt="Training with in-batch negatives. A batch holds the titles and abstracts of four papers. Every title is compared with every abstract; for each title, its own abstract is the right answer and the other abstracts of the batch are wrong ones, so the loss is cross-entropy over each row of the similarity matrix" loading="lazy"></p> <p>A batch holds \(B\) pairs \((t_i, a_i)\). Every title is compared with every abstract, and the loss asks each title to pick its own abstract out of the \(B\), as a classification with \(B\) classes:</p> \[\mathcal{L} = -\frac{1}{B} \sum_{i=1}^{B} \log \frac{\exp\left(s \cdot \cos(t_i, a_i)\right)}{\sum_{j=1}^{B} \exp\left(s \cdot \cos(t_i, a_j)\right)}\] <p>This loss has many names: InfoNCE<sup class="cite">[<a href="#ref-7" id="cite-7" data-ref="7" aria-label="Reference 7: van den Oord, A., Li, Y., &amp; Vinyals, O. (2018). Representation learning with contrastive predictive coding. arXiv:1807.03748.">7</a>]</sup>, the multiple negatives ranking loss, NT-Xent. The scale \(s = 20\), a temperature of 0.05, is what the sentence-transformers library uses by default: cosines live in \([-1, 1]\), and without the scale the softmax over them would be almost flat.</p> <p>Our pairs are the titles and abstracts of the corpus itself, and that is the practical point. We use no question of LitSearch for training, only the papers we are going to search.</p> <div class="callout"> <p class="callout-label">In practice</p> <p>A company that wants search over its own documents rarely has thousands of labelled queries, but it always has documents, and documents have structure: titles and bodies, questions and answers in a support system, a function’s docstring and its code.</p> </div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">both</span> <span class="o">=</span> <span class="p">[</span><span class="n">i</span> <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="p">(</span><span class="n">t</span><span class="p">,</span> <span class="n">a</span><span class="p">)</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="nf">zip</span><span class="p">(</span><span class="n">titles</span><span class="p">,</span> <span class="n">papers</span><span class="p">[</span><span class="sh">"</span><span class="s">abstract</span><span class="sh">"</span><span class="p">]))</span> <span class="k">if</span> <span class="n">t</span> <span class="ow">and</span> <span class="n">a</span><span class="p">.</span><span class="nf">strip</span><span class="p">()]</span>
<span class="n">pairs</span> <span class="o">=</span> <span class="p">[(</span><span class="n">titles</span><span class="p">[</span><span class="n">i</span><span class="p">],</span> <span class="n">papers</span><span class="p">[</span><span class="sh">"</span><span class="s">abstract</span><span class="sh">"</span><span class="p">][</span><span class="n">i</span><span class="p">])</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">both</span><span class="p">]</span>
<span class="n">BATCH</span><span class="p">,</span> <span class="n">EPOCHS</span> <span class="o">=</span> <span class="p">(</span><span class="mi">16</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="nf">else </span><span class="p">(</span><span class="mi">128</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
<span class="n">steps</span> <span class="o">=</span> <span class="n">EPOCHS</span> <span class="o">*</span> <span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">pairs</span><span class="p">)</span> <span class="o">//</span> <span class="n">BATCH</span><span class="p">)</span>
<span class="k">if</span> <span class="n">SMOKE</span><span class="p">:</span>
    <span class="n">steps</span> <span class="o">=</span> <span class="mi">6</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">pairs</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> title–abstract pairs, </span><span class="si">{</span><span class="n">steps</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> steps of </span><span class="si">{</span><span class="n">BATCH</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>

<span class="n">student</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="nf">load_encoder</span><span class="p">(</span><span class="n">BASE</span><span class="p">,</span> <span class="sh">"</span><span class="s">pytorch_model.bin</span><span class="sh">"</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">pooled</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">texts</span><span class="p">,</span> <span class="n">max_length</span><span class="p">):</span>
    <span class="n">batch</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="n">texts</span><span class="p">,</span> <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">truncation</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">max_length</span><span class="o">=</span><span class="n">max_length</span><span class="p">,</span>
                      <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="n">padding</span> <span class="o">=</span> <span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">attention_mask</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="mi">0</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">autocast</span><span class="p">(</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float16</span><span class="p">,</span> <span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">):</span>
        <span class="n">hidden</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">padding</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">F</span><span class="p">.</span><span class="nf">normalize</span><span class="p">(</span><span class="nf">pool</span><span class="p">(</span><span class="n">hidden</span><span class="p">.</span><span class="nf">float</span><span class="p">(),</span> <span class="n">padding</span><span class="p">,</span> <span class="sh">"</span><span class="s">mean</span><span class="sh">"</span><span class="p">),</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">train_bi_encoder</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">scale</span><span class="o">=</span><span class="mf">20.0</span><span class="p">,</span> <span class="n">lr</span><span class="o">=</span><span class="mf">5e-5</span><span class="p">,</span> <span class="n">warmup</span><span class="o">=</span><span class="mi">100</span><span class="p">):</span>
    <span class="n">model</span><span class="p">.</span><span class="nf">train</span><span class="p">()</span>
    <span class="n">optimizer</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">optim</span><span class="p">.</span><span class="nc">AdamW</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="nf">parameters</span><span class="p">(),</span> <span class="n">lr</span><span class="o">=</span><span class="n">lr</span><span class="p">)</span>
    <span class="n">schedule</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">optim</span><span class="p">.</span><span class="n">lr_scheduler</span><span class="p">.</span><span class="nc">LambdaLR</span><span class="p">(</span>
        <span class="n">optimizer</span><span class="p">,</span> <span class="k">lambda</span> <span class="n">s</span><span class="p">:</span> <span class="nf">min</span><span class="p">(</span><span class="mf">1.0</span><span class="p">,</span> <span class="p">(</span><span class="n">s</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">warmup</span><span class="p">)</span> <span class="o">*</span> <span class="nf">max</span><span class="p">(</span><span class="mf">0.0</span><span class="p">,</span> <span class="mi">1</span> <span class="o">-</span> <span class="n">s</span> <span class="o">/</span> <span class="n">steps</span><span class="p">))</span>
    <span class="n">scaler</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">amp</span><span class="p">.</span><span class="nc">GradScaler</span><span class="p">(</span><span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">g</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nc">Generator</span><span class="p">().</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
    <span class="n">order</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">torch</span><span class="p">.</span><span class="nf">randperm</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">pairs</span><span class="p">),</span> <span class="n">generator</span><span class="o">=</span><span class="n">g</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">EPOCHS</span><span class="p">)])</span>
    <span class="n">log</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">step</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">steps</span><span class="p">):</span>
        <span class="n">batch</span> <span class="o">=</span> <span class="p">[</span><span class="n">pairs</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">order</span><span class="p">[</span><span class="n">step</span> <span class="o">*</span> <span class="n">BATCH</span><span class="p">:(</span><span class="n">step</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">*</span> <span class="n">BATCH</span><span class="p">]]</span>
        <span class="n">t</span> <span class="o">=</span> <span class="nf">pooled</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="p">[</span><span class="n">title</span> <span class="k">for</span> <span class="n">title</span><span class="p">,</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">batch</span><span class="p">],</span> <span class="mi">32</span><span class="p">)</span>
        <span class="n">a</span> <span class="o">=</span> <span class="nf">pooled</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="p">[</span><span class="n">abstract</span> <span class="k">for</span> <span class="n">_</span><span class="p">,</span> <span class="n">abstract</span> <span class="ow">in</span> <span class="n">batch</span><span class="p">],</span> <span class="mi">256</span><span class="p">)</span>
        <span class="n">logits</span> <span class="o">=</span> <span class="n">scale</span> <span class="o">*</span> <span class="n">t</span> <span class="o">@</span> <span class="n">a</span><span class="p">.</span><span class="n">T</span>  <span class="c1"># row i: title i against every abstract of the batch
</span>        <span class="n">target</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">batch</span><span class="p">),</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
        <span class="n">loss</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span><span class="n">logits</span><span class="p">,</span> <span class="n">target</span><span class="p">)</span>
        <span class="n">optimizer</span><span class="p">.</span><span class="nf">zero_grad</span><span class="p">()</span>
        <span class="n">scaler</span><span class="p">.</span><span class="nf">scale</span><span class="p">(</span><span class="n">loss</span><span class="p">).</span><span class="nf">backward</span><span class="p">()</span>
        <span class="n">scaler</span><span class="p">.</span><span class="nf">unscale_</span><span class="p">(</span><span class="n">optimizer</span><span class="p">)</span>
        <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="n">utils</span><span class="p">.</span><span class="nf">clip_grad_norm_</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="nf">parameters</span><span class="p">(),</span> <span class="mf">1.0</span><span class="p">)</span>
        <span class="n">scaler</span><span class="p">.</span><span class="nf">step</span><span class="p">(</span><span class="n">optimizer</span><span class="p">)</span>
        <span class="n">scaler</span><span class="p">.</span><span class="nf">update</span><span class="p">()</span>
        <span class="n">schedule</span><span class="p">.</span><span class="nf">step</span><span class="p">()</span>
        <span class="n">accuracy</span> <span class="o">=</span> <span class="p">(</span><span class="n">logits</span><span class="p">.</span><span class="nf">argmax</span><span class="p">(</span><span class="mi">1</span><span class="p">)</span> <span class="o">==</span> <span class="n">target</span><span class="p">).</span><span class="nf">float</span><span class="p">().</span><span class="nf">mean</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
        <span class="n">log</span><span class="p">.</span><span class="nf">append</span><span class="p">((</span><span class="n">loss</span><span class="p">.</span><span class="nf">item</span><span class="p">(),</span> <span class="n">accuracy</span><span class="p">))</span>
    <span class="k">return</span> <span class="n">model</span><span class="p">.</span><span class="nf">eval</span><span class="p">(),</span> <span class="n">np</span><span class="p">.</span><span class="nf">array</span><span class="p">(</span><span class="n">log</span><span class="p">)</span>


<span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
<span class="n">student</span><span class="p">,</span> <span class="n">log</span> <span class="o">=</span> <span class="nf">train_bi_encoder</span><span class="p">(</span><span class="n">student</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">trained in </span><span class="si">{</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> s</span><span class="sh">"</span><span class="p">)</span>

<span class="n">fig</span><span class="p">,</span> <span class="p">(</span><span class="n">left</span><span class="p">,</span> <span class="n">right</span><span class="p">)</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">8.4</span><span class="p">,</span> <span class="mf">3.0</span><span class="p">))</span>
<span class="n">window</span> <span class="o">=</span> <span class="nf">max</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">log</span><span class="p">)</span> <span class="o">//</span> <span class="mi">40</span><span class="p">)</span>
<span class="n">smooth</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">array</span><span class="p">([</span><span class="n">log</span><span class="p">[</span><span class="nf">max</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">i</span> <span class="o">-</span> <span class="n">window</span><span class="p">):</span><span class="n">i</span> <span class="o">+</span> <span class="mi">1</span><span class="p">].</span><span class="nf">mean</span><span class="p">(</span><span class="mi">0</span><span class="p">)</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">log</span><span class="p">))])</span>
<span class="n">left</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">smooth</span><span class="p">[:,</span> <span class="mi">0</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">])</span>
<span class="n">left</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">loss</span><span class="sh">"</span><span class="p">)</span>
<span class="n">right</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">smooth</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">])</span>
<span class="n">right</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">title finds its abstract among </span><span class="si">{</span><span class="n">BATCH</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="k">for</span> <span class="n">ax</span> <span class="ow">in</span> <span class="p">(</span><span class="n">left</span><span class="p">,</span> <span class="n">right</span><span class="p">):</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">step</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <pre class="tfs-printed"><code>55,631 title–abstract pairs, 868 steps of 128
trained in 529 s</code></pre> <p><img class="tfs-output" src="/assets/posts/arch/03/output-04.png" alt="loss" loading="lazy"></p> <p>Within a few hundred steps a title finds its own abstract among 128 nine times out of ten. That is the training task; whether it carries over to questions the model has never seen is what the evaluation says.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">student_docs</span><span class="p">,</span> <span class="n">student_scores</span> <span class="o">=</span> <span class="nf">dense_search</span><span class="p">(</span><span class="sh">"</span><span class="s">MiniLM-L6, trained here</span><span class="sh">"</span><span class="p">,</span> <span class="n">student</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">method</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@5</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@20</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">ms per question</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">index, MB</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">MiniLM-L6, trained here</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.46</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.25</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">44.53</td></tr></tbody></table></div> <p>From nothing to a third of the questions in ten minutes, without a single question in the training data. It is still well below BM25, and the reasons are plain: titles are not questions, and 55,000 pairs are not many.</p> <p>Here is the similarity matrix of eight papers the model trained on, as it looks after training. Six of the eight titles find their own abstract, on the diagonal. The misses are telling: SPREADING VECTORS FOR SIMILARITY SEARCH shares hardly a word with its abstract, which is about quantizers for indexing.</p> <p>And the bright cells off the diagonal are not noise: the two papers on federated learning, rows 3 and 5, come out close to each other’s abstracts, which is what a search engine should want.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">sample</span> <span class="o">=</span> <span class="n">both</span><span class="p">[:</span><span class="mi">8</span><span class="p">]</span>
<span class="n">short</span> <span class="o">=</span> <span class="p">[</span><span class="n">re</span><span class="p">.</span><span class="nf">sub</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s">\s+</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">,</span> <span class="n">titles</span><span class="p">[</span><span class="n">i</span><span class="p">])[:</span><span class="mi">38</span><span class="p">]</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">sample</span><span class="p">]</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">t</span> <span class="o">=</span> <span class="nf">pooled</span><span class="p">(</span><span class="n">student</span><span class="p">,</span> <span class="p">[</span><span class="n">titles</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">sample</span><span class="p">],</span> <span class="mi">32</span><span class="p">)</span>
    <span class="n">a</span> <span class="o">=</span> <span class="nf">pooled</span><span class="p">(</span><span class="n">student</span><span class="p">,</span> <span class="p">[</span><span class="n">papers</span><span class="p">[</span><span class="sh">"</span><span class="s">abstract</span><span class="sh">"</span><span class="p">][</span><span class="n">i</span><span class="p">]</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">sample</span><span class="p">],</span> <span class="mi">256</span><span class="p">)</span>
<span class="nf">heatmap</span><span class="p">((</span><span class="n">t</span> <span class="o">@</span> <span class="n">a</span><span class="p">.</span><span class="n">T</span><span class="p">).</span><span class="nf">cpu</span><span class="p">().</span><span class="nf">numpy</span><span class="p">(),</span> <span class="n">rows</span><span class="o">=</span><span class="n">short</span><span class="p">,</span> <span class="n">cols</span><span class="o">=</span><span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="s">abstract </span><span class="si">{</span><span class="n">k</span> <span class="o">+</span> <span class="mi">1</span><span class="si">}</span><span class="sh">"</span> <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">8</span><span class="p">)],</span>
        <span class="n">annotate</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">fmt</span><span class="o">=</span><span class="sh">"</span><span class="s">{:.2f}</span><span class="sh">"</span><span class="p">,</span> <span class="n">cell</span><span class="o">=</span><span class="mf">0.62</span><span class="p">,</span> <span class="n">vmin</span><span class="o">=-</span><span class="mf">0.2</span><span class="p">,</span> <span class="n">vmax</span><span class="o">=</span><span class="mf">1.0</span><span class="p">,</span> <span class="n">role</span><span class="o">=</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">,</span>
        <span class="n">title</span><span class="o">=</span><span class="sh">"</span><span class="s">Titles against abstracts after training</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">8.8</span><span class="p">,</span> <span class="mf">3.0</span><span class="p">),</span> <span class="n">sharex</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="nf">cosine_histogram</span><span class="p">(</span><span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="n">base_docs</span><span class="p">,</span> <span class="n">base_scores</span><span class="p">,</span> <span class="sh">"</span><span class="s">before</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">cosine_histogram</span><span class="p">(</span><span class="n">axes</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="n">student_docs</span><span class="p">,</span> <span class="n">student_scores</span><span class="p">,</span> <span class="sh">"</span><span class="s">after training on our pairs</span><span class="sh">"</span><span class="p">)</span>
<span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">legend</span><span class="p">(</span><span class="n">loc</span><span class="o">=</span><span class="sh">"</span><span class="s">upper left</span><span class="sh">"</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">8</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/03/output-05.png" alt="Titles against abstracts after training" loading="lazy"></p> <p><img class="tfs-output" src="/assets/posts/arch/03/output-06.png" alt="Titles against abstracts after training" loading="lazy"></p> <p>The cone has opened. Random pairs of papers now spread around zero, and the questions, which the model never saw during training, sit to the right of them, around 0.5. The model learned what makes two texts in this corpus mean the same thing, from the corpus alone.</p> <h2 id="5-what-a-billion-pairs-buy">5. What a billion pairs buy</h2> <p><strong>all-MiniLM-L6-v2</strong> is not just the most popular embedding model: with 184 million downloads in the month before this lesson was written, it is the most downloaded model of any kind on the Hugging Face Hub.</p> <p>Its model card says it started from exactly our <code class="language-plaintext highlighter-rouge">nreimers/MiniLM-L6-H384-uncased</code> and was trained with the same loss, on 1,170,060,424 pairs from 290 sources: Reddit, Stack Exchange, WikiAnswers, PAQ, and 41,769,185 titles with their abstracts from the S2ORC corpus of scientific papers, which is our task at 750 times our scale. It trained for 100,000 steps of 1,024 pairs on a TPU v3-8.</p> <p>Same architecture, same starting point, same loss; only the data differ. So the comparison with our model shows what the data buy. Its weights load into our code, and the check against Hugging Face’s <code class="language-plaintext highlighter-rouge">BertModel</code>:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">MINILM</span> <span class="o">=</span> <span class="sh">"</span><span class="s">sentence-transformers/all-MiniLM-L6-v2</span><span class="sh">"</span>
<span class="n">minilm</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="nf">load_encoder</span><span class="p">(</span><span class="n">MINILM</span><span class="p">)</span>
<span class="n">reference</span> <span class="o">=</span> <span class="n">BertModel</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">MINILM</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="n">check</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="n">questions</span><span class="p">[:</span><span class="mi">4</span><span class="p">],</span> <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="n">padding</span> <span class="o">=</span> <span class="n">check</span><span class="p">[</span><span class="sh">"</span><span class="s">attention_mask</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="mi">0</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">theirs</span> <span class="o">=</span> <span class="nf">reference</span><span class="p">(</span><span class="o">**</span><span class="n">check</span><span class="p">).</span><span class="n">last_hidden_state</span>
    <span class="n">ours</span> <span class="o">=</span> <span class="nf">minilm</span><span class="p">(</span><span class="n">check</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">padding</span><span class="p">)</span>
<span class="n">gap</span> <span class="o">=</span> <span class="p">(</span><span class="n">ours</span> <span class="o">-</span> <span class="n">theirs</span><span class="p">)[</span><span class="o">~</span><span class="n">padding</span><span class="p">].</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">largest difference from Hugging Face: </span><span class="si">{</span><span class="n">gap</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="k">assert</span> <span class="n">gap</span> <span class="o">&lt;</span> <span class="mf">1e-3</span>
<span class="k">del</span> <span class="n">reference</span>

<span class="n">minilm_docs</span><span class="p">,</span> <span class="n">minilm_scores</span> <span class="o">=</span> <span class="nf">dense_search</span><span class="p">(</span><span class="sh">"</span><span class="s">all-MiniLM-L6-v2</span><span class="sh">"</span><span class="p">,</span> <span class="n">minilm</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>largest difference from Hugging Face: 1.8e-06</code></pre> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">method</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@5</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@20</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">ms per question</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">index, MB</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all-MiniLM-L6-v2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.42</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.59</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.25</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">44.53</td></tr></tbody></table></div> <p>Ten points above our ten-minute model, and still three below BM25: 750 times more of our task, and a billion other pairs, bought ten points. Before going further, one more thing that costs nothing to check. The model was trained with mean pooling; here it is read with the <code class="language-plaintext highlighter-rouge">[CLS]</code> vector instead, the other common choice:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">_</span> <span class="o">=</span> <span class="nf">dense_search</span><span class="p">(</span><span class="sh">"</span><span class="s">all-MiniLM-L6-v2, [CLS] instead of the mean</span><span class="sh">"</span><span class="p">,</span> <span class="n">minilm</span><span class="p">,</span> <span class="sh">"</span><span class="s">cls</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">method</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@5</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@20</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">ms per question</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">index, MB</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all-MiniLM-L6-v2, [CLS] instead of the mean</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.30</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.43</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.25</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">44.53</td></tr></tbody></table></div> <div class="callout callout-warn"> <p class="callout-label">Trap</p> <p>Twelve points gone, without an error or a warning: the vectors look like vectors, and the search still works, only worse. A model is its weights and its pooling, and the card says which pooling.</p> </div> <p>The most practical question of the section is the next one. We have a general model trained on a billion pairs, and a corpus with 55,000 pairs of its own. Does a few minutes of the same training on our titles and abstracts, starting from all-MiniLM-L6-v2 instead of from scratch, adapt it to this corpus?</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">adapted</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="nf">load_encoder</span><span class="p">(</span><span class="n">MINILM</span><span class="p">)</span>
<span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
<span class="n">adapted</span><span class="p">,</span> <span class="n">adapted_log</span> <span class="o">=</span> <span class="nf">train_bi_encoder</span><span class="p">(</span><span class="n">adapted</span><span class="p">,</span> <span class="n">lr</span><span class="o">=</span><span class="mf">2e-5</span><span class="p">)</span>
<span class="n">found</span> <span class="o">=</span> <span class="n">adapted_log</span><span class="p">[</span><span class="o">-</span><span class="mi">50</span><span class="p">:,</span> <span class="mi">1</span><span class="p">].</span><span class="nf">mean</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">adapted in </span><span class="si">{</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> s; in the last 50 steps a title found </span><span class="sh">"</span>
      <span class="sa">f</span><span class="sh">"</span><span class="s">its abstract </span><span class="si">{</span><span class="n">found</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="o">%</span><span class="si">}</span><span class="s"> of the time</span><span class="sh">"</span><span class="p">)</span>
<span class="n">adapted_docs</span><span class="p">,</span> <span class="n">adapted_scores</span> <span class="o">=</span> <span class="nf">dense_search</span><span class="p">(</span><span class="sh">"</span><span class="s">all-MiniLM-L6-v2, adapted here</span><span class="sh">"</span><span class="p">,</span> <span class="n">adapted</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>adapted in 527 s; in the last 50 steps a title found its abstract 97% of the time</code></pre> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">method</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@5</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@20</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">ms per question</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">index, MB</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all-MiniLM-L6-v2, adapted here</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.51</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.65</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.25</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">44.53</td></tr></tbody></table></div> <p class="takeaway">Ten minutes of the same training took all-MiniLM-L6-v2 from 0.42 to 0.51, above BM25.</p> <p>The general model brought what a billion pairs teach about language; our pairs showed it what this corpus’s titles and abstracts look like. This is the cheapest improvement in the lesson, and it is open to anyone with a corpus: no labels, no questions, one T4.</p> <p><strong>BGE</strong> models from the Beijing Academy of Artificial Intelligence are a newer generation of the same idea <sup class="cite">[<a href="#ref-8" id="cite-8" data-ref="8" aria-label="Reference 8: Xiao, S., Liu, Z., Zhang, P., Muennighoff, N., Lian, D., &amp; Nie, J.-Y. (2023). C-Pack: packed resources for general Chinese embeddings. SIGIR 2024.">8</a>]</sup>: BERT’s architecture again, with <a href="/blog/2024/llms-for-those-who-missed-out/">pre-training</a> aimed at retrieval, contrastive training on a larger and cleaner collection, and a final round on labelled data.</p> <p>The base size has 12 layers and 768 dimensions. Its model card says two things that are easy to miss: the embedding is the vector of <code class="language-plaintext highlighter-rouge">[CLS]</code>, not the mean, and a query, though not a document, should start with an instruction; without it, the card promises “a slight degradation”.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">BGE</span> <span class="o">=</span> <span class="sh">"</span><span class="s">BAAI/bge-base-en-v1.5</span><span class="sh">"</span>
<span class="n">INSTRUCTION</span> <span class="o">=</span> <span class="sh">"</span><span class="s">Represent this sentence for searching relevant passages: </span><span class="sh">"</span>
<span class="n">bge</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="nf">load_encoder</span><span class="p">(</span><span class="n">BGE</span><span class="p">)</span>
<span class="n">bge_tokenizer</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">BGE</span><span class="p">)</span>
<span class="n">bge_docs</span><span class="p">,</span> <span class="n">bge_scores</span> <span class="o">=</span> <span class="nf">dense_search</span><span class="p">(</span><span class="sh">"</span><span class="s">bge-base-en-v1.5</span><span class="sh">"</span><span class="p">,</span> <span class="n">bge</span><span class="p">,</span> <span class="sh">"</span><span class="s">cls</span><span class="sh">"</span><span class="p">,</span> <span class="n">INSTRUCTION</span><span class="p">,</span>
                                   <span class="n">tok</span><span class="o">=</span><span class="n">bge_tokenizer</span><span class="p">)</span>
<span class="n">_</span> <span class="o">=</span> <span class="nf">dense_search</span><span class="p">(</span><span class="sh">"</span><span class="s">bge-base-en-v1.5, mean pooling, no instruction</span><span class="sh">"</span><span class="p">,</span> <span class="n">bge</span><span class="p">,</span>
                 <span class="n">tok</span><span class="o">=</span><span class="n">bge_tokenizer</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">method</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@5</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@20</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">ms per question</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">index, MB</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">bge-base-en-v1.5</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.50</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.67</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.83</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">89.07</td></tr></tbody></table></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">method</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@5</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@20</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">ms per question</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">index, MB</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">bge-base-en-v1.5, mean pooling, no instruction</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.51</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.66</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.71</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">89.07</td></tr></tbody></table></div> <p>bge-base-en-v1.5, with twice the layers and twice the width, scores 0.50: the same as the small model adapted to our corpus, with an index twice the size and three times the time per question. The second line holds a surprise.</p> <p>Used against its card’s advice, with mean pooling and no instruction, bge does no worse. Its card warns only of “a slight degradation” without the instruction, and here even that is lost in the noise, while all-MiniLM-L6-v2 read with <code class="language-plaintext highlighter-rouge">[CLS]</code> lost twelve points. Pooling matters for one model and not for another, and you can’t know which without checking.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">results</span><span class="p">))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">method</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@5</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@20</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">ms per question</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">index, MB</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">BM25</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.45</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.60</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.03</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">34.77</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">MiniLM-L6, as pre-trained</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.00</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.00</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.29</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">44.53</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">MiniLM-L6, trained here</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.46</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.25</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">44.53</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all-MiniLM-L6-v2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.42</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.59</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.25</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">44.53</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all-MiniLM-L6-v2, [CLS] instead of the mean</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.30</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.43</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.25</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">44.53</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all-MiniLM-L6-v2, adapted here</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.51</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.65</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.25</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">44.53</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">bge-base-en-v1.5</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.50</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.67</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.83</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">89.07</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">bge-base-en-v1.5, mean pooling, no instruction</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.51</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.66</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.71</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">89.07</td></tr></tbody></table></div> <h2 id="6-the-cross-encoder-reading-the-question-and-the-paper-together">6. The cross-encoder: reading the question and the paper together</h2> <p>A bi-encoder never sees the query and the document at the same time; it compares two summaries written independently.</p> <p>A <strong>cross-encoder</strong> is plain BERT reading a pair of texts, in the input format of <a href="/blog/2026/transformer-architectures-01-bert/">lesson 1</a>: the query and the document go in as one sequence, <code class="language-plaintext highlighter-rouge">[CLS] query [SEP] document [SEP]</code>, the two parts marked by their segment ids, and every token of the query attends to every token of the document in every layer.</p> <p>On top sits a classifier that turns the <code class="language-plaintext highlighter-rouge">[CLS]</code> vector into one number, a relevance score.</p> <p>Putting BERT on top of BM25 this way was one of the first places where BERT took over search <sup class="cite">[<a href="#ref-9" id="cite-9" data-ref="9" aria-label="Reference 9: Nogueira, R., &amp; Cho, K. (2019). Passage re-ranking with BERT. arXiv:1901.04085.">9</a>]</sup>. It is the most accurate of the three architectures and the most expensive: nothing can be computed before the query arrives.</p> <p>Scoring all 58,000 papers for one question would take 58,000 passes of the encoder. So a cross-encoder is used as a <strong>reranker</strong>: a fast retriever proposes a few dozen candidates and the cross-encoder reorders them.</p> <p>We take <code class="language-plaintext highlighter-rouge">cross-encoder/ms-marco-MiniLM-L6-v2</code>, the same six-layer MiniLM trained on MS MARCO: real Bing queries, each with the passages that human editors marked as containing the answer. Besides the encoder it has BERT’s <strong>pooler</strong>, a dense layer with tanh on the <code class="language-plaintext highlighter-rouge">[CLS]</code> vector, and the classifier with a single output.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">CrossEncoder</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">repo</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">encoder</span><span class="p">,</span> <span class="n">extra</span> <span class="o">=</span> <span class="nf">load_encoder</span><span class="p">(</span><span class="n">repo</span><span class="p">)</span>
        <span class="n">d</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">encoder</span><span class="p">.</span><span class="n">dim</span>
        <span class="n">self</span><span class="p">.</span><span class="n">pooler</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">classifier</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">),</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">pooler</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">({</span><span class="sh">"</span><span class="s">weight</span><span class="sh">"</span><span class="p">:</span> <span class="n">extra</span><span class="p">[</span><span class="sh">"</span><span class="s">pooler.dense.weight</span><span class="sh">"</span><span class="p">],</span>
                                     <span class="sh">"</span><span class="s">bias</span><span class="sh">"</span><span class="p">:</span> <span class="n">extra</span><span class="p">[</span><span class="sh">"</span><span class="s">pooler.dense.bias</span><span class="sh">"</span><span class="p">]})</span>
        <span class="n">self</span><span class="p">.</span><span class="n">classifier</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">({</span><span class="sh">"</span><span class="s">weight</span><span class="sh">"</span><span class="p">:</span> <span class="n">extra</span><span class="p">[</span><span class="sh">"</span><span class="s">classifier.weight</span><span class="sh">"</span><span class="p">],</span>
                                         <span class="sh">"</span><span class="s">bias</span><span class="sh">"</span><span class="p">:</span> <span class="n">extra</span><span class="p">[</span><span class="sh">"</span><span class="s">classifier.bias</span><span class="sh">"</span><span class="p">]})</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">padding</span><span class="p">,</span> <span class="n">segments</span><span class="p">):</span>
        <span class="n">hidden</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">encoder</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">padding</span><span class="p">,</span> <span class="n">segments</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">classifier</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">tanh</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">pooler</span><span class="p">(</span><span class="n">hidden</span><span class="p">[:,</span> <span class="mi">0</span><span class="p">]))).</span><span class="nf">squeeze</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>


<span class="n">RERANKER</span> <span class="o">=</span> <span class="sh">"</span><span class="s">cross-encoder/ms-marco-MiniLM-L6-v2</span><span class="sh">"</span>
<span class="n">reranker</span> <span class="o">=</span> <span class="nc">CrossEncoder</span><span class="p">(</span><span class="n">RERANKER</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="n">reranker_tokenizer</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">RERANKER</span><span class="p">)</span>
<span class="c1"># the reference reads the PyTorch file: this model's safetensors file keeps its tensors at
# offsets that aren't multiples of four bytes; Apple's CPU math library returns NaN there
</span><span class="n">reference</span> <span class="o">=</span> <span class="n">AutoModelForSequenceClassification</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">RERANKER</span><span class="p">,</span>
                                                               <span class="n">use_safetensors</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">reference</span> <span class="o">=</span> <span class="n">reference</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="n">pair</span> <span class="o">=</span> <span class="nf">reranker_tokenizer</span><span class="p">([</span><span class="n">questions</span><span class="p">[</span><span class="mi">0</span><span class="p">]]</span> <span class="o">*</span> <span class="mi">2</span><span class="p">,</span> <span class="p">[</span><span class="n">texts</span><span class="p">[</span><span class="n">gold</span><span class="p">[</span><span class="mi">0</span><span class="p">][</span><span class="mi">0</span><span class="p">]],</span> <span class="n">texts</span><span class="p">[</span><span class="mi">0</span><span class="p">]],</span> <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
                          <span class="n">truncation</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">max_length</span><span class="o">=</span><span class="mi">256</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">theirs</span> <span class="o">=</span> <span class="nf">reference</span><span class="p">(</span><span class="o">**</span><span class="n">pair</span><span class="p">).</span><span class="n">logits</span><span class="p">.</span><span class="nf">squeeze</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">ours</span> <span class="o">=</span> <span class="nf">reranker</span><span class="p">(</span><span class="n">pair</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">pair</span><span class="p">[</span><span class="sh">"</span><span class="s">attention_mask</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="mi">0</span><span class="p">,</span> <span class="n">pair</span><span class="p">[</span><span class="sh">"</span><span class="s">token_type_ids</span><span class="sh">"</span><span class="p">])</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">Hugging Face:</span><span class="sh">"</span><span class="p">,</span> <span class="n">theirs</span><span class="p">.</span><span class="nf">cpu</span><span class="p">().</span><span class="nf">numpy</span><span class="p">().</span><span class="nf">round</span><span class="p">(</span><span class="mi">3</span><span class="p">),</span> <span class="sh">"</span><span class="s"> ours:</span><span class="sh">"</span><span class="p">,</span> <span class="n">ours</span><span class="p">.</span><span class="nf">cpu</span><span class="p">().</span><span class="nf">numpy</span><span class="p">().</span><span class="nf">round</span><span class="p">(</span><span class="mi">3</span><span class="p">))</span>
<span class="nf">assert </span><span class="p">(</span><span class="n">ours</span> <span class="o">-</span> <span class="n">theirs</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">()</span> <span class="o">&lt;</span> <span class="mf">1e-3</span>
<span class="k">del</span> <span class="n">reference</span>
<span class="nf">print</span><span class="p">(</span><span class="n">reranker_tokenizer</span><span class="p">.</span><span class="nf">convert_ids_to_tokens</span><span class="p">(</span><span class="n">pair</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">][</span><span class="mi">0</span><span class="p">])[:</span><span class="mi">24</span><span class="p">])</span>
</code></pre></div></div> <pre class="tfs-printed"><code>Hugging Face: [ 1.074 -9.094]  ours: [ 1.074 -9.094]
['[CLS]', 'are', 'there', 'any', 'research', 'papers', 'on', 'methods', 'to', 'com', '##press', 'large', '-', 'scale', 'language', 'models', 'using', 'task', '-', 'ag', '##nostic', 'knowledge', 'di', '##sti']</code></pre> <p>The first pair is the first question with the paper it wants, the second the same question with a random paper: the scores are logits, and only their order matters. The reranker takes the top 50 papers of a first-stage search and replaces their scores with its own; everything below the 50 stays below.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">rerank</span><span class="p">(</span><span class="n">name</span><span class="p">,</span> <span class="n">scores</span><span class="p">,</span> <span class="n">depth</span><span class="o">=</span><span class="mi">50</span><span class="p">,</span> <span class="n">max_length</span><span class="o">=</span><span class="mi">320</span><span class="p">):</span>
    <span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
    <span class="n">candidates</span> <span class="o">=</span> <span class="n">scores</span><span class="p">.</span><span class="nf">topk</span><span class="p">(</span><span class="n">depth</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">).</span><span class="n">indices</span>
    <span class="n">reranked</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">full_like</span><span class="p">(</span><span class="n">scores</span><span class="p">,</span> <span class="o">-</span><span class="mf">1e4</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">question</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">questions</span><span class="p">):</span>
        <span class="n">docs</span> <span class="o">=</span> <span class="n">candidates</span><span class="p">[</span><span class="n">i</span><span class="p">].</span><span class="nf">tolist</span><span class="p">()</span>
        <span class="n">batch</span> <span class="o">=</span> <span class="nf">reranker_tokenizer</span><span class="p">([</span><span class="n">question</span><span class="p">]</span> <span class="o">*</span> <span class="n">depth</span><span class="p">,</span> <span class="p">[</span><span class="n">texts</span><span class="p">[</span><span class="n">j</span><span class="p">]</span> <span class="k">for</span> <span class="n">j</span> <span class="ow">in</span> <span class="n">docs</span><span class="p">],</span>
                                   <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">truncation</span><span class="o">=</span><span class="sh">"</span><span class="s">only_second</span><span class="sh">"</span><span class="p">,</span>
                                   <span class="n">max_length</span><span class="o">=</span><span class="n">max_length</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
        <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">autocast</span><span class="p">(</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float16</span><span class="p">,</span> <span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">):</span>
            <span class="n">logits</span> <span class="o">=</span> <span class="nf">reranker</span><span class="p">(</span><span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">attention_mask</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="mi">0</span><span class="p">,</span>
                              <span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">token_type_ids</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">reranked</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="n">candidates</span><span class="p">[</span><span class="n">i</span><span class="p">]]</span> <span class="o">=</span> <span class="n">logits</span><span class="p">.</span><span class="nf">float</span><span class="p">()</span>
    <span class="n">seconds</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span>
    <span class="nf">display</span><span class="p">(</span><span class="nf">evaluate</span><span class="p">(</span><span class="n">name</span><span class="p">,</span> <span class="n">reranked</span><span class="p">,</span> <span class="n">seconds</span><span class="p">,</span> <span class="mi">0</span><span class="p">))</span>
    <span class="k">return</span> <span class="n">reranked</span>


<span class="n">reranked_minilm</span> <span class="o">=</span> <span class="nf">rerank</span><span class="p">(</span><span class="sh">"</span><span class="s">all-MiniLM-L6-v2 → reranker</span><span class="sh">"</span><span class="p">,</span> <span class="n">minilm_scores</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">method</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@5</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@20</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">ms per question</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">index, MB</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all-MiniLM-L6-v2 → reranker</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.54</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.64</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">131.45</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.00</td></tr></tbody></table></div> <p class="takeaway">The reranker lifts all-MiniLM-L6-v2 from 0.42 to 0.54: reading each of the 50 candidates together with the question, it puts the right paper in the first five for about 70 more questions.</p> <p>It also takes 131 ms per question, five hundred times as long as the search that found the candidates. That is the trade a reranker always offers.</p> <h2 id="7-colbert-a-vector-for-every-token">7. ColBERT: a vector for every token</h2> <p>Between the two extremes sits <strong>late interaction</strong>, from Omar Khattab and Matei Zaharia at Stanford <sup class="cite">[<a href="#ref-10" id="cite-10" data-ref="10" aria-label="Reference 10: Khattab, O., &amp; Zaharia, M. (2020). ColBERT: efficient and effective passage search via contextualized late interaction over BERT. SIGIR 2020.">10</a>]</sup>. Like a bi-encoder, ColBERT encodes the query and the document separately, so the documents can be indexed in advance.</p> <p>Unlike it, ColBERT keeps a vector for every token, shrunk by a linear layer from 768 dimensions to 128 and normalised.</p> <p>The query and the document meet only at the very end, in <strong>MaxSim</strong>: every query token finds the document token most similar to it, and the document’s score is the sum of these best matches. Against a BERT reranker, the paper reported search “two orders-of-magnitude faster and requiring four orders-of-magnitude fewer FLOPs per query”.</p> \[\text{score}(q, d) = \sum_{i \in q} \max_{j \in d} \cos(q_i, d_j)\] <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/03/maxsim-light.png" width="760" alt="ColBERT's MaxSim. Every query token is compared by cosine with every token of the document; each query token keeps only its best match, and the document's score is the sum of these maxima. Here the query token 'rotary' finds 'rotation' and 'position' finds 'position'; the [MASK] tokens that pad the query also look for a match" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/03/maxsim-dark.png" width="760" alt="ColBERT's MaxSim. Every query token is compared by cosine with every token of the document; each query token keeps only its best match, and the document's score is the sum of these maxima. Here the query token 'rotary' finds 'rotation' and 'position' finds 'position'; the [MASK] tokens that pad the query also look for a match" loading="lazy"></p> <p>A few details matter for loading the real model, ColBERTv2 <sup class="cite">[<a href="#ref-11" id="cite-11" data-ref="11" aria-label="Reference 11: Santhanam, K., Khattab, O., Saad-Falcon, J., Potts, C., &amp; Zaharia, M. (2022). ColBERTv2: effective and efficient retrieval via lightweight late interaction. NAACL 2022.">11</a>]</sup>. The encoder is BERT-base. The query starts with a marker token after <code class="language-plaintext highlighter-rouge">[CLS]</code>, and the document with another; ColBERT’s code writes them into BERT’s unused vocabulary slots, <code class="language-plaintext highlighter-rouge">[unused0]</code> and <code class="language-plaintext highlighter-rouge">[unused1]</code>.</p> <p>A query is always 32 tokens long: what the question doesn’t fill is padded with <code class="language-plaintext highlighter-rouge">[MASK]</code>, the model doesn’t attend to these masks, but their output vectors still take part in MaxSim.</p> <p>The paper calls this <strong>query augmentation</strong>: the masks become soft extra query terms that the model fills with whatever the question implies. Document tokens that are punctuation are dropped from the index.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">ColBERT</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">repo</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">encoder</span><span class="p">,</span> <span class="n">extra</span> <span class="o">=</span> <span class="nf">load_encoder</span><span class="p">(</span><span class="n">repo</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">linear</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">encoder</span><span class="p">.</span><span class="n">dim</span><span class="p">,</span> <span class="mi">128</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">linear</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">({</span><span class="sh">"</span><span class="s">weight</span><span class="sh">"</span><span class="p">:</span> <span class="n">extra</span><span class="p">[</span><span class="sh">"</span><span class="s">linear.weight</span><span class="sh">"</span><span class="p">]})</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">padding</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">F</span><span class="p">.</span><span class="nf">normalize</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">linear</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">encoder</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">padding</span><span class="p">)),</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>


<span class="n">COLBERT</span> <span class="o">=</span> <span class="sh">"</span><span class="s">colbert-ir/colbertv2.0</span><span class="sh">"</span>
<span class="n">colbert</span> <span class="o">=</span> <span class="nc">ColBERT</span><span class="p">(</span><span class="n">COLBERT</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="n">colbert_tokenizer</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">COLBERT</span><span class="p">)</span>
<span class="n">Q_MARKER</span><span class="p">,</span> <span class="n">D_MARKER</span> <span class="o">=</span> <span class="n">colbert_tokenizer</span><span class="p">.</span><span class="nf">convert_tokens_to_ids</span><span class="p">([</span><span class="sh">"</span><span class="s">[unused0]</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">[unused1]</span><span class="sh">"</span><span class="p">])</span>
<span class="n">punctuation</span> <span class="o">=</span> <span class="n">colbert_tokenizer</span><span class="p">.</span><span class="nf">convert_tokens_to_ids</span><span class="p">(</span><span class="nf">list</span><span class="p">(</span><span class="n">string</span><span class="p">.</span><span class="n">punctuation</span><span class="p">))</span>
<span class="n">PUNCTUATION</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">punctuation</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>

<span class="n">reference</span> <span class="o">=</span> <span class="n">BertModel</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">COLBERT</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="n">check</span> <span class="o">=</span> <span class="nf">colbert_tokenizer</span><span class="p">(</span><span class="n">questions</span><span class="p">[:</span><span class="mi">4</span><span class="p">],</span> <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="n">padding</span> <span class="o">=</span> <span class="n">check</span><span class="p">[</span><span class="sh">"</span><span class="s">attention_mask</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="mi">0</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">theirs</span> <span class="o">=</span> <span class="nf">reference</span><span class="p">(</span><span class="o">**</span><span class="n">check</span><span class="p">).</span><span class="n">last_hidden_state</span>
    <span class="n">ours</span> <span class="o">=</span> <span class="n">colbert</span><span class="p">.</span><span class="nf">encoder</span><span class="p">(</span><span class="n">check</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">padding</span><span class="p">)</span>
<span class="n">gap</span> <span class="o">=</span> <span class="p">(</span><span class="n">ours</span> <span class="o">-</span> <span class="n">theirs</span><span class="p">)[</span><span class="o">~</span><span class="n">padding</span><span class="p">].</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">ColBERTv2</span><span class="sh">'</span><span class="s">s encoder, largest difference from Hugging Face: </span><span class="si">{</span><span class="n">gap</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="k">assert</span> <span class="n">gap</span> <span class="o">&lt;</span> <span class="mf">1e-3</span>
<span class="k">del</span> <span class="n">reference</span>


<span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">colbert_queries</span><span class="p">(</span><span class="n">texts</span><span class="p">,</span> <span class="n">length</span><span class="o">=</span><span class="mi">32</span><span class="p">):</span>
    <span class="n">batch</span> <span class="o">=</span> <span class="nf">colbert_tokenizer</span><span class="p">([</span><span class="sh">"</span><span class="s">. </span><span class="sh">"</span> <span class="o">+</span> <span class="n">t</span> <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="n">texts</span><span class="p">],</span> <span class="n">padding</span><span class="o">=</span><span class="sh">"</span><span class="s">max_length</span><span class="sh">"</span><span class="p">,</span>
                              <span class="n">truncation</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">max_length</span><span class="o">=</span><span class="n">length</span><span class="p">,</span>
                              <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="n">ids</span><span class="p">,</span> <span class="n">attended</span> <span class="o">=</span> <span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">attention_mask</span><span class="sh">"</span><span class="p">]</span>
    <span class="n">ids</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">]</span> <span class="o">=</span> <span class="n">Q_MARKER</span>  <span class="c1"># the original ColBERT code's trick: ". " held the marker's place
</span>    <span class="n">ids</span><span class="p">[</span><span class="n">ids</span> <span class="o">==</span> <span class="n">colbert_tokenizer</span><span class="p">.</span><span class="n">pad_token_id</span><span class="p">]</span> <span class="o">=</span> <span class="n">colbert_tokenizer</span><span class="p">.</span><span class="n">mask_token_id</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">autocast</span><span class="p">(</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float16</span><span class="p">,</span> <span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">):</span>
        <span class="k">return</span> <span class="nf">colbert</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">attended</span> <span class="o">==</span> <span class="mi">0</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">half</span><span class="p">),</span> <span class="n">ids</span>


<span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">colbert_documents</span><span class="p">(</span><span class="n">texts</span><span class="p">,</span> <span class="n">length</span><span class="o">=</span><span class="mi">180</span><span class="p">):</span>
    <span class="n">batch</span> <span class="o">=</span> <span class="nf">colbert_tokenizer</span><span class="p">([</span><span class="sh">"</span><span class="s">. </span><span class="sh">"</span> <span class="o">+</span> <span class="n">t</span> <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="n">texts</span><span class="p">],</span> <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">truncation</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
                              <span class="n">max_length</span><span class="o">=</span><span class="n">length</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="n">ids</span><span class="p">,</span> <span class="n">attended</span> <span class="o">=</span> <span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">attention_mask</span><span class="sh">"</span><span class="p">]</span>
    <span class="n">ids</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">]</span> <span class="o">=</span> <span class="n">D_MARKER</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">autocast</span><span class="p">(</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float16</span><span class="p">,</span> <span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">):</span>
        <span class="n">vectors</span> <span class="o">=</span> <span class="nf">colbert</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">attended</span> <span class="o">==</span> <span class="mi">0</span><span class="p">)</span>
    <span class="n">keep</span> <span class="o">=</span> <span class="p">(</span><span class="n">attended</span> <span class="o">==</span> <span class="mi">1</span><span class="p">)</span> <span class="o">&amp;</span> <span class="o">~</span><span class="n">torch</span><span class="p">.</span><span class="nf">isin</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">PUNCTUATION</span><span class="p">)</span>
    <span class="nf">return </span><span class="p">(</span><span class="n">vectors</span> <span class="o">*</span> <span class="n">keep</span><span class="p">.</span><span class="nf">unsqueeze</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)).</span><span class="nf">to</span><span class="p">(</span><span class="n">half</span><span class="p">),</span> <span class="n">keep</span><span class="p">,</span> <span class="n">ids</span>
</code></pre></div></div> <pre class="tfs-printed"><code>ColBERTv2's encoder, largest difference from Hugging Face: 2.1e-06</code></pre> <p>Before indexing anything, here is MaxSim at work on the first question and the paper it wants. Each row is a token of the question, each column a token of the abstract; the brightest cell of a row is the match that row contributes.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">q_vectors</span><span class="p">,</span> <span class="n">q_ids</span> <span class="o">=</span> <span class="nf">colbert_queries</span><span class="p">(</span><span class="n">questions</span><span class="p">[:</span><span class="mi">1</span><span class="p">])</span>
<span class="n">d_vectors</span><span class="p">,</span> <span class="n">d_keep</span><span class="p">,</span> <span class="n">d_ids</span> <span class="o">=</span> <span class="nf">colbert_documents</span><span class="p">([</span><span class="n">texts</span><span class="p">[</span><span class="n">gold</span><span class="p">[</span><span class="mi">0</span><span class="p">][</span><span class="mi">0</span><span class="p">]]])</span>
<span class="n">q_tokens</span> <span class="o">=</span> <span class="n">colbert_tokenizer</span><span class="p">.</span><span class="nf">convert_ids_to_tokens</span><span class="p">(</span><span class="n">q_ids</span><span class="p">[</span><span class="mi">0</span><span class="p">])</span>
<span class="n">d_tokens</span> <span class="o">=</span> <span class="n">colbert_tokenizer</span><span class="p">.</span><span class="nf">convert_ids_to_tokens</span><span class="p">(</span><span class="n">d_ids</span><span class="p">[</span><span class="mi">0</span><span class="p">])</span>
<span class="n">shown</span> <span class="o">=</span> <span class="p">[</span><span class="n">j</span> <span class="k">for</span> <span class="n">j</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">d_tokens</span><span class="p">))</span> <span class="k">if</span> <span class="n">d_keep</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="n">j</span><span class="p">]][:</span><span class="mi">36</span><span class="p">]</span>
<span class="n">n_words</span> <span class="o">=</span> <span class="n">q_tokens</span><span class="p">.</span><span class="nf">index</span><span class="p">(</span><span class="sh">"</span><span class="s">[SEP]</span><span class="sh">"</span><span class="p">)</span> <span class="o">+</span> <span class="mi">1</span>
<span class="n">similarity</span> <span class="o">=</span> <span class="p">(</span><span class="n">q_vectors</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="p">:</span><span class="n">n_words</span><span class="p">].</span><span class="nf">float</span><span class="p">()</span> <span class="o">@</span> <span class="n">d_vectors</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="n">shown</span><span class="p">].</span><span class="nf">float</span><span class="p">().</span><span class="n">T</span><span class="p">).</span><span class="nf">cpu</span><span class="p">().</span><span class="nf">numpy</span><span class="p">()</span>
<span class="nf">heatmap</span><span class="p">(</span><span class="n">similarity</span><span class="p">,</span> <span class="n">rows</span><span class="o">=</span><span class="n">q_tokens</span><span class="p">[:</span><span class="n">n_words</span><span class="p">],</span> <span class="n">cols</span><span class="o">=</span><span class="p">[</span><span class="n">d_tokens</span><span class="p">[</span><span class="n">j</span><span class="p">]</span> <span class="k">for</span> <span class="n">j</span> <span class="ow">in</span> <span class="n">shown</span><span class="p">],</span> <span class="n">cell</span><span class="o">=</span><span class="mf">0.26</span><span class="p">,</span>
        <span class="n">vmin</span><span class="o">=</span><span class="mf">0.0</span><span class="p">,</span> <span class="n">vmax</span><span class="o">=</span><span class="mf">1.0</span><span class="p">,</span> <span class="n">title</span><span class="o">=</span><span class="sh">"</span><span class="s">MaxSim: the question against the paper</span><span class="sh">'</span><span class="s">s first tokens</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">best match of each question token:</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">, </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">q</span><span class="si">}</span><span class="s">→</span><span class="si">{</span><span class="n">d_tokens</span><span class="p">[</span><span class="n">shown</span><span class="p">[</span><span class="n">j</span><span class="p">]]</span><span class="si">}</span><span class="sh">"</span> <span class="k">for</span> <span class="n">q</span><span class="p">,</span> <span class="n">j</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">q_tokens</span><span class="p">[</span><span class="mi">2</span><span class="p">:</span><span class="n">n_words</span> <span class="o">-</span> <span class="mi">1</span><span class="p">],</span>
                                                          <span class="n">similarity</span><span class="p">.</span><span class="nf">argmax</span><span class="p">(</span><span class="mi">1</span><span class="p">)[</span><span class="mi">2</span><span class="p">:</span><span class="o">-</span><span class="mi">1</span><span class="p">])))</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/03/output-07.png" alt="MaxSim: the question against the paper" loading="lazy"></p> <pre class="tfs-printed"><code>best match of each question token:
are→the, there→are, any→the, research→natural, papers→[unused1], on→of, methods→of, to→of, com→pre, ##press→##sti, large→tiny, -→of, scale→models, language→language, models→models, using→of, task→tasks, -→[CLS], ag→natural, ##nostic→bert, knowledge→understanding, di→di, ##sti→##sti, ##llation→##lling, techniques→of, ?→models</code></pre> <p>Most question tokens find their namesakes, piece by piece: <em>di</em>, <em>##sti</em>, <em>##llation</em> find the <em>di</em>, <em>##sti</em>, <em>##lling</em> of <em>TinyBERT: Distilling BERT</em>, and <em>language</em> and <em>models</em> find themselves.</p> <p>Some matches are about meaning rather than spelling: <em>large</em> finds <em>tiny</em>. The question’s filler words, <em>are</em>, <em>there</em>, <em>on</em>, <em>to</em>, settle for whatever filler is nearest; they add a little to every paper’s score and decide nothing.</p> <p>Now the whole corpus. The index keeps up to 180 vectors of 128 numbers for every paper. On a GPU we can afford to search it exhaustively: for every question, MaxSim against every paper, in blocks.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
<span class="n">order</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">argsort</span><span class="p">([</span><span class="o">-</span><span class="nf">len</span><span class="p">(</span><span class="n">t</span><span class="p">)</span> <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="n">texts</span><span class="p">])</span>
<span class="n">index</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">texts</span><span class="p">),</span> <span class="mi">180</span><span class="p">,</span> <span class="mi">128</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">half</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
<span class="n">n_vectors</span> <span class="o">=</span> <span class="mi">0</span>
<span class="k">for</span> <span class="n">s</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">texts</span><span class="p">),</span> <span class="mi">128</span><span class="p">):</span>
    <span class="n">rows</span> <span class="o">=</span> <span class="n">order</span><span class="p">[</span><span class="n">s</span><span class="p">:</span><span class="n">s</span> <span class="o">+</span> <span class="mi">128</span><span class="p">]</span>
    <span class="n">vectors</span><span class="p">,</span> <span class="n">keep</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="nf">colbert_documents</span><span class="p">([</span><span class="n">texts</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">rows</span><span class="p">])</span>
    <span class="n">index</span><span class="p">[</span><span class="n">torch</span><span class="p">.</span><span class="nf">as_tensor</span><span class="p">(</span><span class="n">rows</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">),</span> <span class="p">:</span><span class="n">vectors</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]]</span> <span class="o">=</span> <span class="n">vectors</span>
    <span class="n">n_vectors</span> <span class="o">+=</span> <span class="n">keep</span><span class="p">.</span><span class="nf">sum</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">indexed in </span><span class="si">{</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> s: </span><span class="si">{</span><span class="n">n_vectors</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> vectors, </span><span class="sh">"</span>
      <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">n_vectors</span> <span class="o">/</span> <span class="nf">len</span><span class="p">(</span><span class="n">texts</span><span class="p">)</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> per paper</span><span class="sh">"</span><span class="p">)</span>


<span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">maxsim_search</span><span class="p">(</span><span class="n">query_vectors</span><span class="p">,</span> <span class="n">block</span><span class="o">=</span><span class="mi">2048</span><span class="p">):</span>
    <span class="n">scores</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">empty</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">query_vectors</span><span class="p">),</span> <span class="nf">len</span><span class="p">(</span><span class="n">index</span><span class="p">),</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">qs</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">query_vectors</span><span class="p">),</span> <span class="mi">16</span><span class="p">):</span>
        <span class="n">q</span> <span class="o">=</span> <span class="n">query_vectors</span><span class="p">[</span><span class="n">qs</span><span class="p">:</span><span class="n">qs</span> <span class="o">+</span> <span class="mi">16</span><span class="p">]</span>
        <span class="k">for</span> <span class="n">ds</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">index</span><span class="p">),</span> <span class="n">block</span><span class="p">):</span>
            <span class="n">sim</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">einsum</span><span class="p">(</span><span class="sh">"</span><span class="s">aqd,nld-&gt;anql</span><span class="sh">"</span><span class="p">,</span> <span class="n">q</span><span class="p">,</span> <span class="n">index</span><span class="p">[</span><span class="n">ds</span><span class="p">:</span><span class="n">ds</span> <span class="o">+</span> <span class="n">block</span><span class="p">])</span>
            <span class="n">scores</span><span class="p">[</span><span class="n">qs</span><span class="p">:</span><span class="n">qs</span> <span class="o">+</span> <span class="mi">16</span><span class="p">,</span> <span class="n">ds</span><span class="p">:</span><span class="n">ds</span> <span class="o">+</span> <span class="n">block</span><span class="p">]</span> <span class="o">=</span> <span class="n">sim</span><span class="p">.</span><span class="nf">amax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">).</span><span class="nf">float</span><span class="p">().</span><span class="nf">sum</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">scores</span>


<span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
<span class="n">colbert_scores</span> <span class="o">=</span> <span class="nf">maxsim_search</span><span class="p">(</span><span class="nf">colbert_queries</span><span class="p">(</span><span class="n">questions</span><span class="p">)[</span><span class="mi">0</span><span class="p">])</span>
<span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
    <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">synchronize</span><span class="p">()</span>
<span class="nf">evaluate</span><span class="p">(</span><span class="sh">"</span><span class="s">ColBERTv2</span><span class="sh">"</span><span class="p">,</span> <span class="n">colbert_scores</span><span class="p">,</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span><span class="p">,</span> <span class="n">n_vectors</span> <span class="o">*</span> <span class="mi">128</span> <span class="o">*</span> <span class="mi">2</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>indexed in 209 s: 7,982,607 vectors, 138 per paper</code></pre> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">method</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@5</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@20</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">ms per question</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">index, MB</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">ColBERTv2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.47</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.62</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">13.77</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,043.55</td></tr></tbody></table></div> <p>ColBERTv2 lands between the small and the large single-vector models: 0.47, above BM25 and all-MiniLM-L6-v2, below bge and the adapted MiniLM. Its price is the index, eight million vectors and 2 GB in float16, more than twenty times bge’s, and 14 ms per question even on a GPU.</p> <p>Like the reranker, it learned what relevant means from MS MARCO’s web queries, not from questions about papers.</p> <h2 id="8-a-search-engine">8. A search engine</h2> <p>Each method has seen the questions its own way, and their mistakes differ. BM25 cannot know that <em>compressing a model</em> and <em>distillation</em> are related; an embedding can miss that the question names a specific dataset.</p> <p>The simplest way to combine rankings is <strong>reciprocal rank fusion</strong><sup class="cite">[<a href="#ref-12" id="cite-12" data-ref="12" aria-label="Reference 12: Cormack, G. V., Clarke, C. L. A., &amp; Büttcher, S. (2009). Reciprocal rank fusion outperforms Condorcet and individual rank learning methods. SIGIR 2009.">12</a>]</sup>: each paper gets \(\sum_r 1 / (60 + \text{rank}_r)\) over the rankings \(r\) that contain it. It needs no training and no calibration of scores, which is the point: BM25’s scores and cosines are on scales that have nothing to do with each other, and ranks are on the same scale by construction.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/03/pipeline-light.png" width="760" alt="A search engine in three stages. All papers go to two retrievers, BM25 on words and a bi-encoder on meaning, each returning its top 100; reciprocal rank fusion merges the two rankings; a cross-encoder reads the query with each of the 50 best candidates and returns the final top five" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/03/pipeline-dark.png" width="760" alt="A search engine in three stages. All papers go to two retrievers, BM25 on words and a bi-encoder on meaning, each returning its top 100; reciprocal rank fusion merges the two rankings; a cross-encoder reads the query with each of the 50 best candidates and returns the final top five" loading="lazy"></p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">fuse</span><span class="p">(</span><span class="o">*</span><span class="n">rankings</span><span class="p">,</span> <span class="n">k</span><span class="o">=</span><span class="mi">60</span><span class="p">,</span> <span class="n">depth</span><span class="o">=</span><span class="mi">100</span><span class="p">):</span>
    <span class="n">fused</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros_like</span><span class="p">(</span><span class="n">rankings</span><span class="p">[</span><span class="mi">0</span><span class="p">])</span>
    <span class="n">weight</span> <span class="o">=</span> <span class="mi">1</span> <span class="o">/</span> <span class="p">(</span><span class="n">k</span> <span class="o">+</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">depth</span> <span class="o">+</span> <span class="mi">1</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">fused</span><span class="p">.</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">fused</span><span class="p">.</span><span class="n">dtype</span><span class="p">))</span>
    <span class="k">for</span> <span class="n">scores</span> <span class="ow">in</span> <span class="n">rankings</span><span class="p">:</span>
        <span class="n">top</span> <span class="o">=</span> <span class="n">scores</span><span class="p">.</span><span class="nf">topk</span><span class="p">(</span><span class="n">depth</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">).</span><span class="n">indices</span>
        <span class="n">fused</span><span class="p">.</span><span class="nf">scatter_add_</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">top</span><span class="p">,</span> <span class="n">weight</span><span class="p">.</span><span class="nf">expand_as</span><span class="p">(</span><span class="n">top</span><span class="p">).</span><span class="nf">contiguous</span><span class="p">())</span>
    <span class="k">return</span> <span class="n">fused</span>


<span class="n">bm25_gpu</span> <span class="o">=</span> <span class="n">bm25_scores</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">scores</span> <span class="ow">in</span> <span class="p">[(</span><span class="sh">"</span><span class="s">MiniLM-L6, trained here</span><span class="sh">"</span><span class="p">,</span> <span class="n">student_scores</span><span class="p">),</span>
                     <span class="p">(</span><span class="sh">"</span><span class="s">all-MiniLM-L6-v2</span><span class="sh">"</span><span class="p">,</span> <span class="n">minilm_scores</span><span class="p">),</span>
                     <span class="p">(</span><span class="sh">"</span><span class="s">all-MiniLM-L6-v2, adapted here</span><span class="sh">"</span><span class="p">,</span> <span class="n">adapted_scores</span><span class="p">),</span>
                     <span class="p">(</span><span class="sh">"</span><span class="s">bge-base-en-v1.5</span><span class="sh">"</span><span class="p">,</span> <span class="n">bge_scores</span><span class="p">)]:</span>
    <span class="nf">evaluate</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">BM25 + </span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span> <span class="nf">fuse</span><span class="p">(</span><span class="n">bm25_gpu</span><span class="p">,</span> <span class="n">scores</span><span class="p">),</span> <span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">)</span>
<span class="n">hybrid</span> <span class="o">=</span> <span class="nf">fuse</span><span class="p">(</span><span class="n">bm25_gpu</span><span class="p">,</span> <span class="n">adapted_scores</span><span class="p">)</span>
<span class="n">reranked</span> <span class="o">=</span> <span class="nf">rerank</span><span class="p">(</span><span class="sh">"</span><span class="s">BM25 + MiniLM adapted → reranker</span><span class="sh">"</span><span class="p">,</span> <span class="n">hybrid</span><span class="p">)</span>
<span class="n">engine_scores</span> <span class="o">=</span> <span class="nf">fuse</span><span class="p">(</span><span class="n">hybrid</span><span class="p">,</span> <span class="n">reranked</span><span class="p">,</span> <span class="n">depth</span><span class="o">=</span><span class="mi">50</span><span class="p">)</span>  <span class="c1"># the reranker's order and the hybrid's
</span><span class="nf">evaluate</span><span class="p">(</span><span class="sh">"</span><span class="s">BM25 + MiniLM adapted + reranker, fused</span><span class="sh">"</span><span class="p">,</span> <span class="n">engine_scores</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">results</span><span class="p">).</span><span class="nf">drop</span><span class="p">(</span><span class="n">columns</span><span class="o">=</span><span class="p">[</span><span class="sh">"</span><span class="s">ms per question</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">index, MB</span><span class="sh">"</span><span class="p">]))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">method</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@5</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@20</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">ms per question</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">index, MB</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">BM25 + MiniLM adapted → reranker</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.55</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.71</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">132.62</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.00</td></tr></tbody></table></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">method</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@5</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">recall@20</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">BM25</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.45</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.60</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">MiniLM-L6, as pre-trained</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.00</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.00</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">MiniLM-L6, trained here</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.32</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.46</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all-MiniLM-L6-v2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.42</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.59</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all-MiniLM-L6-v2, [CLS] instead of the mean</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.30</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.43</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all-MiniLM-L6-v2, adapted here</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.51</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.65</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">bge-base-en-v1.5</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.50</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.67</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">bge-base-en-v1.5, mean pooling, no instruction</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.51</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.66</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all-MiniLM-L6-v2 → reranker</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.54</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.64</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">ColBERTv2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.47</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.62</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">BM25 + MiniLM-L6, trained here</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.47</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.63</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">BM25 + all-MiniLM-L6-v2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.53</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.68</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">BM25 + all-MiniLM-L6-v2, adapted here</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.56</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.70</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">BM25 + bge-base-en-v1.5</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.55</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.69</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">BM25 + MiniLM adapted → reranker</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.55</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.71</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">BM25 + MiniLM adapted + reranker, fused</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.59</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.73</td></tr></tbody></table></div> <p>Fusion is the best deal in the table. BM25 + all-MiniLM-L6-v2 reaches 0.53, eleven points above the model alone and eight above BM25, from two rankings that each find what the other misses. Even our ten-minute model, at 0.32 on its own, lifts BM25 by two points.</p> <p>With the adapted MiniLM the hybrid reaches 0.56, as much as bge with BM25. The reranker on top of that hybrid changes nothing at five: on candidates this good, its judgement, learned from Bing queries, is no better than the hybrid’s.</p> <p class="takeaway">Fused with the hybrid’s order, the two judgements together give the best result of the lesson, 0.59 at five and 0.73 at twenty.</p> <p>Fusion and reranking add no index of their own, so their cost in the table is the cost of their parts. The whole picture, quality against the time a question takes and the memory its index needs:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">frame</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">results</span><span class="p">).</span><span class="nf">set_index</span><span class="p">(</span><span class="sh">"</span><span class="s">method</span><span class="sh">"</span><span class="p">)</span>
<span class="n">single</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">BM25</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">MiniLM-L6, trained here</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">all-MiniLM-L6-v2</span><span class="sh">"</span><span class="p">,</span>
          <span class="sh">"</span><span class="s">all-MiniLM-L6-v2, adapted here</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">bge-base-en-v1.5</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">ColBERTv2</span><span class="sh">"</span><span class="p">]</span>
<span class="n">points</span> <span class="o">=</span> <span class="p">{</span><span class="n">name</span><span class="p">:</span> <span class="n">frame</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">single</span><span class="p">}</span>
<span class="n">parts</span> <span class="o">=</span> <span class="n">frame</span><span class="p">.</span><span class="n">loc</span><span class="p">[[</span><span class="sh">"</span><span class="s">BM25</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">all-MiniLM-L6-v2, adapted here</span><span class="sh">"</span><span class="p">,</span>
                   <span class="sh">"</span><span class="s">BM25 + MiniLM adapted → reranker</span><span class="sh">"</span><span class="p">]].</span><span class="nf">sum</span><span class="p">()</span>
<span class="n">engine</span> <span class="o">=</span> <span class="sh">"</span><span class="s">BM25 + MiniLM adapted + reranker, fused</span><span class="sh">"</span>
<span class="n">points</span><span class="p">[</span><span class="sh">"</span><span class="s">the search engine</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">Series</span><span class="p">({</span><span class="sh">"</span><span class="s">recall@5</span><span class="sh">"</span><span class="p">:</span> <span class="n">frame</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">engine</span><span class="p">,</span> <span class="sh">"</span><span class="s">recall@5</span><span class="sh">"</span><span class="p">],</span>
                                         <span class="sh">"</span><span class="s">ms per question</span><span class="sh">"</span><span class="p">:</span> <span class="n">parts</span><span class="p">[</span><span class="sh">"</span><span class="s">ms per question</span><span class="sh">"</span><span class="p">],</span>
                                         <span class="sh">"</span><span class="s">index, MB</span><span class="sh">"</span><span class="p">:</span> <span class="n">parts</span><span class="p">[</span><span class="sh">"</span><span class="s">index, MB</span><span class="sh">"</span><span class="p">]})</span>

<span class="n">fig</span><span class="p">,</span> <span class="p">(</span><span class="n">left</span><span class="p">,</span> <span class="n">right</span><span class="p">)</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">9.6</span><span class="p">,</span> <span class="mf">3.8</span><span class="p">),</span> <span class="n">sharey</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">points</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
    <span class="n">special</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">BM25</span><span class="sh">"</span><span class="p">:</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">data</span><span class="sh">"</span><span class="p">],</span> <span class="sh">"</span><span class="s">the search engine</span><span class="sh">"</span><span class="p">:</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">]}</span>
    <span class="n">color</span> <span class="o">=</span> <span class="n">special</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="n">name</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">])</span>
    <span class="k">for</span> <span class="n">ax</span><span class="p">,</span> <span class="n">x</span> <span class="ow">in</span> <span class="p">((</span><span class="n">left</span><span class="p">,</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">ms per question</span><span class="sh">"</span><span class="p">]),</span> <span class="p">(</span><span class="n">right</span><span class="p">,</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">index, MB</span><span class="sh">"</span><span class="p">])):</span>
        <span class="n">ax</span><span class="p">.</span><span class="nf">scatter</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">recall@5</span><span class="sh">"</span><span class="p">],</span> <span class="n">s</span><span class="o">=</span><span class="mi">55</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span> <span class="n">zorder</span><span class="o">=</span><span class="mi">3</span><span class="p">)</span>
        <span class="n">left_side</span> <span class="o">=</span> <span class="n">name</span> <span class="ow">in</span> <span class="p">(</span><span class="sh">"</span><span class="s">all-MiniLM-L6-v2, adapted here</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">BM25</span><span class="sh">"</span><span class="p">)</span>
        <span class="n">ax</span><span class="p">.</span><span class="nf">annotate</span><span class="p">(</span><span class="n">name</span><span class="p">,</span> <span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">recall@5</span><span class="sh">"</span><span class="p">]),</span> <span class="n">xytext</span><span class="o">=</span><span class="p">(</span><span class="o">-</span><span class="mi">6</span> <span class="k">if</span> <span class="n">left_side</span> <span class="k">else</span> <span class="mi">6</span><span class="p">,</span> <span class="mi">4</span><span class="p">),</span>
                    <span class="n">textcoords</span><span class="o">=</span><span class="sh">"</span><span class="s">offset points</span><span class="sh">"</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">8</span><span class="p">,</span>
                    <span class="n">ha</span><span class="o">=</span><span class="sh">"</span><span class="s">right</span><span class="sh">"</span> <span class="k">if</span> <span class="n">left_side</span> <span class="k">else</span> <span class="sh">"</span><span class="s">left</span><span class="sh">"</span><span class="p">)</span>
<span class="k">for</span> <span class="n">ax</span> <span class="ow">in</span> <span class="p">(</span><span class="n">left</span><span class="p">,</span> <span class="n">right</span><span class="p">):</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">set_xscale</span><span class="p">(</span><span class="sh">"</span><span class="s">log</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">margins</span><span class="p">(</span><span class="n">x</span><span class="o">=</span><span class="mf">0.3</span><span class="p">)</span>
<span class="n">left</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">milliseconds per question, log scale</span><span class="sh">"</span><span class="p">)</span>
<span class="n">right</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">index size, MB, log scale</span><span class="sh">"</span><span class="p">)</span>
<span class="n">left</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">recall@5</span><span class="sh">"</span><span class="p">)</span>
<span class="n">left</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">Quality against time</span><span class="sh">"</span><span class="p">)</span>
<span class="n">right</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">Quality against memory</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/03/output-08.png" alt="Quality against time" loading="lazy"></p> <p>The search engine is alone at the top of both charts. Almost all of its time is the reranker’s, about 130 ms per question on a T4; everything else answers in a millisecond or less, except ColBERT, which also needs twenty times the memory of anything else here.</p> <p>Where the methods disagree is more instructive than the averages. For every question we find the rank of its first right paper under BM25 and under the adapted MiniLM, and look at the questions where one of them finds the paper at once and the other buries it.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">first_rank</span><span class="p">(</span><span class="n">scores</span><span class="p">):</span>
    <span class="n">order</span> <span class="o">=</span> <span class="n">scores</span><span class="p">.</span><span class="nf">argsort</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">descending</span><span class="o">=</span><span class="bp">True</span><span class="p">).</span><span class="nf">cpu</span><span class="p">().</span><span class="nf">numpy</span><span class="p">()</span>
    <span class="n">position</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">empty_like</span><span class="p">(</span><span class="n">order</span><span class="p">)</span>
    <span class="n">position</span><span class="p">[</span><span class="n">np</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">order</span><span class="p">))[:,</span> <span class="bp">None</span><span class="p">],</span> <span class="n">order</span><span class="p">]</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">order</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">])</span>
    <span class="k">return</span> <span class="n">np</span><span class="p">.</span><span class="nf">array</span><span class="p">([</span><span class="nf">min</span><span class="p">(</span><span class="n">position</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="n">g</span><span class="p">])</span> <span class="o">+</span> <span class="mi">1</span> <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">g</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">gold</span><span class="p">)])</span>


<span class="n">ranks</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">({</span><span class="sh">"</span><span class="s">question</span><span class="sh">"</span><span class="p">:</span> <span class="n">questions</span><span class="p">,</span> <span class="sh">"</span><span class="s">BM25</span><span class="sh">"</span><span class="p">:</span> <span class="nf">first_rank</span><span class="p">(</span><span class="n">bm25_gpu</span><span class="p">),</span>
                      <span class="sh">"</span><span class="s">MiniLM</span><span class="sh">"</span><span class="p">:</span> <span class="nf">first_rank</span><span class="p">(</span><span class="n">adapted_scores</span><span class="p">),</span>
                      <span class="sh">"</span><span class="s">engine</span><span class="sh">"</span><span class="p">:</span> <span class="nf">first_rank</span><span class="p">(</span><span class="n">engine_scores</span><span class="p">)})</span>
<span class="n">words_win</span> <span class="o">=</span> <span class="n">ranks</span><span class="p">[(</span><span class="n">ranks</span><span class="p">[</span><span class="sh">"</span><span class="s">BM25</span><span class="sh">"</span><span class="p">]</span> <span class="o">&lt;=</span> <span class="mi">3</span><span class="p">)</span> <span class="o">&amp;</span> <span class="p">(</span><span class="n">ranks</span><span class="p">[</span><span class="sh">"</span><span class="s">MiniLM</span><span class="sh">"</span><span class="p">]</span> <span class="o">&gt;</span> <span class="mi">50</span><span class="p">)]</span>
<span class="n">meaning_wins</span> <span class="o">=</span> <span class="n">ranks</span><span class="p">[(</span><span class="n">ranks</span><span class="p">[</span><span class="sh">"</span><span class="s">MiniLM</span><span class="sh">"</span><span class="p">]</span> <span class="o">&lt;=</span> <span class="mi">3</span><span class="p">)</span> <span class="o">&amp;</span> <span class="p">(</span><span class="n">ranks</span><span class="p">[</span><span class="sh">"</span><span class="s">BM25</span><span class="sh">"</span><span class="p">]</span> <span class="o">&gt;</span> <span class="mi">50</span><span class="p">)]</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">BM25 in the top 3, MiniLM below 50: </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">words_win</span><span class="p">)</span><span class="si">}</span><span class="s"> questions; </span><span class="sh">"</span>
      <span class="sa">f</span><span class="sh">"</span><span class="s">the other way round: </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">meaning_wins</span><span class="p">)</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">display</span><span class="p">(</span><span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nf">concat</span><span class="p">([</span><span class="n">words_win</span><span class="p">.</span><span class="nf">head</span><span class="p">(</span><span class="mi">3</span><span class="p">),</span> <span class="n">meaning_wins</span><span class="p">.</span><span class="nf">head</span><span class="p">(</span><span class="mi">3</span><span class="p">)])))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>BM25 in the top 3, MiniLM below 50: 13 questions; the other way round: 22</code></pre> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">question</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">BM25</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">MiniLM</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">engine</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">In the context of natural language processing, I am looking for research that explores the relationship between a model's prediction entropy and its tendencies to copy existing text versus generating novel content. Can you recommend a paper?</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">162</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">How to achieve zero-shot lip reading?</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">187</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Is there any work that allows large numbers of model outputs to be encoded and compared by causal language models in a single forward pass?</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">846</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Can you recommend a conversational QA dataset where the human questioner does not have access to the evidence passage to simulate a more real-world information-seeking environment?</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">155</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">23</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Can you suggest any literature that explores the idea of training neural networks to translate text passages into related questions?</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">100</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">When using pretrained transformer models for generating sentence embeddings, I've heard different strategies such as mean pooling and using the CLS token's embedding. What study shows that mean pooling outperforms CLS in semantic similarity tasks?</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">59</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">16</td></tr></tbody></table></div> <p>BM25 wins when a question hangs on a rare, exact term: <em>zero-shot lip reading</em>, <em>prediction entropy</em>, <em>a single forward pass</em>. The adapted model wins on paraphrase: the question about networks that “translate text passages into related questions” wants <em>Learning to Ask: Neural Question Generation for Reading Comprehension</em>, whose words the question doesn’t use.</p> <p>Fusion keeps most of both, though not all: QuAC falls from second place under MiniLM to 23rd in the engine, dragged down by BM25’s 155th.</p> <p>The last question in the table is about this lesson. It asks which study showed that mean pooling beats <code class="language-plaintext highlighter-rouge">[CLS]</code> for sentence similarity, and the paper it wants is Sentence-BERT: 59th for BM25, 3rd for the adapted MiniLM.</p> <h2 id="9-your-own-search-engine">9. Your own search engine</h2> <p>Everything is in place for the practical result of the lesson: a function that takes a question in plain words and returns papers. Let’s ask it about the papers this course is built on.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">search</span><span class="p">(</span><span class="n">question</span><span class="p">,</span> <span class="n">k</span><span class="o">=</span><span class="mi">5</span><span class="p">,</span> <span class="n">depth</span><span class="o">=</span><span class="mi">50</span><span class="p">):</span>
    <span class="n">words_ranked</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">from_numpy</span><span class="p">(</span><span class="n">bm25</span><span class="p">.</span><span class="nf">scores</span><span class="p">(</span><span class="n">question</span><span class="p">)).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)[</span><span class="bp">None</span><span class="p">]</span>
    <span class="n">meaning</span> <span class="o">=</span> <span class="nf">embed</span><span class="p">(</span><span class="n">adapted</span><span class="p">,</span> <span class="p">[</span><span class="n">question</span><span class="p">],</span> <span class="mi">64</span><span class="p">)</span> <span class="o">@</span> <span class="n">adapted_docs</span><span class="p">.</span><span class="n">T</span>
    <span class="n">candidates</span> <span class="o">=</span> <span class="nf">fuse</span><span class="p">(</span><span class="n">words_ranked</span><span class="p">,</span> <span class="n">meaning</span><span class="p">).</span><span class="nf">topk</span><span class="p">(</span><span class="n">depth</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">).</span><span class="n">indices</span><span class="p">[</span><span class="mi">0</span><span class="p">].</span><span class="nf">tolist</span><span class="p">()</span>
    <span class="n">batch</span> <span class="o">=</span> <span class="nf">reranker_tokenizer</span><span class="p">([</span><span class="n">question</span><span class="p">]</span> <span class="o">*</span> <span class="n">depth</span><span class="p">,</span> <span class="p">[</span><span class="n">texts</span><span class="p">[</span><span class="n">j</span><span class="p">]</span> <span class="k">for</span> <span class="n">j</span> <span class="ow">in</span> <span class="n">candidates</span><span class="p">],</span>
                               <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">truncation</span><span class="o">=</span><span class="sh">"</span><span class="s">only_second</span><span class="sh">"</span><span class="p">,</span> <span class="n">max_length</span><span class="o">=</span><span class="mi">320</span><span class="p">,</span>
                               <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="n">padding</span> <span class="o">=</span> <span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">attention_mask</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="mi">0</span>
    <span class="n">logits</span> <span class="o">=</span> <span class="nf">reranker</span><span class="p">(</span><span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">padding</span><span class="p">,</span> <span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">token_type_ids</span><span class="sh">"</span><span class="p">])</span>
    <span class="c1"># fuse the two orders, as above: the candidates' own and the reranker's
</span>    <span class="n">by_reranker</span> <span class="o">=</span> <span class="n">logits</span><span class="p">.</span><span class="nf">argsort</span><span class="p">(</span><span class="n">descending</span><span class="o">=</span><span class="bp">True</span><span class="p">).</span><span class="nf">argsort</span><span class="p">()</span>
    <span class="n">by_hybrid</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">depth</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
    <span class="n">score</span> <span class="o">=</span> <span class="mi">1</span> <span class="o">/</span> <span class="p">(</span><span class="mi">61</span> <span class="o">+</span> <span class="n">by_hybrid</span><span class="p">)</span> <span class="o">+</span> <span class="mi">1</span> <span class="o">/</span> <span class="p">(</span><span class="mi">61</span> <span class="o">+</span> <span class="n">by_reranker</span><span class="p">)</span>
    <span class="n">best</span> <span class="o">=</span> <span class="n">score</span><span class="p">.</span><span class="nf">topk</span><span class="p">(</span><span class="n">k</span><span class="p">).</span><span class="n">indices</span><span class="p">.</span><span class="nf">tolist</span><span class="p">()</span>
    <span class="k">return</span> <span class="p">[</span><span class="n">re</span><span class="p">.</span><span class="nf">sub</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s">\s+</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">,</span> <span class="n">titles</span><span class="p">[</span><span class="n">candidates</span><span class="p">[</span><span class="n">j</span><span class="p">]])[:</span><span class="mi">110</span><span class="p">]</span> <span class="k">for</span> <span class="n">j</span> <span class="ow">in</span> <span class="n">best</span><span class="p">]</span>


<span class="k">for</span> <span class="n">question</span> <span class="ow">in</span> <span class="p">[</span>
    <span class="sh">"</span><span class="s">a pre-training task where a discriminator spots tokens replaced by a small generator</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">attention that keeps separate vectors for a token</span><span class="sh">'</span><span class="s">s content and its relative position</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">do contextual word vectors of BERT occupy a narrow cone of the space?</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">fast sentence similarity search with siamese BERT networks</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">late interaction retrieval with compressed token vectors</span><span class="sh">"</span><span class="p">,</span>
<span class="p">]:</span>
    <span class="nf">print</span><span class="p">(</span><span class="n">question</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">rank</span><span class="p">,</span> <span class="n">title</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="nf">search</span><span class="p">(</span><span class="n">question</span><span class="p">),</span> <span class="mi">1</span><span class="p">):</span>
        <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">   </span><span class="si">{</span><span class="n">rank</span><span class="si">}</span><span class="s">. </span><span class="si">{</span><span class="n">title</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>a pre-training task where a discriminator spots tokens replaced by a small generator
   1. ELECTRA: PRE-TRAINING TEXT ENCODERS AS DISCRIMINATORS RATHER THAN GENERATORS
   2. Learning to Sample Replacements for ELECTRA Pre-Training
   3. ELECTRA: PRE-TRAINING TEXT ENCODERS AS DISCRIMINATORS RATHER THAN GENERATORS
   4. Training ELECTRA Augmented with Multi-word Selection
   5. Published as a conference paper at ICLR 2022 PRETRAINING TEXT ENCODERS WITH ADVERSARIAL MIXTURE OF TRAINING SI
attention that keeps separate vectors for a token's content and its relative position
   1. Self-Attention with Relative Position Representations
   2. PermuteFormer: Efficient Relative Position Encoding for Long Sequences
   3. A Simple and Effective Positional Encoding for Transformers
   4. Published as a conference paper at ICLR 2017 FRUSTRATINGLY SHORT ATTENTION SPANS IN NEURAL LANGUAGE MODELING
   5. A Target Attention Model for Neural Machine Translation
do contextual word vectors of BERT occupy a narrow cone of the space?
   1. How does BERT capture semantics? A closer look at polysemous words
   2. Unsupervised Contextualized Document Representation
   3. Open Sesame: Getting Inside BERT's Linguistic Knowledge
   4. Sentence Selection Strategies for Distilling Word Embeddings from BERT
   5. OoMMix: Out-of-manifold Regularization in Contextual Embedding Space for Text Classification
fast sentence similarity search with siamese BERT networks
   1. Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks
   2. Structure-aware Sentence Encoder in BERT-Based Siamese Network
   3. Efficient Nearest Neighbor Emotion Classification with BERT-whitening
   4. Semantic Textual Similarity with Siamese Neural Networks
   5. An Unsupervised Sentence Embedding Method by Mutual Information Maximization
late interaction retrieval with compressed token vectors
   1. ColBERTv2: Effective and Efficient Retrieval via Lightweight Late Interaction
   2. CITADEL: Conditional Token Interaction via Dynamic Lexical Routing for Efficient and Effective Multi-Vector Re
   3. LI-RAGE: Late Interaction Retrieval Augmented Generation with Explicit Signals for Open-Domain Table Question 
   4. SDR: Efficient Neural Re-ranking using Succinct Document Representation
   5. Inflate and Shrink: Enriching and Reducing Interactions for Fast Text-Image Retrieval</code></pre> <p>Three of five come back first. ELECTRA appears twice because the corpus holds the paper twice, a duplicate that the same embeddings would catch in a deduplication pass.</p> <p>The DeBERTa question returns an earlier paper on relative positions, Shaw et al.’s, and other position encodings, but not DeBERTa itself. The question about the narrow cone misses Ethayarajh’s paper, which is in the corpus; the engine prefers papers on BERT’s semantics that share more of the question’s words.</p> <h2 id="10-which-one-to-use-today">10. Which one to use today</h2> <p>The lesson’s table is a small version of what retrieval benchmarks keep finding. BM25 is a baseline that refuses to lose by much, and it is never the right thing to throw away: it finds names, numbers, codes and rare terms that an embedding smears into their neighbourhood.</p> <p>A bi-encoder catches paraphrase and meaning, and costs one vector per document. Fusing the two is nearly free and usually better than either.</p> <p>A cross-encoder on the top few dozen buys more, paid for in latency on every query: here it lifted a weak retriever by twelve points, and a strong hybrid only once its order was fused with the hybrid’s.</p> <p>ColBERT puts token-level matching into the first stage, and pays in memory; ColBERTv2’s residual compression cuts that index “by 6–10×”, and the PLAID engine searches it up to “7× on a GPU and 45× on a CPU” faster than vanilla ColBERTv2 <sup class="cite">[<a href="#ref-13" id="cite-13" data-ref="13" aria-label="Reference 13: Santhanam, K., Khattab, O., Potts, C., &amp; Zaharia, M. (2022). PLAID: an efficient engine for late interaction retrieval. CIKM 2022.">13</a>]</sup>.</p> <p>Choosing an embedding model is now a matter of reading a leaderboard such as MTEB <sup class="cite">[<a href="#ref-14" id="cite-14" data-ref="14" aria-label="Reference 14: Muennighoff, N., Tazi, N., Magne, L., &amp; Reimers, N. (2022). MTEB: massive text embedding benchmark. EACL 2023.">14</a>]</sup> and then checking on your own data, because the leaderboard’s tasks are not yours.</p> <p>Since 2024 its top places have mostly gone not to encoders but to decoders, large language models such as NV-Embed and Qwen3-Embedding turned into embedders by the same contrastive recipe.</p> <p>On LitSearch itself the best embedder in the paper was one of them, the 7-billion-parameter GritLM, with 74.8% recall@5 on the specific questions. The next lessons are about decoders.</p> <p>Two results of the lesson are worth taking to your own projects. The largest gain from a single step came from ten minutes of training a general model on the corpus’s own titles and abstracts, with no labels and no queries; if your documents have that kind of structure, use it before you buy a bigger model.</p> <p>And the model card is part of the model: the same weights read with the wrong pooling lost twelve points without a word of warning.</p> <p>Sentence-BERT’s passport, and the family tree with this lesson’s branch:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/03/passport-light.png" width="760" alt="Sentence-BERT's passport: published August 2019 by Reimers and Gurevych at TU Darmstadt; a bi-encoder, one encoder applied to each text separately; built on BERT or RoBERTa; one vector per text, the mean of its token vectors, compared by cosine; trained in 2019 on about a million sentence pairs from SNLI and MultiNLI, today contrastively with in-batch negatives on up to a billion pairs; relatives are the cross-encoder and ColBERT; good at semantic search, retrieval, clustering and duplicates; not for exact names and numbers" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/03/passport-dark.png" width="760" alt="Sentence-BERT's passport: published August 2019 by Reimers and Gurevych at TU Darmstadt; a bi-encoder, one encoder applied to each text separately; built on BERT or RoBERTa; one vector per text, the mean of its token vectors, compared by cosine; trained in 2019 on about a million sentence pairs from SNLI and MultiNLI, today contrastively with in-batch negatives on up to a billion pairs; relatives are the cross-encoder and ColBERT; good at semantic search, retrieval, clustering and duplicates; not for exact names and numbers" loading="lazy"></p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/03/family-light.png" width="760" alt="The family of the Transformer as this course covers it, with lesson 3, embeddings and search, highlighted and lessons 1 and 2 done" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/03/family-dark.png" width="760" alt="The family of the Transformer as this course covers it, with lesson 3, embeddings and search, highlighted and lessons 1 and 2 done" loading="lazy"></p> <h2 id="references">References</h2> <ol class="tfs-refs"> <li id="ref-1">Reimers, N., &amp; Gurevych, I. (2019). <a href="https://arxiv.org/abs/1908.10084">Sentence-BERT: sentence embeddings using Siamese BERT-networks</a>. <em>EMNLP-IJCNLP 2019</em>. <a class="ref-back" href="#cite-1" aria-label="Back to the text">↩</a></li> <li id="ref-2">Ajith, A., Xia, M., Chevalier, A., Goyal, T., Chen, D., &amp; Gao, T. (2024). <a href="https://arxiv.org/abs/2407.18940">LitSearch: a retrieval benchmark for scientific literature search</a>. <em>EMNLP 2024</em>. <a class="ref-back" href="#cite-2" aria-label="Back to the text">↩</a></li> <li id="ref-3">Robertson, S. E., Walker, S., Jones, S., Hancock-Beaulieu, M., &amp; Gatford, M. (1995). <a href="https://trec.nist.gov/pubs/trec3/papers/city.ps.gz">Okapi at TREC-3</a>. <em>The Third Text REtrieval Conference (TREC-3)</em>, NIST SP 500-226. <a class="ref-back" href="#cite-3" aria-label="Back to the text">↩</a></li> <li id="ref-4">Wang, W., Wei, F., Dong, L., Bao, H., Yang, N., &amp; Zhou, M. (2020). <a href="https://arxiv.org/abs/2002.10957">MiniLM: deep self-attention distillation for task-agnostic compression of pre-trained transformers</a>. <em>NeurIPS 2020</em>. <a class="ref-back" href="#cite-4" aria-label="Back to the text">↩</a></li> <li id="ref-5">Henderson, M., Al-Rfou, R., Strope, B., Sung, Y., Lukács, L., Guo, R., Kumar, S., Miklos, B., &amp; Kurzweil, R. (2017). <a href="https://arxiv.org/abs/1705.00652">Efficient natural language response suggestion for Smart Reply</a>. arXiv:1705.00652. <a class="ref-back" href="#cite-5" aria-label="Back to the text">↩</a></li> <li id="ref-6">Karpukhin, V., Oğuz, B., Min, S., Lewis, P., Wu, L., Edunov, S., Chen, D., &amp; Yih, W. (2020). <a href="https://arxiv.org/abs/2004.04906">Dense passage retrieval for open-domain question answering</a>. <em>EMNLP 2020</em>. <a class="ref-back" href="#cite-6" aria-label="Back to the text">↩</a></li> <li id="ref-7">van den Oord, A., Li, Y., &amp; Vinyals, O. (2018). <a href="https://arxiv.org/abs/1807.03748">Representation learning with contrastive predictive coding</a>. arXiv:1807.03748. <a class="ref-back" href="#cite-7" aria-label="Back to the text">↩</a></li> <li id="ref-8">Xiao, S., Liu, Z., Zhang, P., Muennighoff, N., Lian, D., &amp; Nie, J.-Y. (2023). <a href="https://arxiv.org/abs/2309.07597">C-Pack: packed resources for general Chinese embeddings</a>. <em>SIGIR 2024</em>. <a class="ref-back" href="#cite-8" aria-label="Back to the text">↩</a></li> <li id="ref-9">Nogueira, R., &amp; Cho, K. (2019). <a href="https://arxiv.org/abs/1901.04085">Passage re-ranking with BERT</a>. arXiv:1901.04085. <a class="ref-back" href="#cite-9" aria-label="Back to the text">↩</a></li> <li id="ref-10">Khattab, O., &amp; Zaharia, M. (2020). <a href="https://arxiv.org/abs/2004.12832">ColBERT: efficient and effective passage search via contextualized late interaction over BERT</a>. <em>SIGIR 2020</em>. <a class="ref-back" href="#cite-10" aria-label="Back to the text">↩</a></li> <li id="ref-11">Santhanam, K., Khattab, O., Saad-Falcon, J., Potts, C., &amp; Zaharia, M. (2022). <a href="https://arxiv.org/abs/2112.01488">ColBERTv2: effective and efficient retrieval via lightweight late interaction</a>. <em>NAACL 2022</em>. <a class="ref-back" href="#cite-11" aria-label="Back to the text">↩</a></li> <li id="ref-12">Cormack, G. V., Clarke, C. L. A., &amp; Büttcher, S. (2009). <a href="https://doi.org/10.1145/1571941.1572114">Reciprocal rank fusion outperforms Condorcet and individual rank learning methods</a>. <em>SIGIR 2009</em>. <a class="ref-back" href="#cite-12" aria-label="Back to the text">↩</a></li> <li id="ref-13">Santhanam, K., Khattab, O., Potts, C., &amp; Zaharia, M. (2022). <a href="https://arxiv.org/abs/2205.09707">PLAID: an efficient engine for late interaction retrieval</a>. <em>CIKM 2022</em>. <a class="ref-back" href="#cite-13" aria-label="Back to the text">↩</a></li> <li id="ref-14">Muennighoff, N., Tazi, N., Magne, L., &amp; Reimers, N. (2022). <a href="https://arxiv.org/abs/2210.07316">MTEB: massive text embedding benchmark</a>. <em>EACL 2023</em>. <a class="ref-back" href="#cite-14" aria-label="Back to the text">↩</a></li> <li id="ref-15">Ethayarajh, K. (2019). <a href="https://arxiv.org/abs/1909.00512">How contextual are contextualized word representations? Comparing the geometry of BERT, ELMo, and GPT-2 embeddings</a>. <em>EMNLP-IJCNLP 2019</em>.</li> </ol>]]></content> <author> <name>Eva Koroleva</name> </author> <category term="machine-learning"/> <category term="transformer-architectures"/> <category term="sentence-bert"/> <category term="colbert"/> <category term="embeddings"/> <category term="retrieval"/> <category term="search"/> <summary type="html"><![CDATA[How a search engine reads: BM25 written from scratch, Sentence-BERT's bi-encoder trained with in-batch negatives, a cross-encoder reranker and ColBERT's late interaction, each checked against the real weights and put together into a literature search over 64,000 machine-learning papers.]]></summary> <media:thumbnail url="https://blog.korolevalab.com/assets/posts/arch/03/cover.png"/> <media:content medium="image" url="https://blog.korolevalab.com/assets/posts/arch/03/cover.png"/> </entry> <entry> <title type="html">From RoBERTa to ModernBERT: what seven years did to BERT</title> <link href="https://blog.korolevalab.com/blog/2026/transformer-architectures-02-modernbert/" rel="alternate" type="text/html" title="From RoBERTa to ModernBERT: what seven years did to BERT"/> <published>2026-03-20T11:00:00+00:00</published> <updated>2026-11-02T00:00:00+00:00</updated> <id>https://blog.korolevalab.com/blog/2026/transformer-architectures-02-modernbert</id> <content type="html" xml:base="https://blog.korolevalab.com/blog/2026/transformer-architectures-02-modernbert/"><![CDATA[<p class="tfs-links"><strong>Transformer architectures: from BERT to diffusion</strong> · lesson 2 of 15 · <a href="/teaching/">all lessons</a> · <a href="https://www.kaggle.com/code/qmarva/transformer-architectures-02-roberta-modernbert">run on Kaggle</a> · <a href="https://colab.research.google.com/github/xmarva/transformers-from-scratch/blob/main/notebooks/colab/a02_modernbert.ipynb">open in Colab</a> · <a href="https://github.com/xmarva/transformers-from-scratch">code on GitHub</a></p> <p>Nine months after BERT, a team at Facebook AI and the University of Washington trained it again. They kept the architecture, every layer and every head, and changed only how it was trained: longer, on more data, with bigger batches and without one of its two training games.</p> <p>The abstract of their paper says what came out: BERT “was significantly undertrained, and can match or exceed the performance of every model published after it” <sup class="cite">[<a href="#ref-1" id="cite-1" data-ref="1" aria-label="Reference 1: Liu, Y., Ott, M., Goyal, N., Du, J., Joshi, M., Chen, D., Levy, O., Lewis, M., Zettlemoyer, L., &amp; Stoyanov, V. (2019). RoBERTa: a robustly optimized BERT pretraining approach. arXiv:1907.11692.">1</a>]</sup>.</p> <p>That sentence sets the tone for the next five years of encoders. ELECTRA changed the training task, DeBERTa changed how attention sees positions, and only in December 2024 did ModernBERT rebuild the block itself, out of the parts that large language models had made standard in the meantime.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/02/hero-light.png" width="760" alt="Four encoders after BERT, each with the one thing it changed: RoBERTa in 2019 the training recipe, ELECTRA in 2020 the training task, DeBERTa in 2020 the attention, ModernBERT in 2024 the whole block" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/02/hero-dark.png" width="760" alt="Four encoders after BERT, each with the one thing it changed: RoBERTa in 2019 the training recipe, ELECTRA in 2020 the training task, DeBERTa in 2020 the attention, ModernBERT in 2024 the whole block" loading="lazy"></p> <p>In this lesson you will write each change yourself, check it against the real weights, and then put the four generations to work on a job engineers know well: sorting GitHub issues into bugs, feature requests, questions and documentation, for projects the models have never seen.</p> <p><strong>What you’ll do</strong></p> <ol> <li>Load RoBERTa into the BERT of <a href="/blog/2026/transformer-architectures-01-bert/">lesson 1</a> with two small changes, and see what byte-level <a href="/blog/2026/transformers-from-scratch-01-tokenization/">BPE</a> does with code.</li> <li>Write ELECTRA’s replaced-token detection and race it against masked language modelling on a T4.</li> <li>Write DeBERTa’s disentangled attention and learn why its check needs float64.</li> <li>Write ModernBERT: rotary positions, GeGLU, no biases, and layers that alternate local and global attention.</li> <li><a href="/blog/2025/adapters/">Fine-tune</a> BERT, RoBERTa, DeBERTa-v3 and ModernBERT to triage issues of unseen repositories, and measure what reading the whole issue is worth.</li> </ol> <p><strong>What you need</strong>: a GPU. On Kaggle, <em>Settings → Accelerator → GPU</em>; on Colab, <em>Runtime → Change runtime type → T4 GPU</em>. The notebook downloads four pre-trained encoders and the issues of thirteen open-source projects; on a T4 it runs in about an hour.</p> <h2 id="setup">Setup</h2> <p>One small helper package, <code class="language-plaintext highlighter-rouge">tfs</code>, draws the course’s plots and token chips and knows where the notebook runs (Kaggle, Colab or your own machine). Everything the lesson teaches is written out in the notebook itself.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">importlib.util</span>
<span class="kn">import</span> <span class="n">subprocess</span>
<span class="kn">import</span> <span class="n">sys</span>

<span class="n">TFS</span> <span class="o">=</span> <span class="sh">"</span><span class="s">git+https://github.com/xmarva/transformers-from-scratch@main</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">importlib</span><span class="p">.</span><span class="n">util</span><span class="p">.</span><span class="nf">find_spec</span><span class="p">(</span><span class="sh">"</span><span class="s">tfs</span><span class="sh">"</span><span class="p">)</span> <span class="ow">is</span> <span class="bp">None</span><span class="p">:</span>
    <span class="n">subprocess</span><span class="p">.</span><span class="nf">check_call</span><span class="p">([</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">-m</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">pip</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">install</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-q</span><span class="sh">"</span><span class="p">,</span> <span class="n">TFS</span><span class="p">])</span>

<span class="kn">from</span> <span class="n">tfs</span> <span class="kn">import</span> <span class="n">env</span>
<span class="kn">from</span> <span class="n">tfs.viz</span> <span class="kn">import</span> <span class="n">table</span><span class="p">,</span> <span class="n">token_chips</span><span class="p">,</span> <span class="n">use_course_style</span>

<span class="n">env</span><span class="p">.</span><span class="nf">quiet</span><span class="p">()</span>  <span class="c1"># no progress bars or environment warnings in the outputs
</span><span class="n">SEED</span> <span class="o">=</span> <span class="mi">42</span>
<span class="n">env</span><span class="p">.</span><span class="nf">seed_everything</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">COLORS</span> <span class="o">=</span> <span class="nf">use_course_style</span><span class="p">()</span>
<span class="n">WORK_DIR</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">work_dir</span><span class="p">()</span>
</code></pre></div></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">ast</span>
<span class="kn">import</span> <span class="n">json</span>
<span class="kn">import</span> <span class="n">math</span>
<span class="kn">import</span> <span class="n">re</span>
<span class="kn">import</span> <span class="n">time</span>
<span class="kn">import</span> <span class="n">warnings</span>

<span class="kn">import</span> <span class="n">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>
<span class="kn">import</span> <span class="n">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="n">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">import</span> <span class="n">torch</span>
<span class="kn">import</span> <span class="n">torch.nn</span> <span class="k">as</span> <span class="n">nn</span>
<span class="kn">import</span> <span class="n">torch.nn.functional</span> <span class="k">as</span> <span class="n">F</span>
<span class="kn">from</span> <span class="n">huggingface_hub</span> <span class="kn">import</span> <span class="n">hf_hub_download</span>
<span class="kn">from</span> <span class="n">IPython.display</span> <span class="kn">import</span> <span class="n">display</span>
<span class="kn">from</span> <span class="n">safetensors.torch</span> <span class="kn">import</span> <span class="n">load_file</span>
<span class="kn">from</span> <span class="n">tfs.viz</span> <span class="kn">import</span> <span class="n">heatmap</span>
<span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">AutoModelForSequenceClassification</span><span class="p">,</span> <span class="n">AutoTokenizer</span>
<span class="c1"># the reference implementations, for the checks
</span><span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">DebertaV2Model</span><span class="p">,</span> <span class="n">ModernBertModel</span><span class="p">,</span> <span class="n">RobertaModel</span>

<span class="c1"># mixed precision skips a step when a gradient overflows; PyTorch reports it as a warning
</span><span class="n">warnings</span><span class="p">.</span><span class="nf">filterwarnings</span><span class="p">(</span><span class="sh">"</span><span class="s">ignore</span><span class="sh">"</span><span class="p">,</span> <span class="n">message</span><span class="o">=</span><span class="sh">"</span><span class="s">Detected call of `lr_scheduler.step</span><span class="sh">"</span><span class="p">)</span>
<span class="n">SMOKE</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">smoke</span><span class="p">()</span>  <span class="c1"># CI runs the lesson on a small slice; you run it in full
</span><span class="n">device</span> <span class="o">=</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">if</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">is_available</span><span class="p">()</span> <span class="k">else</span> <span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span>
<span class="k">assert</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="ow">or</span> <span class="n">SMOKE</span><span class="p">,</span> <span class="sh">"</span><span class="s">This lesson fine-tunes several encoders: use a GPU.</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">GPU:</span><span class="sh">"</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">get_device_name</span><span class="p">(</span><span class="mi">0</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>GPU: Tesla T4</code></pre> <h2 id="1-roberta-the-same-bert-trained-properly">1. RoBERTa: the same BERT, trained properly</h2> <p>RoBERTa’s authors went through BERT’s training choices one at a time, and most of the gain came from the plainest ones. BERT trained with batches of 256 sequences; RoBERTa with 8,000. BERT read 16 GB of text; RoBERTa “over 160GB”, for longer.</p> <p>The cleverer-sounding changes mattered less. BERT masked each sentence once, when the data was prepared; RoBERTa draws new masks every time a sequence is used, as the <code class="language-plaintext highlighter-rouge">mask_tokens</code> of lesson 1 does, and found this “comparable or slightly better”.</p> <p>Dropping BERT’s second game, telling a real next sentence from a random one, “matches or slightly improves” the results, so the inputs became whole stretches of text instead of pairs.</p> <p>The architecture is BERT’s. So our BERT from lesson 1 should take RoBERTa’s weights, and it does, with two changes that are left-overs of the code RoBERTa was trained with. Here is lesson 1’s model again, in one cell:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">Embeddings</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">words</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">positions</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">max_position_embeddings</span><span class="sh">"</span><span class="p">],</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">segments</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">type_vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">layer_norm_eps</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">dropout</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Dropout</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_dropout_prob</span><span class="sh">"</span><span class="p">])</span>
        <span class="c1"># RoBERTa numbers positions from pad_token_id + 1: fairseq kept 0 and 1 for padding
</span>        <span class="n">self</span><span class="p">.</span><span class="n">first</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">pad_token_id</span><span class="sh">"</span><span class="p">]</span> <span class="o">+</span> <span class="mi">1</span> <span class="k">if</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">model_type</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="sh">"</span><span class="s">roberta</span><span class="sh">"</span> <span class="k">else</span> <span class="mi">0</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">):</span>
        <span class="n">positions</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="n">device</span><span class="o">=</span><span class="n">ids</span><span class="p">.</span><span class="n">device</span><span class="p">)</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">first</span>
        <span class="n">segments</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros_like</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span>  <span class="c1"># one sentence per input
</span>        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">words</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">positions</span><span class="p">(</span><span class="n">positions</span><span class="p">)</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">segments</span><span class="p">(</span><span class="n">segments</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">dropout</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">norm</span><span class="p">(</span><span class="n">x</span><span class="p">))</span>


<span class="k">class</span> <span class="nc">Layer</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span><span class="p">,</span> <span class="n">eps</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">layer_norm_eps</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">q</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">k</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">v</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">out</span> <span class="o">=</span> <span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">4</span><span class="p">))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm1</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">eps</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">up</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">down</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm2</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">eps</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">dropout</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Dropout</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_dropout_prob</span><span class="sh">"</span><span class="p">])</span>

    <span class="k">def</span> <span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">batch</span><span class="p">,</span> <span class="n">length</span><span class="p">,</span> <span class="n">d</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span>
        <span class="k">return</span> <span class="n">x</span><span class="p">.</span><span class="nf">view</span><span class="p">(</span><span class="n">batch</span><span class="p">,</span> <span class="n">length</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">d</span> <span class="o">//</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">padding</span><span class="p">):</span>
        <span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">q</span><span class="p">(</span><span class="n">x</span><span class="p">)),</span> <span class="n">self</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">k</span><span class="p">(</span><span class="n">x</span><span class="p">)),</span> <span class="n">self</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">v</span><span class="p">(</span><span class="n">x</span><span class="p">))</span>
        <span class="n">scores</span> <span class="o">=</span> <span class="n">q</span> <span class="o">@</span> <span class="n">k</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">2</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">])</span>
        <span class="n">lowest</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">finfo</span><span class="p">(</span><span class="n">scores</span><span class="p">.</span><span class="n">dtype</span><span class="p">).</span><span class="nb">min</span>  <span class="c1"># not -inf: see section 4
</span>        <span class="n">scores</span> <span class="o">=</span> <span class="n">scores</span><span class="p">.</span><span class="nf">masked_fill</span><span class="p">(</span><span class="n">padding</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:],</span> <span class="n">lowest</span><span class="p">)</span>
        <span class="n">y</span> <span class="o">=</span> <span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">dropout</span><span class="p">(</span><span class="n">scores</span><span class="p">.</span><span class="nf">softmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">))</span> <span class="o">@</span> <span class="n">v</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">)</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm1</span><span class="p">(</span><span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">dropout</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">out</span><span class="p">(</span><span class="n">y</span><span class="p">)))</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm2</span><span class="p">(</span><span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">dropout</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">down</span><span class="p">(</span><span class="n">F</span><span class="p">.</span><span class="nf">gelu</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">up</span><span class="p">(</span><span class="n">x</span><span class="p">)))))</span>


<span class="k">class</span> <span class="nc">Encoder</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">embeddings</span> <span class="o">=</span> <span class="nc">Embeddings</span><span class="p">(</span><span class="n">config</span><span class="p">)</span>
        <span class="n">n_layers</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">layers</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">ModuleList</span><span class="p">(</span><span class="nc">Layer</span><span class="p">(</span><span class="n">config</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n_layers</span><span class="p">))</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">padding</span><span class="p">):</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">embeddings</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span>
        <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">self</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
            <span class="n">x</span> <span class="o">=</span> <span class="nf">layer</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">padding</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">x</span>
</code></pre></div></div> <p>The second left-over is in the embedding table’s shape: RoBERTa has one segment, not two, since it never packs two sentences for the abandoned game, and 514 positions, two of them never used. The names of its tensors differ from Google’s too; they follow PyTorch’s conventions, <code class="language-plaintext highlighter-rouge">weight</code> and <code class="language-plaintext highlighter-rouge">bias</code>, because RoBERTa was trained in PyTorch.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">roberta_names</span><span class="p">(</span><span class="n">config</span><span class="p">):</span>
    <span class="n">names</span> <span class="o">=</span> <span class="p">{</span>
        <span class="sh">"</span><span class="s">embeddings.words.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">roberta.embeddings.word_embeddings.weight</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">embeddings.positions.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">roberta.embeddings.position_embeddings.weight</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">embeddings.segments.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">roberta.embeddings.token_type_embeddings.weight</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">embeddings.norm.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">roberta.embeddings.LayerNorm.weight</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">embeddings.norm.bias</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">roberta.embeddings.LayerNorm.bias</span><span class="sh">"</span><span class="p">,</span>
    <span class="p">}</span>
    <span class="n">parts</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">q</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention.self.query</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">k</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention.self.key</span><span class="sh">"</span><span class="p">,</span>
             <span class="sh">"</span><span class="s">v</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention.self.value</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">out</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention.output.dense</span><span class="sh">"</span><span class="p">,</span>
             <span class="sh">"</span><span class="s">norm1</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention.output.LayerNorm</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">up</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">intermediate.dense</span><span class="sh">"</span><span class="p">,</span>
             <span class="sh">"</span><span class="s">down</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">output.dense</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">norm2</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">output.LayerNorm</span><span class="sh">"</span><span class="p">}</span>
    <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">]):</span>
        <span class="k">for</span> <span class="n">ours</span><span class="p">,</span> <span class="n">theirs</span> <span class="ow">in</span> <span class="n">parts</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
            <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="p">(</span><span class="sh">"</span><span class="s">weight</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">bias</span><span class="sh">"</span><span class="p">):</span>
                <span class="n">names</span><span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="s">layers.</span><span class="si">{</span><span class="n">i</span><span class="si">}</span><span class="s">.</span><span class="si">{</span><span class="n">ours</span><span class="si">}</span><span class="s">.</span><span class="si">{</span><span class="n">p</span><span class="si">}</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">roberta.encoder.layer.</span><span class="si">{</span><span class="n">i</span><span class="si">}</span><span class="s">.</span><span class="si">{</span><span class="n">theirs</span><span class="si">}</span><span class="s">.</span><span class="si">{</span><span class="n">p</span><span class="si">}</span><span class="sh">"</span>
    <span class="k">return</span> <span class="n">names</span>


<span class="n">ROBERTA</span> <span class="o">=</span> <span class="sh">"</span><span class="s">FacebookAI/roberta-base</span><span class="sh">"</span>
<span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">ROBERTA</span><span class="p">,</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">))</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
    <span class="n">roberta_config</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">f</span><span class="p">)</span>
<span class="n">weights</span> <span class="o">=</span> <span class="nf">load_file</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">ROBERTA</span><span class="p">,</span> <span class="sh">"</span><span class="s">model.safetensors</span><span class="sh">"</span><span class="p">))</span>
<span class="n">roberta</span> <span class="o">=</span> <span class="nc">Encoder</span><span class="p">(</span><span class="n">roberta_config</span><span class="p">)</span>
<span class="n">state</span> <span class="o">=</span> <span class="p">{</span><span class="n">ours</span><span class="p">:</span> <span class="n">weights</span><span class="p">[</span><span class="n">theirs</span><span class="p">]</span> <span class="k">for</span> <span class="n">ours</span><span class="p">,</span> <span class="n">theirs</span> <span class="ow">in</span> <span class="nf">roberta_names</span><span class="p">(</span><span class="n">roberta_config</span><span class="p">).</span><span class="nf">items</span><span class="p">()}</span>
<span class="n">roberta</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">(</span><span class="n">state</span><span class="p">,</span> <span class="n">strict</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">roberta</span> <span class="o">=</span> <span class="n">roberta</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>

<span class="n">roberta_tokenizer</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">ROBERTA</span><span class="p">)</span>
<span class="n">reference</span> <span class="o">=</span> <span class="n">RobertaModel</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">ROBERTA</span><span class="p">,</span> <span class="n">add_pooling_layer</span><span class="o">=</span><span class="bp">False</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="n">texts</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">Segfault in torch.compile() with dynamic shapes 🚀</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Docs typo</span><span class="sh">"</span><span class="p">]</span>
<span class="n">check</span> <span class="o">=</span> <span class="nf">roberta_tokenizer</span><span class="p">(</span><span class="n">texts</span><span class="p">,</span> <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="n">padding</span> <span class="o">=</span> <span class="n">check</span><span class="p">[</span><span class="sh">"</span><span class="s">attention_mask</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="mi">0</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">theirs</span> <span class="o">=</span> <span class="nf">reference</span><span class="p">(</span><span class="o">**</span><span class="n">check</span><span class="p">).</span><span class="n">last_hidden_state</span>
    <span class="n">ours</span> <span class="o">=</span> <span class="nf">roberta</span><span class="p">(</span><span class="n">check</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">padding</span><span class="p">)</span>
<span class="n">gap</span> <span class="o">=</span> <span class="p">(</span><span class="n">ours</span> <span class="o">-</span> <span class="n">theirs</span><span class="p">)[</span><span class="o">~</span><span class="n">padding</span><span class="p">].</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">largest difference from Hugging Face</span><span class="sh">'</span><span class="s">s RoBERTa: </span><span class="si">{</span><span class="n">gap</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="k">assert</span> <span class="n">gap</span> <span class="o">&lt;</span> <span class="mf">1e-3</span>
<span class="k">del</span> <span class="n">reference</span>
</code></pre></div></div> <pre class="tfs-printed"><code>largest difference from Hugging Face's RoBERTa: 5.7e-06</code></pre> <p>RoBERTa’s other visible change is its tokenizer. BERT’s WordPiece splits text into characters it knows, and a character it doesn’t know becomes <code class="language-plaintext highlighter-rouge">[UNK]</code>, the same token for an emoji, a Chinese name and a Greek letter.</p> <p>RoBERTa borrowed GPT-2’s <strong>byte-level BPE</strong>: the text is first turned into bytes, and any byte sequence can be spelled out with 256 byte tokens, so nothing is ever unknown.</p> <p>The <code class="language-plaintext highlighter-rouge">Ġ</code> you’ll see marks a token that starts with a space, and pairs like <code class="language-plaintext highlighter-rouge">Ã¯</code> are the two bytes of one character, <em>ï</em>, printed one by one.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">bert_tokenizer</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="sh">"</span><span class="s">google-bert/bert-base-uncased</span><span class="sh">"</span><span class="p">)</span>
<span class="n">samples</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">x = torch.compile(model)  # 🚀</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">naïve café in Zürich, Ελλάδα</span><span class="sh">"</span><span class="p">]</span>
<span class="n">rows</span><span class="p">,</span> <span class="n">labels</span> <span class="o">=</span> <span class="p">[],</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">text</span> <span class="ow">in</span> <span class="n">samples</span><span class="p">:</span>
    <span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">tok</span> <span class="ow">in</span> <span class="p">[(</span><span class="sh">"</span><span class="s">WordPiece</span><span class="sh">"</span><span class="p">,</span> <span class="n">bert_tokenizer</span><span class="p">),</span> <span class="p">(</span><span class="sh">"</span><span class="s">byte BPE</span><span class="sh">"</span><span class="p">,</span> <span class="n">roberta_tokenizer</span><span class="p">)]:</span>
        <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">tok</span><span class="p">.</span><span class="nf">tokenize</span><span class="p">(</span><span class="n">text</span><span class="p">))</span>
        <span class="n">labels</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">name</span><span class="p">)</span>
<span class="nf">token_chips</span><span class="p">(</span><span class="n">rows</span><span class="p">,</span> <span class="n">labels</span><span class="o">=</span><span class="n">labels</span><span class="p">,</span> <span class="n">max_width</span><span class="o">=</span><span class="mi">640</span><span class="p">,</span>
            <span class="n">strong</span><span class="o">=</span><span class="k">lambda</span> <span class="n">row</span><span class="p">,</span> <span class="n">col</span><span class="p">,</span> <span class="n">token</span><span class="p">:</span> <span class="n">token</span> <span class="o">==</span> <span class="sh">"</span><span class="s">[UNK]</span><span class="sh">"</span><span class="p">)</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">tok</span> <span class="ow">in</span> <span class="p">[(</span><span class="sh">"</span><span class="s">WordPiece</span><span class="sh">"</span><span class="p">,</span> <span class="n">bert_tokenizer</span><span class="p">),</span> <span class="p">(</span><span class="sh">"</span><span class="s">byte BPE</span><span class="sh">"</span><span class="p">,</span> <span class="n">roberta_tokenizer</span><span class="p">)]:</span>
    <span class="n">unknown</span> <span class="o">=</span> <span class="nf">sum</span><span class="p">(</span><span class="n">t</span> <span class="o">==</span> <span class="n">tok</span><span class="p">.</span><span class="n">unk_token</span> <span class="k">for</span> <span class="n">text</span> <span class="ow">in</span> <span class="n">samples</span> <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="n">tok</span><span class="p">.</span><span class="nf">tokenize</span><span class="p">(</span><span class="n">text</span><span class="p">))</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="s">: </span><span class="si">{</span><span class="n">unknown</span><span class="si">}</span><span class="s"> unknown tokens</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>WordPiece: 1 unknown tokens
byte BPE: 0 unknown tokens</code></pre> <p><img class="tfs-output" src="/assets/posts/arch/02/output-01.png" alt="Output of the code above" loading="lazy"></p> <p>WordPiece also lowercased everything and stripped the accents; byte BPE keeps the text exactly, and turns what it hasn’t seen often into more, smaller pieces, sometimes single bytes of a multi-byte character. For text that mixes prose, code, stack traces and emoji, which is what GitHub issues are, that matters.</p> <h2 id="2-electra-learning-from-every-token">2. ELECTRA: learning from every token</h2> <p>Masked language modelling has a cost that lesson 1 mentioned in passing: the model learns only from the 15% of tokens it hides. ELECTRA, from Stanford and Google, turned the game around <sup class="cite">[<a href="#ref-2" id="cite-2" data-ref="2" aria-label="Reference 2: Clark, K., Luong, M.-T., Le, Q. V., &amp; Manning, C. D. (2020). ELECTRA: pre-training text encoders as discriminators rather than generators. ICLR 2020.">2</a>]</sup>. A small masked language model, the <strong>generator</strong>, fills the masked positions with its own guesses.</p> <p>The model we actually want, the <strong>discriminator</strong>, sees the result and says for <em>every</em> token whether it is the original or a replacement. This is <strong>replaced token detection</strong>, and its headline result was a small model trained “on one GPU for 4 days that outperforms GPT (trained using 30x more compute)”.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/02/electra-light.png" width="760" alt="Replaced token detection. A sentence has some tokens masked; a small generator fills each mask with a plausible word, sometimes the right one; the discriminator reads the result and labels every token as original or replaced, so it learns from all of them" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/02/electra-dark.png" width="760" alt="Replaced token detection. A sentence has some tokens masked; a small generator fills each mask with a plausible word, sometimes the right one; the discriminator reads the result and labels every token as original or replaced, so it learns from all of them" loading="lazy"></p> <p>The generator is trained as an ordinary masked language model, “rather than being trained adversarially to fool the discriminator”, and it is small: the paper recommends a quarter to half of the discriminator’s size.</p> <p>Its guesses are good enough to be hard to spot, and when it happens to guess the right word, that token counts as original. After <a href="/blog/2024/llms-for-those-who-missed-out/">pre-training</a> the generator is thrown away.</p> <p>To see what this buys we’ll pre-train two small encoders from scratch, one with each task, for the same number of minutes on the same GPU, and then compare them on the job of section 5.</p> <p>The text they learn from is GitHub issues themselves, which we load now. The dataset holds the issues of seventeen large projects with their labels <sup class="cite">[<a href="#ref-3" id="cite-3" data-ref="3" aria-label="Reference 3: open-index (2026). Open GitHub issues. Hugging Face dataset, ODC-By.">3</a>]</sup>; every project labels its issues its own way, so we map the labels to four kinds.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">ISSUES</span> <span class="o">=</span> <span class="sh">"</span><span class="s">open-index/open-github-issues</span><span class="sh">"</span>
<span class="n">TRAIN_REPOS</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">python/cpython</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">rust-lang/rust</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">microsoft/TypeScript</span><span class="sh">"</span><span class="p">,</span>
               <span class="sh">"</span><span class="s">kubernetes/kubernetes</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">pingcap/tidb</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">swiftlang/swift</span><span class="sh">"</span><span class="p">,</span>
               <span class="sh">"</span><span class="s">ClickHouse/ClickHouse</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">golang/go</span><span class="sh">"</span><span class="p">]</span>
<span class="n">TEST_REPOS</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">moby/moby</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">etcd-io/etcd</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">facebook/react</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">redis/redis</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">vuejs/core</span><span class="sh">"</span><span class="p">]</span>
<span class="n">KINDS</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">bug</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">feature</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">question</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">docs</span><span class="sh">"</span><span class="p">]</span>
<span class="n">RULES</span> <span class="o">=</span> <span class="p">[(</span><span class="sh">"</span><span class="s">docs</span><span class="sh">"</span><span class="p">,</span> <span class="sa">r</span><span class="sh">"</span><span class="s">\bdoc(s|umentation)?\b</span><span class="sh">"</span><span class="p">),</span> <span class="p">(</span><span class="sh">"</span><span class="s">question</span><span class="sh">"</span><span class="p">,</span> <span class="sa">r</span><span class="sh">"</span><span class="s">\bquestion\b|\bsupport\b</span><span class="sh">"</span><span class="p">),</span>
         <span class="p">(</span><span class="sh">"</span><span class="s">feature</span><span class="sh">"</span><span class="p">,</span> <span class="sa">r</span><span class="sh">"</span><span class="s">feature|enhancement|suggestion|proposal|improvement</span><span class="sh">"</span><span class="p">),</span>
         <span class="p">(</span><span class="sh">"</span><span class="s">bug</span><span class="sh">"</span><span class="p">,</span> <span class="sa">r</span><span class="sh">"</span><span class="s">\bbug\b|crash|unexpected behaviour</span><span class="sh">"</span><span class="p">)]</span>
<span class="n">SKIP</span> <span class="o">=</span> <span class="sa">r</span><span class="sh">"</span><span class="s">not a bug|working as intended|duplicate|spam|question-answered</span><span class="sh">"</span>


<span class="k">def</span> <span class="nf">kind_of</span><span class="p">(</span><span class="n">labels</span><span class="p">):</span>
    <span class="n">found</span> <span class="o">=</span> <span class="nf">set</span><span class="p">()</span>
    <span class="k">for</span> <span class="n">label</span> <span class="ow">in</span> <span class="n">labels</span><span class="p">:</span>
        <span class="n">low</span> <span class="o">=</span> <span class="n">label</span><span class="p">.</span><span class="nf">lower</span><span class="p">()</span>
        <span class="k">if</span> <span class="n">re</span><span class="p">.</span><span class="nf">search</span><span class="p">(</span><span class="n">SKIP</span><span class="p">,</span> <span class="n">low</span><span class="p">):</span>
            <span class="k">return</span> <span class="bp">None</span>
        <span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">pattern</span> <span class="ow">in</span> <span class="n">RULES</span><span class="p">:</span>
            <span class="k">if</span> <span class="n">re</span><span class="p">.</span><span class="nf">search</span><span class="p">(</span><span class="n">pattern</span><span class="p">,</span> <span class="n">low</span><span class="p">):</span>
                <span class="n">found</span><span class="p">.</span><span class="nf">add</span><span class="p">(</span><span class="n">name</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">found</span><span class="p">.</span><span class="nf">pop</span><span class="p">()</span> <span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="n">found</span><span class="p">)</span> <span class="o">==</span> <span class="mi">1</span> <span class="k">else</span> <span class="bp">None</span>  <span class="c1"># one kind, or the issue is left out
</span>

<span class="k">def</span> <span class="nf">load_issues</span><span class="p">(</span><span class="n">repo</span><span class="p">):</span>
    <span class="n">path</span> <span class="o">=</span> <span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">ISSUES</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="s">data/issues/</span><span class="si">{</span><span class="n">repo</span><span class="si">}</span><span class="s">/0.parquet</span><span class="sh">"</span><span class="p">,</span> <span class="n">repo_type</span><span class="o">=</span><span class="sh">"</span><span class="s">dataset</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">frame</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nf">read_parquet</span><span class="p">(</span><span class="n">path</span><span class="p">,</span> <span class="n">columns</span><span class="o">=</span><span class="p">[</span><span class="sh">"</span><span class="s">is_pull_request</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">title</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">body</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">labels</span><span class="sh">"</span><span class="p">])</span>
    <span class="n">frame</span> <span class="o">=</span> <span class="n">frame</span><span class="p">[</span><span class="n">frame</span><span class="p">[</span><span class="sh">"</span><span class="s">is_pull_request</span><span class="sh">"</span><span class="p">].</span><span class="nf">astype</span><span class="p">(</span><span class="nb">str</span><span class="p">)</span> <span class="o">==</span> <span class="sh">"</span><span class="s">False</span><span class="sh">"</span><span class="p">]</span>
    <span class="k">if</span> <span class="n">SMOKE</span><span class="p">:</span>
        <span class="n">frame</span> <span class="o">=</span> <span class="n">frame</span><span class="p">.</span><span class="nf">head</span><span class="p">(</span><span class="mi">3000</span><span class="p">)</span>
    <span class="n">labels</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">x</span> <span class="ow">in</span> <span class="n">frame</span><span class="p">[</span><span class="sh">"</span><span class="s">labels</span><span class="sh">"</span><span class="p">]:</span>  <span class="c1"># a list, the string of a list, or "null" for no labels
</span>        <span class="k">if</span> <span class="nf">isinstance</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="nb">str</span><span class="p">):</span>
            <span class="n">labels</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">ast</span><span class="p">.</span><span class="nf">literal_eval</span><span class="p">(</span><span class="n">x</span><span class="p">)</span> <span class="k">if</span> <span class="n">x</span><span class="p">.</span><span class="nf">startswith</span><span class="p">(</span><span class="sh">"</span><span class="s">[</span><span class="sh">"</span><span class="p">)</span> <span class="k">else</span> <span class="p">[])</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="n">labels</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="nf">list</span><span class="p">(</span><span class="n">x</span><span class="p">)</span> <span class="k">if</span> <span class="n">x</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span> <span class="k">else</span> <span class="p">[])</span>
    <span class="n">frame</span> <span class="o">=</span> <span class="n">frame</span><span class="p">.</span><span class="nf">assign</span><span class="p">(</span><span class="n">kind</span><span class="o">=</span><span class="p">[</span><span class="nf">kind_of</span><span class="p">(</span><span class="n">ls</span><span class="p">)</span> <span class="k">for</span> <span class="n">ls</span> <span class="ow">in</span> <span class="n">labels</span><span class="p">],</span> <span class="n">repo</span><span class="o">=</span><span class="n">repo</span><span class="p">)</span>
    <span class="n">frame</span> <span class="o">=</span> <span class="n">frame</span><span class="p">[</span><span class="n">frame</span><span class="p">[</span><span class="sh">"</span><span class="s">kind</span><span class="sh">"</span><span class="p">].</span><span class="nf">notna</span><span class="p">()]</span>
    <span class="n">text</span> <span class="o">=</span> <span class="n">frame</span><span class="p">[</span><span class="sh">"</span><span class="s">title</span><span class="sh">"</span><span class="p">].</span><span class="nf">fillna</span><span class="p">(</span><span class="sh">""</span><span class="p">)</span> <span class="o">+</span> <span class="sh">"</span><span class="se">\n\n</span><span class="sh">"</span> <span class="o">+</span> <span class="n">frame</span><span class="p">[</span><span class="sh">"</span><span class="s">body</span><span class="sh">"</span><span class="p">].</span><span class="nf">fillna</span><span class="p">(</span><span class="sh">""</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">frame</span><span class="p">.</span><span class="nf">assign</span><span class="p">(</span><span class="n">text</span><span class="o">=</span><span class="n">text</span><span class="p">)[[</span><span class="sh">"</span><span class="s">repo</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">kind</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">]]</span>


<span class="n">issues</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nf">concat</span><span class="p">([</span><span class="nf">load_issues</span><span class="p">(</span><span class="n">r</span><span class="p">)</span> <span class="k">for</span> <span class="n">r</span> <span class="ow">in</span> <span class="n">TRAIN_REPOS</span> <span class="o">+</span> <span class="n">TEST_REPOS</span><span class="p">],</span> <span class="n">ignore_index</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nf">crosstab</span><span class="p">(</span><span class="n">issues</span><span class="p">[</span><span class="sh">"</span><span class="s">repo</span><span class="sh">"</span><span class="p">],</span> <span class="n">issues</span><span class="p">[</span><span class="sh">"</span><span class="s">kind</span><span class="sh">"</span><span class="p">],</span> <span class="n">margins</span><span class="o">=</span><span class="bp">True</span><span class="p">).</span><span class="nf">reset_index</span><span class="p">())</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">repo</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">bug</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">docs</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">feature</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">question</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">All</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">ClickHouse/ClickHouse</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8,429</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">456</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4,570</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3,362</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">16,817</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">etcd-io/etcd</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">850</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">183</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">690</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">449</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,172</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">facebook/react</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,417</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">579</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">501</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,497</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">golang/go</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3,137</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7,899</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">46</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">11,082</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">kubernetes/kubernetes</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">14,636</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,034</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6,025</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,316</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">24,011</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">microsoft/TypeScript</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">11,119</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">316</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6,702</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3,315</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">21,452</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">moby/moby</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3,054</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">506</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,952</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,160</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">7,672</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">pingcap/tidb</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">11,258</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">11</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6,956</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">972</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">19,197</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">python/cpython</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">27,473</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6,944</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">13,204</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">47,621</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">redis/redis</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">189</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">11</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">200</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">90</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">490</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">rust-lang/rust</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">19,965</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">918</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6,934</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">27,817</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">swiftlang/swift</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">14,161</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">30</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,469</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">23</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">15,683</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">vuejs/core</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">957</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">9</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">411</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,377</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">All</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">113,508</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">13,555</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">58,591</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">12,234</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">197,888</td></tr></tbody></table></div> <p>The projects in <code class="language-plaintext highlighter-rouge">TEST_REPOS</code> are kept for the end: neither pre-training nor fine-tuning will see a single issue of theirs. Both pre-training runs read the issues of the training projects, cut into pieces of 128 tokens.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">train_text</span> <span class="o">=</span> <span class="n">issues</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">issues</span><span class="p">[</span><span class="sh">"</span><span class="s">repo</span><span class="sh">"</span><span class="p">].</span><span class="nf">isin</span><span class="p">(</span><span class="n">TRAIN_REPOS</span><span class="p">),</span> <span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">]</span>
<span class="n">n_sample</span> <span class="o">=</span> <span class="nf">min</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">train_text</span><span class="p">),</span> <span class="mi">400</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">40000</span><span class="p">)</span>
<span class="n">sample</span> <span class="o">=</span> <span class="n">train_text</span><span class="p">.</span><span class="nf">sample</span><span class="p">(</span><span class="n">n</span><span class="o">=</span><span class="n">n_sample</span><span class="p">,</span> <span class="n">random_state</span><span class="o">=</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">encoded</span> <span class="o">=</span> <span class="nf">bert_tokenizer</span><span class="p">(</span><span class="nf">list</span><span class="p">(</span><span class="n">sample</span><span class="p">),</span> <span class="n">add_special_tokens</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">truncation</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
                         <span class="n">max_length</span><span class="o">=</span><span class="mi">2048</span><span class="p">)[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">]</span>
<span class="n">cls</span><span class="p">,</span> <span class="n">sep</span> <span class="o">=</span> <span class="n">bert_tokenizer</span><span class="p">.</span><span class="n">cls_token_id</span><span class="p">,</span> <span class="n">bert_tokenizer</span><span class="p">.</span><span class="n">sep_token_id</span>
<span class="n">pieces</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">ids</span> <span class="ow">in</span> <span class="n">encoded</span><span class="p">:</span>
    <span class="k">for</span> <span class="n">start</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">max</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span> <span class="o">-</span> <span class="mi">32</span><span class="p">),</span> <span class="mi">126</span><span class="p">):</span>
        <span class="n">piece</span> <span class="o">=</span> <span class="p">[</span><span class="n">cls</span><span class="p">]</span> <span class="o">+</span> <span class="n">ids</span><span class="p">[</span><span class="n">start</span><span class="p">:</span><span class="n">start</span> <span class="o">+</span> <span class="mi">126</span><span class="p">]</span> <span class="o">+</span> <span class="p">[</span><span class="n">sep</span><span class="p">]</span>
        <span class="n">pieces</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">piece</span> <span class="o">+</span> <span class="p">[</span><span class="mi">0</span><span class="p">]</span> <span class="o">*</span> <span class="p">(</span><span class="mi">128</span> <span class="o">-</span> <span class="nf">len</span><span class="p">(</span><span class="n">piece</span><span class="p">)))</span>
<span class="n">corpus</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">pieces</span><span class="p">)</span>
<span class="n">real_tokens</span> <span class="o">=</span> <span class="n">corpus</span><span class="p">.</span><span class="nf">ne</span><span class="p">(</span><span class="mi">0</span><span class="p">).</span><span class="nf">sum</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">corpus</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> pieces of 128 tokens, </span><span class="si">{</span><span class="n">real_tokens</span> <span class="o">/</span> <span class="mf">1e6</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s">M real tokens</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>221,157 pieces of 128 tokens, 27.0M real tokens</code></pre> <p>Both encoders are the same small BERT, 4 layers and 256 wide, initialised as BERT was. The masked language model gets lesson 1’s head. ELECTRA’s generator is a one-layer encoder that shares the discriminator’s word embeddings, a quarter of its depth; its head predicts words, and the discriminator’s head predicts one number per token, <em>replaced or not</em>.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">TINY</span> <span class="o">=</span> <span class="nf">dict</span><span class="p">(</span><span class="n">vocab_size</span><span class="o">=</span><span class="nf">len</span><span class="p">(</span><span class="n">bert_tokenizer</span><span class="p">),</span> <span class="n">hidden_size</span><span class="o">=</span><span class="mi">256</span><span class="p">,</span> <span class="n">num_hidden_layers</span><span class="o">=</span><span class="mi">4</span><span class="p">,</span>
            <span class="n">num_attention_heads</span><span class="o">=</span><span class="mi">4</span><span class="p">,</span> <span class="n">intermediate_size</span><span class="o">=</span><span class="mi">1024</span><span class="p">,</span> <span class="n">max_position_embeddings</span><span class="o">=</span><span class="mi">512</span><span class="p">,</span>
            <span class="n">type_vocab_size</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span> <span class="n">layer_norm_eps</span><span class="o">=</span><span class="mf">1e-12</span><span class="p">,</span> <span class="n">hidden_dropout_prob</span><span class="o">=</span><span class="mf">0.1</span><span class="p">,</span>
            <span class="n">attention_probs_dropout_prob</span><span class="o">=</span><span class="mf">0.1</span><span class="p">,</span> <span class="n">model_type</span><span class="o">=</span><span class="sh">"</span><span class="s">bert</span><span class="sh">"</span><span class="p">,</span> <span class="n">pad_token_id</span><span class="o">=</span><span class="mi">0</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">init_like_bert</span><span class="p">(</span><span class="n">module</span><span class="p">):</span>
    <span class="k">if</span> <span class="nf">isinstance</span><span class="p">(</span><span class="n">module</span><span class="p">,</span> <span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Linear</span><span class="p">,</span> <span class="n">nn</span><span class="p">.</span><span class="n">Embedding</span><span class="p">)):</span>
        <span class="n">nn</span><span class="p">.</span><span class="n">init</span><span class="p">.</span><span class="nf">normal_</span><span class="p">(</span><span class="n">module</span><span class="p">.</span><span class="n">weight</span><span class="p">,</span> <span class="n">std</span><span class="o">=</span><span class="mf">0.02</span><span class="p">)</span>
    <span class="k">if</span> <span class="nf">isinstance</span><span class="p">(</span><span class="n">module</span><span class="p">,</span> <span class="n">nn</span><span class="p">.</span><span class="n">Linear</span><span class="p">)</span> <span class="ow">and</span> <span class="n">module</span><span class="p">.</span><span class="n">bias</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
        <span class="n">nn</span><span class="p">.</span><span class="n">init</span><span class="p">.</span><span class="nf">zeros_</span><span class="p">(</span><span class="n">module</span><span class="p">.</span><span class="n">bias</span><span class="p">)</span>
    <span class="k">if</span> <span class="nf">isinstance</span><span class="p">(</span><span class="n">module</span><span class="p">,</span> <span class="n">nn</span><span class="p">.</span><span class="n">LayerNorm</span><span class="p">):</span>
        <span class="n">nn</span><span class="p">.</span><span class="n">init</span><span class="p">.</span><span class="nf">ones_</span><span class="p">(</span><span class="n">module</span><span class="p">.</span><span class="n">weight</span><span class="p">)</span>
        <span class="n">nn</span><span class="p">.</span><span class="n">init</span><span class="p">.</span><span class="nf">zeros_</span><span class="p">(</span><span class="n">module</span><span class="p">.</span><span class="n">bias</span><span class="p">)</span>


<span class="k">class</span> <span class="nc">WordHead</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>  <span class="c1"># lesson 1's masked LM head: a score for every word
</span>    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">words</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">dense</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">norm</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">words</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">),</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">),</span> <span class="n">words</span>
        <span class="n">self</span><span class="p">.</span><span class="n">bias</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">words</span><span class="p">.</span><span class="n">num_embeddings</span><span class="p">))</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">h</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm</span><span class="p">(</span><span class="n">F</span><span class="p">.</span><span class="nf">gelu</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">dense</span><span class="p">(</span><span class="n">h</span><span class="p">)))</span> <span class="o">@</span> <span class="n">self</span><span class="p">.</span><span class="n">words</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">T</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">bias</span>


<span class="k">class</span> <span class="nc">ReplacedHead</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>  <span class="c1"># ELECTRA's discriminator: one score per token
</span>    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">d</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">dense</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">score</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">),</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">h</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">score</span><span class="p">(</span><span class="n">F</span><span class="p">.</span><span class="nf">gelu</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">dense</span><span class="p">(</span><span class="n">h</span><span class="p">))).</span><span class="nf">squeeze</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">mask_tokens</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">generator</span><span class="p">,</span> <span class="n">rate</span><span class="o">=</span><span class="mf">0.15</span><span class="p">):</span>
    <span class="n">special</span> <span class="o">=</span> <span class="p">(</span><span class="n">ids</span> <span class="o">==</span> <span class="n">cls</span><span class="p">)</span> <span class="o">|</span> <span class="p">(</span><span class="n">ids</span> <span class="o">==</span> <span class="n">sep</span><span class="p">)</span> <span class="o">|</span> <span class="p">(</span><span class="n">ids</span> <span class="o">==</span> <span class="mi">0</span><span class="p">)</span>
    <span class="n">chosen</span> <span class="o">=</span> <span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">rand</span><span class="p">(</span><span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">,</span> <span class="n">generator</span><span class="o">=</span><span class="n">generator</span><span class="p">)</span> <span class="o">&lt;</span> <span class="n">rate</span><span class="p">)</span> <span class="o">&amp;</span> <span class="o">~</span><span class="n">special</span>
    <span class="n">roll</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">rand</span><span class="p">(</span><span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">,</span> <span class="n">generator</span><span class="o">=</span><span class="n">generator</span><span class="p">)</span>
    <span class="n">masked</span> <span class="o">=</span> <span class="n">ids</span><span class="p">.</span><span class="nf">clone</span><span class="p">()</span>
    <span class="n">masked</span><span class="p">[</span><span class="n">chosen</span> <span class="o">&amp;</span> <span class="p">(</span><span class="n">roll</span> <span class="o">&lt;</span> <span class="mf">0.8</span><span class="p">)]</span> <span class="o">=</span> <span class="n">bert_tokenizer</span><span class="p">.</span><span class="n">mask_token_id</span>
    <span class="n">swap</span> <span class="o">=</span> <span class="n">chosen</span> <span class="o">&amp;</span> <span class="p">(</span><span class="n">roll</span> <span class="o">&gt;=</span> <span class="mf">0.8</span><span class="p">)</span> <span class="o">&amp;</span> <span class="p">(</span><span class="n">roll</span> <span class="o">&lt;</span> <span class="mf">0.9</span><span class="p">)</span>
    <span class="n">masked</span><span class="p">[</span><span class="n">swap</span><span class="p">]</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randint</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">bert_tokenizer</span><span class="p">),</span> <span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">,</span> <span class="n">generator</span><span class="o">=</span><span class="n">generator</span><span class="p">)[</span><span class="n">swap</span><span class="p">]</span>
    <span class="k">return</span> <span class="n">masked</span><span class="p">,</span> <span class="n">chosen</span>
</code></pre></div></div> <p>One training step of each. The masked language model computes its loss at the chosen positions only. ELECTRA runs the generator on the masked text, samples a word for every chosen position from the generator’s own predictions, and asks the discriminator to find the replacements among all real tokens.</p> <p>The paper weighs the discriminator’s loss fifty times more than the generator’s, since a binary decision per token gives much smaller losses than a choice among 30,000 words.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">mlm_step</span><span class="p">(</span><span class="n">models</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">generator</span><span class="p">):</span>
    <span class="n">encoder</span><span class="p">,</span> <span class="n">head</span> <span class="o">=</span> <span class="n">models</span>
    <span class="n">masked</span><span class="p">,</span> <span class="n">chosen</span> <span class="o">=</span> <span class="nf">mask_tokens</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">generator</span><span class="p">)</span>
    <span class="n">logits</span> <span class="o">=</span> <span class="nf">head</span><span class="p">(</span><span class="nf">encoder</span><span class="p">(</span><span class="n">masked</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">),</span> <span class="p">(</span><span class="n">ids</span> <span class="o">==</span> <span class="mi">0</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)))</span>
    <span class="k">return</span> <span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span><span class="n">logits</span><span class="p">[</span><span class="n">chosen</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)].</span><span class="nf">float</span><span class="p">(),</span> <span class="n">ids</span><span class="p">[</span><span class="n">chosen</span><span class="p">].</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">))</span>


<span class="k">def</span> <span class="nf">electra_step</span><span class="p">(</span><span class="n">models</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">generator</span><span class="p">):</span>
    <span class="n">encoder</span><span class="p">,</span> <span class="n">head</span><span class="p">,</span> <span class="n">gen</span><span class="p">,</span> <span class="n">gen_head</span> <span class="o">=</span> <span class="n">models</span>
    <span class="n">masked</span><span class="p">,</span> <span class="n">chosen</span> <span class="o">=</span> <span class="nf">mask_tokens</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">generator</span><span class="p">)</span>
    <span class="n">padding</span> <span class="o">=</span> <span class="p">(</span><span class="n">ids</span> <span class="o">==</span> <span class="mi">0</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="n">ids</span><span class="p">,</span> <span class="n">masked</span><span class="p">,</span> <span class="n">chosen</span> <span class="o">=</span> <span class="n">ids</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">),</span> <span class="n">masked</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">),</span> <span class="n">chosen</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="n">gen_logits</span> <span class="o">=</span> <span class="nf">gen_head</span><span class="p">(</span><span class="nf">gen</span><span class="p">(</span><span class="n">masked</span><span class="p">,</span> <span class="n">padding</span><span class="p">))[</span><span class="n">chosen</span><span class="p">].</span><span class="nf">float</span><span class="p">()</span>
    <span class="n">gen_loss</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span><span class="n">gen_logits</span><span class="p">,</span> <span class="n">ids</span><span class="p">[</span><span class="n">chosen</span><span class="p">])</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="n">guesses</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">distributions</span><span class="p">.</span><span class="nc">Categorical</span><span class="p">(</span><span class="n">logits</span><span class="o">=</span><span class="n">gen_logits</span><span class="p">).</span><span class="nf">sample</span><span class="p">()</span>
    <span class="n">corrupted</span> <span class="o">=</span> <span class="n">ids</span><span class="p">.</span><span class="nf">clone</span><span class="p">()</span>
    <span class="n">corrupted</span><span class="p">[</span><span class="n">chosen</span><span class="p">]</span> <span class="o">=</span> <span class="n">guesses</span>
    <span class="n">replaced</span> <span class="o">=</span> <span class="p">(</span><span class="n">corrupted</span> <span class="o">!=</span> <span class="n">ids</span><span class="p">).</span><span class="nf">float</span><span class="p">()</span>  <span class="c1"># a lucky guess counts as original
</span>    <span class="n">scores</span> <span class="o">=</span> <span class="nf">head</span><span class="p">(</span><span class="nf">encoder</span><span class="p">(</span><span class="n">corrupted</span><span class="p">,</span> <span class="n">padding</span><span class="p">)).</span><span class="nf">float</span><span class="p">()</span>
    <span class="n">disc_loss</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">binary_cross_entropy_with_logits</span><span class="p">(</span><span class="n">scores</span><span class="p">[</span><span class="o">~</span><span class="n">padding</span><span class="p">],</span> <span class="n">replaced</span><span class="p">[</span><span class="o">~</span><span class="n">padding</span><span class="p">])</span>
    <span class="k">return</span> <span class="n">gen_loss</span> <span class="o">+</span> <span class="mi">50</span> <span class="o">*</span> <span class="n">disc_loss</span>


<span class="k">def</span> <span class="nf">pretrain</span><span class="p">(</span><span class="n">task</span><span class="p">,</span> <span class="n">minutes</span><span class="p">):</span>
    <span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
    <span class="n">encoder</span> <span class="o">=</span> <span class="nc">Encoder</span><span class="p">(</span><span class="n">TINY</span><span class="p">)</span>
    <span class="k">if</span> <span class="n">task</span> <span class="o">==</span> <span class="sh">"</span><span class="s">mlm</span><span class="sh">"</span><span class="p">:</span>
        <span class="n">models</span> <span class="o">=</span> <span class="p">[</span><span class="n">encoder</span><span class="p">,</span> <span class="nc">WordHead</span><span class="p">(</span><span class="mi">256</span><span class="p">,</span> <span class="n">encoder</span><span class="p">.</span><span class="n">embeddings</span><span class="p">.</span><span class="n">words</span><span class="p">)]</span>
    <span class="k">else</span><span class="p">:</span>
        <span class="n">generator_config</span> <span class="o">=</span> <span class="nf">dict</span><span class="p">(</span><span class="n">TINY</span><span class="p">,</span> <span class="n">num_hidden_layers</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">gen</span> <span class="o">=</span> <span class="nc">Encoder</span><span class="p">(</span><span class="n">generator_config</span><span class="p">)</span>
        <span class="n">gen</span><span class="p">.</span><span class="n">embeddings</span><span class="p">.</span><span class="n">words</span> <span class="o">=</span> <span class="n">encoder</span><span class="p">.</span><span class="n">embeddings</span><span class="p">.</span><span class="n">words</span>  <span class="c1"># shared word embeddings
</span>        <span class="n">models</span> <span class="o">=</span> <span class="p">[</span><span class="n">encoder</span><span class="p">,</span> <span class="nc">ReplacedHead</span><span class="p">(</span><span class="mi">256</span><span class="p">),</span> <span class="n">gen</span><span class="p">,</span> <span class="nc">WordHead</span><span class="p">(</span><span class="mi">256</span><span class="p">,</span> <span class="n">encoder</span><span class="p">.</span><span class="n">embeddings</span><span class="p">.</span><span class="n">words</span><span class="p">)]</span>
    <span class="k">for</span> <span class="n">model</span> <span class="ow">in</span> <span class="n">models</span><span class="p">:</span>
        <span class="n">model</span><span class="p">.</span><span class="nf">apply</span><span class="p">(</span><span class="n">init_like_bert</span><span class="p">)</span>
    <span class="n">models</span> <span class="o">=</span> <span class="p">[</span><span class="n">m</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">train</span><span class="p">()</span> <span class="k">for</span> <span class="n">m</span> <span class="ow">in</span> <span class="n">models</span><span class="p">]</span>
    <span class="n">params</span> <span class="o">=</span> <span class="p">{</span><span class="nf">id</span><span class="p">(</span><span class="n">p</span><span class="p">):</span> <span class="n">p</span> <span class="k">for</span> <span class="n">m</span> <span class="ow">in</span> <span class="n">models</span> <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">m</span><span class="p">.</span><span class="nf">parameters</span><span class="p">()}.</span><span class="nf">values</span><span class="p">()</span>
    <span class="n">optimizer</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">optim</span><span class="p">.</span><span class="nc">AdamW</span><span class="p">(</span><span class="n">params</span><span class="p">,</span> <span class="n">lr</span><span class="o">=</span><span class="mf">5e-4</span><span class="p">,</span> <span class="n">weight_decay</span><span class="o">=</span><span class="mf">0.01</span><span class="p">)</span>
    <span class="n">step_fn</span> <span class="o">=</span> <span class="n">mlm_step</span> <span class="k">if</span> <span class="n">task</span> <span class="o">==</span> <span class="sh">"</span><span class="s">mlm</span><span class="sh">"</span> <span class="k">else</span> <span class="n">electra_step</span>
    <span class="n">generator</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nc">Generator</span><span class="p">().</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
    <span class="n">scaler</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">amp</span><span class="p">.</span><span class="nc">GradScaler</span><span class="p">(</span><span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">)</span>  <span class="c1"># float16 gradients in range
</span>    <span class="n">steps</span><span class="p">,</span> <span class="n">start</span> <span class="o">=</span> <span class="mi">0</span><span class="p">,</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
    <span class="k">while</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span> <span class="o">&lt;</span> <span class="n">minutes</span> <span class="o">*</span> <span class="mi">60</span><span class="p">:</span>
        <span class="k">for</span> <span class="n">group</span> <span class="ow">in</span> <span class="n">optimizer</span><span class="p">.</span><span class="n">param_groups</span><span class="p">:</span>
            <span class="n">group</span><span class="p">[</span><span class="sh">"</span><span class="s">lr</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="mf">5e-4</span> <span class="o">*</span> <span class="nf">min</span><span class="p">(</span><span class="mf">1.0</span><span class="p">,</span> <span class="p">(</span><span class="n">steps</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="mi">500</span><span class="p">)</span>  <span class="c1"># warm-up, then constant
</span>        <span class="n">batch</span> <span class="o">=</span> <span class="n">corpus</span><span class="p">[</span><span class="n">torch</span><span class="p">.</span><span class="nf">randint</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">corpus</span><span class="p">),</span> <span class="p">(</span><span class="mi">128</span><span class="p">,),</span> <span class="n">generator</span><span class="o">=</span><span class="n">generator</span><span class="p">)]</span>
        <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">autocast</span><span class="p">(</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float16</span><span class="p">,</span> <span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">):</span>
            <span class="n">loss</span> <span class="o">=</span> <span class="nf">step_fn</span><span class="p">(</span><span class="n">models</span><span class="p">,</span> <span class="n">batch</span><span class="p">,</span> <span class="n">generator</span><span class="p">)</span>
        <span class="n">optimizer</span><span class="p">.</span><span class="nf">zero_grad</span><span class="p">(</span><span class="n">set_to_none</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
        <span class="n">scaler</span><span class="p">.</span><span class="nf">scale</span><span class="p">(</span><span class="n">loss</span><span class="p">).</span><span class="nf">backward</span><span class="p">()</span>
        <span class="n">scaler</span><span class="p">.</span><span class="nf">unscale_</span><span class="p">(</span><span class="n">optimizer</span><span class="p">)</span>
        <span class="n">nn</span><span class="p">.</span><span class="n">utils</span><span class="p">.</span><span class="nf">clip_grad_norm_</span><span class="p">(</span><span class="n">params</span><span class="p">,</span> <span class="mf">1.0</span><span class="p">)</span>
        <span class="n">scaler</span><span class="p">.</span><span class="nf">step</span><span class="p">(</span><span class="n">optimizer</span><span class="p">)</span>
        <span class="n">scaler</span><span class="p">.</span><span class="nf">update</span><span class="p">()</span>
        <span class="n">steps</span> <span class="o">+=</span> <span class="mi">1</span>
    <span class="k">return</span> <span class="n">encoder</span><span class="p">.</span><span class="nf">eval</span><span class="p">(),</span> <span class="n">steps</span>


<span class="n">MINUTES</span> <span class="o">=</span> <span class="mf">0.3</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">8</span>
<span class="n">mlm_encoder</span><span class="p">,</span> <span class="n">mlm_steps</span> <span class="o">=</span> <span class="nf">pretrain</span><span class="p">(</span><span class="sh">"</span><span class="s">mlm</span><span class="sh">"</span><span class="p">,</span> <span class="n">MINUTES</span><span class="p">)</span>
<span class="n">electra_encoder</span><span class="p">,</span> <span class="n">electra_steps</span> <span class="o">=</span> <span class="nf">pretrain</span><span class="p">(</span><span class="sh">"</span><span class="s">electra</span><span class="sh">"</span><span class="p">,</span> <span class="n">MINUTES</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">MINUTES</span><span class="si">}</span><span class="s"> minutes each: masked LM made </span><span class="si">{</span><span class="n">mlm_steps</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> steps, </span><span class="sh">"</span>
      <span class="sa">f</span><span class="sh">"</span><span class="s">ELECTRA </span><span class="si">{</span><span class="n">electra_steps</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>8 minutes each: masked LM made 2,661 steps, ELECTRA 2,143</code></pre> <p>ELECTRA’s step is more expensive, since it runs two encoders, so in the same minutes it makes fewer steps. What each pre-trained encoder learned shows in two ways.</p> <p>First, without any training of the encoder: its vectors for whole issues, frozen, and a linear classifier on top that tells bugs from feature requests, questions and documentation.</p> <p>Second, the way encoders are used in practice: fine-tuned, with only a hundred labelled issues of each kind, since pre-training matters most when labels are scarce. A third encoder starts from random weights. All the labelled issues come from the training projects, and the test issues from the five unseen ones.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">balanced</span><span class="p">(</span><span class="n">frame</span><span class="p">,</span> <span class="n">per_kind</span><span class="p">,</span> <span class="n">seed</span><span class="p">):</span>
    <span class="n">parts</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">kind</span> <span class="ow">in</span> <span class="n">KINDS</span><span class="p">:</span>
        <span class="n">rows</span> <span class="o">=</span> <span class="n">frame</span><span class="p">[</span><span class="n">frame</span><span class="p">[</span><span class="sh">"</span><span class="s">kind</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="n">kind</span><span class="p">]</span>
        <span class="n">parts</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">rows</span><span class="p">.</span><span class="nf">sample</span><span class="p">(</span><span class="n">n</span><span class="o">=</span><span class="nf">min</span><span class="p">(</span><span class="n">per_kind</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">rows</span><span class="p">)),</span> <span class="n">random_state</span><span class="o">=</span><span class="n">seed</span><span class="p">))</span>
    <span class="k">return</span> <span class="n">pd</span><span class="p">.</span><span class="nf">concat</span><span class="p">(</span><span class="n">parts</span><span class="p">).</span><span class="nf">sample</span><span class="p">(</span><span class="n">frac</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">random_state</span><span class="o">=</span><span class="n">seed</span><span class="p">).</span><span class="nf">reset_index</span><span class="p">(</span><span class="n">drop</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>


<span class="n">seen</span> <span class="o">=</span> <span class="n">issues</span><span class="p">[</span><span class="n">issues</span><span class="p">[</span><span class="sh">"</span><span class="s">repo</span><span class="sh">"</span><span class="p">].</span><span class="nf">isin</span><span class="p">(</span><span class="n">TRAIN_REPOS</span><span class="p">)]</span>
<span class="n">unseen</span> <span class="o">=</span> <span class="n">issues</span><span class="p">[</span><span class="n">issues</span><span class="p">[</span><span class="sh">"</span><span class="s">repo</span><span class="sh">"</span><span class="p">].</span><span class="nf">isin</span><span class="p">(</span><span class="n">TEST_REPOS</span><span class="p">)]</span>
<span class="n">probe_train</span> <span class="o">=</span> <span class="nf">balanced</span><span class="p">(</span><span class="n">seen</span><span class="p">,</span> <span class="mi">16</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">1000</span><span class="p">,</span> <span class="n">SEED</span><span class="p">)</span>
<span class="n">few_train</span> <span class="o">=</span> <span class="nf">balanced</span><span class="p">(</span><span class="n">seen</span><span class="p">,</span> <span class="mi">8</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">100</span><span class="p">,</span> <span class="n">SEED</span> <span class="o">+</span> <span class="mi">2</span><span class="p">)</span>
<span class="n">small_test</span> <span class="o">=</span> <span class="nf">balanced</span><span class="p">(</span><span class="n">unseen</span><span class="p">,</span> <span class="mi">8</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">300</span><span class="p">,</span> <span class="n">SEED</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">probe_train</span><span class="p">)</span><span class="si">}</span><span class="s"> issues for the probe, </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">few_train</span><span class="p">)</span><span class="si">}</span><span class="s"> for fine-tuning, </span><span class="sh">"</span>
      <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">small_test</span><span class="p">)</span><span class="si">}</span><span class="s"> test issues from unseen projects</span><span class="sh">"</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">macro_f1</span><span class="p">(</span><span class="n">truth</span><span class="p">,</span> <span class="n">predicted</span><span class="p">):</span>  <span class="c1"># F1 of each kind, averaged: every kind counts the same
</span>    <span class="n">truth</span><span class="p">,</span> <span class="n">predicted</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">asarray</span><span class="p">(</span><span class="n">truth</span><span class="p">),</span> <span class="n">np</span><span class="p">.</span><span class="nf">asarray</span><span class="p">(</span><span class="n">predicted</span><span class="p">)</span>
    <span class="n">scores</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">c</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">KINDS</span><span class="p">)):</span>
        <span class="n">hits</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">sum</span><span class="p">((</span><span class="n">predicted</span> <span class="o">==</span> <span class="n">c</span><span class="p">)</span> <span class="o">&amp;</span> <span class="p">(</span><span class="n">truth</span> <span class="o">==</span> <span class="n">c</span><span class="p">))</span>
        <span class="n">precision</span> <span class="o">=</span> <span class="n">hits</span> <span class="o">/</span> <span class="nf">max</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">np</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="n">predicted</span> <span class="o">==</span> <span class="n">c</span><span class="p">))</span>
        <span class="n">recall</span> <span class="o">=</span> <span class="n">hits</span> <span class="o">/</span> <span class="nf">max</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">np</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="n">truth</span> <span class="o">==</span> <span class="n">c</span><span class="p">))</span>
        <span class="n">scores</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="mf">0.0</span> <span class="k">if</span> <span class="n">hits</span> <span class="o">==</span> <span class="mi">0</span> <span class="k">else</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">precision</span> <span class="o">*</span> <span class="n">recall</span> <span class="o">/</span> <span class="p">(</span><span class="n">precision</span> <span class="o">+</span> <span class="n">recall</span><span class="p">))</span>
    <span class="k">return</span> <span class="nf">float</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">mean</span><span class="p">(</span><span class="n">scores</span><span class="p">))</span>


<span class="k">def</span> <span class="nf">confusion</span><span class="p">(</span><span class="n">truth</span><span class="p">,</span> <span class="n">predicted</span><span class="p">):</span>  <span class="c1"># rows: the actual kind, columns: what the model said
</span>    <span class="n">counts</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">zeros</span><span class="p">((</span><span class="nf">len</span><span class="p">(</span><span class="n">KINDS</span><span class="p">),</span> <span class="nf">len</span><span class="p">(</span><span class="n">KINDS</span><span class="p">)))</span>
    <span class="k">for</span> <span class="n">t</span><span class="p">,</span> <span class="n">p</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">truth</span><span class="p">,</span> <span class="n">predicted</span><span class="p">,</span> <span class="n">strict</span><span class="o">=</span><span class="bp">True</span><span class="p">):</span>
        <span class="n">counts</span><span class="p">[</span><span class="n">t</span><span class="p">,</span> <span class="n">p</span><span class="p">]</span> <span class="o">+=</span> <span class="mi">1</span>
    <span class="k">return</span> <span class="n">counts</span> <span class="o">/</span> <span class="n">np</span><span class="p">.</span><span class="nf">maximum</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">counts</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdims</span><span class="o">=</span><span class="bp">True</span><span class="p">))</span>


<span class="k">def</span> <span class="nf">batches</span><span class="p">(</span><span class="n">frame</span><span class="p">,</span> <span class="n">size</span><span class="p">,</span> <span class="n">shuffle</span><span class="p">):</span>
    <span class="n">order</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="nf">permutation</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">frame</span><span class="p">))</span> <span class="k">if</span> <span class="n">shuffle</span> <span class="k">else</span> <span class="n">np</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">frame</span><span class="p">))</span>
    <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">frame</span><span class="p">),</span> <span class="n">size</span><span class="p">):</span>
        <span class="n">rows</span> <span class="o">=</span> <span class="n">frame</span><span class="p">.</span><span class="n">iloc</span><span class="p">[</span><span class="n">order</span><span class="p">[</span><span class="n">k</span><span class="p">:</span><span class="n">k</span> <span class="o">+</span> <span class="n">size</span><span class="p">]]</span>
        <span class="n">enc</span> <span class="o">=</span> <span class="nf">bert_tokenizer</span><span class="p">(</span><span class="nf">list</span><span class="p">(</span><span class="n">rows</span><span class="p">[</span><span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">]),</span> <span class="n">truncation</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">max_length</span><span class="o">=</span><span class="mi">128</span><span class="p">,</span>
                             <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">)</span>
        <span class="n">labels</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">([</span><span class="n">KINDS</span><span class="p">.</span><span class="nf">index</span><span class="p">(</span><span class="n">x</span><span class="p">)</span> <span class="k">for</span> <span class="n">x</span> <span class="ow">in</span> <span class="n">rows</span><span class="p">[</span><span class="sh">"</span><span class="s">kind</span><span class="sh">"</span><span class="p">]])</span>
        <span class="k">yield</span> <span class="n">enc</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">].</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">),</span> <span class="n">labels</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">pooled</span><span class="p">(</span><span class="n">encoder</span><span class="p">,</span> <span class="n">ids</span><span class="p">):</span>  <span class="c1"># the mean of the last layer over real tokens
</span>    <span class="n">real</span> <span class="o">=</span> <span class="p">(</span><span class="n">ids</span> <span class="o">!=</span> <span class="mi">0</span><span class="p">).</span><span class="nf">unsqueeze</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">).</span><span class="nf">float</span><span class="p">()</span>
    <span class="nf">return </span><span class="p">(</span><span class="nf">encoder</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">ids</span> <span class="o">==</span> <span class="mi">0</span><span class="p">)</span> <span class="o">*</span> <span class="n">real</span><span class="p">).</span><span class="nf">sum</span><span class="p">(</span><span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">real</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="mi">1</span><span class="p">)</span>


<span class="nd">@torch.no_grad</span><span class="p">()</span>
<span class="k">def</span> <span class="nf">frozen_features</span><span class="p">(</span><span class="n">encoder</span><span class="p">,</span> <span class="n">frame</span><span class="p">):</span>
    <span class="n">encoder</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>
    <span class="n">xs</span><span class="p">,</span> <span class="n">ys</span> <span class="o">=</span> <span class="p">[],</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">ids</span><span class="p">,</span> <span class="n">labels</span> <span class="ow">in</span> <span class="nf">batches</span><span class="p">(</span><span class="n">frame</span><span class="p">,</span> <span class="mi">64</span><span class="p">,</span> <span class="n">shuffle</span><span class="o">=</span><span class="bp">False</span><span class="p">):</span>
        <span class="n">xs</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="nf">pooled</span><span class="p">(</span><span class="n">encoder</span><span class="p">,</span> <span class="n">ids</span><span class="p">))</span>
        <span class="n">ys</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">labels</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">(</span><span class="n">xs</span><span class="p">),</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">(</span><span class="n">ys</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">probe_f1</span><span class="p">(</span><span class="n">encoder</span><span class="p">):</span>
    <span class="n">x</span><span class="p">,</span> <span class="n">y</span> <span class="o">=</span> <span class="nf">frozen_features</span><span class="p">(</span><span class="n">encoder</span><span class="p">,</span> <span class="n">probe_train</span><span class="p">)</span>
    <span class="n">x_test</span><span class="p">,</span> <span class="n">y_test</span> <span class="o">=</span> <span class="nf">frozen_features</span><span class="p">(</span><span class="n">encoder</span><span class="p">,</span> <span class="n">small_test</span><span class="p">)</span>
    <span class="n">mean</span><span class="p">,</span> <span class="n">std</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="nf">mean</span><span class="p">(</span><span class="mi">0</span><span class="p">),</span> <span class="n">x</span><span class="p">.</span><span class="nf">std</span><span class="p">(</span><span class="mi">0</span><span class="p">)</span> <span class="o">+</span> <span class="mf">1e-6</span>
    <span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
    <span class="n">linear</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="nf">len</span><span class="p">(</span><span class="n">KINDS</span><span class="p">)).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="n">optimizer</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">optim</span><span class="p">.</span><span class="nc">Adam</span><span class="p">(</span><span class="n">linear</span><span class="p">.</span><span class="nf">parameters</span><span class="p">(),</span> <span class="n">lr</span><span class="o">=</span><span class="mf">1e-2</span><span class="p">,</span> <span class="n">weight_decay</span><span class="o">=</span><span class="mf">1e-4</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">300</span><span class="p">):</span>  <span class="c1"># the whole set at once: it is small
</span>        <span class="n">loss</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span><span class="nf">linear</span><span class="p">((</span><span class="n">x</span> <span class="o">-</span> <span class="n">mean</span><span class="p">)</span> <span class="o">/</span> <span class="n">std</span><span class="p">),</span> <span class="n">y</span><span class="p">)</span>
        <span class="n">optimizer</span><span class="p">.</span><span class="nf">zero_grad</span><span class="p">()</span>
        <span class="n">loss</span><span class="p">.</span><span class="nf">backward</span><span class="p">()</span>
        <span class="n">optimizer</span><span class="p">.</span><span class="nf">step</span><span class="p">()</span>
    <span class="n">predicted</span> <span class="o">=</span> <span class="nf">linear</span><span class="p">((</span><span class="n">x_test</span> <span class="o">-</span> <span class="n">mean</span><span class="p">)</span> <span class="o">/</span> <span class="n">std</span><span class="p">).</span><span class="nf">argmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
    <span class="k">return</span> <span class="nf">macro_f1</span><span class="p">(</span><span class="n">y_test</span><span class="p">.</span><span class="nf">tolist</span><span class="p">(),</span> <span class="n">predicted</span><span class="p">.</span><span class="nf">tolist</span><span class="p">())</span>


<span class="k">def</span> <span class="nf">fine_tuned_f1</span><span class="p">(</span><span class="n">encoder</span><span class="p">,</span> <span class="n">epochs</span><span class="o">=</span><span class="mi">8</span><span class="p">):</span>
    <span class="n">encoder</span> <span class="o">=</span> <span class="n">encoder</span><span class="p">.</span><span class="nf">train</span><span class="p">()</span>
    <span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
    <span class="n">head</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="mi">256</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">KINDS</span><span class="p">)).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="n">params</span> <span class="o">=</span> <span class="nf">list</span><span class="p">(</span><span class="n">encoder</span><span class="p">.</span><span class="nf">parameters</span><span class="p">())</span> <span class="o">+</span> <span class="nf">list</span><span class="p">(</span><span class="n">head</span><span class="p">.</span><span class="nf">parameters</span><span class="p">())</span>
    <span class="n">optimizer</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">optim</span><span class="p">.</span><span class="nc">AdamW</span><span class="p">(</span><span class="n">params</span><span class="p">,</span> <span class="n">lr</span><span class="o">=</span><span class="mf">1e-4</span><span class="p">,</span> <span class="n">weight_decay</span><span class="o">=</span><span class="mf">0.01</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">epochs</span><span class="p">):</span>
        <span class="k">for</span> <span class="n">ids</span><span class="p">,</span> <span class="n">labels</span> <span class="ow">in</span> <span class="nf">batches</span><span class="p">(</span><span class="n">few_train</span><span class="p">,</span> <span class="mi">32</span><span class="p">,</span> <span class="n">shuffle</span><span class="o">=</span><span class="bp">True</span><span class="p">):</span>
            <span class="n">loss</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span><span class="nf">head</span><span class="p">(</span><span class="nf">pooled</span><span class="p">(</span><span class="n">encoder</span><span class="p">,</span> <span class="n">ids</span><span class="p">)),</span> <span class="n">labels</span><span class="p">)</span>
            <span class="n">optimizer</span><span class="p">.</span><span class="nf">zero_grad</span><span class="p">()</span>
            <span class="n">loss</span><span class="p">.</span><span class="nf">backward</span><span class="p">()</span>
            <span class="n">optimizer</span><span class="p">.</span><span class="nf">step</span><span class="p">()</span>
    <span class="n">encoder</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>
    <span class="n">predicted</span><span class="p">,</span> <span class="n">truth</span> <span class="o">=</span> <span class="p">[],</span> <span class="p">[]</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="k">for</span> <span class="n">ids</span><span class="p">,</span> <span class="n">labels</span> <span class="ow">in</span> <span class="nf">batches</span><span class="p">(</span><span class="n">small_test</span><span class="p">,</span> <span class="mi">64</span><span class="p">,</span> <span class="n">shuffle</span><span class="o">=</span><span class="bp">False</span><span class="p">):</span>
            <span class="n">predicted</span> <span class="o">+=</span> <span class="nf">head</span><span class="p">(</span><span class="nf">pooled</span><span class="p">(</span><span class="n">encoder</span><span class="p">,</span> <span class="n">ids</span><span class="p">)).</span><span class="nf">argmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">).</span><span class="nf">tolist</span><span class="p">()</span>
            <span class="n">truth</span> <span class="o">+=</span> <span class="n">labels</span><span class="p">.</span><span class="nf">tolist</span><span class="p">()</span>
    <span class="k">return</span> <span class="nf">macro_f1</span><span class="p">(</span><span class="n">truth</span><span class="p">,</span> <span class="n">predicted</span><span class="p">)</span>


<span class="n">untrained</span> <span class="o">=</span> <span class="nc">Encoder</span><span class="p">(</span><span class="n">TINY</span><span class="p">)</span>
<span class="n">untrained</span><span class="p">.</span><span class="nf">apply</span><span class="p">(</span><span class="n">init_like_bert</span><span class="p">)</span>
<span class="n">untrained</span> <span class="o">=</span> <span class="n">untrained</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="n">race</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">steps</span><span class="p">,</span> <span class="n">encoder</span> <span class="ow">in</span> <span class="p">[(</span><span class="sh">"</span><span class="s">none, random weights</span><span class="sh">"</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="n">untrained</span><span class="p">),</span>
                             <span class="p">(</span><span class="sh">"</span><span class="s">masked LM</span><span class="sh">"</span><span class="p">,</span> <span class="n">mlm_steps</span><span class="p">,</span> <span class="n">mlm_encoder</span><span class="p">),</span>
                             <span class="p">(</span><span class="sh">"</span><span class="s">ELECTRA</span><span class="sh">"</span><span class="p">,</span> <span class="n">electra_steps</span><span class="p">,</span> <span class="n">electra_encoder</span><span class="p">)]:</span>
    <span class="n">probe</span> <span class="o">=</span> <span class="nf">probe_f1</span><span class="p">(</span><span class="n">encoder</span><span class="p">)</span>  <span class="c1"># before fine-tuning changes the weights
</span>    <span class="n">fine</span> <span class="o">=</span> <span class="nf">fine_tuned_f1</span><span class="p">(</span><span class="n">encoder</span><span class="p">)</span>
    <span class="n">race</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">pre-training</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span> <span class="sh">"</span><span class="s">steps</span><span class="sh">"</span><span class="p">:</span> <span class="n">steps</span><span class="p">,</span> <span class="sh">"</span><span class="s">frozen + linear probe</span><span class="sh">"</span><span class="p">:</span> <span class="n">probe</span><span class="p">,</span>
                 <span class="sh">"</span><span class="s">fine-tuned on 400 issues</span><span class="sh">"</span><span class="p">:</span> <span class="n">fine</span><span class="p">})</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">race</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>4000 issues for the probe, 400 for fine-tuning, 1200 test issues from unseen projects</code></pre> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">pre-training</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">steps</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">frozen + linear probe</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">fine-tuned on 400 issues</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">none, random weights</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.47</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.30</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">masked LM</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,661</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.45</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.49</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">ELECTRA</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,143</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.47</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.32</td></tr></tbody></table></div> <p>The probe column first. Averaged vectors of an untrained encoder are a bag of random word vectors, and a linear classifier on top already does far better than chance: which words an issue contains says a lot about its kind. Eight minutes of pre-training didn’t make either encoder’s frozen vectors better than that.</p> <p>Fine-tuning on few labels is where pre-training shows. The masked language model starts far ahead of random weights, the effect of lesson 1 at a tiny scale. ELECTRA, in our race, did not: its discriminator fine-tuned no better than random weights.</p> <p>The paper’s smallest ELECTRA trained for four days on a GPU, some seven hundred times our budget, with a generator narrower than its discriminator, while ours is one layer of the same width; its advantage is measured there.</p> <div class="callout callout-key"> <p class="callout-label">Key point</p> <p>A race this short says what happens in the first eight minutes, and in them the simpler task won. It is RoBERTa’s lesson again: an idea is only as good as the recipe it is trained with, and ours is a sketch.</p> </div> <h2 id="3-deberta-positions-as-vectors-of-their-own">3. DeBERTa: positions as vectors of their own</h2> <p>BERT adds a position vector to each word vector at the input, and from then on a token is one vector that mixes what the word is with where it stands.</p> <p>DeBERTa, from Microsoft, keeps them apart <sup class="cite">[<a href="#ref-4" id="cite-4" data-ref="4" aria-label="Reference 4: He, P., Liu, X., Gao, J., &amp; Chen, W. (2020). DeBERTa: decoding-enhanced BERT with disentangled attention. ICLR 2021.">4</a>]</sup>. Positions are relative, the distance from one token to another, and each layer’s attention score between tokens \(i\) and \(j\) is the sum of three terms:</p> \[A_{ij} = \underbrace{q_i^{c} \cdot k_j^{c}}_{\text{content to content}} + \underbrace{q_i^{c} \cdot k_{\delta(i,j)}^{r}}_{\text{content to position}} + \underbrace{k_j^{c} \cdot q_{\delta(j,i)}^{r}}_{\text{position to content}}, \qquad \text{scaled by } \frac{1}{\sqrt{3d}} .\] <p>Here \(q^c, k^c\) are the usual queries and keys of the tokens, and \(q^r, k^r\) are queries and keys computed, with the same projection matrices, from a table of relative-position embeddings; \(\delta(i, j)\) is the distance from \(i\) to \(j\), put into a bucket. The second term asks “what does this word look for at that distance”, the third “what does that word look for at this distance”. The scale has 3 instead of 1 because three terms are summed.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/02/deberta-light.png" width="760" alt="DeBERTa's attention score between two tokens as the sum of three terms: content to content, as in BERT; content to position, the query of the first token against the embedding of their relative distance; and position to content, the key of the second token against the distance seen from the other side" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/02/deberta-dark.png" width="760" alt="DeBERTa's attention score between two tokens as the sum of three terms: content to content, as in BERT; content to position, the query of the first token against the embedding of their relative distance; and position to content, the key of the second token against the distance seen from the other side" loading="lazy"></p> <p>It worked: at the end of 2020 a 1.5-billion-parameter DeBERTa became the first model to score above the human baseline on SuperGLUE, a benchmark built to be hard for models, 89.9 against 89.8. Microsoft’s own announcement added that the model “is by no means reaching the human-level intelligence of NLU” <sup class="cite">[<a href="#ref-5" id="cite-5" data-ref="5" aria-label="Reference 5: Microsoft Research, 2021. microsoft.com.">5</a>]</sup>.</p> <p>DeBERTa-v3 sorts distances into 256 buckets: exact up to 128 tokens in either direction, and logarithmically coarser beyond, so a model trained on 512-token inputs can still tell near from far in longer ones:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">log_buckets</span><span class="p">(</span><span class="n">relative</span><span class="p">,</span> <span class="n">buckets</span><span class="o">=</span><span class="mi">256</span><span class="p">,</span> <span class="n">max_position</span><span class="o">=</span><span class="mi">512</span><span class="p">):</span>
    <span class="n">mid</span> <span class="o">=</span> <span class="n">buckets</span> <span class="o">//</span> <span class="mi">2</span>
    <span class="n">sign</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">sign</span><span class="p">(</span><span class="n">relative</span><span class="p">)</span>
    <span class="n">near</span> <span class="o">=</span> <span class="p">(</span><span class="n">relative</span> <span class="o">&lt;</span> <span class="n">mid</span><span class="p">)</span> <span class="o">&amp;</span> <span class="p">(</span><span class="n">relative</span> <span class="o">&gt;</span> <span class="o">-</span><span class="n">mid</span><span class="p">)</span>
    <span class="n">size</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">where</span><span class="p">(</span><span class="n">near</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">mid</span> <span class="o">-</span> <span class="mi">1</span><span class="p">),</span> <span class="n">relative</span><span class="p">.</span><span class="nf">abs</span><span class="p">())</span>
    <span class="n">scale</span> <span class="o">=</span> <span class="n">math</span><span class="p">.</span><span class="nf">log</span><span class="p">((</span><span class="n">max_position</span> <span class="o">-</span> <span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">mid</span><span class="p">)</span>
    <span class="n">far</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ceil</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">log</span><span class="p">(</span><span class="n">size</span> <span class="o">/</span> <span class="n">mid</span><span class="p">)</span> <span class="o">/</span> <span class="n">scale</span> <span class="o">*</span> <span class="p">(</span><span class="n">mid</span> <span class="o">-</span> <span class="mi">1</span><span class="p">))</span> <span class="o">+</span> <span class="n">mid</span>
    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">where</span><span class="p">(</span><span class="n">size</span> <span class="o">&lt;=</span> <span class="n">mid</span><span class="p">,</span> <span class="n">relative</span><span class="p">,</span> <span class="p">(</span><span class="n">far</span> <span class="o">*</span> <span class="n">sign</span><span class="p">).</span><span class="nf">long</span><span class="p">())</span>


<span class="n">distance</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="o">-</span><span class="mi">700</span><span class="p">,</span> <span class="mi">701</span><span class="p">)</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.4</span><span class="p">,</span> <span class="mf">3.4</span><span class="p">))</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">distance</span><span class="p">,</span> <span class="nf">log_buckets</span><span class="p">(</span><span class="n">distance</span><span class="p">),</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">DeBERTa-v3</span><span class="sh">'</span><span class="s">s bucket for each relative distance</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">distance from the query to the key, tokens</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">bucket</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/02/output-02.png" alt="DeBERTa-v3" loading="lazy"></p> <p>The rest of a DeBERTa-v3 layer is BERT’s: post-norm, GELU. One more detail of v3: there are no absolute positions anywhere, not even at the input.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">DebertaLayer</span><span class="p">(</span><span class="n">Layer</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">padding</span><span class="p">,</span> <span class="n">rel</span><span class="p">,</span> <span class="n">relative</span><span class="p">,</span> <span class="n">span</span><span class="o">=</span><span class="mi">256</span><span class="p">):</span>
        <span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">q</span><span class="p">(</span><span class="n">x</span><span class="p">)),</span> <span class="n">self</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">k</span><span class="p">(</span><span class="n">x</span><span class="p">)),</span> <span class="n">self</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">v</span><span class="p">(</span><span class="n">x</span><span class="p">))</span>
        <span class="n">pq</span><span class="p">,</span> <span class="n">pk</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">q</span><span class="p">(</span><span class="n">rel</span><span class="p">)),</span> <span class="n">self</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">k</span><span class="p">(</span><span class="n">rel</span><span class="p">))</span>  <span class="c1"># same projections
</span>        <span class="n">n</span><span class="p">,</span> <span class="n">heads</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span>
        <span class="n">shape</span> <span class="o">=</span> <span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="n">heads</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">n</span><span class="p">)</span>
        <span class="n">c2p_index</span> <span class="o">=</span> <span class="p">(</span><span class="n">relative</span> <span class="o">+</span> <span class="n">span</span><span class="p">).</span><span class="nf">clamp</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">span</span> <span class="o">-</span> <span class="mi">1</span><span class="p">).</span><span class="nf">expand</span><span class="p">(</span><span class="n">shape</span><span class="p">)</span>
        <span class="n">p2c_index</span> <span class="o">=</span> <span class="p">(</span><span class="o">-</span><span class="n">relative</span> <span class="o">+</span> <span class="n">span</span><span class="p">).</span><span class="nf">clamp</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">span</span> <span class="o">-</span> <span class="mi">1</span><span class="p">).</span><span class="nf">expand</span><span class="p">(</span><span class="n">shape</span><span class="p">)</span>
        <span class="n">content</span> <span class="o">=</span> <span class="n">q</span> <span class="o">@</span> <span class="n">k</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">2</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">c2p</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">gather</span><span class="p">(</span><span class="n">q</span> <span class="o">@</span> <span class="n">pk</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">2</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">),</span> <span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="n">c2p_index</span><span class="p">)</span>
        <span class="n">p2c</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">gather</span><span class="p">(</span><span class="n">k</span> <span class="o">@</span> <span class="n">pq</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">2</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">),</span> <span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="n">p2c_index</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">2</span><span class="p">)</span>
        <span class="n">scores</span> <span class="o">=</span> <span class="p">(</span><span class="n">content</span> <span class="o">+</span> <span class="n">c2p</span> <span class="o">+</span> <span class="n">p2c</span><span class="p">)</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="mi">3</span> <span class="o">*</span> <span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">])</span>
        <span class="n">lowest</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">finfo</span><span class="p">(</span><span class="n">scores</span><span class="p">.</span><span class="n">dtype</span><span class="p">).</span><span class="nb">min</span>
        <span class="n">scores</span> <span class="o">=</span> <span class="n">scores</span><span class="p">.</span><span class="nf">masked_fill</span><span class="p">(</span><span class="n">padding</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:],</span> <span class="n">lowest</span><span class="p">)</span>
        <span class="n">y</span> <span class="o">=</span> <span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">dropout</span><span class="p">(</span><span class="n">scores</span><span class="p">.</span><span class="nf">softmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">))</span> <span class="o">@</span> <span class="n">v</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">)</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm1</span><span class="p">(</span><span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">dropout</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">out</span><span class="p">(</span><span class="n">y</span><span class="p">)))</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm2</span><span class="p">(</span><span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">dropout</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">down</span><span class="p">(</span><span class="n">F</span><span class="p">.</span><span class="nf">gelu</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">up</span><span class="p">(</span><span class="n">x</span><span class="p">)))))</span>


<span class="k">class</span> <span class="nc">Deberta</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span><span class="p">,</span> <span class="n">eps</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">layer_norm_eps</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">span</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">position_buckets</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">words</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">eps</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">distances</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="mi">2</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">span</span><span class="p">,</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">distance_norm</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">eps</span><span class="p">)</span>
        <span class="n">n_layers</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">layers</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">ModuleList</span><span class="p">(</span><span class="nc">DebertaLayer</span><span class="p">(</span><span class="n">config</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n_layers</span><span class="p">))</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">padding</span><span class="p">):</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">words</span><span class="p">(</span><span class="n">ids</span><span class="p">))</span> <span class="o">*</span> <span class="p">(</span><span class="o">~</span><span class="n">padding</span><span class="p">)[...,</span> <span class="bp">None</span><span class="p">]</span>
        <span class="n">positions</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="n">device</span><span class="o">=</span><span class="n">ids</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
        <span class="n">relative</span> <span class="o">=</span> <span class="nf">log_buckets</span><span class="p">(</span><span class="n">positions</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">-</span> <span class="n">positions</span><span class="p">[</span><span class="bp">None</span><span class="p">,</span> <span class="p">:],</span> <span class="n">self</span><span class="p">.</span><span class="n">span</span><span class="p">)</span>
        <span class="n">rel</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">distance_norm</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">distances</span><span class="p">.</span><span class="n">weight</span><span class="p">)[</span><span class="bp">None</span><span class="p">]</span>
        <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">self</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
            <span class="n">x</span> <span class="o">=</span> <span class="nf">layer</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">padding</span><span class="p">,</span> <span class="n">rel</span><span class="p">,</span> <span class="n">relative</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">span</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">x</span>
</code></pre></div></div> <p>Microsoft published DeBERTa-v3’s weights as a PyTorch pickle rather than safetensors; <code class="language-plaintext highlighter-rouge">weights_only=True</code> loads the tensors and refuses anything else a pickle could carry.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">DEBERTA</span> <span class="o">=</span> <span class="sh">"</span><span class="s">microsoft/deberta-v3-base</span><span class="sh">"</span>
<span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">DEBERTA</span><span class="p">,</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">))</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
    <span class="n">deberta_config</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">f</span><span class="p">)</span>
<span class="n">deberta_file</span> <span class="o">=</span> <span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">DEBERTA</span><span class="p">,</span> <span class="sh">"</span><span class="s">pytorch_model.bin</span><span class="sh">"</span><span class="p">)</span>
<span class="n">deberta_weights</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">deberta_file</span><span class="p">,</span> <span class="n">map_location</span><span class="o">=</span><span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span><span class="p">,</span> <span class="n">weights_only</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">names</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">words.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">deberta.embeddings.word_embeddings.weight</span><span class="sh">"</span><span class="p">,</span>
         <span class="sh">"</span><span class="s">norm.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">deberta.embeddings.LayerNorm.weight</span><span class="sh">"</span><span class="p">,</span>
         <span class="sh">"</span><span class="s">norm.bias</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">deberta.embeddings.LayerNorm.bias</span><span class="sh">"</span><span class="p">,</span>
         <span class="sh">"</span><span class="s">distances.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">deberta.encoder.rel_embeddings.weight</span><span class="sh">"</span><span class="p">,</span>
         <span class="sh">"</span><span class="s">distance_norm.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">deberta.encoder.LayerNorm.weight</span><span class="sh">"</span><span class="p">,</span>
         <span class="sh">"</span><span class="s">distance_norm.bias</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">deberta.encoder.LayerNorm.bias</span><span class="sh">"</span><span class="p">}</span>
<span class="n">parts</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">q</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention.self.query_proj</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">k</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention.self.key_proj</span><span class="sh">"</span><span class="p">,</span>
         <span class="sh">"</span><span class="s">v</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention.self.value_proj</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">out</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention.output.dense</span><span class="sh">"</span><span class="p">,</span>
         <span class="sh">"</span><span class="s">norm1</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention.output.LayerNorm</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">up</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">intermediate.dense</span><span class="sh">"</span><span class="p">,</span>
         <span class="sh">"</span><span class="s">down</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">output.dense</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">norm2</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">output.LayerNorm</span><span class="sh">"</span><span class="p">}</span>
<span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">deberta_config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">]):</span>
    <span class="k">for</span> <span class="n">ours</span><span class="p">,</span> <span class="n">theirs</span> <span class="ow">in</span> <span class="n">parts</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
        <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="p">(</span><span class="sh">"</span><span class="s">weight</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">bias</span><span class="sh">"</span><span class="p">):</span>
            <span class="n">names</span><span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="s">layers.</span><span class="si">{</span><span class="n">i</span><span class="si">}</span><span class="s">.</span><span class="si">{</span><span class="n">ours</span><span class="si">}</span><span class="s">.</span><span class="si">{</span><span class="n">p</span><span class="si">}</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">deberta.encoder.layer.</span><span class="si">{</span><span class="n">i</span><span class="si">}</span><span class="s">.</span><span class="si">{</span><span class="n">theirs</span><span class="si">}</span><span class="s">.</span><span class="si">{</span><span class="n">p</span><span class="si">}</span><span class="sh">"</span>
<span class="n">deberta</span> <span class="o">=</span> <span class="nc">Deberta</span><span class="p">(</span><span class="n">deberta_config</span><span class="p">)</span>
<span class="n">deberta</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">({</span><span class="n">o</span><span class="p">:</span> <span class="n">deberta_weights</span><span class="p">[</span><span class="n">t</span><span class="p">]</span> <span class="k">for</span> <span class="n">o</span><span class="p">,</span> <span class="n">t</span> <span class="ow">in</span> <span class="n">names</span><span class="p">.</span><span class="nf">items</span><span class="p">()},</span> <span class="n">strict</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">deberta</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>

<span class="n">deberta_tokenizer</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">DEBERTA</span><span class="p">)</span>
<span class="n">reference</span> <span class="o">=</span> <span class="n">DebertaV2Model</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">DEBERTA</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="n">trace</span> <span class="o">=</span> <span class="sh">"</span><span class="s">Traceback (most recent call last): File </span><span class="sh">'</span><span class="s">train.py</span><span class="sh">'</span><span class="s">, line 12 </span><span class="sh">"</span> <span class="o">*</span> <span class="mi">25</span>
<span class="n">check</span> <span class="o">=</span> <span class="nf">deberta_tokenizer</span><span class="p">([</span><span class="n">trace</span><span class="p">],</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">)</span>
<span class="k">for</span> <span class="n">dtype</span> <span class="ow">in</span> <span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="n">float32</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="n">float64</span><span class="p">):</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="n">theirs</span> <span class="o">=</span> <span class="n">reference</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">dtype</span><span class="p">)(</span><span class="o">**</span><span class="n">check</span><span class="p">).</span><span class="n">last_hidden_state</span>
        <span class="n">ours</span> <span class="o">=</span> <span class="n">deberta</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">dtype</span><span class="p">)(</span><span class="n">check</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">check</span><span class="p">[</span><span class="sh">"</span><span class="s">attention_mask</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="mi">0</span><span class="p">)</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">str</span><span class="p">(</span><span class="n">dtype</span><span class="p">)[</span><span class="mi">6</span><span class="si">:</span><span class="p">]</span><span class="si">}</span><span class="s">: largest difference </span><span class="si">{</span><span class="p">(</span><span class="n">ours</span> <span class="o">-</span> <span class="n">theirs</span><span class="p">).</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="s">, </span><span class="sh">"</span>
          <span class="sa">f</span><span class="sh">"</span><span class="s">largest activation </span><span class="si">{</span><span class="n">theirs</span><span class="p">.</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="k">del</span> <span class="n">reference</span><span class="p">,</span> <span class="n">deberta</span><span class="p">,</span> <span class="n">deberta_weights</span>
</code></pre></div></div> <pre class="tfs-printed"><code>float32: largest difference 1.7e-05, largest activation 9.5
float64: largest difference 3.1e-07, largest activation 9.5</code></pre> <p>In float32 the two implementations agree to four or five decimal places, the rounding of summing the same numbers in a different order; in float64, to seven. Our forty lines are DeBERTa’s attention.</p> <p>The explicit <code class="language-plaintext highlighter-rouge">.to(dtype)</code> in that loop is there for a reason we found the hard way while writing this lesson.</p> <div class="callout callout-warn"> <p class="callout-label">Trap</p> <p>Microsoft stored DeBERTa-v3’s weights in float16, and recent versions of <code class="language-plaintext highlighter-rouge">transformers</code> load a model in the precision of its checkpoint. Compared without the cast, the reference quietly runs in half precision, and the two models disagree in the second decimal place, which looks exactly like a bug in the attention. Running both in float64 is the quickest way to tell a bug from rounding: a bug survives it, rounding doesn’t.</p> </div> <h2 id="4-modernbert-an-encoder-rebuilt-from-llm-parts">4. ModernBERT: an encoder rebuilt from LLM parts</h2> <p>For five years after DeBERTa, decoder-only models got all the attention and nearly all the improvements. ModernBERT, from Answer.AI and LightOn, took those improvements back into an encoder <sup class="cite">[<a href="#ref-6" id="cite-6" data-ref="6" aria-label="Reference 6: Warner, B., Chaffin, A., Clavié, B., Weller, O., Hallström, O., Taghadouini, S., Gallagher, A., Biswas, R., Ladhak, F., Aarsen, T., Cooper, N., Adams, G., Howard, J., &amp; Poli, I. (2024). Smarter, better, faster, longer: a modern bidirectional encoder for fast, memory efficient, and long context finetuning and inference. arXiv:2412.13663.">6</a>]</sup>.</p> <p>Every piece of its block has appeared in this course before, mostly in <a href="/blog/2026/transformer-architectures-05-t5/">lesson 5</a> of the first one: pre-normalisation, rotary positions (RoPE) instead of learned ones, a gated feed-forward layer (GeGLU, the GELU sibling of Llama’s SwiGLU), and no bias terms except in the last layer that scores the vocabulary.</p> <p>One piece is new: most layers attend only to a window of 128 tokens around each token, and every third layer attends globally. It was trained on 2 trillion tokens of text and code, with 30% of tokens masked rather than 15%, and its authors call it “a major Pareto improvement over older encoders”: better and faster at once.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/02/modernbert-light.png" width="760" alt="ModernBERT-base's 22 layers: every third layer, starting with the first, attends globally with rotary positions of base 160,000; the others attend to a window of 128 tokens with rotary base 10,000. Each layer is pre-norm, without biases, with a GeGLU feed-forward network" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/02/modernbert-dark.png" width="760" alt="ModernBERT-base's 22 layers: every third layer, starting with the first, attends globally with rotary positions of base 160,000; the others attend to a window of 128 tokens with rotary base 10,000. Each layer is pre-norm, without biases, with a GeGLU feed-forward network" loading="lazy"></p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">MODERNBERT</span> <span class="o">=</span> <span class="sh">"</span><span class="s">answerdotai/ModernBERT-base</span><span class="sh">"</span>
<span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">MODERNBERT</span><span class="p">,</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">))</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
    <span class="n">modern_config</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">f</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">rotate</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">theta</span><span class="p">):</span>
    <span class="n">d</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
    <span class="n">inv</span> <span class="o">=</span> <span class="mf">1.0</span> <span class="o">/</span> <span class="n">theta</span> <span class="o">**</span> <span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">x</span><span class="p">.</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float32</span><span class="p">)</span> <span class="o">/</span> <span class="n">d</span><span class="p">)</span>
    <span class="n">angles</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">2</span><span class="p">],</span> <span class="n">device</span><span class="o">=</span><span class="n">x</span><span class="p">.</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float32</span><span class="p">)[:,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="n">inv</span>
    <span class="n">cos</span><span class="p">,</span> <span class="n">sin</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">angles</span><span class="p">.</span><span class="nf">cos</span><span class="p">()]</span> <span class="o">*</span> <span class="mi">2</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">),</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">angles</span><span class="p">.</span><span class="nf">sin</span><span class="p">()]</span> <span class="o">*</span> <span class="mi">2</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">half</span> <span class="o">=</span> <span class="n">d</span> <span class="o">//</span> <span class="mi">2</span>
    <span class="k">return</span> <span class="n">x</span> <span class="o">*</span> <span class="n">cos</span> <span class="o">+</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="o">-</span><span class="n">x</span><span class="p">[...,</span> <span class="n">half</span><span class="p">:],</span> <span class="n">x</span><span class="p">[...,</span> <span class="p">:</span><span class="n">half</span><span class="p">]],</span> <span class="o">-</span><span class="mi">1</span><span class="p">)</span> <span class="o">*</span> <span class="n">sin</span>


<span class="k">class</span> <span class="nc">ModernLayer</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">,</span> <span class="n">index</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span><span class="p">,</span> <span class="n">eps</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">norm_eps</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">is_global</span> <span class="o">=</span> <span class="n">index</span> <span class="o">%</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">global_attn_every_n_layers</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="mi">0</span>
        <span class="n">self</span><span class="p">.</span><span class="n">theta</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">global_rope_theta</span><span class="sh">"</span> <span class="k">if</span> <span class="n">self</span><span class="p">.</span><span class="n">is_global</span> <span class="k">else</span> <span class="sh">"</span><span class="s">local_rope_theta</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">half_window</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">local_attention</span><span class="sh">"</span><span class="p">]</span> <span class="o">//</span> <span class="mi">2</span>
        <span class="c1"># the first layer reads the embeddings' norm directly, so it has none of its own
</span>        <span class="k">if</span> <span class="n">index</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">:</span>
            <span class="n">self</span><span class="p">.</span><span class="n">attn_norm</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">eps</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="n">self</span><span class="p">.</span><span class="n">attn_norm</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Identity</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">qkv</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="mi">3</span> <span class="o">*</span> <span class="n">d</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">out</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">mlp_norm</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">eps</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">up</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">down</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">d</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">attention</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">padding</span><span class="p">):</span>
        <span class="n">b</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">d</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span>
        <span class="n">qkv</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">qkv</span><span class="p">(</span><span class="n">x</span><span class="p">).</span><span class="nf">view</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">d</span> <span class="o">//</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">).</span><span class="nf">permute</span><span class="p">(</span><span class="mi">2</span><span class="p">,</span> <span class="mi">0</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">4</span><span class="p">)</span>
        <span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="o">=</span> <span class="nf">rotate</span><span class="p">(</span><span class="n">qkv</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="n">self</span><span class="p">.</span><span class="n">theta</span><span class="p">),</span> <span class="nf">rotate</span><span class="p">(</span><span class="n">qkv</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="n">self</span><span class="p">.</span><span class="n">theta</span><span class="p">),</span> <span class="n">qkv</span><span class="p">[</span><span class="mi">2</span><span class="p">]</span>
        <span class="n">hidden</span> <span class="o">=</span> <span class="n">padding</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:]</span>
        <span class="k">if</span> <span class="ow">not</span> <span class="n">self</span><span class="p">.</span><span class="n">is_global</span><span class="p">:</span>
            <span class="n">position</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">x</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
            <span class="n">distance</span> <span class="o">=</span> <span class="p">(</span><span class="n">position</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">-</span> <span class="n">position</span><span class="p">[</span><span class="bp">None</span><span class="p">,</span> <span class="p">:]).</span><span class="nf">abs</span><span class="p">()</span>
            <span class="n">hidden</span> <span class="o">=</span> <span class="n">hidden</span> <span class="o">|</span> <span class="p">(</span><span class="n">distance</span> <span class="o">&gt;</span> <span class="n">self</span><span class="p">.</span><span class="n">half_window</span><span class="p">)</span>
        <span class="n">scores</span> <span class="o">=</span> <span class="n">q</span> <span class="o">@</span> <span class="n">k</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">2</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">])</span>
        <span class="n">weights</span> <span class="o">=</span> <span class="n">scores</span><span class="p">.</span><span class="nf">masked_fill</span><span class="p">(</span><span class="n">hidden</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="nf">finfo</span><span class="p">(</span><span class="n">scores</span><span class="p">.</span><span class="n">dtype</span><span class="p">).</span><span class="nb">min</span><span class="p">).</span><span class="nf">softmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">out</span><span class="p">((</span><span class="n">weights</span> <span class="o">@</span> <span class="n">v</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">d</span><span class="p">))</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">padding</span><span class="p">):</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">attention</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">attn_norm</span><span class="p">(</span><span class="n">x</span><span class="p">),</span> <span class="n">padding</span><span class="p">)</span>
        <span class="n">h</span><span class="p">,</span> <span class="n">gate</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">up</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">mlp_norm</span><span class="p">(</span><span class="n">x</span><span class="p">)).</span><span class="nf">chunk</span><span class="p">(</span><span class="mi">2</span><span class="p">,</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>  <span class="c1"># GeGLU
</span>        <span class="k">return</span> <span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">down</span><span class="p">(</span><span class="n">F</span><span class="p">.</span><span class="nf">gelu</span><span class="p">(</span><span class="n">h</span><span class="p">)</span> <span class="o">*</span> <span class="n">gate</span><span class="p">)</span>


<span class="k">class</span> <span class="nc">ModernBert</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span><span class="p">,</span> <span class="n">eps</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">norm_eps</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">words</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">eps</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">n_layers</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">layers</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">ModuleList</span><span class="p">(</span><span class="nc">ModernLayer</span><span class="p">(</span><span class="n">config</span><span class="p">,</span> <span class="n">i</span><span class="p">)</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n_layers</span><span class="p">))</span>
        <span class="n">self</span><span class="p">.</span><span class="n">final_norm</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">eps</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">padding</span><span class="p">):</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">words</span><span class="p">(</span><span class="n">ids</span><span class="p">))</span>
        <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">self</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
            <span class="n">x</span> <span class="o">=</span> <span class="nf">layer</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">padding</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">final_norm</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>
</code></pre></div></div> <p>A padded position far from any real token has every key hidden in a local layer, both by padding and by distance. A softmax over nothing but \(-\infty\) is <code class="language-plaintext highlighter-rouge">nan</code>, and <code class="language-plaintext highlighter-rouge">nan</code> times a zero weight is still <code class="language-plaintext highlighter-rouge">nan</code>, which would leak into the real tokens through the next layer. Filling hidden scores with the most negative finite number instead of \(-\infty\), as above, keeps such rows harmless.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">weights</span> <span class="o">=</span> <span class="nf">load_file</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">MODERNBERT</span><span class="p">,</span> <span class="sh">"</span><span class="s">model.safetensors</span><span class="sh">"</span><span class="p">))</span>
<span class="n">names</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">words.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">model.embeddings.tok_embeddings.weight</span><span class="sh">"</span><span class="p">,</span>
         <span class="sh">"</span><span class="s">norm.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">model.embeddings.norm.weight</span><span class="sh">"</span><span class="p">,</span>
         <span class="sh">"</span><span class="s">final_norm.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">model.final_norm.weight</span><span class="sh">"</span><span class="p">}</span>
<span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">modern_config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">]):</span>
    <span class="k">for</span> <span class="n">ours</span><span class="p">,</span> <span class="n">theirs</span> <span class="ow">in</span> <span class="p">[(</span><span class="sh">"</span><span class="s">qkv</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">attn.Wqkv</span><span class="sh">"</span><span class="p">),</span> <span class="p">(</span><span class="sh">"</span><span class="s">out</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">attn.Wo</span><span class="sh">"</span><span class="p">),</span> <span class="p">(</span><span class="sh">"</span><span class="s">up</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">mlp.Wi</span><span class="sh">"</span><span class="p">),</span>
                         <span class="p">(</span><span class="sh">"</span><span class="s">down</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">mlp.Wo</span><span class="sh">"</span><span class="p">),</span> <span class="p">(</span><span class="sh">"</span><span class="s">mlp_norm</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">mlp_norm</span><span class="sh">"</span><span class="p">)]:</span>
        <span class="n">names</span><span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="s">layers.</span><span class="si">{</span><span class="n">i</span><span class="si">}</span><span class="s">.</span><span class="si">{</span><span class="n">ours</span><span class="si">}</span><span class="s">.weight</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">model.layers.</span><span class="si">{</span><span class="n">i</span><span class="si">}</span><span class="s">.</span><span class="si">{</span><span class="n">theirs</span><span class="si">}</span><span class="s">.weight</span><span class="sh">"</span>
    <span class="k">if</span> <span class="n">i</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">:</span>
        <span class="n">names</span><span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="s">layers.</span><span class="si">{</span><span class="n">i</span><span class="si">}</span><span class="s">.attn_norm.weight</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">model.layers.</span><span class="si">{</span><span class="n">i</span><span class="si">}</span><span class="s">.attn_norm.weight</span><span class="sh">"</span>
<span class="n">modern</span> <span class="o">=</span> <span class="nc">ModernBert</span><span class="p">(</span><span class="n">modern_config</span><span class="p">)</span>
<span class="n">modern</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">({</span><span class="n">o</span><span class="p">:</span> <span class="n">weights</span><span class="p">[</span><span class="n">t</span><span class="p">]</span> <span class="k">for</span> <span class="n">o</span><span class="p">,</span> <span class="n">t</span> <span class="ow">in</span> <span class="n">names</span><span class="p">.</span><span class="nf">items</span><span class="p">()},</span> <span class="n">strict</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">modern</span> <span class="o">=</span> <span class="n">modern</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>

<span class="n">modern_tokenizer</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">MODERNBERT</span><span class="p">)</span>
<span class="n">reference</span> <span class="o">=</span> <span class="n">ModernBertModel</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">MODERNBERT</span><span class="p">,</span> <span class="n">attn_implementation</span><span class="o">=</span><span class="sh">"</span><span class="s">eager</span><span class="sh">"</span><span class="p">)</span>
<span class="n">reference</span> <span class="o">=</span> <span class="n">reference</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="n">check</span> <span class="o">=</span> <span class="nf">modern_tokenizer</span><span class="p">([</span><span class="n">trace</span><span class="p">,</span> <span class="sh">"</span><span class="s">Docs typo</span><span class="sh">"</span><span class="p">],</span> <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="n">padding</span> <span class="o">=</span> <span class="n">check</span><span class="p">[</span><span class="sh">"</span><span class="s">attention_mask</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="mi">0</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">theirs</span> <span class="o">=</span> <span class="nf">reference</span><span class="p">(</span><span class="o">**</span><span class="n">check</span><span class="p">).</span><span class="n">last_hidden_state</span>
    <span class="n">ours</span> <span class="o">=</span> <span class="nf">modern</span><span class="p">(</span><span class="n">check</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">padding</span><span class="p">)</span>
<span class="n">gap</span> <span class="o">=</span> <span class="p">(</span><span class="n">ours</span> <span class="o">-</span> <span class="n">theirs</span><span class="p">)[</span><span class="o">~</span><span class="n">padding</span><span class="p">].</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
<span class="n">length</span> <span class="o">=</span> <span class="n">check</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">].</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">length</span><span class="si">}</span><span class="s"> tokens, largest difference from Hugging Face</span><span class="sh">'</span><span class="s">s ModernBERT: </span><span class="si">{</span><span class="n">gap</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="k">assert</span> <span class="n">gap</span> <span class="o">&lt;</span> <span class="mf">1e-3</span>
<span class="k">del</span> <span class="n">reference</span>
</code></pre></div></div> <pre class="tfs-printed"><code>403 tokens, largest difference from Hugging Face's ModernBERT: 1.6e-04</code></pre> <p>What does the window buy? In a global layer each of \(n\) tokens attends to all \(n\); in a local layer to at most 129. Counted over ModernBERT-base’s 22 layers:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="p">[</span><span class="mi">512</span><span class="p">,</span> <span class="mi">2048</span><span class="p">,</span> <span class="mi">8192</span><span class="p">]:</span>
    <span class="n">pairs</span> <span class="o">=</span> <span class="nf">sum</span><span class="p">(</span><span class="n">n</span> <span class="o">*</span> <span class="n">n</span> <span class="k">if</span> <span class="n">layer</span><span class="p">.</span><span class="n">is_global</span> <span class="k">else</span> <span class="n">n</span> <span class="o">*</span> <span class="nf">min</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">layer</span><span class="p">.</span><span class="n">half_window</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span>
                <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">modern</span><span class="p">.</span><span class="n">layers</span><span class="p">)</span>
    <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">tokens</span><span class="sh">"</span><span class="p">:</span> <span class="n">n</span><span class="p">,</span> <span class="sh">"</span><span class="s">attended pairs</span><span class="sh">"</span><span class="p">:</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">pairs</span> <span class="o">/</span> <span class="mf">1e6</span><span class="si">:</span><span class="p">,.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s">M</span><span class="sh">"</span><span class="p">,</span>
                 <span class="sh">"</span><span class="s">share of an all-global model</span><span class="sh">"</span><span class="p">:</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">pairs</span> <span class="o">/</span> <span class="p">(</span><span class="mi">22</span> <span class="o">*</span> <span class="n">n</span> <span class="o">*</span> <span class="n">n</span><span class="p">)</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span><span class="p">})</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">tokens</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">attended pairs</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">share of an all-global model</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">512</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">3M</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">52%</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,048</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">37M</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">40%</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">8,192</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">552M</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">37%</td></tr></tbody></table></div> <p class="takeaway">The local layers get almost free as inputs grow, and the cost settles at that of the eight global layers: 37% of an all-global model at 8,192 tokens, the length ModernBERT was trained for.</p> <p>On GPUs with <a href="/blog/2026/transformers-from-scratch-05-llama/">FlashAttention</a> the saving is real time; the T4 has no kernel for windows, so here the mask only hides scores that are still computed.</p> <h2 id="5-triage-for-projects-the-model-has-never-seen">5. Triage for projects the model has never seen</h2> <p>Every large project gets more issues than its maintainers can read the day they arrive, and the first thing anyone does with a new issue is decide what it is: a bug, a feature request, a question, or a problem with the documentation.</p> <p>A model that does this well saves real time, and the honest test of one is a project it was not trained on, since that is where a new tool would be used.</p> <p>The four generations get the same job: 6,000 labelled issues from the eight training projects, 1,500 of each kind, and the issues of the five unseen projects as the test, 400 of each kind. Each model is the pre-trained encoder with a classification head, fine-tuned for two epochs with the same recipe, reading the first 256 tokens of each issue.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">train_set</span> <span class="o">=</span> <span class="nf">balanced</span><span class="p">(</span><span class="n">seen</span><span class="p">,</span> <span class="mi">8</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">1500</span><span class="p">,</span> <span class="n">SEED</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span>
<span class="n">test_set</span> <span class="o">=</span> <span class="nf">balanced</span><span class="p">(</span><span class="n">unseen</span><span class="p">,</span> <span class="mi">4</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">400</span><span class="p">,</span> <span class="n">SEED</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span>
<span class="n">TOKENS</span><span class="p">,</span> <span class="n">EPOCHS</span> <span class="o">=</span> <span class="p">(</span><span class="mi">64</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="nf">else </span><span class="p">(</span><span class="mi">256</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>  <span class="c1"># CI checks the code on a CPU, briefly
</span><span class="n">lengths</span> <span class="o">=</span> <span class="p">[</span><span class="nf">len</span><span class="p">(</span><span class="nf">modern_tokenizer</span><span class="p">(</span><span class="n">t</span><span class="p">)[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">])</span> <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="n">test_set</span><span class="p">[</span><span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">]]</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">test issues longer than 256 tokens: </span><span class="si">{</span><span class="n">np</span><span class="p">.</span><span class="nf">mean</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">array</span><span class="p">(</span><span class="n">lengths</span><span class="p">)</span> <span class="o">&gt;</span> <span class="mi">256</span><span class="p">)</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="o">%</span><span class="si">}</span><span class="s">, </span><span class="sh">"</span>
      <span class="sa">f</span><span class="sh">"</span><span class="s">longer than 1,024: </span><span class="si">{</span><span class="n">np</span><span class="p">.</span><span class="nf">mean</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">array</span><span class="p">(</span><span class="n">lengths</span><span class="p">)</span> <span class="o">&gt;</span> <span class="mi">1024</span><span class="p">)</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="n">example</span> <span class="o">=</span> <span class="n">test_set</span><span class="p">[</span><span class="n">test_set</span><span class="p">[</span><span class="sh">"</span><span class="s">kind</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="sh">"</span><span class="s">bug</span><span class="sh">"</span><span class="p">].</span><span class="n">iloc</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="n">example</span><span class="p">[</span><span class="sh">"</span><span class="s">repo</span><span class="sh">"</span><span class="p">],</span> <span class="sh">"</span><span class="s">|</span><span class="sh">"</span><span class="p">,</span> <span class="n">example</span><span class="p">[</span><span class="sh">"</span><span class="s">kind</span><span class="sh">"</span><span class="p">],</span> <span class="sh">"</span><span class="se">\n</span><span class="sh">"</span><span class="p">,</span> <span class="n">example</span><span class="p">[</span><span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">][:</span><span class="mi">700</span><span class="p">])</span>
</code></pre></div></div> <pre class="tfs-printed"><code>test issues longer than 256 tokens: 56%, longer than 1,024: 21%
moby/moby | bug 
 docker push fails when DNS `AAAA` response with 0 answers beats `A` response with 1 answer

I've been experiencing an issue with docker push for a local, ipv4 only registry. Every once in a while, it'll fail, with `dial tcp: lookup registry.weave.local: no such host`, only to succeed after.

I've run wireshark and have confirmed that Docker is issuing an `A` and `AAAA` DNS query simultaneously, and when the `AAAA` response comes back first, I get the error. Most of the time, the `A` response comes back first, and it succeeds.

Also, I've confirmed that AAAA is responding correctly with "No answer".

![Screen shot from wireshark showing the proper AAAA response](https://files.gitter.im/docker</code></pre> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">ENCODERS</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">BERT</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">google-bert/bert-base-uncased</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">RoBERTa</span><span class="sh">"</span><span class="p">:</span> <span class="n">ROBERTA</span><span class="p">,</span>
            <span class="sh">"</span><span class="s">DeBERTa-v3</span><span class="sh">"</span><span class="p">:</span> <span class="n">DEBERTA</span><span class="p">,</span> <span class="sh">"</span><span class="s">ModernBERT</span><span class="sh">"</span><span class="p">:</span> <span class="n">MODERNBERT</span><span class="p">}</span>


<span class="k">def</span> <span class="nf">fine_tune</span><span class="p">(</span><span class="n">name</span><span class="p">,</span> <span class="n">max_length</span><span class="p">,</span> <span class="n">label</span><span class="p">,</span> <span class="n">epochs</span><span class="o">=</span><span class="n">EPOCHS</span><span class="p">,</span> <span class="n">lr</span><span class="o">=</span><span class="mf">3e-5</span><span class="p">,</span> <span class="n">batch_size</span><span class="o">=</span><span class="mi">16</span><span class="p">):</span>
    <span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
    <span class="n">tokenizer</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">ENCODERS</span><span class="p">[</span><span class="n">name</span><span class="p">])</span>
    <span class="n">model</span> <span class="o">=</span> <span class="n">AutoModelForSequenceClassification</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">ENCODERS</span><span class="p">[</span><span class="n">name</span><span class="p">],</span>
                                                               <span class="n">num_labels</span><span class="o">=</span><span class="nf">len</span><span class="p">(</span><span class="n">KINDS</span><span class="p">))</span>
    <span class="n">model</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="nf">float</span><span class="p">().</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>  <span class="c1"># some checkpoints are stored in float16
</span>    <span class="n">steps</span> <span class="o">=</span> <span class="n">epochs</span> <span class="o">*</span> <span class="n">math</span><span class="p">.</span><span class="nf">ceil</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">train_set</span><span class="p">)</span> <span class="o">/</span> <span class="n">batch_size</span><span class="p">)</span>
    <span class="n">optimizer</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">optim</span><span class="p">.</span><span class="nc">AdamW</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="nf">parameters</span><span class="p">(),</span> <span class="n">lr</span><span class="o">=</span><span class="n">lr</span><span class="p">,</span> <span class="n">weight_decay</span><span class="o">=</span><span class="mf">0.01</span><span class="p">)</span>
    <span class="n">warmup</span> <span class="o">=</span> <span class="nf">max</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">steps</span> <span class="o">//</span> <span class="mi">10</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">rate</span><span class="p">(</span><span class="n">step</span><span class="p">):</span>
        <span class="k">return</span> <span class="nf">min</span><span class="p">((</span><span class="n">step</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">warmup</span><span class="p">,</span> <span class="nf">max</span><span class="p">(</span><span class="mf">0.0</span><span class="p">,</span> <span class="p">(</span><span class="n">steps</span> <span class="o">-</span> <span class="n">step</span><span class="p">)</span> <span class="o">/</span> <span class="nf">max</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">steps</span> <span class="o">-</span> <span class="n">warmup</span><span class="p">)))</span>

    <span class="n">schedule</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">optim</span><span class="p">.</span><span class="n">lr_scheduler</span><span class="p">.</span><span class="nc">LambdaLR</span><span class="p">(</span><span class="n">optimizer</span><span class="p">,</span> <span class="n">rate</span><span class="p">)</span>
    <span class="n">scaler</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">amp</span><span class="p">.</span><span class="nc">GradScaler</span><span class="p">(</span><span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">batches</span><span class="p">(</span><span class="n">frame</span><span class="p">,</span> <span class="n">size</span><span class="p">,</span> <span class="n">shuffle</span><span class="p">):</span>
        <span class="n">order</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="nf">permutation</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">frame</span><span class="p">))</span> <span class="k">if</span> <span class="n">shuffle</span> <span class="k">else</span> <span class="n">np</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">frame</span><span class="p">))</span>
        <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">frame</span><span class="p">),</span> <span class="n">size</span><span class="p">):</span>
            <span class="n">rows</span> <span class="o">=</span> <span class="n">frame</span><span class="p">.</span><span class="n">iloc</span><span class="p">[</span><span class="n">order</span><span class="p">[</span><span class="n">k</span><span class="p">:</span><span class="n">k</span> <span class="o">+</span> <span class="n">size</span><span class="p">]]</span>
            <span class="n">enc</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="nf">list</span><span class="p">(</span><span class="n">rows</span><span class="p">[</span><span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">]),</span> <span class="n">truncation</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">max_length</span><span class="o">=</span><span class="n">max_length</span><span class="p">,</span>
                            <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
            <span class="n">labels</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">([</span><span class="n">KINDS</span><span class="p">.</span><span class="nf">index</span><span class="p">(</span><span class="n">x</span><span class="p">)</span> <span class="k">for</span> <span class="n">x</span> <span class="ow">in</span> <span class="n">rows</span><span class="p">[</span><span class="sh">"</span><span class="s">kind</span><span class="sh">"</span><span class="p">]],</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
            <span class="k">yield</span> <span class="n">enc</span><span class="p">,</span> <span class="n">labels</span>

    <span class="n">t0</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
    <span class="n">model</span><span class="p">.</span><span class="nf">train</span><span class="p">()</span>
    <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">epochs</span><span class="p">):</span>
        <span class="k">for</span> <span class="n">enc</span><span class="p">,</span> <span class="n">labels</span> <span class="ow">in</span> <span class="nf">batches</span><span class="p">(</span><span class="n">train_set</span><span class="p">,</span> <span class="n">batch_size</span><span class="p">,</span> <span class="n">shuffle</span><span class="o">=</span><span class="bp">True</span><span class="p">):</span>
            <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">autocast</span><span class="p">(</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float16</span><span class="p">,</span> <span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">):</span>
                <span class="n">loss</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span><span class="nf">model</span><span class="p">(</span><span class="o">**</span><span class="n">enc</span><span class="p">).</span><span class="n">logits</span><span class="p">.</span><span class="nf">float</span><span class="p">(),</span> <span class="n">labels</span><span class="p">)</span>
            <span class="n">optimizer</span><span class="p">.</span><span class="nf">zero_grad</span><span class="p">(</span><span class="n">set_to_none</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
            <span class="n">scaler</span><span class="p">.</span><span class="nf">scale</span><span class="p">(</span><span class="n">loss</span><span class="p">).</span><span class="nf">backward</span><span class="p">()</span>
            <span class="n">scaler</span><span class="p">.</span><span class="nf">unscale_</span><span class="p">(</span><span class="n">optimizer</span><span class="p">)</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">utils</span><span class="p">.</span><span class="nf">clip_grad_norm_</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="nf">parameters</span><span class="p">(),</span> <span class="mf">1.0</span><span class="p">)</span>
            <span class="n">scaler</span><span class="p">.</span><span class="nf">step</span><span class="p">(</span><span class="n">optimizer</span><span class="p">)</span>
            <span class="n">scaler</span><span class="p">.</span><span class="nf">update</span><span class="p">()</span>
            <span class="n">schedule</span><span class="p">.</span><span class="nf">step</span><span class="p">()</span>
    <span class="n">train_minutes</span> <span class="o">=</span> <span class="p">(</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">t0</span><span class="p">)</span> <span class="o">/</span> <span class="mi">60</span>
    <span class="n">model</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>
    <span class="n">predicted</span><span class="p">,</span> <span class="n">truth</span> <span class="o">=</span> <span class="p">[],</span> <span class="p">[]</span>
    <span class="n">t0</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
    <span class="n">half</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">autocast</span><span class="p">(</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float16</span><span class="p">,</span> <span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">)</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">(),</span> <span class="n">half</span><span class="p">:</span>
        <span class="k">for</span> <span class="n">enc</span><span class="p">,</span> <span class="n">labels</span> <span class="ow">in</span> <span class="nf">batches</span><span class="p">(</span><span class="n">test_set</span><span class="p">,</span> <span class="mi">32</span><span class="p">,</span> <span class="n">shuffle</span><span class="o">=</span><span class="bp">False</span><span class="p">):</span>
            <span class="n">predicted</span> <span class="o">+=</span> <span class="nf">model</span><span class="p">(</span><span class="o">**</span><span class="n">enc</span><span class="p">).</span><span class="n">logits</span><span class="p">.</span><span class="nf">argmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">).</span><span class="nf">tolist</span><span class="p">()</span>
            <span class="n">truth</span> <span class="o">+=</span> <span class="n">labels</span><span class="p">.</span><span class="nf">tolist</span><span class="p">()</span>
    <span class="n">per_second</span> <span class="o">=</span> <span class="nf">len</span><span class="p">(</span><span class="n">test_set</span><span class="p">)</span> <span class="o">/</span> <span class="p">(</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">t0</span><span class="p">)</span>
    <span class="n">result</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">:</span> <span class="n">label</span><span class="p">,</span> <span class="sh">"</span><span class="s">tokens</span><span class="sh">"</span><span class="p">:</span> <span class="n">max_length</span><span class="p">,</span>
              <span class="sh">"</span><span class="s">macro F1</span><span class="sh">"</span><span class="p">:</span> <span class="nf">macro_f1</span><span class="p">(</span><span class="n">truth</span><span class="p">,</span> <span class="n">predicted</span><span class="p">),</span>
              <span class="sh">"</span><span class="s">train, min</span><span class="sh">"</span><span class="p">:</span> <span class="n">train_minutes</span><span class="p">,</span> <span class="sh">"</span><span class="s">issues/s</span><span class="sh">"</span><span class="p">:</span> <span class="n">per_second</span><span class="p">}</span>
    <span class="k">del</span> <span class="n">model</span>
    <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
        <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">empty_cache</span><span class="p">()</span>
    <span class="k">return</span> <span class="n">result</span><span class="p">,</span> <span class="nf">confusion</span><span class="p">(</span><span class="n">truth</span><span class="p">,</span> <span class="n">predicted</span><span class="p">)</span>


<span class="n">results</span><span class="p">,</span> <span class="n">confusions</span> <span class="o">=</span> <span class="p">[],</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">ENCODERS</span><span class="p">:</span>
    <span class="n">result</span><span class="p">,</span> <span class="n">confusions</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="o">=</span> <span class="nf">fine_tune</span><span class="p">(</span><span class="n">name</span><span class="p">,</span> <span class="n">TOKENS</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="n">name</span><span class="p">)</span>
    <span class="n">results</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">result</span><span class="p">)</span>
    <span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="s">: macro F1 </span><span class="si">{</span><span class="n">result</span><span class="p">[</span><span class="sh">'</span><span class="s">macro F1</span><span class="sh">'</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">3</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span> <span class="n">flush</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">results</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>BERT: macro F1 0.703
RoBERTa: macro F1 0.717
DeBERTa-v3: macro F1 0.728
ModernBERT: macro F1 0.730</code></pre> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">model</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">tokens</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">macro F1</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">train, min</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">issues/s</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">BERT</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">256</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.70</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.85</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">223.35</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">RoBERTa</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">256</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.72</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.92</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">220.92</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">DeBERTa-v3</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">256</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.73</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5.16</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">119.90</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">ModernBERT</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">256</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.73</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4.93</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">113.90</td></tr></tbody></table></div> <p>The table needs a second look before any conclusion: each number comes from one run, one random seed, and a test set of 1,600 issues, so differences of a point or two are within the noise.</p> <p>With that in mind, the order is the order of history. RoBERTa gains on BERT with exactly the same block, from its training alone; DeBERTa-v3 and ModernBERT add a little more and tie with each other.</p> <p>On this GPU they also cost the same, about half the speed of BERT; ModernBERT’s speed comes from FlashAttention and unpadding, which a T4 can’t use.</p> <p>Now the thing only ModernBERT can do here. BERT, RoBERTa and DeBERTa-v3 were trained on 512 tokens at most, while ModernBERT was trained on 8,192. Issues are long, with logs and stack traces, so we let it read four times more:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">LONG</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">ModernBERT, </span><span class="si">{</span><span class="mi">4</span> <span class="o">*</span> <span class="n">TOKENS</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> tokens</span><span class="sh">"</span>
<span class="n">long_result</span><span class="p">,</span> <span class="n">confusions</span><span class="p">[</span><span class="n">LONG</span><span class="p">]</span> <span class="o">=</span> <span class="nf">fine_tune</span><span class="p">(</span><span class="sh">"</span><span class="s">ModernBERT</span><span class="sh">"</span><span class="p">,</span> <span class="mi">4</span> <span class="o">*</span> <span class="n">TOKENS</span><span class="p">,</span> <span class="n">LONG</span><span class="p">,</span> <span class="n">batch_size</span><span class="o">=</span><span class="mi">8</span><span class="p">)</span>
<span class="n">results</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">long_result</span><span class="p">)</span>
<span class="nf">display</span><span class="p">(</span><span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">results</span><span class="p">)))</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.4</span><span class="p">,</span> <span class="mf">3.8</span><span class="p">))</span>
<span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">results</span><span class="p">:</span>
    <span class="n">color</span> <span class="o">=</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">]</span> <span class="k">if</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">].</span><span class="nf">startswith</span><span class="p">(</span><span class="sh">"</span><span class="s">ModernBERT</span><span class="sh">"</span><span class="p">)</span> <span class="k">else</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">]</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">scatter</span><span class="p">(</span><span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">issues/s</span><span class="sh">"</span><span class="p">],</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">macro F1</span><span class="sh">"</span><span class="p">],</span> <span class="n">s</span><span class="o">=</span><span class="mi">60</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">)</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">annotate</span><span class="p">(</span><span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">],</span> <span class="p">(</span><span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">issues/s</span><span class="sh">"</span><span class="p">],</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">macro F1</span><span class="sh">"</span><span class="p">]),</span> <span class="n">xytext</span><span class="o">=</span><span class="p">(</span><span class="mi">6</span><span class="p">,</span> <span class="mi">4</span><span class="p">),</span>
                <span class="n">textcoords</span><span class="o">=</span><span class="sh">"</span><span class="s">offset points</span><span class="sh">"</span><span class="p">,</span> <span class="n">fontsize</span><span class="o">=</span><span class="mi">9</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">Triage of unseen projects: quality against speed</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">issues classified per second on this GPU</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">macro F1</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">model</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">tokens</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">macro F1</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">train, min</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">issues/s</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">BERT</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">256</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.70</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.85</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">223.35</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">RoBERTa</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">256</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.72</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.92</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">220.92</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">DeBERTa-v3</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">256</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.73</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">5.16</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">119.90</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">ModernBERT</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">256</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.73</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4.93</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">113.90</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">ModernBERT, 1,024 tokens</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,024</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.73</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">19.64</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">26.31</td></tr></tbody></table></div> <p><img class="tfs-output" src="/assets/posts/arch/02/output-03.png" alt="Triage of unseen projects: quality against speed" loading="lazy"></p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">best</span> <span class="o">=</span> <span class="nf">max</span><span class="p">(</span><span class="n">results</span><span class="p">,</span> <span class="n">key</span><span class="o">=</span><span class="k">lambda</span> <span class="n">row</span><span class="p">:</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">macro F1</span><span class="sh">"</span><span class="p">])[</span><span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="p">]</span>
<span class="nf">heatmap</span><span class="p">(</span><span class="n">confusions</span><span class="p">[</span><span class="n">best</span><span class="p">],</span> <span class="n">rows</span><span class="o">=</span><span class="n">KINDS</span><span class="p">,</span> <span class="n">cols</span><span class="o">=</span><span class="n">KINDS</span><span class="p">,</span> <span class="n">annotate</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">fmt</span><span class="o">=</span><span class="sh">"</span><span class="s">{:.2f}</span><span class="sh">"</span><span class="p">,</span> <span class="n">cell</span><span class="o">=</span><span class="mf">0.6</span><span class="p">,</span>
        <span class="n">title</span><span class="o">=</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">best</span><span class="si">}</span><span class="s">: what each kind of issue was taken for</span><span class="sh">"</span><span class="p">,</span> <span class="n">xlabel</span><span class="o">=</span><span class="sh">"</span><span class="s">predicted</span><span class="sh">"</span><span class="p">,</span>
        <span class="n">ylabel</span><span class="o">=</span><span class="sh">"</span><span class="s">actual</span><span class="sh">"</span><span class="p">,</span> <span class="n">role</span><span class="o">=</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/02/output-04.png" alt="Output of the code above" loading="lazy"></p> <p class="takeaway">Reading four times more of each issue changed nothing: ModernBERT trained four times longer and classified four times slower for the same macro F1, 0.73.</p> <p>The title and the first paragraph decide what an issue is, and the stack trace below them adds nothing to that decision. Long context earns its price where the answer is spread through a document, like the personal data of lesson 1’s bank documents, not here.</p> <p>The errors that remain gather in one place: almost a third of the bugs were taken for questions. A bug report often is a question, “is this expected?”, and the projects’ own labels don’t agree on where one ends and the other begins.</p> <h2 id="6-which-one-to-use-today">6. Which one to use today</h2> <p>Encoders are not a museum piece. On the day this lesson was written, the four most downloaded models on the Hugging Face Hub were small BERT-style encoders that turn text into vectors for search, the first of them more than a hundred million times in a month<sup class="cite">[<a href="#ref-7" id="cite-7" data-ref="7" aria-label="Reference 7: Hugging Face, 2026. huggingface.co.">7</a>]</sup>. The next lesson is about exactly those.</p> <div class="callout callout-key"> <p class="callout-label">Key point</p> <p>For a new project that needs an encoder, ModernBERT is a good default: it reads long inputs, it was trained on code as well as prose, and it is fast where FlashAttention is available.</p> </div> <p>DeBERTa-v3 remains a strong choice for short English text when the last point of accuracy matters more than speed, and years of Kaggle competitions have worn smooth every way of fine-tuning it.</p> <p>RoBERTa and BERT are worth knowing because half the models on the Hub are their descendants, fine-tuned for one task or another, and an existing fine-tuned model often beats a better base trained by you on less data.</p> <p>The lesson’s other result is about method rather than models. RoBERTa won without touching the architecture, ELECTRA without touching it either, and our tiny race showed that the training task alone moves the result. When a paper reports a new architecture beating an old one, the first question is whether the old one was trained as well.</p> <p>ModernBERT’s passport, and the family tree with this lesson’s branch:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/02/passport-light.png" width="760" alt="ModernBERT's passport: published December 2024 by Answer.AI and LightOn; encoder; masked language model with 30% of tokens masked, on 2 trillion tokens of text and code; attention alternating global and local windows of 128 tokens; rotary positions, 8,192 tokens; pre-norm LayerNorm, no biases except the vocabulary decoder; GeGLU; base 149 million parameters and 22 layers, large 395 million and 28 layers" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/02/passport-dark.png" width="760" alt="ModernBERT's passport: published December 2024 by Answer.AI and LightOn; encoder; masked language model with 30% of tokens masked, on 2 trillion tokens of text and code; attention alternating global and local windows of 128 tokens; rotary positions, 8,192 tokens; pre-norm LayerNorm, no biases except the vocabulary decoder; GeGLU; base 149 million parameters and 22 layers, large 395 million and 28 layers" loading="lazy"></p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/02/family-light.png" width="760" alt="The family of the Transformer as this course covers it, with lesson 2, RoBERTa to ModernBERT, highlighted and lesson 1, BERT, done" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/02/family-dark.png" width="760" alt="The family of the Transformer as this course covers it, with lesson 2, RoBERTa to ModernBERT, highlighted and lesson 1, BERT, done" loading="lazy"></p> <h2 id="references">References</h2> <ol class="tfs-refs"> <li id="ref-1">Liu, Y., Ott, M., Goyal, N., Du, J., Joshi, M., Chen, D., Levy, O., Lewis, M., Zettlemoyer, L., &amp; Stoyanov, V. (2019). <a href="https://arxiv.org/abs/1907.11692">RoBERTa: a robustly optimized BERT pretraining approach</a>. arXiv:1907.11692. <a class="ref-back" href="#cite-1" aria-label="Back to the text">↩</a></li> <li id="ref-2">Clark, K., Luong, M.-T., Le, Q. V., &amp; Manning, C. D. (2020). <a href="https://arxiv.org/abs/2003.10555">ELECTRA: pre-training text encoders as discriminators rather than generators</a>. <em>ICLR 2020</em>. <a class="ref-back" href="#cite-2" aria-label="Back to the text">↩</a></li> <li id="ref-3">open-index (2026). <a href="https://huggingface.co/datasets/open-index/open-github-issues">Open GitHub issues</a>. Hugging Face dataset, ODC-By. <a class="ref-back" href="#cite-3" aria-label="Back to the text">↩</a></li> <li id="ref-4">He, P., Liu, X., Gao, J., &amp; Chen, W. (2020). <a href="https://arxiv.org/abs/2006.03654">DeBERTa: decoding-enhanced BERT with disentangled attention</a>. <em>ICLR 2021</em>. <a class="ref-back" href="#cite-4" aria-label="Back to the text">↩</a></li> <li id="ref-5">Microsoft Research, 2021. <a href="https://www.microsoft.com/en-us/research/blog/microsoft-deberta-surpasses-human-performance-on-the-superglue-benchmark/">microsoft.com</a>. <a class="ref-back" href="#cite-5" aria-label="Back to the text">↩</a></li> <li id="ref-6">Warner, B., Chaffin, A., Clavié, B., Weller, O., Hallström, O., Taghadouini, S., Gallagher, A., Biswas, R., Ladhak, F., Aarsen, T., Cooper, N., Adams, G., Howard, J., &amp; Poli, I. (2024). <a href="https://arxiv.org/abs/2412.13663">Smarter, better, faster, longer: a modern bidirectional encoder for fast, memory efficient, and long context finetuning and inference</a>. arXiv:2412.13663. <a class="ref-back" href="#cite-6" aria-label="Back to the text">↩</a></li> <li id="ref-7">Hugging Face, 2026. <a href="https://huggingface.co/models?sort=downloads">huggingface.co</a>. <a class="ref-back" href="#cite-7" aria-label="Back to the text">↩</a></li> <li id="ref-8">Devlin, J., Chang, M.-W., Lee, K., &amp; Toutanova, K. (2018). <a href="https://arxiv.org/abs/1810.04805">BERT: pre-training of deep bidirectional transformers for language understanding</a>. <em>NAACL 2019</em>.</li> <li id="ref-9">He, P., Gao, J., &amp; Chen, W. (2021). <a href="https://arxiv.org/abs/2111.09543">DeBERTaV3: improving DeBERTa using ELECTRA-style pre-training with gradient-disentangled embedding sharing</a>. <em>ICLR 2023</em>.</li> <li id="ref-10">Su, J., Lu, Y., Pan, S., Murtadha, A., Wen, B., &amp; Liu, Y. (2021). <a href="https://arxiv.org/abs/2104.09864">RoFormer: enhanced transformer with rotary position embedding</a>. arXiv:2104.09864.</li> <li id="ref-11">Shazeer, N. (2020). <a href="https://arxiv.org/abs/2002.05202">GLU variants improve Transformer</a>. arXiv:2002.05202.</li> </ol>]]></content> <author> <name>Eva Koroleva</name> </author> <category term="machine-learning"/> <category term="transformer-architectures"/> <category term="roberta"/> <category term="electra"/> <category term="deberta"/> <category term="modernbert"/> <category term="nlp"/> <summary type="html"><![CDATA[What seven years did to BERT: RoBERTa's training recipe, ELECTRA's replaced-token detection, DeBERTa's disentangled attention and ModernBERT's LLM-era block, each written in PyTorch and checked against the real weights, and the four compared on triaging GitHub issues of projects they never saw.]]></summary> <media:thumbnail url="https://blog.korolevalab.com/assets/posts/arch/02/cover.png"/> <media:content medium="image" url="https://blog.korolevalab.com/assets/posts/arch/02/cover.png"/> </entry> <entry> <title type="html">BERT from scratch: masked language modelling and fine-tuning</title> <link href="https://blog.korolevalab.com/blog/2026/transformer-architectures-01-bert/" rel="alternate" type="text/html" title="BERT from scratch: masked language modelling and fine-tuning"/> <published>2026-02-27T10:00:00+00:00</published> <updated>2026-11-02T00:00:00+00:00</updated> <id>https://blog.korolevalab.com/blog/2026/transformer-architectures-01-bert</id> <content type="html" xml:base="https://blog.korolevalab.com/blog/2026/transformer-architectures-01-bert/"><![CDATA[<p class="tfs-links"><strong>Transformer architectures: from BERT to diffusion</strong> · lesson 1 of 15 · <a href="/teaching/">all lessons</a> · <a href="https://www.kaggle.com/code/qmarva/transformer-architectures-01-bert">run on Kaggle</a> · <a href="https://colab.research.google.com/github/xmarva/transformers-from-scratch/blob/main/notebooks/colab/a01_bert.ipynb">open in Colab</a> · <a href="https://github.com/xmarva/transformers-from-scratch">code on GitHub</a></p> <p>In October 2019 Google changed the way its search engine reads queries. Its own example was the query “2019 brazil traveler to usa need a visa”. The old system treated the little word <em>to</em> as noise and “returned results about U.S. citizens traveling to Brazil”, which is the other way around.</p> <p>The new one understood that the traveller goes from Brazil to the US. Google said the model would help with “one in 10 searches in the U.S. in English” and called it “the biggest leap forward in the past five years” <sup class="cite">[<a href="#ref-1" id="cite-1" data-ref="1" aria-label="Reference 1: Nayak, P. (2019). Understanding searches better than ever before. Google, 25 October 2019.">1</a>]</sup>.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/01/hero-light.png" width="760" alt="The query 2019 brazil traveler to usa need a visa, read two ways. As a bag of keywords, brazil, traveler, usa and visa match pages for Americans going to Brazil. Read as a sentence, the word to links traveler and usa: a Brazilian going to the US" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/01/hero-dark.png" width="760" alt="The query 2019 brazil traveler to usa need a visa, read two ways. As a bag of keywords, brazil, traveler, usa and visa match pages for Americans going to Brazil. Read as a sentence, the word to links traveler and usa: a Brazilian going to the US" loading="lazy"></p> <p>The model was <strong>BERT</strong>, published by Google a year earlier <sup class="cite">[<a href="#ref-2" id="cite-2" data-ref="2" aria-label="Reference 2: Devlin, J., Chang, M.-W., Lee, K., &amp; Toutanova, K. (2018). BERT: pre-training of deep bidirectional transformers for language understanding. NAACL 2019.">2</a>]</sup>. It is the Transformer encoder you built in the first course, trained on books and Wikipedia to fill in hidden words, and then taught a task with a few thousand examples.</p> <p>That recipe, pre-train once and <a href="/blog/2025/adapters/">fine-tune</a> for everything, is how most of NLP worked for the next four years, and BERT-sized encoders still sort, tag and search a large part of the world’s text, because they are small, fast and very good at it.</p> <p>In this lesson you will write BERT yourself, load Google’s weights into your code and check that it gives exactly the same answers as the reference implementation. Then you will ask it what it learned, look at what its attention heads do, and teach it a job that companies pay for: finding personal data in financial documents.</p> <p><strong>What you’ll do</strong></p> <ol> <li>See why a language model couldn’t simply read in both directions, and how a mask fixed it.</li> <li>Read BERT-base’s blueprint from its config and count where its 110 million parameters live.</li> <li>Write BERT in PyTorch, load Google’s weights into it and match Hugging Face’s outputs.</li> <li>Mask words the way BERT was trained, and ask it about facts, grammar, negation and gender.</li> <li>Look inside its attention: which heads watch the previous word, and why so many watch <code class="language-plaintext highlighter-rouge">[SEP]</code>.</li> <li>Fine-tune it to find names, addresses and account numbers in long documents, and compare it with regular expressions and with the same network trained without <a href="/blog/2024/llms-for-those-who-missed-out/">pre-training</a>.</li> </ol> <p><strong>What you need</strong>: a GPU. On Kaggle, <em>Settings → Accelerator → GPU</em>; on Colab, <em>Runtime → Change runtime type → T4 GPU</em>.</p> <p>The notebook downloads BERT-base twice (uncased and cased, 440 MB each) and a dataset of synthetic financial documents, and fine-tunes seven models, most of them on a few hundred documents; on a T4 it runs in about an hour.</p> <h2 id="setup">Setup</h2> <p>One small helper package, <code class="language-plaintext highlighter-rouge">tfs</code>, draws the course’s plots and token chips and knows where the notebook runs (Kaggle, Colab or your own machine). Everything the lesson teaches is written out in the notebook itself.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">importlib.util</span>
<span class="kn">import</span> <span class="n">subprocess</span>
<span class="kn">import</span> <span class="n">sys</span>

<span class="n">TFS</span> <span class="o">=</span> <span class="sh">"</span><span class="s">git+https://github.com/xmarva/transformers-from-scratch@main</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">importlib</span><span class="p">.</span><span class="n">util</span><span class="p">.</span><span class="nf">find_spec</span><span class="p">(</span><span class="sh">"</span><span class="s">tfs</span><span class="sh">"</span><span class="p">)</span> <span class="ow">is</span> <span class="bp">None</span><span class="p">:</span>
    <span class="n">subprocess</span><span class="p">.</span><span class="nf">check_call</span><span class="p">([</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">-m</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">pip</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">install</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-q</span><span class="sh">"</span><span class="p">,</span> <span class="n">TFS</span><span class="p">])</span>

<span class="kn">from</span> <span class="n">tfs</span> <span class="kn">import</span> <span class="n">env</span>
<span class="kn">from</span> <span class="n">tfs.viz</span> <span class="kn">import</span> <span class="n">table</span><span class="p">,</span> <span class="n">token_chips</span><span class="p">,</span> <span class="n">use_course_style</span>

<span class="n">env</span><span class="p">.</span><span class="nf">quiet</span><span class="p">()</span>  <span class="c1"># no progress bars or environment warnings in the outputs
</span><span class="n">SEED</span> <span class="o">=</span> <span class="mi">42</span>
<span class="n">env</span><span class="p">.</span><span class="nf">seed_everything</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">COLORS</span> <span class="o">=</span> <span class="nf">use_course_style</span><span class="p">()</span>
<span class="n">WORK_DIR</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">work_dir</span><span class="p">()</span>
</code></pre></div></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">json</span>
<span class="kn">import</span> <span class="n">math</span>
<span class="kn">import</span> <span class="n">random</span>
<span class="kn">import</span> <span class="n">re</span>
<span class="kn">import</span> <span class="n">time</span>

<span class="kn">import</span> <span class="n">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>
<span class="kn">import</span> <span class="n">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="n">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">import</span> <span class="n">torch</span>
<span class="kn">import</span> <span class="n">torch.nn</span> <span class="k">as</span> <span class="n">nn</span>
<span class="kn">import</span> <span class="n">torch.nn.functional</span> <span class="k">as</span> <span class="n">F</span>
<span class="kn">from</span> <span class="n">datasets</span> <span class="kn">import</span> <span class="n">load_dataset</span>
<span class="kn">from</span> <span class="n">huggingface_hub</span> <span class="kn">import</span> <span class="n">get_safetensors_metadata</span><span class="p">,</span> <span class="n">hf_hub_download</span>
<span class="kn">from</span> <span class="n">IPython.display</span> <span class="kn">import</span> <span class="n">HTML</span><span class="p">,</span> <span class="n">display</span>
<span class="kn">from</span> <span class="n">safetensors.torch</span> <span class="kn">import</span> <span class="n">load_file</span>
<span class="kn">from</span> <span class="n">tfs.viz</span> <span class="kn">import</span> <span class="n">heatmap</span>
<span class="kn">from</span> <span class="n">transformers</span> <span class="kn">import</span> <span class="n">AutoTokenizer</span><span class="p">,</span> <span class="n">BertForMaskedLM</span>

<span class="kn">import</span> <span class="n">warnings</span>

<span class="c1"># mixed precision skips a step when a gradient overflows; PyTorch reports it as a warning
</span><span class="n">warnings</span><span class="p">.</span><span class="nf">filterwarnings</span><span class="p">(</span><span class="sh">"</span><span class="s">ignore</span><span class="sh">"</span><span class="p">,</span> <span class="n">message</span><span class="o">=</span><span class="sh">"</span><span class="s">Detected call of `lr_scheduler.step</span><span class="sh">"</span><span class="p">)</span>
<span class="n">SMOKE</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">smoke</span><span class="p">()</span>  <span class="c1"># CI runs the lesson on a small slice; you run it in full
</span><span class="n">device</span> <span class="o">=</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="k">if</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">is_available</span><span class="p">()</span> <span class="k">else</span> <span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span>
<span class="k">assert</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span> <span class="ow">or</span> <span class="n">SMOKE</span><span class="p">,</span> <span class="sh">"</span><span class="s">This lesson fine-tunes BERT seven times: use a GPU.</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">GPU:</span><span class="sh">"</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">get_device_name</span><span class="p">(</span><span class="mi">0</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>GPU: Tesla T4</code></pre> <h2 id="1-reading-in-both-directions">1. Reading in both directions</h2> <p>Before BERT, the standard way to give a network some knowledge of language was a table of word vectors, such as word2vec’s: one vector per word, learned from which words appear near which. One vector per word is the problem.</p> <p><em>Bank</em> gets the same vector in “the bank raised its rates” and “we sat on the river bank”, and the network that uses it has to work out the difference on its own, from whatever little labelled data it has.</p> <p>The fix everyone could see was to read the whole sentence first: a vector for <em>bank</em> computed from its neighbours. A language model does exactly that.</p> <p>It is trained on raw text, which is free and endless, to predict the next word, so its hidden state at every position is a summary of the words before it. In 2018 two models showed how much that summary is worth.</p> <p>ELMo trained two recurrent language models, one reading left to right and one right to left, and glued their states together<sup class="cite">[<a href="#ref-3" id="cite-3" data-ref="3" aria-label="Reference 3: Peters, M. E., Neumann, M., Iyyer, M., Gardner, M., Clark, C., Lee, K., &amp; Zettlemoyer, L. (2018). Deep contextualized word representations. NAACL 2018.">3</a>]</sup>. OpenAI’s first GPT trained a Transformer decoder left to right and fine-tuned the whole of it for each task <sup class="cite">[<a href="#ref-4" id="cite-4" data-ref="4" aria-label="Reference 4: Radford, A., Narasimhan, K., Salimans, T., &amp; Sutskever, I. (2018). Improving language understanding by generative pre-training. OpenAI.">4</a>]</sup>.</p> <p>Both read with one eye closed. In “we sat on the river bank” the word that decides what <em>bank</em> means comes before it, but in “the bank of the river was steep” it comes after, and a left-to-right model sees it too late.</p> <p>ELMo’s two directions never meet inside the network: each half reads one way, and only their outputs are joined.</p> <p>Why not train one model that reads both ways at once? Because it would cheat. Devlin and colleagues put it in one sentence:</p> <blockquote class="pull"> <p>Bidirectional conditioning would allow each word to indirectly “see itself”, and the model could trivially predict the target word in a multi-layered context.</p> <p><cite>Devlin et al., 2018</cite></p> </blockquote> <p>Ask a model to predict word 5 while it can attend to word 5, and it learns to copy. Even if word 5 can’t attend to itself in the first layer, word 6 can, and in the second layer word 5 reads it back from word 6.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/01/readers-light.png" width="760" alt="Three ways to learn from raw text. GPT predicts each word from the words before it. ELMo trains a left-to-right and a right-to-left model separately and joins their outputs. BERT hides a word behind a mask and predicts it from both sides at once, in every layer" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/01/readers-dark.png" width="760" alt="Three ways to learn from raw text. GPT predicts each word from the words before it. ELMo trains a left-to-right and a right-to-left model separately and joins their outputs. BERT hides a word behind a mask and predicts it from both sides at once, in every layer" loading="lazy"></p> <p>BERT’s answer is old. In 1953 Wilson Taylor proposed measuring how readable a text is by deleting every fifth word and asking people to fill the gaps; he called it the <strong>cloze procedure</strong> <sup class="cite">[<a href="#ref-5" id="cite-5" data-ref="5" aria-label="Reference 5: Taylor, W. L. (1953). &quot;Cloze procedure&quot;: a new tool for measuring readability. Journalism Quarterly, 30(4), 415–433.">5</a>]</sup>.</p> <p>BERT plays the same game. It hides some of the words, replaces them with a special token <code class="language-plaintext highlighter-rouge">[MASK]</code> and is trained to restore them.</p> <p>A hidden word can’t see itself, so every layer can attend to everything else, in both directions. The paper calls this the <strong>masked language model</strong> (MLM), “inspired by the Cloze task (Taylor, 1953)”.</p> <p>The price is efficiency. A left-to-right model learns from every word of every sentence; BERT learns only from the 15% it hides.</p> <p>Google paid for that with compute: BERT-base was trained “on 4 Cloud TPUs in Pod configuration (16 TPU chips total)” and “each pre-training took 4 days to complete”, on a corpus of 3.3 billion words, books and English Wikipedia. We will not repeat that. We will write the network and borrow the four days.</p> <h2 id="2-the-blueprint">2. The blueprint</h2> <p>BERT-base’s weights live on the Hugging Face Hub, under Google’s name. Its configuration is a few hundred bytes:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">BERT</span> <span class="o">=</span> <span class="sh">"</span><span class="s">google-bert/bert-base-uncased</span><span class="sh">"</span>
<span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">BERT</span><span class="p">,</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">))</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
    <span class="n">config</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">f</span><span class="p">)</span>

<span class="n">FIELDS</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">,</span>
          <span class="sh">"</span><span class="s">hidden_act</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">max_position_embeddings</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">type_vocab_size</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">,</span>
          <span class="sh">"</span><span class="s">layer_norm_eps</span><span class="sh">"</span><span class="p">]</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">({</span><span class="sh">"</span><span class="s">setting</span><span class="sh">"</span><span class="p">:</span> <span class="n">FIELDS</span><span class="p">,</span> <span class="sh">"</span><span class="s">value</span><span class="sh">"</span><span class="p">:</span> <span class="p">[</span><span class="nf">str</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="n">name</span><span class="p">])</span> <span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">FIELDS</span><span class="p">]}))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">setting</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">value</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">num_hidden_layers</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">12</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">hidden_size</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">768</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">num_attention_heads</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">12</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">intermediate_size</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">3072</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">hidden_act</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">gelu</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">max_position_embeddings</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">512</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">type_vocab_size</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">vocab_size</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">30522</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">layer_norm_eps</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">1e-12</td></tr></tbody></table></div> <p>Twelve layers, each 768 wide with 12 attention heads, a feed-forward layer four times wider, GELU instead of ReLU.</p> <p>This is the encoder of the 2017 Transformer with two differences you will see in the code: positions are learned vectors rather than sinusoids, and there is a third embedding, the <strong>segment</strong>, which says whether a token belongs to the first or the second of two sentences.</p> <p>512 positions is the most BERT can read at once, a limit we will run into in section 7.</p> <p>The headers of the weight file list every tensor with its shape, and the Hub serves just the headers. Summed by where they live:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">metadata</span> <span class="o">=</span> <span class="nf">get_safetensors_metadata</span><span class="p">(</span><span class="n">BERT</span><span class="p">)</span>
<span class="n">tensors</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">file_metadata</span> <span class="ow">in</span> <span class="n">metadata</span><span class="p">.</span><span class="n">files_metadata</span><span class="p">.</span><span class="nf">values</span><span class="p">():</span>
    <span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">info</span> <span class="ow">in</span> <span class="n">file_metadata</span><span class="p">.</span><span class="n">tensors</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
        <span class="n">tensors</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="o">=</span> <span class="n">info</span><span class="p">.</span><span class="n">shape</span>


<span class="k">def</span> <span class="nf">part_of</span><span class="p">(</span><span class="n">name</span><span class="p">):</span>
    <span class="k">if</span> <span class="n">name</span> <span class="o">==</span> <span class="sh">"</span><span class="s">bert.embeddings.word_embeddings.weight</span><span class="sh">"</span><span class="p">:</span>
        <span class="k">return</span> <span class="sh">"</span><span class="s">word embeddings</span><span class="sh">"</span>
    <span class="k">if</span> <span class="n">name</span><span class="p">.</span><span class="nf">startswith</span><span class="p">(</span><span class="sh">"</span><span class="s">bert.embeddings.</span><span class="sh">"</span><span class="p">):</span>
        <span class="k">return</span> <span class="sh">"</span><span class="s">positions, segments, norm</span><span class="sh">"</span>
    <span class="k">if</span> <span class="sh">"</span><span class="s">.attention.</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">name</span><span class="p">:</span>
        <span class="k">return</span> <span class="sh">"</span><span class="s">attention, 12 layers</span><span class="sh">"</span>
    <span class="k">if</span> <span class="sh">"</span><span class="s">.intermediate.</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">name</span> <span class="ow">or</span> <span class="sh">"</span><span class="s">.output.</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">name</span><span class="p">:</span>
        <span class="k">return</span> <span class="sh">"</span><span class="s">feed-forward, 12 layers</span><span class="sh">"</span>
    <span class="k">if</span> <span class="n">name</span><span class="p">.</span><span class="nf">startswith</span><span class="p">(</span><span class="sh">"</span><span class="s">bert.pooler.</span><span class="sh">"</span><span class="p">):</span>
        <span class="k">return</span> <span class="sh">"</span><span class="s">pooler</span><span class="sh">"</span>
    <span class="k">return</span> <span class="sh">"</span><span class="s">pre-training heads</span><span class="sh">"</span>


<span class="n">parts</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">shape</span> <span class="ow">in</span> <span class="n">tensors</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
    <span class="n">parts</span><span class="p">[</span><span class="nf">part_of</span><span class="p">(</span><span class="n">name</span><span class="p">)]</span> <span class="o">=</span> <span class="n">parts</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="nf">part_of</span><span class="p">(</span><span class="n">name</span><span class="p">),</span> <span class="mi">0</span><span class="p">)</span> <span class="o">+</span> <span class="n">math</span><span class="p">.</span><span class="nf">prod</span><span class="p">(</span><span class="n">shape</span><span class="p">)</span>
<span class="n">total</span> <span class="o">=</span> <span class="nf">sum</span><span class="p">(</span><span class="n">parts</span><span class="p">.</span><span class="nf">values</span><span class="p">())</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">tensors</span><span class="p">)</span><span class="si">}</span><span class="s"> tensors, </span><span class="si">{</span><span class="n">total</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> parameters</span><span class="sh">"</span><span class="p">)</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.4</span><span class="p">,</span> <span class="mf">2.9</span><span class="p">))</span>
<span class="n">names</span> <span class="o">=</span> <span class="nf">list</span><span class="p">(</span><span class="n">parts</span><span class="p">)[::</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">barh</span><span class="p">(</span><span class="n">names</span><span class="p">,</span> <span class="p">[</span><span class="n">parts</span><span class="p">[</span><span class="n">n</span><span class="p">]</span> <span class="o">/</span> <span class="mf">1e6</span> <span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="n">names</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">])</span>
<span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">n</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">names</span><span class="p">):</span>
    <span class="n">label</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">parts</span><span class="p">[</span><span class="n">n</span><span class="p">]</span> <span class="o">/</span> <span class="mf">1e6</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s">M</span><span class="sh">"</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">text</span><span class="p">(</span><span class="n">parts</span><span class="p">[</span><span class="n">n</span><span class="p">]</span> <span class="o">/</span> <span class="mf">1e6</span> <span class="o">+</span> <span class="mf">0.8</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">label</span><span class="p">,</span> <span class="n">va</span><span class="o">=</span><span class="sh">"</span><span class="s">center</span><span class="sh">"</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">Where BERT-base</span><span class="sh">'</span><span class="s">s parameters live</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">millions of parameters</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">grid</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="sh">"</span><span class="s">y</span><span class="sh">"</span><span class="p">,</span> <span class="n">visible</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <pre class="tfs-printed"><code>206 tensors, 110,106,428 parameters</code></pre> <p><img class="tfs-output" src="/assets/posts/arch/01/output-01.png" alt="Where BERT-base" loading="lazy"></p> <p>One matrix stands out. The word embeddings, one 768-number row for each of the 30,522 entries of the vocabulary, take a fifth of the model, as much as three of its twelve layers. That is why the multilingual BERT, which needs a vocabulary for 104 languages, is bigger than the English one with exactly the same layers.</p> <p>Two names in the list are a little archaeological. Every LayerNorm stores <code class="language-plaintext highlighter-rouge">gamma</code> and <code class="language-plaintext highlighter-rouge">beta</code> rather than PyTorch’s <code class="language-plaintext highlighter-rouge">weight</code> and <code class="language-plaintext highlighter-rouge">bias</code>: Google trained BERT in TensorFlow, and the converted weights kept their names. And there is no output matrix for the masked word prediction at all.</p> <p>The model predicts a word by comparing its hidden state with the very same embedding table it reads words from; the input and output vocabularies share one matrix.</p> <h2 id="3-wordpiece-and-what-goes-in">3. WordPiece and what goes in</h2> <p>BERT reads <strong>WordPiece</strong> tokens. WordPiece builds its vocabulary like <a href="/blog/2026/transformers-from-scratch-01-tokenization/">BPE</a> in lesson 1 of the first course, by merging frequent pieces, but it picks the merge that most increases the likelihood of the training text rather than the most frequent pair, and it marks the pieces that continue a word with <code class="language-plaintext highlighter-rouge">##</code>. Here are two sentences as BERT receives them:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">tokenizer</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">BERT</span><span class="p">)</span>
<span class="n">pair</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="sh">"</span><span class="s">The bank raised its rates.</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">We sat on the river bank, unbothered.</span><span class="sh">"</span><span class="p">)</span>
<span class="n">tokens</span> <span class="o">=</span> <span class="n">tokenizer</span><span class="p">.</span><span class="nf">convert_ids_to_tokens</span><span class="p">(</span><span class="n">pair</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">])</span>
<span class="nf">token_chips</span><span class="p">([</span><span class="n">tokens</span><span class="p">],</span> <span class="n">ids</span><span class="o">=</span><span class="p">[</span><span class="n">pair</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">]],</span> <span class="n">mark_spaces</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">max_width</span><span class="o">=</span><span class="mi">620</span><span class="p">,</span>
            <span class="n">strong</span><span class="o">=</span><span class="k">lambda</span> <span class="n">row</span><span class="p">,</span> <span class="n">col</span><span class="p">,</span> <span class="n">token</span><span class="p">:</span> <span class="n">token</span> <span class="ow">in</span> <span class="p">(</span><span class="sh">"</span><span class="s">[CLS]</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">[SEP]</span><span class="sh">"</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">segments:</span><span class="sh">"</span><span class="p">,</span> <span class="n">pair</span><span class="p">[</span><span class="sh">"</span><span class="s">token_type_ids</span><span class="sh">"</span><span class="p">])</span>
</code></pre></div></div> <pre class="tfs-printed"><code>segments: [0, 0, 0, 0, 0, 0, 0, 0, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1]</code></pre> <p><img class="tfs-output" src="/assets/posts/arch/01/output-02.png" alt="Output of the code above" loading="lazy"></p> <p><code class="language-plaintext highlighter-rouge">[CLS]</code> opens every input; its final hidden state is meant to summarise the whole input for classification. <code class="language-plaintext highlighter-rouge">[SEP]</code> closes each sentence.</p> <p>The segment ids, 0 for the first sentence and 1 for the second, were needed for BERT’s second training game, <strong>next sentence prediction</strong>: half of the training pairs were real consecutive sentences and half were random ones, and BERT had to tell which.</p> <p>The game turned out to be nearly useless, and the next lesson’s RoBERTa dropped it. <em>Unbothered</em> was not frequent enough to get a token of its own and is spelled out in pieces: nothing is ever out of vocabulary.</p> <p>This is the <em>uncased</em> BERT: its tokenizer lowercases everything and strips accents before splitting. Google also released a <em>cased</em> one. The difference matters more than it sounds:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">cased_tokenizer</span> <span class="o">=</span> <span class="n">AutoTokenizer</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="sh">"</span><span class="s">google-bert/bert-base-cased</span><span class="sh">"</span><span class="p">)</span>
<span class="n">name</span> <span class="o">=</span> <span class="sh">"</span><span class="s">Eufemia Gordillo-Pagès</span><span class="sh">"</span>
<span class="nf">token_chips</span><span class="p">([</span><span class="n">tokenizer</span><span class="p">.</span><span class="nf">tokenize</span><span class="p">(</span><span class="n">name</span><span class="p">),</span> <span class="n">cased_tokenizer</span><span class="p">.</span><span class="nf">tokenize</span><span class="p">(</span><span class="n">name</span><span class="p">)],</span>
            <span class="n">labels</span><span class="o">=</span><span class="p">[</span><span class="sh">"</span><span class="s">uncased</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">cased</span><span class="sh">"</span><span class="p">],</span> <span class="n">max_width</span><span class="o">=</span><span class="mi">620</span><span class="p">)</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/01/output-03.png" alt="Output of the code above" loading="lazy"></p> <p><img class="tfs-output" src="/assets/posts/arch/01/output-04.png" alt="Output of the code above" loading="lazy"></p> <div class="callout callout-warn"> <p class="callout-label">Trap</p> <p>Lowercasing, which helps a model that reads queries typed in a hurry, hurts a model that must find names: the capital letters are gone, and stripping the accent turns the end of a Spanish surname into the English word <em>pages</em>.</p> </div> <p>In section 7 we will look for names, and switch to the cased BERT.</p> <p>Each token becomes the sum of three learned vectors, its word, its position and its segment:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/01/inputs-light.png" width="760" alt="BERT's input for two sentences: each token's vector is the sum of a word embedding, a learned position embedding for positions 0 to 511, and a segment embedding A or B, followed by LayerNorm" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/01/inputs-dark.png" width="760" alt="BERT's input for two sentences: each token's vector is the sum of a word embedding, a learned position embedding for positions 0 to 511, and a segment embedding A or B, followed by LayerNorm" loading="lazy"></p> <h2 id="4-bert-in-pytorch">4. BERT in PyTorch</h2> <p>The embeddings first: three tables, added, normalised. Dropout is part of the model; it is active while training and does nothing in <code class="language-plaintext highlighter-rouge">eval()</code> mode.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">Embeddings</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">words</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">positions</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">max_position_embeddings</span><span class="sh">"</span><span class="p">],</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">segments</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">type_vocab_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">layer_norm_eps</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">dropout</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Dropout</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_dropout_prob</span><span class="sh">"</span><span class="p">])</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">segments</span><span class="p">):</span>
        <span class="n">positions</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="n">device</span><span class="o">=</span><span class="n">ids</span><span class="p">.</span><span class="n">device</span><span class="p">)</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">words</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">positions</span><span class="p">(</span><span class="n">positions</span><span class="p">)</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">segments</span><span class="p">(</span><span class="n">segments</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">dropout</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">norm</span><span class="p">(</span><span class="n">x</span><span class="p">))</span>
</code></pre></div></div> <p><a href="/blog/2026/transformers-from-scratch-02-transformer/">Self-attention</a> is the one from the first course, with one difference that is the whole point: there is no causal mask. Every token attends to every other token. The only mask hides padding, the filler that makes the sentences of a batch equally long.</p> <p><code class="language-plaintext highlighter-rouge">padding</code> is <code class="language-plaintext highlighter-rouge">True</code> at those positions, and their scores become \(-\infty\) before the softmax, so they get zero weight. The layer can also hand back its attention weights, which we will look at in section 6.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">SelfAttention</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">heads</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">q</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">k</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">v</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">out</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">dropout</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Dropout</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">attention_probs_dropout_prob</span><span class="sh">"</span><span class="p">])</span>

    <span class="k">def</span> <span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">batch</span><span class="p">,</span> <span class="n">length</span><span class="p">,</span> <span class="n">d</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="n">shape</span>
        <span class="k">return</span> <span class="n">x</span><span class="p">.</span><span class="nf">view</span><span class="p">(</span><span class="n">batch</span><span class="p">,</span> <span class="n">length</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">,</span> <span class="n">d</span> <span class="o">//</span> <span class="n">self</span><span class="p">.</span><span class="n">heads</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">padding</span><span class="p">,</span> <span class="n">keep_weights</span><span class="o">=</span><span class="bp">False</span><span class="p">):</span>
        <span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">q</span><span class="p">(</span><span class="n">x</span><span class="p">)),</span> <span class="n">self</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">k</span><span class="p">(</span><span class="n">x</span><span class="p">)),</span> <span class="n">self</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">v</span><span class="p">(</span><span class="n">x</span><span class="p">))</span>
        <span class="n">scores</span> <span class="o">=</span> <span class="n">q</span> <span class="o">@</span> <span class="n">k</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">2</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">])</span>
        <span class="n">scores</span> <span class="o">=</span> <span class="n">scores</span><span class="p">.</span><span class="nf">masked_fill</span><span class="p">(</span><span class="n">padding</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:],</span> <span class="nf">float</span><span class="p">(</span><span class="sh">"</span><span class="s">-inf</span><span class="sh">"</span><span class="p">))</span>
        <span class="n">weights</span> <span class="o">=</span> <span class="n">scores</span><span class="p">.</span><span class="nf">softmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">y</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">dropout</span><span class="p">(</span><span class="n">weights</span><span class="p">)</span> <span class="o">@</span> <span class="n">v</span>
        <span class="n">y</span> <span class="o">=</span> <span class="n">y</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">shape</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">out</span><span class="p">(</span><span class="n">y</span><span class="p">),</span> <span class="p">(</span><span class="n">weights</span> <span class="k">if</span> <span class="n">keep_weights</span> <span class="k">else</span> <span class="bp">None</span><span class="p">)</span>
</code></pre></div></div> <p>A layer of BERT normalises <em>after</em> adding the residual, as the 2017 Transformer did; the next lessons’ models moved the norm before. The feed-forward part uses GELU, \(\text{GELU}(x) = x\,\Phi(x)\), where \(\Phi\) is the standard normal distribution function: a ReLU whose corner is smoothed, so that small negative inputs pass a little.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/01/layer-light.png" width="760" alt="One BERT layer: self-attention, dropout, add the input, LayerNorm; then a feed-forward network 768 to 3072 to 768 with GELU, dropout, add, LayerNorm. The norm sits after each addition, on the main path" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/01/layer-dark.png" width="760" alt="One BERT layer: self-attention, dropout, add the input, LayerNorm; then a feed-forward network 768 to 3072 to 768 with GELU, dropout, add, LayerNorm. The norm sits after each addition, on the main path" loading="lazy"></p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">Layer</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span><span class="p">,</span> <span class="n">eps</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">layer_norm_eps</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">attention</span> <span class="o">=</span> <span class="nc">SelfAttention</span><span class="p">(</span><span class="n">config</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm1</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">eps</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">up</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">down</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">intermediate_size</span><span class="sh">"</span><span class="p">],</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm2</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">eps</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">dropout</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Dropout</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_dropout_prob</span><span class="sh">"</span><span class="p">])</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">padding</span><span class="p">,</span> <span class="n">keep_weights</span><span class="o">=</span><span class="bp">False</span><span class="p">):</span>
        <span class="n">a</span><span class="p">,</span> <span class="n">weights</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">attention</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">padding</span><span class="p">,</span> <span class="n">keep_weights</span><span class="p">)</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm1</span><span class="p">(</span><span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">dropout</span><span class="p">(</span><span class="n">a</span><span class="p">))</span>
        <span class="n">f</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">down</span><span class="p">(</span><span class="n">F</span><span class="p">.</span><span class="nf">gelu</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">up</span><span class="p">(</span><span class="n">x</span><span class="p">)))</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm2</span><span class="p">(</span><span class="n">x</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="nf">dropout</span><span class="p">(</span><span class="n">f</span><span class="p">))</span>
        <span class="k">return</span> <span class="n">x</span><span class="p">,</span> <span class="n">weights</span>


<span class="k">class</span> <span class="nc">Bert</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">embeddings</span> <span class="o">=</span> <span class="nc">Embeddings</span><span class="p">(</span><span class="n">config</span><span class="p">)</span>
        <span class="n">n_layers</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">layers</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">ModuleList</span><span class="p">(</span><span class="nc">Layer</span><span class="p">(</span><span class="n">config</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">n_layers</span><span class="p">))</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">segments</span><span class="p">,</span> <span class="n">padding</span><span class="p">,</span> <span class="n">keep_weights</span><span class="o">=</span><span class="bp">False</span><span class="p">):</span>
        <span class="n">x</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">embeddings</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">segments</span><span class="p">)</span>
        <span class="n">attention</span> <span class="o">=</span> <span class="p">[]</span>
        <span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">self</span><span class="p">.</span><span class="n">layers</span><span class="p">:</span>
            <span class="n">x</span><span class="p">,</span> <span class="n">weights</span> <span class="o">=</span> <span class="nf">layer</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">padding</span><span class="p">,</span> <span class="n">keep_weights</span><span class="p">)</span>
            <span class="n">attention</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">weights</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">x</span><span class="p">,</span> <span class="n">attention</span>
</code></pre></div></div> <p>The head that predicts hidden words is small: a dense layer, GELU, LayerNorm, and then a dot product of the result with every row of the word embedding table, plus a bias per word. The table is not copied; the head holds the same <code class="language-plaintext highlighter-rouge">nn.Embedding</code> the model reads with, so training the head trains the embeddings too.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">MaskedLMHead</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">,</span> <span class="n">words</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">d</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">hidden_size</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">dense</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">d</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">norm</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LayerNorm</span><span class="p">(</span><span class="n">d</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">layer_norm_eps</span><span class="sh">"</span><span class="p">])</span>
        <span class="n">self</span><span class="p">.</span><span class="n">words</span> <span class="o">=</span> <span class="n">words</span>  <span class="c1"># the input embeddings, shared
</span>        <span class="n">self</span><span class="p">.</span><span class="n">bias</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Parameter</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">vocab_size</span><span class="sh">"</span><span class="p">]))</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">h</span><span class="p">):</span>
        <span class="n">h</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">norm</span><span class="p">(</span><span class="n">F</span><span class="p">.</span><span class="nf">gelu</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">dense</span><span class="p">(</span><span class="n">h</span><span class="p">)))</span>
        <span class="k">return</span> <span class="n">h</span> <span class="o">@</span> <span class="n">self</span><span class="p">.</span><span class="n">words</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">T</span> <span class="o">+</span> <span class="n">self</span><span class="p">.</span><span class="n">bias</span>


<span class="k">class</span> <span class="nc">MaskedLM</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">config</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">bert</span> <span class="o">=</span> <span class="nc">Bert</span><span class="p">(</span><span class="n">config</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">head</span> <span class="o">=</span> <span class="nc">MaskedLMHead</span><span class="p">(</span><span class="n">config</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">bert</span><span class="p">.</span><span class="n">embeddings</span><span class="p">.</span><span class="n">words</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">segments</span><span class="p">,</span> <span class="n">padding</span><span class="p">):</span>
        <span class="n">h</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">bert</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">segments</span><span class="p">,</span> <span class="n">padding</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">head</span><span class="p">(</span><span class="n">h</span><span class="p">)</span>
</code></pre></div></div> <p>Now the transplant. Our names differ from Google’s, so we write down which of their tensors goes where, load the file and let <code class="language-plaintext highlighter-rouge">load_state_dict</code> refuse anything missing or left over:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">google_names</span><span class="p">(</span><span class="n">config</span><span class="p">):</span>
    <span class="n">names</span> <span class="o">=</span> <span class="p">{</span>
        <span class="sh">"</span><span class="s">bert.embeddings.words.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">bert.embeddings.word_embeddings.weight</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">bert.embeddings.positions.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">bert.embeddings.position_embeddings.weight</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">bert.embeddings.segments.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">bert.embeddings.token_type_embeddings.weight</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">bert.embeddings.norm.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">bert.embeddings.LayerNorm.gamma</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">bert.embeddings.norm.bias</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">bert.embeddings.LayerNorm.beta</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">head.dense.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">cls.predictions.transform.dense.weight</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">head.dense.bias</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">cls.predictions.transform.dense.bias</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">head.norm.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">cls.predictions.transform.LayerNorm.gamma</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">head.norm.bias</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">cls.predictions.transform.LayerNorm.beta</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">head.words.weight</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">bert.embeddings.word_embeddings.weight</span><span class="sh">"</span><span class="p">,</span>  <span class="c1"># the shared table
</span>        <span class="sh">"</span><span class="s">head.bias</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">cls.predictions.bias</span><span class="sh">"</span><span class="p">,</span>
    <span class="p">}</span>
    <span class="n">layer_parts</span> <span class="o">=</span> <span class="p">{</span>
        <span class="sh">"</span><span class="s">attention.q</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention.self.query</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">attention.k</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention.self.key</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">attention.v</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention.self.value</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">attention.out</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention.output.dense</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">up</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">intermediate.dense</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">down</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">output.dense</span><span class="sh">"</span><span class="p">,</span>
    <span class="p">}</span>
    <span class="n">norms</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">norm1</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">attention.output.LayerNorm</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">norm2</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">output.LayerNorm</span><span class="sh">"</span><span class="p">}</span>
    <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">]):</span>
        <span class="n">ours</span><span class="p">,</span> <span class="n">theirs</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">bert.layers.</span><span class="si">{</span><span class="n">i</span><span class="si">}</span><span class="s">.</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="s">bert.encoder.layer.</span><span class="si">{</span><span class="n">i</span><span class="si">}</span><span class="s">.</span><span class="sh">"</span>
        <span class="k">for</span> <span class="n">a</span><span class="p">,</span> <span class="n">b</span> <span class="ow">in</span> <span class="n">layer_parts</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
            <span class="n">names</span><span class="p">[</span><span class="n">ours</span> <span class="o">+</span> <span class="n">a</span> <span class="o">+</span> <span class="sh">"</span><span class="s">.weight</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">theirs</span> <span class="o">+</span> <span class="n">b</span> <span class="o">+</span> <span class="sh">"</span><span class="s">.weight</span><span class="sh">"</span>
            <span class="n">names</span><span class="p">[</span><span class="n">ours</span> <span class="o">+</span> <span class="n">a</span> <span class="o">+</span> <span class="sh">"</span><span class="s">.bias</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">theirs</span> <span class="o">+</span> <span class="n">b</span> <span class="o">+</span> <span class="sh">"</span><span class="s">.bias</span><span class="sh">"</span>
        <span class="k">for</span> <span class="n">a</span><span class="p">,</span> <span class="n">b</span> <span class="ow">in</span> <span class="n">norms</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
            <span class="n">names</span><span class="p">[</span><span class="n">ours</span> <span class="o">+</span> <span class="n">a</span> <span class="o">+</span> <span class="sh">"</span><span class="s">.weight</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">theirs</span> <span class="o">+</span> <span class="n">b</span> <span class="o">+</span> <span class="sh">"</span><span class="s">.gamma</span><span class="sh">"</span>
            <span class="n">names</span><span class="p">[</span><span class="n">ours</span> <span class="o">+</span> <span class="n">a</span> <span class="o">+</span> <span class="sh">"</span><span class="s">.bias</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">theirs</span> <span class="o">+</span> <span class="n">b</span> <span class="o">+</span> <span class="sh">"</span><span class="s">.beta</span><span class="sh">"</span>
    <span class="k">return</span> <span class="n">names</span>


<span class="k">def</span> <span class="nf">load_masked_lm</span><span class="p">(</span><span class="n">repo</span><span class="p">):</span>
    <span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">repo</span><span class="p">,</span> <span class="sh">"</span><span class="s">config.json</span><span class="sh">"</span><span class="p">))</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
        <span class="n">config</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="n">f</span><span class="p">)</span>
    <span class="n">weights</span> <span class="o">=</span> <span class="nf">load_file</span><span class="p">(</span><span class="nf">hf_hub_download</span><span class="p">(</span><span class="n">repo</span><span class="p">,</span> <span class="sh">"</span><span class="s">model.safetensors</span><span class="sh">"</span><span class="p">))</span>
    <span class="n">model</span> <span class="o">=</span> <span class="nc">MaskedLM</span><span class="p">(</span><span class="n">config</span><span class="p">)</span>
    <span class="n">state</span> <span class="o">=</span> <span class="p">{</span><span class="n">ours</span><span class="p">:</span> <span class="n">weights</span><span class="p">[</span><span class="n">theirs</span><span class="p">]</span> <span class="k">for</span> <span class="n">ours</span><span class="p">,</span> <span class="n">theirs</span> <span class="ow">in</span> <span class="nf">google_names</span><span class="p">(</span><span class="n">config</span><span class="p">).</span><span class="nf">items</span><span class="p">()}</span>
    <span class="n">model</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">(</span><span class="n">state</span><span class="p">,</span> <span class="n">strict</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">model</span><span class="p">,</span> <span class="n">config</span>


<span class="n">mlm</span><span class="p">,</span> <span class="n">config</span> <span class="o">=</span> <span class="nf">load_masked_lm</span><span class="p">(</span><span class="n">BERT</span><span class="p">)</span>
<span class="n">mlm</span> <span class="o">=</span> <span class="n">mlm</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">loaded </span><span class="si">{</span><span class="nf">sum</span><span class="p">(</span><span class="n">p</span><span class="p">.</span><span class="nf">numel</span><span class="p">()</span> <span class="k">for</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">mlm</span><span class="p">.</span><span class="nf">parameters</span><span class="p">())</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> parameters into our model</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>loaded 109,514,298 parameters into our model</code></pre> <p>Two of Google’s tensors were not used: the pooler and the next-sentence head, which only the abandoned second game needs. Does our model compute what Google’s does?</p> <p>Hugging Face’s <code class="language-plaintext highlighter-rouge">BertForMaskedLM</code> is the reference implementation. Both models get the same two sentences; we compare the hidden states of the last layer and the scores of every word of the vocabulary at every position:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">reference</span> <span class="o">=</span> <span class="n">BertForMaskedLM</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">BERT</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="n">check</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">([</span><span class="sh">"</span><span class="s">The bank raised its rates.</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">We sat on the river bank, unbothered.</span><span class="sh">"</span><span class="p">],</span>
                  <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="n">padding</span> <span class="o">=</span> <span class="n">check</span><span class="p">[</span><span class="sh">"</span><span class="s">attention_mask</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="mi">0</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">theirs</span> <span class="o">=</span> <span class="nf">reference</span><span class="p">(</span><span class="o">**</span><span class="n">check</span><span class="p">,</span> <span class="n">output_hidden_states</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">hidden</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">mlm</span><span class="p">.</span><span class="nf">bert</span><span class="p">(</span><span class="n">check</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">check</span><span class="p">[</span><span class="sh">"</span><span class="s">token_type_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">padding</span><span class="p">)</span>
    <span class="n">logits</span> <span class="o">=</span> <span class="n">mlm</span><span class="p">.</span><span class="nf">head</span><span class="p">(</span><span class="n">hidden</span><span class="p">)</span>

<span class="n">real</span> <span class="o">=</span> <span class="o">~</span><span class="n">padding</span>  <span class="c1"># padded positions hold numbers nobody reads
</span><span class="n">hidden_gap</span> <span class="o">=</span> <span class="p">(</span><span class="n">hidden</span> <span class="o">-</span> <span class="n">theirs</span><span class="p">.</span><span class="n">hidden_states</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">])[</span><span class="n">real</span><span class="p">].</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
<span class="n">logits_gap</span> <span class="o">=</span> <span class="p">(</span><span class="n">logits</span> <span class="o">-</span> <span class="n">theirs</span><span class="p">.</span><span class="n">logits</span><span class="p">)[</span><span class="n">real</span><span class="p">].</span><span class="nf">abs</span><span class="p">().</span><span class="nf">max</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">largest difference, hidden states: </span><span class="si">{</span><span class="n">hidden_gap</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">largest difference, word scores:   </span><span class="si">{</span><span class="n">logits_gap</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">e</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="k">assert</span> <span class="n">hidden_gap</span> <span class="o">&lt;</span> <span class="mf">1e-3</span> <span class="ow">and</span> <span class="n">logits_gap</span> <span class="o">&lt;</span> <span class="mf">1e-2</span>
<span class="k">del</span> <span class="n">reference</span>
</code></pre></div></div> <pre class="tfs-printed"><code>largest difference, hidden states: 8.4e-05
largest difference, word scores:   1.1e-04</code></pre> <p>The differences are rounding: the two implementations add the same numbers in a different order. Our sixty lines are BERT.</p> <h2 id="5-filling-in-the-blanks">5. Filling in the blanks</h2> <p>Pre-training picks 15% of the tokens of every sequence at random, never <code class="language-plaintext highlighter-rouge">[CLS]</code> or <code class="language-plaintext highlighter-rouge">[SEP]</code>, and asks the model to restore them. If every picked token became <code class="language-plaintext highlighter-rouge">[MASK]</code>, the model would learn something slightly wrong: that only <code class="language-plaintext highlighter-rouge">[MASK]</code> positions need predicting, while in fine-tuning <code class="language-plaintext highlighter-rouge">[MASK]</code> never appears.</p> <p>The paper calls this “a mismatch between pre-training and fine-tuning” and softens it with a rule that every BERT-like model has copied since: of the picked tokens, 80% become <code class="language-plaintext highlighter-rouge">[MASK]</code>, 10% become a random token, and 10% stay as they are.</p> <p>The model never knows which tokens are real, so it has to keep a good guess for every position.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/01/masking-light.png" width="760" alt="The 80/10/10 rule. Of all tokens, 15% are picked for prediction. Of those, 80% are replaced with the MASK token, 10% with a random word, and 10% are left unchanged; the model must predict the original word at all of them" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/01/masking-dark.png" width="760" alt="The 80/10/10 rule. Of all tokens, 15% are picked for prediction. Of those, 80% are replaced with the MASK token, 10% with a random word, and 10% are left unchanged; the model must predict the original word at all of them" loading="lazy"></p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">mask_tokens</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">special</span><span class="p">,</span> <span class="n">generator</span><span class="p">,</span> <span class="n">rate</span><span class="o">=</span><span class="mf">0.15</span><span class="p">):</span>
    <span class="n">chosen</span> <span class="o">=</span> <span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">rand</span><span class="p">(</span><span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">,</span> <span class="n">generator</span><span class="o">=</span><span class="n">generator</span><span class="p">)</span> <span class="o">&lt;</span> <span class="n">rate</span><span class="p">)</span> <span class="o">&amp;</span> <span class="o">~</span><span class="n">special</span>
    <span class="n">labels</span> <span class="o">=</span> <span class="n">ids</span><span class="p">.</span><span class="nf">clone</span><span class="p">()</span>
    <span class="n">labels</span><span class="p">[</span><span class="o">~</span><span class="n">chosen</span><span class="p">]</span> <span class="o">=</span> <span class="o">-</span><span class="mi">100</span>  <span class="c1"># the loss ignores positions that weren't picked
</span>    <span class="n">roll</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">rand</span><span class="p">(</span><span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">,</span> <span class="n">generator</span><span class="o">=</span><span class="n">generator</span><span class="p">)</span>
    <span class="n">masked</span> <span class="o">=</span> <span class="n">ids</span><span class="p">.</span><span class="nf">clone</span><span class="p">()</span>
    <span class="n">masked</span><span class="p">[</span><span class="n">chosen</span> <span class="o">&amp;</span> <span class="p">(</span><span class="n">roll</span> <span class="o">&lt;</span> <span class="mf">0.8</span><span class="p">)]</span> <span class="o">=</span> <span class="n">tokenizer</span><span class="p">.</span><span class="n">mask_token_id</span>
    <span class="n">swap</span> <span class="o">=</span> <span class="n">chosen</span> <span class="o">&amp;</span> <span class="p">(</span><span class="n">roll</span> <span class="o">&gt;=</span> <span class="mf">0.8</span><span class="p">)</span> <span class="o">&amp;</span> <span class="p">(</span><span class="n">roll</span> <span class="o">&lt;</span> <span class="mf">0.9</span><span class="p">)</span>
    <span class="n">random_ids</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">randint</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">tokenizer</span><span class="p">),</span> <span class="n">ids</span><span class="p">.</span><span class="n">shape</span><span class="p">,</span> <span class="n">generator</span><span class="o">=</span><span class="n">generator</span><span class="p">)</span>
    <span class="n">masked</span><span class="p">[</span><span class="n">swap</span><span class="p">]</span> <span class="o">=</span> <span class="n">random_ids</span><span class="p">[</span><span class="n">swap</span><span class="p">]</span>
    <span class="k">return</span> <span class="n">masked</span><span class="p">,</span> <span class="n">labels</span>


<span class="n">TEXT</span> <span class="o">=</span> <span class="p">(</span><span class="sh">"</span><span class="s">In October 2019 Google changed the way its search engine reads queries. The old </span><span class="sh">"</span>
        <span class="sh">"</span><span class="s">system treated the little word to as noise and returned results about American </span><span class="sh">"</span>
        <span class="sh">"</span><span class="s">citizens travelling to Brazil, which is the other way around. The new one </span><span class="sh">"</span>
        <span class="sh">"</span><span class="s">understood that the traveller goes from Brazil to the United States.</span><span class="sh">"</span><span class="p">)</span>
<span class="n">encoded</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="n">TEXT</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">,</span> <span class="n">return_special_tokens_mask</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">ids</span> <span class="o">=</span> <span class="n">encoded</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">]</span>
<span class="n">special</span> <span class="o">=</span> <span class="n">encoded</span><span class="p">[</span><span class="sh">"</span><span class="s">special_tokens_mask</span><span class="sh">"</span><span class="p">].</span><span class="nf">bool</span><span class="p">()</span>
<span class="n">generator</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nc">Generator</span><span class="p">().</span><span class="nf">manual_seed</span><span class="p">(</span><span class="mi">7</span><span class="p">)</span>
<span class="n">masked</span><span class="p">,</span> <span class="n">labels</span> <span class="o">=</span> <span class="nf">mask_tokens</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">special</span><span class="p">,</span> <span class="n">generator</span><span class="p">)</span>
<span class="n">before</span> <span class="o">=</span> <span class="n">tokenizer</span><span class="p">.</span><span class="nf">convert_ids_to_tokens</span><span class="p">(</span><span class="n">ids</span><span class="p">[</span><span class="mi">0</span><span class="p">])</span>
<span class="n">after</span> <span class="o">=</span> <span class="n">tokenizer</span><span class="p">.</span><span class="nf">convert_ids_to_tokens</span><span class="p">(</span><span class="n">masked</span><span class="p">[</span><span class="mi">0</span><span class="p">])</span>
<span class="nf">token_chips</span><span class="p">([</span><span class="n">before</span><span class="p">,</span> <span class="n">after</span><span class="p">],</span> <span class="n">labels</span><span class="o">=</span><span class="p">[</span><span class="sh">"</span><span class="s">original</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">input</span><span class="sh">"</span><span class="p">],</span> <span class="n">max_width</span><span class="o">=</span><span class="mi">640</span><span class="p">,</span>
            <span class="n">strong</span><span class="o">=</span><span class="k">lambda</span> <span class="n">row</span><span class="p">,</span> <span class="n">col</span><span class="p">,</span> <span class="n">token</span><span class="p">:</span> <span class="nf">bool</span><span class="p">(</span><span class="n">labels</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="n">col</span><span class="p">]</span> <span class="o">!=</span> <span class="o">-</span><span class="mi">100</span><span class="p">))</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/01/output-05.png" alt="Output of the code above" loading="lazy"></p> <p><img class="tfs-output" src="/assets/posts/arch/01/output-06.png" alt="Output of the code above" loading="lazy"></p> <p>The highlighted positions are the ones the loss looks at: some became <code class="language-plaintext highlighter-rouge">[MASK]</code>, and with this many tokens you may also see a word replaced by a random one, or a picked word left alone. Over many sequences the shares settle at what the rule says:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">many</span> <span class="o">=</span> <span class="n">ids</span><span class="p">.</span><span class="nf">repeat</span><span class="p">(</span><span class="mi">4000</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
<span class="n">masked_many</span><span class="p">,</span> <span class="n">labels_many</span> <span class="o">=</span> <span class="nf">mask_tokens</span><span class="p">(</span><span class="n">many</span><span class="p">,</span> <span class="n">special</span><span class="p">.</span><span class="nf">repeat</span><span class="p">(</span><span class="mi">4000</span><span class="p">,</span> <span class="mi">1</span><span class="p">),</span> <span class="n">generator</span><span class="p">)</span>
<span class="n">picked</span> <span class="o">=</span> <span class="n">labels_many</span> <span class="o">!=</span> <span class="o">-</span><span class="mi">100</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">picked for prediction: </span><span class="si">{</span><span class="n">picked</span><span class="p">.</span><span class="nf">float</span><span class="p">().</span><span class="nf">mean</span><span class="p">()</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="s"> of all tokens</span><span class="sh">"</span><span class="p">)</span>
<span class="n">became_mask</span> <span class="o">=</span> <span class="p">(</span><span class="n">masked_many</span><span class="p">[</span><span class="n">picked</span><span class="p">]</span> <span class="o">==</span> <span class="n">tokenizer</span><span class="p">.</span><span class="n">mask_token_id</span><span class="p">).</span><span class="nf">float</span><span class="p">().</span><span class="nf">mean</span><span class="p">()</span>
<span class="n">unchanged</span> <span class="o">=</span> <span class="p">(</span><span class="n">masked_many</span><span class="p">[</span><span class="n">picked</span><span class="p">]</span> <span class="o">==</span> <span class="n">many</span><span class="p">[</span><span class="n">picked</span><span class="p">]).</span><span class="nf">float</span><span class="p">().</span><span class="nf">mean</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">  became [MASK]:   </span><span class="si">{</span><span class="n">became_mask</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">  left unchanged:  </span><span class="si">{</span><span class="n">unchanged</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">  became another:  </span><span class="si">{</span><span class="mi">1</span> <span class="o">-</span> <span class="n">became_mask</span> <span class="o">-</span> <span class="n">unchanged</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>picked for prediction: 14.4% of all tokens
  became [MASK]:   79.9%
  left unchanged:  10.3%
  became another:  9.9%</code></pre> <p>A random replacement can occasionally draw the original word back, so “left unchanged” comes out a hair above 10%. Google’s own data generator picked exactly 15% of each sequence rather than tossing a coin per token; the coin is what most libraries do today, and it makes no difference that anyone has measured.</p> <p>The share picked is a little under 15% because <code class="language-plaintext highlighter-rouge">[CLS]</code> and <code class="language-plaintext highlighter-rouge">[SEP]</code> are never picked.</p> <p>The loss is cross-entropy over the vocabulary at the picked positions. On a text BERT has never seen, the first paragraph of this lesson, here is what four days of pre-training bought, against the same network as it was before training: weights drawn at random with a standard deviation of 0.02, the way BERT’s were initialised.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">masked_lm_loss</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">special</span><span class="p">,</span> <span class="n">repeats</span><span class="o">=</span><span class="mi">20</span><span class="p">):</span>
    <span class="n">generator</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nc">Generator</span><span class="p">().</span><span class="nf">manual_seed</span><span class="p">(</span><span class="mi">0</span><span class="p">)</span>
    <span class="n">losses</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">repeats</span><span class="p">):</span>
        <span class="n">masked</span><span class="p">,</span> <span class="n">labels</span> <span class="o">=</span> <span class="nf">mask_tokens</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">special</span><span class="p">,</span> <span class="n">generator</span><span class="p">)</span>
        <span class="n">segments</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros_like</span><span class="p">(</span><span class="n">masked</span><span class="p">)</span>
        <span class="n">padding</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros_like</span><span class="p">(</span><span class="n">masked</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">)</span>
        <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
            <span class="n">logits</span> <span class="o">=</span> <span class="nf">model</span><span class="p">(</span><span class="n">masked</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">),</span> <span class="n">segments</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">),</span> <span class="n">padding</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">))</span>
        <span class="n">loss</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span><span class="n">logits</span><span class="p">.</span><span class="nf">view</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="n">logits</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]).</span><span class="nf">float</span><span class="p">(),</span>
                               <span class="n">labels</span><span class="p">.</span><span class="nf">view</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">),</span> <span class="n">ignore_index</span><span class="o">=-</span><span class="mi">100</span><span class="p">)</span>
        <span class="n">losses</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">loss</span><span class="p">.</span><span class="nf">item</span><span class="p">())</span>
    <span class="k">return</span> <span class="nf">sum</span><span class="p">(</span><span class="n">losses</span><span class="p">)</span> <span class="o">/</span> <span class="nf">len</span><span class="p">(</span><span class="n">losses</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">init_like_bert</span><span class="p">(</span><span class="n">module</span><span class="p">):</span>  <span class="c1"># how BERT started: small random weights
</span>    <span class="k">if</span> <span class="nf">isinstance</span><span class="p">(</span><span class="n">module</span><span class="p">,</span> <span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Linear</span><span class="p">,</span> <span class="n">nn</span><span class="p">.</span><span class="n">Embedding</span><span class="p">)):</span>
        <span class="n">nn</span><span class="p">.</span><span class="n">init</span><span class="p">.</span><span class="nf">normal_</span><span class="p">(</span><span class="n">module</span><span class="p">.</span><span class="n">weight</span><span class="p">,</span> <span class="n">std</span><span class="o">=</span><span class="mf">0.02</span><span class="p">)</span>
    <span class="k">if</span> <span class="nf">isinstance</span><span class="p">(</span><span class="n">module</span><span class="p">,</span> <span class="n">nn</span><span class="p">.</span><span class="n">Linear</span><span class="p">)</span> <span class="ow">and</span> <span class="n">module</span><span class="p">.</span><span class="n">bias</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
        <span class="n">nn</span><span class="p">.</span><span class="n">init</span><span class="p">.</span><span class="nf">zeros_</span><span class="p">(</span><span class="n">module</span><span class="p">.</span><span class="n">bias</span><span class="p">)</span>
    <span class="k">if</span> <span class="nf">isinstance</span><span class="p">(</span><span class="n">module</span><span class="p">,</span> <span class="n">nn</span><span class="p">.</span><span class="n">LayerNorm</span><span class="p">):</span>
        <span class="n">nn</span><span class="p">.</span><span class="n">init</span><span class="p">.</span><span class="nf">ones_</span><span class="p">(</span><span class="n">module</span><span class="p">.</span><span class="n">weight</span><span class="p">)</span>
        <span class="n">nn</span><span class="p">.</span><span class="n">init</span><span class="p">.</span><span class="nf">zeros_</span><span class="p">(</span><span class="n">module</span><span class="p">.</span><span class="n">bias</span><span class="p">)</span>


<span class="n">untrained</span> <span class="o">=</span> <span class="nc">MaskedLM</span><span class="p">(</span><span class="n">config</span><span class="p">)</span>
<span class="n">untrained</span><span class="p">.</span><span class="nf">apply</span><span class="p">(</span><span class="n">init_like_bert</span><span class="p">)</span>
<span class="n">untrained</span> <span class="o">=</span> <span class="n">untrained</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">).</span><span class="nf">eval</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">random weights:  loss </span><span class="si">{</span><span class="nf">masked_lm_loss</span><span class="p">(</span><span class="n">untrained</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">special</span><span class="p">)</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">BERT</span><span class="sh">'</span><span class="s">s weights:  loss </span><span class="si">{</span><span class="nf">masked_lm_loss</span><span class="p">(</span><span class="n">mlm</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">special</span><span class="p">)</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">guessing uniformly among </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">tokenizer</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> tokens: </span><span class="si">{</span><span class="n">math</span><span class="p">.</span><span class="nf">log</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">tokenizer</span><span class="p">))</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
<span class="k">del</span> <span class="n">untrained</span>
</code></pre></div></div> <pre class="tfs-printed"><code>random weights:  loss 10.33
BERT's weights:  loss 3.00
guessing uniformly among 30,522 tokens: 10.33</code></pre> <p>A loss of \(L\) means the model gives the right word a probability of \(e^{-L}\) on average, in the geometric sense. The untrained network is no better than picking from the dictionary blindfolded.</p> <p class="takeaway">Four days of pre-training took the loss from 10.33 to 3.00: BERT gives the hidden word a sizeable probability most of the time, on a text written years after it was trained.</p> <p>That makes BERT a strange kind of oracle: ask it to fill a blank, and you see what it absorbed from books and Wikipedia. Petroni and colleagues used exactly this to show that BERT holds “relational knowledge competitive with traditional NLP methods”<sup class="cite">[<a href="#ref-6" id="cite-6" data-ref="6" aria-label="Reference 6: Petroni, F., Rocktäschel, T., Lewis, P., Bakhtin, A., Wu, Y., Miller, A. H., &amp; Riedel, S. (2019). Language models as knowledge bases? EMNLP 2019.">6</a>]</sup>. Our own probes:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">fill_mask</span><span class="p">(</span><span class="n">text</span><span class="p">,</span> <span class="n">k</span><span class="o">=</span><span class="mi">3</span><span class="p">):</span>
    <span class="n">batch</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="n">text</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="n">padding</span> <span class="o">=</span> <span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">attention_mask</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="mi">0</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="n">logits</span> <span class="o">=</span> <span class="nf">mlm</span><span class="p">(</span><span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">token_type_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">padding</span><span class="p">)</span>
    <span class="n">where</span> <span class="o">=</span> <span class="p">(</span><span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">][</span><span class="mi">0</span><span class="p">]</span> <span class="o">==</span> <span class="n">tokenizer</span><span class="p">.</span><span class="n">mask_token_id</span><span class="p">).</span><span class="nf">nonzero</span><span class="p">()[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">]</span>
    <span class="n">probs</span> <span class="o">=</span> <span class="n">logits</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="n">where</span><span class="p">].</span><span class="nf">float</span><span class="p">().</span><span class="nf">softmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">top</span> <span class="o">=</span> <span class="n">probs</span><span class="p">.</span><span class="nf">topk</span><span class="p">(</span><span class="n">k</span><span class="p">)</span>
    <span class="n">words</span> <span class="o">=</span> <span class="n">tokenizer</span><span class="p">.</span><span class="nf">convert_ids_to_tokens</span><span class="p">(</span><span class="n">top</span><span class="p">.</span><span class="n">indices</span><span class="p">.</span><span class="nf">tolist</span><span class="p">())</span>
    <span class="k">return</span> <span class="sh">"</span><span class="s">, </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">w</span><span class="si">}</span><span class="s"> </span><span class="si">{</span><span class="n">p</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="o">%</span><span class="si">}</span><span class="sh">"</span> <span class="k">for</span> <span class="n">w</span><span class="p">,</span> <span class="n">p</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">words</span><span class="p">,</span> <span class="n">top</span><span class="p">.</span><span class="n">values</span><span class="p">.</span><span class="nf">tolist</span><span class="p">()))</span>


<span class="n">PROBES</span> <span class="o">=</span> <span class="p">[</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">a fact</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">The capital of Portugal is [MASK].</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">a fact</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Dante was born in [MASK].</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">common sense</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">You cut bread with a [MASK].</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">grammar</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">The keys to the old cabinet [MASK] on the kitchen table.</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">grammar</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">The key to the old cabinets [MASK] on the kitchen table.</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">negation</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">A robin is a [MASK].</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">negation</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">A robin is not a [MASK].</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">negation</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Birds can [MASK].</span><span class="sh">"</span><span class="p">),</span>
    <span class="p">(</span><span class="sh">"</span><span class="s">negation</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Birds cannot [MASK].</span><span class="sh">"</span><span class="p">),</span>
<span class="p">]</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">({</span><span class="sh">"</span><span class="s">probe</span><span class="sh">"</span><span class="p">:</span> <span class="p">[</span><span class="n">kind</span> <span class="k">for</span> <span class="n">kind</span><span class="p">,</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">PROBES</span><span class="p">],</span>
                    <span class="sh">"</span><span class="s">sentence</span><span class="sh">"</span><span class="p">:</span> <span class="p">[</span><span class="n">text</span> <span class="k">for</span> <span class="n">_</span><span class="p">,</span> <span class="n">text</span> <span class="ow">in</span> <span class="n">PROBES</span><span class="p">],</span>
                    <span class="sh">"</span><span class="s">BERT</span><span class="sh">'</span><span class="s">s top three</span><span class="sh">"</span><span class="p">:</span> <span class="p">[</span><span class="nf">fill_mask</span><span class="p">(</span><span class="n">text</span><span class="p">)</span> <span class="k">for</span> <span class="n">_</span><span class="p">,</span> <span class="n">text</span> <span class="ow">in</span> <span class="n">PROBES</span><span class="p">]}))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">probe</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">sentence</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">BERT's top three</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">a fact</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">The capital of Portugal is [MASK].</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">lisbon 73%, porto 20%, madeira 0%</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">a fact</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Dante was born in [MASK].</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">rome 5%, paris 4%, london 2%</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">common sense</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">You cut bread with a [MASK].</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">knife 72%, stick 8%, fork 4%</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">grammar</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">The keys to the old cabinet [MASK] on the kitchen table.</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">were 52%, sat 17%, lay 12%</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">grammar</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">The key to the old cabinets [MASK] on the kitchen table.</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">was 41%, lay 18%, sat 18%</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">negation</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">A robin is a [MASK].</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">robin 38%, bird 32%, pigeon 1%</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">negation</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">A robin is not a [MASK].</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">robin 57%, bird 10%, pigeon 1%</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">negation</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Birds can [MASK].</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">fly 19%, sing 9%, breed 8%</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">negation</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">Birds cannot [MASK].</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">fly 37%, sing 10%, escape 3%</td></tr></tbody></table></div> <p>The knowledge is patchy in a revealing way. BERT is sure about Lisbon and the knife, and has no idea where Dante was born: a fact that is stated less often in so many words.</p> <p>The grammar is right, and it is the impressive row. The verb agrees with <em>keys</em> or <em>key</em>, the subject, and not with <em>cabinet</em> or <em>cabinets</em>, the noun right next to it, so the model must know which word the verb belongs to.</p> <p>Negation is where it breaks. To BERT a robin is above all a robin, and it is <em>more</em> sure that birds cannot fly than that they can.</p> <p>Kassner and Schütze found this across models and put it in the title of their paper, “Birds Can Talk, But Cannot Fly”: pre-trained models “do not distinguish between negated (‘Birds cannot [MASK]’) and non-negated (‘Birds can [MASK]’) cloze questions”<sup class="cite">[<a href="#ref-7" id="cite-7" data-ref="7" aria-label="Reference 7: Kassner, N., &amp; Schütze, H. (2020). Negated and misprimed probes for pretrained language models: birds can talk, but cannot fly. ACL 2020.">7</a>]</sup>.</p> <p>Filling a blank rewards knowing which words go together, and <em>birds</em> and <em>fly</em> go together whether or not there is a <em>not</em> between them.</p> <p>The same oracle shows what else came with the books. Give BERT a sentence about a person with a job and ask for the pronoun:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">JOBS</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">nurse</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">receptionist</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">secretary</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">librarian</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">hairdresser</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">teacher</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">cashier</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">baker</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">accountant</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">doctor</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">lawyer</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">scientist</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">programmer</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">engineer</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">pilot</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">mechanic</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">carpenter</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">surgeon</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">firefighter</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">farmer</span><span class="sh">"</span><span class="p">]</span>
<span class="n">he</span><span class="p">,</span> <span class="n">she</span> <span class="o">=</span> <span class="n">tokenizer</span><span class="p">.</span><span class="nf">convert_tokens_to_ids</span><span class="p">([</span><span class="sh">"</span><span class="s">he</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">she</span><span class="sh">"</span><span class="p">])</span>
<span class="n">shares</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">job</span> <span class="ow">in</span> <span class="n">JOBS</span><span class="p">:</span>
    <span class="n">sentence</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">the </span><span class="si">{</span><span class="n">job</span><span class="si">}</span><span class="s"> said that [MASK] would be late.</span><span class="sh">"</span>
    <span class="n">batch</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="n">sentence</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="n">padding</span> <span class="o">=</span> <span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">attention_mask</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="mi">0</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="n">logits</span> <span class="o">=</span> <span class="nf">mlm</span><span class="p">(</span><span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">token_type_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">padding</span><span class="p">)</span>
    <span class="n">where</span> <span class="o">=</span> <span class="p">(</span><span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">][</span><span class="mi">0</span><span class="p">]</span> <span class="o">==</span> <span class="n">tokenizer</span><span class="p">.</span><span class="n">mask_token_id</span><span class="p">).</span><span class="nf">nonzero</span><span class="p">()[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">]</span>
    <span class="n">probs</span> <span class="o">=</span> <span class="n">logits</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="n">where</span><span class="p">].</span><span class="nf">float</span><span class="p">().</span><span class="nf">softmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">shares</span><span class="p">[</span><span class="n">job</span><span class="p">]</span> <span class="o">=</span> <span class="p">(</span><span class="n">probs</span><span class="p">[</span><span class="n">she</span><span class="p">]</span> <span class="o">/</span> <span class="p">(</span><span class="n">probs</span><span class="p">[</span><span class="n">he</span><span class="p">]</span> <span class="o">+</span> <span class="n">probs</span><span class="p">[</span><span class="n">she</span><span class="p">])).</span><span class="nf">item</span><span class="p">()</span>

<span class="n">order</span> <span class="o">=</span> <span class="nf">sorted</span><span class="p">(</span><span class="n">shares</span><span class="p">,</span> <span class="n">key</span><span class="o">=</span><span class="n">shares</span><span class="p">.</span><span class="n">get</span><span class="p">)</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.4</span><span class="p">,</span> <span class="mf">5.2</span><span class="p">))</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">barh</span><span class="p">(</span><span class="n">order</span><span class="p">,</span> <span class="p">[</span><span class="n">shares</span><span class="p">[</span><span class="n">j</span><span class="p">]</span> <span class="k">for</span> <span class="n">j</span> <span class="ow">in</span> <span class="n">order</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">att</span><span class="sh">"</span><span class="p">])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">axvline</span><span class="p">(</span><span class="mf">0.5</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">muted</span><span class="sh">"</span><span class="p">],</span> <span class="n">linewidth</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">linestyle</span><span class="o">=</span><span class="sh">"</span><span class="s">--</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlim</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">“The ___ said that [MASK] would be late”: she or he?</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">P(she) / (P(she) + P(he))</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">grid</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="sh">"</span><span class="s">y</span><span class="sh">"</span><span class="p">,</span> <span class="n">visible</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/01/output-07.png" alt="“The ___ said that [MASK] would be late”: she or he?" loading="lazy"></p> <p>Nothing in the sentence says anything about the person’s gender, and the dashed line is where a model with no opinion would put every job. BERT has opinions.</p> <p>Receptionists, nurses and hairdressers are <em>she</em>; engineers, pilots and programmers are <em>he</em>; and most jobs, the doctor and the teacher among them, lean <em>he</em>. These are the statistics of its training text.</p> <p>Kurita and colleagues measured them this way, with templates and the masked word’s probabilities, and showed that such associations carry into the models fine-tuned from BERT <sup class="cite">[<a href="#ref-8" id="cite-8" data-ref="8" aria-label="Reference 8: Kurita, K., Vyas, N., Pareek, A., Black, A. W., &amp; Tsvetkov, Y. (2019). Measuring bias in contextualized word representations. 1st Workshop on Gender Bias in Natural Language Processing.">8</a>]</sup>. It is worth remembering when a BERT-based classifier screens CVs.</p> <h2 id="6-what-the-heads-look-at">6. What the heads look at</h2> <p>BERT-base has 144 attention heads, 12 in each of 12 layers, and nobody told any of them what to do.</p> <p>Clark and colleagues looked at all of them and found heads attending “to delimiter tokens, specific positional offsets, or broadly attending over the whole sentence”, and some that “correspond well to linguistic notions of syntax and coreference”<sup class="cite">[<a href="#ref-9" id="cite-9" data-ref="9" aria-label="Reference 9: Clark, K., Khandelwal, U., Levy, O., &amp; Manning, C. D. (2019). What does BERT look at? An analysis of BERT's attention. BlackboxNLP 2019.">9</a>]</sup>.</p> <p>Our model hands back its attention weights, so we can measure the same thing on a few hundred sentences of Wikipedia: for every head, how much of its attention goes to <code class="language-plaintext highlighter-rouge">[CLS]</code>, to <code class="language-plaintext highlighter-rouge">[SEP]</code>, to the previous token and to the next one, averaged over all real tokens.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">wiki</span> <span class="o">=</span> <span class="nf">load_dataset</span><span class="p">(</span><span class="sh">"</span><span class="s">Salesforce/wikitext</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">wikitext-2-raw-v1</span><span class="sh">"</span><span class="p">,</span> <span class="n">split</span><span class="o">=</span><span class="sh">"</span><span class="s">test</span><span class="sh">"</span><span class="p">)</span>
<span class="n">sentences</span> <span class="o">=</span> <span class="p">[</span><span class="n">line</span><span class="p">.</span><span class="nf">strip</span><span class="p">()</span> <span class="k">for</span> <span class="n">line</span> <span class="ow">in</span> <span class="n">wiki</span><span class="p">[</span><span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">]</span> <span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="n">line</span><span class="p">.</span><span class="nf">strip</span><span class="p">())</span> <span class="o">&gt;</span> <span class="mi">200</span><span class="p">]</span>
<span class="n">sentences</span> <span class="o">=</span> <span class="n">sentences</span><span class="p">[:</span><span class="mi">32</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">320</span><span class="p">]</span>

<span class="n">layers</span><span class="p">,</span> <span class="n">heads</span> <span class="o">=</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_hidden_layers</span><span class="sh">"</span><span class="p">],</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">num_attention_heads</span><span class="sh">"</span><span class="p">]</span>
<span class="n">TARGETS</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">[CLS]</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">[SEP]</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">previous</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">next</span><span class="sh">"</span><span class="p">]</span>
<span class="n">totals</span> <span class="o">=</span> <span class="p">{</span><span class="n">name</span><span class="p">:</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">layers</span><span class="p">,</span> <span class="n">heads</span><span class="p">)</span> <span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">TARGETS</span><span class="p">}</span>
<span class="n">count</span> <span class="o">=</span> <span class="mi">0</span>
<span class="k">for</span> <span class="n">start</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">sentences</span><span class="p">),</span> <span class="mi">32</span><span class="p">):</span>
    <span class="n">batch</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="n">sentences</span><span class="p">[</span><span class="n">start</span><span class="p">:</span><span class="n">start</span> <span class="o">+</span> <span class="mi">32</span><span class="p">],</span> <span class="n">padding</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">truncation</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
                      <span class="n">max_length</span><span class="o">=</span><span class="mi">128</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
    <span class="n">padding</span> <span class="o">=</span> <span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">attention_mask</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="mi">0</span>
    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
        <span class="n">_</span><span class="p">,</span> <span class="n">attention</span> <span class="o">=</span> <span class="n">mlm</span><span class="p">.</span><span class="nf">bert</span><span class="p">(</span><span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">token_type_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">padding</span><span class="p">,</span>
                                <span class="n">keep_weights</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">weights</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">(</span><span class="n">attention</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">).</span><span class="nf">float</span><span class="p">()</span>  <span class="c1"># batch, layer, head, query, key
</span>    <span class="n">real</span> <span class="o">=</span> <span class="p">(</span><span class="o">~</span><span class="n">padding</span><span class="p">).</span><span class="nf">float</span><span class="p">()</span>
    <span class="n">is_sep</span> <span class="o">=</span> <span class="p">(</span><span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="n">tokenizer</span><span class="p">.</span><span class="n">sep_token_id</span><span class="p">).</span><span class="nf">float</span><span class="p">()</span>
    <span class="n">to_cls</span> <span class="o">=</span> <span class="n">weights</span><span class="p">[...,</span> <span class="mi">0</span><span class="p">]</span>
    <span class="n">to_sep</span> <span class="o">=</span> <span class="p">(</span><span class="n">weights</span> <span class="o">*</span> <span class="n">is_sep</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:]).</span><span class="nf">sum</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">to_prev</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">diagonal</span><span class="p">(</span><span class="n">weights</span><span class="p">,</span> <span class="n">offset</span><span class="o">=-</span><span class="mi">1</span><span class="p">,</span> <span class="n">dim1</span><span class="o">=-</span><span class="mi">2</span><span class="p">,</span> <span class="n">dim2</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">to_next</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">diagonal</span><span class="p">(</span><span class="n">weights</span><span class="p">,</span> <span class="n">offset</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">dim1</span><span class="o">=-</span><span class="mi">2</span><span class="p">,</span> <span class="n">dim2</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">totals</span><span class="p">[</span><span class="sh">"</span><span class="s">[CLS]</span><span class="sh">"</span><span class="p">]</span> <span class="o">+=</span> <span class="p">(</span><span class="n">to_cls</span> <span class="o">*</span> <span class="n">real</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:]).</span><span class="nf">sum</span><span class="p">((</span><span class="mi">0</span><span class="p">,</span> <span class="mi">3</span><span class="p">)).</span><span class="nf">cpu</span><span class="p">()</span>
    <span class="n">totals</span><span class="p">[</span><span class="sh">"</span><span class="s">[SEP]</span><span class="sh">"</span><span class="p">]</span> <span class="o">+=</span> <span class="p">(</span><span class="n">to_sep</span> <span class="o">*</span> <span class="n">real</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:]).</span><span class="nf">sum</span><span class="p">((</span><span class="mi">0</span><span class="p">,</span> <span class="mi">3</span><span class="p">)).</span><span class="nf">cpu</span><span class="p">()</span>
    <span class="n">totals</span><span class="p">[</span><span class="sh">"</span><span class="s">previous</span><span class="sh">"</span><span class="p">]</span> <span class="o">+=</span> <span class="p">(</span><span class="n">to_prev</span> <span class="o">*</span> <span class="n">real</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="mi">1</span><span class="p">:]).</span><span class="nf">sum</span><span class="p">((</span><span class="mi">0</span><span class="p">,</span> <span class="mi">3</span><span class="p">)).</span><span class="nf">cpu</span><span class="p">()</span>
    <span class="n">totals</span><span class="p">[</span><span class="sh">"</span><span class="s">next</span><span class="sh">"</span><span class="p">]</span> <span class="o">+=</span> <span class="p">(</span><span class="n">to_next</span> <span class="o">*</span> <span class="n">real</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:</span><span class="o">-</span><span class="mi">1</span><span class="p">]).</span><span class="nf">sum</span><span class="p">((</span><span class="mi">0</span><span class="p">,</span> <span class="mi">3</span><span class="p">)).</span><span class="nf">cpu</span><span class="p">()</span>
    <span class="n">count</span> <span class="o">+=</span> <span class="n">real</span><span class="p">.</span><span class="nf">sum</span><span class="p">().</span><span class="nf">item</span><span class="p">()</span>
<span class="n">shares_by_head</span> <span class="o">=</span> <span class="p">{</span><span class="n">name</span><span class="p">:</span> <span class="p">(</span><span class="n">value</span> <span class="o">/</span> <span class="n">count</span><span class="p">).</span><span class="nf">numpy</span><span class="p">()</span> <span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">value</span> <span class="ow">in</span> <span class="n">totals</span><span class="p">.</span><span class="nf">items</span><span class="p">()}</span>

<span class="n">fig</span><span class="p">,</span> <span class="n">axes</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">4</span><span class="p">,</span> <span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">12</span><span class="p">,</span> <span class="mf">3.6</span><span class="p">))</span>
<span class="k">for</span> <span class="n">ax</span><span class="p">,</span> <span class="p">(</span><span class="n">name</span><span class="p">,</span> <span class="n">values</span><span class="p">)</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">axes</span><span class="p">,</span> <span class="n">shares_by_head</span><span class="p">.</span><span class="nf">items</span><span class="p">()):</span>
    <span class="nf">heatmap</span><span class="p">(</span><span class="n">values</span><span class="p">,</span> <span class="n">rows</span><span class="o">=</span><span class="nf">range</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">layers</span> <span class="o">+</span> <span class="mi">1</span><span class="p">),</span> <span class="n">cols</span><span class="o">=</span><span class="nf">range</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">heads</span> <span class="o">+</span> <span class="mi">1</span><span class="p">),</span> <span class="n">ax</span><span class="o">=</span><span class="n">ax</span><span class="p">,</span>
            <span class="n">vmin</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span> <span class="n">vmax</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">cell</span><span class="o">=</span><span class="mf">0.22</span><span class="p">,</span> <span class="n">title</span><span class="o">=</span><span class="sa">f</span><span class="sh">"</span><span class="s">to </span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span>
            <span class="n">xlabel</span><span class="o">=</span><span class="sh">"</span><span class="s">head</span><span class="sh">"</span><span class="p">,</span> <span class="n">ylabel</span><span class="o">=</span><span class="sh">"</span><span class="s">layer</span><span class="sh">"</span> <span class="k">if</span> <span class="n">ax</span> <span class="ow">is</span> <span class="n">axes</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span> <span class="k">else</span> <span class="bp">None</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">tight_layout</span><span class="p">()</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/01/output-08.png" alt="Output of the code above" loading="lazy"></p> <p>The layers divide the work. In layers 2 to 4 attention gathers on <code class="language-plaintext highlighter-rouge">[CLS]</code>; in layers 5 to 10 almost every head sends much of it to <code class="language-plaintext highlighter-rouge">[SEP]</code>, a token that carries no information about any particular word; the last two layers spread out again.</p> <p>Clark and colleagues suggested that a head with nothing useful to do in a given context parks its attention on <code class="language-plaintext highlighter-rouge">[SEP]</code>, a no-op: softmax has to send the weight somewhere.</p> <p>The first layers also have heads that look almost only one token back or one token ahead, which is how a model with no built-in notion of order puts neighbouring words together. Here is the most devoted previous-token head on one sentence:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">layer</span><span class="p">,</span> <span class="n">head</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">unravel_index</span><span class="p">(</span><span class="n">shares_by_head</span><span class="p">[</span><span class="sh">"</span><span class="s">previous</span><span class="sh">"</span><span class="p">].</span><span class="nf">argmax</span><span class="p">(),</span> <span class="p">(</span><span class="n">layers</span><span class="p">,</span> <span class="n">heads</span><span class="p">))</span>
<span class="n">example</span> <span class="o">=</span> <span class="sh">"</span><span class="s">The traveller from Brazil needs a visa to enter the United States.</span><span class="sh">"</span>
<span class="n">batch</span> <span class="o">=</span> <span class="nf">tokenizer</span><span class="p">(</span><span class="n">example</span><span class="p">,</span> <span class="n">return_tensors</span><span class="o">=</span><span class="sh">"</span><span class="s">pt</span><span class="sh">"</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">_</span><span class="p">,</span> <span class="n">attention</span> <span class="o">=</span> <span class="n">mlm</span><span class="p">.</span><span class="nf">bert</span><span class="p">(</span><span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">token_type_ids</span><span class="sh">"</span><span class="p">],</span>
                            <span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">attention_mask</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="mi">0</span><span class="p">,</span> <span class="n">keep_weights</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">words</span> <span class="o">=</span> <span class="n">tokenizer</span><span class="p">.</span><span class="nf">convert_ids_to_tokens</span><span class="p">(</span><span class="n">batch</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">][</span><span class="mi">0</span><span class="p">])</span>
<span class="nf">heatmap</span><span class="p">(</span><span class="n">attention</span><span class="p">[</span><span class="n">layer</span><span class="p">][</span><span class="mi">0</span><span class="p">,</span> <span class="n">head</span><span class="p">].</span><span class="nf">float</span><span class="p">().</span><span class="nf">cpu</span><span class="p">().</span><span class="nf">numpy</span><span class="p">(),</span> <span class="n">rows</span><span class="o">=</span><span class="n">words</span><span class="p">,</span> <span class="n">cols</span><span class="o">=</span><span class="n">words</span><span class="p">,</span> <span class="n">cell</span><span class="o">=</span><span class="mf">0.28</span><span class="p">,</span>
        <span class="n">title</span><span class="o">=</span><span class="sa">f</span><span class="sh">"</span><span class="s">Layer </span><span class="si">{</span><span class="n">layer</span> <span class="o">+</span> <span class="mi">1</span><span class="si">}</span><span class="s">, head </span><span class="si">{</span><span class="n">head</span> <span class="o">+</span> <span class="mi">1</span><span class="si">}</span><span class="s">: where each word looks</span><span class="sh">"</span><span class="p">,</span>
        <span class="n">xlabel</span><span class="o">=</span><span class="sh">"</span><span class="s">attends to</span><span class="sh">"</span><span class="p">,</span> <span class="n">ylabel</span><span class="o">=</span><span class="sh">"</span><span class="s">word</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">on average this head puts </span><span class="si">{</span><span class="n">shares_by_head</span><span class="p">[</span><span class="sh">'</span><span class="s">previous</span><span class="sh">'</span><span class="p">][</span><span class="n">layer</span><span class="p">,</span> <span class="n">head</span><span class="p">]</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="o">%</span><span class="si">}</span><span class="s"> </span><span class="sh">"</span>
      <span class="sh">"</span><span class="s">of its attention on the previous token</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/01/output-09.png" alt="Output of the code above" loading="lazy"></p> <pre class="tfs-printed"><code>on average this head puts 71% of its attention on the previous token</code></pre> <div class="callout callout-warn"> <p class="callout-label">Trap</p> <p>Heads like this one are why reading “attention maps” as explanations is risky. Most of what a head does is plumbing: moving information to where the next layer can use it. The linguistically interesting heads exist, but they are a minority, and a head that looks at a word doesn’t mean the model uses what it found.</p> </div> <h2 id="7-a-job-for-bert-personal-data-in-financial-documents">7. A job for BERT: personal data in financial documents</h2> <p>Banks, insurers and their software vendors move a lot of text around: support tickets, loan applications, SWIFT messages, contracts. Before such text goes into a log, a search index, a test environment or a prompt for some external model, the personal data in it has to be found and masked: names, addresses, account numbers, phone numbers.</p> <p>Regular expressions find the things with a fixed shape. Names and addresses have no fixed shape, and that is a classic job for an encoder: <strong>named entity recognition</strong>, a label for every token.</p> <p>Real documents full of real personal data are, for good reasons, not something anyone publishes. Gretel’s dataset is synthetic: about 56,000 documents of 60 kinds, in seven languages, written by a language model and annotated with the character spans of 29 kinds of personal data <sup class="cite">[<a href="#ref-10" id="cite-10" data-ref="10" aria-label="Reference 10: Gretel (2024). Synthetic PII finance multilingual. Hugging Face dataset, Apache 2.0.">10</a>]</sup>. We take the English ones.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">pii</span> <span class="o">=</span> <span class="nf">load_dataset</span><span class="p">(</span><span class="sh">"</span><span class="s">gretelai/synthetic_pii_finance_multilingual</span><span class="sh">"</span><span class="p">)</span>
<span class="n">english</span> <span class="o">=</span> <span class="n">pii</span><span class="p">.</span><span class="nf">filter</span><span class="p">(</span><span class="k">lambda</span> <span class="n">row</span><span class="p">:</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">language</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="sh">"</span><span class="s">English</span><span class="sh">"</span><span class="p">)</span>
<span class="n">train_rows</span><span class="p">,</span> <span class="n">test_rows</span> <span class="o">=</span> <span class="n">english</span><span class="p">[</span><span class="sh">"</span><span class="s">train</span><span class="sh">"</span><span class="p">],</span> <span class="n">english</span><span class="p">[</span><span class="sh">"</span><span class="s">test</span><span class="sh">"</span><span class="p">]</span>
<span class="k">if</span> <span class="n">SMOKE</span><span class="p">:</span>
    <span class="n">train_rows</span><span class="p">,</span> <span class="n">test_rows</span> <span class="o">=</span> <span class="n">train_rows</span><span class="p">.</span><span class="nf">select</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="mi">96</span><span class="p">)),</span> <span class="n">test_rows</span><span class="p">.</span><span class="nf">select</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="mi">24</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">train_rows</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> documents to train on, </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">test_rows</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> to test on</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="nf">set</span><span class="p">(</span><span class="n">train_rows</span><span class="p">[</span><span class="sh">'</span><span class="s">document_type</span><span class="sh">'</span><span class="p">]))</span><span class="si">}</span><span class="s"> kinds, e.g.:</span><span class="sh">"</span><span class="p">,</span>
      <span class="sh">"</span><span class="s">, </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="nf">sorted</span><span class="p">(</span><span class="nf">set</span><span class="p">(</span><span class="n">train_rows</span><span class="p">[</span><span class="sh">"</span><span class="s">document_type</span><span class="sh">"</span><span class="p">]))[:</span><span class="mi">8</span><span class="p">]))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>25,948 documents to train on, 2,962 to test on
60 kinds, e.g.: Annual Report, Audit Report, BAI Format, Bank Statement, Bill of Lading, Business Plan, CSV, Compliance Certificate</code></pre> <p>The 29 kinds of the annotation are more than we need to see. We fold them into twelve groups, which is roughly how a masking policy would treat them: a first name and a full name are both a person, an IBAN and a routing number are both bank details.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">GROUPS</span> <span class="o">=</span> <span class="p">{</span>
    <span class="sh">"</span><span class="s">name</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">PERSON</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">first_name</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">PERSON</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">last_name</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">PERSON</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">company</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">COMPANY</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">street_address</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">ADDRESS</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">local_latlng</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">LOCATION</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">date</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">DATE</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">date_of_birth</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">DATE</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">date_time</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">DATE</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">time</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">DATE</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">email</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">EMAIL</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">phone_number</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">PHONE</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">iban</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">BANK</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">bban</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">BANK</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">swift_bic_code</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">BANK</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">bank_routing_number</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">BANK</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">credit_card_number</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">CARD</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">credit_card_security_code</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">CARD</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">ssn</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">GOV_ID</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">passport_number</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">GOV_ID</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">driver_license_number</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">GOV_ID</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">customer_id</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">ACCOUNT</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">employee_id</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">ACCOUNT</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">account_pin</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">ACCOUNT</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">ipv4</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">DIGITAL</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">ipv6</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">DIGITAL</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">user_name</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">DIGITAL</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">password</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">DIGITAL</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">api_key</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">DIGITAL</span><span class="sh">"</span><span class="p">,</span>
<span class="p">}</span>
<span class="n">KINDS</span> <span class="o">=</span> <span class="nf">sorted</span><span class="p">(</span><span class="nf">set</span><span class="p">(</span><span class="n">GROUPS</span><span class="p">.</span><span class="nf">values</span><span class="p">()))</span>


<span class="k">def</span> <span class="nf">gold_spans</span><span class="p">(</span><span class="n">row</span><span class="p">):</span>
    <span class="n">spans</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">span</span> <span class="ow">in</span> <span class="n">json</span><span class="p">.</span><span class="nf">loads</span><span class="p">(</span><span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">pii_spans</span><span class="sh">"</span><span class="p">]):</span>
        <span class="n">spans</span><span class="p">.</span><span class="nf">append</span><span class="p">((</span><span class="n">span</span><span class="p">[</span><span class="sh">"</span><span class="s">start</span><span class="sh">"</span><span class="p">],</span> <span class="n">span</span><span class="p">[</span><span class="sh">"</span><span class="s">end</span><span class="sh">"</span><span class="p">],</span> <span class="n">GROUPS</span><span class="p">[</span><span class="n">span</span><span class="p">[</span><span class="sh">"</span><span class="s">label</span><span class="sh">"</span><span class="p">]]))</span>
    <span class="k">return</span> <span class="n">spans</span>


<span class="n">counts</span> <span class="o">=</span> <span class="p">{</span><span class="n">kind</span><span class="p">:</span> <span class="mi">0</span> <span class="k">for</span> <span class="n">kind</span> <span class="ow">in</span> <span class="n">KINDS</span><span class="p">}</span>
<span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">train_rows</span><span class="p">:</span>
    <span class="k">for</span> <span class="n">_</span><span class="p">,</span> <span class="n">_</span><span class="p">,</span> <span class="n">kind</span> <span class="ow">in</span> <span class="nf">gold_spans</span><span class="p">(</span><span class="n">row</span><span class="p">):</span>
        <span class="n">counts</span><span class="p">[</span><span class="n">kind</span><span class="p">]</span> <span class="o">+=</span> <span class="mi">1</span>
<span class="n">order</span> <span class="o">=</span> <span class="nf">sorted</span><span class="p">(</span><span class="n">KINDS</span><span class="p">,</span> <span class="n">key</span><span class="o">=</span><span class="n">counts</span><span class="p">.</span><span class="n">get</span><span class="p">)</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.4</span><span class="p">,</span> <span class="mf">3.6</span><span class="p">))</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">barh</span><span class="p">(</span><span class="n">order</span><span class="p">,</span> <span class="p">[</span><span class="n">counts</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="n">order</span><span class="p">],</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">data</span><span class="sh">"</span><span class="p">])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xscale</span><span class="p">(</span><span class="sh">"</span><span class="s">log</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">Annotated spans in the training documents, by group</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">spans (log scale)</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">grid</span><span class="p">(</span><span class="n">axis</span><span class="o">=</span><span class="sh">"</span><span class="s">y</span><span class="sh">"</span><span class="p">,</span> <span class="n">visible</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/01/output-10.png" alt="Annotated spans in the training documents, by group" loading="lazy"></p> <p>Dates, people and companies are everywhere; GPS coordinates and card numbers are rare. A model will learn the common groups easily and the rare ones from a few hundred examples each. Here is one document with its annotation:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">SHADES</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">PERSON</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">#D23F57</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">COMPANY</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">#6A55D8</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">ADDRESS</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">#0F8C7E</span><span class="sh">"</span><span class="p">,</span>
          <span class="sh">"</span><span class="s">DATE</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">#C27A0E</span><span class="sh">"</span><span class="p">}</span>


<span class="k">def</span> <span class="nf">highlight</span><span class="p">(</span><span class="n">text</span><span class="p">,</span> <span class="n">spans</span><span class="p">):</span>
    <span class="n">pieces</span><span class="p">,</span> <span class="n">last</span> <span class="o">=</span> <span class="p">[],</span> <span class="mi">0</span>
    <span class="k">for</span> <span class="n">start</span><span class="p">,</span> <span class="n">end</span><span class="p">,</span> <span class="n">kind</span> <span class="ow">in</span> <span class="nf">sorted</span><span class="p">(</span><span class="n">spans</span><span class="p">):</span>
        <span class="n">color</span> <span class="o">=</span> <span class="n">SHADES</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="n">kind</span><span class="p">,</span> <span class="sh">"</span><span class="s">#5B6575</span><span class="sh">"</span><span class="p">)</span>
        <span class="n">pieces</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">text</span><span class="p">[</span><span class="n">last</span><span class="p">:</span><span class="n">start</span><span class="p">].</span><span class="nf">replace</span><span class="p">(</span><span class="sh">"</span><span class="s">&lt;</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">&amp;lt;</span><span class="sh">"</span><span class="p">))</span>
        <span class="n">pieces</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="sa">f</span><span class="sh">'</span><span class="s">&lt;span style=</span><span class="sh">"</span><span class="s">background:</span><span class="si">{</span><span class="n">color</span><span class="si">}</span><span class="s">2e;border-bottom:2px solid </span><span class="si">{</span><span class="n">color</span><span class="si">}</span><span class="s">;</span><span class="sh">'</span>
                      <span class="sa">f</span><span class="sh">'</span><span class="s">padding:0 2px</span><span class="sh">"</span><span class="s">&gt;</span><span class="si">{</span><span class="n">text</span><span class="p">[</span><span class="n">start</span><span class="si">:</span><span class="n">end</span><span class="p">]</span><span class="si">}</span><span class="s">&lt;sub style=</span><span class="sh">"</span><span class="s">color:</span><span class="si">{</span><span class="n">color</span><span class="si">}</span><span class="s">;</span><span class="sh">'</span>
                      <span class="sa">f</span><span class="sh">'</span><span class="s">font-size:0.7em</span><span class="sh">"</span><span class="s">&gt; </span><span class="si">{</span><span class="n">kind</span><span class="si">}</span><span class="s">&lt;/sub&gt;&lt;/span&gt;</span><span class="sh">'</span><span class="p">)</span>
        <span class="n">last</span> <span class="o">=</span> <span class="n">end</span>
    <span class="n">pieces</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">text</span><span class="p">[</span><span class="n">last</span><span class="p">:].</span><span class="nf">replace</span><span class="p">(</span><span class="sh">"</span><span class="s">&lt;</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">&amp;lt;</span><span class="sh">"</span><span class="p">))</span>
    <span class="n">body</span> <span class="o">=</span> <span class="sh">""</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">pieces</span><span class="p">)</span>
    <span class="n">style</span> <span class="o">=</span> <span class="sh">"</span><span class="s">white-space:pre-wrap;font-size:0.85em;line-height:1.55</span><span class="sh">"</span>
    <span class="k">return</span> <span class="nc">HTML</span><span class="p">(</span><span class="sa">f</span><span class="sh">'</span><span class="s">&lt;div style=</span><span class="sh">"</span><span class="si">{</span><span class="n">style</span><span class="si">}</span><span class="sh">"</span><span class="s">&gt;</span><span class="si">{</span><span class="n">body</span><span class="si">}</span><span class="s">&lt;/div&gt;</span><span class="sh">'</span><span class="p">)</span>


<span class="n">sample</span> <span class="o">=</span> <span class="n">train_rows</span><span class="p">[</span><span class="mi">3</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="n">sample</span><span class="p">[</span><span class="sh">"</span><span class="s">document_type</span><span class="sh">"</span><span class="p">])</span>
<span class="n">sample_spans</span> <span class="o">=</span> <span class="p">[</span><span class="n">s</span> <span class="k">for</span> <span class="n">s</span> <span class="ow">in</span> <span class="nf">gold_spans</span><span class="p">(</span><span class="n">sample</span><span class="p">)</span> <span class="k">if</span> <span class="n">s</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span> <span class="o">&lt;=</span> <span class="mi">900</span><span class="p">]</span>
<span class="nf">display</span><span class="p">(</span><span class="nf">highlight</span><span class="p">(</span><span class="n">sample</span><span class="p">[</span><span class="sh">"</span><span class="s">generated_text</span><span class="sh">"</span><span class="p">][:</span><span class="mi">900</span><span class="p">],</span> <span class="n">sample_spans</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>Health Insurance Claim Form</code></pre> <div class="tfs-table-wrap"><div style="white-space:pre-wrap;font-size:0.85em;line-height:1.55">Patient Information * Full Name: <span style="background:#D23F572e;border-bottom:2px solid #D23F57;padding:0 2px">Eufemia Gordillo-Pagès<sub style="color:#D23F57;font-size:0.7em"> PERSON</sub></span> * Date of Birth: MM/DD/YYYY * Address: <span style="background:#0F8C7E2e;border-bottom:2px solid #0F8C7E;padding:0 2px">8055 Tanya Estates<sub style="color:#0F8C7E;font-size:0.7em"> ADDRESS</sub></span> * Policy Number: <span style="background:#5B65752e;border-bottom:2px solid #5B6575;padding:0 2px">RUIA78128695550594<sub style="color:#5B6575;font-size:0.7em"> BANK</sub></span> Claim Details * Date of Service: MM/DD/YYYY * Provider Name: [Treating Dentist's Name] * Provider Address: <span style="background:#0F8C7E2e;border-bottom:2px solid #0F8C7E;padding:0 2px">[Treating Dentist's Address]<sub style="color:#0F8C7E;font-size:0.7em"> ADDRESS</sub></span> * Procedure Code: [Dental Procedure Code] * Procedure Description: [Brief Description of Dental Procedure] * Cost of Service: $[Amount] Notes: * This claim is for a dental check-up and cleaning. * The treating dentist identified no issues during the examination. * Regular dental check-ups are essential for maintaining good oral health. By signing below, I confirm that the information provided is true and accurate to the best of my knowledge. Patient Signature: \_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_\_ Date: \_\_\_\_\_\_\_\_\_ Please attach any relevant receipts or invoices to this claim form. Mail the </div></div> <p>Synthetic data has its own quirks, and this document shows two. The template line “Provider Address: [Treating Dentist’s Address]” is a placeholder the generator forgot to fill, and the annotator, also a model, marked it as an address. And a policy number is labelled as a bank account number.</p> <p>A model trained on such labels will learn some of their mistakes too; when we measure it, a small share of its “errors” will be the annotation’s.</p> <p>The bigger problem is length. BERT reads at most 512 tokens, two of them <code class="language-plaintext highlighter-rouge">[CLS]</code> and <code class="language-plaintext highlighter-rouge">[SEP]</code>:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">lengths</span> <span class="o">=</span> <span class="p">[</span><span class="nf">len</span><span class="p">(</span><span class="nf">cased_tokenizer</span><span class="p">(</span><span class="n">text</span><span class="p">,</span> <span class="n">add_special_tokens</span><span class="o">=</span><span class="bp">False</span><span class="p">)[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">])</span>
           <span class="k">for</span> <span class="n">text</span> <span class="ow">in</span> <span class="n">test_rows</span><span class="p">[</span><span class="sh">"</span><span class="s">generated_text</span><span class="sh">"</span><span class="p">]]</span>
<span class="n">longer</span> <span class="o">=</span> <span class="nf">sum</span><span class="p">(</span><span class="n">n</span> <span class="o">&gt;</span> <span class="mi">510</span> <span class="k">for</span> <span class="n">n</span> <span class="ow">in</span> <span class="n">lengths</span><span class="p">)</span> <span class="o">/</span> <span class="nf">len</span><span class="p">(</span><span class="n">lengths</span><span class="p">)</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.4</span><span class="p">,</span> <span class="mf">3.2</span><span class="p">))</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">hist</span><span class="p">(</span><span class="n">lengths</span><span class="p">,</span> <span class="n">bins</span><span class="o">=</span><span class="mi">40</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">data</span><span class="sh">"</span><span class="p">])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">axvline</span><span class="p">(</span><span class="mi">510</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">],</span> <span class="n">linewidth</span><span class="o">=</span><span class="mf">1.5</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">text</span><span class="p">(</span><span class="mi">520</span><span class="p">,</span> <span class="n">ax</span><span class="p">.</span><span class="nf">get_ylim</span><span class="p">()[</span><span class="mi">1</span><span class="p">]</span> <span class="o">*</span> <span class="mf">0.85</span><span class="p">,</span> <span class="sh">"</span><span class="s">BERT</span><span class="sh">'</span><span class="s">s limit</span><span class="sh">"</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">Length of the test documents in BERT</span><span class="sh">'</span><span class="s">s tokens</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">tokens</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">longer</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="o">%</span><span class="si">}</span><span class="s"> of the documents don</span><span class="sh">'</span><span class="s">t fit in one input</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/01/output-11.png" alt="Length of the test documents in BERT" loading="lazy"></p> <pre class="tfs-printed"><code>14% of the documents don't fit in one input</code></pre> <p class="takeaway">Truncating the 14% of documents that don’t fit would silently skip whatever personal data sits past the limit, which for a masking tool is the worst kind of error.</p> <p>The standard fix is a sliding window: cut the document into overlapping pieces of 510 tokens, run each, and for every token keep the prediction from the window in which it sits furthest from an edge, where it had the most context on both sides.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/01/windows-light.png" width="760" alt="A document of 1,100 tokens cut into three overlapping windows of 510 tokens with a stride of 384. Each token's label is taken from the window where it is furthest from the window's edge, so every token is judged with context on both sides" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/01/windows-dark.png" width="760" alt="A document of 1,100 tokens cut into three overlapping windows of 510 tokens with a stride of 384. Each token's label is taken from the window where it is furthest from the window's edge, so every token is judged with context on both sides" loading="lazy"></p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">WINDOW</span><span class="p">,</span> <span class="n">STRIDE</span> <span class="o">=</span> <span class="p">(</span><span class="mi">126</span><span class="p">,</span> <span class="mi">96</span><span class="p">)</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="nf">else </span><span class="p">(</span><span class="mi">510</span><span class="p">,</span> <span class="mi">384</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">windows</span><span class="p">(</span><span class="n">n_tokens</span><span class="p">):</span>
    <span class="k">if</span> <span class="n">n_tokens</span> <span class="o">&lt;=</span> <span class="n">WINDOW</span><span class="p">:</span>
        <span class="k">return</span> <span class="p">[(</span><span class="mi">0</span><span class="p">,</span> <span class="n">n_tokens</span><span class="p">)]</span>
    <span class="n">starts</span> <span class="o">=</span> <span class="nf">list</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">n_tokens</span> <span class="o">-</span> <span class="n">WINDOW</span> <span class="o">+</span> <span class="mi">1</span><span class="p">,</span> <span class="n">STRIDE</span><span class="p">))</span>
    <span class="k">if</span> <span class="n">starts</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span> <span class="o">+</span> <span class="n">WINDOW</span> <span class="o">&lt;</span> <span class="n">n_tokens</span><span class="p">:</span>
        <span class="n">starts</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">n_tokens</span> <span class="o">-</span> <span class="n">WINDOW</span><span class="p">)</span>
    <span class="k">return</span> <span class="p">[(</span><span class="n">start</span><span class="p">,</span> <span class="n">start</span> <span class="o">+</span> <span class="n">WINDOW</span><span class="p">)</span> <span class="k">for</span> <span class="n">start</span> <span class="ow">in</span> <span class="n">starts</span><span class="p">]</span>


<span class="nf">print</span><span class="p">(</span><span class="nf">windows</span><span class="p">(</span><span class="mi">1100</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>[(0, 510), (384, 894), (590, 1100)]</code></pre> <p>Labels come as character spans, and the model needs one label per token. We use the <strong>BIO</strong> scheme: <code class="language-plaintext highlighter-rouge">B-PERSON</code> on the first token of a name, <code class="language-plaintext highlighter-rouge">I-PERSON</code> on the tokens that continue it, <code class="language-plaintext highlighter-rouge">O</code> on everything else. The tokenizer’s offset mapping says which characters each token covers:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">LABELS</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">O</span><span class="sh">"</span><span class="p">]</span> <span class="o">+</span> <span class="p">[</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">prefix</span><span class="si">}</span><span class="s">-</span><span class="si">{</span><span class="n">kind</span><span class="si">}</span><span class="sh">"</span> <span class="k">for</span> <span class="n">kind</span> <span class="ow">in</span> <span class="n">KINDS</span> <span class="k">for</span> <span class="n">prefix</span> <span class="ow">in</span> <span class="p">(</span><span class="sh">"</span><span class="s">B</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">I</span><span class="sh">"</span><span class="p">)]</span>
<span class="n">LABEL_ID</span> <span class="o">=</span> <span class="p">{</span><span class="n">label</span><span class="p">:</span> <span class="n">i</span> <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">label</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">LABELS</span><span class="p">)}</span>


<span class="k">def</span> <span class="nf">encode</span><span class="p">(</span><span class="n">row</span><span class="p">):</span>
    <span class="n">text</span> <span class="o">=</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">generated_text</span><span class="sh">"</span><span class="p">]</span>
    <span class="n">encoded</span> <span class="o">=</span> <span class="nf">cased_tokenizer</span><span class="p">(</span><span class="n">text</span><span class="p">,</span> <span class="n">add_special_tokens</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">return_offsets_mapping</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">offsets</span> <span class="o">=</span> <span class="n">encoded</span><span class="p">[</span><span class="sh">"</span><span class="s">offset_mapping</span><span class="sh">"</span><span class="p">]</span>
    <span class="n">tags</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">O</span><span class="sh">"</span><span class="p">]</span> <span class="o">*</span> <span class="nf">len</span><span class="p">(</span><span class="n">offsets</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">start</span><span class="p">,</span> <span class="n">end</span><span class="p">,</span> <span class="n">kind</span> <span class="ow">in</span> <span class="nf">gold_spans</span><span class="p">(</span><span class="n">row</span><span class="p">):</span>
        <span class="n">first</span> <span class="o">=</span> <span class="bp">True</span>
        <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="p">(</span><span class="n">a</span><span class="p">,</span> <span class="n">b</span><span class="p">)</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">offsets</span><span class="p">):</span>
            <span class="k">if</span> <span class="n">a</span> <span class="o">&gt;=</span> <span class="n">start</span> <span class="ow">and</span> <span class="n">b</span> <span class="o">&lt;=</span> <span class="n">end</span> <span class="ow">and</span> <span class="n">b</span> <span class="o">&gt;</span> <span class="n">a</span><span class="p">:</span>
                <span class="n">tags</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="o">=</span> <span class="p">(</span><span class="sh">"</span><span class="s">B-</span><span class="sh">"</span> <span class="k">if</span> <span class="n">first</span> <span class="k">else</span> <span class="sh">"</span><span class="s">I-</span><span class="sh">"</span><span class="p">)</span> <span class="o">+</span> <span class="n">kind</span>
                <span class="n">first</span> <span class="o">=</span> <span class="bp">False</span>
    <span class="k">return</span> <span class="n">encoded</span><span class="p">[</span><span class="sh">"</span><span class="s">input_ids</span><span class="sh">"</span><span class="p">],</span> <span class="n">offsets</span><span class="p">,</span> <span class="n">tags</span>


<span class="n">ids</span><span class="p">,</span> <span class="n">offsets</span><span class="p">,</span> <span class="n">tags</span> <span class="o">=</span> <span class="nf">encode</span><span class="p">(</span><span class="n">sample</span><span class="p">)</span>
<span class="n">shown</span> <span class="o">=</span> <span class="p">[(</span><span class="n">cased_tokenizer</span><span class="p">.</span><span class="nf">convert_ids_to_tokens</span><span class="p">(</span><span class="n">i</span><span class="p">),</span> <span class="n">t</span><span class="p">)</span> <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">t</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">ids</span><span class="p">[:</span><span class="mi">40</span><span class="p">],</span> <span class="n">tags</span><span class="p">[:</span><span class="mi">40</span><span class="p">])]</span>
<span class="nf">token_chips</span><span class="p">([[</span><span class="n">token</span> <span class="k">for</span> <span class="n">token</span><span class="p">,</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">shown</span><span class="p">]],</span> <span class="n">max_width</span><span class="o">=</span><span class="mi">640</span><span class="p">,</span>
            <span class="n">strong</span><span class="o">=</span><span class="k">lambda</span> <span class="n">row</span><span class="p">,</span> <span class="n">col</span><span class="p">,</span> <span class="n">token</span><span class="p">:</span> <span class="n">shown</span><span class="p">[</span><span class="n">col</span><span class="p">][</span><span class="mi">1</span><span class="p">]</span> <span class="o">!=</span> <span class="sh">"</span><span class="s">O</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">tag</span> <span class="k">for</span> <span class="n">_</span><span class="p">,</span> <span class="n">tag</span> <span class="ow">in</span> <span class="n">shown</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>O O O O O O O B-PERSON I-PERSON I-PERSON I-PERSON I-PERSON I-PERSON I-PERSON I-PERSON I-PERSON I-PERSON O O O O O O O O O O O O O O O O O O B-ADDRESS I-ADDRESS I-ADDRESS I-ADDRESS O</code></pre> <p><img class="tfs-output" src="/assets/posts/arch/01/output-12.png" alt="Output of the code above" loading="lazy"></p> <p>Each window becomes a training example: <code class="language-plaintext highlighter-rouge">[CLS]</code>, the window’s tokens, <code class="language-plaintext highlighter-rouge">[SEP]</code>, and labels of \(-100\) on the two special tokens so that the loss ignores them.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">examples</span><span class="p">(</span><span class="n">rows</span><span class="p">):</span>
    <span class="n">out</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">rows</span><span class="p">:</span>
        <span class="n">ids</span><span class="p">,</span> <span class="n">_</span><span class="p">,</span> <span class="n">tags</span> <span class="o">=</span> <span class="nf">encode</span><span class="p">(</span><span class="n">row</span><span class="p">)</span>
        <span class="k">for</span> <span class="n">start</span><span class="p">,</span> <span class="n">end</span> <span class="ow">in</span> <span class="nf">windows</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">ids</span><span class="p">)):</span>
            <span class="n">window_ids</span> <span class="o">=</span> <span class="p">[</span><span class="n">cased_tokenizer</span><span class="p">.</span><span class="n">cls_token_id</span><span class="p">]</span> <span class="o">+</span> <span class="n">ids</span><span class="p">[</span><span class="n">start</span><span class="p">:</span><span class="n">end</span><span class="p">]</span>
            <span class="n">window_ids</span> <span class="o">+=</span> <span class="p">[</span><span class="n">cased_tokenizer</span><span class="p">.</span><span class="n">sep_token_id</span><span class="p">]</span>
            <span class="n">window_labels</span> <span class="o">=</span> <span class="p">[</span><span class="o">-</span><span class="mi">100</span><span class="p">]</span> <span class="o">+</span> <span class="p">[</span><span class="n">LABEL_ID</span><span class="p">[</span><span class="n">t</span><span class="p">]</span> <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="n">tags</span><span class="p">[</span><span class="n">start</span><span class="p">:</span><span class="n">end</span><span class="p">]]</span> <span class="o">+</span> <span class="p">[</span><span class="o">-</span><span class="mi">100</span><span class="p">]</span>
            <span class="n">out</span><span class="p">.</span><span class="nf">append</span><span class="p">((</span><span class="n">window_ids</span><span class="p">,</span> <span class="n">window_labels</span><span class="p">))</span>
    <span class="k">return</span> <span class="n">out</span>
</code></pre></div></div> <h2 id="8-fine-tuning-and-what-pre-training-is-worth">8. Fine-tuning, and what pre-training is worth</h2> <p>The tagger is our <code class="language-plaintext highlighter-rouge">Bert</code> with one linear layer on top: 768 numbers in, one score per label out, at every position. All of BERT’s weights train along with the new layer, which is what “fine-tuning” meant in the paper.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">Tagger</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">bert</span><span class="p">,</span> <span class="n">n_labels</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">().</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">bert</span> <span class="o">=</span> <span class="n">bert</span>
        <span class="n">self</span><span class="p">.</span><span class="n">dropout</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Dropout</span><span class="p">(</span><span class="mf">0.1</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">classify</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">bert</span><span class="p">.</span><span class="n">embeddings</span><span class="p">.</span><span class="n">words</span><span class="p">.</span><span class="n">embedding_dim</span><span class="p">,</span> <span class="n">n_labels</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">ids</span><span class="p">,</span> <span class="n">padding</span><span class="p">):</span>
        <span class="n">h</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">bert</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros_like</span><span class="p">(</span><span class="n">ids</span><span class="p">),</span> <span class="n">padding</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">classify</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="nf">dropout</span><span class="p">(</span><span class="n">h</span><span class="p">))</span>


<span class="k">def</span> <span class="nf">new_tagger</span><span class="p">(</span><span class="n">pretrained</span><span class="p">):</span>  <span class="c1"># random weights are initialised as in section 5
</span>    <span class="n">masked_lm</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="nf">load_masked_lm</span><span class="p">(</span><span class="sh">"</span><span class="s">google-bert/bert-base-cased</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">tagger</span> <span class="o">=</span> <span class="nc">Tagger</span><span class="p">(</span><span class="n">masked_lm</span><span class="p">.</span><span class="n">bert</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">LABELS</span><span class="p">))</span>
    <span class="k">if</span> <span class="ow">not</span> <span class="n">pretrained</span><span class="p">:</span>
        <span class="n">tagger</span><span class="p">.</span><span class="nf">apply</span><span class="p">(</span><span class="n">init_like_bert</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">tagger</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
</code></pre></div></div> <p>Training sorts the windows by length and batches neighbours together, so a batch of short windows isn’t padded to</p> <ol> <li>The rest is the recipe from the paper’s fine-tuning appendix: AdamW, a learning rate warmed up over the first tenth of the steps and then decayed linearly, a few epochs. Mixed precision keeps it fast on a T4.</li> </ol> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">batches</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">size</span><span class="p">,</span> <span class="n">shuffle</span><span class="p">):</span>
    <span class="n">order</span> <span class="o">=</span> <span class="nf">sorted</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">data</span><span class="p">)),</span> <span class="n">key</span><span class="o">=</span><span class="k">lambda</span> <span class="n">i</span><span class="p">:</span> <span class="nf">len</span><span class="p">(</span><span class="n">data</span><span class="p">[</span><span class="n">i</span><span class="p">][</span><span class="mi">0</span><span class="p">]))</span>
    <span class="n">groups</span> <span class="o">=</span> <span class="p">[</span><span class="n">order</span><span class="p">[</span><span class="n">i</span><span class="p">:</span><span class="n">i</span> <span class="o">+</span> <span class="n">size</span><span class="p">]</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">order</span><span class="p">),</span> <span class="n">size</span><span class="p">)]</span>
    <span class="k">if</span> <span class="n">shuffle</span><span class="p">:</span>
        <span class="n">random</span><span class="p">.</span><span class="nf">shuffle</span><span class="p">(</span><span class="n">groups</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">group</span> <span class="ow">in</span> <span class="n">groups</span><span class="p">:</span>
        <span class="n">width</span> <span class="o">=</span> <span class="nf">max</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">data</span><span class="p">[</span><span class="n">i</span><span class="p">][</span><span class="mi">0</span><span class="p">])</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">group</span><span class="p">)</span>
        <span class="n">ids</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">full</span><span class="p">((</span><span class="nf">len</span><span class="p">(</span><span class="n">group</span><span class="p">),</span> <span class="n">width</span><span class="p">),</span> <span class="n">cased_tokenizer</span><span class="p">.</span><span class="n">pad_token_id</span><span class="p">)</span>
        <span class="n">labels</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">full</span><span class="p">((</span><span class="nf">len</span><span class="p">(</span><span class="n">group</span><span class="p">),</span> <span class="n">width</span><span class="p">),</span> <span class="o">-</span><span class="mi">100</span><span class="p">)</span>
        <span class="k">for</span> <span class="n">row</span><span class="p">,</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">group</span><span class="p">):</span>
            <span class="n">n</span> <span class="o">=</span> <span class="nf">len</span><span class="p">(</span><span class="n">data</span><span class="p">[</span><span class="n">i</span><span class="p">][</span><span class="mi">0</span><span class="p">])</span>
            <span class="n">ids</span><span class="p">[</span><span class="n">row</span><span class="p">,</span> <span class="p">:</span><span class="n">n</span><span class="p">]</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">data</span><span class="p">[</span><span class="n">i</span><span class="p">][</span><span class="mi">0</span><span class="p">])</span>
            <span class="n">labels</span><span class="p">[</span><span class="n">row</span><span class="p">,</span> <span class="p">:</span><span class="n">n</span><span class="p">]</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="n">data</span><span class="p">[</span><span class="n">i</span><span class="p">][</span><span class="mi">1</span><span class="p">])</span>
        <span class="k">yield</span> <span class="n">ids</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">),</span> <span class="n">labels</span><span class="p">.</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">train</span><span class="p">(</span><span class="n">tagger</span><span class="p">,</span> <span class="n">data</span><span class="p">,</span> <span class="n">epochs</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span> <span class="n">lr</span><span class="o">=</span><span class="mf">5e-5</span><span class="p">,</span> <span class="n">batch_size</span><span class="o">=</span><span class="mi">16</span><span class="p">,</span> <span class="n">steps</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
    <span class="k">if</span> <span class="n">steps</span><span class="p">:</span>  <span class="c1"># a fixed number of updates, however much data there is
</span>        <span class="n">epochs</span> <span class="o">=</span> <span class="n">math</span><span class="p">.</span><span class="nf">ceil</span><span class="p">(</span><span class="n">steps</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">ceil</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">data</span><span class="p">)</span> <span class="o">/</span> <span class="n">batch_size</span><span class="p">))</span>
    <span class="n">steps</span> <span class="o">=</span> <span class="n">epochs</span> <span class="o">*</span> <span class="n">math</span><span class="p">.</span><span class="nf">ceil</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">data</span><span class="p">)</span> <span class="o">/</span> <span class="n">batch_size</span><span class="p">)</span>
    <span class="n">warmup</span> <span class="o">=</span> <span class="nf">max</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">steps</span> <span class="o">//</span> <span class="mi">10</span><span class="p">)</span>
    <span class="n">optimizer</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">optim</span><span class="p">.</span><span class="nc">AdamW</span><span class="p">(</span><span class="n">tagger</span><span class="p">.</span><span class="nf">parameters</span><span class="p">(),</span> <span class="n">lr</span><span class="o">=</span><span class="n">lr</span><span class="p">,</span> <span class="n">weight_decay</span><span class="o">=</span><span class="mf">0.01</span><span class="p">)</span>
    <span class="k">def</span> <span class="nf">rate</span><span class="p">(</span><span class="n">step</span><span class="p">):</span>  <span class="c1"># linear warm-up, then linear decay to zero
</span>        <span class="k">return</span> <span class="nf">min</span><span class="p">((</span><span class="n">step</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">warmup</span><span class="p">,</span> <span class="nf">max</span><span class="p">(</span><span class="mf">0.0</span><span class="p">,</span> <span class="p">(</span><span class="n">steps</span> <span class="o">-</span> <span class="n">step</span><span class="p">)</span> <span class="o">/</span> <span class="nf">max</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">steps</span> <span class="o">-</span> <span class="n">warmup</span><span class="p">)))</span>

    <span class="n">schedule</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">optim</span><span class="p">.</span><span class="n">lr_scheduler</span><span class="p">.</span><span class="nc">LambdaLR</span><span class="p">(</span><span class="n">optimizer</span><span class="p">,</span> <span class="n">rate</span><span class="p">)</span>
    <span class="n">scaler</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">amp</span><span class="p">.</span><span class="nc">GradScaler</span><span class="p">(</span><span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">tagger</span><span class="p">.</span><span class="nf">train</span><span class="p">()</span>
    <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">epochs</span><span class="p">):</span>
        <span class="k">for</span> <span class="n">ids</span><span class="p">,</span> <span class="n">labels</span> <span class="ow">in</span> <span class="nf">batches</span><span class="p">(</span><span class="n">data</span><span class="p">,</span> <span class="n">batch_size</span><span class="p">,</span> <span class="n">shuffle</span><span class="o">=</span><span class="bp">True</span><span class="p">):</span>
            <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">autocast</span><span class="p">(</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float16</span><span class="p">,</span> <span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">):</span>
                <span class="n">logits</span> <span class="o">=</span> <span class="nf">tagger</span><span class="p">(</span><span class="n">ids</span><span class="p">,</span> <span class="n">ids</span> <span class="o">==</span> <span class="n">cased_tokenizer</span><span class="p">.</span><span class="n">pad_token_id</span><span class="p">)</span>
                <span class="n">flat</span> <span class="o">=</span> <span class="n">logits</span><span class="p">.</span><span class="nf">view</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">LABELS</span><span class="p">)).</span><span class="nf">float</span><span class="p">()</span>
                <span class="n">loss</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="nf">cross_entropy</span><span class="p">(</span><span class="n">flat</span><span class="p">,</span> <span class="n">labels</span><span class="p">.</span><span class="nf">view</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">),</span> <span class="n">ignore_index</span><span class="o">=-</span><span class="mi">100</span><span class="p">)</span>
            <span class="n">optimizer</span><span class="p">.</span><span class="nf">zero_grad</span><span class="p">(</span><span class="n">set_to_none</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
            <span class="n">scaler</span><span class="p">.</span><span class="nf">scale</span><span class="p">(</span><span class="n">loss</span><span class="p">).</span><span class="nf">backward</span><span class="p">()</span>
            <span class="n">scaler</span><span class="p">.</span><span class="nf">unscale_</span><span class="p">(</span><span class="n">optimizer</span><span class="p">)</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">utils</span><span class="p">.</span><span class="nf">clip_grad_norm_</span><span class="p">(</span><span class="n">tagger</span><span class="p">.</span><span class="nf">parameters</span><span class="p">(),</span> <span class="mf">1.0</span><span class="p">)</span>
            <span class="n">scaler</span><span class="p">.</span><span class="nf">step</span><span class="p">(</span><span class="n">optimizer</span><span class="p">)</span>
            <span class="n">scaler</span><span class="p">.</span><span class="nf">update</span><span class="p">()</span>
            <span class="n">schedule</span><span class="p">.</span><span class="nf">step</span><span class="p">()</span>
    <span class="k">return</span> <span class="n">tagger</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>
</code></pre></div></div> <p>Prediction runs the windows of a document, keeps each token’s best-placed prediction, and turns runs of <code class="language-plaintext highlighter-rouge">B-</code> and <code class="language-plaintext highlighter-rouge">I-</code> labels back into character spans. Evaluation is strict: a predicted span counts only if it has the right group and exactly the right boundaries, on the token grid.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">predict</span><span class="p">(</span><span class="n">tagger</span><span class="p">,</span> <span class="n">row</span><span class="p">):</span>
    <span class="n">ids</span><span class="p">,</span> <span class="n">offsets</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="nf">encode</span><span class="p">(</span><span class="n">row</span><span class="p">)</span>
    <span class="n">best</span><span class="p">,</span> <span class="n">depth</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">O</span><span class="sh">"</span><span class="p">]</span> <span class="o">*</span> <span class="nf">len</span><span class="p">(</span><span class="n">ids</span><span class="p">),</span> <span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span> <span class="o">*</span> <span class="nf">len</span><span class="p">(</span><span class="n">ids</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">start</span><span class="p">,</span> <span class="n">end</span> <span class="ow">in</span> <span class="nf">windows</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">ids</span><span class="p">)):</span>
        <span class="n">window</span> <span class="o">=</span> <span class="p">[</span><span class="n">cased_tokenizer</span><span class="p">.</span><span class="n">cls_token_id</span><span class="p">]</span> <span class="o">+</span> <span class="n">ids</span><span class="p">[</span><span class="n">start</span><span class="p">:</span><span class="n">end</span><span class="p">]</span>
        <span class="n">window</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">([</span><span class="n">window</span> <span class="o">+</span> <span class="p">[</span><span class="n">cased_tokenizer</span><span class="p">.</span><span class="n">sep_token_id</span><span class="p">]],</span> <span class="n">device</span><span class="o">=</span><span class="n">device</span><span class="p">)</span>
        <span class="n">no_padding</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros_like</span><span class="p">(</span><span class="n">window</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">)</span>
        <span class="n">half</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">autocast</span><span class="p">(</span><span class="n">device</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="n">float16</span><span class="p">,</span> <span class="n">enabled</span><span class="o">=</span><span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">)</span>
        <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">(),</span> <span class="n">half</span><span class="p">:</span>
            <span class="n">logits</span> <span class="o">=</span> <span class="nf">tagger</span><span class="p">(</span><span class="n">window</span><span class="p">,</span> <span class="n">no_padding</span><span class="p">)</span>
        <span class="n">labels</span> <span class="o">=</span> <span class="n">logits</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">:</span><span class="o">-</span><span class="mi">1</span><span class="p">].</span><span class="nf">argmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">).</span><span class="nf">tolist</span><span class="p">()</span>
        <span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">label</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">labels</span><span class="p">):</span>
            <span class="n">i</span> <span class="o">=</span> <span class="n">start</span> <span class="o">+</span> <span class="n">k</span>
            <span class="n">room</span> <span class="o">=</span> <span class="nf">min</span><span class="p">(</span><span class="n">k</span><span class="p">,</span> <span class="n">end</span> <span class="o">-</span> <span class="n">start</span> <span class="o">-</span> <span class="mi">1</span> <span class="o">-</span> <span class="n">k</span><span class="p">)</span>  <span class="c1"># distance to the nearer edge of the window
</span>            <span class="k">if</span> <span class="n">room</span> <span class="o">&gt;</span> <span class="n">depth</span><span class="p">[</span><span class="n">i</span><span class="p">]:</span>
                <span class="n">best</span><span class="p">[</span><span class="n">i</span><span class="p">],</span> <span class="n">depth</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="o">=</span> <span class="n">LABELS</span><span class="p">[</span><span class="n">label</span><span class="p">],</span> <span class="n">room</span>
    <span class="k">return</span> <span class="nf">to_spans</span><span class="p">(</span><span class="n">best</span><span class="p">,</span> <span class="n">offsets</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">to_spans</span><span class="p">(</span><span class="n">tags</span><span class="p">,</span> <span class="n">offsets</span><span class="p">):</span>
    <span class="n">spans</span><span class="p">,</span> <span class="n">current</span> <span class="o">=</span> <span class="p">[],</span> <span class="bp">None</span>
    <span class="nf">for </span><span class="p">(</span><span class="n">a</span><span class="p">,</span> <span class="n">b</span><span class="p">),</span> <span class="n">tag</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">offsets</span><span class="p">,</span> <span class="n">tags</span><span class="p">):</span>
        <span class="n">kind</span> <span class="o">=</span> <span class="n">tag</span><span class="p">[</span><span class="mi">2</span><span class="p">:]</span> <span class="k">if</span> <span class="n">tag</span> <span class="o">!=</span> <span class="sh">"</span><span class="s">O</span><span class="sh">"</span> <span class="k">else</span> <span class="bp">None</span>
        <span class="k">if</span> <span class="n">kind</span> <span class="ow">and</span> <span class="p">(</span><span class="n">tag</span><span class="p">.</span><span class="nf">startswith</span><span class="p">(</span><span class="sh">"</span><span class="s">B-</span><span class="sh">"</span><span class="p">)</span> <span class="ow">or</span> <span class="n">current</span> <span class="ow">is</span> <span class="bp">None</span> <span class="ow">or</span> <span class="n">current</span><span class="p">[</span><span class="mi">2</span><span class="p">]</span> <span class="o">!=</span> <span class="n">kind</span><span class="p">):</span>
            <span class="k">if</span> <span class="n">current</span><span class="p">:</span>
                <span class="n">spans</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="nf">tuple</span><span class="p">(</span><span class="n">current</span><span class="p">))</span>
            <span class="n">current</span> <span class="o">=</span> <span class="p">[</span><span class="n">a</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">kind</span><span class="p">]</span>
        <span class="k">elif</span> <span class="n">kind</span><span class="p">:</span>
            <span class="n">current</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span> <span class="o">=</span> <span class="n">b</span>
        <span class="k">elif</span> <span class="n">current</span><span class="p">:</span>
            <span class="n">spans</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="nf">tuple</span><span class="p">(</span><span class="n">current</span><span class="p">))</span>
            <span class="n">current</span> <span class="o">=</span> <span class="bp">None</span>
    <span class="k">if</span> <span class="n">current</span><span class="p">:</span>
        <span class="n">spans</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="nf">tuple</span><span class="p">(</span><span class="n">current</span><span class="p">))</span>
    <span class="k">return</span> <span class="n">spans</span>


<span class="k">def</span> <span class="nf">aligned_gold</span><span class="p">(</span><span class="n">row</span><span class="p">):</span>
    <span class="n">_</span><span class="p">,</span> <span class="n">offsets</span><span class="p">,</span> <span class="n">tags</span> <span class="o">=</span> <span class="nf">encode</span><span class="p">(</span><span class="n">row</span><span class="p">)</span>
    <span class="k">return</span> <span class="nf">to_spans</span><span class="p">(</span><span class="n">tags</span><span class="p">,</span> <span class="n">offsets</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">scores</span><span class="p">(</span><span class="n">predicted</span><span class="p">,</span> <span class="n">gold</span><span class="p">):</span>
    <span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">kind</span> <span class="ow">in</span> <span class="n">KINDS</span> <span class="o">+</span> <span class="p">[</span><span class="sh">"</span><span class="s">all</span><span class="sh">"</span><span class="p">]:</span>
        <span class="n">hits</span> <span class="o">=</span> <span class="n">found</span> <span class="o">=</span> <span class="n">wanted</span> <span class="o">=</span> <span class="mi">0</span>
        <span class="k">for</span> <span class="n">p</span><span class="p">,</span> <span class="n">g</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">predicted</span><span class="p">,</span> <span class="n">gold</span><span class="p">):</span>
            <span class="n">p</span> <span class="o">=</span> <span class="p">{</span><span class="n">s</span> <span class="k">for</span> <span class="n">s</span> <span class="ow">in</span> <span class="n">p</span> <span class="k">if</span> <span class="n">kind</span> <span class="o">==</span> <span class="sh">"</span><span class="s">all</span><span class="sh">"</span> <span class="ow">or</span> <span class="n">s</span><span class="p">[</span><span class="mi">2</span><span class="p">]</span> <span class="o">==</span> <span class="n">kind</span><span class="p">}</span>
            <span class="n">g</span> <span class="o">=</span> <span class="p">{</span><span class="n">s</span> <span class="k">for</span> <span class="n">s</span> <span class="ow">in</span> <span class="n">g</span> <span class="k">if</span> <span class="n">kind</span> <span class="o">==</span> <span class="sh">"</span><span class="s">all</span><span class="sh">"</span> <span class="ow">or</span> <span class="n">s</span><span class="p">[</span><span class="mi">2</span><span class="p">]</span> <span class="o">==</span> <span class="n">kind</span><span class="p">}</span>
            <span class="n">hits</span><span class="p">,</span> <span class="n">found</span><span class="p">,</span> <span class="n">wanted</span> <span class="o">=</span> <span class="n">hits</span> <span class="o">+</span> <span class="nf">len</span><span class="p">(</span><span class="n">p</span> <span class="o">&amp;</span> <span class="n">g</span><span class="p">),</span> <span class="n">found</span> <span class="o">+</span> <span class="nf">len</span><span class="p">(</span><span class="n">p</span><span class="p">),</span> <span class="n">wanted</span> <span class="o">+</span> <span class="nf">len</span><span class="p">(</span><span class="n">g</span><span class="p">)</span>
        <span class="n">precision</span> <span class="o">=</span> <span class="n">hits</span> <span class="o">/</span> <span class="n">found</span> <span class="k">if</span> <span class="n">found</span> <span class="k">else</span> <span class="nf">float</span><span class="p">(</span><span class="sh">"</span><span class="s">nan</span><span class="sh">"</span><span class="p">)</span>
        <span class="n">recall</span> <span class="o">=</span> <span class="n">hits</span> <span class="o">/</span> <span class="n">wanted</span> <span class="k">if</span> <span class="n">wanted</span> <span class="k">else</span> <span class="nf">float</span><span class="p">(</span><span class="sh">"</span><span class="s">nan</span><span class="sh">"</span><span class="p">)</span>
        <span class="n">f1</span> <span class="o">=</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">precision</span> <span class="o">*</span> <span class="n">recall</span> <span class="o">/</span> <span class="p">(</span><span class="n">precision</span> <span class="o">+</span> <span class="n">recall</span><span class="p">)</span> <span class="k">if</span> <span class="n">hits</span> <span class="k">else</span> <span class="mf">0.0</span>
        <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">group</span><span class="sh">"</span><span class="p">:</span> <span class="n">kind</span><span class="p">,</span> <span class="sh">"</span><span class="s">spans</span><span class="sh">"</span><span class="p">:</span> <span class="n">wanted</span><span class="p">,</span> <span class="sh">"</span><span class="s">precision</span><span class="sh">"</span><span class="p">:</span> <span class="n">precision</span><span class="p">,</span>
                     <span class="sh">"</span><span class="s">recall</span><span class="sh">"</span><span class="p">:</span> <span class="n">recall</span><span class="p">,</span> <span class="sh">"</span><span class="s">F1</span><span class="sh">"</span><span class="p">:</span> <span class="n">f1</span><span class="p">})</span>
    <span class="k">return</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">)</span>
</code></pre></div></div> <p>First the experiment that explains why BERT mattered. The same network is fine-tuned twice on the same documents: once starting from Google’s weights, once from random ones, each with the same 300 updates of the weights. We repeat it with more and more training documents.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">random</span><span class="p">.</span><span class="nf">seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">test_subset</span> <span class="o">=</span> <span class="n">test_rows</span><span class="p">.</span><span class="nf">select</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="nf">min</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">test_rows</span><span class="p">),</span> <span class="mi">400</span><span class="p">)))</span>
<span class="n">test_gold</span> <span class="o">=</span> <span class="p">[</span><span class="nf">aligned_gold</span><span class="p">(</span><span class="n">row</span><span class="p">)</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">test_subset</span><span class="p">]</span>
<span class="n">SIZES</span> <span class="o">=</span> <span class="p">[</span><span class="mi">16</span><span class="p">]</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="p">[</span><span class="mi">100</span><span class="p">,</span> <span class="mi">400</span><span class="p">,</span> <span class="mi">1600</span><span class="p">]</span>  <span class="c1"># CI runs on a slow CPU
</span><span class="n">curve</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">size</span> <span class="ow">in</span> <span class="n">SIZES</span><span class="p">:</span>
    <span class="n">data</span> <span class="o">=</span> <span class="nf">examples</span><span class="p">(</span><span class="n">train_rows</span><span class="p">.</span><span class="nf">select</span><span class="p">(</span><span class="nf">range</span><span class="p">(</span><span class="n">size</span><span class="p">)))</span>
    <span class="k">for</span> <span class="n">pretrained</span> <span class="ow">in</span> <span class="p">(</span><span class="bp">True</span><span class="p">,</span> <span class="bp">False</span><span class="p">):</span>
        <span class="n">t0</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
        <span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
        <span class="n">tagger</span> <span class="o">=</span> <span class="nf">train</span><span class="p">(</span><span class="nf">new_tagger</span><span class="p">(</span><span class="n">pretrained</span><span class="p">),</span> <span class="n">data</span><span class="p">,</span> <span class="n">steps</span><span class="o">=</span><span class="mi">10</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">300</span><span class="p">)</span>
        <span class="n">predicted</span> <span class="o">=</span> <span class="p">[</span><span class="nf">predict</span><span class="p">(</span><span class="n">tagger</span><span class="p">,</span> <span class="n">row</span><span class="p">)</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">test_subset</span><span class="p">]</span>
        <span class="n">f1</span> <span class="o">=</span> <span class="nf">scores</span><span class="p">(</span><span class="n">predicted</span><span class="p">,</span> <span class="n">test_gold</span><span class="p">).</span><span class="nf">set_index</span><span class="p">(</span><span class="sh">"</span><span class="s">group</span><span class="sh">"</span><span class="p">).</span><span class="n">loc</span><span class="p">[</span><span class="sh">"</span><span class="s">all</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">F1</span><span class="sh">"</span><span class="p">]</span>
        <span class="n">start</span> <span class="o">=</span> <span class="sh">"</span><span class="s">BERT</span><span class="sh">'</span><span class="s">s weights</span><span class="sh">"</span> <span class="k">if</span> <span class="n">pretrained</span> <span class="k">else</span> <span class="sh">"</span><span class="s">random</span><span class="sh">"</span>
        <span class="n">curve</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">documents</span><span class="sh">"</span><span class="p">:</span> <span class="n">size</span><span class="p">,</span> <span class="sh">"</span><span class="s">start</span><span class="sh">"</span><span class="p">:</span> <span class="n">start</span><span class="p">,</span> <span class="sh">"</span><span class="s">F1</span><span class="sh">"</span><span class="p">:</span> <span class="n">f1</span><span class="p">,</span>
                      <span class="sh">"</span><span class="s">minutes</span><span class="sh">"</span><span class="p">:</span> <span class="p">(</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">t0</span><span class="p">)</span> <span class="o">/</span> <span class="mi">60</span><span class="p">})</span>
        <span class="k">del</span> <span class="n">tagger</span>
        <span class="k">if</span> <span class="n">device</span> <span class="o">==</span> <span class="sh">"</span><span class="s">cuda</span><span class="sh">"</span><span class="p">:</span>
            <span class="n">torch</span><span class="p">.</span><span class="n">cuda</span><span class="p">.</span><span class="nf">empty_cache</span><span class="p">()</span>
<span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">curve</span><span class="p">))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">documents</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">start</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">F1</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">minutes</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">100</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">BERT's weights</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.53</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.33</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">100</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">random</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.05</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.42</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">400</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">BERT's weights</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.59</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.76</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">400</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">random</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.07</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2.82</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,600</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">BERT's weights</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.64</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.12</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,600</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">random</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.08</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3.16</td></tr></tbody></table></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">curve_frame</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">curve</span><span class="p">)</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">6.4</span><span class="p">,</span> <span class="mf">3.6</span><span class="p">))</span>
<span class="k">for</span> <span class="n">start</span><span class="p">,</span> <span class="n">color</span> <span class="ow">in</span> <span class="p">[(</span><span class="sh">"</span><span class="s">BERT</span><span class="sh">'</span><span class="s">s weights</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">]),</span> <span class="p">(</span><span class="sh">"</span><span class="s">random</span><span class="sh">"</span><span class="p">,</span> <span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">dec</span><span class="sh">"</span><span class="p">])]:</span>
    <span class="n">part</span> <span class="o">=</span> <span class="n">curve_frame</span><span class="p">[</span><span class="n">curve_frame</span><span class="p">[</span><span class="sh">"</span><span class="s">start</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="n">start</span><span class="p">]</span>
    <span class="n">ax</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span><span class="n">part</span><span class="p">[</span><span class="sh">"</span><span class="s">documents</span><span class="sh">"</span><span class="p">],</span> <span class="n">part</span><span class="p">[</span><span class="sh">"</span><span class="s">F1</span><span class="sh">"</span><span class="p">],</span> <span class="n">marker</span><span class="o">=</span><span class="sh">"</span><span class="s">o</span><span class="sh">"</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">color</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="n">start</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xscale</span><span class="p">(</span><span class="sh">"</span><span class="s">log</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xticks</span><span class="p">(</span><span class="n">SIZES</span><span class="p">,</span> <span class="p">[</span><span class="nf">str</span><span class="p">(</span><span class="n">s</span><span class="p">)</span> <span class="k">for</span> <span class="n">s</span> <span class="ow">in</span> <span class="n">SIZES</span><span class="p">])</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylim</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">Same network, same data: starting from pre-trained weights</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xlabel</span><span class="p">(</span><span class="sh">"</span><span class="s">training documents</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylabel</span><span class="p">(</span><span class="sh">"</span><span class="s">entity F1 on the test documents</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/01/output-13.png" alt="Same network, same data: starting from pre-trained weights" loading="lazy"></p> <p>This is the chart that changed NLP in 2018. With a hundred documents the pre-trained network already gets about half of the spans exactly right.</p> <p>The random one gets almost none, and sixteen times more documents barely move it: it spends its 300 updates learning that most tokens are <code class="language-plaintext highlighter-rouge">O</code>, while the pre-trained one starts from a model of English and only has to learn what a name or an IBAN looks like in these documents.</p> <p>With far more updates and data the random network would get further; pre-training paid for those in advance.</p> <div class="callout callout-key"> <p class="callout-label">Key point</p> <p>The four days of Google’s TPUs are not in the architecture, since the two networks are identical. They are in the weights.</p> </div> <p>Now the real model, on all the training documents:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">train_data</span> <span class="o">=</span> <span class="nf">examples</span><span class="p">(</span><span class="n">train_rows</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">train_data</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> windows from </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">train_rows</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> documents</span><span class="sh">"</span><span class="p">)</span>
<span class="n">t0</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
<span class="n">torch</span><span class="p">.</span><span class="nf">manual_seed</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">tagger</span> <span class="o">=</span> <span class="nf">train</span><span class="p">(</span><span class="nf">new_tagger</span><span class="p">(</span><span class="n">pretrained</span><span class="o">=</span><span class="bp">True</span><span class="p">),</span> <span class="n">train_data</span><span class="p">,</span> <span class="n">epochs</span><span class="o">=</span><span class="mi">1</span> <span class="k">if</span> <span class="n">SMOKE</span> <span class="k">else</span> <span class="mi">2</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">fine-tuned in </span><span class="si">{</span><span class="p">(</span><span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">t0</span><span class="p">)</span> <span class="o">/</span> <span class="mi">60</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s"> min</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>30,142 windows from 25,948 documents
fine-tuned in 30.7 min</code></pre> <h2 id="9-bert-against-regular-expressions">9. BERT against regular expressions</h2> <p>The fair opponent is what a careful engineer would write first: regular expressions for everything that has a shape. Emails, phone numbers, IBANs, card numbers checked with the Luhn algorithm, dates in the common formats, IP addresses, social security numbers. Names, companies and addresses get no regex, because there is no honest one to write.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">MONTHS</span> <span class="o">=</span> <span class="sh">"</span><span class="s">Jan|Feb|Mar|Apr|May|Jun|Jul|Aug|Sep|Oct|Nov|Dec</span><span class="sh">"</span>
<span class="n">PATTERNS</span> <span class="o">=</span> <span class="p">{</span>
    <span class="sh">"</span><span class="s">EMAIL</span><span class="sh">"</span><span class="p">:</span> <span class="sa">r</span><span class="sh">"</span><span class="s">[\w.+-]+@[\w-]+(?:\.[\w-]+)+</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">PHONE</span><span class="sh">"</span><span class="p">:</span> <span class="sa">r</span><span class="sh">"</span><span class="s">(?&lt;![\w-])(?:\+\d{1,3}[\s.-]?)?(?:\(\d{2,4}\)[\s.-]?)?\d{3}[\s.-]\d{3,4}</span><span class="sh">"</span>
             <span class="sa">r</span><span class="sh">"</span><span class="s">(?:[\s.-]\d{2,4})?(?![\w-])</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">BANK</span><span class="sh">"</span><span class="p">:</span> <span class="sa">r</span><span class="sh">"</span><span class="s">\b[A-Z]{2}\d{2}(?:\s?[A-Z0-9]{4}){2,7}(?:\s?[A-Z0-9]{1,4})?\b</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">CARD</span><span class="sh">"</span><span class="p">:</span> <span class="sa">r</span><span class="sh">"</span><span class="s">\b(?:\d[ -]?){12,18}\d\b</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">DATE</span><span class="sh">"</span><span class="p">:</span> <span class="sa">rf</span><span class="sh">"</span><span class="s">\b\d{{4}}-\d{{2}}-\d{{2}}\b|\b\d{{1,2}}/\d{{1,2}}/\d{{2,4}}\b</span><span class="sh">"</span>
            <span class="sa">rf</span><span class="sh">"</span><span class="s">|\b(?:</span><span class="si">{</span><span class="n">MONTHS</span><span class="si">}</span><span class="s">)[a-z]*\.? \d{{1,2}},? \d{{4}}\b</span><span class="sh">"</span>
            <span class="sa">rf</span><span class="sh">"</span><span class="s">|\b\d{{1,2}} (?:</span><span class="si">{</span><span class="n">MONTHS</span><span class="si">}</span><span class="s">)[a-z]* \d{{4}}\b</span><span class="sh">"</span>
            <span class="sa">rf</span><span class="sh">"</span><span class="s">|\b\d{{1,2}}:\d{{2}}(?::\d{{2}})?(?:\s?[AP]M)?\b</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">DIGITAL</span><span class="sh">"</span><span class="p">:</span> <span class="sa">r</span><span class="sh">"</span><span class="s">\b(?:\d{1,3}\.){3}\d{1,3}\b|\b(?:[0-9a-fA-F]{1,4}:){7}[0-9a-fA-F]{1,4}\b</span><span class="sh">"</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">GOV_ID</span><span class="sh">"</span><span class="p">:</span> <span class="sa">r</span><span class="sh">"</span><span class="s">\b\d{3}-\d{2}-\d{4}\b</span><span class="sh">"</span><span class="p">,</span>
<span class="p">}</span>


<span class="k">def</span> <span class="nf">luhn</span><span class="p">(</span><span class="n">digits</span><span class="p">):</span>
    <span class="n">total</span> <span class="o">=</span> <span class="mi">0</span>
    <span class="k">for</span> <span class="n">i</span><span class="p">,</span> <span class="n">d</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="nf">reversed</span><span class="p">(</span><span class="n">digits</span><span class="p">)):</span>
        <span class="n">d</span> <span class="o">=</span> <span class="nf">int</span><span class="p">(</span><span class="n">d</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">i</span> <span class="o">%</span> <span class="mi">2</span> <span class="o">==</span> <span class="mi">1</span><span class="p">:</span>
            <span class="n">d</span> <span class="o">=</span> <span class="n">d</span> <span class="o">*</span> <span class="mi">2</span> <span class="o">-</span> <span class="mi">9</span> <span class="k">if</span> <span class="n">d</span> <span class="o">*</span> <span class="mi">2</span> <span class="o">&gt;</span> <span class="mi">9</span> <span class="k">else</span> <span class="n">d</span> <span class="o">*</span> <span class="mi">2</span>
        <span class="n">total</span> <span class="o">+=</span> <span class="n">d</span>
    <span class="k">return</span> <span class="n">total</span> <span class="o">%</span> <span class="mi">10</span> <span class="o">==</span> <span class="mi">0</span>


<span class="k">def</span> <span class="nf">regex_spans</span><span class="p">(</span><span class="n">row</span><span class="p">):</span>
    <span class="n">text</span> <span class="o">=</span> <span class="n">row</span><span class="p">[</span><span class="sh">"</span><span class="s">generated_text</span><span class="sh">"</span><span class="p">]</span>
    <span class="n">_</span><span class="p">,</span> <span class="n">offsets</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="nf">encode</span><span class="p">(</span><span class="n">row</span><span class="p">)</span>
    <span class="n">found</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">kind</span><span class="p">,</span> <span class="n">pattern</span> <span class="ow">in</span> <span class="n">PATTERNS</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
        <span class="k">for</span> <span class="n">match</span> <span class="ow">in</span> <span class="n">re</span><span class="p">.</span><span class="nf">finditer</span><span class="p">(</span><span class="n">pattern</span><span class="p">,</span> <span class="n">text</span><span class="p">):</span>
            <span class="k">if</span> <span class="n">kind</span> <span class="o">==</span> <span class="sh">"</span><span class="s">CARD</span><span class="sh">"</span> <span class="ow">and</span> <span class="ow">not</span> <span class="nf">luhn</span><span class="p">(</span><span class="n">re</span><span class="p">.</span><span class="nf">sub</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s">\D</span><span class="sh">"</span><span class="p">,</span> <span class="sh">""</span><span class="p">,</span> <span class="n">match</span><span class="p">.</span><span class="nf">group</span><span class="p">())):</span>
                <span class="k">continue</span>
            <span class="n">inside</span> <span class="o">=</span> <span class="p">[(</span><span class="n">a</span><span class="p">,</span> <span class="n">b</span><span class="p">)</span> <span class="k">for</span> <span class="n">a</span><span class="p">,</span> <span class="n">b</span> <span class="ow">in</span> <span class="n">offsets</span> <span class="k">if</span> <span class="n">a</span> <span class="o">&gt;=</span> <span class="n">match</span><span class="p">.</span><span class="nf">start</span><span class="p">()</span> <span class="ow">and</span> <span class="n">b</span> <span class="o">&lt;=</span> <span class="n">match</span><span class="p">.</span><span class="nf">end</span><span class="p">()]</span>
            <span class="k">if</span> <span class="n">inside</span><span class="p">:</span>  <span class="c1"># the same token grid as the model's predictions
</span>                <span class="n">found</span><span class="p">.</span><span class="nf">append</span><span class="p">((</span><span class="n">inside</span><span class="p">[</span><span class="mi">0</span><span class="p">][</span><span class="mi">0</span><span class="p">],</span> <span class="n">inside</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">][</span><span class="mi">1</span><span class="p">],</span> <span class="n">kind</span><span class="p">))</span>
    <span class="k">return</span> <span class="n">found</span>


<span class="n">test_all</span> <span class="o">=</span> <span class="n">test_rows</span>
<span class="n">gold_all</span> <span class="o">=</span> <span class="p">[</span><span class="nf">aligned_gold</span><span class="p">(</span><span class="n">row</span><span class="p">)</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">test_all</span><span class="p">]</span>
<span class="n">t0</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
<span class="n">bert_found</span> <span class="o">=</span> <span class="p">[</span><span class="nf">predict</span><span class="p">(</span><span class="n">tagger</span><span class="p">,</span> <span class="n">row</span><span class="p">)</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">test_all</span><span class="p">]</span>
<span class="n">seconds</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">t0</span>
<span class="n">regex_found</span> <span class="o">=</span> <span class="p">[</span><span class="nf">regex_spans</span><span class="p">(</span><span class="n">row</span><span class="p">)</span> <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">test_all</span><span class="p">]</span>
<span class="n">bert_scores</span> <span class="o">=</span> <span class="nf">scores</span><span class="p">(</span><span class="n">bert_found</span><span class="p">,</span> <span class="n">gold_all</span><span class="p">).</span><span class="nf">set_index</span><span class="p">(</span><span class="sh">"</span><span class="s">group</span><span class="sh">"</span><span class="p">)</span>
<span class="n">regex_scores</span> <span class="o">=</span> <span class="nf">scores</span><span class="p">(</span><span class="n">regex_found</span><span class="p">,</span> <span class="n">gold_all</span><span class="p">).</span><span class="nf">set_index</span><span class="p">(</span><span class="sh">"</span><span class="s">group</span><span class="sh">"</span><span class="p">)</span>
<span class="n">comparison</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">({</span><span class="sh">"</span><span class="s">spans</span><span class="sh">"</span><span class="p">:</span> <span class="n">bert_scores</span><span class="p">[</span><span class="sh">"</span><span class="s">spans</span><span class="sh">"</span><span class="p">],</span>
                           <span class="sh">"</span><span class="s">BERT F1</span><span class="sh">"</span><span class="p">:</span> <span class="n">bert_scores</span><span class="p">[</span><span class="sh">"</span><span class="s">F1</span><span class="sh">"</span><span class="p">],</span>
                           <span class="sh">"</span><span class="s">regex F1</span><span class="sh">"</span><span class="p">:</span> <span class="n">regex_scores</span><span class="p">[</span><span class="sh">"</span><span class="s">F1</span><span class="sh">"</span><span class="p">].</span><span class="nf">where</span><span class="p">(</span>
                               <span class="n">regex_scores</span><span class="p">.</span><span class="n">index</span><span class="p">.</span><span class="nf">isin</span><span class="p">(</span><span class="nf">list</span><span class="p">(</span><span class="n">PATTERNS</span><span class="p">)</span> <span class="o">+</span> <span class="p">[</span><span class="sh">"</span><span class="s">all</span><span class="sh">"</span><span class="p">]))})</span>
<span class="nf">display</span><span class="p">(</span><span class="nf">table</span><span class="p">(</span><span class="n">comparison</span><span class="p">.</span><span class="nf">reset_index</span><span class="p">().</span><span class="nf">fillna</span><span class="p">(</span><span class="sh">"</span><span class="s">—</span><span class="sh">"</span><span class="p">)))</span>  <span class="c1"># no regex for that group
</span><span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">BERT tagged </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">test_all</span><span class="p">)</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> documents in </span><span class="si">{</span><span class="n">seconds</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> s, </span><span class="sh">"</span>
      <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">test_all</span><span class="p">)</span> <span class="o">/</span> <span class="n">seconds</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> documents a second</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">group</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">spans</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">BERT F1</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">regex F1</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">ACCOUNT</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">281</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.81</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">ADDRESS</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">2,330</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.86</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">BANK</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">425</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.87</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.31</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">CARD</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">175</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.74</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.31</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">COMPANY</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">3,606</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.78</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">DATE</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">6,638</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.82</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.45</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">DIGITAL</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">289</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.76</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.69</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">EMAIL</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">844</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.86</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.93</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">GOV_ID</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">225</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.85</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.45</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">LOCATION</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">67</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.59</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">PERSON</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">4,555</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.85</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">—</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">PHONE</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">532</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.90</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.58</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">all</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">19,967</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.82</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.30</td></tr></tbody></table></div> <pre class="tfs-printed"><code>BERT tagged 2,962 documents in 51 s, 58 documents a second</code></pre> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">shown_kinds</span> <span class="o">=</span> <span class="p">[</span><span class="n">k</span> <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="n">KINDS</span> <span class="k">if</span> <span class="n">bert_scores</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">k</span><span class="p">,</span> <span class="sh">"</span><span class="s">spans</span><span class="sh">"</span><span class="p">]</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">]</span>
<span class="n">x</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">shown_kinds</span><span class="p">))</span>
<span class="n">fig</span><span class="p">,</span> <span class="n">ax</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="nf">subplots</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mf">8.4</span><span class="p">,</span> <span class="mf">3.6</span><span class="p">))</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">bar</span><span class="p">(</span><span class="n">x</span> <span class="o">-</span> <span class="mf">0.2</span><span class="p">,</span> <span class="p">[</span><span class="n">bert_scores</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">k</span><span class="p">,</span> <span class="sh">"</span><span class="s">F1</span><span class="sh">"</span><span class="p">]</span> <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="n">shown_kinds</span><span class="p">],</span> <span class="mf">0.4</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">enc</span><span class="sh">"</span><span class="p">],</span>
       <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">fine-tuned BERT</span><span class="sh">"</span><span class="p">)</span>
<span class="n">regex_values</span> <span class="o">=</span> <span class="p">[</span><span class="n">regex_scores</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">k</span><span class="p">,</span> <span class="sh">"</span><span class="s">F1</span><span class="sh">"</span><span class="p">]</span> <span class="k">if</span> <span class="n">k</span> <span class="ow">in</span> <span class="n">PATTERNS</span> <span class="k">else</span> <span class="mi">0</span> <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="n">shown_kinds</span><span class="p">]</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">bar</span><span class="p">(</span><span class="n">x</span> <span class="o">+</span> <span class="mf">0.2</span><span class="p">,</span> <span class="n">regex_values</span><span class="p">,</span> <span class="mf">0.4</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">COLORS</span><span class="p">[</span><span class="sh">"</span><span class="s">data</span><span class="sh">"</span><span class="p">],</span> <span class="n">label</span><span class="o">=</span><span class="sh">"</span><span class="s">regular expressions</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_xticks</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">shown_kinds</span><span class="p">,</span> <span class="n">rotation</span><span class="o">=</span><span class="mi">35</span><span class="p">,</span> <span class="n">ha</span><span class="o">=</span><span class="sh">"</span><span class="s">right</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_ylim</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">set_title</span><span class="p">(</span><span class="sh">"</span><span class="s">Entity F1 on the test documents, by group</span><span class="sh">"</span><span class="p">)</span>
<span class="n">ax</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">frameon</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">loc</span><span class="o">=</span><span class="sh">"</span><span class="s">upper left</span><span class="sh">"</span><span class="p">,</span> <span class="n">bbox_to_anchor</span><span class="o">=</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">))</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">show</span><span class="p">()</span>
</code></pre></div></div> <p><img class="tfs-output" src="/assets/posts/arch/01/output-14.png" alt="Entity F1 on the test documents, by group" loading="lazy"></p> <p>Look at emails first: there the regular expression beats the model. An email address has a strict shape, and a pattern matches it character by character, while BERT reads tokens and now and then stops a piece short. Everywhere else the model is ahead, by the most on bank details, card numbers, ID numbers and dates.</p> <p>The regular expressions lose there on both counts: they miss every format nobody wrote a pattern for, a passport number, an account number without a country code, a date spelled out in words, and they flag strings of the right shape that are nobody’s personal data.</p> <p>And for people, companies and addresses, most of the personal data in these documents, there is no pattern to compare with at all. BERT reads the context: <em>Full Name:</em> before a string makes it a person, <em>Ship to</em> before a line makes it an address.</p> <div class="callout"> <p class="callout-label">In practice</p> <p>The two are combined: patterns for the few strict shapes, where they are exact and easy to audit, and the model for everything else.</p> </div> <p>Here is the model at work on a test document it has never seen, everything it found replaced by its group:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">redact</span><span class="p">(</span><span class="n">text</span><span class="p">,</span> <span class="n">spans</span><span class="p">):</span>
    <span class="n">out</span><span class="p">,</span> <span class="n">last</span> <span class="o">=</span> <span class="p">[],</span> <span class="mi">0</span>
    <span class="k">for</span> <span class="n">start</span><span class="p">,</span> <span class="n">end</span><span class="p">,</span> <span class="n">kind</span> <span class="ow">in</span> <span class="nf">sorted</span><span class="p">(</span><span class="n">spans</span><span class="p">):</span>
        <span class="n">out</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">text</span><span class="p">[</span><span class="n">last</span><span class="p">:</span><span class="n">start</span><span class="p">])</span>
        <span class="n">out</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">[</span><span class="si">{</span><span class="n">kind</span><span class="si">}</span><span class="s">]</span><span class="sh">"</span><span class="p">)</span>
        <span class="n">last</span> <span class="o">=</span> <span class="n">end</span>
    <span class="n">out</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">text</span><span class="p">[</span><span class="n">last</span><span class="p">:])</span>
    <span class="k">return</span> <span class="sh">""</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">out</span><span class="p">)</span>


<span class="c1"># a test document with something of every common group in its first 1,200 characters,
# and none of the generator's unfilled template fields, such as "[Graduation Date]"
</span><span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">test_all</span><span class="p">)):</span>
    <span class="n">early</span> <span class="o">=</span> <span class="p">[</span><span class="n">s</span> <span class="k">for</span> <span class="n">s</span> <span class="ow">in</span> <span class="n">bert_found</span><span class="p">[</span><span class="n">k</span><span class="p">]</span> <span class="k">if</span> <span class="n">s</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span> <span class="o">&lt;=</span> <span class="mi">1200</span><span class="p">]</span>
    <span class="n">filled</span> <span class="o">=</span> <span class="sh">"</span><span class="s">[</span><span class="sh">"</span> <span class="ow">not</span> <span class="ow">in</span> <span class="n">test_all</span><span class="p">[</span><span class="n">k</span><span class="p">][</span><span class="sh">"</span><span class="s">generated_text</span><span class="sh">"</span><span class="p">][:</span><span class="mi">1200</span><span class="p">]</span>
    <span class="k">if</span> <span class="n">filled</span> <span class="ow">and</span> <span class="p">{</span><span class="sh">"</span><span class="s">PERSON</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">COMPANY</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">ADDRESS</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">DATE</span><span class="sh">"</span><span class="p">}</span> <span class="o">&lt;=</span> <span class="p">{</span><span class="n">s</span><span class="p">[</span><span class="mi">2</span><span class="p">]</span> <span class="k">for</span> <span class="n">s</span> <span class="ow">in</span> <span class="n">early</span><span class="p">}:</span>
        <span class="k">break</span>
<span class="n">demo</span><span class="p">,</span> <span class="n">demo_spans</span> <span class="o">=</span> <span class="n">test_all</span><span class="p">[</span><span class="n">k</span><span class="p">],</span> <span class="n">early</span>
<span class="nf">print</span><span class="p">(</span><span class="n">demo</span><span class="p">[</span><span class="sh">"</span><span class="s">document_type</span><span class="sh">"</span><span class="p">])</span>
<span class="nf">display</span><span class="p">(</span><span class="nf">highlight</span><span class="p">(</span><span class="n">demo</span><span class="p">[</span><span class="sh">"</span><span class="s">generated_text</span><span class="sh">"</span><span class="p">][:</span><span class="mi">1200</span><span class="p">],</span> <span class="n">demo_spans</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">redact</span><span class="p">(</span><span class="n">demo</span><span class="p">[</span><span class="sh">"</span><span class="s">generated_text</span><span class="sh">"</span><span class="p">][:</span><span class="mi">1200</span><span class="p">],</span> <span class="n">demo_spans</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>Credit Application</code></pre> <div class="tfs-table-wrap"><div style="white-space:pre-wrap;font-size:0.85em;line-height:1.55">--- Credit Application - Medical Loan Full Name: <span style="background:#D23F572e;border-bottom:2px solid #D23F57;padding:0 2px">John Smith<sub style="color:#D23F57;font-size:0.7em"> PERSON</sub></span> Date of Birth: <span style="background:#C27A0E2e;border-bottom:2px solid #C27A0E;padding:0 2px">01/01/1980<sub style="color:#C27A0E;font-size:0.7em"> DATE</sub></span> Address: <span style="background:#0F8C7E2e;border-bottom:2px solid #0F8C7E;padding:0 2px">123 Maple Street, Anytown, USA<sub style="color:#0F8C7E;font-size:0.7em"> ADDRESS</sub></span> Email: <span style="background:#5B65752e;border-bottom:2px solid #5B6575;padding:0 2px">john.smith@email.com<sub style="color:#5B6575;font-size:0.7em"> EMAIL</sub></span> Phone: <span style="background:#5B65752e;border-bottom:2px solid #5B6575;padding:0 2px">(123) 456-7890<sub style="color:#5B6575;font-size:0.7em"> PHONE</sub></span> Employment Information Employer Name: <span style="background:#6A55D82e;border-bottom:2px solid #6A55D8;padding:0 2px">XYZ Corporation<sub style="color:#6A55D8;font-size:0.7em"> COMPANY</sub></span> Address: <span style="background:#0F8C7E2e;border-bottom:2px solid #0F8C7E;padding:0 2px">456 Oak Street, Anytown, USA<sub style="color:#0F8C7E;font-size:0.7em"> ADDRESS</sub></span> Job Title: Software Engineer <span style="background:#C27A0E2e;border-bottom:2px solid #C27A0E;padding:0 2px">Monthly<sub style="color:#C27A0E;font-size:0.7em"> DATE</sub></span> Income: $7,500 Loan Details Loan Amount: $25,000 Loan Purpose: Cover medical expenses for upcoming surgery Medical Provider Information Provider Name: <span style="background:#D23F572e;border-bottom:2px solid #D23F57;padding:0 2px">Dr. Jane Doe<sub style="color:#D23F57;font-size:0.7em"> PERSON</sub></span> Address: <span style="background:#0F8C7E2e;border-bottom:2px solid #0F8C7E;padding:0 2px">789 Pine Street, Anytown, USA<sub style="color:#0F8C7E;font-size:0.7em"> ADDRESS</sub></span> Phone: <span style="background:#5B65752e;border-bottom:2px solid #5B6575;padding:0 2px">(987) 654-3210<sub style="color:#5B6575;font-size:0.7em"> PHONE</sub></span> Treatment Details Description of Medical Services: - Pre-surgery consultation and testing - Complex knee surgery - Post-surgery rehabilitation Cost Breakdown - Pre-surgery consultation and testing: $3,500 - Surgery: $20,000 - Rehabilitation: $1,500 - Total: $25,000 I, <span style="background:#D23F572e;border-bottom:2px solid #D23F57;padding:0 2px">John Smith<sub style="color:#D23F57;font-size:0.7em"> PERSON</sub></span>, hereby authorize the release of my medical and financial information to the necessary parties for the purpose of processing this loan application. Signature: <span style="background:#D23F572e;border-bottom:2px solid #D23F57;padding:0 2px">John Smith<sub style="color:#D23F57;font-size:0.7em"> PERSON</sub></span> Date: <span style="background:#C27A0E2e;border-bottom:2px solid #C27A0E;padding:0 2px">01/15/2023<sub style="color:#C27A0E;font-size:0.7em"> DATE</sub></span> ---</div></div> <pre class="tfs-printed"><code>---
Credit Application - Medical Loan

Full Name: [PERSON]
Date of Birth: [DATE]
Address: [ADDRESS]
Email: [EMAIL]
Phone: [PHONE]

Employment Information

Employer Name: [COMPANY]
Address: [ADDRESS]
Job Title: Software Engineer
[DATE] Income: $7,500

Loan Details

Loan Amount: $25,000
Loan Purpose: Cover medical expenses for upcoming surgery

Medical Provider Information

Provider Name: [PERSON]
Address: [ADDRESS]
Phone: [PHONE]

Treatment Details

Description of Medical Services:
- Pre-surgery consultation and testing
- Complex knee surgery
- Post-surgery rehabilitation

Cost Breakdown

- Pre-surgery consultation and testing: $3,500
- Surgery: $20,000
- Rehabilitation: $1,500
- Total: $25,000

I, [PERSON], hereby authorize the release of my medical and financial information to the necessary parties for the purpose of processing this loan application.

Signature: [PERSON]
Date: [DATE]

---</code></pre> <p>One mistake is in plain sight: in “Monthly Income” the model took <em>Monthly</em> for a date, a word it has seen next to dates many times.</p> <p>Two caveats belong next to any number above. The test documents come from the same generator as the training ones, with the same templates and the same habits, so the scores are an upper bound for real documents, which will be messier. And a share of the “errors” are the annotation’s, as we saw in section 7.</p> <p>Before a model like this masks real data, it needs a few hundred real documents annotated by people, and a threshold chosen for recall, since a missed account number costs more than a masked word.</p> <h2 id="10-where-bert-is-the-right-tool-today">10. Where BERT is the right tool today</h2> <p>BERT was overtaken years ago on every leaderboard, and it is still everywhere.</p> <p>For the jobs it was built for, classifying text and labelling tokens, a fine-tuned encoder of a hundred million parameters is usually as accurate as a large language model asked nicely, and far cheaper: our tagger went through almost three thousand documents in under a minute on a free T4, while a 70-billion-parameter model has more than six hundred times as many weights to run for every token it writes.</p> <p>BERT reads the whole input at once instead of producing text token by token, its output is a label rather than prose that must be parsed, and it runs on a CPU if it has to.</p> <p>Where it is the wrong tool: anything that needs generation, anything longer than 512 tokens that can’t be cut into windows, and languages it didn’t see in pre-training (multilingual BERT covers 104 languages, worse than the English one covers English).</p> <p>Its 2018 training recipe has also aged; the next lesson takes it apart and shows what seven years of improvements did to it, from RoBERTa to ModernBERT.</p> <p>Every lesson of this course ends with the same card, the architecture’s passport, so that the models can be compared side by side:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/01/passport-light.png" width="760" alt="BERT's passport. Published October 2018 by Google. Type: encoder. Pre-training objective: masked language modelling and next sentence prediction. Attention: bidirectional, full. Positions: learned, up to 512. Normalisation: LayerNorm after each sublayer. Activation: GELU. Sizes: base 110 million parameters, 12 layers, width 768; large 340 million, 24 layers, width 1024. Best at: classification, tagging, retrieval" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/01/passport-dark.png" width="760" alt="BERT's passport. Published October 2018 by Google. Type: encoder. Pre-training objective: masked language modelling and next sentence prediction. Attention: bidirectional, full. Positions: learned, up to 512. Normalisation: LayerNorm after each sublayer. Activation: GELU. Sizes: base 110 million parameters, 12 layers, width 768; large 340 million, 24 layers, width 1024. Best at: classification, tagging, retrieval" loading="lazy"></p> <p>and with the family tree, which grows by one branch per lesson:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/arch/01/family-light.png" width="760" alt="The family of the Transformer as this course covers it, from the 2017 Transformer: encoders (BERT, RoBERTa to ModernBERT, sentence embeddings), decoders (GPT, modern LLMs, mixtures of experts, long context, Mamba hybrids), encoder–decoders (T5 and BART, Whisper) and models beyond text (ViT, CLIP, vision-language models, diffusion transformers). BERT, this lesson, is highlighted" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/arch/01/family-dark.png" width="760" alt="The family of the Transformer as this course covers it, from the 2017 Transformer: encoders (BERT, RoBERTa to ModernBERT, sentence embeddings), decoders (GPT, modern LLMs, mixtures of experts, long context, Mamba hybrids), encoder–decoders (T5 and BART, Whisper) and models beyond text (ViT, CLIP, vision-language models, diffusion transformers). BERT, this lesson, is highlighted" loading="lazy"></p> <h2 id="references">References</h2> <ol class="tfs-refs"> <li id="ref-1">Nayak, P. (2019). <a href="https://blog.google/products/search/search-language-understanding-bert/">Understanding searches better than ever before</a>. Google, 25 October 2019. <a class="ref-back" href="#cite-1" aria-label="Back to the text">↩</a></li> <li id="ref-2">Devlin, J., Chang, M.-W., Lee, K., &amp; Toutanova, K. (2018). <a href="https://arxiv.org/abs/1810.04805">BERT: pre-training of deep bidirectional transformers for language understanding</a>. <em>NAACL 2019</em>. <a class="ref-back" href="#cite-2" aria-label="Back to the text">↩</a></li> <li id="ref-3">Peters, M. E., Neumann, M., Iyyer, M., Gardner, M., Clark, C., Lee, K., &amp; Zettlemoyer, L. (2018). <a href="https://arxiv.org/abs/1802.05365">Deep contextualized word representations</a>. <em>NAACL 2018</em>. <a class="ref-back" href="#cite-3" aria-label="Back to the text">↩</a></li> <li id="ref-4">Radford, A., Narasimhan, K., Salimans, T., &amp; Sutskever, I. (2018). <a href="https://cdn.openai.com/research-covers/language-unsupervised/language_understanding_paper.pdf">Improving language understanding by generative pre-training</a>. OpenAI. <a class="ref-back" href="#cite-4" aria-label="Back to the text">↩</a></li> <li id="ref-5">Taylor, W. L. (1953). <a href="https://doi.org/10.1177/107769905303000401">“Cloze procedure”: a new tool for measuring readability</a>. <em>Journalism Quarterly</em>, 30(4), 415–433. <a class="ref-back" href="#cite-5" aria-label="Back to the text">↩</a></li> <li id="ref-6">Petroni, F., Rocktäschel, T., Lewis, P., Bakhtin, A., Wu, Y., Miller, A. H., &amp; Riedel, S. (2019). <a href="https://arxiv.org/abs/1909.01066">Language models as knowledge bases?</a> <em>EMNLP 2019</em>. <a class="ref-back" href="#cite-6" aria-label="Back to the text">↩</a></li> <li id="ref-7">Kassner, N., &amp; Schütze, H. (2020). <a href="https://arxiv.org/abs/1911.03343">Negated and misprimed probes for pretrained language models: birds can talk, but cannot fly</a>. <em>ACL 2020</em>. <a class="ref-back" href="#cite-7" aria-label="Back to the text">↩</a></li> <li id="ref-8">Kurita, K., Vyas, N., Pareek, A., Black, A. W., &amp; Tsvetkov, Y. (2019). <a href="https://arxiv.org/abs/1906.07337">Measuring bias in contextualized word representations</a>. <em>1st Workshop on Gender Bias in Natural Language Processing</em>. <a class="ref-back" href="#cite-8" aria-label="Back to the text">↩</a></li> <li id="ref-9">Clark, K., Khandelwal, U., Levy, O., &amp; Manning, C. D. (2019). <a href="https://arxiv.org/abs/1906.04341">What does BERT look at? An analysis of BERT’s attention</a>. <em>BlackboxNLP 2019</em>. <a class="ref-back" href="#cite-9" aria-label="Back to the text">↩</a></li> <li id="ref-10">Gretel (2024). <a href="https://huggingface.co/datasets/gretelai/synthetic_pii_finance_multilingual">Synthetic PII finance multilingual</a>. Hugging Face dataset, Apache 2.0. <a class="ref-back" href="#cite-10" aria-label="Back to the text">↩</a></li> </ol>]]></content> <author> <name>Eva Koroleva</name> </author> <category term="machine-learning"/> <category term="transformer-architectures"/> <category term="bert"/> <category term="nlp"/> <category term="transformer"/> <category term="pytorch"/> <category term="ner"/> <summary type="html"><![CDATA[BERT written in PyTorch from scratch and loaded with Google's weights: why reading in both directions needed a mask, what BERT knows and what its attention heads do, and a detector of personal data in long financial documents, against regular expressions.]]></summary> <media:thumbnail url="https://blog.korolevalab.com/assets/posts/arch/01/cover.png"/> <media:content medium="image" url="https://blog.korolevalab.com/assets/posts/arch/01/cover.png"/> </entry> <entry> <title type="html">Mixture of experts: why the largest LLMs use a few percent of their weights per token</title> <link href="https://blog.korolevalab.com/blog/2026/mixture-of-experts/" rel="alternate" type="text/html" title="Mixture of experts: why the largest LLMs use a few percent of their weights per token"/> <published>2026-02-06T09:00:00+00:00</published> <updated>2026-11-02T00:00:00+00:00</updated> <id>https://blog.korolevalab.com/blog/2026/mixture-of-experts</id> <content type="html" xml:base="https://blog.korolevalab.com/blog/2026/mixture-of-experts/"><![CDATA[<aside class="tldr"> <p class="tldr-label">In short</p> <p>A mixture of experts splits each feed-forward network into many smaller ones and lets a router send every token to a few of them, so the newest models hold twenty to thirty times as many parameters as they use for a token.</p> <p>In my small runs, a mixture with the compute of a small dense model got two thirds of the way to a dense model with as many parameters, once its router was kept from piling the tokens onto a few favourite experts.</p> <p>Serving is where a mixture is expensive: every expert must sit in memory, and a server’s batch reads nearly all of them at every step.</p> <div class="stats"> <div class="stat"><span class="stat-value">31%</span><span class="stat-label">longer per training step than a dense model doing the same arithmetic</span></div> <div class="stat"><span class="stat-value">94–98%</span><span class="stat-label">of the tokens one expert takes in three of six layers, without any balancing</span></div> <div class="stat"><span class="stat-value">87%</span><span class="stat-label">of DeepSeek-V3's routed experts read in one decoding step for 64 sequences</span></div> </div> </aside> <p>DeepSeek-V3 has 671 billion parameters and uses 37 billion of them for each token. Kimi K2 has a trillion and uses 32 billion, gpt-oss-120b uses 5.1 billion of its 117, and some names spell the arithmetic out: Qwen3-235B-A22B has 235 billion parameters, 22 billion of them active.</p> <p>In every layer of these models a small router looks at the token and picks a few feed-forward networks, the experts, out of dozens or hundreds. Only those are computed. The rest of the weights wait in memory for tokens that need them.</p> <p>The idea is older than the Transformer. In 1991 Jacobs, Jordan, Nowlan and Hinton described systems “composed of many separate networks, each of which learns to handle a subset of the complete set of training cases”<sup class="cite">[<a href="#ref-1" id="cite-1" data-ref="1" aria-label="Reference 1: Jacobs, R. A., Jordan, M. I., Nowlan, S. J., &amp; Hinton, G. E. (1991). Adaptive mixtures of local experts. Neural Computation, 3(1), 79–87.">1</a>]</sup>.</p> <p>In 2017 Shazeer and colleagues put a layer of up to 131,072 experts between the layers of an LSTM language model<sup class="cite">[<a href="#ref-2" id="cite-2" data-ref="2" aria-label="Reference 2: Shazeer, N., Mirhoseini, A., Maziarz, K., Davis, A., Le, Q., Hinton, G., &amp; Dean, J. (2017). Outrageously large neural networks: the sparsely-gated mixture-of-experts layer. ICLR 2017.">2</a>]</sup>, and today the largest open models of DeepSeek, Qwen, Moonshot, OpenAI, Meta, Zhipu and MiniMax are all mixtures of experts.</p> <p>This post builds a mixture-of-experts layer in PyTorch, trains it next to dense models of the same cost on English, Russian and Python code, and looks inside: what the router decides, why it has to be kept from playing favourites, what the experts end up specialising in, and what it takes to serve a model whose weights are mostly idle.</p> <h2 id="where-a-transformer-keeps-its-parameters">Where a Transformer keeps its parameters</h2> <p>A layer of a Transformer has two parts. Attention moves information between tokens: each token looks at the earlier ones and takes what it needs from them.</p> <p>The feed-forward network then works on every token separately, with the same weights for all of them: it multiplies the token’s vector by a wide matrix, passes the result through a nonlinearity and multiplies it by a second matrix back to the original width. In modern models it is a <a href="/blog/2026/transformers-from-scratch-05-llama/">SwiGLU</a> network with three matrices:</p> \[\mathrm{FFN}(x) = W_{\text{down}}\big(\mathrm{silu}(W_{\text{gate}}\, x) \odot W_{\text{up}}\, x\big).\] <p>Here \(x\) is the token’s vector of width \(d\), \(W_{\text{gate}}\) and \(W_{\text{up}}\) map it to a hidden width \(h\), usually three to five times \(d\), the elementwise product \(\odot\) lets one projection switch the other on and off, and \(W_{\text{down}}\) maps the result back to width \(d\).</p> <p>Most of a model’s weights are in these networks. Qwen3-32B has 64 layers of width 5,120 with feed-forward networks of width 25,600, and its config gives the exact split:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/mixture-of-experts/parameters-light.png" width="760" alt="Parameters of two Qwen3 models by part, from their config files. Qwen3-32B, dense: attention 6.0 billion, feed-forward networks 25.2 billion, embeddings 1.6 billion, all used for every token. Qwen3-235B-A22B, a mixture of experts: attention 6.7 billion, the experts a token uses 14.2 billion, the experts it doesn't use 212.9 billion, embeddings 1.2 billion" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/mixture-of-experts/parameters-dark.png" width="760" alt="Parameters of two Qwen3 models by part, from their config files. Qwen3-32B, dense: attention 6.0 billion, feed-forward networks 25.2 billion, embeddings 1.6 billion, all used for every token. Qwen3-235B-A22B, a mixture of experts: attention 6.7 billion, the experts a token uses 14.2 billion, the experts it doesn't use 212.9 billion, embeddings 1.2 billion" loading="lazy"></p> <p>The feed-forward networks hold 25.2 billion of its 32.8 billion parameters, 77%; attention has 6.0 billion and the embeddings 1.6. Qwen3-235B-A22B, a mixture of experts of the same family, turns the picture around. Of its 235 billion parameters a token passes through 22 billion, and 213 billion, 91% of the model, are experts that this token does not use.</p> <p>Every weight a token passes through costs two operations, a multiplication and an addition, so a dense model of 32 billion parameters spends about 64 billion operations on every token it reads or writes, and most of them in the feed-forward networks.</p> <p>What do these networks do with so many weights? Geva and colleagues read the two matrices as a memory.</p> <p>Each row of the first matrix is a key that responds to some pattern in the input, each column of the second is a value added to the output when its key responds, and the network’s output is the sum of the values whose keys fired.</p> <p>In their words, feed-forward layers “operate as key-value memories, where each key correlates with textual patterns in the training examples”<sup class="cite">[<a href="#ref-3" id="cite-3" data-ref="3" aria-label="Reference 3: Geva, M., Schuster, R., Berant, J., &amp; Levy, O. (2021). Transformer feed-forward layers are key-value memories. EMNLP 2021.">3</a>]</sup>.</p> <p>A memory of 25,600 patterns of which a given token needs a few, read in full for every token, is an obvious candidate for economy. The idea of the mixture of experts is to cut it into many smaller networks and let every token use only some of them.</p> <h2 id="a-layer-of-experts">A layer of experts</h2> <p>A mixture-of-experts layer replaces the one feed-forward network with \(E\) smaller ones, the experts, and adds a router: a matrix \(W_r\) that gives every expert a score for the current token. A softmax turns the scores into probabilities, the token goes to the \(k\) experts with the highest ones, and its output is their outputs added with weights:</p> \[p = \mathrm{softmax}(W_r\, x), \qquad \mathcal{T} = \text{the } k \text{ largest of } p_1, \dots, p_E, \qquad y = \sum_{i \in \mathcal{T}} \frac{p_i}{\sum_{j \in \mathcal{T}} p_j}\, E_i(x).\] <p>Term by term: \(W_r\) is an \(E \times d\) matrix, so the router is a single linear layer, tiny next to the experts. \(p_i\) is how much the router trusts expert \(i\) with this token.</p> <p>\(\mathcal{T}\) is the set of the \(k\) chosen experts; the others are not computed at all, which is the whole point. The weights are the chosen probabilities divided by their sum, so they add up to one, and each \(E_i\) is an ordinary SwiGLU network, only narrower than the dense one.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/mixture-of-experts/moe-layer-light.png" width="760" alt="A dense feed-forward layer next to a mixture of experts. In the dense layer every token passes through all 768 hidden units. In the mixture, a router scores 8 experts of 384 hidden units each for the token, the token goes to the 2 best, and its output is their outputs added with the router's weights. The token passes through 768 hidden units in both, but the mixture holds 3072" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/mixture-of-experts/moe-layer-dark.png" width="760" alt="A dense feed-forward layer next to a mixture of experts. In the dense layer every token passes through all 768 hidden units. In the mixture, a router scores 8 experts of 384 hidden units each for the token, the token goes to the 2 best, and its output is their outputs added with the router's weights. The token passes through 768 hidden units in both, but the mixture holds 3072" loading="lazy"></p> <p>The models trained below have experts of width 384 and send every token to 2 of 8, so a token passes through 768 hidden units, as in a dense layer of width 768, while the layer holds 3,072.</p> <p>Here is what the router of one of them, after training, does with the Russian word “президент” in a sentence it has not seen:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/mixture-of-experts/router-light.png" width="760" alt="The router of layer 3 of the trained model with 8 experts, deciding where the token 'президент' of a held-out Russian sentence goes. Its probabilities for the eight experts are E1 0.07, E2 0.01, E3 0.04, E4 0.10, E5 0.36, E6 0.32, E7 0.04, E8 0.06. The two largest, E5 and E6, are kept and divided by their sum, giving weights 0.53 and 0.47; the token's output is the two experts' outputs added with these weights" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/mixture-of-experts/router-dark.png" width="760" alt="The router of layer 3 of the trained model with 8 experts, deciding where the token 'президент' of a held-out Russian sentence goes. Its probabilities for the eight experts are E1 0.07, E2 0.01, E3 0.04, E4 0.10, E5 0.36, E6 0.32, E7 0.04, E8 0.06. The two largest, E5 and E6, are kept and divided by their sum, giving weights 0.53 and 0.47; the token's output is the two experts' outputs added with these weights" loading="lazy"></p> <p>The router hesitates over this token. Experts 5 and 6 get 0.36 and 0.32 of the probability, and the other six share the remaining third, expert 4 most of it with 0.10.</p> <p>The two largest probabilities are kept and divided by their sum, 0.68, which turns them into weights 0.53 and 0.47, so the token’s output is roughly half of what expert 5 computes and half of what expert 6 computes. Experts 1, 2, 3, 4, 7 and 8 never see the token at all.</p> <p>The router learns with the rest of the model. Its gradient comes through the weights \(p_i / \sum_j p_j\): if expert 3’s output would have lowered the loss more than expert 7’s, the gradient raises \(p_3\) relative to \(p_7\), and the next similar token is more likely to go to expert 3.</p> <p>Nothing tells the router what an expert should be good at. Specialisation, if any, appears because sending similar tokens to the same expert makes that expert better at them.</p> <p>In code the layer is a loop over experts, each taking the tokens that chose it:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">moe</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">router</span><span class="p">,</span> <span class="n">experts</span><span class="p">,</span> <span class="n">k</span><span class="p">):</span>
    <span class="n">probs</span> <span class="o">=</span> <span class="p">(</span><span class="n">x</span> <span class="o">@</span> <span class="n">router</span><span class="p">).</span><span class="nf">softmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>              <span class="c1"># (tokens, experts)
</span>    <span class="n">top_probs</span><span class="p">,</span> <span class="n">top_experts</span> <span class="o">=</span> <span class="n">probs</span><span class="p">.</span><span class="nf">topk</span><span class="p">(</span><span class="n">k</span><span class="p">,</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>    <span class="c1"># the k best experts of every token
</span>    <span class="n">weights</span> <span class="o">=</span> <span class="n">top_probs</span> <span class="o">/</span> <span class="n">top_probs</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">out</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros_like</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>
    <span class="k">for</span> <span class="n">e</span><span class="p">,</span> <span class="n">expert</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">experts</span><span class="p">):</span>
        <span class="n">rows</span><span class="p">,</span> <span class="n">slot</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">nonzero</span><span class="p">(</span><span class="n">top_experts</span> <span class="o">==</span> <span class="n">e</span><span class="p">,</span> <span class="n">as_tuple</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>   <span class="c1"># tokens that chose e
</span>        <span class="n">out</span><span class="p">[</span><span class="n">rows</span><span class="p">]</span> <span class="o">+=</span> <span class="n">weights</span><span class="p">[</span><span class="n">rows</span><span class="p">,</span> <span class="n">slot</span><span class="p">,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="nf">expert</span><span class="p">(</span><span class="n">x</span><span class="p">[</span><span class="n">rows</span><span class="p">])</span>
    <span class="k">return</span> <span class="n">out</span>
</code></pre></div></div> <p>Whether this loop is slow depends on how many tokens each expert gets. Every pass launches a few matrix products, and a GPU is efficient only when a product is large enough to keep all of its cores busy.</p> <p>In training, with thousands of tokens in a batch and a handful of experts, each expert gets plenty of them. With hundreds of experts, or in decoding, where a step has one token per sequence, each expert gets a few rows, and the loop spends its time launching kernels and gathering rows instead of multiplying.</p> <p>The usual remedy is to sort the token-expert pairs by expert, so that every expert’s tokens lie next to each other, and to run all the experts at once:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/mixture-of-experts/dispatch-light.png" width="760" alt="How a mixture-of-experts layer processes a batch. The first 8 tokens of a held-out English sentence each go to two of the eight experts of layer 3: 'At' to E6 and E5; 'the' to E3 and E1; 'beginning' to E1 and E4; 'of' to E5 and E3; 'the' to E1 and E3; '21' to E1 and E6; 'st' to E7 and E6; 'century' to E6 and E7. Sorted by expert, they form a queue for each expert: E1: 4; E2: 0; E3: 3; E4: 1; E5: 2; E6: 4; E7: 2; E8: 0. The queues are padded to the same length and every expert processes its queue in one batched product" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/mixture-of-experts/dispatch-dark.png" width="760" alt="How a mixture-of-experts layer processes a batch. The first 8 tokens of a held-out English sentence each go to two of the eight experts of layer 3: 'At' to E6 and E5; 'the' to E3 and E1; 'beginning' to E1 and E4; 'of' to E5 and E3; 'the' to E1 and E3; '21' to E1 and E6; 'st' to E7 and E6; 'century' to E6 and E7. Sorted by expert, they form a queue for each expert: E1: 4; E2: 0; E3: 3; E4: 1; E5: 2; E6: 4; E7: 2; E8: 0. The queues are padded to the same length and every expert processes its queue in one batched product" loading="lazy"></p> <details class="method"> <summary>How my version batches the experts, and what production kernels do instead</summary> <p>My version pads every expert’s queue to the length of the longest, rounded up to a multiple of 256 so that the GPU sees few different shapes, and multiplies all of them by the stacked expert weights in one batched product. It agrees with a reference that runs every expert on every token and multiplies the unchosen ones by zero, to rounding error. Production kernels avoid even the padding: MegaBlocks writes the layer as a block-sparse matrix product<sup class="cite">[<a href="#ref-4" id="cite-4" data-ref="4" aria-label="Reference 4: Gale, T., Narayanan, D., Young, C., &amp; Zaharia, M. (2023). MegaBlocks: efficient sparse training with mixture-of-experts. MLSys 2023.">4</a>]</sup>, and DeepSeek’s DeepGEMM library has grouped products that take the experts’ tokens concatenated one after another, each expert’s segment padded only to the kernel’s block size.</p> </details> <h2 id="same-compute-more-parameters">Same compute, more parameters</h2> <p>What does a mixture buy? To see it on a small scale, I trained four models on a corpus of three kinds of text: English Wikipedia, Russian Wikipedia and the Python standard library, 8 million tokens of each, with a <a href="/blog/2026/transformers-from-scratch-01-tokenization/">tokenizer</a> of 8,192 tokens trained on the same mix (<a href="https://github.com/xmarva/transformers-from-scratch/tree/main/articles/moe">code</a>).</p> <p>All four have 6 layers of width 256 with 4 attention heads, rotary positions and RMSNorm, and differ only in the feed-forward layers.</p> <p>The dense model has SwiGLU networks of width 768 and 7.2 million parameters in all. The mixture with 8 experts sends every token to 2 experts of width 384: it does the same work per token as the dense model, with 7.2 million active parameters, but holds 17.8 million.</p> <p>The mixture with 32 experts cuts the same budget finer, 8 of 32 experts of width 96. The fourth model is dense with networks of width 3,072: as many parameters as the mixtures, every one of them used for every token, at about two and a half times the compute.</p> <p>Each model trained three times, with different seeds, for 3,000 steps of 32 sequences of 256 tokens, about 25 million tokens, on an NVIDIA T4 on Kaggle, with the auxiliary balancing loss <a class="arrow-link" href="#keeping-the-experts-busy">described below</a> for the mixtures.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/mixture-of-experts/loss-light.png" width="760" alt="Validation loss during 3,000 training steps, mean over English, Russian and Python, and the final loss on each: Dense 3.076 (English 3.95, Russian 2.99, Python 2.28); Dense, 4x wider 2.958 (English 3.84, Russian 2.83, Python 2.20); MoE, 8 experts 2.989 (English 3.87, Russian 2.88, Python 2.21); MoE, 32 experts 2.988 (English 3.86, Russian 2.90, Python 2.21)" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/mixture-of-experts/loss-dark.png" width="760" alt="Validation loss during 3,000 training steps, mean over English, Russian and Python, and the final loss on each: Dense 3.076 (English 3.95, Russian 2.99, Python 2.28); Dense, 4x wider 2.958 (English 3.84, Russian 2.83, Python 2.20); MoE, 8 experts 2.989 (English 3.87, Russian 2.88, Python 2.21); MoE, 32 experts 2.988 (English 3.86, Russian 2.90, Python 2.21)" loading="lazy"></p> <p>At the same compute per token, the mixture with 8 experts ends with a validation loss of 2.985 on average over the three seeds, against 3.062 for the dense model.</p> <p>The three seeds of the dense model end within 0.024 of each other and those of the mixture within 0.008, so a gap of 0.077 is not noise, and the mixture is better on each kind of text: by 0.08 on English, 0.10 on Russian and 0.06 on Python.</p> <p>The dense model with networks four times wider, as many parameters as the mixture and all of them working on every token, reaches 2.948, and until about step 1,750 the mixtures are even ahead of it.</p> <p class="takeaway">The mixture with 8 experts gets two thirds of the way from the small dense model to the large one while computing as much as the small one.</p> <p>Compute per token is not the same thing as time. Here is how long one training step takes, with the experts run by the loop shown earlier and by the sorted, batched version:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/mixture-of-experts/speed-light.png" width="760" alt="Time of one training step on the Tesla T4: Dense 144 ms; Dense, 4x wider 307 ms; MoE, 8 experts, sorted and batched 188 ms; MoE, 8 experts, loop over experts 189 ms; MoE, 32 experts, sorted and batched 253 ms; MoE, 32 experts, loop over experts 307 ms" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/mixture-of-experts/speed-dark.png" width="760" alt="Time of one training step on the Tesla T4: Dense 144 ms; Dense, 4x wider 307 ms; MoE, 8 experts, sorted and batched 188 ms; MoE, 8 experts, loop over experts 189 ms; MoE, 32 experts, sorted and batched 253 ms; MoE, 32 experts, loop over experts 307 ms" loading="lazy"></p> <p>The mixture with 8 experts takes 31% longer than the dense model that does the same arithmetic, and the one with 32 experts 76% longer: routing, sorting and gathering the tokens are work that a count of multiplications doesn’t show.</p> <p>The dense model with networks four times wider takes 307 milliseconds, more than twice as long as the narrow one. The loop itself turns out to be harmless here.</p> <p>With 8 experts a batch of 8,192 tokens gives each expert about 2,000 of them, and the loop is as fast as the batched version, 189 against 188 milliseconds per step; with 32 narrower experts it is 21% slower.</p> <h2 id="keeping-the-experts-busy">Keeping the experts busy</h2> <p>Left alone, the router has a bad habit. Early in training some expert happens to be a little better than the others, the router sends it more tokens, it trains on more data and gets better still, and the router sends it even more.</p> <p>The other experts get few tokens, learn little and stay unattractive. Shazeer and colleagues, who brought mixtures of experts to large networks, observed this “self-reinforcing” imbalance and countered it with an extra loss<sup class="cite">[<a href="#ref-2" id="cite-5" data-ref="2" aria-label="Reference 2: Shazeer, N., Mirhoseini, A., Maziarz, K., Davis, A., Le, Q., Hinton, G., &amp; Dean, J. (2017). Outrageously large neural networks: the sparsely-gated mixture-of-experts layer. ICLR 2017.">2</a>]</sup>.</p> <p class="flow"><span>one expert starts a little better</span><span>the router sends it more tokens</span><span>it trains on more and gets better still</span><span>the other experts learn little</span></p> <p><img class="tfs-figure tfs-light" src="/assets/posts/mixture-of-experts/balance-light.png" width="760" alt="The busiest expert's share of the tokens as a multiple of an even share, mean of 6 layers, during training of the model with 8 experts: no balancing 2.48 at the start and 3.10 at the end; auxiliary loss 1.23 at the start and 1.13 at the end; bias, no loss 1.87 at the start and 1.02 at the end" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/mixture-of-experts/balance-dark.png" width="760" alt="The busiest expert's share of the tokens as a multiple of an even share, mean of 6 layers, during training of the model with 8 experts: no balancing 2.48 at the start and 3.10 at the end; auxiliary loss 1.23 at the start and 1.13 at the end; bias, no loss 1.87 at the start and 1.02 at the end" loading="lazy"></p> <p>I trained the mixture with 8 experts in three versions: without any balancing, with the loss described below, and with the bias method that comes after it.</p> <p>Without balancing, the busiest expert of a layer has 2.6 to 3.1 times its fair share of the tokens by step 200, and nothing ever reverses it.</p> <p>On held-out text, in three of the six layers of the first of these models a single expert receives 94 to 98% of the tokens, and 9 of the 48 experts get less than a tenth of an even share. They are practically dead: their weights take memory and learn almost nothing.</p> <p>With the balancing loss, the busiest expert stays at about 1.1 times an even share for the whole run. The unbalanced mixture is still better than the dense model, 3.013 against 3.062, but worse than the balanced one and less predictable: its three seeds end between 2.991 and 3.030.</p> <p>The balancing loss most models use comes from the Switch Transformer<sup class="cite">[<a href="#ref-5" id="cite-6" data-ref="5" aria-label="Reference 5: Fedus, W., Zoph, B., &amp; Shazeer, N. (2022). Switch Transformers: scaling to trillion parameter models with simple and efficient sparsity. Journal of Machine Learning Research, 23(120), 1–39.">5</a>]</sup>. For a batch of tokens, let \(f_i\) be the share of the token-expert assignments that went to expert \(i\), and \(P_i\) the mean probability the router gave expert \(i\) over the same tokens. The loss is</p> \[L_{\text{balance}} = \alpha \cdot E \sum_{i=1}^{E} f_i\, P_i ,\] <p>added to the language modelling loss with a small weight \(\alpha\), 0.01 in the Switch Transformer and in my runs. When the router is perfectly even, \(f_i = P_i = 1/E\) and the sum times \(E\) is 1. When it favours some experts, their large \(f_i\) meet large \(P_i\) and the sum grows.</p> <p>The two factors play different roles. \(f_i\) is a count of decisions, and a count has no gradient. \(P_i\) is an average of softmax outputs and has one.</p> <p>So the loss pushes down the probabilities of experts that are already busy, in proportion to how busy they are, and the next tokens drift to the others. Here are both factors in two trained routers, one trained with the loss and one without:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/mixture-of-experts/aux-light.png" width="760" alt="Share of the assignments f and mean router probability P for each expert of layer 3, on held-out text, for two trained routers. no balancing: assignments from 0% to 49% per expert, mean probabilities from 1% to 58%, E times the sum of f·P 2.68; auxiliary loss: assignments from 11% to 16% per expert, mean probabilities from 11% to 15%, E times the sum of f·P 1.00" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/mixture-of-experts/aux-dark.png" width="760" alt="Share of the assignments f and mean router probability P for each expert of layer 3, on held-out text, for two trained routers. no balancing: assignments from 0% to 49% per expert, mean probabilities from 1% to 58%, E times the sum of f·P 2.68; auxiliary loss: assignments from 11% to 16% per expert, mean probabilities from 11% to 15%, E times the sum of f·P 1.00" loading="lazy"></p> <p>In layer 3 of the router trained without the loss, expert 2 gets 49% of the assignments, and the router’s mean probability for it is 0.58, so the router is not hesitating between experts, it is sure of its favourite.</p> <p>Experts 1 and 8 get almost nothing. The loss would be 2.68 for this router. For the router trained with it, it is 1.00, and its eight experts all get between 11% and 16% of the assignments.</p> <p>The extra loss has a cost: its gradient flows into the same weights as the language modelling loss and pulls them towards a goal that has nothing to do with predicting text.</p> <p>Wang and colleagues at DeepSeek proposed balancing without a loss<sup class="cite">[<a href="#ref-6" id="cite-7" data-ref="6" aria-label="Reference 6: Wang, L., Gao, H., Zhao, C., Sun, X., &amp; Dai, D. (2024). Auxiliary-loss-free load balancing strategy for mixture-of-experts. arXiv.">6</a>]</sup>, and DeepSeek-V3 uses their method<sup class="cite">[<a href="#ref-7" id="cite-8" data-ref="7" aria-label="Reference 7: DeepSeek-AI (2024). DeepSeek-V3 technical report. arXiv.">7</a>]</sup>. Every expert gets a bias \(b_i\) that is added to its score when the \(k\) experts are chosen, and only then:</p> \[\mathcal{T} = \text{the } k \text{ largest of } p_1 + b_1, \dots, p_E + b_E, \qquad \text{weights from } p_i \text{ alone}.\] <p>After every training step, the bias of each expert that got fewer tokens than the average goes up by a small step \(\gamma\), and the bias of each one that got more goes down by \(\gamma\).</p> <p>The biases are not learned by gradient descent and don’t touch the model’s weights; they act like a traffic controller that keeps nudging the queues until they are even. I used \(\gamma = 0.001\), the value DeepSeek-V3 used for most of its training.</p> <p>The biases start at zero and move by 0.001 a step, so they need time: for the first 200 steps the busiest expert gets one and a half to two times its share.</p> <p>From about step 500 on, the biases keep the load more even than the loss does, 1.02 times an even share at the end against 1.10 to 1.13.</p> <p>In quality the two are the same at my scale: 2.981 with the biases and 2.985 with the loss, while the seeds of each spread over 0.014 and 0.008.</p> <p>DeepSeek’s comparison on models with a billion parameters is hardly more decisive: a validation loss of 2.253 with the biases, 2.258 with a balancing loss computed over each sequence, and 2.253 with one computed over the whole batch, as mine is<sup class="cite">[<a href="#ref-7" id="cite-9" data-ref="7" aria-label="Reference 7: DeepSeek-AI (2024). DeepSeek-V3 technical report. arXiv.">7</a>]</sup>.</p> <h2 id="a-fixed-budget-per-expert">A fixed budget per expert</h2> <p>Balancing on average is not enough when the experts sit on different GPUs. Each GPU has to reserve memory for the tokens its experts will receive before it knows how many will come, and the shapes of the arrays on an accelerator are fixed in advance.</p> <p>The Switch Transformer and GShard therefore give every expert a capacity, a fixed number of slots per batch<sup class="cite">[<a href="#ref-8" id="cite-10" data-ref="8" aria-label="Reference 8: Lepikhin, D., Lee, H., Xu, Y., Chen, D., Firat, O., Huang, Y., Krikun, M., Shazeer, N., &amp; Chen, Z. (2021). GShard: scaling giant models with conditional computation and automatic sharding. ICLR 2021.">8</a>]</sup>:</p> \[C = c \cdot \frac{T\, k}{E},\] <p>where \(T\) is the number of tokens in the batch, \(T k / E\) is what each expert would get with perfectly even routing, and the capacity factor \(c\), usually between 1 and 2, leaves room for unevenness.</p> <p>Tokens beyond the capacity are dropped by that expert. A dropped token loses that expert’s contribution; if all its experts are full, it passes through the layer unchanged, carried only by the residual connection.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/mixture-of-experts/capacity-light.png" width="760" alt="Tokens per expert against the capacity, and the share of assignments dropped for capacity factors from 1 to 2, for three routers of the model with 8 experts. no balancing: the busiest expert gets 3.89 times an even share; dropped 33.3% at 1, 26.3% at 1.25, 21.4% at 1.5, 14.8% at 2; auxiliary loss: the busiest expert gets 1.25 times an even share; dropped 6.1% at 1, 1.0% at 1.25, 0.3% at 1.5, 0.0% at 2; bias, no loss: the busiest expert gets 1.17 times an even share; dropped 5.2% at 1, 0.1% at 1.25, 0.0% at 1.5, 0.0% at 2" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/mixture-of-experts/capacity-dark.png" width="760" alt="Tokens per expert against the capacity, and the share of assignments dropped for capacity factors from 1 to 2, for three routers of the model with 8 experts. no balancing: the busiest expert gets 3.89 times an even share; dropped 33.3% at 1, 26.3% at 1.25, 21.4% at 1.5, 14.8% at 2; auxiliary loss: the busiest expert gets 1.25 times an even share; dropped 6.1% at 1, 1.0% at 1.25, 0.3% at 1.5, 0.0% at 2; bias, no loss: the busiest expert gets 1.17 times an even share; dropped 5.2% at 1, 0.1% at 1.25, 0.0% at 1.5, 0.0% at 2" loading="lazy"></p> <p>For the balanced routers a capacity factor of 1 is tight: any unevenness overflows, and 5 to 6% of the assignments are dropped. At 1.25 the share falls to 1% or less, and at 1.5 practically nothing is dropped.</p> <p>The router trained without balancing is another story. At a capacity factor of 1 it drops a third of the assignments, and even at 2 it drops 15%, because its favourite experts receive nearly four times their share.</p> <p>The dropped assignments cost more than their share suggests. On the held-out sequences of this analysis, the loss of the mixture with the balancing loss is 2.97 without a limit, 3.21 with 6% of the assignments dropped and 3.01 with 1%. My models were trained without a capacity limit and never learned to do without a missing expert.</p> <p>A model trained with one adapts: the Switch Transformer saw “typically &lt;1%” of tokens dropped<sup class="cite">[<a href="#ref-5" id="cite-11" data-ref="5" aria-label="Reference 5: Fedus, W., Zoph, B., &amp; Shazeer, N. (2022). Switch Transformers: scaling to trillion parameter models with simple and efficient sparsity. Journal of Machine Learning Research, 23(120), 1–39.">5</a>]</sup>, and the ST-MoE study found that models “dropping 10-15% of tokens can perform approximately as well as models that drop &lt;1%”<sup class="cite">[<a href="#ref-9" id="cite-12" data-ref="9" aria-label="Reference 9: Zoph, B., Bello, I., Kumar, S., Du, N., Huang, Y., Dean, J., Shazeer, N., &amp; Fedus, W. (2022). ST-MoE: designing stable and transferable sparse expert models. arXiv.">9</a>]</sup>.</p> <p>Dropping tokens is a compromise between quality and the cost of padding, and newer systems avoid it. MegaBlocks computes the experts as one block-sparse product in which every expert gets exactly the rows it was sent<sup class="cite">[<a href="#ref-4" id="cite-13" data-ref="4" aria-label="Reference 4: Gale, T., Narayanan, D., Young, C., &amp; Zaharia, M. (2023). MegaBlocks: efficient sparse training with mixture-of-experts. MLSys 2023.">4</a>]</sup>, and DeepSeek-V3 drops no tokens in training or inference, relying on balancing to keep the load even<sup class="cite">[<a href="#ref-7" id="cite-14" data-ref="7" aria-label="Reference 7: DeepSeek-AI (2024). DeepSeek-V3 technical report. arXiv.">7</a>]</sup>.</p> <h2 id="what-the-experts-learn">What the experts learn</h2> <p>Nobody tells an expert what to specialise in, so it is a fair question whether they specialise at all. My corpus makes it easy to see: a third English, a third Russian, a third Python, three kinds of text that differ in alphabet, vocabulary and structure. If an expert’s tokens are split evenly between the three, it has no preference.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/mixture-of-experts/specialization-light.png" width="760" alt="What each expert of the model with 8 experts receives on held-out text with equal amounts of English, Russian and Python. The middle layers are mixed; the first and especially the last layer have experts that lean to one kind of text. Experts that get at least 60% of their tokens from one kind, per layer: layer 1: 1 Russian, 1 Python; layer 2: none; layer 3: none; layer 4: 1 English, 2 Python; layer 5: 2 English, 1 Russian, 2 Python; layer 6: 1 English, 2 Russian, 2 Python" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/mixture-of-experts/specialization-dark.png" width="760" alt="What each expert of the model with 8 experts receives on held-out text with equal amounts of English, Russian and Python. The middle layers are mixed; the first and especially the last layer have experts that lean to one kind of text. Experts that get at least 60% of their tokens from one kind, per layer: layer 1: 1 Russian, 1 Python; layer 2: none; layer 3: none; layer 4: 1 English, 2 Python; layer 5: 2 English, 1 Russian, 2 Python; layer 6: 1 English, 2 Russian, 2 Python" loading="lazy"></p> <p>The early layers have little preference. In layers 2 and 3 no expert gets more than about half of its tokens from one kind of text, and the preference grows with depth: three experts of layer 4 lean to one kind, five of layer 5.</p> <p>In layer 6 the experts have divided the languages between them. Five of the eight get 83 to 96% of their tokens from one kind of text, two from Python, two from Russian and one from English; a sixth leans to English with 59%, and two remain mixed.</p> <p>The first layer stands apart from its neighbours: one of its experts gets 83% of its tokens from Russian text, another 67% from Python.</p> <p>Here is the same thing token by token, on three short snippets of held-out text. Each token is coloured by the expert it goes to first:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/mixture-of-experts/tokens-light.png" width="760" alt="The first-choice expert of every token of three held-out snippets, English, Russian and Python, in the first and the last layer of the trained model with 8 experts. A token is coloured by the kind of text its expert leans to, if at least 60% of that expert's tokens are of one kind. Tokens that go to an expert of their own kind: layer 1: 0 of 13 English, 10 of 17 Russian, 6 of 16 Python; layer 6: 10 of 13 English, 14 of 17 Russian, 9 of 16 Python. In the first layer the Russian expert takes mostly the Cyrillic pieces of names, the English one short words, and a third expert Python's symbols and newlines; in the last, almost every token goes to an expert of its language" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/mixture-of-experts/tokens-dark.png" width="760" alt="The first-choice expert of every token of three held-out snippets, English, Russian and Python, in the first and the last layer of the trained model with 8 experts. A token is coloured by the kind of text its expert leans to, if at least 60% of that expert's tokens are of one kind. Tokens that go to an expert of their own kind: layer 1: 0 of 13 English, 10 of 17 Russian, 6 of 16 Python; layer 6: 10 of 13 English, 14 of 17 Russian, 9 of 16 Python. In the first layer the Russian expert takes mostly the Cyrillic pieces of names, the English one short words, and a third expert Python's symbols and newlines; in the last, almost every token goes to an expert of its language" loading="lazy"></p> <p>In the first layer the router sorts tokens by what they look like. Its Russian expert takes президент and most of the pieces into which the tokenizer cut the names Либерии, Чарльз and Кинг: Л, иб, Ч, ар, ль, з, Д, Б, инг.</p> <p>Python’s =, _, (), try and newlines go to an expert that leans to code. English has no expert of its own in this layer at all. At this depth a token’s vector is still mostly the token itself, and the router has little else to go on.</p> <p>In the last layer, 10 of the 13 English tokens, 14 of the 17 Russian ones and 9 of the 16 Python ones go to an expert of their own kind.</p> <p>All the others but one go to the two mixed experts of this layer, and most of them are tokens the three kinds of text share: the numbers 3 and 21, the full stops after the initials Д. and Б., and in Python the brackets, colons, the underscore and newlines.</p> <div class="callout callout-key"> <p class="callout-label">Key point</p> <p>In the last layer the router sorts tokens by language, because that layer prepares the prediction of the next token, and what the next token can be depends first of all on the language.</p> </div> <p>Specialisation by topic, the kind people usually hope for, is much weaker in large models. Mistral looked for experts on topics in Mixtral and did not find them: “the distribution of expert assignment is very similar for ArXiv papers (written in Latex), for biology (PubMed Abstracts), and for Philosophy (PhilPapers) documents”.</p> <p>What they found instead was syntax: “in code, the indentation tokens are always assigned to the same experts, particularly at the first and last layers where the hidden states are more correlated to the input and output of the model”<sup class="cite">[<a href="#ref-10" id="cite-15" data-ref="10" aria-label="Reference 10: Jiang, A. Q., et al. (2024). Mixtral of experts. arXiv.">10</a>]</sup>.</p> <p>In OLMoE, trained from scratch with 64 small experts per layer, the specialisation is stronger: “for arXiv, which has a very specific distribution with lots of scientific text, the first expert in layer 0 is nearly 100% specialized”, and “vocabulary specialization is higher in later layers”<sup class="cite">[<a href="#ref-11" id="cite-16" data-ref="11" aria-label="Reference 11: Muennighoff, N., et al. (2025). OLMoE: open mixture-of-experts language models. ICLR 2025.">11</a>]</sup>.</p> <p>Languages are a case of their own. The ST-MoE study found that “experts trained on multilingual mixtures do not exhibit language specialization” and blamed the balancing: a group of tokens over which the loss was computed held only one or a few languages, so every expert had to take every language to keep the load even within the group<sup class="cite">[<a href="#ref-9" id="cite-17" data-ref="9" aria-label="Reference 9: Zoph, B., Bello, I., Kumar, S., Du, N., Huang, Y., Dean, J., Shazeer, N., &amp; Fedus, W. (2022). ST-MoE: designing stable and transferable sparse expert models. arXiv.">9</a>]</sup>.</p> <p>My batches mix all three kinds of text, and an English expert can stay busy on the English part of every batch.</p> <h2 id="smaller-experts-and-one-for-everybody">Smaller experts, and one for everybody</h2> <p>An expert in Mixtral<sup class="cite">[<a href="#ref-10" id="cite-18" data-ref="10" aria-label="Reference 10: Jiang, A. Q., et al. (2024). Mixtral of experts. arXiv.">10</a>]</sup> is as wide as the whole feed-forward network of Mistral 7B, whose architecture Mixtral otherwise shares, and a token picks 2 of 8.</p> <p>DeepSeekMoE argued that this is too coarse: with only 8 experts, each has to cover a broad mix of tokens, and knowledge that all of them need is learned several times over<sup class="cite">[<a href="#ref-12" id="cite-19" data-ref="12" aria-label="Reference 12: Dai, D., et al. (2024). DeepSeekMoE: towards ultimate expert specialization in mixture-of-experts language models. ACL 2024.">12</a>]</sup>. Their remedy has two parts.</p> <p>The first is to cut every expert into \(m\) smaller ones and route each token to \(m\) times as many, which keeps the parameters and the compute the same and multiplies the number of combinations a token can choose from: in their example, top-2 of 16 experts allows 120 combinations, top-8 of 64 quarter-size experts “4,426,165,368 potential combinations”.</p> <p>The second is to set aside shared experts that every token passes through, for what all tokens need, so that the routed experts can specialise.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/mixture-of-experts/fine-grained-light.png" width="760" alt="Three ways to cut the same budget of experts. Eight experts with two per token can be combined in 28 ways; 32 experts a quarter of the size with eight per token, the same compute and the same parameters, in 10,518,300 ways. DeepSeek-V3 has one shared expert every token passes through and 256 routed experts with eight per token: about 4.1e+14 combinations" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/mixture-of-experts/fine-grained-dark.png" width="760" alt="Three ways to cut the same budget of experts. Eight experts with two per token can be combined in 28 ways; 32 experts a quarter of the size with eight per token, the same compute and the same parameters, in 10,518,300 ways. DeepSeek-V3 has one shared expert every token passes through and 256 routed experts with eight per token: about 4.1e+14 combinations" loading="lazy"></p> <p>In my models the finer cut made no difference. The mixture with 32 experts ends at 2.983 and the one with 8 at 2.985, well within the spread of the seeds, and the finer one costs more time, 253 milliseconds per step against 188, because routing, sorting and gathering grow with the number of experts. It does take dropped tokens better.</p> <p>With a capacity factor of 1 it loses the same 6% of its assignments as the coarse mixture, but its loss rises by 0.10 instead of 0.24: a dropped assignment takes away one of a token’s eight experts instead of one of two.</p> <p>The case for finer experts was made on larger models. DeepSeekMoE’s smallest comparison is at 2 billion parameters, where “DeepSeekMoE 2B achieves comparable performance with GShard 2.9B”<sup class="cite">[<a href="#ref-12" id="cite-20" data-ref="12" aria-label="Reference 12: Dai, D., et al. (2024). DeepSeekMoE: towards ultimate expert specialization in mixture-of-experts language models. ACL 2024.">12</a>]</sup>, a hundred times the size of my models, trained on far more than my 25 million tokens.</p> <h2 id="mixtures-in-real-models">Mixtures in real models</h2> <p>Here are the experts of open models as their config files describe them, in the order the models came out:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/mixture-of-experts/models-light.png" width="760" alt="Routed experts per token and per layer, and the active share of parameters, in open mixture-of-experts models in the order of release: Mixtral 8x7B (Dec 2023): 2 of 8 experts, 12.9B of 46.7B parameters active; DeepSeek-V2 (May 2024): 6 of 160 experts plus 2 shared, 21B of 236B parameters active; OLMoE-1B-7B (Sep 2024): 8 of 64 experts, 1.3B of 6.9B parameters active; DeepSeek-V3 (Dec 2024): 8 of 256 experts plus 1 shared, 37B of 671B parameters active; Llama 4 Maverick (Apr 2025): 1 of 128 experts plus 1 shared, 17B of 400B parameters active; Qwen3-235B-A22B (Apr 2025): 8 of 128 experts, 22B of 235B parameters active; Kimi K2 (Jul 2025): 8 of 384 experts plus 1 shared, 32B of 1,000B parameters active; GLM-4.5 (Jul 2025): 8 of 160 experts plus 1 shared, 32B of 355B parameters active; gpt-oss-120b (Aug 2025): 4 of 128 experts, 5.1B of 116.8B parameters active; Qwen3-Next-80B-A3B (Sep 2025): 10 of 512 experts plus 1 shared, 3B of 80B parameters active; MiniMax-M2 (Oct 2025): 8 of 256 experts, 10B of 230B parameters active; Qwen3.5-397B-A17B (Feb 2026): 10 of 512 experts plus 1 shared, 17B of 397B parameters active; DeepSeek-V4-Pro (Apr 2026): 6 of 384 experts plus 1 shared, 49B of 1,600B parameters active; Kimi K3 (Jun 2026): 16 of 896 experts plus 2 shared, 104B of 2,800B parameters active" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/mixture-of-experts/models-dark.png" width="760" alt="Routed experts per token and per layer, and the active share of parameters, in open mixture-of-experts models in the order of release: Mixtral 8x7B (Dec 2023): 2 of 8 experts, 12.9B of 46.7B parameters active; DeepSeek-V2 (May 2024): 6 of 160 experts plus 2 shared, 21B of 236B parameters active; OLMoE-1B-7B (Sep 2024): 8 of 64 experts, 1.3B of 6.9B parameters active; DeepSeek-V3 (Dec 2024): 8 of 256 experts plus 1 shared, 37B of 671B parameters active; Llama 4 Maverick (Apr 2025): 1 of 128 experts plus 1 shared, 17B of 400B parameters active; Qwen3-235B-A22B (Apr 2025): 8 of 128 experts, 22B of 235B parameters active; Kimi K2 (Jul 2025): 8 of 384 experts plus 1 shared, 32B of 1,000B parameters active; GLM-4.5 (Jul 2025): 8 of 160 experts plus 1 shared, 32B of 355B parameters active; gpt-oss-120b (Aug 2025): 4 of 128 experts, 5.1B of 116.8B parameters active; Qwen3-Next-80B-A3B (Sep 2025): 10 of 512 experts plus 1 shared, 3B of 80B parameters active; MiniMax-M2 (Oct 2025): 8 of 256 experts, 10B of 230B parameters active; Qwen3.5-397B-A17B (Feb 2026): 10 of 512 experts plus 1 shared, 17B of 397B parameters active; DeepSeek-V4-Pro (Apr 2026): 6 of 384 experts plus 1 shared, 49B of 1,600B parameters active; Kimi K3 (Jun 2026): 16 of 896 experts plus 2 shared, 104B of 2,800B parameters active" loading="lazy"></p> <p>Three things changed over these two and a half years. The experts multiplied and shrank. Mixtral has 8 experts of width 14,336 per layer, DeepSeek-V3 256 of width 2,048, Kimi K3 896.</p> <p>Moonshot measured the effect directly for Kimi K2: at a fixed number of active parameters, “increasing the total number of experts (i.e., increasing sparsity) consistently lowers both the training and validation loss”, and they settled on 8 of 384 as a balance between quality and the cost of the infrastructure<sup class="cite">[<a href="#ref-13" id="cite-21" data-ref="13" aria-label="Reference 13: Kimi Team (2025). Kimi K2: open agentic intelligence. arXiv.">13</a>]</sup>.</p> <p>Krajewski and colleagues reached the same conclusion from scaling laws: setting the size of experts to match the dense feed-forward layer “is not optimal at almost any computational budget”<sup class="cite">[<a href="#ref-14" id="cite-22" data-ref="14" aria-label="Reference 14: Krajewski, J., et al. (2024). Scaling laws for fine-grained mixture of experts. ICML 2024.">14</a>]</sup>.</p> <p>The active share fell accordingly, from 28% in Mixtral to 3–5% in the models of the past year. A model now holds twenty to thirty times as many parameters as it uses for a token.</p> <p>The shared expert did not convince everyone. DeepSeek, Moonshot, Zhipu and the newer Qwen models use one or two; the OLMoE team found that “sharing an expert performs slightly worse” and left it out<sup class="cite">[<a href="#ref-11" id="cite-23" data-ref="11" aria-label="Reference 11: Muennighoff, N., et al. (2025). OLMoE: open mixture-of-experts language models. ICLR 2025.">11</a>]</sup>, and Qwen3 also has none<sup class="cite">[<a href="#ref-15" id="cite-24" data-ref="15" aria-label="Reference 15: Qwen Team (2025). Qwen3 technical report. arXiv.">15</a>]</sup>.</p> <p>Not every layer is a mixture either. DeepSeek-V3 keeps its first three layers dense, and Llama 4 Maverick alternates dense and mixture layers, with a token going to 1 of 128 routed experts plus a shared one<sup class="cite">[<a href="#ref-16" id="cite-25" data-ref="16" aria-label="Reference 16: Meta (2025). The Llama 4 herd: the beginning of a new era of natively multimodal AI innovation. Blog post.">16</a>]</sup>.</p> <h2 id="serving-a-model-that-is-mostly-idle">Serving a model that is mostly idle</h2> <p>The first cost of a mixture is memory. Every expert has to be at hand, because any token may need any of them, so DeepSeek-V3 needs room for all 671 billion parameters, about 671 GB at one byte per parameter in FP8, more than the 640 GB of a server with eight 80 GB GPUs.</p> <p>OpenAI made gpt-oss-120b fit on one GPU by storing the experts, which hold “90+% of the total parameter count”, in a 4-bit format, MXFP4: “quantizing these to MXFP4 enables the larger model to fit on a single 80GB GPU”<sup class="cite">[<a href="#ref-17" id="cite-26" data-ref="17" aria-label="Reference 17: OpenAI (2025). gpt-oss-120b &amp; gpt-oss-20b model card. arXiv.">17</a>]</sup>.</p> <p>A model with all its experts in memory reads only a few of them for each token. At a batch of one, the case of a chatbot on a laptop, a decoding step reads the attention weights and \(k\) experts per layer and nothing else.</p> <p>Decoding is limited by how fast weights come from memory, not by arithmetic, so the step costs about as much as in a dense model of the active size.</p> <p>This is why models like Qwen3-30B-A3B are popular on laptops: they need the memory of a 30-billion-parameter model but read only about 3 billion parameters per token. llama.cpp even has options to keep the experts in the computer’s main memory while the rest of the model sits on the GPU, <code class="language-plaintext highlighter-rouge">--cpu-moe</code> for all of them and <code class="language-plaintext highlighter-rouge">--n-cpu-moe N</code> for the first N layers<sup class="cite">[<a href="#ref-18" id="cite-27" data-ref="18" aria-label="Reference 18: llama.cpp (2025). llama : add --n-cpu-moe option. Pull request #15077.">18</a>]</sup>; the GPU then holds what every token needs, and each token reads only its few experts from the slower memory.</p> <p>A server decodes many conversations at once, and every conversation’s token picks its own experts. If the router spreads tokens evenly, a given expert is skipped by one token with probability \(1 - k/E\), and by all \(B\) tokens of a batch with probability \((1 - k/E)^B\). The expected share of experts a decoding step has to read is therefore</p> \[1 - \left(1 - \frac{k}{E}\right)^{B}.\] <p><img class="tfs-figure tfs-light" src="/assets/posts/mixture-of-experts/decode-light.png" width="760" alt="Expected share of the experts of a layer that one decoding step has to read, for batches of 1 to 256 sequences, if the router spreads tokens evenly: Mixtral 8x7B (2 of 8) 25% at 1, 99% at 16, 100% at 256; Qwen3-235B-A22B (8 of 128) 6% at 1, 64% at 16, 100% at 256; DeepSeek-V3 (8 of 256) 3% at 1, 40% at 16, 100% at 256; Kimi K2 (8 of 384) 2% at 1, 29% at 16, 100% at 256. Our trained router with 8 of 32 experts, measured: 25% at 1, 68% at 4, 99% at 16, 100% at 64, 100% at 256" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/mixture-of-experts/decode-dark.png" width="760" alt="Expected share of the experts of a layer that one decoding step has to read, for batches of 1 to 256 sequences, if the router spreads tokens evenly: Mixtral 8x7B (2 of 8) 25% at 1, 99% at 16, 100% at 256; Qwen3-235B-A22B (8 of 128) 6% at 1, 64% at 16, 100% at 256; DeepSeek-V3 (8 of 256) 3% at 1, 40% at 16, 100% at 256; Kimi K2 (8 of 384) 2% at 1, 29% at 16, 100% at 256. Our trained router with 8 of 32 experts, measured: 25% at 1, 68% at 4, 99% at 16, 100% at 64, 100% at 256" loading="lazy"></p> <p>My router with 8 of 32 experts sits exactly on its curve: a decoding step needs 25% of the experts for one sequence, 90% for 8 and all of them from 32 on, as if every token picked its experts at random.</p> <p>A model with a smaller share per token holds out longer. DeepSeek-V3, with 8 of 256, reads 3% of its routed experts for one sequence, 40% for 16 and 87% for 64, and from about 128 sequences on, nearly all of them.</p> <div class="callout callout-key"> <p class="callout-label">Key point</p> <p>The saving in memory traffic that makes a mixture fast at a batch of one disappears at the batch sizes a server runs at. What remains is the saving in arithmetic: each expert multiplies only the tokens that chose it.</p> </div> <p>To turn this saving into speed, a server needs enough tokens per expert to keep each product efficient, and that is what expert parallelism is for: the experts are spread over many GPUs, every GPU holds a few of them, and tokens travel to their experts and back.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/mixture-of-experts/expert-parallel-light.png" width="760" alt="Expert parallelism on four GPUs, each holding two of the eight experts and a quarter of the tokens. The tokens of GPU 0 are followed: after the router, each is sent to the GPUs that hold its two experts, in an all-to-all exchange in which every GPU sends to every other; the experts process what they received; a second all-to-all brings the results back to GPU 0, where each token's two results are added" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/mixture-of-experts/expert-parallel-dark.png" width="760" alt="Expert parallelism on four GPUs, each holding two of the eight experts and a quarter of the tokens. The tokens of GPU 0 are followed: after the router, each is sent to the GPUs that hold its two experts, in an all-to-all exchange in which every GPU sends to every other; the experts process what they received; a second all-to-all brings the results back to GPU 0, where each token's two results are added" loading="lazy"></p> <p>DeepSeek described its production setup for V3 and R1 in early 2025. Its reasoning is the same: “the model’s high sparsity necessitates an extremely large overall batch size. This ensures sufficient batch size per expert, enabling higher throughput and lower latency. Large-scale cross-node EP is essential.”</p> <p>Reading a prompt, one deployment unit spans 4 nodes with 32-way expert parallelism; decoding, it spans 18 nodes with 144-way expert parallelism, each GPU holding 2 routed experts and the shared one, and each node of 8 GPUs writes about 14,800 tokens per second<sup class="cite">[<a href="#ref-19" id="cite-28" data-ref="19" aria-label="Reference 19: DeepSeek-AI (2025). Day 6: one more thing, DeepSeek-V3/R1 inference system overview. GitHub.">19</a>]</sup>.</p> <p>The price is communication. Every mixture layer sends every token to other GPUs and back, twice per layer and 58 layers per token in DeepSeek-V3, and the exchange has to be hidden behind computation.</p> <p>DeepSeek overlaps the communication of one batch with the computation of another and, for training, limits every token to experts on at most 4 nodes, because NVLink inside a node is about 3.2 times faster than InfiniBand between nodes<sup class="cite">[<a href="#ref-7" id="cite-29" data-ref="7" aria-label="Reference 7: DeepSeek-AI (2024). DeepSeek-V3 technical report. arXiv.">7</a>]</sup>.</p> <h2 id="when-a-mixture-is-the-right-choice">When a mixture is the right choice</h2> <p>A mixture of experts trades memory for compute. For a given quality it needs fewer operations per token than a dense model, and in exchange it keeps all its experts in memory and, served at scale, moves every token between GPUs and back in every layer.</p> <p>The gain in compute is real and large. The Switch Transformer reached the quality of a dense T5-Base “in one-seventh the time” at the same compute per token<sup class="cite">[<a href="#ref-5" id="cite-30" data-ref="5" aria-label="Reference 5: Fedus, W., Zoph, B., &amp; Shazeer, N. (2022). Switch Transformers: scaling to trillion parameter models with simple and efficient sparsity. Journal of Machine Learning Research, 23(120), 1–39.">5</a>]</sup>.</p> <p>The gain in wall-clock time is smaller, because routing and moving tokens cost time that no operation count shows: the OLMoE team found that their mixture “reaches the performance of the dense model with ∼3× fewer tokens”, but in time “only ∼2× faster”<sup class="cite">[<a href="#ref-11" id="cite-31" data-ref="11" aria-label="Reference 11: Muennighoff, N., et al. (2025). OLMoE: open mixture-of-experts language models. ICLR 2025.">11</a>]</sup>.</p> <p>So the trade pays where compute is the bottleneck and memory is plentiful: training large models, and serving them to many users at once on clusters where every expert sees enough tokens to stay busy. It pays less where memory is the bottleneck or traffic is light.</p> <p>The authors of GLaM, one of the first large mixtures, noted that sparse models “require a larger number of devices”, which “increases the serving cost especially when the serving traffic is low”<sup class="cite">[<a href="#ref-20" id="cite-32" data-ref="20" aria-label="Reference 20: Du, N., et al. (2022). GLaM: efficient scaling of language models with mixture-of-experts. ICML 2022.">20</a>]</sup>.</p> <div class="callout"> <p class="callout-label">In practice</p> <p><a href="/blog/2025/adapters/">Fine-tuning</a> needs care too. In the ST-MoE study, sparse models were “prone to overfitting”: on a task with 250 training examples the sparse model did worse than the dense one, and sparse models needed their own fine-tuning settings, smaller batches and a higher learning rate<sup class="cite">[<a href="#ref-9" id="cite-33" data-ref="9" aria-label="Reference 9: Zoph, B., Bello, I., Kumar, S., Du, N., Huang, Y., Dean, J., Shazeer, N., &amp; Fedus, W. (2022). ST-MoE: designing stable and transferable sparse expert models. arXiv.">9</a>]</sup>.</p> </div> <p>A laptop with plenty of memory and a modest processor is a case of its own. Its memory can hold all the experts, and at a batch of one each token reads only the few it needs.</p> <h2 id="references">References</h2> <ol class="tfs-refs"> <li id="ref-1">Jacobs, R. A., Jordan, M. I., Nowlan, S. J., &amp; Hinton, G. E. (1991). <a href="https://doi.org/10.1162/neco.1991.3.1.79">Adaptive mixtures of local experts</a>. <em>Neural Computation</em>, 3(1), 79–87. <a class="ref-back" href="#cite-1" aria-label="Back to the text">↩</a></li> <li id="ref-2">Shazeer, N., Mirhoseini, A., Maziarz, K., Davis, A., Le, Q., Hinton, G., &amp; Dean, J. (2017). <a href="https://arxiv.org/abs/1701.06538">Outrageously large neural networks: the sparsely-gated mixture-of-experts layer</a>. <em>ICLR 2017</em>. <a class="ref-back" href="#cite-2" aria-label="Back to the text">↩</a></li> <li id="ref-3">Geva, M., Schuster, R., Berant, J., &amp; Levy, O. (2021). <a href="https://arxiv.org/abs/2012.14913">Transformer feed-forward layers are key-value memories</a>. <em>EMNLP 2021</em>. <a class="ref-back" href="#cite-3" aria-label="Back to the text">↩</a></li> <li id="ref-4">Gale, T., Narayanan, D., Young, C., &amp; Zaharia, M. (2023). <a href="https://arxiv.org/abs/2211.15841">MegaBlocks: efficient sparse training with mixture-of-experts</a>. <em>MLSys 2023</em>. <a class="ref-back" href="#cite-4" aria-label="Back to the text">↩</a></li> <li id="ref-5">Fedus, W., Zoph, B., &amp; Shazeer, N. (2022). <a href="https://arxiv.org/abs/2101.03961">Switch Transformers: scaling to trillion parameter models with simple and efficient sparsity</a>. <em>Journal of Machine Learning Research</em>, 23(120), 1–39. <a class="ref-back" href="#cite-6" aria-label="Back to the text">↩</a></li> <li id="ref-6">Wang, L., Gao, H., Zhao, C., Sun, X., &amp; Dai, D. (2024). <a href="https://arxiv.org/abs/2408.15664">Auxiliary-loss-free load balancing strategy for mixture-of-experts</a>. arXiv. <a class="ref-back" href="#cite-7" aria-label="Back to the text">↩</a></li> <li id="ref-7">DeepSeek-AI (2024). <a href="https://arxiv.org/abs/2412.19437">DeepSeek-V3 technical report</a>. arXiv. <a class="ref-back" href="#cite-8" aria-label="Back to the text">↩</a></li> <li id="ref-8">Lepikhin, D., Lee, H., Xu, Y., Chen, D., Firat, O., Huang, Y., Krikun, M., Shazeer, N., &amp; Chen, Z. (2021). <a href="https://arxiv.org/abs/2006.16668">GShard: scaling giant models with conditional computation and automatic sharding</a>. <em>ICLR 2021</em>. <a class="ref-back" href="#cite-10" aria-label="Back to the text">↩</a></li> <li id="ref-9">Zoph, B., Bello, I., Kumar, S., Du, N., Huang, Y., Dean, J., Shazeer, N., &amp; Fedus, W. (2022). <a href="https://arxiv.org/abs/2202.08906">ST-MoE: designing stable and transferable sparse expert models</a>. arXiv. <a class="ref-back" href="#cite-12" aria-label="Back to the text">↩</a></li> <li id="ref-10">Jiang, A. Q., et al. (2024). <a href="https://arxiv.org/abs/2401.04088">Mixtral of experts</a>. arXiv. <a class="ref-back" href="#cite-15" aria-label="Back to the text">↩</a></li> <li id="ref-11">Muennighoff, N., et al. (2025). <a href="https://arxiv.org/abs/2409.02060">OLMoE: open mixture-of-experts language models</a>. <em>ICLR 2025</em>. <a class="ref-back" href="#cite-16" aria-label="Back to the text">↩</a></li> <li id="ref-12">Dai, D., et al. (2024). <a href="https://arxiv.org/abs/2401.06066">DeepSeekMoE: towards ultimate expert specialization in mixture-of-experts language models</a>. <em>ACL 2024</em>. <a class="ref-back" href="#cite-19" aria-label="Back to the text">↩</a></li> <li id="ref-13">Kimi Team (2025). <a href="https://arxiv.org/abs/2507.20534">Kimi K2: open agentic intelligence</a>. arXiv. <a class="ref-back" href="#cite-21" aria-label="Back to the text">↩</a></li> <li id="ref-14">Krajewski, J., et al. (2024). <a href="https://arxiv.org/abs/2402.07871">Scaling laws for fine-grained mixture of experts</a>. <em>ICML 2024</em>. <a class="ref-back" href="#cite-22" aria-label="Back to the text">↩</a></li> <li id="ref-15">Qwen Team (2025). <a href="https://arxiv.org/abs/2505.09388">Qwen3 technical report</a>. arXiv. <a class="ref-back" href="#cite-24" aria-label="Back to the text">↩</a></li> <li id="ref-16">Meta (2025). <a href="https://ai.meta.com/blog/llama-4-multimodal-intelligence/">The Llama 4 herd: the beginning of a new era of natively multimodal AI innovation</a>. Blog post. <a class="ref-back" href="#cite-25" aria-label="Back to the text">↩</a></li> <li id="ref-17">OpenAI (2025). <a href="https://arxiv.org/abs/2508.10925">gpt-oss-120b &amp; gpt-oss-20b model card</a>. arXiv. <a class="ref-back" href="#cite-26" aria-label="Back to the text">↩</a></li> <li id="ref-18">llama.cpp (2025). <a href="https://github.com/ggml-org/llama.cpp/pull/15077">llama : add –n-cpu-moe option</a>. Pull request #15077. <a class="ref-back" href="#cite-27" aria-label="Back to the text">↩</a></li> <li id="ref-19">DeepSeek-AI (2025). <a href="https://github.com/deepseek-ai/open-infra-index/blob/main/202502OpenSourceWeek/day_6_one_more_thing_deepseekV3R1_inference_system_overview.md">Day 6: one more thing, DeepSeek-V3/R1 inference system overview</a>. GitHub. <a class="ref-back" href="#cite-28" aria-label="Back to the text">↩</a></li> <li id="ref-20">Du, N., et al. (2022). <a href="https://arxiv.org/abs/2112.06905">GLaM: efficient scaling of language models with mixture-of-experts</a>. <em>ICML 2022</em>. <a class="ref-back" href="#cite-32" aria-label="Back to the text">↩</a></li> </ol>]]></content> <author> <name>Eva Koroleva</name> </author> <category term="machine-learning"/> <category term="machine-learning"/> <category term="transformers"/> <category term="mixture-of-experts"/> <category term="llm"/> <category term="deepseek"/> <summary type="html"><![CDATA[A mixture-of-experts layer in PyTorch trained next to dense models: the router, load balancing, dropped tokens, what experts learn, and serving]]></summary> <media:thumbnail url="https://blog.korolevalab.com/assets/posts/mixture-of-experts/cover.png"/> <media:content medium="image" url="https://blog.korolevalab.com/assets/posts/mixture-of-experts/cover.png"/> </entry> <entry> <title type="html">Hybrid attention: why new LLMs keep full attention in only a few layers</title> <link href="https://blog.korolevalab.com/blog/2026/hybrid-attention/" rel="alternate" type="text/html" title="Hybrid attention: why new LLMs keep full attention in only a few layers"/> <published>2026-01-15T12:00:00+00:00</published> <updated>2026-11-02T00:00:00+00:00</updated> <id>https://blog.korolevalab.com/blog/2026/hybrid-attention</id> <content type="html" xml:base="https://blog.korolevalab.com/blog/2026/hybrid-attention/"><![CDATA[<aside class="tldr"> <p class="tldr-label">In short</p> <p>In Qwen3-Next, Kimi Linear and the other hybrids, most layers are recurrent: they read the text into a state of fixed size, keep no cache and write every token at the same cost. The price is exact recall, because a \(d \times d\) state holds at most \(d\) key-value pairs exactly.</p> <p>A few layers of full attention bring the lookups back, though where they sit matters: in a small recall test the same four layers recalled every value with attention second and far fewer with it last.</p> <p>What a hybrid saves is the cache, four to ten times over, and that pays off where contexts are long and many conversations share a GPU.</p> <div class="stats"> <div class="stat"><span class="stat-value">3 GiB</span><span class="stat-label">cache of Qwen3-Next for one 128K-token conversation, against 32 GiB for Qwen3-32B</span></div> <div class="stat"><span class="stat-value">36%</span><span class="stat-label">of the values recalled at 32 pairs by DeltaNet, the best purely recurrent model</span></div> <div class="stat"><span class="stat-value">16×</span><span class="stat-label">faster to write a token after 65K tokens, one recurrent layer against attention</span></div> </div> </aside> <p>Qwen3-32B, a dense model from April 2025, keeps 32 GiB of keys and values for one conversation of 128 thousand tokens, about half of what its weights take. Qwen3-Next, released by the same team a few months later, keeps 3 GiB at the same length. It doesn’t compress its cache or skip tokens.</p> <p>Three of every four of its layers simply have no cache: they read the text the way a recurrent network does, into a state of fixed size, and only every fourth layer is ordinary attention.</p> <p>Qwen3-Next is not the only one. Jamba, the Nemotron-H models, Kimi Linear and, for a while, MiniMax made the same choice: full attention in a few layers, something cheaper in the rest.</p> <p>This post builds the cheaper part from scratch, from linear attention to the gated delta rule, tests what it can and cannot remember, and then looks at how real models combine the two and what that buys on a GPU.</p> <h2 id="what-attention-remembers">What attention remembers</h2> <p>Every attention layer of a Transformer answers the same question for every token: which of the earlier tokens matter here, and what do they say. Softmax attention answers it by brute force. Each token leaves behind a key, which says what it is about, and a value, which says what it contributes.</p> <p>A new token arrives with a query, compares it with every key, turns the scores into weights with a softmax, and takes the weighted sum of the values:</p> \[o_t = \sum_{j \le t} \frac{\exp(q_t \cdot k_j / \sqrt{d})}{\sum_{i \le t} \exp(q_t \cdot k_i / \sqrt{d})}\, v_j .\] <p>Nothing is ever thrown away. To write token \(t\), the layer needs the keys and values of all \(t-1\) tokens before it, which is why serving engines keep them in a <em><a href="/blog/2025/inference-optimization/">KV cache</a></em> instead of recomputing them.</p> <p>Memory therefore grows linearly with the text, and since each new token reads all of it, reading a whole text of \(n\) tokens takes time proportional to \(n^2\).</p> <p>Think of a library that keeps every book it has ever received and checks the whole catalogue for every question. The answers are exact, but the building has to grow with the collection.</p> <h2 id="attention-without-the-softmax">Attention without the softmax</h2> <p>The softmax is what forces the rereading: the exponential ties every query to every key. Katharopoulos and colleagues replaced it, putting a dot product of features \(\phi(q) \cdot \phi(k)\) in place of \(\exp(q \cdot k)\), with a positive map such as \(\phi(x) = \mathrm{elu}(x) + 1\), and noticed that the rest follows from associativity<sup class="cite">[<a href="#ref-1" id="cite-1" data-ref="1" aria-label="Reference 1: Katharopoulos, A., Vyas, A., Pappas, N., &amp; Fleuret, F. (2020). Transformers are RNNs: fast autoregressive Transformers with linear attention. ICML 2020.">1</a>]</sup>:</p> \[o_t = \frac{\sum_{j \le t} \big(\phi(q_t)^\top \phi(k_j)\big) v_j}{\sum_{j \le t} \phi(q_t)^\top \phi(k_j)} = \frac{\phi(q_t)^\top S_t}{\phi(q_t)^\top z_t}, \qquad S_t = \sum_{j \le t} \phi(k_j)\, v_j^\top, \quad z_t = \sum_{j \le t} \phi(k_j).\] <p>The query no longer sits inside the sum. Everything the layer needs from the past now sits in \(S_t\), a \(d \times d\) matrix, and \(z_t\), a vector, and both are updated by adding one term per token:</p> \[S_t = S_{t-1} + \phi(k_t)\, v_t^\top .\] <p>This is a recurrent network. Its state has the same size after ten tokens and after ten million, writing a token costs the same at any position, and there is no cache. Done for all positions at once, the same computation is the attention formula with the brackets moved:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/hybrid-attention/associativity-light.png" width="760" alt="The same product computed in two orders, for 32,768 tokens and 128-dimensional heads. Multiplying the queries by the keys first gives a 32,768 by 32,768 matrix of scores, 1,073,741,824 numbers, before the values are applied. Multiplying the keys by the values first gives a 128 by 128 matrix, 16,384 numbers, that every query then reads. Without the softmax between them, the order is free" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/hybrid-attention/associativity-dark.png" width="760" alt="The same product computed in two orders, for 32,768 tokens and 128-dimensional heads. Multiplying the queries by the keys first gives a 32,768 by 32,768 matrix of scores, 1,073,741,824 numbers, before the values are applied. Multiplying the keys by the values first gives a 128 by 128 matrix, 16,384 numbers, that every query then reads. Without the softmax between them, the order is free" loading="lazy"></p> <p>Both forms compute the same numbers, only in a different order. In code, the recurrent form loops over positions and the parallel one builds the masked score matrix:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">linear_recurrent</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">):</span>
    <span class="n">q</span><span class="p">,</span> <span class="n">k</span> <span class="o">=</span> <span class="nf">feature</span><span class="p">(</span><span class="n">q</span><span class="p">),</span> <span class="nf">feature</span><span class="p">(</span><span class="n">k</span><span class="p">)</span>
    <span class="n">state</span> <span class="o">=</span> <span class="n">q</span><span class="p">.</span><span class="nf">new_zeros</span><span class="p">(</span><span class="o">*</span><span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[:</span><span class="mi">2</span><span class="p">],</span> <span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">],</span> <span class="n">v</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">])</span>  <span class="c1"># S = sum of k v^T
</span>    <span class="n">norm</span> <span class="o">=</span> <span class="n">q</span><span class="p">.</span><span class="nf">new_zeros</span><span class="p">(</span><span class="o">*</span><span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[:</span><span class="mi">2</span><span class="p">],</span> <span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">])</span>                <span class="c1"># z = sum of k
</span>    <span class="n">out</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">2</span><span class="p">]):</span>
        <span class="n">state</span> <span class="o">=</span> <span class="n">state</span> <span class="o">+</span> <span class="n">k</span><span class="p">[:,</span> <span class="p">:,</span> <span class="n">t</span><span class="p">,</span> <span class="p">:,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">*</span> <span class="n">v</span><span class="p">[:,</span> <span class="p">:,</span> <span class="n">t</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:]</span>
        <span class="n">norm</span> <span class="o">=</span> <span class="n">norm</span> <span class="o">+</span> <span class="n">k</span><span class="p">[:,</span> <span class="p">:,</span> <span class="n">t</span><span class="p">]</span>
        <span class="n">out</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">einsum</span><span class="p">(</span><span class="sh">"</span><span class="s">bhk,bhkv-&gt;bhv</span><span class="sh">"</span><span class="p">,</span> <span class="n">q</span><span class="p">[:,</span> <span class="p">:,</span> <span class="n">t</span><span class="p">],</span> <span class="n">state</span><span class="p">)</span>
                   <span class="o">/</span> <span class="n">torch</span><span class="p">.</span><span class="nf">einsum</span><span class="p">(</span><span class="sh">"</span><span class="s">bhk,bhk-&gt;bh</span><span class="sh">"</span><span class="p">,</span> <span class="n">q</span><span class="p">[:,</span> <span class="p">:,</span> <span class="n">t</span><span class="p">],</span> <span class="n">norm</span><span class="p">)[...,</span> <span class="bp">None</span><span class="p">])</span>
    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">(</span><span class="n">out</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">2</span><span class="p">)</span>

<span class="k">def</span> <span class="nf">linear_attention</span><span class="p">(</span><span class="n">q</span><span class="p">,</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span><span class="p">):</span>
    <span class="n">q</span><span class="p">,</span> <span class="n">k</span> <span class="o">=</span> <span class="nf">feature</span><span class="p">(</span><span class="n">q</span><span class="p">),</span> <span class="nf">feature</span><span class="p">(</span><span class="n">k</span><span class="p">)</span>
    <span class="n">causal</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">ones</span><span class="p">(</span><span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">2</span><span class="p">],</span> <span class="n">q</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">2</span><span class="p">],</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">bool</span><span class="p">).</span><span class="nf">tril</span><span class="p">()</span>
    <span class="n">scores</span> <span class="o">=</span> <span class="p">(</span><span class="n">q</span> <span class="o">@</span> <span class="n">k</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">2</span><span class="p">)).</span><span class="nf">masked_fill</span><span class="p">(</span><span class="o">~</span><span class="n">causal</span><span class="p">,</span> <span class="mi">0</span><span class="p">)</span>
    <span class="nf">return </span><span class="p">(</span><span class="n">scores</span> <span class="o">@</span> <span class="n">v</span><span class="p">)</span> <span class="o">/</span> <span class="n">scores</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
</code></pre></div></div> <p>On random inputs in double precision the two functions agree to about \(10^{-15}\), which is rounding error. The recurrent form is how the layer writes text, one token at a time; the parallel form is how it trains, all positions at once.</p> <p>The parallel form also shows a catch: it still builds an \(n \times n\) matrix of scores, because with a causal mask every position needs its own prefix of the sum and the brackets can’t simply move. Training a linear layer efficiently needs a third form, <a class="arrow-link" href="#training-a-recurrence-in-parallel">which comes later</a>.</p> <h2 id="a-memory-of-fixed-size">A memory of fixed size</h2> <p>The price of the fixed state can be read straight from the formula. The state is one matrix. Every pair \((k_j, v_j)\) is added into the same \(d^2\) numbers, and to recall the value stored under a key, the layer multiplies the state by it:</p> \[S^\top k_i = \sum_j (k_j \cdot k_i)\, v_j = (k_i \cdot k_i)\, v_i + \sum_{j \ne i} (k_j \cdot k_i)\, v_j .\] <p>The first term is the stored value. The second is interference: every other pair, weighted by how similar its key is to \(k_i\). If the keys are orthogonal, the interference is exactly zero, but a \(d\)-dimensional space has room for only \(d\) orthogonal directions.</p> <p>Beyond that, each new pair blurs the ones already stored. The library has turned into one notebook page on which every note is written over the others; it stays readable while there are few notes.</p> <p>Softmax attention has no such limit because it never mixes the notes: it keeps them all and lets the exponential pick out the right one. It pays for that with the growing cache. Everything below is about this trade between a fixed state and exact recall.</p> <p>Arora and colleagues measured it across efficient architectures and called it “a key tradeoff between a model’s state size and recall ability”<sup class="cite">[<a href="#ref-2" id="cite-2" data-ref="2" aria-label="Reference 2: Arora, S., et al. (2024). Simple linear attention language models balance the recall-throughput tradeoff. ICML 2024.">2</a>]</sup>: the smaller the state a model keeps while reading, the worse it recalls.</p> <h2 id="writing-with-the-delta-rule">Writing with the delta rule</h2> <p>Plain addition has a second, quieter problem. If the same key comes back with a new value, say a variable that has been reassigned, the state holds the sum of the old and the new value, and reading it returns a mixture of both. Nothing in the notebook can be crossed out.</p> <p>The remedy dates from 1960, when Widrow and Hoff trained their linear neurons with what became known as the delta rule: compare the output with the target and move the weights in proportion to the error<sup class="cite">[<a href="#ref-3" id="cite-3" data-ref="3" aria-label="Reference 3: Widrow, B., &amp; Hoff, M. E. (1960). Adaptive switching circuits. IRE WESCON Convention Record, 4, 96–104.">3</a>]</sup>.</p> <p>Schlag, Irie and Schmidhuber noticed that the state of linear attention is a weight matrix, written at every step, and proposed writing it the same way<sup class="cite">[<a href="#ref-4" id="cite-4" data-ref="4" aria-label="Reference 4: Schlag, I., Irie, K., &amp; Schmidhuber, J. (2021). Linear Transformers are secretly fast weight programmers. ICML 2021.">4</a>]</sup>. Before storing \(v_t\) under \(k_t\), read what is already there, and write only the difference:</p> \[S_t = S_{t-1} + \beta_t\, k_t \big(v_t - S_{t-1}^\top k_t\big)^\top = (I - \beta_t k_t k_t^\top)\, S_{t-1} + \beta_t\, k_t v_t^\top ,\] <p>with \(k_t\) of unit length and \(\beta_t \in (0, 1)\), a writing strength the layer computes for each token. This is one step of gradient descent on the memory’s error for this key, \(\tfrac12 \lVert S^\top k_t - v_t \rVert^2\), with learning rate \(\beta_t\): the gradient with respect to \(S\) is \(k_t (S^\top k_t - v_t)^\top\).</p> <p>With \(\beta_t = 1\), the old value under \(k_t\) is erased and the new one is stored exactly. A layer that writes this way is called <em>DeltaNet</em>. In the space of values, one write looks like this:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/hybrid-attention/delta-step-light.png" width="760" alt="One write of the delta rule, drawn in the space of values. The memory returns an old value for the key; the new value is elsewhere; the error is the arrow between them. A write of strength 0.5 moves the memory's answer halfway along the error, a write of strength 1 lands on the new value exactly. Plain addition would instead add the new value to the old one" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/hybrid-attention/delta-step-dark.png" width="760" alt="One write of the delta rule, drawn in the space of values. The memory returns an old value for the key; the new value is elsewhere; the error is the arrow between them. A write of strength 0.5 moves the memory's answer halfway along the error, a write of strength 1 lands on the new value exactly. Plain addition would instead add the new value to the old one" loading="lazy"></p> <p>Side by side, the three memories differ in what they keep and in how a new pair changes it:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/hybrid-attention/memories-light.png" width="760" alt="Three ways for a layer to remember the tokens it has read. Softmax attention keeps the key and the value of every token, so its memory grows with the text, and a query is compared with every key. Linear attention keeps one matrix and adds the outer product of each key and value to it, so its memory has a fixed size. The delta rule keeps the same matrix but first reads what it holds under the new key and writes only the difference" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/hybrid-attention/memories-dark.png" width="760" alt="Three ways for a layer to remember the tokens it has read. Softmax attention keeps the key and the value of every token, so its memory grows with the text, and a query is compared with every key. Linear attention keeps one matrix and adds the outer product of each key and value to it, so its memory has a fixed size. The delta rule keeps the same matrix but first reads what it holds under the new key and writes only the difference" loading="lazy"></p> <p>How much of a difference does editing make? A small experiment shows both sides of it: a \(64 \times 64\) memory, random unit keys and values, written once by adding and once by the delta rule, and read back by finding the nearest stored value. Softmax attention, which keeps every pair, is the reference.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/hybrid-attention/memory-light.png" width="760" alt="Left: share of 64-dimensional key-value pairs recalled from a 64 by 64 memory. Keeping every pair, as softmax attention does, recalls all of them at any number. Adding outer products recalls 98% of 128 pairs and 34% of 512; editing with the delta rule recalls 53% and 13%, keeping the newest. Right: after 32 pairs, some keys get a new value; the delta rule returns the new value 100% of the time, adding and softmax attention about half the time" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/hybrid-attention/memory-dark.png" width="760" alt="Left: share of 64-dimensional key-value pairs recalled from a 64 by 64 memory. Keeping every pair, as softmax attention does, recalls all of them at any number. Adding outer products recalls 98% of 128 pairs and 34% of 512; editing with the delta rule recalls 53% and 13%, keeping the newest. Right: after 32 pairs, some keys get a new value; the delta rule returns the new value 100% of the time, adding and softmax attention about half the time" loading="lazy"></p> <p>The left panel holds a surprise: from 64 pairs on, plain addition recalls more than the delta rule. With \(\beta_t = 1\), each write makes the memory return exactly \(v_t\) for \(k_t\), and since random keys are not orthogonal, it also shifts what the memory returns for every older key that overlaps with \(k_t\).</p> <p>Once the memory is full, the delta rule holds the recent pairs well and the old ones poorly. Addition keeps a blur of everything, in which the nearest value is still often the right one.</p> <p>The right panel shows what the delta rule is for. After 32 pairs, some of the keys get a new value. The delta rule returns the new value nearly every time.</p> <p>Addition returns the sum of the old and the new value, which is nearer to the new one only about half the time, and softmax attention as written here does no better: it sees two identical keys and averages their values.</p> <p>A trained Transformer can tell the later pair from the earlier one by their positions; this toy has no positions.</p> <div class="callout callout-key"> <p class="callout-label">Key point</p> <p>The delta rule doesn’t enlarge the memory. A \(d \times d\) matrix stays a \(d \times d\) matrix, and it holds at most \(d\) pairs exactly, whichever way they are written. What the delta rule adds is the ability to correct what is stored, which plain addition doesn’t have at all.</p> </div> <h2 id="forgetting-on-purpose">Forgetting on purpose</h2> <p>Editing handles values that change. It does nothing about the opposite problem: a long text moves on, and much of what the state holds stops mattering. A memory of fixed size needs a way to let go of it.</p> <p>That is what gates are for. RetNet multiplied the state by a fixed decay at every step<sup class="cite">[<a href="#ref-5" id="cite-5" data-ref="5" aria-label="Reference 5: Sun, Y., et al. (2023). Retentive network: a successor to Transformer for large language models. arXiv.">5</a>]</sup>, Gated Linear Attention made the decay depend on the token<sup class="cite">[<a href="#ref-6" id="cite-6" data-ref="6" aria-label="Reference 6: Yang, S., Wang, B., Shen, Y., Panda, R., &amp; Kim, Y. (2024). Gated linear attention Transformers with hardware-efficient training. ICML 2024.">6</a>]</sup>, and Mamba-2 showed that its own selective state space model is linear attention with a data-dependent scalar gate<sup class="cite">[<a href="#ref-7" id="cite-7" data-ref="7" aria-label="Reference 7: Dao, T., &amp; Gu, A. (2024). Transformers are SSMs: generalized models and efficient algorithms through structured state space duality. ICML 2024.">7</a>]</sup>. <em>Gated DeltaNet</em> puts the gate and the delta rule together<sup class="cite">[<a href="#ref-8" id="cite-8" data-ref="8" aria-label="Reference 8: Yang, S., Kautz, J., &amp; Hatamizadeh, A. (2025). Gated delta networks: improving Mamba2 with delta rule. ICLR 2025.">8</a>]</sup>:</p> \[S_t = \alpha_t \,(I - \beta_t k_t k_t^\top)\, S_{t-1} + \beta_t\, k_t v_t^\top, \qquad \alpha_t \in (0, 1).\] <p>Both \(\alpha_t\) and \(\beta_t\) are computed from the current token, so the layer decides as it reads when to forget and how firmly to write.</p> <p>The two parts split the work: in the authors’ words, the gate “can promptly clear memory by setting \(\alpha_t \to 0\)”, and with \(\alpha_t \to 1\) the layer is “effectively switching to the pure delta rule” and edits single entries without touching the rest.</p> <p>This is the layer Qwen3-Next is built on, and Kimi Delta Attention is the same update with a separate gate for every channel of the state instead of one per head<sup class="cite">[<a href="#ref-9" id="cite-9" data-ref="9" aria-label="Reference 9: Kimi Team (2025). Kimi Linear: an expressive, efficient attention architecture. arXiv.">9</a>]</sup>.</p> <h2 id="training-a-recurrence-in-parallel">Training a recurrence in parallel</h2> <p>A recurrence over positions is awkward to train on a GPU, which is fast at large matrix products and slow at loops of ten thousand small updates. The solution is to cut the sequence into chunks.</p> <p>Inside a chunk of 64 tokens, the writes depend on each other only through a small lower-triangular system that can be solved with matrix products; between chunks, only the \(d \times d\) state is passed along<sup class="cite">[<a href="#ref-10" id="cite-10" data-ref="10" aria-label="Reference 10: Yang, S., Wang, B., Zhang, Y., Shen, Y., &amp; Kim, Y. (2024). Parallelizing linear Transformers with the delta rule over sequence length. NeurIPS 2024.">10</a>]</sup>.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/hybrid-attention/chunks-light.png" width="760" alt="How a recurrent layer is trained in parallel. The sequence is cut into chunks of 64 tokens. Inside a chunk, all positions are computed at once with matrix products; between chunks, only the d by d state is passed on, one step per chunk instead of one per token" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/hybrid-attention/chunks-dark.png" width="760" alt="How a recurrent layer is trained in parallel. The sequence is cut into chunks of 64 tokens. Inside a chunk, all positions are computed at once with matrix products; between chunks, only the d by d state is passed on, one step per chunk instead of one per token" loading="lazy"></p> <p>The chunked form is exact. My plain-PyTorch version of it agrees with the token-by-token loop to \(1.4 \times 10^{-15}\) in double precision, with the gate or without it, and it is what the experiments below train with. Production models use the Triton kernels of <a href="https://github.com/fla-org/flash-linear-attention">flash-linear-attention</a>, which do the same thing much faster.</p> <h2 id="a-test-of-memory-associative-recall">A test of memory: associative recall</h2> <p>The language modelling loss says little about memory, because much of predicting the next word needs little of it. A more direct test asks a model to remember what it was told. In multi-query associative recall, a sequence lists key-value pairs and then asks for the values of the keys in a shuffled order<sup class="cite">[<a href="#ref-11" id="cite-11" data-ref="11" aria-label="Reference 11: Arora, S., et al. (2023). Zoology: measuring and improving recall in efficient language models. ICLR 2024.">11</a>]</sup>:</p> <div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>k1 v1  k2 v2  ...  kN vN   |   q1 a1  q2 a2  ...  qN aN
</code></pre></div></div> <p>Each \(q_i\) is one of the keys, and the model must put the right value after it. It is the skill behind answering a question about a long document, using a name defined forty pages earlier, or calling a function with the arguments described at the top of a prompt.</p> <p>I trained six small models on it, each with four layers of width 64 and two heads, the same in everything except how their layers mix tokens: softmax attention in all four, linear attention, DeltaNet, Gated DeltaNet, and two hybrids with three Gated DeltaNet layers and one softmax attention layer.</p> <p>In one hybrid the attention layer is second; in the other it is on top, the place it has in each block of four in Qwen3-Next.</p> <p>Every layer, attention included, first passes its queries, keys and values through a short convolution over the last four positions, as Mamba and DeltaNet do, so that a value can carry its key with it.</p> <p>Each model saw 64 fresh random sequences at each of 4,000 steps and was scored on held-out ones. The models with Gated DeltaNet layers trained on an Apple M2, the others on a T4 (<a href="https://github.com/xmarva/transformers-from-scratch/tree/main/articles/hybrid_attention">code</a>).</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/hybrid-attention/mqar-light.png" width="760" alt="Share of values recalled with 4, 8, 16, 32 and 64 key-value pairs, by six models of four layers and width 64: Transformer 100%, 100%, 100%, 100%, 100%; Hybrid (attention 2nd) 100%, 100%, 100%, 100%, 100%; Hybrid (attention on top) 100%, 100%, 26%, 12%, 1%; Gated DeltaNet 100%, 98%, 19%, 2%, 0%; DeltaNet 100%, 100%, 71%, 36%, 13%; Linear attention 97%, 82%, 76%, 26%, 0%" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/hybrid-attention/mqar-dark.png" width="760" alt="Share of values recalled with 4, 8, 16, 32 and 64 key-value pairs, by six models of four layers and width 64: Transformer 100%, 100%, 100%, 100%, 100%; Hybrid (attention 2nd) 100%, 100%, 100%, 100%, 100%; Hybrid (attention on top) 100%, 100%, 26%, 12%, 1%; Gated DeltaNet 100%, 98%, 19%, 2%, 0%; DeltaNet 100%, 100%, 71%, 36%, 13%; Linear attention 97%, 82%, 76%, 26%, 0%" loading="lazy"></p> <p>The Transformer recalls every value at every size on the chart. The three recurrent models hold up while there are few pairs and fall apart between 8 and 32: at 32 pairs DeltaNet recalls 36% of the values, linear attention 26% and Gated DeltaNet 2%, and at 64 the best of them, DeltaNet, recalls 13%.</p> <p>Each head here works with keys of 32 numbers, so by the bound from earlier its state holds at most 32 pairs exactly, and at 16 pairs all three are already well short of full recall.</p> <p>At 128 pairs even the Transformer didn’t learn the task in 4,000 steps, which is why the chart stops at 64.</p> <p>Gated DeltaNet, the newest of the three, comes last from 16 pairs on. That is less strange than it looks, because this test gives the gate nothing to do. Every pair has to be kept until its question comes, so forgetting can only lose information.</p> <p>The authors of Gated DeltaNet, who trained models of 1.3 billion parameters on 100 billion tokens of real text, found that it “consistently surpasses existing models like Mamba2 and DeltaNet”, in-context retrieval included<sup class="cite">[<a href="#ref-8" id="cite-12" data-ref="8" aria-label="Reference 8: Yang, S., Kautz, J., &amp; Hatamizadeh, A. (2025). Gated delta networks: improving Mamba2 with delta rule. ICLR 2025.">8</a>]</sup>. Four layers and 4,000 steps of a synthetic task are a different regime.</p> <div class="callout callout-warn"> <p class="callout-label">Trap</p> <p>The gate is the easiest part to get wrong. In my first version it started at about one half, and weight decay kept pulling it back there, so the state lost half of what it held at every token, and Gated DeltaNet and the hybrid stayed at chance level. Starting the gate as the Gated DeltaNet and Mamba-2 code does, where a typical head keeps about 94% of its state from one token to the next, and leaving it out of weight decay, fixed it.</p> </div> <p>The two hybrids differ only in the order of their layers. With attention second, the hybrid recalls every value at every size, like the Transformer, though three of its four layers are Gated DeltaNet, which on its own recalls the least.</p> <p>With attention on top, the same layers recall 26% of the values at 16 pairs and 12% at 32, at the better of two learning rates: a little more than Gated DeltaNet alone and less than DeltaNet.</p> <p>I can’t say for certain why. The attention layer on top has what it needs: the convolution hands each value its key, and the other hybrid shows that one attention layer among three Gated DeltaNet layers is enough. This one just doesn’t learn the lookup in 4,000 steps.</p> <p>A model of four layers is far from Qwen3-Next, where twelve attention layers are spread through 48 and most of them have many recurrent layers on both sides, so this says nothing about whether its layout is a good one.</p> <p class="takeaway">The ratio alone doesn’t describe a hybrid: with the same layers in a different order, one model recalled every value, like a Transformer, and the other 12% of them at 32 pairs, like a recurrent network.</p> <h2 id="why-one-layer-of-attention-is-enough">Why one layer of attention is enough</h2> <p>Attention solves associative recall in one layer: the query for \(k_i\) meets the stored key \(k_i\), the softmax puts nearly all the weight on it, and out comes \(v_i\), however many pairs came before.</p> <p>Arora and colleagues proved that attention needs a model dimension independent of the sequence length for this, while the gated convolutions they studied need one that grows with it.</p> <p>Measuring the gap in quality between the two kinds of models on real text, they found that “82% of the gap is explained by each model’s ability to recall information that is previously mentioned in-context”<sup class="cite">[<a href="#ref-11" id="cite-13" data-ref="11" aria-label="Reference 11: Arora, S., et al. (2023). Zoology: measuring and improving recall in efficient language models. ICLR 2024.">11</a>]</sup>.</p> <p>Copying gives the same picture. Jelassi and colleagues proved that two layers of attention can copy strings of exponential length, while models with a fixed state are “fundamentally limited by their fixed-size latent state”<sup class="cite">[<a href="#ref-12" id="cite-14" data-ref="12" aria-label="Reference 12: Jelassi, S., Brandfonbrener, D., Kakade, S. M., &amp; Malach, E. (2024). Repeat after me: Transformers are better than state space models at copying. ICML 2024.">12</a>]</sup>.</p> <p>None of this requires attention everywhere. Much of predicting the next token is local, or a matter of keeping a running summary of what the text is about, and a gated recurrent layer does that well and cheaply.</p> <p>Exact lookups into the distant past are rarer, and a layer that can make them serves the whole model: the recurrent layers around it carry the local context, the attention layer finds the match. In the library picture, most floors work from a notebook page, and every few floors someone is allowed into the archive.</p> <p>The authors of Mamba-2 tried such hybrids and described the division of labour the same way:</p> <blockquote class="pull"> <p>Attention layers act as a retrieval mechanism to quickly refer to previous tokens in the sequence instead of forcing the model to compress all the context to its memory.</p> <p><cite>Tri Dao and Albert Gu, the authors of Mamba-2</cite></p> </blockquote> <p>They found that “around 10% of the total number of layers being attention performs best”<sup class="cite">[<a href="#ref-7" id="cite-15" data-ref="7" aria-label="Reference 7: Dao, T., &amp; Gu, A. (2024). Transformers are SSMs: generalized models and efficient algorithms through structured state space duality. ICML 2024.">7</a>]</sup>.</p> <p>A study at NVIDIA trained an 8-billion-parameter Transformer, pure Mamba and Mamba-2 models and a hybrid with 4 attention layers out of 56 on the same data.</p> <p>The pure Mamba models began to fail at looking up a number in a phone book beyond about 500 tokens. The hybrid exceeded the Transformer on all 12 standard tasks the authors evaluated, by 2.65 points on average<sup class="cite">[<a href="#ref-13" id="cite-16" data-ref="13" aria-label="Reference 13: Waleffe, R., et al. (2024). An empirical study of Mamba-based language models. arXiv.">13</a>]</sup>.</p> <h2 id="hybrids-in-practice">Hybrids in practice</h2> <p>The first large hybrid was Jamba from AI21, in March 2024: Mamba layers with one attention layer in every eight<sup class="cite">[<a href="#ref-14" id="cite-17" data-ref="14" aria-label="Reference 14: Lieber, O., et al. (2024). Jamba: a hybrid Transformer-Mamba language model. arXiv.">14</a>]</sup>. MiniMax, NVIDIA, Qwen and Moonshot followed, each with its own recurrent layer and its own ratio.</p> <p>MiniMax-Text-01 put one softmax layer after every seven layers of lightning attention, a fast form of linear attention, after finding that lightning attention alone “demonstrates limited retrieval capabilities”<sup class="cite">[<a href="#ref-15" id="cite-18" data-ref="15" aria-label="Reference 15: MiniMax (2025). MiniMax-01: scaling foundation models with lightning attention. arXiv.">15</a>]</sup>. NVIDIA’s Nemotron-H models keep “roughly 8% of the total number of layers” as attention, and the rest are Mamba-2 and MLP layers<sup class="cite">[<a href="#ref-16" id="cite-19" data-ref="16" aria-label="Reference 16: NVIDIA (2025). Nemotron-H: a family of accurate and efficient hybrid Mamba-Transformer models. arXiv.">16</a>]</sup>.</p> <p>Qwen3-Next uses Gated DeltaNet in three layers out of four. According to the Qwen team, at this ratio “the model consistently outperforms any monolithic architecture”<sup class="cite">[<a href="#ref-17" id="cite-20" data-ref="17" aria-label="Reference 17: Qwen Team (2025). Qwen3-Next: towards ultimate training &amp; inference efficiency. Alibaba Cloud blog.">17</a>]</sup>.</p> <p>Kimi Linear uses Kimi Delta Attention, the variant with a gate for every channel, also at 3:1. It leaves word order entirely to the recurrent layers: its attention layers use no positional encoding at all<sup class="cite">[<a href="#ref-9" id="cite-21" data-ref="9" aria-label="Reference 9: Kimi Team (2025). Kimi Linear: an expressive, efficient attention architecture. arXiv.">9</a>]</sup>.</p> <p>Here is where each model keeps its full attention, read from the config files the models are published with:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/hybrid-attention/patterns-light.png" width="760" alt="The layers of real models, one mark per token-mixing layer, read from their config files. Jamba: 4 of 32 layers are full attention. MiniMax-Text-01: 10 of 80 layers are full attention. Nemotron-H-8B: 4 of 28 layers are full attention. Qwen3-Next-80B-A3B: 12 of 48 layers are full attention. Kimi Linear 48B-A3B: 7 of 27 layers are full attention. Qwen3.5-397B-A17B: 15 of 60 layers are full attention. Kimi K3: 24 of 93 layers are full attention. gpt-oss-20b: 12 of 24 layers are full attention, 12 use a sliding window. Gemma 4 31B: 10 of 60 layers are full attention, 50 use a sliding window. MiniMax-M2: 62 of 62 layers are full attention. MiniMax-M2, the successor of MiniMax-Text-01, uses full attention in all of its layers" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/hybrid-attention/patterns-dark.png" width="760" alt="The layers of real models, one mark per token-mixing layer, read from their config files. Jamba: 4 of 32 layers are full attention. MiniMax-Text-01: 10 of 80 layers are full attention. Nemotron-H-8B: 4 of 28 layers are full attention. Qwen3-Next-80B-A3B: 12 of 48 layers are full attention. Kimi Linear 48B-A3B: 7 of 27 layers are full attention. Qwen3.5-397B-A17B: 15 of 60 layers are full attention. Kimi K3: 24 of 93 layers are full attention. gpt-oss-20b: 12 of 24 layers are full attention, 12 use a sliding window. Gemma 4 31B: 10 of 60 layers are full attention, 50 use a sliding window. MiniMax-M2: 62 of 62 layers are full attention. MiniMax-M2, the successor of MiniMax-Text-01, uses full attention in all of its layers" loading="lazy"></p> <p>Drawn to scale, the designs differ more than their headline ratios. Jamba and MiniMax-Text-01 keep one attention layer in eight, Nemotron-H-8B 4 of its 28 token-mixing layers, the Qwen and Kimi models one in four.</p> <p>Kimi Linear’s released model has 27 layers, so its 3:1 turns into 20 recurrent layers and 7 attention layers, the last one attention.</p> <p>Kimi K3, 93 layers deep, adds an extra attention layer at the top, “ensuring that the final layer always performs global attention”<sup class="cite">[<a href="#ref-18" id="cite-22" data-ref="18" aria-label="Reference 18: Kimi Team (2026). Kimi K3: open frontier intelligence. arXiv.">18</a>]</sup>. All of them spread the attention layers evenly through the depth.</p> <p>The second group shrinks the cache in another way. gpt-oss and Gemma use softmax attention in every layer, but most of their layers see only a sliding window of recent tokens: 128 in gpt-oss, where windowed and full layers alternate<sup class="cite">[<a href="#ref-19" id="cite-23" data-ref="19" aria-label="Reference 19: OpenAI (2025). gpt-oss-120b &amp; gpt-oss-20b model card. arXiv.">19</a>]</sup>, and 1,024 in Gemma 3, with five windowed layers for every full one<sup class="cite">[<a href="#ref-20" id="cite-24" data-ref="20" aria-label="Reference 20: Gemma Team (2025). Gemma 3 technical report. arXiv.">20</a>]</sup>.</p> <p>Gemma 4 kept the ratio. A window is the opposite trade to a recurrent state: it keeps recent tokens exactly and forgets older ones completely, while a state keeps a blurred summary of everything.</p> <p>The last row is MiniMax-M2, the successor of MiniMax-Text-01, with full attention in all 62 layers. The team explained why in a blog post.</p> <p>Small hybrids had matched full attention on the leaderboards, but “the price paid became obvious at a larger scale: the model had clear deficits in complex, multi-hop reasoning tasks”<sup class="cite">[<a href="#ref-21" id="cite-25" data-ref="21" aria-label="Reference 21: MiniMax (2025). Why did MiniMax M2 end up as a full attention model? Hugging Face blog.">21</a>]</sup>.</p> <p>The Qwen and Kimi hybrids keep more attention than MiniMax-Text-01 did, one layer in four rather than one in eight, and use the delta rule, which lightning attention lacks. Still, the episode is a fair warning that parity on small models and leaderboards doesn’t settle the question.</p> <p>What the hybrids save is easiest to see in memory. For each model, the size of its cache follows from the config: the number of attention layers, key-value heads and head dimension.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/hybrid-attention/kv-memory-light.png" width="760" alt="Keys and values one sequence of 128K tokens keeps in bf16, derived from each model's config: Qwen3-32B 32 GiB, MiniMax-M2 31 GiB, Qwen3-8B 18 GiB, MiniMax-Text-01 5 GiB, gpt-oss-20b 3 GiB, Qwen3-Next 3 GiB, Jamba 2 GiB, Kimi Linear 0.98 GiB, Nemotron 3 Nano 0.75 GiB. Qwen3-32B, MiniMax-M2 and Qwen3-8B use full attention in every layer, gpt-oss-20b a sliding window in half of them, the others recurrent layers with full attention in a few" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/hybrid-attention/kv-memory-dark.png" width="760" alt="Keys and values one sequence of 128K tokens keeps in bf16, derived from each model's config: Qwen3-32B 32 GiB, MiniMax-M2 31 GiB, Qwen3-8B 18 GiB, MiniMax-Text-01 5 GiB, gpt-oss-20b 3 GiB, Qwen3-Next 3 GiB, Jamba 2 GiB, Kimi Linear 0.98 GiB, Nemotron 3 Nano 0.75 GiB. Qwen3-32B, MiniMax-M2 and Qwen3-8B use full attention in every layer, gpt-oss-20b a sliding window in half of them, the others recurrent layers with full attention in a few" loading="lazy"></p> <p>For one sequence of 128K tokens, Qwen3-Next keeps 3 GiB of keys and values, against 32 GiB for Qwen3-32B. Not all of the factor of ten comes from the hybrid. Each attention layer of Qwen3-Next keeps two key-value heads of 256 dimensions, where Qwen3-32B keeps eight of 128, which halves the cache per layer.</p> <p>The rest, a factor of 5.3, is 12 attention layers instead of 64. The recurrent layers add a state of 36 MiB that stays the same at any length.</p> <p>Kimi Linear starts from multi-head latent attention, introduced in DeepSeek-V2<sup class="cite">[<a href="#ref-22" id="cite-26" data-ref="22" aria-label="Reference 22: DeepSeek-AI (2024). DeepSeek-V2: a strong, economical, and efficient mixture-of-experts language model. arXiv.">22</a>]</sup>, which already caches one compressed vector of 576 numbers per token and layer in place of keys and values for every head, and keeps it in 7 layers of 27.</p> <p>That is 26% of the cache of an all-MLA model of the same depth, in line with the paper’s “reducing KV cache usage by up to 75%”. MiniMax-M2, at 31 GiB, keeps six times more than its predecessor.</p> <p>At long context, the cache rather than the weights decides how many conversations fit on a GPU at once, and decoding speed follows from that.</p> <p>The Kimi Linear authors measured decoding with a million tokens of context and put the result down to memory: the smaller cache “enables larger batches, yielding a 6.3× faster TPOT (1.84ms vs. 11.48ms) than MLA at 1M tokens”, TPOT being the time per output token.</p> <p class="flow"><span>attention in 7 of 27 layers</span><span>26% of the cache</span><span>larger batches</span><span>6.3× faster decoding at 1M tokens</span></p> <h2 id="what-it-costs-on-a-gpu">What it costs on a GPU</h2> <p>The recurrent layer pays off only where the cache grows large, and a single layer on one GPU shows where that starts.</p> <p>I timed one layer with 16 heads of 128 dimensions, about the size of a Gated DeltaNet layer in Qwen3-Next, in two situations: reading a prompt of \(n\) tokens at once, and writing one new token after \(n\) tokens.</p> <p>Softmax attention runs through PyTorch’s fused attention kernel in half precision. Gated DeltaNet runs my plain-PyTorch chunked version in single precision, a Python loop over chunks of 64. The comparison is tilted against the recurrent layer on purpose: if it wins anyway, it wins on arithmetic, not on engineering.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/hybrid-attention/prefill-light.png" width="760" alt="Time for one layer with 16 heads of 128 to read a prompt, on a Tesla T4, on logarithmic axes. Softmax attention takes 0.18 ms for 512 tokens and 1,579 ms for 65,536; the chunked Gated DeltaNet in plain PyTorch takes 3.0 ms and 377 ms. Attention is faster up to 8K tokens, the recurrent layer from 16K on" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/hybrid-attention/prefill-dark.png" width="760" alt="Time for one layer with 16 heads of 128 to read a prompt, on a Tesla T4, on logarithmic axes. Softmax attention takes 0.18 ms for 512 tokens and 1,579 ms for 65,536; the chunked Gated DeltaNet in plain PyTorch takes 3.0 ms and 377 ms. Attention is faster up to 8K tokens, the recurrent layer from 16K on" loading="lazy"></p> <p><img class="tfs-figure tfs-light" src="/assets/posts/hybrid-attention/decode-light.png" width="760" alt="Writing one token after a context of 512 to 65,536 tokens. Left: softmax attention takes 0.08 ms to 3.7 ms, growing with the context; Gated DeltaNet about 0.2 ms at every length. Right: attention reads 4 to 512 MiB of keys and values, the recurrent layer a state of 1 MiB" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/hybrid-attention/decode-dark.png" width="760" alt="Writing one token after a context of 512 to 65,536 tokens. Left: softmax attention takes 0.08 ms to 3.7 ms, growing with the context; Gated DeltaNet about 0.2 ms at every length. Right: attention reads 4 to 512 MiB of keys and values, the recurrent layer a state of 1 MiB" loading="lazy"></p> <p>Reading a prompt, softmax attention is faster up to 8K tokens, which is no surprise: its kernel is one fused program, and mine is a loop. The slopes differ, though.</p> <p>From 512 to 65,536 tokens, a sequence 128 times longer, the attention layer gets 8,600 times slower and the recurrent one 124 times slower. The curves cross between 8K and 16K tokens, and at 65K the recurrent layer is 4.2 times faster.</p> <p>Writing a token is where the cache costs most. Attention reads the keys and values of every earlier token, 512 MiB at 65K tokens in this one layer, and its time grows in proportion, from 0.08 ms to 3.7 ms. The recurrent layer updates a state of 1 MiB and takes 0.2 ms at any length; at that size the time is mostly the overhead of launching a few small GPU kernels.</p> <p>From about 2K tokens on, the recurrent step is faster, and at 65K it is 16 times faster.</p> <p class="takeaway">On one GPU the recurrent layer overtakes attention from about 2K tokens when writing a token, and between 8K and 16K tokens when reading a prompt.</p> <p>One layer and one sequence understate the difference in a real server. There, the caches of all the conversations in a batch have to fit in memory at once, so a model whose cache is a quarter or an eighth of the size can serve proportionally more conversations at the same length.</p> <p>Kimi Linear’s 6.3 times, quoted above, comes from exactly that. The attention layers of a hybrid still pay the full price; three quarters of its layers stop paying it.</p> <h2 id="when-a-hybrid-is-the-right-choice">When a hybrid is the right choice</h2> <p>A hybrid pays off when contexts are long and there are many of them: agents that carry long transcripts of tool calls, reasoning models that write tens of thousands of tokens, questions over long documents, a server holding hundreds of such conversations at once.</p> <p>There the cache is most of the memory and reading it is most of the decoding time, and cutting it by a factor of four to ten changes how many users one GPU can serve.</p> <p>At short contexts the gain is smaller than the headlines suggest. According to Qwen, the decoding throughput of Qwen3-Next is nearly 4 times that of Qwen3-32B at 4K tokens and over 10 times beyond 32K<sup class="cite">[<a href="#ref-17" id="cite-27" data-ref="17" aria-label="Reference 17: Qwen Team (2025). Qwen3-Next: towards ultimate training &amp; inference efficiency. Alibaba Cloud blog.">17</a>]</sup>.</p> <p>But Qwen3-Next activates 3 billion parameters per token and Qwen3-32B all 32 billion, so the comparison mixes two savings, the mixture of experts and the hybrid, and the blog doesn’t separate them. The hybrid’s share is the part that grows with the context.</p> <p>The costs are of three kinds. The first is quality on the tasks attention is best at, precise retrieval and multi-hop reasoning over long inputs: the deficits that sent MiniMax back to full attention.</p> <p>The second is engineering. Recurrent layers need their own kernels, and serving tricks built around a cache of separate tokens get harder when part of the model keeps a state that has absorbed all of them.</p> <p>Reusing the cache of a shared prompt needs copies of the state saved at chosen positions, and rolling back a rejected speculative token needs the state from a step earlier.</p> <p>The third is that the field keeps moving. Qwen3.8-Flash-Next replaced the full attention layers of its hybrid with sparse attention<sup class="cite">[<a href="#ref-23" id="cite-28" data-ref="23" aria-label="Reference 23: Qwen Team (2026). Qwen3.8-Flash-Next model card. Hugging Face.">23</a>]</sup>, and DeepSeek-V4 combines two kinds of compressed attention instead of adding recurrent layers<sup class="cite">[<a href="#ref-24" id="cite-29" data-ref="24" aria-label="Reference 24: DeepSeek-AI (2026). DeepSeek-V4: towards highly efficient million-token context intelligence. arXiv.">24</a>]</sup>. Both directions go after the same cache.</p> <p>A hybrid’s way is to give most layers a memory of fixed size and to keep a few that can still read every token.</p> <h2 id="references">References</h2> <ol class="tfs-refs"> <li id="ref-1">Katharopoulos, A., Vyas, A., Pappas, N., &amp; Fleuret, F. (2020). <a href="https://arxiv.org/abs/2006.16236">Transformers are RNNs: fast autoregressive Transformers with linear attention</a>. <em>ICML 2020</em>. <a class="ref-back" href="#cite-1" aria-label="Back to the text">↩</a></li> <li id="ref-2">Arora, S., et al. (2024). <a href="https://arxiv.org/abs/2402.18668">Simple linear attention language models balance the recall-throughput tradeoff</a>. <em>ICML 2024</em>. <a class="ref-back" href="#cite-2" aria-label="Back to the text">↩</a></li> <li id="ref-3">Widrow, B., &amp; Hoff, M. E. (1960). <a href="https://isl.stanford.edu/~widrow/papers/c1960adaptiveswitching.pdf">Adaptive switching circuits</a>. <em>IRE WESCON Convention Record</em>, 4, 96–104. <a class="ref-back" href="#cite-3" aria-label="Back to the text">↩</a></li> <li id="ref-4">Schlag, I., Irie, K., &amp; Schmidhuber, J. (2021). <a href="https://arxiv.org/abs/2102.11174">Linear Transformers are secretly fast weight programmers</a>. <em>ICML 2021</em>. <a class="ref-back" href="#cite-4" aria-label="Back to the text">↩</a></li> <li id="ref-5">Sun, Y., et al. (2023). <a href="https://arxiv.org/abs/2307.08621">Retentive network: a successor to Transformer for large language models</a>. arXiv. <a class="ref-back" href="#cite-5" aria-label="Back to the text">↩</a></li> <li id="ref-6">Yang, S., Wang, B., Shen, Y., Panda, R., &amp; Kim, Y. (2024). <a href="https://arxiv.org/abs/2312.06635">Gated linear attention Transformers with hardware-efficient training</a>. <em>ICML 2024</em>. <a class="ref-back" href="#cite-6" aria-label="Back to the text">↩</a></li> <li id="ref-7">Dao, T., &amp; Gu, A. (2024). <a href="https://arxiv.org/abs/2405.21060">Transformers are SSMs: generalized models and efficient algorithms through structured state space duality</a>. <em>ICML 2024</em>. <a class="ref-back" href="#cite-7" aria-label="Back to the text">↩</a></li> <li id="ref-8">Yang, S., Kautz, J., &amp; Hatamizadeh, A. (2025). <a href="https://arxiv.org/abs/2412.06464">Gated delta networks: improving Mamba2 with delta rule</a>. <em>ICLR 2025</em>. <a class="ref-back" href="#cite-8" aria-label="Back to the text">↩</a></li> <li id="ref-9">Kimi Team (2025). <a href="https://arxiv.org/abs/2510.26692">Kimi Linear: an expressive, efficient attention architecture</a>. arXiv. <a class="ref-back" href="#cite-9" aria-label="Back to the text">↩</a></li> <li id="ref-10">Yang, S., Wang, B., Zhang, Y., Shen, Y., &amp; Kim, Y. (2024). <a href="https://arxiv.org/abs/2406.06484">Parallelizing linear Transformers with the delta rule over sequence length</a>. <em>NeurIPS 2024</em>. <a class="ref-back" href="#cite-10" aria-label="Back to the text">↩</a></li> <li id="ref-11">Arora, S., et al. (2023). <a href="https://arxiv.org/abs/2312.04927">Zoology: measuring and improving recall in efficient language models</a>. <em>ICLR 2024</em>. <a class="ref-back" href="#cite-11" aria-label="Back to the text">↩</a></li> <li id="ref-12">Jelassi, S., Brandfonbrener, D., Kakade, S. M., &amp; Malach, E. (2024). <a href="https://arxiv.org/abs/2402.01032">Repeat after me: Transformers are better than state space models at copying</a>. <em>ICML 2024</em>. <a class="ref-back" href="#cite-14" aria-label="Back to the text">↩</a></li> <li id="ref-13">Waleffe, R., et al. (2024). <a href="https://arxiv.org/abs/2406.07887">An empirical study of Mamba-based language models</a>. arXiv. <a class="ref-back" href="#cite-16" aria-label="Back to the text">↩</a></li> <li id="ref-14">Lieber, O., et al. (2024). <a href="https://arxiv.org/abs/2403.19887">Jamba: a hybrid Transformer-Mamba language model</a>. arXiv. <a class="ref-back" href="#cite-17" aria-label="Back to the text">↩</a></li> <li id="ref-15">MiniMax (2025). <a href="https://arxiv.org/abs/2501.08313">MiniMax-01: scaling foundation models with lightning attention</a>. arXiv. <a class="ref-back" href="#cite-18" aria-label="Back to the text">↩</a></li> <li id="ref-16">NVIDIA (2025). <a href="https://arxiv.org/abs/2504.03624">Nemotron-H: a family of accurate and efficient hybrid Mamba-Transformer models</a>. arXiv. <a class="ref-back" href="#cite-19" aria-label="Back to the text">↩</a></li> <li id="ref-17">Qwen Team (2025). <a href="https://www.alibabacloud.com/blog/602580">Qwen3-Next: towards ultimate training &amp; inference efficiency</a>. Alibaba Cloud blog. <a class="ref-back" href="#cite-20" aria-label="Back to the text">↩</a></li> <li id="ref-18">Kimi Team (2026). <a href="https://arxiv.org/abs/2607.24653">Kimi K3: open frontier intelligence</a>. arXiv. <a class="ref-back" href="#cite-22" aria-label="Back to the text">↩</a></li> <li id="ref-19">OpenAI (2025). <a href="https://arxiv.org/abs/2508.10925">gpt-oss-120b &amp; gpt-oss-20b model card</a>. arXiv. <a class="ref-back" href="#cite-23" aria-label="Back to the text">↩</a></li> <li id="ref-20">Gemma Team (2025). <a href="https://arxiv.org/abs/2503.19786">Gemma 3 technical report</a>. arXiv. <a class="ref-back" href="#cite-24" aria-label="Back to the text">↩</a></li> <li id="ref-21">MiniMax (2025). <a href="https://huggingface.co/blog/MiniMax-AI/why-did-m2-end-up-as-a-full-attention-model">Why did MiniMax M2 end up as a full attention model?</a> Hugging Face blog. <a class="ref-back" href="#cite-25" aria-label="Back to the text">↩</a></li> <li id="ref-22">DeepSeek-AI (2024). <a href="https://arxiv.org/abs/2405.04434">DeepSeek-V2: a strong, economical, and efficient mixture-of-experts language model</a>. arXiv. <a class="ref-back" href="#cite-26" aria-label="Back to the text">↩</a></li> <li id="ref-23">Qwen Team (2026). <a href="https://huggingface.co/Qwen/Qwen3.8-Flash-Next">Qwen3.8-Flash-Next model card</a>. Hugging Face. <a class="ref-back" href="#cite-28" aria-label="Back to the text">↩</a></li> <li id="ref-24">DeepSeek-AI (2026). <a href="https://arxiv.org/abs/2606.19348">DeepSeek-V4: towards highly efficient million-token context intelligence</a>. arXiv. <a class="ref-back" href="#cite-29" aria-label="Back to the text">↩</a></li> </ol>]]></content> <author> <name>Eva Koroleva</name> </author> <category term="machine-learning"/> <category term="machine-learning"/> <category term="transformers"/> <category term="attention"/> <category term="linear-attention"/> <category term="llm"/> <summary type="html"><![CDATA[Linear attention, the delta rule and Gated DeltaNet in PyTorch, a recall test, GPU timings, and why Qwen3-Next and Kimi Linear keep few attention layers]]></summary> <media:thumbnail url="https://blog.korolevalab.com/assets/posts/hybrid-attention/cover.png"/> <media:content medium="image" url="https://blog.korolevalab.com/assets/posts/hybrid-attention/cover.png"/> </entry> <entry> <title type="html">It works on my laptop: a reproducible Docker image of a model</title> <link href="https://blog.korolevalab.com/blog/2026/transformers-from-scratch-09-docker/" rel="alternate" type="text/html" title="It works on my laptop: a reproducible Docker image of a model"/> <published>2025-12-31T18:00:00+00:00</published> <updated>2026-11-02T00:00:00+00:00</updated> <id>https://blog.korolevalab.com/blog/2026/transformers-from-scratch-09-docker</id> <content type="html" xml:base="https://blog.korolevalab.com/blog/2026/transformers-from-scratch-09-docker/"><![CDATA[<p class="tfs-links"><strong>Transformers: from scratch to production</strong> · lesson 9 of 10 · <a href="/teaching/">all lessons</a> · <a href="https://www.kaggle.com/code/qmarva/transformers-from-scratch-09-reproducible-docker">run on Kaggle</a> · <a href="https://colab.research.google.com/github/xmarva/transformers-from-scratch/blob/main/notebooks/colab/09_docker.ipynb">open in Colab</a> · <a href="https://github.com/xmarva/transformers-from-scratch">code on GitHub</a></p> <p>On 16 June 2024 NumPy 2.0.0 came out, and code that nobody had touched started to fail. A model served with PyTorch 2.3.1 printed this on import, and stopped <sup class="cite">[<a href="#ref-1" id="cite-1" data-ref="1" aria-label="Reference 1: NumPy 2.0.0 release notes, and the error in practice: PyTorch issue #129310.">1</a>]</sup>:</p> <div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>A module that was compiled using NumPy 1.x cannot be run in
NumPy 2.0.0 as it may crash. To support both 1.x and 2.x
versions of NumPy, modules must be compiled with NumPy 2.0.
Some module may need to rebuild instead e.g. with 'pybind11&gt;=2.12'.
</code></pre></div></div> <p>Nothing in those projects had changed. Their requirements said <code class="language-plaintext highlighter-rouge">numpy</code>, or <code class="language-plaintext highlighter-rouge">numpy&gt;=1.24</code>, and on that Sunday the newest NumPy that matched became a different program.</p> <p>NumPy had warned about it in its release notes: packages “built against a NumPy 1.xx release will not work with NumPy 2.0” <sup class="cite">[<a href="#ref-1" id="cite-2" data-ref="1" aria-label="Reference 1: NumPy 2.0.0 release notes, and the error in practice: PyTorch issue #129310.">1</a>]</sup>. PyTorch caught up five weeks later, in 2.4.0. Everyone who reinstalled in between learned what their model was really made of.</p> <p>It is made of more than weights. When perevod translates a sentence, its 38 MB of weights are one part of what runs: around them are the package’s code, three dozen Python packages, Python itself, the system libraries that Python and PyTorch load, and a processor.</p> <p>Change any of them, and you have a different program, which may or may not give the same translations, or start at all.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/tfs/09/hero-light.png" width="760" alt="What runs when perevod translates, as a stack: the weights, perevod's code, the Python packages, Python and Debian's libraries, the build itself, and the processor. Next to each, what pins it in perevod 0.3.1: the model's commit, a git tag, a lock file with hashes, a base image pinned by digest, a pinned builder and a fixed time; the processor is the one part no image can pin" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/tfs/09/hero-dark.png" width="760" alt="What runs when perevod translates, as a stack: the weights, perevod's code, the Python packages, Python and Debian's libraries, the build itself, and the processor. Next to each, what pins it in perevod 0.3.1: the model's commit, a git tag, a lock file with hashes, a base image pinned by digest, a pinned builder and a fixed time; the processor is the one part no image can pin" loading="lazy"></p> <p>This lesson pins every layer of that stack except the last, and puts the result in one Docker image that gives the same bytes each time it’s built, so that anyone can check it was built from the code they can read.</p> <p>Then it takes the image apart without Docker, runs the model from it, and finally ships the same model a second way: to the browser, where a free page translates on the visitor’s own device.</p> <p><strong>What you’ll do</strong></p> <ol> <li>Watch the same requirements turn into three different programs on three different days.</li> <li>Freeze them in a lock file with hashes, and see pip refuse a file that doesn’t match.</li> <li>Take a container image apart by hand: a registry, manifests, layers and digests.</li> <li>Find out why two builds of one Dockerfile differ, and remove each cause.</li> <li>Write perevod’s Dockerfile, and a GitHub Actions job that builds the image twice and publishes it.</li> <li>Pull the published image without Docker, run the model from it, and check its weights.</li> <li>Export the model to ONNX and run it in a browser, on a free Hugging Face Space.</li> </ol> <p><strong>What you need</strong>: a CPU, as in lessons 7 and 8. Not Docker: Kaggle and Colab don’t have it, so the notebook does by hand what Docker does, which turns out to be the best way to see what an image is.</p> <p>It downloads the published image (about 365 MB) and runs in a few minutes. On your own machine with Docker, the lesson also shows the commands that build and run the image.</p> <h2 id="setup">Setup</h2> <p>One small helper package, <code class="language-plaintext highlighter-rouge">tfs</code>, draws the course’s plots and token chips and knows where the notebook runs (Kaggle, Colab or your own machine). Everything the lesson teaches is written out in the notebook itself.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">importlib.util</span>
<span class="kn">import</span> <span class="n">subprocess</span>
<span class="kn">import</span> <span class="n">sys</span>

<span class="n">TFS</span> <span class="o">=</span> <span class="sh">"</span><span class="s">git+https://github.com/xmarva/transformers-from-scratch@main</span><span class="sh">"</span>
<span class="k">if</span> <span class="n">importlib</span><span class="p">.</span><span class="n">util</span><span class="p">.</span><span class="nf">find_spec</span><span class="p">(</span><span class="sh">"</span><span class="s">tfs</span><span class="sh">"</span><span class="p">)</span> <span class="ow">is</span> <span class="bp">None</span><span class="p">:</span>
    <span class="n">subprocess</span><span class="p">.</span><span class="nf">check_call</span><span class="p">([</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">-m</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">pip</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">install</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-q</span><span class="sh">"</span><span class="p">,</span> <span class="n">TFS</span><span class="p">])</span>

<span class="kn">from</span> <span class="n">tfs</span> <span class="kn">import</span> <span class="n">env</span>
<span class="kn">from</span> <span class="n">tfs.viz</span> <span class="kn">import</span> <span class="n">table</span><span class="p">,</span> <span class="n">token_chips</span><span class="p">,</span> <span class="n">use_course_style</span>

<span class="n">env</span><span class="p">.</span><span class="nf">quiet</span><span class="p">()</span>  <span class="c1"># no progress bars or environment warnings in the outputs
</span><span class="n">SEED</span> <span class="o">=</span> <span class="mi">42</span>
<span class="n">env</span><span class="p">.</span><span class="nf">seed_everything</span><span class="p">(</span><span class="n">SEED</span><span class="p">)</span>
<span class="n">COLORS</span> <span class="o">=</span> <span class="nf">use_course_style</span><span class="p">()</span>
<span class="n">WORK_DIR</span> <span class="o">=</span> <span class="n">env</span><span class="p">.</span><span class="nf">work_dir</span><span class="p">()</span>
</code></pre></div></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">gzip</span>
<span class="kn">import</span> <span class="n">hashlib</span>
<span class="kn">import</span> <span class="n">io</span>
<span class="kn">import</span> <span class="n">json</span>
<span class="kn">import</span> <span class="n">math</span>
<span class="kn">import</span> <span class="n">os</span>
<span class="kn">import</span> <span class="n">py_compile</span>
<span class="kn">import</span> <span class="n">shutil</span>
<span class="kn">import</span> <span class="n">tarfile</span>
<span class="kn">import</span> <span class="n">time</span>
<span class="kn">from</span> <span class="n">pathlib</span> <span class="kn">import</span> <span class="n">Path</span>

<span class="kn">import</span> <span class="n">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="n">pandas</span> <span class="k">as</span> <span class="n">pd</span>
<span class="kn">import</span> <span class="n">requests</span>
<span class="kn">import</span> <span class="n">torch</span>
<span class="kn">from</span> <span class="n">huggingface_hub</span> <span class="kn">import</span> <span class="n">hf_hub_download</span>

<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">Python</span><span class="sh">"</span><span class="p">,</span> <span class="n">sys</span><span class="p">.</span><span class="n">version</span><span class="p">.</span><span class="nf">split</span><span class="p">()[</span><span class="mi">0</span><span class="p">],</span> <span class="sh">"</span><span class="s">on</span><span class="sh">"</span><span class="p">,</span> <span class="n">os</span><span class="p">.</span><span class="nf">uname</span><span class="p">().</span><span class="n">machine</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>Python 3.13.15 on x86_64</code></pre> <h2 id="1-one-requirements-list-three-programs">1. One requirements list, three programs</h2> <p>Start from perevod as <a href="/blog/2026/transformers-from-scratch-08-serving/">lesson 8</a> released it, version 0.2.0: the release’s tag, and only the <code class="language-plaintext highlighter-rouge">perevod/</code> folder of the course repository.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">REPO</span> <span class="o">=</span> <span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">course</span><span class="sh">"</span>
<span class="n">shutil</span><span class="p">.</span><span class="nf">rmtree</span><span class="p">(</span><span class="n">REPO</span><span class="p">,</span> <span class="n">ignore_errors</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">URL</span> <span class="o">=</span> <span class="sh">"</span><span class="s">https://github.com/xmarva/transformers-from-scratch</span><span class="sh">"</span>
<span class="n">QUIET</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">-c</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">advice.detachedHead=false</span><span class="sh">"</span><span class="p">]</span>
<span class="n">subprocess</span><span class="p">.</span><span class="nf">run</span><span class="p">([</span><span class="sh">"</span><span class="s">git</span><span class="sh">"</span><span class="p">,</span> <span class="o">*</span><span class="n">QUIET</span><span class="p">,</span> <span class="sh">"</span><span class="s">clone</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-q</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">--depth</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">1</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">--branch</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">perevod-v0.2.0</span><span class="sh">"</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">--filter=blob:none</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">--sparse</span><span class="sh">"</span><span class="p">,</span> <span class="n">URL</span><span class="p">,</span> <span class="nf">str</span><span class="p">(</span><span class="n">REPO</span><span class="p">)],</span> <span class="n">check</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">subprocess</span><span class="p">.</span><span class="nf">run</span><span class="p">([</span><span class="sh">"</span><span class="s">git</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">sparse-checkout</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">set</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">perevod</span><span class="sh">"</span><span class="p">],</span> <span class="n">cwd</span><span class="o">=</span><span class="n">REPO</span><span class="p">,</span> <span class="n">check</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">os</span><span class="p">.</span><span class="nf">chdir</span><span class="p">(</span><span class="n">REPO</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">write</span><span class="p">(</span><span class="n">path</span><span class="p">,</span> <span class="n">text</span><span class="p">):</span>
    <span class="nc">Path</span><span class="p">(</span><span class="n">path</span><span class="p">).</span><span class="n">parent</span><span class="p">.</span><span class="nf">mkdir</span><span class="p">(</span><span class="n">parents</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">exist_ok</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="nc">Path</span><span class="p">(</span><span class="n">path</span><span class="p">).</span><span class="nf">write_text</span><span class="p">(</span><span class="n">text</span><span class="p">.</span><span class="nf">lstrip</span><span class="p">(</span><span class="sh">"</span><span class="se">\n</span><span class="sh">"</span><span class="p">),</span> <span class="n">encoding</span><span class="o">=</span><span class="sh">"</span><span class="s">utf-8</span><span class="sh">"</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">replace</span><span class="p">(</span><span class="n">path</span><span class="p">,</span> <span class="n">old</span><span class="p">,</span> <span class="n">new</span><span class="p">):</span>
    <span class="n">text</span> <span class="o">=</span> <span class="nc">Path</span><span class="p">(</span><span class="n">path</span><span class="p">).</span><span class="nf">read_text</span><span class="p">(</span><span class="n">encoding</span><span class="o">=</span><span class="sh">"</span><span class="s">utf-8</span><span class="sh">"</span><span class="p">)</span>
    <span class="k">assert</span> <span class="n">text</span><span class="p">.</span><span class="nf">count</span><span class="p">(</span><span class="n">old</span><span class="p">)</span> <span class="o">==</span> <span class="mi">1</span><span class="p">,</span> <span class="n">old</span>
    <span class="nc">Path</span><span class="p">(</span><span class="n">path</span><span class="p">).</span><span class="nf">write_text</span><span class="p">(</span><span class="n">text</span><span class="p">.</span><span class="nf">replace</span><span class="p">(</span><span class="n">old</span><span class="p">,</span> <span class="n">new</span><span class="p">),</span> <span class="n">encoding</span><span class="o">=</span><span class="sh">"</span><span class="s">utf-8</span><span class="sh">"</span><span class="p">)</span>


<span class="nf">print</span><span class="p">(</span><span class="nc">Path</span><span class="p">(</span><span class="sh">"</span><span class="s">perevod/pyproject.toml</span><span class="sh">"</span><span class="p">).</span><span class="nf">read_text</span><span class="p">().</span><span class="nf">split</span><span class="p">(</span><span class="sh">"</span><span class="s">[project.scripts]</span><span class="sh">"</span><span class="p">)[</span><span class="mi">0</span><span class="p">])</span>
</code></pre></div></div> <pre class="tfs-printed"><code>[project]
name = "perevod"
dynamic = ["version"]  # read from src/perevod/__init__.py, see [tool.hatch.version]
description = "English-to-Russian translation with a small Transformer built from scratch"
readme = "README.md"
license = "MIT"
requires-python = "&gt;=3.10"
dependencies = [
    "torch&gt;=2.1",
    "tokenizers&gt;=0.15",
    "huggingface_hub&gt;=0.20",
    "safetensors&gt;=0.4",
]

[project.optional-dependencies]
serve = ["fastapi&gt;=0.110", "uvicorn&gt;=0.29"]
demo = ["fastapi&gt;=0.110", "uvicorn&gt;=0.29", "gradio&gt;=4.40"]
test = ["pytest&gt;=8", "ruff&gt;=0.6", "sacrebleu&gt;=2.4", "pandas&gt;=2.0", "pyarrow&gt;=14",
        "fastapi&gt;=0.110", "httpx&gt;=0.27"]</code></pre> <p>Its dependencies are ranges: <code class="language-plaintext highlighter-rouge">torch&gt;=2.1</code> means “any PyTorch from 2.1 on”. That’s right for a package other people install. perevod has to live next to whatever else they have, and the Python Packaging User Guide calls pinning exact versions there “overly-restrictive” <sup class="cite">[<a href="#ref-2" id="cite-3" data-ref="2" aria-label="Reference 2: Python Packaging User Guide: installrequires vs requirements files.">2</a>]</sup>. But a range is a question, and pip answers it on the day you install.</p> <p>You can ask it on other days. <a href="https://docs.astral.sh/uv/">uv</a>, a fast replacement for pip written in Rust, can resolve requirements as if it were an earlier date: <code class="language-plaintext highlighter-rouge">--exclude-newer</code> makes it ignore every file uploaded after it.</p> <p>Here is what perevod’s requirements, with the server extra, resolved to a year before this lesson, half a year before, and on the day perevod’s lock file was made:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="err">!</span><span class="p">{</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">}</span> <span class="o">-</span><span class="n">m</span> <span class="n">pip</span> <span class="n">install</span> <span class="o">-</span><span class="n">q</span> <span class="n">uv</span><span class="o">==</span><span class="mf">0.12</span><span class="p">.</span><span class="mi">24</span>
<span class="n">UV</span> <span class="o">=</span> <span class="p">[</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">-m</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">uv</span><span class="sh">"</span><span class="p">]</span>


<span class="k">def</span> <span class="nf">resolve</span><span class="p">(</span><span class="n">day</span><span class="p">):</span>
    <span class="n">command</span> <span class="o">=</span> <span class="p">[</span><span class="o">*</span><span class="n">UV</span><span class="p">,</span> <span class="sh">"</span><span class="s">pip</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">compile</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">perevod/pyproject.toml</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">--extra</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">serve</span><span class="sh">"</span><span class="p">,</span>
               <span class="sh">"</span><span class="s">--python-version</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">3.12</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">--python-platform</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">x86_64-manylinux_2_28</span><span class="sh">"</span><span class="p">,</span>
               <span class="sh">"</span><span class="s">--torch-backend</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">--exclude-newer</span><span class="sh">"</span><span class="p">,</span> <span class="n">day</span><span class="p">,</span>
               <span class="sh">"</span><span class="s">--no-header</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">--no-annotate</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">--quiet</span><span class="sh">"</span><span class="p">]</span>
    <span class="n">result</span> <span class="o">=</span> <span class="n">subprocess</span><span class="p">.</span><span class="nf">run</span><span class="p">(</span><span class="n">command</span><span class="p">,</span> <span class="n">capture_output</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">text</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">check</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">versions</span> <span class="o">=</span> <span class="p">{}</span>
    <span class="k">for</span> <span class="n">line</span> <span class="ow">in</span> <span class="n">result</span><span class="p">.</span><span class="n">stdout</span><span class="p">.</span><span class="nf">splitlines</span><span class="p">():</span>
        <span class="n">name</span><span class="p">,</span> <span class="n">version</span> <span class="o">=</span> <span class="n">line</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="sh">"</span><span class="s">==</span><span class="sh">"</span><span class="p">)</span>
        <span class="n">versions</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="o">=</span> <span class="n">version</span>
    <span class="k">return</span> <span class="n">versions</span>


<span class="n">DAYS</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">2025-10-27T00:00:00Z</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2026-04-27T00:00:00Z</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">2026-10-27T00:00:00Z</span><span class="sh">"</span><span class="p">]</span>
<span class="n">resolved</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">day</span> <span class="ow">in</span> <span class="n">DAYS</span><span class="p">:</span>
    <span class="n">resolved</span><span class="p">[</span><span class="n">day</span><span class="p">[:</span><span class="mi">10</span><span class="p">]]</span> <span class="o">=</span> <span class="nf">resolve</span><span class="p">(</span><span class="n">day</span><span class="p">)</span>

<span class="n">DIRECT</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">torch</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">tokenizers</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">huggingface-hub</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">safetensors</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">fastapi</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">uvicorn</span><span class="sh">"</span><span class="p">]</span>
<span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">DIRECT</span><span class="p">:</span>
    <span class="n">row</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">package</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">}</span>
    <span class="k">for</span> <span class="n">day</span><span class="p">,</span> <span class="n">versions</span> <span class="ow">in</span> <span class="n">resolved</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
        <span class="n">row</span><span class="p">[</span><span class="n">day</span><span class="p">]</span> <span class="o">=</span> <span class="n">versions</span><span class="p">[</span><span class="n">name</span><span class="p">]</span>
    <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">row</span><span class="p">)</span>
<span class="nf">display</span><span class="p">(</span><span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">)))</span>

<span class="n">first</span><span class="p">,</span> <span class="n">last</span> <span class="o">=</span> <span class="n">resolved</span><span class="p">[</span><span class="sh">"</span><span class="s">2025-10-27</span><span class="sh">"</span><span class="p">],</span> <span class="n">resolved</span><span class="p">[</span><span class="sh">"</span><span class="s">2026-10-27</span><span class="sh">"</span><span class="p">]</span>
<span class="n">changed</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">first</span><span class="p">:</span>
    <span class="k">if</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">last</span> <span class="ow">and</span> <span class="n">first</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="o">!=</span> <span class="n">last</span><span class="p">[</span><span class="n">name</span><span class="p">]:</span>
        <span class="n">changed</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">name</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">first</span><span class="p">),</span> <span class="sh">"</span><span class="s">packages a year ago,</span><span class="sh">"</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">last</span><span class="p">),</span> <span class="sh">"</span><span class="s">on the release day</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">changed</span><span class="p">),</span> <span class="sh">"</span><span class="s">packages installed on both days, at different versions</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">gone:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">sorted</span><span class="p">(</span><span class="nf">set</span><span class="p">(</span><span class="n">first</span><span class="p">)</span> <span class="o">-</span> <span class="nf">set</span><span class="p">(</span><span class="n">last</span><span class="p">)))</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">new: </span><span class="sh">"</span><span class="p">,</span> <span class="nf">sorted</span><span class="p">(</span><span class="nf">set</span><span class="p">(</span><span class="n">last</span><span class="p">)</span> <span class="o">-</span> <span class="nf">set</span><span class="p">(</span><span class="n">first</span><span class="p">)))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">package</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">2025-10-27</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">2026-04-27</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">2026-10-27</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">torch</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2.9.0+cpu</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2.10.0+cpu</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2.14.1+cpu</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">tokenizers</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.22.1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.22.2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.23.3</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">huggingface-hub</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.36.0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">1.12.0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">2.3.0</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">safetensors</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.6.2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.7.0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.8.0</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">fastapi</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.120.0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.136.1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.162.0</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">uvicorn</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.38.0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.46.0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">0.54.0</td></tr></tbody></table></div> <pre class="tfs-printed"><code>34 packages a year ago, 33 on the release day
24 packages installed on both days, at different versions
gone: ['certifi', 'charset-normalizer', 'requests', 'sniffio', 'urllib3']
new:  ['httpcore2', 'httpx2', 'opentelemetry-api', 'truststore']</code></pre> <p class="takeaway">Same <code class="language-plaintext highlighter-rouge">pyproject.toml</code>, three programs: of the packages installed both a year ago and on the release day, 24 are at different versions.</p> <p>PyTorch moves by several releases, and each of them changes kernels, defaults and warnings. huggingface-hub, which downloads the model, jumps two major versions.</p> <p>And these are only the packages perevod names: behind them, nearly every package it pulls in changed version too, and some were replaced outright, an HTTP library by another. None of this is a bug. It’s what a range asks for.</p> <p>For a library, that’s the deal. For a service, it’s a gamble: the server you test today and the one that restarts next month install different code. Donald Stufft, who maintained pip and PyPI for years, drew the line in 2013<sup class="cite">[<a href="#ref-3" id="cite-4" data-ref="3" aria-label="Reference 3: Stufft, D. (2013). setup.py vs requirements.txt. Abstract and concrete dependencies.">3</a>]</sup>:</p> <blockquote class="pull"> <p>While a library tends to want to have wide open ended version specifiers an application wants very specific dependencies.</p> <p><cite>Donald Stufft</cite></p> </blockquote> <p>perevod is both. It keeps the ranges in <code class="language-plaintext highlighter-rouge">pyproject.toml</code> for people who install it as a library, and the service is deployed from a second file that pins every package: a <strong>lock file</strong>.</p> <h2 id="2-a-lock-file-with-hashes">2. A lock file, with hashes</h2> <p>First, a change that the image revealed. On a laptop, some other package has always installed NumPy; in an image that holds only what perevod asks for, it’s missing, and PyTorch, which tries to import NumPy when it loads, prints <code class="language-plaintext highlighter-rouge">Failed to initialize NumPy: No module named 'numpy'</code>. perevod never calls NumPy, so nothing breaks, but a server that starts with a warning trains people to ignore warnings. perevod now asks for it:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nf">replace</span><span class="p">(</span><span class="sh">"</span><span class="s">perevod/pyproject.toml</span><span class="sh">"</span><span class="p">,</span> <span class="sh">'</span><span class="s">    </span><span class="sh">"</span><span class="s">safetensors&gt;=0.4</span><span class="sh">"</span><span class="s">,</span><span class="se">\n</span><span class="sh">'</span><span class="p">,</span>
        <span class="sh">'</span><span class="s">    </span><span class="sh">"</span><span class="s">safetensors&gt;=0.4</span><span class="sh">"</span><span class="s">,</span><span class="se">\n</span><span class="sh">'</span>
        <span class="sh">'</span><span class="s">    </span><span class="sh">"</span><span class="s">numpy&gt;=1.24</span><span class="sh">"</span><span class="s">,  # perevod doesn</span><span class="se">\'</span><span class="s">t use it, </span><span class="sh">'</span>
        <span class="sh">'</span><span class="s">but PyTorch warns on import without it</span><span class="se">\n</span><span class="sh">'</span><span class="p">)</span>
</code></pre></div></div> <p>Now the lock. <code class="language-plaintext highlighter-rouge">uv pip compile</code> resolves the requirements once and writes the answer down, one exact version per package. Three options matter here:</p> <ul> <li><code class="language-plaintext highlighter-rouge">--universal</code>: one file for every platform. Where the answer differs, a line carries a marker, such as <code class="language-plaintext highlighter-rouge">; sys_platform == 'win32'</code>, and pip skips the lines that don’t apply.</li> <li><code class="language-plaintext highlighter-rouge">--torch-backend cpu</code>: PyTorch’s CPU-only build from PyTorch’s own index. The default Linux wheel on PyPI is built with CUDA and pulls in NVIDIA’s libraries: for torch 2.14.1 that’s about 3 GB of downloads, against 196 MB for the CPU build. A translation server without a GPU needs none of it.</li> <li><code class="language-plaintext highlighter-rouge">--generate-hashes</code>: next to each version, the sha256 of every file that version may be installed from.</li> </ul> <p>And one more for this lesson: <code class="language-plaintext highlighter-rouge">--exclude-newer</code> with the day perevod 0.3’s lock was made, so that the notebook resolves the same answer even if you run it a year from now.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">LOCKED_ON</span> <span class="o">=</span> <span class="sh">"</span><span class="s">2026-10-27T12:00:00Z</span><span class="sh">"</span>  <span class="c1"># the day perevod 0.3's lock was made
</span><span class="n">COMPILE</span> <span class="o">=</span> <span class="p">[</span><span class="o">*</span><span class="n">UV</span><span class="p">,</span> <span class="sh">"</span><span class="s">pip</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">compile</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">--universal</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">--python-version</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">3.12</span><span class="sh">"</span><span class="p">,</span>
           <span class="sh">"</span><span class="s">--generate-hashes</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">--exclude-newer</span><span class="sh">"</span><span class="p">,</span> <span class="n">LOCKED_ON</span><span class="p">,</span> <span class="sh">"</span><span class="s">--quiet</span><span class="sh">"</span><span class="p">]</span>
<span class="n">subprocess</span><span class="p">.</span><span class="nf">run</span><span class="p">([</span><span class="o">*</span><span class="n">COMPILE</span><span class="p">,</span> <span class="sh">"</span><span class="s">pyproject.toml</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">--extra</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">serve</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">--torch-backend</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">-o</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">requirements.lock</span><span class="sh">"</span><span class="p">],</span> <span class="n">cwd</span><span class="o">=</span><span class="sh">"</span><span class="s">perevod</span><span class="sh">"</span><span class="p">,</span> <span class="n">check</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>

<span class="n">lock</span> <span class="o">=</span> <span class="nc">Path</span><span class="p">(</span><span class="sh">"</span><span class="s">perevod/requirements.lock</span><span class="sh">"</span><span class="p">).</span><span class="nf">read_text</span><span class="p">()</span>
<span class="n">pins</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">line</span> <span class="ow">in</span> <span class="n">lock</span><span class="p">.</span><span class="nf">splitlines</span><span class="p">():</span>
    <span class="k">if</span> <span class="sh">"</span><span class="s">==</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">line</span> <span class="ow">and</span> <span class="ow">not</span> <span class="n">line</span><span class="p">.</span><span class="nf">startswith</span><span class="p">((</span><span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">#</span><span class="sh">"</span><span class="p">)):</span>
        <span class="n">pins</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">line</span><span class="p">.</span><span class="nf">rstrip</span><span class="p">(</span><span class="sh">"</span><span class="s"> </span><span class="se">\\</span><span class="sh">"</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">pins</span><span class="p">),</span> <span class="sh">"</span><span class="s">pinned lines,</span><span class="sh">"</span><span class="p">,</span> <span class="n">lock</span><span class="p">.</span><span class="nf">count</span><span class="p">(</span><span class="sh">"</span><span class="s">--hash=sha256:</span><span class="sh">"</span><span class="p">),</span> <span class="sh">"</span><span class="s">hashes</span><span class="sh">"</span><span class="p">)</span>
<span class="k">for</span> <span class="n">pin</span> <span class="ow">in</span> <span class="n">pins</span><span class="p">:</span>
    <span class="k">if</span> <span class="n">pin</span><span class="p">.</span><span class="nf">startswith</span><span class="p">((</span><span class="sh">"</span><span class="s">torch==</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">numpy==</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">huggingface-hub==</span><span class="sh">"</span><span class="p">)):</span>
        <span class="nf">print</span><span class="p">(</span><span class="n">pin</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>37 pinned lines, 582 hashes
huggingface-hub==2.3.0
numpy==2.5.4
torch==2.14.1 ; sys_platform == 'darwin'
torch==2.14.1+cpu ; sys_platform != 'darwin'</code></pre> <p>PyTorch gets two lines. On macOS, PyPI’s wheel is already CPU-only and the PyTorch index has no <code class="language-plaintext highlighter-rouge">+cpu</code> build, so the lock takes the plain one there and the <code class="language-plaintext highlighter-rouge">+cpu</code> build everywhere else.</p> <p>The hashes are what make the lock more than a list of versions. A version is a name: whoever controls the index, a mirror, or a proxy between you and it, decides which bytes stand behind it.</p> <p>A hash is the bytes themselves. With a hash on every line, pip switches to hash-checking mode, in which “Hashes are required for <em>all</em> requirements” and every downloaded file must match one of them <sup class="cite">[<a href="#ref-4" id="cite-5" data-ref="4" aria-label="Reference 4: pip: secure installs and hash-checking mode; uv: uv pip compile and using uv with PyTorch.">4</a>]</sup>.</p> <p>Try it on one small package from the lock, h11, an HTTP/1.1 library the server uses. First as locked:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">lines</span> <span class="o">=</span> <span class="n">lock</span><span class="p">.</span><span class="nf">splitlines</span><span class="p">()</span>
<span class="n">start</span> <span class="o">=</span> <span class="mi">0</span>
<span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">line</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">lines</span><span class="p">):</span>
    <span class="k">if</span> <span class="n">line</span><span class="p">.</span><span class="nf">startswith</span><span class="p">(</span><span class="sh">"</span><span class="s">h11==</span><span class="sh">"</span><span class="p">):</span>
        <span class="n">start</span> <span class="o">=</span> <span class="n">k</span>
<span class="n">entry</span> <span class="o">=</span> <span class="p">[</span><span class="n">lines</span><span class="p">[</span><span class="n">start</span><span class="p">]]</span>
<span class="k">for</span> <span class="n">line</span> <span class="ow">in</span> <span class="n">lines</span><span class="p">[</span><span class="n">start</span> <span class="o">+</span> <span class="mi">1</span><span class="p">:]:</span>
    <span class="k">if</span> <span class="ow">not</span> <span class="n">line</span><span class="p">.</span><span class="nf">startswith</span><span class="p">(</span><span class="sh">"</span><span class="s">    --hash</span><span class="sh">"</span><span class="p">):</span>
        <span class="k">break</span>
    <span class="n">entry</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">line</span><span class="p">)</span>
<span class="n">good</span> <span class="o">=</span> <span class="sh">"</span><span class="se">\n</span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">entry</span><span class="p">).</span><span class="nf">rstrip</span><span class="p">(</span><span class="sh">"</span><span class="s"> </span><span class="se">\\</span><span class="sh">"</span><span class="p">)</span> <span class="o">+</span> <span class="sh">"</span><span class="se">\n</span><span class="sh">"</span>
<span class="nf">print</span><span class="p">(</span><span class="n">good</span><span class="p">)</span>

<span class="n">PIP_DOWNLOAD</span> <span class="o">=</span> <span class="p">[</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">-m</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">pip</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">download</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">--no-deps</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">--require-hashes</span><span class="sh">"</span><span class="p">,</span>
                <span class="sh">"</span><span class="s">--no-color</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">--disable-pip-version-check</span><span class="sh">"</span><span class="p">]</span>
<span class="n">shutil</span><span class="p">.</span><span class="nf">rmtree</span><span class="p">(</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">downloads</span><span class="sh">"</span><span class="p">,</span> <span class="n">ignore_errors</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="nc">Path</span><span class="p">(</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">good.txt</span><span class="sh">"</span><span class="p">).</span><span class="nf">write_text</span><span class="p">(</span><span class="n">good</span><span class="p">)</span>
<span class="n">subprocess</span><span class="p">.</span><span class="nf">run</span><span class="p">([</span><span class="o">*</span><span class="n">PIP_DOWNLOAD</span><span class="p">,</span> <span class="sh">"</span><span class="s">-q</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-d</span><span class="sh">"</span><span class="p">,</span> <span class="nf">str</span><span class="p">(</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">downloads</span><span class="sh">"</span><span class="p">),</span>
                <span class="sh">"</span><span class="s">-r</span><span class="sh">"</span><span class="p">,</span> <span class="nf">str</span><span class="p">(</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">good.txt</span><span class="sh">"</span><span class="p">)],</span> <span class="n">check</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="k">for</span> <span class="n">path</span> <span class="ow">in</span> <span class="nf">sorted</span><span class="p">((</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">downloads</span><span class="sh">"</span><span class="p">).</span><span class="nf">glob</span><span class="p">(</span><span class="sh">"</span><span class="s">h11-*</span><span class="sh">"</span><span class="p">)):</span>
    <span class="nf">print</span><span class="p">(</span><span class="n">path</span><span class="p">.</span><span class="n">name</span><span class="p">,</span> <span class="sh">"</span><span class="s">sha256:</span><span class="sh">"</span> <span class="o">+</span> <span class="n">hashlib</span><span class="p">.</span><span class="nf">sha256</span><span class="p">(</span><span class="n">path</span><span class="p">.</span><span class="nf">read_bytes</span><span class="p">()).</span><span class="nf">hexdigest</span><span class="p">())</span>
</code></pre></div></div> <pre class="tfs-printed"><code>h11==0.16.0 \
    --hash=sha256:4e35b956cf45792e4caa5885e69fba00bdbc6ffafbfa020300e549b208ee5ff1 \
    --hash=sha256:63cf8bbe7522de3bf65932fda1d9c2772064ffb3dae62d55932da54b31cb6c86

h11-0.16.0-py3-none-any.whl sha256:63cf8bbe7522de3bf65932fda1d9c2772064ffb3dae62d55932da54b31cb6c86</code></pre> <p>The file pip downloaded has one of the locked hashes. Now change the last hex digit of each hash, which is what pip would see if someone swapped the file behind the version:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">bad_lines</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">line</span> <span class="ow">in</span> <span class="n">good</span><span class="p">.</span><span class="nf">splitlines</span><span class="p">():</span>
    <span class="k">if</span> <span class="sh">"</span><span class="s">--hash=sha256:</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">line</span><span class="p">:</span>
        <span class="n">digest</span> <span class="o">=</span> <span class="n">line</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="sh">"</span><span class="s">sha256:</span><span class="sh">"</span><span class="p">)[</span><span class="mi">1</span><span class="p">][:</span><span class="mi">64</span><span class="p">]</span>
        <span class="n">last</span> <span class="o">=</span> <span class="sh">"</span><span class="s">1</span><span class="sh">"</span> <span class="k">if</span> <span class="n">digest</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span> <span class="o">==</span> <span class="sh">"</span><span class="s">0</span><span class="sh">"</span> <span class="k">else</span> <span class="sh">"</span><span class="s">0</span><span class="sh">"</span>
        <span class="n">line</span> <span class="o">=</span> <span class="n">line</span><span class="p">.</span><span class="nf">replace</span><span class="p">(</span><span class="n">digest</span><span class="p">,</span> <span class="n">digest</span><span class="p">[:</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span> <span class="o">+</span> <span class="n">last</span><span class="p">)</span>
    <span class="n">bad_lines</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">line</span><span class="p">)</span>
<span class="nc">Path</span><span class="p">(</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">bad.txt</span><span class="sh">"</span><span class="p">).</span><span class="nf">write_text</span><span class="p">(</span><span class="sh">"</span><span class="se">\n</span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">bad_lines</span><span class="p">)</span> <span class="o">+</span> <span class="sh">"</span><span class="se">\n</span><span class="sh">"</span><span class="p">)</span>
<span class="n">shutil</span><span class="p">.</span><span class="nf">rmtree</span><span class="p">(</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">tampered</span><span class="sh">"</span><span class="p">,</span> <span class="n">ignore_errors</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">result</span> <span class="o">=</span> <span class="n">subprocess</span><span class="p">.</span><span class="nf">run</span><span class="p">([</span><span class="o">*</span><span class="n">PIP_DOWNLOAD</span><span class="p">,</span> <span class="sh">"</span><span class="s">-d</span><span class="sh">"</span><span class="p">,</span> <span class="nf">str</span><span class="p">(</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">tampered</span><span class="sh">"</span><span class="p">),</span>
                         <span class="sh">"</span><span class="s">-r</span><span class="sh">"</span><span class="p">,</span> <span class="nf">str</span><span class="p">(</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">bad.txt</span><span class="sh">"</span><span class="p">)],</span> <span class="n">capture_output</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">text</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">pip exit code:</span><span class="sh">"</span><span class="p">,</span> <span class="n">result</span><span class="p">.</span><span class="n">returncode</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="n">result</span><span class="p">.</span><span class="n">stderr</span><span class="p">.</span><span class="nf">strip</span><span class="p">().</span><span class="nf">replace</span><span class="p">(</span><span class="nf">str</span><span class="p">(</span><span class="n">WORK_DIR</span><span class="p">)</span> <span class="o">+</span> <span class="sh">"</span><span class="s">/</span><span class="sh">"</span><span class="p">,</span> <span class="sh">""</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">files downloaded:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">list</span><span class="p">((</span><span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">tampered</span><span class="sh">"</span><span class="p">).</span><span class="nf">glob</span><span class="p">(</span><span class="sh">"</span><span class="s">*</span><span class="sh">"</span><span class="p">)))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>pip exit code: 1
ERROR: THESE PACKAGES DO NOT MATCH THE HASHES FROM THE REQUIREMENTS FILE. If you have updated the package versions, please update the hashes. Otherwise, examine the package contents carefully; someone may have tampered with them.
    h11==0.16.0 from https://files.pythonhosted.org/packages/04/4b/29cac41a4d98d144bf5f6d33995617b185d14b22401f75ca86f384e87ff1/h11-0.16.0-py3-none-any.whl (from -r bad.txt (line 1)):
        Expected sha256 4e35b956cf45792e4caa5885e69fba00bdbc6ffafbfa020300e549b208ee5ff0
        Expected     or 63cf8bbe7522de3bf65932fda1d9c2772064ffb3dae62d55932da54b31cb6c80
             Got        63cf8bbe7522de3bf65932fda1d9c2772064ffb3dae62d55932da54b31cb6c86
files downloaded: []</code></pre> <p>pip refuses, names the package, and shows the hashes the lock expects next to the one it got. Nothing is kept, let alone installed. The lock now pins the bytes of every file, not just a version number.</p> <p>One more program runs during the install, and nobody asked for it by name: the <strong>build backend</strong>. To install perevod from source, pip first builds a wheel with hatchling, the backend <code class="language-plaintext highlighter-rouge">pyproject.toml</code> names, and by default it builds in a fresh environment with whatever hatchling is newest that day.</p> <p>A newer hatchling writes slightly different metadata into the wheel, so it gets a lock of its own, and the Dockerfile will build without that fresh environment:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nf">write</span><span class="p">(</span><span class="sh">"</span><span class="s">perevod/build.in</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">hatchling</span><span class="se">\n</span><span class="sh">"</span><span class="p">)</span>
<span class="n">subprocess</span><span class="p">.</span><span class="nf">run</span><span class="p">([</span><span class="o">*</span><span class="n">COMPILE</span><span class="p">,</span> <span class="sh">"</span><span class="s">build.in</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-o</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">build.lock</span><span class="sh">"</span><span class="p">],</span> <span class="n">cwd</span><span class="o">=</span><span class="sh">"</span><span class="s">perevod</span><span class="sh">"</span><span class="p">,</span> <span class="n">check</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="k">for</span> <span class="n">line</span> <span class="ow">in</span> <span class="nc">Path</span><span class="p">(</span><span class="sh">"</span><span class="s">perevod/build.lock</span><span class="sh">"</span><span class="p">).</span><span class="nf">read_text</span><span class="p">().</span><span class="nf">splitlines</span><span class="p">():</span>
    <span class="k">if</span> <span class="sh">"</span><span class="s">==</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">line</span> <span class="ow">and</span> <span class="ow">not</span> <span class="n">line</span><span class="p">.</span><span class="nf">startswith</span><span class="p">((</span><span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">#</span><span class="sh">"</span><span class="p">)):</span>
        <span class="nf">print</span><span class="p">(</span><span class="n">line</span><span class="p">.</span><span class="nf">rstrip</span><span class="p">(</span><span class="sh">"</span><span class="s"> </span><span class="se">\\</span><span class="sh">"</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>hatchling==1.32.4
packaging==26.3
pathspec==1.1.1
pluggy==1.7.0
tomlkit==0.15.2
trove-classifiers==2026.9.21.13</code></pre> <h2 id="3-what-an-image-is">3. What an image is</h2> <p>A Docker image sounds like a disk image, one big file. It isn’t: it’s a few small JSON documents and a stack of tar archives, stored in a registry under names that are their own sha256 hashes. All of it comes over plain HTTP, and fetching it once by hand explains most of the rest of this lesson.</p> <p>Registries speak one protocol, the OCI distribution spec: Docker Hub, GitHub’s registry and the others. To pull, a client asks <code class="language-plaintext highlighter-rouge">/v2/&lt;name&gt;/manifests/&lt;tag&gt;</code> for a <strong>manifest</strong>, then downloads what the manifest lists from <code class="language-plaintext highlighter-rouge">/v2/&lt;name&gt;/blobs/&lt;digest&gt;</code> (<a href="https://github.com/opencontainers/distribution-spec/blob/main/spec.md#pulling-manifests">OCI distribution spec</a>).</p> <p>Public images need no account, only a short-lived anonymous token. Here are the four requests, as functions:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">INDEX</span> <span class="o">=</span> <span class="sh">"</span><span class="s">application/vnd.oci.image.index.v1+json</span><span class="sh">"</span>
<span class="n">MANIFEST</span> <span class="o">=</span> <span class="sh">"</span><span class="s">application/vnd.oci.image.manifest.v1+json</span><span class="sh">"</span>
<span class="n">DOCKER_LIST</span> <span class="o">=</span> <span class="sh">"</span><span class="s">application/vnd.docker.distribution.manifest.list.v2+json</span><span class="sh">"</span>
<span class="n">DOCKER_MANIFEST</span> <span class="o">=</span> <span class="sh">"</span><span class="s">application/vnd.docker.distribution.manifest.v2+json</span><span class="sh">"</span>


<span class="k">def</span> <span class="nf">sha256</span><span class="p">(</span><span class="n">data</span><span class="p">):</span>
    <span class="k">return</span> <span class="sh">"</span><span class="s">sha256:</span><span class="sh">"</span> <span class="o">+</span> <span class="n">hashlib</span><span class="p">.</span><span class="nf">sha256</span><span class="p">(</span><span class="n">data</span><span class="p">).</span><span class="nf">hexdigest</span><span class="p">()</span>


<span class="k">def</span> <span class="nf">pull_token</span><span class="p">(</span><span class="n">registry</span><span class="p">,</span> <span class="n">repository</span><span class="p">):</span>
    <span class="n">scope</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">repository:</span><span class="si">{</span><span class="n">repository</span><span class="si">}</span><span class="s">:pull</span><span class="sh">"</span>
    <span class="k">if</span> <span class="n">registry</span> <span class="o">==</span> <span class="sh">"</span><span class="s">registry-1.docker.io</span><span class="sh">"</span><span class="p">:</span>
        <span class="n">params</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">service</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">registry.docker.io</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">scope</span><span class="sh">"</span><span class="p">:</span> <span class="n">scope</span><span class="p">}</span>
        <span class="n">response</span> <span class="o">=</span> <span class="n">requests</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">https://auth.docker.io/token</span><span class="sh">"</span><span class="p">,</span> <span class="n">params</span><span class="o">=</span><span class="n">params</span><span class="p">)</span>
    <span class="k">else</span><span class="p">:</span>
        <span class="n">response</span> <span class="o">=</span> <span class="n">requests</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">https://</span><span class="si">{</span><span class="n">registry</span><span class="si">}</span><span class="s">/token</span><span class="sh">"</span><span class="p">,</span> <span class="n">params</span><span class="o">=</span><span class="p">{</span><span class="sh">"</span><span class="s">scope</span><span class="sh">"</span><span class="p">:</span> <span class="n">scope</span><span class="p">})</span>
    <span class="k">return</span> <span class="n">response</span><span class="p">.</span><span class="nf">json</span><span class="p">()[</span><span class="sh">"</span><span class="s">token</span><span class="sh">"</span><span class="p">]</span>


<span class="k">def</span> <span class="nf">get_manifest</span><span class="p">(</span><span class="n">registry</span><span class="p">,</span> <span class="n">repository</span><span class="p">,</span> <span class="n">reference</span><span class="p">,</span> <span class="n">token</span><span class="p">):</span>
    <span class="n">accept</span> <span class="o">=</span> <span class="sh">"</span><span class="s">, </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">([</span><span class="n">INDEX</span><span class="p">,</span> <span class="n">MANIFEST</span><span class="p">,</span> <span class="n">DOCKER_LIST</span><span class="p">,</span> <span class="n">DOCKER_MANIFEST</span><span class="p">])</span>
    <span class="n">headers</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">Authorization</span><span class="sh">"</span><span class="p">:</span> <span class="sa">f</span><span class="sh">"</span><span class="s">Bearer </span><span class="si">{</span><span class="n">token</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">Accept</span><span class="sh">"</span><span class="p">:</span> <span class="n">accept</span><span class="p">}</span>
    <span class="n">url</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">https://</span><span class="si">{</span><span class="n">registry</span><span class="si">}</span><span class="s">/v2/</span><span class="si">{</span><span class="n">repository</span><span class="si">}</span><span class="s">/manifests/</span><span class="si">{</span><span class="n">reference</span><span class="si">}</span><span class="sh">"</span>
    <span class="n">response</span> <span class="o">=</span> <span class="n">requests</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="n">url</span><span class="p">,</span> <span class="n">headers</span><span class="o">=</span><span class="n">headers</span><span class="p">)</span>
    <span class="n">response</span><span class="p">.</span><span class="nf">raise_for_status</span><span class="p">()</span>
    <span class="k">return</span> <span class="n">response</span>


<span class="k">def</span> <span class="nf">get_blob</span><span class="p">(</span><span class="n">registry</span><span class="p">,</span> <span class="n">repository</span><span class="p">,</span> <span class="n">digest</span><span class="p">,</span> <span class="n">token</span><span class="p">):</span>
    <span class="n">headers</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">Authorization</span><span class="sh">"</span><span class="p">:</span> <span class="sa">f</span><span class="sh">"</span><span class="s">Bearer </span><span class="si">{</span><span class="n">token</span><span class="si">}</span><span class="sh">"</span><span class="p">}</span>
    <span class="n">url</span> <span class="o">=</span> <span class="sa">f</span><span class="sh">"</span><span class="s">https://</span><span class="si">{</span><span class="n">registry</span><span class="si">}</span><span class="s">/v2/</span><span class="si">{</span><span class="n">repository</span><span class="si">}</span><span class="s">/blobs/</span><span class="si">{</span><span class="n">digest</span><span class="si">}</span><span class="sh">"</span>
    <span class="n">response</span> <span class="o">=</span> <span class="n">requests</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="n">url</span><span class="p">,</span> <span class="n">headers</span><span class="o">=</span><span class="n">headers</span><span class="p">)</span>
    <span class="n">response</span><span class="p">.</span><span class="nf">raise_for_status</span><span class="p">()</span>
    <span class="k">assert</span> <span class="nf">sha256</span><span class="p">(</span><span class="n">response</span><span class="p">.</span><span class="n">content</span><span class="p">)</span> <span class="o">==</span> <span class="n">digest</span>  <span class="c1"># the name of a blob is the hash of its bytes
</span>    <span class="k">return</span> <span class="n">response</span><span class="p">.</span><span class="n">content</span>
</code></pre></div></div> <p>perevod’s image is built on <code class="language-plaintext highlighter-rouge">python:3.12-slim</code>, the official Python image on Debian. Ask Docker Hub for it:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">HUB</span> <span class="o">=</span> <span class="sh">"</span><span class="s">registry-1.docker.io</span><span class="sh">"</span>
<span class="n">hub_token</span> <span class="o">=</span> <span class="nf">pull_token</span><span class="p">(</span><span class="n">HUB</span><span class="p">,</span> <span class="sh">"</span><span class="s">library/python</span><span class="sh">"</span><span class="p">)</span>
<span class="n">response</span> <span class="o">=</span> <span class="nf">get_manifest</span><span class="p">(</span><span class="n">HUB</span><span class="p">,</span> <span class="sh">"</span><span class="s">library/python</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">3.12-slim</span><span class="sh">"</span><span class="p">,</span> <span class="n">hub_token</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">Content-Type:         </span><span class="sh">"</span><span class="p">,</span> <span class="n">response</span><span class="p">.</span><span class="n">headers</span><span class="p">[</span><span class="sh">"</span><span class="s">Content-Type</span><span class="sh">"</span><span class="p">])</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">Docker-Content-Digest:</span><span class="sh">"</span><span class="p">,</span> <span class="n">response</span><span class="p">.</span><span class="n">headers</span><span class="p">[</span><span class="sh">"</span><span class="s">Docker-Content-Digest</span><span class="sh">"</span><span class="p">])</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">sha256 of the body:   </span><span class="sh">"</span><span class="p">,</span> <span class="nf">sha256</span><span class="p">(</span><span class="n">response</span><span class="p">.</span><span class="n">content</span><span class="p">))</span>

<span class="n">index</span> <span class="o">=</span> <span class="n">response</span><span class="p">.</span><span class="nf">json</span><span class="p">()</span>
<span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
<span class="n">attestations</span> <span class="o">=</span> <span class="mi">0</span>
<span class="k">for</span> <span class="n">entry</span> <span class="ow">in</span> <span class="n">index</span><span class="p">[</span><span class="sh">"</span><span class="s">manifests</span><span class="sh">"</span><span class="p">]:</span>
    <span class="n">platform</span> <span class="o">=</span> <span class="n">entry</span><span class="p">[</span><span class="sh">"</span><span class="s">platform</span><span class="sh">"</span><span class="p">]</span>
    <span class="k">if</span> <span class="n">platform</span><span class="p">[</span><span class="sh">"</span><span class="s">architecture</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="sh">"</span><span class="s">unknown</span><span class="sh">"</span><span class="p">:</span>
        <span class="n">attestations</span> <span class="o">+=</span> <span class="mi">1</span>
        <span class="k">continue</span>
    <span class="n">name</span> <span class="o">=</span> <span class="n">platform</span><span class="p">[</span><span class="sh">"</span><span class="s">os</span><span class="sh">"</span><span class="p">]</span> <span class="o">+</span> <span class="sh">"</span><span class="s">/</span><span class="sh">"</span> <span class="o">+</span> <span class="n">platform</span><span class="p">[</span><span class="sh">"</span><span class="s">architecture</span><span class="sh">"</span><span class="p">]</span>
    <span class="k">if</span> <span class="sh">"</span><span class="s">variant</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">platform</span><span class="p">:</span>
        <span class="n">name</span> <span class="o">+=</span> <span class="sh">"</span><span class="s">/</span><span class="sh">"</span> <span class="o">+</span> <span class="n">platform</span><span class="p">[</span><span class="sh">"</span><span class="s">variant</span><span class="sh">"</span><span class="p">]</span>
    <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">platform</span><span class="sh">"</span><span class="p">:</span> <span class="n">name</span><span class="p">,</span> <span class="sh">"</span><span class="s">manifest</span><span class="sh">"</span><span class="p">:</span> <span class="n">entry</span><span class="p">[</span><span class="sh">"</span><span class="s">digest</span><span class="sh">"</span><span class="p">][:</span><span class="mi">19</span><span class="p">]</span> <span class="o">+</span> <span class="sh">"</span><span class="s">…</span><span class="sh">"</span><span class="p">,</span>
                 <span class="sh">"</span><span class="s">bytes</span><span class="sh">"</span><span class="p">:</span> <span class="n">entry</span><span class="p">[</span><span class="sh">"</span><span class="s">size</span><span class="sh">"</span><span class="p">]})</span>
<span class="nf">display</span><span class="p">(</span><span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">)))</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">and</span><span class="sh">"</span><span class="p">,</span> <span class="n">attestations</span><span class="p">,</span> <span class="sh">"</span><span class="s">attestation manifests, one per image</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>Content-Type:          application/vnd.oci.image.index.v1+json
Docker-Content-Digest: sha256:aa943ce411423c7582288f18707ff66eddcbaeb510502d747a72aeb34f30d159
sha256 of the body:    sha256:aa943ce411423c7582288f18707ff66eddcbaeb510502d747a72aeb34f30d159</code></pre> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">platform</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">manifest</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">bytes</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">linux/amd64</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">sha256:1148dbb01461…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,746</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">linux/arm/v5</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">sha256:e353f56390bc…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,748</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">linux/arm/v7</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">sha256:e3f11fed4d77…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,748</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">linux/arm64/v8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">sha256:b224e2fe306f…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,748</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">linux/386</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">sha256:0f83099f3138…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,745</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">linux/ppc64le</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">sha256:20d5360eb0a6…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,748</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">linux/riscv64</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">sha256:2628eda9aec1…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,748</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">linux/s390x</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">sha256:c806450897d2…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1,746</td></tr></tbody></table></div> <pre class="tfs-printed"><code>and 8 attestation manifests, one per image</code></pre> <p>The digest the registry reports is the sha256 of the bytes it sent, and the OCI image spec makes that the content’s name: a digest “acts as a content identifier, enabling content addressability” (<a href="https://github.com/opencontainers/image-spec/blob/main/descriptor.md">OCI image spec: descriptors</a>). Change one byte, and it’s a different object with a different name.</p> <p>What came back is an <strong>image index</strong>: one image per processor architecture, from x86-64 to IBM’s mainframes, plus as many attestations, records of how each image was built. <code class="language-plaintext highlighter-rouge">docker pull</code> takes the entry for your machine. Follow the one for x86-64 down to its <strong>config</strong> and its <strong>layers</strong>:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">for</span> <span class="n">entry</span> <span class="ow">in</span> <span class="n">index</span><span class="p">[</span><span class="sh">"</span><span class="s">manifests</span><span class="sh">"</span><span class="p">]:</span>
    <span class="k">if</span> <span class="n">entry</span><span class="p">[</span><span class="sh">"</span><span class="s">platform</span><span class="sh">"</span><span class="p">][</span><span class="sh">"</span><span class="s">architecture</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="sh">"</span><span class="s">amd64</span><span class="sh">"</span><span class="p">:</span>
        <span class="n">amd64</span> <span class="o">=</span> <span class="n">entry</span>
<span class="n">manifest</span> <span class="o">=</span> <span class="nf">get_manifest</span><span class="p">(</span><span class="n">HUB</span><span class="p">,</span> <span class="sh">"</span><span class="s">library/python</span><span class="sh">"</span><span class="p">,</span> <span class="n">amd64</span><span class="p">[</span><span class="sh">"</span><span class="s">digest</span><span class="sh">"</span><span class="p">],</span> <span class="n">hub_token</span><span class="p">).</span><span class="nf">json</span><span class="p">()</span>
<span class="n">config_digest</span> <span class="o">=</span> <span class="n">manifest</span><span class="p">[</span><span class="sh">"</span><span class="s">config</span><span class="sh">"</span><span class="p">][</span><span class="sh">"</span><span class="s">digest</span><span class="sh">"</span><span class="p">]</span>
<span class="n">config</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">loads</span><span class="p">(</span><span class="nf">get_blob</span><span class="p">(</span><span class="n">HUB</span><span class="p">,</span> <span class="sh">"</span><span class="s">library/python</span><span class="sh">"</span><span class="p">,</span> <span class="n">config_digest</span><span class="p">,</span> <span class="n">hub_token</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">built:</span><span class="sh">"</span><span class="p">,</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">created</span><span class="sh">"</span><span class="p">])</span>
<span class="k">for</span> <span class="n">item</span> <span class="ow">in</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">config</span><span class="sh">"</span><span class="p">][</span><span class="sh">"</span><span class="s">Env</span><span class="sh">"</span><span class="p">]:</span>
    <span class="k">if</span> <span class="n">item</span><span class="p">.</span><span class="nf">startswith</span><span class="p">(</span><span class="sh">"</span><span class="s">PYTHON_VERSION</span><span class="sh">"</span><span class="p">):</span>
        <span class="nf">print</span><span class="p">(</span><span class="n">item</span><span class="p">)</span>

<span class="n">steps</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">step</span> <span class="ow">in</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">history</span><span class="sh">"</span><span class="p">]:</span>
    <span class="k">if</span> <span class="ow">not</span> <span class="n">step</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">empty_layer</span><span class="sh">"</span><span class="p">):</span>
        <span class="n">steps</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">step</span><span class="p">[</span><span class="sh">"</span><span class="s">created_by</span><span class="sh">"</span><span class="p">])</span>
<span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">layer</span><span class="p">,</span> <span class="n">step</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">manifest</span><span class="p">[</span><span class="sh">"</span><span class="s">layers</span><span class="sh">"</span><span class="p">],</span> <span class="n">steps</span><span class="p">,</span> <span class="n">strict</span><span class="o">=</span><span class="bp">True</span><span class="p">):</span>
    <span class="n">command</span> <span class="o">=</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">step</span><span class="p">.</span><span class="nf">split</span><span class="p">())</span>
    <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">layer</span><span class="sh">"</span><span class="p">:</span> <span class="n">layer</span><span class="p">[</span><span class="sh">"</span><span class="s">digest</span><span class="sh">"</span><span class="p">][:</span><span class="mi">19</span><span class="p">]</span> <span class="o">+</span> <span class="sh">"</span><span class="s">…</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">MB</span><span class="sh">"</span><span class="p">:</span> <span class="n">layer</span><span class="p">[</span><span class="sh">"</span><span class="s">size</span><span class="sh">"</span><span class="p">]</span> <span class="o">/</span> <span class="mf">1e6</span><span class="p">,</span>
                 <span class="sh">"</span><span class="s">made by</span><span class="sh">"</span><span class="p">:</span> <span class="n">command</span><span class="p">[:</span><span class="mi">58</span><span class="p">]})</span>
<span class="nf">display</span><span class="p">(</span><span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">1</span><span class="p">))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>built: 2026-10-28T02:03:39.583192962Z
PYTHON_VERSION=3.12.16</code></pre> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">layer</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">MB</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">made by</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">sha256:6fc242d221a6…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">29.9</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"># debian.sh --arch 'amd64' out/ 'trixie' '@1793059200'</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">sha256:3eb771151506…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.3</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">RUN /bin/sh -c set -eux; apt-get update; apt-get install -</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">sha256:f574edac59d9…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">12.1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">RUN /bin/sh -c set -eux; savedAptMark="$(apt-mark showmanu</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">sha256:acca7542dfc7…</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">RUN /bin/sh -c set -eux; for src in idle3 pip3 pydoc3 pyth</td></tr></tbody></table></div> <p>That’s the whole structure:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/tfs/09/anatomy-light.png" width="760" alt="The structure of an image, top to bottom. A tag points to an image index. The index lists one manifest per platform by digest. A manifest lists a config and the layers by digest. The config holds the environment, the command and the hash of each unpacked layer; each layer is a gzipped tar archive of the files one Dockerfile step changed. Each level names the next by its sha256, so the digest at the top fixes every byte below it" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/tfs/09/anatomy-dark.png" width="760" alt="The structure of an image, top to bottom. A tag points to an image index. The index lists one manifest per platform by digest. A manifest lists a config and the layers by digest. The config holds the environment, the command and the hash of each unpacked layer; each layer is a gzipped tar archive of the files one Dockerfile step changed. Each level names the next by its sha256, so the digest at the top fixes every byte below it" loading="lazy"></p> <p>A <strong>layer</strong> is a gzipped tar archive of the files one step of a Dockerfile added or changed. The <strong>config</strong> is a JSON document with what Docker needs to start the image: environment variables, the user, the command, and the hash of each unpacked layer.</p> <p>The <strong>manifest</strong> lists the config and the layers by digest, and the <strong>index</strong> lists the manifests. Every level names the next one by its hash, so the digest at the top fixes every byte below it. <code class="language-plaintext highlighter-rouge">FROM python:3.12-slim@sha256:…</code> pins the whole base image down to the last file.</p> <div class="callout callout-warn"> <p class="callout-label">Trap</p> <p><code class="language-plaintext highlighter-rouge">FROM python:3.12-slim</code> pins nothing. A tag is a pointer, and Docker says so plainly: “Image tags are mutable, meaning a publisher can update a tag to point to a new image” (<a href="https://docs.docker.com/build/building/best-practices/#pin-base-image-versions">Docker: build best practices</a>).</p> </div> <p>The official images are rebuilt whenever Debian or Python ships a fix; the maintainers “strive to publish updated images at least monthly for Debian”<sup class="cite">[<a href="#ref-5" id="cite-6" data-ref="5" aria-label="Reference 5: docker-library FAQ and Docker's build best practices, on tags and digests.">5</a>]</sup>. Compare today’s tag with the digest perevod’s Dockerfile pins, which was the tag’s target the day the Dockerfile was written:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">PINNED</span> <span class="o">=</span> <span class="sh">"</span><span class="s">sha256:12316debbfb86890f6b2d825820612741ba527ad5a44e3902759141d572bfe8f</span><span class="sh">"</span>
<span class="n">today</span> <span class="o">=</span> <span class="n">response</span><span class="p">.</span><span class="n">headers</span><span class="p">[</span><span class="sh">"</span><span class="s">Docker-Content-Digest</span><span class="sh">"</span><span class="p">]</span>
<span class="k">if</span> <span class="n">today</span> <span class="o">==</span> <span class="n">PINNED</span><span class="p">:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">python:3.12-slim still points to the image perevod pins</span><span class="sh">"</span><span class="p">)</span>
<span class="k">else</span><span class="p">:</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">python:3.12-slim has moved: today it points to</span><span class="sh">"</span><span class="p">,</span> <span class="n">today</span><span class="p">[:</span><span class="mi">19</span><span class="p">]</span> <span class="o">+</span> <span class="sh">"</span><span class="s">…</span><span class="sh">"</span><span class="p">)</span>
<span class="n">pinned</span> <span class="o">=</span> <span class="nf">get_manifest</span><span class="p">(</span><span class="n">HUB</span><span class="p">,</span> <span class="sh">"</span><span class="s">library/python</span><span class="sh">"</span><span class="p">,</span> <span class="n">PINNED</span><span class="p">,</span> <span class="n">hub_token</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">the pinned image is still served by its digest:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">sha256</span><span class="p">(</span><span class="n">pinned</span><span class="p">.</span><span class="n">content</span><span class="p">)</span> <span class="o">==</span> <span class="n">PINNED</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>python:3.12-slim has moved: today it points to sha256:aa943ce41142…
the pinned image is still served by its digest: True</code></pre> <h2 id="4-why-two-builds-of-one-dockerfile-differ">4. Why two builds of one Dockerfile differ</h2> <p>The definition the reproducible-builds project uses is strict: “A build is reproducible if given the same source code, build environment and build instructions, any party can recreate bit-by-bit identical copies of all specified artifacts”<sup class="cite">[<a href="#ref-6" id="cite-7" data-ref="6" aria-label="Reference 6: reproducible-builds.org: the definition, and SOURCEDATEEPOCH.">6</a>]</sup>.</p> <p>For an image, bit by bit means the same digest at the top. It’s worth the trouble for one reason: then anyone can check that the image was built from the source they can read, by building it and comparing one hash.</p> <p>Docker doesn’t give you that by default. Build one Dockerfile twice without the cache, and you get two digests.</p> <p>This lesson’s image did exactly that on its first two builds, and the differences were in places that have nothing to do with the program. Two of them you can reproduce right here.</p> <p>The first is time. A layer is a tar archive, and tar stores each file’s modification time. Pack perevod’s source as a layer, then “save” the same files a minute later, as a fresh checkout in CI would:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">commit_time</span> <span class="o">=</span> <span class="n">subprocess</span><span class="p">.</span><span class="nf">run</span><span class="p">([</span><span class="sh">"</span><span class="s">git</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">log</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-1</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">--format=%ct</span><span class="sh">"</span><span class="p">],</span> <span class="n">capture_output</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
                             <span class="n">text</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">check</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">EPOCH</span> <span class="o">=</span> <span class="nf">int</span><span class="p">(</span><span class="n">commit_time</span><span class="p">.</span><span class="n">stdout</span><span class="p">)</span>  <span class="c1"># the time of the commit the notebook started from
</span>

<span class="k">def</span> <span class="nf">layer_digest</span><span class="p">(</span><span class="n">folder</span><span class="p">,</span> <span class="n">normalize</span><span class="p">):</span>
    <span class="nb">buffer</span> <span class="o">=</span> <span class="n">io</span><span class="p">.</span><span class="nc">BytesIO</span><span class="p">()</span>
    <span class="k">with</span> <span class="n">tarfile</span><span class="p">.</span><span class="nf">open</span><span class="p">(</span><span class="n">fileobj</span><span class="o">=</span><span class="nb">buffer</span><span class="p">,</span> <span class="n">mode</span><span class="o">=</span><span class="sh">"</span><span class="s">w</span><span class="sh">"</span><span class="p">)</span> <span class="k">as</span> <span class="n">tar</span><span class="p">:</span>
        <span class="k">for</span> <span class="n">path</span> <span class="ow">in</span> <span class="nf">sorted</span><span class="p">(</span><span class="nc">Path</span><span class="p">(</span><span class="n">folder</span><span class="p">).</span><span class="nf">rglob</span><span class="p">(</span><span class="sh">"</span><span class="s">*</span><span class="sh">"</span><span class="p">)):</span>
            <span class="n">info</span> <span class="o">=</span> <span class="n">tar</span><span class="p">.</span><span class="nf">gettarinfo</span><span class="p">(</span><span class="nf">str</span><span class="p">(</span><span class="n">path</span><span class="p">),</span> <span class="n">arcname</span><span class="o">=</span><span class="nf">str</span><span class="p">(</span><span class="n">path</span><span class="p">.</span><span class="nf">relative_to</span><span class="p">(</span><span class="n">folder</span><span class="p">)))</span>
            <span class="k">if</span> <span class="n">normalize</span><span class="p">:</span>
                <span class="n">info</span><span class="p">.</span><span class="n">mtime</span> <span class="o">=</span> <span class="nf">min</span><span class="p">(</span><span class="n">info</span><span class="p">.</span><span class="n">mtime</span><span class="p">,</span> <span class="n">EPOCH</span><span class="p">)</span>  <span class="c1"># no time later than the commit
</span>                <span class="n">info</span><span class="p">.</span><span class="n">uid</span> <span class="o">=</span> <span class="mi">0</span>
                <span class="n">info</span><span class="p">.</span><span class="n">gid</span> <span class="o">=</span> <span class="mi">0</span>
                <span class="n">info</span><span class="p">.</span><span class="n">uname</span> <span class="o">=</span> <span class="sh">""</span>
                <span class="n">info</span><span class="p">.</span><span class="n">gname</span> <span class="o">=</span> <span class="sh">""</span>
            <span class="k">if</span> <span class="n">path</span><span class="p">.</span><span class="nf">is_file</span><span class="p">():</span>
                <span class="k">with</span> <span class="nf">open</span><span class="p">(</span><span class="n">path</span><span class="p">,</span> <span class="sh">"</span><span class="s">rb</span><span class="sh">"</span><span class="p">)</span> <span class="k">as</span> <span class="nb">file</span><span class="p">:</span>
                    <span class="n">tar</span><span class="p">.</span><span class="nf">addfile</span><span class="p">(</span><span class="n">info</span><span class="p">,</span> <span class="nb">file</span><span class="p">)</span>
            <span class="k">else</span><span class="p">:</span>
                <span class="n">tar</span><span class="p">.</span><span class="nf">addfile</span><span class="p">(</span><span class="n">info</span><span class="p">)</span>
    <span class="k">return</span> <span class="nf">sha256</span><span class="p">(</span><span class="n">gzip</span><span class="p">.</span><span class="nf">compress</span><span class="p">(</span><span class="nb">buffer</span><span class="p">.</span><span class="nf">getvalue</span><span class="p">(),</span> <span class="n">mtime</span><span class="o">=</span><span class="mi">0</span><span class="p">))</span>  <span class="c1"># gzip stores a time too
</span>

<span class="k">def</span> <span class="nf">touch</span><span class="p">(</span><span class="n">path</span><span class="p">):</span>
    <span class="n">stat</span> <span class="o">=</span> <span class="n">path</span><span class="p">.</span><span class="nf">stat</span><span class="p">()</span>
    <span class="n">os</span><span class="p">.</span><span class="nf">utime</span><span class="p">(</span><span class="n">path</span><span class="p">,</span> <span class="p">(</span><span class="n">stat</span><span class="p">.</span><span class="n">st_atime</span><span class="p">,</span> <span class="n">stat</span><span class="p">.</span><span class="n">st_mtime</span> <span class="o">+</span> <span class="mi">60</span><span class="p">))</span>


<span class="n">SOURCE</span> <span class="o">=</span> <span class="nc">Path</span><span class="p">(</span><span class="sh">"</span><span class="s">perevod/src</span><span class="sh">"</span><span class="p">)</span>
<span class="n">as_is</span> <span class="o">=</span> <span class="nf">layer_digest</span><span class="p">(</span><span class="n">SOURCE</span><span class="p">,</span> <span class="n">normalize</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
<span class="n">normalized</span> <span class="o">=</span> <span class="nf">layer_digest</span><span class="p">(</span><span class="n">SOURCE</span><span class="p">,</span> <span class="n">normalize</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="k">for</span> <span class="n">path</span> <span class="ow">in</span> <span class="n">SOURCE</span><span class="p">.</span><span class="nf">rglob</span><span class="p">(</span><span class="sh">"</span><span class="s">*.py</span><span class="sh">"</span><span class="p">):</span>
    <span class="nf">touch</span><span class="p">(</span><span class="n">path</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">as on disk:</span><span class="sh">"</span><span class="p">,</span> <span class="n">as_is</span><span class="p">[:</span><span class="mi">23</span><span class="p">],</span> <span class="sh">"</span><span class="s">-&gt;</span><span class="sh">"</span><span class="p">,</span> <span class="nf">layer_digest</span><span class="p">(</span><span class="n">SOURCE</span><span class="p">,</span> <span class="n">normalize</span><span class="o">=</span><span class="bp">False</span><span class="p">)[:</span><span class="mi">23</span><span class="p">])</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">normalized:</span><span class="sh">"</span><span class="p">,</span> <span class="n">normalized</span><span class="p">[:</span><span class="mi">23</span><span class="p">],</span> <span class="sh">"</span><span class="s">-&gt;</span><span class="sh">"</span><span class="p">,</span> <span class="nf">layer_digest</span><span class="p">(</span><span class="n">SOURCE</span><span class="p">,</span> <span class="n">normalize</span><span class="o">=</span><span class="bp">True</span><span class="p">)[:</span><span class="mi">23</span><span class="p">])</span>
</code></pre></div></div> <pre class="tfs-printed"><code>as on disk: sha256:9e9b126813cbaec2 -&gt; sha256:e673f23034cdb19a
normalized: sha256:c25edb033761b87c -&gt; sha256:c25edb033761b87c</code></pre> <p>Same bytes in every file, a new digest. Clamping every time to the commit’s time, and dropping the owner’s name, fixes it.</p> <p>BuildKit, the engine behind <code class="language-plaintext highlighter-rouge">docker build</code>, does exactly this when asked: it takes the time from the <code class="language-plaintext highlighter-rouge">SOURCE_DATE_EPOCH</code> variable, a convention of the reproducible-builds project, and with the exporter option <code class="language-plaintext highlighter-rouge">rewrite-timestamp=true</code> it clamps the time of every file in every layer to it <sup class="cite">[<a href="#ref-7" id="cite-8" data-ref="7" aria-label="Reference 7: BuildKit: reproducible builds; Docker: image exporter options.">7</a>]</sup>.</p> <p>The second cause hides inside the files. pip compiles every <code class="language-plaintext highlighter-rouge">.py</code> file it installs to bytecode, a <code class="language-plaintext highlighter-rouge">.pyc</code>, and a <code class="language-plaintext highlighter-rouge">.pyc</code> starts with a 16-byte header that tells Python whether the cache is still valid. By default the header holds the source file’s modification time:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">module</span> <span class="o">=</span> <span class="nc">Path</span><span class="p">(</span><span class="sh">"</span><span class="s">perevod/src/perevod/config.py</span><span class="sh">"</span><span class="p">)</span>
<span class="n">target</span> <span class="o">=</span> <span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">config.pyc</span><span class="sh">"</span>


<span class="k">def</span> <span class="nf">compiled</span><span class="p">():</span>
    <span class="n">py_compile</span><span class="p">.</span><span class="nf">compile</span><span class="p">(</span><span class="nf">str</span><span class="p">(</span><span class="n">module</span><span class="p">),</span> <span class="n">cfile</span><span class="o">=</span><span class="nf">str</span><span class="p">(</span><span class="n">target</span><span class="p">))</span>
    <span class="k">return</span> <span class="n">target</span><span class="p">.</span><span class="nf">read_bytes</span><span class="p">()</span>


<span class="k">def</span> <span class="nf">header</span><span class="p">(</span><span class="n">pyc</span><span class="p">):</span>
    <span class="n">flags</span> <span class="o">=</span> <span class="nb">int</span><span class="p">.</span><span class="nf">from_bytes</span><span class="p">(</span><span class="n">pyc</span><span class="p">[</span><span class="mi">4</span><span class="p">:</span><span class="mi">8</span><span class="p">],</span> <span class="sh">"</span><span class="s">little</span><span class="sh">"</span><span class="p">)</span>
    <span class="k">if</span> <span class="n">flags</span> <span class="o">==</span> <span class="mi">0</span><span class="p">:</span>
        <span class="n">mtime</span> <span class="o">=</span> <span class="nb">int</span><span class="p">.</span><span class="nf">from_bytes</span><span class="p">(</span><span class="n">pyc</span><span class="p">[</span><span class="mi">8</span><span class="p">:</span><span class="mi">12</span><span class="p">],</span> <span class="sh">"</span><span class="s">little</span><span class="sh">"</span><span class="p">)</span>
        <span class="n">size</span> <span class="o">=</span> <span class="nb">int</span><span class="p">.</span><span class="nf">from_bytes</span><span class="p">(</span><span class="n">pyc</span><span class="p">[</span><span class="mi">12</span><span class="p">:</span><span class="mi">16</span><span class="p">],</span> <span class="sh">"</span><span class="s">little</span><span class="sh">"</span><span class="p">)</span>
        <span class="k">return</span> <span class="sa">f</span><span class="sh">"</span><span class="s">flags </span><span class="si">{</span><span class="n">flags</span><span class="si">}</span><span class="s">, source modified at </span><span class="si">{</span><span class="n">mtime</span><span class="si">}</span><span class="s">, source size </span><span class="si">{</span><span class="n">size</span><span class="si">}</span><span class="sh">"</span>
    <span class="k">return</span> <span class="sa">f</span><span class="sh">"</span><span class="s">flags </span><span class="si">{</span><span class="n">flags</span><span class="si">}</span><span class="s">, source hash </span><span class="si">{</span><span class="n">pyc</span><span class="p">[</span><span class="mi">8</span><span class="si">:</span><span class="mi">16</span><span class="p">].</span><span class="nf">hex</span><span class="p">()</span><span class="si">}</span><span class="sh">"</span>


<span class="n">first</span> <span class="o">=</span> <span class="nf">compiled</span><span class="p">()</span>
<span class="nf">touch</span><span class="p">(</span><span class="n">module</span><span class="p">)</span>
<span class="n">second</span> <span class="o">=</span> <span class="nf">compiled</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">header</span><span class="p">(</span><span class="n">first</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">header</span><span class="p">(</span><span class="n">second</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">same bytes:</span><span class="sh">"</span><span class="p">,</span> <span class="n">first</span> <span class="o">==</span> <span class="n">second</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>flags 0, source modified at 1793220667, source size 1856
flags 0, source modified at 1793220727, source size 1856
same bytes: False</code></pre> <p>Even if the archive’s times are clamped, the time inside the file survives, and pip installs thousands of <code class="language-plaintext highlighter-rouge">.pyc</code> files. PEP 552 added a second kind of header, with a hash of the source instead of its time, and <code class="language-plaintext highlighter-rouge">py_compile</code>, which pip uses through <code class="language-plaintext highlighter-rouge">compileall</code>, switches to it by itself when <code class="language-plaintext highlighter-rouge">SOURCE_DATE_EPOCH</code> is set <sup class="cite">[<a href="#ref-8" id="cite-9" data-ref="8" aria-label="Reference 8: PEP 552: Deterministic pycs; pycompile.">8</a>]</sup>:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">os</span><span class="p">.</span><span class="n">environ</span><span class="p">[</span><span class="sh">"</span><span class="s">SOURCE_DATE_EPOCH</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="nf">str</span><span class="p">(</span><span class="n">EPOCH</span><span class="p">)</span>
<span class="n">first</span> <span class="o">=</span> <span class="nf">compiled</span><span class="p">()</span>
<span class="nf">touch</span><span class="p">(</span><span class="n">module</span><span class="p">)</span>
<span class="n">second</span> <span class="o">=</span> <span class="nf">compiled</span><span class="p">()</span>
<span class="k">del</span> <span class="n">os</span><span class="p">.</span><span class="n">environ</span><span class="p">[</span><span class="sh">"</span><span class="s">SOURCE_DATE_EPOCH</span><span class="sh">"</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">header</span><span class="p">(</span><span class="n">first</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">header</span><span class="p">(</span><span class="n">second</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">same bytes:</span><span class="sh">"</span><span class="p">,</span> <span class="n">first</span> <span class="o">==</span> <span class="n">second</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>flags 3, source hash 6e4327a19146f24e
flags 3, source hash 6e4327a19146f24e
same bytes: True</code></pre> <p>Flags 3 mean “checked hash”: Python compares the stored hash with the source’s when it imports the module. The bytes no longer depend on when the file was saved.</p> <p>There’s a catch in the Dockerfile, though: BuildKit hands <code class="language-plaintext highlighter-rouge">SOURCE_DATE_EPOCH</code> to the build, but a <code class="language-plaintext highlighter-rouge">RUN</code> step only sees a build argument that the Dockerfile declares with <code class="language-plaintext highlighter-rouge">ARG</code>. Without that one line, pip in the image never sees the variable.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/tfs/09/pyc-light.png" width="760" alt="The 16-byte header of a .pyc file, compiled twice from the same source saved a minute apart. Timestamp mode: magic number, flags 0, the source's modification time and size; the time differs, so the files differ. Checked-hash mode, with SOURCE_DATE_EPOCH set: magic number, flags 3, an 8-byte hash of the source; the two files are identical" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/tfs/09/pyc-dark.png" width="760" alt="The 16-byte header of a .pyc file, compiled twice from the same source saved a minute apart. Timestamp mode: magic number, flags 0, the source's modification time and size; the time differs, so the files differ. Checked-hash mode, with SOURCE_DATE_EPOCH set: magic number, flags 3, an 8-byte hash of the source; the two files are identical" loading="lazy"></p> <p>The rest of the list, from the first naive builds to two identical ones:</p> <table> <thead> <tr> <th>What differed</th> <th>Why</th> <th>The fix</th> </tr> </thead> <tbody> <tr> <td>file times in every layer</td> <td>each file gets the time it was written</td> <td><code class="language-plaintext highlighter-rouge">SOURCE_DATE_EPOCH</code> and <code class="language-plaintext highlighter-rouge">rewrite-timestamp=true</code></td> </tr> <tr> <td>the dates in the image’s config</td> <td>the clock at build time</td> <td><code class="language-plaintext highlighter-rouge">SOURCE_DATE_EPOCH</code></td> </tr> <tr> <td>every <code class="language-plaintext highlighter-rouge">.pyc</code> that pip wrote</td> <td>the header holds the source’s time</td> <td><code class="language-plaintext highlighter-rouge">ARG SOURCE_DATE_EPOCH</code>, so pip sees it</td> </tr> <tr> <td>a log file in the model’s layer</td> <td>hf-xet names its log by the time</td> <td>delete it in the same <code class="language-plaintext highlighter-rouge">RUN</code></td> </tr> <tr> <td>the base image, next month</td> <td>the tag moves</td> <td><code class="language-plaintext highlighter-rouge">FROM python:3.12-slim@sha256:…</code></td> </tr> <tr> <td>the packages, next month</td> <td>new releases</td> <td>the lock file, with hashes</td> </tr> <tr> <td>the wheel’s metadata</td> <td>pip fetches the newest hatchling</td> <td><code class="language-plaintext highlighter-rouge">build.lock</code> and <code class="language-plaintext highlighter-rouge">--no-build-isolation</code></td> </tr> <tr> <td>the archives, and the parser</td> <td>each BuildKit version writes and parses its own way</td> <td>BuildKit’s version pinned in CI</td> </tr> <tr> <td>attestations</td> <td>they record when and where a build ran</td> <td><code class="language-plaintext highlighter-rouge">--provenance=false --sbom=false</code></td> </tr> </tbody> </table> <p>The order of the entries in a tar archive can differ too, in general; here BuildKit’s builds agreed on it. And one cause this table missed: perevod 0.3.0 shipped with it, and section 7 shows it.</p> <h2 id="5-perevods-dockerfile">5. perevod’s Dockerfile</h2> <p>Before the image, two small changes in the package. An image runs somewhere you can’t see, so it should be able to say what it is: <code class="language-plaintext highlighter-rouge">/health</code> now reports the model’s commit along with the package’s version. The translator remembers where its weights came from; a snapshot downloaded from the Hub lives in a folder named by its commit:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">TRANSLATOR</span> <span class="o">=</span> <span class="sh">"</span><span class="s">perevod/src/perevod/translator.py</span><span class="sh">"</span>
<span class="nf">replace</span><span class="p">(</span><span class="n">TRANSLATOR</span><span class="p">,</span> <span class="sh">"</span><span class="s">        self.generation = generation</span><span class="se">\n</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">        self.generation = generation</span><span class="se">\n</span><span class="sh">"</span>
        <span class="sh">"</span><span class="s">        self.source = None  </span><span class="sh">"</span>
        <span class="sh">"</span><span class="s"># where the weights came from; from_pretrained fills it in</span><span class="se">\n</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">replace</span><span class="p">(</span><span class="n">TRANSLATOR</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">        if not path.is_dir():</span><span class="se">\n</span><span class="sh">"</span>
        <span class="sh">"</span><span class="s">            path = Path(snapshot_download(model, revision=revision, </span><span class="sh">"</span>
        <span class="sh">"</span><span class="s">allow_patterns=FILES))</span><span class="se">\n</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">        if path.is_dir():</span><span class="se">\n</span><span class="sh">"</span>
        <span class="sh">"</span><span class="s">            source = str(path)</span><span class="se">\n</span><span class="sh">"</span>
        <span class="sh">"</span><span class="s">        else:</span><span class="se">\n</span><span class="sh">"</span>
        <span class="sh">"</span><span class="s">            path = Path(snapshot_download(model, revision=revision, </span><span class="sh">"</span>
        <span class="sh">"</span><span class="s">allow_patterns=FILES))</span><span class="se">\n</span><span class="sh">"</span>
        <span class="sh">'</span><span class="s">            source = f</span><span class="sh">"</span><span class="s">{model}@{path.name}</span><span class="sh">"</span><span class="s">  </span><span class="sh">'</span>
        <span class="sh">"</span><span class="s"># a snapshot</span><span class="sh">'</span><span class="s">s folder is named by its commit</span><span class="se">\n</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">replace</span><span class="p">(</span><span class="n">TRANSLATOR</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">        return cls(network.to(device), tokenizer, </span><span class="sh">"</span>
        <span class="sh">"</span><span class="s">GenerationConfig.from_dict(settings))</span><span class="se">\n</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">        generation = GenerationConfig.from_dict(settings)</span><span class="se">\n</span><span class="sh">"</span>
        <span class="sh">"</span><span class="s">        translator = cls(network.to(device), tokenizer, generation)</span><span class="se">\n</span><span class="sh">"</span>
        <span class="sh">"</span><span class="s">        translator.source = source</span><span class="se">\n</span><span class="sh">"</span>
        <span class="sh">"</span><span class="s">        return translator</span><span class="se">\n</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <p>The server returns it, and its test checks it:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nf">replace</span><span class="p">(</span><span class="sh">"</span><span class="s">perevod/src/perevod/server.py</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">    async def health():</span><span class="se">\n</span><span class="sh">"</span>
        <span class="sh">'</span><span class="s">        return {</span><span class="sh">"</span><span class="s">status</span><span class="sh">"</span><span class="s">: </span><span class="sh">"</span><span class="s">ok</span><span class="sh">"</span><span class="s">, </span><span class="sh">"</span><span class="s">version</span><span class="sh">"</span><span class="s">: __version__}</span><span class="se">\n</span><span class="sh">'</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">    async def health():  </span><span class="sh">"</span>
        <span class="sh">"</span><span class="s"># what is running: the package</span><span class="sh">'</span><span class="s">s version and the model</span><span class="sh">'</span><span class="s">s commit</span><span class="se">\n</span><span class="sh">"</span>
        <span class="sh">"</span><span class="s">        model = app.state.batcher.translator.source</span><span class="se">\n</span><span class="sh">"</span>
        <span class="sh">'</span><span class="s">        return {</span><span class="sh">"</span><span class="s">status</span><span class="sh">"</span><span class="s">: </span><span class="sh">"</span><span class="s">ok</span><span class="sh">"</span><span class="s">, </span><span class="sh">"</span><span class="s">version</span><span class="sh">"</span><span class="s">: __version__, </span><span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="s">: model}</span><span class="se">\n</span><span class="sh">'</span><span class="p">)</span>
<span class="nf">replace</span><span class="p">(</span><span class="sh">"</span><span class="s">perevod/tests/test_server.py</span><span class="sh">"</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">def test_the_health_check(client):</span><span class="se">\n</span><span class="sh">"</span>
        <span class="sh">'</span><span class="s">    assert client.get(</span><span class="sh">"</span><span class="s">/health</span><span class="sh">"</span><span class="s">).json()[</span><span class="sh">"</span><span class="s">status</span><span class="sh">"</span><span class="s">] == </span><span class="sh">"</span><span class="s">ok</span><span class="sh">"</span><span class="se">\n</span><span class="sh">'</span><span class="p">,</span>
        <span class="sh">"</span><span class="s">def test_the_health_check_names_the_model(client, tiny_dir):</span><span class="se">\n</span><span class="sh">"</span>
        <span class="sh">'</span><span class="s">    health = client.get(</span><span class="sh">"</span><span class="s">/health</span><span class="sh">"</span><span class="s">).json()</span><span class="se">\n</span><span class="sh">'</span>
        <span class="sh">'</span><span class="s">    assert health[</span><span class="sh">"</span><span class="s">status</span><span class="sh">"</span><span class="s">] == </span><span class="sh">"</span><span class="s">ok</span><span class="sh">"</span><span class="se">\n</span><span class="sh">'</span>
        <span class="sh">'</span><span class="s">    assert health[</span><span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="s">] == str(tiny_dir)</span><span class="se">\n</span><span class="sh">'</span><span class="p">)</span>
<span class="nf">replace</span><span class="p">(</span><span class="sh">"</span><span class="s">perevod/src/perevod/__init__.py</span><span class="sh">"</span><span class="p">,</span> <span class="sh">'</span><span class="s">__version__ = </span><span class="sh">"</span><span class="s">0.2.0</span><span class="sh">"'</span><span class="p">,</span> <span class="sh">'</span><span class="s">__version__ = </span><span class="sh">"</span><span class="s">0.3.1</span><span class="sh">"'</span><span class="p">)</span>
</code></pre></div></div> <p>Now the Dockerfile, top to bottom.</p> <p><code class="language-plaintext highlighter-rouge">FROM</code> takes the Python image by digest, as section 3 showed. The Dockerfile’s parser is part of BuildKit, so pinning BuildKit’s version in CI pins it too. (A <code class="language-plaintext highlighter-rouge"># syntax=</code> line on top can name a newer parser, as an image of its own; then pin that by digest as well.)</p> <p><code class="language-plaintext highlighter-rouge">ARG SOURCE_DATE_EPOCH</code> is the line from section 4 that lets pip see the build’s time. A user with uid 1000 instead of root: a process that has no reason to write to the system shouldn’t be able to.</p> <p>The dependencies are installed before the code, and exactly as locked: <code class="language-plaintext highlighter-rouge">--require-hashes</code> turns on the checks, <code class="language-plaintext highlighter-rouge">--no-deps</code> makes pip install only what the lock lists, and the lock already lists everything. The order matters for speed, too.</p> <p>Docker caches each step and reruns a step only when something it depends on changes, so the slow step that installs PyTorch, which changes least often, comes first, and editing perevod’s code rebuilds only the cheap steps after it.</p> <p>The package is installed with <code class="language-plaintext highlighter-rouge">--no-build-isolation</code>, so that pip builds it with the locked hatchling from the previous step. Then the model, in a folder of its own, at the commit perevod pins.</p> <p>The download leaves more than the model behind in <code class="language-plaintext highlighter-rouge">~/.cache</code>, and all of that goes in the same step, because a file deleted in a later step stays in the earlier layer forever.</p> <p>Finally <code class="language-plaintext highlighter-rouge">HF_HUB_OFFLINE=1</code>: in the running container, “no HTTP calls will be made to the Hugging Face Hub” (<a href="https://huggingface.co/docs/huggingface_hub/package_reference/environment_variables#hfhuboffline">huggingface_hub: environment variables</a>), so the image runs where there is no network, and never quietly downloads anything else. The labels say where the image came from; GitHub uses <code class="language-plaintext highlighter-rouge">org.opencontainers.image.source</code> to link the image to its repository.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nf">write</span><span class="p">(</span><span class="sh">"</span><span class="s">perevod/Dockerfile</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"""</span><span class="s">
# perevod</span><span class="sh">'</span><span class="s">s server with its model inside: one commit builds one image, bit for bit.
# The base image by digest; the Dockerfile</span><span class="sh">'</span><span class="s">s parser comes with BuildKit, pinned in CI.
FROM </span><span class="se">\\</span><span class="s">
    python:3.12-slim@sha256:12316debbfb86890f6b2d825820612741ba527ad5a44e3902759141d572bfe8f

# a fixed time instead of the clock: with it pip writes .pyc files that don</span><span class="sh">'</span><span class="s">t record when
ARG SOURCE_DATE_EPOCH
ENV PIP_NO_CACHE_DIR=1 PIP_DISABLE_PIP_VERSION_CHECK=1 PYTHONUNBUFFERED=1
RUN useradd --uid 1000 --create-home perevod
WORKDIR /home/perevod

# dependencies first, exactly as locked: they change least often, so this layer is cached
COPY requirements.lock build.lock ./
RUN pip install --require-hashes --no-deps -r requirements.lock -r build.lock </span><span class="se">\\</span><span class="s">
        --extra-index-url https://download.pytorch.org/whl/cpu

# the package itself, built with the locked build backend
COPY pyproject.toml README.md ./src/
COPY src ./src/src
RUN pip install --no-deps --no-build-isolation ./src &amp;&amp; rm -rf ./src

# the model, at the commit this version of perevod was tested with, in a folder of its own;
# the rest of what the download leaves in ~/.cache goes: hf-xet</span><span class="sh">'</span><span class="s">s log is named by the time,
# and huggingface_hub caches a list of AI agents that the Hub can change at any moment
ENV HF_HUB_CACHE=/home/perevod/models
USER perevod
RUN python -c </span><span class="sh">"</span><span class="s">from perevod import Translator; Translator.from_pretrained()</span><span class="sh">"</span><span class="s"> </span><span class="se">\\</span><span class="s">
    &amp;&amp; rm -rf /home/perevod/.cache
ENV HF_HUB_OFFLINE=1

ARG VERSION=dev REVISION=unknown
LABEL org.opencontainers.image.source=https://github.com/xmarva/transformers-from-scratch </span><span class="se">\\</span><span class="s">
      org.opencontainers.image.version=$VERSION </span><span class="se">\\</span><span class="s">
      org.opencontainers.image.revision=$REVISION
EXPOSE 8000
CMD [</span><span class="sh">"</span><span class="s">perevod-server</span><span class="sh">"</span><span class="s">, </span><span class="sh">"</span><span class="s">--host</span><span class="sh">"</span><span class="s">, </span><span class="sh">"</span><span class="s">0.0.0.0</span><span class="sh">"</span><span class="s">, </span><span class="sh">"</span><span class="s">--port</span><span class="sh">"</span><span class="s">, </span><span class="sh">"</span><span class="s">8000</span><span class="sh">"</span><span class="s">]
</span><span class="sh">"""</span><span class="p">)</span>
<span class="k">assert</span> <span class="n">PINNED</span> <span class="ow">in</span> <span class="nc">Path</span><span class="p">(</span><span class="sh">"</span><span class="s">perevod/Dockerfile</span><span class="sh">"</span><span class="p">).</span><span class="nf">read_text</span><span class="p">()</span>
</code></pre></div></div> <p>The build context, the folder Docker sends to the builder, is <code class="language-plaintext highlighter-rouge">perevod/</code>. A <code class="language-plaintext highlighter-rouge">.dockerignore</code> keeps out what the image doesn’t need, and what would change its bytes without changing the program, like Python’s caches:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nf">write</span><span class="p">(</span><span class="sh">"</span><span class="s">perevod/.dockerignore</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"""</span><span class="s">
# only what the image needs: the code, its metadata and the lock files
tests
**/__pycache__
.pytest_cache
.ruff_cache
dist
build
*.egg-info
</span><span class="sh">"""</span><span class="p">)</span>
</code></pre></div></div> <p>On a machine with Docker, this builds the image and runs it, with the same options CI uses below (Docker Desktop and OrbStack ship with BuildKit):</p> <div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nb">cd </span>perevod
<span class="nb">export </span><span class="nv">SOURCE_DATE_EPOCH</span><span class="o">=</span><span class="si">$(</span>git log <span class="nt">-1</span> <span class="nt">--format</span><span class="o">=</span>%ct<span class="si">)</span>
docker buildx build <span class="nb">.</span> <span class="nt">--build-arg</span> SOURCE_DATE_EPOCH <span class="nt">--provenance</span><span class="o">=</span><span class="nb">false</span> <span class="nt">--sbom</span><span class="o">=</span><span class="nb">false</span> <span class="se">\</span>
    <span class="nt">--output</span> <span class="nb">type</span><span class="o">=</span>docker,name<span class="o">=</span>perevod:dev,rewrite-timestamp<span class="o">=</span><span class="nb">true
</span>docker run <span class="nt">--rm</span> <span class="nt">-p</span> 8000:8000 perevod:dev
</code></pre></div></div> <p>And without a network at all, from the command line of <a href="/blog/2026/transformers-from-scratch-07-package/">lesson 7</a>:</p> <div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>docker run <span class="nt">--rm</span> <span class="nt">--network</span> none perevod:dev perevod <span class="s2">"Tom is afraid of the dark."</span>
</code></pre></div></div> <p>One trap when you limit the container’s CPUs. <code class="language-plaintext highlighter-rouge">docker run --cpus 2</code> is a quota on CPU time, not a set of processors, and PyTorch doesn’t read quotas: it starts as many threads as the host has physical cores, and they fight over the two CPUs’ worth of time. Tell it explicitly, with <code class="language-plaintext highlighter-rouge">-e OMP_NUM_THREADS=2</code>.</p> <h2 id="6-build-twice-publish-once">6. Build twice, publish once</h2> <div class="callout callout-key"> <p class="callout-label">Key point</p> <p>Reproducibility that nobody checks decays: one day a step starts writing a timestamp, and nobody notices until the day it matters. So the CI job that publishes the image also checks it.</p> </div> <p>On every pull request that touches the package it builds the image twice, the second time without any cache, and compares the two digests. On a release tag it does the same and pushes the first build to the GitHub Container Registry, <code class="language-plaintext highlighter-rouge">ghcr.io</code>, as <code class="language-plaintext highlighter-rouge">ghcr.io/xmarva/perevod:&lt;version&gt;</code>.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/tfs/09/ci-light.png" width="760" alt="The image job in GitHub Actions. A pull request or a release tag starts it. It builds the image for x86-64 and ARM, then builds it again from scratch, and compares the two digests; if they differ, the job fails. On a release tag, the first build is pushed to ghcr.io/xmarva/perevod with the package's version as its tag" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/tfs/09/ci-dark.png" width="760" alt="The image job in GitHub Actions. A pull request or a release tag starts it. It builds the image for x86-64 and ARM, then builds it again from scratch, and compares the two digests; if they differ, the job fails. On a release tag, the first build is pushed to ghcr.io/xmarva/perevod with the package's version as its tag" loading="lazy"></p> <p>Some details of the workflow below. <code class="language-plaintext highlighter-rouge">SOURCE_DATE_EPOCH</code> is the time of the commit, so a rebuild of the same commit next year uses the same time.</p> <p>QEMU, an emulator, lets the x86 runner build the ARM image too, for people on Apple silicon and ARM servers. The builder is pinned, <code class="language-plaintext highlighter-rouge">moby/buildkit:v0.34.1</code>, because another version of BuildKit may pack the same files into different bytes.</p> <p>Attestations are switched off: they record when and where a build ran, so no two builds have the same ones. The job logs in to the registry with the token GitHub gives every workflow run, and needs the <code class="language-plaintext highlighter-rouge">packages: write</code> permission for it <sup class="cite">[<a href="#ref-9" id="cite-10" data-ref="9" aria-label="Reference 9: GitHub: publishing Docker images and the Container registry.">9</a>]</sup>.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nf">write</span><span class="p">(</span><span class="sh">"</span><span class="s">.github/workflows/image.yml</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"""</span><span class="s">
name: image

# perevod</span><span class="sh">'</span><span class="s">s Docker image. On pull requests that touch the package: build it twice and check
# that the two builds are the same, bit for bit. On a release tag: the same, and publish it.
on:
  push:
    tags: [</span><span class="sh">"</span><span class="s">perevod-v*</span><span class="sh">"</span><span class="s">]
  pull_request:
    paths: [</span><span class="sh">"</span><span class="s">perevod/**</span><span class="sh">"</span><span class="s">, </span><span class="sh">"</span><span class="s">.github/workflows/image.yml</span><span class="sh">"</span><span class="s">]

env:
  IMAGE: ghcr.io/xmarva/perevod
  PLATFORMS: linux/amd64,linux/arm64
  # OCI media types in both builds, and no attestations: those record when and where a build
  # ran, so no two builds have the same ones
  OUTPUT: oci-mediatypes=true,rewrite-timestamp=true
  PUSH: ${{ github.ref_type == </span><span class="sh">'</span><span class="s">tag</span><span class="sh">'</span><span class="s"> }}  # only a release tag publishes

jobs:
  image:
    runs-on: ubuntu-latest
    permissions:
      contents: read
      packages: write
    steps:
      - uses: actions/checkout@v7
      - uses: docker/setup-qemu-action@v4  # runs the arm64 build on an x86 machine
      - uses: docker/setup-buildx-action@v4
        with:
          driver-opts: image=moby/buildkit:v0.34.1  # a pinned builder writes the same bytes
      - name: Settings from the commit
        run: |
          echo </span><span class="sh">"</span><span class="s">SOURCE_DATE_EPOCH=$(git log -1 --format=%ct)</span><span class="sh">"</span><span class="s"> &gt;&gt; </span><span class="sh">"</span><span class="s">$GITHUB_ENV</span><span class="sh">"</span><span class="s">
          init=perevod/src/perevod/__init__.py
          version=$(sed -n </span><span class="sh">'</span><span class="s">s/^__version__ = </span><span class="sh">"</span><span class="se">\\</span><span class="s">(.*</span><span class="se">\\</span><span class="s">)</span><span class="sh">"</span><span class="s">$/</span><span class="se">\\</span><span class="s">1/p</span><span class="sh">'</span><span class="s"> </span><span class="sh">"</span><span class="s">$init</span><span class="sh">"</span><span class="s">)
          echo </span><span class="sh">"</span><span class="s">VERSION=$version</span><span class="sh">"</span><span class="s"> &gt;&gt; </span><span class="sh">"</span><span class="s">$GITHUB_ENV</span><span class="sh">"</span><span class="s">
          echo </span><span class="sh">"</span><span class="s">REVISION=$GITHUB_SHA</span><span class="sh">"</span><span class="s"> &gt;&gt; </span><span class="sh">"</span><span class="s">$GITHUB_ENV</span><span class="sh">"</span><span class="s">
      - name: The tag matches the package</span><span class="sh">'</span><span class="s">s version
        if: github.ref_type == </span><span class="sh">'</span><span class="s">tag</span><span class="sh">'</span><span class="s">
        run: test </span><span class="sh">"</span><span class="s">$GITHUB_REF_NAME</span><span class="sh">"</span><span class="s"> = </span><span class="sh">"</span><span class="s">perevod-v$VERSION</span><span class="sh">"</span><span class="s">
      - uses: docker/login-action@v4
        if: github.ref_type == </span><span class="sh">'</span><span class="s">tag</span><span class="sh">'</span><span class="s">
        with:
          registry: ghcr.io
          username: ${{ github.actor }}
          password: ${{ secrets.GITHUB_TOKEN }}
      - name: Build, and push on a release tag
        run: |
          docker buildx build perevod --platform </span><span class="sh">"</span><span class="s">$PLATFORMS</span><span class="sh">"</span><span class="s"> </span><span class="se">\\</span><span class="s">
            --provenance=false --sbom=false </span><span class="se">\\</span><span class="s">
            --build-arg SOURCE_DATE_EPOCH --build-arg VERSION --build-arg REVISION </span><span class="se">\\</span><span class="s">
            --output </span><span class="sh">"</span><span class="s">type=image,name=$IMAGE:$VERSION,push=$PUSH,$OUTPUT</span><span class="sh">"</span><span class="s"> </span><span class="se">\\</span><span class="s">
            --metadata-file first.json
      - name: Build again from scratch, and compare
        run: |
          docker buildx build perevod --platform </span><span class="sh">"</span><span class="s">$PLATFORMS</span><span class="sh">"</span><span class="s"> </span><span class="se">\\</span><span class="s">
            --provenance=false --sbom=false --no-cache </span><span class="se">\\</span><span class="s">
            --build-arg SOURCE_DATE_EPOCH --build-arg VERSION --build-arg REVISION </span><span class="se">\\</span><span class="s">
            --output </span><span class="sh">"</span><span class="s">type=oci,dest=second.tar,$OUTPUT</span><span class="sh">"</span><span class="s"> --metadata-file second.json
          first=$(jq -r </span><span class="sh">'</span><span class="s">.</span><span class="sh">"</span><span class="s">containerimage.digest</span><span class="sh">"'</span><span class="s"> first.json)
          second=$(jq -r </span><span class="sh">'</span><span class="s">.</span><span class="sh">"</span><span class="s">containerimage.digest</span><span class="sh">"'</span><span class="s"> second.json)
          echo </span><span class="sh">"</span><span class="s">first build:  $first</span><span class="sh">"</span><span class="s">
          echo </span><span class="sh">"</span><span class="s">second build: $second</span><span class="sh">"</span><span class="s">
          test </span><span class="sh">"</span><span class="s">$first</span><span class="sh">"</span><span class="s"> = </span><span class="sh">"</span><span class="s">$second</span><span class="sh">"</span><span class="s">
</span><span class="sh">"""</span><span class="p">)</span>
</code></pre></div></div> <p>The README gets the commands to run the image, and the server’s, which 0.2.0’s README never mentioned:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nf">replace</span><span class="p">(</span><span class="sh">"</span><span class="s">perevod/README.md</span><span class="sh">"</span><span class="p">,</span> <span class="sh">'</span><span class="s">perevod </span><span class="sh">"</span><span class="s">I think, therefore I am.</span><span class="sh">"'</span><span class="p">,</span>
        <span class="sh">'</span><span class="s">perevod </span><span class="sh">"</span><span class="s">Tom is afraid of the dark.</span><span class="sh">"'</span><span class="p">)</span>
<span class="nf">replace</span><span class="p">(</span><span class="sh">"</span><span class="s">perevod/README.md</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">The model was trained on short everyday sentences</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"""</span><span class="se">\
</span><span class="s">As a service, with an HTTP API at `/translate`, its documentation at `/docs`, and with
`--demo` a page at `/`:

```bash
pip install </span><span class="sh">"</span><span class="s">perevod[demo] @ git+$REPO#subdirectory=perevod</span><span class="sh">"</span><span class="s">
perevod-server --port 8000 --demo
```

Or from the image of a release, with the model inside, which needs no network to run:

```bash
docker run --rm -p 8000:8000 ghcr.io/xmarva/perevod:0.3.1
curl -X POST localhost:8000/translate -H </span><span class="sh">"</span><span class="s">Content-Type: application/json</span><span class="sh">"</span><span class="s"> </span><span class="se">\\</span><span class="s">
    -d </span><span class="sh">'</span><span class="s">{</span><span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="s">: </span><span class="sh">"</span><span class="s">Hello!</span><span class="sh">"</span><span class="s">}</span><span class="sh">'</span><span class="s">
```

The model was trained on short everyday sentences</span><span class="sh">"""</span><span class="p">)</span>
</code></pre></div></div> <p>A release tag starts the workflow (<a href="https://github.com/xmarva/transformers-from-scratch/actions/workflows/image.yml">its runs</a>), and its log ends with two equal digests, or the job fails. The image it pushed is public, so the notebook can check the result itself. The registry is GitHub’s this time, with the same four requests:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">VERSION</span> <span class="o">=</span> <span class="sh">"</span><span class="s">0.3.1</span><span class="sh">"</span>
<span class="n">GHCR</span> <span class="o">=</span> <span class="sh">"</span><span class="s">ghcr.io</span><span class="sh">"</span>
<span class="n">IMAGE</span> <span class="o">=</span> <span class="sh">"</span><span class="s">xmarva/perevod</span><span class="sh">"</span>
<span class="n">ghcr_token</span> <span class="o">=</span> <span class="nf">pull_token</span><span class="p">(</span><span class="n">GHCR</span><span class="p">,</span> <span class="n">IMAGE</span><span class="p">)</span>
<span class="n">response</span> <span class="o">=</span> <span class="nf">get_manifest</span><span class="p">(</span><span class="n">GHCR</span><span class="p">,</span> <span class="n">IMAGE</span><span class="p">,</span> <span class="n">VERSION</span><span class="p">,</span> <span class="n">ghcr_token</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">GHCR</span><span class="si">}</span><span class="s">/</span><span class="si">{</span><span class="n">IMAGE</span><span class="si">}</span><span class="s">:</span><span class="si">{</span><span class="n">VERSION</span><span class="si">}</span><span class="sh">"</span><span class="p">,</span> <span class="n">response</span><span class="p">.</span><span class="n">headers</span><span class="p">[</span><span class="sh">"</span><span class="s">Docker-Content-Digest</span><span class="sh">"</span><span class="p">])</span>

<span class="n">manifests</span> <span class="o">=</span> <span class="p">{}</span>
<span class="n">configs</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">entry</span> <span class="ow">in</span> <span class="n">response</span><span class="p">.</span><span class="nf">json</span><span class="p">()[</span><span class="sh">"</span><span class="s">manifests</span><span class="sh">"</span><span class="p">]:</span>
    <span class="n">arch</span> <span class="o">=</span> <span class="n">entry</span><span class="p">[</span><span class="sh">"</span><span class="s">platform</span><span class="sh">"</span><span class="p">][</span><span class="sh">"</span><span class="s">architecture</span><span class="sh">"</span><span class="p">]</span>
    <span class="n">manifests</span><span class="p">[</span><span class="n">arch</span><span class="p">]</span> <span class="o">=</span> <span class="nf">get_manifest</span><span class="p">(</span><span class="n">GHCR</span><span class="p">,</span> <span class="n">IMAGE</span><span class="p">,</span> <span class="n">entry</span><span class="p">[</span><span class="sh">"</span><span class="s">digest</span><span class="sh">"</span><span class="p">],</span> <span class="n">ghcr_token</span><span class="p">).</span><span class="nf">json</span><span class="p">()</span>
    <span class="n">config_digest</span> <span class="o">=</span> <span class="n">manifests</span><span class="p">[</span><span class="n">arch</span><span class="p">][</span><span class="sh">"</span><span class="s">config</span><span class="sh">"</span><span class="p">][</span><span class="sh">"</span><span class="s">digest</span><span class="sh">"</span><span class="p">]</span>
    <span class="n">configs</span><span class="p">[</span><span class="n">arch</span><span class="p">]</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">loads</span><span class="p">(</span><span class="nf">get_blob</span><span class="p">(</span><span class="n">GHCR</span><span class="p">,</span> <span class="n">IMAGE</span><span class="p">,</span> <span class="n">config_digest</span><span class="p">,</span> <span class="n">ghcr_token</span><span class="p">))</span>
<span class="k">for</span> <span class="n">name</span><span class="p">,</span> <span class="n">value</span> <span class="ow">in</span> <span class="n">configs</span><span class="p">[</span><span class="sh">"</span><span class="s">amd64</span><span class="sh">"</span><span class="p">][</span><span class="sh">"</span><span class="s">config</span><span class="sh">"</span><span class="p">][</span><span class="sh">"</span><span class="s">Labels</span><span class="sh">"</span><span class="p">].</span><span class="nf">items</span><span class="p">():</span>
    <span class="nf">print</span><span class="p">(</span><span class="n">name</span><span class="p">,</span> <span class="sh">"</span><span class="s">=</span><span class="sh">"</span><span class="p">,</span> <span class="n">value</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>ghcr.io/xmarva/perevod:0.3.1 sha256:8b46a084770cc8cd7aac71ca30ffd1c95807ad79af9200f5e7fb28464b27839b
org.opencontainers.image.revision = 1db63fa5a13dd09d00be9b7c6179850a1894500a
org.opencontainers.image.source = https://github.com/xmarva/transformers-from-scratch
org.opencontainers.image.version = 0.3.1</code></pre> <p>The labels say which commit the image was built from. And the two architectures can be compared layer by layer:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">short</span><span class="p">(</span><span class="n">command</span><span class="p">):</span>
    <span class="n">command</span> <span class="o">=</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">command</span><span class="p">.</span><span class="nf">split</span><span class="p">())</span>
    <span class="n">command</span> <span class="o">=</span> <span class="n">command</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="sh">"</span><span class="s"> /bin/sh -c </span><span class="sh">"</span><span class="p">)[</span><span class="o">-</span><span class="mi">1</span><span class="p">].</span><span class="nf">replace</span><span class="p">(</span><span class="sh">"</span><span class="s"> # buildkit</span><span class="sh">"</span><span class="p">,</span> <span class="sh">""</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">command</span><span class="p">[:</span><span class="mi">56</span><span class="p">]</span>


<span class="n">steps</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">step</span> <span class="ow">in</span> <span class="n">configs</span><span class="p">[</span><span class="sh">"</span><span class="s">amd64</span><span class="sh">"</span><span class="p">][</span><span class="sh">"</span><span class="s">history</span><span class="sh">"</span><span class="p">]:</span>
    <span class="k">if</span> <span class="ow">not</span> <span class="n">step</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">empty_layer</span><span class="sh">"</span><span class="p">):</span>
        <span class="n">steps</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">step</span><span class="p">[</span><span class="sh">"</span><span class="s">created_by</span><span class="sh">"</span><span class="p">])</span>
<span class="n">rows</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">step</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">steps</span><span class="p">):</span>
    <span class="n">x86</span> <span class="o">=</span> <span class="n">manifests</span><span class="p">[</span><span class="sh">"</span><span class="s">amd64</span><span class="sh">"</span><span class="p">][</span><span class="sh">"</span><span class="s">layers</span><span class="sh">"</span><span class="p">][</span><span class="n">k</span><span class="p">]</span>
    <span class="n">arm</span> <span class="o">=</span> <span class="n">manifests</span><span class="p">[</span><span class="sh">"</span><span class="s">arm64</span><span class="sh">"</span><span class="p">][</span><span class="sh">"</span><span class="s">layers</span><span class="sh">"</span><span class="p">][</span><span class="n">k</span><span class="p">]</span>
    <span class="n">same</span> <span class="o">=</span> <span class="sh">"</span><span class="s">yes</span><span class="sh">"</span> <span class="k">if</span> <span class="n">x86</span><span class="p">[</span><span class="sh">"</span><span class="s">digest</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="n">arm</span><span class="p">[</span><span class="sh">"</span><span class="s">digest</span><span class="sh">"</span><span class="p">]</span> <span class="k">else</span> <span class="sh">"</span><span class="s">no</span><span class="sh">"</span>
    <span class="n">rows</span><span class="p">.</span><span class="nf">append</span><span class="p">({</span><span class="sh">"</span><span class="s">step</span><span class="sh">"</span><span class="p">:</span> <span class="nf">short</span><span class="p">(</span><span class="n">step</span><span class="p">),</span> <span class="sh">"</span><span class="s">MB (x86)</span><span class="sh">"</span><span class="p">:</span> <span class="n">x86</span><span class="p">[</span><span class="sh">"</span><span class="s">size</span><span class="sh">"</span><span class="p">]</span> <span class="o">/</span> <span class="mf">1e6</span><span class="p">,</span> <span class="sh">"</span><span class="s">same on ARM</span><span class="sh">"</span><span class="p">:</span> <span class="n">same</span><span class="p">})</span>
<span class="nf">display</span><span class="p">(</span><span class="nf">table</span><span class="p">(</span><span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">(</span><span class="n">rows</span><span class="p">),</span> <span class="n">digits</span><span class="o">=</span><span class="mi">1</span><span class="p">))</span>
</code></pre></div></div> <div class="tfs-table-wrap"><table class="tfs-table" style="border-collapse:collapse;font-family:'IBM Plex Sans', -apple-system, 'Segoe UI', Roboto, Helvetica, Arial, sans-serif;font-size:13.5px;line-height:1.45;margin:4px 0 8px;"><thead><tr><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">step</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:right;">MB (x86)</th><th style="padding:7px 14px;border-bottom:2px solid #B9C0CB;font-weight:600;color:#5B6575;font-size:12px;letter-spacing:0.02em;text-align:left;">same on ARM</th></tr></thead><tbody><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;"># debian.sh --arch 'amd64' out/ 'trixie' '@1792531975'</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">29.8</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">no</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">set -eux; apt-get update; apt-get install -y --no-instal</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">1.6</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">no</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">set -eux; savedAptMark="$(apt-mark showmanual)"; apt-get</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">12.1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">no</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">set -eux; for src in idle3 pip3 pydoc3 python3 python3-c</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">no</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">useradd --uid 1000 --create-home perevod</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">no</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">WORKDIR /home/perevod</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">yes</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">COPY requirements.lock build.lock ./</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">yes</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">pip install --require-hashes --no-deps -r requirements.l</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">285.2</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">no</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">COPY pyproject.toml README.md ./src/</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">yes</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">COPY src ./src/src</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.0</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">yes</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">pip install --no-deps --no-build-isolation ./src &amp;&amp; rm -</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">0.1</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">no</td></tr><tr><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">python -c "from perevod import Translator; Translator.fr</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:right;font-variant-numeric:tabular-nums;max-width:460px;white-space:normal;">35.9</td><td style="padding:7px 14px;border-bottom:1px solid #E6E9EE;vertical-align:top;text-align:left;max-width:460px;white-space:normal;">yes</td></tr></tbody></table></div> <p>Most layers differ, and should: Debian, Python and PyTorch are compiled for each processor. The interesting rows are the others. The copied files are the same bytes on both, and so is the model’s layer, which was made by running Python on each architecture, the ARM one inside an emulator, and keeping what the download wrote.</p> <p>Two different processors, one emulated, produced the same bytes, because nothing in that layer depends on when or where it was made.</p> <p>Two small layers of ours differ for a reason that took some digging: both carry times inherited from the base image, which was built separately, minutes apart, for each architecture.</p> <p><code class="language-plaintext highlighter-rouge">useradd</code> copies the new user’s start-up files from <code class="language-plaintext highlighter-rouge">/etc/skel</code> with their original times. And running pip makes Python import a few modules of its own standard library that the base image hadn’t cached yet, so Python writes their <code class="language-plaintext highlighter-rouge">.pyc</code> files into the layer that installs perevod.</p> <p>Python’s import system writes timestamp headers no matter what <code class="language-plaintext highlighter-rouge">SOURCE_DATE_EPOCH</code> says, which only changes the default of <code class="language-plaintext highlighter-rouge">py_compile</code> and <code class="language-plaintext highlighter-rouge">compileall</code>, and the timestamps are those of the standard library’s files.</p> <p><code class="language-plaintext highlighter-rouge">rewrite-timestamp</code> only rewrites times later than <code class="language-plaintext highlighter-rouge">SOURCE_DATE_EPOCH</code>, and these are earlier. Inside one architecture they’re pinned along with the base, so two builds still agree.</p> <p>There’s a stronger test than CI’s. CI builds twice on the same machine, minutes apart. The real promise of a reproducible build is that anyone, anywhere, later, gets the same bytes.</p> <p>A day after the release, a rebuild of the same commit on a laptop, an ARM Mac, with the same command and the same pinned BuildKit, gave the published digest, on a fresh builder.</p> <p>On a builder that had built earlier versions, one directory in one layer came out with the time of an old build, and the digest differed: rebuild on a fresh builder, as CI always does.</p> <h2 id="7-the-image-without-docker">7. The image, without Docker</h2> <p>The notebook can’t run Docker, but it can do what Docker does when it pulls an image: download the layers, check each against its digest, and unpack them on top of each other into one folder. That folder is the image’s filesystem.</p> <p>One detail matters while unpacking. A layer can’t change an earlier layer, so when a step deletes a file, its layer carries an empty marker named <code class="language-plaintext highlighter-rouge">.wh.&lt;name&gt;</code>, a <strong>whiteout</strong>, and the file must be removed from what’s been unpacked so far.</p> <p>And a tar archive from the internet deserves suspicion: Python’s <code class="language-plaintext highlighter-rouge">data</code> filter refuses entries that would land outside the folder, including links to absolute paths, which would point into this machine’s own system instead of the image’s <sup class="cite">[<a href="#ref-10" id="cite-11" data-ref="10" aria-label="Reference 10: Python: tarfile extraction filters; the dynamic loader: ld.so(8).">10</a>]</sup>.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">MACHINES</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">x86_64</span><span class="sh">"</span><span class="p">:</span> <span class="p">(</span><span class="sh">"</span><span class="s">amd64</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">x86_64-linux-gnu</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">ld-linux-x86-64.so.2</span><span class="sh">"</span><span class="p">),</span>
            <span class="sh">"</span><span class="s">aarch64</span><span class="sh">"</span><span class="p">:</span> <span class="p">(</span><span class="sh">"</span><span class="s">arm64</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">aarch64-linux-gnu</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">ld-linux-aarch64.so.1</span><span class="sh">"</span><span class="p">)}</span>
<span class="n">ARCH</span><span class="p">,</span> <span class="n">TRIPLET</span><span class="p">,</span> <span class="n">LOADER</span> <span class="o">=</span> <span class="n">MACHINES</span><span class="p">[</span><span class="n">os</span><span class="p">.</span><span class="nf">uname</span><span class="p">().</span><span class="n">machine</span><span class="p">]</span>
<span class="n">ROOT</span> <span class="o">=</span> <span class="n">WORK_DIR</span> <span class="o">/</span> <span class="sh">"</span><span class="s">rootfs</span><span class="sh">"</span>
<span class="n">shutil</span><span class="p">.</span><span class="nf">rmtree</span><span class="p">(</span><span class="n">ROOT</span><span class="p">,</span> <span class="n">ignore_errors</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">ROOT</span><span class="p">.</span><span class="nf">mkdir</span><span class="p">()</span>
<span class="n">refused</span> <span class="o">=</span> <span class="p">[]</span>


<span class="k">def</span> <span class="nf">unpack</span><span class="p">(</span><span class="n">member</span><span class="p">,</span> <span class="n">path</span><span class="p">):</span>
    <span class="n">name</span> <span class="o">=</span> <span class="nc">Path</span><span class="p">(</span><span class="n">member</span><span class="p">.</span><span class="n">name</span><span class="p">)</span>
    <span class="k">if</span> <span class="n">name</span><span class="p">.</span><span class="n">name</span><span class="p">.</span><span class="nf">startswith</span><span class="p">(</span><span class="sh">"</span><span class="s">.wh.</span><span class="sh">"</span><span class="p">):</span>  <span class="c1"># a whiteout: a later layer deleted this file
</span>        <span class="n">gone</span> <span class="o">=</span> <span class="nc">Path</span><span class="p">(</span><span class="n">path</span><span class="p">)</span> <span class="o">/</span> <span class="n">name</span><span class="p">.</span><span class="n">parent</span> <span class="o">/</span> <span class="n">name</span><span class="p">.</span><span class="n">name</span><span class="p">.</span><span class="nf">removeprefix</span><span class="p">(</span><span class="sh">"</span><span class="s">.wh.</span><span class="sh">"</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">gone</span><span class="p">.</span><span class="nf">is_dir</span><span class="p">()</span> <span class="ow">and</span> <span class="ow">not</span> <span class="n">gone</span><span class="p">.</span><span class="nf">is_symlink</span><span class="p">():</span>
            <span class="n">shutil</span><span class="p">.</span><span class="nf">rmtree</span><span class="p">(</span><span class="n">gone</span><span class="p">)</span>
        <span class="k">elif</span> <span class="n">gone</span><span class="p">.</span><span class="nf">exists</span><span class="p">()</span> <span class="ow">or</span> <span class="n">gone</span><span class="p">.</span><span class="nf">is_symlink</span><span class="p">():</span>
            <span class="n">gone</span><span class="p">.</span><span class="nf">unlink</span><span class="p">()</span>
        <span class="k">return</span> <span class="bp">None</span>
    <span class="k">try</span><span class="p">:</span>
        <span class="k">return</span> <span class="n">tarfile</span><span class="p">.</span><span class="nf">data_filter</span><span class="p">(</span><span class="n">member</span><span class="p">,</span> <span class="n">path</span><span class="p">)</span>
    <span class="k">except</span> <span class="n">tarfile</span><span class="p">.</span><span class="n">FilterError</span><span class="p">:</span>
        <span class="n">refused</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">member</span><span class="p">.</span><span class="n">name</span><span class="p">)</span>
        <span class="k">return</span> <span class="bp">None</span>


<span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
<span class="n">downloaded</span> <span class="o">=</span> <span class="mi">0</span>
<span class="k">for</span> <span class="n">layer</span> <span class="ow">in</span> <span class="n">manifests</span><span class="p">[</span><span class="n">ARCH</span><span class="p">][</span><span class="sh">"</span><span class="s">layers</span><span class="sh">"</span><span class="p">]:</span>
    <span class="n">data</span> <span class="o">=</span> <span class="nf">get_blob</span><span class="p">(</span><span class="n">GHCR</span><span class="p">,</span> <span class="n">IMAGE</span><span class="p">,</span> <span class="n">layer</span><span class="p">[</span><span class="sh">"</span><span class="s">digest</span><span class="sh">"</span><span class="p">],</span> <span class="n">ghcr_token</span><span class="p">)</span>  <span class="c1"># checked against its digest
</span>    <span class="n">downloaded</span> <span class="o">+=</span> <span class="nf">len</span><span class="p">(</span><span class="n">data</span><span class="p">)</span>
    <span class="k">with</span> <span class="n">tarfile</span><span class="p">.</span><span class="nf">open</span><span class="p">(</span><span class="n">fileobj</span><span class="o">=</span><span class="n">io</span><span class="p">.</span><span class="nc">BytesIO</span><span class="p">(</span><span class="n">data</span><span class="p">),</span> <span class="n">mode</span><span class="o">=</span><span class="sh">"</span><span class="s">r:gz</span><span class="sh">"</span><span class="p">)</span> <span class="k">as</span> <span class="n">tar</span><span class="p">:</span>
        <span class="n">tar</span><span class="p">.</span><span class="nf">extractall</span><span class="p">(</span><span class="n">ROOT</span><span class="p">,</span> <span class="nb">filter</span><span class="o">=</span><span class="n">unpack</span><span class="p">)</span>
<span class="n">seconds</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">downloaded</span> <span class="o">/</span> <span class="mf">1e6</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> MB downloaded, checked and unpacked in </span><span class="si">{</span><span class="n">seconds</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> s</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">refused</span><span class="p">),</span> <span class="sh">"</span><span class="s">links refused, for example</span><span class="sh">"</span><span class="p">,</span> <span class="n">refused</span><span class="p">[:</span><span class="mi">3</span><span class="p">])</span>
</code></pre></div></div> <pre class="tfs-printed"><code>365 MB downloaded, checked and unpacked in 37 s
185 links refused, for example ['etc/alternatives/awk', 'etc/alternatives/awk.1.gz', 'etc/alternatives/builtins.7.gz']</code></pre> <p>The refused entries are Debian’s links such as <code class="language-plaintext highlighter-rouge">/etc/alternatives/awk</code>, which point to absolute paths. They only make sense inside the container, and the program doesn’t need them. Look around:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nf">print</span><span class="p">(</span><span class="nf">sorted</span><span class="p">(</span><span class="n">path</span><span class="p">.</span><span class="n">name</span> <span class="k">for</span> <span class="n">path</span> <span class="ow">in</span> <span class="n">ROOT</span><span class="p">.</span><span class="nf">iterdir</span><span class="p">()))</span>
<span class="n">site</span> <span class="o">=</span> <span class="n">ROOT</span> <span class="o">/</span> <span class="sh">"</span><span class="s">usr/local/lib/python3.12/site-packages</span><span class="sh">"</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="nf">list</span><span class="p">(</span><span class="n">site</span><span class="p">.</span><span class="nf">glob</span><span class="p">(</span><span class="sh">"</span><span class="s">*.dist-info</span><span class="sh">"</span><span class="p">))),</span> <span class="sh">"</span><span class="s">installed packages</span><span class="sh">"</span><span class="p">)</span>
<span class="n">models</span> <span class="o">=</span> <span class="n">ROOT</span> <span class="o">/</span> <span class="sh">"</span><span class="s">home/perevod/models</span><span class="sh">"</span>
<span class="k">for</span> <span class="n">path</span> <span class="ow">in</span> <span class="nf">sorted</span><span class="p">(</span><span class="n">models</span><span class="p">.</span><span class="nf">rglob</span><span class="p">(</span><span class="sh">"</span><span class="s">*</span><span class="sh">"</span><span class="p">)):</span>
    <span class="k">if</span> <span class="n">path</span><span class="p">.</span><span class="nf">is_file</span><span class="p">()</span> <span class="ow">and</span> <span class="sh">"</span><span class="s">snapshots</span><span class="sh">"</span> <span class="ow">in</span> <span class="n">path</span><span class="p">.</span><span class="n">parts</span><span class="p">:</span>
        <span class="nf">print</span><span class="p">(</span><span class="n">path</span><span class="p">.</span><span class="nf">relative_to</span><span class="p">(</span><span class="n">models</span><span class="p">),</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">path</span><span class="p">.</span><span class="nf">stat</span><span class="p">().</span><span class="n">st_size</span><span class="si">:</span><span class="p">,</span><span class="si">}</span><span class="s"> bytes</span><span class="sh">"</span><span class="p">)</span>
<span class="n">leftovers</span> <span class="o">=</span> <span class="p">[]</span>
<span class="nf">if </span><span class="p">(</span><span class="n">ROOT</span> <span class="o">/</span> <span class="sh">"</span><span class="s">home/perevod/.cache</span><span class="sh">"</span><span class="p">).</span><span class="nf">exists</span><span class="p">():</span>
    <span class="n">leftovers</span> <span class="o">=</span> <span class="nf">list</span><span class="p">((</span><span class="n">ROOT</span> <span class="o">/</span> <span class="sh">"</span><span class="s">home/perevod/.cache</span><span class="sh">"</span><span class="p">).</span><span class="nf">rglob</span><span class="p">(</span><span class="sh">"</span><span class="s">*</span><span class="sh">"</span><span class="p">))</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">anything in ~/.cache:</span><span class="sh">"</span><span class="p">,</span> <span class="n">leftovers</span> <span class="ow">or</span> <span class="sh">"</span><span class="s">no</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>['bin', 'boot', 'dev', 'etc', 'home', 'lib', 'lib64', 'media', 'mnt', 'opt', 'proc', 'root', 'run', 'sbin', 'srv', 'sys', 'tmp', 'usr', 'var']
41 installed packages
models--xmarva--perevod-en-ru/snapshots/4abc0d63e862ca99d2bd99cd1007e4a9fe47c358/config.json 235 bytes
models--xmarva--perevod-en-ru/snapshots/4abc0d63e862ca99d2bd99cd1007e4a9fe47c358/generation_config.json 58 bytes
models--xmarva--perevod-en-ru/snapshots/4abc0d63e862ca99d2bd99cd1007e4a9fe47c358/model.safetensors 38,453,000 bytes
models--xmarva--perevod-en-ru/snapshots/4abc0d63e862ca99d2bd99cd1007e4a9fe47c358/tokenizer.json 1,230,871 bytes
anything in ~/.cache: no</code></pre> <p>A Linux system, Python’s packages, and the model at the commit perevod pins. Is it the model that’s on the Hub? The Hub stores the sha256 of every large file, so ask it, and hash the file from the image:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="n">huggingface_hub</span> <span class="kn">import</span> <span class="n">HfApi</span>

<span class="n">MODEL</span> <span class="o">=</span> <span class="sh">"</span><span class="s">xmarva/perevod-en-ru</span><span class="sh">"</span>
<span class="n">REVISION</span> <span class="o">=</span> <span class="sh">"</span><span class="s">4abc0d63e862ca99d2bd99cd1007e4a9fe47c358</span><span class="sh">"</span>
<span class="n">info</span> <span class="o">=</span> <span class="nc">HfApi</span><span class="p">().</span><span class="nf">model_info</span><span class="p">(</span><span class="n">MODEL</span><span class="p">,</span> <span class="n">revision</span><span class="o">=</span><span class="n">REVISION</span><span class="p">,</span> <span class="n">files_metadata</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="k">for</span> <span class="nb">file</span> <span class="ow">in</span> <span class="n">info</span><span class="p">.</span><span class="n">siblings</span><span class="p">:</span>
    <span class="k">if</span> <span class="nb">file</span><span class="p">.</span><span class="n">rfilename</span> <span class="o">==</span> <span class="sh">"</span><span class="s">model.safetensors</span><span class="sh">"</span><span class="p">:</span>
        <span class="n">hub_sha</span> <span class="o">=</span> <span class="nb">file</span><span class="p">.</span><span class="n">lfs</span><span class="p">.</span><span class="n">sha256</span>
<span class="n">snapshot</span> <span class="o">=</span> <span class="n">models</span> <span class="o">/</span> <span class="sh">"</span><span class="s">models--xmarva--perevod-en-ru</span><span class="sh">"</span> <span class="o">/</span> <span class="sh">"</span><span class="s">snapshots</span><span class="sh">"</span> <span class="o">/</span> <span class="n">REVISION</span>
<span class="n">weights</span> <span class="o">=</span> <span class="n">snapshot</span> <span class="o">/</span> <span class="sh">"</span><span class="s">model.safetensors</span><span class="sh">"</span>
<span class="n">image_sha</span> <span class="o">=</span> <span class="n">hashlib</span><span class="p">.</span><span class="nf">sha256</span><span class="p">(</span><span class="n">weights</span><span class="p">.</span><span class="nf">read_bytes</span><span class="p">()).</span><span class="nf">hexdigest</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">on the Hub:   </span><span class="sh">"</span><span class="p">,</span> <span class="n">hub_sha</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">in the image: </span><span class="sh">"</span><span class="p">,</span> <span class="n">image_sha</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">the same:</span><span class="sh">"</span><span class="p">,</span> <span class="n">hub_sha</span> <span class="o">==</span> <span class="n">image_sha</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>on the Hub:    0b085d1e77815f47b17cbd5b400ec735edff9a222fb9e18c32c00101168e021d
in the image:  0b085d1e77815f47b17cbd5b400ec735edff9a222fb9e18c32c00101168e021d
the same: True</code></pre> <p>Now the cause that the table in section 4 missed. perevod 0.3.0 passed CI’s check, two identical builds, and its model layer still held a file that had no business there. Open that layer of the 0.3.0 image:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">old_index</span> <span class="o">=</span> <span class="nf">get_manifest</span><span class="p">(</span><span class="n">GHCR</span><span class="p">,</span> <span class="n">IMAGE</span><span class="p">,</span> <span class="sh">"</span><span class="s">0.3.0</span><span class="sh">"</span><span class="p">,</span> <span class="n">ghcr_token</span><span class="p">).</span><span class="nf">json</span><span class="p">()</span>
<span class="k">for</span> <span class="n">entry</span> <span class="ow">in</span> <span class="n">old_index</span><span class="p">[</span><span class="sh">"</span><span class="s">manifests</span><span class="sh">"</span><span class="p">]:</span>
    <span class="k">if</span> <span class="n">entry</span><span class="p">[</span><span class="sh">"</span><span class="s">platform</span><span class="sh">"</span><span class="p">][</span><span class="sh">"</span><span class="s">architecture</span><span class="sh">"</span><span class="p">]</span> <span class="o">==</span> <span class="n">ARCH</span><span class="p">:</span>
        <span class="n">old_manifest</span> <span class="o">=</span> <span class="nf">get_manifest</span><span class="p">(</span><span class="n">GHCR</span><span class="p">,</span> <span class="n">IMAGE</span><span class="p">,</span> <span class="n">entry</span><span class="p">[</span><span class="sh">"</span><span class="s">digest</span><span class="sh">"</span><span class="p">],</span> <span class="n">ghcr_token</span><span class="p">).</span><span class="nf">json</span><span class="p">()</span>
<span class="n">old_model_layer</span> <span class="o">=</span> <span class="nf">get_blob</span><span class="p">(</span><span class="n">GHCR</span><span class="p">,</span> <span class="n">IMAGE</span><span class="p">,</span> <span class="n">old_manifest</span><span class="p">[</span><span class="sh">"</span><span class="s">layers</span><span class="sh">"</span><span class="p">][</span><span class="o">-</span><span class="mi">1</span><span class="p">][</span><span class="sh">"</span><span class="s">digest</span><span class="sh">"</span><span class="p">],</span> <span class="n">ghcr_token</span><span class="p">)</span>
<span class="k">with</span> <span class="n">tarfile</span><span class="p">.</span><span class="nf">open</span><span class="p">(</span><span class="n">fileobj</span><span class="o">=</span><span class="n">io</span><span class="p">.</span><span class="nc">BytesIO</span><span class="p">(</span><span class="n">old_model_layer</span><span class="p">),</span> <span class="n">mode</span><span class="o">=</span><span class="sh">"</span><span class="s">r:gz</span><span class="sh">"</span><span class="p">)</span> <span class="k">as</span> <span class="n">tar</span><span class="p">:</span>
    <span class="k">for</span> <span class="n">member</span> <span class="ow">in</span> <span class="n">tar</span><span class="p">.</span><span class="nf">getmembers</span><span class="p">():</span>
        <span class="k">if</span> <span class="n">member</span><span class="p">.</span><span class="nf">isfile</span><span class="p">()</span> <span class="ow">and</span> <span class="sh">"</span><span class="s">/hub/</span><span class="sh">"</span> <span class="ow">not</span> <span class="ow">in</span> <span class="n">member</span><span class="p">.</span><span class="n">name</span><span class="p">:</span>
            <span class="nf">print</span><span class="p">(</span><span class="n">member</span><span class="p">.</span><span class="n">name</span><span class="p">,</span> <span class="n">member</span><span class="p">.</span><span class="n">size</span><span class="p">,</span> <span class="sh">"</span><span class="s">bytes</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">found</span> <span class="o">=</span> <span class="n">tar</span><span class="p">.</span><span class="nf">extractfile</span><span class="p">(</span><span class="sh">"</span><span class="s">home/perevod/.cache/huggingface/.agent_harnesses.json</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">agents</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">loads</span><span class="p">(</span><span class="n">found</span><span class="p">.</span><span class="nf">read</span><span class="p">())</span>
<span class="n">names</span> <span class="o">=</span> <span class="nf">list</span><span class="p">(</span><span class="n">agents</span><span class="p">[</span><span class="sh">"</span><span class="s">harnesses</span><span class="sh">"</span><span class="p">])</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">names</span><span class="p">),</span> <span class="sh">"</span><span class="s">AI coding agents, starting with</span><span class="sh">"</span><span class="p">,</span> <span class="n">names</span><span class="p">[:</span><span class="mi">4</span><span class="p">])</span>
</code></pre></div></div> <pre class="tfs-printed"><code>home/perevod/.cache/huggingface/.agent_harnesses.json 5778 bytes
25 AI coding agents, starting with ['antigravity', 'augment-cli', 'cline', 'cowork']</code></pre> <p>Next to the model sat a list of AI coding agents. huggingface_hub 2.x labels its requests with the agent that made them, if any, and to recognise agents it downloads the list from the Hub, “at most once a day”, and caches it in <code class="language-plaintext highlighter-rouge">~/.cache/huggingface</code>.</p> <p>The list lives on the Hub’s server and changes when the Hub adds an agent. So the two builds of the release agreed, but a rebuild of the same commit after the next change to that list would not: the model layer would hold a different file and get a different digest.</p> <p>Nothing pins a file the build downloads from a server, except the build itself. perevod 0.3.1 keeps the model in a folder of its own and deletes everything else under <code class="language-plaintext highlighter-rouge">~/.cache</code> in the same step, which is the line you saw in the Dockerfile.</p> <div class="callout callout-key"> <p class="callout-label">Key point</p> <p>The lesson in it is general: a step that runs a program records everything that program writes, not only what you asked for. Look inside a layer at least once.</p> </div> <p>Now run the image. A container is, at heart, a process that sees the image’s folder as its whole filesystem.</p> <p>Docker arranges that with the kernel’s namespaces, which a notebook can’t use, but there’s a simpler trick that’s enough here: run the image’s own Python through the image’s own dynamic loader, the program that starts every Linux binary and loads its libraries.</p> <p>Pointed at the image’s libraries, it runs the image’s Python with the image’s C library and the image’s packages, whatever this machine has installed. The environment comes from the image’s config, with its paths moved into the folder:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">config</span> <span class="o">=</span> <span class="n">configs</span><span class="p">[</span><span class="n">ARCH</span><span class="p">][</span><span class="sh">"</span><span class="s">config</span><span class="sh">"</span><span class="p">]</span>
<span class="n">env</span> <span class="o">=</span> <span class="p">{}</span>
<span class="k">for</span> <span class="n">item</span> <span class="ow">in</span> <span class="n">config</span><span class="p">[</span><span class="sh">"</span><span class="s">Env</span><span class="sh">"</span><span class="p">]:</span>
    <span class="n">name</span><span class="p">,</span> <span class="n">value</span> <span class="o">=</span> <span class="n">item</span><span class="p">.</span><span class="nf">split</span><span class="p">(</span><span class="sh">"</span><span class="s">=</span><span class="sh">"</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
    <span class="k">if</span> <span class="n">value</span><span class="p">.</span><span class="nf">startswith</span><span class="p">(</span><span class="sh">"</span><span class="s">/home/</span><span class="sh">"</span><span class="p">):</span>
        <span class="n">value</span> <span class="o">=</span> <span class="nf">str</span><span class="p">(</span><span class="n">ROOT</span><span class="p">)</span> <span class="o">+</span> <span class="n">value</span>  <span class="c1"># a path inside the image
</span>    <span class="n">env</span><span class="p">[</span><span class="n">name</span><span class="p">]</span> <span class="o">=</span> <span class="n">value</span>
<span class="n">env</span><span class="p">[</span><span class="sh">"</span><span class="s">PATH</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="n">os</span><span class="p">.</span><span class="n">environ</span><span class="p">[</span><span class="sh">"</span><span class="s">PATH</span><span class="sh">"</span><span class="p">]</span>
<span class="n">env</span><span class="p">[</span><span class="sh">"</span><span class="s">HOME</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="nf">str</span><span class="p">(</span><span class="n">ROOT</span> <span class="o">/</span> <span class="sh">"</span><span class="s">home/perevod</span><span class="sh">"</span><span class="p">)</span>
<span class="n">env</span><span class="p">[</span><span class="sh">"</span><span class="s">PYTHONHOME</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="nf">str</span><span class="p">(</span><span class="n">ROOT</span> <span class="o">/</span> <span class="sh">"</span><span class="s">usr/local</span><span class="sh">"</span><span class="p">)</span>
<span class="n">env</span><span class="p">[</span><span class="sh">"</span><span class="s">HF_HUB_DISABLE_PROGRESS_BARS</span><span class="sh">"</span><span class="p">]</span> <span class="o">=</span> <span class="sh">"</span><span class="s">1</span><span class="sh">"</span>
<span class="n">libraries</span> <span class="o">=</span> <span class="p">[</span><span class="n">ROOT</span> <span class="o">/</span> <span class="sh">"</span><span class="s">usr/local/lib</span><span class="sh">"</span><span class="p">,</span> <span class="n">ROOT</span> <span class="o">/</span> <span class="sh">"</span><span class="s">usr/lib</span><span class="sh">"</span> <span class="o">/</span> <span class="n">TRIPLET</span><span class="p">]</span>
<span class="n">PYTHON</span> <span class="o">=</span> <span class="p">[</span><span class="nf">str</span><span class="p">(</span><span class="n">ROOT</span> <span class="o">/</span> <span class="sh">"</span><span class="s">usr/lib</span><span class="sh">"</span> <span class="o">/</span> <span class="n">TRIPLET</span> <span class="o">/</span> <span class="n">LOADER</span><span class="p">),</span> <span class="sh">"</span><span class="s">--library-path</span><span class="sh">"</span><span class="p">,</span>
          <span class="sh">"</span><span class="s">:</span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="nf">str</span><span class="p">(</span><span class="n">path</span><span class="p">)</span> <span class="k">for</span> <span class="n">path</span> <span class="ow">in</span> <span class="n">libraries</span><span class="p">),</span> <span class="nf">str</span><span class="p">(</span><span class="n">ROOT</span> <span class="o">/</span> <span class="sh">"</span><span class="s">usr/local/bin/python3.12</span><span class="sh">"</span><span class="p">)]</span>
<span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="p">[</span><span class="sh">"</span><span class="s">HF_HUB_OFFLINE</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">HF_HUB_CACHE</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">PYTHON_VERSION</span><span class="sh">"</span><span class="p">]:</span>
    <span class="nf">print</span><span class="p">(</span><span class="n">name</span><span class="p">,</span> <span class="sh">"</span><span class="s">=</span><span class="sh">"</span><span class="p">,</span> <span class="n">env</span><span class="p">[</span><span class="n">name</span><span class="p">])</span>

<span class="n">probe</span> <span class="o">=</span> <span class="sh">"""</span><span class="s">
import sys, torch, perevod
from perevod import Translator
translator = Translator.from_pretrained(device=</span><span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span><span class="s">)
print(</span><span class="sh">"</span><span class="s">Python</span><span class="sh">"</span><span class="s">, sys.version.split()[0], </span><span class="sh">"</span><span class="s">| torch</span><span class="sh">"</span><span class="s">, torch.__version__,
      </span><span class="sh">"</span><span class="s">| perevod</span><span class="sh">"</span><span class="s">, perevod.__version__)
print(</span><span class="sh">"</span><span class="s">model:</span><span class="sh">"</span><span class="s">, translator.source)
</span><span class="sh">"""</span>
<span class="n">result</span> <span class="o">=</span> <span class="n">subprocess</span><span class="p">.</span><span class="nf">run</span><span class="p">([</span><span class="o">*</span><span class="n">PYTHON</span><span class="p">,</span> <span class="sh">"</span><span class="s">-c</span><span class="sh">"</span><span class="p">,</span> <span class="n">probe</span><span class="p">],</span> <span class="n">env</span><span class="o">=</span><span class="n">env</span><span class="p">,</span> <span class="n">capture_output</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">text</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="n">result</span><span class="p">.</span><span class="n">stdout</span><span class="p">.</span><span class="nf">strip</span><span class="p">()</span> <span class="ow">or</span> <span class="n">result</span><span class="p">.</span><span class="n">stderr</span><span class="p">[</span><span class="o">-</span><span class="mi">2000</span><span class="p">:])</span>
</code></pre></div></div> <pre class="tfs-printed"><code>HF_HUB_OFFLINE = 1
HF_HUB_CACHE = /kaggle/working/tfs/rootfs/home/perevod/models
PYTHON_VERSION = 3.12.16
Python 3.12.16 | torch 2.14.1+cpu | perevod 0.3.1
model: xmarva/perevod-en-ru@4abc0d63e862ca99d2bd99cd1007e4a9fe47c358</code></pre> <p>Python 3.12 from the image, its PyTorch, its perevod, and the model loaded from inside it with the Hub switched off. This notebook’s own Python is a different version, with a different PyTorch, which makes a good experiment: install the package from the source the notebook has been editing, translate the same sentences both ways, and compare.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">PIP_INSTALL</span> <span class="o">=</span> <span class="p">[</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">-m</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">pip</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">install</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-q</span><span class="sh">"</span><span class="p">]</span>
<span class="n">subprocess</span><span class="p">.</span><span class="nf">run</span><span class="p">([</span><span class="o">*</span><span class="n">PIP_INSTALL</span><span class="p">,</span> <span class="sh">"</span><span class="s">./perevod[test,serve]</span><span class="sh">"</span><span class="p">],</span> <span class="n">check</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">importlib</span><span class="p">.</span><span class="nf">invalidate_caches</span><span class="p">()</span>

<span class="kn">import</span> <span class="n">perevod</span>
<span class="kn">from</span> <span class="n">perevod</span> <span class="kn">import</span> <span class="n">Translator</span><span class="p">,</span> <span class="n">decoding</span>

<span class="n">DATA_REVISION</span> <span class="o">=</span> <span class="sh">"</span><span class="s">540be5b93bf77cd0846b02d55f2558a5596887a9</span><span class="sh">"</span>
<span class="n">test_path</span> <span class="o">=</span> <span class="nf">hf_hub_download</span><span class="p">(</span><span class="sh">"</span><span class="s">xmarva/tfs-tatoeba-en-ru</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">data/test.parquet</span><span class="sh">"</span><span class="p">,</span>
                            <span class="n">repo_type</span><span class="o">=</span><span class="sh">"</span><span class="s">dataset</span><span class="sh">"</span><span class="p">,</span> <span class="n">revision</span><span class="o">=</span><span class="n">DATA_REVISION</span><span class="p">)</span>
<span class="n">sentences</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nf">read_parquet</span><span class="p">(</span><span class="n">test_path</span><span class="p">)[</span><span class="sh">"</span><span class="s">en</span><span class="sh">"</span><span class="p">].</span><span class="nf">sample</span><span class="p">(</span><span class="mi">200</span><span class="p">,</span> <span class="n">random_state</span><span class="o">=</span><span class="n">SEED</span><span class="p">).</span><span class="nf">tolist</span><span class="p">()</span>

<span class="n">translator</span> <span class="o">=</span> <span class="n">Translator</span><span class="p">.</span><span class="nf">from_pretrained</span><span class="p">(</span><span class="n">device</span><span class="o">=</span><span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span><span class="p">)</span>
<span class="n">here</span> <span class="o">=</span> <span class="n">translator</span><span class="p">.</span><span class="nf">translate</span><span class="p">(</span><span class="n">sentences</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">this notebook: Python</span><span class="sh">"</span><span class="p">,</span> <span class="n">sys</span><span class="p">.</span><span class="n">version</span><span class="p">.</span><span class="nf">split</span><span class="p">()[</span><span class="mi">0</span><span class="p">],</span> <span class="sh">"</span><span class="s">| torch</span><span class="sh">"</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="n">__version__</span><span class="p">,</span>
      <span class="sh">"</span><span class="s">| perevod</span><span class="sh">"</span><span class="p">,</span> <span class="n">perevod</span><span class="p">.</span><span class="n">__version__</span><span class="p">)</span>

<span class="n">job</span> <span class="o">=</span> <span class="sh">"""</span><span class="s">
import json, sys
from perevod import Translator
sentences = json.load(sys.stdin)
translations = Translator.from_pretrained(device=</span><span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span><span class="s">).translate(sentences)
print(json.dumps(translations, ensure_ascii=False))
</span><span class="sh">"""</span>
<span class="n">result</span> <span class="o">=</span> <span class="n">subprocess</span><span class="p">.</span><span class="nf">run</span><span class="p">([</span><span class="o">*</span><span class="n">PYTHON</span><span class="p">,</span> <span class="sh">"</span><span class="s">-c</span><span class="sh">"</span><span class="p">,</span> <span class="n">job</span><span class="p">],</span> <span class="n">env</span><span class="o">=</span><span class="n">env</span><span class="p">,</span> <span class="nb">input</span><span class="o">=</span><span class="n">json</span><span class="p">.</span><span class="nf">dumps</span><span class="p">(</span><span class="n">sentences</span><span class="p">),</span>
                        <span class="n">capture_output</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">text</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">check</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">there</span> <span class="o">=</span> <span class="n">json</span><span class="p">.</span><span class="nf">loads</span><span class="p">(</span><span class="n">result</span><span class="p">.</span><span class="n">stdout</span><span class="p">)</span>
<span class="n">same</span> <span class="o">=</span> <span class="mi">0</span>
<span class="k">for</span> <span class="n">a</span><span class="p">,</span> <span class="n">b</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">here</span><span class="p">,</span> <span class="n">there</span><span class="p">,</span> <span class="n">strict</span><span class="o">=</span><span class="bp">True</span><span class="p">):</span>
    <span class="k">if</span> <span class="n">a</span> <span class="o">==</span> <span class="n">b</span><span class="p">:</span>
        <span class="n">same</span> <span class="o">+=</span> <span class="mi">1</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">identical translations: </span><span class="si">{</span><span class="n">same</span><span class="si">}</span><span class="s"> of </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">sentences</span><span class="p">)</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>this notebook: Python 3.13.15 | torch 2.11.0+cpu | perevod 0.3.1
identical translations: 200 of 200</code></pre> <p>A different Python and a different PyTorch, and here every translation came out the same. That isn’t guaranteed.</p> <p>PyTorch’s kernels change between versions, and so does the order of their arithmetic; when two hypotheses in a beam are nearly tied, a difference in the last digit of a score picks a different one. The image is how you stop wondering whether that will happen to you.</p> <p>Finally the image’s own command, the server, started the same way, and asked the question that 0.3 added:</p> <p>(On Kaggle and Colab nothing else is listening on port 8009; on your machine, pick a free port.)</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">start_server</span> <span class="o">=</span> <span class="sh">"</span><span class="s">from perevod.server import main; main([</span><span class="sh">'</span><span class="s">--port</span><span class="sh">'</span><span class="s">, </span><span class="sh">'</span><span class="s">8009</span><span class="sh">'</span><span class="s">])</span><span class="sh">"</span>
<span class="n">server</span> <span class="o">=</span> <span class="n">subprocess</span><span class="p">.</span><span class="nc">Popen</span><span class="p">([</span><span class="o">*</span><span class="n">PYTHON</span><span class="p">,</span> <span class="sh">"</span><span class="s">-c</span><span class="sh">"</span><span class="p">,</span> <span class="n">start_server</span><span class="p">],</span> <span class="n">env</span><span class="o">=</span><span class="n">env</span><span class="p">,</span>
                          <span class="n">stdout</span><span class="o">=</span><span class="n">subprocess</span><span class="p">.</span><span class="n">DEVNULL</span><span class="p">,</span> <span class="n">stderr</span><span class="o">=</span><span class="n">subprocess</span><span class="p">.</span><span class="n">DEVNULL</span><span class="p">)</span>
<span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">120</span><span class="p">):</span>  <span class="c1"># up to a minute for the server to start
</span>    <span class="k">try</span><span class="p">:</span>
        <span class="n">health</span> <span class="o">=</span> <span class="n">requests</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="sh">"</span><span class="s">http://127.0.0.1:8009/health</span><span class="sh">"</span><span class="p">,</span> <span class="n">timeout</span><span class="o">=</span><span class="mi">1</span><span class="p">).</span><span class="nf">json</span><span class="p">()</span>
        <span class="k">break</span>
    <span class="k">except</span> <span class="n">requests</span><span class="p">.</span><span class="nb">ConnectionError</span><span class="p">:</span>
        <span class="n">time</span><span class="p">.</span><span class="nf">sleep</span><span class="p">(</span><span class="mf">0.5</span><span class="p">)</span>
<span class="n">question</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">text</span><span class="sh">"</span><span class="p">:</span> <span class="sh">"</span><span class="s">Tom is afraid of the dark.</span><span class="sh">"</span><span class="p">}</span>
<span class="n">answer</span> <span class="o">=</span> <span class="n">requests</span><span class="p">.</span><span class="nf">post</span><span class="p">(</span><span class="sh">"</span><span class="s">http://127.0.0.1:8009/translate</span><span class="sh">"</span><span class="p">,</span> <span class="n">json</span><span class="o">=</span><span class="n">question</span><span class="p">)</span>
<span class="n">server</span><span class="p">.</span><span class="nf">terminate</span><span class="p">()</span>
<span class="n">server</span><span class="p">.</span><span class="nf">wait</span><span class="p">()</span>
<span class="nf">print</span><span class="p">(</span><span class="n">health</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="n">answer</span><span class="p">.</span><span class="nf">json</span><span class="p">())</span>
</code></pre></div></div> <pre class="tfs-printed"><code>{'status': 'ok', 'version': '0.3.1', 'model': 'xmarva/perevod-en-ru@4abc0d63e862ca99d2bd99cd1007e4a9fe47c358'}
{'translation': 'Том боится темноты.'}</code></pre> <p>That’s the image working, minus what Docker adds on top: its own process tree, network and hostname (namespaces), limits on CPU and memory (cgroups), and a root filesystem the process can’t see past.</p> <p>Our trick shares all of those with the notebook, which is fine for a check and no way to run a service. The unpacked image takes more than a gigabyte, so it goes:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">shutil</span><span class="p">.</span><span class="nf">rmtree</span><span class="p">(</span><span class="n">ROOT</span><span class="p">)</span>
</code></pre></div></div> <h2 id="8-the-same-model-in-a-browser">8. The same model in a browser</h2> <p>An image needs a machine to run on, and someone to pay for the machine. For a demo there’s a cheaper place to run a model this small: the visitor’s own device.</p> <p>The obvious host for a free demo used to be a Hugging Face Space with Gradio on a free CPU. That changed in July 2026: now “Gradio and Docker Spaces run on compute and require a paid plan to create”, while “Static Spaces are free for everyone”<sup class="cite">[<a href="#ref-11" id="cite-12" data-ref="11" aria-label="Reference 11: Hugging Face: Spaces overview and static Spaces.">11</a>]</sup>.</p> <p>A static Space serves files, HTML and JavaScript, and nothing stops one of those files from being a model. <a href="https://onnxruntime.ai/docs/tutorials/web/">ONNX Runtime Web</a> runs ONNX models in the browser with WebAssembly, and perevod’s weights take 38 MB. So the page downloads the model once, and every translation runs on the visitor’s processor: no server, and nothing typed leaves the device.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/tfs/09/browser-light.png" width="760" alt="The in-browser demo. A static Hugging Face Space serves the page, the tokenizer as JSON and two ONNX files: the encoder and one decoder step. In the visitor's browser, a JavaScript tokenizer turns the text into ids, ONNX Runtime Web runs the encoder once and the decoder step once per beam search step, and the beam search in JavaScript picks the translation" loading="lazy"> <img class="tfs-figure tfs-dark" src="/assets/posts/tfs/09/browser-dark.png" width="760" alt="The in-browser demo. A static Hugging Face Space serves the page, the tokenizer as JSON and two ONNX files: the encoder and one decoder step. In the visitor's browser, a JavaScript tokenizer turns the text into ids, ONNX Runtime Web runs the encoder once and the decoder step once per beam search step, and the beam search in JavaScript picks the translation" loading="lazy"></p> <p>ONNX is a file format for a computation graph: the operations of a network and its weights, readable by many runtimes. The model goes in as two graphs. The <strong>encoder</strong> runs once per sentence.</p> <p>The <strong>decoder step</strong> takes the hypotheses so far and returns the log-probabilities of the next token for each, so the beam search of <a href="/blog/2026/transformers-from-scratch-03-training/">lesson 3</a> stays outside the graph, written in JavaScript, where it’s a loop of forty lines.</p> <p>The step has no <a href="/blog/2025/inference-optimization/">KV cache</a>, so each step recomputes the whole prefix; for short sentences that costs less than it sounds, and keeps the graph simple.</p> <p>The export is a script in the course repository, next to the page’s files:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nf">write</span><span class="p">(</span><span class="sh">"</span><span class="s">space/export_onnx.py</span><span class="sh">"</span><span class="p">,</span> <span class="sh">'''</span><span class="s">
# Export perevod</span><span class="sh">'</span><span class="s">s model to the two ONNX graphs of the in-browser demo:
#   encoder.onnx: source ids -&gt; memory
#   decoder.onnx: hypotheses, memory, source ids -&gt; log-probabilities of the next token
# and the tokenizer, which the page loads as it is.
# Usage: python export_onnx.py --out model
import argparse
import logging
from pathlib import Path

import torch
from torch.export import Dim

from perevod import Translator, decoding


class Encoder(torch.nn.Module):
    def __init__(self, model):
        super().__init__()
        self.model = model

    def forward(self, src):
        return self.model.encode(src)


class DecoderStep(torch.nn.Module):
    def __init__(self, model):
        super().__init__()
        self.model = model

    def forward(self, tgt, memory, src):
        return self.model.decode(tgt, memory, src)[:, -1].log_softmax(-1)


def main():
    parser = argparse.ArgumentParser(description=</span><span class="sh">"</span><span class="s">Export perevod</span><span class="sh">'</span><span class="s">s model to ONNX</span><span class="sh">"</span><span class="s">)
    parser.add_argument(</span><span class="sh">"</span><span class="s">--out</span><span class="sh">"</span><span class="s">, default=</span><span class="sh">"</span><span class="s">model</span><span class="sh">"</span><span class="s">)
    out = Path(parser.parse_args().out)
    out.mkdir(parents=True, exist_ok=True)
    logging.getLogger(</span><span class="sh">"</span><span class="s">torch.onnx</span><span class="sh">"</span><span class="s">).setLevel(logging.ERROR)  # the exporter is chatty
    translator = Translator.from_pretrained(device=</span><span class="sh">"</span><span class="s">cpu</span><span class="sh">"</span><span class="s">)
    model = translator.model
    _, bos, _ = decoding.special_ids(translator.tokenizer)
    ids = decoding.source_ids(translator.tokenizer, </span><span class="sh">"</span><span class="s">Tom is afraid of the dark.</span><span class="sh">"</span><span class="s">, 256)
    src = torch.tensor([ids, ids])  # two rows, three target tokens: any sizes above one do
    tgt = torch.tensor([[bos, bos, bos], [bos, bos, bos]])
    batch = Dim(</span><span class="sh">"</span><span class="s">batch</span><span class="sh">"</span><span class="s">)
    source = Dim(</span><span class="sh">"</span><span class="s">source</span><span class="sh">"</span><span class="s">, max=256)  # the model</span><span class="sh">'</span><span class="s">s positions
    target = Dim(</span><span class="sh">"</span><span class="s">target</span><span class="sh">"</span><span class="s">, max=256)
    # export leaves a module in the mode it found it in, and a new module starts in training
    # mode: without eval() the wrappers would switch the model</span><span class="sh">'</span><span class="s">s dropout back on afterwards
    encoder = Encoder(model).eval()
    step = DecoderStep(model).eval()
    with torch.no_grad():
        memory = model.encode(src)
        torch.onnx.export(encoder, (src,), out / </span><span class="sh">"</span><span class="s">encoder.onnx</span><span class="sh">"</span><span class="s">, input_names=[</span><span class="sh">"</span><span class="s">src</span><span class="sh">"</span><span class="s">],
                          output_names=[</span><span class="sh">"</span><span class="s">memory</span><span class="sh">"</span><span class="s">], external_data=False, verbose=False,
                          dynamic_shapes={</span><span class="sh">"</span><span class="s">src</span><span class="sh">"</span><span class="s">: {0: batch, 1: source}})
        torch.onnx.export(step, (tgt, memory, src), out / </span><span class="sh">"</span><span class="s">decoder.onnx</span><span class="sh">"</span><span class="s">,
                          input_names=[</span><span class="sh">"</span><span class="s">tgt</span><span class="sh">"</span><span class="s">, </span><span class="sh">"</span><span class="s">memory</span><span class="sh">"</span><span class="s">, </span><span class="sh">"</span><span class="s">src</span><span class="sh">"</span><span class="s">], output_names=[</span><span class="sh">"</span><span class="s">logp</span><span class="sh">"</span><span class="s">],
                          external_data=False, verbose=False,
                          dynamic_shapes={</span><span class="sh">"</span><span class="s">tgt</span><span class="sh">"</span><span class="s">: {0: batch, 1: target},
                                          </span><span class="sh">"</span><span class="s">memory</span><span class="sh">"</span><span class="s">: {0: batch, 1: source},
                                          </span><span class="sh">"</span><span class="s">src</span><span class="sh">"</span><span class="s">: {0: batch, 1: source}})
    translator.tokenizer.save(str(out / </span><span class="sh">"</span><span class="s">tokenizer.json</span><span class="sh">"</span><span class="s">))  # the page needs it too
    for path in sorted(out.glob(</span><span class="sh">"</span><span class="s">*.onnx</span><span class="sh">"</span><span class="s">)):
        print(f</span><span class="sh">"</span><span class="s">{path.name}: {path.stat().st_size / 1e6:.1f} MB</span><span class="sh">"</span><span class="s">)


if __name__ == </span><span class="sh">"</span><span class="s">__main__</span><span class="sh">"</span><span class="s">:
    main()
</span><span class="sh">'''</span><span class="p">)</span>
</code></pre></div></div> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">ONNX</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">onnx==1.19.1</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">onnxscript==0.7.2</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">onnxruntime==1.31.1</span><span class="sh">"</span><span class="p">]</span>
<span class="n">subprocess</span><span class="p">.</span><span class="nf">run</span><span class="p">([</span><span class="o">*</span><span class="n">PIP_INSTALL</span><span class="p">,</span> <span class="o">*</span><span class="n">ONNX</span><span class="p">],</span> <span class="n">check</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">result</span> <span class="o">=</span> <span class="n">subprocess</span><span class="p">.</span><span class="nf">run</span><span class="p">([</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">,</span> <span class="sh">"</span><span class="s">space/export_onnx.py</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">--out</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">space/model</span><span class="sh">"</span><span class="p">],</span>
                        <span class="n">capture_output</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">text</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">check</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="n">result</span><span class="p">.</span><span class="n">stdout</span><span class="p">.</span><span class="nf">strip</span><span class="p">())</span>
</code></pre></div></div> <pre class="tfs-printed"><code>decoder.onnx: 29.6 MB
encoder.onnx: 26.3 MB</code></pre> <p>The two graphs share the embeddings in PyTorch, so together they’re larger than the weights: each file carries its own copy. <code class="language-plaintext highlighter-rouge">Dim</code> tells the exporter which sizes may change between calls: the number of hypotheses, and the lengths of the source and of the translation so far.</p> <p>Before anything goes near a browser, check that the graphs compute what PyTorch computes. ONNX Runtime has a Python package with the same engine:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">onnxruntime</span> <span class="k">as</span> <span class="n">ort</span>

<span class="n">encoder</span> <span class="o">=</span> <span class="n">ort</span><span class="p">.</span><span class="nc">InferenceSession</span><span class="p">(</span><span class="sh">"</span><span class="s">space/model/encoder.onnx</span><span class="sh">"</span><span class="p">)</span>
<span class="n">decoder</span> <span class="o">=</span> <span class="n">ort</span><span class="p">.</span><span class="nc">InferenceSession</span><span class="p">(</span><span class="sh">"</span><span class="s">space/model/decoder.onnx</span><span class="sh">"</span><span class="p">)</span>
<span class="n">pad_id</span><span class="p">,</span> <span class="n">bos_id</span><span class="p">,</span> <span class="n">eos_id</span> <span class="o">=</span> <span class="n">decoding</span><span class="p">.</span><span class="nf">special_ids</span><span class="p">(</span><span class="n">translator</span><span class="p">.</span><span class="n">tokenizer</span><span class="p">)</span>

<span class="n">src</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">([</span><span class="n">decoding</span><span class="p">.</span><span class="nf">source_ids</span><span class="p">(</span><span class="n">translator</span><span class="p">.</span><span class="n">tokenizer</span><span class="p">,</span> <span class="n">sentences</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="mi">256</span><span class="p">)])</span>
<span class="n">tgt</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">([[</span><span class="n">bos_id</span><span class="p">]])</span>
<span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">memory</span> <span class="o">=</span> <span class="n">translator</span><span class="p">.</span><span class="n">model</span><span class="p">.</span><span class="nf">encode</span><span class="p">(</span><span class="n">src</span><span class="p">)</span>
    <span class="n">expected</span> <span class="o">=</span> <span class="n">translator</span><span class="p">.</span><span class="n">model</span><span class="p">.</span><span class="nf">decode</span><span class="p">(</span><span class="n">tgt</span><span class="p">,</span> <span class="n">memory</span><span class="p">,</span> <span class="n">src</span><span class="p">)[:,</span> <span class="o">-</span><span class="mi">1</span><span class="p">].</span><span class="nf">log_softmax</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">).</span><span class="nf">numpy</span><span class="p">()</span>
<span class="n">onnx_memory</span> <span class="o">=</span> <span class="n">encoder</span><span class="p">.</span><span class="nf">run</span><span class="p">(</span><span class="bp">None</span><span class="p">,</span> <span class="p">{</span><span class="sh">"</span><span class="s">src</span><span class="sh">"</span><span class="p">:</span> <span class="n">src</span><span class="p">.</span><span class="nf">numpy</span><span class="p">()})[</span><span class="mi">0</span><span class="p">]</span>
<span class="n">got</span> <span class="o">=</span> <span class="n">decoder</span><span class="p">.</span><span class="nf">run</span><span class="p">(</span><span class="bp">None</span><span class="p">,</span> <span class="p">{</span><span class="sh">"</span><span class="s">tgt</span><span class="sh">"</span><span class="p">:</span> <span class="n">tgt</span><span class="p">.</span><span class="nf">numpy</span><span class="p">(),</span> <span class="sh">"</span><span class="s">memory</span><span class="sh">"</span><span class="p">:</span> <span class="n">onnx_memory</span><span class="p">,</span> <span class="sh">"</span><span class="s">src</span><span class="sh">"</span><span class="p">:</span> <span class="n">src</span><span class="p">.</span><span class="nf">numpy</span><span class="p">()})[</span><span class="mi">0</span><span class="p">]</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">largest difference in log-probabilities:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">float</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">abs</span><span class="p">(</span><span class="n">got</span> <span class="o">-</span> <span class="n">expected</span><span class="p">).</span><span class="nf">max</span><span class="p">()))</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">the same first token:</span><span class="sh">"</span><span class="p">,</span> <span class="nf">int</span><span class="p">(</span><span class="n">got</span><span class="p">.</span><span class="nf">argmax</span><span class="p">())</span> <span class="o">==</span> <span class="nf">int</span><span class="p">(</span><span class="n">expected</span><span class="p">.</span><span class="nf">argmax</span><span class="p">()))</span>
</code></pre></div></div> <pre class="tfs-printed"><code>largest difference in log-probabilities: 7.62939453125e-06
the same first token: True</code></pre> <p>The differences are in the fifth or sixth decimal place: the same arithmetic, done in a different order. What matters is the translations. Here is lesson 3’s beam search once more, written against the two graphs the way the page’s JavaScript does it, step for step: every hypothesis is fed again whole, and the four best continuations survive.</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">length_penalty</span><span class="p">(</span><span class="n">length</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.6</span><span class="p">):</span>
    <span class="nf">return </span><span class="p">((</span><span class="mi">5</span> <span class="o">+</span> <span class="n">length</span><span class="p">)</span> <span class="o">/</span> <span class="mi">6</span><span class="p">)</span> <span class="o">**</span> <span class="n">alpha</span>


<span class="k">def</span> <span class="nf">onnx_translate</span><span class="p">(</span><span class="n">sentence</span><span class="p">,</span> <span class="n">beam_size</span><span class="o">=</span><span class="mi">4</span><span class="p">,</span> <span class="n">max_tokens</span><span class="o">=</span><span class="mi">128</span><span class="p">):</span>
    <span class="n">ids</span> <span class="o">=</span> <span class="n">decoding</span><span class="p">.</span><span class="nf">source_ids</span><span class="p">(</span><span class="n">translator</span><span class="p">.</span><span class="n">tokenizer</span><span class="p">,</span> <span class="n">sentence</span><span class="p">,</span> <span class="mi">256</span><span class="p">)</span>
    <span class="n">src</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">array</span><span class="p">([</span><span class="n">ids</span><span class="p">],</span> <span class="n">dtype</span><span class="o">=</span><span class="n">np</span><span class="p">.</span><span class="n">int64</span><span class="p">)</span>
    <span class="n">memory</span> <span class="o">=</span> <span class="n">encoder</span><span class="p">.</span><span class="nf">run</span><span class="p">(</span><span class="bp">None</span><span class="p">,</span> <span class="p">{</span><span class="sh">"</span><span class="s">src</span><span class="sh">"</span><span class="p">:</span> <span class="n">src</span><span class="p">})[</span><span class="mi">0</span><span class="p">]</span>
    <span class="n">beams</span> <span class="o">=</span> <span class="p">[([</span><span class="n">bos_id</span><span class="p">],</span> <span class="mf">0.0</span><span class="p">)]</span>
    <span class="n">finished</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">max_tokens</span><span class="p">):</span>
        <span class="n">n</span> <span class="o">=</span> <span class="nf">len</span><span class="p">(</span><span class="n">beams</span><span class="p">)</span>
        <span class="n">tgt</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">array</span><span class="p">([</span><span class="n">tokens</span> <span class="k">for</span> <span class="n">tokens</span><span class="p">,</span> <span class="n">score</span> <span class="ow">in</span> <span class="n">beams</span><span class="p">],</span> <span class="n">dtype</span><span class="o">=</span><span class="n">np</span><span class="p">.</span><span class="n">int64</span><span class="p">)</span>
        <span class="n">feeds</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">tgt</span><span class="sh">"</span><span class="p">:</span> <span class="n">tgt</span><span class="p">,</span> <span class="sh">"</span><span class="s">memory</span><span class="sh">"</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="nf">repeat</span><span class="p">(</span><span class="n">memory</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">0</span><span class="p">),</span>
                 <span class="sh">"</span><span class="s">src</span><span class="sh">"</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="nf">repeat</span><span class="p">(</span><span class="n">src</span><span class="p">,</span> <span class="n">n</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">0</span><span class="p">)}</span>
        <span class="n">logp</span> <span class="o">=</span> <span class="n">decoder</span><span class="p">.</span><span class="nf">run</span><span class="p">(</span><span class="bp">None</span><span class="p">,</span> <span class="n">feeds</span><span class="p">)[</span><span class="mi">0</span><span class="p">]</span>
        <span class="n">candidates</span> <span class="o">=</span> <span class="p">[]</span>
        <span class="nf">for </span><span class="p">(</span><span class="n">tokens</span><span class="p">,</span> <span class="n">score</span><span class="p">),</span> <span class="n">row</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">beams</span><span class="p">,</span> <span class="n">logp</span><span class="p">):</span>
            <span class="k">for</span> <span class="n">token</span> <span class="ow">in</span> <span class="n">np</span><span class="p">.</span><span class="nf">argsort</span><span class="p">(</span><span class="o">-</span><span class="n">row</span><span class="p">,</span> <span class="n">kind</span><span class="o">=</span><span class="sh">"</span><span class="s">stable</span><span class="sh">"</span><span class="p">)[:</span><span class="n">beam_size</span><span class="p">]:</span>
                <span class="n">candidates</span><span class="p">.</span><span class="nf">append</span><span class="p">((</span><span class="n">tokens</span> <span class="o">+</span> <span class="p">[</span><span class="nf">int</span><span class="p">(</span><span class="n">token</span><span class="p">)],</span> <span class="n">score</span> <span class="o">+</span> <span class="nf">float</span><span class="p">(</span><span class="n">row</span><span class="p">[</span><span class="n">token</span><span class="p">])))</span>
        <span class="n">candidates</span><span class="p">.</span><span class="nf">sort</span><span class="p">(</span><span class="n">key</span><span class="o">=</span><span class="k">lambda</span> <span class="n">candidate</span><span class="p">:</span> <span class="n">candidate</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="n">reverse</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
        <span class="n">beams</span> <span class="o">=</span> <span class="p">[]</span>
        <span class="k">for</span> <span class="n">tokens</span><span class="p">,</span> <span class="n">score</span> <span class="ow">in</span> <span class="n">candidates</span><span class="p">:</span>
            <span class="k">if</span> <span class="n">tokens</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span> <span class="o">==</span> <span class="n">eos_id</span><span class="p">:</span>
                <span class="n">finished</span><span class="p">.</span><span class="nf">append</span><span class="p">((</span><span class="n">tokens</span><span class="p">,</span> <span class="n">score</span><span class="p">))</span>
            <span class="k">else</span><span class="p">:</span>
                <span class="n">beams</span><span class="p">.</span><span class="nf">append</span><span class="p">((</span><span class="n">tokens</span><span class="p">,</span> <span class="n">score</span><span class="p">))</span>
            <span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="n">beams</span><span class="p">)</span> <span class="o">==</span> <span class="n">beam_size</span><span class="p">:</span>
                <span class="k">break</span>
        <span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="n">finished</span><span class="p">)</span> <span class="o">&gt;=</span> <span class="n">beam_size</span> <span class="ow">or</span> <span class="ow">not</span> <span class="n">beams</span><span class="p">:</span>
            <span class="k">break</span>
    <span class="n">pool</span> <span class="o">=</span> <span class="n">finished</span> <span class="ow">or</span> <span class="n">beams</span>
    <span class="n">best</span><span class="p">,</span> <span class="n">best_score</span> <span class="o">=</span> <span class="n">pool</span><span class="p">[</span><span class="mi">0</span><span class="p">][</span><span class="mi">0</span><span class="p">],</span> <span class="o">-</span><span class="n">math</span><span class="p">.</span><span class="n">inf</span>
    <span class="k">for</span> <span class="n">tokens</span><span class="p">,</span> <span class="n">score</span> <span class="ow">in</span> <span class="n">pool</span><span class="p">:</span>
        <span class="n">normalized</span> <span class="o">=</span> <span class="n">score</span> <span class="o">/</span> <span class="nf">length_penalty</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">tokens</span><span class="p">)</span> <span class="o">-</span> <span class="mi">1</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">normalized</span> <span class="o">&gt;</span> <span class="n">best_score</span><span class="p">:</span>
            <span class="n">best</span><span class="p">,</span> <span class="n">best_score</span> <span class="o">=</span> <span class="n">tokens</span><span class="p">,</span> <span class="n">normalized</span>
    <span class="k">return</span> <span class="n">translator</span><span class="p">.</span><span class="n">tokenizer</span><span class="p">.</span><span class="nf">decode</span><span class="p">([</span><span class="n">token</span> <span class="k">for</span> <span class="n">token</span> <span class="ow">in</span> <span class="n">best</span><span class="p">[</span><span class="mi">1</span><span class="p">:]</span> <span class="k">if</span> <span class="n">token</span> <span class="o">!=</span> <span class="n">eos_id</span><span class="p">])</span>


<span class="n">start</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span>
<span class="n">through_onnx</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">sentence</span> <span class="ow">in</span> <span class="n">sentences</span><span class="p">:</span>
    <span class="n">through_onnx</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="nf">onnx_translate</span><span class="p">(</span><span class="n">sentence</span><span class="p">))</span>
<span class="n">same</span> <span class="o">=</span> <span class="mi">0</span>
<span class="k">for</span> <span class="n">a</span><span class="p">,</span> <span class="n">b</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">here</span><span class="p">,</span> <span class="n">through_onnx</span><span class="p">,</span> <span class="n">strict</span><span class="o">=</span><span class="bp">True</span><span class="p">):</span>
    <span class="k">if</span> <span class="n">a</span> <span class="o">==</span> <span class="n">b</span><span class="p">:</span>
        <span class="n">same</span> <span class="o">+=</span> <span class="mi">1</span>
<span class="n">seconds</span> <span class="o">=</span> <span class="n">time</span><span class="p">.</span><span class="nf">time</span><span class="p">()</span> <span class="o">-</span> <span class="n">start</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">identical to the package: </span><span class="si">{</span><span class="n">same</span><span class="si">}</span><span class="s"> of </span><span class="si">{</span><span class="nf">len</span><span class="p">(</span><span class="n">sentences</span><span class="p">)</span><span class="si">}</span><span class="s">, in </span><span class="si">{</span><span class="n">seconds</span><span class="si">:</span><span class="p">.</span><span class="mi">0</span><span class="n">f</span><span class="si">}</span><span class="s"> s</span><span class="sh">"</span><span class="p">)</span>
<span class="k">for</span> <span class="n">sentence</span><span class="p">,</span> <span class="n">translation</span> <span class="ow">in</span> <span class="nf">list</span><span class="p">(</span><span class="nf">zip</span><span class="p">(</span><span class="n">sentences</span><span class="p">,</span> <span class="n">through_onnx</span><span class="p">))[:</span><span class="mi">3</span><span class="p">]:</span>
    <span class="nf">print</span><span class="p">(</span><span class="n">sentence</span><span class="p">,</span> <span class="sh">"</span><span class="s">-&gt;</span><span class="sh">"</span><span class="p">,</span> <span class="n">translation</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>identical to the package: 200 of 200, in 35 s
The novel has been translated into German. -&gt; Роман был переведён на немецкий.
I wonder why you never told me about it. -&gt; Интересно, почему ты никогда мне об этом не рассказывал.
Arguing is no way to go about it. -&gt; И спорить об этом нет.</code></pre> <p>Word for word. The page itself is three small files in the course repository’s <a href="https://github.com/xmarva/transformers-from-scratch/tree/main/space"><code class="language-plaintext highlighter-rouge">space/</code></a> folder, and only one of them is about the page.</p> <p><code class="language-plaintext highlighter-rouge">translate.js</code> is the function above in JavaScript. <code class="language-plaintext highlighter-rouge">tokenizer.js</code> rewrites the tokenizer of <a href="/blog/2026/transformers-from-scratch-01-tokenization/">lesson 1</a>, whose <code class="language-plaintext highlighter-rouge">tokenizer.json</code> the page loads as it is, and it had one trap worth knowing.</p> <div class="callout callout-warn"> <p class="callout-label">Trap</p> <p>The tokenizer splits text into words with the regular expression <code class="language-plaintext highlighter-rouge">\w+</code>, and in the Rust library behind Hugging Face’s <code class="language-plaintext highlighter-rouge">tokenizers</code>, <code class="language-plaintext highlighter-rouge">\w</code> matches letters of every alphabet. In JavaScript it matches only <code class="language-plaintext highlighter-rouge">[A-Za-z0-9_]</code>, even with the Unicode flag, so a word like “naïve” or “Москва” would come apart.</p> </div> <p>The JavaScript version spells the classes out, <code class="language-plaintext highlighter-rouge">[\p{Alphabetic}\p{M}\p{Nd}\p{Pc}\p{Join_Control}]</code>, and a script in the same folder checks it against the original on every English sentence of the test set, id for id.</p> <p>The rest is a static Space: a <code class="language-plaintext highlighter-rouge">README.md</code> whose header says <code class="language-plaintext highlighter-rouge">sdk: static</code>, uploaded with the two graphs:</p> <div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>python space/export_onnx.py <span class="nt">--out</span> space/model
hf upload xmarva/perevod space <span class="nb">.</span> <span class="nt">--repo-type</span> space
</code></pre></div></div> <p>Here it is, <a href="https://huggingface.co/spaces/xmarva/perevod">xmarva/perevod</a>:</p> <p><img class="tfs-figure" src="/assets/posts/tfs/09/space.png" width="700" alt="The perevod page on Hugging Face Spaces: an English text box with 'My brother lives in a small town by the sea.', the Russian translation 'Мой брат живёт в маленьком городке у моря.' below it, the time the translation took on this device, a note that the model runs on the visitor's device and nothing typed leaves it, and four example sentences" loading="lazy"></p> <p>The first visit downloads the two graphs once, and the browser keeps them. After that the page works without a network, and the translation takes about as long as in this notebook, on whatever device it opened on. The model can’t do more there than here, of course; it’s the same model, with the same limits its card lists.</p> <p>Two ways to ship one model, then, for two jobs. The image is for running it as a service: the same bytes on every server, checkable by anyone, with nothing left to chance at startup.</p> <p>The page is for showing it to people: free, private, and limited by the visitor’s device. Both are built from the same weights at the same commit, and both were checked against the package, translation for translation.</p> <h2 id="9-release-031">9. Release 0.3.1</h2> <p>Before a release, the fast tests, which now include the health check that names the model:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="err">!</span><span class="n">cd</span> <span class="n">perevod</span> <span class="o">&amp;&amp;</span> <span class="p">{</span><span class="n">sys</span><span class="p">.</span><span class="n">executable</span><span class="p">}</span> <span class="o">-</span><span class="n">m</span> <span class="n">pytest</span> <span class="o">-</span><span class="n">q</span> <span class="o">-</span><span class="n">p</span> <span class="n">no</span><span class="p">:</span><span class="n">cacheprovider</span> <span class="o">-</span><span class="n">m</span> <span class="sh">"</span><span class="s">not slow</span><span class="sh">"</span> <span class="o">--</span><span class="n">color</span><span class="o">=</span><span class="n">no</span>
</code></pre></div></div> <pre class="tfs-printed"><code>........................                                                 [100%]
24 passed, 2 deselected in 6.97s
</code></pre> <p>The release is a commit and a tag, <code class="language-plaintext highlighter-rouge">perevod-v0.3.1</code>, and the image is whatever CI builds from them. That gives the notebook one last check: are the files it wrote and edited the same as the release’s?</p> <p>Only the files that go into the image count, the build context and the workflow. The lock files are compared without their first lines, where uv records the command, which here includes <code class="language-plaintext highlighter-rouge">--exclude-newer</code>:</p> <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">RELEASE</span> <span class="o">=</span> <span class="sh">"</span><span class="s">perevod-v0.3.1</span><span class="sh">"</span>
<span class="n">subprocess</span><span class="p">.</span><span class="nf">run</span><span class="p">([</span><span class="sh">"</span><span class="s">git</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">fetch</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-q</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">--depth</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">1</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">origin</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">tag</span><span class="sh">"</span><span class="p">,</span> <span class="n">RELEASE</span><span class="p">],</span> <span class="n">check</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="n">listed</span> <span class="o">=</span> <span class="n">subprocess</span><span class="p">.</span><span class="nf">run</span><span class="p">([</span><span class="sh">"</span><span class="s">git</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">ls-tree</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">-r</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">--name-only</span><span class="sh">"</span><span class="p">,</span> <span class="n">RELEASE</span><span class="p">,</span> <span class="sh">"</span><span class="s">perevod</span><span class="sh">"</span><span class="p">],</span>
                        <span class="n">capture_output</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">text</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">check</span><span class="o">=</span><span class="bp">True</span><span class="p">).</span><span class="n">stdout</span><span class="p">.</span><span class="nf">split</span><span class="p">()</span>
<span class="n">IMAGE_FILES</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">Dockerfile</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">.dockerignore</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">requirements.lock</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">build.lock</span><span class="sh">"</span><span class="p">,</span>
               <span class="sh">"</span><span class="s">pyproject.toml</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">README.md</span><span class="sh">"</span><span class="p">}</span>
<span class="n">context</span> <span class="o">=</span> <span class="p">[</span><span class="sh">"</span><span class="s">.github/workflows/image.yml</span><span class="sh">"</span><span class="p">]</span>
<span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">listed</span><span class="p">:</span>
    <span class="k">if</span> <span class="n">name</span><span class="p">.</span><span class="nf">startswith</span><span class="p">(</span><span class="sh">"</span><span class="s">perevod/src/</span><span class="sh">"</span><span class="p">)</span> <span class="ow">or</span> <span class="n">name</span><span class="p">.</span><span class="nf">removeprefix</span><span class="p">(</span><span class="sh">"</span><span class="s">perevod/</span><span class="sh">"</span><span class="p">)</span> <span class="ow">in</span> <span class="n">IMAGE_FILES</span><span class="p">:</span>
        <span class="n">context</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">name</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">without_command</span><span class="p">(</span><span class="n">text</span><span class="p">):</span>
    <span class="n">lines</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="k">for</span> <span class="n">line</span> <span class="ow">in</span> <span class="n">text</span><span class="p">.</span><span class="nf">splitlines</span><span class="p">():</span>
        <span class="k">if</span> <span class="ow">not</span> <span class="n">line</span><span class="p">.</span><span class="nf">startswith</span><span class="p">(</span><span class="sh">"</span><span class="s">#    uv pip compile</span><span class="sh">"</span><span class="p">):</span>
            <span class="n">lines</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">line</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">lines</span>


<span class="n">different</span> <span class="o">=</span> <span class="p">[]</span>
<span class="k">for</span> <span class="n">name</span> <span class="ow">in</span> <span class="n">context</span><span class="p">:</span>
    <span class="n">released</span> <span class="o">=</span> <span class="n">subprocess</span><span class="p">.</span><span class="nf">run</span><span class="p">([</span><span class="sh">"</span><span class="s">git</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">show</span><span class="sh">"</span><span class="p">,</span> <span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">RELEASE</span><span class="si">}</span><span class="s">:</span><span class="si">{</span><span class="n">name</span><span class="si">}</span><span class="sh">"</span><span class="p">],</span> <span class="n">capture_output</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
                              <span class="n">text</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">check</span><span class="o">=</span><span class="bp">True</span><span class="p">).</span><span class="n">stdout</span>
    <span class="k">if</span> <span class="nf">without_command</span><span class="p">(</span><span class="nc">Path</span><span class="p">(</span><span class="n">name</span><span class="p">).</span><span class="nf">read_text</span><span class="p">())</span> <span class="o">!=</span> <span class="nf">without_command</span><span class="p">(</span><span class="n">released</span><span class="p">):</span>
        <span class="n">different</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">name</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="nf">len</span><span class="p">(</span><span class="n">context</span><span class="p">),</span> <span class="sh">"</span><span class="s">files compared, different:</span><span class="sh">"</span><span class="p">,</span> <span class="n">different</span> <span class="ow">or</span> <span class="sh">"</span><span class="s">none</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div> <pre class="tfs-printed"><code>15 files compared, different: none</code></pre> <p>The notebook rebuilt the release’s inputs file for file, and CI turned them into <code class="language-plaintext highlighter-rouge">ghcr.io/xmarva/perevod:0.3.1</code>, the image section 7 took apart. On your machine:</p> <div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>docker run <span class="nt">--rm</span> <span class="nt">-p</span> 8000:8000 ghcr.io/xmarva/perevod:0.3.1
curl localhost:8000/health
</code></pre></div></div> <p>0.3.1 is a <strong>patch</strong> release in lesson 7’s terms: the package’s code is the same as in 0.3.0, and only the way the image is built changed. Pinned by its digest, the image will translate the same way in a year, on any machine that runs Docker, with or without a network. That was the point of the lesson.</p> <h2 id="references">References</h2> <ol class="tfs-refs"> <li id="ref-1"><a href="https://numpy.org/doc/stable/release/2.0.0-notes.html">NumPy 2.0.0 release notes</a>, and the error in practice: <a href="https://github.com/pytorch/pytorch/issues/129310#issuecomment-2185605356">PyTorch issue #129310</a>. <a class="ref-back" href="#cite-1" aria-label="Back to the text">↩</a></li> <li id="ref-2">Python Packaging User Guide: <a href="https://packaging.python.org/en/latest/discussions/install-requires-vs-requirements/">install_requires vs requirements files</a>. <a class="ref-back" href="#cite-3" aria-label="Back to the text">↩</a></li> <li id="ref-3">Stufft, D. (2013). <a href="https://caremad.io/posts/2013/07/setup-vs-requirement/">setup.py vs requirements.txt</a>. <em>Abstract and concrete dependencies.</em> <a class="ref-back" href="#cite-4" aria-label="Back to the text">↩</a></li> <li id="ref-4">pip: <a href="https://pip.pypa.io/en/stable/topics/secure-installs/">secure installs and hash-checking mode</a>; uv: <a href="https://docs.astral.sh/uv/reference/cli/#uv-pip-compile"><code class="language-plaintext highlighter-rouge">uv pip compile</code></a> and <a href="https://docs.astral.sh/uv/guides/integration/pytorch/">using uv with PyTorch</a>. <a class="ref-back" href="#cite-5" aria-label="Back to the text">↩</a></li> <li id="ref-5"><a href="https://github.com/docker-library/faq">docker-library FAQ</a> and Docker’s <a href="https://docs.docker.com/build/building/best-practices/">build best practices</a>, on tags and digests. <a class="ref-back" href="#cite-6" aria-label="Back to the text">↩</a></li> <li id="ref-6"><a href="https://reproducible-builds.org/docs/definition/">reproducible-builds.org</a>: the definition, and <a href="https://reproducible-builds.org/docs/source-date-epoch/"><code class="language-plaintext highlighter-rouge">SOURCE_DATE_EPOCH</code></a>. <a class="ref-back" href="#cite-7" aria-label="Back to the text">↩</a></li> <li id="ref-7">BuildKit: <a href="https://github.com/moby/buildkit/blob/master/docs/build-repro.md">reproducible builds</a>; Docker: <a href="https://docs.docker.com/build/exporters/image-registry/">image exporter options</a>. <a class="ref-back" href="#cite-8" aria-label="Back to the text">↩</a></li> <li id="ref-8"><a href="https://peps.python.org/pep-0552/">PEP 552: Deterministic pycs</a>; <a href="https://docs.python.org/3/library/py_compile.html">py_compile</a>. <a class="ref-back" href="#cite-9" aria-label="Back to the text">↩</a></li> <li id="ref-9">GitHub: <a href="https://docs.github.com/en/actions/tutorials/publish-packages/publish-docker-images">publishing Docker images</a> and <a href="https://docs.github.com/en/packages/working-with-a-github-packages-registry/working-with-the-container-registry">the Container registry</a>. <a class="ref-back" href="#cite-10" aria-label="Back to the text">↩</a></li> <li id="ref-10">Python: <a href="https://docs.python.org/3/library/tarfile.html#tarfile-extraction-filter">tarfile extraction filters</a>; the dynamic loader: <a href="https://man7.org/linux/man-pages/man8/ld.so.8.html">ld.so(8)</a>. <a class="ref-back" href="#cite-11" aria-label="Back to the text">↩</a></li> <li id="ref-11">Hugging Face: <a href="https://huggingface.co/docs/hub/spaces-overview">Spaces overview</a> and <a href="https://huggingface.co/docs/hub/spaces-sdks-static">static Spaces</a>. <a class="ref-back" href="#cite-12" aria-label="Back to the text">↩</a></li> <li id="ref-12">Open Container Initiative: <a href="https://github.com/opencontainers/image-spec">image specification</a> (index, manifest, config, layers, descriptors) and <a href="https://github.com/opencontainers/distribution-spec/blob/main/spec.md">distribution specification</a>.</li> <li id="ref-13"><a href="https://huggingface.co/docs/huggingface_hub/package_reference/environment_variables">huggingface_hub environment variables</a> (<code class="language-plaintext highlighter-rouge">HF_HUB_CACHE</code>, <code class="language-plaintext highlighter-rouge">HF_HUB_OFFLINE</code>).</li> <li id="ref-14">PyTorch: <a href="https://docs.pytorch.org/docs/stable/onnx_export.html">exporting to ONNX</a>; <a href="https://onnxruntime.ai/docs/tutorials/web/">ONNX Runtime Web</a>.</li> </ol>]]></content> <author> <name>Eva Koroleva</name> </author> <category term="machine-learning"/> <category term="system-design"/> <category term="transformers-from-scratch"/> <category term="docker"/> <category term="reproducibility"/> <category term="onnx"/> <category term="mlops"/> <summary type="html"><![CDATA[Ship a model so that it runs the same next year: a lock file with hashes, an image pinned by digest, builds that give the same bytes twice, GitHub Actions publishing to GHCR, the image pulled and run without Docker, and the model exported to ONNX for a free in-browser demo.]]></summary> <media:thumbnail url="https://blog.korolevalab.com/assets/posts/tfs/09/cover.png"/> <media:content medium="image" url="https://blog.korolevalab.com/assets/posts/tfs/09/cover.png"/> </entry> <entry> <title type="html">Is it rational to be good? Game theory and the ethics of cooperation</title> <link href="https://blog.korolevalab.com/blog/2026/game-theory-ethics/" rel="alternate" type="text/html" title="Is it rational to be good? Game theory and the ethics of cooperation"/> <published>2025-12-11T12:00:00+00:00</published> <updated>2026-11-02T00:00:00+00:00</updated> <id>https://blog.korolevalab.com/blog/2026/game-theory-ethics</id> <content type="html" xml:base="https://blog.korolevalab.com/blog/2026/game-theory-ethics/"><![CDATA[<aside class="tldr"> <p class="tldr-label">In short</p> <p>Glaucon’s challenge in the <em>Republic</em>, that people are just only for fear of being wronged and that a ring of invisibility would make anyone unjust, has the structure of the prisoner’s dilemma: whatever the other player does, defecting pays more. Game theory answers him in part.</p> <p>For people who expect to meet again, who are watched by others and who cannot be sure that their rings will keep working, justice is very often the rational choice, and the models even say which kind: nice, firm, forgiving within limits, and clear.</p> <p>They do not answer the question Glaucon actually asked, whether justice is good in itself for someone whose ring never fails.</p> </aside> <p>In the second book of Plato’s <em>Republic</em>, Glaucon offers Socrates a challenge that moral philosophy has been answering ever since. People, he says, praise justice not for itself but for its consequences.</p> <p>Left to ourselves we would all prefer to wrong others and get away with it; we settle for justice because we fear being wronged more than we enjoy wronging.</p> <p>Justice, on this account, is “a mean or compromise, between the best of all, which is to do injustice and not be punished, and the worst of all, which is to suffer injustice without the power of retaliation” (<em>Republic</em> 359a)<sup class="cite">[<a href="#ref-1" id="cite-1" data-ref="1" aria-label="Reference 1: Plato. Republic, book II, 358e–360d. Translated by B. Jowett. Project Gutenberg #1497.">1</a>]</sup>.</p> <p>To make the point he tells the story of Gyges, a shepherd who finds a ring that makes him invisible, and uses it to seduce the queen, kill the king and take the throne.</p> <p>Give such a ring to a just man and to an unjust one, Glaucon says, and they will end up doing the same things, since “no man can be imagined to be of such an iron nature that he would stand fast in justice”, and “wherever any one thinks that he can safely be unjust, there he is unjust” (360b–c).</p> <p>Glaucon’s argument has a structure, and the structure has a name. Twenty-three centuries after the <em>Republic</em>, the mathematicians of game theory found it in a two-by-two table and called it the prisoner’s dilemma.</p> <p>The table turned the old question into a precise one: under which conditions is it rational to be just, and which kind of justice is rational?</p> <p>This essay follows the answers that game theory gives, from Hobbes to evolutionary simulations, and marks the point where they stop. The models are small enough to compute exactly, and every picture below is computed from them.</p> <h2 id="1-the-prisoners-dilemma">1. The prisoner’s dilemma</h2> <p>Two people can each do something for the other at a cost to themselves: keep a promise, share credit, return a favour. If both do, both are better off.</p> <p>If one does and the other doesn’t, the one who didn’t is best off of all and the one who did is worst off. If neither does, both lose what they could have had together.</p> <p>Game theory calls this structure the <em>prisoner’s dilemma</em>, after a story Albert Tucker told in 1950 to illustrate a game that Merrill Flood and Melvin Dresher had invented a few months earlier at the RAND Corporation<sup class="cite">[<a href="#ref-2" id="cite-2" data-ref="2" aria-label="Reference 2: Flood, M. M. (1952). Some Experimental Games. RAND Research Memorandum RM-789-1.">2</a>]</sup>.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/game-theory-ethics/dilemma-light.png" width="760" alt="The prisoner&#x27;s dilemma with Axelrod&#x27;s payoffs. Both cooperate: 3 points each. You cooperate and they defect: 0 for you, 5 for them. You defect and they cooperate: 5 for you, 0 for them. Both defect: 1 each. Whatever the other does, defecting gives you more, and two players who reason this way get 1 each" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/game-theory-ethics/dilemma-dark.png" width="760" alt="The prisoner&#x27;s dilemma with Axelrod&#x27;s payoffs. Both cooperate: 3 points each. You cooperate and they defect: 0 for you, 5 for them. You defect and they cooperate: 5 for you, 0 for them. Both defect: 1 each. Whatever the other does, defecting gives you more, and two players who reason this way get 1 each" loading="lazy"/></p> <p>Only the order of the four outcomes matters. The <em>temptation</em> to exploit beats the <em>reward</em> for mutual cooperation, which beats the <em>punishment</em> for mutual defection, which beats the <em>sucker’s payoff</em>:</p> \[T &gt; R &gt; P &gt; S, \qquad 2R &gt; T + S.\] <p>The second condition says that taking turns at exploiting each other is worse than cooperating, so that cooperation, not alternation, is what the two players lose. The numbers in the table, \(T = 5\), \(R = 3\), \(P = 1\), \(S = 0\), are the ones Robert Axelrod used, and the rest of this essay uses them too.</p> <p>The reasoning that follows is short and, within its assumptions, impeccable. Whatever the other player does, you do better by defecting: \(5 &gt; 3\) if they cooperate, \(1 &gt; 0\) if they don’t. Defection is a <em>dominant strategy</em>, and two players who see this end up with 1 point each, while 3 each was on the table.</p> <p>The outcome is a Nash equilibrium, since neither can gain by changing alone, and it is worse for both than another outcome they could have reached. Individual rationality, applied correctly by both, produces a result that both regard as a failure.</p> <p class="flow"><span>defecting pays whatever the other does</span><span>both players defect</span><span>1 point each instead of 3</span></p> <p>This is Glaucon’s compromise in miniature. Each would most like to wrong the other with impunity; each fears most to be wronged; and justice, mutual cooperation, is an agreement they would both welcome and neither has a reason to keep.</p> <h2 id="2-hobbes-changing-the-game">2. Hobbes: changing the game</h2> <p>Thomas Hobbes described the same structure as the condition of humanity without government.</p> <p>In the state of nature, where nobody can trust anybody to hold back, everyone has reason to strike first, and the result is a war of all against all, in which there is “no place for Industry; because the fruit thereof is uncertain”, and the life of man is “solitary, poore, nasty, brutish, and short” (<em>Leviathan</em>, ch. 13)<sup class="cite">[<a href="#ref-3" id="cite-3" data-ref="3" aria-label="Reference 3: Hobbes, T. (1651). Leviathan, chapters 13, 15 and 17 (pp. 62, 72–73 and 85 of the first edition). Project Gutenberg #3207.">3</a>]</sup>.</p> <p>Hobbes also gave Glaucon’s position its sharpest voice. “The Foole hath sayd in his heart, there is no such thing as Justice”, and he argues that “to make, or not make; keep, or not keep Covenants, was not against Reason, when it conduced to ones benefit” (ch. 15). The Foole is the player who has noticed that defection dominates.</p> <p>Hobbes’s reply is not that the Foole makes a logical error in the single case. It is that the Foole is not in a single case.</p> <p>A man who breaks his covenant, and declares that he may with reason do so, “cannot be received into any Society, that unite themselves for Peace and defence, but by the errour of them that receive him”, and “if he be left, or cast out of Society, he perisheth” (ch. 15).</p> <p>The Foole’s defection is a single move, but it tells everyone what kind of player he is, and the rest of the game is played against that knowledge.</p> <p>Hobbes’s remedy for the war of all against all, though, is not an argument but an institution:</p> <blockquote class="pull"> <p>Covenants, without the Sword, are but Words, and of no strength to secure a man at all.</p> <p><cite>Thomas Hobbes, <em>Leviathan</em>, ch. 17</cite></p> </blockquote> <p>The sovereign does not persuade the players to cooperate; he changes their payoffs, so that defection no longer pays. In the language of game theory, Hobbes’s solution is to make the game stop being a prisoner’s dilemma.</p> <p>That works, and modern states, courts and contracts are its descendants. But it leaves Glaucon’s question untouched, because it explains why people keep promises when someone watches them, which Glaucon never doubted. His question was about the ring.</p> <h2 id="3-can-cooperation-in-a-single-encounter-be-rational">3. Can cooperation in a single encounter be rational?</h2> <p>Some philosophers have argued that the dominance reasoning itself is wrong, or at least incomplete, even when the two players meet once and no sovereign watches.</p> <p>The first argument is Kantian. Kant’s categorical imperative reads, in Thomas Kingsmill Abbott’s translation, “Act only on that maxim whereby thou canst at the same time will that it should become a universal law” (<em>Groundwork</em>, Ak 4:421)<sup class="cite">[<a href="#ref-4" id="cite-4" data-ref="4" aria-label="Reference 4: Kant, I. (1785). Groundwork of the Metaphysics of Morals, Ak 4:421–422. Translated by T. K. Abbott as Fundamental Principles of the Metaphysic of Morals. Project Gutenberg #5682.">4</a>]</sup>.</p> <p>One of Kant’s own examples is close to the dilemma: a man borrows money with a promise he knows he will not keep.</p> <p>If everyone acted on that maxim, “the promise itself would become impossible, as well as the end that one might have in view in it, since no one would consider that anything was promised to him” (Ak 4:422).</p> <p>The defector’s maxim, accept the cooperation of others and give none back, has the same shape. It works only as an exception, and made universal it destroys the cooperation it lives on.</p> <p>In 1983 the cognitive scientist Douglas Hofstadter turned a related thought into an argument about the game itself. His <em>superrational</em> thinkers, “by recursive definition, include in their calculations the fact that they are in a group of superrational thinkers”<sup class="cite">[<a href="#ref-5" id="cite-5" data-ref="5" aria-label="Reference 5: Hofstadter, D. R. (1983). Dilemmas for superrational thinkers, leading up to a luring lottery. Scientific American, 248(6), 14–28. Reprinted in Metamagical Themas (1985), ch. 30.">5</a>]</sup>.</p> <p>Two such players know that they will reach the same conclusion, so the only outcomes really open to them are the two on the diagonal, and of those mutual cooperation is better.</p> <p>David Lewis showed that this is a special case of a deeper split in decision theory: “Prisoners’ Dilemma is a Newcomb Problem—or rather, two Newcomb Problems side by side, one per prisoner”<sup class="cite">[<a href="#ref-6" id="cite-6" data-ref="6" aria-label="Reference 6: Lewis, D. (1979). Prisoners&#x27; dilemma is a Newcomb problem. Philosophy &amp; Public Affairs, 8(3), 235–240.">6</a>]</sup>.</p> <p>In <em>Newcomb’s problem</em>, a very reliable predictor has put a million dollars into an opaque box if it predicted that you would take only that box, and nothing if it predicted that you would also take a transparent box with a thousand dollars in it.</p> <p>Against a player who reasons as you do, the other player’s choice is like the predictor’s: your choice does not cause it, but it is very good evidence about it.</p> <p><em>Evidential decision theory</em>, which chooses the act that is the best news about the outcome, recommends taking one box, and cooperating.</p> <p><em>Causal decision theory</em>, which chooses the act with the best causal consequences, recommends taking both boxes, and defecting, because nothing you do now changes what is in the box or what the other player does. Philosophers have not agreed which theory is right, and the disagreement is now half a century old.</p> <p>David Gauthier took a different route<sup class="cite">[<a href="#ref-7" id="cite-7" data-ref="7" aria-label="Reference 7: Gauthier, D. (1986). Morals by Agreement. Clarendon Press. Chapter VI.">7</a>]</sup>. Rather than ask which act is rational, he asked which <em>disposition</em> it is rational to have. A <em>straightforward maximizer</em> always chooses the act with the best expected outcome; a <em>constrained maximizer</em> cooperates with others who are disposed to cooperate, and defects otherwise.</p> <p>If dispositions are <em>translucent</em>, if others can tell, at least sometimes, what kind of person you are, constrained maximizers are offered cooperation and straightforward maximizers are not, and the constrained ones do better. The rational choice of a disposition can then require acts that, taken one at a time, are not rational.</p> <p>Critics have pointed out that the argument works only to the extent that dispositions really are visible, which brings Gauthier close to the next idea: that what makes cooperation rational is that the encounter is not, in fact, single.</p> <h2 id="4-the-shadow-of-the-future">4. The shadow of the future</h2> <p>David Hume saw the problem in an agricultural setting (<em>Treatise</em> 3.2.5.8)<sup class="cite">[<a href="#ref-8" id="cite-8" data-ref="8" aria-label="Reference 8: Hume, D. (1739–40). A Treatise of Human Nature, book 3, part 2, sections 2 and 5. Hume Texts Online.">8</a>]</sup>:</p> <blockquote> <p>Your corn is ripe to-day; mine will be so to-morrow. ‘Tis profitable for us both, that I shou’d labour with you to-day, and that you shou’d aid me to-morrow. I have no kindness for you, and know you have as little for me. I will not, therefore, take any pains upon your account; and should I labour with you upon my own account, in expectation of a return, I know I shou’d be disappointed, and that I shou’d in vain depend upon your gratitude. Here then I leave you to labour alone: You treat me in the same manner. The seasons change; and both of us lose our harvests for want of mutual confidence and security.</p> </blockquote> <p>The farmers in Hume’s example are not wicked; they are prudent, and prudence ruins them both. What saves them is not a sovereign but the expectation of further dealings.</p> <p>“Hence I learn to do a service to another, without bearing him any real kindness; because I forsee, that he will return my service, in expectation of another of the same kind” (3.2.5.9).</p> <p>The promise, on Hume’s account, is a convention that makes this expectation public: whoever promises “subjects himself to the penalty of never being trusted again in case of failure” (3.2.5.10).</p> <p>Game theory makes this precise. Suppose that after each round there is another with probability \(w\), so that a relationship lasts \(1/(1 - w)\) rounds on average. Now a strategy can depend on what the other player did.</p> <p>The simplest such strategy, <em>tit for tat</em>, cooperates first and then copies the other player’s previous move. Against it, a defection buys \(T\) today and costs a punishment tomorrow, and it pays to cooperate if and only if</p> \[w \;\ge\; \max\!\left(\frac{T - R}{T - P},\; \frac{T - R}{R - S}\right) = \frac{2}{3}.\] <p>The first term guards against always defecting, the second against defecting and making up in turns<sup class="cite">[<a href="#ref-9" id="cite-9" data-ref="9" aria-label="Reference 9: Axelrod, R., &amp; Hamilton, W. D. (1981). The evolution of cooperation. Science, 211(4489), 1390–1396.">9</a>]</sup>. Axelrod called \(w\) the <em>shadow of the future</em><sup class="cite">[<a href="#ref-10" id="cite-10" data-ref="10" aria-label="Reference 10: Axelrod, R. (1984). The Evolution of Cooperation. Basic Books. Chapter 4, The live-and-let-live system in trench warfare in World War I, pp. 73–87.">10</a>]</sup>.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/game-theory-ethics/shadow-light.png" width="760" alt="Points per round against tit for tat as a function of w, the probability of another round. Cooperating earns 3. Always defecting earns 5 - 4w and wins below w=1/2; defecting and making up in turns earns 5/(1 + w) and wins below w=2/3. Above 2/3 cooperating is the best reply" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/game-theory-ethics/shadow-dark.png" width="760" alt="Points per round against tit for tat as a function of w, the probability of another round. Cooperating earns 3. Always defecting earns 5 - 4w and wins below w=1/2; defecting and making up in turns earns 5/(1 + w) and wins below w=2/3. Above 2/3 cooperating is the best reply" loading="lazy"/></p> <p>The most striking illustration comes from the First World War. On quiet stretches of the Western Front, British and German battalions faced each other for weeks at a time and, without negotiating anything, stopped trying to kill each other.</p> <p>A British staff officer was “astonished to observe German soldiers walking about within rifle range behind their own line. Our men appeared to take no notice … These people evidently did not know there was a war on. Both sides apparently believed in the policy of ‘live and let live’“<sup class="cite">[<a href="#ref-11" id="cite-11" data-ref="11" aria-label="Reference 11: Ashworth, T. (1980). Trench Warfare 1914–1918: The Live and Let Live System. Macmillan.">11</a>, <a href="#ref-10" id="cite-12" data-ref="10" aria-label="Reference 10: Axelrod, R. (1984). The Evolution of Cooperation. Basic Books. Chapter 4, The live-and-let-live system in trench warfare in World War I, pp. 73–87.">10</a>]</sup>.</p> <p>When a salvo landed by mistake, a German climbed onto his parapet and shouted: “We are very sorry about that; we hope no one was hurt. It is not our fault, it is that damned Prussian artillery.”</p> <p>The truce ended when headquarters ordered raids, whose results it could check: “There was no effective way to pretend that a raid had been undertaken when it had not.”</p> <p>Two philosophical lessons follow, and the second is less comfortable than the first. The first is that the rationality of cooperation is a fact about the structure of a relationship as much as about the people in it. The same person has more reason to keep a promise to a neighbour than to a stranger at an airport.</p> <p>The second is that the repeated game does not <em>select</em> cooperation; it only <em>permits</em> it. The theorems that show cooperation can be an equilibrium of a repeated game, known collectively as the folk theorem, also show that almost any pattern of behaviour can be one, including mutual defection forever and many unequal arrangements in between.</p> <div class="callout callout-key"> <p class="callout-label">Key point</p> <p>Rationality alone underdetermines what rational people will do together. Something else, a convention, a norm, a shared history, has to pick one equilibrium among many, and that something is where much of morality lives.</p> </div> <h2 id="5-which-character-is-rational">5. Which character is rational?</h2> <p>If many strategies can sustain cooperation, which ones do well? Axelrod asked game theorists, economists, psychologists and mathematicians to submit programs and played them against each other in a round robin<sup class="cite">[<a href="#ref-12" id="cite-13" data-ref="12" aria-label="Reference 12: Axelrod, R. (1980a). Effective choice in the prisoner&#x27;s dilemma. Journal of Conflict Resolution, 24(1), 3–25.">12</a>]</sup>.</p> <p>The winner was “the simplest of all strategies submitted”, tit for tat, sent by the psychologist Anatol Rapoport<sup class="cite">[<a href="#ref-9" id="cite-14" data-ref="9" aria-label="Reference 9: Axelrod, R., &amp; Hamilton, W. D. (1981). The evolution of cooperation. Science, 211(4489), 1390–1396.">9</a>]</sup>. In a second round, 62 entrants who knew this tried to beat it, and it won again<sup class="cite">[<a href="#ref-13" id="cite-15" data-ref="13" aria-label="Reference 13: Axelrod, R. (1980b). More effective choice in the prisoner&#x27;s dilemma. Journal of Conflict Resolution, 24(3), 379–403.">13</a>]</sup>.</p> <p>A rerun of that second tournament from Axelrod’s original code with 25,000 random seeds has since found that tit for tat wins about 63% of them<sup class="cite">[<a href="#ref-14" id="cite-16" data-ref="14" aria-label="Reference 14: Knight, V., Campbell, O., Harper, M., Gaffney, T. J., &amp; Glynatsi, N. E. (2025). Reviving, reproducing, and revisiting Axelrod&#x27;s second tournament. arXiv:2510.15438.">14</a>]</sup>, so the result is a tendency, not a law. Here is a small tournament of the same kind, with twelve classic strategies:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/game-theory-ethics/tournament-light.png" width="760" alt="Matches won against mean points per round for twelve strategies. Generous ZD scores highest, 2.50, winning 0 matches; the nice strategies take the top places without winning any. Always defect wins 9 of 11 matches and scores 2.05; Joss is last with 1.87" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/game-theory-ethics/tournament-dark.png" width="760" alt="Matches won against mean points per round for twelve strategies. Generous ZD scores highest, 2.50, winning 0 matches; the nice strategies take the top places without winning any. Always defect wins 9 of 11 matches and scores 2.05; Joss is last with 1.87" loading="lazy"/></p> <p class="takeaway">The six strategies that never defect first take the top six places, while always defect wins nine of its eleven matches and finishes ninth.</p> <p>Between them, those six win almost no individual matches. The <em>Extortioner</em>, one of the zero-determinant strategies that William Press and Freeman Dyson found in 2012, is built never to earn less than its partner<sup class="cite">[<a href="#ref-15" id="cite-17" data-ref="15" aria-label="Reference 15: Press, W. H., &amp; Dyson, F. J. (2012). Iterated Prisoner&#x27;s Dilemma contains strategies that dominate any evolutionary opponent. PNAS, 109(26), 10409–10413.">15</a>]</sup>.</p> <p>It loses no match and finishes eleventh. Its generous twin, built never to earn more than its partner, wins no match and finishes first<sup class="cite">[<a href="#ref-16" id="cite-18" data-ref="16" aria-label="Reference 16: Stewart, A. J., &amp; Plotkin, J. B. (2013). From extortion to generosity, evolution in the Iterated Prisoner&#x27;s Dilemma. PNAS, 110(38), 15348–15353.">16</a>]</sup>.</p> <p>Axelrod’s explanation is that a nice strategy can never get more than its partner in a single game, since it only defects in answer to a defection; it wins the tournament by doing reasonably well with everyone.</p> <p>His advice “Don’t be envious” is a point about which comparison is rational: your score is measured against others in your position, not against the person across the table.</p> <p>Axelrod summed up the winning character in four words, “nice, retaliatory, forgiving, and clear”<sup class="cite">[<a href="#ref-10" id="cite-19" data-ref="10" aria-label="Reference 10: Axelrod, R. (1984). The Evolution of Cooperation. Basic Books. Chapter 4, The live-and-let-live system in trench warfare in World War I, pp. 73–87.">10</a>]</sup>. Each word names something a moral philosopher would recognise: benevolence, a readiness to resent injury, a willingness to let it go, and the transparency that makes a person predictable.</p> <p>What game theory adds is that the four belong together. Niceness without retaliation is exploited, retaliation without forgiveness turns every accident into a feud, and both without clarity are wasted, because the other side cannot learn from them.</p> <p>The feud is easy to see once mistakes are allowed, as they always are in life:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/game-theory-ethics/echo-light.png" width="760" alt="Sixteen rounds between two players of the same strategy, with one mistake in round 4: player one means to cooperate and defects. Two tit for tat players then punish each other in turns for the rest of the game. Two generous tit for tat players stop the echo when one of them forgives, here after 2 rounds. Two win-stay, lose-shift players defect together once and are back to cooperating in round 6" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/game-theory-ethics/echo-dark.png" width="760" alt="Sixteen rounds between two players of the same strategy, with one mistake in round 4: player one means to cooperate and defects. Two tit for tat players then punish each other in turns for the rest of the game. Two generous tit for tat players stop the echo when one of them forgives, here after 2 rounds. Two win-stay, lose-shift players defect together once and are back to cooperating in round 6" loading="lazy"/></p> <p>Between two tit for tat players, one misread gesture starts an exchange of punishments that never ends, each side certain that it is only responding. A <em>generous</em> version of tit for tat, which forgives a defection with some probability \(q\), stops the echo after a few rounds<sup class="cite">[<a href="#ref-17" id="cite-20" data-ref="17" aria-label="Reference 17: Nowak, M., &amp; Sigmund, K. (1992). Tit for tat in heterogeneous populations. Nature, 355, 250–253.">17</a>]</sup>.</p> <p>How large should \(q\) be? Forgive too rarely, and mistakes turn into feuds; forgive too often, and a player who alternates defection and apology earns more than honest cooperators. The largest forgiveness that no exploiter can profit from is</p> \[q^* = \min\!\left(1 - \frac{T - R}{R - S},\; \frac{R - P}{T - P}\right) = \frac{1}{3}\] <p>with these payoffs<sup class="cite">[<a href="#ref-18" id="cite-21" data-ref="18" aria-label="Reference 18: Molander, P. (1985). The optimal level of generosity in a selfish, uncertain environment. Journal of Conflict Resolution, 29(4), 611–618.">18</a>, <a href="#ref-17" id="cite-22" data-ref="17" aria-label="Reference 17: Nowak, M., &amp; Sigmund, K. (1992). Tit for tat in heterogeneous populations. Nature, 355, 250–253.">17</a>]</sup>:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/game-theory-ethics/forgiveness-light.png" width="760" alt="Left: residents who forgive a defection with probability q earn 3; an invader who defects every other round earns more once q passes 1/3, one who always defects once q passes 1/2. Right: with 5 percent mistakes the residents earn more the more they forgive" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/game-theory-ethics/forgiveness-dark.png" width="760" alt="Left: residents who forgive a defection with probability q earn 3; an invader who defects every other round earns more once q passes 1/3, one who always defects once q passes 1/2. Right: with 5 percent mistakes the residents earn more the more they forgive" loading="lazy"/></p> <p>It is hard not to read this as a formal version of Aristotle’s doctrine of the mean.</p> <p>“Virtue, then, is a state of character concerned with choice, lying in a mean, i.e. the mean relative to us”; to feel anger “at the right times, with reference to the right objects, towards the right people, with the right motive, and in the right way, is what is both intermediate and best” (<em>Nicomachean Ethics</em> II.6)<sup class="cite">[<a href="#ref-19" id="cite-23" data-ref="19" aria-label="Reference 19: Aristotle. Nicomachean Ethics, book II. Translated by W. D. Ross.">19</a>]</sup>.</p> <p>Forgiveness here has an excess and a deficiency, and its mean is not a midpoint but depends on the situation, as Aristotle said it should: as the temptation \(T\) grows relative to the reward \(R\), the right amount of forgiveness falls.</p> <h2 id="6-evolution-and-the-origin-of-morality">6. Evolution and the origin of morality</h2> <p>If cooperative dispositions pay, natural selection and cultural imitation will spread them, and biologists have taken this as an explanation of where morality comes from.</p> <p>Robert Trivers opened the paper that introduced reciprocal altruism with an admission: “Models that attempt to explain altruistic behavior in terms of natural selection are models designed to take the altruism out of altruism”<sup class="cite">[<a href="#ref-20" id="cite-24" data-ref="20" aria-label="Reference 20: Trivers, R. L. (1971). The evolution of reciprocal altruism. Quarterly Review of Biology, 46(1), 35–57.">20</a>]</sup>.</p> <p>Here is what imitation does to a population of a hundred players who copy strategies that earn more, with relationships of twenty rounds on average and one move in fifty going wrong:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/game-theory-ethics/cycles-light.png" width="760" alt="Shares of strategies in a population of a hundred over time. Without generous tit for tat the population cycles: defectors are replaced by tit for tat, which drifts into unconditional cooperation, which defectors take over again; over twenty runs defectors hold the majority 49% of the time. With generous tit for tat it mostly holds the population, and defectors hold the majority 18% of the time" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/game-theory-ethics/cycles-dark.png" width="760" alt="Shares of strategies in a population of a hundred over time. Without generous tit for tat the population cycles: defectors are replaced by tit for tat, which drifts into unconditional cooperation, which defectors take over again; over twenty runs defectors hold the majority 49% of the time. With generous tit for tat it mostly holds the population, and defectors hold the majority 18% of the time" loading="lazy"/></p> <p>With only always defect, tit for tat and unconditional cooperation available, the population never settles. Tit for tat drives out defectors; unconditional cooperators then drift in, since among reciprocators they do just as well; once there are enough of them, defectors return.</p> <p>Lorens Imhof, Drew Fudenberg and Martin Nowak described this cycle in finite populations<sup class="cite">[<a href="#ref-21" id="cite-25" data-ref="21" aria-label="Reference 21: Imhof, L. A., Fudenberg, D., &amp; Nowak, M. A. (2005). Evolutionary cycles of cooperation and defection. PNAS, 102(31), 10797–10800.">21</a>]</sup>. Over twenty runs of the simulation, defectors held the majority 49% of the time.</p> <p>Unconditional kindness, on this picture, is not a stable state of a society but a phase of it, and what protects a cooperative society is a willingness to punish that erodes exactly when it seems least necessary.</p> <p class="takeaway">When generous tit for tat is available, it takes over and holds the population: defectors held the majority 18% of the time, and the average payoff rose from 1.94 to 2.58 points per round.</p> <p>The evolutionary story raises an old worry in a new form. If our moral dispositions exist because they paid, are they really moral?</p> <p>One answer is that the explanation of a disposition’s origin is not an account of its content: a person who keeps a promise because they value honesty is honest, whatever selection did to their ancestors.</p> <p>Another answer comes from the way cooperation among strangers actually works. Richard Alexander argued that “moral systems are systems of indirect reciprocity” (p. 77)<sup class="cite">[<a href="#ref-22" id="cite-26" data-ref="22" aria-label="Reference 22: Alexander, R. D. (1987). The Biology of Moral Systems. Aldine de Gruyter; reissued by Routledge, 2017.">22</a>]</sup>: I help you, and someone else helps me, because they saw what I did.</p> <p>Reputation then does the work that repetition does between two people, and it requires judging others, which brings normative questions back in. Martin Nowak and Karl Sigmund showed that cooperation can be sustained by a public “image score” that rises when you help and falls when you refuse<sup class="cite">[<a href="#ref-23" id="cite-27" data-ref="23" aria-label="Reference 23: Nowak, M. A., &amp; Sigmund, K. (1998). Evolution of indirect reciprocity by image scoring. Nature, 393, 573–577.">23</a>]</sup>.</p> <p>But a player who refuses to help a known cheat then loses reputation for enforcing the norm, so a rule called <em>standing</em>, which looks at whom you refused, works much better<sup class="cite">[<a href="#ref-24" id="cite-28" data-ref="24" aria-label="Reference 24: Leimar, O., &amp; Hammerstein, P. (2001). Evolution of cooperation through indirect reciprocity. Proceedings of the Royal Society B, 268, 745–753.">24</a>]</sup>:</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/game-theory-ethics/reputation-light.png" width="760" alt="How an observer updates a donor&#x27;s reputation. Image scoring looks only at the act: helping makes the donor good, refusing makes the donor bad. Standing also looks at whom the donor refused: refusing someone with a bad reputation keeps the donor good. The two rules differ only in that one case" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/game-theory-ethics/reputation-dark.png" width="760" alt="How an observer updates a donor&#x27;s reputation. Image scoring looks only at the act: helping makes the donor good, refusing makes the donor bad. Standing also looks at whom the donor refused: refusing someone with a bad reputation keeps the donor good. The two rules differ only in that one case" loading="lazy"/></p> <p>When Hisashi Ohtsuki and Yoh Iwasa checked all 4096 rules of this kind, only eight kept cooperation stable, and all eight share two features: helping a good person is good and refusing one is bad; refusing a bad person is good, “because it works as sanction”<sup class="cite">[<a href="#ref-25" id="cite-29" data-ref="25" aria-label="Reference 25: Ohtsuki, H., &amp; Iwasa, Y. (2004). How should we define goodness? Reputation dynamics in indirect reciprocity. Journal of Theoretical Biology, 231(1), 107–120.">25</a>]</sup>.</p> <p>The evolution of cooperation selects not only for helping but for a particular moral judgement: that punishing the guilty is just and punishing the punisher is not.</p> <p>Indirect reciprocity also gives an answer to Hume’s <em>sensible knave</em>, who reasons: “That honesty is the best policy, may be a good general rule; but is liable to many exceptions: And he, it may, perhaps, be thought, conducts himself with most wisdom, who observes the general rule, and takes advantage of all the exceptions” (<em>Enquiry</em> 9.22)<sup class="cite">[<a href="#ref-26" id="cite-30" data-ref="26" aria-label="Reference 26: Hume, D. (1751). An Enquiry concerning the Principles of Morals, section 9, part 2. Hume Texts Online.">26</a>]</sup>.</p> <p>Hume admitted that if a man thinks this reasoning requires an answer, “it will be a little difficult to find any, which will to him appear satisfactory and convincing” (9.23).</p> <p>The answer he did give was about the knave’s inner life: knaves “are, in the end, the greatest dupes, and have sacrificed the invaluable enjoyment of a character, with themselves at least, for the acquisition of worthless toys and gewgaws” (9.25).</p> <p>The game-theoretic answer is about his outer life. In a world of indirect reciprocity, the knave’s exceptions are exactly what others observe and remember, and only a knave who could be sure of never being seen would profit from them. That knave is Gyges again, and rings like his are rare.</p> <h2 id="7-the-stag-hunt-and-the-social-contract">7. The stag hunt and the social contract</h2> <p>Not every problem of cooperation is a prisoner’s dilemma. Rousseau told a story in which nobody gains by betraying anyone: “Was a deer to be taken? Every one saw that to succeed he must faithfully stand to his post; but suppose a hare to have slipped by within reach of any one of them, it is not to be doubted but he pursued it without scruple”<sup class="cite">[<a href="#ref-27" id="cite-31" data-ref="27" aria-label="Reference 27: Rousseau, J.-J. (1755). A Discourse upon the Origin and the Foundation of the Inequality among Mankind, part II.">27</a>]</sup>.</p> <p>Brian Skyrms argued that this game deserves at least as much attention as the prisoner’s dilemma: “The Stag Hunt is a story that became a game. The game is a prototype of the social contract”<sup class="cite">[<a href="#ref-28" id="cite-32" data-ref="28" aria-label="Reference 28: Skyrms, B. (2001). The stag hunt. Proceedings and Addresses of the American Philosophical Association, 75(2), 31–41.">28</a>]</sup>.</p> <p><img class="tfs-figure tfs-light" src="/assets/posts/game-theory-ethics/stag-light.png" width="760" alt="Expected catch of hunting the stag (4 times the share p of others who hunt it) and of hunting hare (3). Hunting the stag pays when more than three quarters of the others hunt it; below that the share of stag hunters falls, above it it rises" loading="lazy"/> <img class="tfs-figure tfs-dark" src="/assets/posts/game-theory-ethics/stag-dark.png" width="760" alt="Expected catch of hunting the stag (4 times the share p of others who hunt it) and of hunting hare (3). Hunting the stag pays when more than three quarters of the others hunt it; below that the share of stag hunters falls, above it it rises" loading="lazy"/></p> <p>In the stag hunt, mutual cooperation is an equilibrium: nobody wants to leave a successful hunt. But mutual distrust is an equilibrium too, and it is the safer one, what John Harsanyi and Reinhard Selten called <em>risk-dominant</em><sup class="cite">[<a href="#ref-29" id="cite-33" data-ref="29" aria-label="Reference 29: Harsanyi, J. C., &amp; Selten, R. (1988). A General Theory of Equilibrium Selection in Games. MIT Press.">29</a>]</sup>.</p> <p>With a stag worth 4 to each hunter, a hare worth 3 and nothing for hunting the stag alone, hunting the stag pays only if more than three quarters of the others will hunt it too.</p> <p>The problem is not temptation but trust, and trust here is self-fulfilling: the same people, with the same values, end up in either equilibrium depending on what they expect of each other.</p> <p>This is the structure of what Hume called convention, and his example is the cleanest: “Two men, who pull the oars of a boat, do it by an agreement or convention, tho’ they have never given promises to each other” (<em>Treatise</em> 3.2.2.10)<sup class="cite">[<a href="#ref-8" id="cite-34" data-ref="8" aria-label="Reference 8: Hume, D. (1739–40). A Treatise of Human Nature, book 3, part 2, sections 2 and 5. Hume Texts Online.">8</a>]</sup>.</p> <p>David Lewis built his analysis of convention on such cases, Hume’s rowers among them: a regularity is a convention if everyone conforms to it, everyone expects everyone else to conform, and everyone prefers to conform on condition that the others do (p. 42)<sup class="cite">[<a href="#ref-30" id="cite-35" data-ref="30" aria-label="Reference 30: Lewis, D. (1969). Convention: A Philosophical Study. Harvard University Press. The introduction and chapters I–II in facsimile, Econ Journal Watch, 16(2), 2019.">30</a>]</sup>.</p> <p>On this view, a good deal of what we call morality, the rules of fair division, of turn-taking, of truthfulness in ordinary talk, is less a constraint on self-interest than a way of coordinating on one of many equilibria.</p> <p>Skyrms noted the link with the shadow of the future: “If the probability of repetition is high enough, the stag hunting equilibrium becomes risk dominant.”</p> <h2 id="8-what-game-theory-cannot-settle">8. What game theory cannot settle</h2> <p>Every model in this essay takes the payoffs as given and asks only how to play. Amartya Sen argued that this is where the theory is weakest: a person who acts only on their own preferences, with no room for commitment to others or to principles, is not a model of rationality but of a kind of impoverishment.</p> <p>In his words, “The purely economic man is indeed close to being a social moron” (p. 336)<sup class="cite">[<a href="#ref-31" id="cite-36" data-ref="31" aria-label="Reference 31: Sen, A. K. (1977). Rational fools: a critique of the behavioral foundations of economic theory. Philosophy &amp; Public Affairs, 6(4), 317–344.">31</a>]</sup>. Experiments agree that real players are not like this.</p> <p>In the ultimatum game, where one player proposes how to split a sum and the other can accept or let both get nothing, the narrowly rational offer is the smallest possible one, and typical offers are 40 to 50 percent<sup class="cite">[<a href="#ref-32" id="cite-37" data-ref="32" aria-label="Reference 32: Güth, W., &amp; Kocher, M. G. (2014). More than thirty years of ultimatum bargaining experiments. Journal of Economic Behavior &amp; Organization, 108, 396–409.">32</a>]</sup>.</p> <p>Across fifteen small-scale societies, mean offers ranged from 26 to 58 percent, and “the higher the degree of market integration and the higher the payoffs to cooperation, the greater the level of cooperation in experimental games”<sup class="cite">[<a href="#ref-33" id="cite-38" data-ref="33" aria-label="Reference 33: Henrich, J., Boyd, R., Bowles, S., Camerer, C., Fehr, E., Gintis, H., &amp; McElreath, R. (2001). In search of homo economicus: behavioral experiments in 15 small-scale societies. American Economic Review, 91(2), 73–78.">33</a>]</sup>.</p> <p>Even the trench truce has been questioned as an example: Andrew Gelman argued that not shooting simply lowered each side’s own risk, so the soldiers may not have faced a prisoner’s dilemma at all<sup class="cite">[<a href="#ref-34" id="cite-39" data-ref="34" aria-label="Reference 34: Gelman, A. (2008). Methodology as ideology: some comments on Robert Axelrod&#x27;s The Evolution of Cooperation. QA Rivista dell&#x27;Associazione Rossi-Doria, 2/2008, 167–176.">34</a>]</sup>.</p> <p>This sets the limit of the whole approach. Game theory can show that, given what people want, certain dispositions are rational: niceness, retaliation, a measured forgiveness, attention to reputation, a readiness to trust when trust is likely to be returned.</p> <div class="callout callout-key"> <p class="callout-label">Key point</p> <p>Game theory cannot show what people should want. The payoffs are inputs, and the question of what is worth wanting, which is most of ethics, comes before the first row of the table.</p> </div> <p>What, then, of Glaucon? Game theory answers him in part. For people who expect to meet again, who are watched by others, and who cannot be sure that their rings will keep working, justice is very often the rational choice, and the models even say which kind of justice: nice, firm, forgiving within limits, and clear.</p> <p>They do not answer the question Glaucon actually asked, which was whether justice is good in itself, for someone whose ring never fails. That question the models leave where Plato found it.</p> <h2 id="references">References</h2> <ol class="tfs-refs"> <li id="ref-1">Plato. <em>Republic</em>, book II, 358e–360d. Translated by B. Jowett. <a href="https://www.gutenberg.org/ebooks/1497">Project Gutenberg #1497</a>. <a class="ref-back" href="#cite-1" aria-label="Back to the text">↩</a></li> <li id="ref-2">Flood, M. M. (1952). <a href="https://www.rand.org/pubs/research_memoranda/RM789-1.html"><em>Some Experimental Games</em></a>. RAND Research Memorandum RM-789-1. <a class="ref-back" href="#cite-2" aria-label="Back to the text">↩</a></li> <li id="ref-3">Hobbes, T. (1651). <em>Leviathan</em>, chapters 13, 15 and 17 (pp. 62, 72–73 and 85 of the first edition). <a href="https://www.gutenberg.org/ebooks/3207">Project Gutenberg #3207</a>. <a class="ref-back" href="#cite-3" aria-label="Back to the text">↩</a></li> <li id="ref-4">Kant, I. (1785). <em>Groundwork of the Metaphysics of Morals</em>, Ak 4:421–422. Translated by T. K. Abbott as <em>Fundamental Principles of the Metaphysic of Morals</em>. <a href="https://www.gutenberg.org/ebooks/5682">Project Gutenberg #5682</a>. <a class="ref-back" href="#cite-4" aria-label="Back to the text">↩</a></li> <li id="ref-5">Hofstadter, D. R. (1983). <a href="https://doi.org/10.1038/scientificamerican0683-14">Dilemmas for superrational thinkers, leading up to a luring lottery</a>. <em>Scientific American</em>, 248(6), 14–28. Reprinted in <em>Metamagical Themas</em> (1985), ch. 30. <a class="ref-back" href="#cite-5" aria-label="Back to the text">↩</a></li> <li id="ref-6">Lewis, D. (1979). <a href="https://www.jstor.org/stable/2265034">Prisoners’ dilemma is a Newcomb problem</a>. <em>Philosophy &amp; Public Affairs</em>, 8(3), 235–240. <a class="ref-back" href="#cite-6" aria-label="Back to the text">↩</a></li> <li id="ref-7">Gauthier, D. (1986). <a href="https://doi.org/10.1093/0198249926.001.0001"><em>Morals by Agreement</em></a>. Clarendon Press. Chapter VI. <a class="ref-back" href="#cite-7" aria-label="Back to the text">↩</a></li> <li id="ref-8">Hume, D. (1739–40). <em>A Treatise of Human Nature</em>, book 3, part 2, sections <a href="https://davidhume.org/texts/t/3/2/2">2</a> and <a href="https://davidhume.org/texts/t/3/2/5">5</a>. Hume Texts Online. <a class="ref-back" href="#cite-8" aria-label="Back to the text">↩</a></li> <li id="ref-9">Axelrod, R., &amp; Hamilton, W. D. (1981). <a href="https://doi.org/10.1126/science.7466396">The evolution of cooperation</a>. <em>Science</em>, 211(4489), 1390–1396. <a class="ref-back" href="#cite-9" aria-label="Back to the text">↩</a></li> <li id="ref-10">Axelrod, R. (1984). <em>The Evolution of Cooperation</em>. Basic Books. Chapter 4, <a href="https://gwern.net/doc/economics/1984-axelrod-theevolutionofcooperation-ch4-theliveandletlivesysteminwwi.html">The live-and-let-live system in trench warfare in World War I</a>, pp. 73–87. <a class="ref-back" href="#cite-10" aria-label="Back to the text">↩</a></li> <li id="ref-11">Ashworth, T. (1980). <a href="https://doi.org/10.1007/978-1-349-04356-9"><em>Trench Warfare 1914–1918: The Live and Let Live System</em></a>. Macmillan. <a class="ref-back" href="#cite-11" aria-label="Back to the text">↩</a></li> <li id="ref-12">Axelrod, R. (1980a). <a href="https://doi.org/10.1177/002200278002400101">Effective choice in the prisoner’s dilemma</a>. <em>Journal of Conflict Resolution</em>, 24(1), 3–25. <a class="ref-back" href="#cite-13" aria-label="Back to the text">↩</a></li> <li id="ref-13">Axelrod, R. (1980b). <a href="https://doi.org/10.1177/002200278002400301">More effective choice in the prisoner’s dilemma</a>. <em>Journal of Conflict Resolution</em>, 24(3), 379–403. <a class="ref-back" href="#cite-15" aria-label="Back to the text">↩</a></li> <li id="ref-14">Knight, V., Campbell, O., Harper, M., Gaffney, T. J., &amp; Glynatsi, N. E. (2025). <a href="https://arxiv.org/abs/2510.15438">Reviving, reproducing, and revisiting Axelrod’s second tournament</a>. arXiv:2510.15438. <a class="ref-back" href="#cite-16" aria-label="Back to the text">↩</a></li> <li id="ref-15">Press, W. H., &amp; Dyson, F. J. (2012). <a href="https://doi.org/10.1073/pnas.1206569109">Iterated Prisoner’s Dilemma contains strategies that dominate any evolutionary opponent</a>. <em>PNAS</em>, 109(26), 10409–10413. <a class="ref-back" href="#cite-17" aria-label="Back to the text">↩</a></li> <li id="ref-16">Stewart, A. J., &amp; Plotkin, J. B. (2013). <a href="https://doi.org/10.1073/pnas.1306246110">From extortion to generosity, evolution in the Iterated Prisoner’s Dilemma</a>. <em>PNAS</em>, 110(38), 15348–15353. <a class="ref-back" href="#cite-18" aria-label="Back to the text">↩</a></li> <li id="ref-17">Nowak, M., &amp; Sigmund, K. (1992). <a href="https://doi.org/10.1038/355250a0">Tit for tat in heterogeneous populations</a>. <em>Nature</em>, 355, 250–253. <a class="ref-back" href="#cite-20" aria-label="Back to the text">↩</a></li> <li id="ref-18">Molander, P. (1985). <a href="https://doi.org/10.1177/0022002785029004004">The optimal level of generosity in a selfish, uncertain environment</a>. <em>Journal of Conflict Resolution</em>, 29(4), 611–618. <a class="ref-back" href="#cite-21" aria-label="Back to the text">↩</a></li> <li id="ref-19">Aristotle. <em>Nicomachean Ethics</em>, <a href="https://classics.mit.edu/Aristotle/nicomachaen.2.ii.html">book II</a>. Translated by W. D. Ross. <a class="ref-back" href="#cite-23" aria-label="Back to the text">↩</a></li> <li id="ref-20">Trivers, R. L. (1971). <a href="https://doi.org/10.1086/406755">The evolution of reciprocal altruism</a>. <em>Quarterly Review of Biology</em>, 46(1), 35–57. <a class="ref-back" href="#cite-24" aria-label="Back to the text">↩</a></li> <li id="ref-21">Imhof, L. A., Fudenberg, D., &amp; Nowak, M. A. (2005). <a href="https://doi.org/10.1073/pnas.0502589102">Evolutionary cycles of cooperation and defection</a>. <em>PNAS</em>, 102(31), 10797–10800. <a class="ref-back" href="#cite-25" aria-label="Back to the text">↩</a></li> <li id="ref-22">Alexander, R. D. (1987). <a href="https://doi.org/10.4324/9780203700976"><em>The Biology of Moral Systems</em></a>. Aldine de Gruyter; reissued by Routledge, 2017. <a class="ref-back" href="#cite-26" aria-label="Back to the text">↩</a></li> <li id="ref-23">Nowak, M. A., &amp; Sigmund, K. (1998). <a href="https://doi.org/10.1038/31225">Evolution of indirect reciprocity by image scoring</a>. <em>Nature</em>, 393, 573–577. <a class="ref-back" href="#cite-27" aria-label="Back to the text">↩</a></li> <li id="ref-24">Leimar, O., &amp; Hammerstein, P. (2001). <a href="https://doi.org/10.1098/rspb.2000.1573">Evolution of cooperation through indirect reciprocity</a>. <em>Proceedings of the Royal Society B</em>, 268, 745–753. <a class="ref-back" href="#cite-28" aria-label="Back to the text">↩</a></li> <li id="ref-25">Ohtsuki, H., &amp; Iwasa, Y. (2004). <a href="https://doi.org/10.1016/j.jtbi.2004.06.005">How should we define goodness? Reputation dynamics in indirect reciprocity</a>. <em>Journal of Theoretical Biology</em>, 231(1), 107–120. <a class="ref-back" href="#cite-29" aria-label="Back to the text">↩</a></li> <li id="ref-26">Hume, D. (1751). <em>An Enquiry concerning the Principles of Morals</em>, <a href="https://davidhume.org/texts/m/9">section 9, part 2</a>. Hume Texts Online. <a class="ref-back" href="#cite-30" aria-label="Back to the text">↩</a></li> <li id="ref-27">Rousseau, J.-J. (1755). <a href="https://www.gutenberg.org/ebooks/11136"><em>A Discourse upon the Origin and the Foundation of the Inequality among Mankind</em></a>, part II. <a class="ref-back" href="#cite-31" aria-label="Back to the text">↩</a></li> <li id="ref-28">Skyrms, B. (2001). <a href="https://doi.org/10.2307/3218711">The stag hunt</a>. <em>Proceedings and Addresses of the American Philosophical Association</em>, 75(2), 31–41. <a class="ref-back" href="#cite-32" aria-label="Back to the text">↩</a></li> <li id="ref-29">Harsanyi, J. C., &amp; Selten, R. (1988). <a href="https://openlibrary.org/isbn/0262081733"><em>A General Theory of Equilibrium Selection in Games</em></a>. MIT Press. <a class="ref-back" href="#cite-33" aria-label="Back to the text">↩</a></li> <li id="ref-30">Lewis, D. (1969). <em>Convention: A Philosophical Study</em>. Harvard University Press. The introduction and chapters I–II in <a href="https://econjwatch.org/articles/convention-a-philosophical-studyintroduction-chapter-i-and-chapter-ii">facsimile</a>, <em>Econ Journal Watch</em>, 16(2), 2019. <a class="ref-back" href="#cite-35" aria-label="Back to the text">↩</a></li> <li id="ref-31">Sen, A. K. (1977). <a href="https://www.jstor.org/stable/2264946">Rational fools: a critique of the behavioral foundations of economic theory</a>. <em>Philosophy &amp; Public Affairs</em>, 6(4), 317–344. <a class="ref-back" href="#cite-36" aria-label="Back to the text">↩</a></li> <li id="ref-32">Güth, W., &amp; Kocher, M. G. (2014). <a href="https://doi.org/10.1016/j.jebo.2014.06.006">More than thirty years of ultimatum bargaining experiments</a>. <em>Journal of Economic Behavior &amp; Organization</em>, 108, 396–409. <a class="ref-back" href="#cite-37" aria-label="Back to the text">↩</a></li> <li id="ref-33">Henrich, J., Boyd, R., Bowles, S., Camerer, C., Fehr, E., Gintis, H., &amp; McElreath, R. (2001). <a href="https://doi.org/10.1257/aer.91.2.73">In search of homo economicus: behavioral experiments in 15 small-scale societies</a>. <em>American Economic Review</em>, 91(2), 73–78. <a class="ref-back" href="#cite-38" aria-label="Back to the text">↩</a></li> <li id="ref-34">Gelman, A. (2008). <a href="https://francoangeli.it/riviste/articolo/33851">Methodology as ideology: some comments on Robert Axelrod’s <em>The Evolution of Cooperation</em></a>. <em>QA Rivista dell’Associazione Rossi-Doria</em>, 2/2008, 167–176. <a class="ref-back" href="#cite-39" aria-label="Back to the text">↩</a></li> </ol> <h2 id="further-reading">Further reading</h2> <ul> <li>Kuhn, S. <a href="https://plato.stanford.edu/entries/prisoner-dilemma/">Prisoner’s Dilemma</a>. <em>Stanford Encyclopedia of Philosophy</em>.</li> <li>Hankins, K., &amp; Vanderschraaf, P. <a href="https://plato.stanford.edu/entries/game-ethics/">Game Theory and Ethics</a>. <em>Stanford Encyclopedia of Philosophy</em>.</li> <li>Lloyd, S. A., &amp; Sreedhar, S. <a href="https://plato.stanford.edu/entries/hobbes-moral/">Hobbes’s Moral and Political Philosophy</a>. <em>Stanford Encyclopedia of Philosophy</em>.</li> <li>Cudd, A., &amp; Eftekhari, S. <a href="https://plato.stanford.edu/entries/contractarianism/">Contractarianism</a>. <em>Stanford Encyclopedia of Philosophy</em>.</li> <li>Alexander, J. McK. <a href="https://plato.stanford.edu/entries/game-evolutionary/">Evolutionary Game Theory</a>. <em>Stanford Encyclopedia of Philosophy</em>.</li> <li>Rescorla, M. <a href="https://plato.stanford.edu/entries/convention/">Convention</a>. <em>Stanford Encyclopedia of Philosophy</em>.</li> <li>Skyrms, B. (1996). <a href="https://doi.org/10.1017/CBO9780511806308"><em>Evolution of the Social Contract</em></a>. Cambridge University Press.</li> <li>Binmore, K. (2005). <a href="https://doi.org/10.1093/acprof:oso/9780195178111.001.0001"><em>Natural Justice</em></a>. Oxford University Press.</li> </ul> <p>The models, the simulations and the figures: <a href="https://github.com/xmarva/transformers-from-scratch/tree/main/articles/game_theory">articles/game_theory</a>.</p>]]></content> <author> <name>Eva Koroleva</name> </author> <category term="philosophy"/> <category term="game-theory"/> <category term="ethics"/> <category term="philosophy"/> <category term="cooperation"/> <category term="prisoners-dilemma"/> <summary type="html"><![CDATA[Glaucon's challenge, Hobbes's Foole and Hume's farmers read through the prisoner's dilemma: when cooperation is rational, which virtues the models select, how much forgiveness reason allows, and what game theory cannot settle]]></summary> <media:thumbnail url="https://blog.korolevalab.com/assets/posts/game-theory-ethics/cover.png"/> <media:content medium="image" url="https://blog.korolevalab.com/assets/posts/game-theory-ethics/cover.png"/> </entry> </feed>